
GPT-5.2 بالتفصيل: المزايا، معايير الأداء، التسعير، وحالات الاستخدام
تعرّف على GPT-5.2 Instant وThinking وPro وCodex: التسعير، معايير الأداء، الوصول، القيود، ومقارنته مع Gemini 3 للمطورين في 2026.
الشكل 1. تقييم GPT-5.2 من حيث الجودة والسرعة والتكلفة والتحكم
اخترت GPT‑5.2 Pro داخل Enter Pro لبناء أداة مراجعة ملخصات مشاريع تحوّل أفكار التطبيقات إلى متطلبات ومعايير قبول. تُظهر لقطات الشاشة عملية الإعداد ومخرجات المراجعة، بينما يبقى التحقق من اكتمال الطلب خطوة مفتوحة.
تمنح هذه الحالة العملية هذا الدليل نقطة مرجعية ملموسة. أفصل بين نتائج معايير الأداء الرسمية وما أظهره التطبيق فعليًا بالعين، ثم أفحص قدرات عائلة النماذج هذه وتسعيرها وحدودها. يجب عليك تحديد النسخة الدقيقة قبل تطبيق أي ملاحظة على Instant أو Thinking أو Pro أو Codex.
قدّمت OpenAI هذه العائلة في 11 ديسمبر 2025 كإصدار موجّه للعمل المهني والوكلاء طويلي التشغيل. يوفر تقرير الإطلاق خط الأساس الرسمي لمعايير الأداء والتسعير. أستخدم هذا التقرير مع معلومات التوجيه الحالية، ونقد مستقل مهم، وتقارير من المجتمع، لأن مصدرًا واحدًا لا يستطيع التقاط الأداء المضبوط ومصاعب الاستخدام اليومي في آنٍ واحد.
من يبحث عن شات GPT 5.2 يقصد غالبًا العائلة الكاملة لشهر ديسمبر 2025، لكن التمييز بين أنماط ChatGPT ومعرّفات نماذج واجهة البرمجة مهم. اختبار Instant لا يُثبت سلوك أو سعر أو زمن استجابة Thinking أو Pro أو النموذج المتخصص في البرمجة.
GPT-5.2 في نظرة سريعة
حتى 9 أكتوبر 2026، تُصنّف OpenAI GPT‑5.2 وGPT‑5.2 Pro كخيارات من الجيل السابق. قد تجد المشاريع القائمة قيمة في سلوكها المعروف ولقطاتها الثابتة، أما المشروع الجديد فينبغي أن يقارن النماذج الموصى بها حاليًا وفق معايير القبول نفسها.
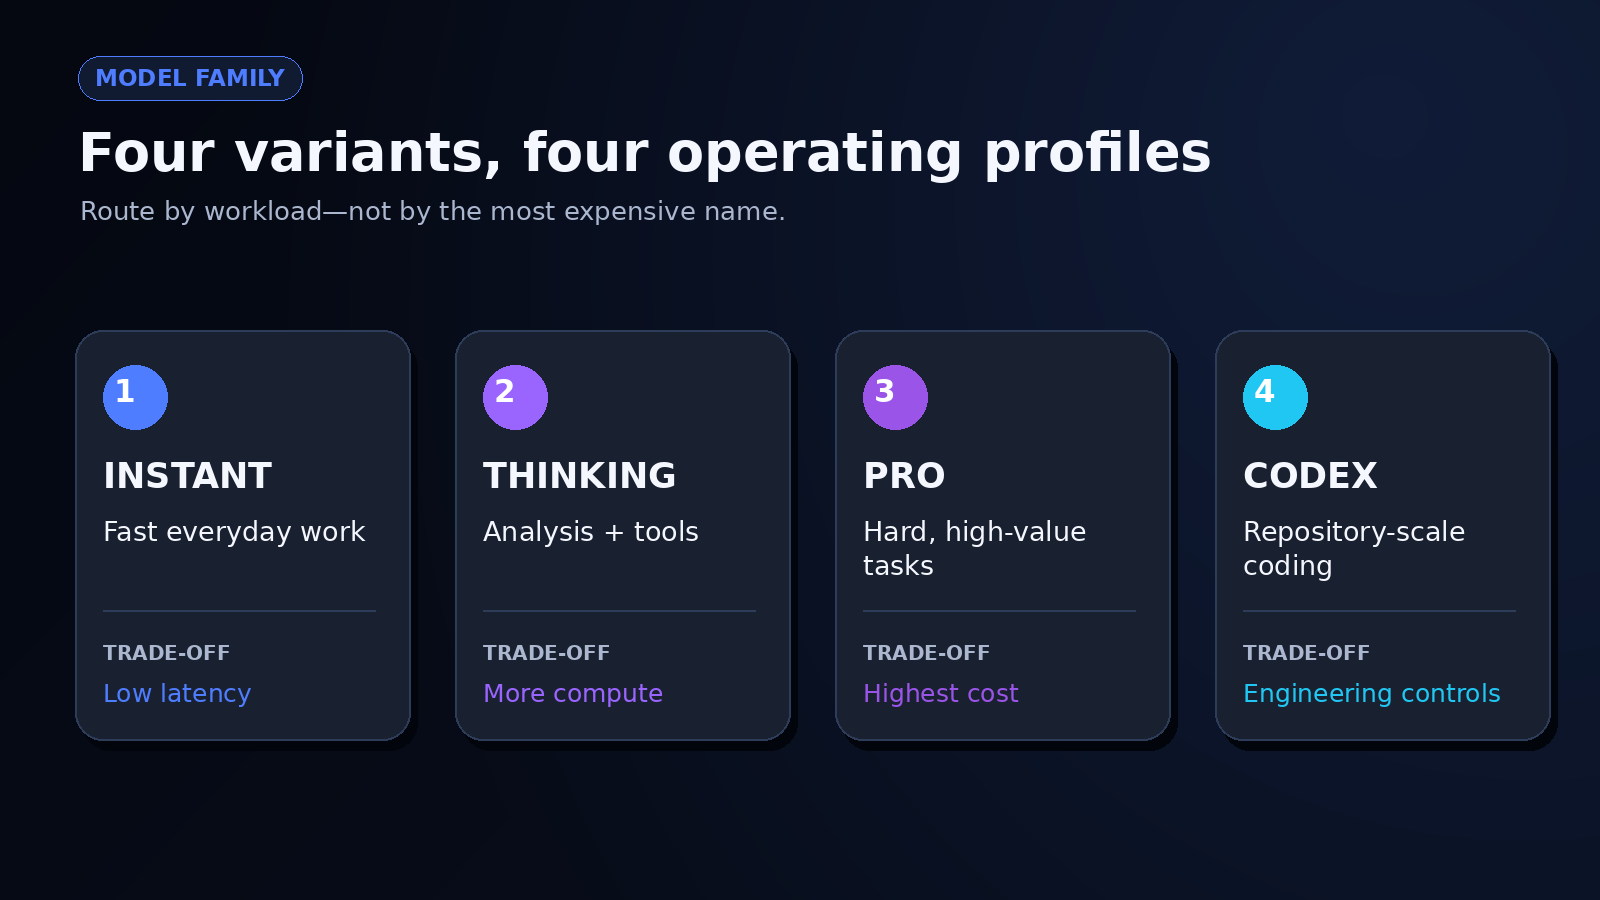
الشكل 2. Instant وThinking وPro وCodex موزّعة على أنواع أحمال العمل
| المواصفة | GPT-5.2 | GPT-5.2 Pro |
|---|---|---|
| الموضع الحالي | النموذج الرائد السابق | نموذج Pro السابق |
| نافذة السياق | 400,000 رمز | 400,000 رمز |
| الحد الأقصى للمخرجات | 128,000 رمز | 128,000 رمز |
| تاريخ انقطاع المعرفة | 31 أغسطس 2025 | 31 أغسطس 2025 |
| الوسائط | إدخال/إخراج نصي؛ إدخال صور | إدخال/إخراج نصي؛ إدخال صور |
| مستوى الاستدلال | بلا، منخفض، متوسط، مرتفع، مرتفع جدًا | متوسط، مرتفع، مرتفع جدًا |
| سعر واجهة البرمجة لكل مليون رمز | 1.75$ إدخال؛ 0.175$ مُخزّن مؤقتًا؛ 14$ إخراج | 21$ إدخال؛ 168$ إخراج |
| المخرجات المنظَّمة | مدعومة | غير مدعومة |
| الضبط الدقيق | غير مدعوم | غير مدعوم |
| اللقطة | gpt-5.2-2025-12-11 | gpt-5.2-pro-2025-12-11 |
الحالة الراهنة والسياق والوسائط
نافذة السياق البالغة 400,000 رمز وسقف المخرجات البالغ 128,000 رمز كبيرتان بشكل غير معتاد، لكن السعة ليست استرجاعًا. إذا وضعت العقود والسجلات ولقطات الشاشة والمتطلبات في طلب واحد، فستظل بحاجة إلى اختبار استرجاع: ضع حقائق في مواضع مختلفة، واطرح أسئلة تتطلب دمجها، وسجّل ما يفوت النموذج. لا أستنتج استدلالًا موثوقًا للوثائق الطويلة من رقم السياق وحده.
تقبل النماذج الصور وتُنتج نصًا؛ ولا تقبل الصوت أو الفيديو كمدخلات أصلية. هذا يجعلها مفيدة للرسوم البيانية ولقطات الواجهات والمخططات والوثائق الممسوحة، بشرط التحقق من التفاصيل المكانية والقيم المستخرجة. قد يحوّل تسمية غير واضحة أو مقياس رسم بياني غير مألوف تفسيرًا يبدو واثقًا إلى خطأ قابل للتصديق.
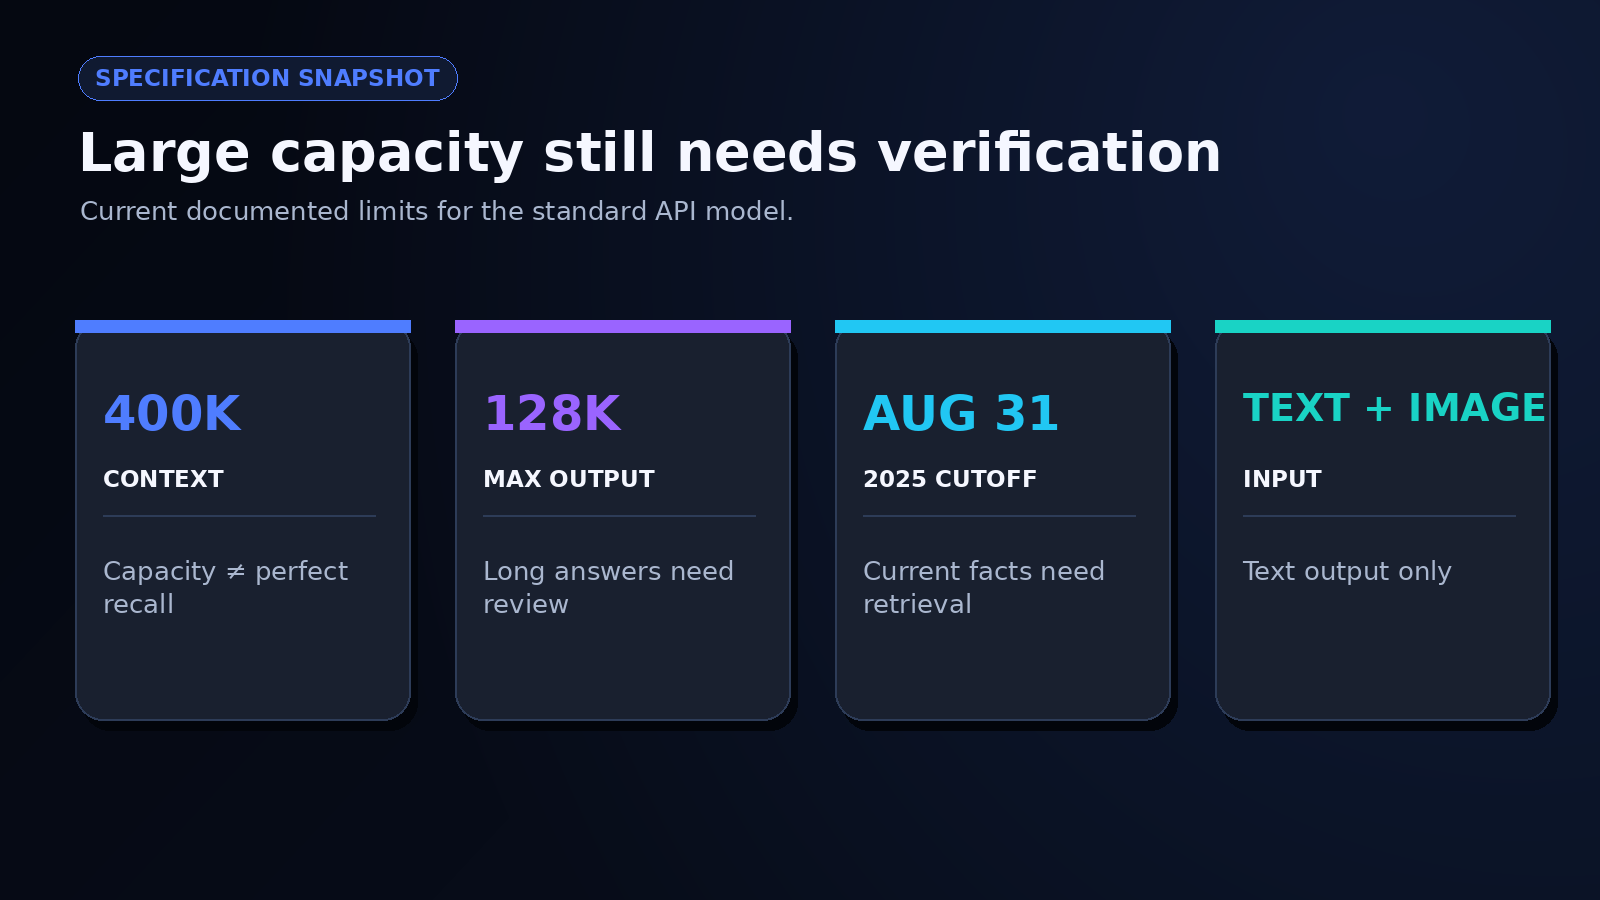
الشكل 3. السياق والمخرجات والوسائط وتاريخ الانقطاع واللقطات
تسعير واجهة البرمجة والوصول
يكلّف نموذج واجهة البرمجة القياسي 1.75 دولارًا لكل مليون رمز إدخال، و0.175 دولارًا لكل مليون رمز إدخال مُخزّن مؤقتًا، و14 دولارًا لكل مليون رمز إخراج. يكلّف GPT 5.2 Pro 21 دولارًا للإدخال و168 دولارًا للإخراج. ترفع رموز الاستدلال وإعادة المحاولات واستدعاءات الأدوات والتصحيح البشري تكلفة النتيجة المقبولة. عند استخدام منصة تكامل، تحقق من وحدات الفوترة الخاصة بها بشكل منفصل قبل مقارنتها بأسعار OpenAI بالدولار.
يمكنك رؤية توجيه المزوّدين الحالي وتوافره على صفحة GPT‑5.2 في OpenRouter. أفضّل حساب التكلفة لكل مهمة مكتملة، وليس لكل طلب. فاستجابة أرخص تفشل في التحقق مرتين قد تكلّف أكثر من استجابة أعلى سعرًا تنجح من المحاولة الأولى.
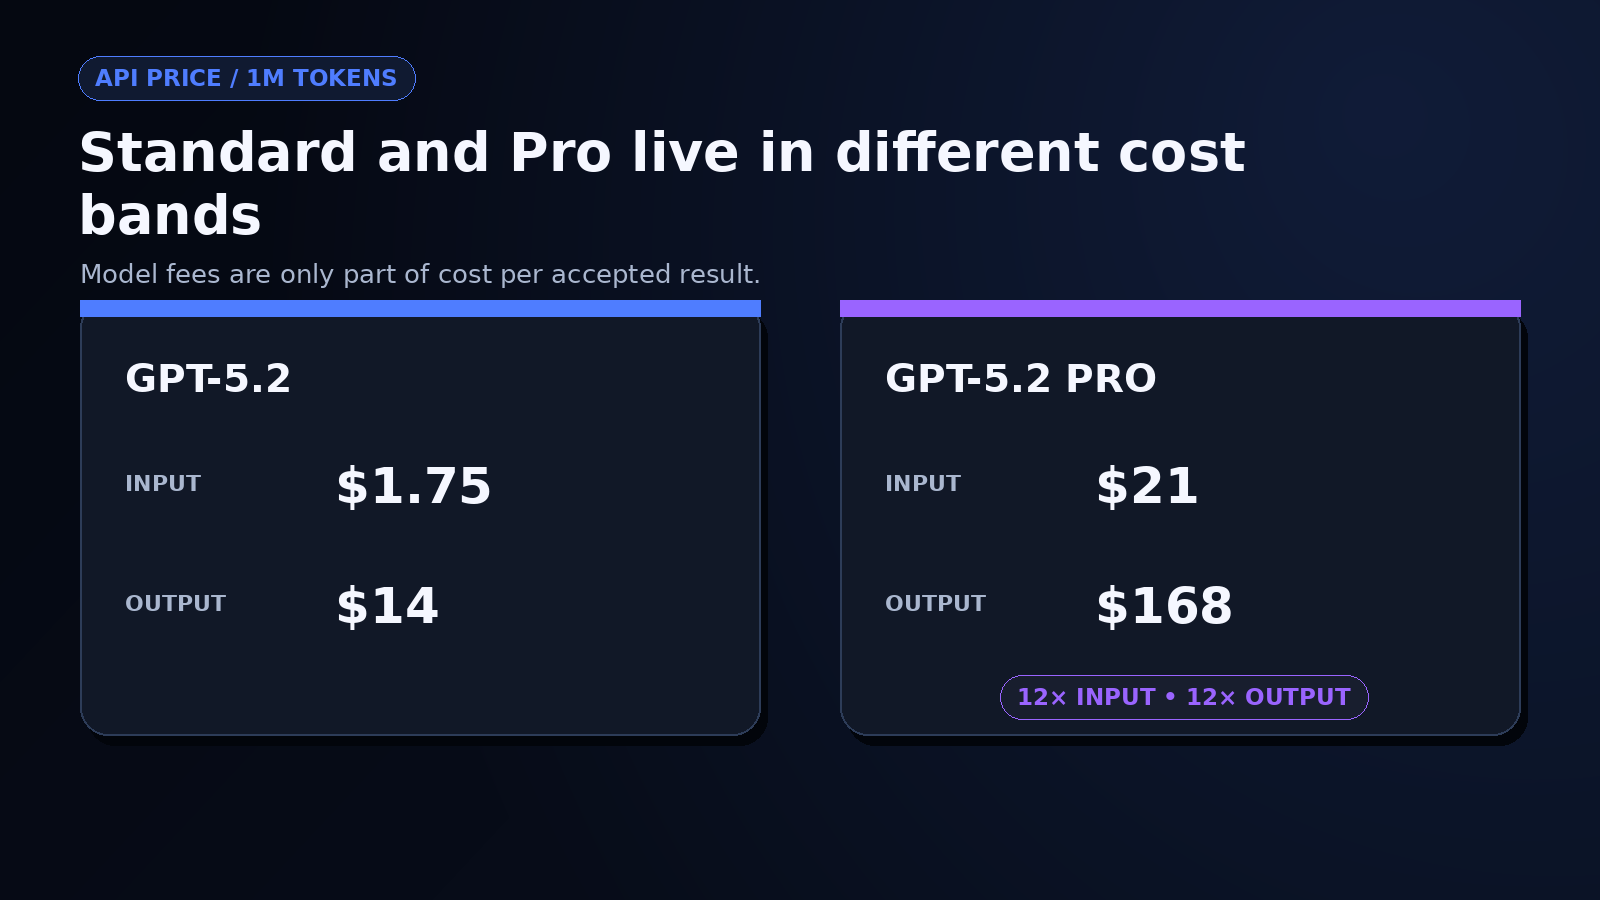
الشكل 4. التكلفة القياسية مقابل Pro لكل مليون رمز
ما الذي تغيّر في إصدار GPT-5.2 من OpenAI؟
استهدف إصدار GPT-5.2 من OpenAI العمل الذي يستمر إلى ما بعد إجابة واحدة: بناء المخرجات الملموسة، فحص الوثائق الطويلة، استخدام الأدوات، كتابة ومراجعة الشيفرة، الاستدلال عبر الصور، وإنجاز مهام مهنية متعددة الخطوات. كما فصل بوضوح أكبر بين المحادثة السريعة والاستدلال العميق والعمل كثيف الحوسبة، مما كان يعكسه وسم نموذج واحد.
Instant وThinking وPro تستهدف أحمال عمل مختلفة
كان Instant يُعطي الأولوية للأسئلة اليومية والشرح والترجمة والمسودات السريعة. كان Thinking يستهدف التحليل والبرمجة والملفات والتخطيط واستخدام الأدوات. أما Pro فكان يصرف حوسبة أكبر على المشكلات الصعبة التي يمكن تبرير انتظار أطول وفاتورة واجهة برمجة أعلى بكثير من أجلها.
| النمط أو النموذج | الملاءمة العملية | المقايضة الأساسية |
|---|---|---|
| Instant | الأسئلة الروتينية والعمل الحساس لزمن الاستجابة | تفكير أقل في المهام الصعبة متعددة الخطوات |
| Thinking | التحليل والبرمجة والملفات الطويلة وسير العمل المعتمد على الأدوات | زمن استجابة واستخدام رموز أكبر |
| Pro | المهام الصعبة التي تكون فيها الجودة التدريجية ذات قيمة عالية | تكلفة مرتفعة جدًا؛ قد تستغرق الاستجابات دقائق |
أفضّل التوجيه بناءً على الخطورة لا على المكانة. قد تحتاج خطوة تصنيف إلى نموذج سريع بمخطط صارم. وقد تبرر مراجعة نموذج مالي استدلالًا أعمق. إذا أرسلت كل طلب إلى Pro، فإنك تحجب رؤية أي المهام تستفيد فعليًا من الحوسبة الإضافية وتُصعّب التحكم في التكاليف كثيرًا.
كان العمل المهني واستخدام الأدوات محوريين في الإطلاق
أكّدت OpenAI على جداول البيانات والعروض التقديمية وعمل الواجهة الأمامية ومراجعة الشيفرة وتحليل الوثائق والعلوم والرياضيات واستدعاءات الأدوات. في تقييم أجراه المزوّد على استعلامات ChatGPT منزوعة الهوية، أُفيد بأن أخطاء مستوى الاستجابة أقل نسبيًا بنسبة 30% مقارنة بـ GPT‑5.1 Thinking. يشير تقرير الإطلاق أيضًا إلى أن النماذج نفسها قامت بتقييم الأخطاء، لذا أقرأ هذا الرقم كدليل اتجاهي لا كضمانة مستقلة.
التحسّن العملي لا يعني "النموذج يعرف كل شيء". إنه زيادة في احتمال أن تنجو مهمة محددة جيدًا من عدة خطوات دون أن تفقد بنيتها. ما زلت تحتاج إلى نقاط تحقق قابلة للرصد: أي أداة عملت، وما البيانات التي استلمتها، وما الذي غيّرته، وكيف تعافى سير العمل بعد استدعاء فاشل.
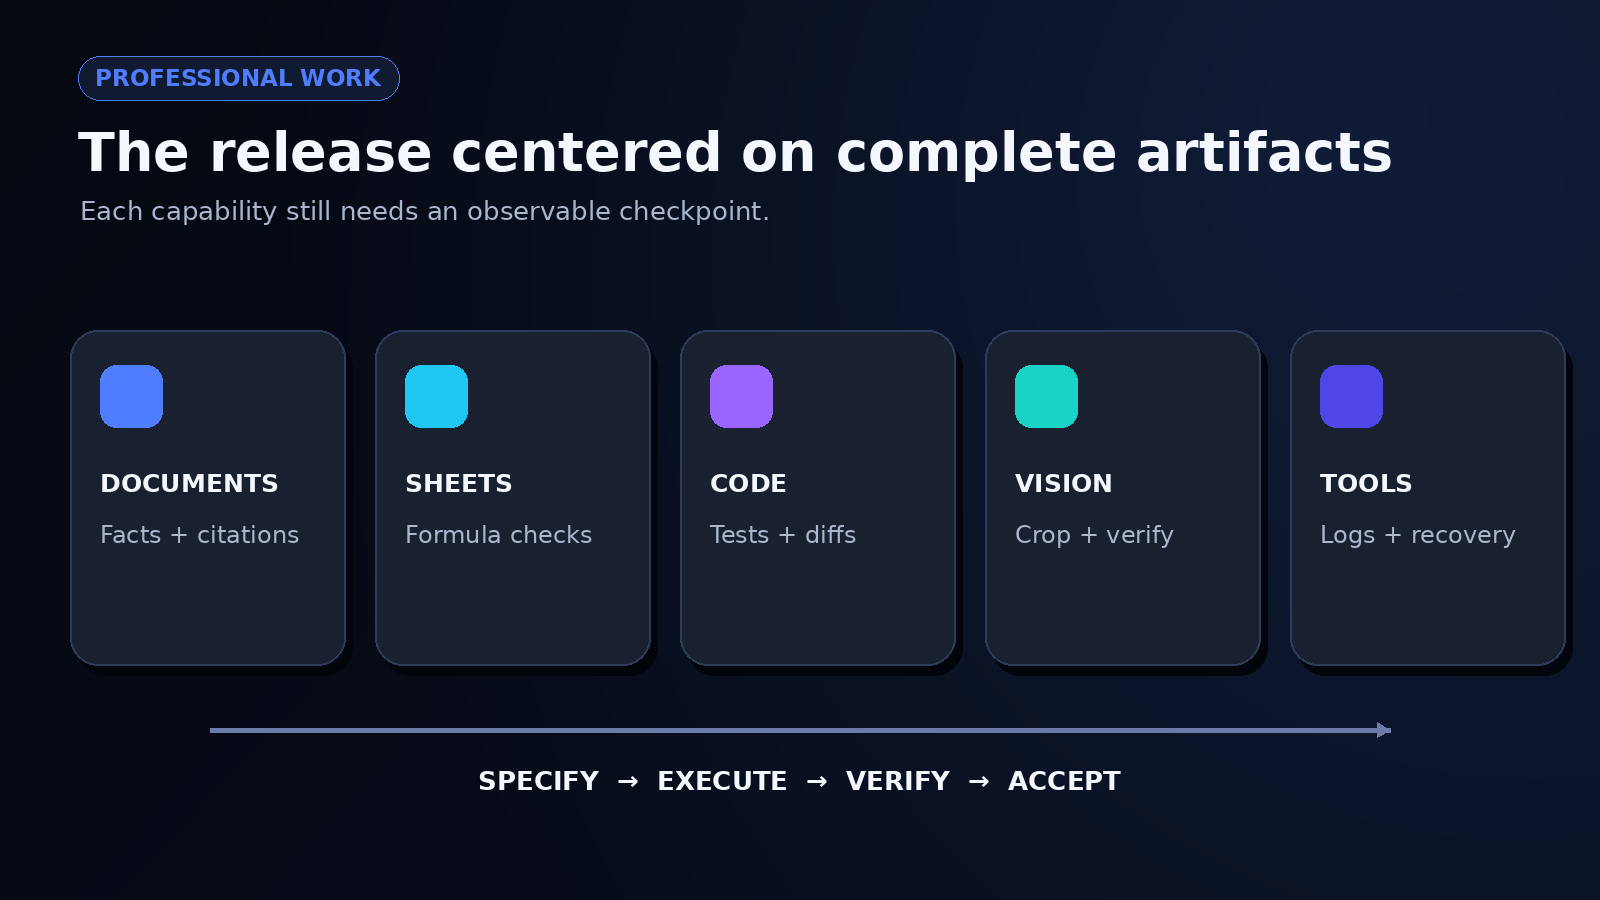
الشكل 5. لوحات جداول البيانات والشيفرة والوثائق والصور واستدعاءات الأدوات
أظهرت معايير الأداء عند الإطلاق نقاط قوة واسعة لكن غير متجانسة
| معيار الأداء | GPT-5.2 Thinking | ما يقيسه |
|---|---|---|
| انتصارات أو تعادلات GDPval | 70.9% | مهام مهنية محددة جيدًا عبر 44 مهنة |
| SWE-Bench Pro العام | 55.6% | مهام هندسة برمجيات متعددة اللغات |
| SWE-bench Verified | 80.0% | مهام مستودعات Python موثّقة |
| GPQA Diamond | 92.4% | أسئلة علمية بمستوى الدراسات العليا دون أدوات |
| AIME 2025 | 100.0% | رياضيات تنافسية دون أدوات |
| ARC-AGI-2 Verified | 52.9% | مهام استدلال مجرّد جديدة |
التباين هو الجزء المفيد هنا. فهو يُظهر نتائج قوية دون أن يعني تفوقًا موحّدًا. فحصول النموذج على 80% في مسائل Python موثّقة لا يتنبأ بمعدل نجاحك في مستودع TypeScript أحادي يحتوي قواعد نشر مخصصة. وبالمثل، لا يُثبت معيار علمي حكمًا قانونيًا أو طبيًا موثوقًا.
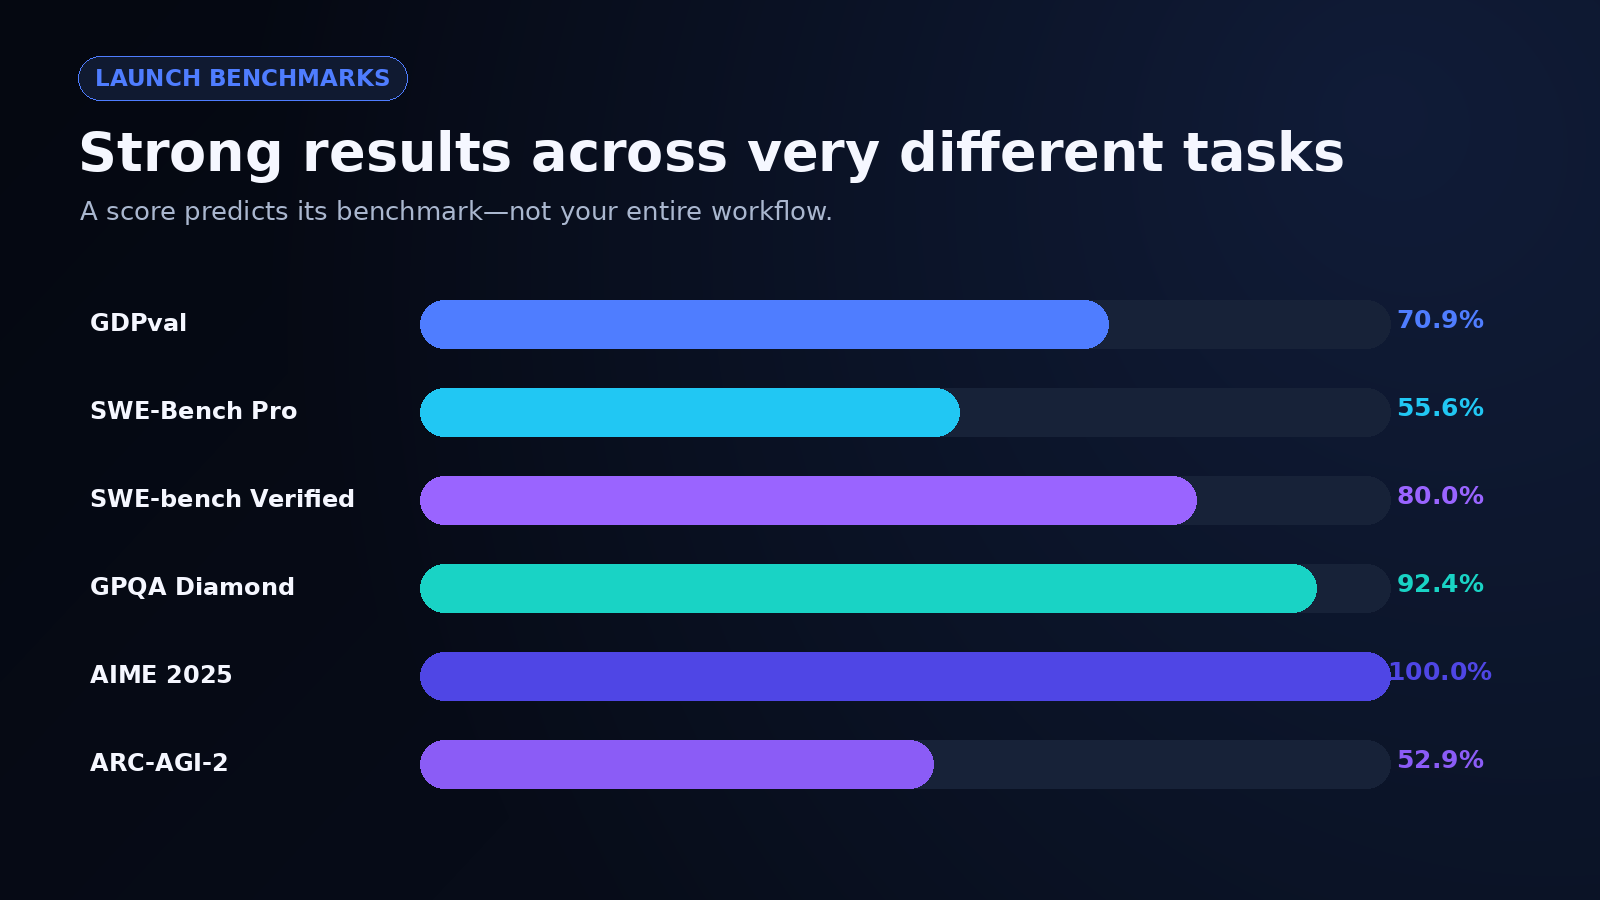
الشكل 6. ستة نتائج إطلاق مع فئات المهام
اقرأ معايير أداء GPT-5.2 جنبًا إلى جنب مع حدوده
تضغط النتائج العامة خيارات كثيرة في رقم واحد: صيغة التوجيه، الأدوات، مستوى الاستدلال، اختيار الاختبارات، سلوك المُقيّم، وسياسة إعادة المحاولة. يضيف سير عمل الإنتاج لديك جودة البيانات والأذونات وحدود زمن الاستجابة والمراجعة البشرية. أجد معايير الأداء أكثر فائدة في اختيار ما ينبغي اختباره، لا في تجاوز الاختبار.
ما أظهرته مراجعة تطبيقي فعليًا
أظهرت أداة مراجعة ملخصات المشاريع التعليمات المُقدَّمة تحت "ملخص المشروع" و"المتطلبات الأساسية" بينما كانت الاستجابة لا تزال في طور التدفق. طلب الإدخال فحوصات تنفيذ، لكن النتيجة الظاهرة نظّمت ذلك الطلب كملخص. لم تُفِد بفحص شيفرة مكتمل أو نتائج اختبار.
لم تحتوِ نافذة الجلسة المنفصلة على طلبات أو استخدام مُسجَّل، تاركةً زمن الاستجابة والتوجيه والتكلفة غير مُحققة. أكمل طلبًا بملخص مقيّد لإنهاء هذا الفحص.
نتائج معايير الأداء ليست ضمانات للإنتاج
ابدأ بـ 20 إلى 50 مهمة تمثيلية وحدد معايير القبول قبل تشغيلها. بالنسبة للشيفرة، قد يشمل ذلك معدل نجاح الاختبارات وحجم الفرق الناتج (diff) والنتائج الأمنية وأمان التراجع. بالنسبة لأعمال الوثائق، قد يشمل الدقة الواقعية وتغطية الاستشهادات وأخطاء الحساب ووقت التحرير. شغّل المجموعة نفسها أكثر من مرة لأن التباين مهم.
ثم قِس التكلفة لكل نتيجة مقبولة. افترض أن نموذجًا يكلّف 0.18$ لكل تشغيل وينجح في 60% من الحالات، بينما يكلّف نموذج آخر 0.28$ وينجح في 90%. قبل التصحيح البشري، تكون التكلفة المتوقعة لكل نتيجة مقبولة 0.30$ وحوالي 0.31$ على التوالي. بعد تسعير وقت المراجعة، قد يصبح الثاني أرخص بوضوح — أو لا. هذه الحسابات تُعيد القرار إلى سير عملك.
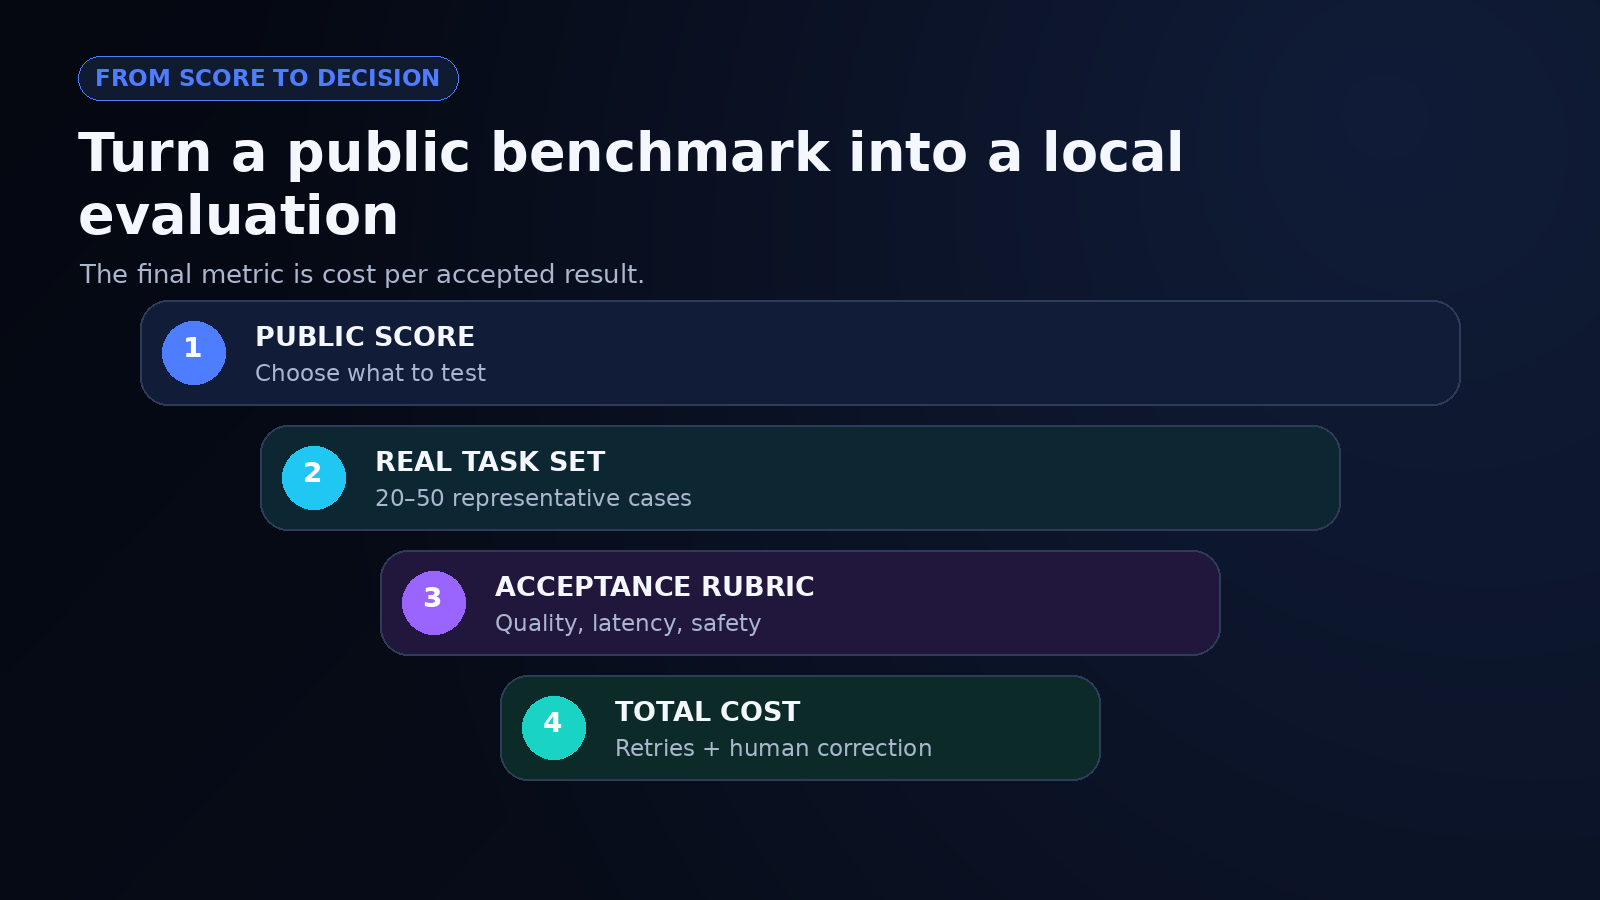
الشكل 7. من نتيجة معيار الأداء إلى المهام التمثيلية إلى تكلفة النتيجة المقبولة
السياق الطويل وإدخال الصور لا يزالان يتطلبان التحقق
يمكن لنافذة سياق طويلة أن تقلل التجزيء، لكنها تجعل أيضًا السهو أصعب ملاحظة. أنصح باختبار الاسترجاع من بداية ووسط ونهاية مجموعة الملفات؛ ومطالبة النموذج باقتباسات أو معرّفات سجلات للحقائق الحرجة؛ وإعادة إجراء الحسابات خارج النموذج. بالنسبة للصور، اقتطع المنطقة المعنية واطرح السؤال بشكل صريح بدلًا من انتظار أن يستنتج النموذج ما هو المهم.
يمكن للنقد المستقل أيضًا أن يكشف أنماط فشل لا يسلط عليها منشور الإطلاق الضوء. يصف نقد عملي مخرجات مخيبة للآمال في مهام الكاتب. هذا لا يُفنّد نتائج معايير الأداء؛ بل يُظهر لماذا يجب إعادة إنتاج توجيهك وحمل عملك وعتبة قبولك بشكل مباشر.
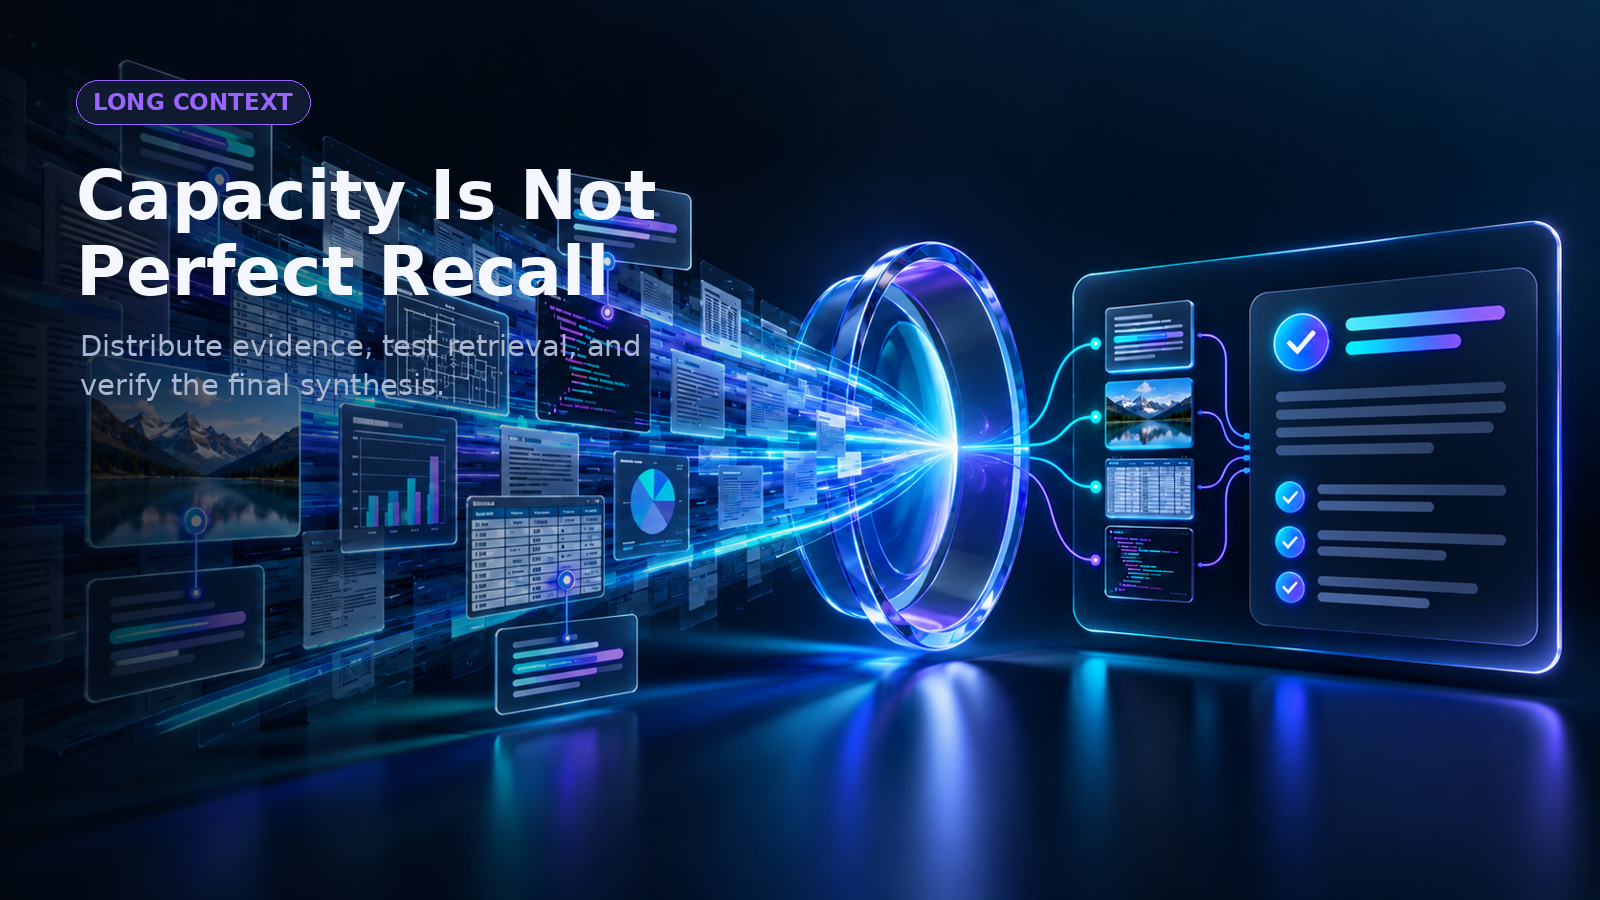
الشكل 8. أدلة موزّعة عبر تدفق وثيقة بحجم 400 ألف رمز
العمل عالي المخاطر يحتاج إلى ضمانات خاصة بالمجال
يعني تاريخ انقطاع المعرفة في 31 أغسطس 2025 أن الحقائق الحالية تتطلب استرجاعًا. قد تظل النماذج تخترع مصادر، أو تتجاهل متطلبات، أو تقرأ لقطات الشاشة بشكل خاطئ، أو تُنتج شيفرة غير آمنة. كما أنها لا تدعم الضبط الدقيق، لذا يجب على الفرق التي تحتاج إلى سلوك مخصص بعمق أن تعتمد على التوجيه أو الاسترجاع أو الأدوات أو التحقق أو نموذج آخر.
يجب عليك التمييز بين المساعدة والسلطة. يمكن للنموذج تلخيص عقد، أو الإشارة إلى معاملة مشبوهة، أو اقتراح تصحيح. أما القرار القانوني أو الطبي أو المالي أو الأمني أو المتعلق بالإنتاج فيجب أن يتخذه شخص مؤهَّل أو ضابط حتمي. سجّل الأدلة واحتفظ بمسار واضح لرفض المخرجات أو التراجع عنها.
ما هو GPT-5.2-Codex وكيف ينبغي للمطورين استخدامه؟
GPT 5.2 Codex هو العضو المتخصص في البرمجة من هذه العائلة، صُمِّم لأعمال هندسة البرمجيات الأطول بدلًا من الإكمال التلقائي المنعزل. التمييز المفيد هو عمق سير العمل: فهم مستودع، تخطيط تغيير، تحرير عدة ملفات، تشغيل أدوات، فحص الأعطال، وتنقيح التصحيح.
المهام البرمجية الأنسب
تشمل المرشحات الجيدة استكشاف المستودعات، تنفيذ الميزات، إصلاح الأخطاء، إعادة الهيكلة، إنشاء الاختبارات، مراجعة الشيفرة، والترحيلات ذات معايير قبول واضحة. أفضّل أن أعطي النموذج الهدف المتماسك الأصغر الذي لا يزال يشمل حدود التبعية الحقيقية. فتوجيه صغير بشكل مفرط ومصطنع قد يُنتج فرقًا محليًا نظيفًا يفشل في النظام المحيط.
يمكنك تقييم GPT 5.2 Codex بمجموعة مستودعات قابلة للتكرار: مشكلات معروفة، اختبارات مخفية، فحص أنماط الشيفرة، سياسة التبعيات، فحوصات أمنية، وحجم فرق أقصى مقبول. سجّل عدد استدعاءات الأدوات والتصحيحات وتدخلات المراجع. لا يُعتبر التصحيح ناجحًا فقط لأنه يُجمَّع بنجاح.
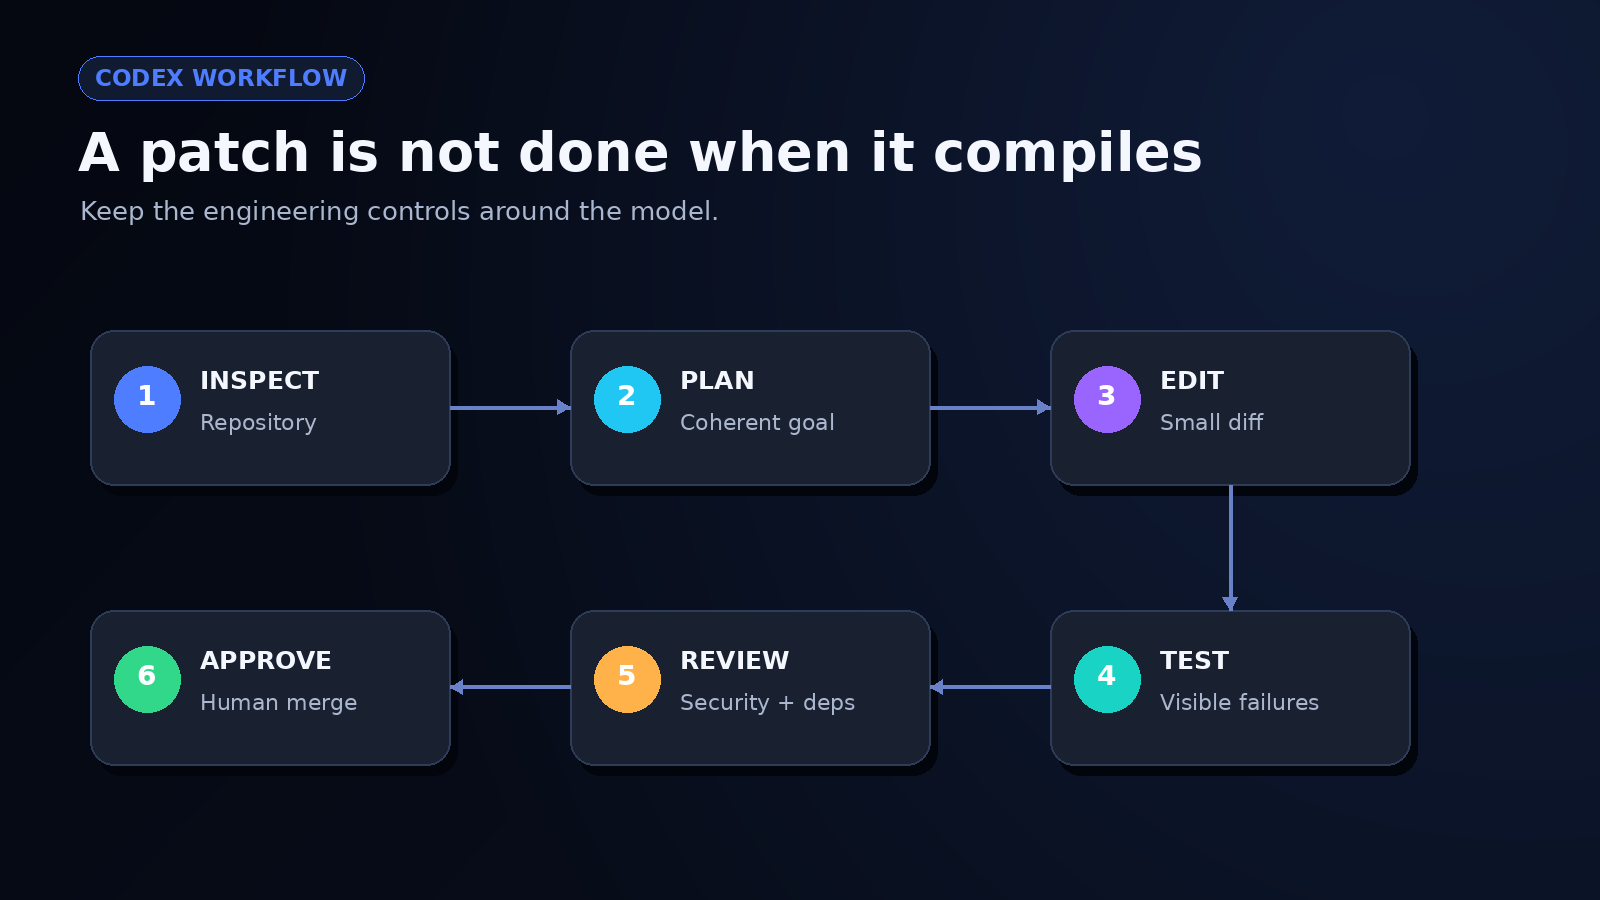
الشكل 9. الفحص، التخطيط، التحرير، الاختبار، المراجعة، والاعتماد
لا تزال حواجز حماية الإنتاج سارية
حافظ على صغر حجم التغييرات بما يكفي لمراجعتها، وثبّت لقطة النموذج عندما تكون قابلية التكرار مهمة، وقيّد الأدوات بأقل الصلاحيات اللازمة. شغّل اختبارات المستودع، وفحص التبعيات، وكشف الأسرار، والتحليل الساكن، ومراجعة الفرق البشرية. إذا كان الوكيل قادرًا على النشر أو حذف البيانات أو تدوير بيانات الاعتماد، ضع هذه الإجراءات خلف موافقة صريحة.
أفضّل أيضًا ميزانية فشل: حدّد عدد إعادات المحاولة أو الدقائق أو الرموز التي يمكن لمهمة استهلاكها قبل أن تعود إلى بشري. بدون هذا الحد، قد يبدو الوكيل منتجًا أثناء دورانه في إصلاحات متزايدة التخمين.
يعتمد GPT-5.2 مقابل Gemini 3 على المهمة الدقيقة
GPT-5.2 مقابل Gemini 3: يوضح أن نموذج الذكاء الاصطناعي الأفضل يعتمد على المهمة، مثل البرمجة أو الاستدلال أو الكتابة أو البحث.
الإجابة الصادقة على "GPT 5.2 مقابل Gemini 3" هي تصميم اختبار، وليست فائزًا شاملًا. يجب تسجيل النسخ الدقيقة والتواريخ والأدوات وأحجام السياق وإعدادات الاستدلال والتسعير. وإلا فقد تمنح المقارنة بصمت نموذجًا واحدًا بحث أو تنفيذ شيفرة أو ميزانية وقت أكبر.
| عامل القرار | السؤال المطلوب اختباره |
|---|---|
| جودة المخرجات | أي نموذج ينجح في معيار مهامك بشكل أكثر تكرارًا؟ |
| البرمجة | أيهما يُحقِّق معدل نجاح اختبارات أعلى بفروق أصغر وأكثر أمانًا؟ |
| السياق الطويل | أيهما يسترجع ويجمع الحقائق من ملفاتك بدقة أكبر؟ |
| استخدام الأدوات | أيهما يُنهي سير العمل بأعطال قابلة للتعافي وسجلات قابلة للاستخدام؟ |
| زمن الاستجابة | ما هو زمن الاستجابة المتوسط والمئين 95؟ |
| التكلفة | ما هي التكلفة الإجمالية لكل نتيجة مقبولة بعد إعادة المحاولة والتصحيح؟ |
| الحوكمة | أي ضوابط بيانات واحتفاظ ومنطقة ومراجعة تناسب حالة استخدامك؟ |
شغّل التقييم المباشر نفسه على كل من النموذجين
أعط النموذجين نفس التوجيهات، وملفات المصدر، والأدوات، وميزانية الوقت، ومعيار التقييم. اخلط ترتيب المهام بشكل عشوائي، وأخفِ اسم النموذج عن المراجعين حيثما أمكن. كرّر الحالات التمثيلية بدلًا من اختيار إجابة واحدة جميلة. تُفيد تفاعلات المجتمع في نقاش إطلاق GPT‑5.2 في كشف الشكاوى التي ينبغي اختبارها، لكنها ليست مقارنات مضبوطة.
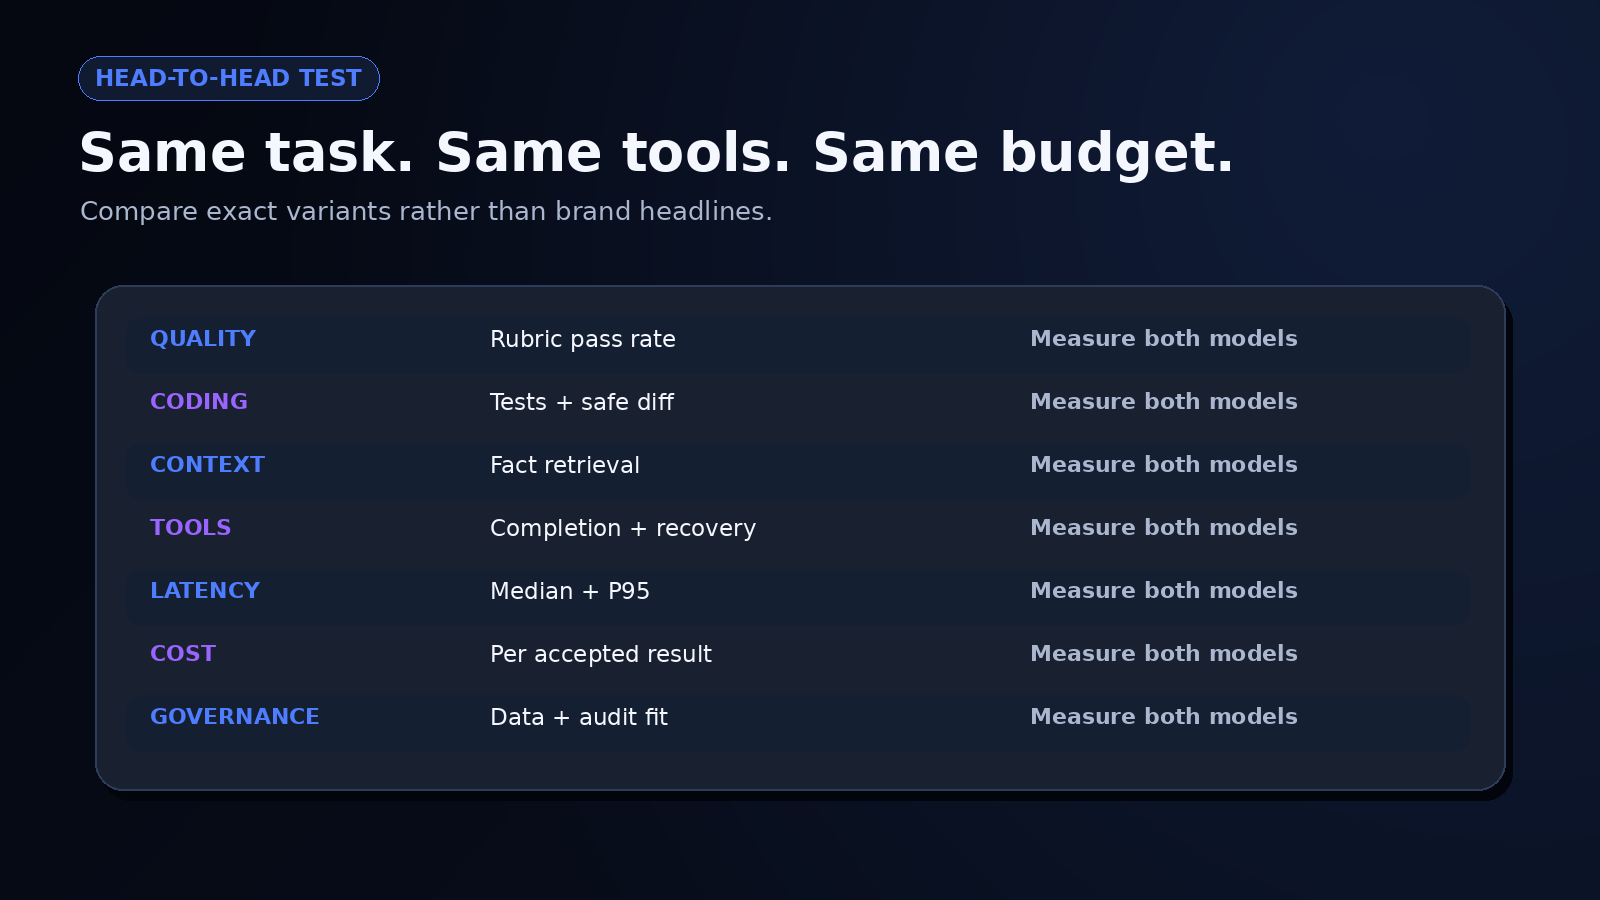
الشكل 10. الجودة والبرمجة والسياق والأدوات وزمن الاستجابة والتكلفة والحوكمة
اختر سير العمل الأقل خطورة، لا العنوان الأفضل
قد يختلف الفائز بحسب الخطوة. فقد يُخطّط نموذج جيدًا، ويُنتج آخر شيفرة أنظف، وقد تتعامل خيار أصغر مع التصنيف بجزء بسيط من التكلفة. يمكن للبنية الصحيحة توجيه العمل بدلًا من إلزام نموذج واحد بفعل كل شيء.
في تقييم GPT 5.2 مقابل Gemini 3، سأختار أبسط مزيج من النماذج يُحقّق عتبة الجودة ويبقى قابلًا للرصد عند فشله. يضيف كل مزوّد أو حل احتياطي إضافي منطق توجيه، وعمل تقييم، ومراجعة خصوصية، وتعقيدًا في الحوادث. تنوّع النماذج مفيد عندما يُقلّل خطرًا مقاسًا.
بناء تطبيق GPT‑5.2 Pro في Enter Pro
استخدمت أداة بناء التطبيقات بالذكاء الاصطناعي من Enter Pro لإنشاء أداة مراجعة ملخصات مشاريع بالذكاء الاصطناعي، باختيار GPT‑5.2 Pro كتكامل لها. كان الهدف تحويل فكرة تطبيق تقريبية إلى متطلبات، معلومات ناقصة، أولويات، ومعايير قبول.
اختر GPT‑5.2 Pro وتفقّد الأسعار
وجدت GPT‑5.2 Pro في كتالوج النماذج وفتحت تفاصيله. عرضت اللوحة زر دمج وأسعار** 2.1 رصيد لكل 1,000 رمز إدخال** و16.8 رصيد لكل 1,000 رمز إخراج. هذه هي أسعار المنصة المسجّلة.
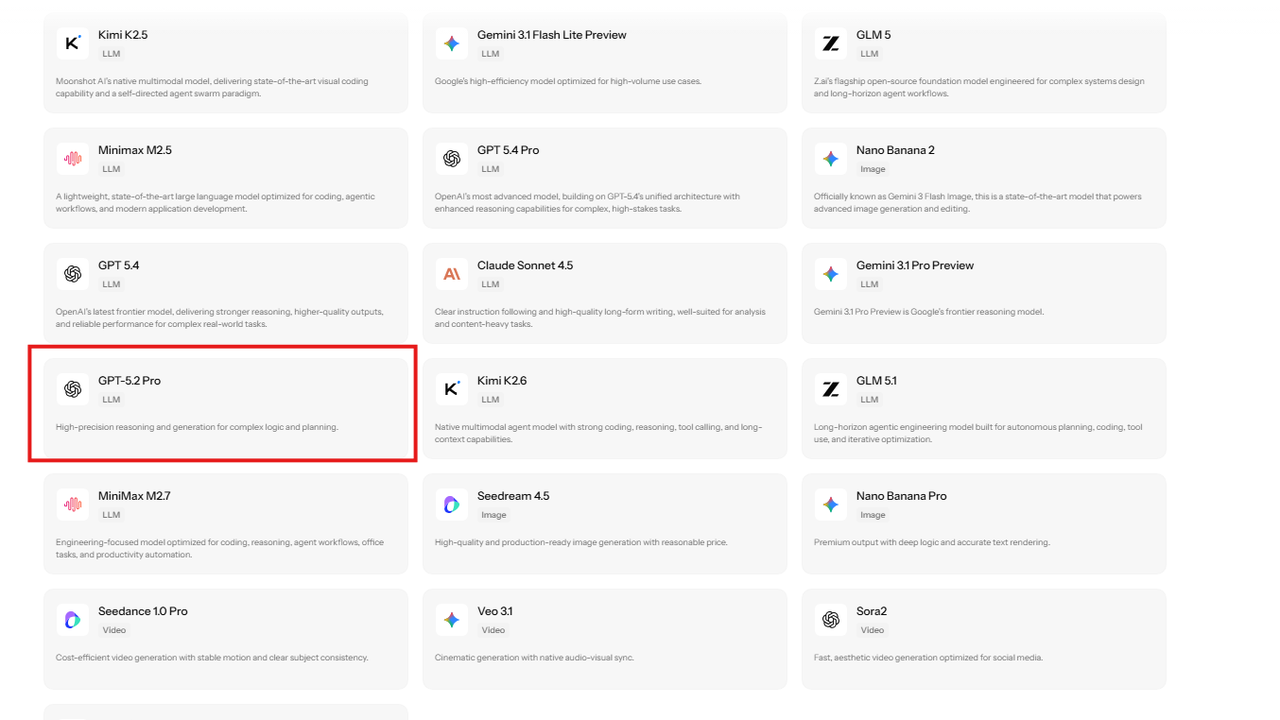
الشكل 11. يظهر GPT‑5.2 Pro في كتالوج النماذج بين تكاملات أخرى متاحة.
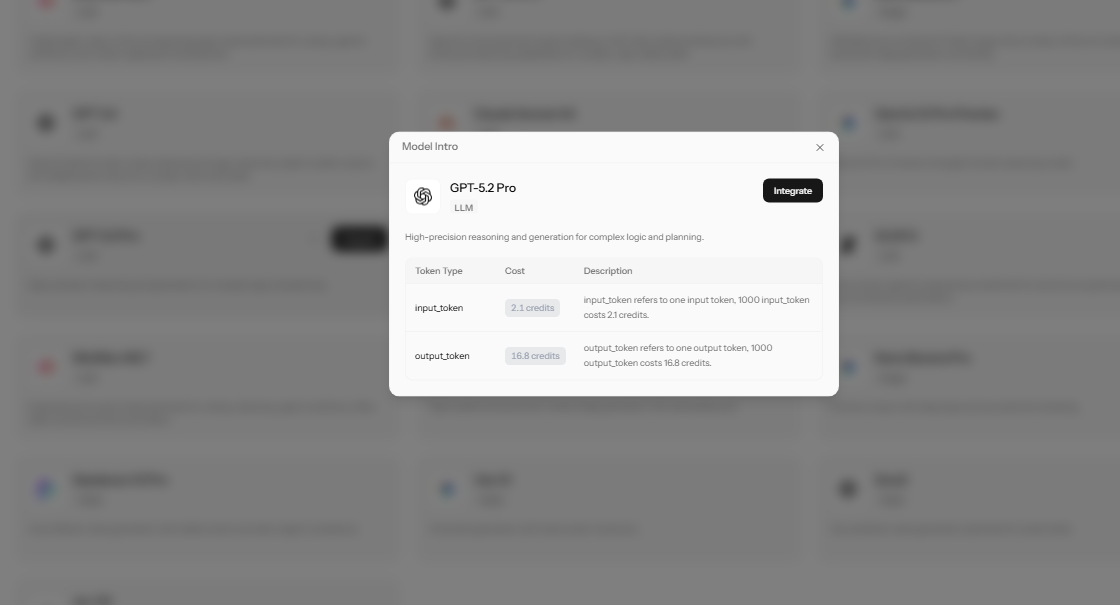
الشكل 12. تعرض لوحة تفاصيل GPT‑5.2 Pro عنصر التحكم "دمج" وأسعار الرصيد.
أرفق النموذج وصف التطبيق
كان طلب المشروع مرفقًا به شريحة GPT‑5.2 Pro. طلبت حقل ملخص كبيرًا، وزر مراجعة الملخص، واستجابات مُنظَّمة في خمسة أقسام: ملخص المشروع، المتطلبات الأساسية، التناقضات والمعلومات الناقصة، أولويات التنفيذ، ومعايير القبول. طلب أيضًا حالات تحميل وأخطاء حقيقية.
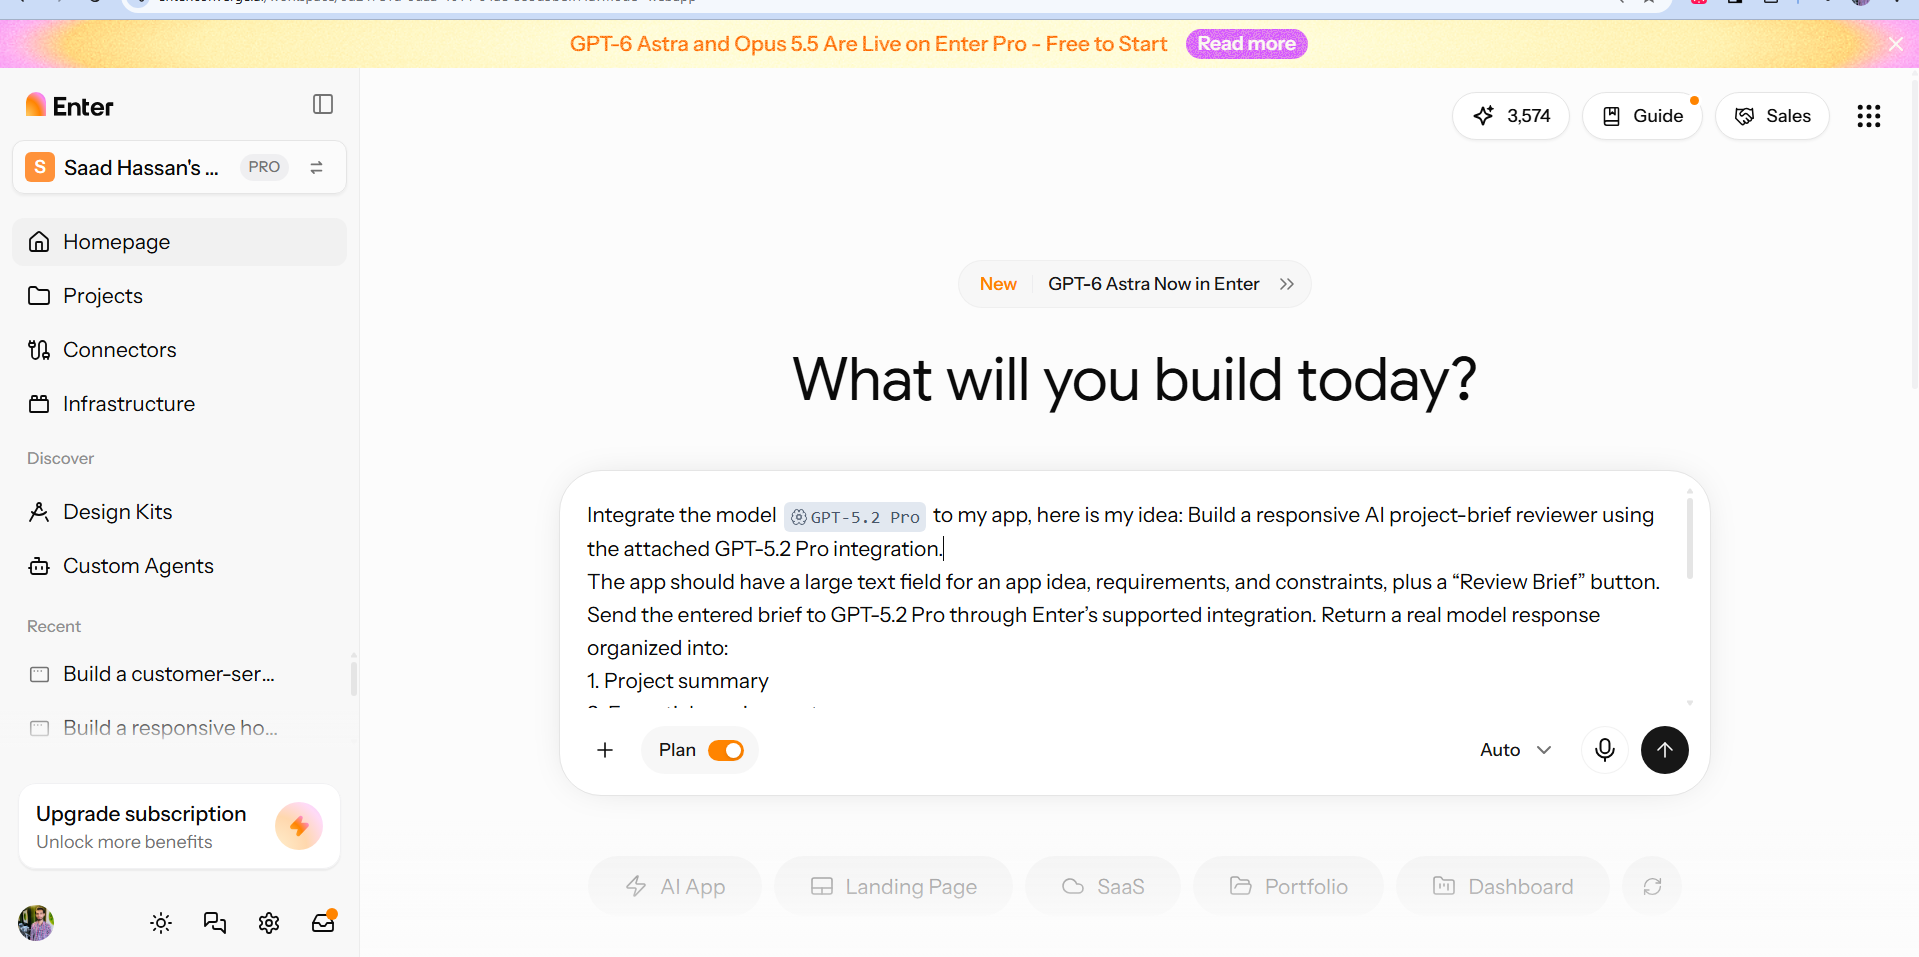
الشكل 13. يُرفق توجيه المشروع GPT‑5.2 Pro ويحدد الغرض من أداة المراجعة وبنية استجابتها.
فحص خطة البناء
أنشأ Enter خطة لواجهة Vite وReact وTailwind مع وظيفة خلفية تتعامل مع طلب الذكاء الاصطناعي. حدّدت نتائج متدفقة، ونصًا بلغة إنجليزية بسيطة، وعدم وجود سجل مراجعة محفوظ. كان الاحتفاظ ببيانات الاعتماد الخاصة في الواجهة الخلفية جزءًا من الخطة. تُسجّل هذه اللقطة التنفيذ المقترح.
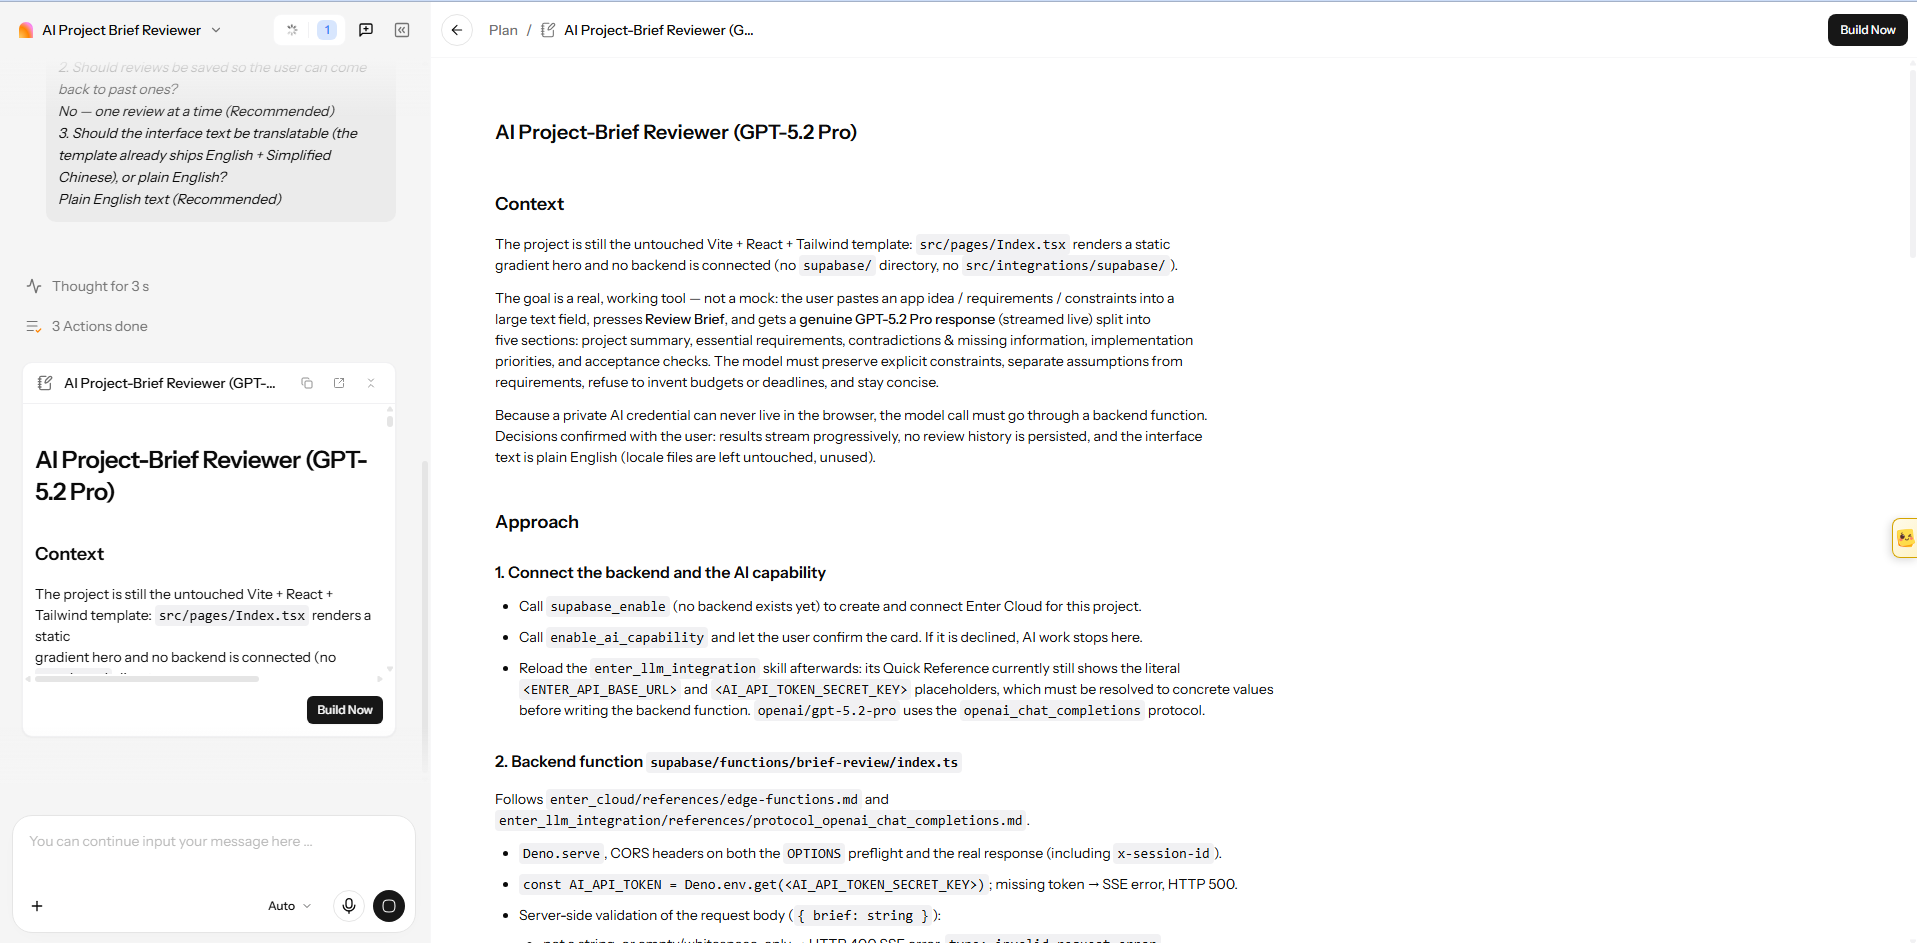
الشكل 14. تصف خطة البناء الواجهة والطلب الخلفي والمخرجات المتدفقة ومعالجة بيانات الاعتماد.
فحص المراجعة الظاهرة
عرضت أداة المراجعة حقل ملخص بجانب لوحات استجابتها. في المحاولة المُسجَّلة، أدخلت طلب فحص التنفيذ في ذلك الحقل. أعادت الاستجابة تنظيم متطلباتها تحت العناوين المطلوبة، بينما بقيت Streaming review وReviewing ظاهرتين. أظهر ذلك تنظيم الاستجابة، مع بقاء الاكتمال والصحة بحاجة إلى تحقق.
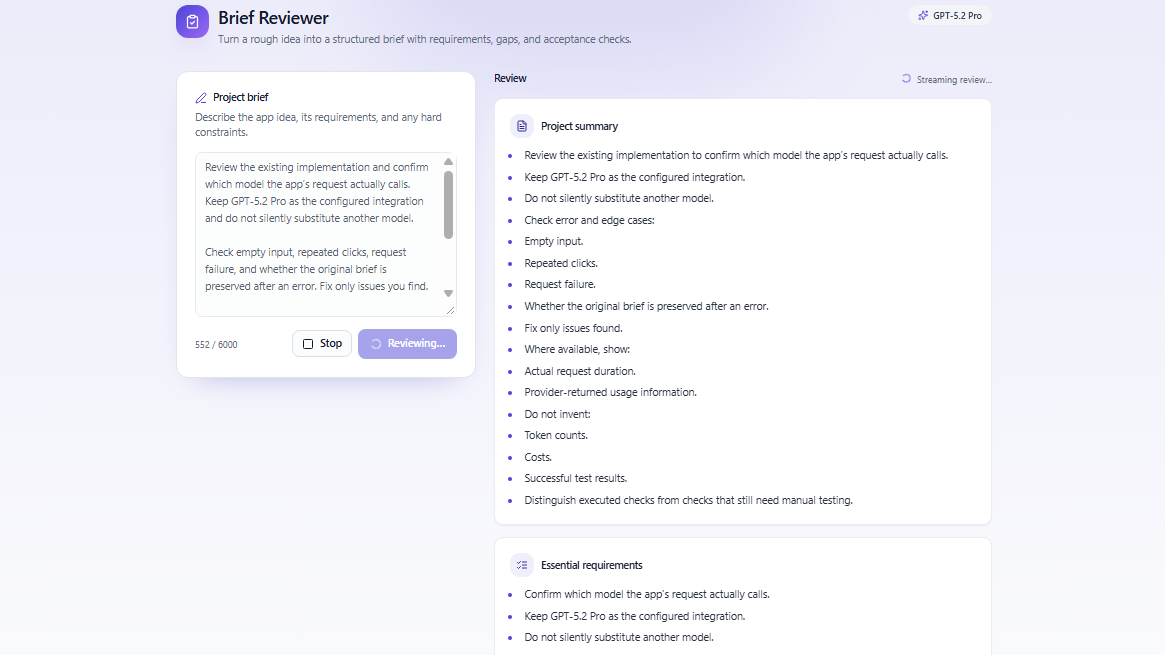
الشكل 15. يظهر نص المراجعة تحت العناوين المطلوبة بينما لا تزال الواجهة تشير إلى استجابة نشطة.
للتحقق من الاستدلال، استخدم ملخص موعد يضم ثلاثة فنيين، ومهام مدتها 45 دقيقة، وهامش انتقال 30 دقيقة، وساعات عمل من 9 صباحًا إلى 5 مساءً، ودون تداخل، وقاعدة إعادة جدولة مدتها 12 ساعة. ثم أضف "السماح بموعدين متزامنين لكل فني" وفحص ما إذا كانت الاستجابة المكتملة تُشير إلى التعارض. هذه النتيجة ليست موجودة في هذه اللقطات.
تحقق من سجل الطلبات واستخدام الرصيد
أظهرت نافذة الحالة الإضافية التكامل بوصفه GPT‑5.2 Pro، والمزوّد بوصفه Enter AI، والبروتوكول بوصفه Responses API. لم تحتوِ جلستها على أي طلبات، وصفر من رموز الإدخال والإخراج، وصفر من الاستخدام المستهلك. لا تستطيع هذه القيم إثبات مدة الاستجابة السابقة أو توجيهها الفعلي أو رسومها.
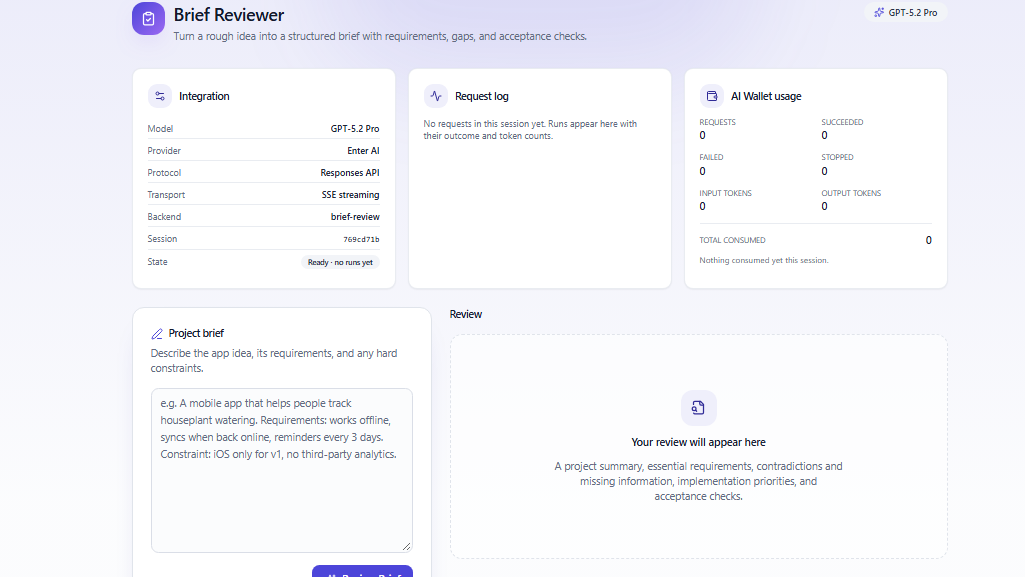
الشكل 16. تُظهر لوحات التكامل والاستخدام جلسة جاهزة دون طلبات أو استهلاك مُسجَّل.
عند الأسعار المعروضة، يُعادل 1,000 رمز إدخال توضيحي بالإضافة إلى 500 رمز إخراج مفوتر 10.5 رصيد. هذا تقدير، وليس إنفاقًا مرصودًا. لمقارنة التكاليف، استخدم الطلبات المكتملة والاستخدام المفوتر وإعادات المحاولة ونسبة المراجعات التي تستوفي معايير قبولك.
يحتفظ Enter بالنموذج المختار وملخص التطبيق في مشروع واحد. بناء تطبيق GPT‑5.2 Pro الخاص بك في Enter Pro والتحقق من التكامل قبل النشر.
الخلاصة النهائية: قيّم GPT‑5.2 من خلال مهمة عملية
تعتمد القيمة العملية لـ GPT‑5.2 على جودة المهمة والتكلفة المقبولة. يربط مشروع أداة المراجعة اختيار Pro بواجهة تطبيق ونص مراجعة منظَّم. ما زالت هناك حاجة إلى استجابة مكتملة، وقيود مُحقَّقة، وسجل طلب مكتمل للحكم على الموثوقية وفعالية التكلفة.
اختر النموذج الأقل تكلفة الذي يستوفي عتبة قبولك، وكرّر الحالات المهمة، واحتفظ بمسار استعادة للأخطاء. يمكنك استخدام Enter Pro لبناء وتحسين تطبيق GPT‑5.2 Pro، ثم التحقق من تكامله قبل توسيعه.
الأسئلة الشائعة حول شات GPT 5.2
متى صدر GPT-5.2؟
أعلنت OpenAI عنه في 11 ديسمبر 2025. بدأت نماذج واجهة البرمجة ونسخ ChatGPT بالانتشار عند الإطلاق، مع أن الوصول والبدائل الموصى بها تغيّرت منذ ذلك الحين.
هل لا يزال GPT-5.2 هو أحدث نموذج من OpenAI؟
لا. حتى 9 أكتوبر 2026، تُوثّقه OpenAI كنموذج من جيل سابق. على من يبحث عن شات GPT 5.2 أن يميّز بين الوصول عبر محدد ChatGPT والوصول عبر واجهة البرمجة أو تكامل طرف ثالث. تحقق من النسخة الدقيقة والتوافر الحالي قبل بدء مشروع.
ما هي نافذة سياق GPT-5.2؟
نافذة السياق الموثّقة هي 400,000 رمز، بحد أقصى للمخرجات يبلغ 128,000 رمز. ينبغي عليك مع ذلك اختبار الاسترجاع والاستدلال عبر وثائقك الطويلة الفعلية.
كم تكلّف واجهة برمجة GPT-5.2؟
سعر واجهة البرمجة القياسي هو 1.75$ لكل مليون رمز إدخال، و0.175$ لكل مليون رمز إدخال مُخزّن مؤقتًا، و14$ لكل مليون رمز إخراج. تضيف رسوم الأدوات والاستدلال وإعادة المحاولة والمراجعة إلى تكلفة المهمة.
كيف يمكنني بناء تطبيق GPT‑5.2 Pro باستخدام Enter Pro؟
اختر GPT‑5.2 Pro من كتالوج النماذج، وأرفق التكامل، واصف الميزة التي يحتاجها تطبيقك. بالنسبة لأداة مراجعة ملخصات المشاريع، حدّد المدخلات المطلوبة وتنسيق المراجعة. فحص التنفيذ الذي تم إنشاؤه، ثم تحقق من طلب مكتمل لتأكيد أن اتصال النموذج يعمل.
كيف يمكنني التحقق من استخدام GPT‑5.2 Pro في Enter Pro؟
تحقق من لوحات الطلبات والاستخدام الخاصة بالتكامل بعد تشغيل مهمة تمثيلية. تأكد من ظهور الطلب، ثم فحص رموز الإدخال، ورموز الإخراج، والرصيد المستهلك. اشمل إعادات المحاولة والاستجابات الأطول عند تقدير التكاليف، باستخدام الأسعار الحالية للمنصة.
ما هو GPT-5.2 Pro؟
GPT 5.2 Pro هو نموذج استدلال أعلى حوسبةً للمهام المهنية الصعبة. أسعار واجهة برمجته الرسمية هي 21$ لكل مليون رمز إدخال و168$ لكل مليون رمز إخراج، ويمكن أن تستغرق بعض الطلبات عدة دقائق.
هل يدعم GPT-5.2 الصور؟
نعم. يقبل إدخال الصور ويُنتج إخراجًا نصيًا. الصوت والفيديو غير مُدرجين كمدخلات أصلية مدعومة، لذا تتطلب هذه الصيغ خطوة معالجة منفصلة.
هل GPT-5.2 أفضل من Gemini 3؟
لا توجد إجابة شاملة. اختبر النسخ الدقيقة بنفس التوجيهات والملفات والأدوات والميزانية والمعيار، ثم قارن جودة النتائج المقبولة وزمن الاستجابة والتكلفة والحوكمة والتعافي من الفشل.
هل يمكن لـ GPT-5.2 إنتاج شيفرة جاهزة للإنتاج؟
يمكنه إنتاج شيفرة قوية، لكن الجاهزية للإنتاج تأتي من عملية الهندسة الكاملة: الاختبارات، مراجعة الفروقات، فحوصات التبعيات والأمان، الأدوات المقيّدة، البيئة التجريبية، المراقبة، والتراجع. لا يمكن للنموذج أن يحل محل هذه الضوابط.





