Aletheia : Votre historique d'achats était déjà la preuve
Aletheia automatise les réclamations de recours collectifs en utilisant votre historique d'achats. Détectez l'exposition aux produits chimiques, trouvez les recours admissibles et déposez facilement.
« La justice est la vérité en action. » — Benjamin Disraeli
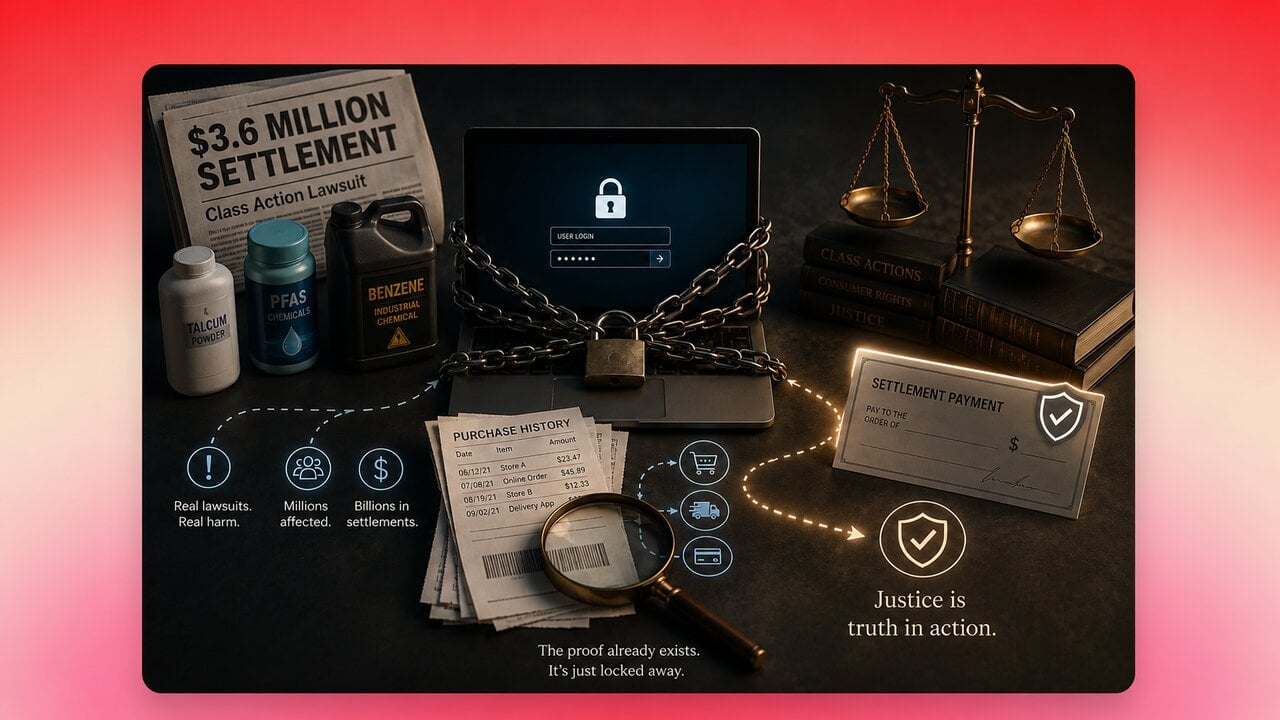
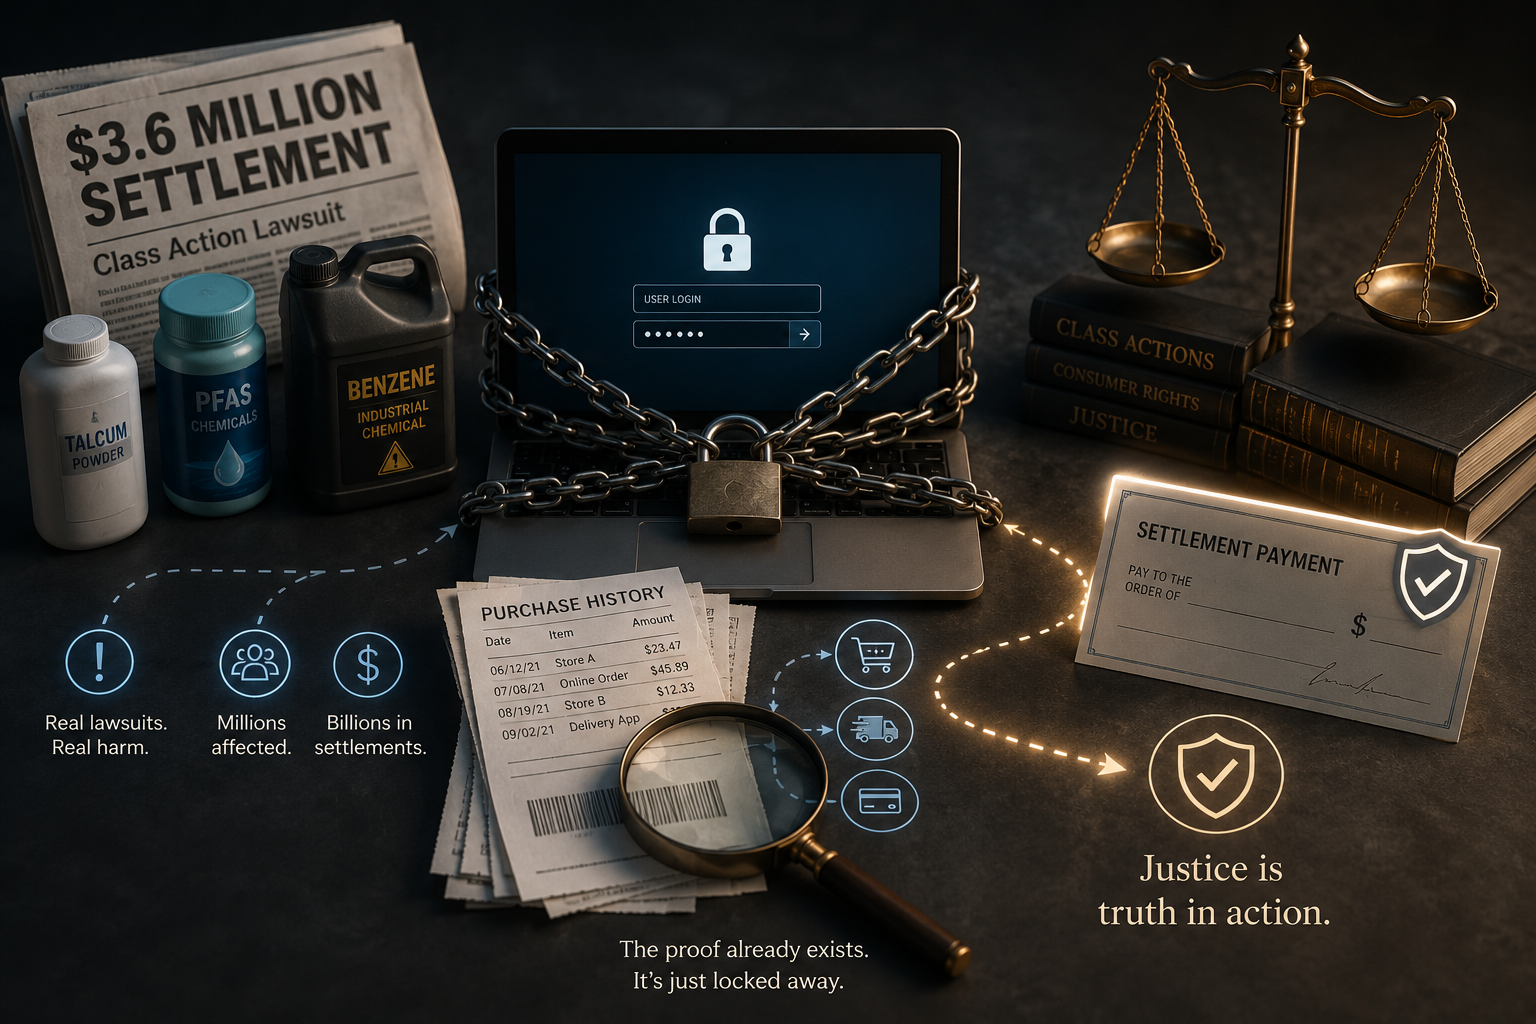
Chaque année, des milliards de dollars issus d'indemnités de recours collectifs ne sont pas réclamés. Non pas parce que les poursuites ne sont pas réelles. Non pas parce que les personnes concernées ne sont pas éligibles. Mais parce que déposer une réclamation nécessite de retrouver une date limite dont vous n'avez jamais entendu parler, de prouver un achat effectué il y a trois ans et de naviguer dans un formulaire de demande qui semble avoir été conçu pour être abandonné.
Le schéma est constant. Un gros titre apparaît — un règlement de 3,6 millions de dollars pour du benzène, une affaire de contamination au talc, une action collective sur les PFAS — et les gens le voient, reconnaissent qu'ils ont probablement utilisé le produit, et passent à autre chose. Non pas parce qu'ils ne se sentent pas concernés. Mais parce que l'effort requis pour passer de « Je pourrais être éligible » à « J'ai déposé ma demande et j'ai été payé » est trop important pour la plupart des gens.
Auparavant, nous avons partagé notre expérience lors de HackPrinceton 2026 x Enter.pro: Construire le Futur | Enter . Cet article portait sur l'énergie, la mission et la vision globale. Cet article est une plongée au cœur d'une équipe qui a construit avec Enter pendant la compétition et a remporté un prix : Aletheia.
Ce que l'équipe derrière Aletheia a remarqué, c'est que l'effort est presque entièrement artificiel. Les preuves existent déjà. L'historique des achats auprès des grands détaillants, des applications de livraison et des plateformes de paiement contient des enregistrements détaillés de ce que les gens ont acheté exactement, quand et auprès de qui. Les données qui prouvent l'éligibilité sont déjà là. Elles sont juste bloquées derrière une connexion.
Ce que fait Aletheia
Aletheia transforme l'historique des achats en un dossier de demande prêt à être déposé en trois étapes.
Lier les comptes. Les utilisateurs connectent leurs comptes de shopping et de livraison, et Aletheia extrait les données de transaction — chaque nom de produit, marchand, date et prix unitaire. Pas des catégories. Des produits réels.
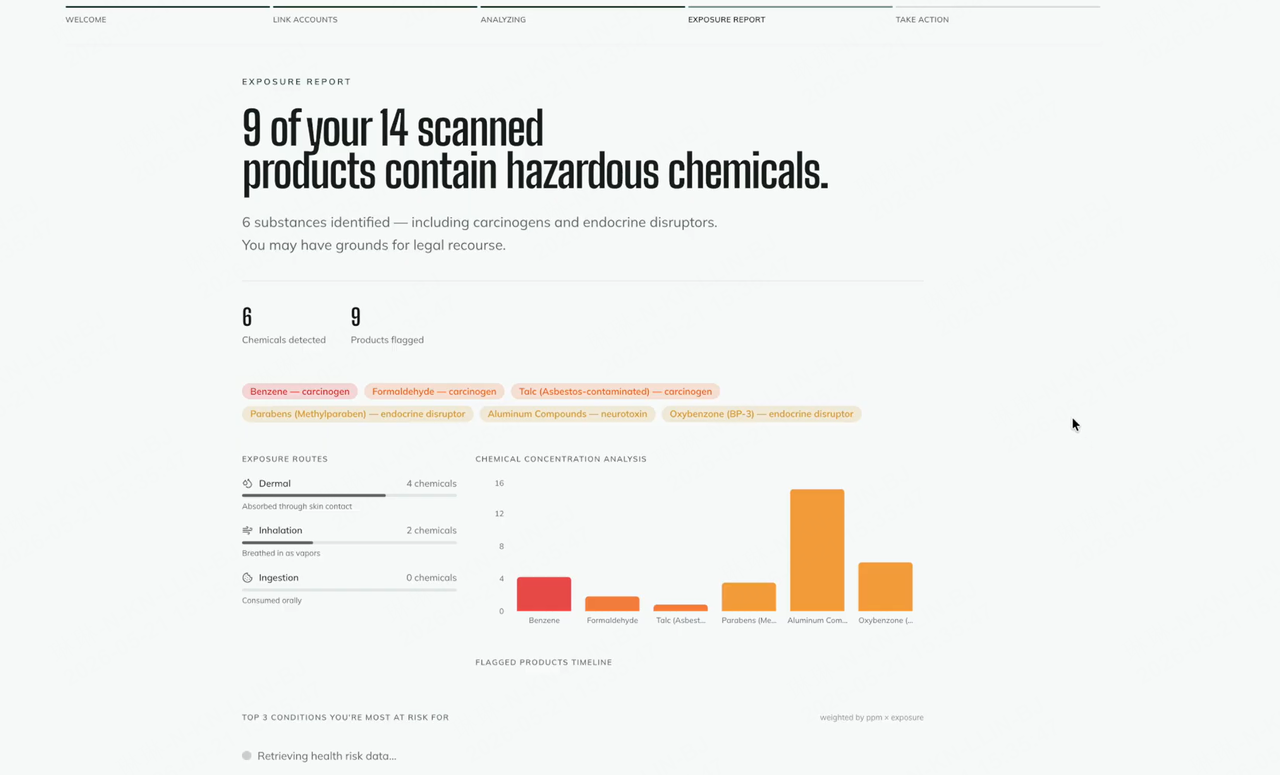
Scanner pour l'exposition. Une analyse basée sur l'IA croise chaque produit acheté avec un catalogue de produits chimiques liés à des litiges : benzène, talc, parabènes, PFAS, libérateurs de formaldéhyde, et autres. Les utilisateurs reçoivent un rapport d'exposition avec un score de 0 à 100, un classement par percentile et une ventilation par produit chimique et par produit signalé. Ce n'est pas un avertissement. C'est une image de ce à quoi vous avez réellement été exposé, sur la base de ce que vous avez réellement acheté.
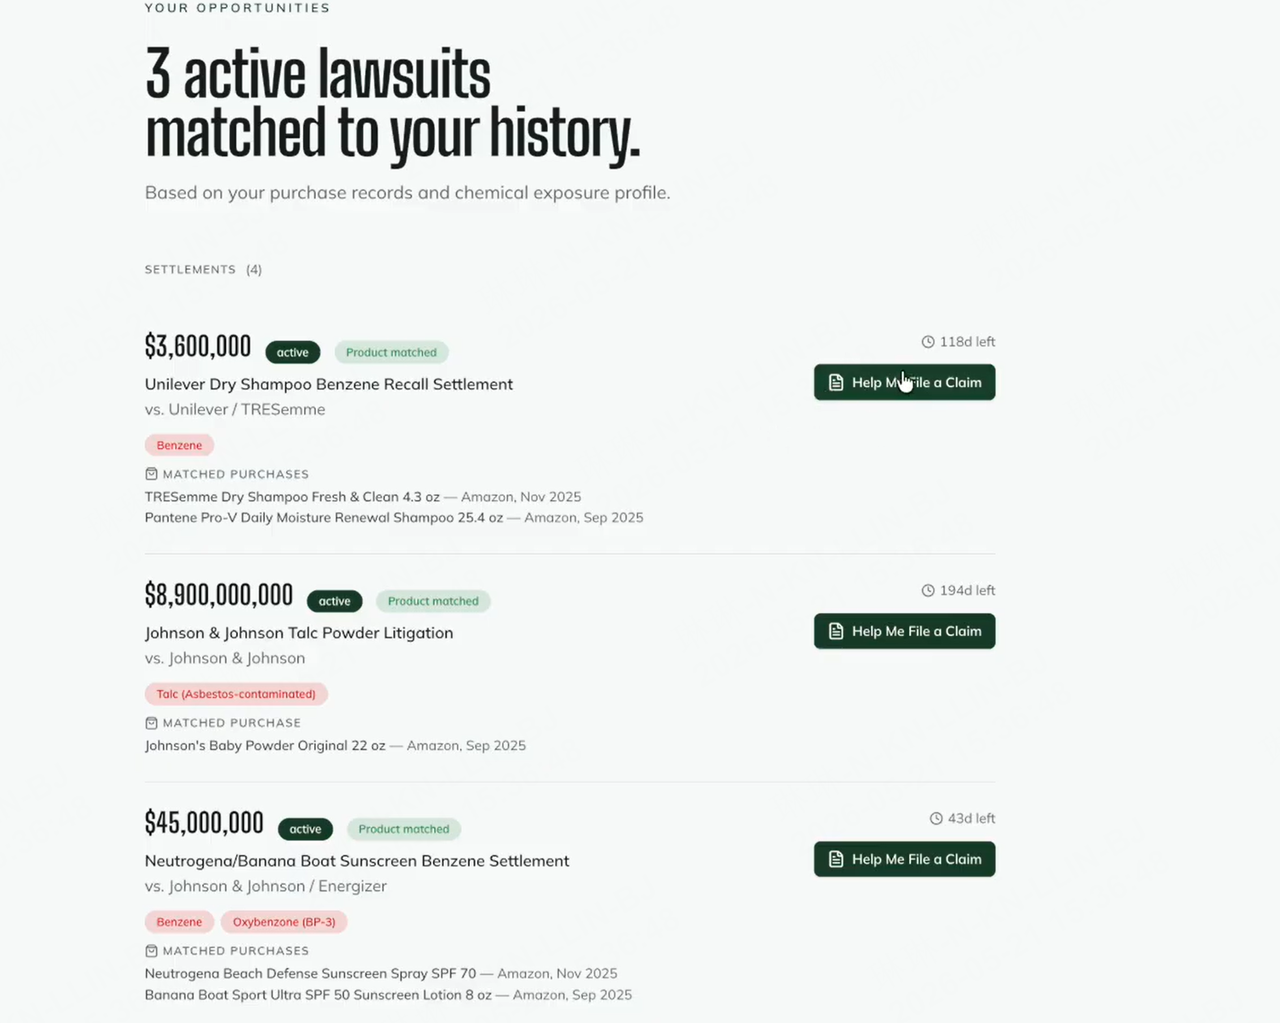
Faire correspondre aux règlements. Les produits chimiques et les produits détectés sont comparés à un catalogue en direct des règlements d'actions collectives en cours, mis à jour toutes les heures à partir de bases de données juridiques publiques. Chaque correspondance est classée : soit l'utilisateur a acheté le produit spécifique éligible, soit son exposition chevauche le produit chimique en question. Les règlements expirés sont filtrés. Les doublons sont fusionnés. Pour chaque correspondance, Aletheia génère un guide de dépôt en cinq étapes et un dossier de preuves PDF — construit à partir des relevés d'achat — prêt à être soumis.
Le décalage qu'Aletheia comble ne concerne pas la complexité juridique. Il s'agit d'information et de friction. Les administrateurs de réclamations acceptent déjà les relevés d'achat comme preuve. Les enregistrements existent déjà. Le fossé était l'absence d'un outil capable de les connecter automatiquement.
La construction — et le problème rencontré
L'équipe a construit Aletheia lors du HackPrinceton Spring 2026 ; leur flux de travail est passé de la recherche aux exigences du produit vers Enter — en utilisant les intégrations MCP et les Skills d'Enter pour connecter les sources de données externes et construire la couche d'intelligence — jusqu'à un produit entièrement déployé. Enter a géré l'infrastructure backend : la couche d'authentification, la base de données et les fonctions Edge qui alimentent l'analyse d'exposition, le scraping des règlements et la logique de correspondance.
Le problème le plus difficile n'était pas l'infrastructure technique. C'était la confiance.
La première version de la logique d'exposition et de correspondance permettait à l'IA de synthétiser à la fois le catalogue des règlements et les scores de correspondance. C'était rapide à construire et plausible dans le résultat — jusqu'à ce que ça ne le soit plus. Le modèle inventait des montants de règlement. Il générait des réclamations pour des poursuites qui n'existaient pas. Il produisait des verdicts d'éligibilité qui n'avaient aucun fondement dans une procédure judiciaire réelle.
Pour un produit de finance grand public, ce n'est pas un bug. C'est une défaillance rédhibitoire. Vous ne pouvez pas dire à quelqu'un qu'il a droit à une indemnité de 4 200 $ si ce chiffre provient d'un modèle qui comblait les lacunes plutôt que de lire des données vérifiées.
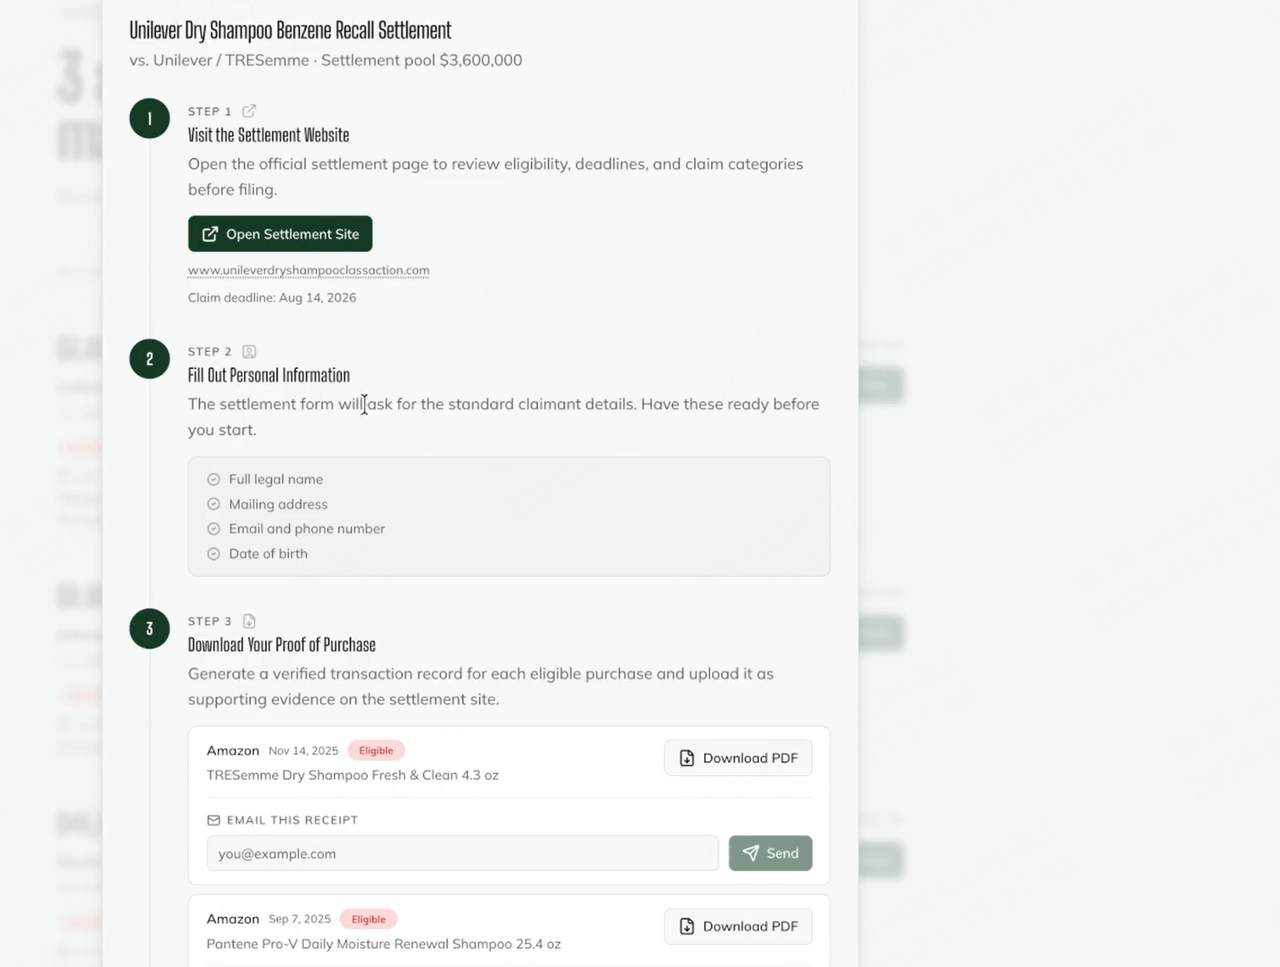
La correction a nécessité de séparer ce que l'IA fait bien de ce qu'on ne peut pas lui confier seule. Les données réelles des règlements sont désormais extraites directement des bases de données juridiques publiques, stockées de manière canonique et enrichies avec des paiements, des délais et des URL de réclamation vérifiés. Le rôle de l'IA lors de la correspondance est limité à ne citer que ce qui est déjà dans le catalogue — pas de synthèse, pas d'extrapolation. Le résultat est fondé parce que la base de données est fondée.
Trois couches de déduplication gèrent le fait que le même règlement apparaît fréquemment sous des URL et des titres légèrement différents selon les sources. La logique des délais distingue les règlements qui sont réellement clos de ceux dont les dates sont inanalysables ou en attente — les premiers étant filtrés agressivement, les seconds traités comme étant toujours ouverts. Le reçu PDF a été itéré jusqu'à ce qu'il ressemble à quelque chose qu'un administrateur de réclamations accepterait réellement : en-têtes de marchand, tableaux de postes, pieds de page de vérification.
Chaque chemin a une solution de secours. La démo n'atteint jamais un état bloqué.
Ce dont ils sont le plus fiers
Le pipeline complet, de bout en bout. Un utilisateur lie ses comptes, reçoit un rapport d'exposition, voit ses règlements correspondants et télécharge un PDF prêt à être déposé — tout cela à partir de données d'achat qu'il possédait déjà, traitées d'une manière à laquelle il n'a jamais eu à réfléchir.
Et le reçu. Faire en sorte qu'un document généré ressemble à une preuve juridique, et non à un résultat de hackathon, a nécessité des itérations. Le fait d'y être parvenu est le détail sur lequel l'équipe revient sans cesse.
Ce qui vient ensuite
Alertes basées sur des Webhooks : avertir les utilisateurs dès qu'un nouvel achat correspond à un règlement existant, sans nécessiter de nouvelle analyse manuelle. Formulaires de réclamation à remplissage automatique : pré-remplir les champs standards à partir des données d'achat et d'exposition, et soumettre pour le compte de l'utilisateur là où les administrateurs l'autorisent. Rétrospective historique via OCR sur les relevés bancaires, là où se trouve l'argent des règlements à long terme — réclamations sur des produits achetés des années avant que toute plateforme ne commence à suivre les SKU. Et intégration réelle des paiements : accepter les fonds de règlement directement, avec une petite commission de succès.
L'infrastructure pour tout cela est déjà en place. Le pipeline qui fonctionne pour les règlements actifs fonctionne pour n'importe quel règlement. La récupération des preuves qui fonctionne pour les comptes liés fonctionne pour les relevés téléchargés. La portée de ce qu'Aletheia peut faire s'étend avec chaque source de données qu'elle peut atteindre.
L'argent a toujours été là. C'était le chemin pour y accéder qui manquait.
L'équipe derrière ce projet : Haoran Xu | Anish Yenduri | Brian Li | Adarsh Danda
Vous avez manqué les volumes précédents ? → Vol. 1 — Heritage in Pixels → Vol. 2 — Terra Zone AI *→ Vol. 3: *reAgent *→ Vol. 4: *TaleTailor *→ Vol. 5: *LEGR *→ Vol. 6: *PolyPath *→ Vol. 7: *EcoThread