
Meilleur générateur de code IA pour applications et développement quotidien
Comparez les meilleurs générateurs de code IA selon votre tâche, votre budget et votre stack, avec un plan d'évaluation concret basé sur Enter Pro.
Le meilleur générateur de code IA est celui qui correspond au travail que vous devez terminer. GitHub Copilot convient aux suggestions dans votre éditeur habituel ; Cursor, Cline et Claude Code offrent des façons de travailler sur tout un dépôt. Pour une nouvelle application web, v0 et Replit Agent valent aussi le coup d'œil. La distinction utile est le type de résultat dont vous avez besoin : une fonction que vous pouvez coller dans un projet, un correctif que vous pouvez relire, ou une application avec ses propres exigences de données et de déploiement.
Une recherche de meilleur générateur de code IA 2026 regroupe des flux de travail très différents dans la même liste restreinte. Affinez ce choix en vérifiant la compatibilité avec votre stack, l'accès aux modèles, les limites du plan gratuit et l'effort nécessaire pour vérifier le résultat. Plus loin, le projet ScopeQuote capturé montre un estimateur dans Enter Pro et la confirmation d'une demande de 450 dollars. Il rend aussi concrète la distinction entre le comportement visible de l'interface et les exigences de stockage, de calcul et d'accès propriétaire encore non vérifiées.
Ce que les générateurs de code IA peuvent réellement créer
Fonctions, scripts et requêtes de base de données
Une demande ciblée fonctionne bien pour un parseur, une requête SQL, un utilitaire en ligne de commande ou une fixture de test, car vous pouvez définir précisément ses entrées et sorties attendues. Prenons un importateur de dépenses en Python : « lis ce CSV » laisse en suspens les formats de devise, les doublons, les valeurs manquantes et les lignes mal formées. Une spécification utile précise si 03/04/2026 signifie le 4 mars ou le 3 avril, et ce qui se passe si une ligne est invalide. Testez ces décisions avec des exemples fixes avant de traiter l'ensemble des données. Une fonction qui s'exécute sans exception peut malgré tout produire des totaux incorrects.
Modifications dans un dépôt existant
Les agents de dépôt peuvent lire les fichiers du projet, modifier plusieurs modules et exécuter des commandes de développement. Cela leur donne un rôle plus large qu'une fenêtre de chat qui vous renvoie un extrait à copier. La mise à jour d'un flux de connexion, par exemple, peut nécessiter des changements dans un formulaire, un gestionnaire de requêtes, un schéma de validation, la logique de session et des tests d'intégration. La question importante est de savoir si le chemin complet fonctionne toujours ensuite. Une grande fenêtre de contexte offre de la place pour l'information ; la découverte des fichiers pertinents et un environnement de test exécutable déterminent si l'agent peut utiliser efficacement cette information.
Interfaces et applications complètes
Les constructeurs d'applications peuvent générer des interfaces, connecter des données et prendre en charge des flux de publication. Vous devez malgré tout distinguer un aperçu convaincant d'une application réellement fonctionnelle. Un tableau de bord client peut afficher des enregistrements d'exemple crédibles alors que l'authentification ou le stockage persistant restent inachevés. Recharger la page, ouvrir l'application dans une autre session et demander l'enregistrement d'un autre utilisateur révèlent plus que l'écran initial. Ces catégories se recoupent : un agent éditeur peut échafauder une application, et un constructeur peut travailler sur du code existant. Choisissez selon le flux de développement et la propriété dont vous aurez besoin ensuite.
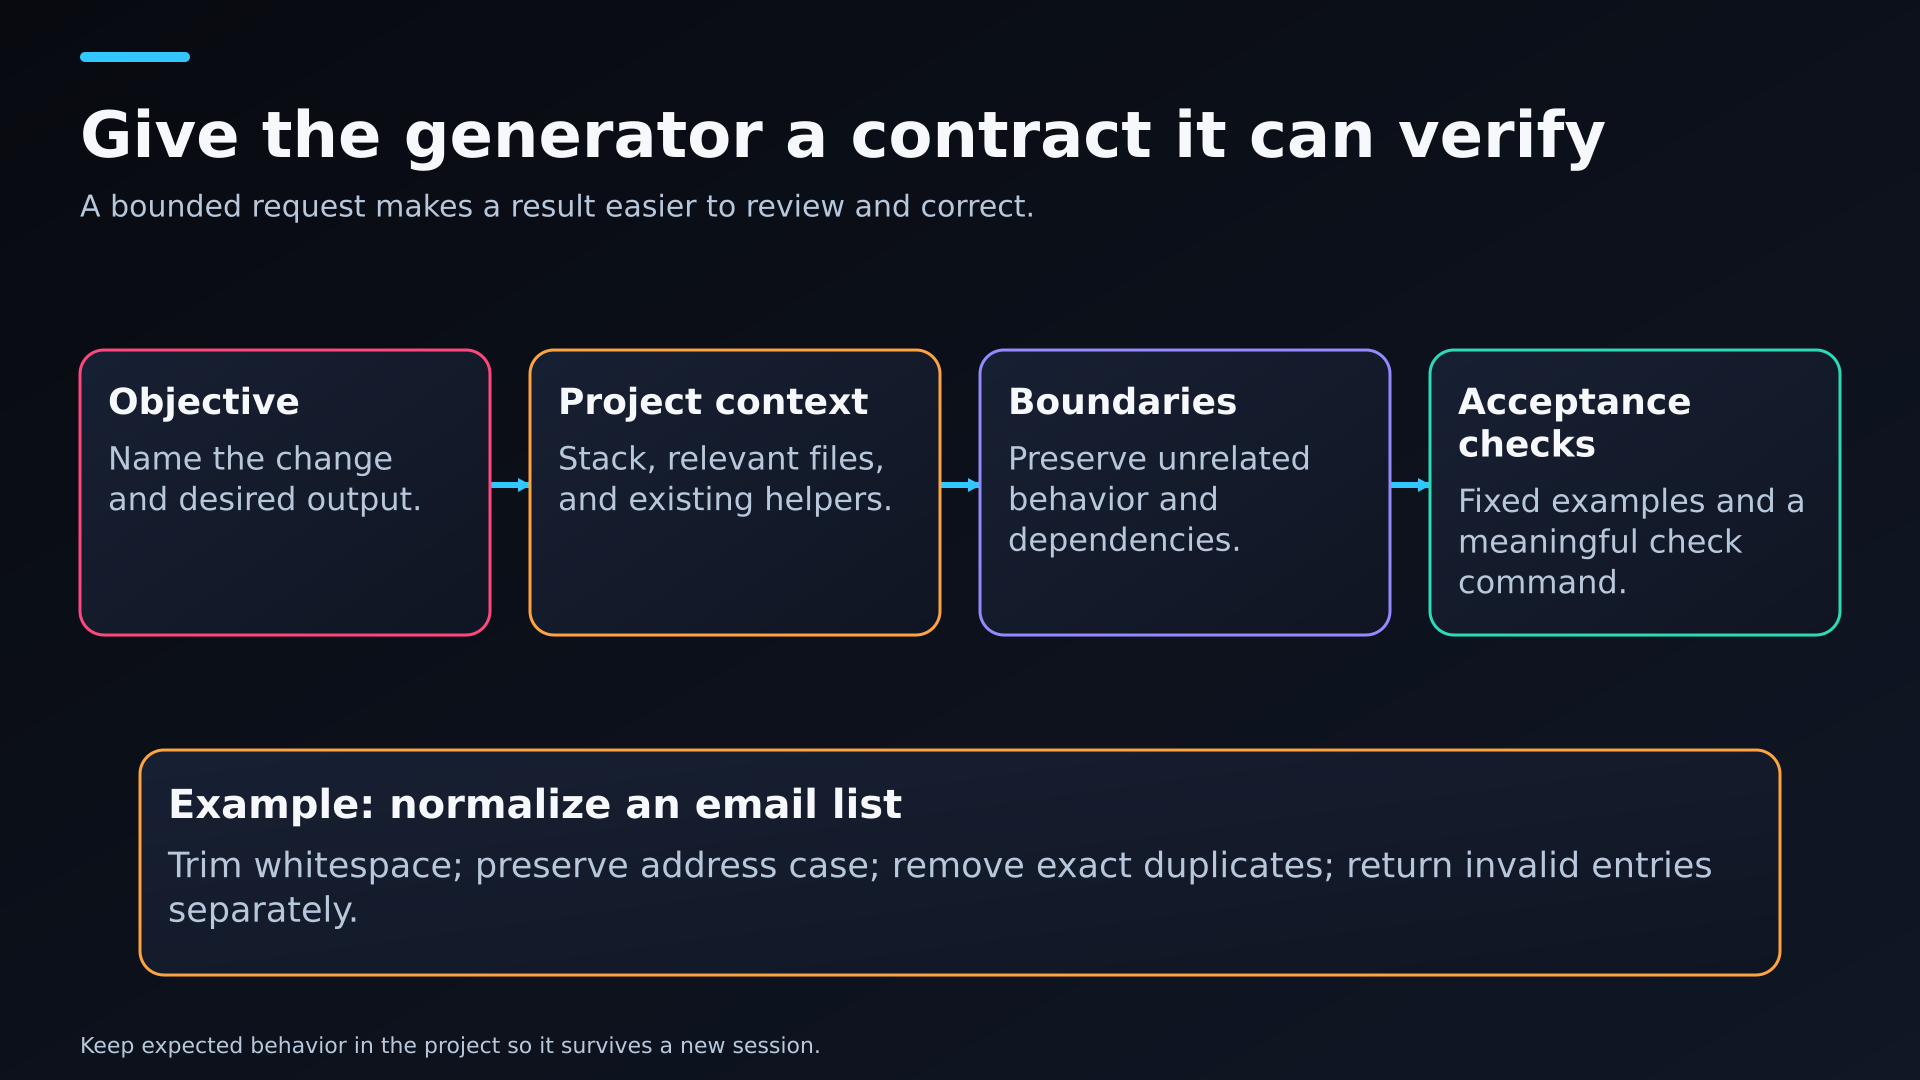
Un contrat de génération en quatre parties avec un exemple de normalisation d'e-mails tiré de l'article.
Comment comparer le meilleur générateur de code IA pour votre projet
Commencez par un seul livrable et une définition claire de « terminé ». Je présélectionnerais par flux de travail, puis je donnerais aux candidats les plus solides la même tâche bornée. Un correctif de validation sur deux fichiers ne devrait pas nécessiter un nouveau framework ni une réécriture complète de l'application. Une bonne génération préserve les parties de votre projet qui fonctionnent déjà et rend le changement demandé facile à inspecter. Le meilleur générateur de code IA pour votre projet est celui qui respecte ces contraintes à un coût acceptable.
La compatibilité du langage et de l'environnement d'exécution passe avant tout. Votre version de Python, vos réglages TypeScript, la version du framework, le gestionnaire de paquets et le lockfile doivent rester cohérents avec le projet que vous comptez maintenir.
Le contexte comprend les fichiers pertinents, les contrats d'API, les conventions du projet et les limites. Un générateur doit savoir quel helper d'authentification réutiliser et quels fichiers de configuration il ne doit pas toucher.
La capacité de relecture compte après la génération. Des diffs clairs, une sortie de commande visible, des permissions appropriées et une voie de récupération fiable facilitent l'acceptation ou le rejet d'un changement.
Le coût total comprend les abonnements, l'inférence facturée séparément, l'hébergement de l'application, les ressources de base de données et le temps de correction. Ces frais peuvent suivre des règles de facturation différentes, même au sein d'un même produit.
Une transmission utile comprend un code source accessible, un manifeste de dépendances, des informations de licence, des noms de variables d'environnement et des instructions d'installation. Un autre développeur devrait pouvoir comprendre ce dont l'application a besoin pour fonctionner.
Tenez un court registre pour chaque candidat : la tâche, le commit de départ, le contexte fourni, le modèle choisi, les fichiers modifiés, les vérifications réussies, les tentatives, le temps de relecture et les frais. Cela rend visible une tentative échouée au lieu de laisser une capture d'écran finale impressionnante effacer le travail nécessaire pour y arriver. Vous pouvez aussi repérer des problèmes récurrents, comme un renouvellement constant des dépendances ou des tests qui ne passent qu'après que l'agent a modifié leurs résultats attendus.
Séparez les échecs d'environnement des échecs de code. Une connexion de base de données manquante ou un registre de paquets indisponible peut empêcher la vérification d'un correctif par ailleurs plausible. Notez cette limitation sans accorder une réussite ni supposer que le correctif est faux. Puis relancez depuis le même commit de départ une fois l'environnement utilisable. Pour une comparaison meilleur générateur de code IA 2026, des détails de configuration datés sont aussi précieux qu'un nom de produit, car les plans, l'accès aux modèles et les environnements d'exécution pris en charge changent.
Meilleures options de générateur de code IA par flux de travail
GitHub Copilot pour la génération dans un éditeur existant
GitHub Copilot est un point de départ pratique quand vous voulez des suggestions dans votre éditeur habituel. L'assistance en ligne soutient l'implémentation locale, tandis que les fonctionnalités de chat et d'agent peuvent soutenir des changements plus larges là où elles sont disponibles. Pour un helper de validation TypeScript, les types et schémas existants sont un contexte plus utile qu'une longue description de produit. Vérifiez les champs optionnels et la forme d'erreur attendue par les appelants. Copilot propose un accès gratuit limité et des plans payants avec leurs modalités d'usage documentées ; utilisez la page de plans actuelle plutôt que de traîner un ancien quota de complétion dans une nouvelle comparaison.
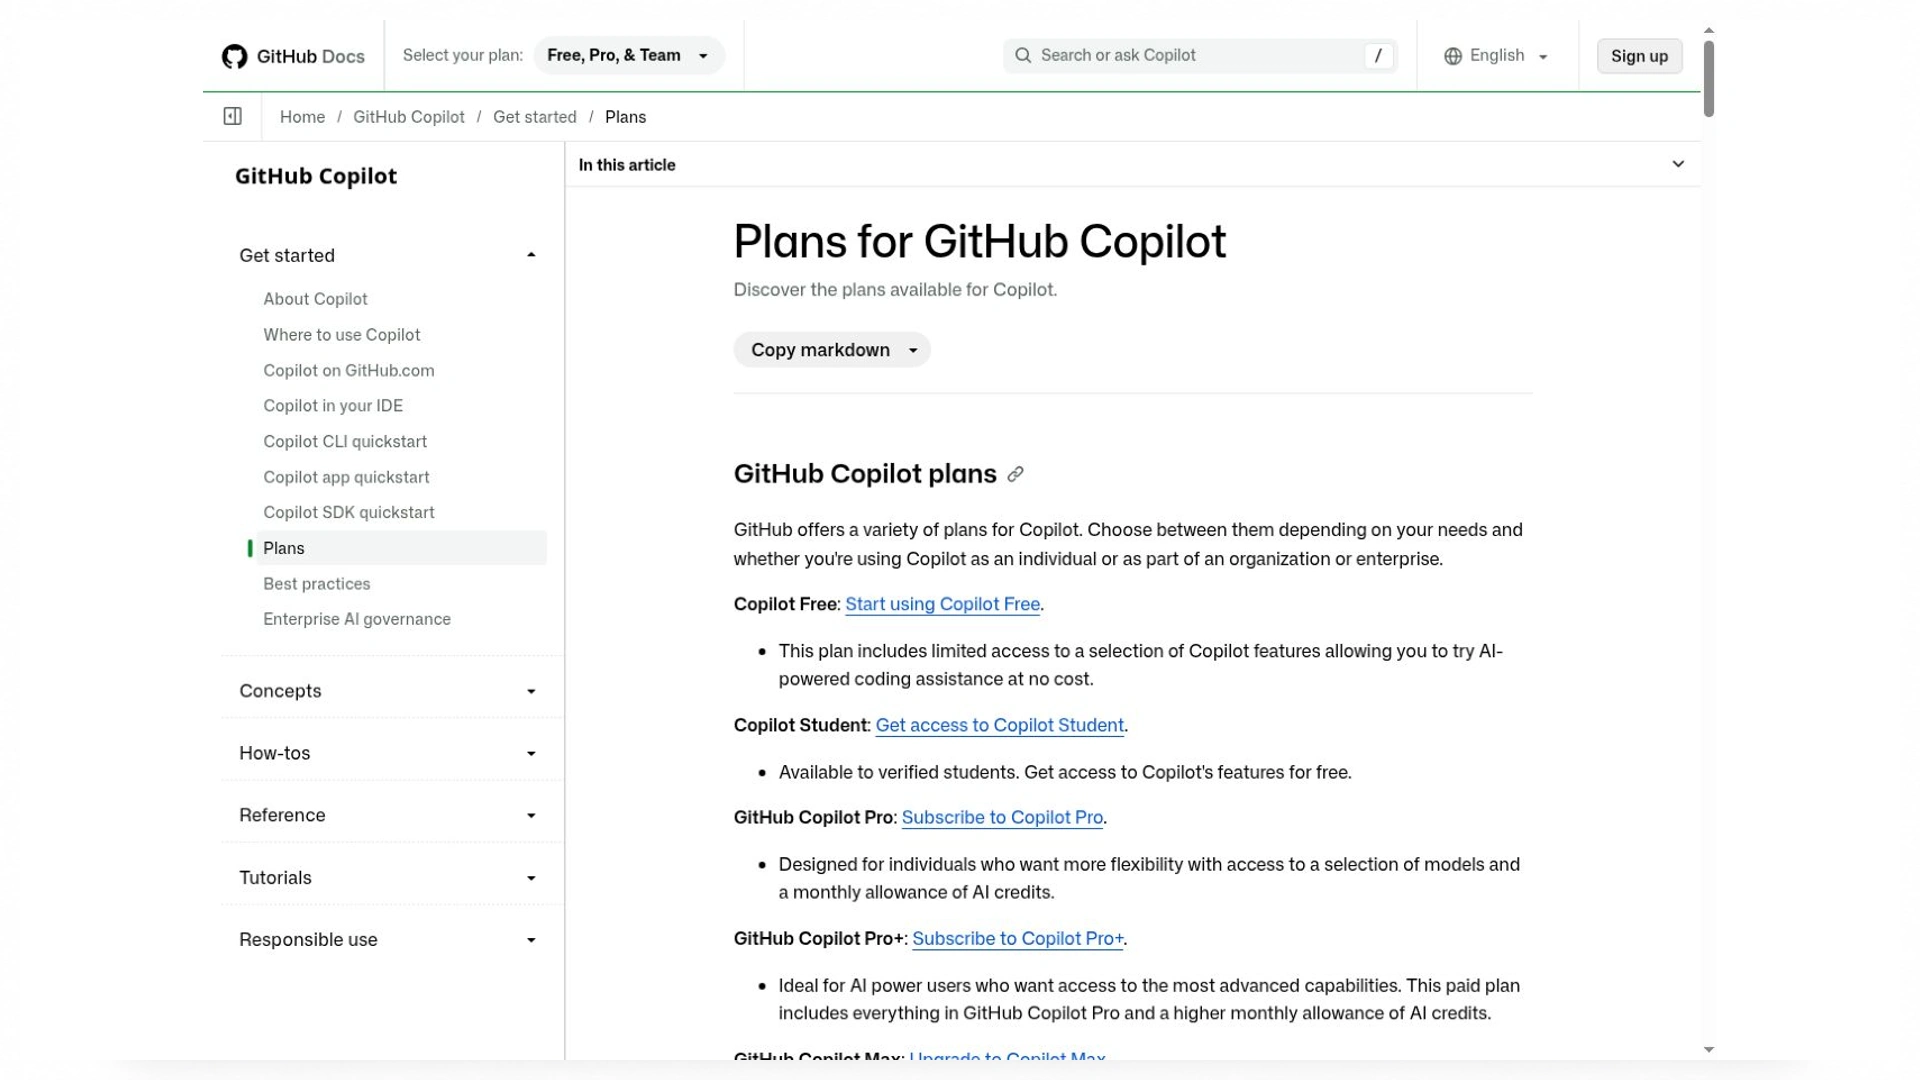
Comparez la fonctionnalité et le quota pertinents pour votre tâche. Les plans actuels sont une meilleure référence que les anciens résumés de quotas.
Cursor pour éditer et générer sur tout un projet
Cursor combine des suggestions Tab prédictives avec l'exploration de projet et des changements pilotés par agent. Cette combinaison est utile quand vous alternez entre petites modifications et une fonctionnalité qui touche plusieurs fichiers. Par exemple, ajouter un filtre à un écran d'administration peut impliquer l'état du composant, des paramètres de requête dans l'URL, une requête backend et une fixture de test. Le correctif devrait préserver les conventions de navigation et de récupération de données existantes. L'intégration à l'éditeur de Cursor est la raison de l'envisager ; la vitesse et la justesse dépendent toujours de votre tâche, de votre modèle et de votre processus de relecture. Son plan actuel et les frais de modèle méritent aussi attention avant de le comparer à d'anciens résumés tarifaires.
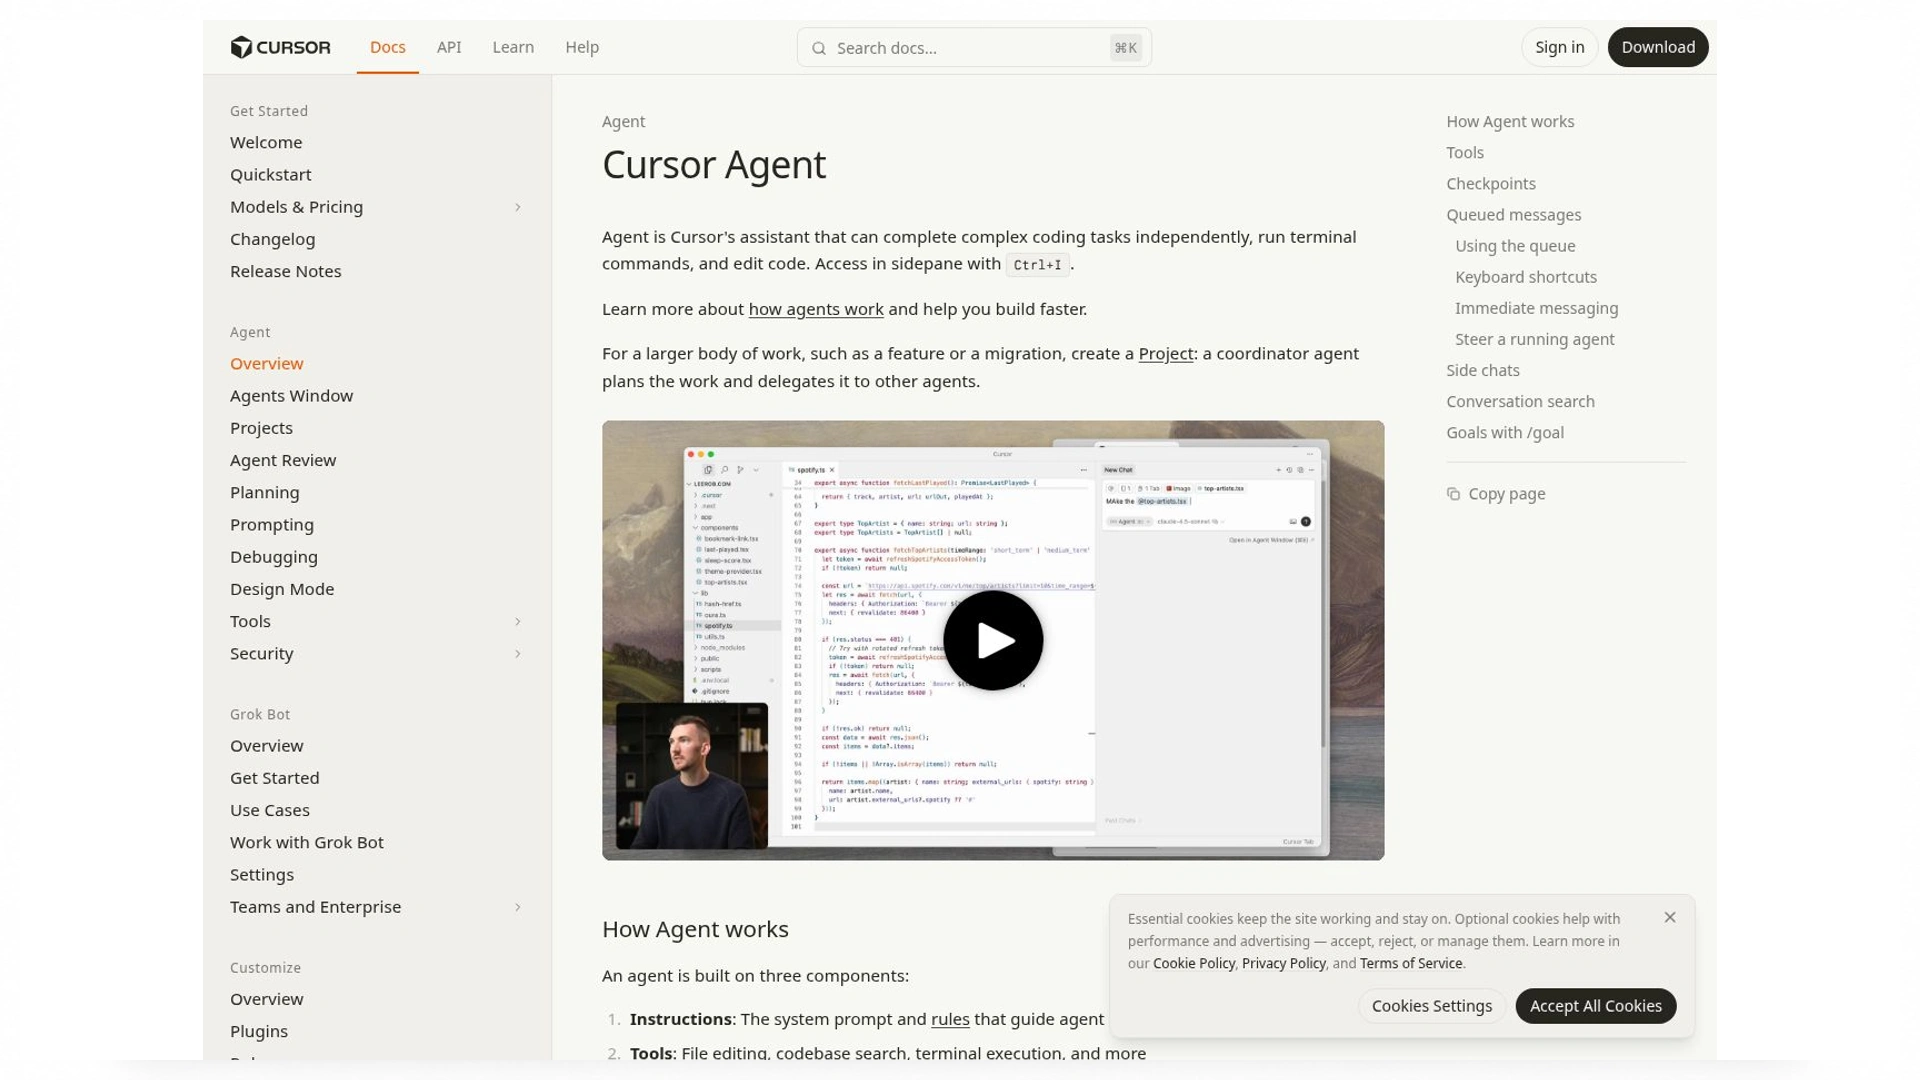
La présentation de l'agent décrit la planification, l'implémentation et les capacités de flux de travail associées. Une capture de documentation, pas un résultat de codage mesuré.
Cline pour des agents configurables et l'accès aux modèles
Cline vous offre plusieurs façons d'exécuter un agent, dont une extension IDE et une CLI, avec un accès configurable aux modèles. Vous pouvez inspecter un service en mode Plan et passer en mode Act une fois que le changement proposé correspond à vos exigences. C'est utile quand vous voulez comparer des fournisseurs ou garder le contrôle sur la configuration derrière une tâche de génération. Les identifiants fournisseur, la facturation d'usage intégrée et l'abonnement optionnel ClinePass sont des voies d'accès différentes. Le logiciel agent et l'inférence qu'il invoque ont des coûts séparés. La capacité du modèle, les paramètres d'approbation et la quantité de contexte fournie influencent tous le déroulement du travail.
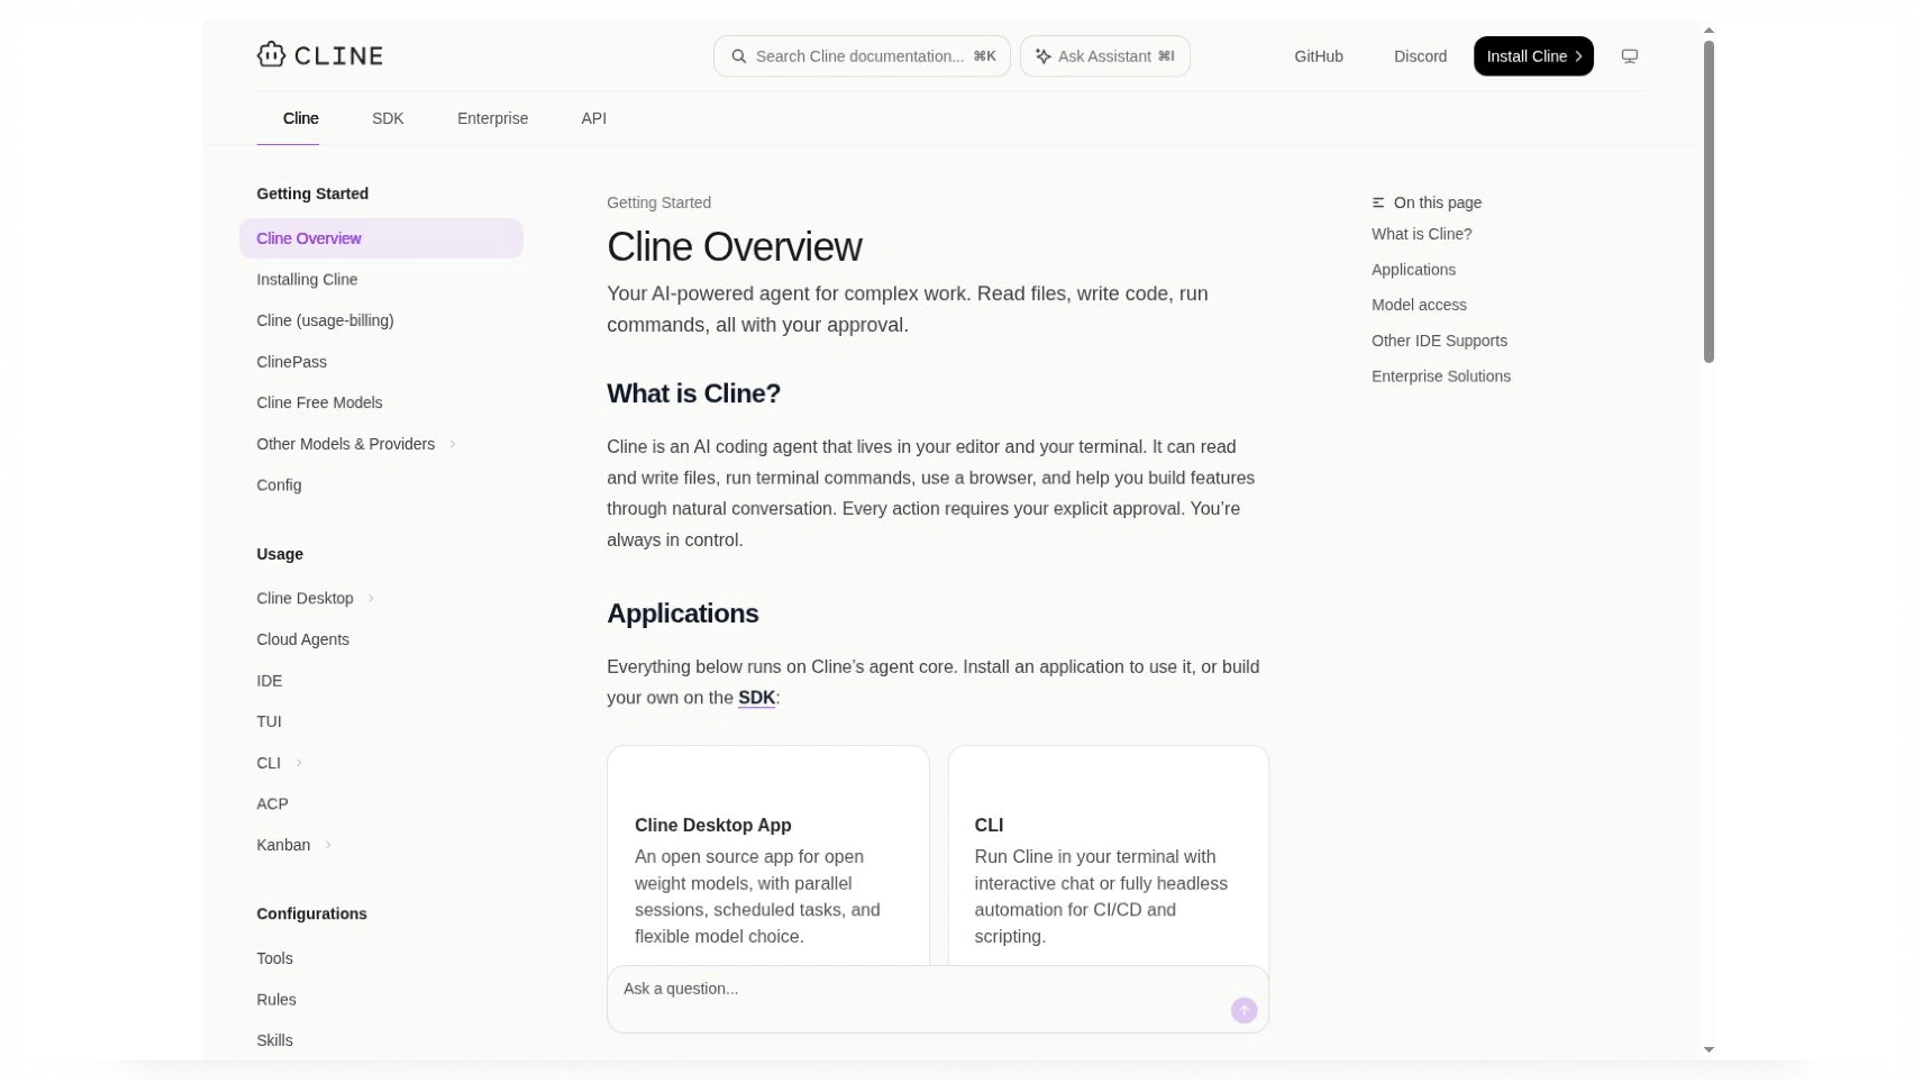
La présentation décrit les surfaces d'agent disponibles et les voies d'accès aux modèles. Une capture de documentation ; aucun test comparatif n'est sous-entendu.
Claude Code pour le travail en terminal et sur dépôt
Claude Code convient au travail sur dépôt où lire des fichiers, modifier du code et exécuter des commandes appartiennent à la même session. Il est disponible via des flux de travail terminal, IDE, bureau et web. Lorsque vous ajoutez un endpoint à un service existant, les détails pertinents incluent ses conventions de routage, son middleware d'authentification, le schéma de réponse et la commande de test. Un résultat utile suit ces modèles et explique tout changement de configuration nécessaire. L'accès par abonnement et par API sont des voies de facturation séparées, confirmez donc laquelle votre session utilise. Le flux de travail en terminal est particulièrement pertinent si vous dépendez déjà d'outils de build locaux et de débogage en ligne de commande.
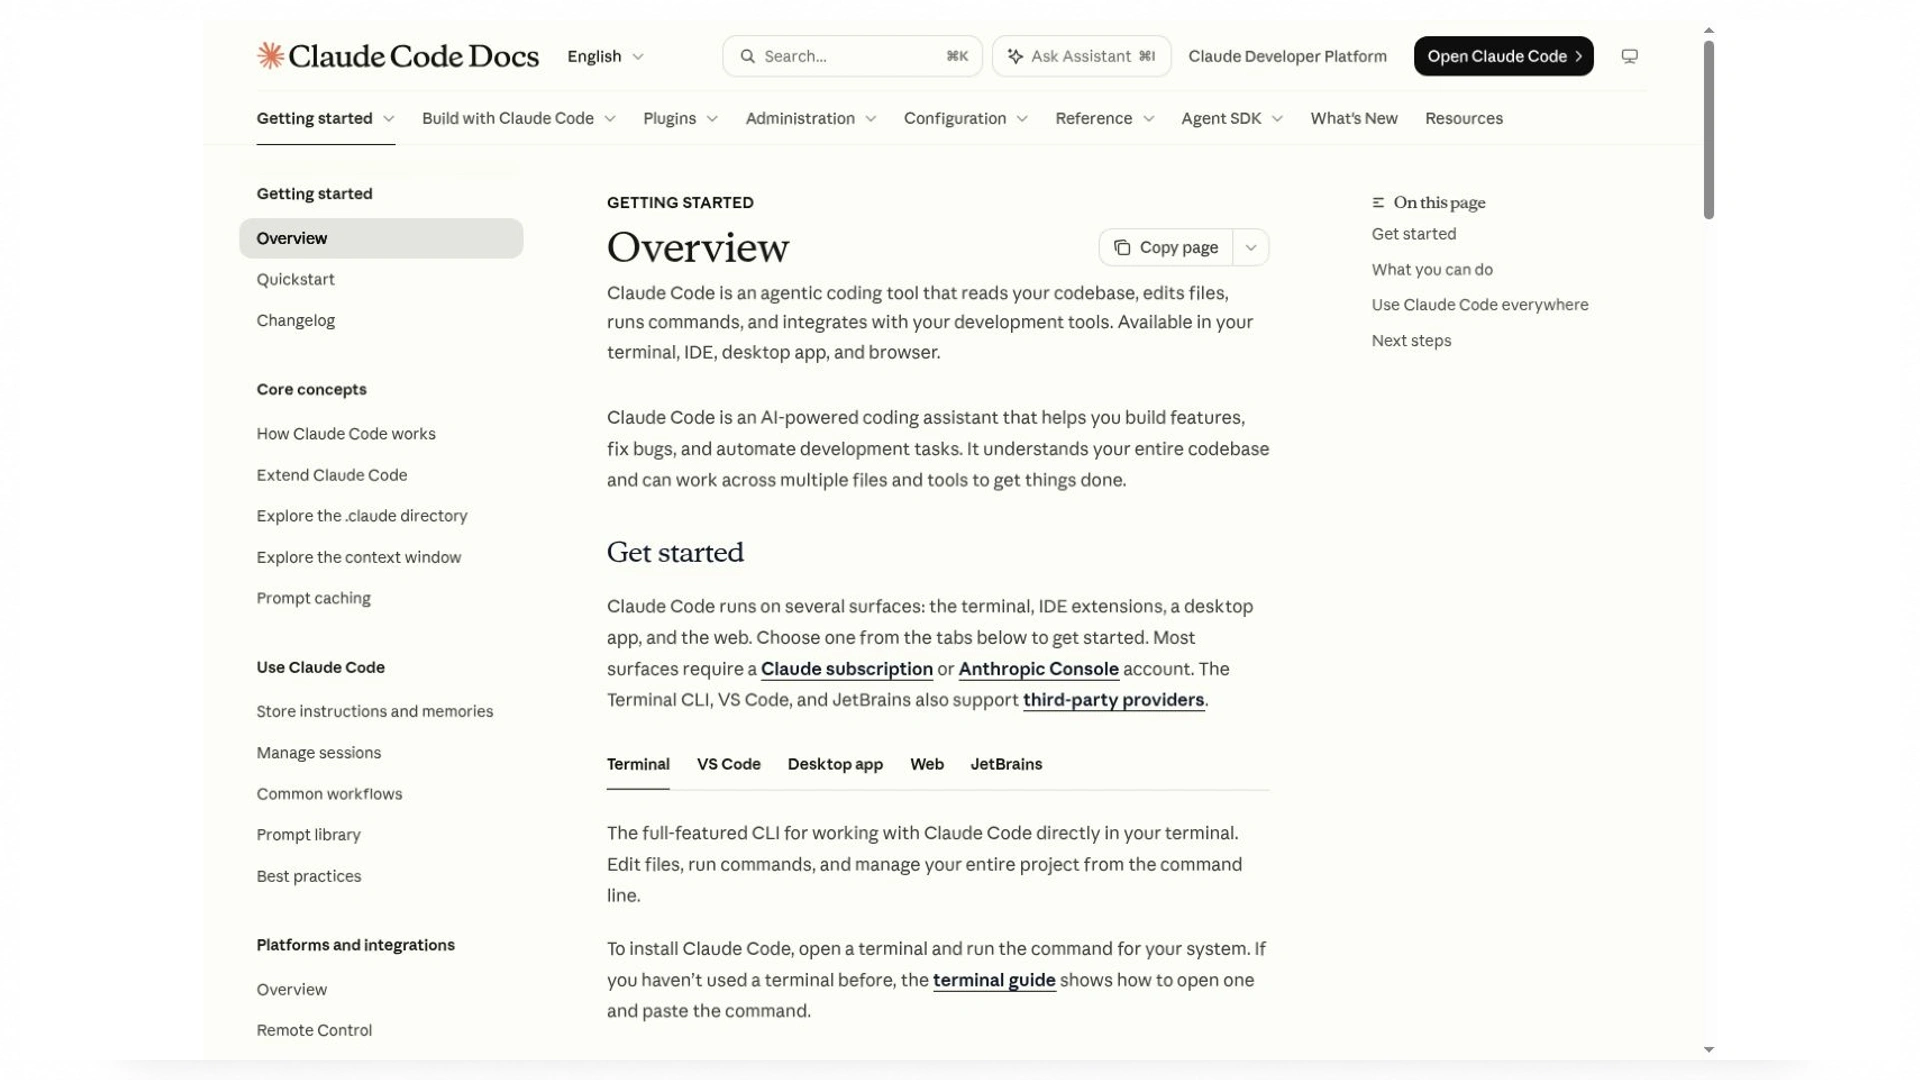
La présentation explique ses surfaces de développement et le flux de travail fichiers-et-commandes. Elle n'établit pas de classement de performance.
v0 pour les interfaces et les applications Next.js
v0 vaut la considération pour le développement web centré sur l'interface, y compris un configurateur de prix responsive ou un portail client. Ses capacités actuelles s'étendent aux applications complètes, aux connexions de base de données et à la logique backend. Next.js est le choix par défaut, bien que d'autres frameworks soient possibles. Votre évaluation devrait couvrir les étiquettes de formulaire accessibles, le focus clavier, les mises en page mobiles, les états de chargement et le code qui traite les valeurs soumises. Un contrôle de prix qui paraît correct peut malgré tout faire confiance à une valeur fournie par le navigateur. Garder les règles de calcul et d'autorisation sur le serveur est une exigence distincte de la reproduction d'un design soigné.
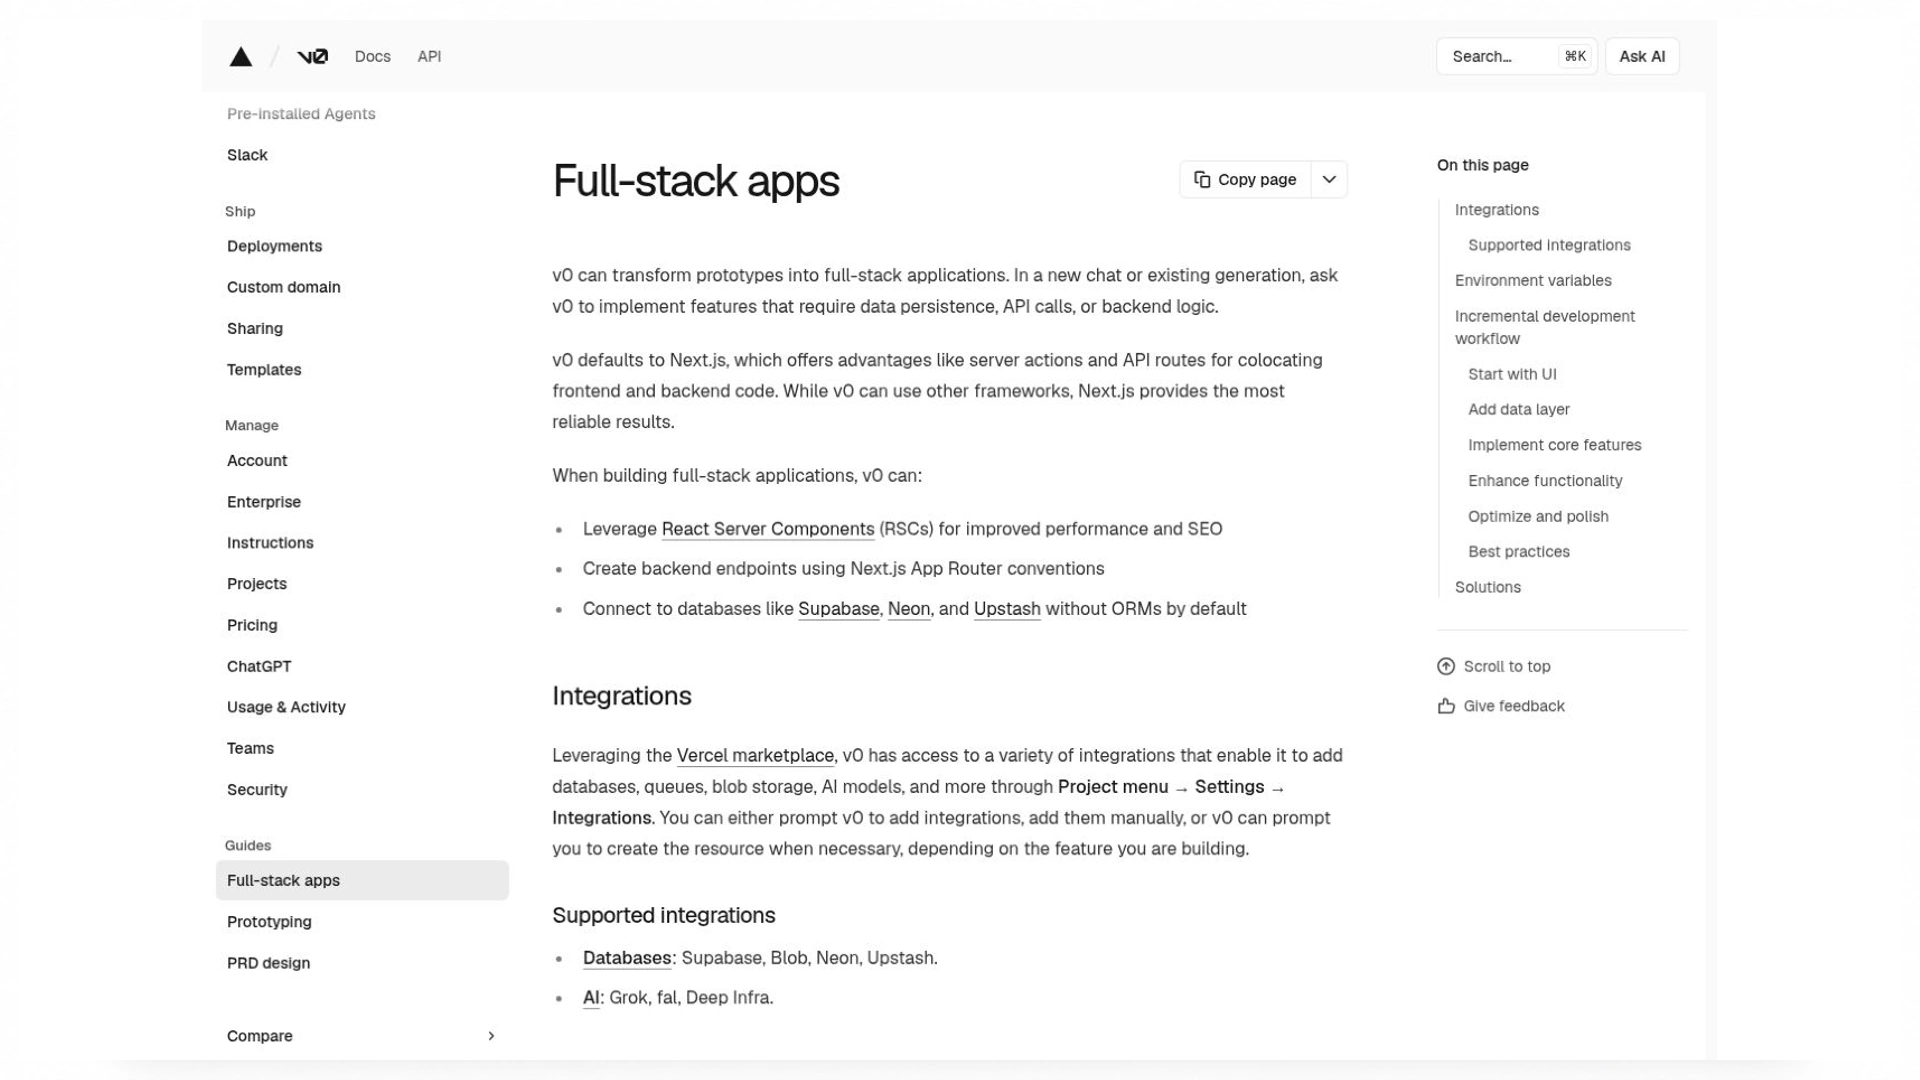
Documentation officielle v0
Le guide des applications complètes couvre plus que la génération d'interface. La validation backend reste une exigence d'acceptation distincte.
Replit Agent pour un flux de travail de développement hébergé
Replit Agent réunit configuration de projet, génération, itération et publication dans un flux de travail hébergé. Cela réduit la configuration locale quand vous voulez construire un tableau de bord interne et vérifier rapidement un aperçu. Vérifiez le quota d'agent actuel du compte et la voie de facturation plutôt que de supposer que développement et hébergement partagent un quota illimité. La publication ajoute de la configuration, des données persistantes, des redirections d'authentification et de la consommation de ressources. Une fonctionnalité qui marche en aperçu peut échouer après publication si une variable d'environnement ou une URL de callback diffère. L'environnement hébergé est une commodité ; le comportement opérationnel a toujours besoin d'être vérifié.
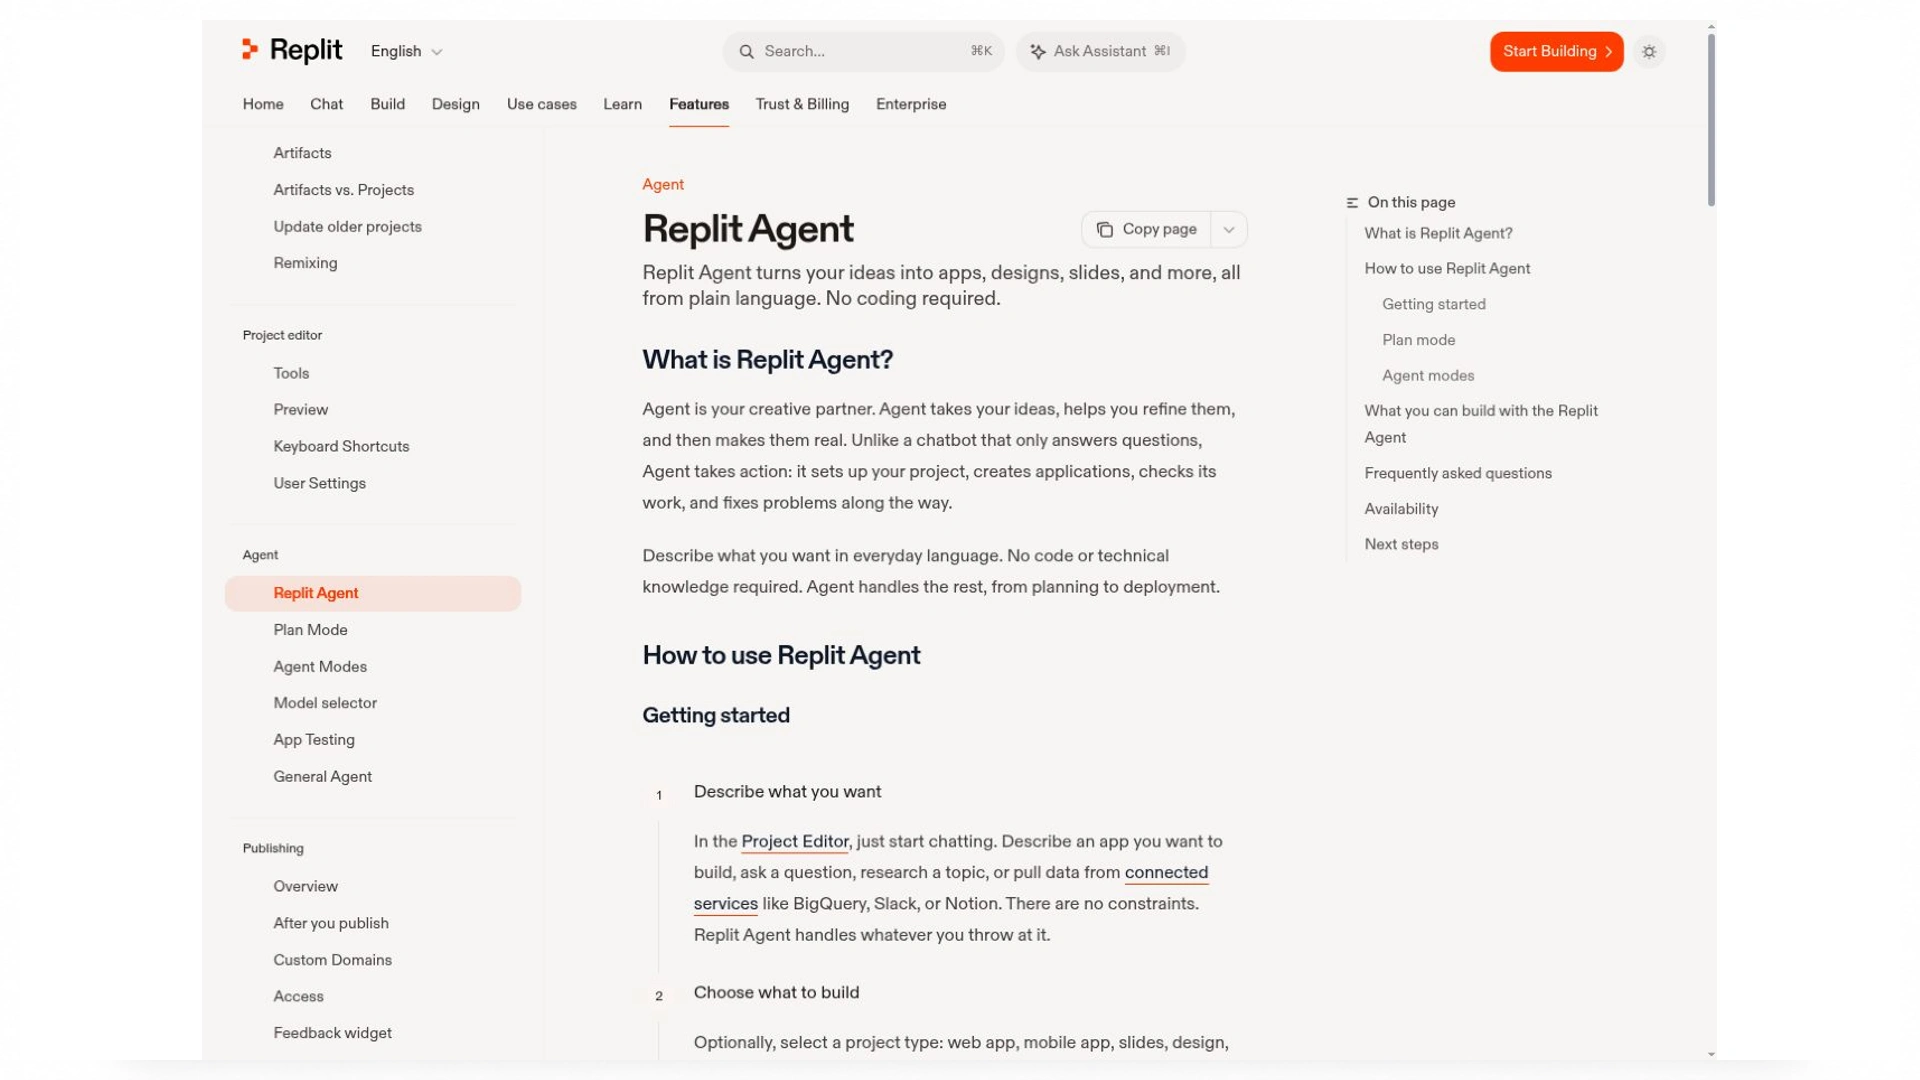
La documentation décrit le flux de travail du projet hébergé. L'aperçu, la publication et la consommation de ressources nécessitent leurs propres vérifications.
Quel est le meilleur générateur de code IA gratuit
Un plan gratuit est utile quand son quota couvre la tâche que vous devez accomplir. L'accès hébergé limité, les modèles promotionnels et l'inférence locale offrent des compromis différents. Une extension gratuite peut quand même appeler un fournisseur payant ; un modèle local évite ces frais de fournisseur mais utilise votre matériel et demande du temps à configurer. Les limites de complétion diffèrent aussi des quotas de chat ou d'agent. Avant de vous engager dans un flux de travail, vérifiez quelles actions consomment le quota et si la publication ou la maintenance de l'application résultante crée des frais séparés.
Un petit essai révèle plus qu'un quota qui paraît généreux. Générez un utilitaire, exécutez-le avec des entrées normales et invalides, et effectuez une correction ciblée. Notez si l'outil peut inspecter l'échec lui-même ou s'il vous faut copier des journaux entre fenêtres. Vérifiez ensuite le quota restant. Une tâche peut consommer plusieurs tours de modèle pendant que l'agent lit des fichiers, modifie du code, exécute une vérification et tente une réparation. Les quotas actuels et les offres promotionnelles peuvent changer, donc l'écran d'usage du compte est une meilleure référence de planification qu'un ancien récapitulatif.
Le meilleur générateur de code IA gratuit est celui dont les contraintes vous permettent de mener une tâche complète et vérifiable. Un quota gratuit élevé est moins utile si l'outil ne peut pas lire les fichiers pertinents ou exécuter la vérification de votre projet. Gardez la première évaluation assez petite pour la terminer, et conservez la source localement ou dans votre dépôt. Votre prochaine modification ne devrait pas dépendre de la récupération d'une longue conversation ni de la recréation d'un aperçu inaccessible.
Choisir selon le langage, le framework et la maturité du projet
Automatisation Python et traitement de données
Automatisez les tâches quotidiennes avec Python et simplifiez votre flux de travail.
L'automatisation Python bénéficie de transformations prévisibles et d'une gestion explicite des erreurs. Pour un script de nettoyage CSV, définissez l'encodage, les types de colonnes, la politique sur les doublons et le traitement des valeurs manquantes. Décidez si une ligne invalide arrête la tâche ou va dans un rapport d'erreurs séparé. Si le fichier peut être volumineux, demandez un traitement en streaming ou par lots plutôt que de tout charger en mémoire sans raison. Gardez le fichier original intact et vérifiez qu'une seconde exécution ne crée pas de sortie dupliquée. Ces exigences rendent l'utilitaire généré plus digne de confiance qu'une démonstration à cinq lignes.
Développement web frontend et full-stack
Le travail frontend a besoin de plus qu'une similitude visuelle. Un formulaire React ou Next.js devrait avoir des étiquettes utilisables, un focus prévisible, des états de chargement appropriés et une validation à la fois côté serveur et côté navigateur. Le routage et la gestion d'état devraient suivre l'application existante. Si vous utilisez Vue, Django, Laravel ou un autre stack, le changement généré devrait convenir à ce stack et à sa version actuelle. Introduire un framework préféré, une bibliothèque de composants dupliquée ou un second système d'authentification peut transformer une petite fonctionnalité en une migration que vous n'avez jamais demandée.
Services existants et dépôts d'équipe
Un service établi a généralement besoin d'un petit correctif compatible. Lors d'une migration d'endpoint, les appelants existants peuvent toujours dépendre du nom de champ ou de la forme de réponse précédente. Un changement généré devrait tenir compte de cette transition plutôt que de remplacer une chaîne partout en supposant le travail terminé. Vérifiez l'autorisation, les changements de dépendances, les migrations de base de données et les tests qui protègent l'ancien comportement. Un correctif ciblé est plus facile à relire et à annuler. Les conventions familières comptent aussi quand un autre membre de l'équipe doit déboguer la fonctionnalité des mois après la fin de la session de génération.
Les changements de dépendances méritent leur propre relecture. Vérifiez si le générateur a ajouté un paquet pour éviter un helper déjà présent, modifié le lockfile de façon inattendue, ou introduit un runtime que votre déploiement ne peut pas exécuter. Pour une migration de schéma, identifiez le changement avant, la fenêtre de compatibilité et la voie de récupération. Un correctif qui exige une mise à jour simultanée de tous les appelants peut ne pas convenir à un service déployé indépendamment, même quand ses tests locaux passent.
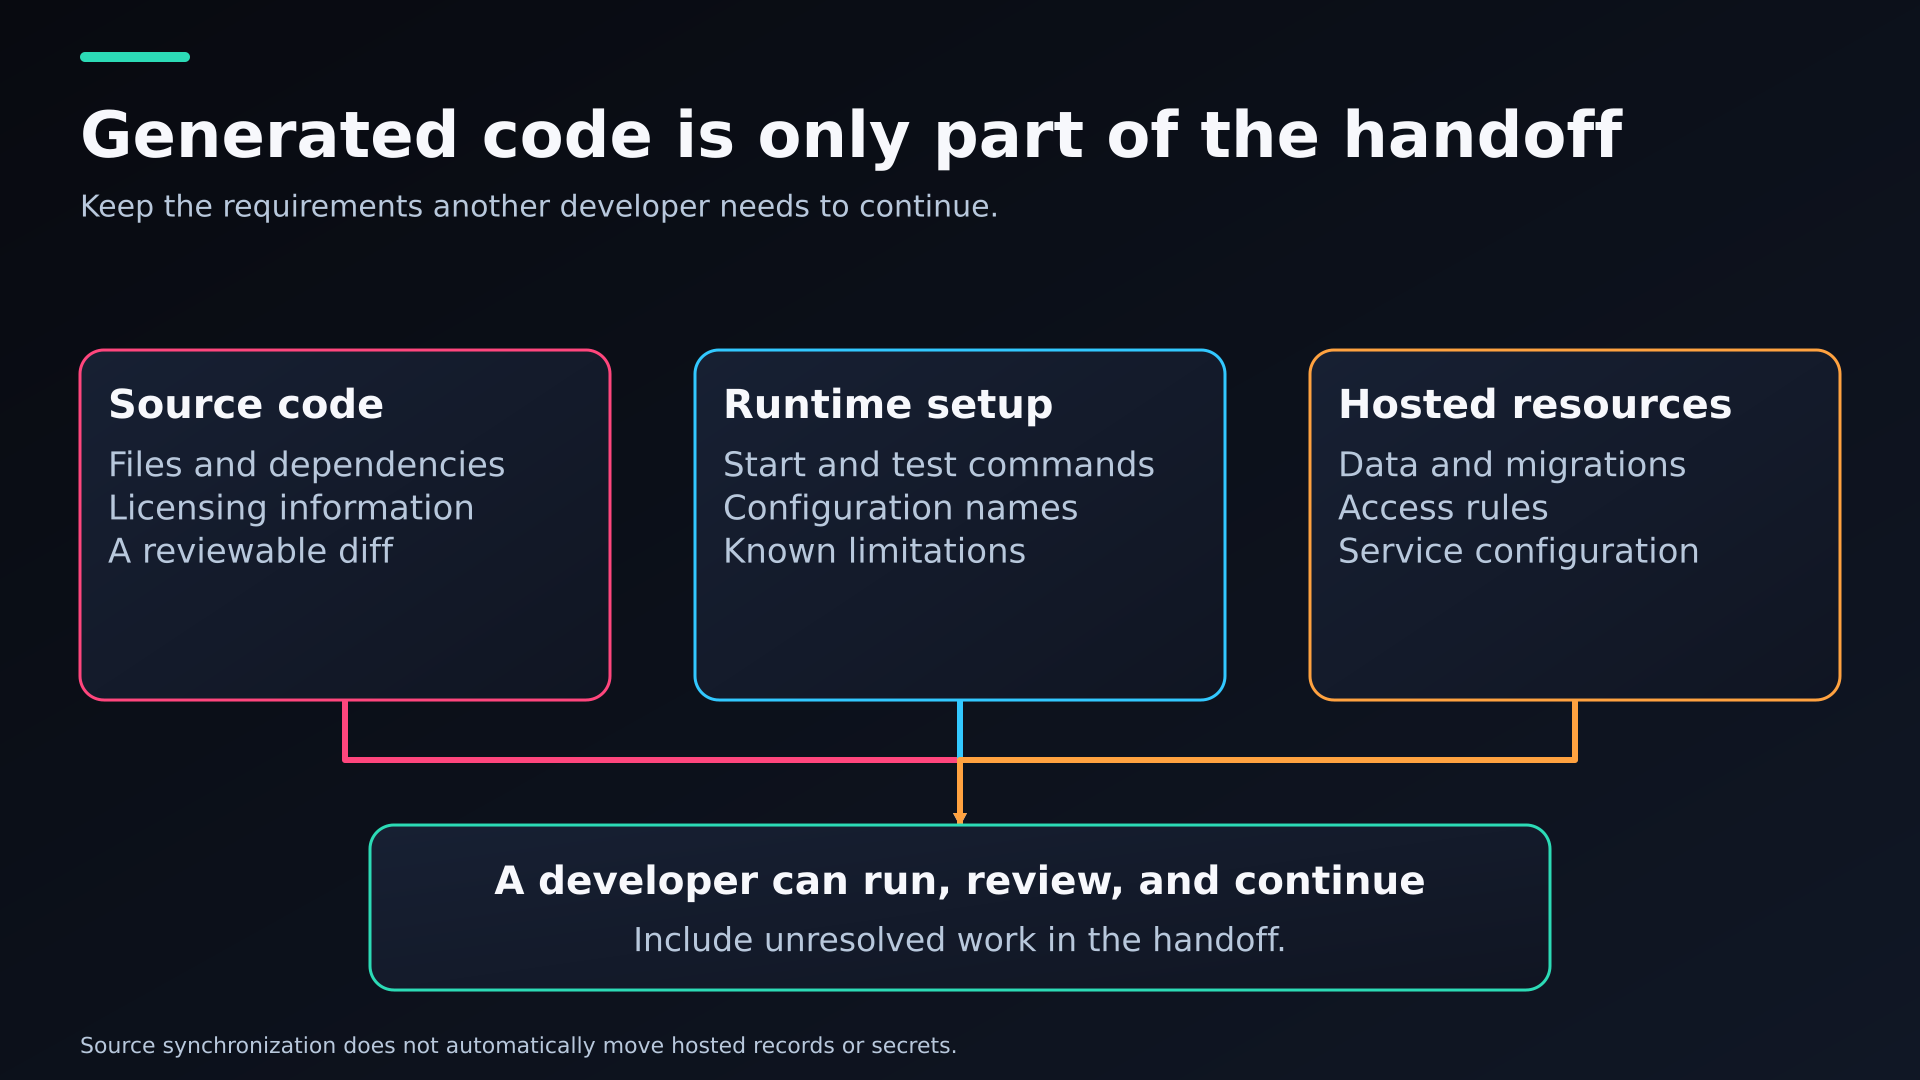
Un diagramme de transmission séparant les fichiers source, la configuration d'exécution et la configuration des ressources hébergées.
Donnez à votre générateur un contrat qu'il peut vérifier
Un prompt de génération solide définit l'objectif, le stack actuel, les fichiers pertinents, des exemples, des contraintes et une commande de vérification. Cela donne à l'outil un contrat qu'il peut vérifier. Pour un parseur, le contrat pourrait spécifier des sorties exactes pour des entrées valides et mal formées. Pour une API, il pourrait définir les champs de réponse, les codes de statut et les règles d'accès. Conservez ces exigences dans le projet pour qu'elles survivent à une nouvelle session. Le prompt devrait aussi exiger que l'agent rapporte quelles commandes il a exécutées, et distingue une vérification réussie d'une qu'il n'a pas pu exécuter.
Exemple de prompt : « Dans ce projet Python, implémente normalize_email_list en utilisant les dépendances existantes. Supprime les espaces en périphérie, préserve la casse de l'adresse, retire les doublons exacts après suppression des espaces, rejette les valeurs vides, et renvoie les entrées invalides séparément. Ajoute des cas pour entrée vide, adresses répétées et valeurs mal formées. Explique le correctif et exécute la commande de test existante. Ne modifie pas de fichiers non liés. »
Un suivi utile identifie un écart : « Le cas d'entrée vide renvoie un enregistrement, mais le contrat exige une liste vide. » Cela donne à l'agent un échec reproductible et limite les modifications inutiles. Les tests d'API devraient vérifier les requêtes non autorisées autant que les requêtes réussies. La génération SQL nécessite des requêtes paramétrées, des limites de résultats raisonnables et un plan d'exécution quand la performance compte. Votre générateur devient plus facile à juger quand les mêmes entrées, le même comportement attendu et le même processus de vérification s'appliquent à chaque candidat.
La question « quel est le meilleur générateur de code IA ? » devient plus utile une fois suivie d'une contrainte précise : pour un service Python existant, un prototype Next.js, ou un utilitaire hors ligne. Conservez les exemples et les sorties attendues dans un fichier de tâches versionné. Demandez à l'outil de préserver ces attentes plutôt que de les réécrire pour correspondre à sa première tentative. Cela rend les tentatives ultérieures comparables et laisse à un autre développeur une explication plus claire du changement.
Mesurer le code accepté et le coût total
Le code accepté est une meilleure mesure que les lignes générées. Suivez les exigences satisfaites, les cycles de correction, les régressions et le temps nécessaire pour relire le correctif. Vérifiez si un relecteur peut expliquer l'implémentation et si le comportement original fonctionne toujours. Les tests écrits par le générateur peuvent aider, mais ils peuvent répéter la même hypothèse erronée que son code. Conservez quelques cas d'acceptation définis indépendamment, et inspectez les changements apportés aux tests existants. Un résultat réussi est moins convaincant si l'agent a supprimé l'assertion qui aurait révélé le défaut.
La recherche sur la productivité a aussi besoin de contexte. L'expérience de METR au début de 2025 a porté sur 16 développeurs expérimentés travaillant sur 246 problèmes dans des dépôts open source familiers, et a signalé un ralentissement de 19 % avec accès à l'IA. Son suivi de février 2026 a décrit des effets de sélection et des difficultés de mesure qui ont rendu les résultats plus récents difficiles à interpréter. Ces constats ne déterminent pas quel outil fonctionnera le mieux pour votre projet aujourd'hui. Ils montrent en revanche pourquoi la vitesse perçue, les scores de référence et le travail accompli sont des mesures différentes. Votre propre comparaison devrait inclure le temps de relecture et de réparation.
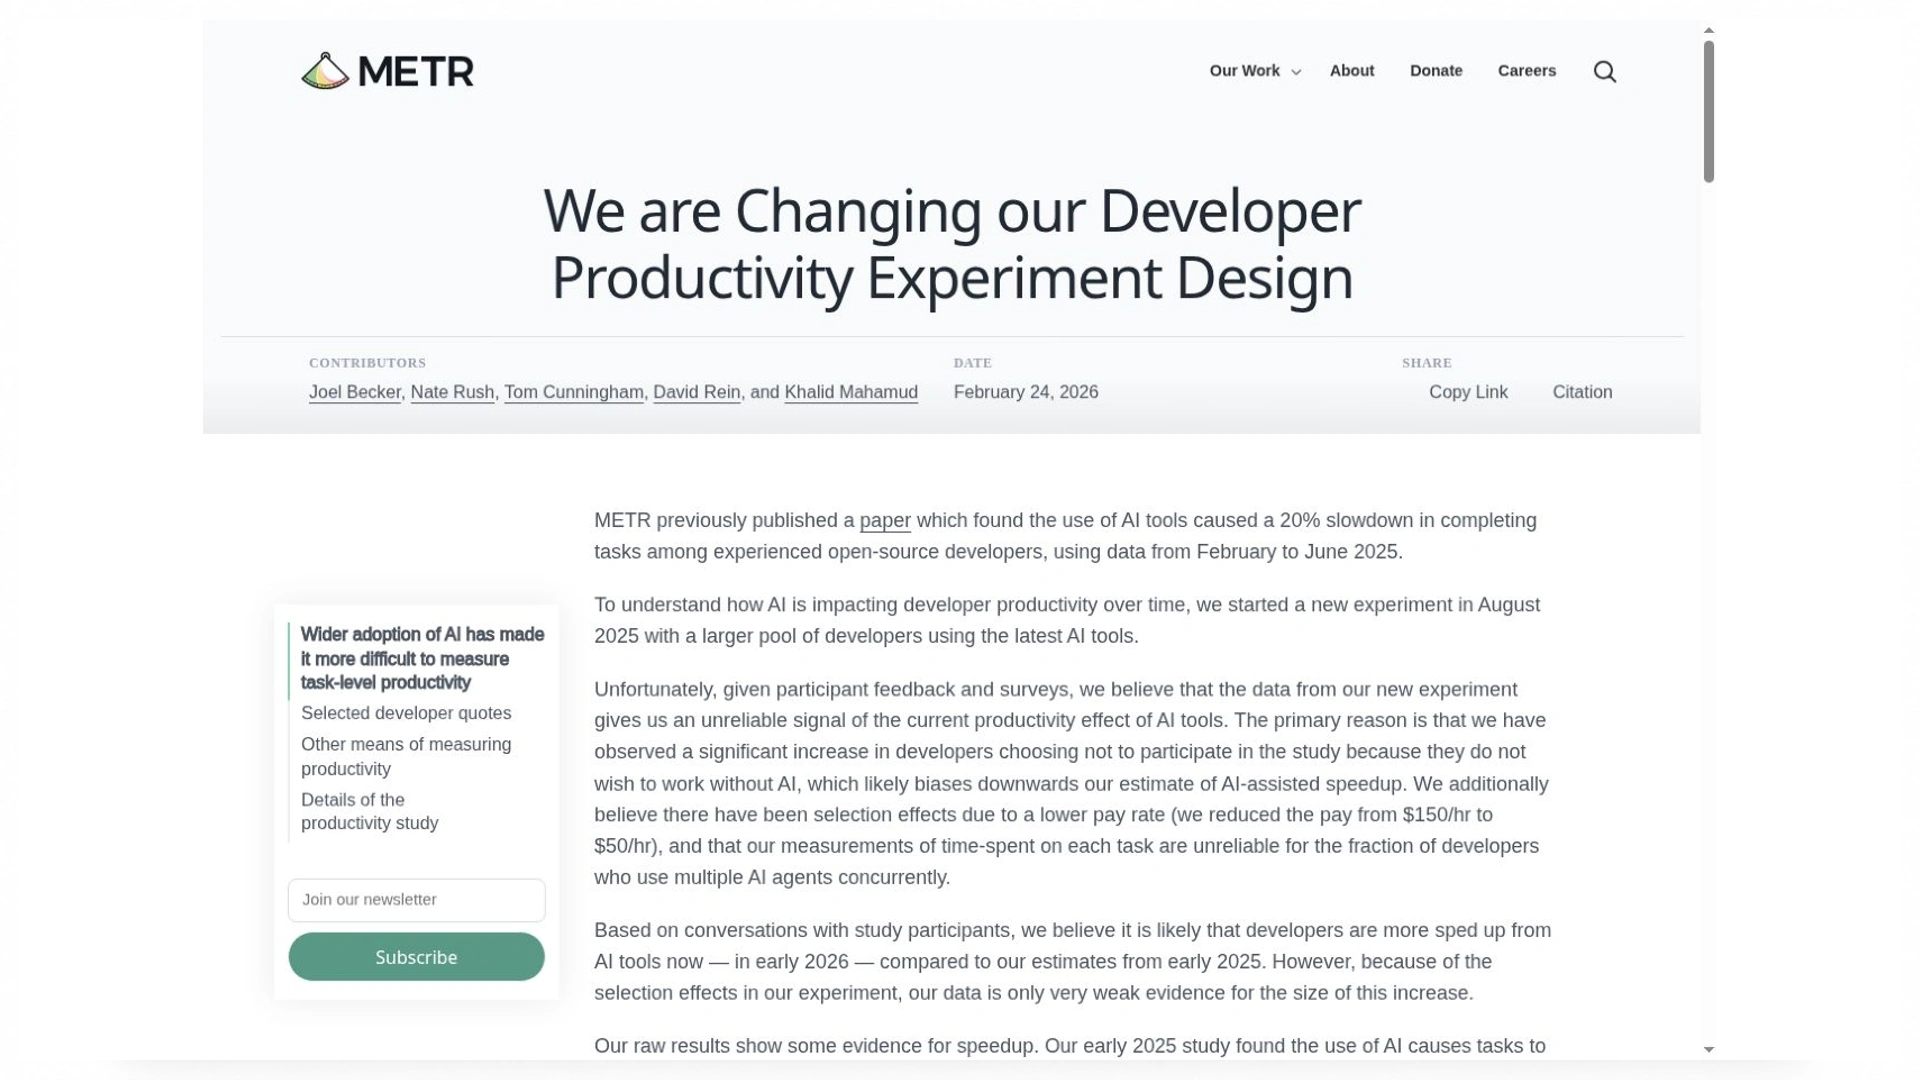
La mise à jour de février 2026 discute des limitations dans l'estimation de l'effet de productivité actuel. Ceci est une capture de page de recherche.
Supposons qu'un essai engendre 12 dollars de frais de génération et produise six tâches acceptées. Cela fait 2 dollars par tâche acceptée avant abonnements, hébergement et relecture humaine. Si les tentatives infructueuses sont déjà incluses dans les 12 dollars, gardez-les incluses ; les exclure rendrait l'outil artificiellement moins cher. Comparez des tâches équivalentes sur la même période de facturation. J'enregistrerais aussi les minutes de relecture séparément, car une facture d'inférence plus basse offre peu d'avantage si chaque changement demande beaucoup plus de débogage. C'est un calcul illustratif, pas une affirmation sur les résultats d'un fournisseur donné.
Évaluer Enter Pro en construisant ScopeQuote
ScopeQuote est un estimateur d'agence fictif capturé dans Enter Pro. Un client sélectionne des services, examine un total et envoie une demande pour une relecture ultérieure par l'agence. Les images montrent le plan, l'estimateur, la confirmation et la porte de connexion propriétaire. C'est suffisant pour examiner le parcours visible et définir précisément les vérifications backend. Ce n'est pas une démonstration capturée d'un propriétaire lisant une demande stockée, ni d'un prix altéré depuis le navigateur rejeté.
Étape 1 : Planifier l'estimateur et son contrat de données
Le plan commence avec un forfait page d'atterrissage à 30 000 centimes et une révision SEO à 15 000 centimes. Les quantités sont des entiers de un à dix. En mode Plan, gardez l'estimation publique, la soumission de demande et la relecture privée du propriétaire connectées au même contrat de données. Définissez les ID de service, les prix canoniques, les lignes de demande et l'autorisation avant de générer. Les paiements, les remises et l'envoi automatique d'e-mail sont des fonctionnalités séparées ; ce premier parcours est une demande de renseignements avec une estimation.
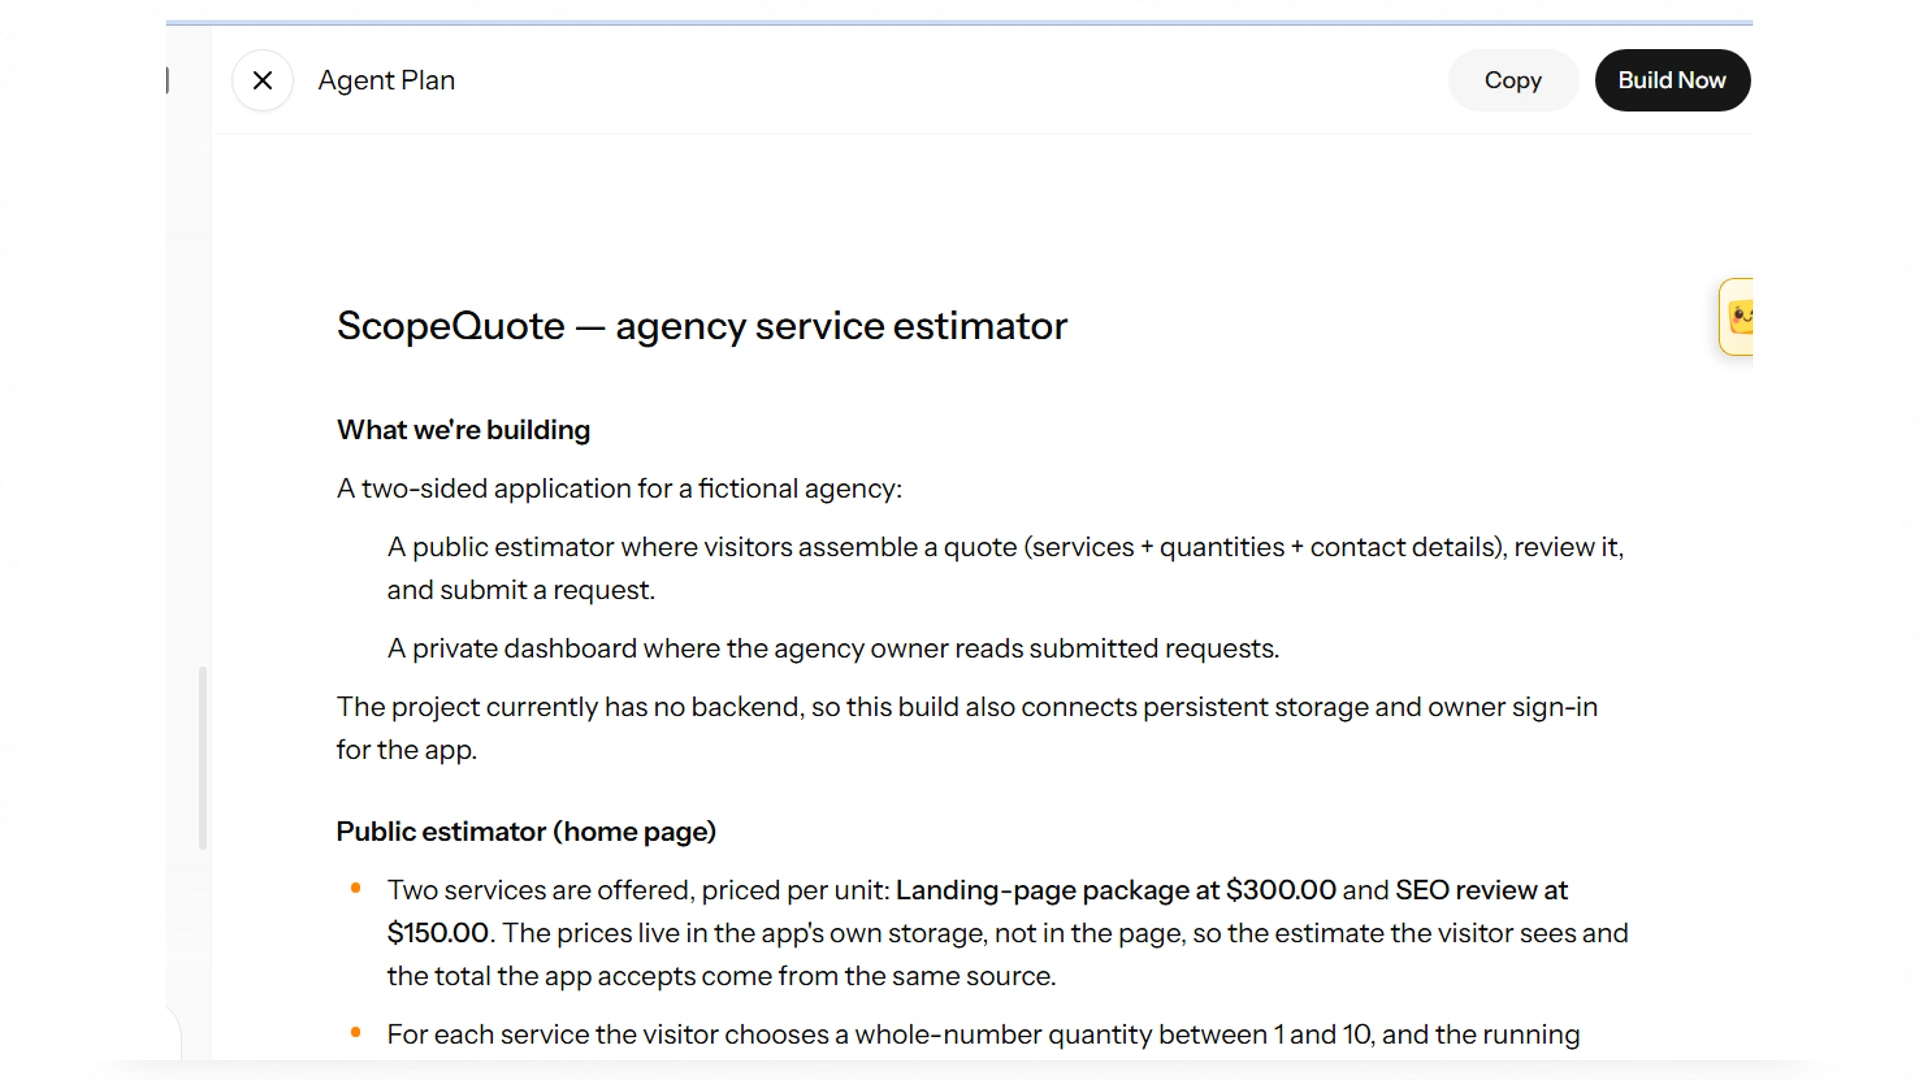
Le plan connecte un estimateur public à une relecture privée du propriétaire. Le stockage et l'autorisation nécessitent des vérifications d'implémentation.
Étape 2 : Construire le parcours client et sécuriser ses enregistrements
L'estimateur capturé sélectionne un forfait page d'atterrissage à 300 $ et une révision SEO à 150 $, produisant un total visible de 450 $. Il étiquette l'action Envoyer la demande et explique qu'aucun paiement n'est prélevé. Cette formulation aide à éviter de confondre une estimation avec une commande payée. Vérifiez les contrôles de quantité, la navigation au clavier et les états de chargement et d'échec aux côtés de l'aperçu. L'image démontre l'arithmétique affichée pour cette sélection ; elle ne révèle pas où le total autorisé est calculé.
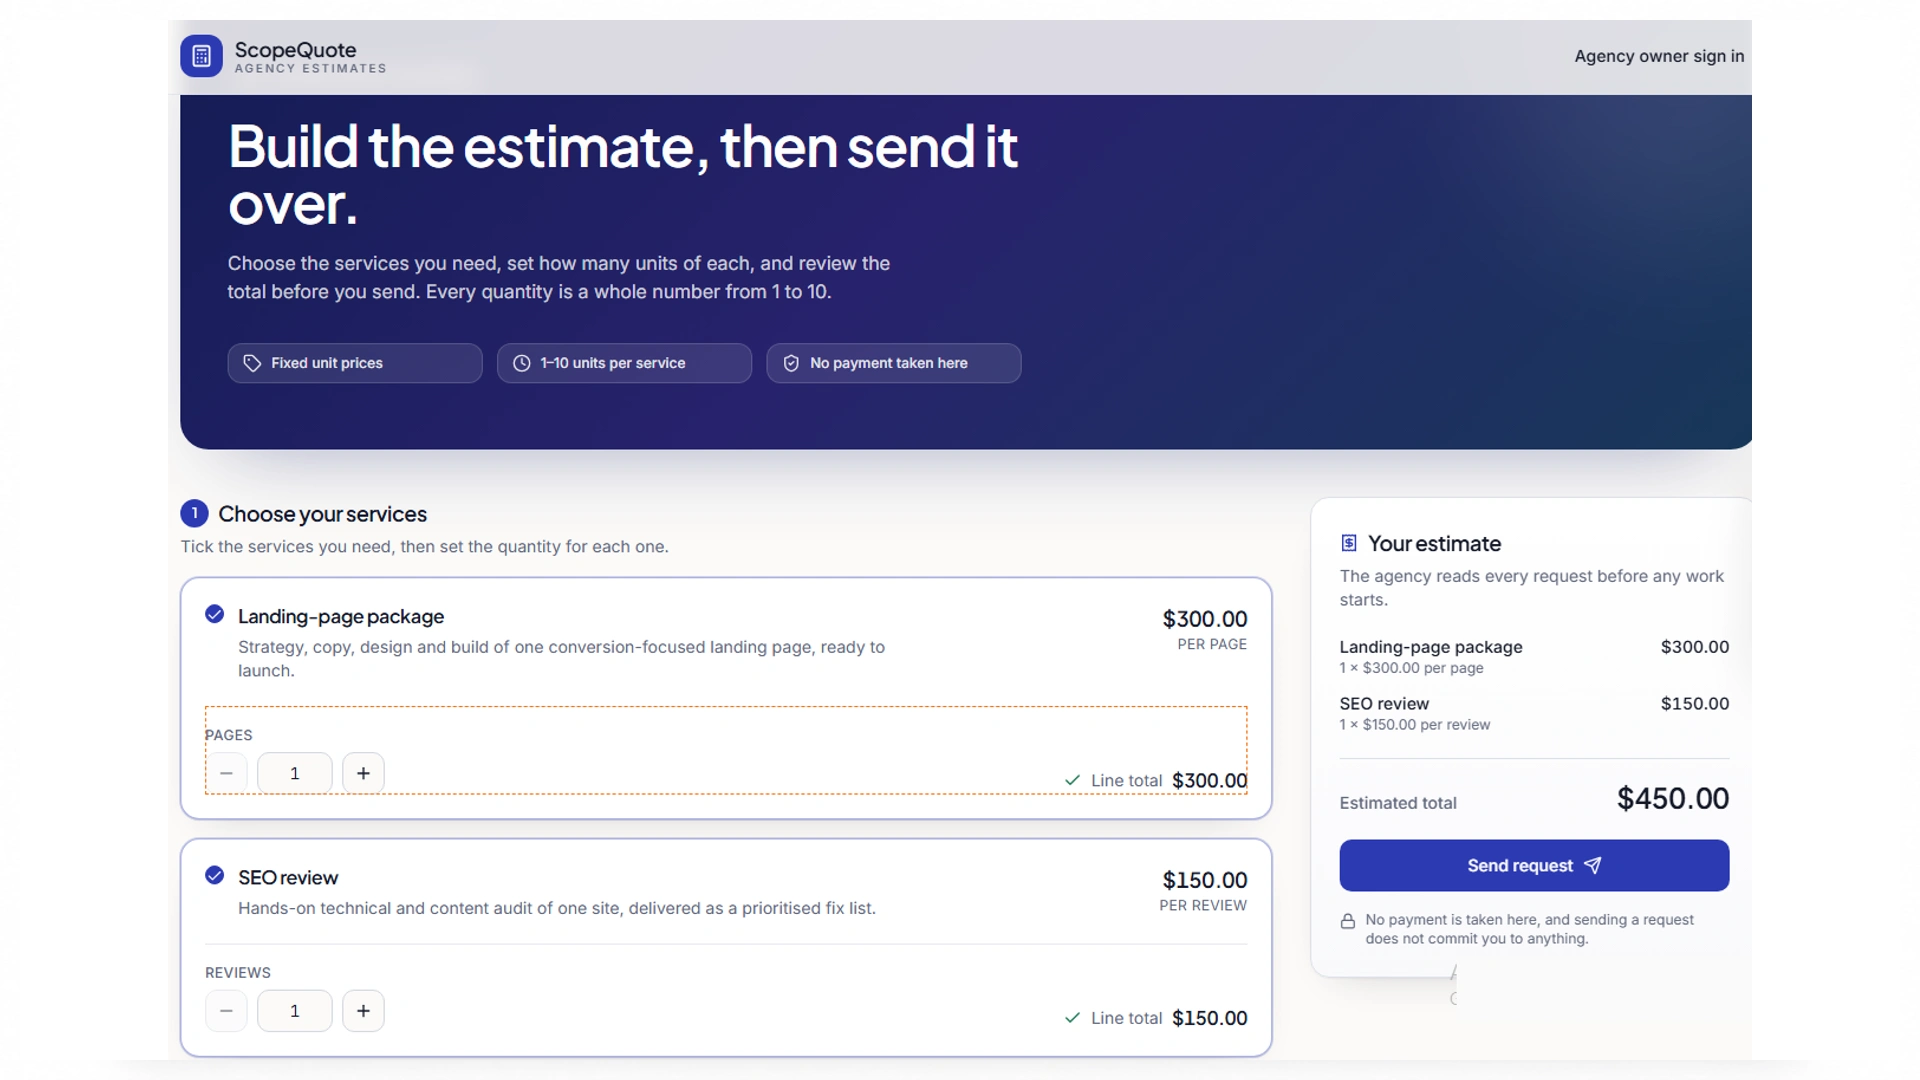
Un forfait page d'atterrissage à 300 $ plus une révision SEO à 150 $ affiche 450 $. Les contours de sélection natifs de l'éditeur font partie de la capture fournie.
Enter Cloud fournit une base de données, une authentification et des capacités de fonctions pour une implémentation de ce flux de travail. Le gestionnaire de soumission devrait charger les prix de service canoniques et calculer les totaux en centimes entiers côté serveur, en rejetant les ID de service inconnus et les quantités invalides même quand le navigateur est contourné. L'écran propriétaire fourni est une porte de connexion. Une porte est une preuve d'interface utile, mais les règles de lecture privée doivent aussi protéger les données de demande sous-jacentes. Ne considérez pas un tableau de bord caché comme une preuve que les demandes directes sont refusées.
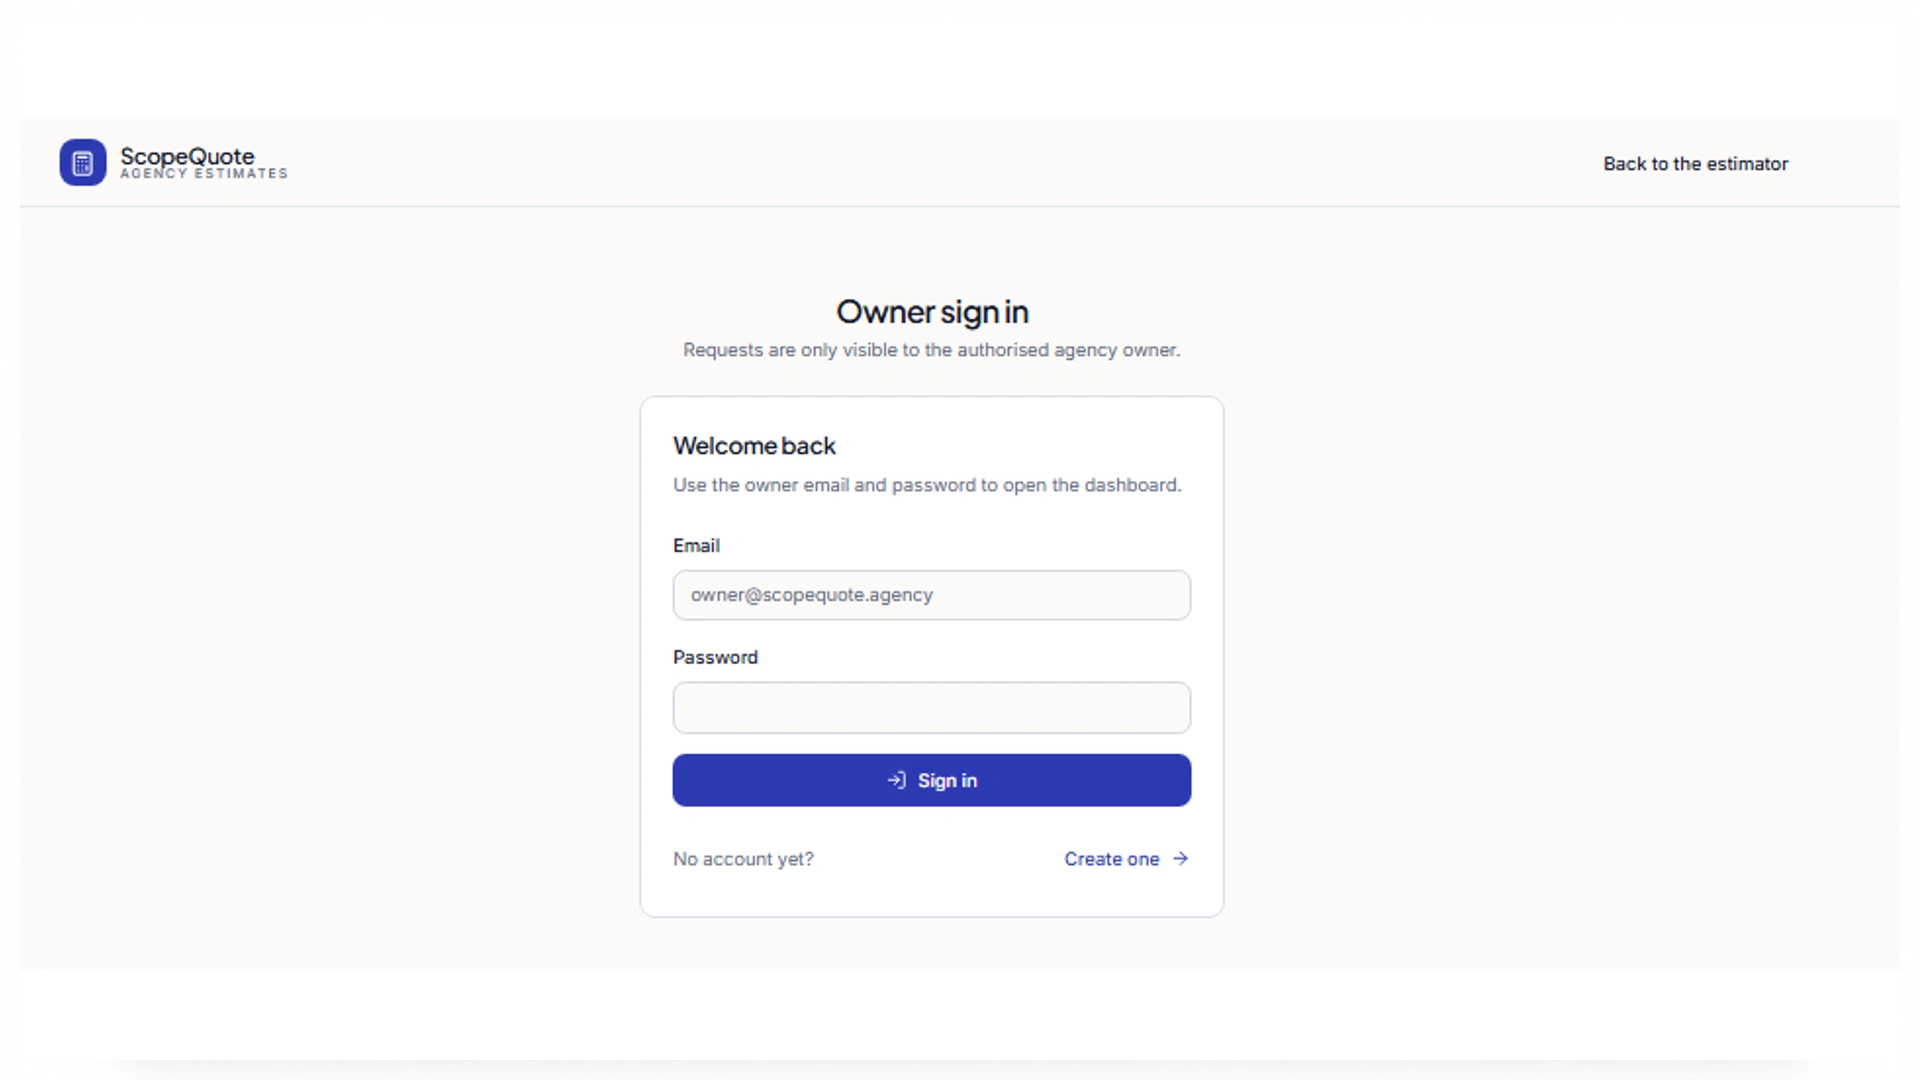
La porte propriétaire est visible. Le refus côté backend des lectures non autorisées nécessite une vérification séparée.
Étape 3 : Vérifier la confirmation et les limites de calcul
La confirmation affiche Demande reçue et montre la référence SQ-2026-1002 avec un total de 450 $. Cela correspond à la sélection visible un-plus-un. La référence est un repère utile pour une relecture ultérieure du propriétaire, mais elle ne prouve pas de manière indépendante une ligne de base de données durable. Ensuite, inspectez la demande stockée correspondante et ses lignes, actualisez la vue propriétaire, et comparez le total serveur. Testez un échec de soumission contrôlé pour qu'une demande rejetée par le backend ne puisse pas quand même produire cet écran de succès.
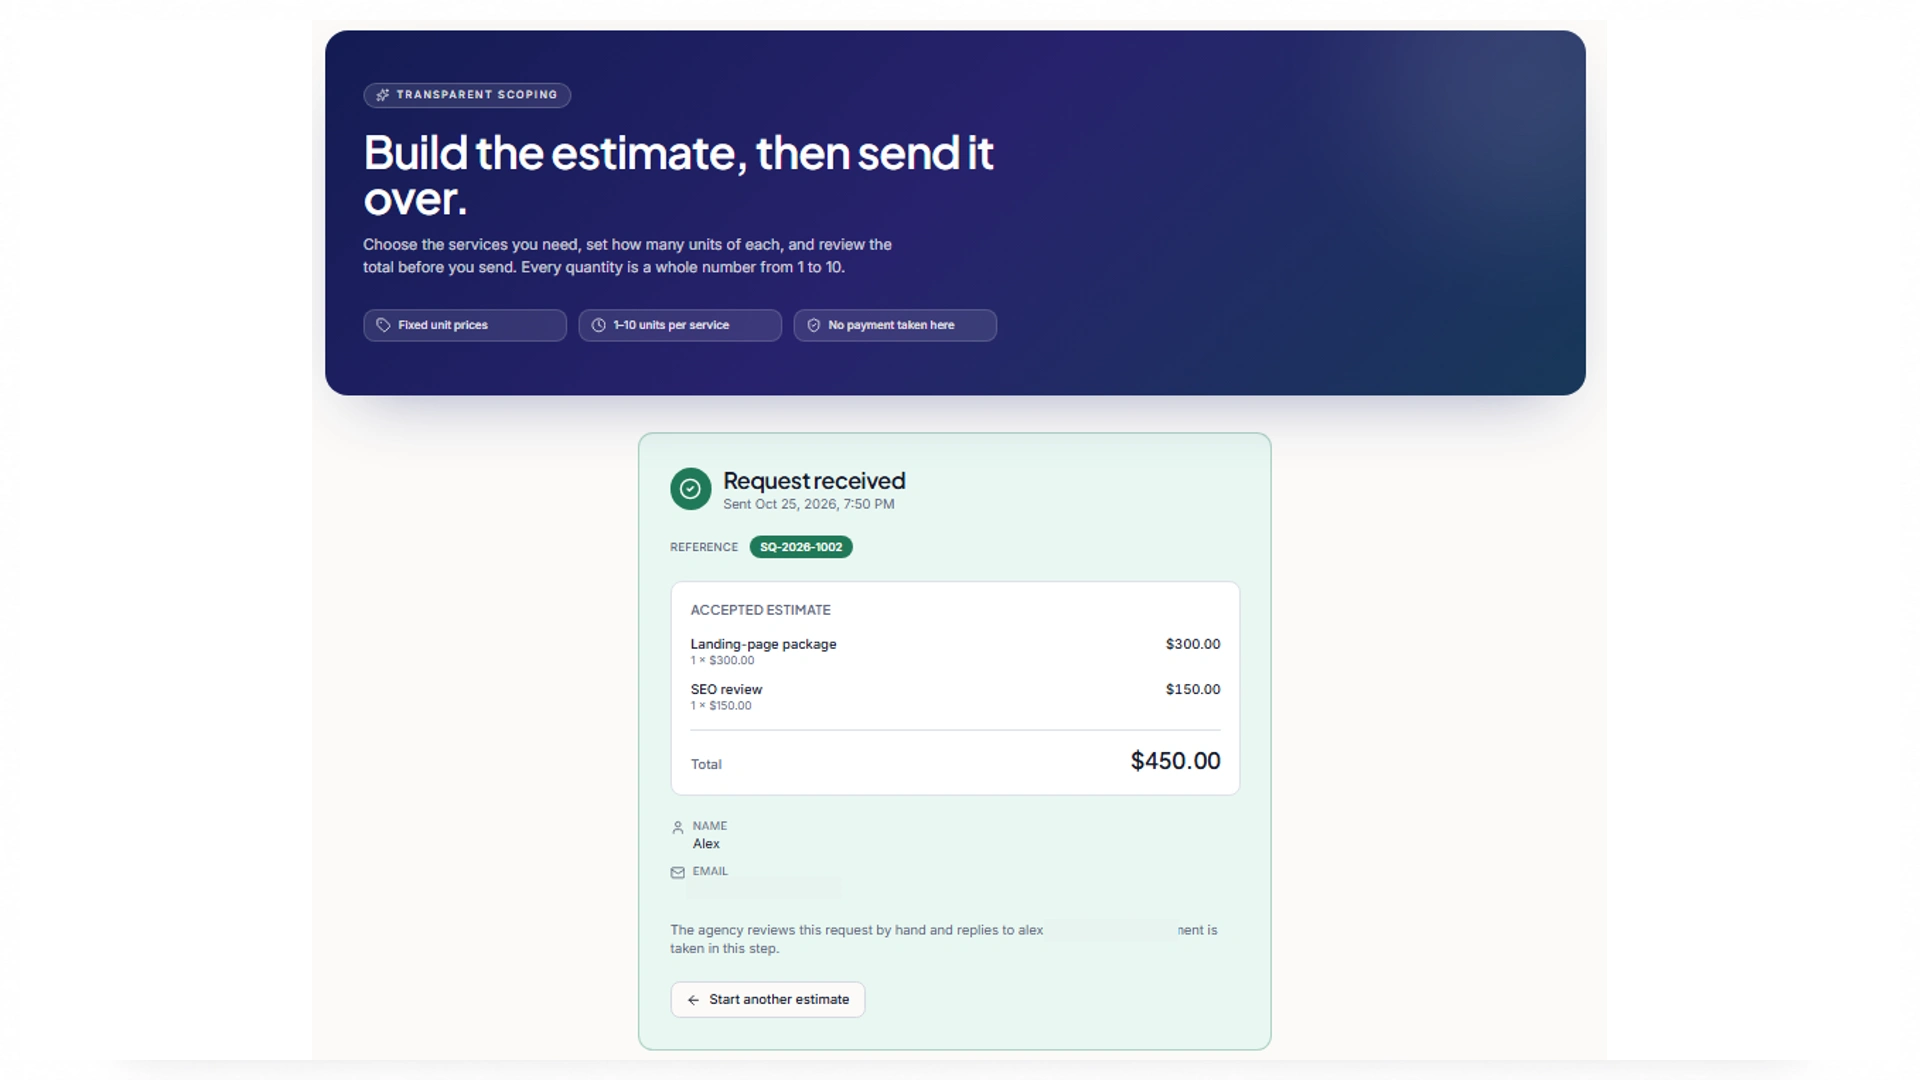
La demande SQ-2026-1002 affiche le même total de 450 $. Les coordonnées sont masquées ; une ligne de base de données sauvegardée n'est pas montrée.
Gardez un cas de calcul supplémentaire distinct du résultat capturé : un forfait page d'atterrissage plus deux révisions SEO devrait totaliser 60 000 centimes, soit 600 $. Puis essayez des quantités nulles, négatives, fractionnaires et excessives. Altérez le prix soumis, répétez un ID de service et demandez un service inconnu. Vérifiez les lectures anonymes et non propriétaires via des demandes directes. Pour les tentatives répétées, utilisez un identifiant de soumission délibéré et déterminez si le serveur renvoie la demande précédemment acceptée ou en crée une nouvelle. Un message de succès seul ne peut pas établir ces propriétés.
Étape 4 : Examiner les preuves et préparer la transmission
La transmission finale devrait inclure les fichiers source, les dépendances, les commandes d'installation, les noms de variables d'environnement, les changements de schéma et les défauts non résolus. La synchronisation GitHub est une voie pour la relecture, pas un résultat démontré par ces images de ScopeQuote. Tenez un bref registre de preuves : l'estimation de 450 $ et la confirmation correspondante sont visibles ; l'application du prix côté serveur, le stockage durable, la récupération par le propriétaire et le comportement en cas de nouvelle tentative ont encore besoin de leurs propres vérifications. Enregistrez les frais réels et le temps de correction en exécutant ces vérifications, afin que votre évaluation couvre le comportement accepté et pas seulement un écran soigné.
Conclusion : choisir le meilleur générateur de code IA
Choisissez le flux de travail qui convient à votre tâche, puis jugez le résultat selon la justesse, l'effort de relecture, le coût total et la qualité de la transmission. Le meilleur générateur de code IA vous aide à maintenir des changements acceptés dans votre propre environnement. ScopeQuote donne à ce principe un exemple concret Enter Pro : une estimation visible et une confirmation correspondante, suivies de vérifications backend claires à compléter avant un usage plus large.
Questions fréquentes sur le meilleur générateur de code IA
Quel est le meilleur générateur de code IA pour un débutant ?
Pour une petite application web, un constructeur hébergé peut réduire la configuration et rendre le résultat plus facile à inspecter dans un aperçu. Si vous apprenez les fonctions ou travaillez dans un dépôt existant, un assistant d'éditeur peut mieux convenir. Choisissez une première tâche que vous pouvez comprendre et vérifier de façon indépendante. Un outil qui explique un petit changement correct est plus utile à un débutant qu'un outil qui génère une application trop complexe à maintenir.
Le meilleur générateur de code IA gratuit peut-il construire une application complète ?
Un prototype limité peut rentrer dans un quota gratuit, mais une application complète a aussi besoin de tests, d'hébergement, de stockage de données et de modifications continues. Ces ressources peuvent avoir des limites ou des frais séparés. Confirmez ce qui se passe quand le quota de génération s'épuise et si l'application publiée continue de fonctionner. L'accès gratuit est une façon raisonnable d'évaluer un flux de travail ; ce n'est pas une garantie de développement illimité ni de fonctionnement gratuit permanent.
Peut-on utiliser du code généré par IA commercialement ?
L'usage commercial dépend des conditions du produit et des licences du code et des dépendances incluses dans votre projet. Vous devriez examiner les deux plutôt que de supposer que la sortie générée n'a aucune restriction. Conservez les mentions de dépendances là où requis et inspectez les paquets inconnus avant de les adopter. Pour une transmission client, documentez les licences pertinentes et les questions de provenance non résolues. L'autorisation d'usage commercial et la qualité de sécurité sont des sujets distincts.
Faut-il des connaissances en programmation pour utiliser ces outils ?
Vous pouvez commencer en décrivant le comportement souhaité, surtout dans un constructeur avec aperçu visuel. Maintenir le résultat demande une compréhension plus poussée : comment les requêtes circulent dans l'application, où les données sont stockées, ce que l'authentification protège, et comment investiguer un échec. Un développeur peut aider pour les changements architecturaux et sensibles à la sécurité. En tant qu'apprenant, travaillez sur des changements que vous pouvez expliquer avant d'élargir la portée.
Un générateur de code peut-il mettre à jour un dépôt existant ?
Oui. Les agents conscients du dépôt peuvent examiner un projet existant et proposer des changements à travers ses fichiers. Leur efficacité dépend de la compatibilité, du contexte pertinent, des permissions et d'un environnement de développement fonctionnel. Démarrez depuis un commit connu, exécutez les vérifications existantes, et demandez un changement borné unique. Vérifiez si le correctif suit les conventions actuelles et préserve le comportement non lié avant d'autoriser une refonte plus large.
Que signifient « meilleur générateur de code par IA » et « meilleure IA de génération de code » ?
Ce sont des ordres de mots de recherche alternatifs pour la même grande catégorie. Aucun des deux n'indique si vous avez besoin d'un extrait, d'un correctif de dépôt ou d'une application hébergée. Commencez par le livrable, l'environnement d'exécution et le processus de relecture, puis comparez les outils au sein de ce flux de travail. Une expression de recherche ne peut pas remplacer un test d'acceptation.
Enter Pro peut-il générer le backend ainsi que l'interface ?
Oui. Enter Cloud fournit des capacités backend incluant une base de données, une authentification et des fonctions. La conception de ScopeQuote utilise ces capacités pour les demandes stockées et les calculs autorisés. Les captures fournies montrent l'estimateur, la confirmation et la porte de connexion propriétaire ; elles ne vérifient pas le gestionnaire ni les enregistrements privés. Inspectez la validation backend et les politiques d'accès avant d'utiliser le projet généré pour de vraies demandes.
Un développeur peut-il poursuivre un projet Enter Pro plus tard ?
Oui. L'intégration GitHub d'Enter Pro offre une voie pour la relecture de code et la collaboration entre développeurs. La transmission devrait aussi couvrir les instructions d'installation, les dépendances, les variables d'environnement, les migrations et les services backend. L'accès au dépôt ne transfère pas automatiquement les données hébergées ni les secrets. Un développeur devrait pouvoir exécuter le projet et comprendre ses exigences externes avant d'assumer la responsabilité des mises à jour.





