Meilleure IA pour Coder : Comparatif par Tâche, Coût et Workflow
Comparez les meilleures IA pour coder selon le workflow, les modèles, les limites des offres gratuites et les coûts réels, avec un exemple d'app Enter Pro testée en détail.
La meilleure IA pour coder est l'outil qui vous aide à finaliser une modification que vous pouvez comprendre, relire et maintenir. Une simple suggestion de fonction, une réparation à l'échelle d'un dépôt entier et une application fonctionnelle demandent des types d'assistance différents. Choisir en fonction d'un seul score de modèle peut masquer l'éditeur, les outils d'exécution, les limites d'usage et le travail de relecture qui déterminent le résultat final.
Je préfère présélectionner en fonction du travail à faire, puis effectuer une petite comparaison sur des tâches représentatives. Ce guide distingue les outils des modèles, compare six environnements de développement, examine l'accès gratuit et les preuves publiées, puis explique une méthode d'évaluation reproductible. Vers la fin, le projet FixTrack réalisé dans Enter Pro réunit les vérifications de création d'application via une interface privée de suivi des tickets, avec des résultats visibles clairement distingués des vérifications backend restant à effectuer.
Quelle Est la Meilleure IA pour Coder Selon Votre Travail Réel ?
Choisir la meilleure IA pour coder commence par la tâche et l'environnement que vous devez conserver. Un assistant adapté à un dépôt déjà établi peut être un meilleur choix qu'un générateur d'application pour un ticket de maintenance. Un créateur d'applications dans le navigateur peut supprimer le travail de configuration pour un nouveau prototype. Ce qui suit constitue des points de départ pour l'évaluation, et non un classement de performance mesuré.
Conservez votre éditeur et votre workflow GitHub : évaluez GitHub Copilot pour les suggestions, les questions sur le code et les tâches de dépôt déléguées.
Examinez et modifiez plusieurs fichiers : comparez Cursor, Claude Code ou Codex en utilisant le même instantané de dépôt et les mêmes tests d'acceptation.
Essayez un environnement centré sur l'agent : évaluez Google Antigravity selon son éligibilité de compte actuelle, les modèles pris en charge et les limites de débit.
Créez un prototype dans le navigateur : comparez le workflow de projet de Replit avec un espace de travail de création d'applications comme Enter Pro, notamment les exigences en matière de données et de déploiement.
Les meilleurs outils IA pour coder peuvent se recouper sur ces tâches. Évitez de payer plusieurs abonnements avant d'avoir identifié une tâche concrète qu'un outil gère mieux dans votre workflow.
Pour répondre à la question « quelle est la meilleure IA pour coder ? », utilisez une tâche que vous savez déjà évaluer. Un débutant peut prédire le résultat d'une petite fonction ; un mainteneur peut reproduire un bug ; un fondateur peut suivre une action client complète. Cette référence connue évite que des explications fluides remplacent des preuves réelles. Conservez une implémentation manuelle classique ou un test existant comme référence quand c'est possible, afin de voir si l'assistance a réellement permis de gagner du temps après relecture et correction.
Distinguer le Modèle, l'Outil et l'Agent
Un Modèle Produit le Raisonnement et le Code
Un modèle reçoit des entrées et génère des sorties. Un outil ajoute l'interface et le contexte du projet. Un agent combine le modèle avec une boucle d'exécution capable d'inspecter des fichiers, d'exécuter des commandes et de réviser le travail. Deux produits proposant un modèle similaire peuvent quand même se comporter différemment, car ils fournissent un contexte, des outils, des permissions et un retour différents.
Le Contexte et la Vérification Comptent Autant que la Génération
Une large fenêtre de contexte est une capacité, pas une preuve que les bons fichiers ont été utilisés. Pour un bug de connexion, le contexte utile comprend la route défaillante, la configuration d'authentification, les tests pertinents et le comportement attendu. Une explication convaincante sans échec reproduit ni modification inspectée est une preuve plus faible qu'une correction ciblée qui passe un test significatif.
Pour une modification touchant plusieurs fichiers, demandez à l'agent d'identifier la route, le schéma, l'appelant et le test existant avant de modifier quoi que ce soit. Comparez ensuite sa cartographie avec le dépôt réel. S'il manque un helper partagé ou invente un chemin de fichier, corrigez le contexte avant l'implémentation. Les meilleurs outils IA pour coder sont utiles en partie parce qu'ils raccourcissent cette phase d'investigation, mais un résumé confiant ne suffit pas. Le contexte pertinent doit apparaître dans le patch réel et dans la vérification.
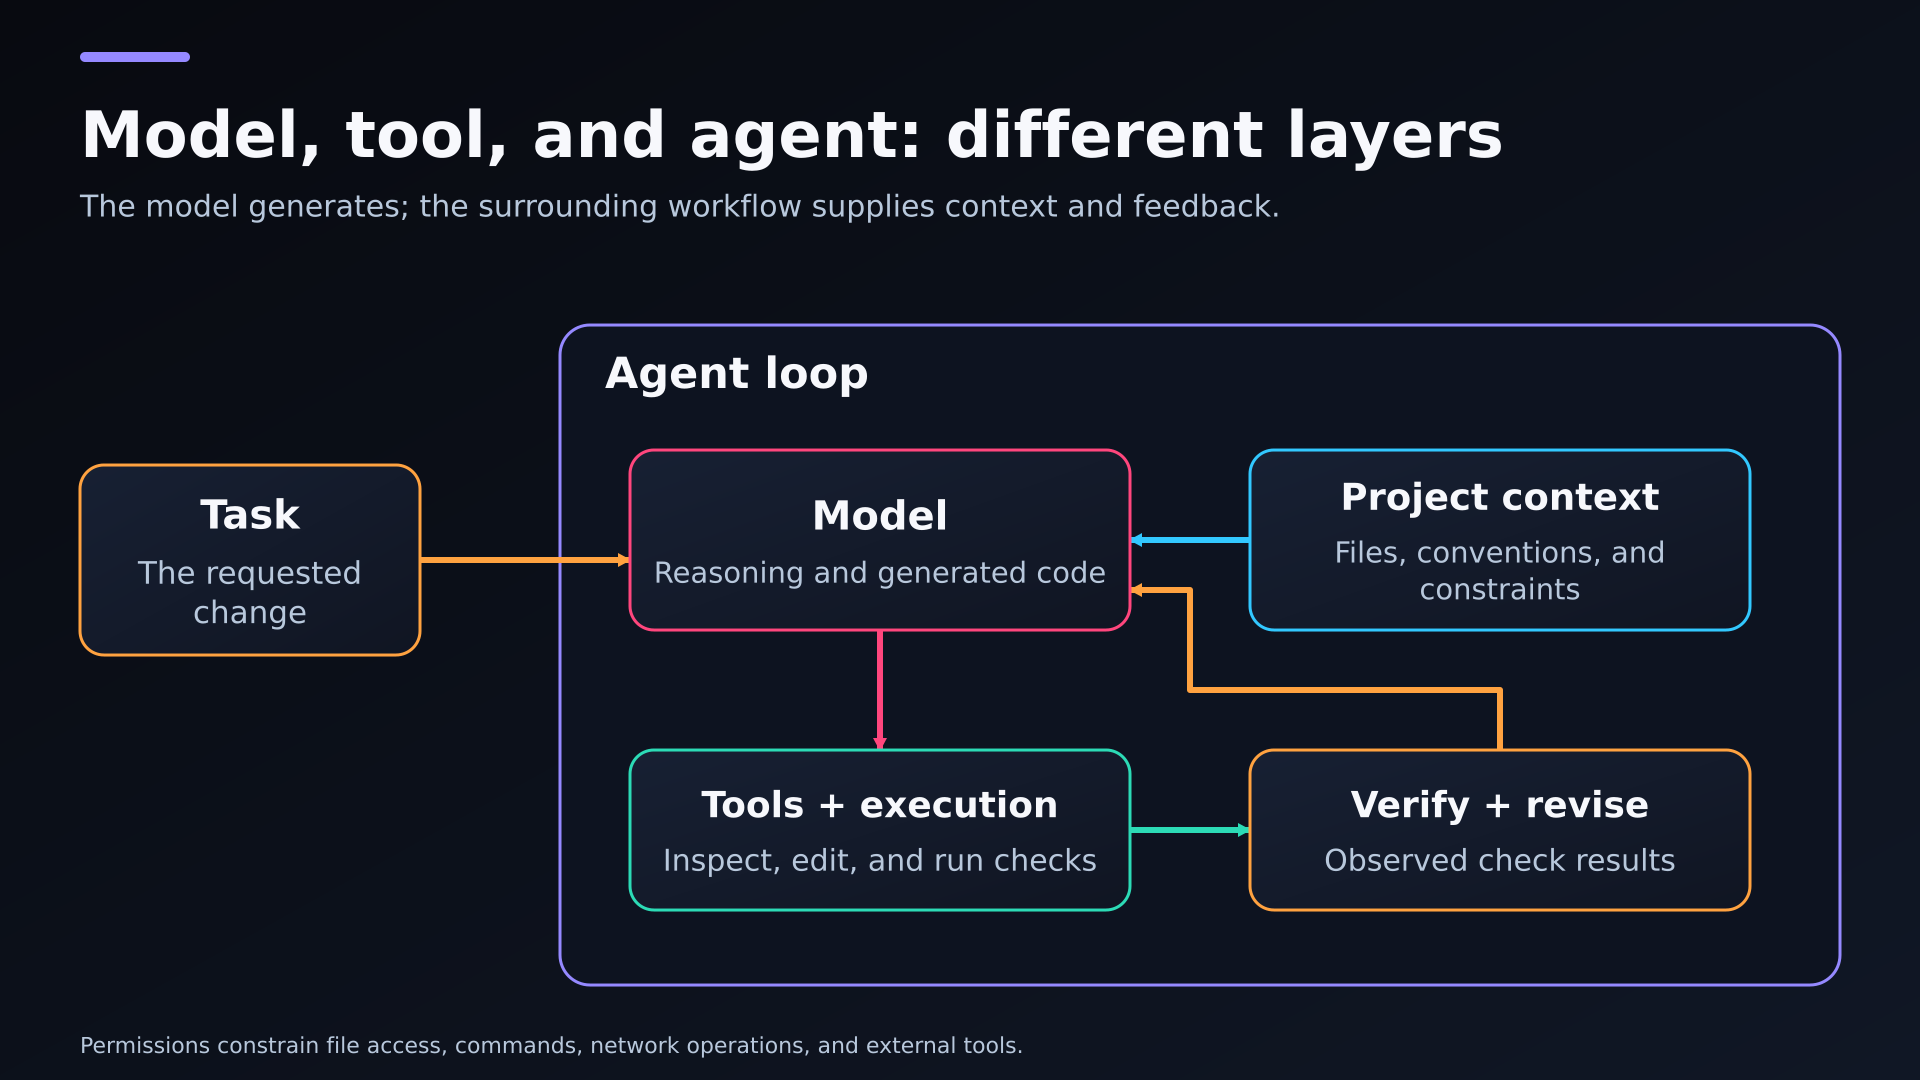
Une boucle conceptuelle d'agent montrant le contexte du projet, un modèle, l'exécution d'outils et la vérification.
Comparer Six Outils d'IA pour Coder Selon Leur Environnement de Travail
GitHub Copilot pour un Éditeur et un Workflow de Dépôt Existants
Copilot propose des suggestions en ligne, des questions sur le code, de la relecture et des tâches agentiques au sein des workflows de développement pris en charge. C'est un candidat utile lorsque vous souhaitez une assistance autour d'un éditeur, d'un ticket ou d'une pull request existants. Évaluez les fonctionnalités disponibles dans votre forfait et votre éditeur sélectionnés ; le mode agent local et une pull request créée dans le cloud sont des capacités différentes.
Un essai utile consiste à demander un helper avec une signature de type établie et des appelants proches. Vérifiez si les suggestions suivent les conventions du projet plutôt que d'introduire une autre bibliothèque de validation. Essayez ensuite une question sur le dépôt qui nécessite de suivre un import à travers plusieurs modules. Traitez l'assistance en ligne et les tâches déléguées comme des résultats distincts ; un outil peut être pratique pour l'une même si vous préférez un autre agent pour des modifications plus larges.
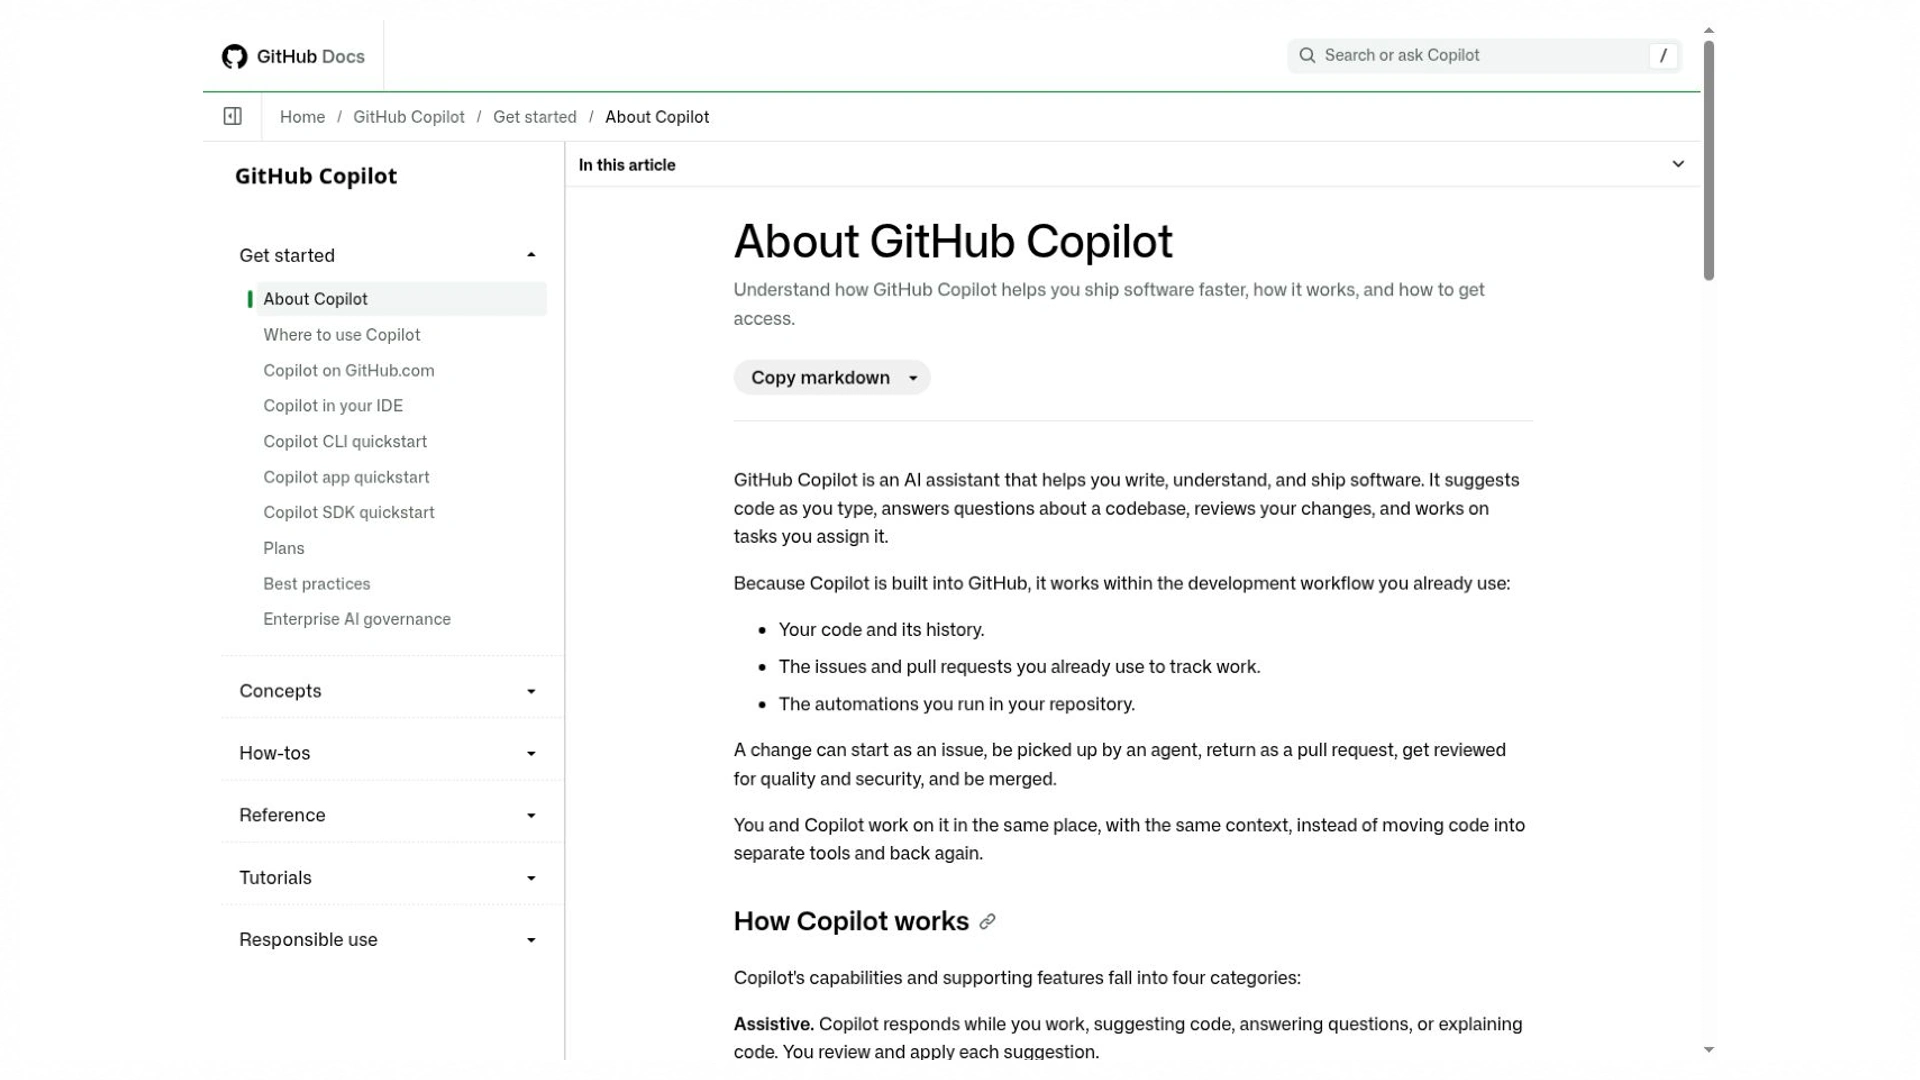
L'aperçu décrit l'assistance et les workflows d'agent pris en charge. La disponibilité des fonctionnalités dépend de l'environnement documenté et du forfait.
Cursor pour Planifier et Relire des Modifications à l'Échelle d'un Projet
La documentation de Cursor couvre la compréhension du dépôt, la planification, l'implémentation, le débogage et la relecture des modifications. Envisagez-le lorsque la tâche traverse plusieurs fichiers et que vous souhaitez relier ces activités entre elles. Donnez-lui le comportement défaillant et les conventions du dépôt, puis inspectez le diff obtenu. Vérifiez le modèle actuel et les modalités d'usage au lieu de supposer qu'un ancien abonnement inclut un accès illimité à des modèles tiers.
Par exemple, un interrupteur de paramètres peut nécessiter un état de composant, une route de mise à jour serveur et une préférence persistée. Demandez à Cursor de préserver les schémas actuels de récupération de données et de validation, puis inspectez ces trois points. Une simple case cochée ne suffit pas. Gardez une vérification du comportement après rechargement afin que la tâche ne se termine pas sur une interaction séduisante qui disparaît dès que la page est actualisée.
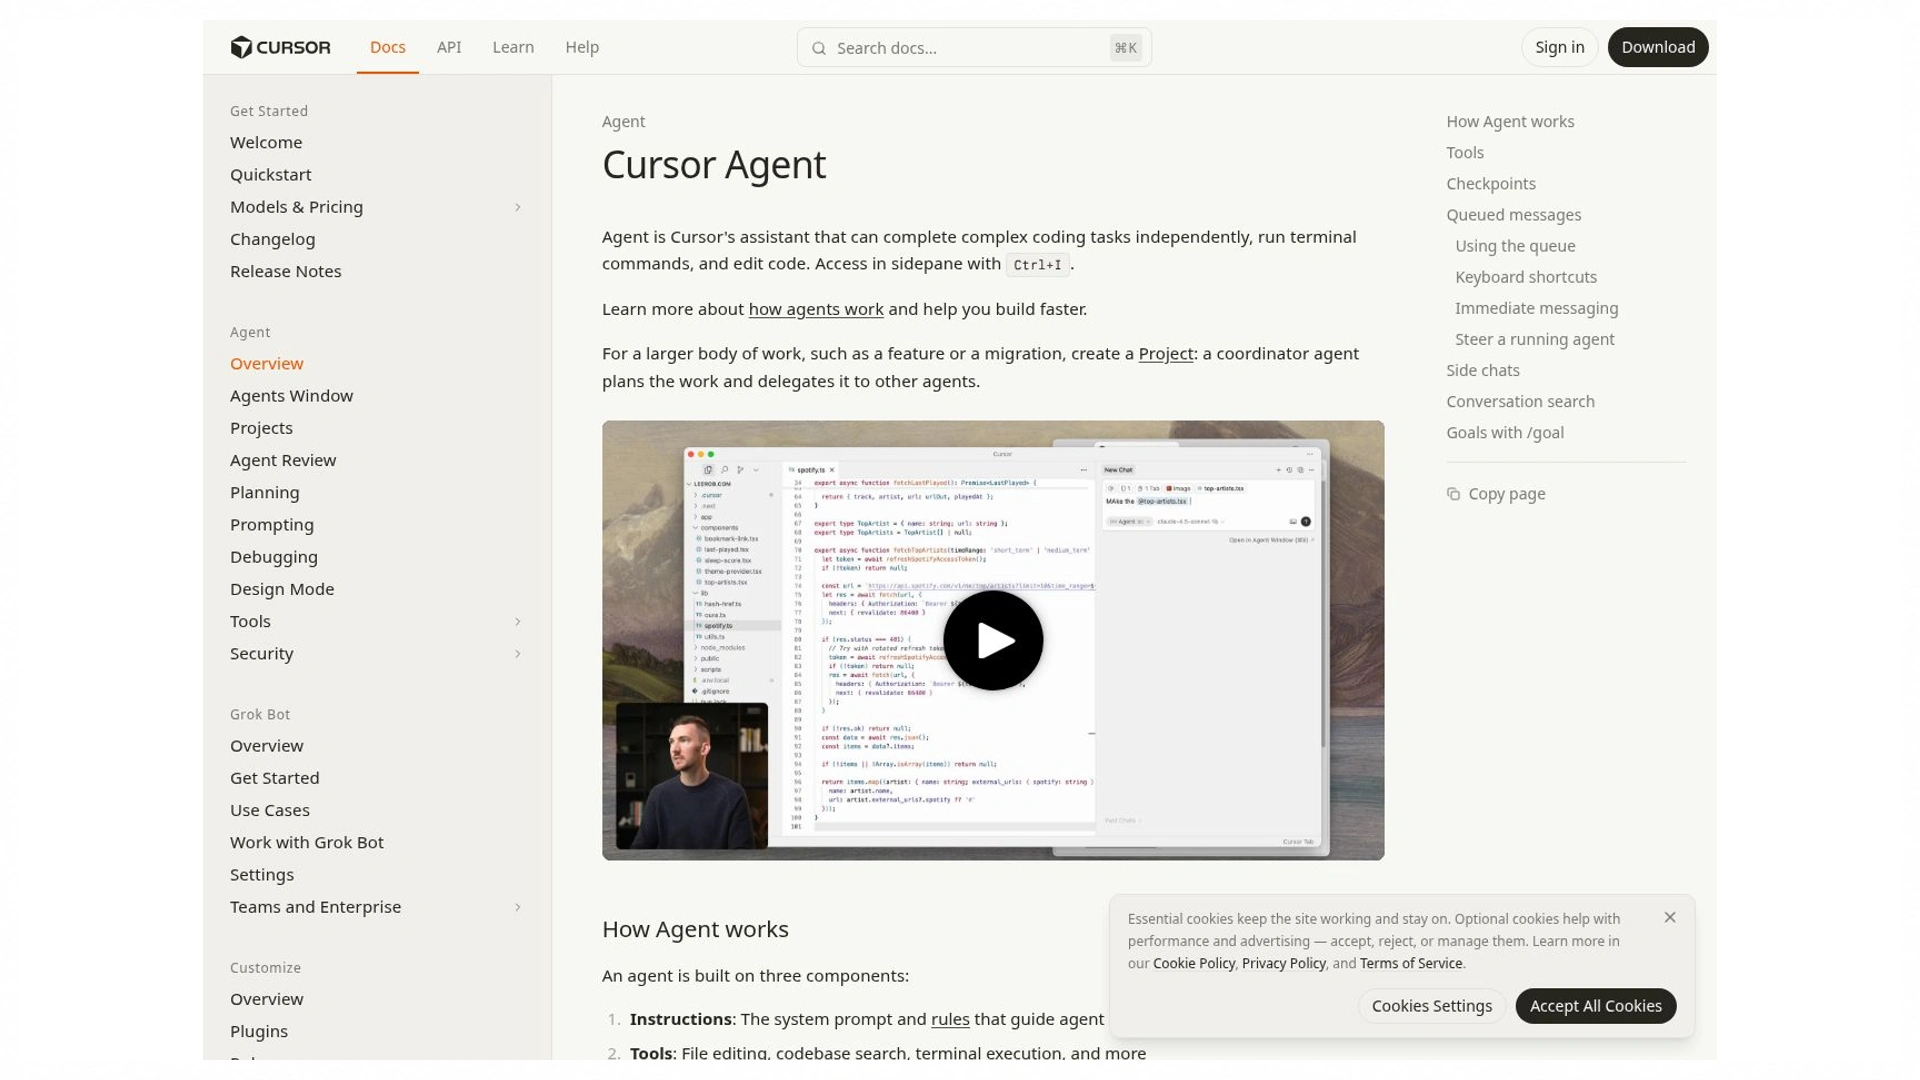
Documentation officielle de Cursor
L'aperçu de l'agent décrit la planification, l'implémentation et les capacités de workflow associées. Il s'agit d'une capture de documentation, pas d'un résultat de codage mesuré.
Source : cursor.com · capturé le 25 octobre 2026
Claude Code pour un Développement Basé sur les Fichiers et les Commandes
Claude Code lit le code, modifie les fichiers, exécute des commandes et fonctionne via le terminal, l'IDE, l'application de bureau et le navigateur. C'est un candidat intéressant pour explorer des modules peu familiers ou coordonner un refactoring circonscrit. Demandez-lui d'identifier les dépendances et le plan de vérification avant de les modifier. Sa capacité à exécuter une commande ne prouve pas que cette commande ou l'architecture proposée soit pertinente.
Une tâche orientée terminal peut commencer par la commande défaillante et une reproduction concise. Donnez à l'agent l'environnement habituel du projet et demandez-lui d'identifier la cause avant de proposer un refactoring. Relisez les opérations shell et les nouvelles dépendances de la même manière que le code. Le succès d'une commande de test n'est utile que si l'assertion pertinente existe toujours et que l'environnement ressemble à celui que vous déployez.
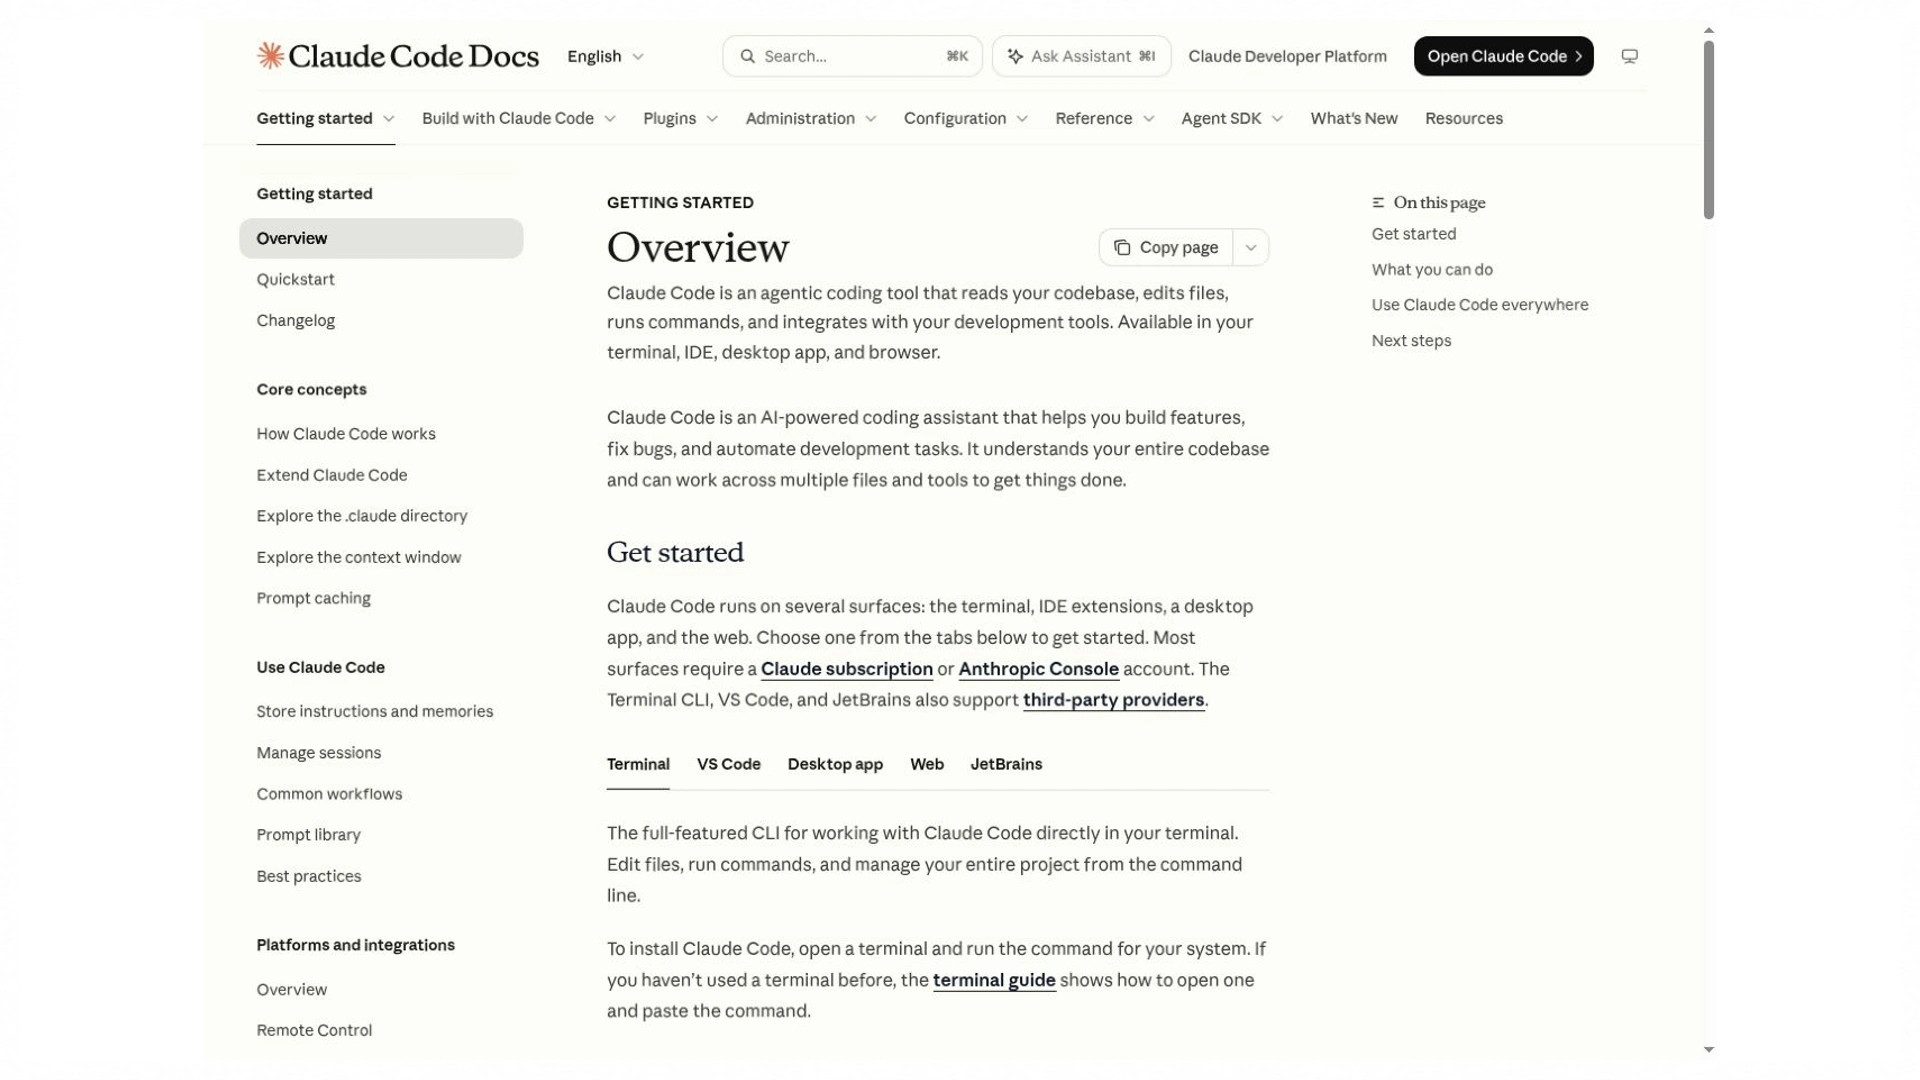
L'aperçu explique ses surfaces de développement et son workflow basé sur les fichiers et les commandes. Il n'établit pas de classement de performance.
Codex pour Déléguer une Tâche Logicielle Bien Délimitée
Codex combine des modèles de codage avec un harnais pour le contexte, l'utilisation d'outils, l'exécution et les limites de relecture. Son application, son CLI et son extension IDE prennent en charge différentes façons de travailler. Une tâche d'évaluation utile a un résultat énoncé, des fichiers pertinents et des vérifications qui peuvent échouer. Comparez le patch terminé et le travail de relecture restant, plutôt que la longueur de l'explication de l'agent.
Pour Codex, gardez le résultat délimité : réparez une régression, mettez à jour un petit contrat d'API ou ajoutez un test ciblé. Identifiez les fichiers ou services qu'il peut modifier et le comportement qui doit rester compatible. Une transmission utile inclut le patch, la sortie de vérification et les limites non résolues. Le développeur décide toujours si l'implémentation correspond à l'architecture du dépôt et au processus de publication.
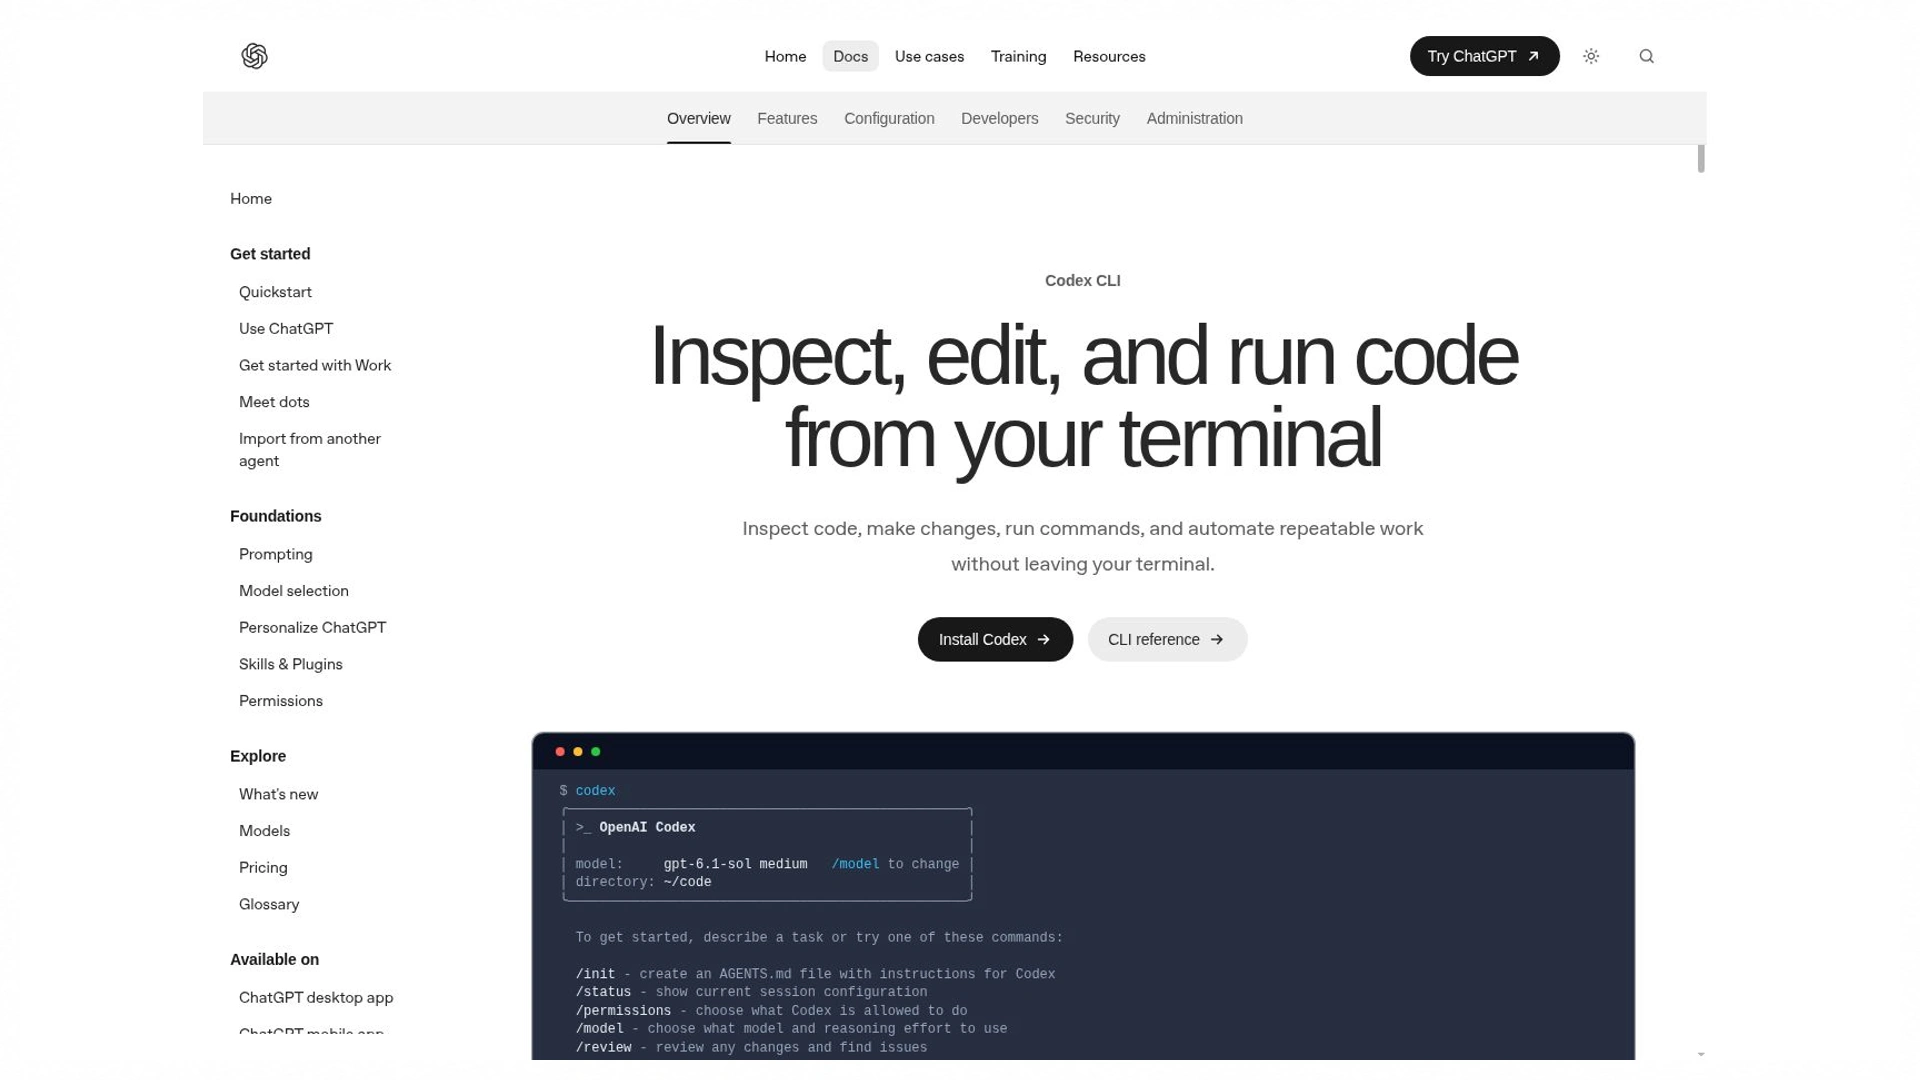
Le CLI est une voie documentée pour une tâche de codage délimitée. Vérifiez les paramètres d'exécution et relisez le patch obtenu.
Google Antigravity pour un Workflow Centré sur l'Agent
Antigravity documente un workflow de développement centré sur l'agent à travers ses surfaces prises en charge. Envisagez-le lorsque vous souhaitez évaluer ensemble la planification, l'exécution et la relecture, puis vérifiez la configuration actuelle, l'éligibilité du compte et les quotas. Demandez-lui d'examiner un problème reproductible et inspectez les artefacts et le diff obtenus. La capacité d'un produit à coordonner plusieurs activités ne prouve pas qu'il accomplit correctement votre tâche spécifique ni qu'il nécessite moins de supervision.
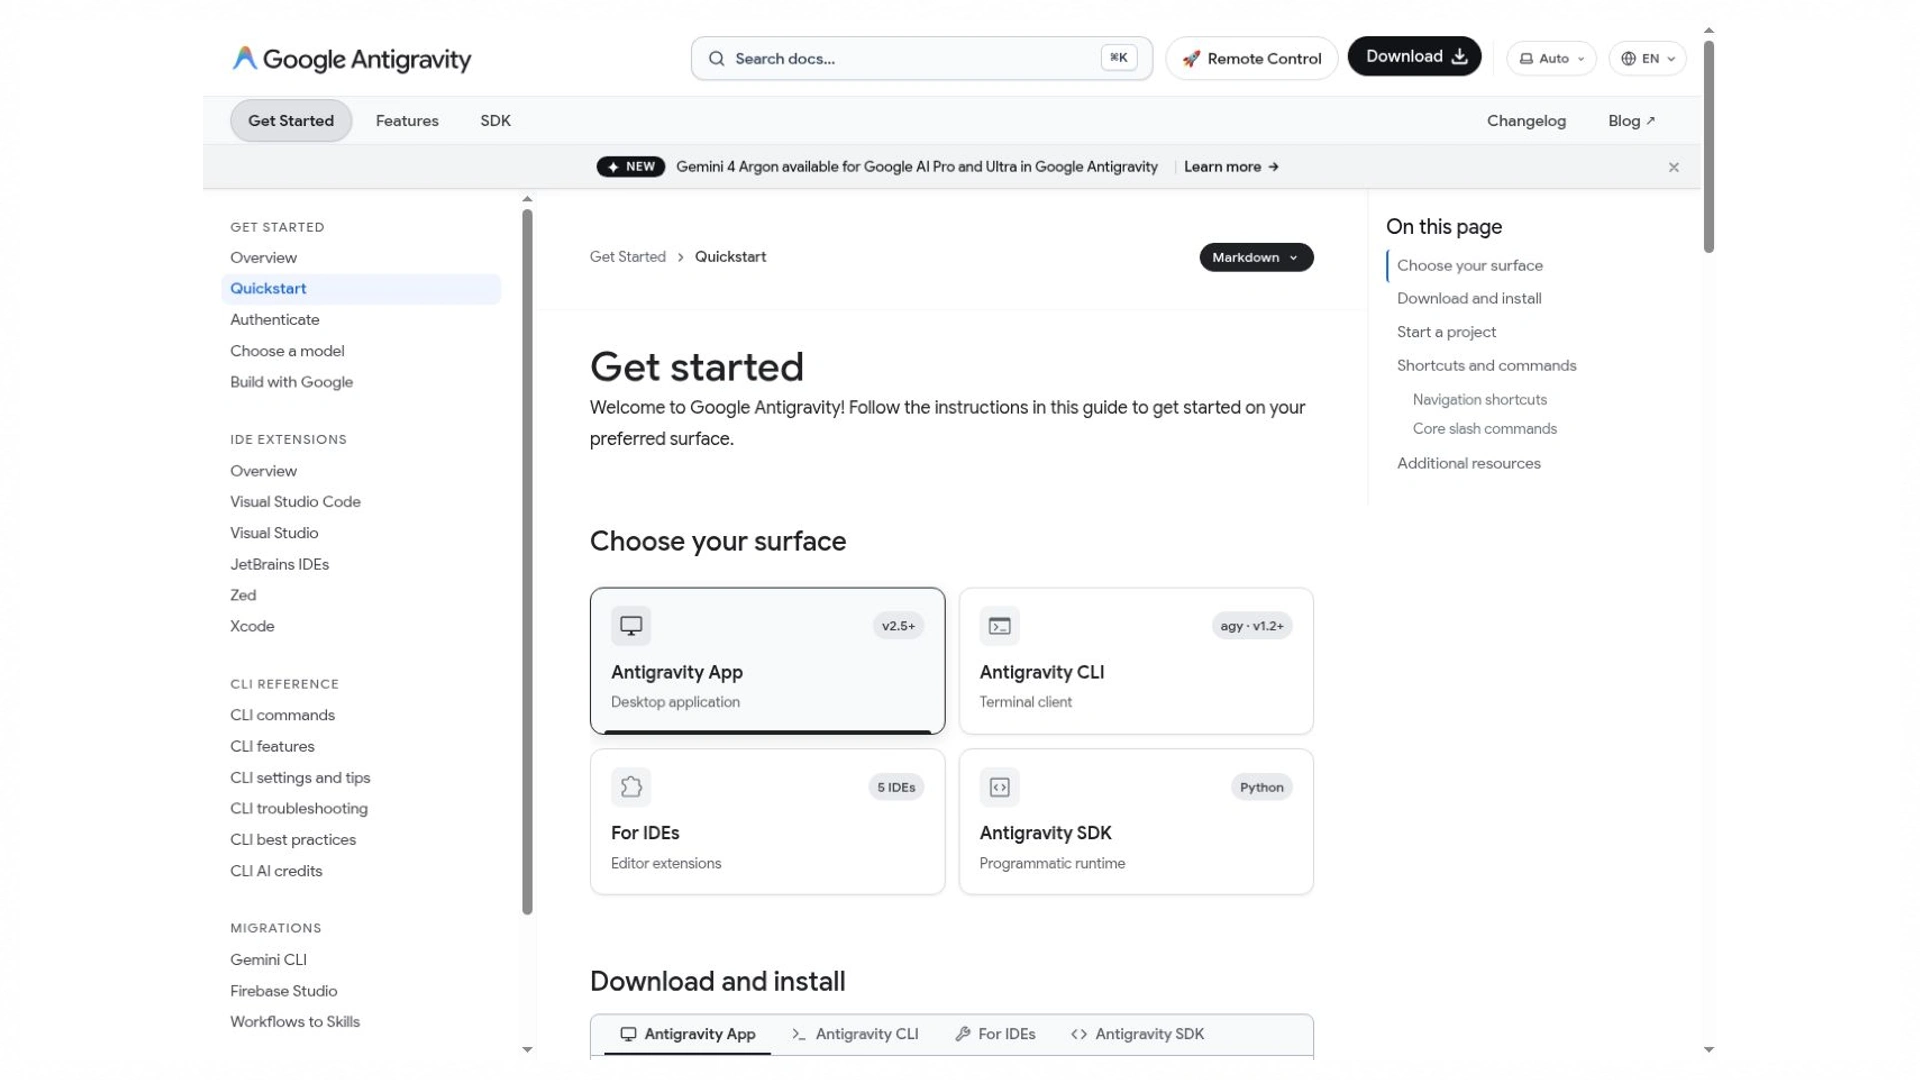
Le guide de prise en main décrit la configuration et le workflow de l'agent. Confirmez les modalités actuelles du compte avant un essai.
Replit pour Démarrer et Publier un Projet dans le Navigateur
Replit Agent peut générer du code, mettre en place l'infrastructure du projet et aider à tester et publier une application dans son espace de travail. Évaluez-le lorsque la configuration de l'environnement local constitue un obstacle. Examinez la pile technique réellement générée, la persistance des données et le comportement de publication. Vérifiez séparément les frais d'usage et les exigences opérationnelles ; un aperçu séduisant ne démontre pas à lui seul une application fiable.
Pour un prototype hébergé, rouvrez la route publiée dans une session distincte et inspectez sa destination de données. Les fixtures de développement, le stockage de prévisualisation et les enregistrements de production peuvent différer. Conservez les redirections d'authentification et les noms de variables d'environnement dans les notes de transmission. Ces détails déterminent souvent si l'application reste utilisable une fois la session de génération initiale terminée.
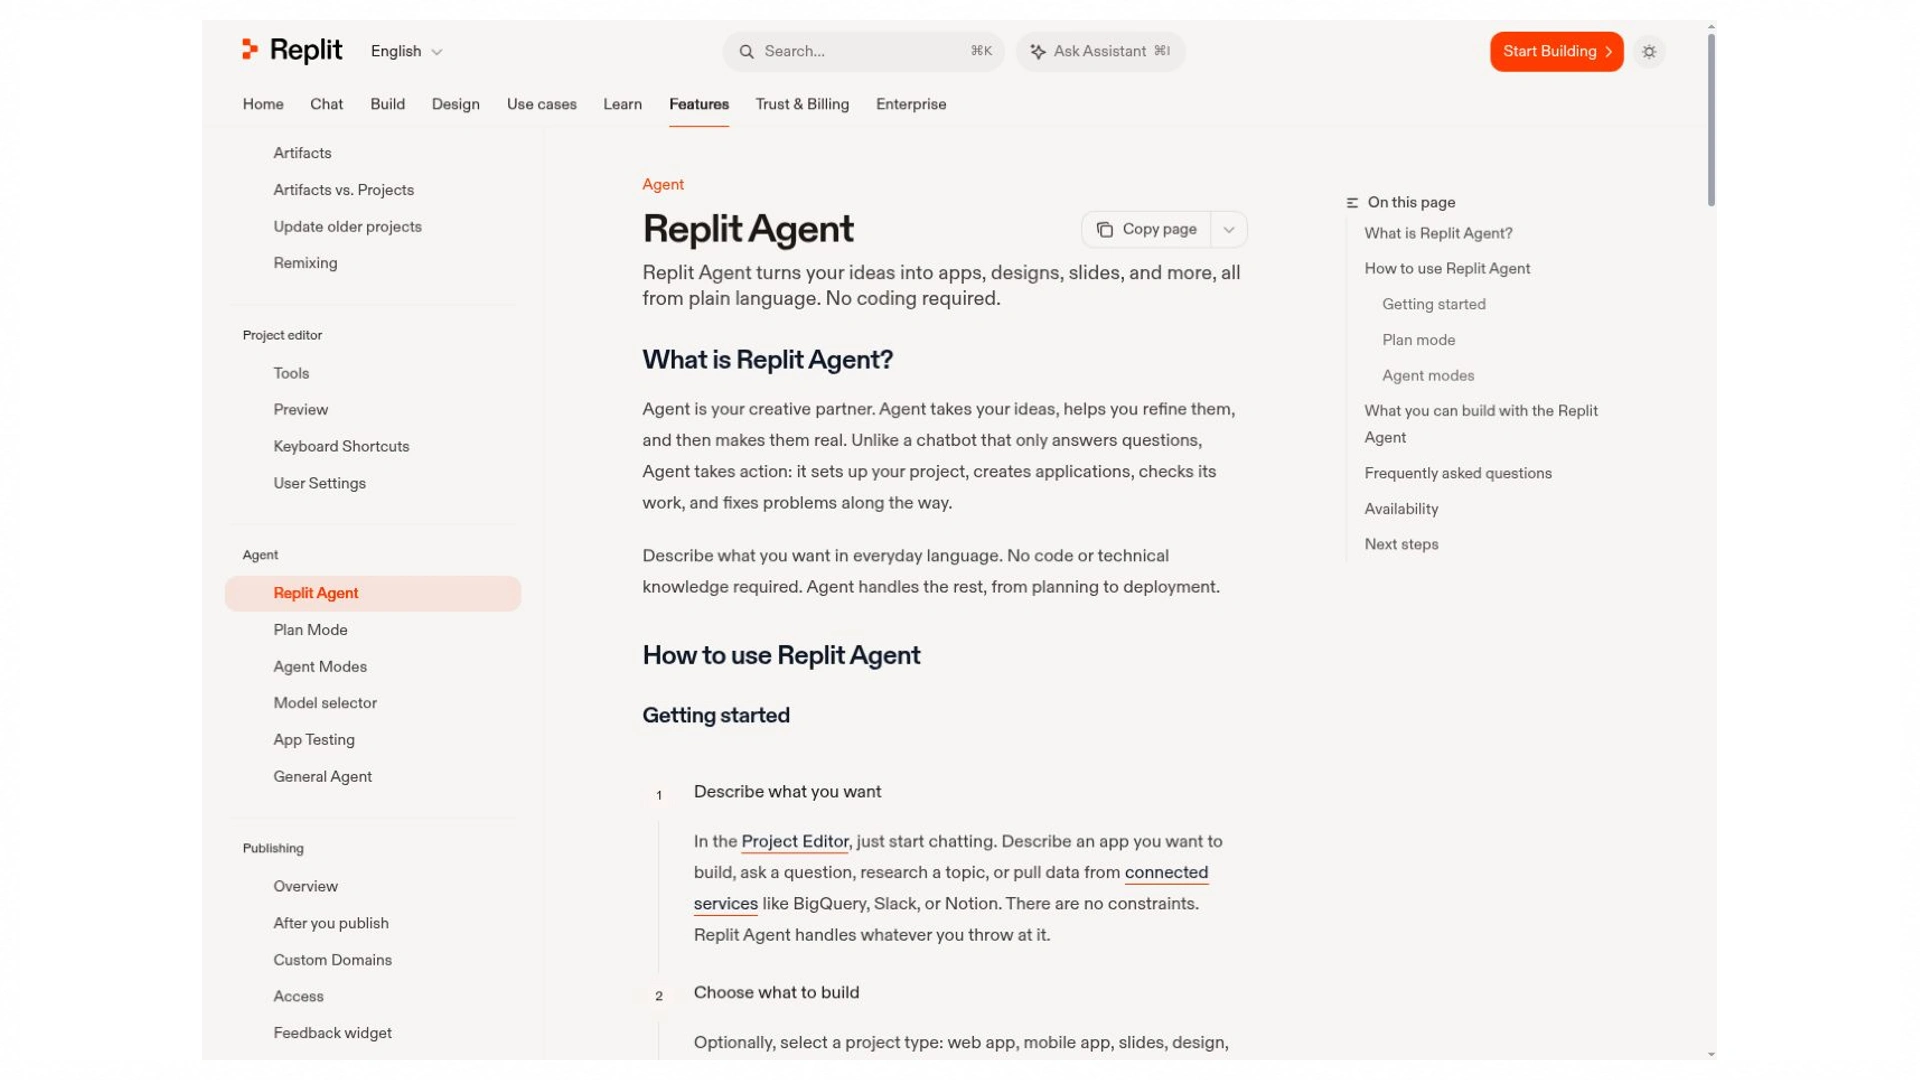
La documentation décrit le workflow de projet hébergé. L'aperçu, la publication et l'usage des ressources nécessitent leurs propres vérifications.
Comparez chaque candidat selon les quatre mêmes questions : Où s'exécute-t-il ? Que peut-il inspecter ? Que peut-il exécuter ? Comment vérifier et conserver le travail ? Parmi les exemples : une réparation d'un vieux dépôt Python, un écran de paramètres React, une migration SQL défaillante et un petit tableau de bord interne. Ces exemples testent des points forts différents sans nécessiter quatre études de cas distinctes.
Choisir le Meilleur Modèle IA pour Coder Grâce à une Vérification au Niveau de la Tâche
Utiliser les ID de Modèles Actuels Plutôt que d'Anciennes Appellations Produit
Choisissez les ID de modèles exposés dans votre outil et votre compte réels. La documentation actuelle d'OpenAI identifie GPT-6.1 Sol comme un candidat pour le codage complexe ; d'autres fournisseurs proposent aussi des modèles avec des compromis différents en matière de raisonnement, de latence et de prix. La disponibilité dans un produit de chat ne garantit pas la disponibilité via votre agent de codage. Notez l'ID exact sélectionné, tout routage automatique et les réglages d'effort. Ce sont des candidats pour votre pilote, pas des résultats d'un test comparatif réalisé pour cet article.
Le meilleur modèle IA pour coder peut différer entre une transformation ciblée et une investigation difficile dans un dépôt. Essayez d'abord le modèle par défaut, puis une option de raisonnement plus capable sur les cas qu'il rate. Conservez les mêmes entrées et vérifiez si la latence et le coût supplémentaires produisent une amélioration acceptée. Un modèle plus grand ou plus coûteux n'est pas automatiquement un meilleur choix pour chaque tâche répétée.
Lire les Benchmarks en Tenant Compte de Leurs Conditions de Test
SWE-bench Verified contient 500 problèmes logiciels filtrés par des humains. Ses résultats concernent un cadre d'évaluation précis, pas tous les langages ou toutes les tâches de création d'application. Notez la variante du benchmark, la configuration de l'agent, la version du modèle et la date avant de comparer les scores. La collection de codage fournie par OpenRouter mesure l'usage récent de tokens sur son service ; la popularité d'usage n'est pas un benchmark de justesse.
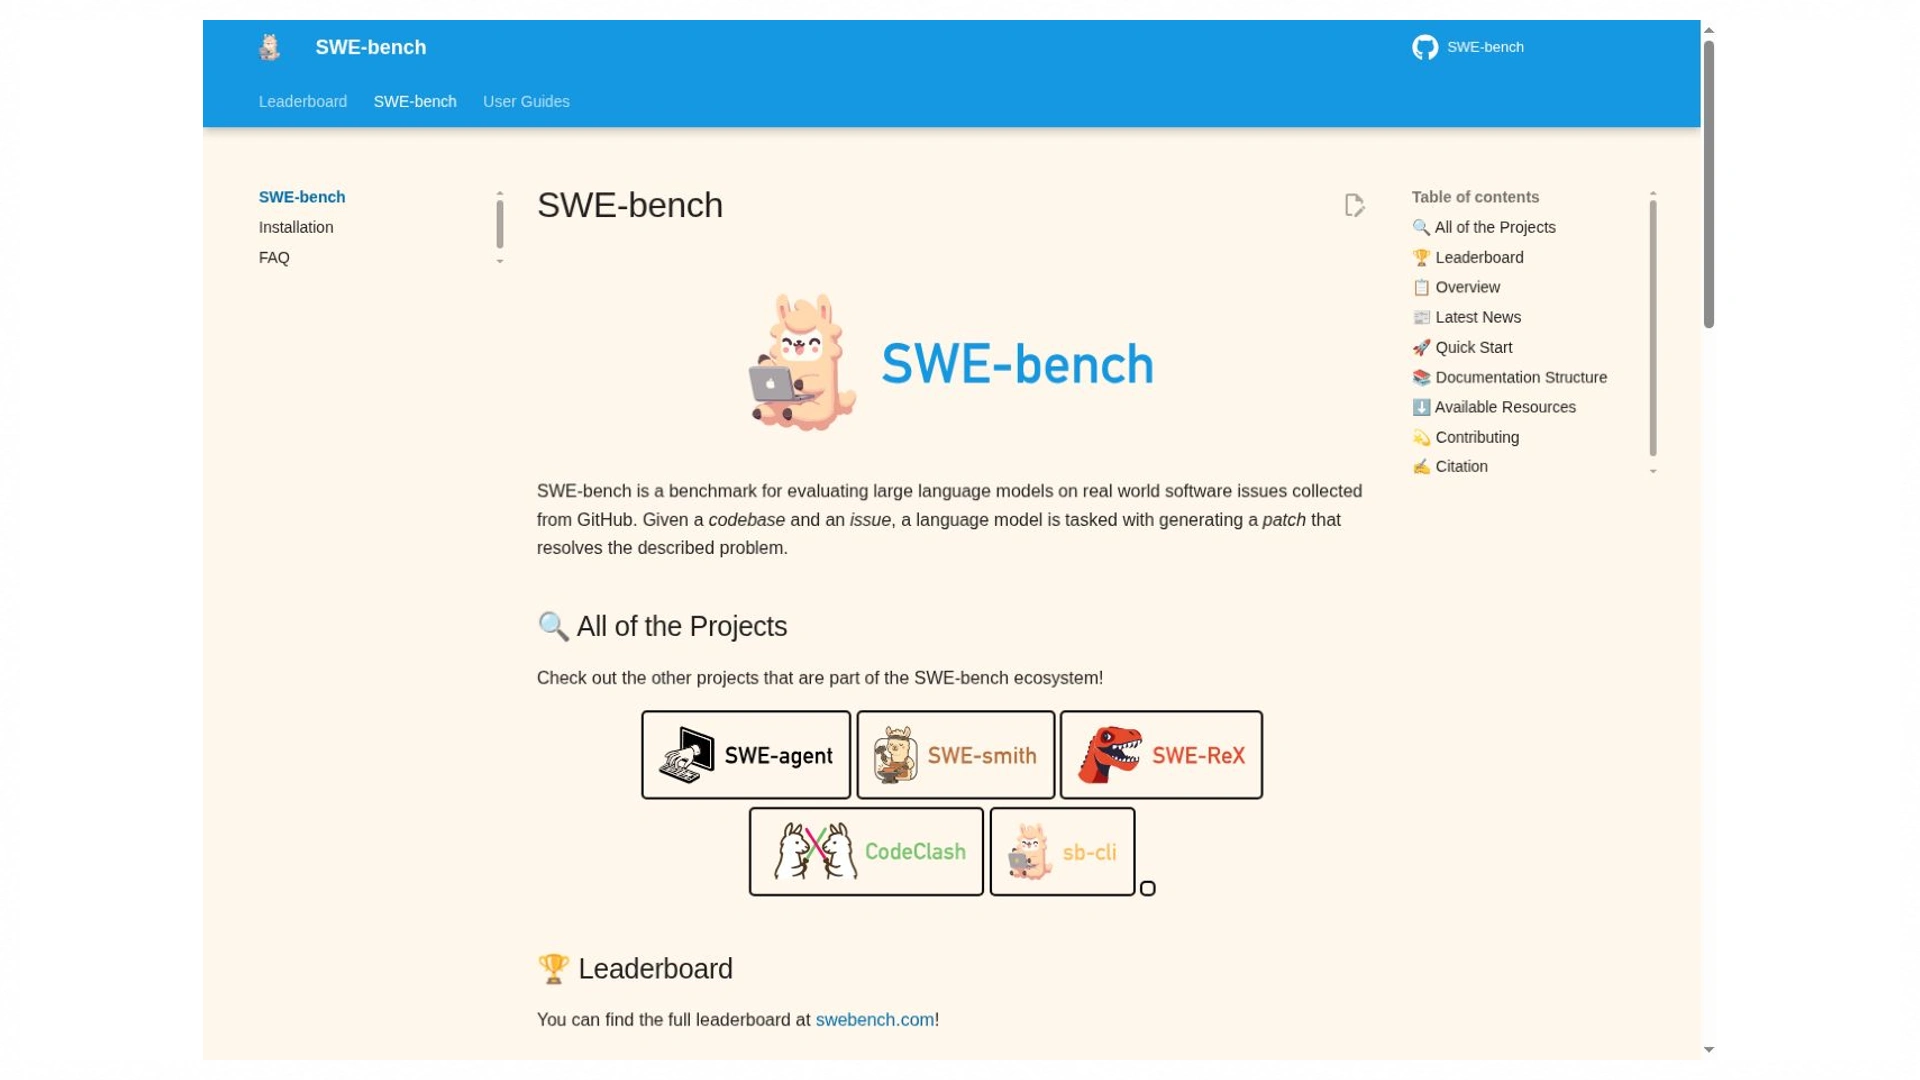
Page officielle du projet SWE-bench
Les variantes de benchmark et les conditions d'évaluation comptent. Les scores publiés ne remplacent pas une tâche réalisée dans votre propre dépôt.
Source : www.swebench.com · capturé le 25 octobre 2026
Trouver la Meilleure IA pour Coder Gratuite, Sans Frais d'Abonnement
Distinguer un Forfait Gratuit de l'Usage d'Agent Inclus
Les pages officielles actuelles décrivent un accès gratuit limité pour des produits comme GitHub Copilot et Cursor. La disponibilité et les limites d'Antigravity dépendent aussi des modalités de compte documentées. Vérifiez la fonctionnalité que vous allez utiliser : les complétions en ligne, le chat, les actions d'agent et l'exécution hébergée peuvent avoir des quotas différents. Une interface d'outil gratuite peut quand même invoquer un fournisseur payant. Datez la vérification et inspectez l'usage restant après une tâche complète, plutôt que de supposer qu'un ancien quota mensuel s'applique toujours.
Une recherche de meilleure IA pour coder gratuite est la plus utile lorsque vous définissez l'intégralité du workflow gratuit. Incluez l'éditeur, les appels au modèle, l'environnement d'exécution et toute ressource hébergée. Un modèle local peut supprimer une facture de fournisseur mais nécessite quand même un matériel capable et une configuration adéquate. Gardez le premier essai suffisamment petit pour tenir dans le quota actuel, puis vérifiez ce que coûterait un usage continu ou une publication.
Inclure le Temps de Relecture, les Essais Répétés, l'Hébergement et les Coûts d'API
Un calcul utile est le coût par tâche acceptée = frais d'outils et d'usage attribuables divisés par le nombre de tâches acceptées, en suivant le temps de relecture séparément. À titre d'illustration, 12 $ de frais attribuables pour quatre tâches acceptées donnent 3 $ par tâche. Ce calcul est hypothétique. Incluez les tentatives échouées dans les frais et définissez « acceptée » avant de tester, afin qu'une fonctionnalité visuellement terminée mais cassée ne compte pas.
Juger la Productivité à Partir de Preuves Plutôt que du Volume Produit
Utiliser les Statistiques de Recherche dans Leur Périmètre d'Origine
Dans l'enquête 2025 de Stack Overflow, 46 % des répondants à cette question se méfiaient de la précision des outils IA et 33 % lui faisaient confiance. Cela mesure la confiance déclarée, pas les défauts du code. Cela soutient une question pratique pour votre pilote : combien de vérification et de correction le résultat nécessite-t-il avant que vous puissiez l'utiliser ?
L'expérience de METR au début de 2025 a impliqué 16 développeurs expérimentés et 246 tâches, et a constaté que les tâches prenaient 19 % plus de temps avec les outils étudiés. Sa mise à jour de février 2026 a signalé des problèmes de sélection et de mesure qui rendent l'expérience ultérieure peu fiable pour estimer l'effet actuel. Aucun des deux résultats n'établit une perte ou un gain de vitesse universel pour les outils d'aujourd'hui.
Consigner la Justesse, le Travail de Relecture et le Délai Jusqu'à une Modification Acceptée
Pour identifier la meilleure IA pour coder dans votre projet, notez le commit de départ, le prompt, le modèle, le plan, le temps écoulé, le temps de relecture actif, les frais et les défauts restants. Lancez chaque candidat à partir d'une copie propre. Répétez des tâches représentatives quand c'est possible et notez les échecs. Un pilote court peut orienter un achat, mais il ne peut pas justifier un pourcentage de précision universel ni l'affirmation qu'un produit est toujours le plus rapide.
Utilisez des vérifications obligatoires avant les scores de confort. Un endpoint qui expose l'enregistrement d'un autre utilisateur échoue même si son patch est petit et son explication excellente. Après la justesse, comparez les minutes de relecture active, les interruptions et la charge de maintenance. Conservez une trace des exécutions infructueuses au lieu de ne rapporter que la meilleure tentative. Cela rend un petit pilote plus informatif, sans prétendre qu'il représente tous les dépôts ou tous les développeurs.
Décider Quelle IA Est la Meilleure pour Coder Selon Votre Situation
Faire Correspondre l'Exemple au Travail à Accomplir
Apprendre une fonction : demandez une explication, prédisez son résultat, puis modifiez-la sans assistance.
Réparer un bug : fournissez une reproduction et le résultat attendu ; conservez la vérification défaillante comme couverture de régression.
Modifier plusieurs modules : demandez un traçage des dépendances et un petit patch avant une réécriture large.
Créer un prototype : vérifiez l'action client complète, la destination des données et les règles d'accès.
Travailler sur du code propriétaire : vérifiez la gestion des données et les contrôles organisationnels du forfait applicable avant d'accorder l'accès au dépôt.
Cela fait de la meilleure IA pour coder une décision que vous pouvez expliquer : le candidat respecte vos contraintes et exige un travail de relecture acceptable sur des tâches représentatives. Conservez les preuves et une voie de transmission viable à mesure que le projet grandit.
Pour décider quelle IA est la meilleure pour coder, incluez le chemin de récupération de votre équipe. Un autre développeur peut-il reprendre le projet, inspecter le diff et continuer sans le chat original ? Conservez les décisions d'architecture, les vérifications et la configuration dans le dépôt. Pour la meilleure IA pour le vibe coding, cette même question compte dès qu'un prototype commence à stocker de vraies données : la facilité de génération doit conduire à une application que vous pouvez comprendre et maintenir.
Évaluer Enter Pro en Créant un Suivi de Tickets Privé
Pour les lecteurs évaluant la meilleure IA pour le vibe coding, FixTrack fournit un exemple concret de création d'application avec Enter Pro. Le plan définit des tickets appartenant à chaque utilisateur et leurs changements de statut, tandis que l'aperçu fourni montre un ticket fictif de priorité élevée au statut Ouvert. Cela vous donne une interface inspectable et un petit ensemble de vérifications d'acceptation. Les images ne montrent pas de test avec un second compte, d'enregistrement backend capturé, ni un ticket passant avec succès au statut Résolu.
Étape 1 : Planifier le Suivi de Tickets et Ses Vérifications d'Acceptation
La première version prévue comprend une liste de tickets privée, un formulaire de création, une vue détaillée et des filtres de statut. Les champs sont le titre, la description, la priorité et le statut : Ouvert, En cours ou Résolu. Définissez le succès avant la génération : un ticket valide survit à un rechargement, une mise à jour autorisée est conservée, et un autre compte ne peut ni le lire ni le modifier. Gardez les invitations d'équipe et les intégrations hors de cette première tâche, afin qu'une interface apparemment complète ne masque pas sa frontière de données de base.
Prompt copiable — Planifiez un FixTrack fictif, un suivi de tickets. Les utilisateurs connectés peuvent créer, lire et mettre à jour uniquement leurs propres tickets. Utilisez le titre, la description, la priorité Basse/Moyenne/Haute et le statut Ouvert/En cours/Résolu. Définissez les routes, le schéma, l'autorisation et les tests d'acceptation. Restez en Plan Mode jusqu'à l'approbation du plan ; n'inventez ni relectures ni résultats.
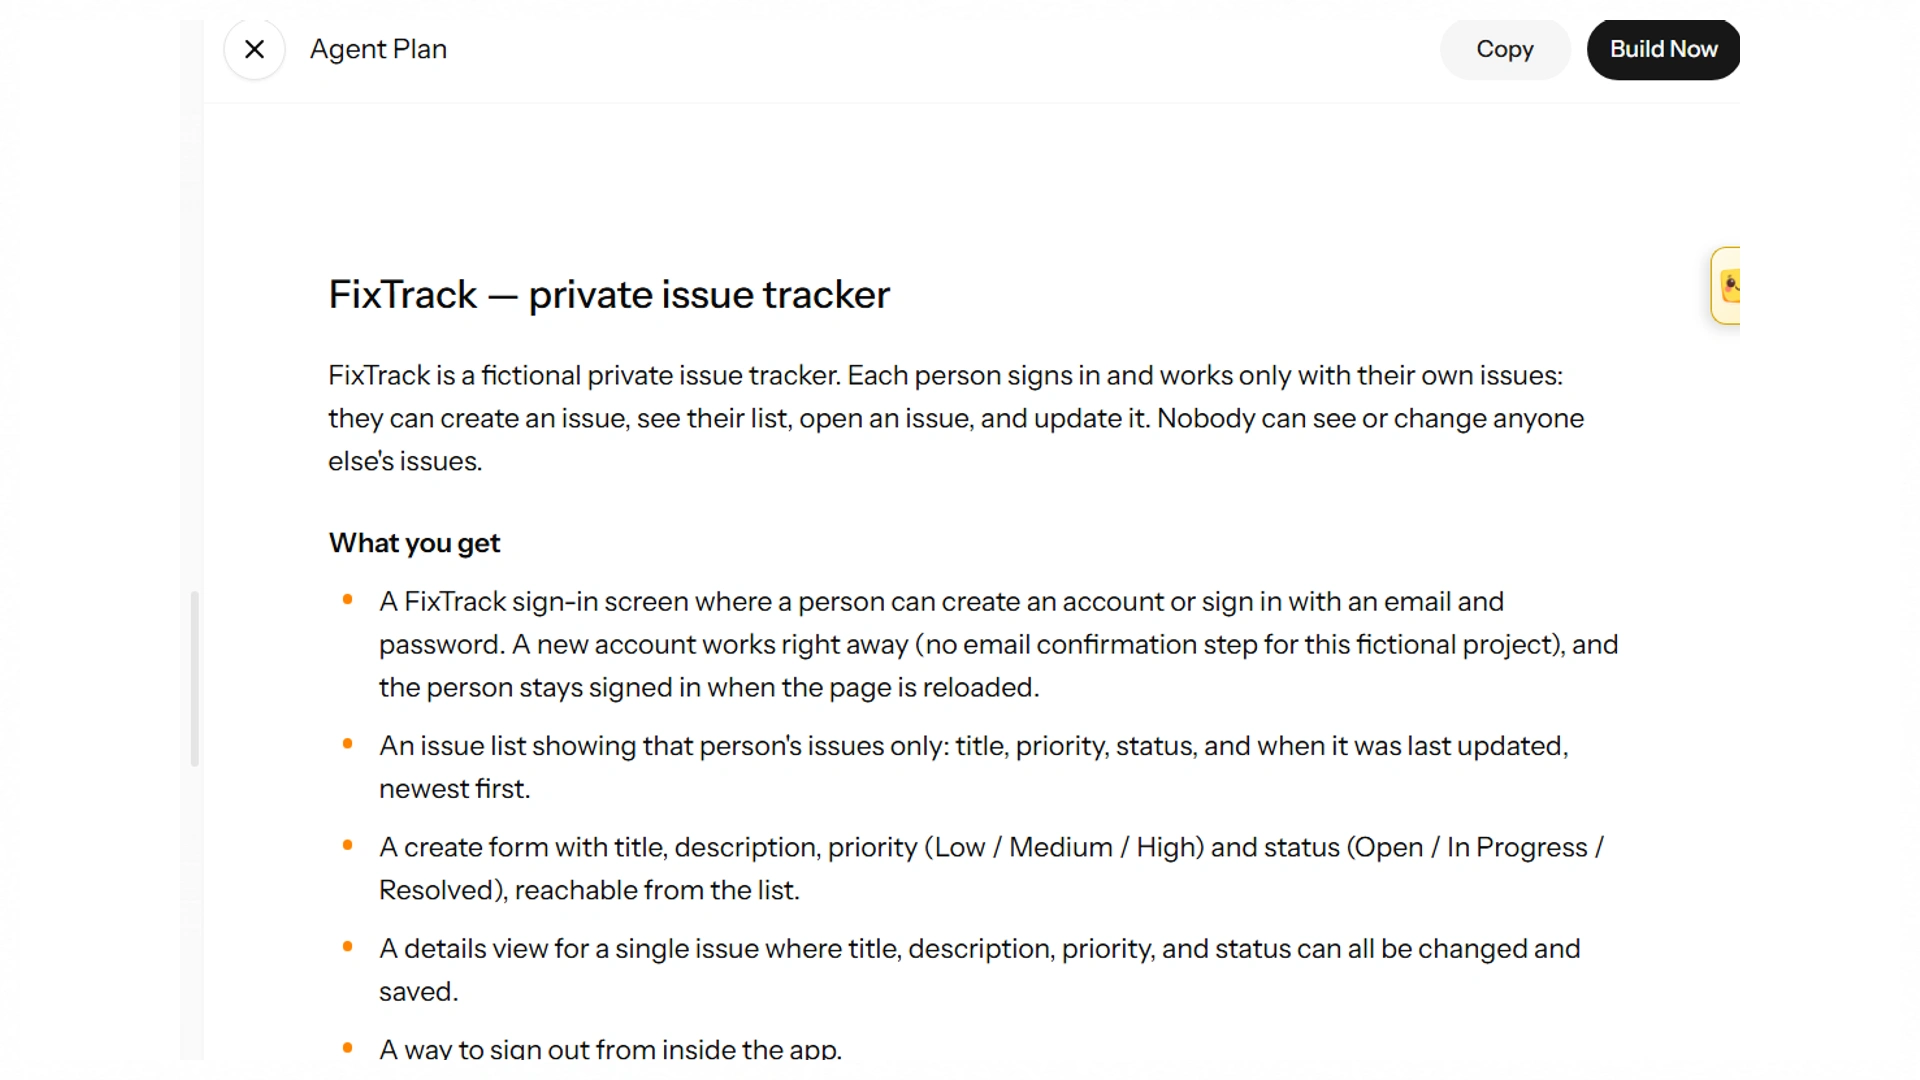
Le plan définit les tickets appartenant à chaque utilisateur et les vérifications d'acceptation. C'est la spécification pour la vérification ultérieure.
Étape 2 : Construire l'Interface et Faire Respecter la Propriété des Enregistrements
L'aperçu capturé contient Checkout error on mobile, marqué priorité Haute, Ouvert, et Données de démo fictives. Les compteurs affichent Tous 1, Ouvert 1, En cours 0 et Résolu 0. Cela constitue une fixture de départ utile, car les comptages attendus sont faciles à vérifier. La description précise que le rapport est inventé et ne concerne aucun client réel. Vérifiez la liste vide et les erreurs du formulaire de création comme des états distincts ; l'image fournie établit le ticket visible, pas toutes les routes du plan.
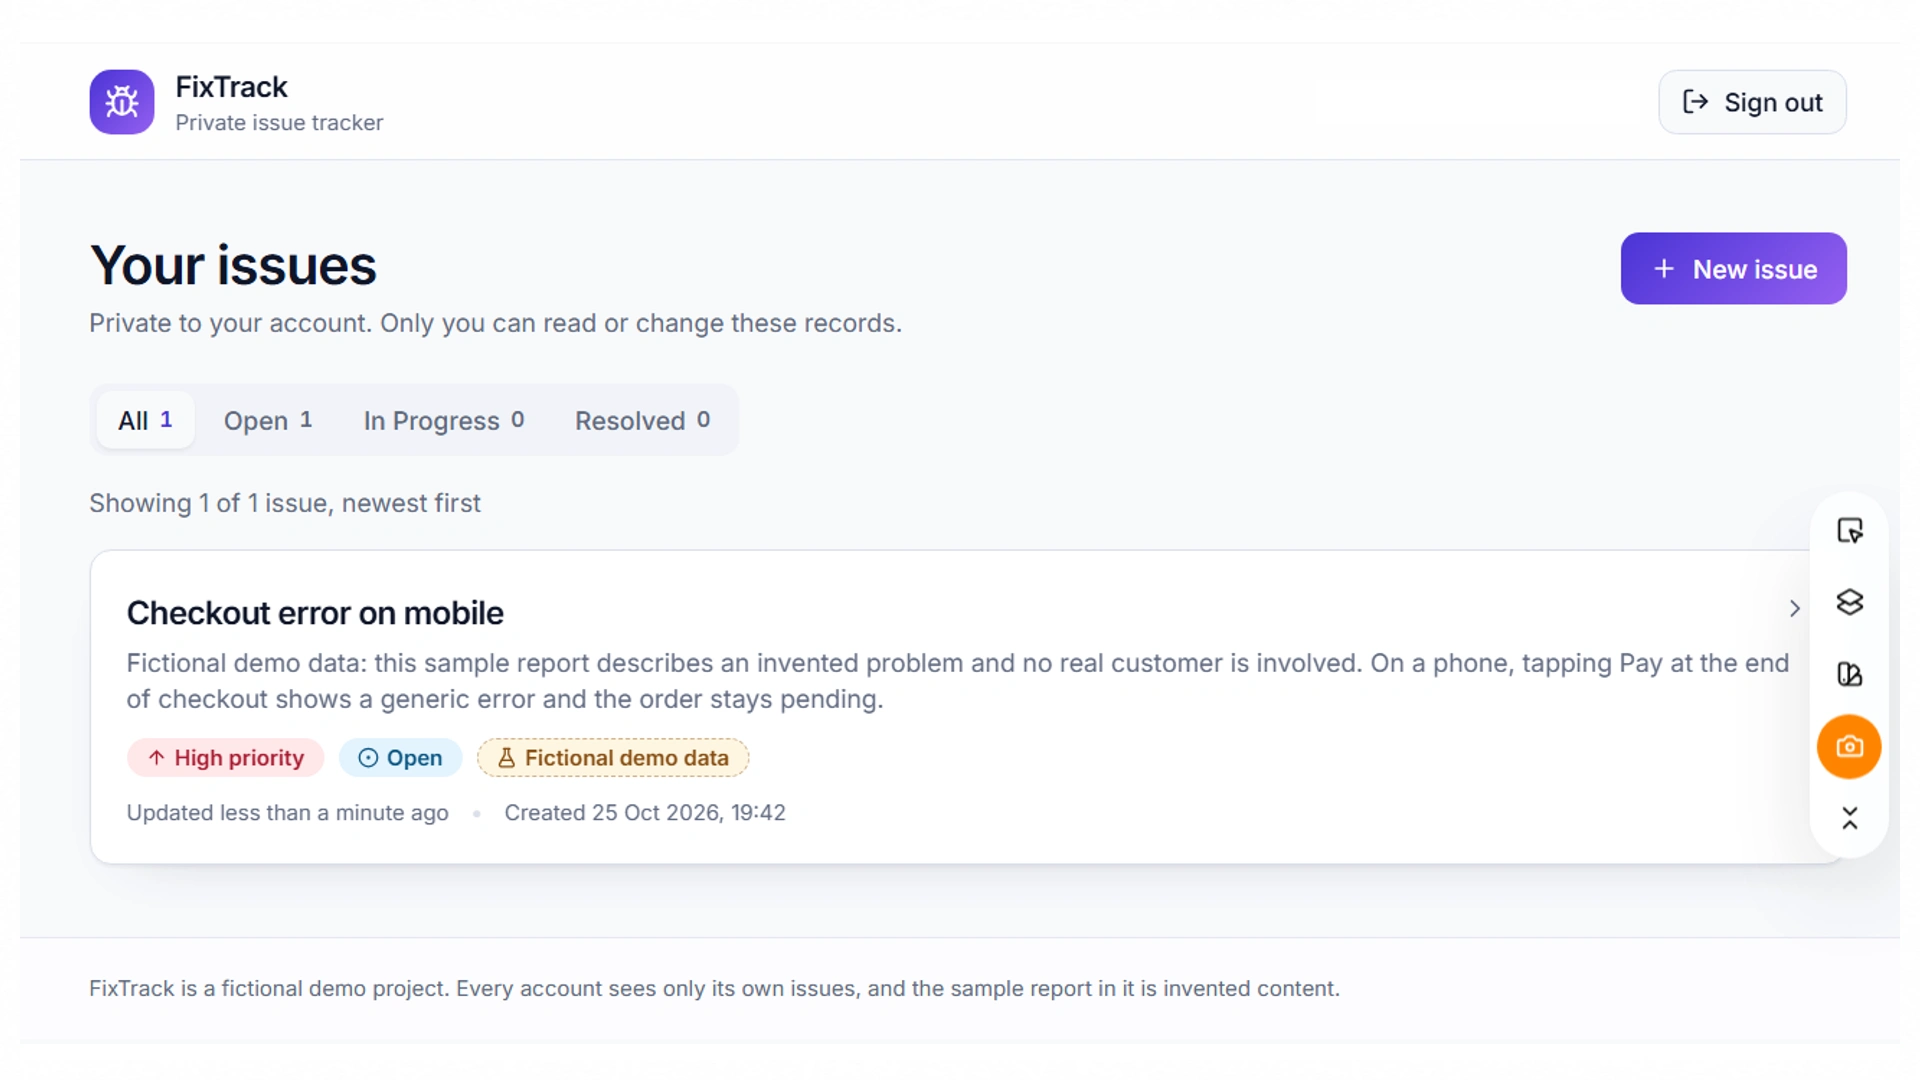
FixTrack dans Enter Pro — liste des tickets
Checkout error on mobile est marqué priorité Haute, Ouvert, et Données de démo fictives. Les compteurs sont Tous 1, Ouvert 1, En cours 0, Résolu 0.
Un tableau de tickets nécessite un identifiant de propriétaire établi côté serveur et des horodatages, avec des règles backend restreignant les lectures et les mises à jour. Déduisez le propriétaire de la session authentifiée plutôt que de faire confiance à un owner_id soumis par le navigateur. Validez la priorité et le statut selon leurs valeurs autorisées. L'aperçu indique que les enregistrements sont privés à votre compte, mais cette mention est une promesse d'interface. Une requête directe non autorisée et les valeurs de propriété stockées constituent les preuves nécessaires pour la vérifier.
Étape 3 : Vérifier un Raffinement Bien Délimité
La liste visible comprend déjà les filtres Tous, Ouvert, En cours et Résolu. Utilisez une demande de raffinement délimitée pour vérifier leur comportement, plutôt que d'affirmer que les captures d'écran montrent un filtre nouvellement ajouté. Après avoir créé un second ticket appartenant au même compte dans un statut différent, chaque filtre devrait renvoyer le sous-ensemble attendu, et Tous devrait restaurer les deux enregistrements. Préservez le chemin de création/mise à jour et l'autorisation du propriétaire. Si un compte est erroné, signalez l'entrée réelle et l'écart observé plutôt que de demander une refonte large.
Prompt de raffinement copiable — Vérifiez les filtres existants Tous/Ouvert/En cours/Résolu avec deux tickets de démonstration appartenant au même compte dans des statuts différents. Préservez l'autorisation, la validation et le comportement de création/mise à jour. Expliquez les fichiers modifiés si une correction est nécessaire. Vérifiez que les filtres ne perdent aucun enregistrement et n'exposent pas les données d'un autre utilisateur, et distinguez les commandes que vous avez exécutées des vérifications que vous n'avez pas pu réaliser.
Étape 4 : Vérifier les États d'Échec et Documenter la Transmission
Testez un titre vide, un statut non pris en charge, une soumission répétée et un échec d'enregistrement contrôlé. Déterminez le comportement de nouvelle tentative attendu, puis vérifiez-le délibérément. Connectez-vous en tant que second utilisateur de test et demandez directement le ticket du premier utilisateur ; répétez l'opération déconnecté. Vérifiez une mise à jour non autorisée ainsi qu'une lecture. Aucune capture d'écran fournie n'enregistre ces résultats backend ; conservez-les donc comme vérifications d'acceptation en suspens jusqu'à ce que les réponses et l'état stocké puissent être inspectés.
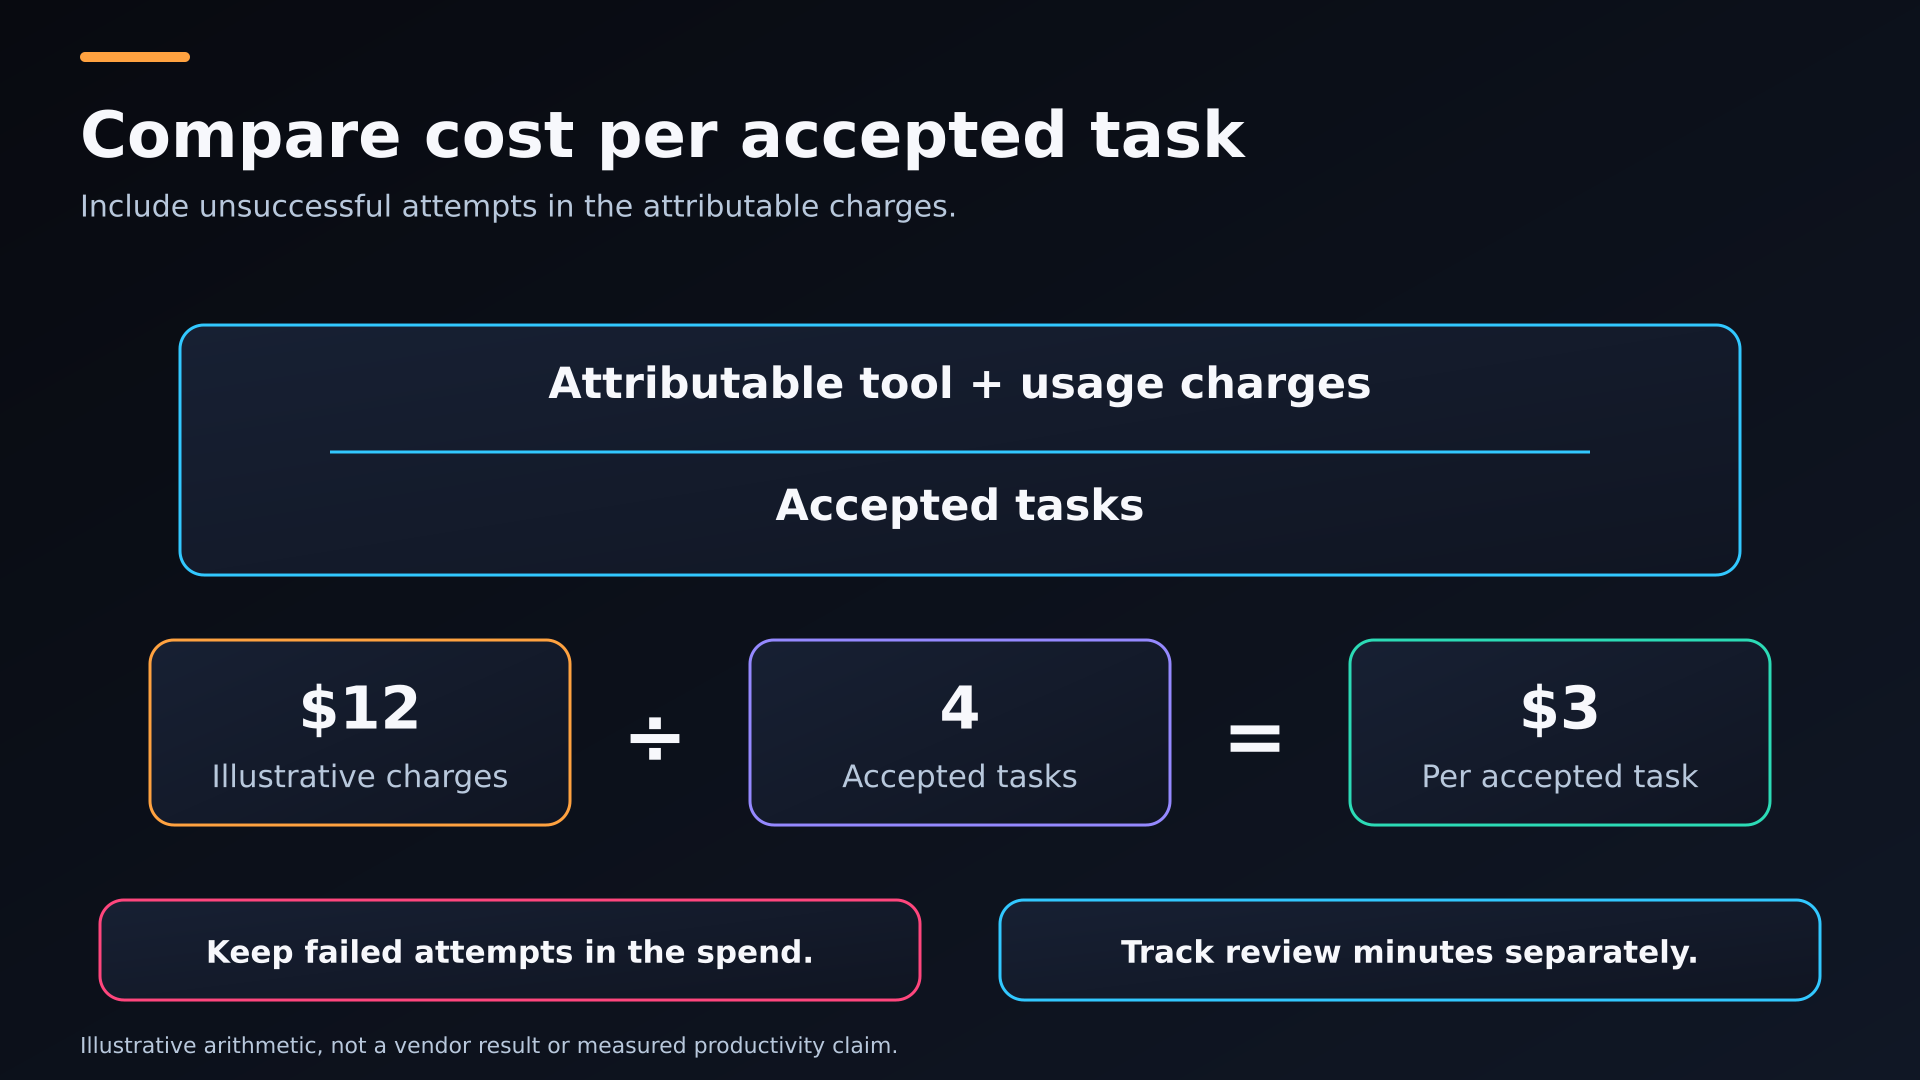
Comparer le coût par tâche acceptée : Une formule de coût par tâche acceptée et l'exemple hypothétique de l'article : 12 $ divisés par quatre.
Le résultat visible est un plan de suivi de tickets généré et un ticket de démonstration Ouvert avec des compteurs de filtre correspondants. Consignez la persistance, le changement de statut et les résultats inter-comptes lorsque vous les exécutez, ainsi que le temps écoulé, le temps de relecture active et les frais attribuables. Conservez la source, les exigences de configuration et les défauts en suspens pour une transmission à un développeur. Ce petit projet peut établir si le workflow convient à votre prototype ; il ne peut pas prouver qu'Enter Pro surpasse tous les agents de codage ou prend en charge tous les frameworks existants.
Faire le Choix Final Grâce à un Petit Pilote Reproductible
La meilleure IA pour coder est un équilibre pratique entre votre tâche, votre environnement, votre budget et votre capacité à vérifier le résultat. Présélectionnez deux candidats, utilisez le même brief, et comparez les modifications acceptées plutôt que les lignes générées. Commencez par un petit pilote dans Enter Pro, conservez votre source et vos vérifications, puis élargissez l'usage lorsque les preuves le justifient.
FAQ sur la Meilleure IA pour Coder
Un Assistant de Codage Peut-il Fonctionner Sans Accès à Tout Mon Dépôt ?
Souvent, vous pouvez limiter le contexte au paquet ou aux fichiers pertinents pour une tâche ciblée, selon les capacités et les réglages de l'outil. Cela peut réduire les éléments non pertinents et l'exposition inutile. Une modification touchant des types partagés ou l'authentification peut nécessiter un chemin de dépendance plus large. Demandez à l'outil ce dont il a besoin et vérifiez les fichiers référencés plutôt que de fournir tout le dépôt par défaut.
Dois-je Payer pour un Outil de Codage et un Abonnement de Modèle Distinct ?
Seulement lorsque la combinaison répond à un véritable besoin d'accès ou de workflow. Un abonnement d'éditeur, un compte API et un abonnement de chat grand public peuvent couvrir des produits et des modes de facturation différents. Vérifiez quel compte la session de codage utilise réellement. Comparez le coût combiné aux tâches acceptées et à l'effort de relecture ; ne supposez pas que payer deux fois signifie que les mêmes appels sont couverts deux fois ou que l'usage est illimité.
Un Modèle Local Peut-il Remplacer un Assistant de Codage Hébergé ?
Un modèle local adapté peut prendre en charge certaines tâches de codage, mais la capacité matérielle, la gestion du contexte, l'utilisation d'outils et la performance linguistique comptent. Le runtime local doit aussi s'intégrer à votre éditeur ou votre agent. Évaluez-le avec la même tâche et les mêmes vérifications d'acceptation qu'une solution hébergée. L'inférence locale peut modifier le flux de données et les frais de fournisseur sans améliorer automatiquement la justesse ni réduire l'effort total.
Un Score de Benchmark Plus Élevé Garantit-il de Meilleurs Résultats dans Mon Langage ?
Non. Un benchmark mesure un ensemble de tâches précis dans une configuration particulière. Vérifiez le langage, les types de dépôt, le harnais de test, la version du modèle et les outils de l'agent. Votre application peut nécessiter un framework différent, une édition interactive, ou un service externe indisponible. Un score élevé est une raison d'examiner un candidat, pas un substitut à une tâche représentative dans votre propre environnement.
À Quelle Fréquence Dois-je Réévaluer Ma Configuration d'IA pour Coder ?
Revenez-y lorsque le modèle, la tarification, la politique d'usage, le dépôt ou le type de tâches change suffisamment pour affecter votre travail. Conservez un court brief d'évaluation et ses vérifications afin que la prochaine comparaison soit reproductible. Le meilleur modèle IA pour coder pour votre équipe peut évoluer à mesure que votre projet passe de l'échafaudage à la maintenance ; changer constamment sans preuve consomme aussi du temps.
Puis-je Utiliser du Code Généré par IA dans un Projet Commercial ?
L'usage commercial dépend des conditions du produit applicable et des licences des dépendances et du code source utilisés dans le projet. Examinez les paquets peu familiers, conservez les mentions requises, et documentez les questions de provenance non résolues pour une transmission client. Ces vérifications sont distinctes de la question de savoir si le code généré fonctionne. Un patch utilisable commercialement peut quand même nécessiter une revue de sécurité, de compatibilité et de maintenabilité.
Puis-je Poursuivre un Projet Enter Pro dans GitHub ?
Enter Pro documente une intégration GitHub pour la synchronisation du code source et la collaboration entre développeurs. Confirmez le dépôt et la branche connectés, puis examinez le code source et les instructions de configuration avant de poursuivre. Les images fournies de FixTrack ne montrent pas cette transmission achevée. Les paramètres de base de données hébergée, les secrets et les migrations peuvent nécessiter un transfert ou une configuration supplémentaire au-delà du dépôt de code.
Enter Pro Prend-il en Charge Tous les Dépôts et Frameworks Existants ?
Ne supposez pas une compatibilité universelle avec tous les dépôts ou frameworks. Vérifiez la voie de projet documentée et inspectez la pile générée et les exigences d'intégration. FixTrack démontre un seul workflow d'application, pas la prise en charge de tous les services existants. Pour un projet existant, vérifiez la compatibilité et effectuez un petit aller-retour avant d'engager le dépôt principal ou de planifier une migration autour de l'outil.