
Quel est le meilleur LLM pour coder en 2026 ? 6 modèles testés et comparés
Découvrez le meilleur LLM pour coder en 2026. Nous comparons les modèles LLM locaux et les assistants cloud selon la précision, la confidentialité et la vitesse.
Quand notre équipe s'est lancée à la recherche du meilleur LLM pour coder, nous avons vite compris que les scores de benchmarks ne suffisent pas. Chaque jour, nous affrontons des complexités sérieuses, comme démêler des bases de code enchevêtrées ou évaluer des géants du backend traditionnels qui entrent en conflit avec les workflows modernes.
Nous avons appris que le choix d'un modèle dépend entièrement des obstacles précis auxquels vous faites face. Si les modèles cloud de pointe offrent le raisonnement profond nécessaire aux applications complexes, une architecture auto-hébergée devient non négociable dès qu'il s'agit de gérer du code d'entreprise propriétaire.
Dans ce guide, nous partageons notre expérience de première main. Nous décortiquons nos critères d'évaluation, analysons les six meilleurs modèles testés, présentons les agents de développement autonomes et passons en revue le consensus des développeurs. Vous découvrirez précisément quel outil, du meilleur LLM de code aux géants hébergés dans le cloud, optimisera réellement votre écosystème.
Critères d'évaluation essentiels pour les LLM de développement
Pour distinguer les assistants de code fiables des simples chatbots conversationnels, notre équipe a évalué chaque modèle selon 5 métriques fondamentales reflétant le développement logiciel réel :
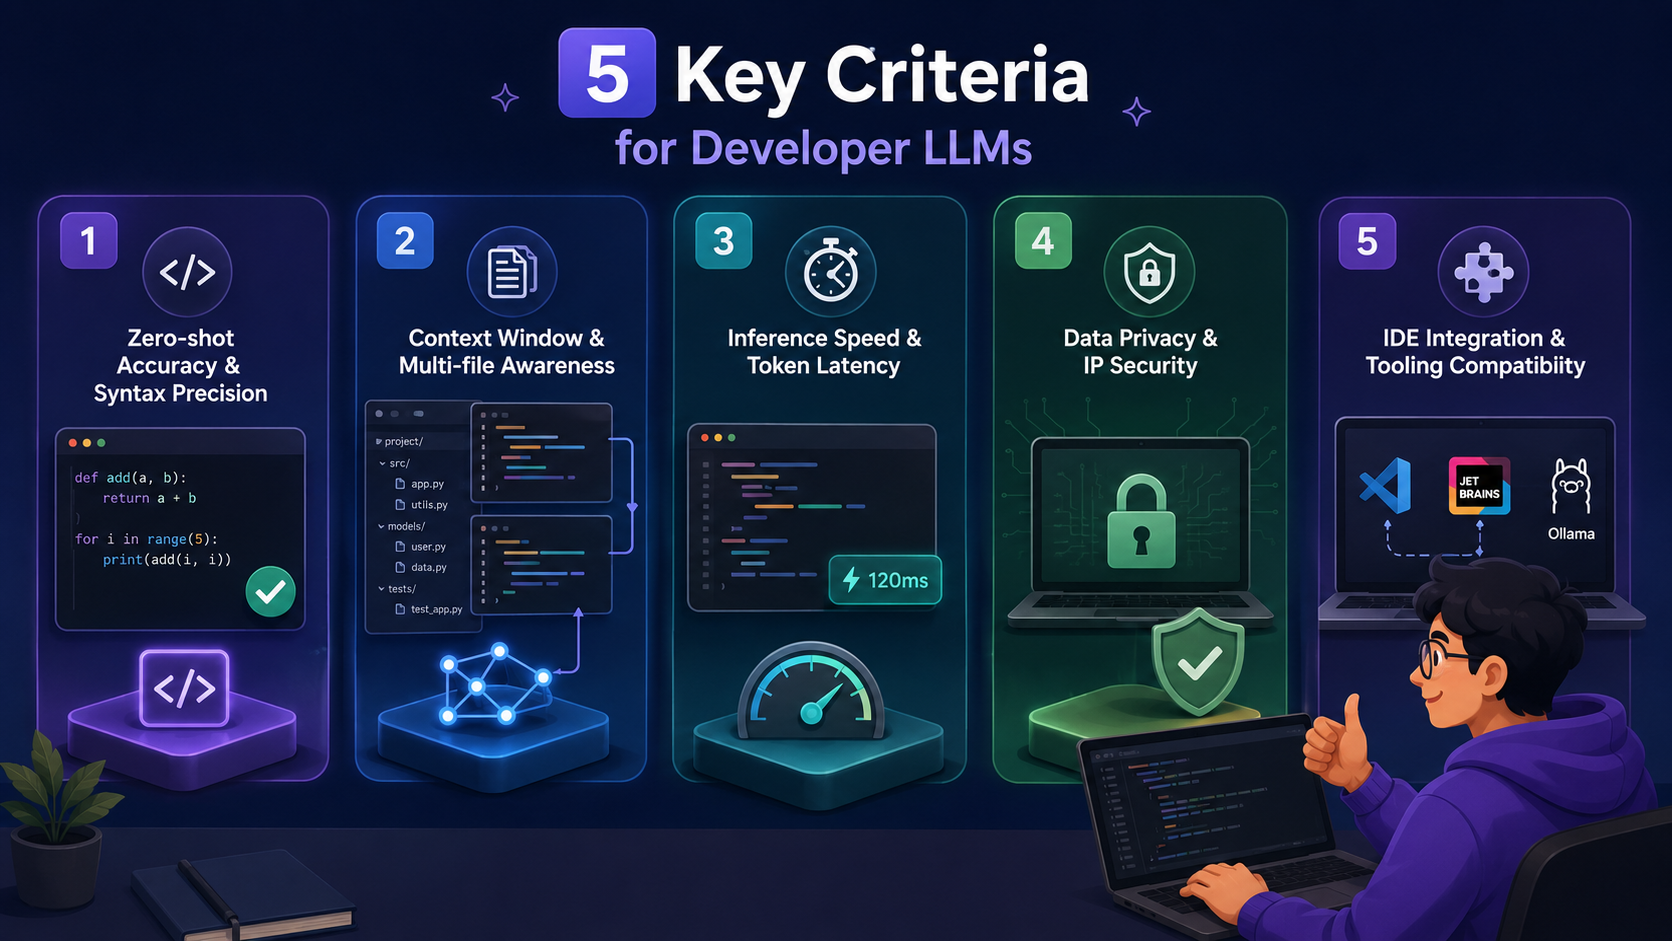
- Précision zero-shot et exactitude syntaxique : Mesure la fiabilité avec laquelle un modèle génère du code correct et fonctionnel dès le premier essai. Un modèle solide écrit immédiatement une syntaxe propre, sans inventer de bibliothèques fictives, référencer des API obsolètes ou introduire des bugs logiques subtils.
- Fenêtre de contexte et conscience multi-fichiers : Le logiciel moderne tient rarement dans un seul fichier. Nous avons évalué la « mémoire de travail » du modèle pour voir avec quelle efficacité il suit les variables interconnectées, les dépendances et la logique architecturale à travers tout un projet multi-fichiers sans se perdre.
- Vitesse d'inférence et latence des tokens : La vitesse a un impact direct sur l'état de flux du développeur. Nous avons testé les temps de réponse pour garantir que les suggestions en ligne et l'autocomplétion en temps réel apparaissent instantanément, sans décalage de frappe perceptible.
- Confidentialité des données et sécurité de la PI : Protéger le code propriétaire est critique pour toute équipe. Nous avons examiné les politiques de conservation des données des API cloud et testé les capacités hors ligne et isolées pour garantir que le code d'entreprise sensible reste entièrement privé.
- Intégration IDE et compatibilité des outils : Un modèle puissant n'est utile que s'il s'intègre naturellement au workflow quotidien d'un développeur. Nous avons évalué la facilité avec laquelle chaque modèle se connecte aux éditeurs de code populaires comme VS Code et JetBrains, ainsi qu'aux moteurs d'exécution locaux comme Ollama.
Les 6 meilleurs LLM pour coder dans les principales catégories
Pour naviguer dans le paysage de l'IA en constante évolution, il faut identifier le meilleur LLM pour coder en 2026 selon vos contraintes matérielles précises, vos exigences de confidentialité et la complexité de votre workflow architectural :
| Nom du modèle | Catégorie | Force principale | Idéal pour |
|---|---|---|---|
| Claude Opus 5 | Cloud de pointe | Codage agentique complexe | Grandes refontes & boucles d'agents |
| GPT-5.6 Sol | Cloud de pointe | Exécution déterministe | Tâches multi-étapes & prototypage |
| GLM-5.2 | Local/open-weight | Fenêtre de contexte 1M tokens | Codage quasi frontier auto-hébergé |
| DeepSeek V4-Pro | Local/open-source | Programmation compétitive | Tâches API à fort volume & maths |
| Qwen3-Coder-Next | Léger | Efficacité par paramètre | Matériel local modeste |
| Gemini 3.7 Flash | Léger/économique | Tâches agentiques complexes | Travail à fort volume & refontes |
Modèles d'IA cloud de pointe (raisonnement et contexte maximaux)
Ces modèles s'appuient sur d'immenses clusters de serveurs distants pour traiter les prompts, ce qui leur permet de gérer des fenêtres de contexte gigantesques et un raisonnement complexe en plusieurs étapes que le matériel local ne peut tout simplement pas supporter. Ils sont idéaux pour la planification d'architectures système complexes.
- Claude Opus 5
En évaluant les options pour notre stack de développement, nous constatons que Claude Opus 5 se distingue comme le meilleur LLM de code pour l'ingénierie réelle, les grandes refontes et les boucles d'agents multi-étapes. Anthropic développe le LLM Claude en paliers tels que Haiku 4.5, Sonnet 5, Opus 5 et Fable 5. Il arrive actuellement en tête des classements vérifiés pour les tâches logicielles complexes.
| Version | Taille mémoire (contexte) | Idéal pour | En termes simples |
|---|---|---|---|
| Claude Fable 5 | Massive (1M tokens) | Recherche spécialisée & tâches de longue haleine | Le modèle ultra-premium conçu pour les travaux scientifiques et de cybersécurité complexes. |
| Claude Opus 5 | Massive (1M tokens) | Refontes lourdes & boucles d'agents | Le cerveau haut de gamme pour les bases de code multi-fichiers complexes. |
| Claude Sonnet 5 | Massive (1M tokens) | Développement quotidien équilibré | Le fidèle cheval de bataille pour les tâches de codage de tous les jours. |
| Claude Haiku 4.5 | Élevée (200K tokens) | Scripts rapides & débogage express | Modèle gratuit : Le sprinteur léger conçu pour la vitesse et le coût zéro. |
Avantages :
- Offre une précision de codage zero-shot leader du secteur avec un comportement de vérification proactif.
- Dispose d'une fenêtre de contexte massive capable d'ingérer sans effort de grandes bases de code multi-fichiers.
- Obtient des scores exceptionnels sur les principaux benchmarks de codage agentique.
Inconvénients :
- Nécessite une connectivité internet constante avec une dépendance stricte au cloud pour fonctionner.
- Les coûts d'utilisation des tokens peuvent grimper rapidement pour les grandes équipes de développement.
Idéal pour : La refonte de code à grande échelle, la conception de systèmes full-stack et les workflows agentiques complexes.
- GPT-5.6 Sol
Il s'agit d'un modèle phare polyvalent offrant une large couverture syntaxique des langages et une intégration étendue à l'écosystème. OpenAI a récemment fait avancer la frontière du rapport qualité-prix avec GPT-5.6. Il constitue un cheval de bataille quotidien très fiable pour les développeurs gérant efficacement le travail logiciel.
| Version | Vitesse | Compatible avec | En termes simples |
|---|---|---|---|
| GPT-5.6 Sol | Rapide | IDE principaux & frameworks d'agents | L'assistant robuste qui gère de façon stable les tâches multi-étapes. |
| GPT-5.6 Terra | Modéré | Outils de développement standard | La version API équilibrée pour une résolution de problèmes stable, étape par étape. |
| GPT-5.6 Luna | Ultra-rapide | Web & outils légers | Modèle gratuit : L'assistant quotidien rapide et gratuit pour la génération de code rapide. |
Avantages :
- Exécution déterministe et stable sur de longues tâches multi-étapes sans dévier de sa trajectoire.
- Compatibilité étendue avec les principales extensions et plateformes de développement.
- Couverture d'entraînement complète sur les langages de programmation obscurs et legacy.
Inconvénients :
- Produit parfois du boilerplate excessivement verbeux plutôt que des extraits concis.
- La mémoire contextuelle peut se dégrader lors de très longues sessions de chat.
Idéal pour : Les tâches déterministes multi-étapes, le prototypage rapide et l'intégration d'API.
Meilleurs LLM open source et locaux (confidentialité et personnalisation en entreprise)
Pour les organisations qui privilégient la sécurité de la propriété intellectuelle, exécuter des modèles LLM locaux hors ligne garantit qu'aucun code propriétaire n'est jamais transmis à un serveur tiers. Ces modèles offrent un formidable atout pour la conformité en entreprise.
- GLM-5.2
Le meilleur modèle de codage à poids ouverts disponible, offrant un énorme potentiel de fine-tuning. GLM-5.2 est un modèle phare conçu pour les tâches de longue haleine et offre cette capacité avec un solide contexte de 1M tokens.
| Version | Matériel requis | Niveau de puissance | En termes simples |
|---|---|---|---|
| GLM-5.2 (grand) | Centre de données d'entreprise lourd | Intelligence haut de gamme | Le meilleur codeur à poids ouverts avec une fenêtre mémoire massive de 1M. |
| GLM-5.2 (petit) | Ordinateur portable standard | Bon pour l'aide quotidienne | 100 % gratuit et local : Fonctionne directement sur votre ordinateur portable hors ligne, sans frais d'API. |
| GLM-5.2 Cloud | Navigateur web/API | Raisonnement élevé | Accès web gratuit : L'outil basé navigateur pour expérimenter sans configuration. |
Avantages :
- Modèle à poids ouverts très compétitif pour les tâches d'ingénierie de longue haleine.
- Fenêtre de contexte massive d'un million de tokens pour ingérer des dépôts entiers localement.
- Licence ouverte permissive adaptée au développement d'entreprise et commercial.
Inconvénients :
- Nécessite un matériel d'entreprise haut de gamme pour exploiter pleinement la fenêtre de contexte de 1M tokens en local.
- Les modèles à poids ouverts sont gratuits à télécharger, mais les exploiter à grande échelle exige des ressources serveur coûteuses.
Idéal pour : L'auto-hébergement d'un codeur quasi frontier en maintenant une confidentialité absolue des données d'entreprise.
- DeepSeek V4-Pro
Un modèle très performant conçu spécifiquement pour les tâches de codage avancées. DeepSeek développe et publie en open source des LLM de pointe. Il surpasse largement sa catégorie en logique mathématique et en structuration algorithmique complexe, offrant une configuration massive de 1,6 billion de paramètres pour la génération de texte intensive.
| Version | Force principale | Idéal pour | En termes simples |
|---|---|---|---|
| DeepSeek V4-Pro | Programmation compétitive & maths | Dépôts de niveau entreprise | Un cerveau de codage spécialisé qui excelle en algorithmes et logique complexe. |
| DeepSeek V4 | Raisonnement général & syntaxe | Scripting quotidien & recherche | Version web gratuite : Un chatbot polyvalent pour l'écriture quotidienne et le code basique. |
| DeepSeek-Coder 7B | Exécution légère | Développement local hors ligne | 100 % gratuit et local : Un modèle privé et gratuit que vous pouvez exécuter sur votre propre PC. |
Avantages :
- Excelle fortement dans les tâches algorithmiques et de programmation compétitive.
- Fournit une confidentialité absolue des données en auto-hébergement pour une conformité stricte en matière de résidence des données.
- Capacités étendues de raisonnement mathématique et de traitement d'API à fort volume.
Inconvénients :
- Les configurations à paramètres complets exigent de la VRAM GPU de niveau entreprise.
- La configuration et l'affinage par quantification nécessitent des connaissances techniques avancées.
Idéal pour : Les dépôts d'entreprise sensibles à la confidentialité, les tâches API à fort volume et la résolution de problèmes algorithmiques.
Modèles de codage spécialisés et légers (autocomplétion rapide & faible latence)
Ces modèles sont fortement quantifiés et explicitement optimisés pour fonctionner nativement en arrière-plan sur des ordinateurs portables grand public ou pour opérer de manière rentable dans le cloud. Ils agissent strictement comme des assistants réactifs, maximisant l'efficacité.
- Qwen3-Coder-Next
Un modèle hautement efficace et spécialisé dans le code, optimisé pour la complétion multilingue sur du matériel grand public standard. Les derniers modèles Qwen3 adoptent des modes de réflexion hybrides permettant de contrôler avec flexibilité les performances de raisonnement, la vitesse et les coûts.
| Version | Vitesse de réponse | Couverture linguistique | En termes simples |
|---|---|---|---|
| Qwen3-Coder-Next | Rapide | 90+ langages de programmation | Le moteur phare à poids ouverts pour les configurations locales de développeurs sérieux. |
| Qwen3-Coder (7B) | Instantané | 90+ langages de programmation | 100 % gratuit et local : Comme une saisie prédictive pour le code qui fonctionne en douceur sur des ordinateurs portables standard. |
| Qwen-Chat | Instantané | Codage standard & langage naturel | Version web gratuite : Un assistant conversationnel rapide et gratuit pour les vérifications syntaxiques. |
Avantages :
- Offre une excellente efficacité de codage par paramètre pour les configurations locales légères.
- Fonctionne en douceur sur du matériel grand public standard et des déploiements locaux modestes avec une charge de ressources minimale.
- Solide prise en charge syntaxique multilingue couvrant plus de 90 langages de programmation.
Inconvénients :
- Profondeur de raisonnement limitée lors de la planification d'architectures logicielles entières.
- Fenêtre de rétention de contexte plus petite par rapport aux grands modèles cloud.
Idéal pour : L'autocomplétion ligne par ligne et les développeurs exécutant des modèles sur des ordinateurs portables standard.
- Gemini 3.7 Flash
Un assistant de codage fluide explicitement conçu pour des opérations cloud économiques et des configurations agentiques complexes. Gemini 3.7 Flash est idéal pour traiter des tâches agentiques complexes à grande échelle.
| Version | Comment il aide | Où il fonctionne | En termes simples |
|---|---|---|---|
| Gemini 3.7 Flash | Tâches agentiques complexes à grande échelle | API cloud | Un assistant cloud ultra-rapide pour les grandes bases de code et les workflows complexes. |
| Gemini 3.5 Flash-Lite | Tâches à fort volume | API cloud | Niveau API gratuit généreux : Un modèle léger conçu pour l'efficacité et l'intelligence. |
| Gemini Web | Discussion générale & extraits de code | Navigateur web | Version web gratuite : Un assistant simple et gratuit pour rédiger des fonctions et répondre aux questions. |
Avantages :
- Incroyablement efficace pour les workflows d'agents à fort volume.
- Gère des fenêtres de contexte massives, lui permettant de lire facilement d'énormes bases de code.
- Vitesses de livraison de tokens rapides pour un débogage rapide et des modifications en temps réel.
Inconvénients :
- Fonctionne strictement comme une API cloud, ce qui signifie qu'il ne peut pas être isolé ou auto-hébergé pour une confidentialité extrême.
- Peut nécessiter un ajustement des prompts pour correspondre à la rigueur de formatage exacte de Claude ou GPT.
Idéal pour : Le codage cloud économique, le travail d'agents à fort volume et les tâches à contexte long.
Comment nous avons testé ces LLM
Nous avons testé chaque modèle via un cadre technique strictement reproductible pour éliminer les biais subjectifs. Notre suite de tests combine des benchmarks de développeurs établis avec des défis d'ingénierie pratiques et réels.
Prompting de référence contrôlé
Pour tester le raisonnement brut en 2026, nous avons soumis 5 prompts identiques de refonte architecturale directement dans les interfaces web natives de leaders du secteur comme ChatGPT et Claude.
Étape 1 : Préparer 5 prompts identiques de refonte architecturale
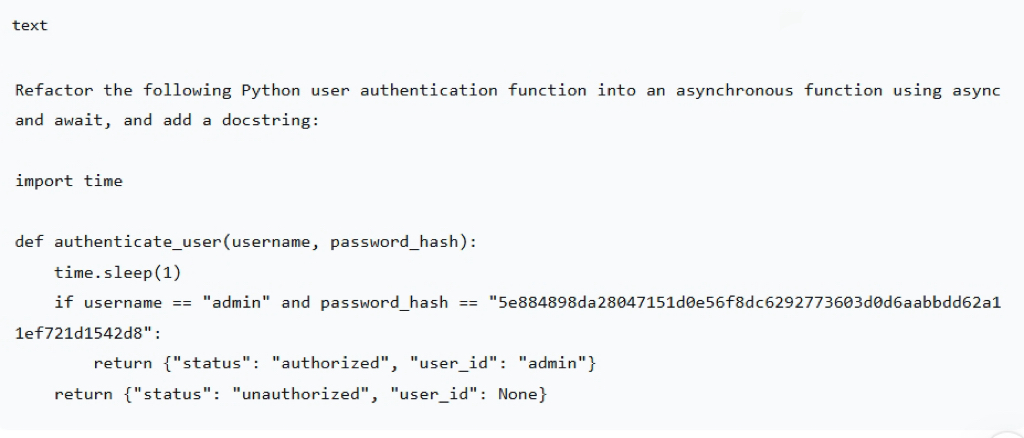
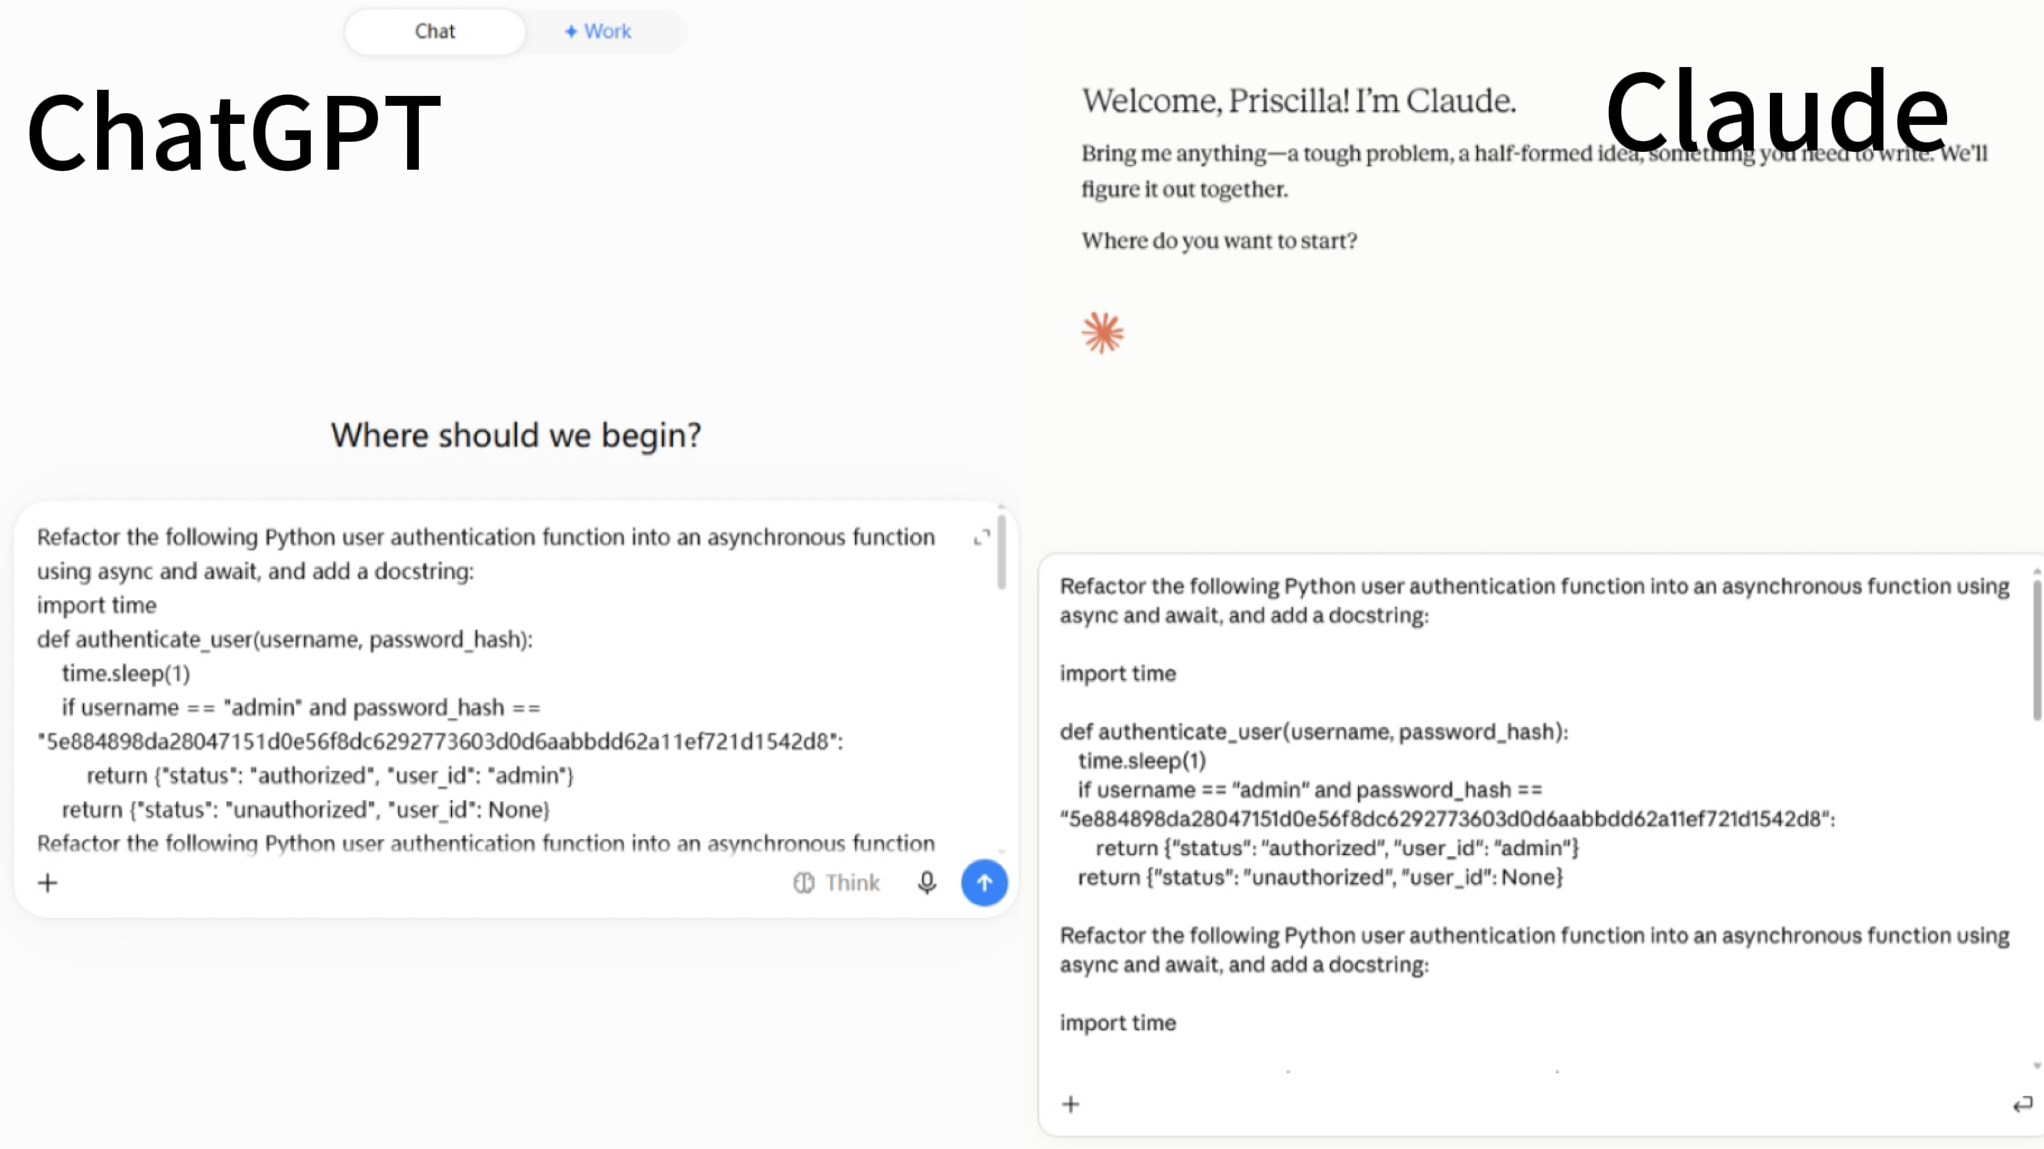
D'abord, j'ai écrit un prompt unifié de refonte architecturale et l'ai copié 5 fois, en veillant à ce que le contenu soit exactement identique. Un exemple de prompt est présenté ci-dessous :
Étape 2 : Soumettre les prompts dans les interfaces natives ChatGPT/Claude
J'ai ouvert les interfaces web de ChatGPT et Claude, collé et soumis les prompts l'un après l'autre, et enregistré intégralement la réponse chaque fois.
Étape 3 : Évaluer la capacité de gestion de la logique multi-fichiers
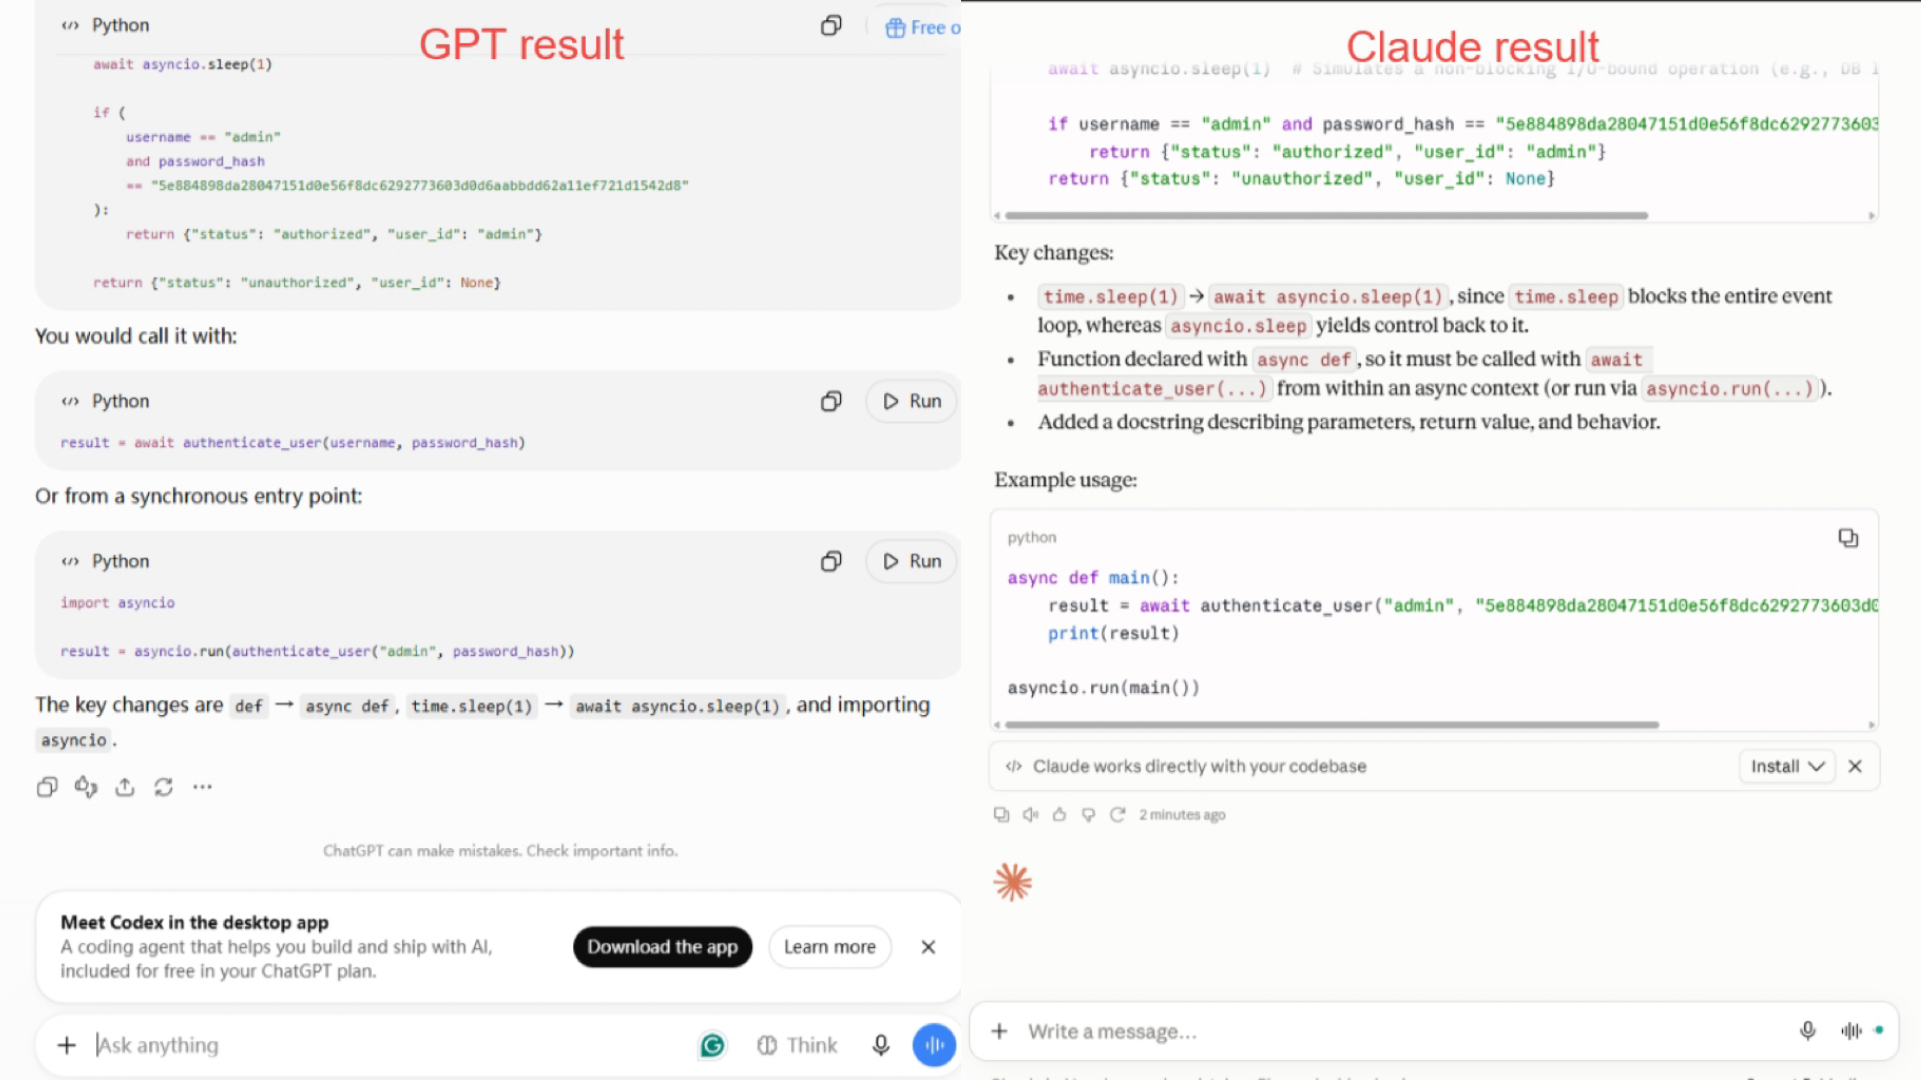
Une fois que chaque outil fournit ses résultats, on évalue sa véritable capacité de raisonnement respective. En prenant ChatGPT et Claude comme exemple, les deux modèles ont correctement réalisé la même refonte, mais j'ai constaté que les styles et les accents de sortie diffèrent : ChatGPT tend à donner le résultat accompagné d'un usage concis, tandis que Claude tend à expliquer les principes sous-jacents et à souligner les contraintes. Cela reflète leurs styles de raisonnement et d'expression différents pour une même entrée.
Profilage de la charge matérielle locale
Les modèles locaux offrent une confidentialité totale des données, mais seulement s'ils fonctionnent efficacement sur du matériel pratique. Nous avons profilé des modèles légers à poids ouverts comme Qwen3-Coder (7B) et DeepSeek-Coder directement sur une station de travail locale.
- Nous avons surveillé les pics de VRAM et les charges CPU pendant la génération de tokens au pic pour identifier les limites réelles de ressources.
- Nous avons confirmé si les développeurs peuvent auto-héberger des workflows hors ligne sécurisés sans matériel d'entreprise coûteux.
Intégration IDE et friction UX
Les métriques de latence théoriques ne signifient rien si les suggestions de code paraissent lentes lors de l'édition en direct. Nous avons testé des modèles légers comme Qwen3-Coder et Gemini 3.7 Flash dans un éditeur de code standard pour évaluer la complétion en ligne en direct et le décalage de saisie.
- Nous avons évalué la latence réelle pour garantir que le texte fantôme prédictif s'adaptait parfaitement au rythme de frappe naturel d'un développeur.
- Nous avons vérifié la conscience du contexte pour garantir que les modèles lisaient et appliquaient correctement les variables à travers des fichiers de projet adjacents ouverts.
Vérification d'exécution isolée et de syntaxe
Le code qui semble correct dans une interface de chat échoue souvent à l'exécution. Nous avons compilé et exécuté des extraits générés par DeepSeek V4-Pro et GPT-5.6 Sol directement dans des conteneurs Docker isolés.
- Des exécutions objectives en bac à sable ont immédiatement signalé les méthodes obsolètes, les imports manquants et les hallucinations syntaxiques.
- Nous avons suivi les véritables taux de Pass@1 pour confirmer que la logique satisfaisait les suites de tests dès la première tentative.
Bien que les LLM cloud et locaux autonomes excellent à générer des extraits et à affiner des fonctions spécifiques, construire des applications complètes exige encore une configuration manuelle de l'IDE, la mise en place de boilerplate et l'intégration frontend-backend. Pour les développeurs et créateurs qui souhaitent contourner entièrement les cycles de codage répétitifs, les agents de développement autonomes offrent un chemin plus rapide du concept au déploiement.
Enter Pro : L'agent de développement IA autonome pour la création rapide de logiciels
Vous souhaitez aller au-delà de l'écriture de fonctions isolées et générer des applications entières de manière autonome ? Enter Pro comble l'écart massif entre les interfaces de chat LLM brutes et la génération complète de projets full-stack. Vous n'avez plus besoin de configurer manuellement des environnements locaux, de mettre à jour des dépendances système ou de vous battre avec des gestionnaires de paquets alambiqués. Au lieu de cela, cette plateforme utilise un mode plan intuitif pour le vibe coding pour transformer directement des prompts en langage naturel de haut niveau en logiciels soignés et prêts pour la production.
Fonctionnalités clés
- Création basée sur des prompts
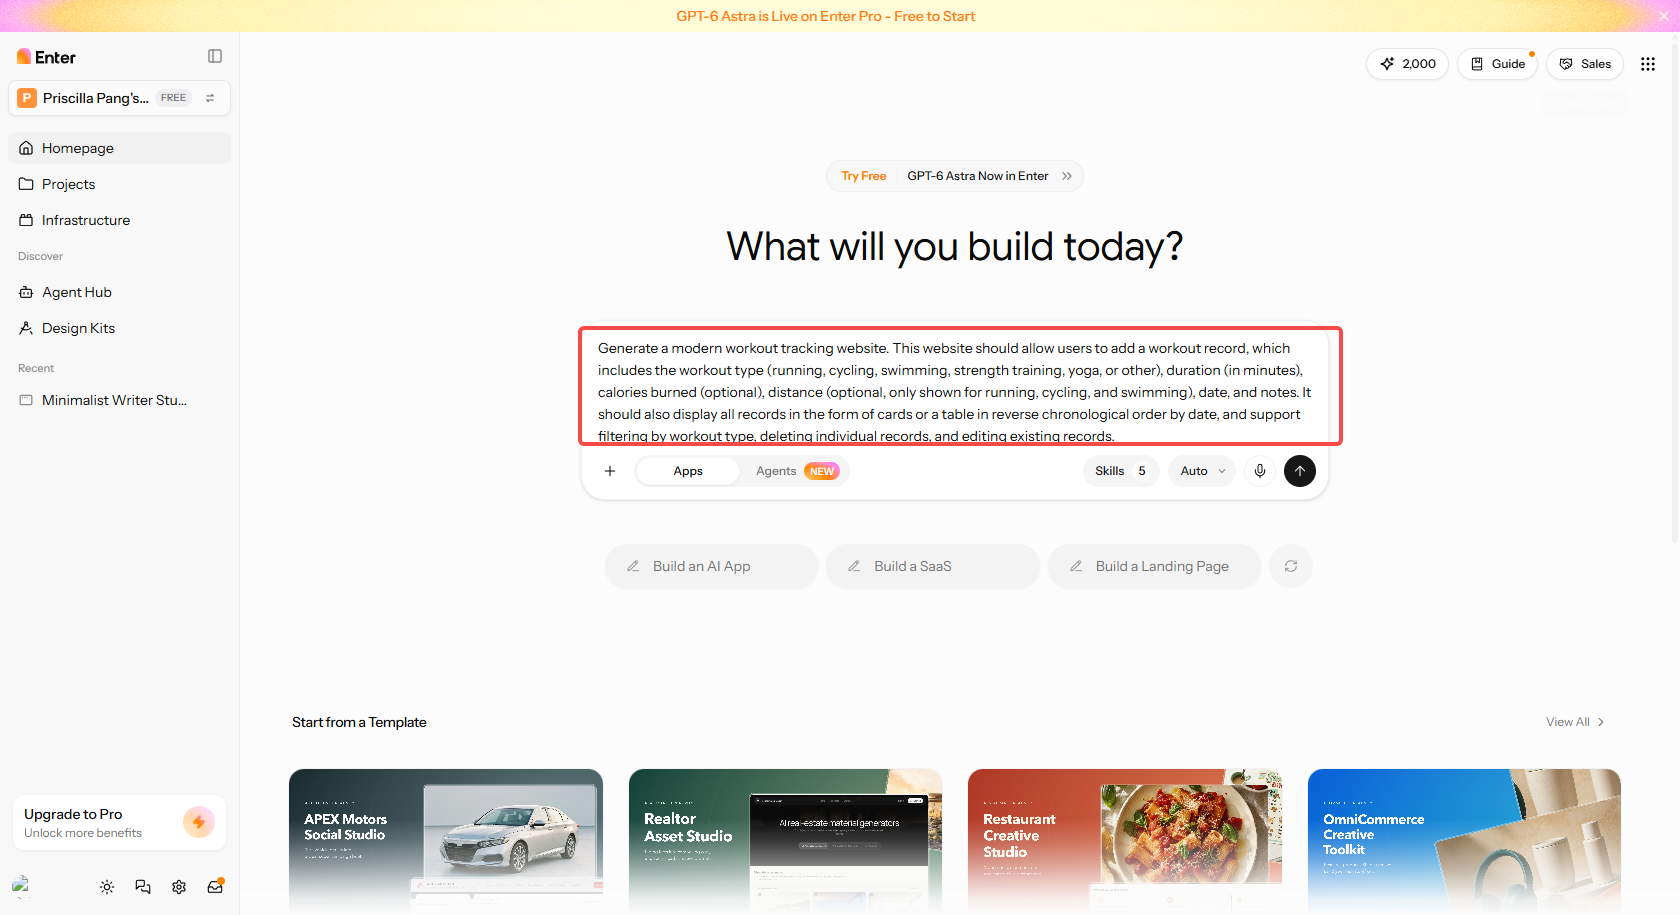
Les utilisateurs fournissent simplement un prompt en langage naturel décrivant le thème de couleur du site web, la mise en page souhaitée et les pages fonctionnelles incluses. Le moteur intégré d'Enter Pro construit instantanément la base de code full-stack fondamentale, incluant la logique frontend et de base de données, réduisant drastiquement le temps de configuration manuelle.
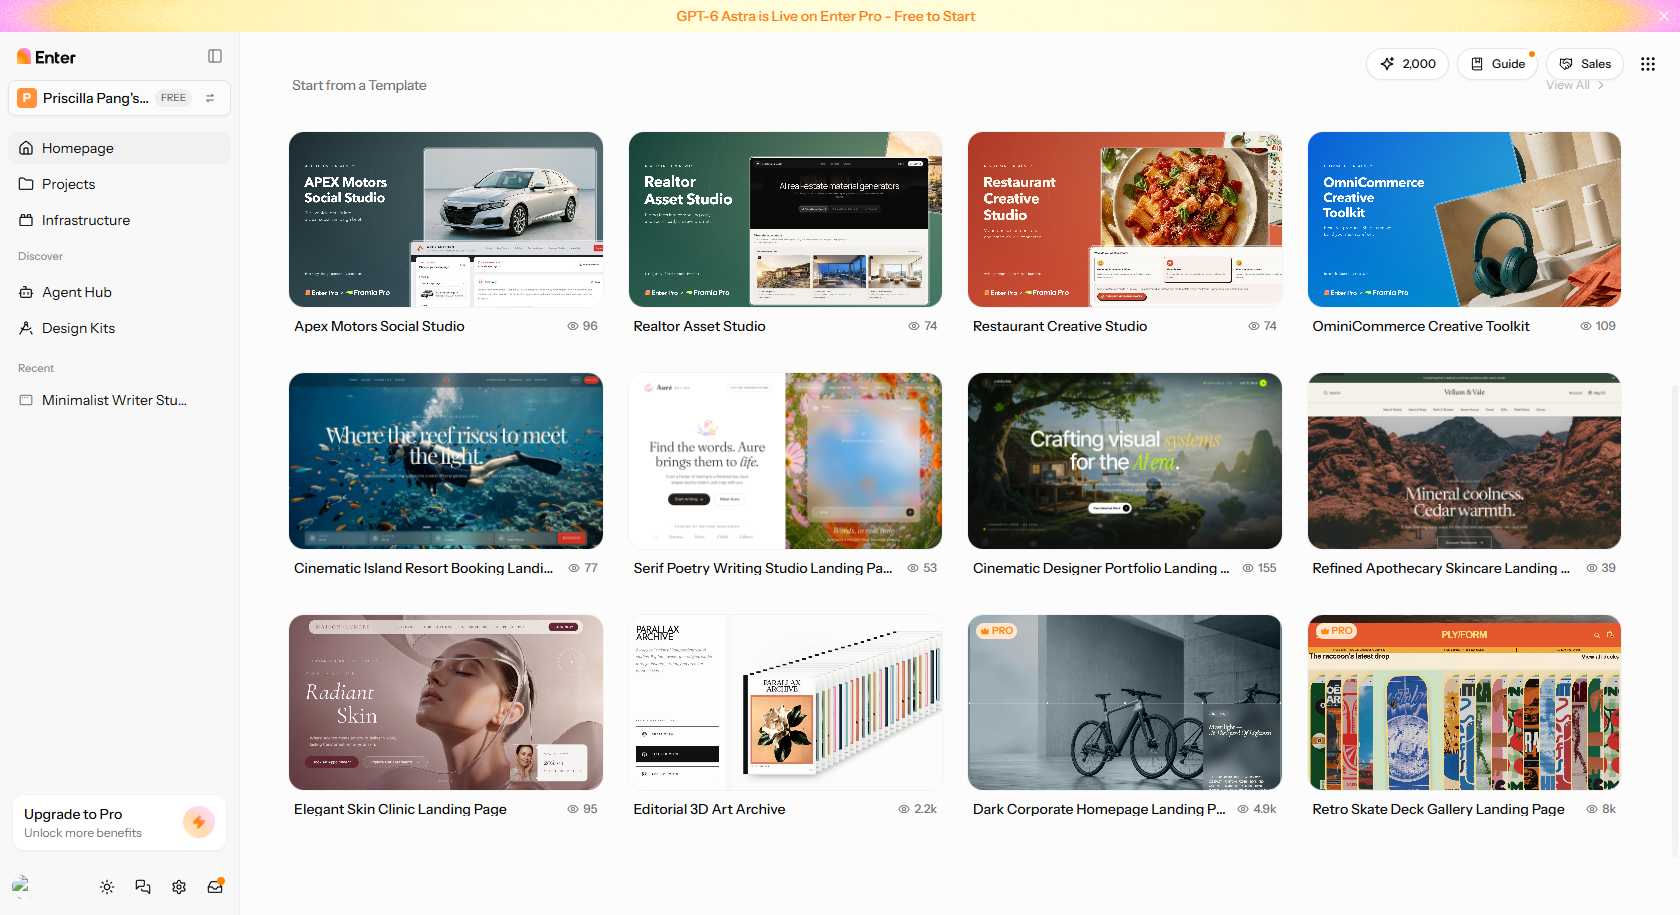
- Modèles prêts à l'emploi
La plateforme propose des modèles de sites web professionnellement conçus et entièrement responsifs, adaptés pour une vitesse de déploiement extrême. Enter Pro optimise spécifiquement ces mises en page pour respecter strictement les standards modernes d'expérience utilisateur, garantissant une livraison d'application de haute qualité sans ajustements visuels manuels.
- Intégration unifiée des modèles
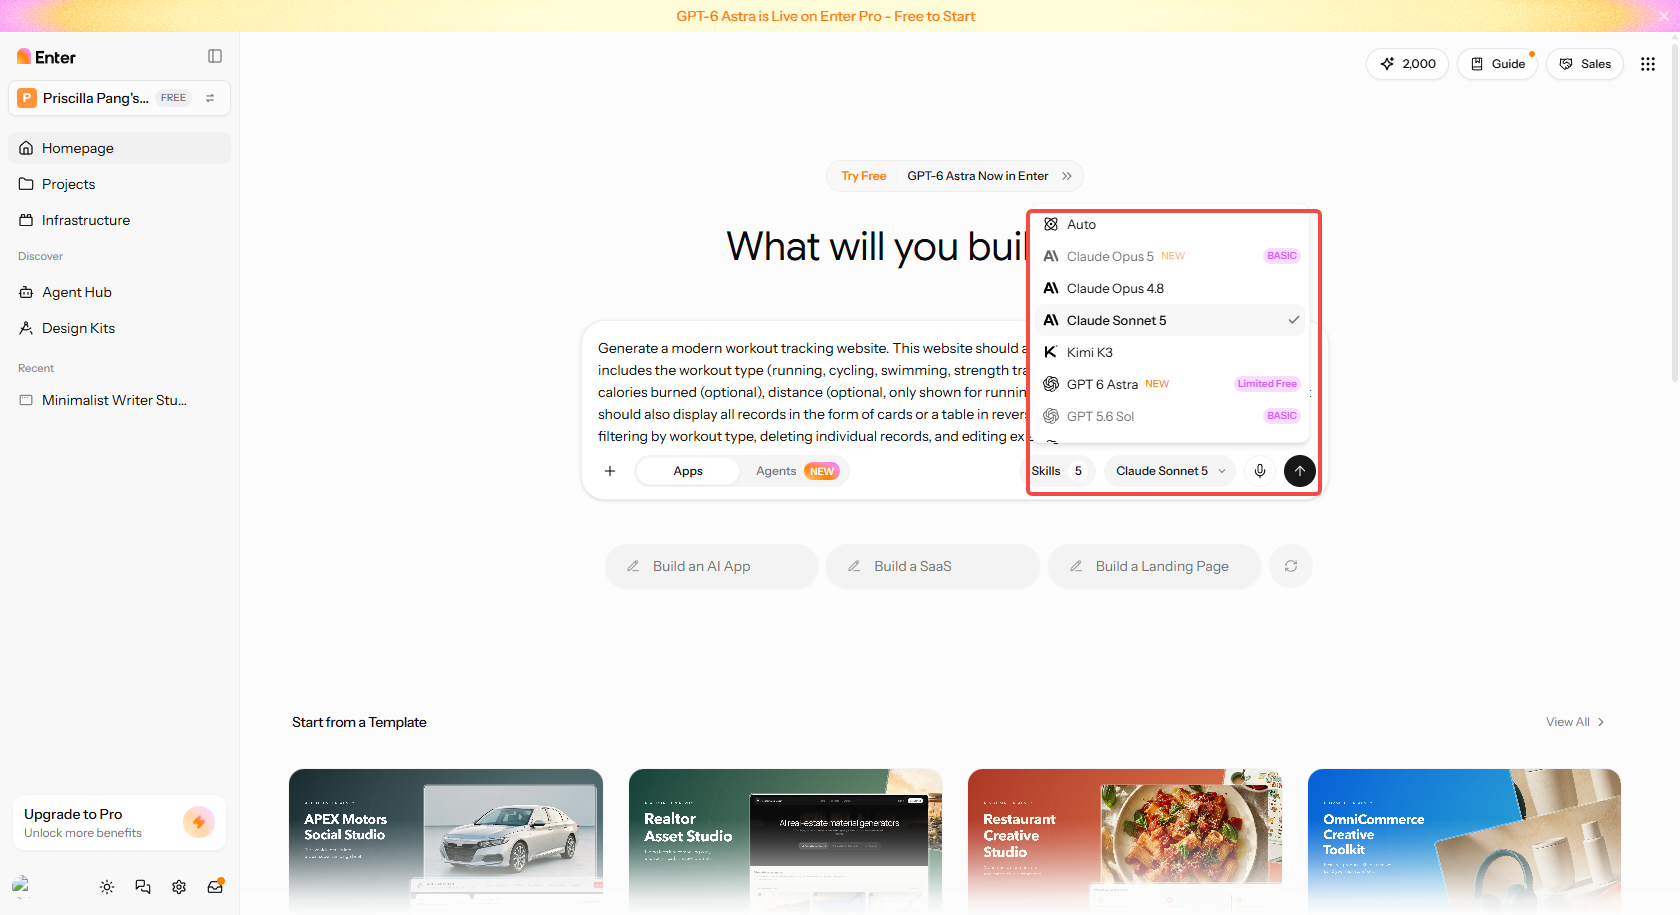
Les développeurs peuvent intégrer nativement des assistants de codage de premier plan et des modèles avancés directement dans leurs builds Enter Pro actifs sous un seul abonnement, incluant Kimi K3, GPT 6 Astra et Claude Sonnet 5. Cette approche simplifiée élimine complètement le cauchemar administratif de gérer et de sécuriser des clés API séparées à travers différents modèles de pointe.
- 100 % de propriété du code
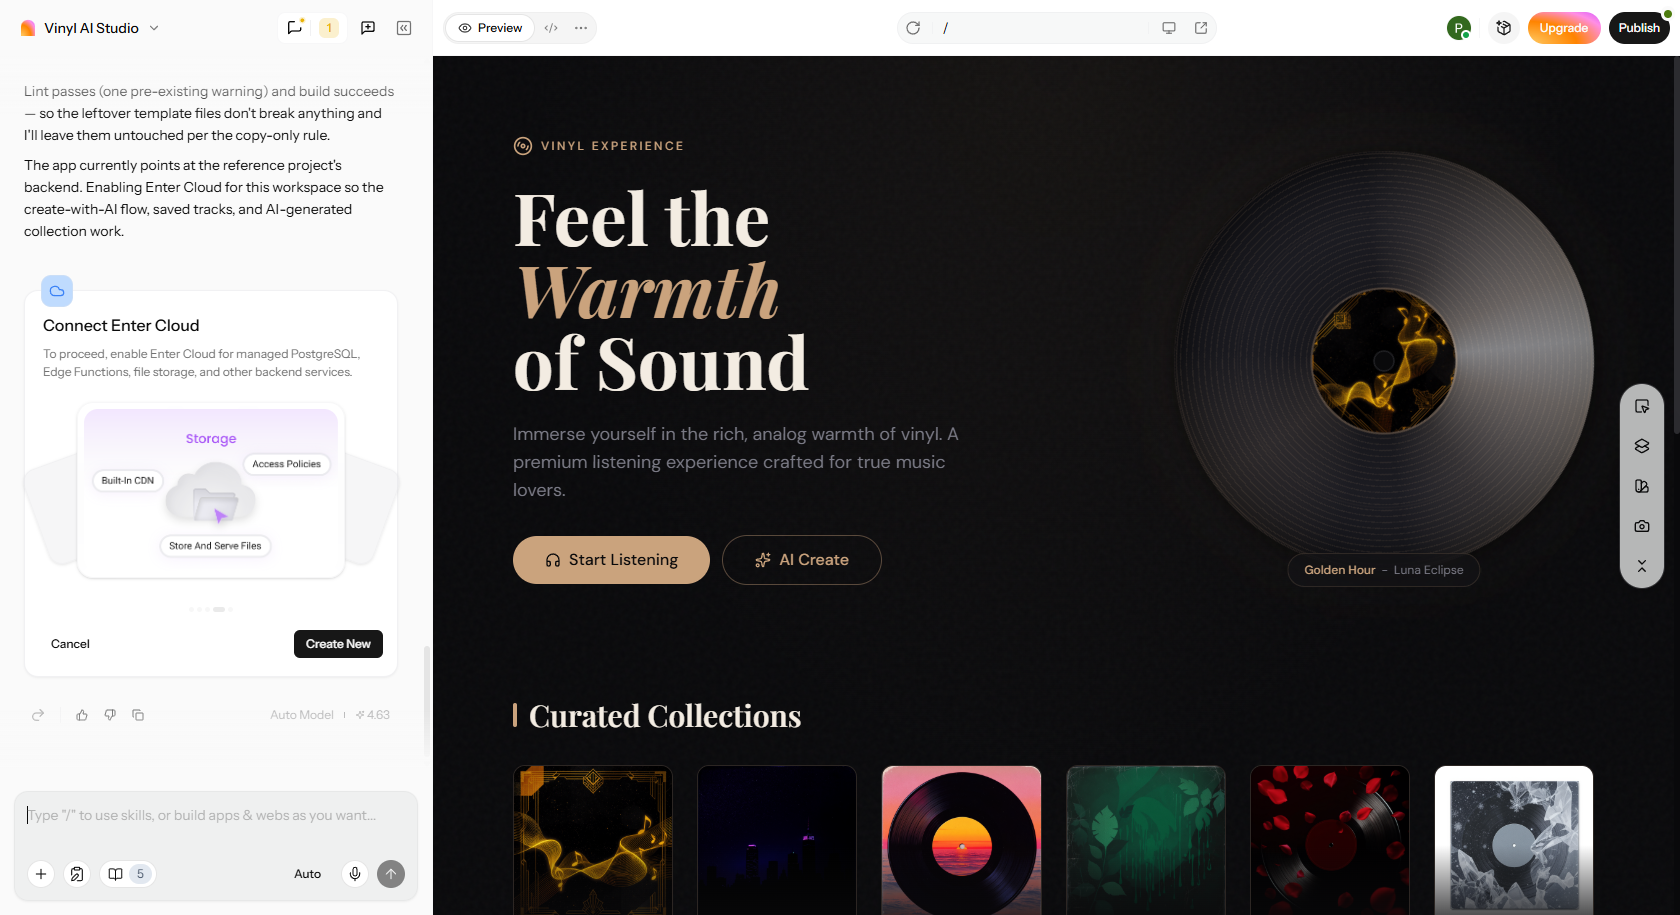
Vous conservez le contrôle absolu et les droits commerciaux complets sur le code source généré après l'export depuis la plateforme Enter Pro. Cela garantit une véritable indépendance sans verrouillage fournisseur restrictif ni complications de licence futures.
Guide étape par étape pour construire des applications
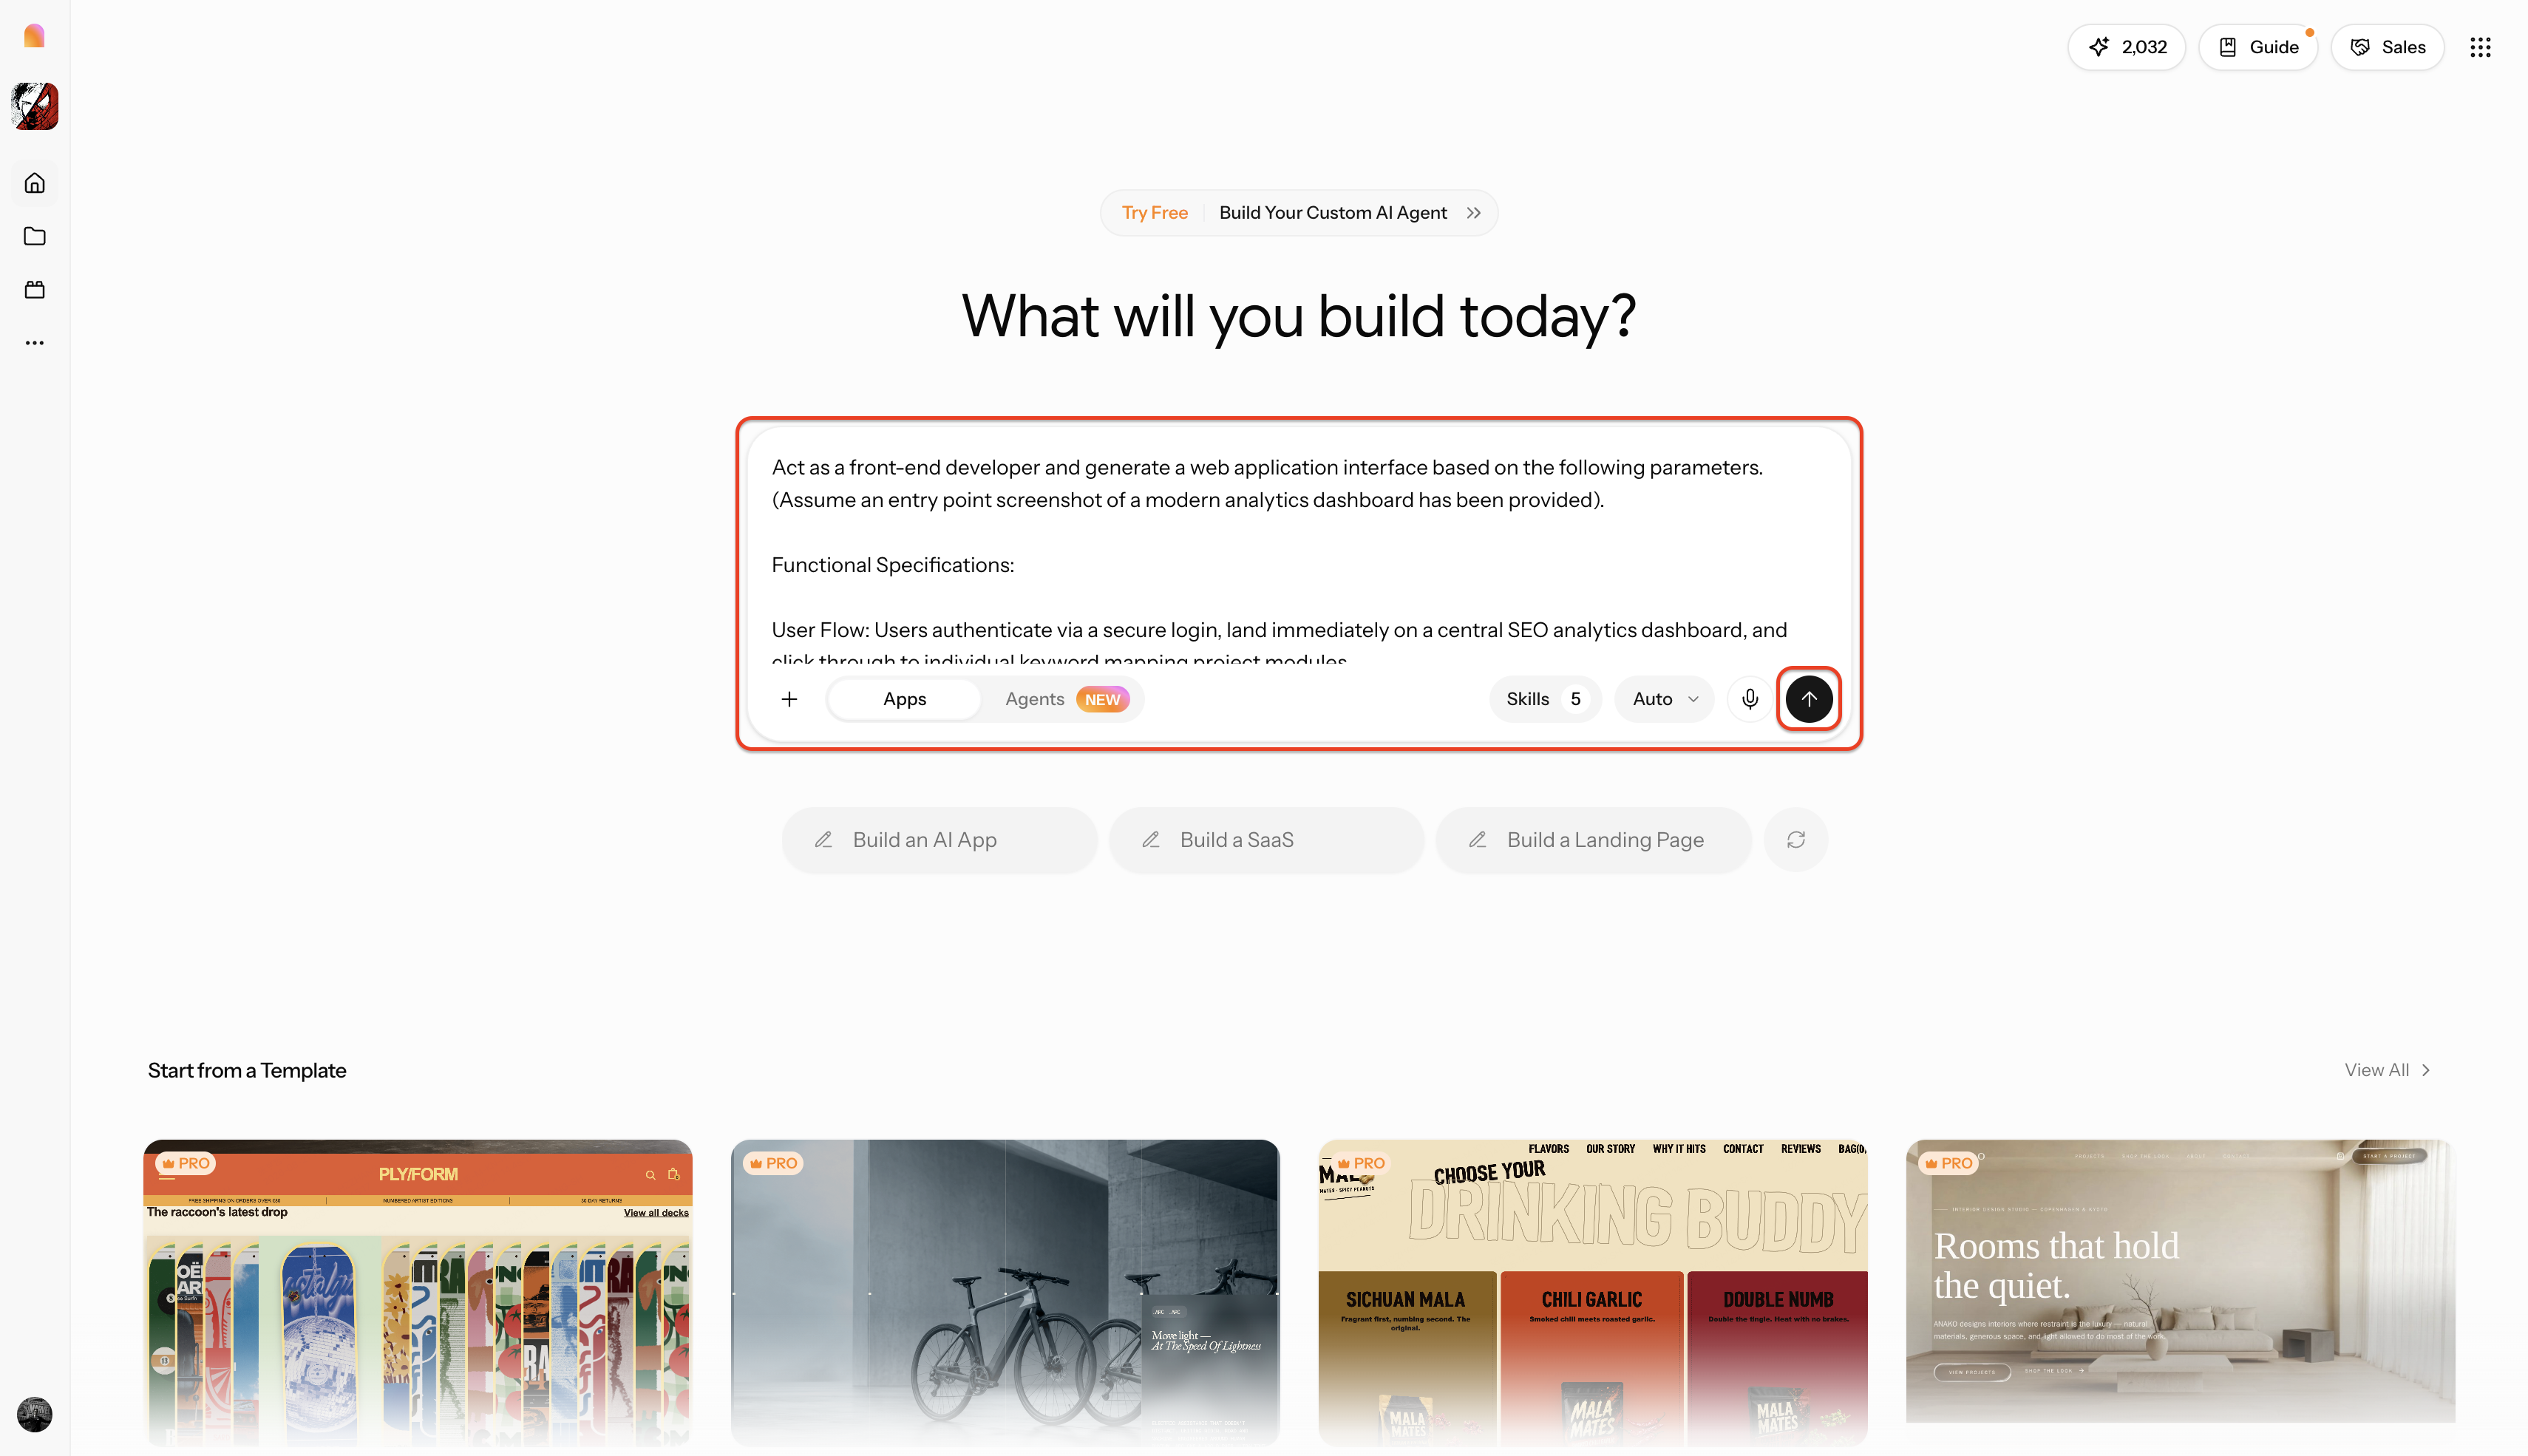
Étape 1 : Lancez Enter Pro et saisissez le prompt du projet
Commencez par définir vos spécifications fonctionnelles, préférences de style d'interface et fonctionnalités cibles entièrement en langage naturel. Vous pouvez facilement télécharger une capture d'écran du point d'entrée de l'interface pour guider la compréhension structurelle et esthétique de l'IA dès le départ.
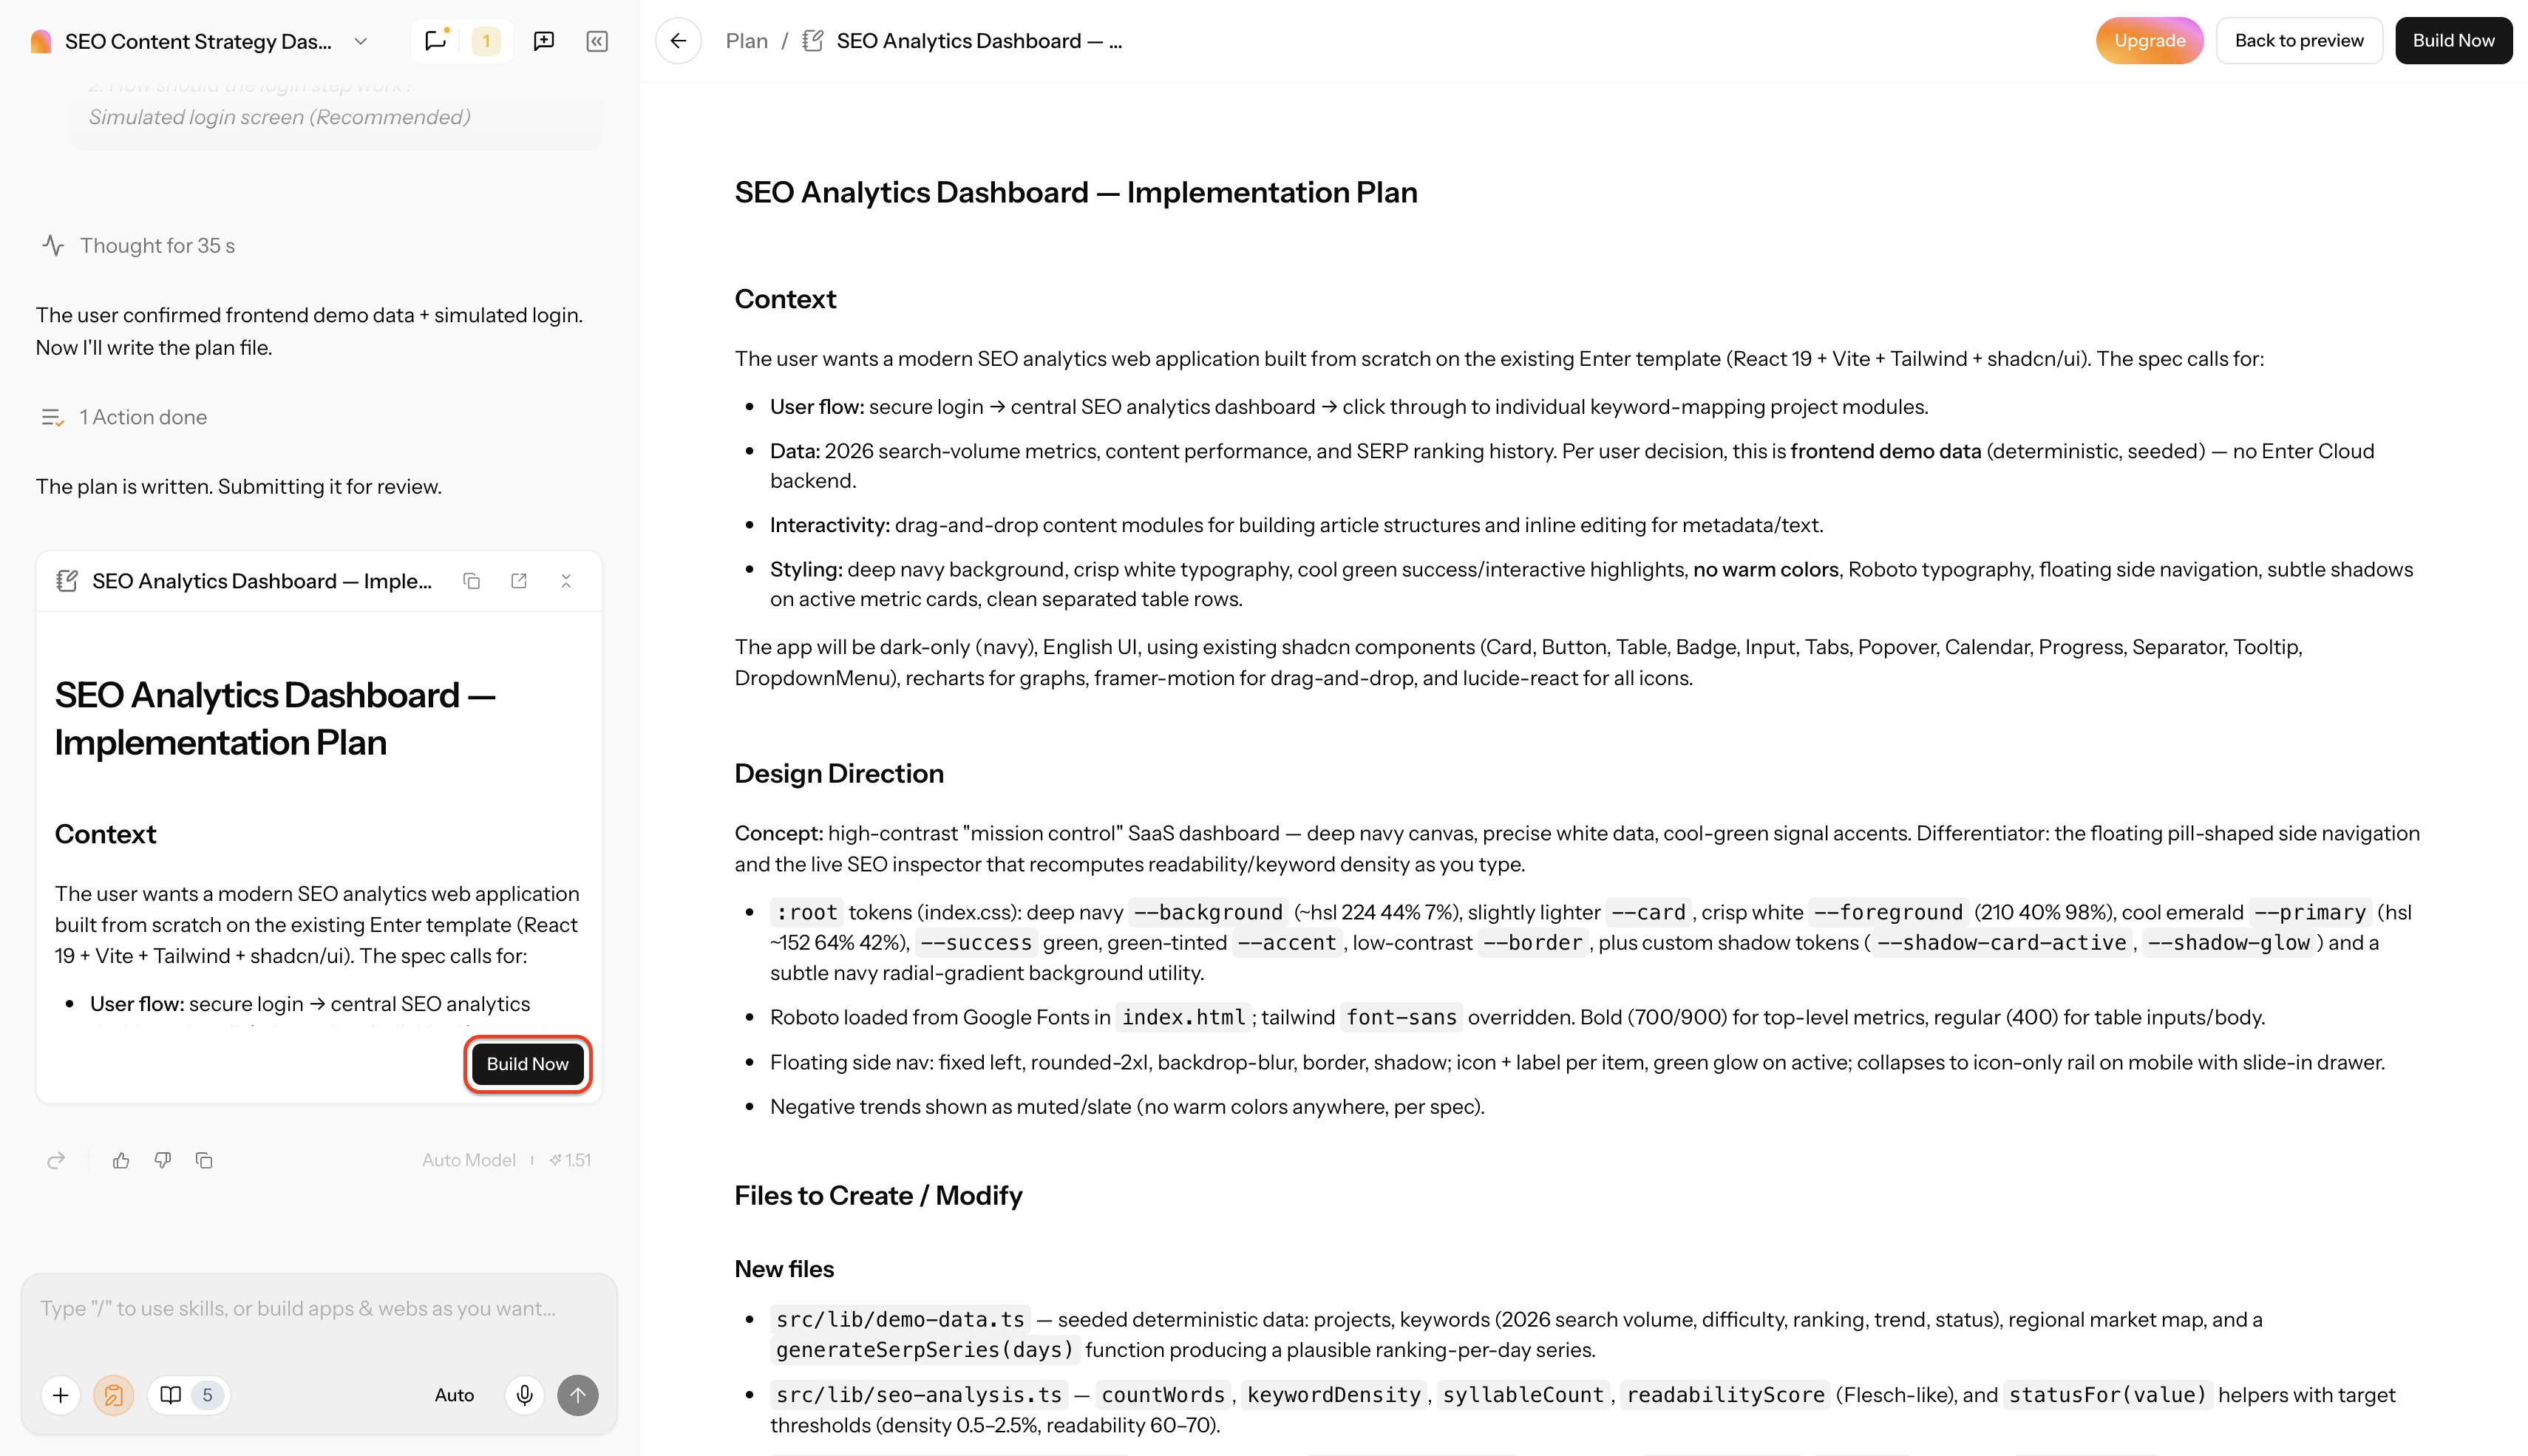
Étape 2 : Examinez le plan d'implémentation et construisez
Examinez le plan généré par l'IA décrivant le contexte de l'application, l'orientation du design et les structures de fichiers nécessaires. Une fois prêt, cliquez simplement sur le bouton « Build Now » pour lancer le processus de génération de code full-stack.
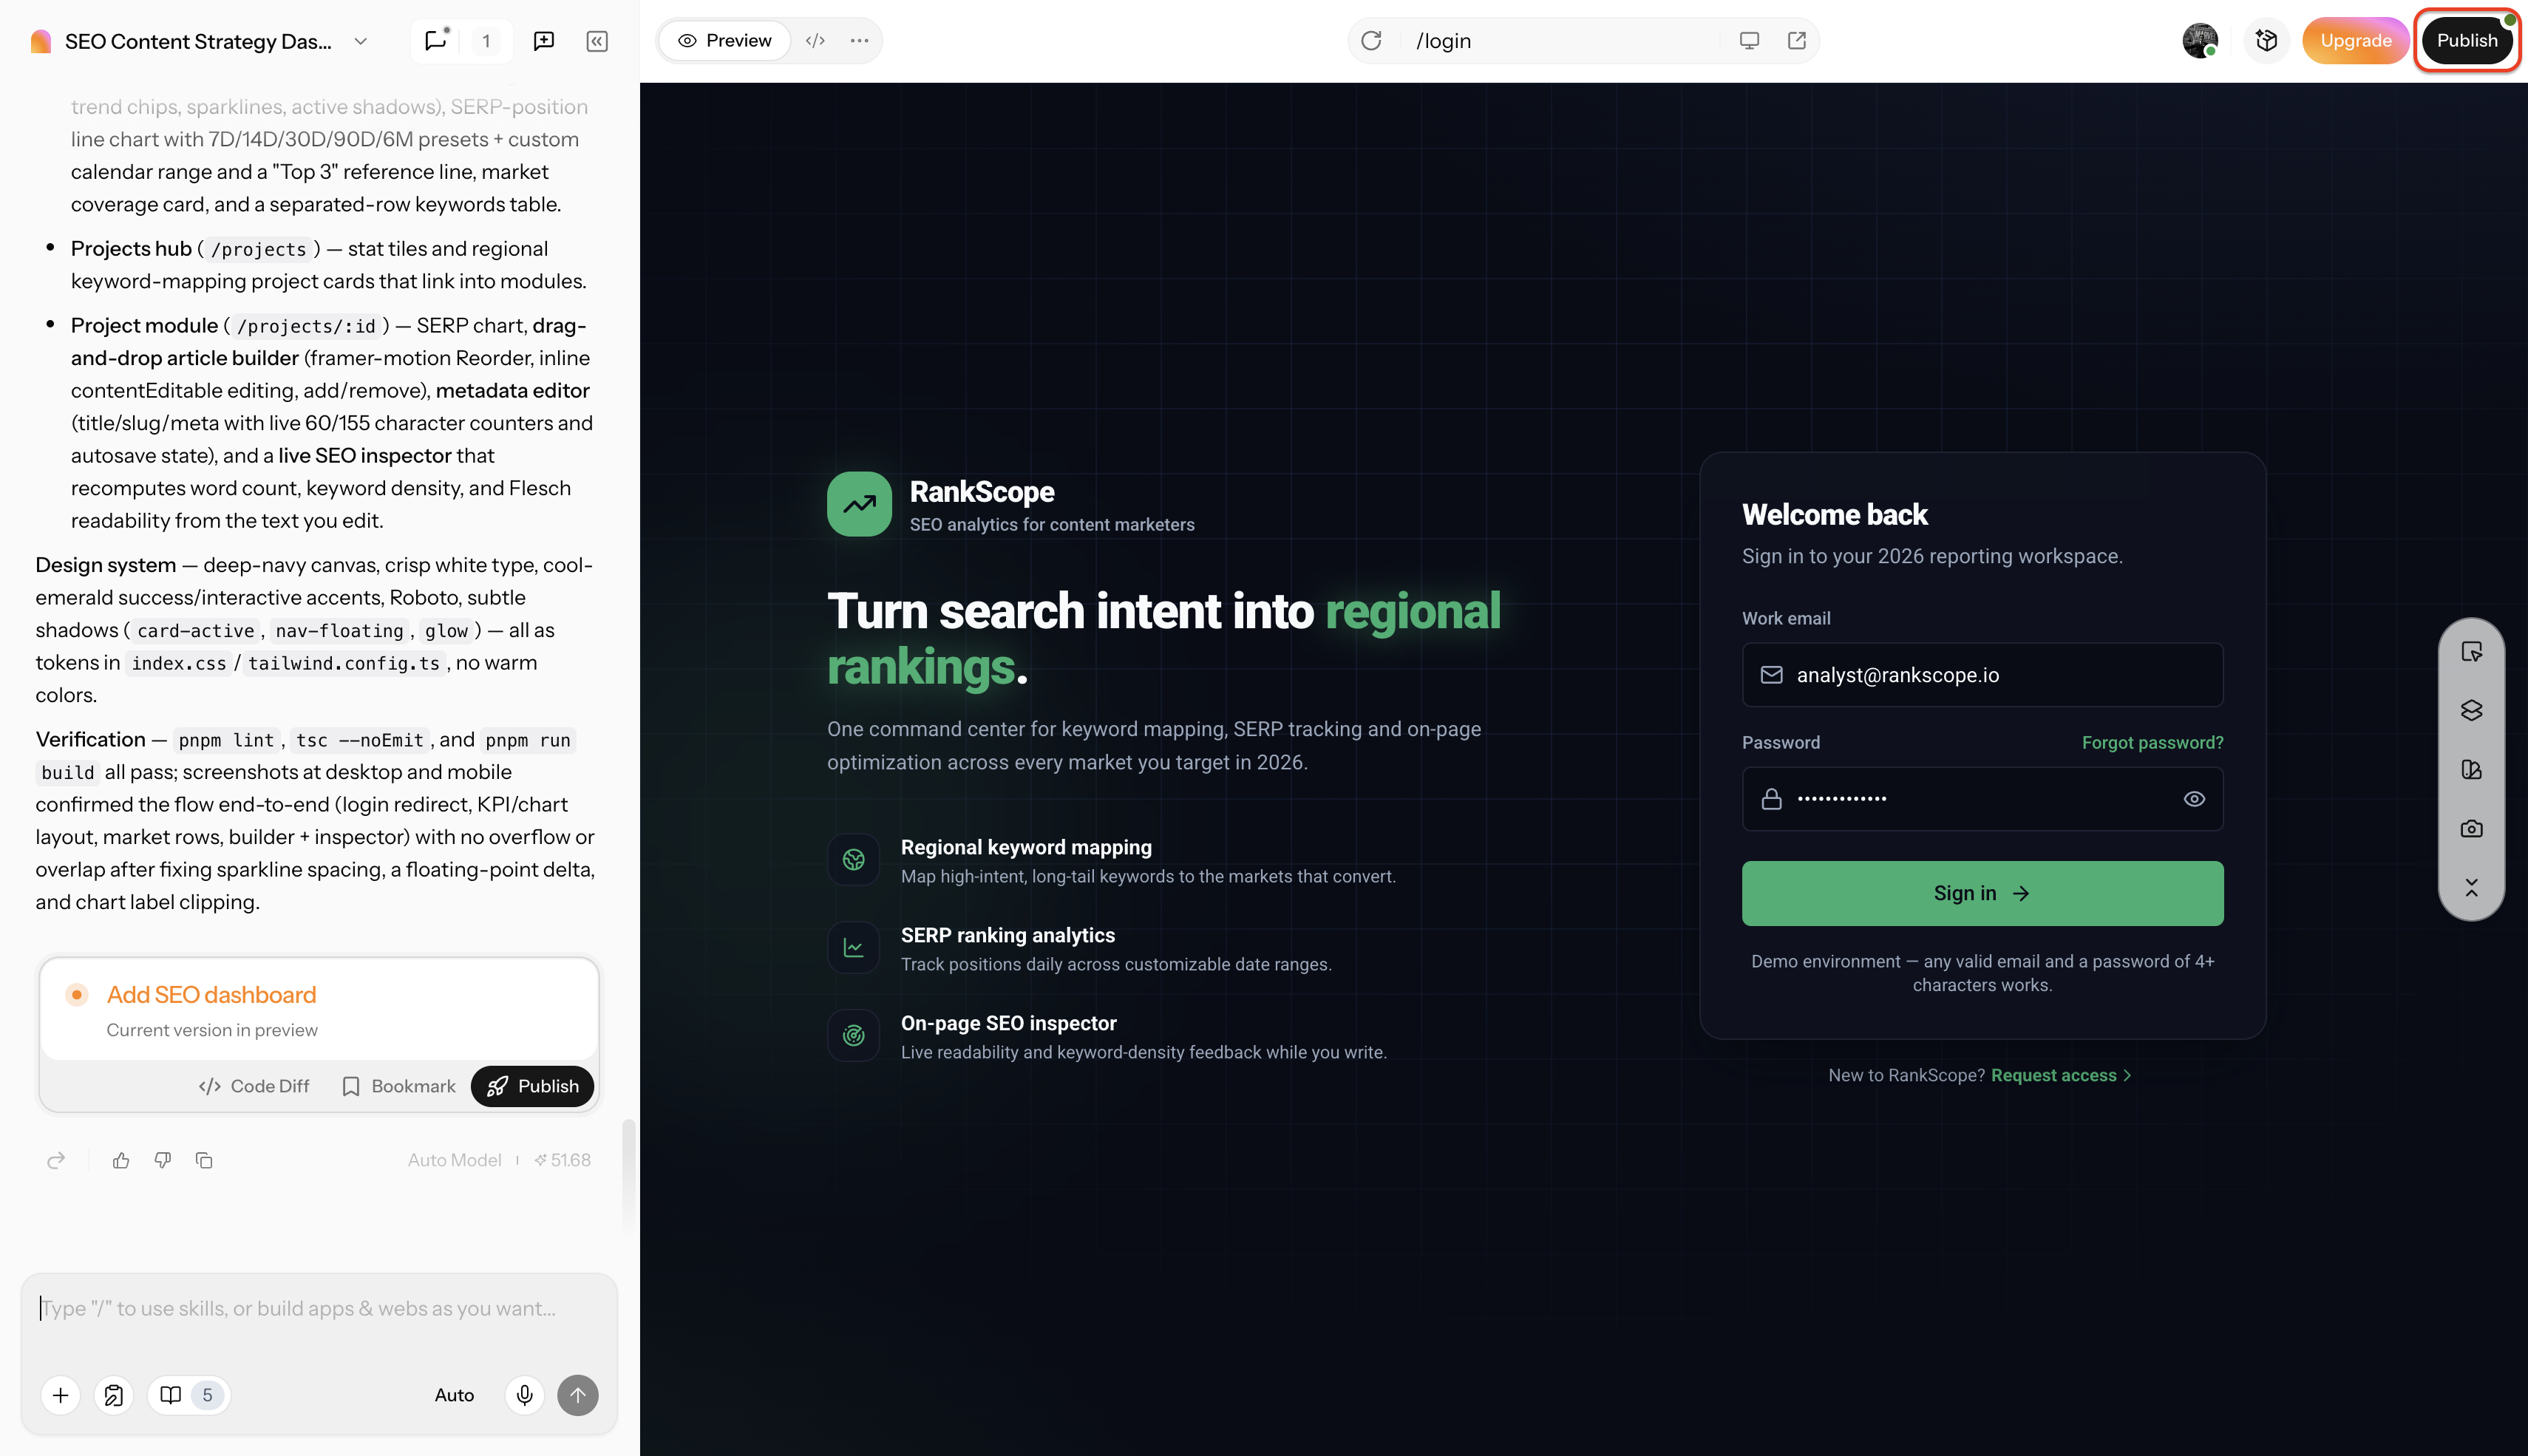
Étape 3 : Modifiez, publiez et exportez
Affinez l'application générée en modifiant avec de simples descriptions de prompt ou l'éditeur visuel. Une fois satisfait des résultats, déployez l'application en direct sur le web en un seul clic, ou exportez en toute sécurité les fichiers source structurés vers votre machine locale.
LLM cloud vs. LLM locaux vs. agents IA autonomes : Compromis performance & confidentialité
Choisir l'architecture la plus appropriée nécessite d'analyser en profondeur les compromis fondamentaux présents dans votre environnement d'ingénierie actuel.
| Dimension | LLM cloud de pointe | LLM locaux auto-hébergés | Agent autonome (Enter Pro) |
|---|---|---|---|
| Confidentialité des données | Dépend de la politique de données de l'API cloud | 100 % privé/isolé | Espace de travail isolé/propriété du code |
| Charge matérielle | Aucun calcul local requis | Nécessite un VRAM/GPU élevé | Aucun calcul local requis |
| Complexité de configuration | Clé API & configuration de plugin IDE | Configuration du runtime local & quantification | Espace de travail visuel prompt-et-lancement |
| Portée de sortie | Extraits, fonctions & conseils de chat | Complétion de code & modifications locales | Applications full-stack complètes |
| Modèle de coût | Abonnement API payé par token | Coût matériel local initial | Abonnement plateforme fixe |
- Confidentialité et propriété intellectuelle : Lorsque je traite des bases de code strictes et hautement propriétaires, je privilégie systématiquement les modèles locaux pour empêcher entièrement toute fuite de PI confidentielle. Envoyer de la logique d'entreprise non publiée vers des serveurs distants viole souvent des réglementations de conformité strictes.
- Exigences matérielles : Exécuter des modèles open source nécessite du matériel dédié sérieux. Un modèle de 7 milliards de paramètres nécessite généralement d'allouer au moins 8 Go de VRAM, un modèle de 14 milliards nécessite 16 Go, et les énormes modèles de 70 milliards de paramètres nécessitent 48 Go+ de VRAM, ce qui exige souvent des configurations de bureau à double GPU coûteuses ou des serveurs locaux spécialisés.
- Latence vs capacité : Les grilles de calcul cloud offrent une puissance immense et inégalée pour le raisonnement profond et la refonte massive multi-fichiers. Cependant, lorsque je passe à des modèles locaux auto-hébergés, je bénéficie d'un avantage réseau strict à latence zéro qui les rend vastement supérieurs et bien plus fluides pour les complétions de texte en ligne instantanées.
Verdict de la communauté : avis des développeurs et tendances du vibe coding
- Le vibe coding désigne un workflow de développement moderne où les développeurs pilotent l'architecture système de haut niveau et la logique applicative à l'aide de prompts en langage naturel, tandis que l'IA génère de manière autonome la syntaxe boilerplate. Plutôt que de taper manuellement des routines, l'ingénieur agit comme un directeur architectural, guidant l'intention du projet et révisant les résultats générés.
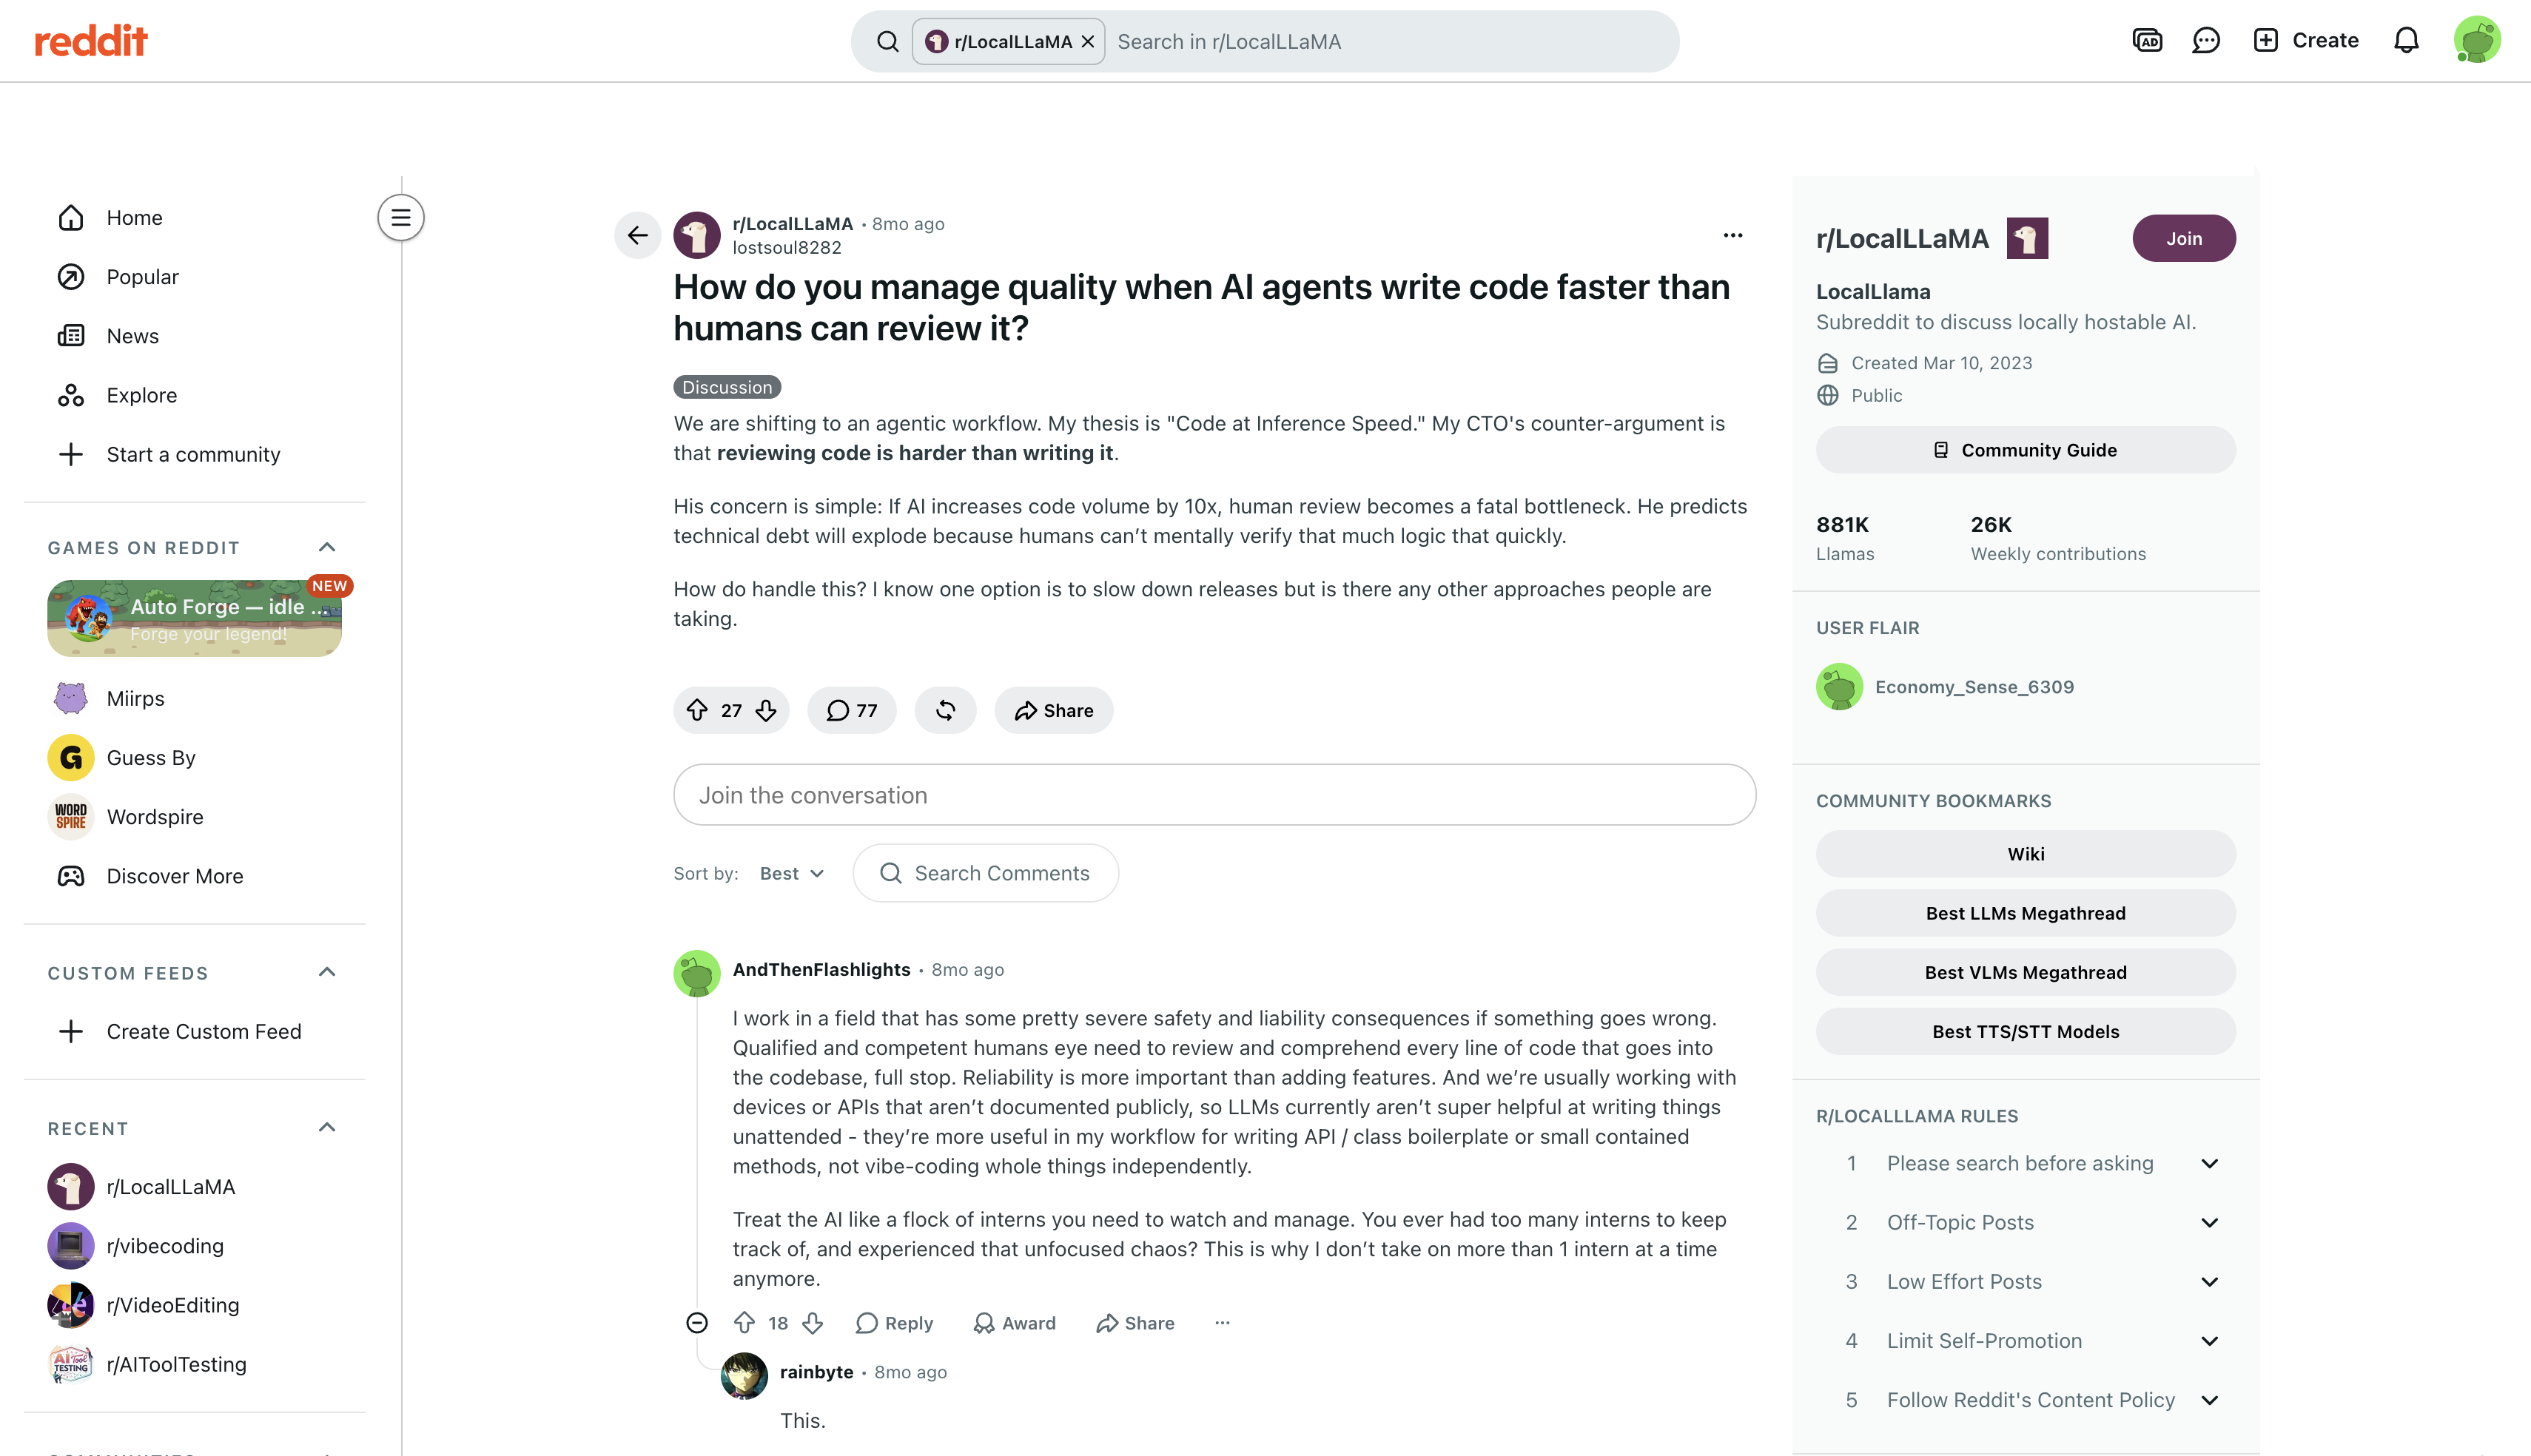
Consensus de la communauté Reddit :
- En synthétisant les perspectives issues des discussions de développeurs sur r/vibecoding, les ingénieurs adoptent fréquemment une approche échelonnée et multi-modèles. Ils s'appuient rarement sur un seul outil pour gérer une construction full-stack complète.
- Les développeurs initient généralement l'échafaudage de haut niveau et les concepts frontend avec des modèles rapides et polyvalents. Ils basculent ensuite immédiatement vers Claude Opus 5 pour l'exécution logique profonde, la refonte complexe multi-fichiers et le débogage ciblé.
- Les discussions sur des forums d'ingénierie comme r/LocalLLaMA soulignent que la supervision humaine reste strictement nécessaire. Si la génération autonome accélère les constructions initiales, les développeurs doivent gérer activement des dépendances d'état complexes pour éviter la dérive logique.
Préférences de modèles de la communauté :
- Workflows sans configuration : Les ingénieurs privilégient fortement les configurations propulsées par le cloud intégrées directement dans des éditeurs de code modernes natifs de l'IA pour un développement rapide. Claude Opus 5 est largement cité comme la référence de facto pour son équilibre entre précision zero-shot, rétention de contexte et sortie hautement fiable.
- Configurations des passionnés du local : De nombreux développeurs optent pour des déploiements locaux afin d'éviter les dépenses récurrentes de tokens API et de protéger des bases de code privées. Les modèles open source comme Qwen3-Coder-Next et DeepSeek V4-Pro sont largement recommandés pour l'auto-hébergement via des runtimes comme Ollama, offrant une génération de code solide sans aucune télémétrie de données.
Conclusion
Finalement, aucun LLM unique pour coder ne convient parfaitement à tous les cas d'usage en ingénierie en 2026. Les modèles cloud de pointe offrent la puissance de raisonnement brute nécessaire pour la refonte de systèmes complexes et la conception structurelle. Pour la sécurité d'entreprise, le meilleur LLM local pour coder garantit zéro fuite de données dans des environnements hautement sensibles. Parallèlement, l'adoption d'agents de développement autonomes rationalise la livraison complète d'applications, du concept initial au déploiement en production. Évaluez le budget, les capacités matérielles et les politiques de sécurité des données de votre équipe avant de vous engager dans un seul écosystème. Démarrez un IDE et configurez quelques clés API ou runtimes locaux. Comparez ces modèles sur votre propre base de code pour découvrir quel ensemble d'outils élève vraiment votre workflow d'ingénierie.
FAQ sur le meilleur LLM pour coder
Quel LLM est le meilleur pour coder en 2026 ?
Claude Opus 5 est actuellement le meilleur LLM de code pour l'ingénierie logicielle complexe, la refonte multi-fichiers et les boucles d'agents autonomes. Pour les développeurs recherchant une exécution déterministe et une large intégration IDE, GPT-5.6 Sol constitue la meilleure alternative cloud. Les équipes privilégiant une confidentialité stricte des données peuvent déployer des modèles à poids ouverts puissants comme GLM-5.2 ou DeepSeek V4-Pro en local, sans dépendance au cloud.
Quel est le meilleur LLM local pour coder sur des ordinateurs portables grand public ?
Qwen3-Coder-Next et GLM-5.2 sont fortement optimisés pour les environnements locaux. Qwen3-Coder-Next offre une excellente efficacité par paramètre sur du matériel modeste, tandis que GLM-5.2 est le meilleur codeur à poids ouverts avec un contexte de 1M tokens.
Combien de RAM et de VRAM faut-il pour exécuter des modèles LLM locaux ?
Pour exécuter confortablement un modèle de codage standard de 7 milliards de paramètres, il faut au moins 8 Go de VRAM GPU ou de mémoire unifiée Apple. Les modèles plus grands de 14 milliards nécessitent environ 16 Go, tandis que les énormes modèles de niveau entreprise de 70 milliards nécessitent entre 48 Go et 64 Go de VRAM pour fonctionner sans accroc.
Les modèles de codage cloud sont-ils sûrs pour le code d'entreprise propriétaire ?
Cela dépend entièrement et exclusivement de la politique de conservation de l'API du fournisseur spécifique. Si les accords d'API d'entreprise haut de gamme promettent généralement de ne pas s'entraîner sur les données des utilisateurs, la conformité d'entreprise stricte et les réglementations gouvernementales imposent souvent des modèles locaux entièrement isolés pour garantir une sécurité absolue.
Qu'est-ce que le « vibe coding » et quel modèle lui convient le mieux ?
Cela désigne un workflow de développement moderne où un ingénieur dirige la logique applicative à l'aide de prompts larges et de haut niveau en langage naturel, tandis que l'IA gère de manière autonome toute la génération de boilerplate et l'écriture de syntaxe. Les modèles de pointe comme Claude Opus 5 et GPT-5.6 Sol excellent fortement dans cette méthodologie pour le codage agentique et les grandes refontes.
Comment les modèles de codage open source se comparent-ils à Claude Fable 5 ?
Les modèles à poids ouverts comme GLM-5.2 et DeepSeek V4-Pro rattrapent rapidement l'écart, dépassant des références antérieures comme GPT-5.5 sur SWE-bench Pro et les défis algorithmiques. Cependant, les moteurs de pointe comme GPT-5.6 Sol et Claude Fable 5 maintiennent encore un avantage distinct sur les refontes massives et les boucles d'agents complexes.
Les LLM de codage peuvent-ils remplacer les ingénieurs logiciels humains ?
Non. Ces modèles agissent actuellement comme des compilateurs très avancés et de puissants accélérateurs de workflow. Ils exigent toujours absolument des ingénieurs humains expérimentés pour concevoir méticuleusement l'architecture système, gérer des protocoles de sécurité complexes et vérifier rigoureusement la logique fonctionnelle avant le déploiement en production.
Quel est le meilleur LLM open source gratuit pour le développement Python ?
GLM-5.2 et Qwen3-Coder-Next possèdent tous deux des capacités étendues et hautement spécialisées. GLM-5.2 s'étend jusqu'à un contexte de 1M tokens pour les grandes bases de code, tandis que Qwen3-Coder-Next offre une excellente efficacité pour les déploiements locaux plus petits, faisant de tous deux des choix gratuits exceptionnels pour les workflows de développement web standard.





