
Analyse de GLM-5 : versions, benchmarks, tarifs et accès
Comparez les versions de GLM-5, leurs benchmarks, tarifs, architecture, déploiement local, accès API et intégration avec Enter Pro.
GLM-5 n'est plus un modèle unique qu'on peut évaluer avec un seul benchmark. C'est désormais toute une famille agile : certaines variantes ne traitent que du texte, d'autres acceptent des images en entrée, les versions récentes ont étendu la fenêtre de contexte à 1 million de tokens, et l'option la plus abordable ne coûte qu'une fraction du modèle phare.
Avant de mettre à jour cette analyse, j'ai passé en revue les notes de version, les fiches modèles, la documentation API, le dépôt et des captures d'écran réelles du produit de Z.ai. C'est important, car certaines affirmations sont assez séduisantes — comme un gain interne de 50 % en codage ou un calcul 2,9 fois moindre sur les contextes longs — mais elles proviennent de Z.ai, et non d'un audit indépendant. Je les présente donc comme des affirmations, pas comme mes propres résultats de test.
Quatre questions se posent lors du choix d'un modèle GLM-5 : quels types d'entrées avez-vous ? Quel est le niveau de difficulté de la tâche ? Où devez-vous exécuter l'inférence ? Combien coûte un résultat réussi s'il y a des tentatives répétées ? Ma réponse rapide : GLM-5.3 pour du texte ou du code complexe, GLM-5.3-Flash pour le multimodal ou l'optimisation des coûts, et GLM-5.2 si vous disposez déjà d'une intégration validée.
Qu'est-ce que GLM-5 ?
GLM-5 est la famille de modèles à poids ouverts développée par Z.ai pour l'ingénierie logicielle, l'usage d'outils et les agents à long horizon. La version originale (février 2026) est un modèle Mixture-of-Experts (MoE) à entrée et sortie textuelles uniquement, avec 744 milliards de paramètres au total, environ 40 milliards de paramètres actifs par token, et une fenêtre de contexte de 200 000 tokens. Ces spécifications proviennent du rapport technique de GLM-5 et du dépôt GitHub officiel.
Un modèle MoE n'active pas tout le réseau pour chaque token. Un routeur envoie chaque token vers un petit groupe d'experts, ce qui réduit le calcul actif tout en conservant un checkpoint très volumineux. Cela ne fait pas de GLM-5 un modèle pour ordinateur portable : les poids complets nécessitent toujours du stockage, du routage et du matériel de niveau serveur.
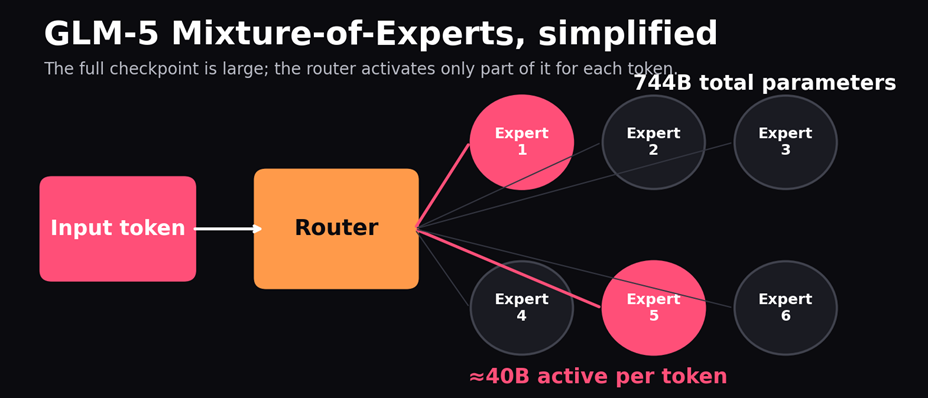
Figure 1. GLM-5 active environ 40 Md de paramètres sur 744 Md par token ; le checkpoint complet reste un déploiement à l'échelle serveur.
Le terme correct est « poids ouverts » (open weights). Le code, les poids du modèle, le service hébergé et les données d'entraînement répondent chacun à des conditions différentes. Vérifiez la licence associée à la fiche modèle que vous souhaitez utiliser avant tout usage commercial, car toutes les versions de GLM n'offrent pas les mêmes droits.
La famille de versions GLM-5
Le nom de famille masque des différences importantes. Choisissez selon la modalité, le contexte, l'historique de validation et le mode de déploiement, plutôt que de traiter chaque version 5.x comme interchangeable.
| Version | Entrée/contexte | Meilleure raison de l'utiliser | Point de vigilance important |
|---|---|---|---|
| GLM-5 | Texte / 200K | Recherche initiale ou intégration historique | Premier lancement de la famille ; pas mon choix par défaut pour un nouveau projet |
| GLM-5-Turbo | Texte / 200K | Travail d'agent hébergé et intensif en outils | Un accès fournisseur, pas un petit checkpoint téléchargeable |
| GLM-5V-Turbo | Texte, images, vidéo, fichiers / 200K | Codage visuel et tâches GUI | Vérifiez les formats acceptés sur votre endpoint |
| GLM-5.1 | Texte / 200K | Exécutions d'ingénierie prolongées | Dépassé pour la plupart des nouvelles évaluations |
| GLM-5.2 | Texte / 1M | Contexte long et intégrations déjà validées | La migration vers 5.3 modifie le comportement de raisonnement |
| GLM-5.3 | Texte / 1M | Codage difficile et agents longue durée | Le raisonnement est toujours activé ; la sortie peut être longue |
| GLM-5.3-Flash | Multimodal / 1M | Captures d'écran, volume et faible coût | Architecture distincte 320B/18B, pas « 5.3 en mode économique » |
Sources : notes de version de Z.ai, guide GLM-5-Turbo, guide GLM-5V-Turbo et guide GLM-5.1. Un hébergeur peut exposer une fenêtre de contexte plus petite que celle supportée par le modèle.
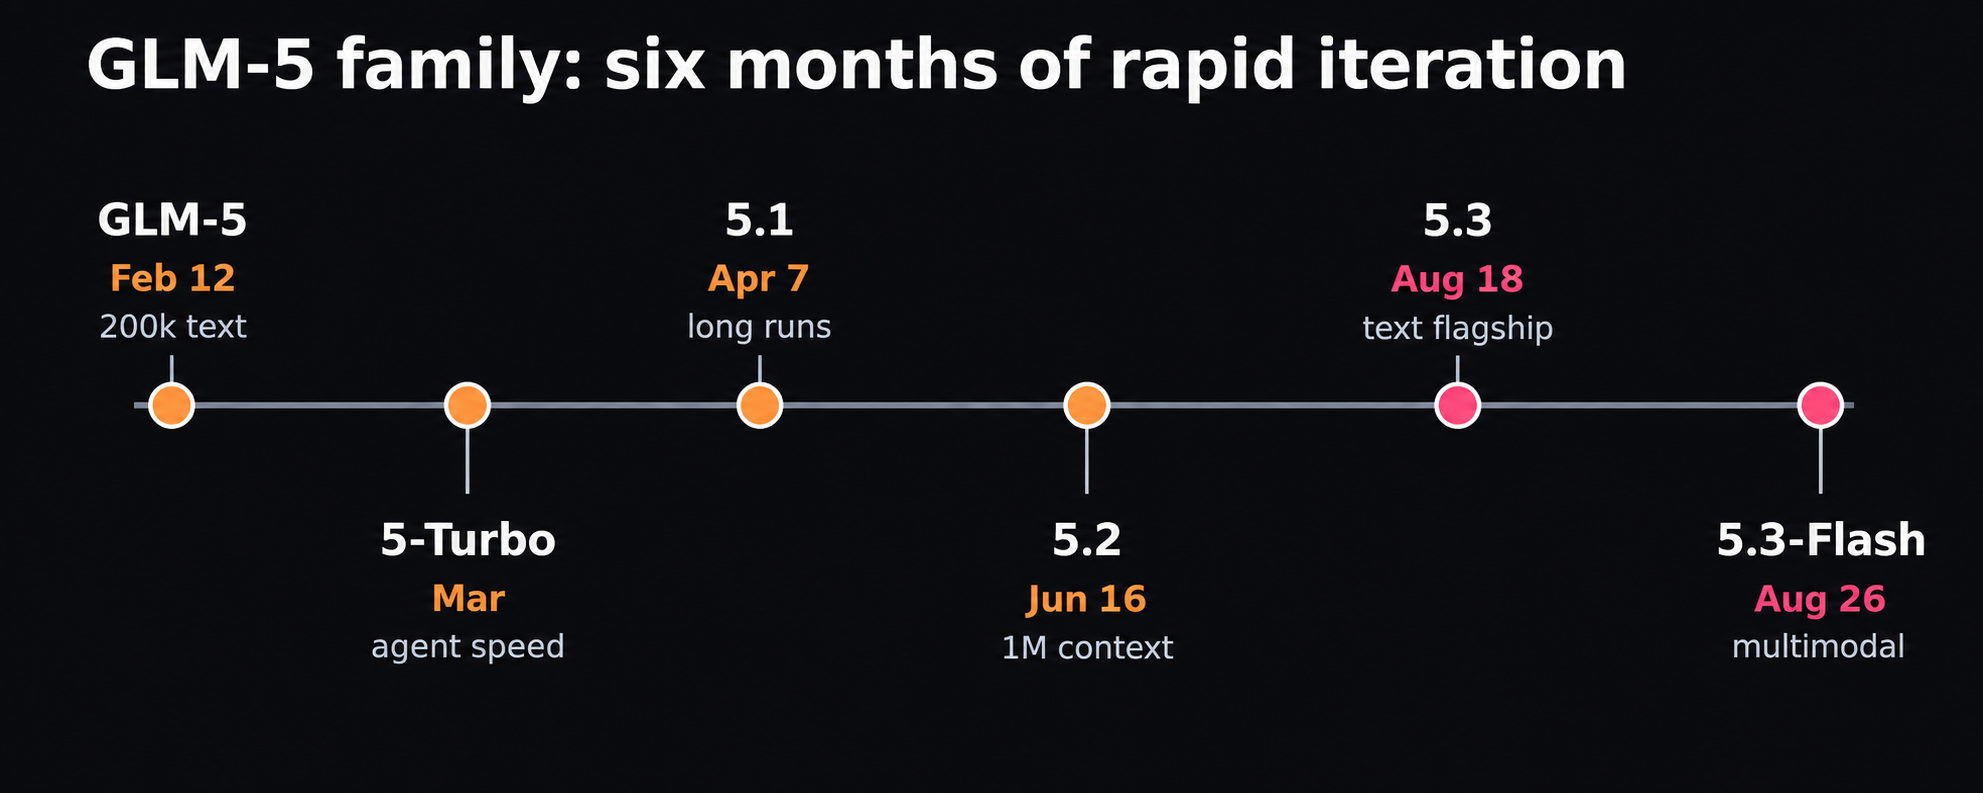
Figure 2. Six mois de versions ont modifié la longueur de contexte, la modalité, le comportement de raisonnement et le prix.
De GLM-5 à GLM-5.2
L'architecture orientée agent a été mise en place avec le GLM-5 de base. GLM-5.1 s'est concentré sur les exécutions prolongées ; Z.ai affirme qu'il peut fonctionner jusqu'à 8 heures, mais il faut prendre cela avec recul, car votre dépôt peut se comporter différemment. GLM-5.2 a ensuite ajouté une fenêtre de contexte d'un million de tokens, des réglages d'effort flexibles, et IndexShare pour une attention efficace sur les contextes longs.
GLM-5.3 et GLM-5.3-Flash
Le modèle phare de GLM est purement textuel : GLM-5.3. Selon sa documentation, il a une limite de 1 million de tokens en entrée, une limite de 128K en sortie, et des niveaux d'effort de raisonnement faible, élevé ou maximal. Le « thinking » ne peut pas être désactivé ; une requête 5.2 qui le désactive explicitement peut échouer lors de la migration.
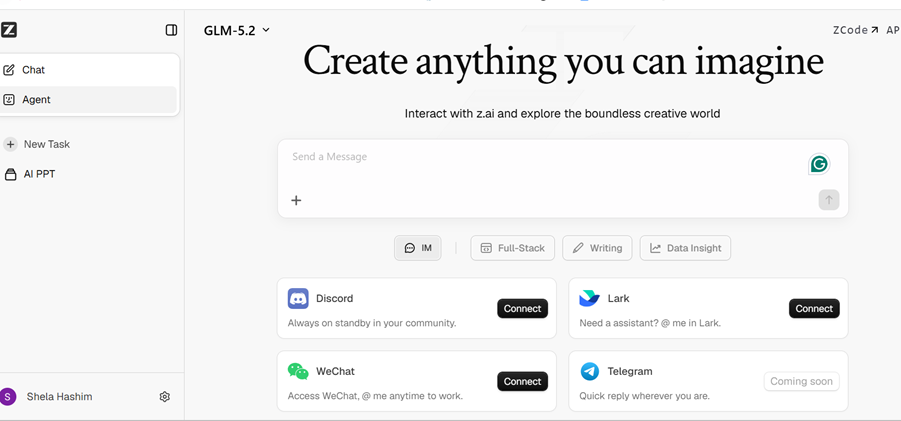
Figure 3. L'interface en direct de GLM-5.3 confirme un accès phare distinct ; la disponibilité et les libellés peuvent changer.
GLM-5.3-Flash est un autre modèle de 320B de paramètres totaux / 18B actifs, doté d'une entrée multimodale native et d'une attention hybride sparse/linéaire. Ma première recommandation est simple : lorsque la profondeur compte, utilisez 5.3 ; pour les captures d'écran ou un fort volume, testez d'abord Flash.
Avant de modifier une intégration existante, rejouez des requêtes sauvegardées plutôt que de simplement remplacer le nom du modèle. Testez la sortie structurée, les arguments d'appel d'outils, la longueur maximale de complétion et la gestion des délais d'attente. Une réponse peut paraître plus séduisante dans un chat, mais peut faire échouer le parseur ou simplement dépasser la limite de latence de votre application. Conservez l'ancien accès actif jusqu'à ce que la nouvelle version passe les mêmes contrôles de production.
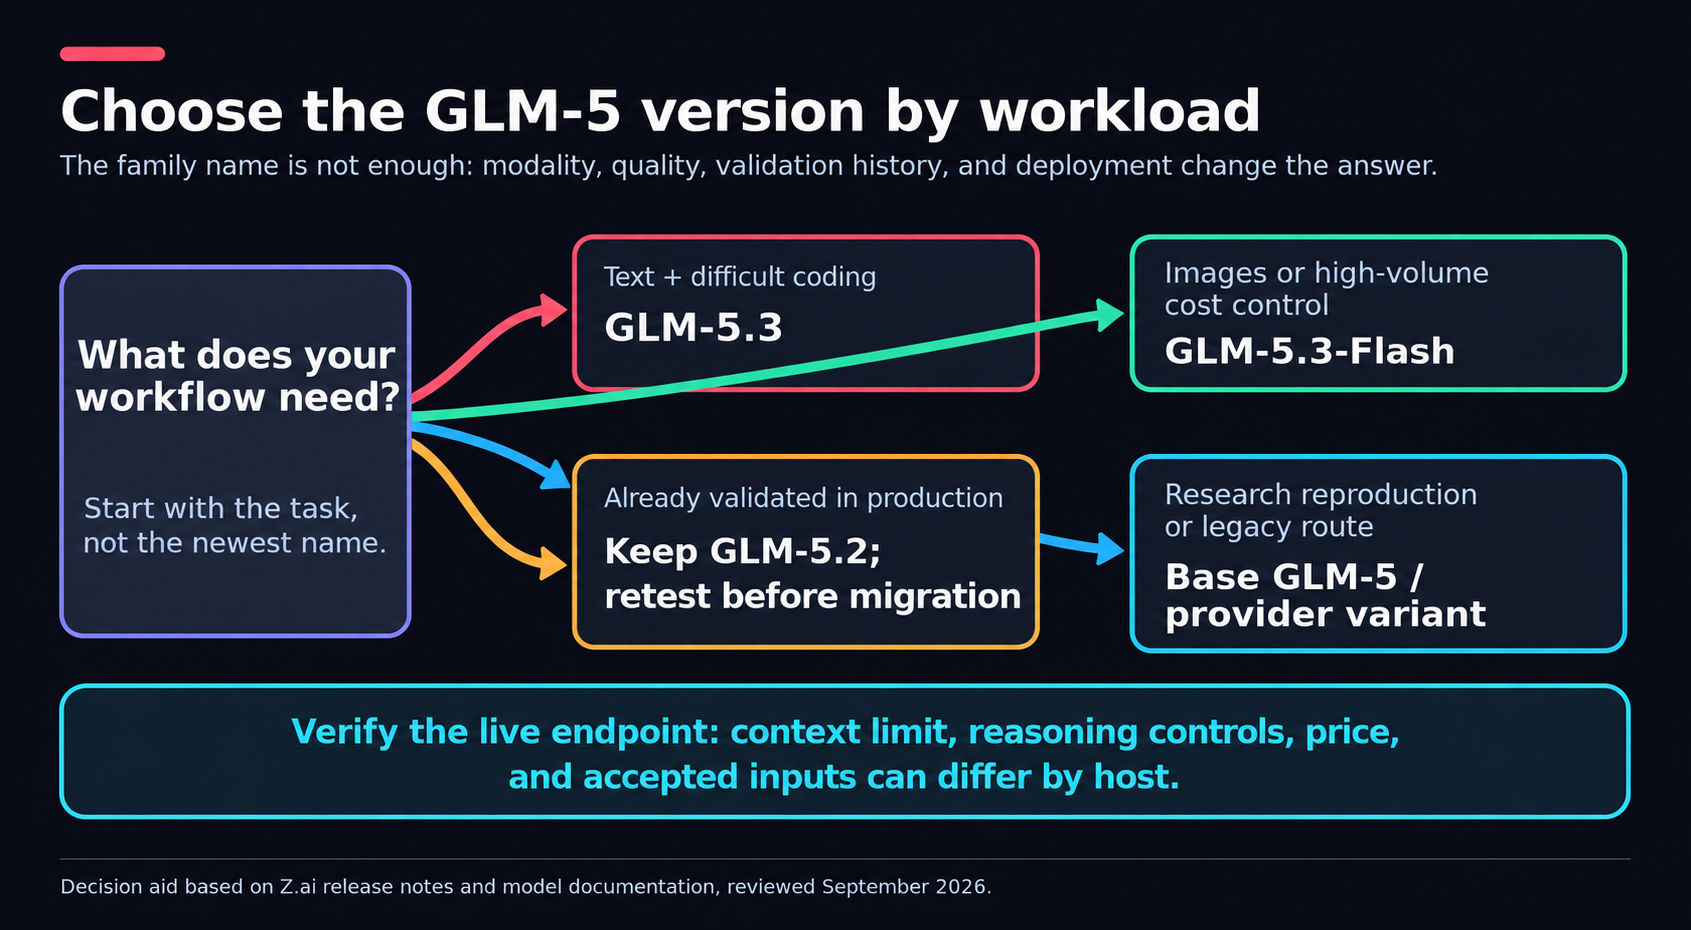
Figure 4. Choisissez selon la charge de travail et le comportement de l'endpoint, pas uniquement selon le nom du modèle le plus récent.
Comment GLM-5 se compare-t-il à Claude, GPT et Gemini ?
GLM-5.3 mérite sa place dans toute liste restreinte d'agents de codage, mais un seul tableau ne peut pas désigner un vainqueur absolu. Les scores Terminal-Bench dépendent du harnais, des permissions d'outils, du budget temps et du niveau d'effort. Z.ai rapporte 88,2 sur Terminal-Bench 2.1 et 28,3 sur Terminal-Bench 3.0 pour GLM-5.3 à effort maximal ; son tableau reproduit aussi les résultats de Claude Opus 4.8 et GPT-5.6 Sol.
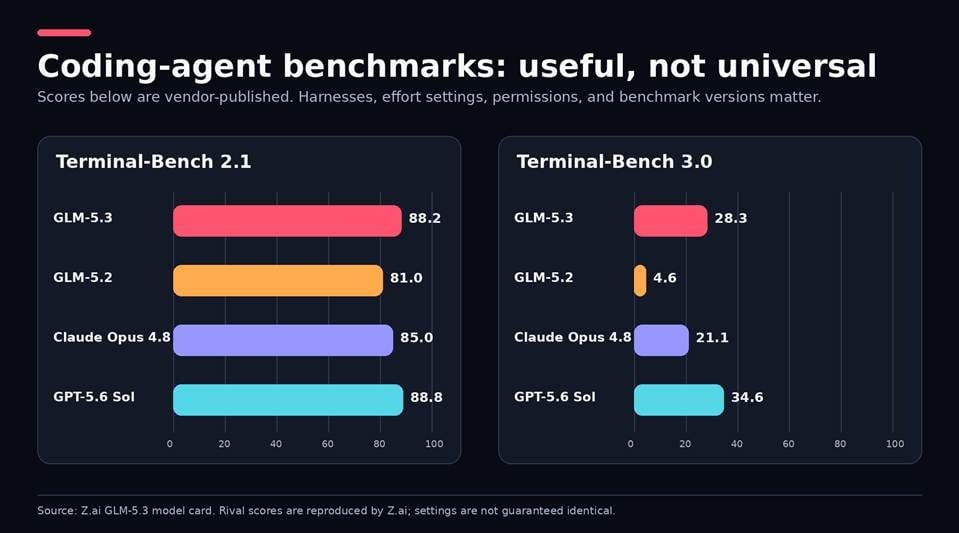
Figure 5. Les scores publiés par le fournisseur sont des indications directionnelles, pas un substitut à un test identique et spécifique à votre charge de travail.
Contrairement à d'autres modèles, la fiche de GLM-5.3 nomme ses harnais et ses réglages d'effort. Elle ne précise pas si les modèles concurrents ont été testés dans des conditions identiques. De même, selon le rapport GLM-5.2, il dépasse Gemini 3.1 Pro sur un sous-ensemble de tâches Terminal-Bench 2.1, une petite partie des tâches de codage mentionnées ici ; cela n'indique cependant pas que GLM dépasse Gemini 3.1 Pro sur toutes les tâches multimodales, de recherche ou de rédaction.
J'évaluerais les modèles avec les mêmes prompts, outils, délais d'attente et critères de réussite. Il faut noter le prix d'une tâche réussie, PAS le prix du token. Un modèle moins cher qui échoue trois fois peut s'avérer plus coûteux au final, et si Flash réussit vos tests dès le premier essai, l'avantage d'un modèle phare devient sans objet.
La fiche de GLM-5.3 est raisonnablement singulière en ce qu'elle indique les noms des harnais et les niveaux d'effort. Reste à démontrer si d'autres modèles concurrents ont été testés dans les mêmes conditions. De même, le guide GLM-5.2 indique qu'il surpasse Gemini 3.1 Pro sur Terminal-Bench 2.1 — une tâche orientée agents de codage — pas nécessairement sur des tâches multimodales, de recherche ou de rédaction.
J'examinerais les modèles avec les mêmes prompts, outils, délai d'attente et critère de réussite. Ne retenir que le coût de la tâche réussie, PAS le prix du token. Si les tests réussissent dès le premier essai, Flash est peut-être l'option la plus avantageuse, son avantage se réduisant alors probablement aussi face au modèle phare.
Dans les coulisses de l'entraînement et de l'architecture de GLM-5
Attention creuse (sparse) et IndexShare
Le contexte long est coûteux car l'attention prend généralement en compte de nombreuses relations entre tokens. Dans GLM-5.2, un indexeur a été introduit pour être réutilisé sur quatre couches d'attention différentes afin d'identifier les bons emplacements. Z.ai indique obtenir 2,9 fois moins de FLOPs par token à 1M de tokens. C'est une déclaration d'efficacité du développeur, pas une déclaration sur la latence de l'endpoint ou le coût réel des requêtes.
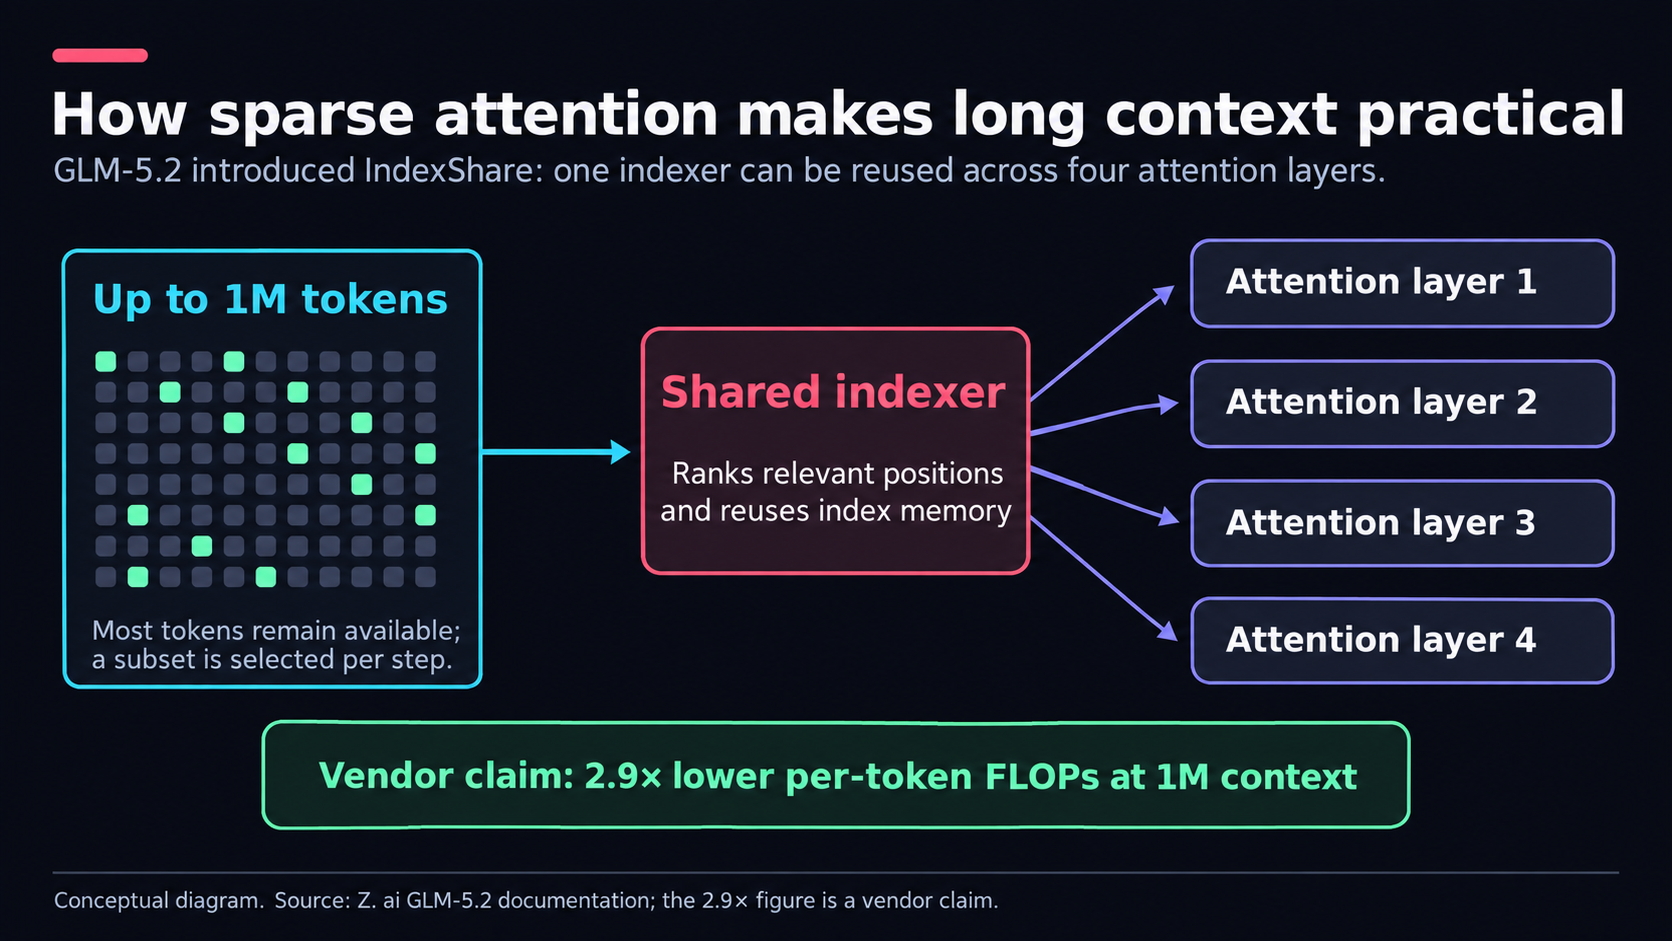
Figure 6. IndexShare réutilise un indexeur sur quatre couches d'attention ; le chiffre de 2,9x est une affirmation de Z.ai.
Apprentissage par renforcement à long horizon
Pour GLM-5.3, Z.ai présente sa propre vision d'un système d'apprentissage par renforcement asynchrone qu'ils appellent « slime », ainsi que la compaction de contexte et des vérificateurs synthétisés. Ces techniques ciblent les erreurs typiques observées chez les agents lors d'exécutions longues : perdre l'objectif de vue, abandonner une tâche, ou ne pas vérifier la réponse. Même ainsi, des checkpoints et des tests externes restent nécessaires, ce qui peut impliquer des trajectoires plus longues et des traces d'échec plus importantes.
Les capacités en cybersécurité nécessitent une validation humaine
Dans le cadre de sa collaboration en sécurité, Z.ai révèle 2 436 vulnérabilités dans 269 projets open source, dont 1 097 de sévérité moyenne à élevée. Ces chiffres sont probablement pertinents pour GLM-5.3 lors d'une revue défensive, mais GLM-5.3 n'identifie pas une vulnérabilité confirmée, seulement un constat du modèle.
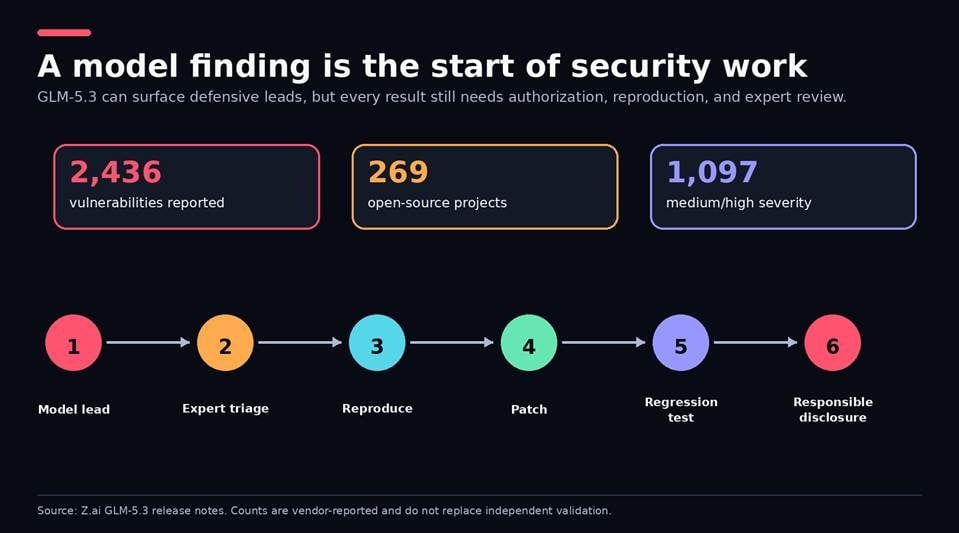
Figure 7. Reproduisez, corrigez, effectuez des tests de régression et divulguez de manière responsable ; ne dirigez jamais un agent contre des systèmes que vous n'êtes pas autorisé à tester.
Tarification de GLM-5
Z.ai distingue les coûts d'entrée non mise en cache, d'entrée mise en cache et de sortie depuis septembre 2026. J'ai revérifié ces prix avec la page tarifaire officielle du site ; ne présumez pas de leur stabilité lors de l'établissement d'un budget, car ils peuvent évoluer dans le temps.
| Modèle | Entrée / 1M | Entrée en cache / 1M | Sortie / 1M |
|---|---|---|---|
| GLM-5 | 1,00 $ | 0,20 $ | 3,20 $ |
| GLM-5.1 | 1,40 $ | 0,26 $ | 4,40 $ |
| GLM-5.2 | 1,40 $ | 0,26 $ | 4,40 $ |
| GLM-5.3 | 1,40 $ | 0,26 $ | 4,40 $ |
| GLM-5.3-Flash | 0,15 $ | 0,03 $ | 0,50 $ |
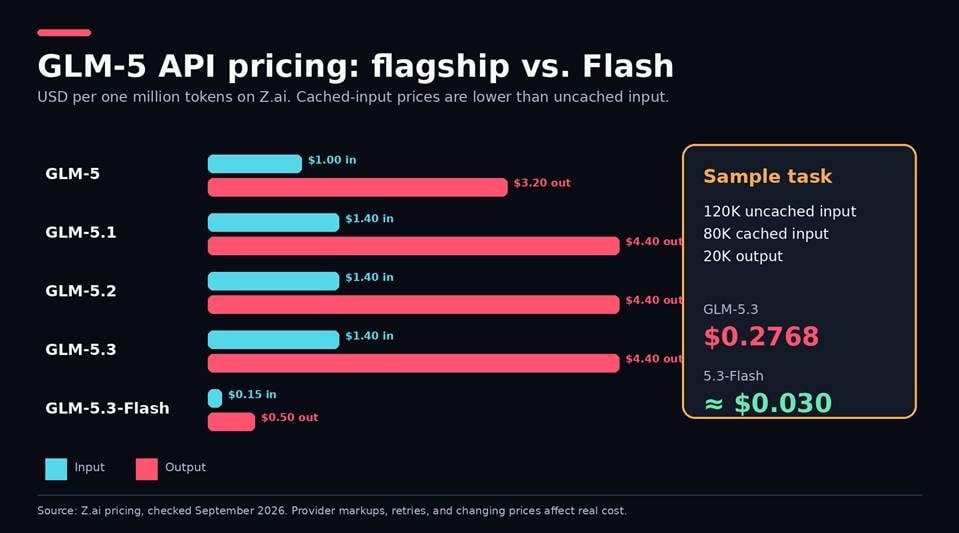
Figure 8. La tarification de l'API Z.ai montre pourquoi la longueur de sortie et les tentatives répétées peuvent dominer la facture finale.
Le coût de GLM-5.3 est d'environ 0,2768 $ pour 120K d'entrée non mise en cache, 80K d'entrée mise en cache et 20K de sortie ; pour 5.3-Flash, il est d'environ 0,030 $ (hors tentatives répétées). D'autres hébergeurs comme OpenRouter peuvent proposer des prix, limites, latences et routages différents. Le GLM Coding Plan n'est pas un quota API de production, mais un abonnement distinct pour les outils de codage pris en charge.
La sortie est l'aspect coûteux de la requête, et un agent qui raisonne longtemps peut rapidement dépasser une estimation rapide. Je fixerais un plafond de sortie, j'utiliserais le cache lorsque le contexte répété s'y prête, et je consignerais le coût par tâche achevée. Lors de l'établissement d'un budget de production, tenez compte des tentatives répétées, des appels d'outils échoués et du temps humain nécessaire pour corriger les réponses faibles. C'est ce chiffre qu'il faut comparer entre fournisseurs.
Comment utiliser GLM-5
| Accès | Idéal pour | Où s'exécute l'inférence |
|---|---|---|
| Z.ai Chat | Évaluation qualitative rapide | Serveurs de Z.ai |
| API Z.ai | Intégration de première partie | Serveurs de Z.ai |
| OpenRouter | Choix du fournisseur et basculement | Fournisseur hébergé sélectionné |
| Enter MaaS | Accès au modèle dans un flux de création d'applications | Accès hébergé visible dans Enter |
| Hugging Face + vLLM/SGLang | Déploiement autogéré | Votre propre infrastructure |
| Ollama :cloud | Accès distant via le client Ollama | Serveurs distants, pas votre ordinateur portable |
Commencez avec Z.ai Chat
L'accès le plus simple à GLM-5 en mode chat est chat.z.ai. Utilisez-le pour tester le comportement des prompts et la structure de sortie, mais notez le modèle exact affiché dans l'interface. Ne promettez jamais à une équipe un usage « gratuit » ou « illimité » sans vérifier le quota actuel du compte.
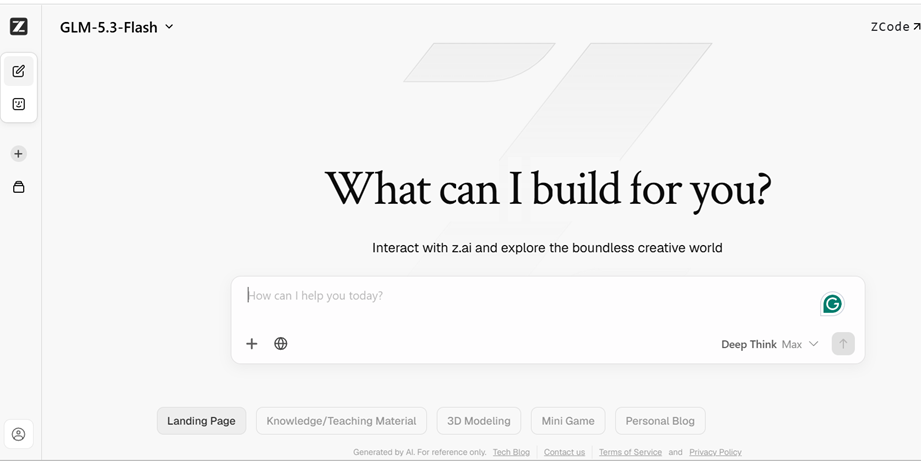
Figure 9. L'interface de chat permet une vérification qualitative rapide, mais le modèle affiché et le quota du compte restent importants.
Appeler l'API Z.ai ou OpenRouter
Z.ai propose un endpoint compatible OpenAI, ce qui signifie que le SDK Python officiel peut être utilisé avec une URL de base différente. Stockez la clé API dans une variable d'environnement et consignez l'ID du modèle, l'effort, le nombre de tokens utilisés et si la requête s'est terminée avec succès.
Figure 10. L'endpoint compatible OpenAI de Z.ai réduit les changements de SDK ; il ne supprime pas les tests de migration.
import os

from openai import OpenAI

client = OpenAI(

        api_key=os.environ["ZAI_API_KEY"],

        base_url="https://api.z.ai/api/paas/v4/",

)

response = client.chat.completions.create(

        model="glm-5.3",

        messages=[{"role": "user", "content": "List five tests for a password-reset flow."}],

        max_tokens=4096,

        extra_body={"thinking": {"type": "enabled"}, "reasoning_effort": "high"},

)

print(response.choices[0].message.content)
Lors d'une migration depuis 5.2, supprimez toute requête qui désactive explicitement le « thinking » ; GLM-5.3 n'accepte pas ce comportement. Si vous utilisez l'accès GLM-5.3 via OpenRouter, consignez quel fournisseur a traité la requête lorsque la gouvernance ou la reproductibilité importent.
Télécharger et auto-héberger les poids
Utilisez le dépôt officiel ou la fiche GLM-5.3 vérifiée sur Hugging Face. Z.ai cite SGLang, vLLM, Transformers, KTransformers et Unsloth parmi les chemins pris en charge.
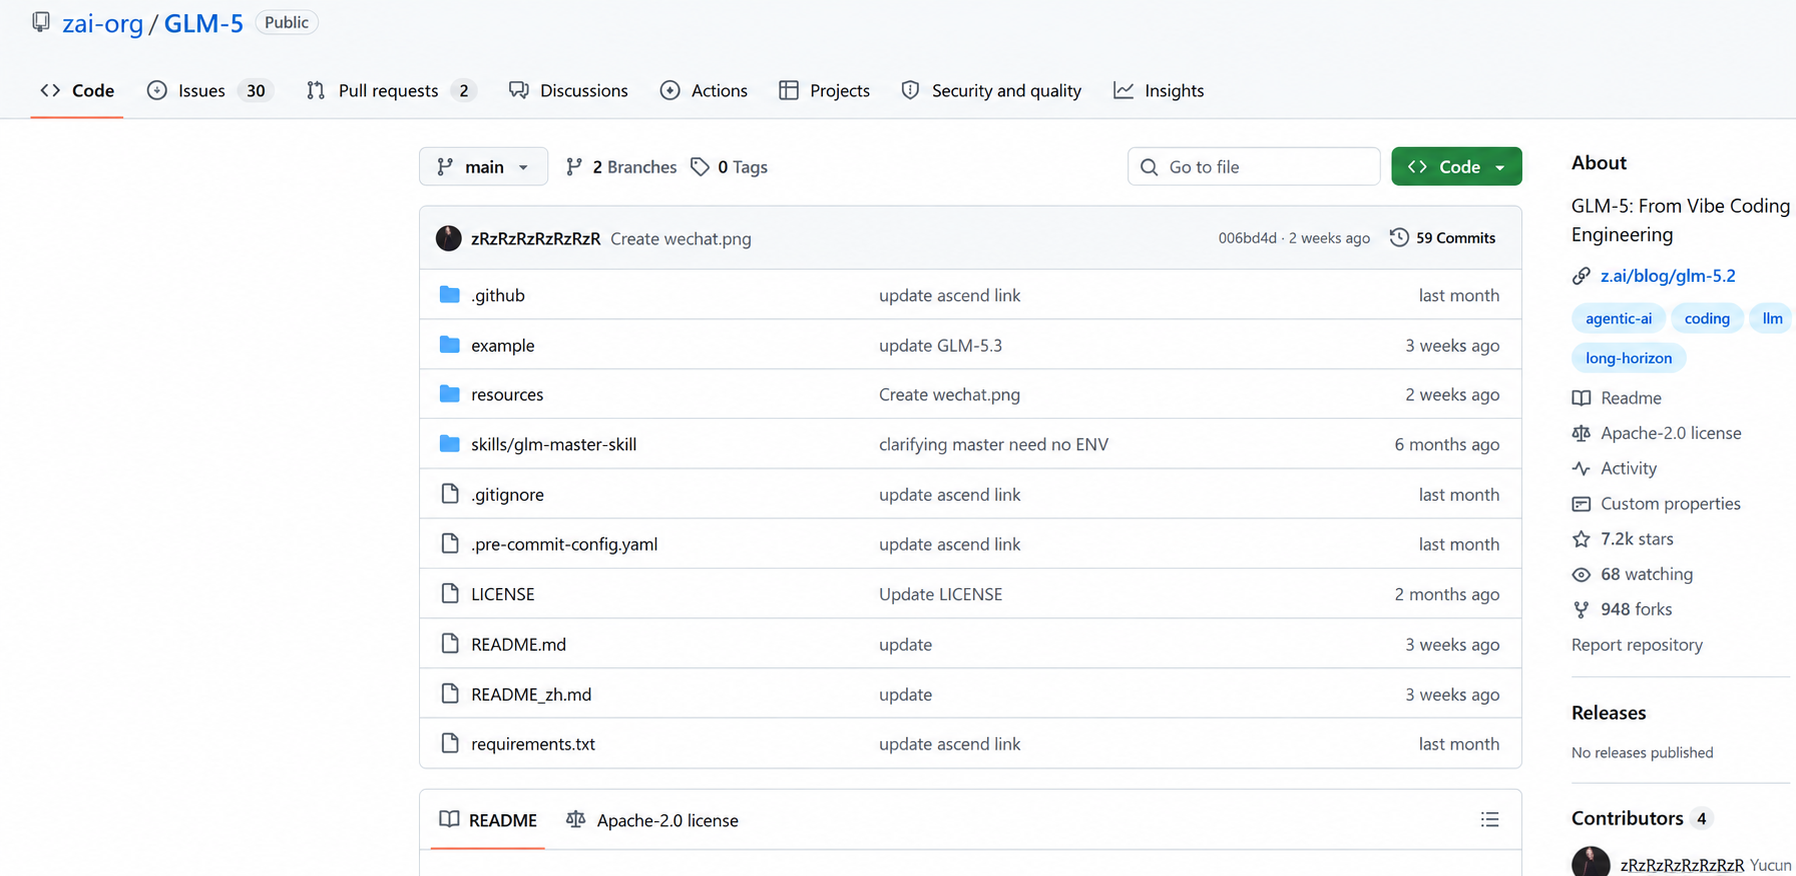
Figure 11. Utilisez le dépôt vérifié et la fiche modèle officielle, plutôt qu'un miroir de poids non officiel.
Téléchargeable NE signifie PAS exécutable. La quantification réduit les besoins en mémoire, mais peut altérer la qualité ; avec un checkpoint de 744B, un stockage et des accélérateurs de niveau serveur sont nécessaires. Lisez attentivement la fiche GLM-5 sur Ollama : une balise « cloud » signifie qu'il s'agit d'une inférence distante. Il faut des poids locaux, un runtime local et du matériel suffisant pour une véritable exécution locale.
Comment j'évaluerais GLM-5 avant la mise en production
Je ne commencerais pas par une question générale du type « quel est le modèle le plus intelligent ? ». J'exécuterais quatre tâches représentatives face à 5.2, 5.3 et Flash en utilisant les mêmes outils et limites : corriger un bug dans un dépôt, récupérer des faits insérés dans un long document, terminer un flux de travail multi-outils avec un échec induit, et produire une sortie évaluée selon une grille écrite.
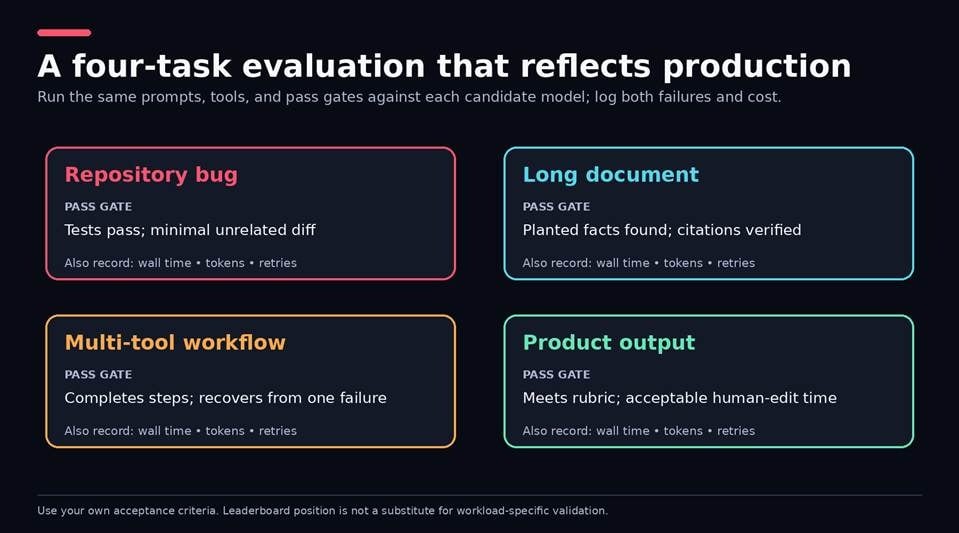
Figure 12. Un test de charge de travail petit et reproductible est plus utile qu'une question générale sur le « modèle le plus intelligent ».
Réussite/échec, temps réel, tokens, tentatives répétées, temps d'édition humaine et fournisseur. Cela permet de détecter des risques de migration que les moyennes de benchmarks ne révèlent pas — comme le raisonnement toujours actif de 5.3 et une sortie potentiellement longue. Cela indique aussi si le prix plus bas de Flash survit au contact de vos tests d'acceptation.
Qui devrait utiliser GLM-5 ?
Codage agentique et travail sur dépôt
GLM-5 est une excellente option si une tâche implique de parcourir un dépôt, des modifications coordonnées, l'exécution de tests et des appels d'outils. Les preuves publiques de benchmark soutiennent cette courte liste, mais votre critère d'acceptation doit être solide : les tests doivent passer, le diff doit être ciblé, et aucune limite de credentials ou de réseau ne doit être franchie. Prévoyez un espace de travail distinct et appliquez le principe du moindre privilège. Plus d'autonomie sans contrôles ne produit que des traces d'échec plus importantes.
Documents longs et travail de connaissance
Les modèles à un million de tokens conviennent aux spécifications, aux dossiers de recherche et aux grandes bases de code. Une grande fenêtre de contexte ne doit pas être considérée comme une récupération fiable. Placez les informations clés au début, au milieu et à la fin ; citez vos sources ; vérifiez les informations citées. Je comparerais aussi avec un pipeline de récupération, car tout mettre dans un seul grand prompt peut s'avérer plus lent et plus coûteux que de sélectionner d'abord les preuves pertinentes.
Flux de travail multimodaux et défensifs
Avec GLM-5.3-Flash ou GLM-5V-Turbo, les captures d'écran, les états d'interface ou d'autres entrées visuelles requises par la tâche font partie du travail courant. Utilisez toutes les découvertes comme pistes pour la revue de sécurité défensive, puis reproduisez-les et classez-les par priorité. GLM-5 convient moins bien à ceux qui recherchent un petit modèle local pour ordinateur portable, qui ne peuvent pas prendre de décisions de déploiement, ou qui ne peuvent pas vérifier la résidence de l'hébergeur ni les conditions de conservation.
GLM-5 est-il sûr pour des données privées ou d'entreprise ?
Accès hébergés
Cela ne dépend pas seulement du modèle, mais de l'accès utilisé. Il existe différents chemins de données : Z.ai Chat, l'API Z.ai, un autre hébergeur, ou un déploiement autogéré. Commencez par la politique de confidentialité de Z.ai, puis vérifiez auprès de tous les intermédiaires la conservation, l'usage à des fins d'entraînement, la suppression, la résidence des données et les conditions contractuelles.
Fixez un fournisseur précis si un agrégateur le propose, et n'envoyez pas de secrets simplement par commodité. Ce qui advient des données hébergées est déterminé par votre contrat et votre configuration, pas par l'expression « poids ouverts ».
Auto-hébergement
L'auto-hébergement garde les prompts dans votre environnement, mais vous êtes responsable des poids, des identifiants, des correctifs, des contrôles réseau et de la surveillance. Je continuerais néanmoins de penser qu'il existe toujours un moyen d'injecter précocement du code généré non sécurisé. Séparez les identifiants de build et de production, limitez l'accès réseau sortant, auditez les actions des outils et maintenez des approbations humaines pour les changements importants. N'accordez pas aux agents plus d'autorité que nécessaire pour la tâche.
Comment utiliser GLM-5 avec Enter Pro
GLM-5 n'est pas un concurrent direct d'Enter Pro. GLM apporte des capacités de modèle, tandis qu'Enter Pro propose un flux de construction de produit autour des modèles. C'est utile lorsque vous ne cherchez pas seulement à « obtenir une complétion », mais à « obtenir une complétion qui peut être transformée en interface, en logique et en chemin de publication ».
Si vous avez besoin de contrôle API, d'une infrastructure personnalisée ou d'une structure de données spécifique, l'accès direct est la meilleure option. Lorsque la solution de contournement produit devient un facteur limitant, Enter Pro entre en jeu. Son AI MVP Builder rassemble la planification, la création d'application, l'édition visuelle et la publication dans un seul processus, tandis qu'Enter Code offre une approche centrée sur le terminal pour les tâches de dépôt.
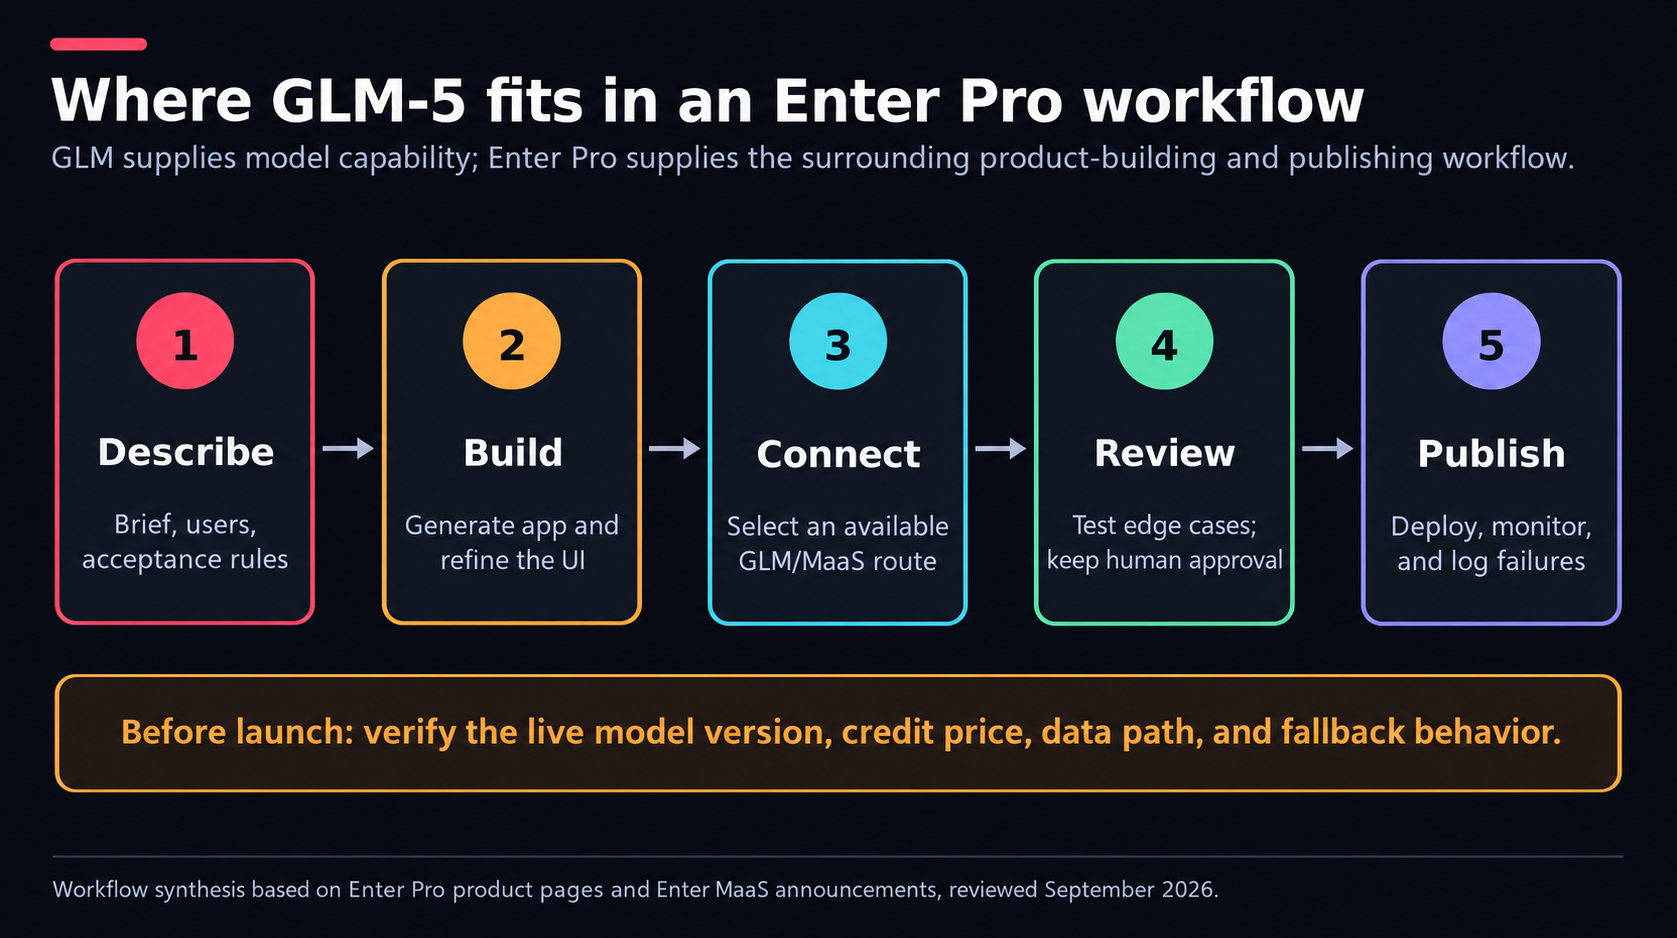
Figure 13. Le modèle génère ou classifie ; le flux de travail produit ajoute l'interface, la revue, le déploiement et la surveillance.
Le changelog d'Enter confirme GLM-5.2 dans le catalogue AI All précédent le 17 juin. L'annonce d'Enter MaaS mentionne GLM 5 et explique comment les modèles sont facturés en crédits. Elle ne confirme pas explicitement GLM-5.3, donc vérifiez bien le sélecteur de modèles en direct, le prix en crédits, la limite de contexte et le chemin des données avant de concevoir autour d'une version spécifique.
Une application de tri de support indique bien où cette combinaison a du sens. Avec Enter Pro, vous pouvez concevoir le formulaire de ticket et le tableau de bord, et relier un accès GLM existant pour catégoriser les tickets et rédiger des réponses. Avant publication, validez les réponses vides du modèle, les demandes ambiguës, les entrées multilingues, les injections de prompt et les données privées dans le corps du message. Gardez toujours une personne entre le brouillon et le bouton d'envoi.
| Si votre priorité est… | Choisissez un accès GLM direct | Choisissez Enter Pro |
|---|---|---|
| Paramètres du modèle et contrôle du fournisseur | Oui | Uniquement dans les options exposées |
| Création et édition visuelle d'applications | Construire ou ajouter un outillage séparé | Avantage central du flux de travail |
| Hébergement personnalisé et politique réseau | Le meilleur choix | Vérifier d'abord l'adéquation de la plateforme |
| Chemin rapide de la sortie du modèle à l'UI produit | Plus d'ingénierie nécessaire | Meilleure adéquation |
Mais Enter ne rend pas GLM plus intelligent, et le fait que GLM ait accès à une application ne rend pas non plus son agent de codage plus intelligent. S'il s'agit d'intégration ou de travail d'UI, j'opterais pour Enter. Si vous êtes dans cette situation, ouvrez l'espace de travail Enter Pro et vérifiez le catalogue de modèles en place avant de vous engager sur une architecture.
Conclusion
Même si on l'appelle GLM-5, la variante et le mode de service comptent tout autant que le modèle lui-même pour le codage et les agents à long horizon. Utilisez GLM-5.3 pour du texte et du code difficiles, GLM-5.3-Flash pour le multimodal et/ou le volume, et conservez 5.2 jusqu'à ce que la migration devienne rentable. Testez ensuite sur vos propres tâches avant d'utiliser les chiffres du leader/fournisseur comme preuve de production.
Celui qui fonctionne réellement est celui qui remplit vos critères d'acceptation, qui reste dans votre plage de latence et de confidentialité, et qui conserve le bon prix même après des tentatives répétées — indépendamment du score presque parfait qu'il pourrait obtenir sur ce benchmark particulier.
Commencez à construire avec Enter Pro →
FAQ
GLM-5 est-il gratuit ?
Les poids publics sont disponibles au téléchargement, sans frais d'API au token, mais le matériel et l'exploitation restent à votre charge. Z.ai Chat peut proposer un accès basé sur un quota. Les API hébergées, les routeurs et les serveurs GPU sont des services payants, et il peut y avoir des différences selon la version et l'accès.
Quelle version de GLM-5 est la meilleure ?
Pour du texte/code exigeant, je commence par GLM-5.3. GLM-5.3-Flash est le meilleur premier test pour les images, les captures d'écran ou un volume sensible au coût. Ne changez pas de GLM-5.2 s'il est déjà validé et que le risque de migration dépasse le bénéfice potentiel.
GLM-5 peut-il écrire et déboguer du code ?
Oui. Les agents de codage et l'ingénierie à l'échelle du dépôt sont des cas d'usage clés, avec de bons résultats rapportés par les fournisseurs sur Terminal-Bench et DeepSWE. Un bac à sable, des tests, des permissions restreintes et une revue humaine restent toujours nécessaires.
Combien coûte l'API GLM-5 ?
En septembre 2026, Z.ai affiche GLM-5 à 1,00 $ en entrée et 3,20 $ en sortie par million de tokens ; GLM-5.3 à 1,40 $ et 4,40 $ ; et 5.3-Flash à 0,15 $ et 0,50 $. L'entrée mise en cache est moins chère. Le coût réel est influencé par les marges des fournisseurs et les tentatives répétées.
GLM-5 est-il un logiciel open source ?
« Poids ouverts » est plus exact. La licence des poids, la licence du code du dépôt et la transparence des données d'entraînement sont des questions distinctes. Avant un déploiement commercial, vérifiez bien la fiche modèle spécifique sur Hugging Face et la licence du dépôt.
GLM-5 peut-il être utilisé localement (avec Ollama) ?
Seulement si vous disposez de poids locaux, d'un support runtime et de matériel suffisant pour cela. La balise « cloud » signifie que l'exécution se fait sur une infrastructure distante, donc elle n'implique pas nécessairement que l'intégralité du modèle 744B s'exécute sur votre appareil.
GLM-5 est-il capable de traiter des images ?
Le GLM-5 de base et GLM-5.3 sont uniquement textuels. Pour les entrées multimodales, utilisez GLM-5.3-Flash ou GLM-5V-Turbo ; vérifiez les types de fichiers acceptés sur l'endpoint choisi.





