
GPT-5.2 expliqué : fonctionnalités, benchmarks, tarifs et cas d'usage
Découvrez GPT-5.2 Instant, Thinking, Pro et Codex : tarifs, benchmarks, accès, limites et comparaison avec Gemini 3 pour les développeurs en 2026.
Figure 1. GPT-5.2 évalué selon la qualité, la vitesse, le coût et le contrôle
J'ai sélectionné GPT‑5.2 Pro dans Enter Pro pour créer un relecteur de briefs de projet qui transforme des idées d'applications en exigences et critères d'acceptation. Les captures montrent la configuration et le résultat de la relecture ; la vérification d'une requête achevée reste une étape ouverte.
Ce cas pratique donne à ce guide un point de référence concret. Je sépare les résultats officiels des benchmarks de ce que l'application a réellement montré, puis j'examine les capacités, les tarifs et les limites de la famille de modèles. Vous devez identifier la variante exacte avant d'appliquer une observation à Instant, Thinking, Pro ou Codex.
OpenAI a présenté la famille le 11 décembre 2025 comme une sortie destinée au travail professionnel et aux agents de longue durée. Son rapport de lancement fournit la base de référence officielle en matière de benchmarks et de tarifs. J'utilise ce rapport ainsi que des informations de routage actuelles, des critiques indépendantes essentielles et des retours de la communauté, car aucune source unique ne capture à la fois la performance contrôlée et les frictions du quotidien.
Les personnes qui recherchent Chat GPT 5.2 font souvent référence à toute la famille de décembre 2025, mais la distinction entre les modes de ChatGPT et les ID de modèles de l'API compte. Un test d'Instant ne détermine pas le comportement, le prix ou la latence de Thinking, Pro ou du modèle spécialisé dans le code.
GPT-5.2 en un coup d'œil
Au 9 octobre 2026, OpenAI répertorie GPT‑5.2 et GPT‑5.2 Pro comme des options de la génération précédente. Les projets existants peuvent accorder de la valeur à leur comportement connu et à leurs snapshots figés, tandis qu'un nouveau projet devrait comparer les modèles actuellement recommandés selon les mêmes critères d'acceptation.
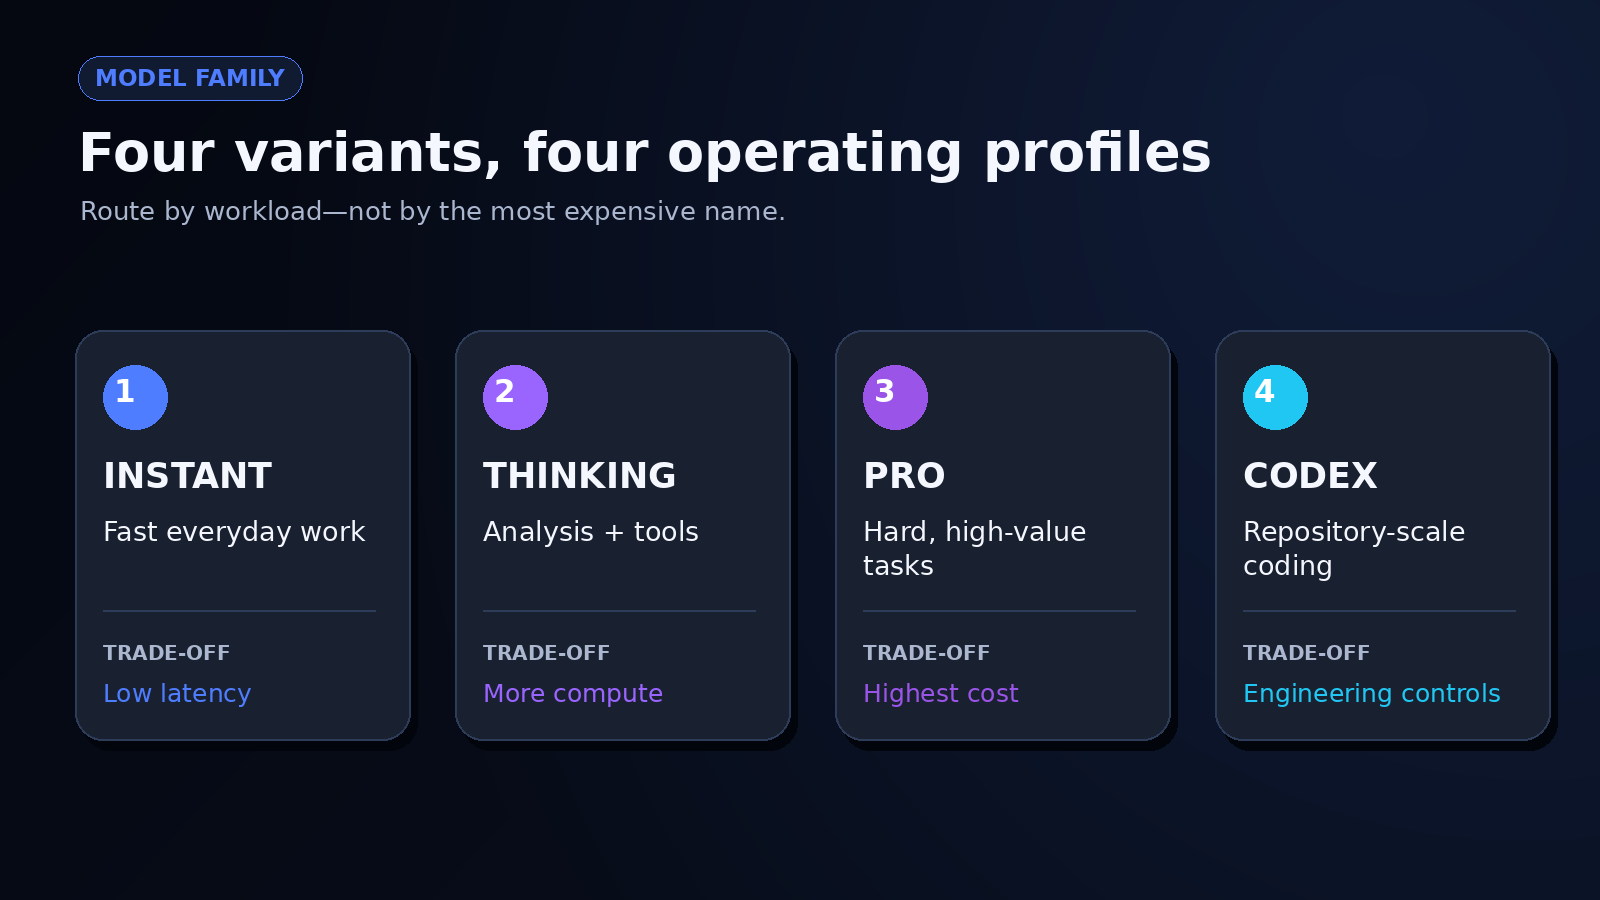
Figure 2. Instant, Thinking, Pro et Codex associés à des types de charges de travail
| Spécification | GPT-5.2 | GPT-5.2 Pro |
|---|---|---|
| Position actuelle | Ancien modèle phare | Ancien modèle Pro |
| Fenêtre de contexte | 400 000 tokens | 400 000 tokens |
| Sortie maximale | 128 000 tokens | 128 000 tokens |
| Date de coupure des connaissances | 31 août 2025 | 31 août 2025 |
| Modalités | Entrée/sortie texte ; entrée image | Entrée/sortie texte ; entrée image |
| Effort de raisonnement | aucun, faible, moyen, élevé, très élevé | moyen, élevé, très élevé |
| Prix API par million de tokens | 1,75 $ entrée ; 0,175 $ en cache ; 14 $ sortie | 21 $ entrée ; 168 $ sortie |
| Sorties structurées | Prise en charge | Non prise en charge |
| Fine-tuning | Non pris en charge | Non pris en charge |
| Snapshot | gpt-5.2-2025-12-11 | gpt-5.2-pro-2025-12-11 |
Statut actuel, contexte et modalités
La fenêtre de contexte de 400 000 tokens et le plafond de sortie de 128 000 tokens sont inhabituellement grands, mais la capacité n'est pas la mémorisation. Si vous placez des contrats, des journaux, des captures d'écran et des exigences dans une seule requête, vous avez tout de même besoin d'un test de récupération : semez des faits à différentes positions, posez des questions qui exigent de les combiner, et notez ce que le modèle manque. Je ne déduirais pas un raisonnement fiable sur de longs documents à partir du seul chiffre de contexte.
Les modèles acceptent les images et produisent du texte ; ils n'acceptent pas l'audio ou la vidéo comme entrées natives. Cela les rend utiles pour les graphiques, les captures d'écran d'interface, les diagrammes et les documents scannés, à condition de vérifier les détails spatiaux et les valeurs extraites. Une étiquette floue ou une échelle de graphique inhabituelle peut transformer une explication assurée en une erreur plausible.
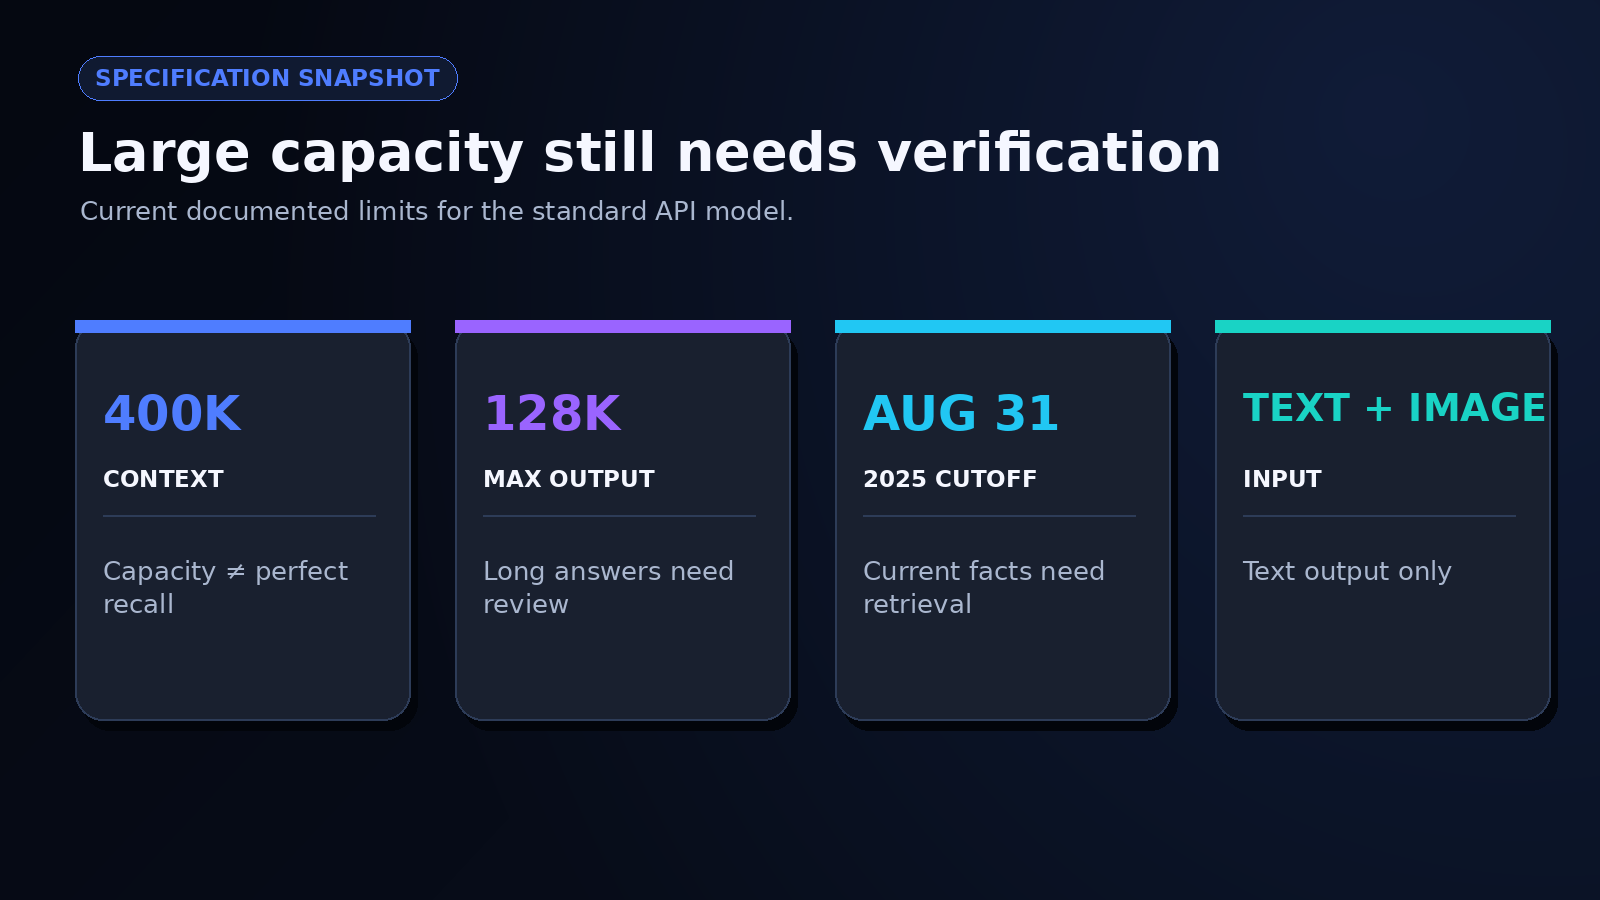
Figure 3. contexte, sortie, modalités, date de coupure et snapshots
Tarifs et accès à l'API
Le modèle standard de l'API coûte 1,75 $ par million de tokens d'entrée, 0,175 $ par million de tokens d'entrée en cache, et 14 $ par million de tokens de sortie. GPT 5.2 Pro coûte 21 $ en entrée et 168 $ en sortie. Les tokens de raisonnement, les nouvelles tentatives, les appels d'outils et les corrections humaines affectent le coût d'un résultat accepté. Lorsque vous utilisez une plateforme d'intégration, vérifiez ses unités de facturation séparément avant de les comparer aux tarifs en dollars d'OpenAI.
Vous pouvez consulter le routage des fournisseurs et la disponibilité actuelle sur la page GPT‑5.2 d'OpenRouter. Je calculerais le coût par tâche achevée, et non le coût par requête. Une réponse moins chère qui échoue deux fois à la validation peut coûter plus cher qu'une réponse plus onéreuse qui réussit dès la première exécution.
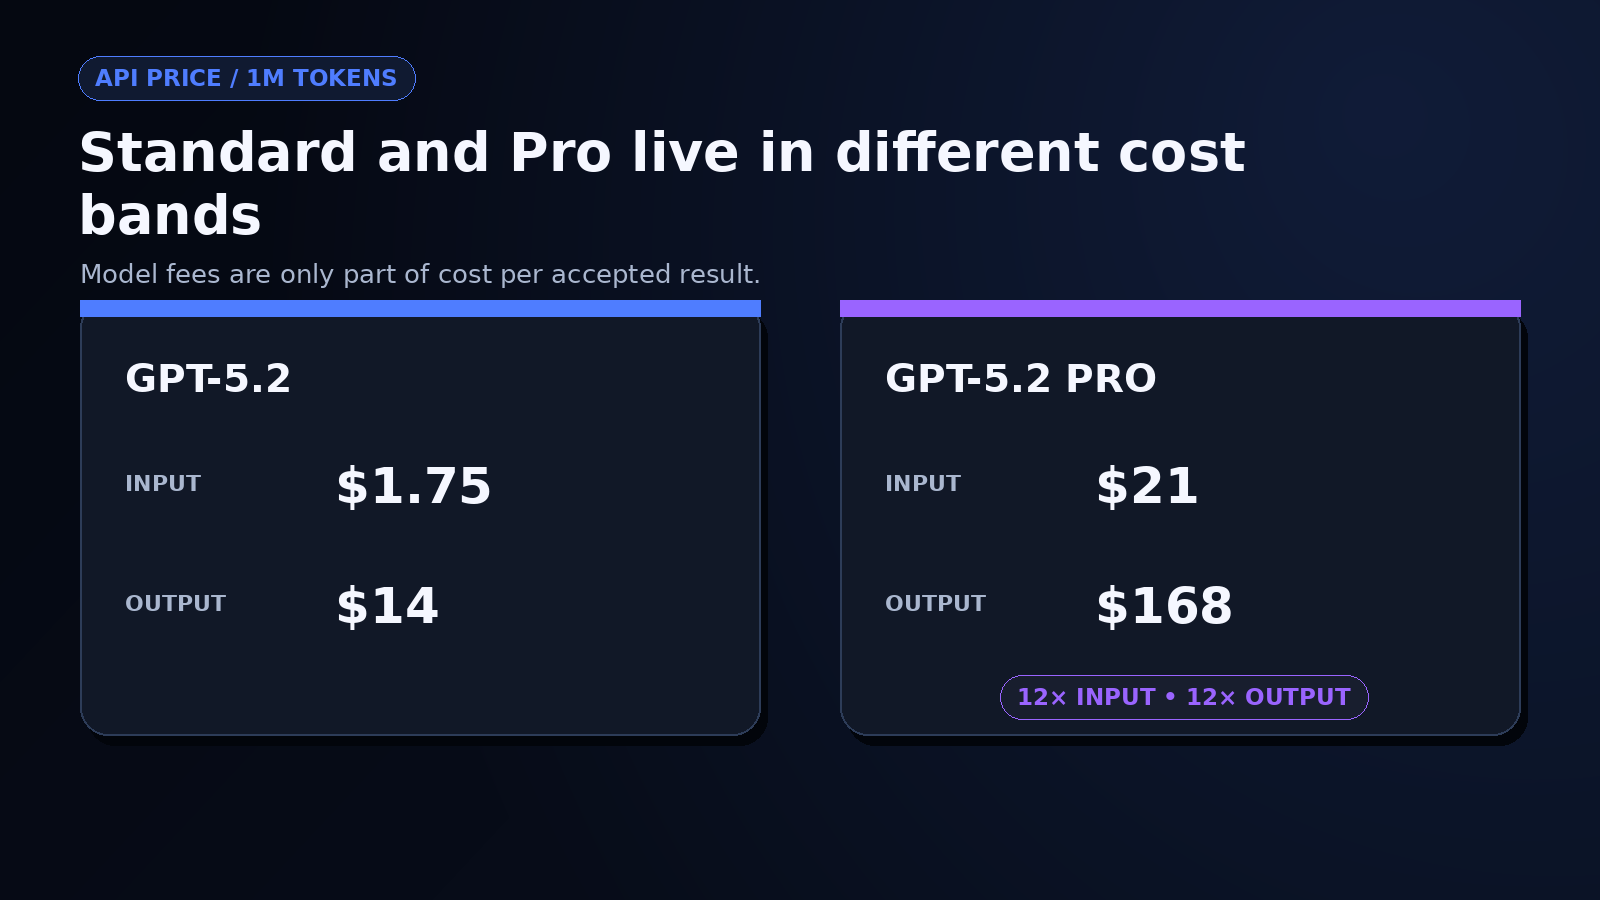
Figure 4. coût standard versus Pro par million de tokens
Qu'est-ce qui a changé avec la sortie de GPT-5.2 d'OpenAI ?
La sortie de GPT-5.2 d'OpenAI visait des travaux qui se poursuivent au-delà d'une seule réponse : construire des artefacts, examiner de longs documents, utiliser des outils, écrire et relire du code, raisonner sur des images et accomplir des tâches professionnelles en plusieurs étapes. Elle a également séparé plus clairement le chat rapide, le raisonnement approfondi et le travail à forte intensité de calcul que ne le suggère une seule étiquette de modèle.
Instant, Thinking et Pro ciblent des charges de travail différentes
Instant privilégiait les questions quotidiennes, l'explication, la traduction et les brouillons rapides. Thinking ciblait l'analyse, le codage, les fichiers, la planification et l'utilisation d'outils. Pro consacrait davantage de calcul aux problèmes difficiles où une attente plus longue et une facture API bien plus élevée pouvaient être justifiées.
| Mode ou modèle | Adéquation pratique | Principal compromis |
|---|---|---|
| Instant | Questions courantes et travail sensible à la latence | Moins de délibération sur les tâches difficiles en plusieurs étapes |
| Thinking | Analyse, codage, longs fichiers et flux pilotés par des outils | Plus de latence et de consommation de tokens |
| Pro | Tâches difficiles où la qualité incrémentale a une forte valeur | Coût très élevé ; les réponses peuvent prendre plusieurs minutes |
Je dirigerais le routage en fonction du risque plutôt que du prestige. Une étape de classification peut nécessiter un modèle rapide avec un schéma strict. Une revue de modèle financier peut justifier un raisonnement plus approfondi. Si vous envoyez chaque requête à Pro, vous masquez les tâches qui bénéficient réellement du calcul supplémentaire et rendez le contrôle des coûts beaucoup plus difficile.
Le travail professionnel et l'utilisation d'outils ont été au centre du lancement
OpenAI a mis l'accent sur les tableurs, les présentations, le travail front-end, la relecture de code, l'analyse de documents, les sciences, les mathématiques et les appels d'outils. Dans une évaluation menée par le fournisseur sur des requêtes ChatGPT dépersonnalisées, les erreurs au niveau des réponses ont été signalées comme 30 % relativement moins fréquentes qu'avec GPT‑5.1 Thinking. Le rapport de lancement note également que ce sont les modèles eux-mêmes qui ont évalué les erreurs, donc je lis ce chiffre comme une preuve directionnelle plutôt que comme une garantie indépendante.
L'amélioration pratique n'est pas « le modèle sait tout ». C'est une probabilité accrue qu'une tâche bien spécifiée survive à plusieurs étapes sans perdre sa structure. Vous avez toujours besoin de points de contrôle observables : quel outil a été exécuté, quelles données il a reçues, ce qu'il a modifié, et comment le flux de travail s'est rétabli après un appel en échec.
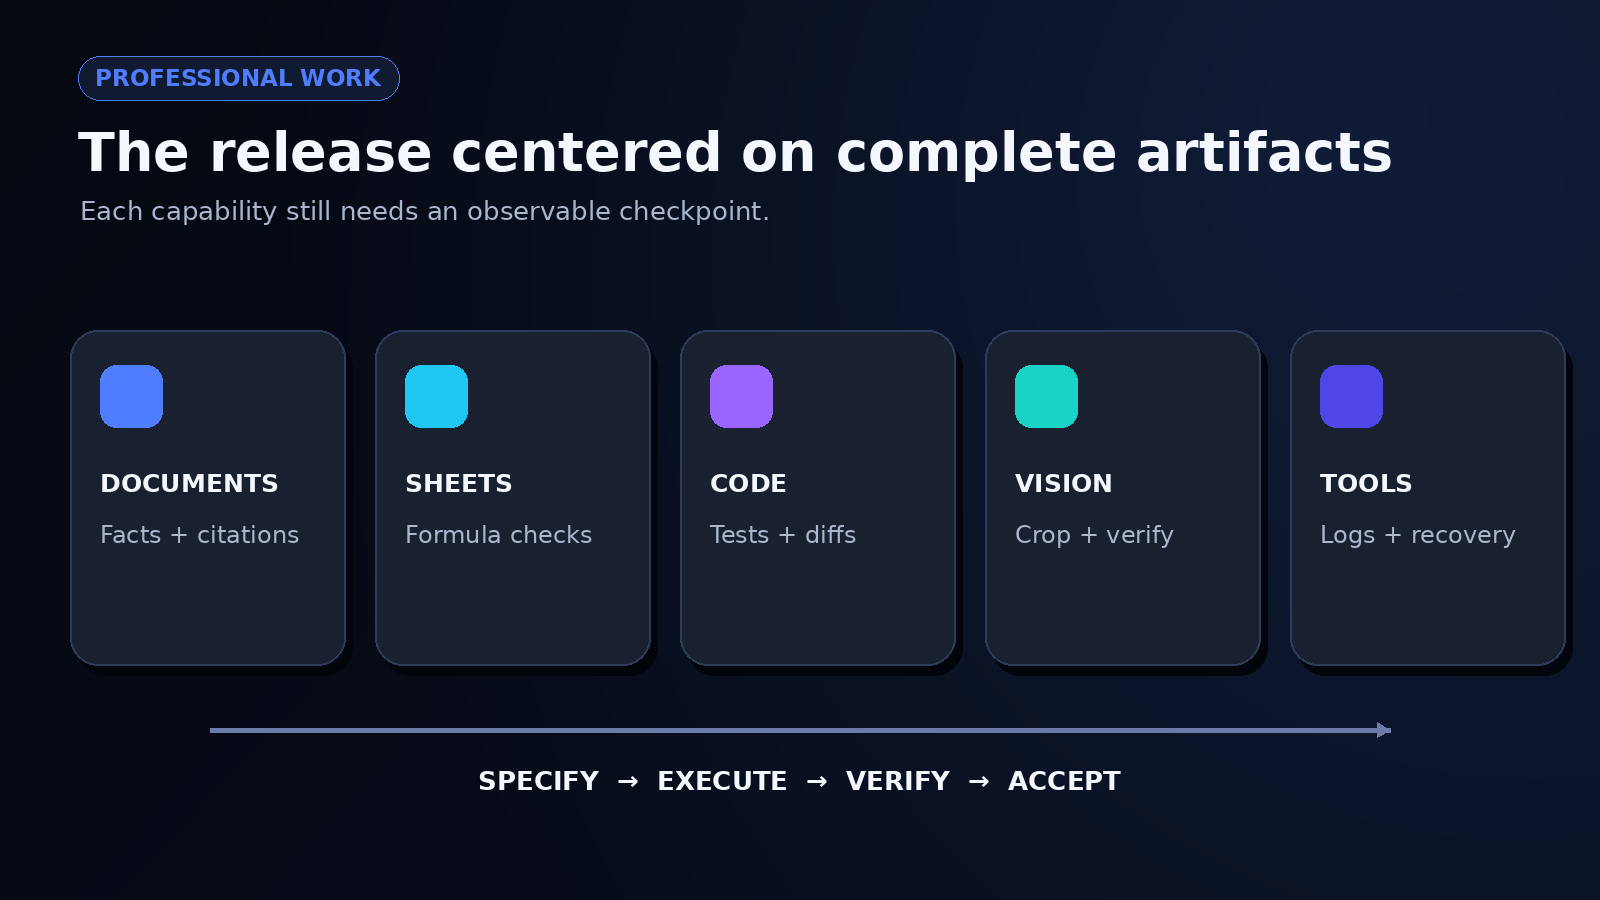
Figure 5. panneaux de tableur, code, document, image et appel d'outil
Les benchmarks de lancement ont montré des forces étendues mais inégales
| Benchmark | GPT-5.2 Thinking | Ce qu'il mesure |
|---|---|---|
| Victoires ou égalités GDPval | 70,9 % | Tâches professionnelles bien spécifiées dans 44 métiers |
| SWE-Bench Pro public | 55,6 % | Tâches d'ingénierie logicielle multilingues |
| SWE-bench Verified | 80,0 % | Tâches vérifiées sur des dépôts Python |
| GPQA Diamond | 92,4 % | Questions scientifiques de niveau doctoral sans outils |
| AIME 2025 | 100,0 % | Mathématiques de compétition sans outils |
| ARC-AGI-2 Verified | 52,9 % | Tâches inédites de raisonnement abstrait |
La dispersion est la partie utile. Elle montre des résultats solides sans impliquer une maîtrise uniforme. Un score de 80 % sur des problèmes Python vérifiés ne prédit pas votre taux de réussite sur un monorepo TypeScript avec des règles de déploiement personnalisées. De même, un benchmark scientifique n'établit pas un jugement juridique ou médical fiable.
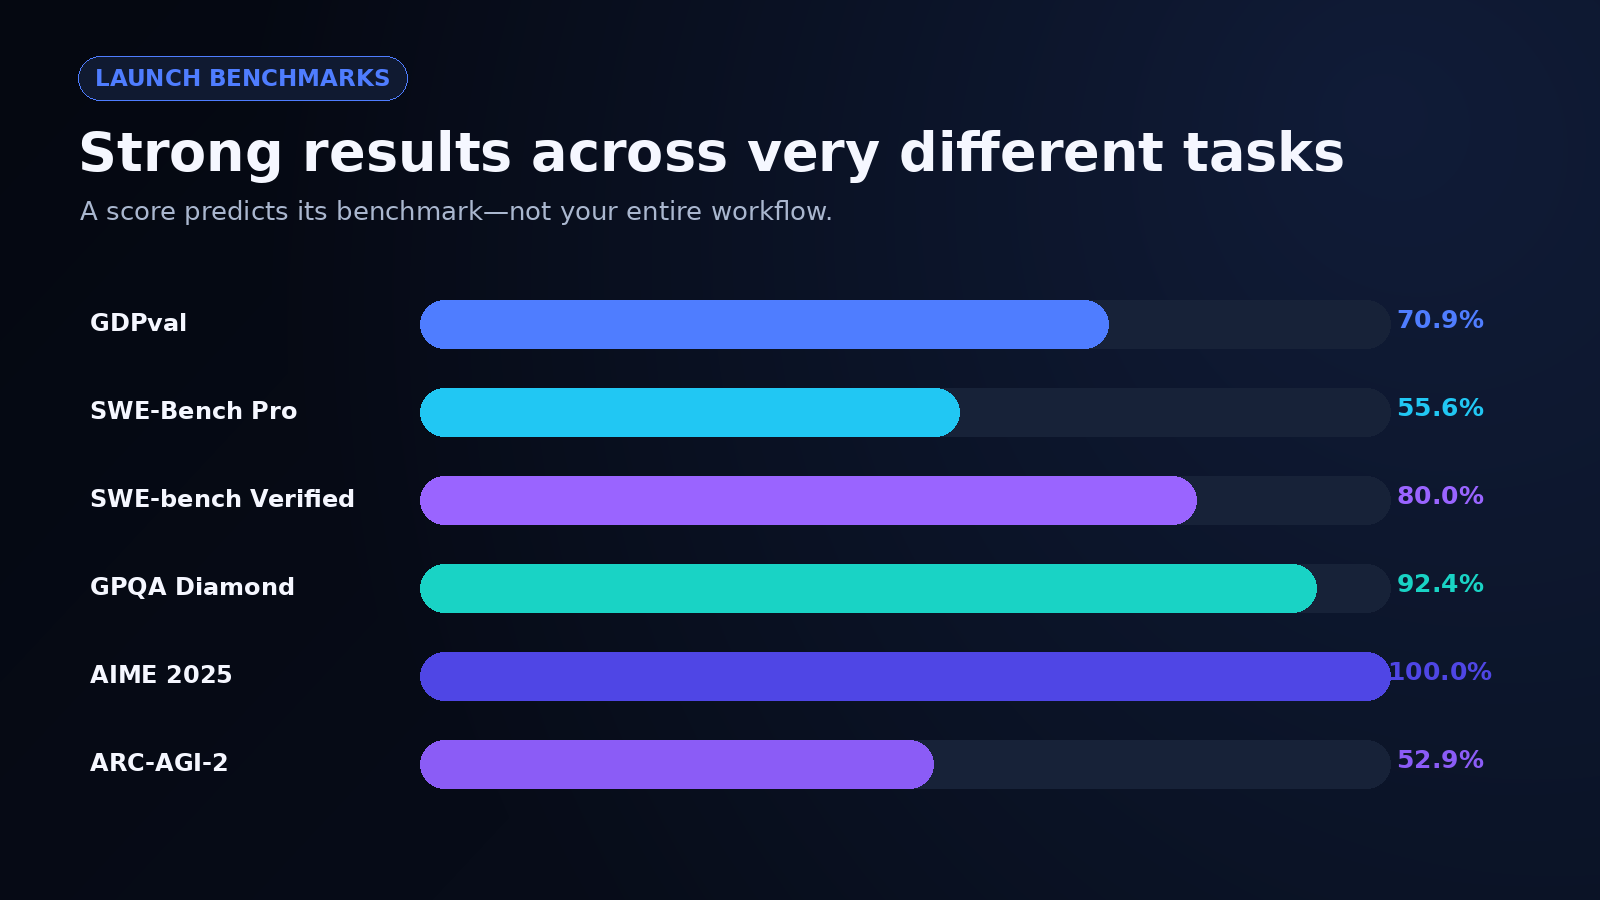
Figure 6. six scores de lancement avec catégories de tâches
Lisez les benchmarks de GPT-5.2 avec leurs limites
Les scores publics compressent de nombreux choix en un seul chiffre : format du prompt, outils, effort de raisonnement, sélection des tests, comportement de l'évaluateur et politique de nouvelles tentatives. Votre flux de travail en production ajoute la qualité des données, les autorisations, les limites de latence et la relecture humaine. Je trouve les benchmarks plus utiles pour choisir quoi tester, et non pour se dispenser du test.
Ce que ma relecture d'application a réellement montré
Le relecteur de briefs de projet affichait les instructions soumises sous « Résumé du projet » et « Exigences essentielles » alors que la réponse était encore en streaming. La saisie demandait des vérifications d'implémentation, mais le résultat visible a organisé cette requête comme un brief. Il n'a pas rapporté d'inspection de code achevée ni de résultats de tests.
La vue de session distincte ne comportait aucune requête ni usage enregistrés, laissant le temps de réponse, le routage et le coût non vérifiés. Terminez une requête avec un brief contraint pour achever la vérification.
Les scores de benchmark ne sont pas des garanties de production
Commencez avec 20 à 50 tâches représentatives et définissez les critères d'acceptation avant de les exécuter. Pour le code, cela peut inclure le taux de réussite des tests, la taille du diff, les constats de sécurité et la sécurité du rollback. Pour le travail documentaire, cela peut inclure l'exactitude factuelle, la couverture des citations, les erreurs de calcul et le temps d'édition. Exécutez le même ensemble plusieurs fois, car la variance compte.
Mesurez ensuite le coût par résultat accepté. Supposons qu'un modèle coûte 0,18 $ par exécution et réussisse 60 % des cas, tandis qu'un autre coûte 0,28 $ et réussit 90 %. Avant correction humaine, leurs coûts attendus par résultat accepté sont de 0,30 $ et d'environ 0,31 $. Une fois que vous valorisez le temps de relecture, le second peut être nettement moins cher — ou pas. Le calcul renvoie la décision vers votre flux de travail.
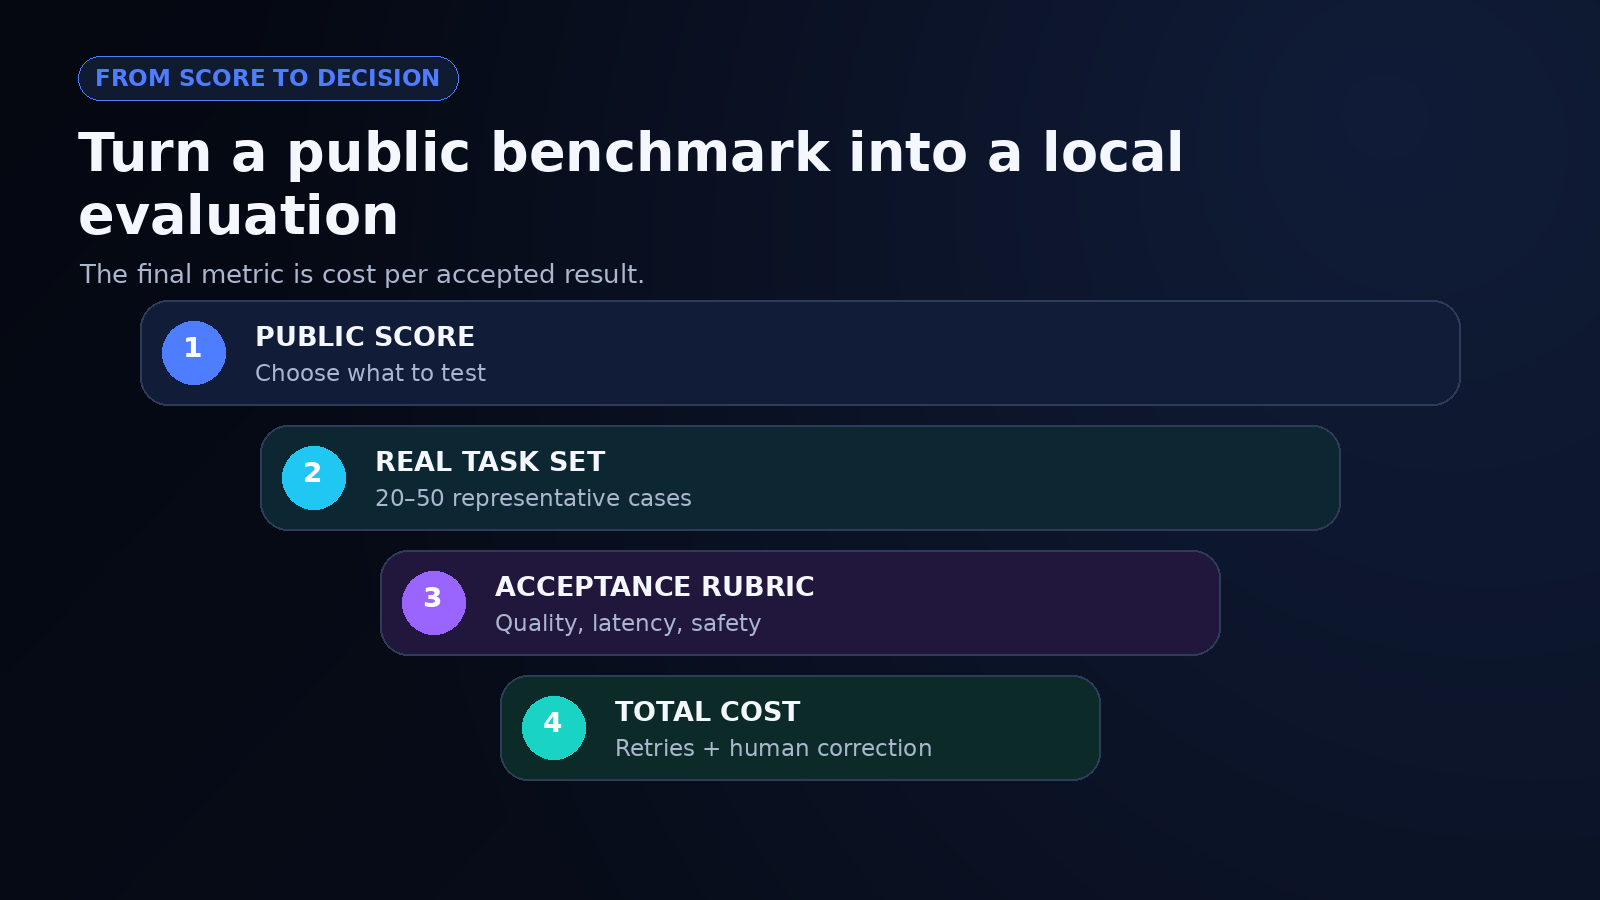
Figure 7. du score de benchmark aux tâches représentatives jusqu'au coût du résultat accepté
Le contexte long et l'entrée d'image nécessitent toujours une vérification
Une longue fenêtre de contexte peut réduire le découpage, mais elle rend aussi les omissions plus difficiles à repérer. Je testerais la récupération depuis le début, le milieu et la fin d'un ensemble de fichiers ; exigerais des citations ou des identifiants d'enregistrement pour les faits critiques ; et referais les calculs hors du modèle. Pour les images, recadrez la zone pertinente et posez la question explicitement au lieu d'attendre que le modèle devine ce qui compte.
Les critiques indépendantes peuvent également révéler des modes d'échec qu'un article de lancement ne mettra pas en avant. Une critique pratique décrit des résultats décevants dans les tâches de l'auteur. Cela ne réfute pas les résultats de benchmark ; cela montre pourquoi votre prompt, votre charge de travail et votre seuil d'acceptation doivent être reproduits directement.
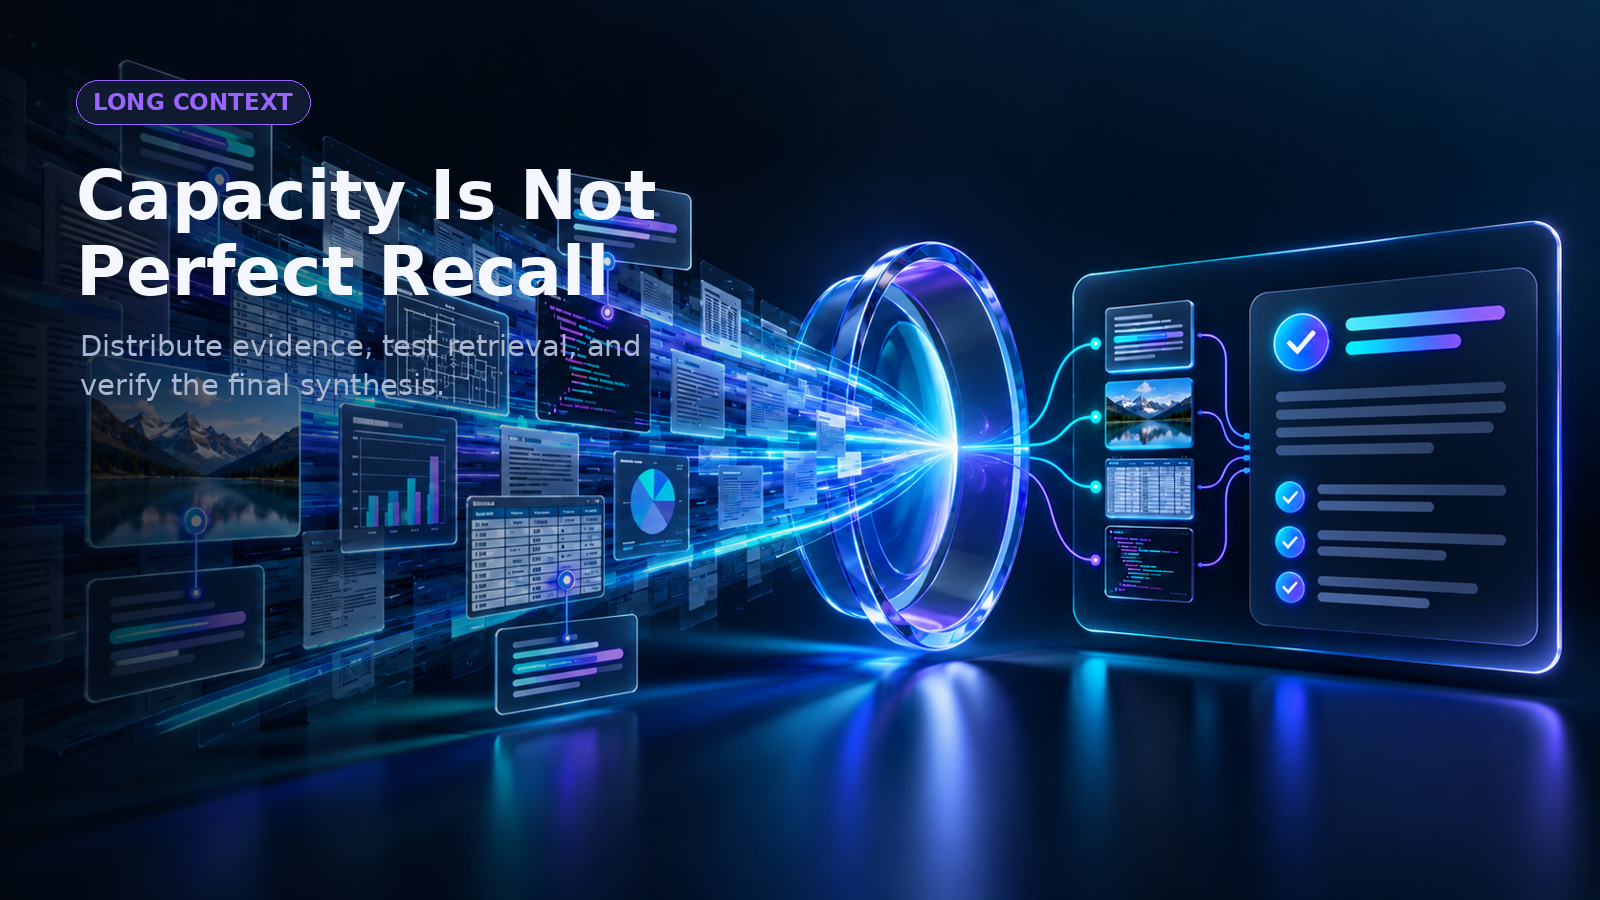
Figure 8. preuves distribuées dans un flux de documents de 400 000 tokens
Le travail à fort enjeu nécessite des garde-fous spécifiques au domaine
La date de coupure des connaissances du 31 août 2025 signifie que les faits actuels nécessitent une récupération. Les modèles peuvent toujours inventer des sources, négliger des exigences, mal lire des captures d'écran ou générer du code non sécurisé. Ils ne prennent pas non plus en charge le fine-tuning, donc les équipes ayant besoin d'un comportement profondément personnalisé doivent s'appuyer sur le prompting, la récupération, les outils, la validation ou un autre modèle.
Vous devez séparer l'assistance de l'autorité. Un modèle peut résumer un contrat, signaler une transaction suspecte ou proposer un correctif. Une personne qualifiée ou un contrôle déterministe devrait prendre la décision juridique, médicale, financière, de sécurité et de production. Enregistrez les preuves et conservez un chemin clair pour rejeter ou annuler le résultat.
Qu'est-ce que GPT-5.2-Codex et comment les développeurs doivent-ils l'utiliser ?
GPT 5.2 Codex est le membre spécialisé en code de la famille, conçu pour un travail d'ingénierie logicielle plus long plutôt qu'une autocomplétion isolée. La distinction utile est la profondeur du flux de travail : comprendre un dépôt, planifier un changement, modifier plusieurs fichiers, exécuter des outils, examiner les échecs et réviser le correctif.
Tâches de codage les mieux adaptées
Les bons candidats incluent l'exploration de dépôts, l'implémentation de fonctionnalités, la réparation de bugs, le refactoring, la création de tests, la relecture de code et les migrations avec des critères d'acceptation explicites. Je donnerais au modèle l'objectif cohérent le plus petit qui inclut tout de même la véritable limite de dépendance. Un prompt artificiellement minuscule peut produire un diff local propre qui échoue dans le système environnant.
Vous pouvez évaluer GPT 5.2 Codex avec un ensemble de dépôts reproductible : problèmes connus, tests cachés, linting, politique de dépendances, vérifications de sécurité et un diff maximal acceptable. Enregistrez le nombre d'appels d'outils, de corrections et d'interventions du relecteur. Un correctif n'est pas réussi simplement parce qu'il compile.
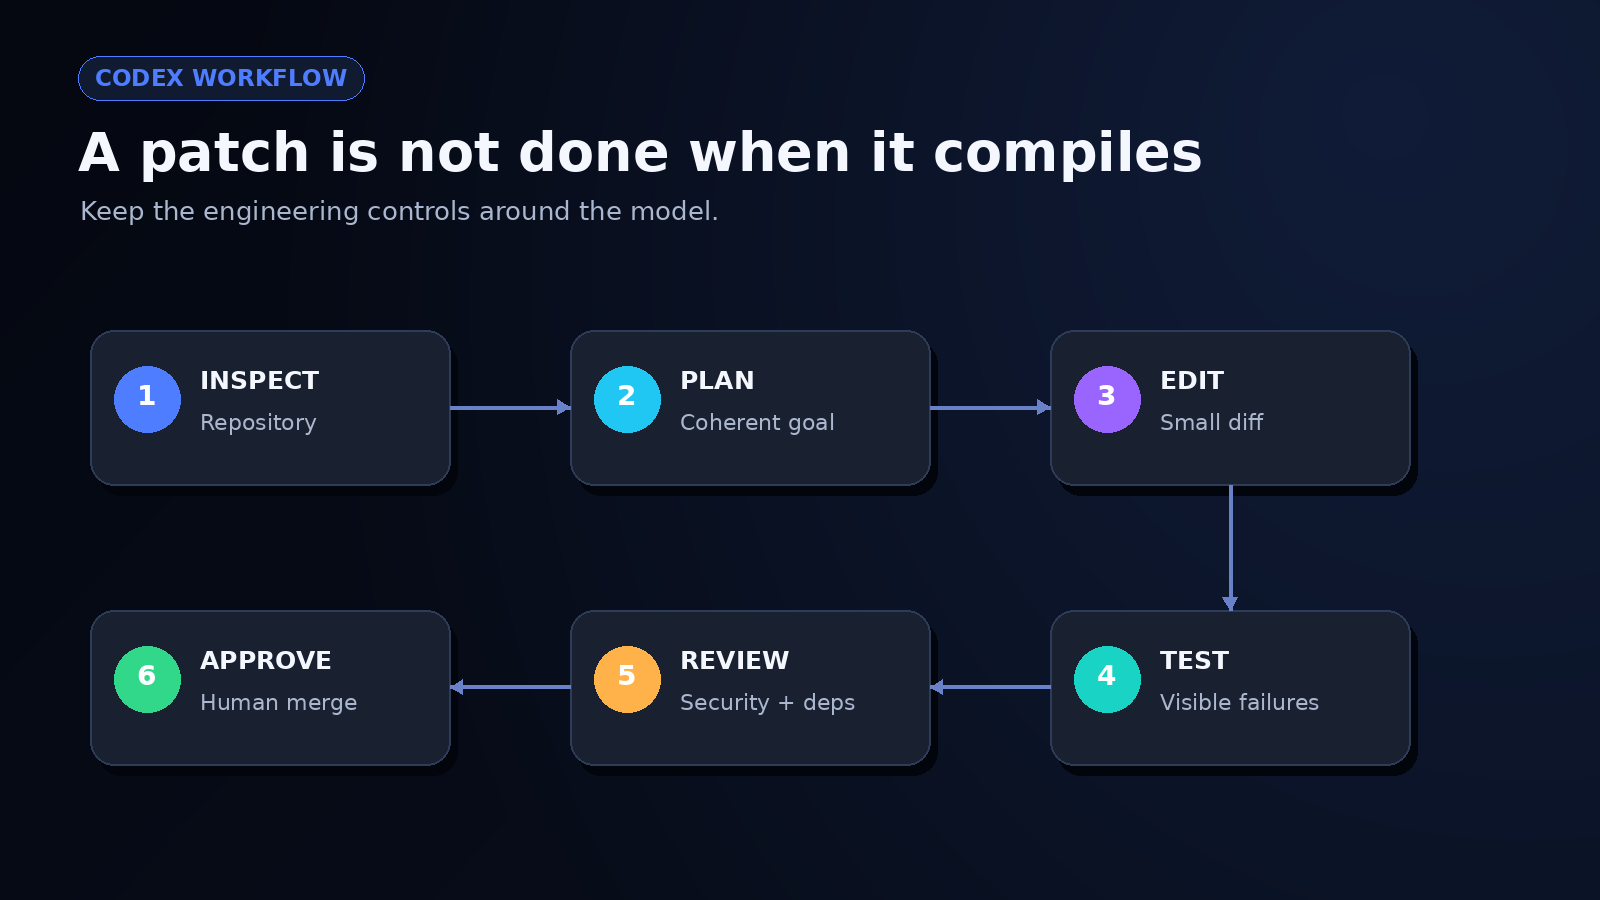
Figure 9. examiner, planifier, modifier, tester, relire et approuver
Les garde-fous de production restent applicables
Gardez les modifications suffisamment petites pour être relues, figez le snapshot du modèle lorsque la reproductibilité compte, et limitez les outils au privilège minimal requis. Exécutez les tests du dépôt, l'analyse des dépendances, la détection de secrets, l'analyse statique et une relecture humaine des diffs. Si l'agent peut déployer, supprimer des données ou faire tourner des identifiants, placez ces actions derrière une approbation explicite.
Je préfère aussi un budget d'échec : définissez combien de nouvelles tentatives, de minutes ou de tokens une tâche peut consommer avant de revenir à un humain. Sans cette limite, un agent peut sembler productif tout en tournant en rond dans des correctifs de plus en plus spéculatifs.
GPT-5.2 contre Gemini 3 dépend de la tâche exacte
GPT-5.2 contre Gemini 3 : explique que le meilleur modèle d'IA dépend de la tâche, comme le codage, le raisonnement, l'écriture ou la recherche.
La réponse honnête à « GPT 5.2 contre Gemini 3 » est une conception de test, pas un gagnant universel. Les variantes exactes, les dates, les outils, les tailles de contexte, les réglages de raisonnement et les tarifs doivent être enregistrés. Sinon, une comparaison peut discrètement accorder à un modèle la recherche, l'exécution de code ou un budget de temps plus important.
| Facteur de décision | Question à tester |
|---|---|
| Qualité de sortie | Quel modèle réussit le plus souvent votre grille de tâches ? |
| Codage | Lequel produit le taux de réussite des tests le plus élevé avec des diffs plus petits et plus sûrs ? |
| Contexte long | Lequel récupère et combine les faits de vos fichiers le plus précisément ? |
| Utilisation d'outils | Lequel achève le flux de travail avec des échecs récupérables et des journaux utilisables ? |
| Latence | Quels sont les temps de réponse médian et au 95e centile ? |
| Coût | Quel est le coût total par résultat accepté après nouvelles tentatives et correction ? |
| Gouvernance | Quels contrôles de données, de conservation, de région et d'audit conviennent à votre cas d'usage ? |
Réalisez la même évaluation comparative directe
Donnez aux deux modèles les mêmes prompts, fichiers sources, outils, budget de temps et grille de notation. Randomisez l'ordre des tâches et cachez le nom du modèle aux relecteurs lorsque possible. Répétez des cas représentatifs plutôt que de sélectionner une seule belle réponse. Les réactions de la communauté dans la discussion de lancement de GPT‑5.2 sont utiles pour découvrir des plaintes à tester, mais ce ne sont pas des comparaisons contrôlées.
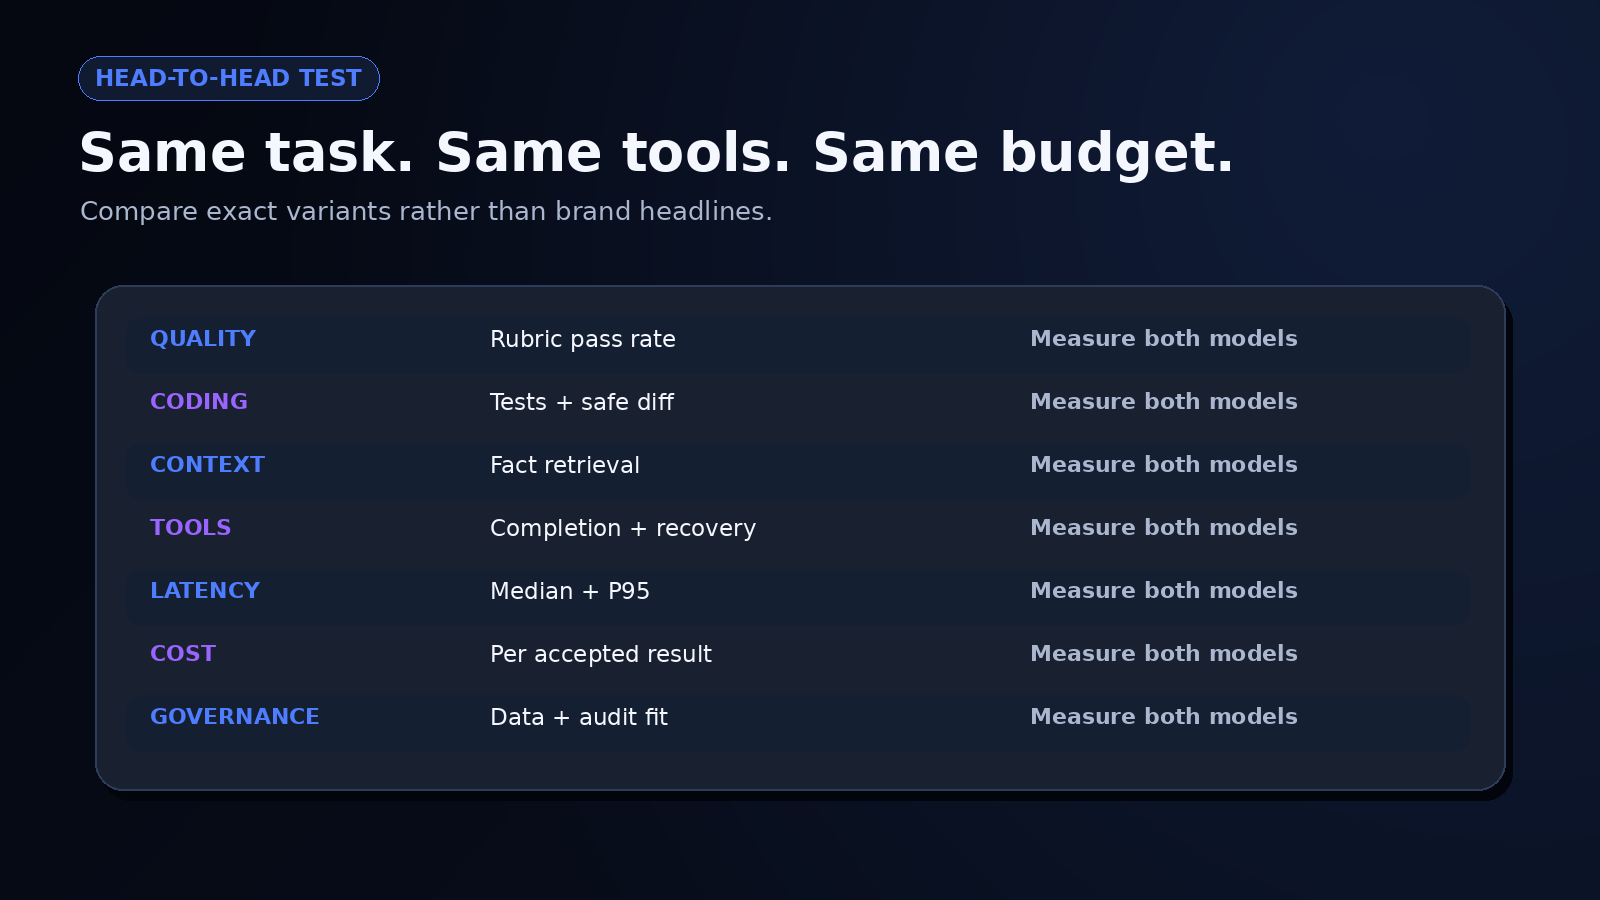
Figure 10. qualité, codage, contexte, outils, latence, coût et gouvernance
Choisissez le flux de travail à moindre risque, pas le meilleur titre
Votre gagnant peut varier selon l'étape. Un modèle peut bien planifier, un autre peut générer du code plus propre, et une option plus petite peut gérer la classification pour une fraction du coût. La bonne architecture peut router le travail plutôt que de forcer un seul modèle à tout faire.
Pour une évaluation GPT 5.2 contre Gemini 3, je choisirais le mélange de modèles le plus simple qui atteint le seuil de qualité et reste observable en cas d'échec. Chaque fournisseur ou solution de repli supplémentaire ajoute de la logique de routage, du travail d'évaluation, une revue de confidentialité et de la complexité d'incident. La diversité des modèles est utile lorsqu'elle réduit un risque mesuré.
Créez une application GPT‑5.2 Pro dans Enter Pro
J'ai utilisé le générateur d'applications par IA d'Enter Pro pour créer un relecteur de briefs de projet par IA, avec GPT‑5.2 Pro sélectionné comme intégration. L'objectif était de transformer une idée d'application approximative en exigences, informations manquantes, priorités et critères d'acceptation.
Sélectionnez GPT‑5.2 Pro et consultez les tarifs
J'ai localisé GPT‑5.2 Pro dans le catalogue de modèles et ouvert ses détails. Le panneau affichait un bouton Intégrer et des tarifs de** 2,1 crédits par 1 000 tokens d'entrée** et** 16,8 crédits par 1 000 tokens de sortie**. Ce sont les tarifs de la plateforme capturés.
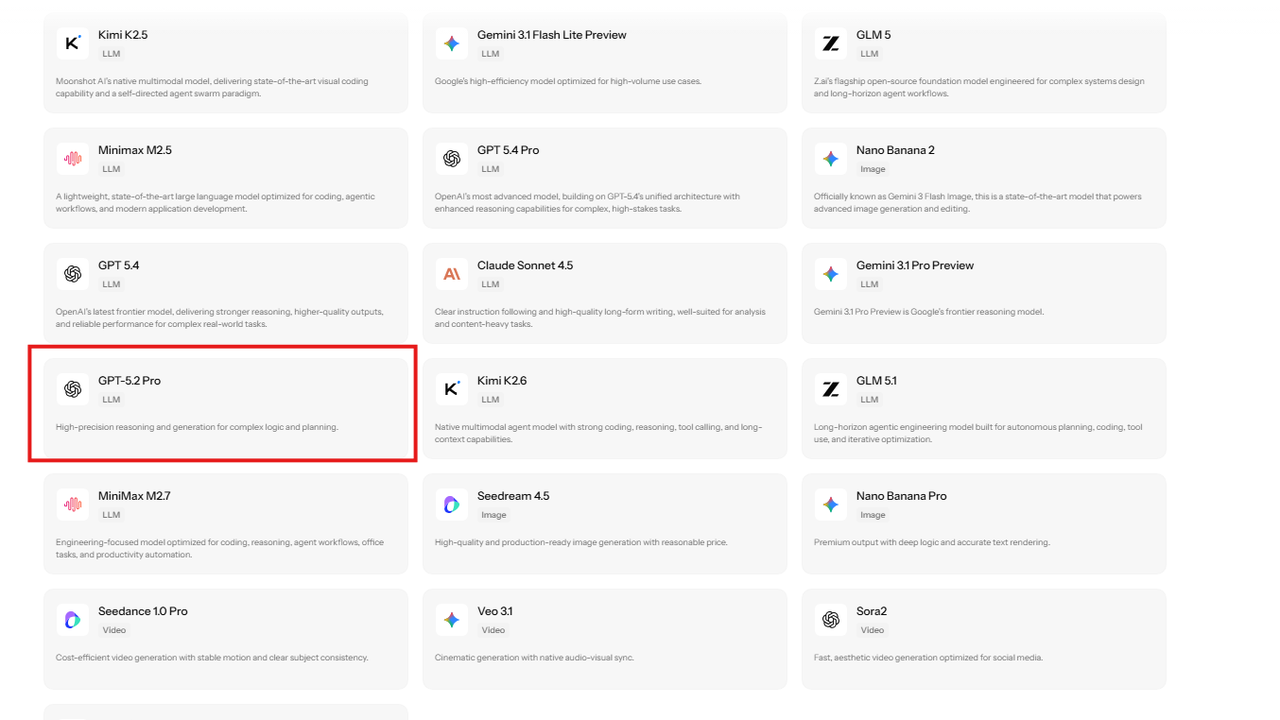
Figure 11. GPT‑5.2 Pro apparaît dans le catalogue de modèles parmi d'autres intégrations disponibles.
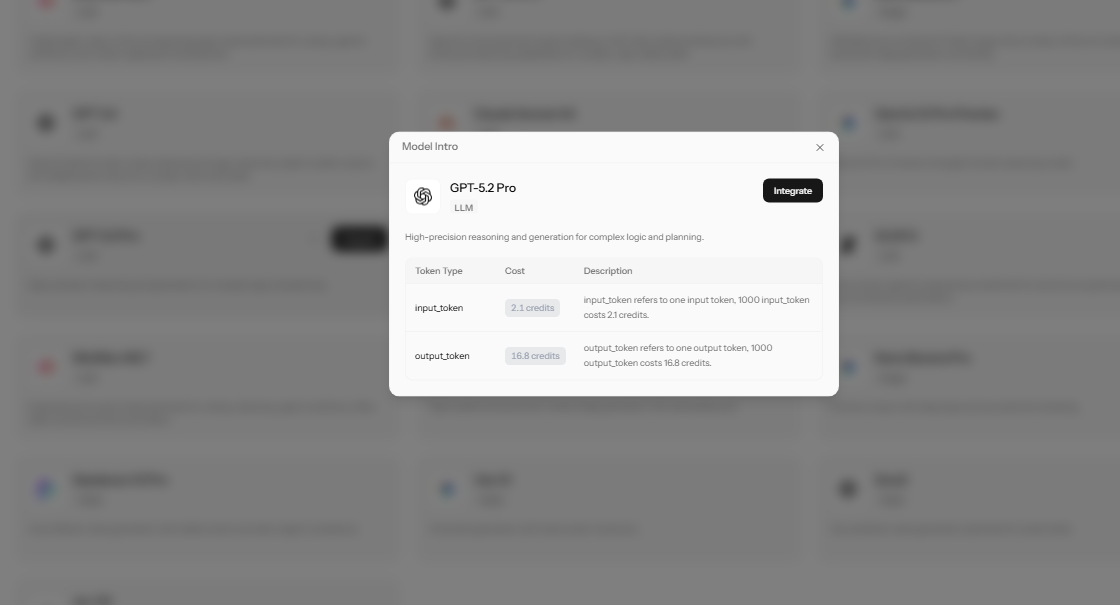
Figure 12. Le panneau de détails de GPT‑5.2 Pro affiche la commande Intégrer et les tarifs en crédits.
Associez le modèle et décrivez l'application
La requête de projet avait la puce GPT‑5.2 Pro associée. J'ai demandé un grand champ de brief, un bouton Relire le brief, et des réponses organisées en cinq sections : résumé du projet, exigences essentielles, contradictions et informations manquantes, priorités de mise en œuvre, et critères d'acceptation. La requête demandait également de véritables états de chargement et d'erreur.
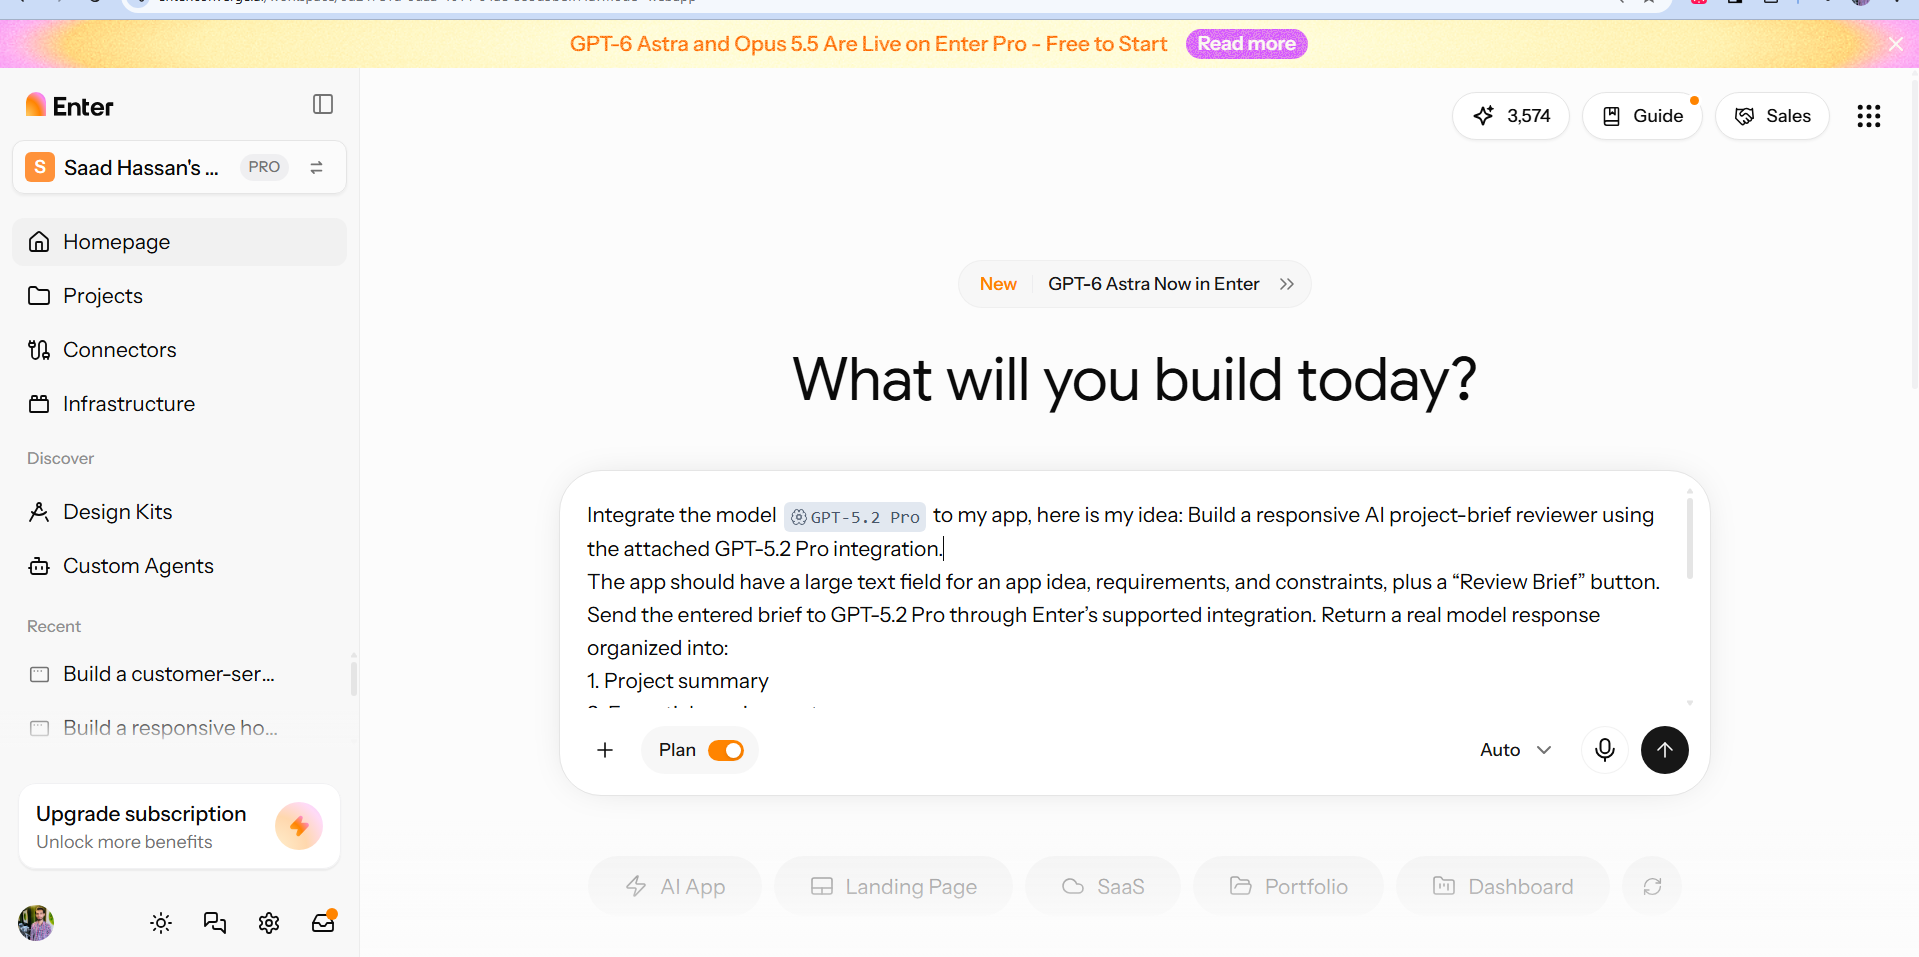
Figure 13. Le prompt du projet associe GPT‑5.2 Pro et précise l'objectif et la structure de réponse du relecteur.
Examinez le plan de construction
Enter a généré un plan pour une interface Vite, React et Tailwind avec une fonction backend gérant la requête à l'IA. Il précisait des résultats en streaming, un texte en langage clair, et aucun historique de relecture sauvegardé. Conserver l'identifiant privé sur le backend faisait partie du plan. Cette capture enregistre l'implémentation proposée.
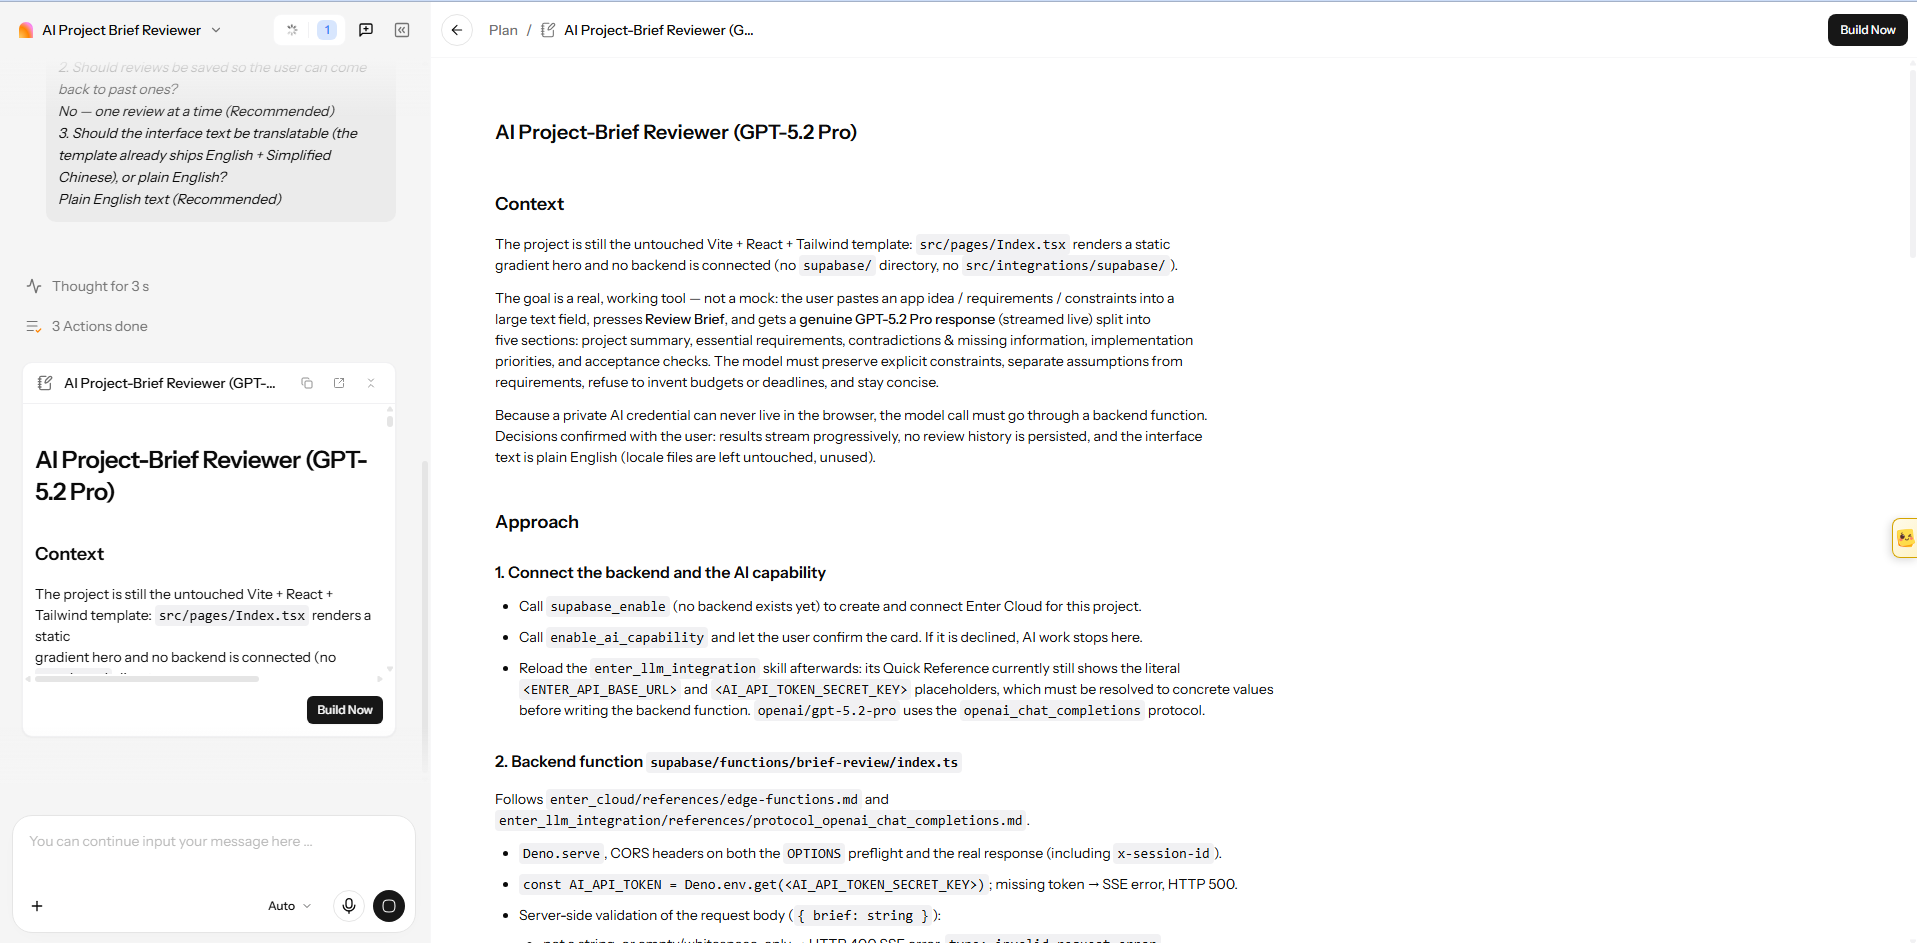
Figure 14. Le plan de construction décrit l'interface, la requête backend, la sortie en streaming et la gestion des identifiants.
Examinez la relecture visible
Le relecteur affichait un champ de brief à côté de ses panneaux de réponse. Dans la tentative capturée, j'ai saisi la demande de vérification d'implémentation dans ce champ. La réponse a réorganisé ses exigences sous les en-têtes demandés, tandis que Streaming review et** Reviewing** restaient visibles. Cela a démontré l'organisation de la réponse, avec la complétude et l'exactitude encore à vérifier.
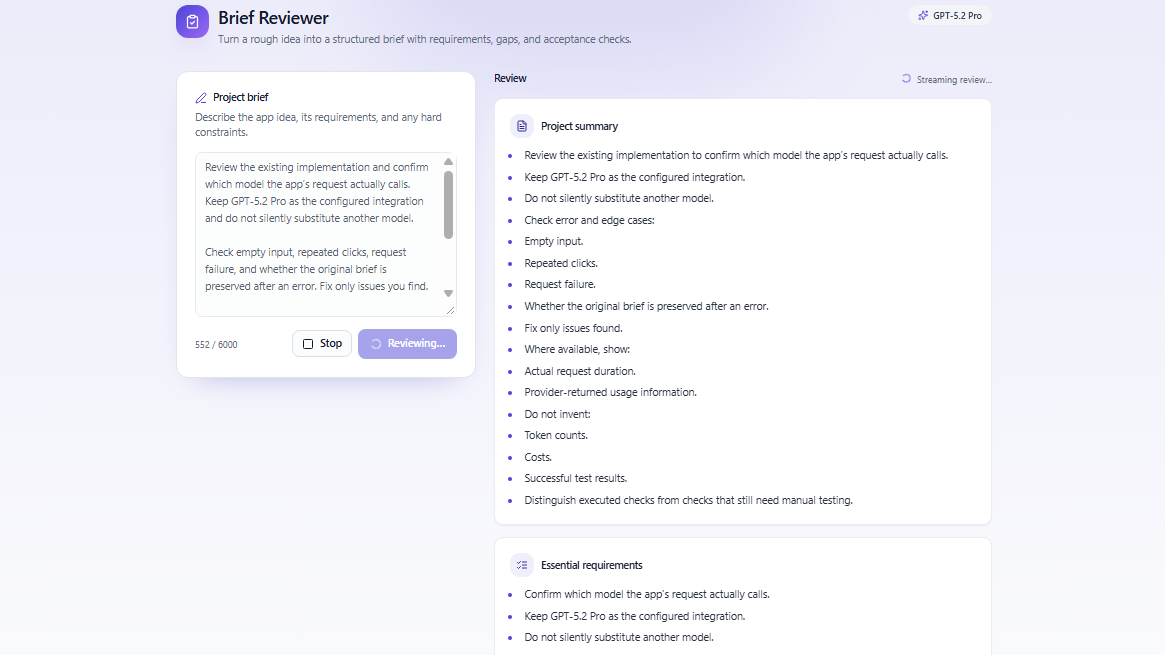
Figure 15. Le texte de la relecture apparaît sous les en-têtes demandés tandis que l'interface indique toujours une réponse active.
Pour un contrôle de raisonnement, utilisez le brief de rendez-vous avec trois techniciens, des interventions de 45 minutes, une marge de trajet de 30 minutes, des horaires de 9 h à 17 h, aucun chevauchement et une règle de replanification de 12 heures. Ajoutez ensuite « autoriser deux rendez-vous simultanés par technicien » et vérifiez si la réponse achevée signale le conflit. Ce résultat n'est pas dans ces captures.
Vérifiez l'historique des requêtes et l'utilisation des crédits
La vue d'état supplémentaire étiquetait l'intégration GPT‑5.2 Pro, le fournisseur Enter AI, et le protocole Responses API. Sa session ne contenait aucune requête, zéro token d'entrée et de sortie, et zéro utilisation consommée. Ces valeurs ne peuvent pas établir la durée, le routage réel ou le coût de la réponse précédente.
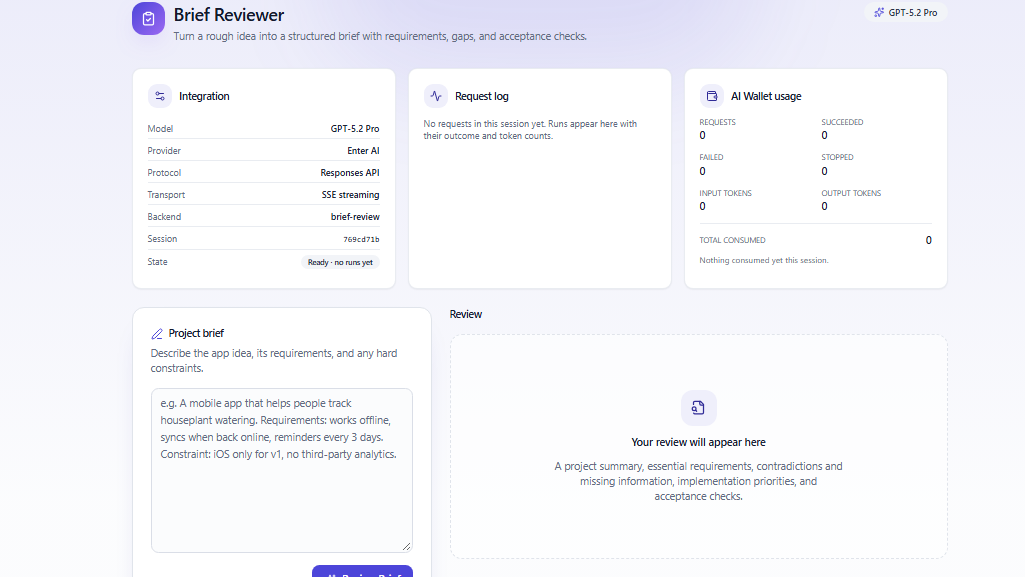
Figure 16. Les panneaux d'intégration et d'utilisation affichent une session prête sans requêtes ni consommation enregistrées.
Aux tarifs affichés, 1 000 tokens d'entrée plus 500 tokens de sortie facturés, à titre illustratif, équivaudraient à 10,5 crédits. Ceci est une estimation, pas une dépense observée. Pour comparer les coûts, utilisez les requêtes achevées, l'usage facturé, les nouvelles tentatives et la proportion de relectures répondant à vos critères d'acceptation.
Enter conserve le modèle sélectionné et le brief de l'application dans un seul projet. Créez votre application GPT‑5.2 Pro dans Enter Pro et vérifiez l'intégration avant de publier.
Conclusion finale : évaluez GPT‑5.2 à travers une tâche réelle
La valeur pratique de GPT‑5.2 dépend de la qualité de la tâche et du coût acceptable. Le projet de relecteur relie la sélection de Pro à une interface d'application et à un texte de relecture organisé. Une réponse achevée, des contraintes vérifiées et un historique de requête complété sont encore nécessaires pour juger de la fiabilité et de la rentabilité.
Choisissez le modèle le moins coûteux qui atteint votre seuil d'acceptation, répétez les cas importants, et conservez un chemin de récupération pour les erreurs. Vous pouvez utiliser Enter Pro pour créer et affiner une application GPT‑5.2 Pro, puis vérifier son intégration avant de l'étendre.
FAQ sur Chat GPT 5.2
Quand GPT-5.2 a-t-il été lancé ?
OpenAI l'a annoncé le 11 décembre 2025. Les modèles de l'API et les variantes de ChatGPT ont commencé à être déployés au lancement, bien que l'accès et les alternatives recommandées aient changé depuis.
GPT-5.2 est-il toujours le modèle le plus récent d'OpenAI ?
Non. Au 9 octobre 2026, OpenAI le documente comme un modèle de génération précédente. Les personnes recherchant Chat GPT 5.2 devraient distinguer l'accès via le sélecteur ChatGPT de l'accès via l'API ou une intégration tierce. Vérifiez la variante exacte et la disponibilité actuelle avant de démarrer un projet.
Quelle est la fenêtre de contexte de GPT-5.2 ?
La fenêtre de contexte documentée est de 400 000 tokens, avec une sortie maximale de 128 000 tokens. Vous devriez tout de même tester la récupération et le raisonnement sur vos propres longs documents réels.
Combien coûte l'API GPT-5.2 ?
Le tarif API standard est de 1,75 $ par million de tokens d'entrée, 0,175 $ par million de tokens d'entrée en cache, et 14 $ par million de tokens de sortie. Les frais d'outils, le raisonnement, les nouvelles tentatives et la relecture s'ajoutent au coût de la tâche.
Comment puis-je créer une application GPT‑5.2 Pro avec Enter Pro ?
Sélectionnez GPT‑5.2 Pro dans le catalogue de modèles, associez l'intégration et décrivez la fonctionnalité dont votre application a besoin. Pour un relecteur de briefs de projet, précisez les entrées requises et le format de relecture. Examinez l'implémentation générée, puis vérifiez une requête achevée pour confirmer que la connexion au modèle fonctionne.
Comment puis-je vérifier l'utilisation de GPT‑5.2 Pro dans Enter Pro ?
Vérifiez les panneaux de requêtes et d'utilisation de l'intégration après avoir exécuté une tâche représentative. Confirmez que la requête apparaît, puis examinez les tokens d'entrée, les tokens de sortie et les crédits consommés. Incluez les nouvelles tentatives et les réponses plus longues lors de l'estimation des coûts, en utilisant les tarifs actuels de la plateforme.
Qu'est-ce que GPT-5.2 Pro ?
GPT 5.2 Pro est un modèle de raisonnement à plus forte intensité de calcul pour les tâches professionnelles difficiles. Ses tarifs officiels d'API sont de 21 $ par million de tokens d'entrée et 168 $ par million de tokens de sortie, et certaines requêtes peuvent prendre plusieurs minutes.
GPT-5.2 prend-il en charge les images ?
Oui. Il accepte une entrée d'image et produit une sortie de texte. L'audio et la vidéo ne sont pas listés comme entrées natives prises en charge, ces formats nécessitent donc une étape de traitement séparée.
GPT-5.2 est-il meilleur que Gemini 3 ?
Il n'y a pas de réponse universelle. Testez les variantes exactes avec les mêmes prompts, fichiers, outils, budget et grille d'évaluation, puis comparez la qualité des résultats acceptés, la latence, le coût, la gouvernance et la récupération après échec.
GPT-5.2 peut-il générer du code prêt pour la production ?
Il peut générer du code solide, mais la préparation pour la production vient de l'ensemble du processus d'ingénierie : tests, relecture des diffs, vérifications de dépendances et de sécurité, outils restreints, mise en préproduction, surveillance et rollback. Le modèle ne peut pas remplacer ces contrôles.





