
De MiniMax M2.5 à la vraie productivité IA : pourquoi les outils comptent plus que les modèles
MiniMax M2.5 est rapide, puissant et économique, mais peut-il vraiment remplacer vos flux de travail ? Forces, limites, et pourquoi les outils comptent plus que le modèle.
La sortie de MiniMax M2.5 marque une étape importante pour l'écosystème de l'IA. On voit enfin un modèle à poids ouverts capable d'orchestrer des flux de travail agentiques complexes pour une fraction des coûts habituels en entreprise. Les modèles passent rapidement du statut de simples chatbots répondant à des questions à celui de systèmes capables d'exécuter de véritables flux de travail.
Cependant, avoir accès à une puissance brute ne signifie pas automatiquement que votre productivité quotidienne va s'améliorer. Dans ce test pratique du modèle d'IA MiniMax M2.5, je détaille mon expérience avec ce système, j'analyse ses performances au sommet des classements et je révèle pourquoi le véritable goulot d'étranglement n'est plus le modèle lui-même, mais la façon dont vous le déployez.
Qu'est-ce que MiniMax M2.5 ?
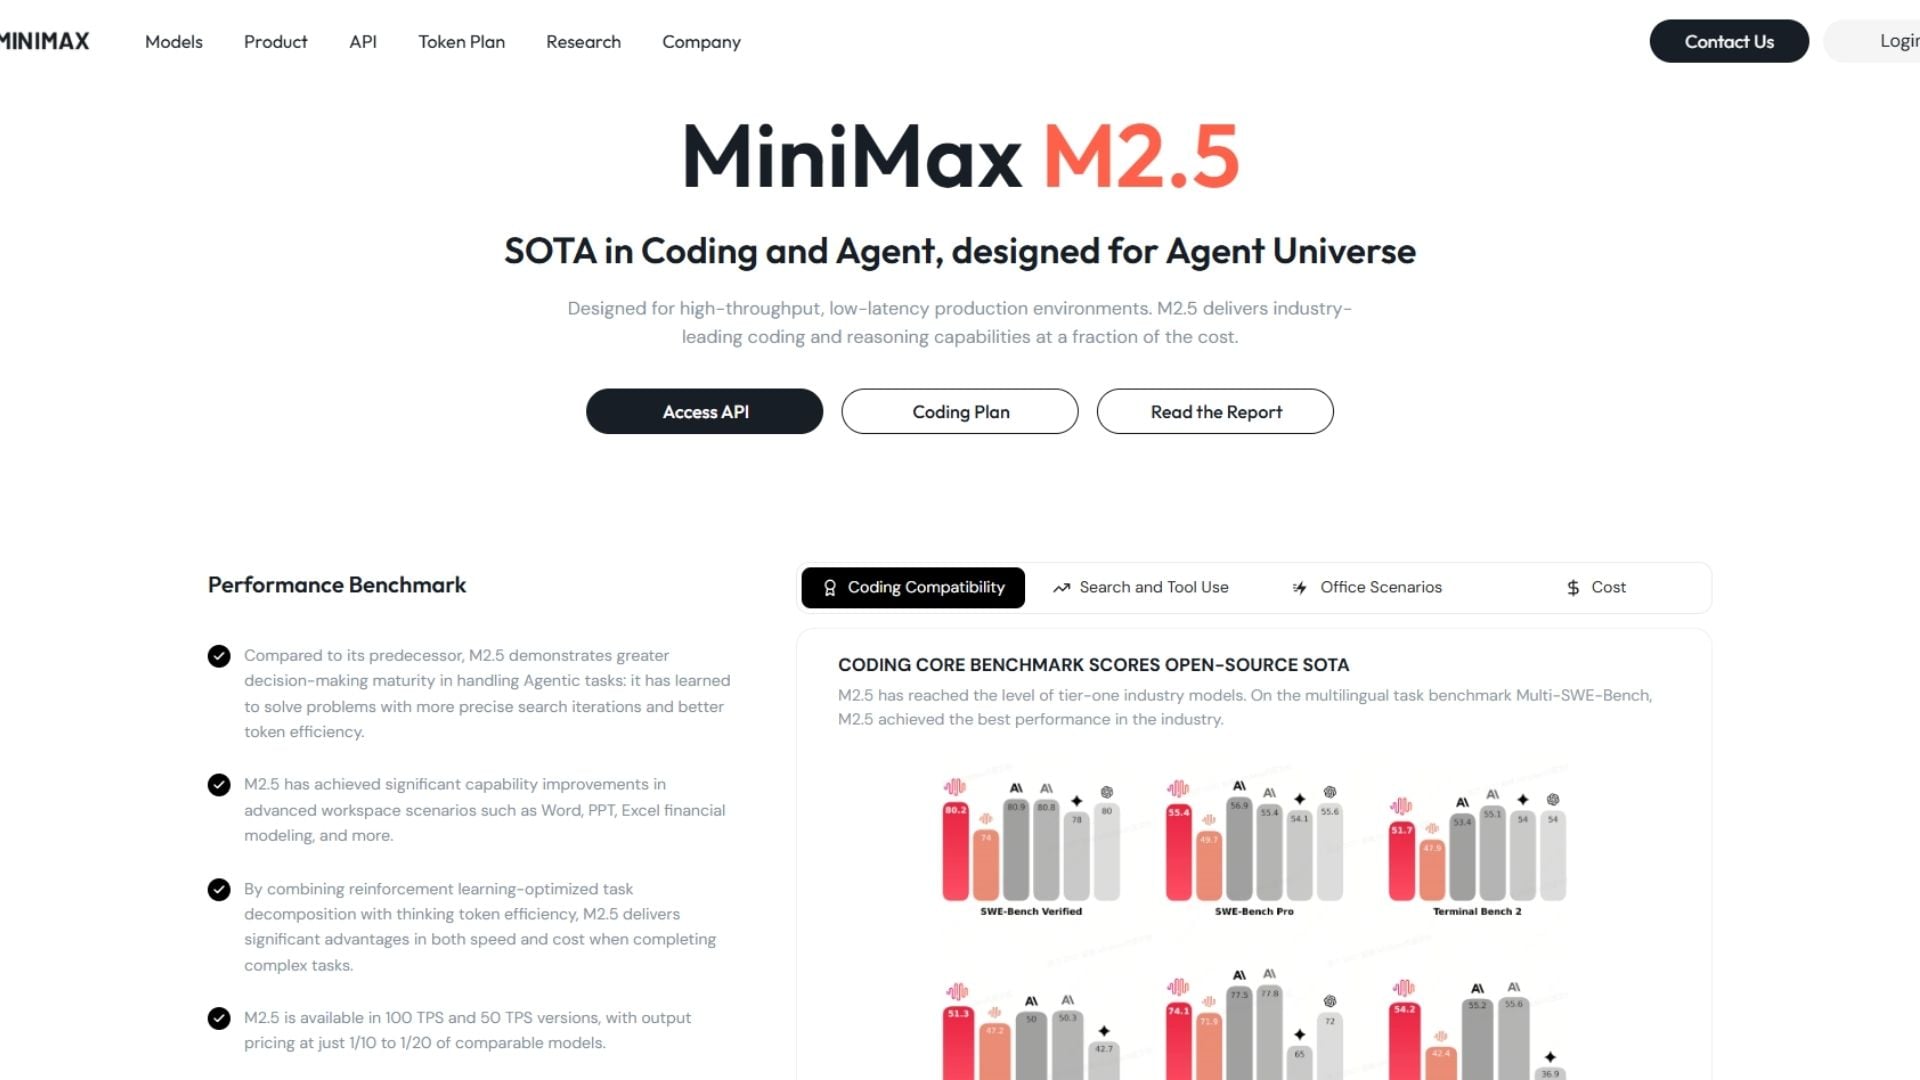
MiniMax M2.5 est un LLM de pointe conçu spécifiquement pour gérer du code complexe et une véritable productivité bureautique. Sorti le 12 février 2026, il repose sur une architecture Mixture of Experts (MoE) massive de 230 milliards de paramètres.
Lors de mes tests, j'ai évalué son impressionnante fenêtre de contexte de 205 000 tokens ainsi que son positionnement unique en tant qu'agent « spec-first ». Les utilisateurs peuvent accéder à cet écosystème via de nombreux fournisseurs d'API, dont le point d'accès ultra-rapide Together AI MiniMax M2.5. Cette large disponibilité le rend très accessible aux développeurs cherchant une alternative à Claude ou GPT-4.
Qu'est-ce qui rend MiniMax 2.5 remarquable ?
Plusieurs raisons expliquent pourquoi MiniMax 2.5 attire autant l'attention dans le monde du développement.
Décomposition avancée des tâches
Pendant mes tests, le modèle a systématiquement affiché ce que ses créateurs appellent un « comportement spec » natif. MiniMax M2.5 est capable d'analyser une instruction de haut niveau et de la convertir en étapes concrètes.
Il conçoit le design de l'interface et la logique back-end de manière conceptuelle avant même d'écrire une seule ligne de code. Cette capacité « spec-first » est essentielle pour construire des agents IA, car elle évite que des projets complexes ne déraillent immédiatement par manque de planification structurelle.
Un excellent support pour le code et les flux de travail
De l'écriture de scripts au débogage d'applications complètes, MiniMax-M2.5 affiche un niveau élevé sur des benchmarks d'ingénierie logicielle comme SWE-Bench Verified, Multi-SWE-Bench et Terminal Bench, le plaçant parmi les meilleurs modèles pour des tâches de codage réelles.
Voici le détail de ses capacités vérifiées :
| Benchmark | Score | Ce qui est mesuré | Pourquoi c'est important |
|---|---|---|---|
| SWE-Bench Verified | ~80,2 % | Corriger de vrais tickets GitHub dans de vrais dépôts | Référence incontournable pour les capacités réelles d'ingénierie logicielle |
| Multi-SWE-Bench | ~51,3 % | Tâches de codage multi-dépôts et multilingues | Teste le raisonnement au niveau système dans des environnements complexes |
| SWE-Bench Pro | ~55,4 % | Tâches d'ingénierie plus difficiles | Mesure la performance dans des scénarios plus exigeants |
| SWE-Bench Multilingual | ~74 % | Codage dans plusieurs langages | Montre une généralisation au-delà des bases de code en anglais |
| Terminal Bench (v2) | ~51,7 % | Réalisation de tâches en environnement terminal/outils | Reflète des flux de travail de codage de type agent (pas seulement de la génération) |
| BrowseComp | ~76,3 % | Recherche + raisonnement + exécution | Simule un débogage réel avec des informations externes |
| VIBE-Pro (interne) | N/D (relatif) | Flux de travail complexes d'ingénierie logicielle | Indique la performance sur des tâches full-stack ou en longue chaîne |
| Évaluation bureautique/productivité | ~59 % de victoires | Tâches de documents, tableurs, flux de travail | Montre des capacités au-delà du code, dans la productivité réelle |
Productivité dans tous les domaines
Au-delà du code, MiniMax M2.5 prend en charge la génération de documents, l'automatisation de tableurs et des flux de travail métier structurés. Il affiche un taux de victoire impressionnant de 59 % face aux modèles grand public en comparaison directe sur des tâches Excel et PowerPoint.
Une efficacité de coût impressionnante
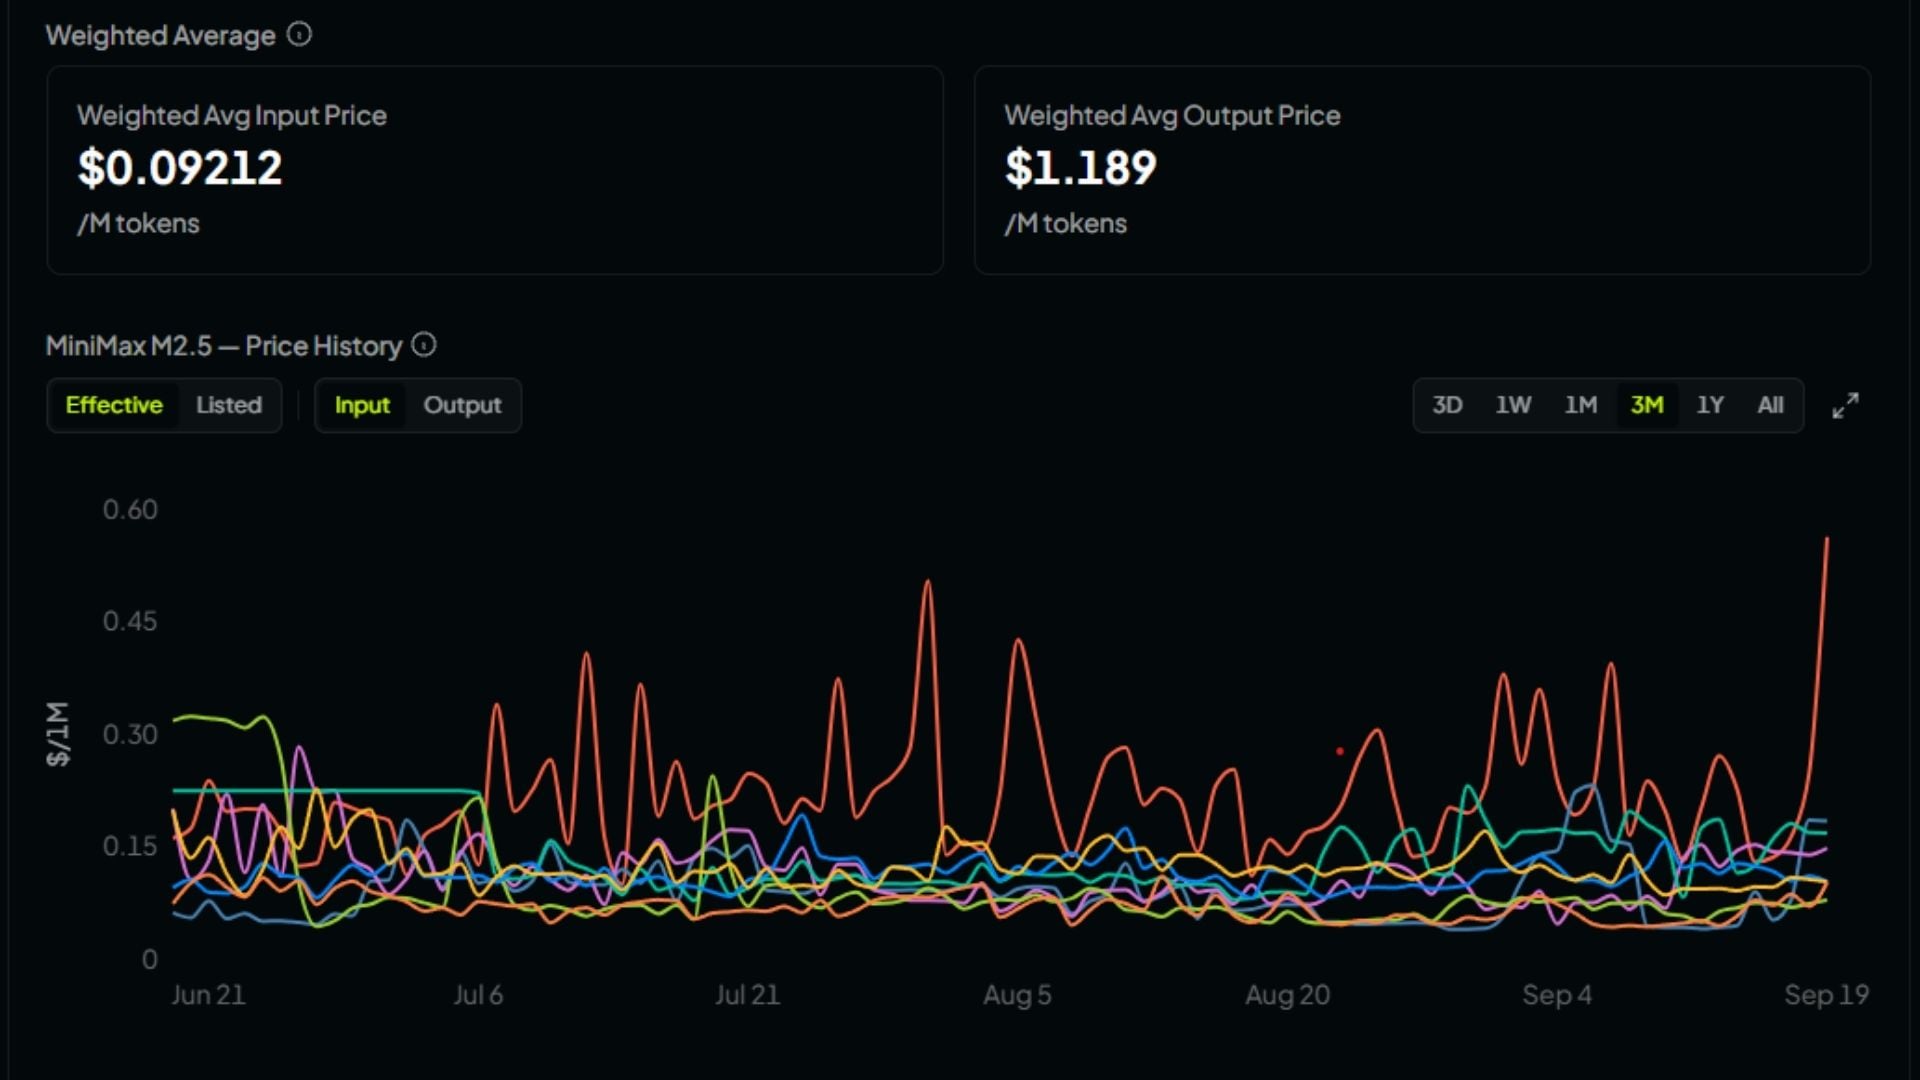
Le tarif de l'API MiniMax M2.5 est 5 à 20 fois moins cher que la plupart des modèles haut de gamme, combinant les coûts d'entrée et de sortie à environ 0,44 $ par million de tokens chez les fournisseurs économiques. Son prix se rapproche des modèles légers, mais sa performance se rapproche des modèles phares.
Cela crée un positionnement rare : « des capacités haut de gamme à un prix proche d'une commodité ». Combiné aux offres de MiniMax M2.5 gratuit ou à l'expérimentation à coût quasi nul sur les plateformes ouvertes, cela abaisse considérablement la barrière à l'entrée.
Cependant, un prix plus bas ne se traduit pas forcément par un coût total plus faible — surtout si l'on prend en compte l'ergonomie, la conception du flux de travail et le temps d'itération.
| Modèle | Prix d'entrée (par 1M tokens) | Prix de sortie (par 1M tokens) | Coût relatif | Positionnement |
|---|---|---|---|---|
| MiniMax M2.5 | ~0,15 $ | ~0,90 $ | 🟢 Très bas | Haute performance + ultra rentable |
| GPT-4o (OpenAI) | ~5,00 $ | ~15,00 $ | 🔴 Très élevé | Modèle phare généraliste |
| Claude 3.5 Sonnet | ~3,00 $ | ~15,00 $ | 🔴 Élevé | Fort en raisonnement et codage |
| Claude 3 Haiku | ~0,25 $ | ~1,25 $ | 🟡 Bas | Rapide et léger |
| Gemini 1.5 Pro | ~3,50 $ | ~10,50 $ | 🔴 Élevé | Long contexte + multimodal |
| Mistral Large | ~2,00 $ | ~6,00 $ | 🟠 Moyen | LLM orienté entreprise |
Pourquoi MiniMax 2.5 ressemble à un tournant
Historiquement, déployer une IA compétente signifiait choisir entre un coût extrême et un raisonnement médiocre. En levant les anciennes contraintes, la sortie du modèle d'IA MiniMax M2.5 marque un changement : la capacité n'est plus rare.
- La performance n'est plus le principal problème, puisque des modèles à poids ouverts atteignent plus de 80 % sur SWE-Bench Verified.
- Le coût n'est plus le principal obstacle, compte tenu des tarifs d'exécution de tokens incroyablement bas.
Le secteur entre dans une nouvelle ère où l'intelligence brute devient une commodité, accessible à quiconque est prêt à l'exploiter.
Les défis cachés de l'utilisation de MiniMax M2.5
Malgré des benchmarks phénoménaux, intégrer le modèle dans une routine quotidienne n'est pas totalement fluide.
La complexité de l'utilisation directe
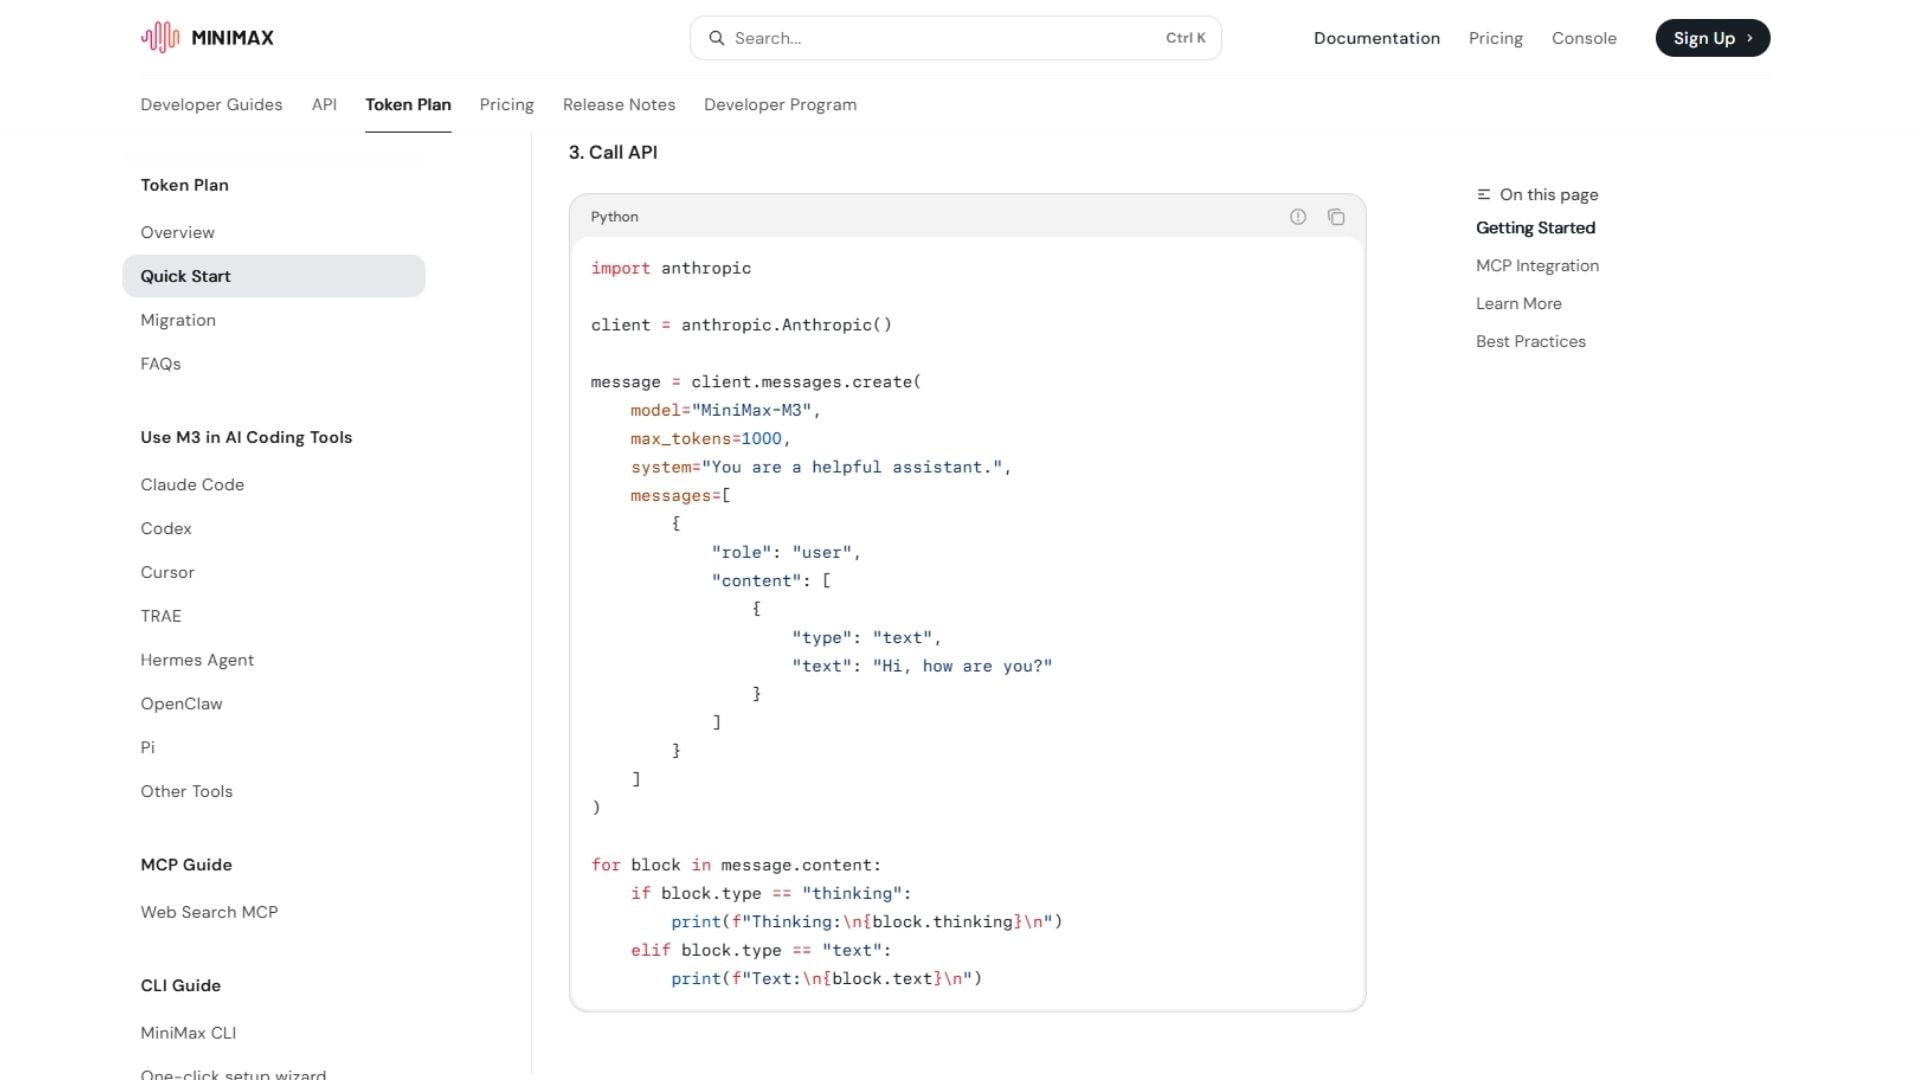
Utiliser ce modèle directement via une API demande un travail important de prompt engineering pour maintenir sa logique de raisonnement.
L'intégration de l'API implique un effort conséquent, créant une courbe d'apprentissage élevée pour les utilisateurs non techniques peu à l'aise avec la gestion de scripts, d'en-têtes et de limites de tokens.
Absence de flux de travail intégrés
Modèle ≠ produit. Un modèle de langage est en fait un « cerveau dans un bocal » sans interface.
Les utilisateurs doivent :
- Concevoir les flux et les interfaces utilisateur.
- Enchaîner les prompts pour les tâches à plusieurs étapes.
- Gérer la logique manuellement et construire l'infrastructure environnante.
Variabilité des résultats
Même avec un raisonnement avancé, vous rencontrerez le problème classique : même MiniMax-M2.5, résultats différents.
La cohérence des résultats dépend entièrement de :
- La structure et la clarté de l'entrée.
- La qualité du contexte fourni dans le prompt.
- L'expertise de l'utilisateur pour recadrer le modèle.
Des modèles puissants comme MiniMax M2.5 déplacent le défi de l'accès vers l'exécution. N'importe qui peut mettre la main sur les derniers modèles, mais seuls quelques-uns peuvent en exploiter toutes les capacités.
Le changement : du choix du modèle au choix de l'outil
À mesure que des modèles comme MiniMax M2.5 deviennent plus puissants et plus accessibles, la véritable différenciation se déplace ailleurs. Il ne s'agit plus seulement de savoir quel modèle vous utilisez, mais :
- À quel point il est facile à utiliser.
- S'il s'intègre à votre flux de travail.
- À quel point les résultats sont cohérents.
C'est là qu'une nouvelle couche de produits commence à compter, en comblant l'écart entre l'intelligence brute et des résultats concrets et déployables.
Là où des outils comme Enter Pro entrent en jeu
Plutôt que d'interagir directement avec des modèles bruts comme MiniMax M2.5, certaines plateformes se concentrent sur la simplification de l'expérience. Des solutions comme Enter Pro visent à :
- Faire abstraction de la complexité des prompts.
- Fournir des flux de travail intégrés.
- Offrir des résultats plus cohérents.
Plutôt que de concurrencer des modèles comme MiniMax M2.5, ces outils s'appuient sur eux — transformant une capacité brute en productivité concrète. Vous pouvez enfin commencer à construire la startup que vous avez toujours voulue.
Comment utiliser Enter Pro pour le développement visuel
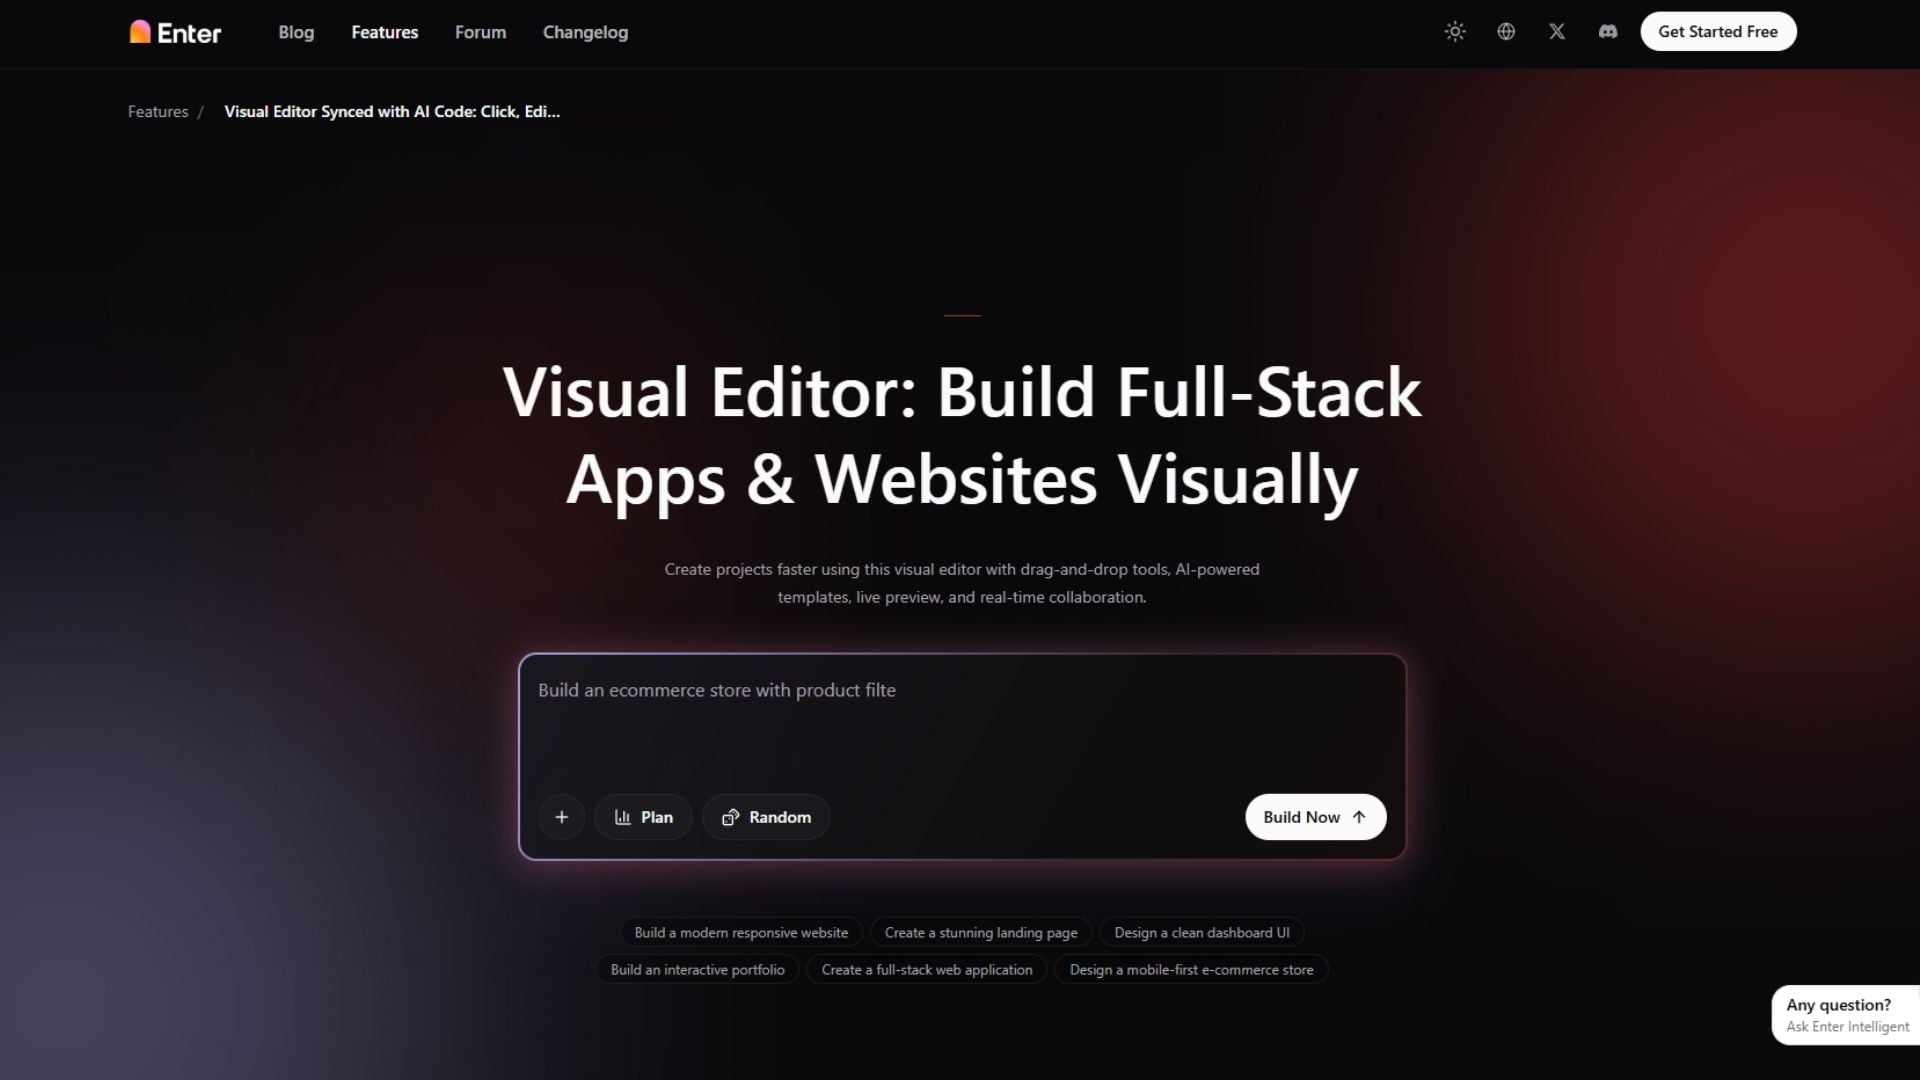
Si gérer des endpoints API vous semble fastidieux, le développement visuel est la solution. Voici comment transformer vos idées en logiciel avec Enter Pro :
| Étape 1 : Définissez votre vision | Décrivez le concept de votre application en langage naturel dans le tableau de bord d'Enter Pro. Pas besoin de vous soucier d'un prompting système complexe : l'outil structure automatiquement vos exigences. |
|---|---|
| Étape 2 : Vérifiez le plan généré par l'IA | Enter Pro prend votre idée et crée un plan visuel interactif décrivant l'interface front-end et la logique de base de données. Vous pouvez ajuster et approuver ce plan visuellement avant qu'aucun code ne soit généré. |
| Étape 3 : Publiez et itérez | Une fois approuvé, cliquez sur « Build ». Enter Pro génère l'ensemble de la stack, l'héberge et vous fournit une URL en ligne. |
En conclusion : la vraie décision ne porte pas sur les modèles
L'arrivée de MiniMax M2.5 marque une étape importante dans le développement de l'IA. Avec de solides performances, un coût bas et une accessibilité croissante, il représente l'avenir des systèmes intelligents.
Mais il révèle aussi une vérité plus profonde : le plus grand défi n'est plus l'accès à une IA puissante, mais savoir l'utiliser efficacement. Pour les développeurs, travailler directement avec MiniMax M2.5 offre flexibilité et contrôle.
Pour tous les autres, la question devient plus simple : voulez-vous construire vos flux de travail vous-même ? Ou utiliser des outils qui les font déjà fonctionner ? Enter Pro pourrait vous apporter une meilleure réponse.
FAQ
À quoi MiniMax M2.5 convient-il le mieux ?
Il excelle dans l'ingénierie logicielle réelle, la correction de bugs et les tâches complexes de productivité bureautique, comme l'automatisation des flux Excel et PowerPoint via des intégrations API.
Les débutants peuvent-ils utiliser MiniMax M2.5 directement ?
L'utilisation directe nécessite des connaissances en programmation pour gérer les endpoints API et les fenêtres de contexte. Les débutants ont tout intérêt à utiliser des plateformes qui font abstraction du modèle derrière une interface visuelle.
Pourquoi les résultats varient-ils autant avec MiniMax M2.5 ?
La qualité des résultats dépend fortement de la structure du prompt, de la gestion du contexte et de la capacité de l'utilisateur à définir clairement des contraintes. Des instructions vagues entraînent inévitablement des résultats incohérents.
MiniMax M2.5 remplace-t-il les outils traditionnels ?
Non. Il fonctionne comme un moteur de raisonnement sous-jacent qui nécessite une interface ou un générateur de flux de travail distinct pour véritablement remplacer un ensemble d'outils complet destiné aux utilisateurs non techniques.
Un prix bas suffit-il pour une adoption en entreprise ?
Si des coûts d'API bas sont très attractifs, les entreprises ont aussi besoin d'une sécurité des données robuste, d'interfaces utilisateur soignées et d'intégrations de flux de travail fiables avant une adoption à grande échelle.
MiniMax M2.5 est-il gratuit ?
Le modèle à poids ouverts peut être téléchargé et exécuté localement gratuitement, mais la plupart des utilisateurs y accèdent via des fournisseurs d'API payants, mais très abordables.
Comment exécuter MiniMax M2.5 localement ?
Il faut des ressources GPU conséquentes pour exécuter localement un modèle MoE de 230 milliards de paramètres. Des frameworks comme Ollama ou vLLM peuvent être utilisés, à condition que votre matériel réponde aux exigences élevées en mémoire.
Quelle est la taille de MiniMax M2.5 ?
Il repose sur une architecture Mixture of Experts (MoE) de 230 milliards de paramètres, avec environ 10 milliards de paramètres actifs utilisés à chaque passe avant.





