AI Terbaik untuk Coding: Perbandingan Berdasarkan Tugas, Biaya, dan Workflow
Bandingkan AI terbaik untuk coding berdasarkan workflow, model, batas paket gratis, dan biaya nyata, lalu lihat contoh aplikasi Enter Pro dengan pengujian jelas.
AI terbaik untuk coding adalah tool yang membantu Anda menyelesaikan perubahan yang bisa Anda pahami, tinjau, dan rawat. Saran fungsi singkat, perbaikan di seluruh repository, dan aplikasi yang benar-benar berjalan membutuhkan jenis bantuan yang berbeda-beda. Memilih hanya berdasarkan skor model tertentu bisa menutupi peran editor, tools eksekusi, batas penggunaan, dan proses review yang sebenarnya menentukan hasil akhir.
Saya akan menyeleksi berdasarkan jenis pekerjaan terlebih dahulu, lalu menjalankan perbandingan kecil pada tugas-tugas yang representatif. Panduan ini memisahkan tools dari model, membandingkan enam environment pengembangan, memeriksa akses gratis dan bukti yang dipublikasikan, serta menjelaskan metode evaluasi yang bisa diulang. Menjelang akhir, proyek FixTrack yang dibangun di Enter Pro menyatukan pengujian pembuatan aplikasi melalui interface pelacak isu privat, dengan hasil yang terlihat dipisahkan secara jelas dari pengujian backend yang masih harus diselesaikan.
AI Apa yang Terbaik untuk Coding Sesuai Pekerjaan Anda Sebenarnya?
Memilih AI terbaik untuk coding dimulai dari tugas dan environment yang perlu Anda pertahankan. Asisten yang cocok untuk repository yang sudah mapan bisa jadi pilihan lebih baik daripada generator aplikasi untuk tiket maintenance. Pembuat aplikasi berbasis browser bisa menghilangkan pekerjaan setup untuk prototipe baru. Berikut ini adalah titik awal untuk evaluasi, bukan peringkat performa yang terukur.
Pertahankan editor dan workflow GitHub Anda: evaluasi GitHub Copilot untuk saran kode, pertanyaan seputar kode, dan tugas repository yang didelegasikan.
Selidiki dan ubah beberapa file: bandingkan Cursor, Claude Code, atau Codex menggunakan snapshot repository yang sama dan test acceptance yang sama.
Coba environment yang berfokus pada agent: evaluasi Google Antigravity berdasarkan kelayakan akun saat ini, model yang didukung, dan batas rate limit.
Bangun prototipe berbasis browser: bandingkan workflow proyek Replit dengan workspace pembuatan aplikasi seperti Enter Pro, termasuk kebutuhan data dan deployment.
AI tools terbaik untuk coding bisa saling tumpang tindih di antara tugas-tugas ini. Hindari membayar beberapa subscription sekaligus sebelum Anda bisa mengidentifikasi tugas konkret yang satu tool tangani lebih baik dalam workflow Anda.
Untuk menjawab "AI apa yang terbaik untuk coding?", gunakan tugas yang sudah Anda tahu cara menilainya. Pemula bisa memprediksi output dari fungsi kecil; maintainer bisa mereproduksi bug; founder bisa mengikuti alur aksi pelanggan secara lengkap. Referensi yang sudah diketahui ini mencegah penjelasan yang terdengar lancar menggantikan bukti nyata. Simpan implementasi manual biasa atau test yang sudah ada sebagai baseline jika memungkinkan, agar Anda bisa melihat apakah bantuan AI benar-benar menghemat pekerjaan setelah proses review dan perbaikan.
Pisahkan Model, Tool, dan Agent
Model Menghasilkan Reasoning dan Kode
Model menerima input dan menghasilkan output. Tool menambahkan interface dan konteks proyek. Agent menggabungkan model dengan loop eksekusi yang bisa memeriksa file, menjalankan command, dan merevisi pekerjaan. Dua produk yang menawarkan model serupa tetap bisa berperilaku berbeda karena mereka menyediakan konteks, tools, izin, dan feedback yang berbeda.
Konteks dan Verifikasi Sama Pentingnya dengan Generasi
Context window yang besar adalah kapasitas, bukan bukti bahwa file yang tepat telah digunakan. Untuk bug login, konteks yang berguna meliputi route yang gagal, konfigurasi autentikasi, test yang relevan, dan behavior yang diharapkan. Penjelasan yang terdengar meyakinkan tanpa reproduksi kegagalan atau pemeriksaan perubahan adalah bukti yang lebih lemah dibandingkan perbaikan sempit yang lolos pengecekan yang bermakna.
Untuk perubahan lintas file, minta agent mengidentifikasi route, schema, pemanggil, dan test yang sudah ada sebelum melakukan edit. Lalu bandingkan pemetaannya dengan repository sebenarnya. Jika ia melewatkan helper bersama atau mengarang path file, perbaiki konteksnya sebelum implementasi. AI tools terbaik untuk coding berguna sebagian karena mereka mempersingkat proses investigasi ini, tetapi ringkasan yang percaya diri saja tidak cukup. Konteks yang relevan harus muncul dalam patch sebenarnya dan dalam verifikasi.
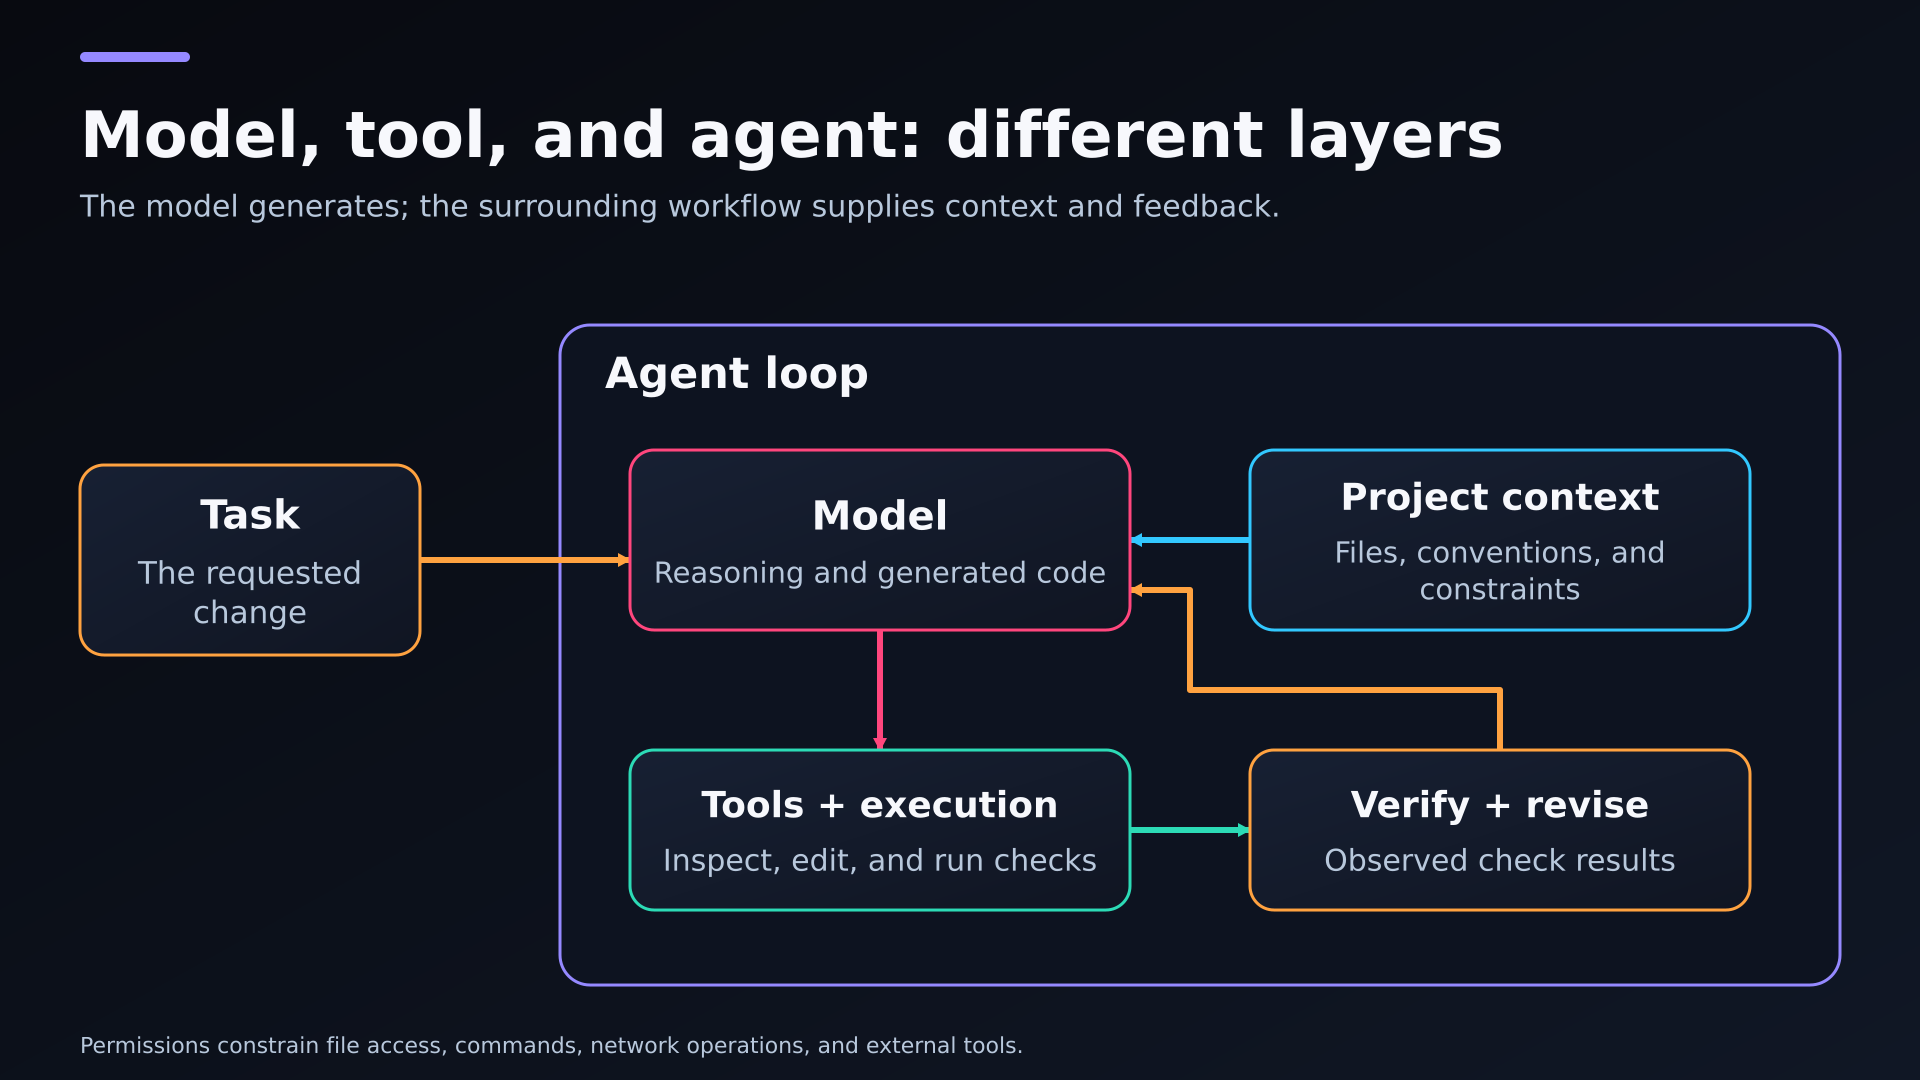
Loop konseptual agent yang menunjukkan konteks proyek, model, eksekusi tool, dan verifikasi.
Bandingkan Enam AI Coding Tools Berdasarkan Environment Kerjanya
GitHub Copilot untuk Editor dan Workflow Repository yang Sudah Ada
Copilot menawarkan saran inline, pertanyaan seputar codebase, review, dan tugas agentic dalam workflow pengembangan yang didukung. Ini jadi kandidat yang berguna saat Anda ingin bantuan di sekitar editor, issue, atau pull request yang sudah ada. Evaluasi fitur yang tersedia di plan dan editor pilihan Anda; mode agent lokal dan pull request yang dibuat di cloud adalah kemampuan yang berbeda.
Uji coba yang berguna adalah helper dengan type signature yang sudah mapan dan pemanggil terdekat. Periksa apakah saran mengikuti aturan proyek, bukan malah memperkenalkan library validasi lain. Lalu coba pertanyaan repository yang membutuhkan penelusuran import lintas modul. Perlakukan bantuan inline dan tugas yang didelegasikan sebagai hasil yang terpisah; satu tool bisa praktis untuk hal tertentu meski Anda lebih memilih agent lain untuk perubahan yang lebih luas.
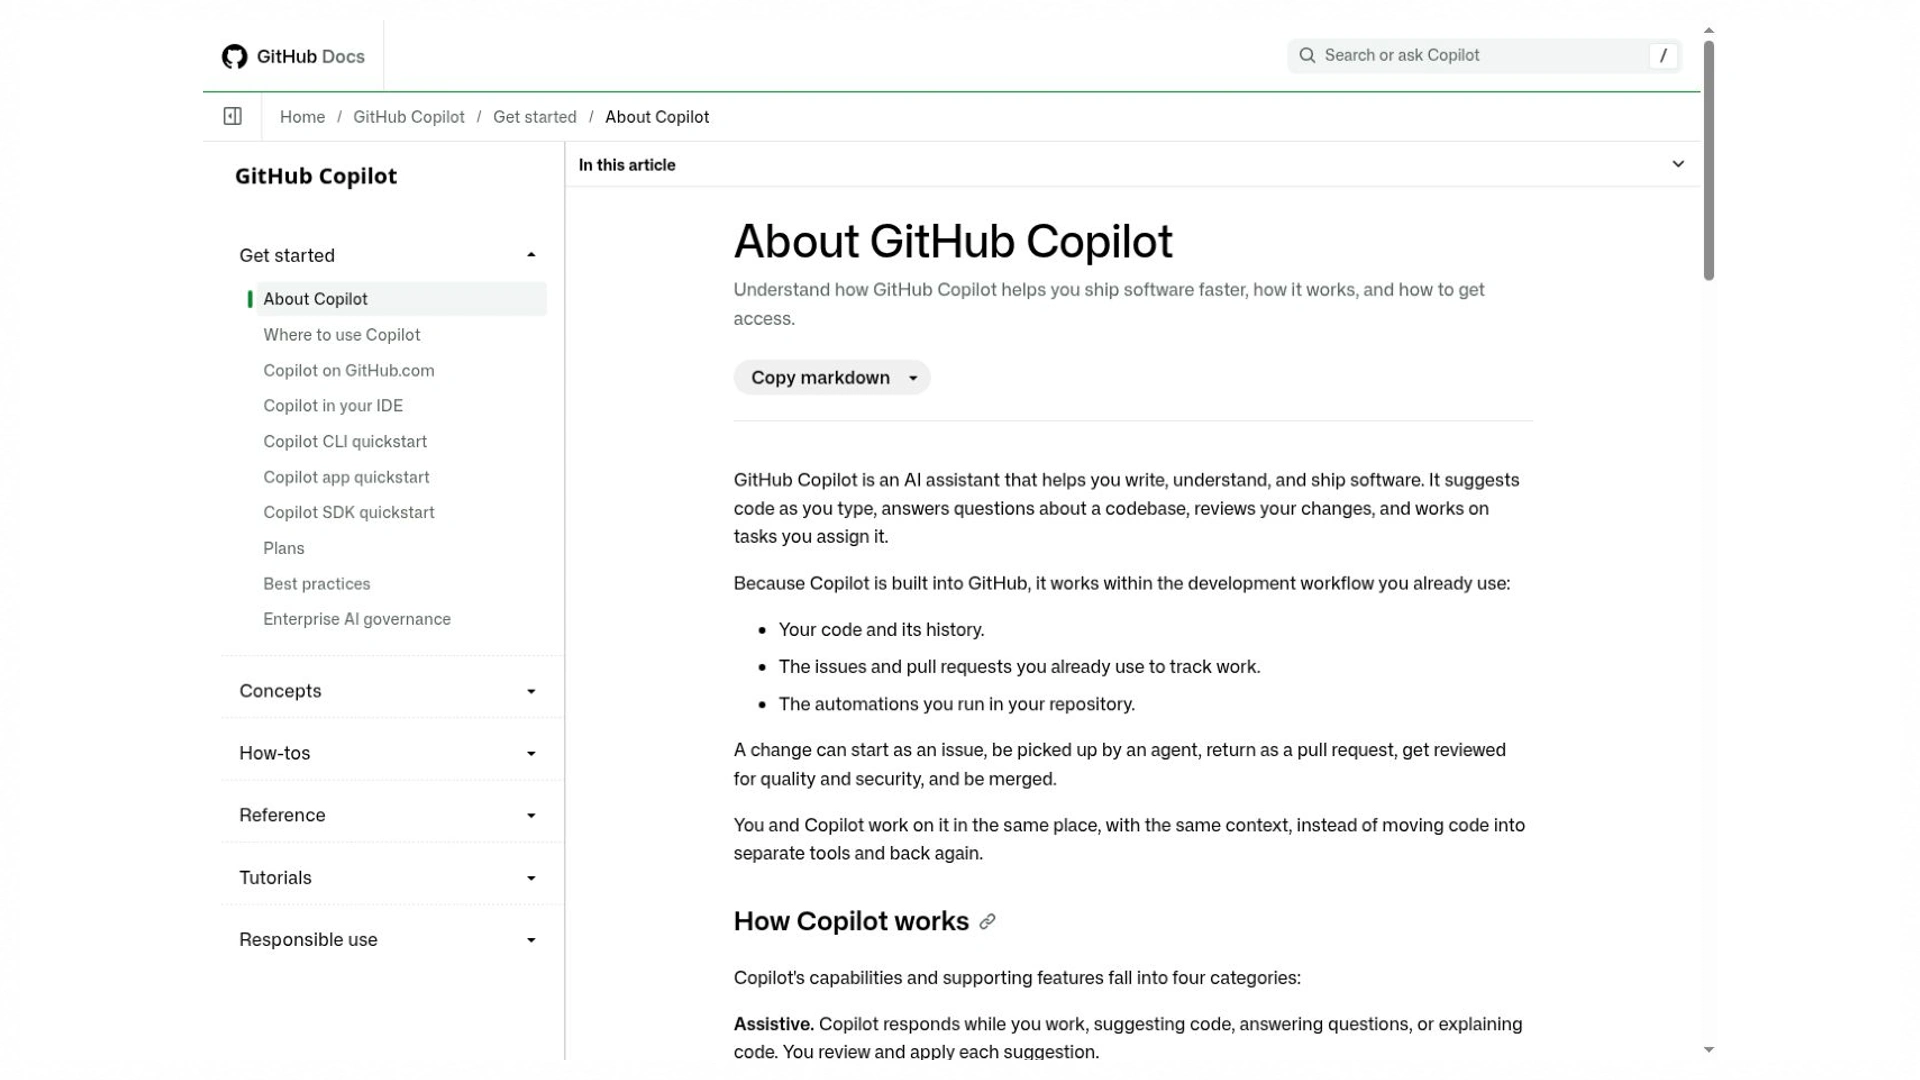
Overview ini menjelaskan bantuan dan workflow agent yang didukung. Ketersediaan fitur bergantung pada environment dan plan yang terdokumentasi.
Cursor untuk Merencanakan dan Meninjau Perubahan di Seluruh Proyek
Dokumentasi Cursor mencakup pemahaman repository, perencanaan, implementasi, debugging, dan review perubahan. Pertimbangkan tool ini saat pekerjaan melintasi banyak file dan Anda ingin aktivitas-aktivitas tersebut saling terhubung. Berikan behavior yang gagal dan konvensi repository, lalu periksa diff yang dihasilkan. Periksa model dan skema penggunaan saat ini, bukan berasumsi subscription lama sudah mencakup akses tak terbatas ke model pihak ketiga.
Misalnya, toggle setting mungkin memerlukan state komponen, route update server, dan preferensi yang tersimpan. Minta Cursor mempertahankan pola fetching dan validasi saat ini, lalu periksa ketiga poin tersebut. Checkbox yang berubah saja tidak cukup. Simpan pengecekan untuk behavior setelah reload agar tugas tidak berhenti pada interaksi yang menarik tapi hilang begitu halaman di-refresh.
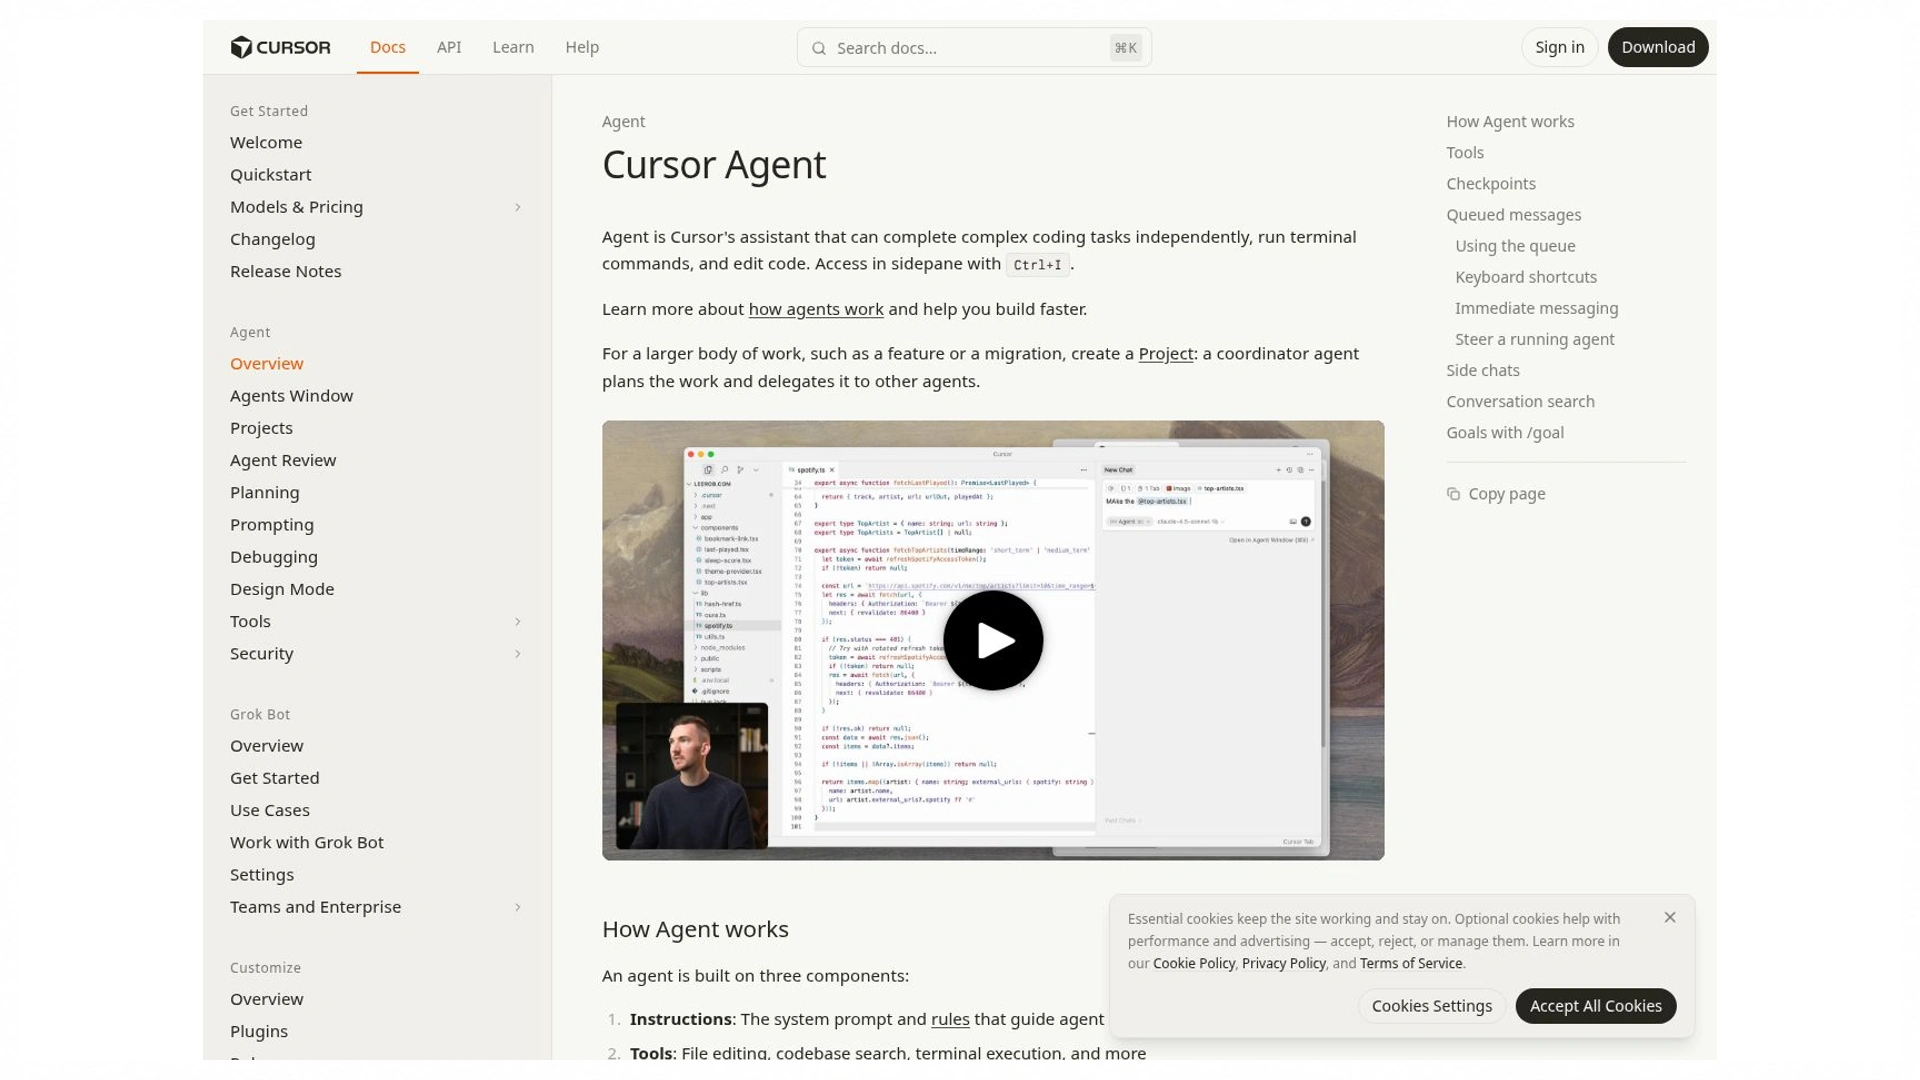
Dokumentasi resmi Cursor
Overview agent ini menjelaskan perencanaan, implementasi, dan kemampuan workflow terkait. Ini adalah tangkapan dokumentasi, bukan hasil coding yang diukur.
Sumber: cursor.com · diambil 25 Oktober 2026
Claude Code untuk Pengembangan Berbasis File dan Command
Claude Code membaca kode, mengedit file, menjalankan command, dan bekerja melalui terminal, IDE, desktop, dan browser. Ini jadi kandidat untuk menyelidiki modul yang belum dikenal atau mengoordinasikan refactor dengan batasan jelas. Minta agent mengidentifikasi dependency dan rencana verifikasi sebelum mengubahnya. Kemampuannya menjalankan command tidak membuktikan bahwa command atau arsitektur yang diusulkan itu tepat.
Tugas berbasis terminal bisa dimulai dari command yang gagal dan reproduksi yang ringkas. Berikan agent environment normal proyek dan minta ia mengidentifikasi penyebabnya sebelum mengusulkan refactor. Tinjau operasi shell dan dependency baru dengan cara yang sama seperti kode. Berhasil menjalankan command test hanya berguna jika assertion yang relevan masih ada dan environment-nya menyerupai environment tempat Anda deploy.
Overview ini menjelaskan surface pengembangan dan workflow berbasis file dan command-nya. Ini tidak menetapkan peringkat performa.
Codex untuk Mendelegasikan Tugas Software yang Terbatas
Codex menggabungkan model coding dengan harness untuk konteks, penggunaan tool, eksekusi, dan batasan review. Aplikasi, CLI, dan ekstensi IDE-nya mendukung cara kerja yang berbeda-beda. Tugas evaluasi yang berguna memiliki hasil yang jelas, file yang relevan, dan pengecekan yang bisa gagal. Bandingkan patch yang sudah selesai dan sisa pekerjaan review, bukan panjang penjelasan agent.
Untuk Codex, buat hasilnya terbatas: perbaiki satu regresi, update kontrak API kecil, atau tambahkan test yang terfokus. Identifikasi file atau service mana yang boleh ia ubah dan behavior mana yang harus tetap kompatibel. Handoff yang berguna mencakup patch, output verifikasi, dan keterbatasan yang belum terselesaikan. Developer tetap yang menentukan apakah implementasinya sesuai dengan arsitektur repository dan proses rilis.
CLI adalah salah satu jalur terdokumentasi untuk tugas coding yang terbatas. Periksa setting eksekusi dan tinjau patch yang dihasilkan.
Google Antigravity untuk Workflow yang Berfokus pada Agent
Antigravity mendokumentasikan workflow pengembangan yang berfokus pada agent di semua surface yang didukungnya. Pertimbangkan tool ini saat Anda ingin mengevaluasi perencanaan, eksekusi, dan review secara bersamaan, lalu periksa setup saat ini, kelayakan akun, dan kuota. Minta ia menyelidiki satu issue yang bisa direproduksi dan periksa artifact serta diff yang dihasilkan. Kemampuan sebuah produk untuk mengoordinasikan beberapa aktivitas tidak membuktikan bahwa ia menyelesaikan tugas spesifik Anda dengan benar atau membutuhkan supervisi yang lebih sedikit.
Panduan getting-started ini menjelaskan setup dan workflow agent. Konfirmasi skema akun saat ini sebelum mencoba.
Replit untuk Memulai dan Mempublikasikan Proyek Berbasis Browser
Replit Agent dapat menghasilkan kode, menyiapkan infrastruktur proyek, dan membantu menguji serta mempublikasikan aplikasi di workspace-nya. Evaluasi tool ini saat setup environment lokal menjadi penghalang. Periksa stack yang benar-benar dihasilkan, persistensi data, dan behavior publikasi. Periksa secara terpisah biaya penggunaan dan kebutuhan operasional; preview yang menarik saja tidak membuktikan aplikasi yang andal.
Untuk prototipe yang di-hosting, buka kembali route yang dipublikasikan di sesi berbeda dan periksa tujuan datanya. Fixture pengembangan, storage preview, dan record produksi bisa berbeda. Simpan redirect autentikasi dan nama variabel environment dalam catatan handoff. Detail-detail ini sering menentukan apakah aplikasi tetap bisa digunakan setelah sesi generasi awal selesai.
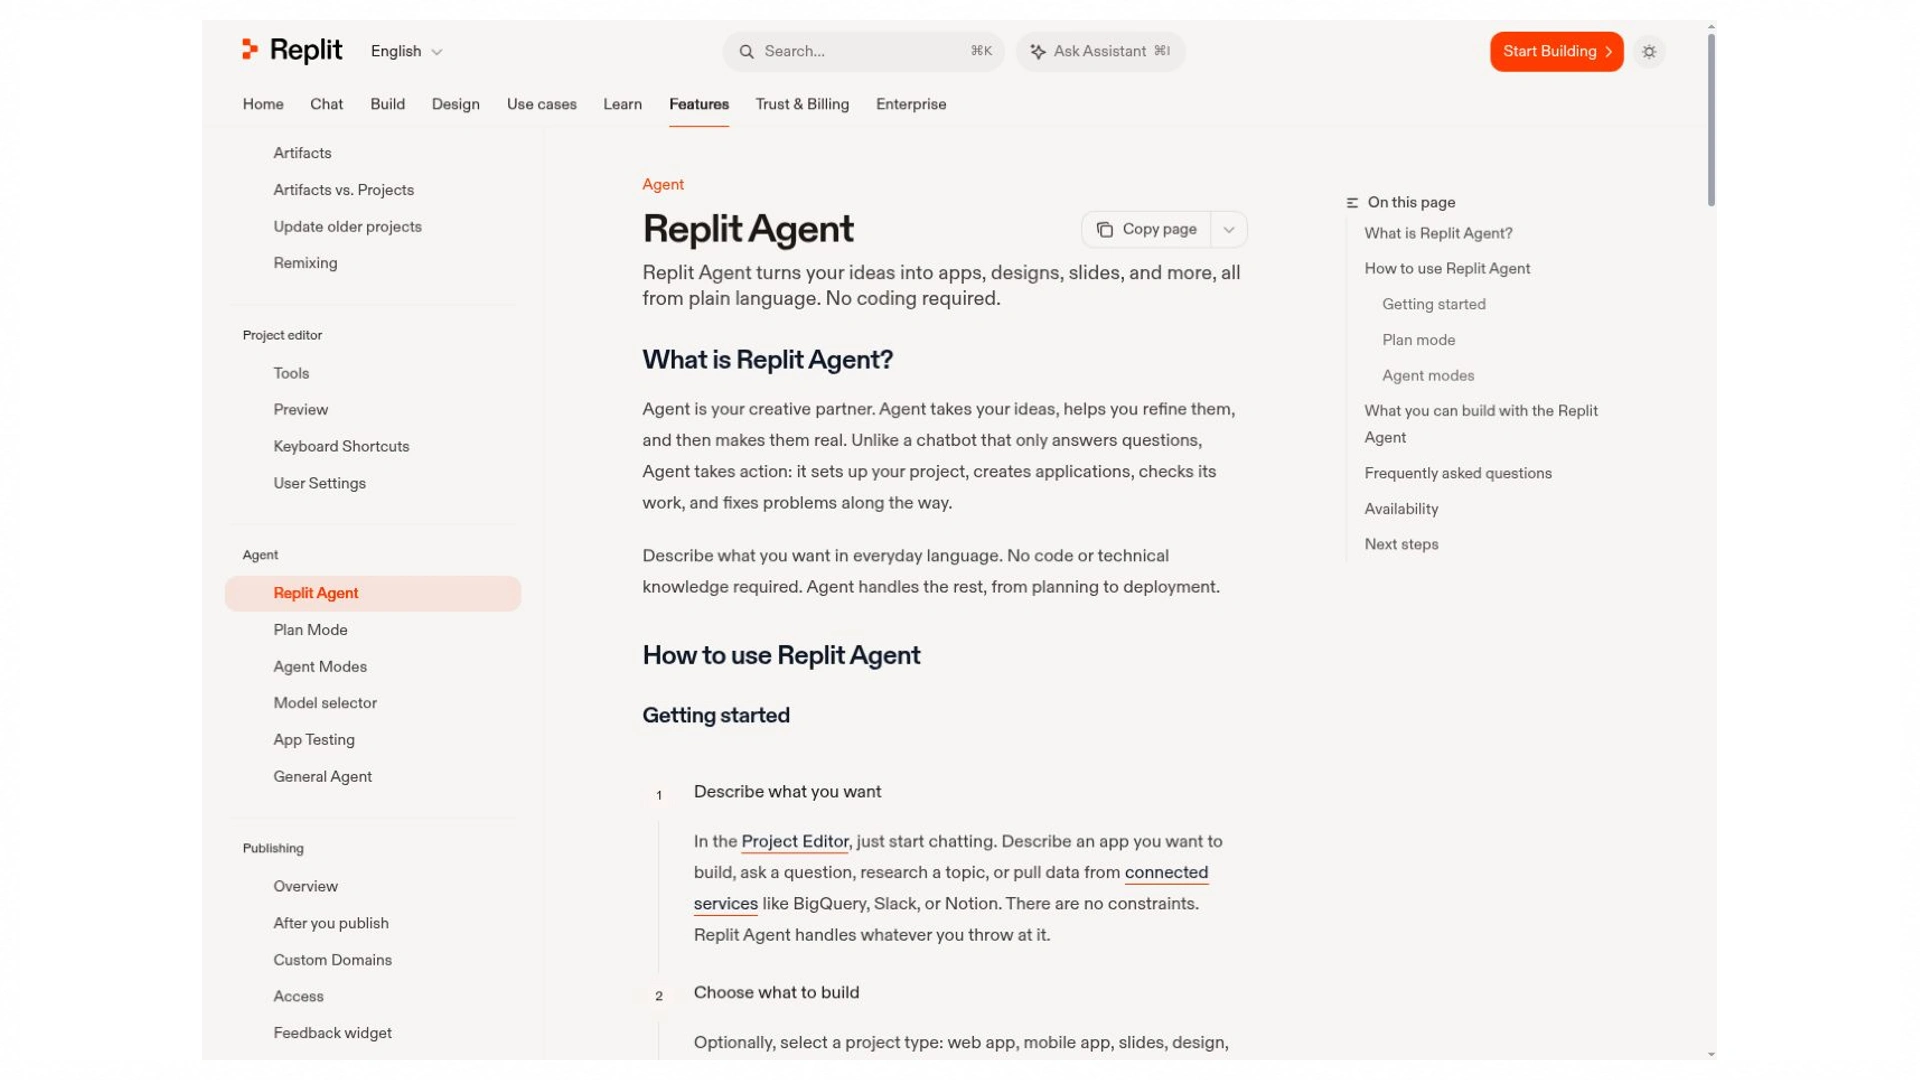
Dokumentasi ini menjelaskan workflow proyek yang di-hosting. Preview, publikasi, dan penggunaan resource memerlukan pengecekan sendiri.
Bandingkan setiap kandidat dengan empat pertanyaan yang sama: Di mana ia berjalan? Apa yang bisa ia periksa? Apa yang bisa ia eksekusi? Bagaimana Anda memverifikasi dan menyimpan pekerjaan tersebut? Contohnya meliputi perbaikan Python lawas, layar setting React, migrasi SQL yang gagal, dan dashboard internal kecil. Contoh-contoh ini menguji kekuatan yang berbeda tanpa memerlukan empat studi kasus terpisah.
Pilih Model AI Terbaik untuk Coding dengan Pengecekan di Level Tugas
Gunakan ID Model Terkini, Bukan Label Produk Lama
Pilih ID model yang muncul di tool dan akun Anda yang sebenarnya. Dokumentasi OpenAI saat ini mengidentifikasi GPT-6.1 Sol sebagai kandidat untuk coding yang kompleks; provider lain juga menawarkan model dengan trade-off reasoning, latensi, dan harga yang berbeda. Ketersediaan di produk chat tidak menjamin ketersediaan melalui coding agent Anda. Catat ID yang dipilih secara tepat, routing otomatis apa pun, dan setting effort. Ini adalah kandidat untuk pilot Anda, bukan hasil dari uji head-to-head yang dilakukan untuk artikel ini.
Model AI terbaik untuk coding bisa berbeda antara transformasi yang sempit dan investigasi repository yang sulit. Coba model default terlebih dahulu, lalu opsi reasoning yang lebih mampu pada kasus-kasus yang gagal ditangani. Simpan input yang sama dan periksa apakah latensi dan biaya ekstra tersebut menghasilkan perbaikan yang diterima. Model yang lebih besar atau lebih mahal tidak otomatis jadi pilihan yang lebih baik untuk setiap tugas yang berulang.
Baca Benchmark Beserta Kondisi Pengujiannya
SWE-bench Verified berisi 500 masalah software yang disaring oleh manusia. Hasilnya menyangkut setting evaluasi tertentu, bukan semua bahasa atau tugas pembuatan aplikasi. Catat varian benchmark, setup agent, versi model, dan tanggal sebelum membandingkan skor. Koleksi coding yang disediakan OpenRouter mengukur penggunaan token terbaru di layanannya; popularitas penggunaan bukanlah benchmark kebenaran.
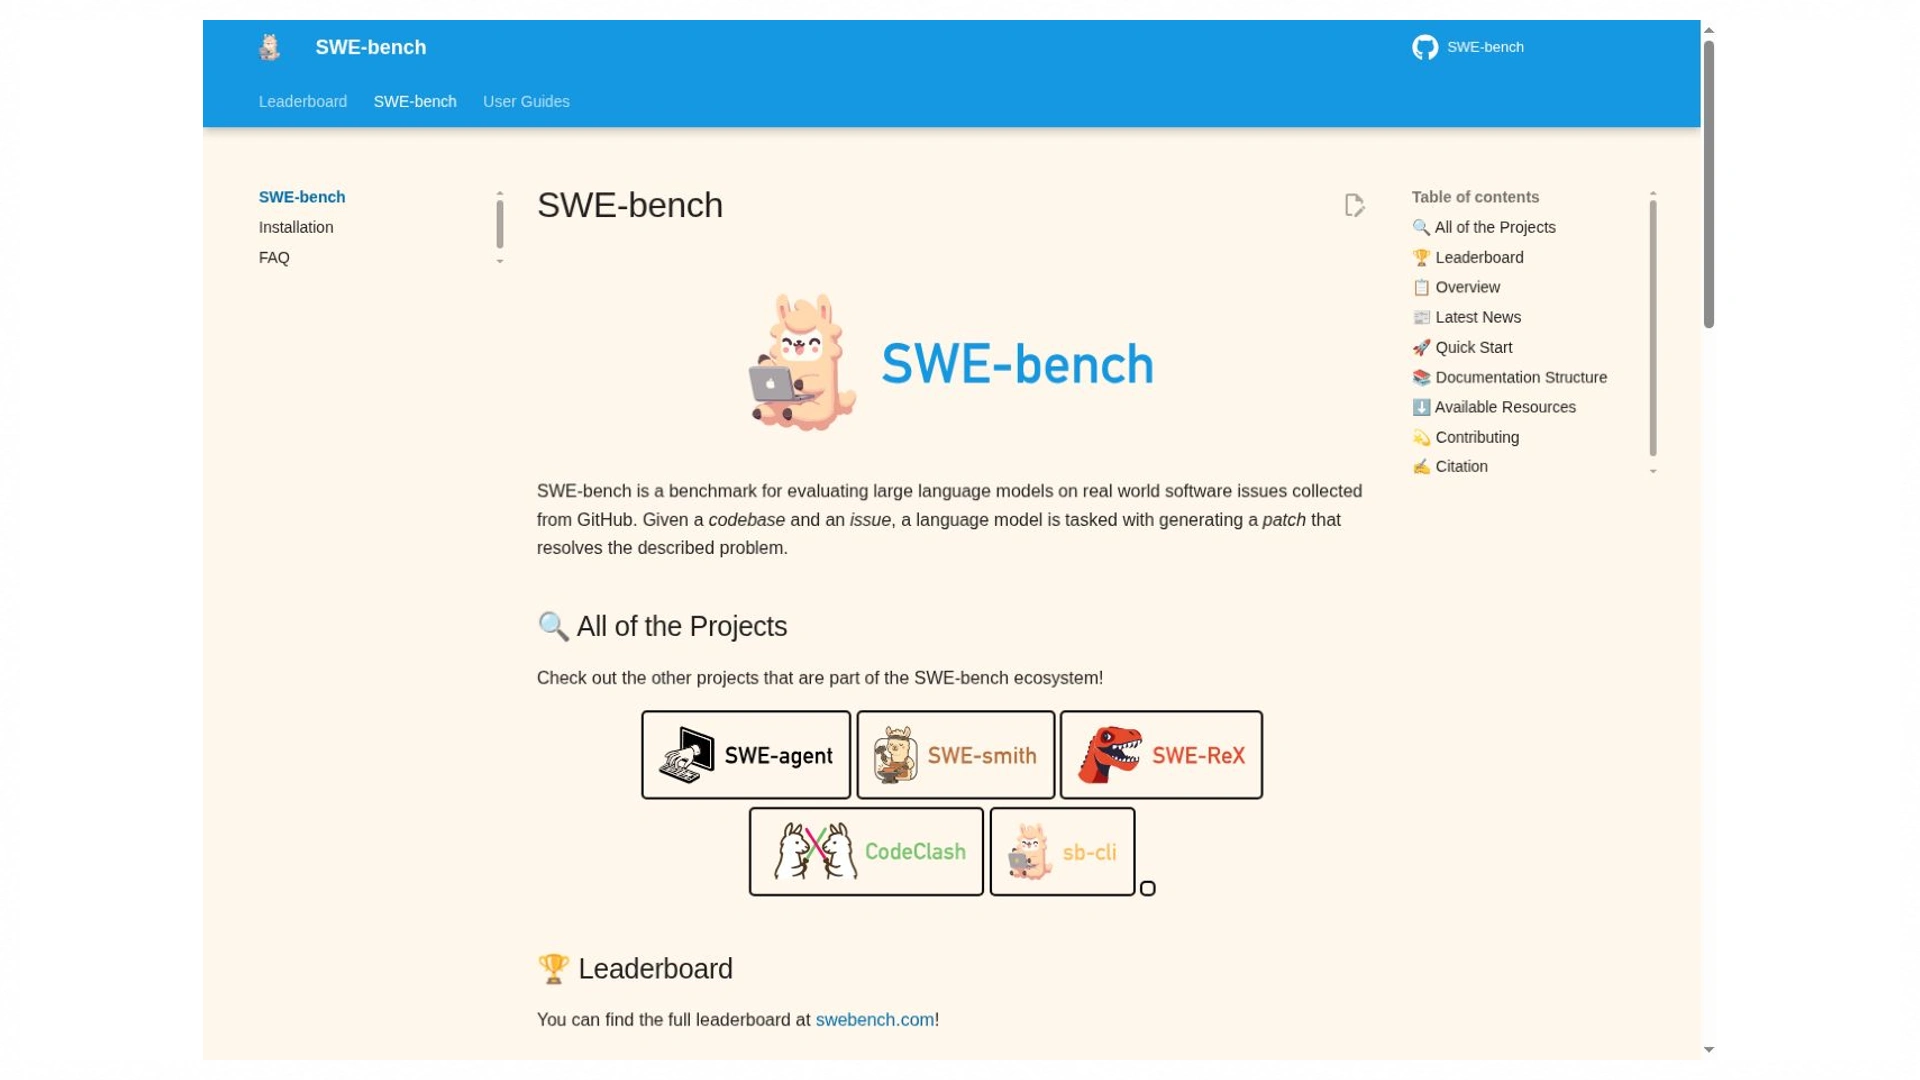
Halaman resmi proyek SWE-bench
Varian benchmark dan kondisi evaluasi itu penting. Skor yang dipublikasikan tidak menggantikan tugas di repository Anda sendiri.
Sumber: www.swebench.com · diambil 25 Oktober 2026
Temukan AI Terbaik untuk Coding Gratis Tanpa Biaya Subscription
Pisahkan Paket Gratis dari Penggunaan Agent yang Disertakan
Halaman resmi saat ini menjelaskan akses gratis terbatas untuk produk seperti GitHub Copilot dan Cursor. Ketersediaan dan batasan Antigravity juga bergantung pada skema akun yang terdokumentasi. Periksa fitur yang akan Anda gunakan: completion inline, chat, aksi agent, dan eksekusi yang di-hosting bisa memiliki kuota yang berbeda-beda. Interface tool gratis tetap bisa memanggil provider berbayar di baliknya. Beri tanggal pada pengecekan dan periksa sisa penggunaan setelah satu tugas selesai, bukan berasumsi kuota bulanan lama masih berlaku.
Pencarian AI terbaik untuk coding gratis paling berguna saat Anda mendefinisikan seluruh workflow gratis tersebut. Masukkan editor, pemanggilan model, environment eksekusi, dan resource yang di-hosting apa pun. Model lokal bisa menghilangkan tagihan provider tetapi tetap memerlukan hardware yang mumpuni dan setup yang tepat. Buat uji coba pertama cukup kecil agar bisa diselesaikan dalam kuota saat ini, lalu periksa berapa biaya penggunaan berkelanjutan atau publikasi.
Masukkan Waktu Review, Percobaan Ulang, Hosting, dan Biaya API
Perhitungan yang berguna adalah biaya per tugas yang diterima = biaya tool dan penggunaan yang dapat diatribusikan dibagi tugas yang diterima, dengan waktu review dilacak secara terpisah. Sebagai ilustrasi, $12 biaya yang dapat diatribusikan untuk empat tugas yang diterima adalah $3 per tugas. Hitungan itu bersifat hipotetis. Masukkan percobaan yang gagal ke dalam biaya dan definisikan "diterima" sebelum pengujian agar fitur yang terlihat selesai secara visual tetapi sebenarnya rusak tidak terhitung.
Nilai Produktivitas dengan Bukti, Bukan Volume Output
Gunakan Statistik Riset Sesuai Lingkup Aslinya
Dalam survei 2025 Stack Overflow, 46% responden untuk pertanyaan tersebut tidak percaya pada akurasi AI tool dan 33% mempercayainya. Ini mengukur tingkat kepercayaan yang dilaporkan, bukan defect kode. Ini mendukung pertanyaan praktis untuk pilot Anda: berapa banyak verifikasi dan koreksi yang dibutuhkan output tersebut sebelum Anda bisa menggunakannya?
Eksperimen METR awal 2025 melibatkan 16 developer berpengalaman dan 246 tugas, dan menemukan bahwa tugas-tugas tersebut memerlukan waktu 19% lebih lama dengan tool yang diteliti. Update Februari 2026-nya melaporkan masalah seleksi dan pengukuran yang membuat eksperimen lanjutan tersebut tidak dapat diandalkan untuk mengestimasi efek saat ini. Tidak satu pun dari temuan ini menetapkan penalti atau keuntungan kecepatan yang universal untuk tool masa kini.
Catat Kebenaran, Pekerjaan Review, dan Waktu Hingga Perubahan Diterima
Untuk mengidentifikasi AI terbaik untuk coding di proyek Anda, catat commit awal, prompt, model, plan, waktu yang berlalu, waktu review aktif, biaya, dan defect yang tersisa. Jalankan setiap kandidat dari copy yang bersih. Ulangi tugas-tugas yang representatif bila memungkinkan dan catat kegagalannya. Pilot singkat bisa mengarahkan keputusan pembelian, tetapi tidak bisa membenarkan persentase akurasi universal atau klaim bahwa satu produk selalu tercepat.
Gunakan pengecekan wajib-lolos sebelum skor kenyamanan. Endpoint yang membocorkan record pengguna lain tetap gagal meskipun patch-nya kecil dan penjelasannya bagus. Setelah kebenaran, bandingkan menit review aktif, interupsi, dan beban maintenance. Simpan catatan dari run yang tidak berhasil, bukan hanya melaporkan percobaan terbaik. Ini membuat pilot kecil lebih informatif tanpa berpretensi mewakili setiap repository atau developer.
Tentukan AI Mana yang Terbaik untuk Coding Sesuai Situasi Anda
Sesuaikan Contoh dengan Pekerjaan yang Perlu Anda Selesaikan
Belajar sebuah fungsi: minta penjelasan, prediksi outputnya, lalu modifikasi tanpa bantuan.
Memperbaiki bug: berikan reproduksi dan hasil yang diharapkan; simpan pengecekan yang gagal sebagai cakupan regresi.
Mengubah beberapa modul: minta penelusuran dependency dan patch kecil sebelum penulisan ulang yang luas.
Membangun prototipe: verifikasi alur aksi pelanggan yang lengkap, tujuan data, dan aturan akses.
Bekerja pada kode proprietary: periksa penanganan data dan kontrol organisasi dari plan yang berlaku sebelum memberikan akses repository.
Ini membuat AI terbaik untuk coding jadi keputusan yang bisa Anda jelaskan: kandidat tersebut memenuhi batasan Anda dan membutuhkan pekerjaan review yang bisa diterima pada tugas-tugas representatif. Simpan bukti dan jalur handoff yang layak saat proyek bertumbuh.
Saat memutuskan AI mana yang terbaik untuk coding, masukkan jalur recovery tim Anda. Bisakah developer lain menjalankan proyek, memeriksa diff, dan melanjutkan tanpa chat asli tersebut? Simpan keputusan arsitektur, pengecekan, dan setup di repository. Untuk AI terbaik untuk vibe coding, pertanyaan yang sama ini penting setelah prototipe mulai menyimpan record yang sebenarnya: kemudahan generasi seharusnya mengarah pada aplikasi yang Anda bisa pahami dan rawat.
Evaluasi Enter Pro dengan Membangun Pelacak Isu Privat
Bagi pembaca yang mengevaluasi AI terbaik untuk vibe coding, FixTrack memberikan satu contoh konkret pembuatan aplikasi di Enter Pro. Plan-nya mendefinisikan isu yang dimiliki pengguna dan perubahan statusnya, sementara preview yang disediakan menunjukkan satu isu fiktif berpriotas tinggi dengan status Open. Ini memberi Anda interface yang bisa diperiksa dan sekumpulan kecil pengecekan acceptance. Gambar-gambarnya tidak menunjukkan pengujian akun kedua, record backend yang tertangkap, atau isu yang berhasil berpindah ke status Resolved.
Langkah 1: Rencanakan Pelacak Isu dan Pengecekan Acceptance-nya
Rilis pertama yang direncanakan memiliki daftar isu privat, form pembuatan, tampilan detail, dan filter status. Field-nya adalah title, description, priority, dan status: Open, In Progress, atau Resolved. Definisikan keberhasilan sebelum generasi: isu yang valid tetap ada setelah refresh, update yang sah tetap tersimpan, dan akun lain tidak bisa membaca atau mengubahnya. Simpan undangan tim dan integrasi di luar tugas pertama ini agar interface yang terlihat lengkap tidak menutupi batas data dasarnya.
Prompt yang bisa disalin — Rencanakan pelacak isu FixTrack fiktif. Pengguna yang sudah login bisa membuat, membaca, dan mengupdate hanya isu mereka sendiri. Gunakan title, description, priority Low/Medium/High, dan status Open/In Progress/Resolved. Definisikan route, schema, authorization, dan test acceptance. Tetap di Plan Mode sampai plan disetujui; jangan mengarang review atau hasil.
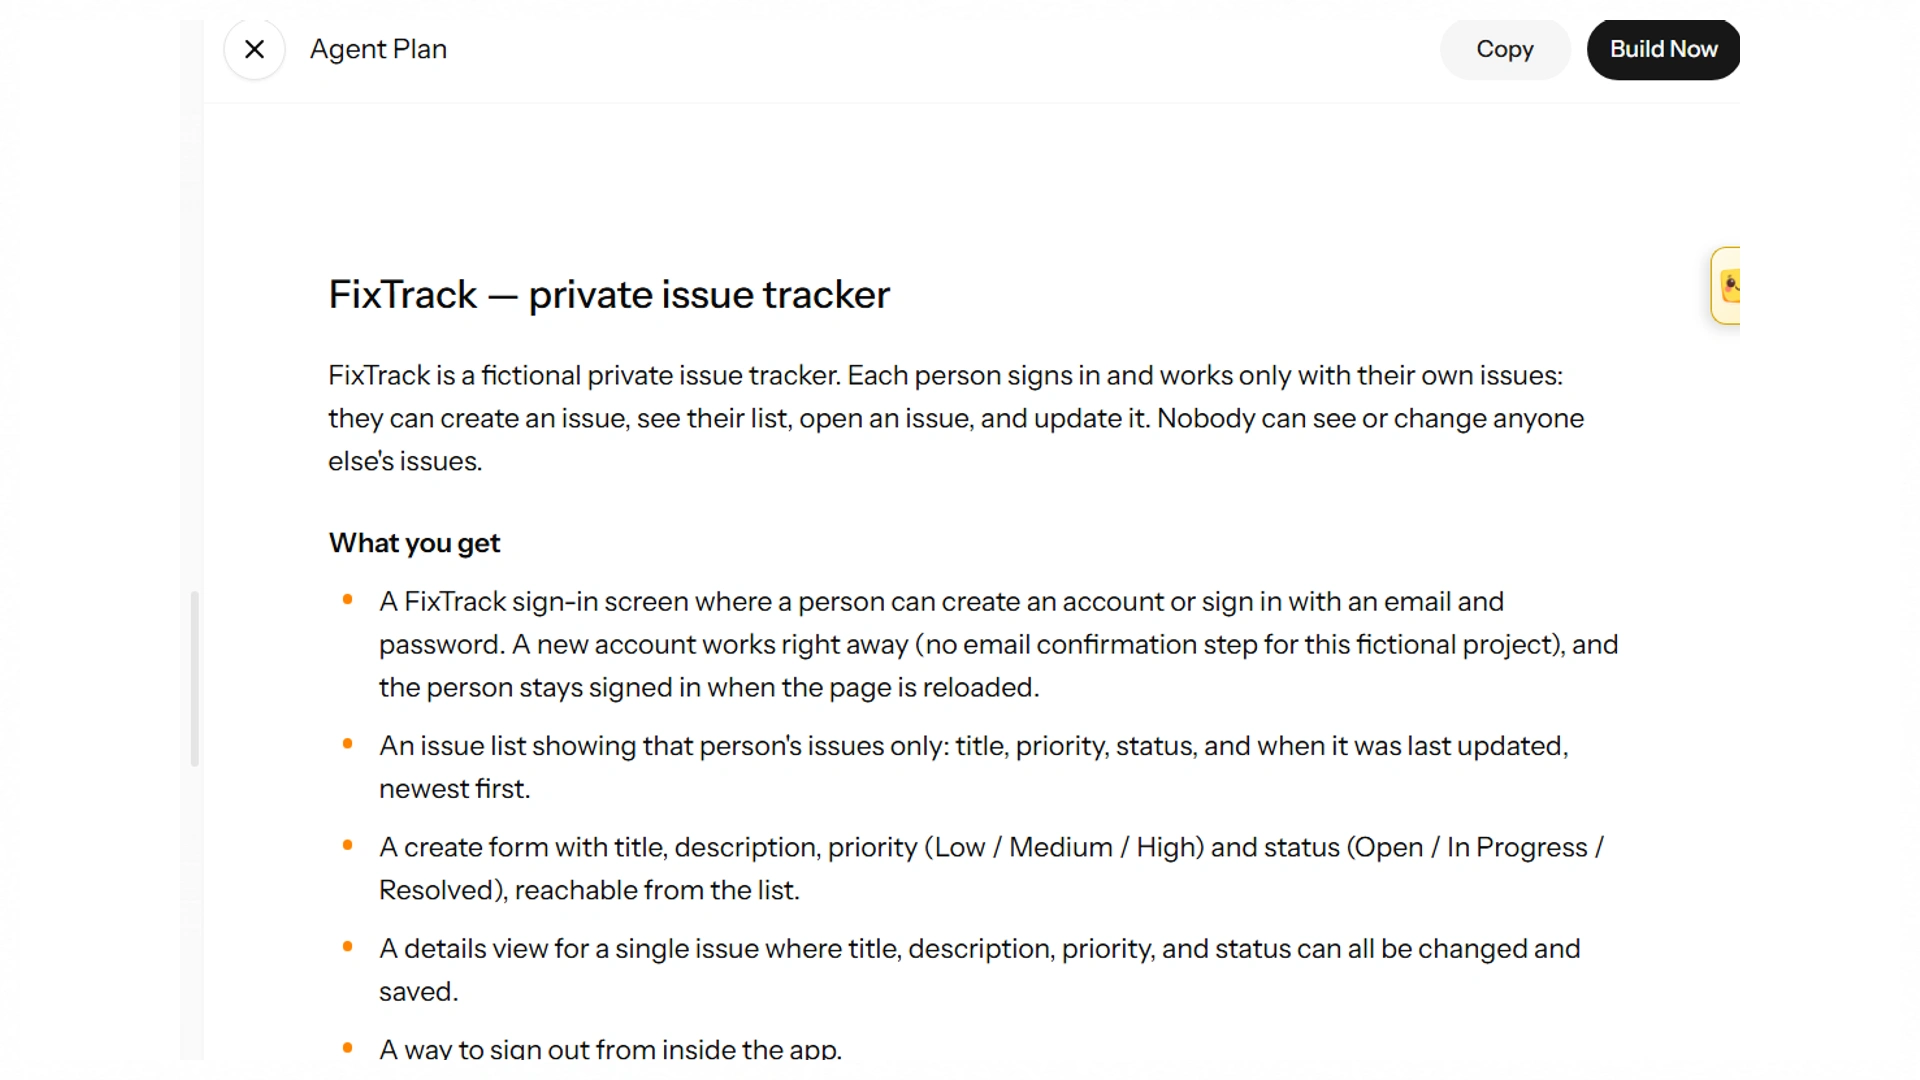
Plan ini mendefinisikan isu yang dimiliki pengguna dan pengecekan acceptance. Ini adalah spesifikasi untuk verifikasi selanjutnya.
Langkah 2: Bangun Interface dan Terapkan Kepemilikan Record
Preview yang tertangkap berisi Checkout error on mobile, ditandai priority High, Open, dan Fictional demo data. Counter menunjukkan All 1, Open 1, In Progress 0, dan Resolved 0. Ini jadi fixture awal yang berguna karena jumlah yang diharapkan mudah diperiksa. Deskripsinya menyatakan bahwa laporan tersebut dibuat-buat dan tidak melibatkan pelanggan nyata. Periksa daftar kosong dan error form pembuatan sebagai state yang terpisah; gambar yang disediakan hanya menetapkan isu yang terlihat, bukan setiap route dalam plan.
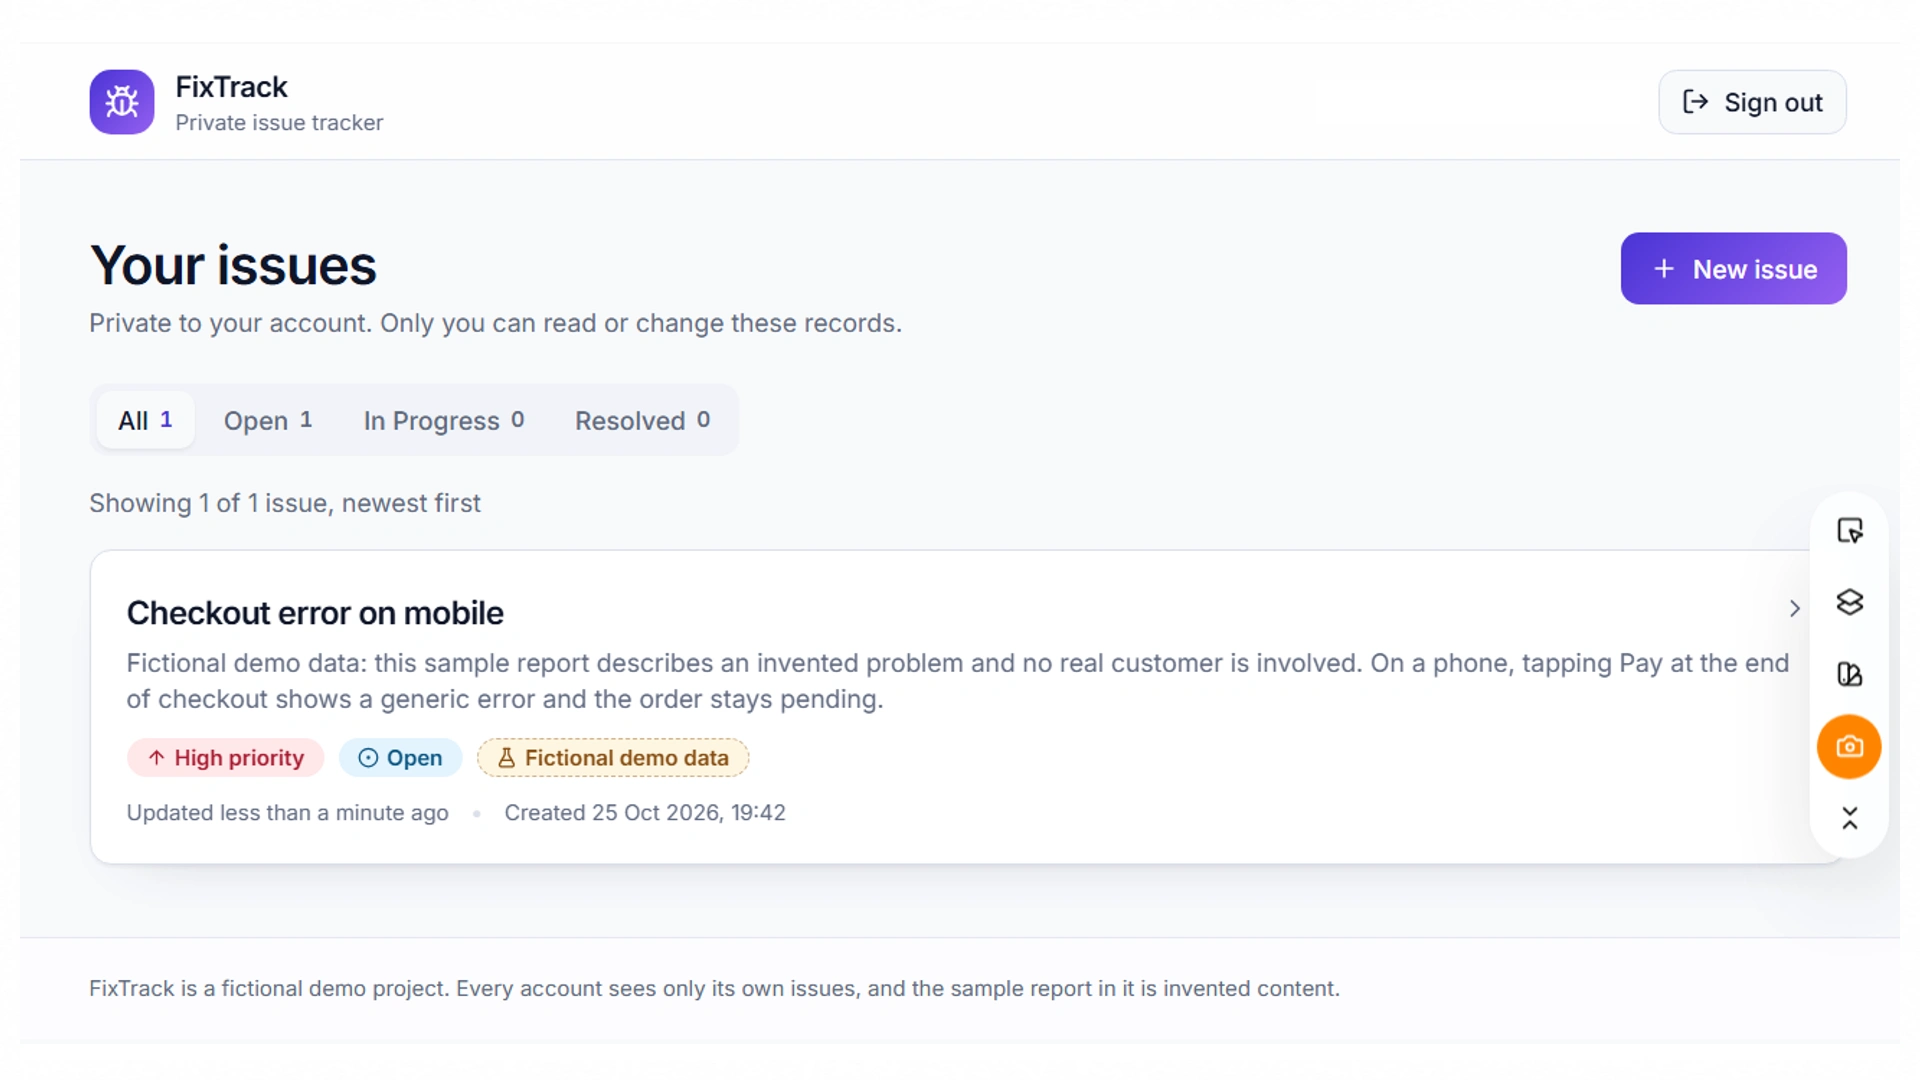
FixTrack di Enter Pro — daftar isu
Checkout error on mobile ditandai priority High, Open, dan Fictional demo data. Jumlahnya adalah All 1, Open 1, In Progress 0, Resolved 0.
Tabel isu memerlukan identifier pemilik yang ditetapkan oleh server dan timestamp, dengan aturan backend yang membatasi pembacaan dan update. Turunkan pemilik dari sesi yang terautentikasi, bukan mempercayai owner_id yang dikirim dari browser. Validasi priority dan status sesuai nilai yang diizinkan. Preview menyatakan record bersifat privat untuk akun Anda, tetapi notifikasi ini adalah janji di level interface. Request langsung yang tidak sah dan nilai kepemilikan yang tersimpan adalah bukti yang diperlukan untuk memverifikasinya.
Langkah 3: Periksa Satu Penyempurnaan yang Terbatas
Daftar yang terlihat sudah mencakup filter All, Open, In Progress, dan Resolved. Gunakan permintaan penyempurnaan yang terbatas untuk memverifikasi behavior-nya, bukan mengklaim bahwa screenshot menunjukkan filter yang baru ditambahkan. Setelah membuat isu kedua dengan pemilik yang sama dalam status berbeda, setiap filter seharusnya mengembalikan subset yang diharapkan dan All seharusnya mengembalikan kedua record. Pertahankan jalur create/update dan authorization pemilik. Jika jumlahnya salah, laporkan input sebenarnya dan ketidaksesuaian yang teramati, bukan meminta desain ulang yang luas.
Prompt penyempurnaan yang bisa disalin — Periksa filter All/Open/In Progress/Resolved yang sudah ada terhadap dua isu demo dengan pemilik sama dalam status berbeda. Pertahankan authorization, validasi, dan behavior create/update. Jelaskan file yang diubah jika perbaikan diperlukan. Verifikasi bahwa filter tidak kehilangan record maupun mengekspos data pengguna lain, dan bedakan command yang Anda jalankan dari pengecekan yang tidak bisa Anda eksekusi.
Langkah 4: Verifikasi State Kegagalan dan Catat Handoff
Uji title yang kosong, status yang tidak didukung, submission yang berulang, dan kegagalan penyimpanan yang terkontrol. Tentukan behavior retry yang diharapkan, lalu periksa secara sengaja. Login sebagai pengguna test kedua dan minta isu pengguna pertama secara langsung; ulangi saat logout. Periksa update yang tidak sah selain pembacaan. Tidak ada screenshot yang disediakan mencatat hasil backend ini, jadi simpan sebagai pengecekan acceptance yang belum selesai hingga respons dan state yang tersimpan dapat diperiksa.
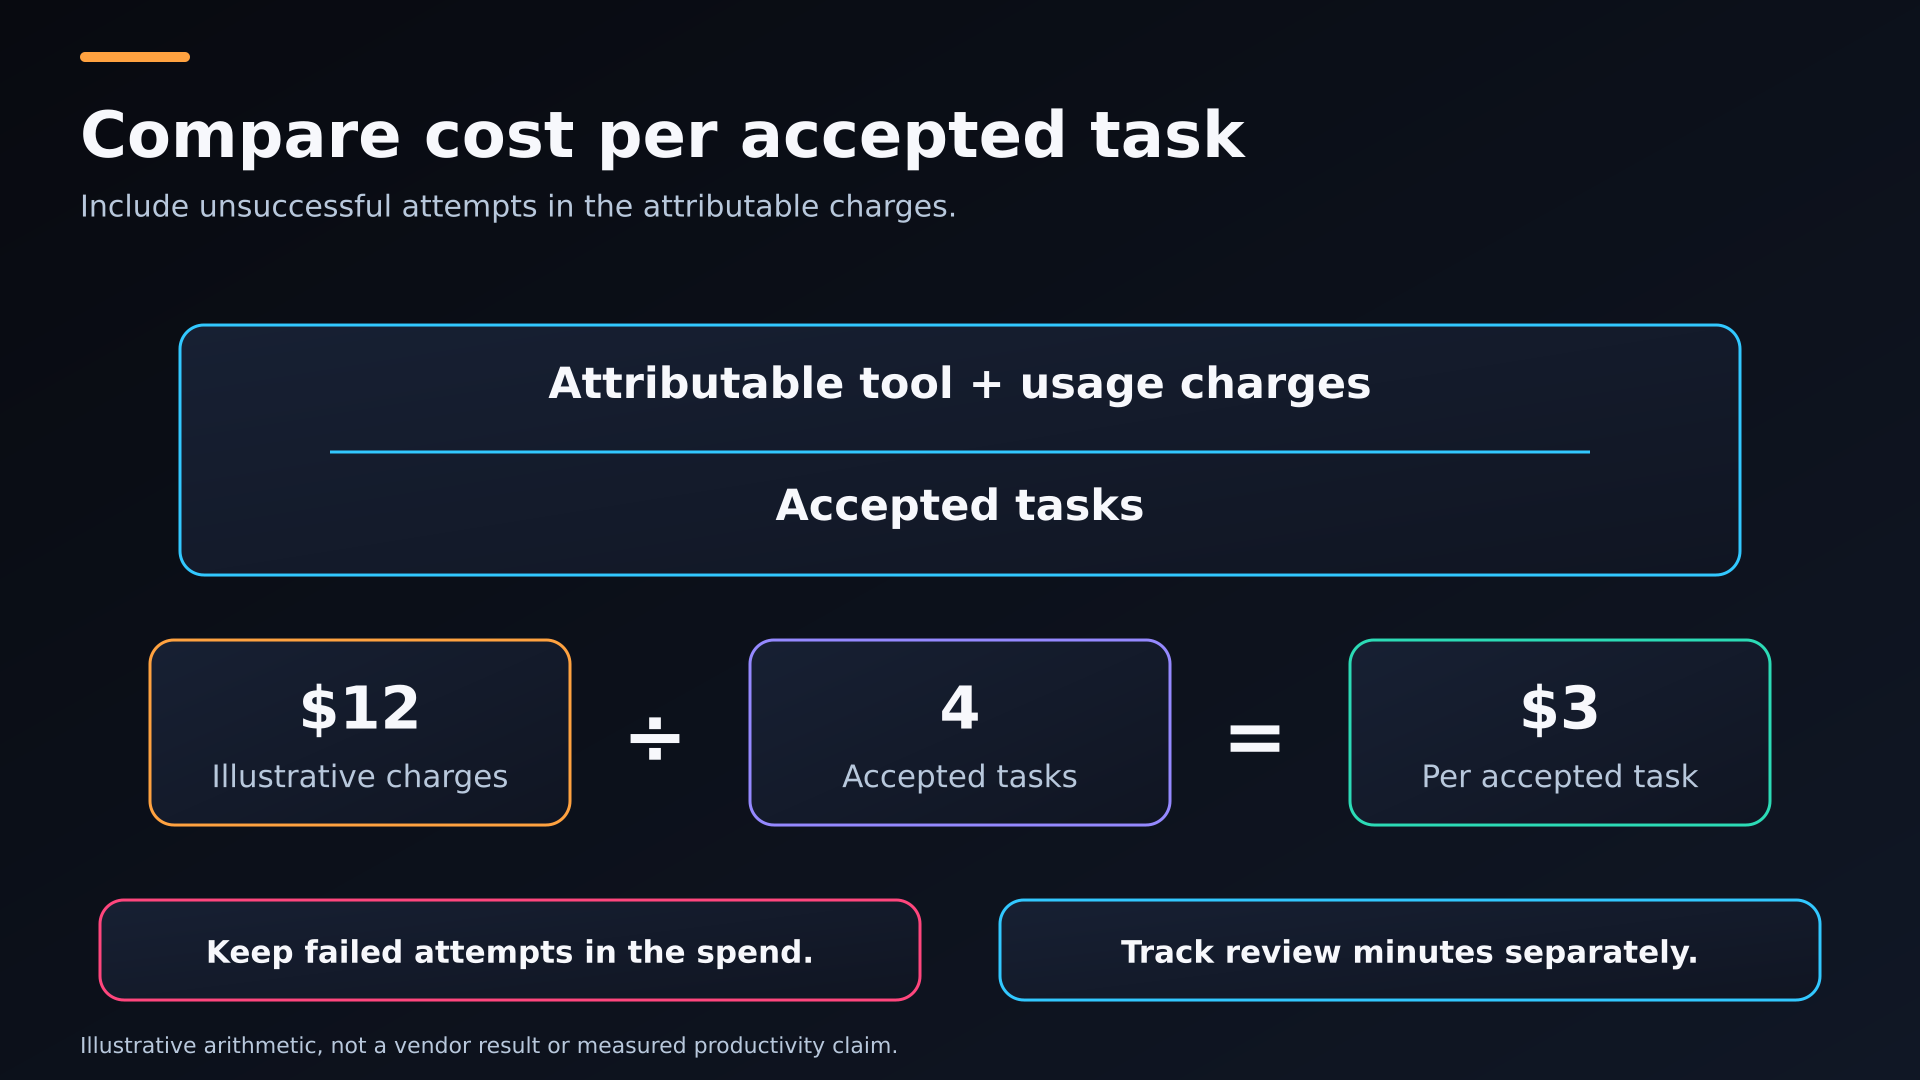
Bandingkan biaya per tugas yang diterima: Formula biaya per tugas yang diterima dan contoh hipotetis artikel ini: $12 dibagi empat.
Hasil yang terlihat adalah plan pelacak isu yang dihasilkan dan satu isu demo Open dengan jumlah filter yang sesuai. Catat persistensi, perubahan status, dan hasil lintas akun saat Anda menjalankannya, beserta waktu yang berlalu, waktu review aktif, dan biaya yang dapat diatribusikan. Simpan sumber, kebutuhan setup, dan defect yang belum selesai untuk handoff ke developer. Proyek kecil ini bisa menetapkan apakah workflow-nya cocok untuk prototipe Anda; ini tidak bisa membuktikan bahwa Enter Pro mengungguli setiap coding agent atau mendukung setiap framework yang ada.
Buat Keputusan Akhir dengan Pilot Kecil yang Bisa Diulang
AI terbaik untuk coding adalah kecocokan praktis antara tugas, environment, budget, dan kemampuan Anda memverifikasi hasilnya. Seleksi dua kandidat, gunakan brief yang sama, dan bandingkan perubahan yang diterima, bukan baris kode yang dihasilkan. Mulai dengan pilot kecil di Enter Pro, simpan source dan pengecekan Anda, lalu perluas penggunaan saat bukti mendukungnya.
FAQ tentang AI Terbaik untuk Coding
Bisakah Coding Assistant Bekerja Tanpa Akses ke Seluruh Repository Saya?
Seringkali, Anda bisa membatasi konteks hanya ke package atau file yang relevan untuk tugas yang sempit, tergantung kemampuan dan setting tool tersebut. Ini bisa mengurangi materi yang tidak relevan dan eksposur yang tidak perlu. Perubahan yang mencakup tipe yang dibagikan atau autentikasi mungkin memerlukan jalur dependency yang lebih luas. Tanyakan pada tool apa yang dibutuhkannya dan verifikasi file yang dirujuk daripada memberikan seluruh repository secara default.
Haruskah Saya Membayar untuk Coding Tool dan Subscription Model Terpisah?
Hanya jika kombinasi tersebut menyelesaikan kebutuhan akses atau workflow yang nyata. Subscription editor, akun API, dan subscription chat konsumer bisa mencakup produk dan jalur billing yang berbeda. Periksa akun mana yang benar-benar digunakan sesi coding tersebut. Bandingkan biaya gabungan dengan tugas yang diterima dan effort review; jangan berasumsi membayar dua kali berarti call yang sama tercakup dua kali atau penggunaannya tidak terbatas.
Bisakah Model Lokal Menggantikan Coding Assistant yang Di-hosting?
Model lokal yang sesuai bisa mendukung beberapa tugas coding, tetapi kapasitas hardware, penanganan konteks, penggunaan tool, dan performa bahasa itu penting. Runtime lokal juga perlu diintegrasikan dengan editor atau agent Anda. Evaluasi dengan tugas dan pengecekan acceptance yang sama seperti jalur yang di-hosting. Inferensi lokal bisa mengubah aliran data dan biaya provider tanpa otomatis meningkatkan kebenaran atau mengurangi effort total.
Apakah Skor Benchmark yang Lebih Tinggi Menjamin Hasil yang Lebih Baik dalam Bahasa Saya?
Tidak. Benchmark mengukur sekumpulan tugas tertentu dalam setup tertentu. Periksa bahasa, tipe repository, test harness, versi model, dan tools agent. Aplikasi Anda mungkin membutuhkan framework yang berbeda, pengeditan interaktif, atau layanan eksternal yang tidak tersedia. Skor tinggi adalah alasan untuk menyelidiki kandidat tersebut, bukan pengganti tugas representatif di environment Anda sendiri.
Seberapa Sering Saya Harus Mengevaluasi Ulang Setup AI Coding Saya?
Evaluasi ulang saat model, harga, kebijakan penggunaan, repository, atau campuran tugas berubah cukup signifikan untuk memengaruhi pekerjaan Anda. Simpan satu brief evaluasi singkat dan pengecekannya agar perbandingan berikutnya bisa diulang. Model AI terbaik untuk coding di tim Anda bisa berubah seiring proyek beralih dari scaffolding ke maintenance; berganti-ganti terus tanpa bukti juga menghabiskan waktu.
Bisakah Saya Menggunakan Kode yang Dihasilkan AI dalam Proyek Komersial?
Penggunaan komersial bergantung pada ketentuan produk yang berlaku dan lisensi dependency serta source material dalam proyek tersebut. Tinjau package yang belum dikenal, simpan notice yang diperlukan, dan dokumentasikan pertanyaan provenance yang belum terjawab untuk handoff ke klien. Pengecekan ini terpisah dari apakah kode yang dihasilkan itu bekerja atau tidak. Patch yang bisa digunakan secara komersial tetap mungkin memerlukan review keamanan, kompatibilitas, dan maintainability.
Bisakah Saya Melanjutkan Proyek Enter Pro di GitHub?
Enter Pro mendokumentasikan integrasi GitHub untuk sinkronisasi source code dan kolaborasi developer. Konfirmasi repository dan branch yang terhubung, lalu tinjau source code dan instruksi setup sebelum melanjutkan. Gambar FixTrack yang disediakan tidak menunjukkan handoff tersebut selesai. Setting database yang di-hosting, secrets, dan migrasi bisa memerlukan transfer atau konfigurasi tambahan di luar repository kode.
Apakah Enter Pro Mendukung Semua Repository dan Framework yang Ada?
Jangan berasumsi kompatibilitas universal dengan semua repository atau framework. Periksa jalur proyek yang terdokumentasi dan periksa stack yang dihasilkan serta kebutuhan integrasinya. FixTrack mendemonstrasikan satu workflow aplikasi, bukan dukungan untuk semua service lawas. Untuk proyek yang sudah ada, verifikasi kompatibilitas dan lakukan uji coba kecil sebelum mengaitkan repository utama atau merencanakan migrasi di sekitar tool tersebut.