
Ulasan GLM-5: Versi, Benchmark, Harga, dan Cara Akses
Bandingkan versi GLM-5, benchmark, harga, arsitektur, deployment lokal, akses API, dan integrasi Enter Pro untuk memilih model yang tepat.
GLM-5 bukan lagi model tunggal yang bisa dinilai dari satu benchmark saja. Ini adalah keluarga model yang gerak cepat: sebagian varian khusus teks, sebagian lagi menerima input gambar, versi terbaru punya jendela konteks hingga 1 juta token, dan opsi paling murah harganya hanya sepersekian dari varian andalannya.
Sebelum memperbarui ulasan ini, saya sudah menelaah catatan rilis Z.ai, model card, dokumentasi API, repositori, dan tangkapan layar produk langsung. Ini penting karena beberapa klaim yang diajukan cukup menggiurkan — seperti peningkatan coding internal 50% atau efisiensi komputasi konteks panjang 2,9× lebih rendah — dan semuanya berasal dari Z.ai, bukan dari audit independen. Saya menyebutnya sebagai klaim, bukan hasil pengujian saya sendiri.
Saat memilih model GLM-5, ada 4 pertanyaan yang perlu dipikirkan: Apa jenis input yang Anda punya? Seberapa sulit tugasnya? Di mana inferensi harus dijalankan? Berapa biaya untuk satu hasil sukses jika ada percobaan ulang? Jawaban cepat saya: GLM-5.3 untuk teks/coding yang lebih kompleks, GLM-5.3-Flash jika Anda butuh multimodal/hemat biaya, dan GLM-5.2 jika Anda sudah punya integrasi yang teruji.
Apa Itu GLM-5?
Keluarga model open-weight yang dikembangkan Z.ai untuk software engineering, penggunaan tool, dan agen jangka panjang disebut GLM-5. Rilis awal (Februari 2026) adalah model Mixture-of-Experts (MoE) dengan input dan output teks, memiliki 744 miliar total parameter, sekitar 40 miliar parameter aktif per token, dan jendela konteks 200.000 token. Spesifikasi ini berasal dari laporan teknis GLM-5 dan repositori GitHub resminya.
Model MoE tidak mengaktifkan seluruh jaringan untuk setiap token. Sebuah router mengirim tiap token ke sekelompok kecil expert, sehingga komputasi aktif berkurang namun checkpoint-nya tetap sangat besar. Ini tidak menjadikan GLM-5 model yang bisa dijalankan di laptop: seluruh weight tetap butuh penyimpanan, routing, dan hardware level server.
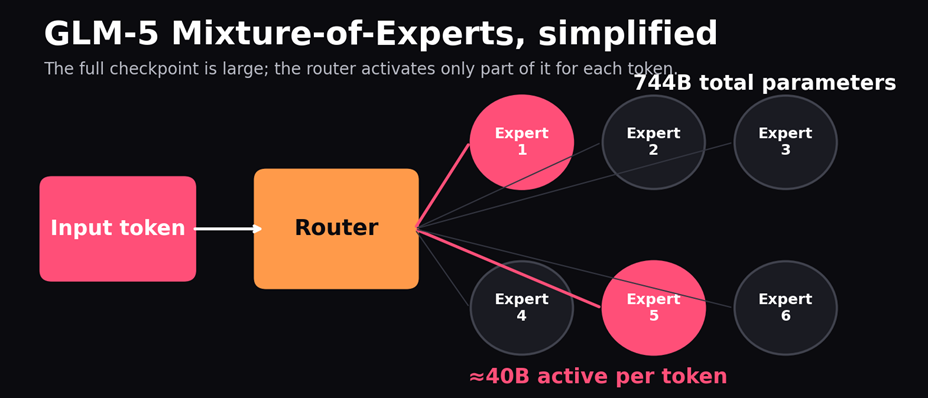
Gambar 1. GLM-5 mengaktifkan sekitar 40 miliar dari 744 miliar parameter per token; checkpoint lengkapnya tetap deployment skala server.
Istilah yang tepat adalah "open weights" (bobot terbuka). Ada ketentuan berbeda untuk kode, bobot model, layanan hosting, dan data pelatihan. Periksa lisensi yang menyertai model card yang akan Anda gunakan sebelum melakukan penggunaan komersial, karena tidak semua versi GLM memiliki hak yang sama.
Keluarga Versi GLM-5
Nama keluarga ini menyembunyikan perbedaan penting. Pilih berdasarkan modalitas, konteks, riwayat validasi, dan jalur deployment — jangan menganggap semua rilis 5.x bisa saling gantikan.
| Versi | Input/Konteks | Alasan Terbaik Menggunakannya | Catatan Penting |
|---|---|---|---|
| GLM-5 | Teks / 200K | Riset awal atau integrasi lama | Rilis keluarga pertama; bukan default saya untuk proyek baru |
| GLM-5-Turbo | Teks / 200K | Kerja agen yang hosted dan berat alat | Jalur penyedia, bukan checkpoint kecil yang bisa diunduh |
| GLM-5V-Turbo | Teks, gambar, video, file / 200K | Coding visual dan tugas GUI | Pastikan format yang diterima di endpoint Anda |
| GLM-5.1 | Teks / 200K | Proses engineering berkelanjutan | Sudah digantikan untuk kebanyakan evaluasi baru |
| GLM-5.2 | Teks / 1M | Konteks panjang dan integrasi teruji | Migrasi ke 5.3 mengubah perilaku penalaran |
| GLM-5.3 | Teks / 1M | Coding sulit dan agen jangka panjang | Penalaran selalu aktif; output bisa panjang |
| GLM-5.3-Flash | Multimodal / 1M | Screenshot, volume tinggi, biaya rendah | Arsitektur 320B/18B terpisah, bukan "5.3 versi hemat" |
Sumber: catatan rilis Z.ai, panduan GLM-5-Turbo, panduan GLM-5V-Turbo, dan panduan GLM-5.1. Sebuah host bisa menampilkan jendela konteks lebih kecil dari yang didukung model.
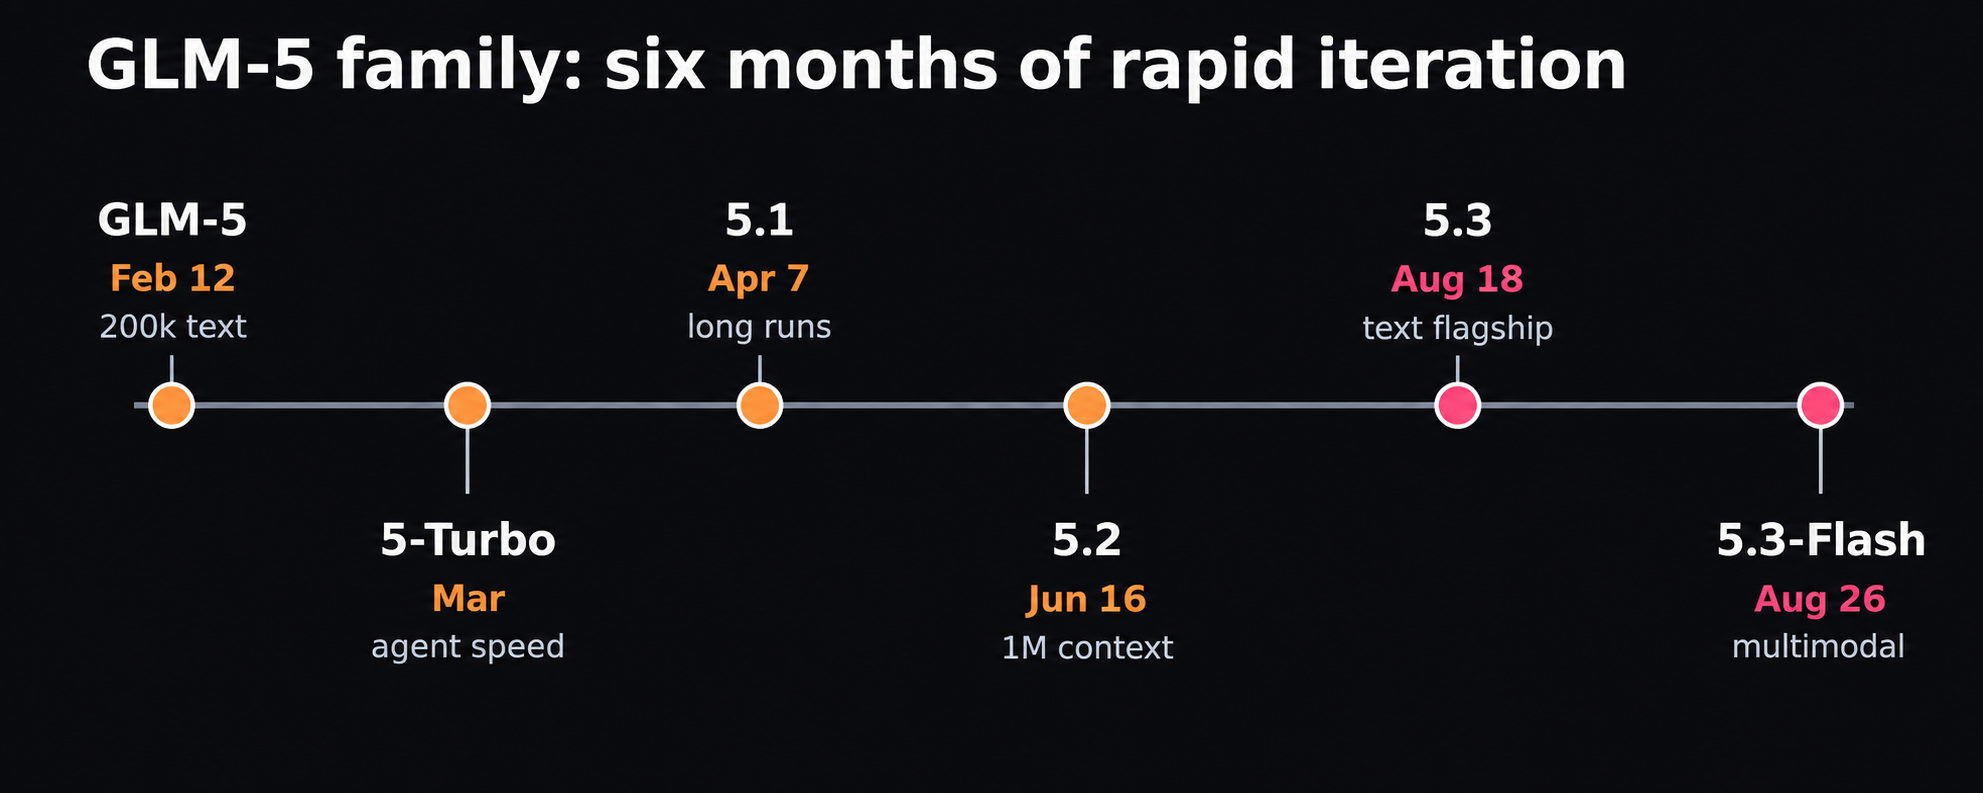
Gambar 2. Enam bulan rilis mengubah panjang konteks, modalitas, perilaku penalaran, dan harga.
Dari GLM-5 ke GLM-5.2
Arsitektur berbasis agen dibangun di atas GLM-5 dasar. GLM-5.1 berfokus pada proses berkelanjutan; Z.ai mengklaim bisa berjalan hingga 8 jam, tapi anggap saja ini perlu diuji sendiri, karena repositori Anda bisa berbeda. Jendela konteks satu juta token, pengaturan effort yang fleksibel, dan IndexShare untuk efisiensi attention konteks panjang kemudian ditambahkan pada GLM-5.2.
GLM-5.3 dan GLM-5.3-Flash
Andalan GLM adalah model khusus teks: GLM-5.3. Sesuai dokumentasinya, batas inputnya 1 juta token, batas output 128K, dan level effort penalaran rendah, tinggi, atau maksimal. Thinking tidak dapat dimatikan; permintaan 5.2 yang secara eksplisit mematikannya bisa gagal saat migrasi.
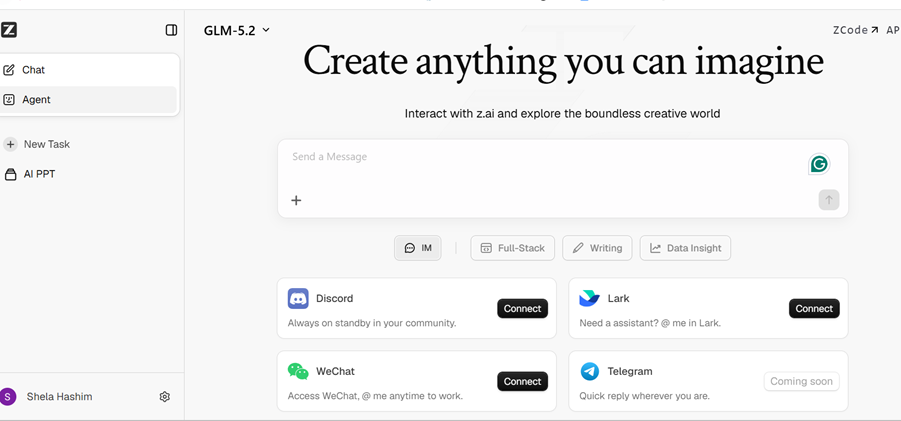
Gambar 3. Antarmuka GLM-5.3 yang langsung memastikan jalur andalan yang berbeda; ketersediaan dan label bisa berubah.
GLM-5.3-Flash adalah model 320B total/18B aktif lainnya yang menghadirkan input multimodal native dan attention hybrid sparse/linear. Rekomendasi awal saya cukup sederhana: gunakan 5.3 saat kedalaman penting; uji Flash dulu saat yang terlibat adalah screenshot atau volume besar.
Replay permintaan yang tersimpan, jangan sekadar mengganti nama model, sebelum mengubah integrasi yang sudah ada. Uji output terstruktur, argumen tool-call, panjang maksimal completion, dan penanganan timeout. Sebuah respons mungkin lebih menarik secara visual di chat tapi bisa membuat parser gagal atau melampaui batas latensi aplikasi Anda. Pertahankan jalur lama sampai versi baru melewati gate produksi yang sama.
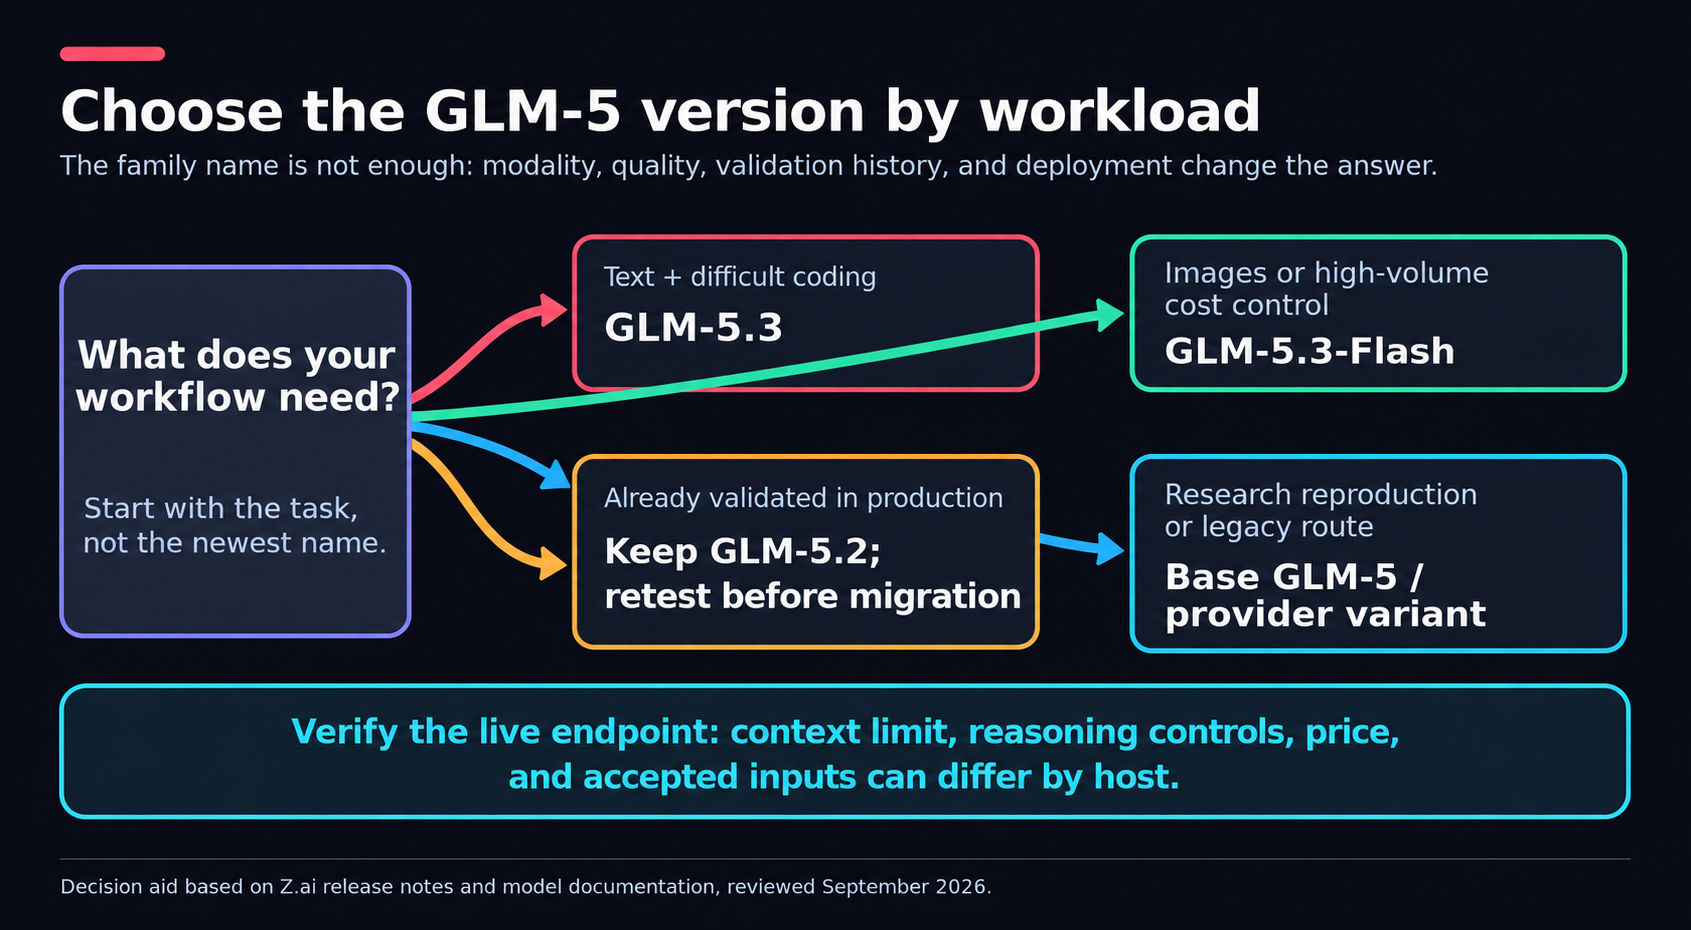
Gambar 4. Pilih berdasarkan beban kerja dan perilaku endpoint, bukan hanya nama model terbaru.
Bagaimana GLM-5 Dibandingkan dengan Claude, GPT, dan Gemini?
GLM-5.3 layak masuk daftar pendek agen coding, tapi satu tabel tidak bisa menobatkan pemenang mutlak. Skor Terminal-Bench bergantung pada harness, izin tool, batas waktu, dan level effort. Z.ai melaporkan 88,2 pada Terminal-Bench 2.1 dan 28,3 pada Terminal-Bench 3.0 untuk GLM-5.3 pada effort maksimal; tabelnya juga menampilkan ulang hasil untuk Claude Opus 4.8 dan GPT-5.6 Sol.
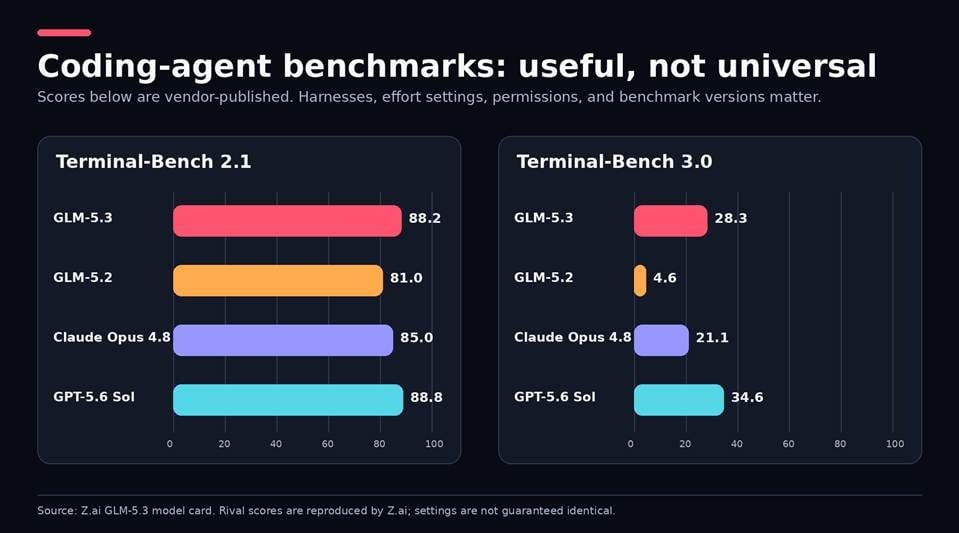
Gambar 5. Skor yang dipublikasikan vendor adalah bukti arah, bukan pengganti uji identik yang spesifik untuk beban kerja Anda.
Berbeda dengan model lain, model card GLM-5.3 mencantumkan nama harness dan pengaturan effort-nya. Namun tidak disebutkan apakah model pesaing dijalankan dalam kondisi yang identik. Begitu pula, menurut laporan GLM-5.2, model ini mengungguli Gemini 3.1 Pro pada sebagian tugas Terminal-Bench 2.1 — sebagian kecil dari tugas coding yang disebutkan di sini — namun ini tidak berarti GLM mengungguli Gemini 3.1 Pro di semua tugas multimodal, riset, atau penulisan.
Saya akan menguji model dengan prompt, tool, timeout, dan kriteria lolos yang sama. Perhatikan biaya per tugas sukses, BUKAN harga per token. Model yang lebih murah tapi gagal tiga kali bisa ternyata lebih mahal, dan jika Flash lolos pada percobaan pertama saat menjalankan pengujian Anda, keunggulan model andalan jadi tidak berarti.
Model card GLM-5.3 cukup unik karena mencantumkan nama harness dan level effort. Apakah model pesaing lain diuji dalam kondisi yang sama masih belum jelas. Begitu pula, panduan GLM-5.2 menyatakan model ini mengungguli Gemini 3.1 Pro pada Terminal-Bench 2.1 — tugas urutan kata untuk agen coding — bukan berarti ia pasti lebih baik pada tugas multimodal, riset, atau penulisan.
Saya akan menilai model-model ini menggunakan prompt, tool, timeout, dan kriteria lolos yang sama. Fokus hanya pada biaya tugas yang sukses, BUKAN harga per token. Jika ada tes yang berhasil di percobaan pertama, Flash mungkin justru menjadi pilihan yang lebih murah, karena keunggulan model andalan tereduksi menjadi sekadar status "andalan" saja.
Di Dalam Pelatihan dan Arsitektur GLM-5
Sparse Attention dan IndexShare
Konteks panjang mahal untuk diproses karena attention biasanya memperhitungkan banyak relasi antar token. Indexer dipasang pada GLM-5.2, sehingga indexer yang sama dapat dipakai di 4 layer attention berbeda untuk menemukan lokasi yang tepat. Z.ai menyatakan efisiensi 2,9× lebih rendah FLOPs per token pada 1M token. Ini adalah klaim efisiensi dari pengembang, bukan klaim latensi endpoint atau biaya permintaan.
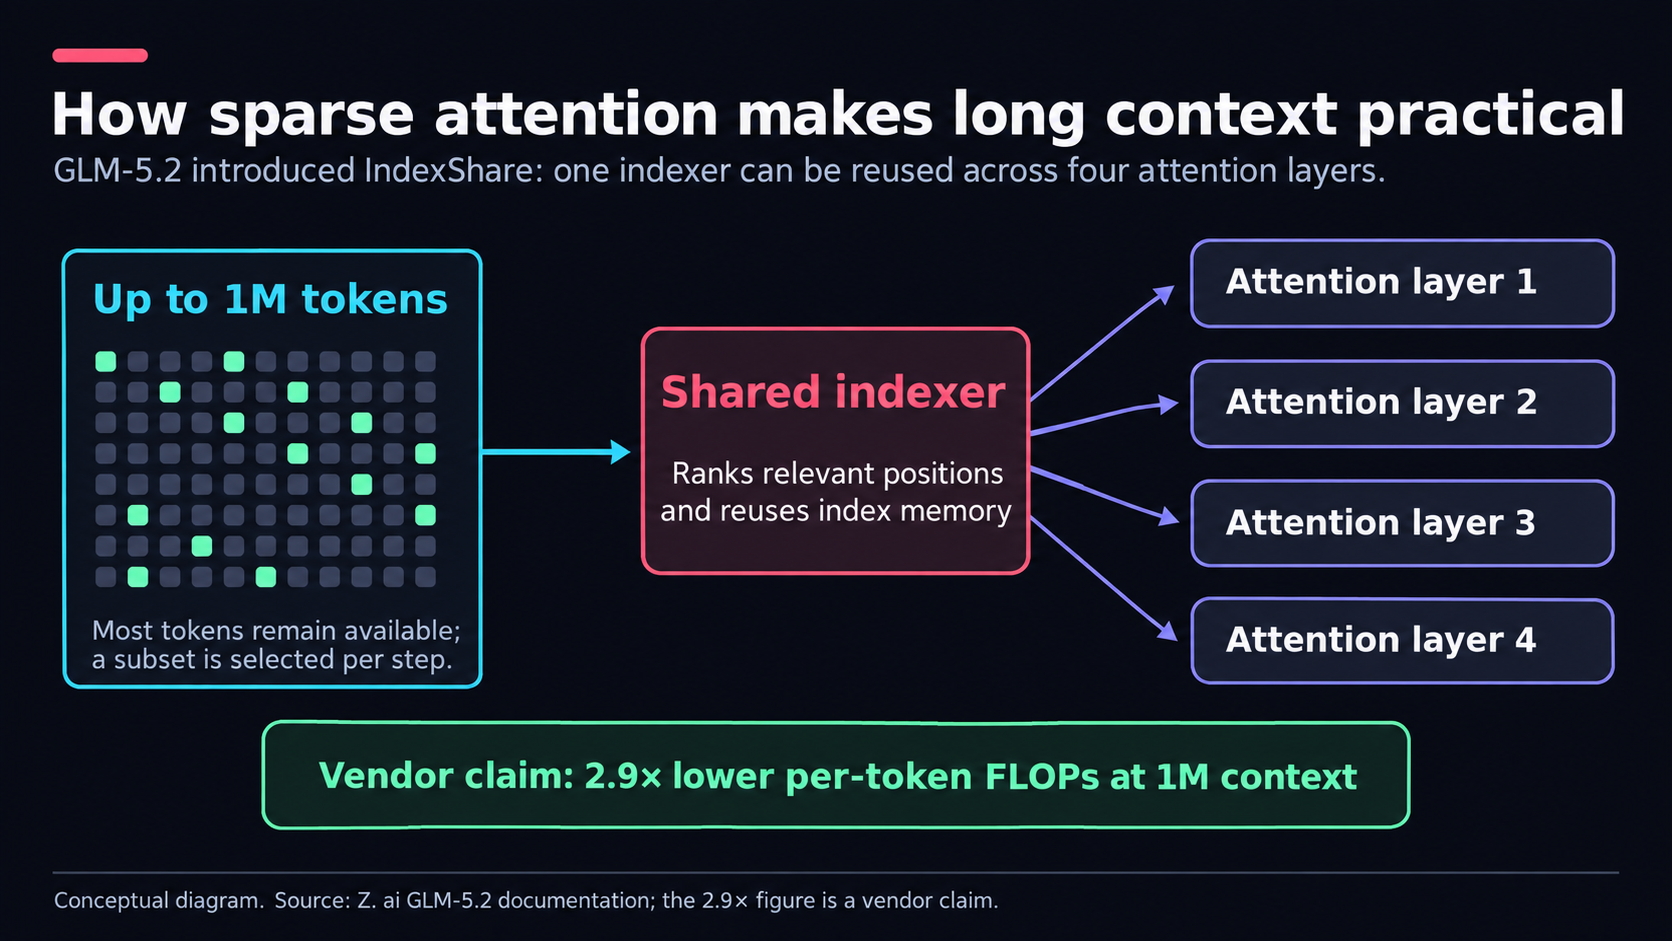
Gambar 6. IndexShare menggunakan ulang satu indexer di empat layer attention; angka 2,9× adalah klaim Z.ai.
Reinforcement Learning Jangka Panjang
Untuk GLM-5.3, Z.ai memperkenalkan sistem reinforcement-learning asinkron yang mereka sebut slime, context compaction, dan verifier sintetis. Teknik-teknik ini menyasar hal-hal yang sering terlihat salah pada agen di proses panjang: kehilangan tujuan, meninggalkan tugas, atau tidak memeriksa jawaban. Meski begitu, beberapa checkpoint dan pengujian eksternal tetap dibutuhkan, dan jejak kegagalannya bisa lebih besar seiring trajektori yang lebih panjang.
Kemampuan Keamanan Siber Tetap Butuh Validasi Manusia
Berdasarkan kolaborasi keamanannya, Z.ai mengungkapkan 2.436 kerentanan dari 269 proyek open-source, dengan 1.097 di antaranya berkategori sedang hingga tinggi. Angka-angka model ini relevan untuk GLM-5.3 dalam konteks tinjauan defensif, tapi GLM-5.3 tidak "menemukan kerentanan" — ia hanya menghasilkan temuan model.
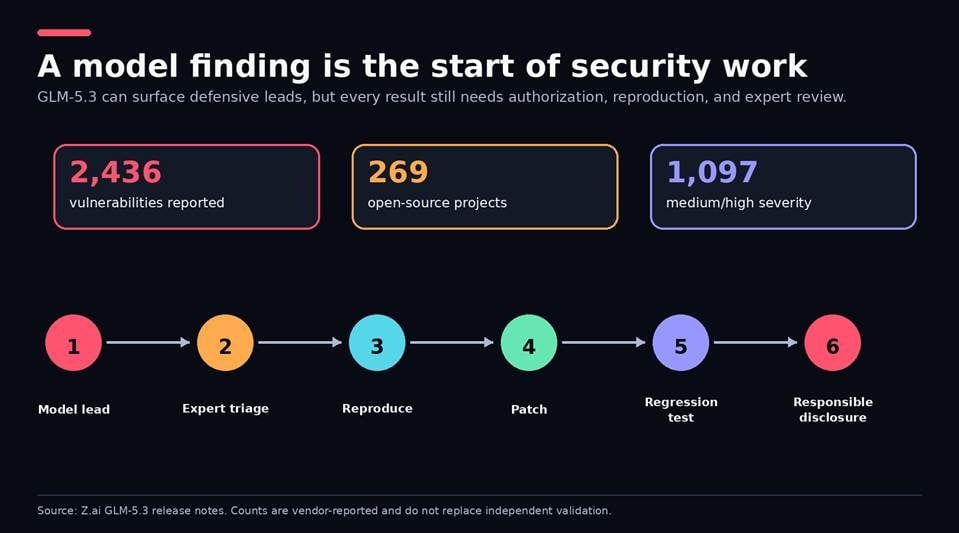
Gambar 7. Reproduksi, patch, uji regresi, dan ungkapkan secara bertanggung jawab; jangan pernah mengarahkan agen ke sistem yang tidak Anda punya izin untuk menguji.
Harga GLM-5
Z.ai memisahkan biaya input tanpa cache, input dengan cache, dan output per September 2026. Saya telah memeriksa ulang harga ini dengan halaman pricing resmi; jangan langsung menganggap harga ini tetap saat menyusun anggaran, karena bisa berubah seiring waktu.
| Model | Input / 1M | Input ter-cache / 1M | Output / 1M |
|---|---|---|---|
| GLM-5 | $1,00 | $0,20 | $3,20 |
| GLM-5.1 | $1,40 | $0,26 | $4,40 |
| GLM-5.2 | $1,40 | $0,26 | $4,40 |
| GLM-5.3 | $1,40 | $0,26 | $4,40 |
| GLM-5.3-Flash | $0,15 | $0,03 | $0,50 |
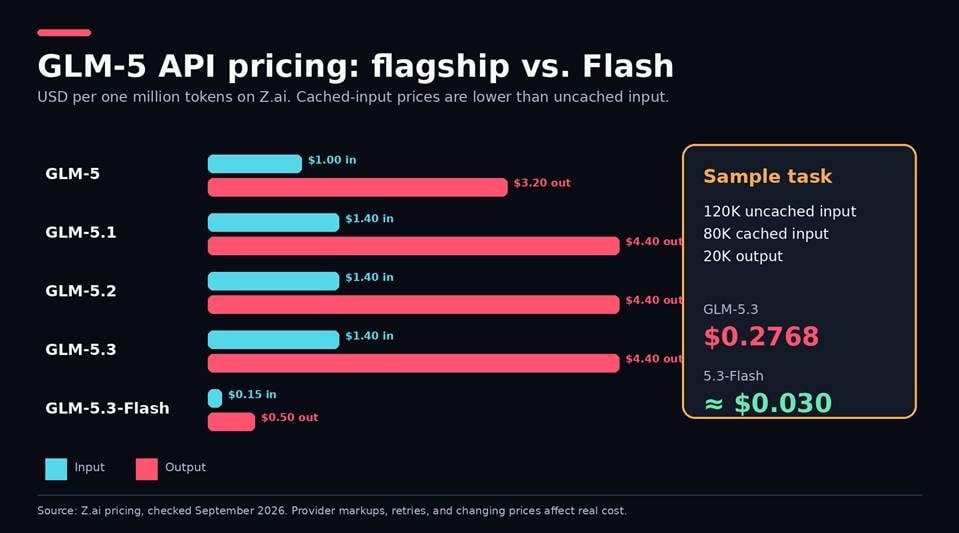
Gambar 8. Harga API Z.ai menunjukkan mengapa panjang output dan percobaan ulang bisa mendominasi total biaya.
Biaya GLM-5.3 sekitar $0,2768 untuk 120K input tanpa cache, 80K input ter-cache, dan 20K output; 5.3-Flash sekitar $0,030 (tidak termasuk percobaan ulang). Host lain seperti OpenRouter bisa menawarkan harga, limit, latensi, dan routing yang berbeda-beda. GLM Coding Plan bukan kuota API produksi, melainkan subscription terpisah untuk tool coding yang didukung.
Output adalah bagian yang mahal dari permintaan, dan agen yang bernalar lama bisa melampaui estimasi cepat. Saya akan memasang batas atas output, memakai caching saat konteks berulang memenuhi syarat, dan mencatat biaya per tugas yang selesai. Saat menyusun anggaran produksi, pertimbangkan percobaan ulang, tool call yang gagal, dan waktu manusia untuk memperbaiki respons yang lemah. Inilah angka yang sebaiknya Anda bandingkan antar penyedia.
Cara Menggunakan GLM-5
| Jalur | Terbaik Untuk | Di Mana Inferensi Berjalan |
|---|---|---|
| Z.ai Chat | Evaluasi kualitatif cepat | Server Z.ai |
| Z.ai API | Integrasi first-party | Server Z.ai |
| OpenRouter | Pilihan penyedia dan failover | Penyedia hosting terpilih |
| Enter MaaS | Akses model dalam workflow pembuatan app | Jalur hosted yang ditampilkan di Enter |
| Hugging Face + vLLM/SGLang | Deployment yang dikelola sendiri | Infrastruktur Anda |
| Ollama :cloud | Akses jarak jauh lewat klien Ollama | Server jarak jauh, bukan laptop Anda |
Mulai dengan Z.ai Chat
Jalur chat GLM-5 dengan friksi paling rendah adalah chat.z.ai. Gunakan untuk menguji perilaku prompt dan struktur output, tapi perhatikan model persis yang ditampilkan di antarmuka. Jangan menjanjikan tim penggunaan "gratis" atau "tanpa batas" tanpa memeriksa kuota akun saat ini.
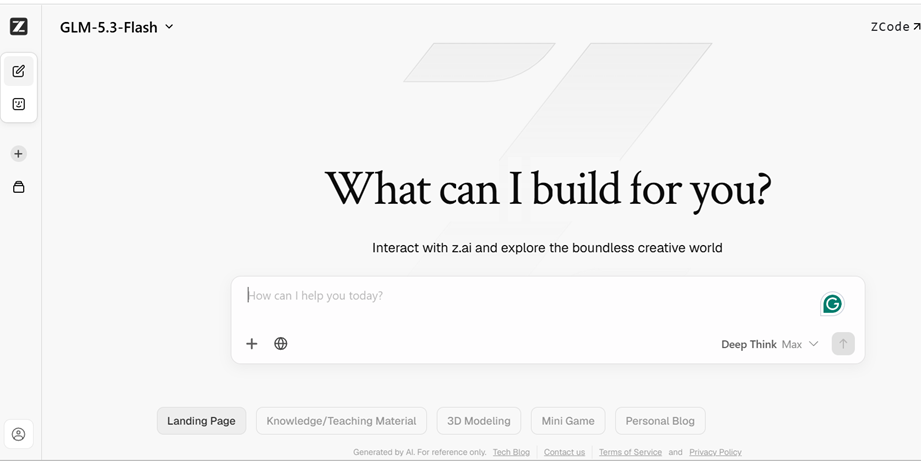
Gambar 9. Antarmuka chat adalah pemeriksaan kualitatif cepat, tapi model yang ditampilkan dan kuota akun tetap penting.
Panggil API Z.ai atau OpenRouter
Z.ai menyediakan endpoint yang kompatibel dengan OpenAI, artinya SDK Python resmi bisa dipakai dengan base URL yang berbeda. Simpan API key di environment variable dan catat ID model, effort, jumlah token yang dipakai, serta apakah permintaan berhasil diselesaikan.
Gambar 10. Endpoint kompatibel-OpenAI dari Z.ai mengurangi perubahan SDK; ini tidak menghilangkan kebutuhan uji migrasi.
import os
from openai import OpenAI

client = OpenAI(
        api_key=os.environ["ZAI_API_KEY"],
        base_url="https://api.z.ai/api/paas/v4/",
)

response = client.chat.completions.create(
        model="glm-5.3",
        messages=[{"role": "user", "content": "List five tests for a password-reset flow."}],
        max_tokens=4096,
        extra_body={"thinking": {"type": "enabled"}, "reasoning_effort": "high"},
)

print(response.choices[0].message.content)
Saat bermigrasi dari 5.2, hapus permintaan yang mematikan thinking; GLM-5.3 tidak menerima perilaku itu. Jika Anda memakai jalur OpenRouter GLM-5.3, catat penyedia mana yang menangani permintaan ketika tata kelola atau reproducibility menjadi penting.
Unduh dan Self-Host Weights
Gunakan repositori resmi atau model card GLM-5.3 Hugging Face yang terverifikasi. Z.ai mencantumkan SGLang, vLLM, Transformers, KTransformers, dan Unsloth sebagai jalur yang didukung.
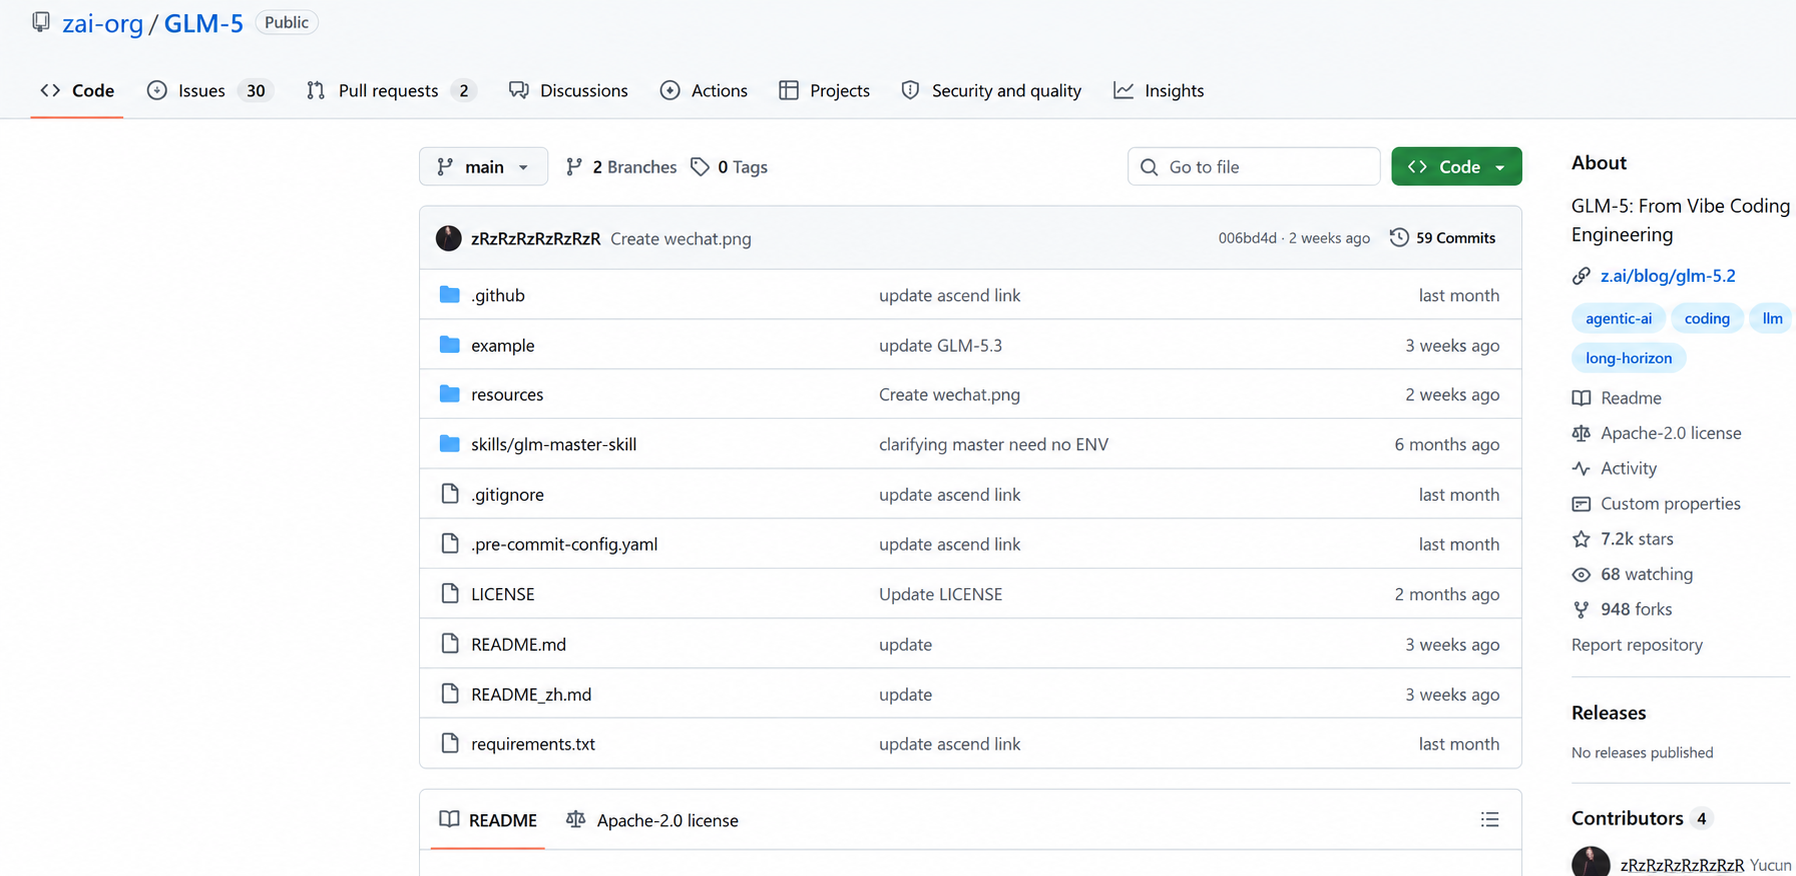
Gambar 11. Gunakan repositori dan model card terverifikasi, bukan mirror weight tidak resmi.
Bisa diunduh TIDAK berarti bisa dijalankan. Quantization mengurangi kebutuhan memori, tapi bisa mengubah kualitas; pada checkpoint 744B, dibutuhkan penyimpanan dan akselerator kelas server. Baca listing Ollama GLM-5 dengan teliti: tag dengan :cloud berarti inferensi berjalan jarak jauh. Yang Anda butuhkan adalah weight lokal, runtime lokal, dan hardware yang mencukupi.
Cara Saya Mengevaluasi GLM-5 Sebelum Produksi
Saya tidak akan mulai dengan prompt luas seperti "Model mana yang paling pintar?" Saya akan menjalankan empat tugas representatif terhadap 5.2, 5.3, dan Flash menggunakan tool dan batas yang sama: memperbaiki bug repositori, mengambil fakta yang disisipkan dari dokumen panjang, menyelesaikan workflow multi-tool dengan satu kegagalan yang disengaja, dan menghasilkan output sesuai rubrik tertulis.
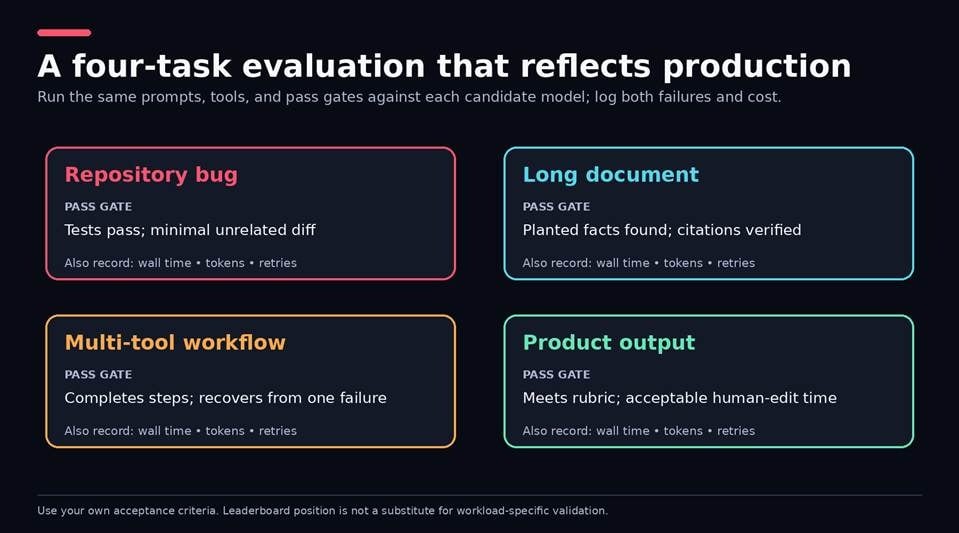
Gambar 12. Tes beban kerja kecil yang dapat diulang lebih berguna daripada prompt luas "model paling pintar".
Lulus/gagal, waktu proses, token, percobaan ulang, waktu edit manusia, dan penyedia. Ini memungkinkan Anda mendeteksi risiko migrasi yang tidak terlihat dari rata-rata benchmark — seperti penalaran yang selalu aktif pada 5.3 dan output yang bisa sangat panjang. Ini juga memberi tahu Anda apakah harga murah Flash tetap bertahan saat berhadapan dengan tes akseptasi Anda.
Siapa yang Sebaiknya Menggunakan GLM-5?
Agentic Coding dan Kerja Repositori
GLM-5 adalah opsi yang sangat baik jika tugas melibatkan pencarian repositori, edit terkoordinasi, eksekusi test, dan tool call. Bukti benchmark publik mendukung daftar singkat ini, tapi gate akseptasi Anda harus solid: test lolos, diff-nya fokus, dan tidak ada kredensial atau batas jaringan yang dilanggar. Sediakan area kerja terpisah dan terapkan least privilege. Otonomi lebih besar tanpa kontrol hanya menghasilkan jejak kegagalan yang lebih besar.
Dokumen Panjang dan Kerja Pengetahuan
Model satu juta token cocok untuk spesifikasi, paket riset, dan codebase besar. Jendela konteks yang besar jangan dianggap sebagai retrieval yang dapat diandalkan. Letakkan informasi uji di awal, tengah, dan akhir; sitasi; verifikasi informasi yang disitasi. Saya juga akan menarik paralel dengan pipeline retrieval, karena memasukkan semuanya ke satu prompt besar bisa jadi lebih lambat dan lebih mahal daripada memilih bukti yang relevan terlebih dahulu.
Workflow Multimodal dan Defensif
Dengan GLM-5.3-Flash atau GLM-5V-Turbo, screenshot, state antarmuka, atau input visual lain yang didukung pekerjaan menjadi bagian dari tugas. Perlakukan semua temuan sebagai petunjuk awal untuk tinjauan keamanan defensif, lalu reproduksi dan triase. GLM-5 kurang cocok untuk yang menginginkan model laptop lokal kecil, yang tidak bisa membuat keputusan deployment, atau yang tidak bisa memverifikasi residensi host dan ketentuan retensi.
Apakah GLM-5 Aman untuk Data Pribadi atau Perusahaan?
Jalur Hosted
Bukan hanya modelnya yang menentukan, tapi juga jalurnya. Ada berbagai jalur data, seperti Z.ai Chat, Z.ai API, host lain, atau deployment yang dikelola sendiri. Mulai dengan kebijakan privasi Z.ai, lalu lanjutkan dengan memeriksa seluruh perantara untuk menentukan retensi, penggunaan untuk pelatihan, penghapusan, residensi, dan ketentuan kontrak.
Kunci penyedia tertentu jika agregator menawarkannya, dan jangan mengirim data rahasia hanya karena praktis. Data yang hosted ditentukan oleh kontrak dan konfigurasi Anda, bukan oleh kata "open weights".
Self-Hosting
Self-hosting membuat prompt tetap di lingkungan Anda, tapi Anda bertanggung jawab atas weight, kredensial, patching, kontrol jaringan, dan monitoring. Saya tetap berasumsi ada kemungkinan kode yang dihasilkan di awal belum aman dan rawan disusupi. Pisahkan kredensial build dan produksi, batasi akses jaringan keluar, audit tindakan tool, dan pertahankan persetujuan manusia untuk perubahan yang signifikan. Jangan memberi agen otoritas lebih dari yang dibutuhkan untuk tugasnya.
Cara Menggunakan GLM-5 dengan Enter Pro
GLM-5 bukan pesaing langsung Enter Pro. GLM menyediakan kemampuan model, sementara Enter Pro menyediakan Product Building Workflow di sekitar model tersebut. Ini berguna saat Anda bukan hanya mencari "dapatkan satu completion", tapi "dapatkan completion yang bisa diubah menjadi antarmuka, logika, dan jalur publikasi."
Jika yang diperlukan adalah kontrol API, infrastruktur khusus, atau struktur data tertentu, jalur langsung adalah pilihan yang lebih baik. Saat workaround produk menjadi faktor pembatas, di sinilah Enter Pro berperan. AI MVP Builder miliknya menyederhanakan proses perencanaan, pembuatan app, editing visual, dan publikasi menjadi satu alur, sementara Enter Code menyediakan pendekatan berbasis terminal untuk tugas repositori.
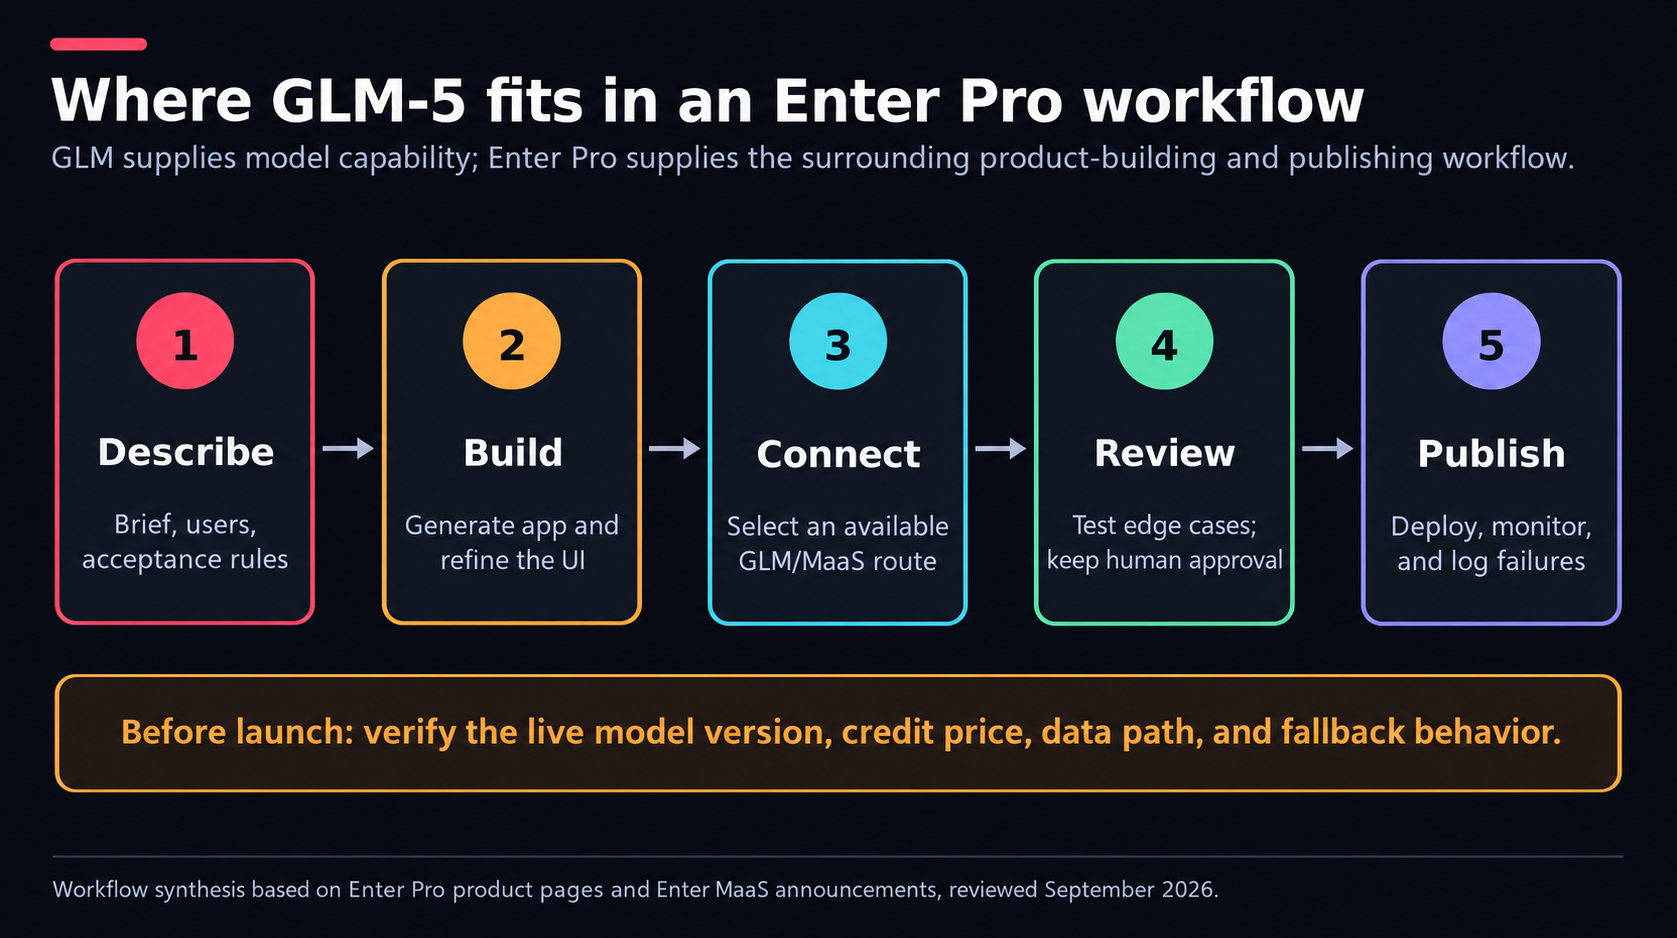
Gambar 13. Model menghasilkan atau mengklasifikasi; workflow produk menambahkan UI, review, deployment, dan monitoring.
Changelog Enter mengonfirmasi GLM-5.2 ada di katalog AI All sebelumnya pada 17 Juni. Pengumuman Enter MaaS menyebut GLM-5 dan menjelaskan cara model dihargai dalam credit. Itu tidak secara eksplisit mengonfirmasi GLM-5.3, jadi pastikan Anda memeriksa model selector yang aktif, harga credit, batas konteks, dan jalur data sebelum merancang sesuatu berdasarkan versi tertentu.
Sebuah aplikasi triase dukungan pelanggan menunjukkan di mana kombinasi ini masuk akal. Dengan Enter Pro, Anda bisa mendesain form tiket dan dashboard tampilan, lalu menghubungkan jalur GLM yang sudah ada untuk mengkategorikan tiket dan menyusun balasan. Sebelum publikasi, validasi respons model yang kosong, permintaan yang ambigu, input multibahasa, prompt injection, dan data pribadi di dalam isi pesan. Pastikan ada manusia di antara draft dan tombol kirim.
| Jika Prioritas Anda… | Pilih Jalur GLM Langsung | Pilih Enter Pro |
|---|---|---|
| Parameter model dan kontrol penyedia | Ya | Hanya dalam opsi yang tersedia |
| Pembuatan dan editing app secara visual | Bangun atau tambahkan tooling terpisah | Keunggulan workflow inti |
| Hosting khusus dan kebijakan jaringan | Paling cocok | Periksa kesesuaian platform dulu |
| Jalur cepat dari output model ke UI produk | Butuh lebih banyak engineering | Lebih cocok |
Tapi Enter tidak membuat GLM lebih pintar, dan fakta bahwa GLM punya akses ke sebuah app juga tidak membuat agen coding mereka lebih pintar. Jika yang dibutuhkan adalah integrasi atau kerja UI, saya akan memilih Enter. Jika Anda berada di posisi itu, buka workspace Enter Pro dan periksa katalog model yang tersedia sebelum berkomitmen pada arsitektur Anda.
Kesimpulan
Meski namanya GLM-5, varian dan metode penyajiannya sama pentingnya saat berbicara soal coding dan agen jangka panjang! Gunakan GLM-5.3 untuk teks dan kode yang sulit, GLM-5.3-Flash untuk multimodal dan/atau volume tinggi, dan pertahankan 5.2 sampai migrasi benar-benar menguntungkan secara biaya. Lalu uji pada tugas Anda sendiri sebelum menjadikan klaim vendor/leaderboard sebagai bukti produksi.
Yang benar-benar memenuhi kriteria akseptasi Anda, berada dalam rentang latensi dan privasi yang Anda butuhkan, dan tetap punya harga yang wajar setelah percobaan ulang — itulah yang akan benar-benar berhasil, terlepas dari skor hampir sempurna yang mungkin ia raih pada satu benchmark tertentu.
Mulai Membangun dengan Enter Pro →
FAQ
FAQ 1: Apakah GLM-5 Gratis?
Bobot publiknya bisa diunduh tanpa biaya API per token, tapi hardware dan operasionalnya tetap berbayar. Z.ai Chat mungkin punya akses berbasis kuota. API hosted, router, dan server GPU adalah layanan berbayar, dan bisa berbeda tergantung versi dan jalur yang dipakai.
FAQ 2: Versi GLM-5 Mana yang Lebih Baik?
Untuk teks/coding yang menantang, saya mulai dengan GLM-5.3. GLM-5.3-Flash adalah pilihan uji awal yang lebih baik untuk gambar, screenshot, atau volume yang sensitif biaya. Jangan ganti dari GLM-5.2 jika sudah tervalidasi dan risiko migrasinya lebih besar daripada manfaatnya.
FAQ 3: Apakah GLM-5 Bisa Menulis dan Men-debug Kode?
Ya. Agen coding dan engineering skala repositori adalah use case utamanya, dengan hasil baik yang dilaporkan vendor terkait Terminal-Bench dan DeepSWE. Sandbox, test, izin terbatas, dan review manusia tetap dibutuhkan.
FAQ 4: Berapa Harga API GLM-5?
Per September 2026, Z.ai mencantumkan GLM-5 di $1,00 input dan $3,20 output per juta token; GLM-5.3 di $1,40 dan $4,40; dan 5.3-Flash di $0,15 dan $0,50. Input ter-cache lebih murah. Biaya sebenarnya dipengaruhi markup penyedia dan percobaan ulang.
FAQ 5: Apakah GLM-5 Perangkat Lunak Open Source?
"Open weights" lebih tepat. Lisensi bobot, lisensi kode repositori, dan transparansi data pelatihan adalah hal yang berbeda-beda. Untuk deployment komersial, pastikan memeriksa model card Hugging Face dan lisensi repositori secara spesifik.
FAQ 6: Bisakah GLM-5 Dipakai Secara Lokal (Dengan Ollama)?
Hanya jika Anda punya bobot lokal, dukungan runtime, dan hardware yang cukup untuk itu. Tag cloud berarti model berjalan di infrastruktur jarak jauh, jadi bukan berarti seluruh 744B berjalan di perangkat Anda.
FAQ 7: Apakah GLM-5 Bisa Memproses Gambar?
GLM-5 dasar dan GLM-5.3 khusus teks. Untuk input multimodal, gunakan GLM-5.3-Flash atau GLM-5V-Turbo; periksa jenis file yang diterima di endpoint yang dipilih.





