
GLM-5レビュー:バージョン、ベンチマーク、価格、利用方法を徹底解説
GLM-5の各バージョン、ベンチマーク、価格、アーキテクチャ、ローカル展開、API接続、Enter Pro連携までを徹底比較。
GLM-5はもはや、たった一つのベンチマークで評価できるような単一モデルではない。あるバリエーションはテキストのみを扱い、別のものは画像入力を受け付け、新しいバージョンではコンテキストウィンドウが100万トークンまで拡張され、最も手頃なオプションはフラッグシップモデルのわずか一部のコストで済む——それほど多様な機敏なファミリーになっている。
このレビューを更新する前に、Z.aiのリリースノート、モデルカード、API文書、リポジトリ、実際のプロダクトスクリーンショットを確認した。これは重要なポイントだ。なぜなら、社内コーディング性能50%向上や、長文コンテキストにおける計算量2.9倍削減といった、かなり魅力的な主張の一部は、独立した検証機関ではなくZ.ai自身によるものだからだ。そのため、これらは「Z.aiの主張」として扱い、自分自身のテスト結果とは区別して紹介する。
GLM-5モデルを選ぶ際には、4つの問いを考えるべきだ。どのような入力があるか?タスクの難易度はどの程度か?推論をどこで実行する必要があるか?リトライが発生した場合、成功結果にかかるコストはいくらか?私の端的な答えは次の通り:複雑なテキスト/コーディングにはGLM-5.3、マルチモーダルやコスト重視ならGLM-5.3-Flash、既に検証済みの統合がある場合はGLM-5.2を使う。
GLM-5とは何か?
GLM-5は、ソフトウェアエンジニアリング、ツール利用、長期的なエージェントタスクのためにZ.aiが開発したオープンウェイトモデルファミリーの名称だ。最初のリリース(2026年2月)はテキスト入出力のみのMixture-of-Experts(MoE)モデルで、総パラメータ数7,440億、トークンあたりのアクティブパラメータ数は約400億、コンテキストウィンドウは20万トークンという仕様を持つ。これらの仕様はGLM-5技術レポートと公式GitHubリポジトリに基づく。
MoEモデルは、すべてのトークンに対してネットワーク全体を起動するわけではない。ルーターが各トークンを少数の「専門家(エキスパート)」のグループに振り分け、非常に大きなチェックポイントを保持しながらも実際の計算量を削減する仕組みだ。ただし、これはGLM-5がノートPCで動くモデルになることを意味するわけではない。完全な重みファイルには、依然としてストレージ、ルーティング機構、サーバークラスのハードウェアが必要となる。
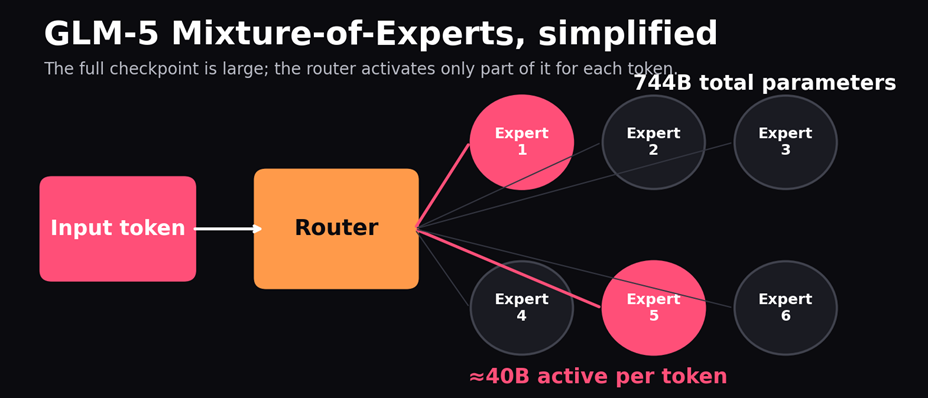
図1. GLM-5は7,440億パラメータのうち、トークンあたり約400億を活性化する。完全なチェックポイントは依然としてサーバー規模のデプロイメントを前提とする。
正しい用語は「オープンウェイト」である。コード、モデルの重み、ホスティングサービス、学習データにはそれぞれ異なる条件が適用される。商用利用を検討する前には、使用予定のモデルカードに付属するライセンスを必ず確認すべきだ。GLMのすべてのバージョンが同じ権利を提供しているわけではないからだ。
GLM-5のバージョンファミリー
このファミリー名は、重要な差異を隠してしまう。すべての5.xリリースを互換性のあるものとして扱うのではなく、モダリティ、コンテキスト長、検証履歴、デプロイ方法によって選ぶべきだ。
| バージョン | 入力/コンテキスト | 使うべき最大の理由 | 重要な注意点 |
|---|---|---|---|
| GLM-5 | テキスト / 20万 | 初期研究またはレガシー統合 | ファミリーの最初のリリース。新規プロジェクトのデフォルト選択ではない |
| GLM-5-Turbo | テキスト / 20万 | ホスト型でツール利用が多いエージェント業務 | プロバイダー経由のアクセスであり、小型のダウンロード可能なチェックポイントではない |
| GLM-5V-Turbo | テキスト、画像、動画、ファイル / 20万 | ビジュアルコーディングとGUIタスク | 利用するエンドポイントで対応フォーマットを確認すること |
| GLM-5.1 | テキスト / 20万 | 長時間の持続的なエンジニアリング作業 | ほとんどの新しい評価では後継版に置き換えられている |
| GLM-5.2 | テキスト / 100万 | 長いコンテキストと実績のある統合 | 5.3への移行で推論の挙動が変わる |
| GLM-5.3 | テキスト / 100万 | 難易度の高いコーディングと長時間稼働するエージェント | 推論機能は常にオン。出力が長くなる場合がある |
| GLM-5.3-Flash | マルチモーダル / 100万 | スクリーンショット処理、大量処理、低コスト | 320B/18Bの独立アーキテクチャであり、「低負荷版5.3」ではない |
出典:Z.aiのリリースノート、GLM-5-Turboガイド、GLM-5V-Turboガイド、GLM-5.1ガイド。ホスト側はモデルが対応する上限よりも小さいコンテキストウィンドウを提供する場合がある。
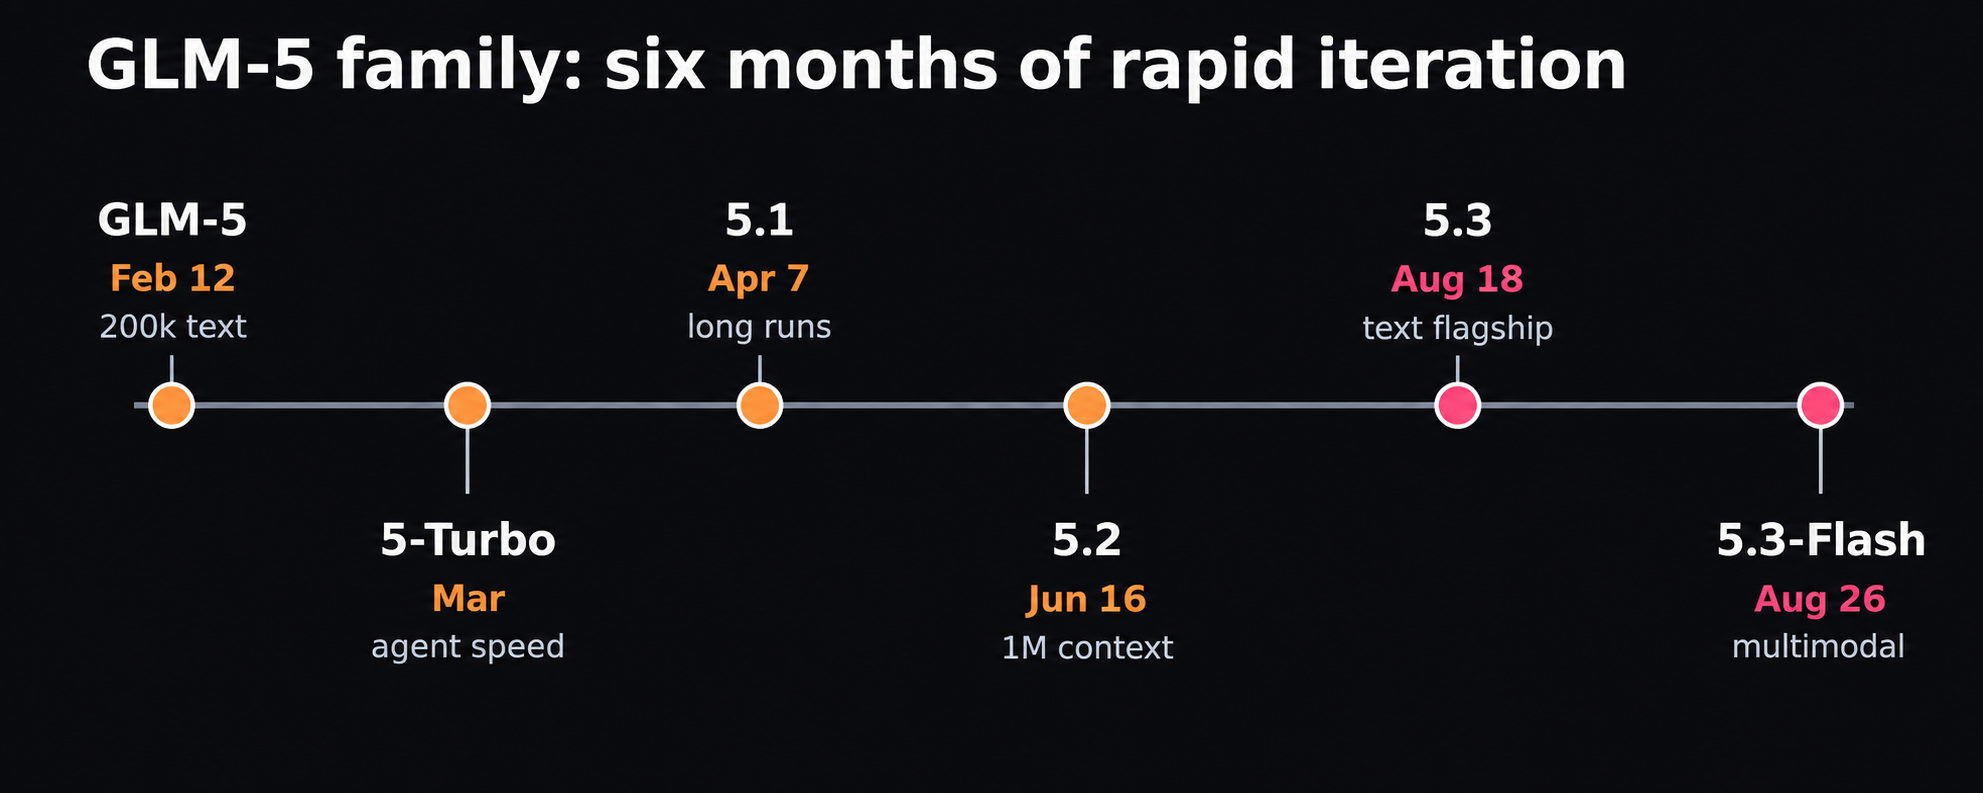
図2. 6か月間のリリースを通じて、コンテキスト長、モダリティ、推論の挙動、価格が変化した。
GLM-5からGLM-5.2へ
エージェントベースのアーキテクチャは、ベースとなるGLM-5の時点で確立された。GLM-5.1は持続的な稼働に焦点を当てており、Z.aiは最長8時間の連続稼働が可能だと主張しているが、自分のリポジトリでは挙動が異なる可能性があるため、この数字は慎重に受け止めるべきだ。その後、GLM-5.2では100万トークンのコンテキストウィンドウ、柔軟な推論投入量(effort)の設定、そして長文コンテキストでの効率的なアテンションを実現するIndexShareが追加された。
GLM-5.3とGLM-5.3-Flash
GLMシリーズのフラッグシップはテキスト専用のGLM-5.3だ。公式ドキュメントによれば、入力上限は100万トークン、出力上限は12.8万トークンで、推論投入量は低・高・最大の3段階から選べる。「思考(thinking)」機能はオフにできない。5.2用に明示的にこれを無効化していたリクエストは、移行時に失敗する可能性がある。
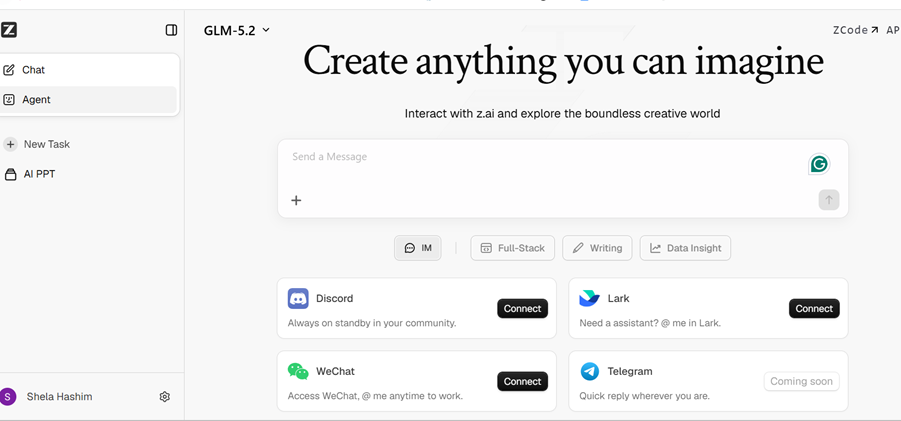
図3. GLM-5.3の実際のインターフェースは、独立したフラッグシップ経路の存在を確認させるものだが、提供状況や表示名は変更される可能性がある。
GLM-5.3-Flashは別のモデルで、総パラメータ320B/アクティブパラメータ18Bを持ち、ネイティブなマルチモーダル入力とスパース/線形ハイブリッドアテンションを備える。私の最初の勧めはシンプルだ:深い推論が重要な場合は5.3を、スクリーンショット処理や大量処理が中心の場合は、まずFlashをテストすること。
既存の統合を変更する前には、モデル名を単に書き換えるだけでなく、保存済みのリクエストを再実行してみるべきだ。構造化された出力、ツール呼び出しの引数、最大補完長、タイムアウト処理をテストする。チャット上では見栄えの良い応答でも、パーサーが失敗したり、アプリケーションのレイテンシ上限を単純に超えてしまったりする可能性がある。新バージョンが本番環境と同じゲートを通過するまでは、旧来の経路を維持しておくべきだ。
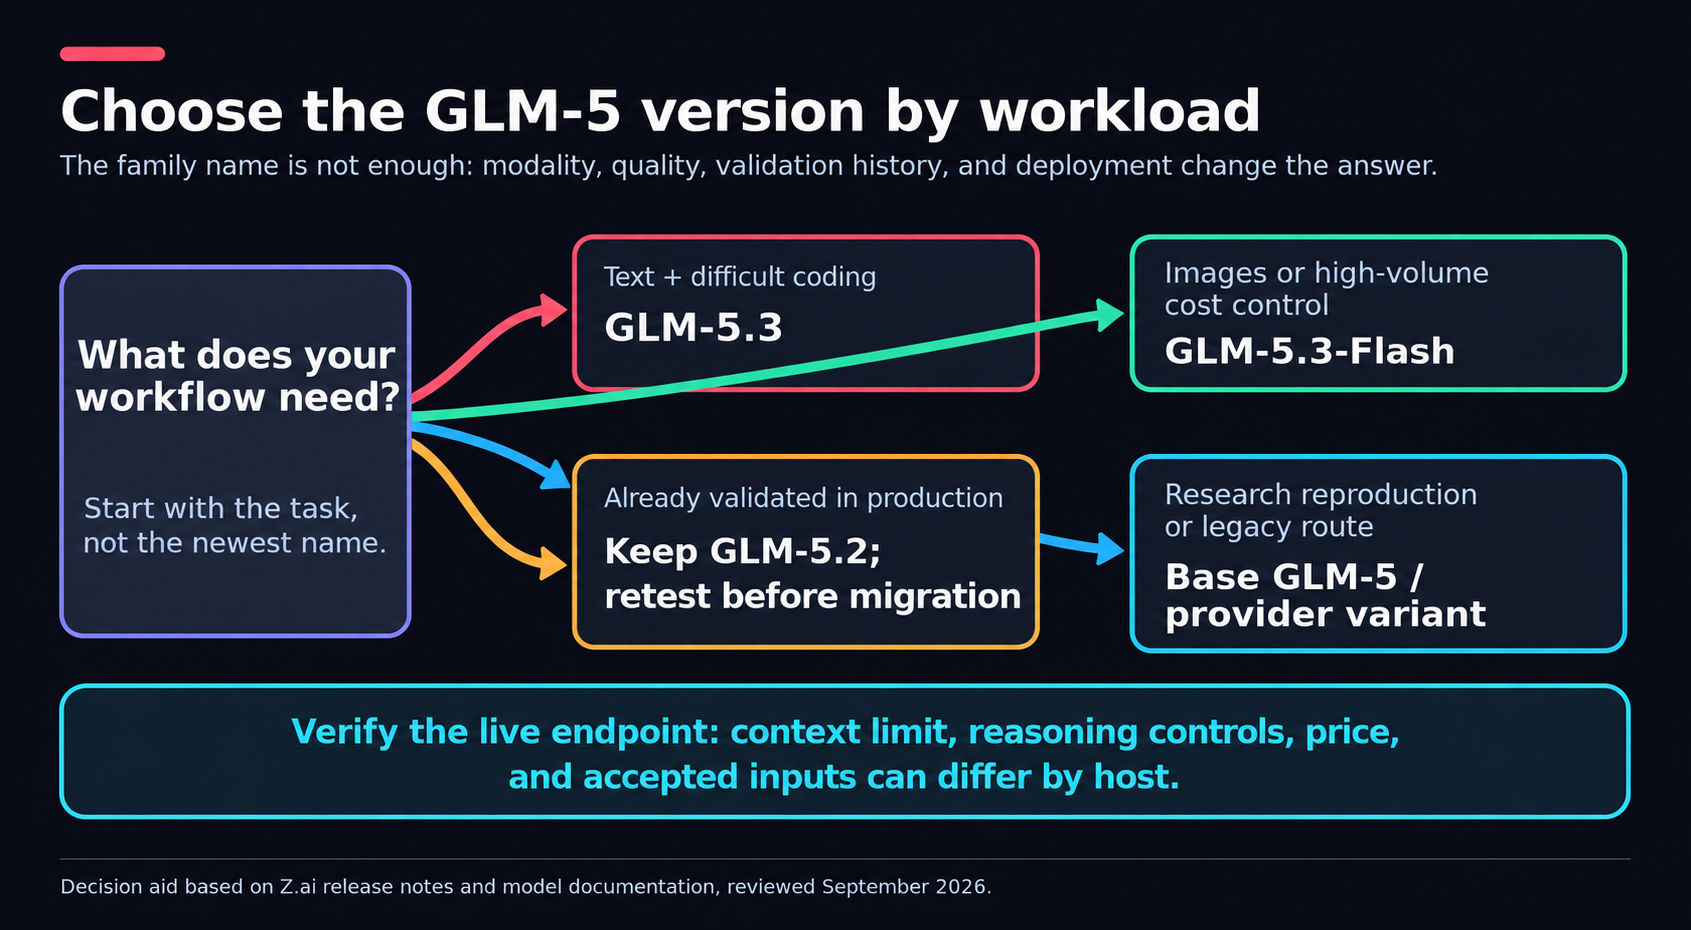
図4. 最新のモデル名だけでなく、ワークロードとエンドポイントの挙動に基づいて選ぶべきだ。
GLM-5はClaude、GPT、Geminiとどう比較されるのか?
GLM-5.3はコーディングエージェントのショートリストに入る資格を十分に持っているが、一つの表だけで総合的な勝者を決めることはできない。Terminal-Benchのスコアは、ハーネス、ツール権限、時間予算、推論投入量のレベルに依存する。Z.aiは、最大推論投入量のGLM-5.3についてTerminal-Bench 2.1で88.2点、Terminal-Bench 3.0で28.3点と報告している。その表にはClaude Opus 4.8やGPT-5.6 Solの結果も再現されている。
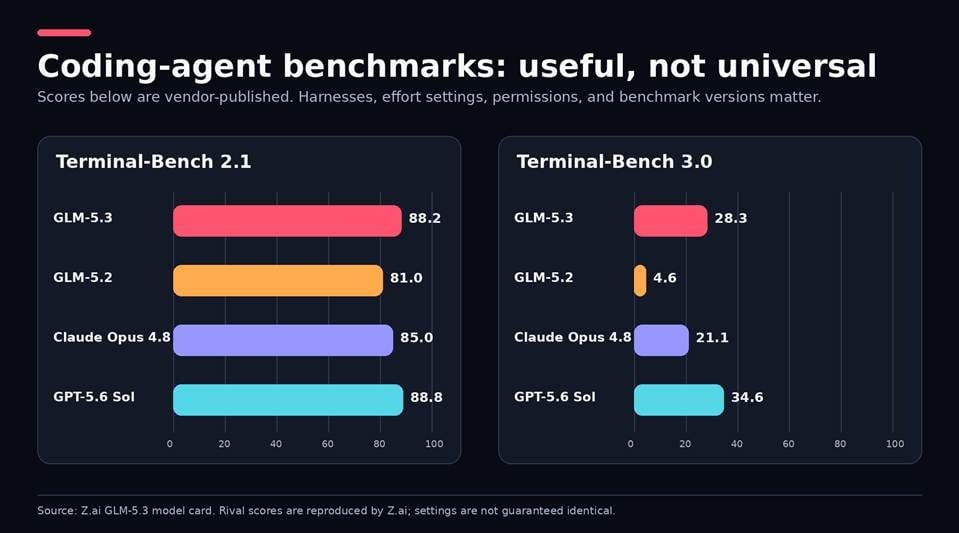
図5. ベンダーが公開するスコアは方向性を示す参考情報であり、あなた自身のワークロードに対する同一条件のテストの代わりにはならない。
他のモデルと異なり、GLM-5.3のモデルカードは使用したハーネスと推論投入量の設定を明示している。しかし、競合モデルが同一の条件下で運用されたかどうかは明言していない。同様に、GLM-5.2のレポートによれば、Terminal-Bench 2.1の一部タスクではGemini 3.1 Proを上回っているが、これは本稿で取り上げたコーディングタスクのごく一部にすぎず、GLMがマルチモーダル、調査、文章作成のすべての領域でGemini 3.1 Proを上回ることを示すものではない。
私であれば、同じプロンプト、ツール、タイムアウト、合格基準でモデルを評価する。注目すべきは成功したタスクの価格であり、トークン単価ではない。3回失敗する安価なモデルは、結果的により高コストになりかねないし、Flashが初回でテストに合格するなら、フラッグシップモデルの優位性は意味を持たなくなる。
GLM-5.3のモデルカードは、ハーネス名と推論投入量のレベルを明示している点で比較的珍しい存在だ。他の競合モデルが同一の条件下でテストされたかどうかは、依然として示されていない。同様に、GLM-5.2のガイドは、コーディングエージェント向けのタスクであるTerminal-Bench 2.1でGemini 3.1 Proを上回ると述べているに過ぎず、マルチモーダルや調査、文章作成のタスクで必ずしも優れているとは限らない。
私は、同じプロンプト、ツール、タイムアウト、合格基準を用いてモデルを検証する。トークン単価ではなく、成功したタスクのコストだけに注目する。テストが一回目で成功するのであれば、Flashのほうがよりお得な選択肢となる可能性があり、その場合フラッグシップモデルの優位性はおそらく同様に縮小するだろう。
GLM-5のトレーニングとアーキテクチャの内部
スパースアテンションとIndexShare
長文コンテキストは、通常アテンション機構がトークン間の多数の関係性を考慮するためコストが高くなる。GLM-5.2では、4つの異なるアテンション層で再利用できるインデクサーが導入され、正しい位置を特定できるようになった。Z.aiによれば、100万トークン時のトークンあたりFLOPsを2.9倍削減できるという。これは開発元による効率性に関する主張であり、エンドポイントのレイテンシや実際のリクエストコストに関する主張ではない。
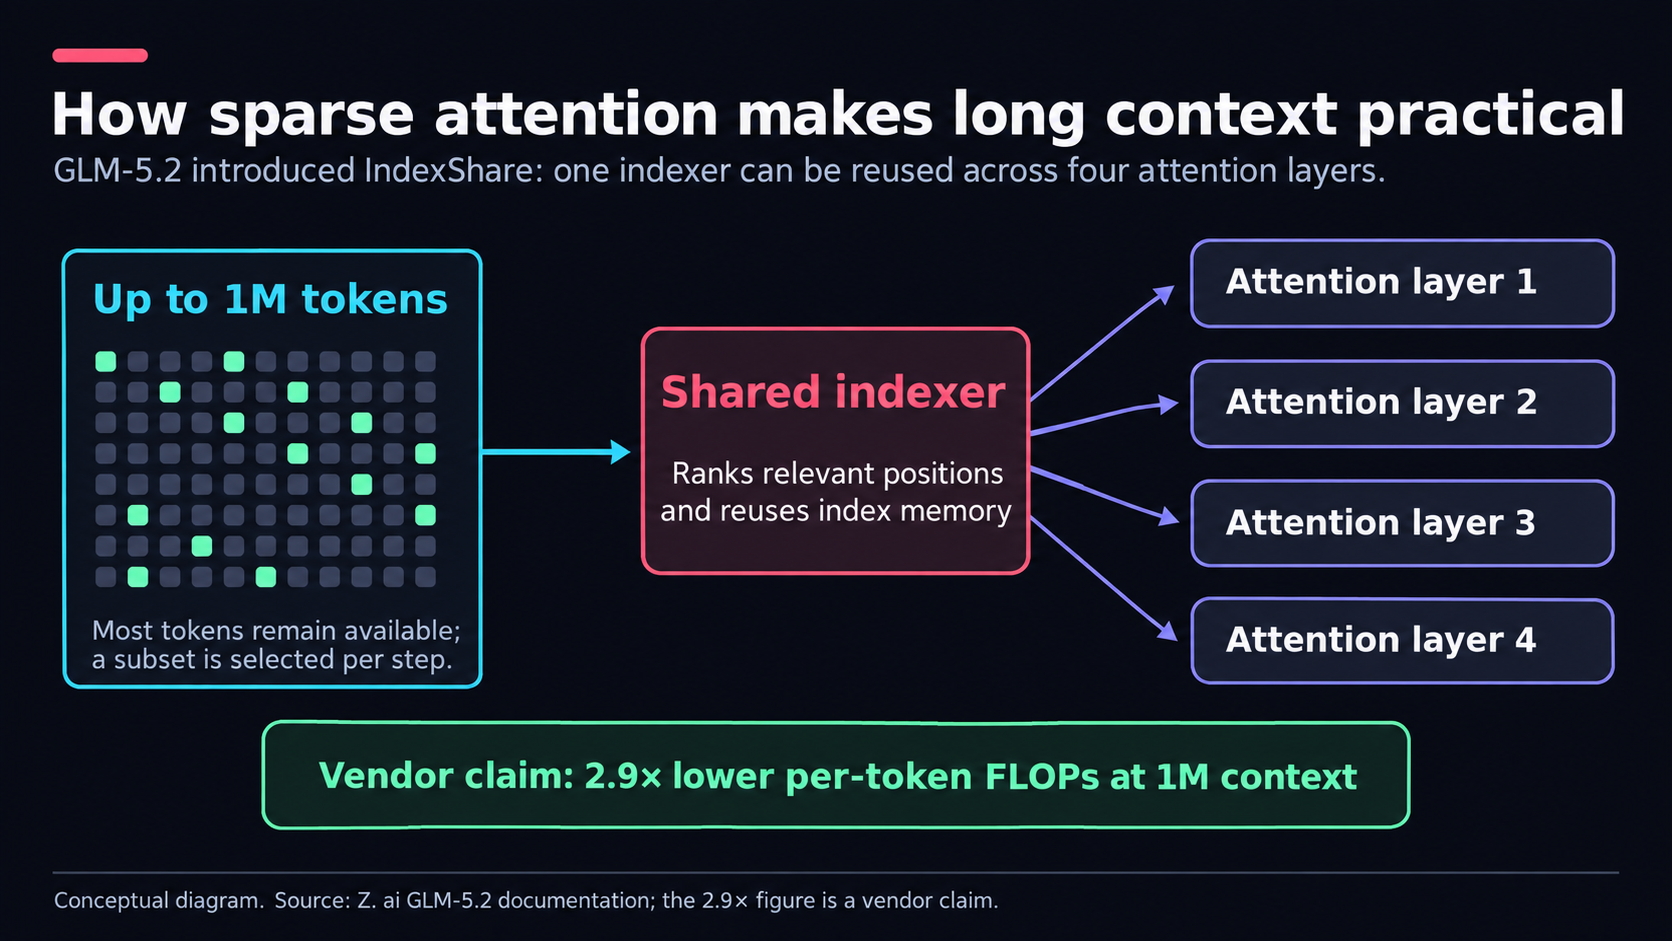
図6. IndexShareは1つのインデクサーを4つのアテンション層で再利用する。2.9倍という数字はZ.aiの主張である。
長期的な強化学習
GLM-5.3のために、Z.aiは「slime」と呼ぶ独自の非同期強化学習システムの構想を導入し、コンテキスト圧縮と合成検証器(synthesized verifiers)も併せて提供している。これらの技術は、長時間稼働時にエージェントがよく起こす典型的な失敗パターンに対応するものだ:目標を見失う、タスクを放棄する、答えを確認しないといったケースだ。それでも依然としてチェックポイントと外部テストが必要であり、それはより長い実行軌跡や、より大きな失敗トレースにつながる可能性がある。
サイバーセキュリティ能力には人間による検証が必要
セキュリティ分野の協業の一環として、Z.aiは269のオープンソースプロジェクトから2,436件の脆弱性を発見し、そのうち1,097件が中〜高の深刻度であると報告している。これらの数字は、防御的なレビューにおけるGLM-5.3の活用にとって関連性が高いと思われるが、GLM-5.3が特定するのは確定した脆弱性ではなく、あくまで「モデルによる所見(model finding)」にすぎない。
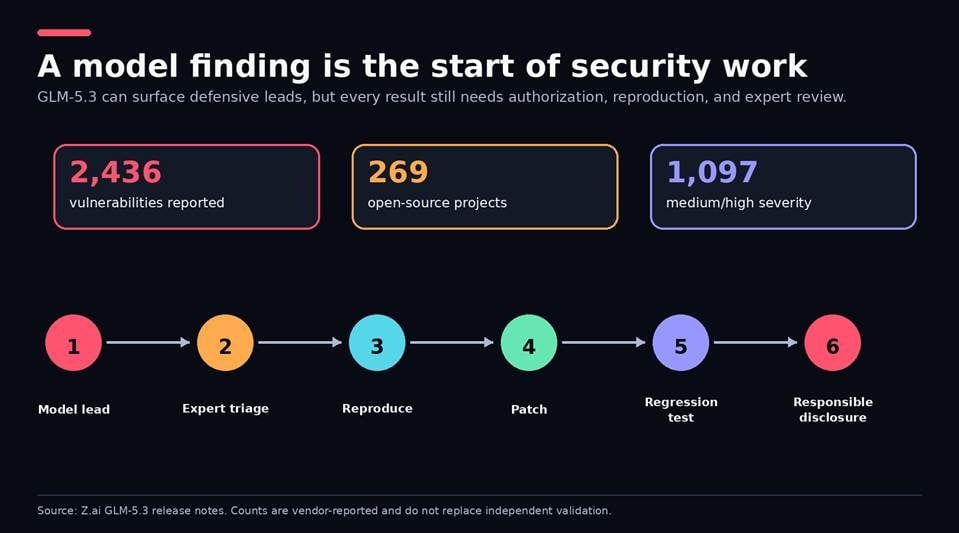
図7. 再現、修正、回帰テスト、そして責任ある形での情報開示を行うこと。テストの許可を得ていないシステムに対して、絶対にエージェントを向けてはならない。
GLM-5の価格
Z.aiは2026年9月時点で、キャッシュなし入力、キャッシュ済み入力、出力のコストをそれぞれ分けて提示している。これらの価格は公式サイトの価格ページと照らし合わせて再確認済みだが、価格は時間の経過とともに変動する可能性があるため、予算を立てる際にそのまま前提とすべきではない。
| モデル | 入力 / 100万トークン | キャッシュ済み入力 / 100万トークン | 出力 / 100万トークン |
|---|---|---|---|
| GLM-5 | $1.00 | $0.20 | $3.20 |
| GLM-5.1 | $1.40 | $0.26 | $4.40 |
| GLM-5.2 | $1.40 | $0.26 | $4.40 |
| GLM-5.3 | $1.40 | $0.26 | $4.40 |
| GLM-5.3-Flash | $0.15 | $0.03 | $0.50 |
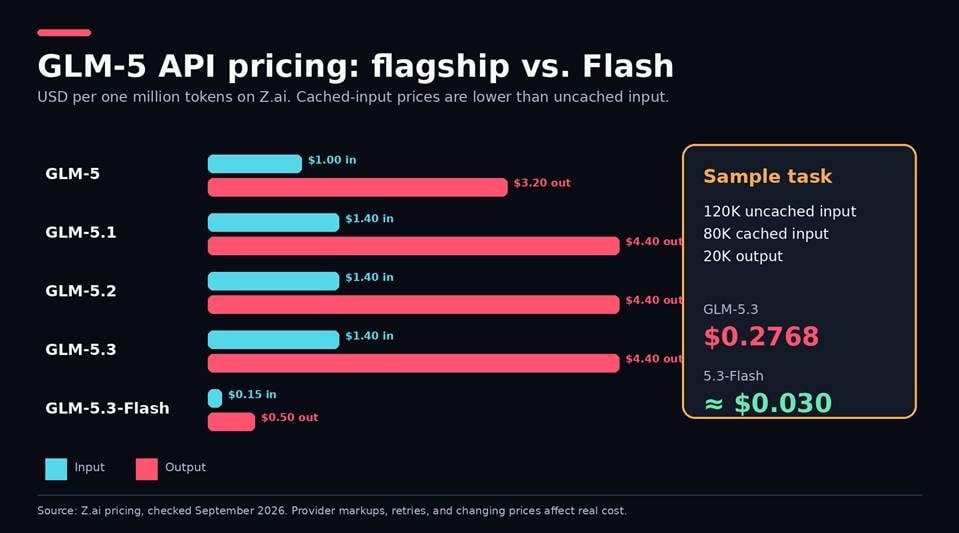
図8. Z.aiのAPI価格は、出力の長さとリトライ回数が最終的な費用を左右しうる理由を示している。
GLM-5.3のコストは、キャッシュなし入力12万トークン、キャッシュ済み入力8万トークン、出力2万トークンの場合でおよそ$0.2768。5.3-Flashの場合は(リトライを除くと)約$0.030となる。OpenRouterのような他のホストでは、異なる価格、上限、レイテンシ、ルーティングが提供されることがある。GLM Coding Planは本番用のAPIクォータではなく、対応するコーディングツール向けの別個のサブスクリプションである点に注意が必要だ。
出力部分がリクエストの中で最もコストがかかる要素であり、長時間推論を行うエージェントは、簡易な見積もりを容易に超えてしまう可能性がある。私であれば出力の上限を設定し、繰り返し使うコンテキストが条件を満たす場合はキャッシュを活用し、完了したタスクごとのコストを記録する。本番用の予算を組む際には、リトライ、失敗したツール呼び出し、そして弱い応答を修正するために人間が費やす時間も考慮すべきだ。これこそが、プロバイダー間で比較すべき本当の数字である。
GLM-5の使い方
| アクセス方法 | 最適な用途 | 推論の実行場所 |
|---|---|---|
| Z.ai Chat | 迅速な質的評価 | Z.aiのサーバー |
| Z.ai API | ファーストパーティ統合 | Z.aiのサーバー |
| OpenRouter | プロバイダー選択とフェイルオーバー | 選択したホスティングプロバイダー |
| Enter MaaS | アプリ構築ワークフロー内でのモデルアクセス | Enter内に表示されるホスト経由の経路 |
| Hugging Face + vLLM/SGLang | 自己管理型デプロイメント | 自社のインフラ |
| Ollama :cloud | Ollamaクライアント経由のリモートアクセス | リモートサーバー(あなたのノートPCではない) |
Z.ai Chatから始める
最も手間のかからないGLM-5チャットの利用方法はchat.z.aiだ。プロンプトの挙動や出力構造をテストするために活用できるが、インターフェース上に表示される具体的なモデル名には注意すべきだ。現在のアカウントクォータを確認する前に、チームに対して「無料」や「無制限」の利用を約束してはいけない。
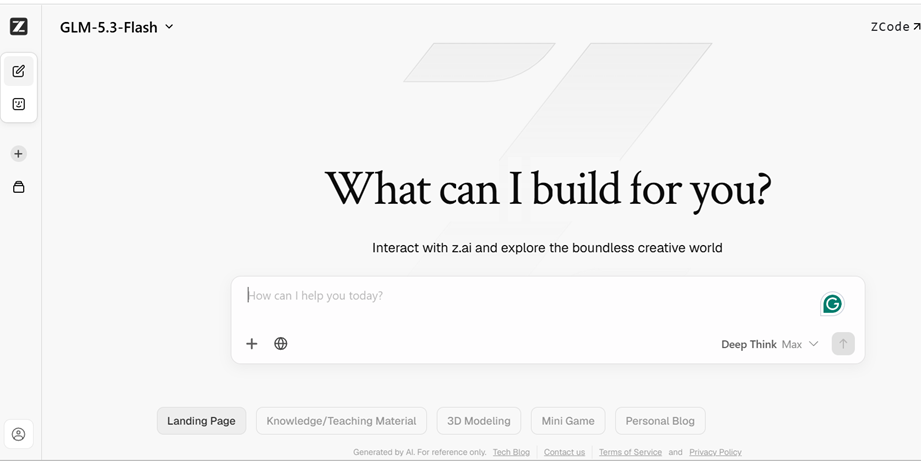
図9. チャットインターフェースは迅速な質的確認に役立つが、表示されているモデルとアカウントクォータは依然として重要だ。
Z.ai APIまたはOpenRouterを呼び出す
Z.aiはOpenAI互換のエンドポイントを提供しており、公式のPython SDKを別のベースURLで利用できることを意味する。APIキーは環境変数に保存し、モデルID、推論投入量、使用したトークン数、処理が完了したかどうかを記録しておくこと。
図10. Z.aiのOpenAI互換エンドポイントはSDKの変更を減らすが、移行時のテストを不要にするわけではない。
import os

from openai import OpenAI

client = OpenAI(

        api_key=os.environ["ZAI_API_KEY"],

        base_url="https://api.z.ai/api/paas/v4/",

)

response = client.chat.completions.create(

        model="glm-5.3",

        messages=[{"role": "user", "content": "List five tests for a password-reset flow."}],

        max_tokens=4096,

        extra_body={"thinking": {"type": "enabled"}, "reasoning_effort": "high"},

)

print(response.choices[0].message.content)
5.2から移行する際には、「thinking」を明示的に無効化しているリクエストを削除すること。GLM-5.3はそのような挙動を受け付けない。OpenRouter経由でGLM-5.3の経路を利用する場合は、ガバナンスや再現性が重要な状況において、どのプロバイダーがそのリクエストを処理したのかを記録しておくべきだ。
重みをダウンロードして自前でホストする
公式リポジトリ、またはHugging Face上で検証済みのGLM-5.3モデルカードを使用すること。Z.aiは対応するデプロイ方法としてSGLang、vLLM、Transformers、KTransformers、Unslothを挙げている。
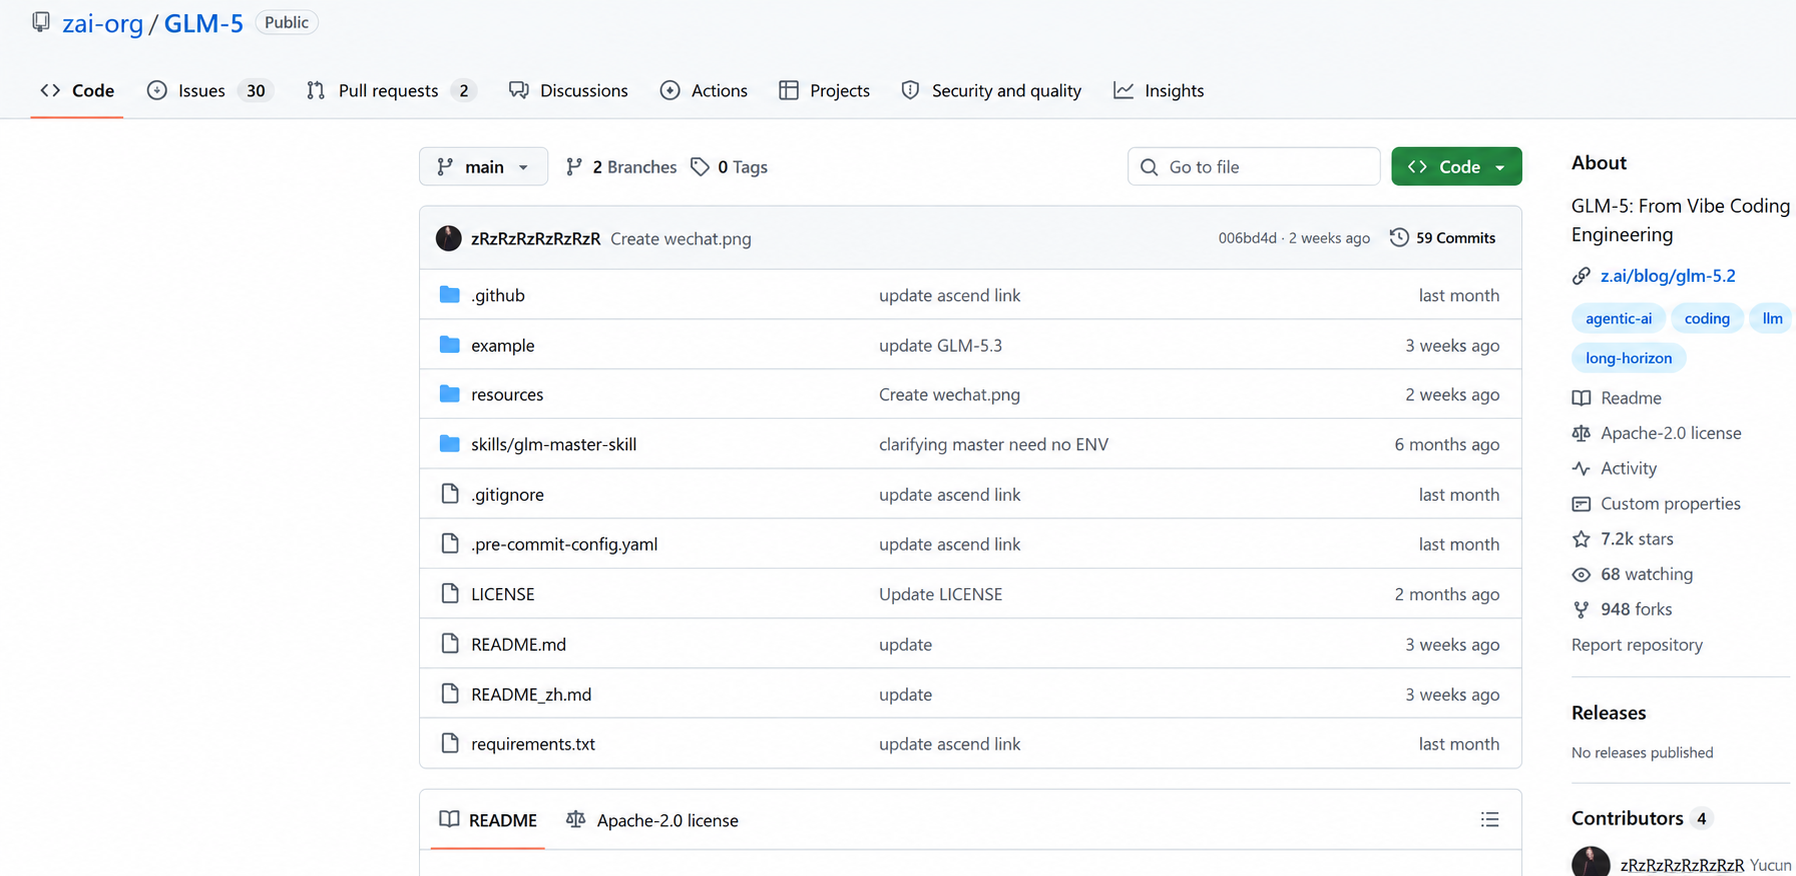
図11. 非公式の重みミラーではなく、検証済みのリポジトリと公式モデルカードを使用すること。
ダウンロード可能であることは、実行可能であることを意味しない。量子化はメモリ要件を削減できるが、品質に影響を与える可能性がある。7,440億パラメータのチェックポイントには、サーバークラスのストレージとアクセラレーターが必要だ。Ollama上のGLM-5のリストはよく読むべきだ。「cloud」というタグはリモート推論であることを示す。本当にローカルで実行するには、ローカルの重み、ローカルのランタイム、十分なハードウェアが必要となる。
本番導入前にGLM-5をどう評価すべきか
「どのモデルが一番優れているか?」という漠然とした問いから始めるべきではない。私であれば、同じツールと制限を用いて、5.2、5.3、Flashに対して4つの代表的なタスクを実行する:リポジトリ内のバグを修正する、長文ドキュメントに埋め込まれた事実情報を取得する、意図的に障害を発生させたマルチツールのワークフローを完了させる、そして文書化された評価基準に基づいて出力を生成する、という4つだ。
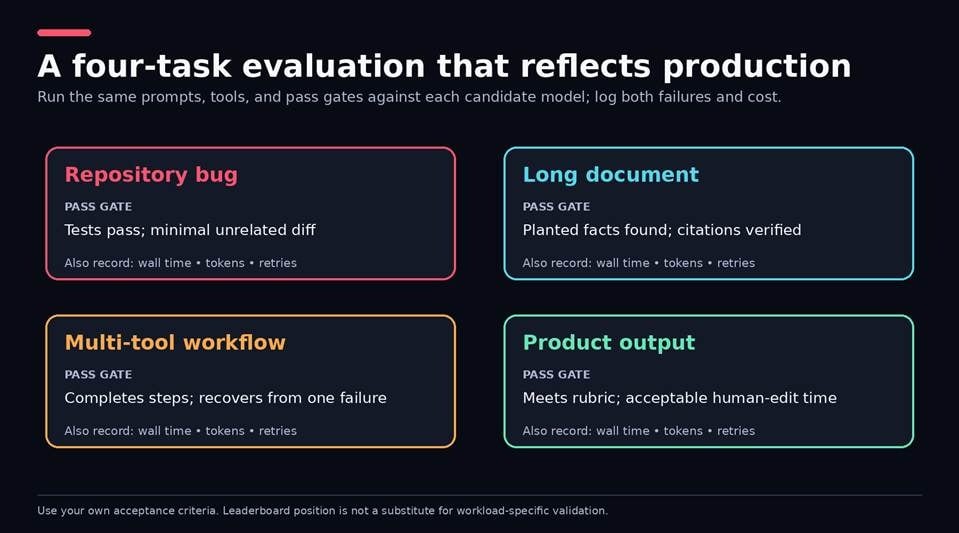
図12. 小規模で再現可能なワークロードテストは、「最も優れたモデル」という漠然とした問いよりもはるかに役立つ。
合格/不合格、実時間、トークン数、リトライ回数、人間による編集時間、そしてプロバイダー。これにより、ベンチマークの平均値だけでは見えてこない移行リスクを検出できる。例えば、5.3の常時オンの推論機能や、潜在的に長くなる出力といったリスクだ。また、Flashの低価格が実際の受け入れテストに耐えられるかどうかも明らかになる。
GLM-5は誰が使うべきか?
エージェント型コーディングとリポジトリ作業
タスクがリポジトリ検索、協調的な編集、テスト実行、ツール呼び出しを含む場合、GLM-5は優れた選択肢となる。公開されているベンチマークの証拠はこの評価を支持しているが、受け入れゲートは厳格であるべきだ:テストに合格し、差分(diff)が明確に絞られ、認証情報やネットワークの境界を一切越えないこと。独立した作業領域を用意し、最小権限の原則を適用すること。制御のない自律性を増やしても、より大きな失敗トレースを生むだけだ。
長文ドキュメントと知識作業
100万トークンのモデルは、仕様書、調査資料パッケージ、大規模なコードベースに適している。大きなコンテキストウィンドウは、信頼できる検索機能と同一視してはならない。重要な情報は文書の冒頭、中間、末尾に配置すること。出典を明記し、引用された情報を検証すること。私であれば検索パイプラインとの比較も検討する。すべてを一つの巨大なプロンプトに詰め込むより、まず有用な証拠を選別するほうが、速度とコストの両面で有利な場合があるからだ。
マルチモーダルおよび防御的なワークフロー
GLM-5.3-FlashまたはGLM-5V-Turboを使えば、スクリーンショット、インターフェースの状態、その他業務に必要な視覚的入力の処理が日常業務の一部となる。すべての発見事項は防御的セキュリティレビューの手がかりとして活用し、それらを再現してトリアージすべきだ。GLM-5は、小型のローカルノートPC向けモデルを求める人、デプロイに関する判断を下せない人、あるいはホストのデータ保管場所や保持条件を検証できない人にとっては、あまり適した選択肢ではない。
GLM-5はプライベートまたは企業データにとって安全か?
ホスト型の経路
これは単にモデルの問題ではなく、使用する経路にも依存する。Z.ai Chat、Z.ai API、他のホスト、あるいは自己管理型デプロイメントなど、さまざまなデータ経路が存在する。まずZ.aiのプライバシーポリシーから確認を始め、続いてすべての中間事業者に対して、データ保持期間、学習への利用、削除、データ保管地、契約条件を確認すべきだ。
アグリゲーターが特定のプロバイダーを指定できる場合は、それを固定すること。単に便利だからという理由で機密情報を送ってはならない。ホストされたデータがどう扱われるかは、「オープンウェイト」という言葉ではなく、契約内容と設定によって決まる。
自前ホスティング
自前ホスティングを行えば、プロンプトは自社の環境内に留まるが、重み、認証情報、パッチ適用、ネットワーク制御、監視についてはすべて自己責任となる。それでも私は、初期段階で安全でない生成コードが混入する経路は常に存在すると想定しておくべきだと考える。ビルド用と本番用の認証情報を分離し、外向きのネットワークアクセスを制限し、ツールの操作内容を監査し、重要な変更には人間の承認を維持すること。タスクに必要な権限を超えてエージェントに権限を与えてはならない。
Enter ProでGLM-5を活用する方法
GLM-5はEnter Proの直接の競合ではない。GLMがモデルとしての能力を提供するのに対し、Enter Proはモデルを取り巻くプロダクト構築ワークフローを提供する。これは、単に「補完結果を得る」だけではなく、「インターフェース、ロジック、公開への道筋に変換可能な補完結果を得る」ことを求めている場合に役立つ。
API制御、カスタムインフラ、特定のデータ構造が必要な場合は、直接利用する経路がより良い選択だ。プロダクトレベルでの回避策が制約要因になった時こそ、Enter Proが力を発揮する。そのAI MVP Builderは、企画、アプリ作成、ビジュアル編集、公開を一つのプロセスに統合し、Enter Codeはリポジトリ作業に向けたターミナル中心のアプローチを提供する。
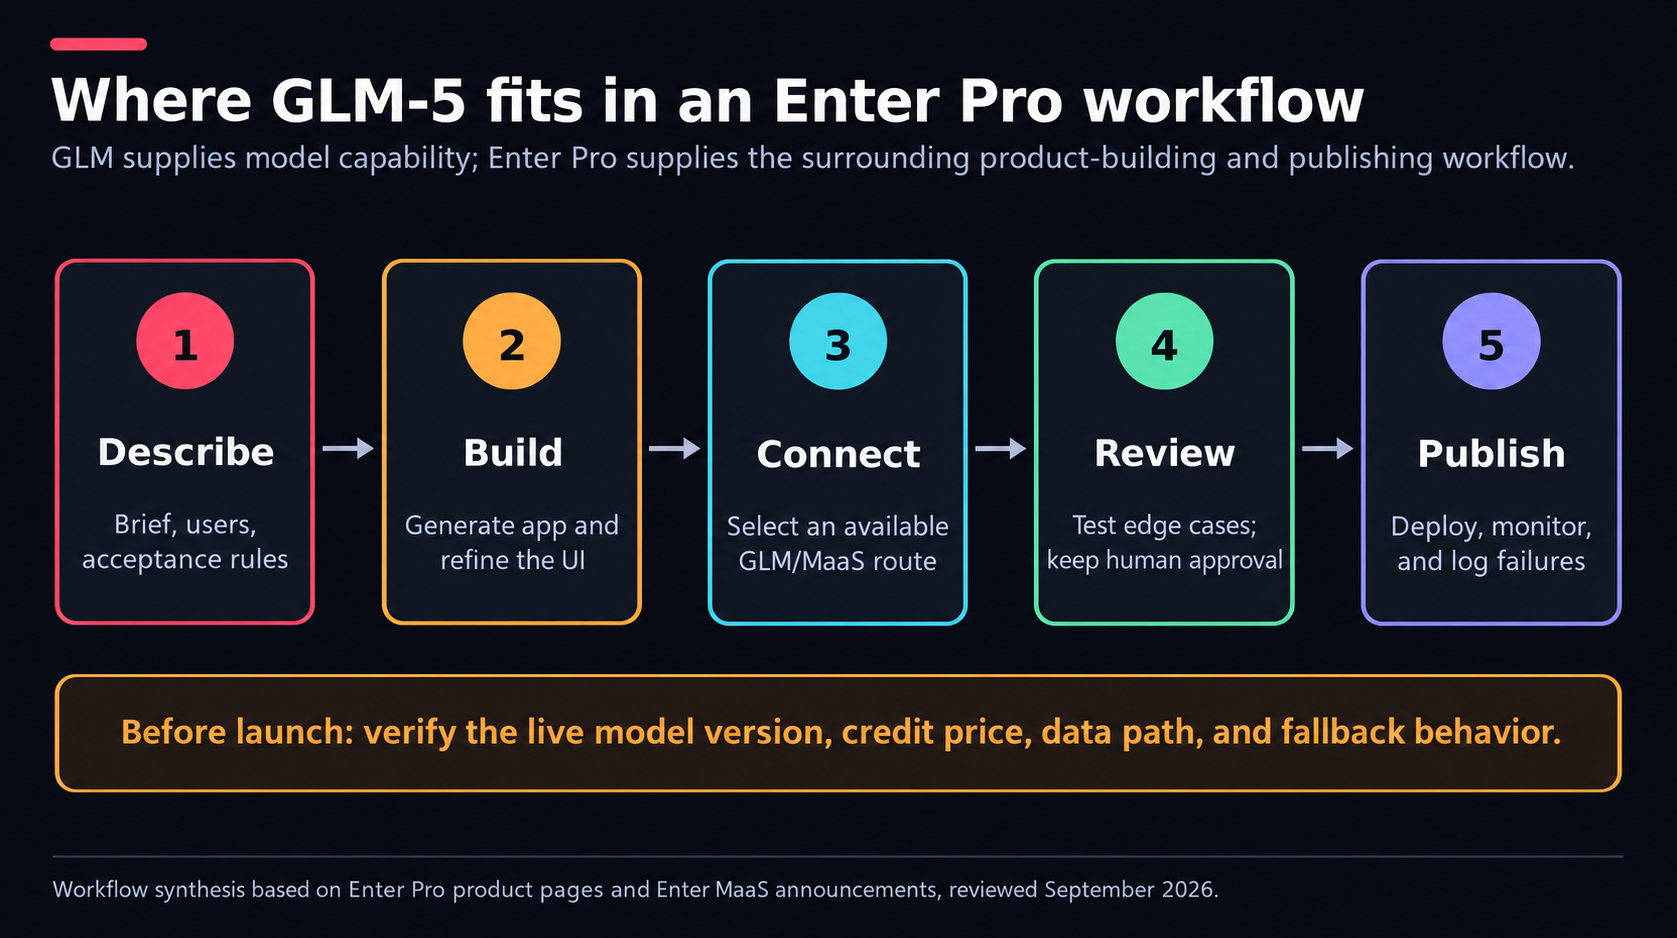
図13. モデルは生成または分類を担い、プロダクトワークフローがUI、レビュー、デプロイ、監視を追加する。
Enterの変更履歴は、6月17日時点の以前のAI Allカタログにおいて、GLM-5.2の存在を確認している。Enter MaaSの発表ではGLM 5について触れられ、モデルがクレジットでどのように価格設定されるかが説明されている。GLM-5.3を明確に確認する内容ではないため、特定のバージョンを前提に設計する前に、最新のモデルセレクター、クレジット価格、コンテキスト上限、データ経路を必ず確認すべきだ。
サポートのトリアージ用アプリは、この組み合わせが有効な典型例を示している。Enter Proを使えば、チケットフォームとダッシュボードを設計し、既存のGLM経路を接続してチケットの分類と返信文の作成を行うことができる。公開前には、モデルの空の応答、曖昧なリクエスト、多言語入力、プロンプトインジェクション、メッセージ本文内のプライベートデータを検証すべきだ。ドラフトと送信ボタンの間には、常に人間を介在させること。
| 優先事項が…なら | 直接GLM経路を選ぶ | Enter Proを選ぶ |
|---|---|---|
| モデルのパラメータとプロバイダー制御 | はい | 公開されたオプション内のみ |
| ビジュアルなアプリ作成と編集 | 別途ツールを構築または追加する必要がある | ワークフローの中核的な優位性 |
| カスタムホスティングとネットワークポリシー | 最も適している | まずプラットフォームの適合性を確認すべき |
| モデル出力からプロダクトUIへの迅速な道筋 | より多くのエンジニアリングが必要 | より適している |
ただし、Enterを使ってもGLMそのものが賢くなるわけではなく、GLMがアプリにアクセスできること自体も、そのコーディングエージェントを賢くするわけではない。統合やUI開発が目的であれば、私はEnterを選ぶ。もしそのような状況にあるなら、アーキテクチャを決める前にEnter Proワークスペースを開き、現在のモデルカタログを確認してほしい。
まとめ
GLM-5という名前ではあるが、コーディングと長期的なエージェントタスクに関して言えば、どのバリエーションを使い、どのように提供されるかは、モデル自体と同じくらい重要だ!難易度の高いテキストとコードにはGLM-5.3を、マルチモーダルや大量処理にはGLM-5.3-Flashを使い、移行がコスト面で見合うようになるまでは5.2を維持すること。その後、業界リーダーやベンダーの数値を本番環境の根拠として使う前に、必ず自分自身のタスクでテストすべきだ。
実際に機能するのは、あなたの受け入れ基準を満たし、レイテンシとプライバシーの許容範囲内に収まり、リトライを経た後でも適正な価格を維持できるモデルだ。それは、ある特定のベンチマークでほぼ完璧な点数を獲得したかどうかとは無関係である。
よくある質問
GLM-5は無料ですか?
公開された重みはトークンごとのAPI費用なしでダウンロード可能だが、ハードウェアと運用には費用がかかる。Z.ai Chatはクォータ制のアクセスを提供している場合がある。ホスト型API、ルーター、GPUサーバーは有料サービスであり、バージョンと経路によって差が生じる可能性がある。
GLM-5のどのバージョンが優れていますか?
難易度の高いテキスト/コーディング作業には、GLM-5.3から始める。画像、スクリーンショット、コスト重視の大量処理には、GLM-5.3-Flashが最初のテストに適している。既に検証済みで、移行のリスクが潜在的なメリットを上回る場合は、GLM-5.2を変更する必要はない。
GLM-5はコードを書いたりデバッグしたりできますか?
できる。コーディングエージェントとリポジトリ規模のエンジニアリングは主要な用途であり、Terminal-BenchとDeepSWEにおいてベンダーから良好な結果が報告されている。それでもサンドボックス、テスト、制限された権限、そして人間によるレビューは依然として必要だ。
GLM-5のAPI料金はいくらですか?
2026年9月時点で、Z.aiはGLM-5を入力$1.00、出力$3.20(100万トークンあたり)、GLM-5.3を$1.40と$4.40、5.3-Flashを$0.15と$0.50と提示している。キャッシュ済み入力はより安価だ。実際のコストは、プロバイダーのマークアップとリトライ回数によって影響を受ける。
GLM-5はオープンソースソフトウェアですか?
「オープンウェイト」という表現がより正確だ。重みのライセンス、リポジトリコードのライセンス、学習データの透明性は、それぞれ別個の問題だ。商用デプロイの前には、Hugging Face上の該当モデルカードとリポジトリのライセンスを必ず確認すること。
GLM-5はローカルで(Ollamaを使って)利用できますか?
ローカルの重み、ランタイムのサポート、十分なハードウェアを備えている場合に限り可能だ。cloudタグは、リモートインフラ上で実行されていることを意味するため、必ずしも7,440億パラメータ全体があなたのデバイス上で動作しているわけではない。
GLM-5は画像を処理できますか?
ベースのGLM-5とGLM-5.3はテキスト専用だ。マルチモーダル入力には、GLM-5.3-FlashまたはGLM-5V-Turboを使用し、選択したエンドポイントで対応ファイル形式を確認すること。





