マルチエージェントシステムとは:AIワークフローの構築・テスト・公開
マルチエージェントシステムの仕組みと活用場面を解説。アーキテクチャやフレームワーク、実例、導入のポイントまで紹介します。
リサーチ、執筆、ファクトチェックにおいて、単一のAIエージェントは容易に方向性を失い、不正確な結果を出してしまうことがあります。専任のエージェントに責任を分割することで、より信頼性の高いワークフローを構築できました。これは、連携するAIエージェントによるマルチエージェントシステムを使うことで実現できます。本ガイドでは、こうしたシステムの仕組み、使うべき場面、構築方法を解説します。さらに、実際にリサーチシステムを構築した経験、ローカル導入の手順、実際のリスク、ワークフローをアプリケーションへと変える方法についても紹介します。早速始めましょう!
マルチエージェントシステムとは?
マルチエージェントシステムとは、同じ環境に存在し、単一または複数の目標を達成できる自律エージェントの集合です。これらのエージェントは独立して動くのではなく、互いの活動を調整し、情報を共有し、複雑な目標を達成するために計画を修正します。リサーチ、分析、実行を担う専門家たちが同じ成果に向かって協力するプロジェクトチームを想像してみてください。IBMによれば、エージェントが単に他のエージェントを呼び出すだけでは、本当のマルチエージェントシステムとは言えません。各エージェントは、他のエージェントの目標、記憶、計画を考慮します。AIエージェントは計画を立て、ツールを使い、記憶を更新します。これは単なるLLMとは異なる点です。
AIにおけるマルチエージェントシステム:その仕組みとは?
AIにおけるマルチエージェントシステムは、それぞれ特定のタスクを実行するように設計された複数の異なるエージェントで構成され、これらのエージェントが連携して共通の目標を達成します。これは4つの基本要素、すなわちエージェント、環境、通信プロトコル、調整メカニズムから成り立っています。各エージェントは情報を感知し、LLMを使って推論し、その情報に基づいて行動し、他のエージェントと通信します。ワークフローはオーケストレーターによって管理され、ツールが実行を支え、共有メモリがコンテキストを保持します。エージェント間の通信については、FIPA ACLやKQMLといった初期の標準規格が存在します。
シングルエージェント vs. AIマルチエージェントシステム:判断ガイド
AIでワークフローを効率化したいが、エージェントを1つにするか複数にするか迷っていませんか?シングルエージェントとマルチエージェントシステムの違いを理解することが重要です。チームによっては、エージェントが多ければ多いほど成功すると考えがちですが、必ずしもそうとは限りません。
- アーキテクチャの主な違い
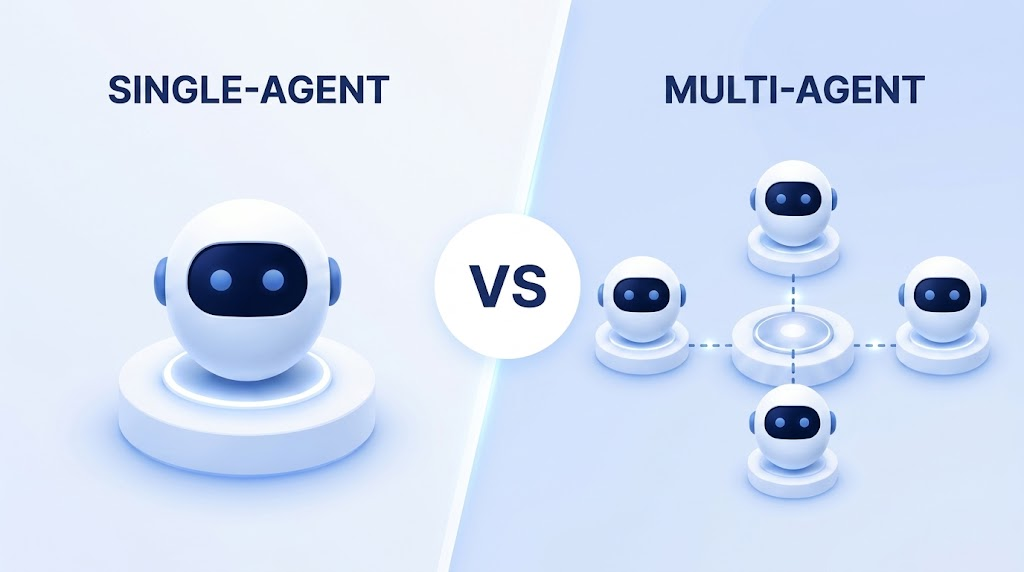
シングルエージェントは、1つのモデルと1セットのツールを備え、1つのコンテキスト内で一連のタスクを最初から最後まで実行します。マルチエージェントシステムは、作業を複数の専門エージェント(プランナー、リサーチャー、レビュアーなど)に分割し、明確に定義された引き渡しを通じて互いに連携します。
- シングルエージェントが最も効果を発揮する場合
文書の要約、サポートへの質問対応、コンテンツ執筆など、特定の逐次的なタスクには1つのエージェントで対応しましょう。コストが低く、応答性が高く、デバッグが容易で、失敗のリスクも低いだけでなく、プロトタイプや特定のワークフローには最適です。
- マルチエージェントシステムが適している場合
マルチエージェント構成は、深いリサーチ、大規模なコード変更、複数ステップのビジネスプロセスなど、複雑・並列・複数領域にわたるタスクに非常に適しています。専門エージェントは小さなコンテキストを維持し、並列実行を可能にし、コンテキストを個別にレビューできるため、精度が向上します。
- コスト、レイテンシ、複雑さのトレードオフ
複数のエージェントは、それぞれが独自のコンテキストを持ち、他のエージェントとも通信する必要があるため、はるかに多くのトークンを消費します。また、レイテンシ、オーケストレーションロジック、エラー伝播のリスクも増加します。これらのオーバーヘッドを、タスクに本当に必要な品質向上と比較検討してください。
まずはシングルエージェントから始めて、パフォーマンスを測定しましょう。コンテキストの限界、ツールの過負荷、精度のギャップが現れたときにのみ、複数エージェントへ移行してください。タスクの複雑さ、並列性、予算、モニタリング能力に基づいて評価し、自信を持って持続的にスケールしましょう。
アーキテクチャ、フレームワーク、最適な使用例を一覧表で紹介
| アーキテクチャ | 仕組み | 最適な使用例 | フレームワーク例 | 評価 |
|---|---|---|---|---|
| 集中型 | 1つのコントローラーが計画、委任、結果の統合を行う。 | カスタマーサービス、医療(監査可能性が重要)。 | LangGraph | 最も制御しやすいが、事前の設計が必要で単一障害点がある。 |
| 分散型 | エージェントがマスターエージェントなしでピアツーピアで対話する。 | ブレインストーミング、コードレビュー、オープンエンドなリサーチ。 | AutoGen | 柔軟だが、ループや脱線が起こりやすく、コストが予測しづらい。 |
| 階層型 | マネージャーが目標をサブチーム向けのサブゴールに分割する。 | サプライチェーン、金融(分析→リスク→コンプライアンス)。 | CrewAI | 役割ベースのチームを最速で機能させられるが、複雑な分岐には不向き。 |
| ホロニック/連合型(学術的) | 入れ子構造のエージェント群(ホロニック)または一時的なタスク連合(連合)。 | 製造業、動的なリソース配分。 | 研究用プロトタイプ | 理論上は優れているが、LLMでは本番稼働に至ることは稀。 |
研究用マルチエージェントシステムの構築事例
目的は、トピックに関するリサーチを自動化し、構造化され検証済みデータに基づく正確な要約を生成することでした。そのために、マルチエージェントのリサーチシステムを開発し、ワークフローを専門化された役割に分割しました。各エージェントは特定のタスクを担当し、その結果を次のエージェントに伝達します。
ステップ1:エージェントの役割を定義する
計画から最終レビューまでのリサーチプロセスを管理するために、6つのエージェントを設計しました。
| エージェント | 役割 | 受け取り・引き渡す内容 |
|---|---|---|
| プランナー | トピックをリサーチ課題に分解し、タスクを割り当てる。 | トピックを受け取り、リサーチ計画を引き渡す。 |
| リサーチャー | 信頼できる情報源から関連情報を見つける。 | リサーチ課題を受け取り、引用付きの調査結果を引き渡す。 |
| ファクトチェッカー | 主張を信頼できる情報源と照合して検証する。 | 調査結果を受け取り、検証済みの主張と修正を引き渡す。 |
| ライター | 検証済みの情報を一貫した要約に変換する。 | 検証済みのメモを受け取り、構造化された草稿を引き渡す。 |
| レビュアー | 明瞭さ、一貫性、完全性を確認する。 | 草稿を受け取り、フィードバックまたは承認を引き渡す。 |
| オーケストレーター | エージェントの実行とタスクの引き渡しを管理する。 | 進行状況を追跡し、エージェント間で出力を振り分ける。 |
ステップ2:ワークフローを接続する
オーケストレーターが各ステージを調整し、共有メモリがリサーチノート、ソースリンク、完了したタスクを保存します。この設計により、各エージェントはリサーチ手順を繰り返す必要がなく、与えられたタスクに集中できます。
ステップ3:構築から得た教訓を反映する
開発中に、ワークフローを改善する3つの実践的な教訓を発見しました:
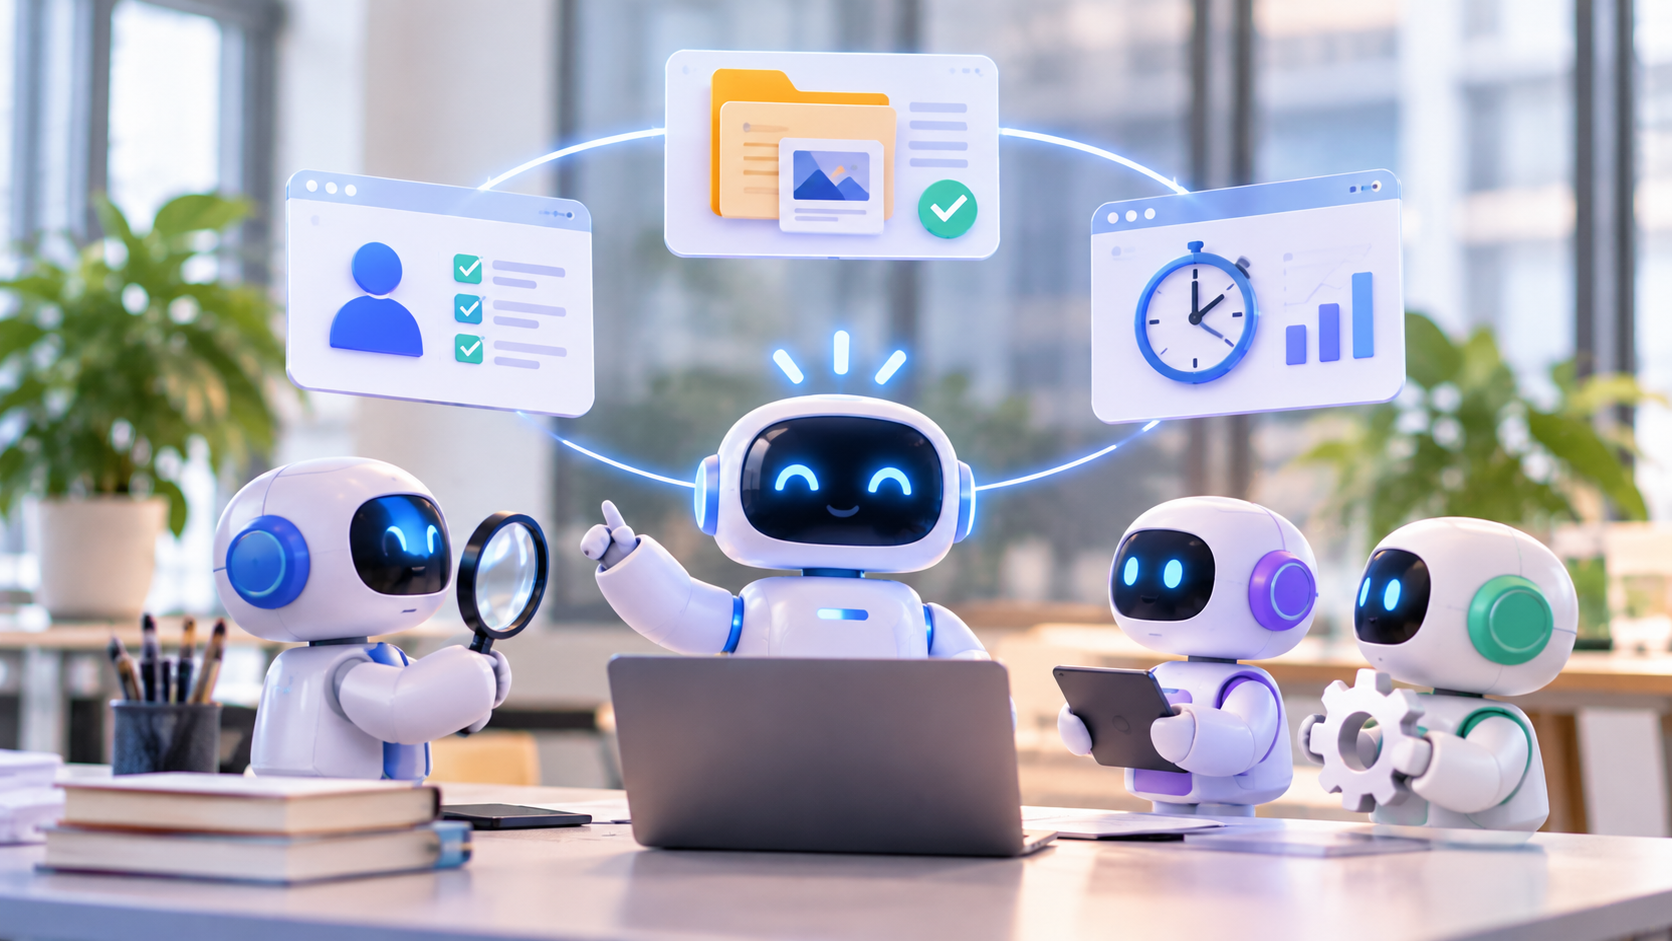
- ロールプロンプトは狙いを絞る: 各エージェントに明確な1つの役割、具体的な出力要件、定義された完了基準を与えましょう。
- 共有メモリを維持する: リサーチ結果とソースURLを1つの共有ファイルに保存し、重複検索を減らしコンテキストを保持しましょう。
- エージェントのターン数を制限する: 不要な処理を防ぎコストを管理するため、やり取りと再試行の最大回数を設定しましょう。
ステップ4:結果を正直に測定する
同じリサーチトピックと品質要件を使って、従来の手動プロセスと自動化プロセスを比較しました。
| 指標 | 手動ワークフロー | マルチエージェントワークフロー |
|---|---|---|
| リサーチ時間 | 60分 | 20分 |
| 要約1件あたりのコスト | $0.50 | $0.30 |
| 検証済みの主張数 | 20件 | 20件 |
これらの値は、自分の実行結果に置き換えてください。公正な比較を行うには、同じタスク範囲、検証基準、コストの前提条件を記録しましょう。
ステップ5:協調の失敗を修正する
初期の失敗の一つは、2つのエージェントが互いに追加情報を求め合ったことでした。これにより不要なループが発生し、完了プロセスが遅くなりました。これは、引き渡し条件、再試行回数を明確に定義し、エージェントに構造化された出力を返すことを要求することで解決しました。あるエージェントが基準を満たした時点で、オーケストレーターはワークフローの次のステージに進みます。
最大の教訓: マルチエージェントのリサーチシステムを成功させるには、明確な役割分担、信頼できる共有コンテキスト、制御された協調が必要であり、単にエージェントを増やすだけでは不十分です。
マルチエージェントAIシステムをローカルで構築する方法
マルチエージェントAIシステムをローカルで実行できることで、プライバシー、コスト、実験に対する管理がより効きます。クラウドサービスを完全に使わずに、さまざまなモデル、エージェントの役割、ワークフローをテストできます。ただし、導入には適切なハードウェア、十分なオーケストレーション、正確なモニタリングが必要です。始めるための6つのステップを紹介します。
ステップ1:ローカルモデルランタイムを選ぶ
Ollamaなどのローカルモデルランタイムを使いましょう。対応する言語モデルをダウンロードしてローカルで実行できます。モデルを選ぶ前に、リサーチマシンの互換性と必要なメモリ量を確認してください。
ステップ2:エージェントフレームワークを選ぶ
エージェントの連携とタスク管理を支えるフレームワークを選びましょう。例としてLangGraph、CrewAI、AutoGenなどがあります。決定する前に、オーケストレーション、統合、複雑さの観点から何を提供しているか確認してください。
ステップ3:エージェントの役割を定義する
計画、リサーチ、ファクトチェック、執筆といった特定の業務を特定の専門エージェントに割り当てます。作業の重複を避けるため、それぞれの入力、出力、引き渡し基準を定義しましょう。
ステップ4:ツールへのアクセスを追加する
検索API、データベース、文書リーダー、コード実行環境などの必要なツールとエージェントを統合します。アクセスを制限し不要な操作を最小限にするため、権限と検証のルールを使いましょう。
ステップ5:Dockerでコンテナ化する
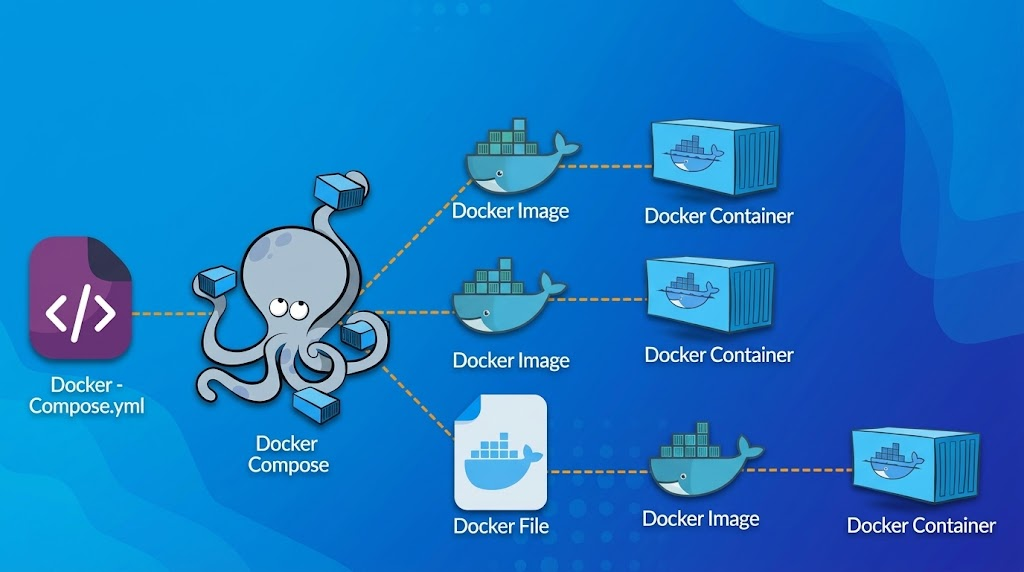
アプリケーション、その依存関係、設定をDockerでパッケージ化します。統一した導入のために、ネットワーク、ストレージ、環境変数、リソース制限を設定しましょう。
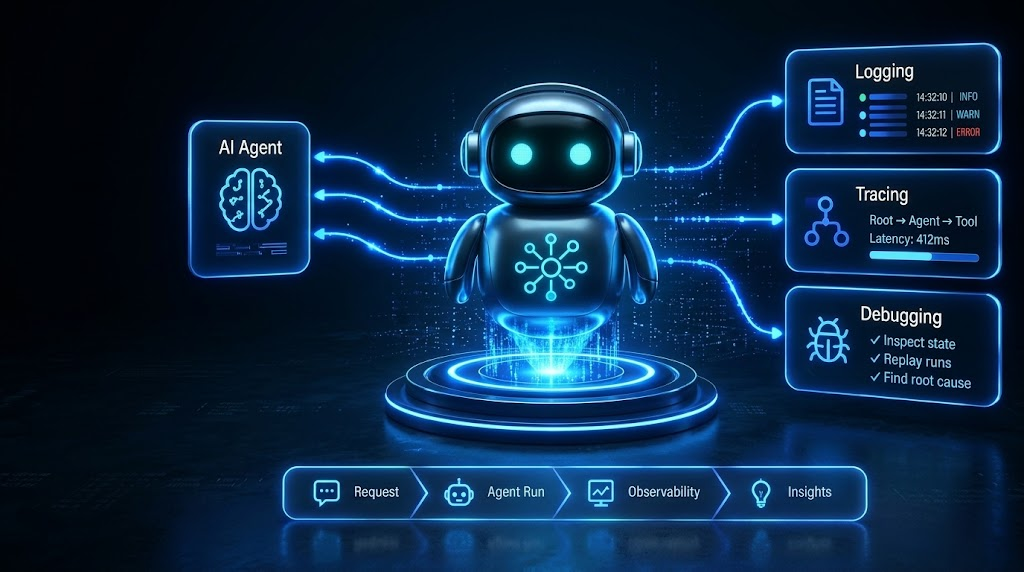
ステップ6:ログとトレーシングを追加する
エージェントの動作、ツールの使用状況、エラー、実行時間のログ記録を有効にしましょう。必要となるハードウェアの量は、モデルのサイズ、量子化、同時実行されるワークロードによって異なります。小さいモデルは必要なリソースは少なくなりますが、信頼性が低く、推論でミスをする可能性が高くなります。重要なコツの一つは、より強力なモデルで計画を立て、単純なタスクにはより軽いモデルを使うことです。
Enter Proでエージェントワークフローを使える製品に変える
リサーチエージェントをターミナル上で動かせるようになった後、実際のユーザー向けにシンプルなインターフェースを提供する必要がありました。そこで役立ったのがEnter Proです。フロントエンドを手作業で構築することなく、初期プロトタイプを作成できました。このプラットフォームはAIを活用して、最小限のコーディングでパーソナライズされたウェブサイトやアプリケーションを作成します。アイデアの検証、MVP、小規模な本番サイトをテストする際に非常に便利です。ランディングページ、フォーム、またはエージェントパイプラインの結果を表示するダッシュボードを作成できます。さらに、アイデアをテスト可能なアプリケーションへと変える過程を加速するAI MVPビルダーも搭載されています。詳しく見ていきましょう!
| コンポーネント | CTAボタン |
|---|---|
| Web.Text | 今すぐウェブサイトを作成 |
| Web.Href | https://enter.pro/workspace/ |
エージェント駆動型プロダクトにおけるEnter Proの実用性
- AIによるアプリ・ウェブサイト作成
Enter ProのAIウェブサイトビルダーは、アイデアを機能するアプリケーションへと変える手助けをします。すべてのコンポーネントを手作業でコーディングする代わりに、要件を記述するだけです。これにより、初期のプロダクト開発とテストが簡単になります。
- 複数のAIモデルから選択可能
GPT-5.4とClaude Opus 4.7は、それぞれ異なるモデルの選択肢を提供します。さまざまな開発タスクに対する出力を比較できます。このアプローチは、個々のエージェントに特化したモデルを選ぶのと似ています。
- ビジュアル編集とカスタマイズ
Enter Proのビジュアルエディタでは、レイアウトやコンテンツを視覚的に調整できます。コードを編集せずに、テキスト、セクション、デザイン要素を調整できます。これにより、開発中のインターフェース改善が容易になります。
- ソースコードへの完全なアクセス
Enter Proは、アプリケーションのソースコードへのアクセスを提供します。エクスポートして他の場所で自前のホスティングをすることも可能です。これにより、導入の柔軟性が高まり、1つのプラットフォームへの依存が軽減されます。
動くエージェントから実際に使えるプロトタイプまで、3ステップ
ステップ1:ユースケースを記述する
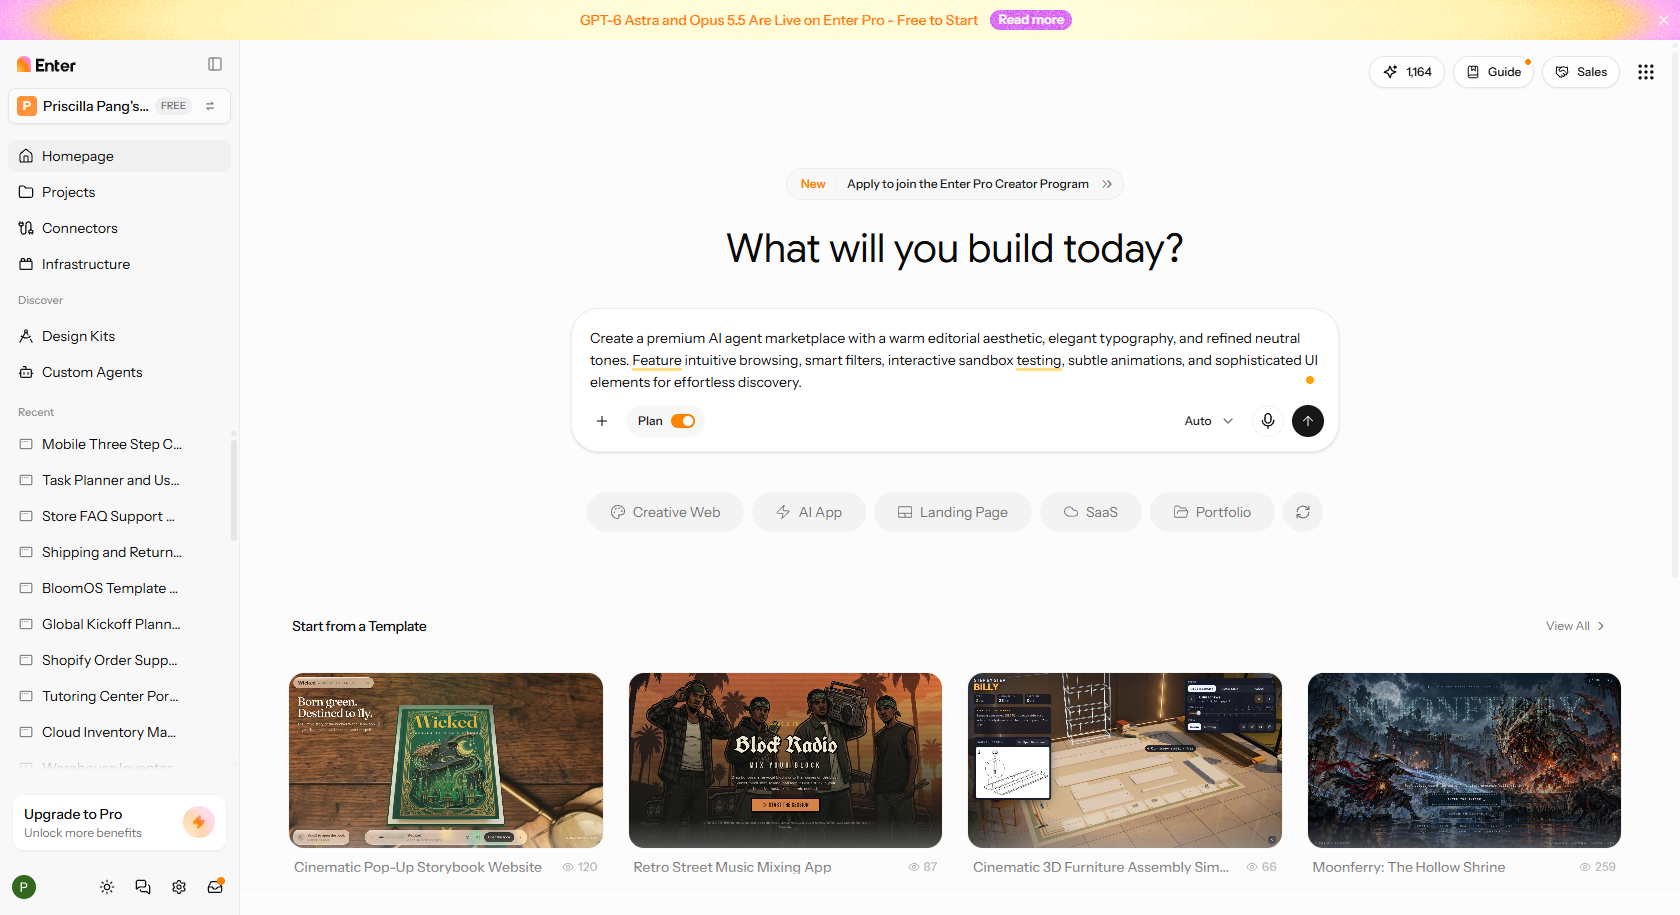
マルチエージェントシステムとその目的を説明する詳細なプロンプトを書くことから始めましょう。タスク、対象ユーザー、エージェントの役割、期待される出力を明記します。必要なツール、コミュニケーションのワークフロー、望ましいインターフェース要素も含めましょう。指示が準備できたら、**「Generate」**をクリックして初期プロトタイプを作成します。次に進む前に、提案された構造を確認してください。
ステップ2:インターフェースを形作る
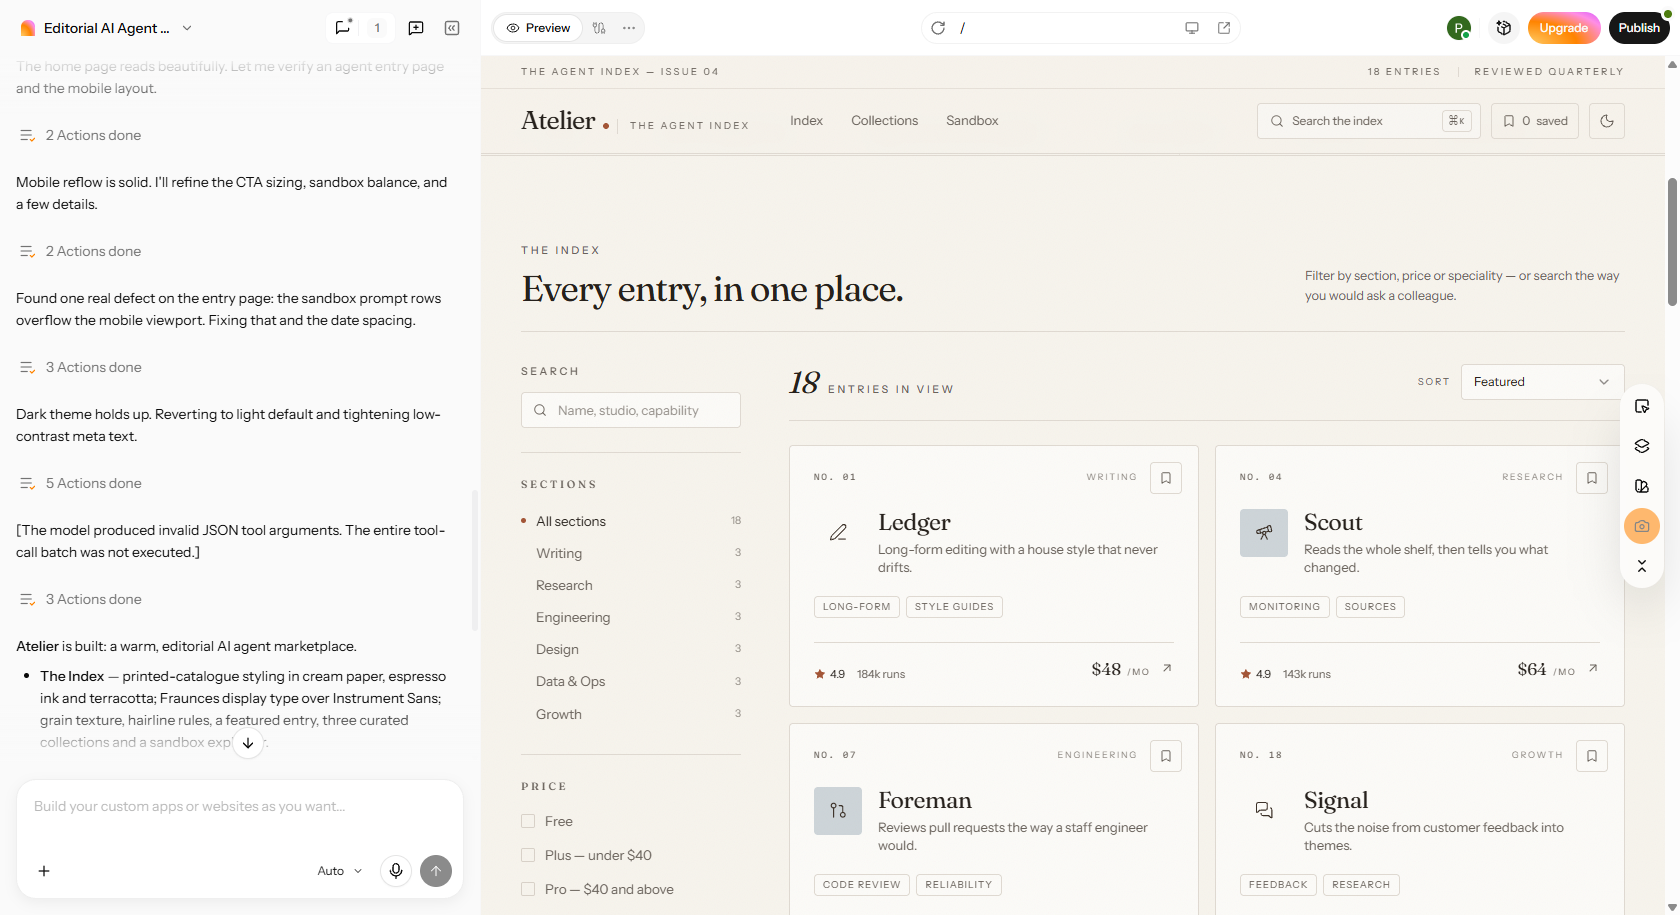
初期プロトタイプを確認し、「Build Now」を選択してアプリケーションを開発します。「Preview」タブを開き、レイアウト、ナビゲーション、エージェント間のやり取り、ワークフローの可視化を確認しましょう。インターフェースが意図したユースケースをサポートしているか確認してください。
ステップ3:公開してフィードバックを集める
エージェントが正しく通信し、割り当てられたタスクを完了することを確認するため、アプリケーションをテストしましょう。ツール統合、出力の精度、エラー処理、全体的な使いやすさを確認します。すべてが期待通りであれば、「Publish」を選択してプロトタイプを公開します。初期ユーザーからフィードバックを集め、ワークフローの問題を特定し、機能を拡張する前に改善を行いましょう。
リスクとその軽減方法
マルチエージェントAIシステムは自動化を強化する一方で、実際の課題も引き起こします。導入前にこれらのリスクを特定し、軽減策を講じましょう。
- コスト管理:エージェントが増えるほど、トークンとコストも増加します。繰り返しの結果を導入・キャッシュし、トークンの予算を定義しましょう。コストを抑えるために、複雑でないタスクにはより単純なモデルを使いましょう。
- ハルシネーション:エージェントは、真実でない、または根拠のない情報を述べることがあります。出力を確認するファクトチェッカーを用意しましょう。ソースに基づかない回答は受け入れず、裏付けのない情報にはフラグを立てましょう。
- セキュリティリスク:過度に広いツール権限は、機密データの流出につながる可能性があります。最小権限アクセスを実装し、エージェント間の通信を検証しましょう。信頼できないソースからのプロンプトインジェクションに対して防御しましょう。
- デバッグの難しさ:エージェントが相互作用すると、エラーの発生箇所を見つけるのが難しくなります。すべてのエージェントのメッセージ、ツール呼び出し、結果を記録しましょう。トレーシングツールを使って、障害を見つけ、ワークフローの挙動を理解しましょう。
- 協調の複雑さ:エージェントは同じことを何度も繰り返したり、予測不能な動作をすることがあります。明確な役割、通信ルール、停止基準を設定しましょう。実行を容易にするため、不要な引き渡しを過度に増やさないようにしましょう。
| コンポーネント | CTAボタン |
|---|---|
| Web.Text | 今すぐウェブサイトを作成 |
| Web.Href | https://enter.pro/workspace/ |
まとめ
成功するマルチエージェントシステムを作る最初のステップは、その目標、役割、通信プロトコルを定義することです。大規模なワークフローにすぐ飛び込むのではなく、まずは精度、実行時間、コストを測定しましょう。MASプランニングチェックリストを活用して、エージェントの役割、ツール、プロトコル、セキュリティ対策、モニタリングの必要性を整理してください。Enter Proのようなツールを使えば、動作するエージェントのプロセスをアプリケーションに変えることもできます。一度に10個のエージェントから始めるのではなく、まずは2つのエージェントが連携する形でテストし、測定可能な改善があり、複雑さが正当化される場合にのみエージェントを追加しましょう。Enter Proを試して、エージェントを使った開発を簡単に始めましょう!
マルチエージェントシステムに関するFAQ
マルチエージェントシステムは従来のAIとどう違うのか?
従来のAIでは、単一のモデルまたはアルゴリズムが特定の機能を実行するために使われます。一方、マルチエージェントシステムは、特定のタスクを持つ複数の自律エージェントを連携させます。これらのエージェントは通信し、情報を共有し、動的に行動を調整します。これは複雑なワークフローに役立ちますが、協調にかかるコストと実行時間が増加します。
AIにおけるマルチエージェントシステムの活用例は?
マルチエージェントシステムは、ソフトウェア開発、サプライチェーン管理、カスタマーサービス、金融、医療、研究などで使われています。不正検知、情報の検証、コーディング、在庫計画はすべて、専門化されたエージェントによって行われます。Enter Proは、企業向けの申請フォームや結果ダッシュボードなど、エージェント駆動型アプリケーションのインターフェース作成にも利用できます。
AIマルチエージェントシステムを信頼性があり拡張性のあるものにする要因は?
構造化された通信、明確なエージェントの責任分担、継続的な評価がシステムの信頼性を高めます。専用の検証エージェント、ソースに基づいた出力、追跡可能な実行ログを実装しましょう。他のシステムを更新する操作は、読み取り中心の操作よりも拡張が難しくなります。Enter Proは、検証済みのエージェントワークフローをテスト可能なアプリケーションへと変える際に役立ちます。
マルチエージェントAIシステムをノートPC上でローカルに導入できるか?
はい、Ollama、LM Studio、またはAppleのMLXを使って、ローカルなマルチエージェントシステムを導入できます。モデルのサイズと実行速度は、使用するハードウェアによって制限されます。小さいモデルはリソース消費が少ない一方、推論の質が低くなる可能性があります。ローカル導入は、プライバシーの向上とAPIコストの管理強化にもつながります。
マルチエージェントシステムを構築する際にどのような課題があるか?
よくある課題には、協調の失敗、通信のオーバーヘッド、デバッグの難しさ、セキュリティリスク、コストの上昇などがあります。エージェントがタスクを繰り返したり、競合したり、予測不能な出力を生成することがあります。プロンプトインジェクションも、連携したワークフローを通じて広がる可能性があります。これらのリスクを減らすために、権限管理、実行制限、ログ記録、人間による承認を活用しましょう。