
Qual é o melhor LLM para programar em 2026? 6 modelos testados e comparados
Descubra o melhor LLM para programar em 2026. Comparamos modelos LLM locais e assistentes em nuvem quanto à precisão, privacidade e velocidade para otimizar seu fluxo de trabalho.
Quando nossa equipe começou a buscar o melhor LLM para programar, percebemos rapidamente que as pontuações de benchmark não bastam. Todos os dias enfrentamos complexidades sérias, como lidar com bases de código emaranhadas ou avaliar gigantes de backend tradicionais que colidem com os fluxos de trabalho modernos.
Aprendemos que escolher um modelo depende inteiramente dos obstáculos específicos que você enfrenta. Enquanto os modelos frontier em nuvem oferecem o raciocínio profundo necessário para aplicações complexas, uma arquitetura autogerenciada é inegociável ao lidar com código empresarial proprietário.
Neste guia, compartilhamos nossa experiência em primeira mão. Detalhamos nossos critérios de avaliação, analisamos os seis melhores modelos testados, apresentamos agentes de desenvolvimento autônomos e revisamos o consenso dos desenvolvedores. Você descobrirá exatamente qual ferramenta, do melhor LLM de código aos gigantes hospedados na nuvem, vai realmente otimizar seu ecossistema.
Critérios essenciais de avaliação para LLMs de desenvolvedores
Para separar assistentes de código confiáveis de simples bots conversacionais, nossa equipe avaliou cada modelo segundo 5 métricas fundamentais que refletem o desenvolvimento de software real:
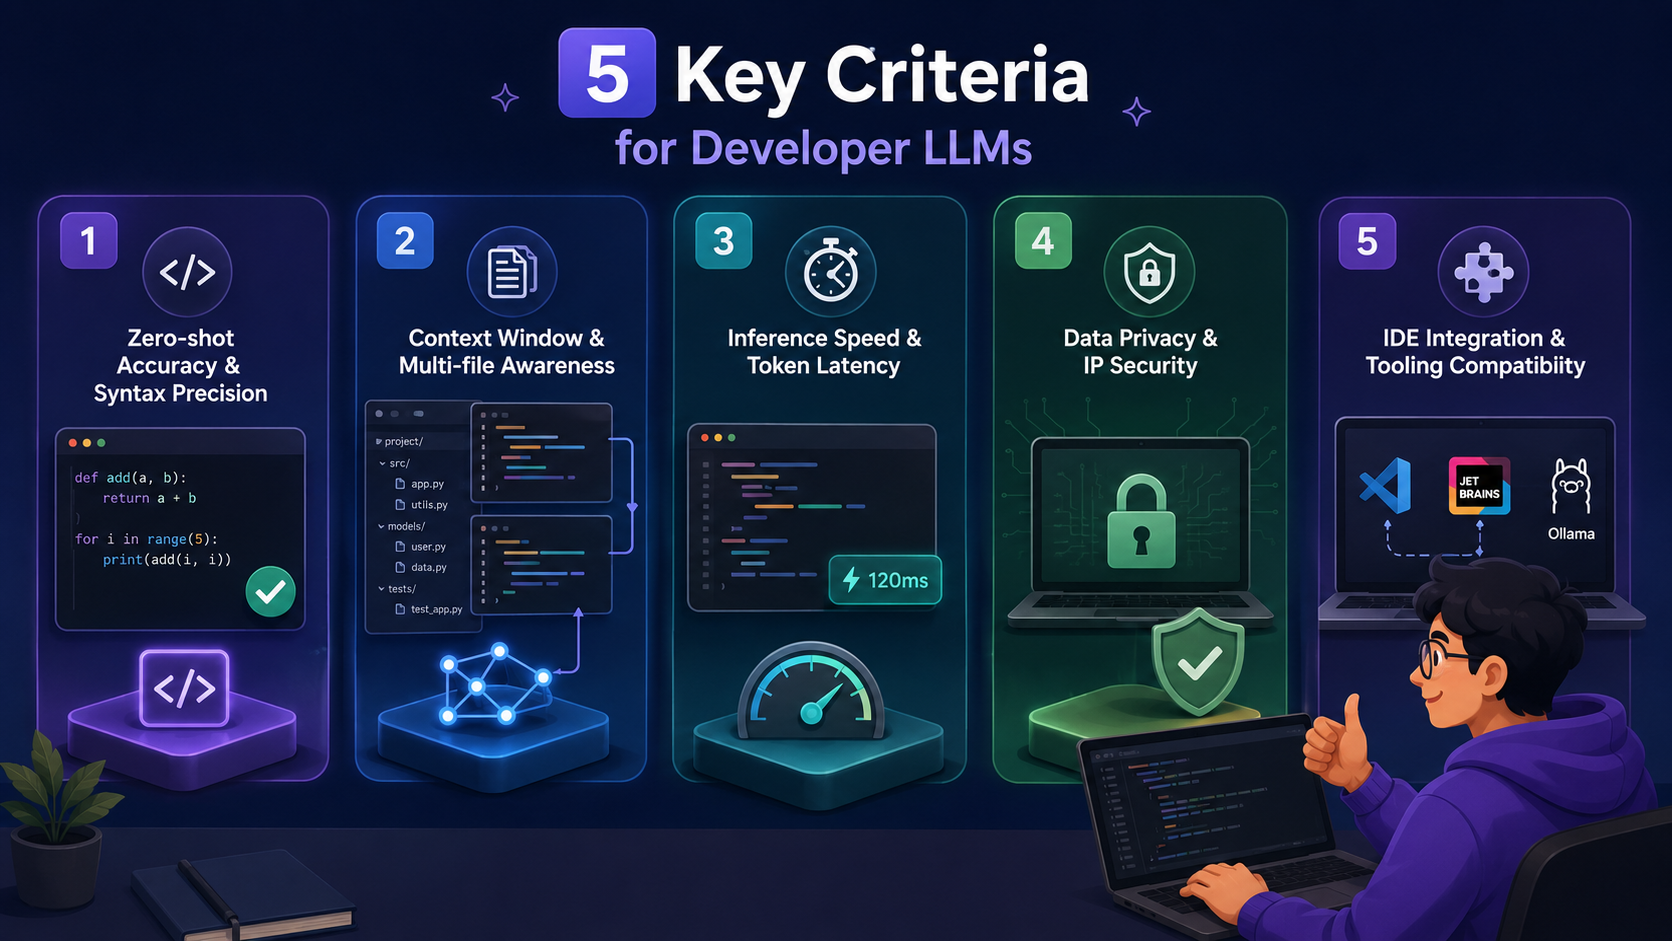
- Precisão zero-shot e precisão sintática: Mede quão confiavelmente um modelo gera código correto e funcional já na primeira tentativa. Um modelo forte escreve sintaxe limpa imediatamente, sem inventar bibliotecas fictícias, referenciar APIs obsoletas ou introduzir bugs lógicos sutis.
- Janela de contexto e consciência multiarquivo: Software moderno raramente cabe em um único arquivo. Avaliamos a "memória de trabalho" do modelo para ver com que eficácia ele rastreia variáveis interconectadas, dependências e lógica arquitetônica em todo um projeto multiarquivo sem se confundir.
- Velocidade de inferência e latência de tokens: A velocidade impacta diretamente o estado de fluxo do desenvolvedor. Testamos os tempos de resposta para garantir que sugestões em linha e autocompletar em tempo real apareçam instantaneamente, sem atraso perceptível na digitação.
- Privacidade de dados e segurança de PI: Proteger código proprietário é crítico para qualquer equipe. Revisamos as políticas de retenção de dados das APIs em nuvem e testamos capacidades offline e isoladas para garantir que o código empresarial sensível permaneça completamente privado.
- Integração com IDE e compatibilidade de ferramentas: Um modelo poderoso só é útil se se encaixa naturalmente no fluxo de trabalho diário de um desenvolvedor. Avaliamos a facilidade com que cada modelo se conecta a editores populares como VS Code e JetBrains, bem como a mecanismos de execução locais como o Ollama.
Os 6 melhores LLMs para programar nas principais categorias
Navegar pelo cenário de IA em rápida mudança exige identificar o melhor LLM para programar em 2026 de acordo com suas restrições exatas de hardware, requisitos de privacidade e a complexidade do fluxo de trabalho arquitetônico:
| Nome do modelo | Categoria | Força principal | Melhor para |
|---|---|---|---|
| Claude Opus 5 | Nuvem frontier | Codificação agêntica complexa | Grandes refatorações e loops de agentes |
| GPT-5.6 Sol | Nuvem frontier | Execução determinística | Tarefas multietapas e prototipagem |
| GLM-5.2 | Local/peso aberto | Janela de contexto de 1M de tokens | Codificação quase frontier autogerenciada |
| DeepSeek V4-Pro | Local/código aberto | Programação competitiva | Tarefas de API de alto volume e matemática |
| Qwen3-Coder-Next | Leve | Eficiência por parâmetro | Hardware local modesto |
| Gemini 3.7 Flash | Leve/econômico | Tarefas agênticas complexas | Trabalho de alto volume e refatorações |
Modelos de IA em nuvem frontier (máximo raciocínio e contexto)
Esses modelos dependem de enormes clusters de servidores remotos para processar prompts, permitindo lidar com janelas de contexto imensas e raciocínio complexo multietapas que o hardware local simplesmente não consegue suportar. São ideais para o planejamento de arquiteturas de sistema complexas.
- Claude Opus 5
Ao avaliar as opções para nossa stack de desenvolvimento, percebemos que o Claude Opus 5 se destaca como o melhor LLM de código para engenharia real, grandes refatorações e loops de agentes multietapas. A Anthropic desenvolve o LLM Claude em níveis como Haiku 4.5, Sonnet 5, Opus 5 e Fable 5. Ele atualmente lidera os rankings verificados para tarefas de software complexas.
| Versão | Tamanho de memória (contexto) | Melhor para | Em termos simples |
|---|---|---|---|
| Claude Fable 5 | Massivo (1M tokens) | Pesquisa especializada e tarefas de longo alcance | O modelo ultra premium construído para trabalho científico e de cibersegurança complexo. |
| Claude Opus 5 | Massivo (1M tokens) | Refatoração pesada e loops de agentes | O cérebro de ponta para bases de código multiarquivo complexas. |
| Claude Sonnet 5 | Massivo (1M tokens) | Desenvolvimento diário equilibrado | O confiável cavalo de batalha diário para tarefas de programação do dia a dia. |
| Claude Haiku 4.5 | Alto (200K tokens) | Scripts rápidos e depuração ágil | Modelo gratuito: O corredor leve criado para velocidade e custo zero. |
Vantagens:
- Entrega precisão de codificação zero-shot líder do setor, aliada a comportamento de verificação proativa.
- Possui uma janela de contexto massiva capaz de absorver bases de código grandes e multiarquivo sem esforço.
- Pontua excepcionalmente bem nos principais benchmarks de codificação agêntica.
Desvantagens:
- Exige conectividade constante com a internet, com estrita dependência de nuvem para funcionar.
- Os custos de uso de tokens podem escalar rapidamente para equipes de desenvolvimento em grande escala.
Melhor para: Refatoração de código em grande escala, design de sistemas full-stack e fluxos de trabalho agênticos complexos.
- GPT-5.6 Sol
Este é um modelo principal versátil, com amplia cobertura de sintaxe de linguagens e integração ampla ao ecossistema. A OpenAI avançou recentemente a fronteira de custo-benefício com o GPT-5.6. Ele serve como um cavalo de batalha diário altamente confiável para desenvolvedores que lidam com trabalho de software com eficiência.
| Versão | Velocidade | Compatível com | Em termos simples |
|---|---|---|---|
| GPT-5.6 Sol | Rápido | IDEs principais e frameworks de agentes | O assistente robusto que lida de forma estável com tarefas multietapas. |
| GPT-5.6 Terra | Moderado | Ferramentas de desenvolvimento padrão | A versão de API equilibrada para resolução de problemas estável, passo a passo. |
| GPT-5.6 Luna | Ultrarrápido | Web e ferramentas leves | Modelo gratuito: O ajudante diário rápido e gratuito para geração rápida de código. |
Vantagens:
- Execução determinística estável ao longo de tarefas longas e multietapas, sem se desviar do curso.
- Compatibilidade profunda de ecossistema com as principais extensões e plataformas de desenvolvedores.
- Cobertura de treinamento abrangente em linguagens de programação obscuras e legadas.
Desvantagens:
- Ocasionalmente produz boilerplate excessivamente verboso em vez de trechos concisos.
- A memória de contexto pode degradar em sessões de chat muito longas.
Melhor para: Tarefas determinísticas multietapas, prototipagem rápida e integração de API.
Melhores LLMs open source e locais (privacidade e personalização empresarial)
Para organizações que priorizam a segurança da propriedade intelectual, executar modelos LLM locais offline garante que nenhum código proprietário seja transmitido a um servidor de terceiros. Esses modelos oferecem enorme poder para conformidade empresarial.
- GLM-5.2
O melhor modelo de codificação de peso aberto disponível, oferecendo enorme potencial de ajuste fino. O GLM-5.2 é um modelo principal construído para tarefas de longo alcance e entrega essa capacidade com um sólido contexto de 1M de tokens.
| Versão | Hardware necessário | Nível de poder | Em termos simples |
|---|---|---|---|
| GLM-5.2 (grande) | Data center empresarial pesado | Inteligência de ponta | O melhor codificador de peso aberto com uma janela de memória massiva de 1M. |
| GLM-5.2 (pequeno) | Notebook padrão | Bom para ajuda do dia a dia | 100% gratuito e local: Roda diretamente no seu notebook, offline, sem taxas de API. |
| GLM-5.2 Cloud | Navegador web/API | Alto raciocínio | Acesso web gratuito: A ferramenta baseada em navegador para experimentação sem configuração. |
Vantagens:
- Modelo de peso aberto altamente competitivo para tarefas de engenharia de longo alcance.
- Janela de contexto massiva de um milhão de tokens para absorver repositórios inteiros localmente.
- Licença aberta permissiva que acomoda desenvolvimento corporativo e comercial.
Desvantagens:
- Exige hardware empresarial de ponta para utilizar plenamente a janela de contexto de 1M de tokens localmente.
- Modelos de peso aberto são gratuitos para baixar, mas operá-los em escala exige recursos de servidor caros.
Melhor para: Autogerenciar um codificador quase frontier mantendo privacidade absoluta de dados empresariais.
- DeepSeek V4-Pro
Um modelo de alto desempenho construído especificamente para tarefas de codificação avançadas. A DeepSeek desenvolve e disponibiliza como open source LLMs frontier. Ele supera muito sua categoria de peso em lógica matemática e estruturação algorítmica complexa, oferecendo uma configuração massiva de 1,6 trilhão de parâmetros para geração intensiva de texto.
| Versão | Força principal | Melhor para | Em termos simples |
|---|---|---|---|
| DeepSeek V4-Pro | Programação competitiva e matemática | Repositórios de nível empresarial | Um cérebro de codificação especializado que se destaca em algoritmos e lógica complexa. |
| DeepSeek V4 | Raciocínio geral e sintaxe | Scripts do dia a dia e pesquisa | Versão web gratuita: Um chatbot de propósito geral para escrita cotidiana e código básico. |
| DeepSeek-Coder 7B | Execução leve | Desenvolvimento local offline | 100% gratuito e local: Um modelo privado e sem custo que você pode executar no seu próprio PC. |
Vantagens:
- Se destaca fortemente em tarefas algorítmicas e de programação competitiva.
- Fornece privacidade de dados absoluta quando autogerenciado, para conformidade estrita com residência de dados.
- Ampla capacidade de raciocínio matemático e capacidades de API de alto volume.
Desvantagens:
- Configurações de parâmetros completos exigem VRAM de GPU de nível empresarial.
- A configuração e o ajuste fino com quantização exigem conhecimento técnico avançado.
Melhor para: Repositórios empresariais sensíveis à privacidade, tarefas de API de alto volume e resolução de problemas algorítmicos.
Modelos de codificação especializados e leves (autocompletar rápido e baixa latência)
Esses modelos são fortemente quantizados e explicitamente otimizados para rodar nativamente em segundo plano em notebooks de consumo ou operar de forma econômica na nuvem. Atuam estritamente como assistentes rápidos, maximizando a eficiência.
- Qwen3-Coder-Next
Um modelo altamente eficiente e especializado em código, otimizado para conclusão multilíngue em hardware de consumo padrão. Os modelos Qwen3 mais recentes adotam modos de pensamento híbridos que permitem controlar com flexibilidade o desempenho de raciocínio, a velocidade e os custos.
| Versão | Velocidade de resposta | Alcance de idiomas | Em termos simples |
|---|---|---|---|
| Qwen3-Coder-Next | Rápido | 90+ linguagens de programação | O motor principal de peso aberto para configurações locais de desenvolvedores sérios. |
| Qwen3-Coder (7B) | Instantâneo | 90+ linguagens de programação | 100% gratuito e local: Como um texto preditivo para código que roda suavemente em notebooks padrão. |
| Qwen-Chat | Instantâneo | Codificação padrão e linguagem natural | Versão web gratuita: Um ajudante conversacional rápido e sem custo para verificações de sintaxe. |
Vantagens:
- Oferece excelente eficiência de codificação por parâmetro para configurações locais leves.
- Roda suavemente em hardware de consumo padrão e implantações locais modestas, com sobrecarga mínima de recursos.
- Forte suporte sintático multilíngue, abrangendo mais de 90 linguagens de programação.
Desvantagens:
- Profundidade de raciocínio limitada ao planejar arquiteturas de software completas.
- Janela de retenção de contexto menor em comparação com grandes modelos em nuvem.
Melhor para: Autocompletar linha por linha e desenvolvedores que executam modelos em notebooks padrão.
- Gemini 3.7 Flash
Um assistente de codificação fluente, projetado explicitamente para operações em nuvem com bom custo e configurações agênticas complexas. O Gemini 3.7 Flash é ideal para enfrentar tarefas agênticas complexas em escala.
| Versão | Como ajuda | Onde roda | Em termos simples |
|---|---|---|---|
| Gemini 3.7 Flash | Tarefas agênticas complexas em escala | API em nuvem | Um assistente em nuvem de alta velocidade para bases de código grandes e fluxos de trabalho complexos. |
| Gemini 3.5 Flash-Lite | Tarefas de alto volume | API em nuvem | Nível de API gratuito generoso: Um modelo leve construído para eficiência e inteligência. |
| Gemini Web | Chat geral e trechos de código | Navegador web | Versão web gratuita: Um assistente simples e gratuito para redigir funções e responder perguntas. |
Vantagens:
- Incrivelmente eficiente para fluxos de trabalho de agentes de alto volume.
- Lida com janelas de contexto massivas, permitindo ler bases de código enormes com facilidade.
- Velocidades rápidas de entrega de tokens para depuração rápida e edições em tempo real.
Desvantagens:
- Funciona estritamente como uma API em nuvem, o que significa que não pode ser isolado ou autogerenciado para privacidade extrema.
- Pode exigir ajuste de prompts para corresponder ao rigor exato de formatação do Claude ou GPT.
Melhor para: Codificação em nuvem econômica, trabalho de agentes de alto volume e tarefas de contexto longo.
Como testamos esses LLMs
Testamos cada modelo por meio de uma estrutura técnica estritamente reproduzível para eliminar viés subjetivo. Nossa suíte de testes combina benchmarks estabelecidos para desenvolvedores com desafios práticos de engenharia do mundo real.
Prompting de linha de base controlada
Para testar o raciocínio puro em 2026, enviamos 5 prompts idênticos de refatoração arquitetônica diretamente nas interfaces web nativas de líderes do setor como ChatGPT e Claude.
Etapa 1: Preparar 5 prompts idênticos de refatoração arquitetônica
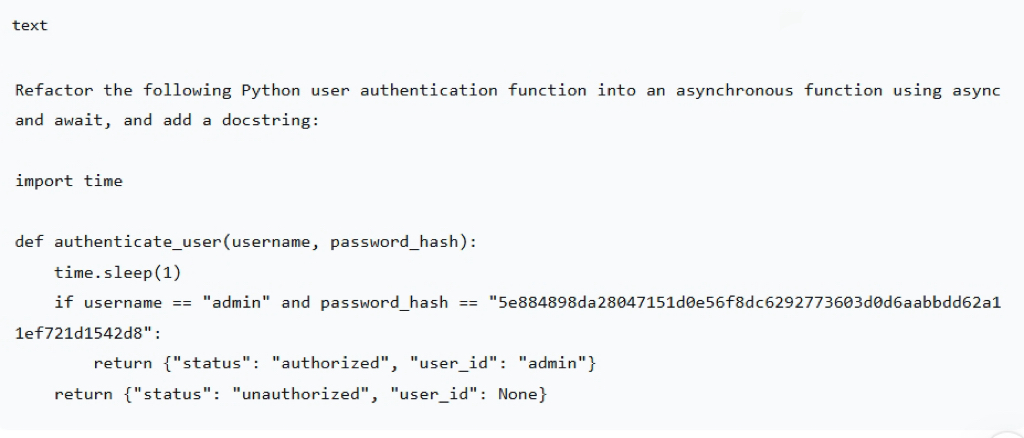
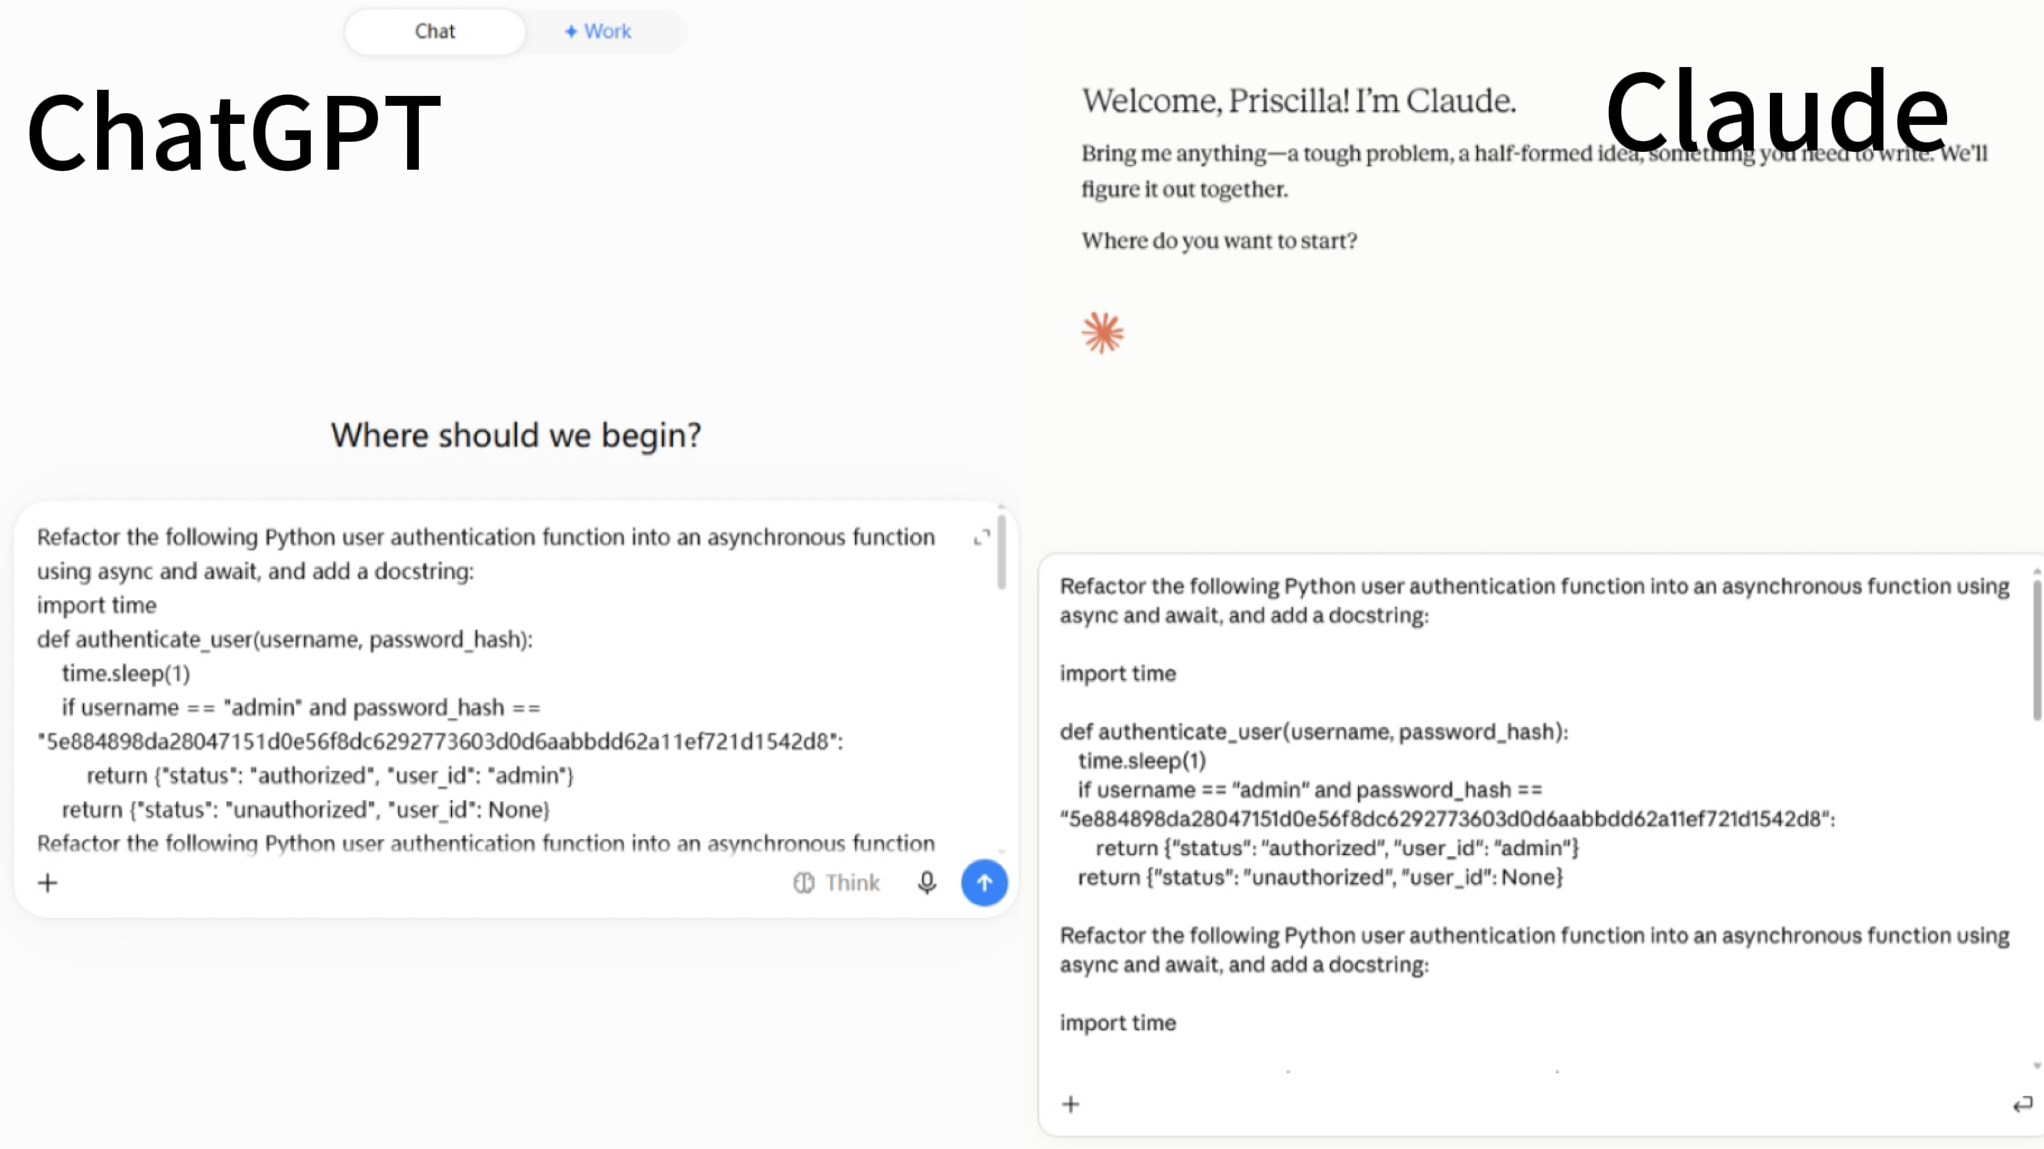
Primeiro, escrevi um prompt unificado de refatoração arquitetônica e o copiei 5 vezes, garantindo que o conteúdo fosse exatamente o mesmo. Um exemplo de prompt é mostrado abaixo:
Etapa 2: Enviar os prompts nas interfaces nativas do ChatGPT/Claude
Abri as interfaces web do ChatGPT e do Claude, colei e enviei os prompts um por um, e registrei completamente a resposta a cada vez.
Etapa 3: Avaliar a capacidade de lidar com lógica multiarquivo
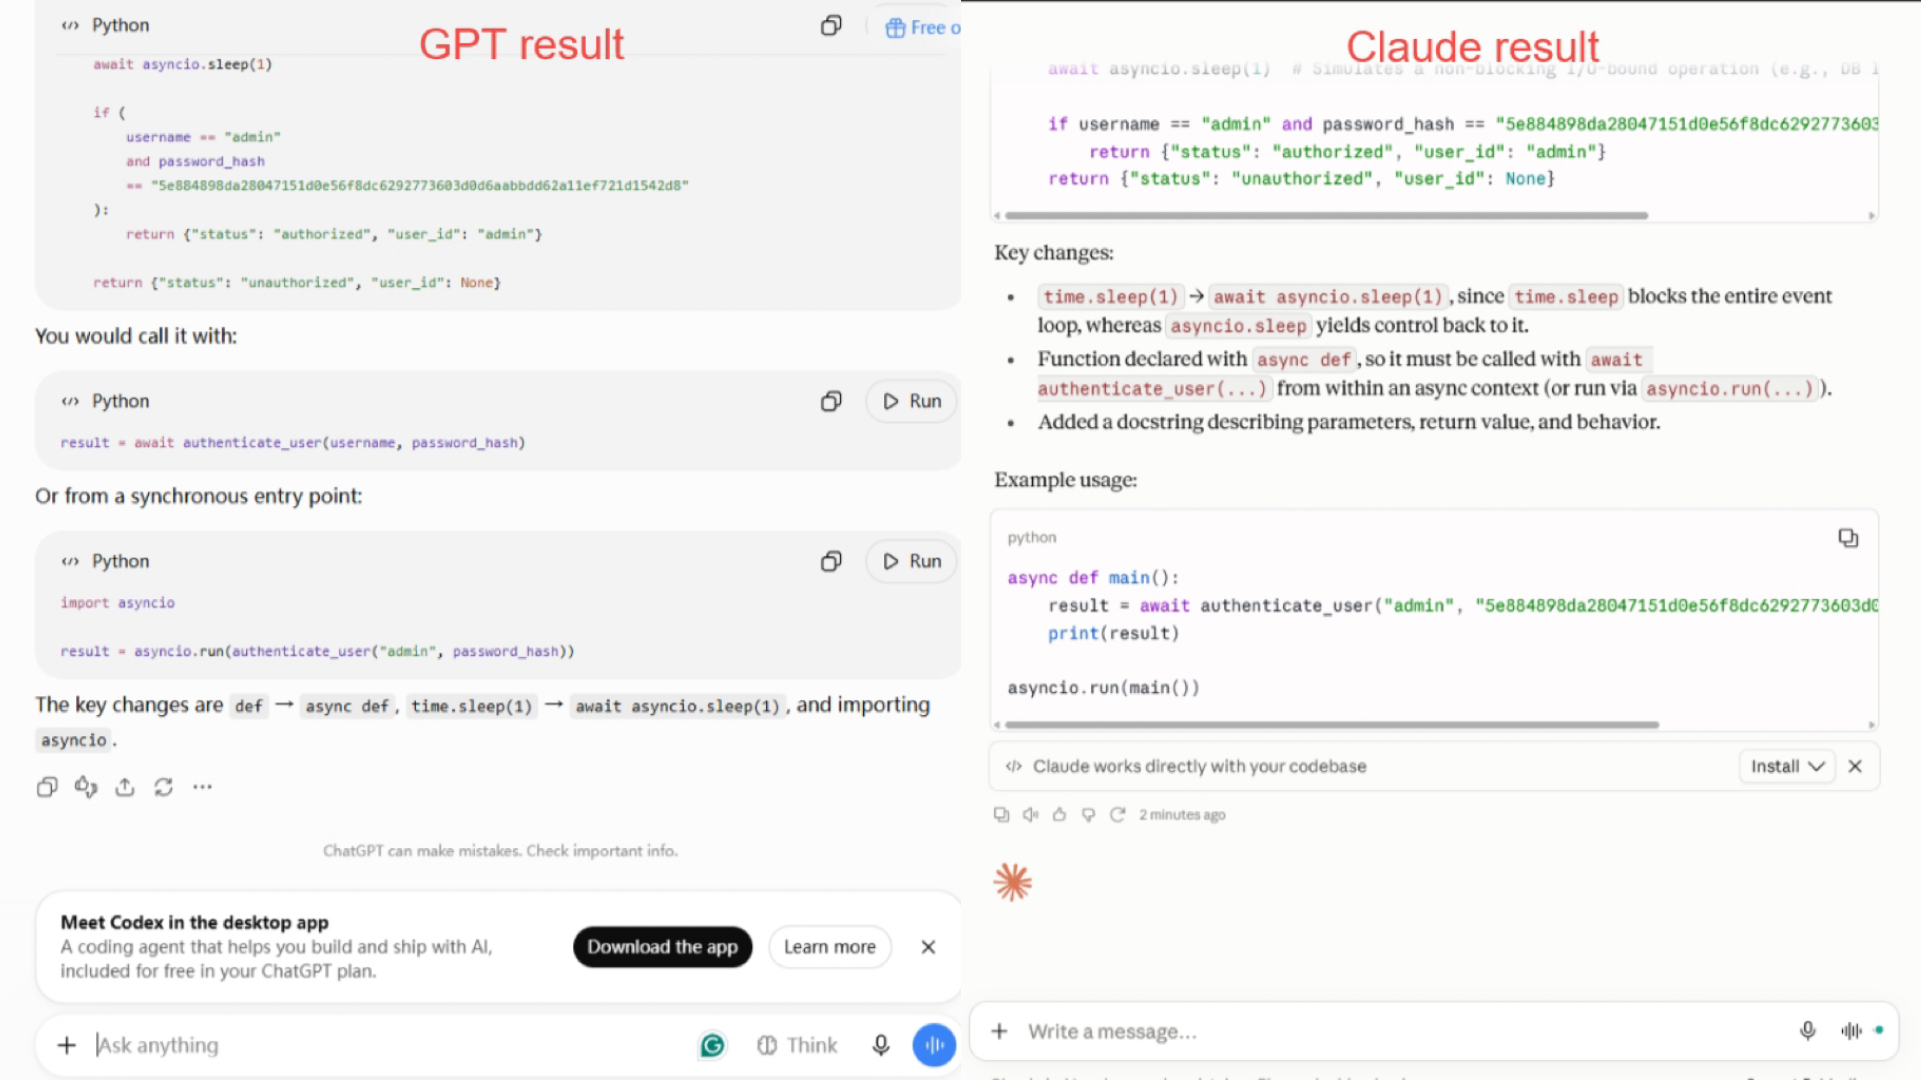
Depois que cada ferramenta entrega seus resultados, avaliamos a verdadeira capacidade de raciocínio de cada uma. Tomando ChatGPT e Claude como exemplo, ambos os modelos completaram corretamente a mesma refatoração, mas percebi que os estilos e ênfases de saída diferem: o ChatGPT tende a dar o resultado mais um uso conciso, enquanto o Claude tende a explicar os princípios subjacentes e enfatizar restrições. Isso reflete seus diferentes estilos de raciocínio e expressão sob a mesma entrada.
Perfilamento de sobrecarga de hardware local
Modelos locais oferecem privacidade completa de dados, mas apenas se funcionarem de forma eficiente em hardware prático. Perfilamos modelos leves de peso aberto como o Qwen3-Coder (7B) e o DeepSeek-Coder diretamente em uma estação de trabalho local.
- Monitoramos picos de VRAM e cargas de CPU durante a geração máxima de tokens para identificar os limites reais de recursos.
- Confirmamos se os desenvolvedores podem autogerenciar fluxos de trabalho offline seguros sem hardware empresarial caro.
Integração com IDE e atrito de UX
Métricas teóricas de latência não significam nada se as sugestões de código parecem lentas durante a edição em tempo real. Testamos modelos leves como Qwen3-Coder e Gemini 3.7 Flash dentro de um editor de código padrão para avaliar a conclusão em linha em tempo real e o atraso de entrada.
- Avaliamos a latência do mundo real para garantir que o texto fantasma preditivo se adaptasse perfeitamente ao ritmo natural de digitação de um desenvolvedor.
- Verificamos a consciência de contexto para garantir que os modelos lessem e aplicassem corretamente variáveis entre arquivos de projeto adjacentes abertos.
Verificação de execução isolada e sintaxe
Código que parece correto em uma interface de chat frequentemente falha em tempo de execução. Compilamos e executamos trechos gerados pelo DeepSeek V4-Pro e pelo GPT-5.6 Sol diretamente dentro de containers Docker isolados.
- Execuções objetivas em sandbox sinalizaram imediatamente métodos obsoletos, importações ausentes e alucinações de sintaxe.
- Rastreamos as taxas reais de Pass@1 para confirmar que a lógica satisfazia os conjuntos de testes na primeira tentativa.
Embora LLMs independentes em nuvem e locais se destaquem na geração de trechos e no refinamento de funções específicas, construir aplicações completas ainda exige configuração manual de IDE, montagem de boilerplate e integração frontend-backend. Para desenvolvedores e criadores que buscam contornar completamente ciclos repetitivos de codificação, agentes de desenvolvimento autônomos oferecem um caminho mais rápido do conceito ao deployment.
Enter Pro: O agente de desenvolvimento de IA autônomo para criação rápida de software
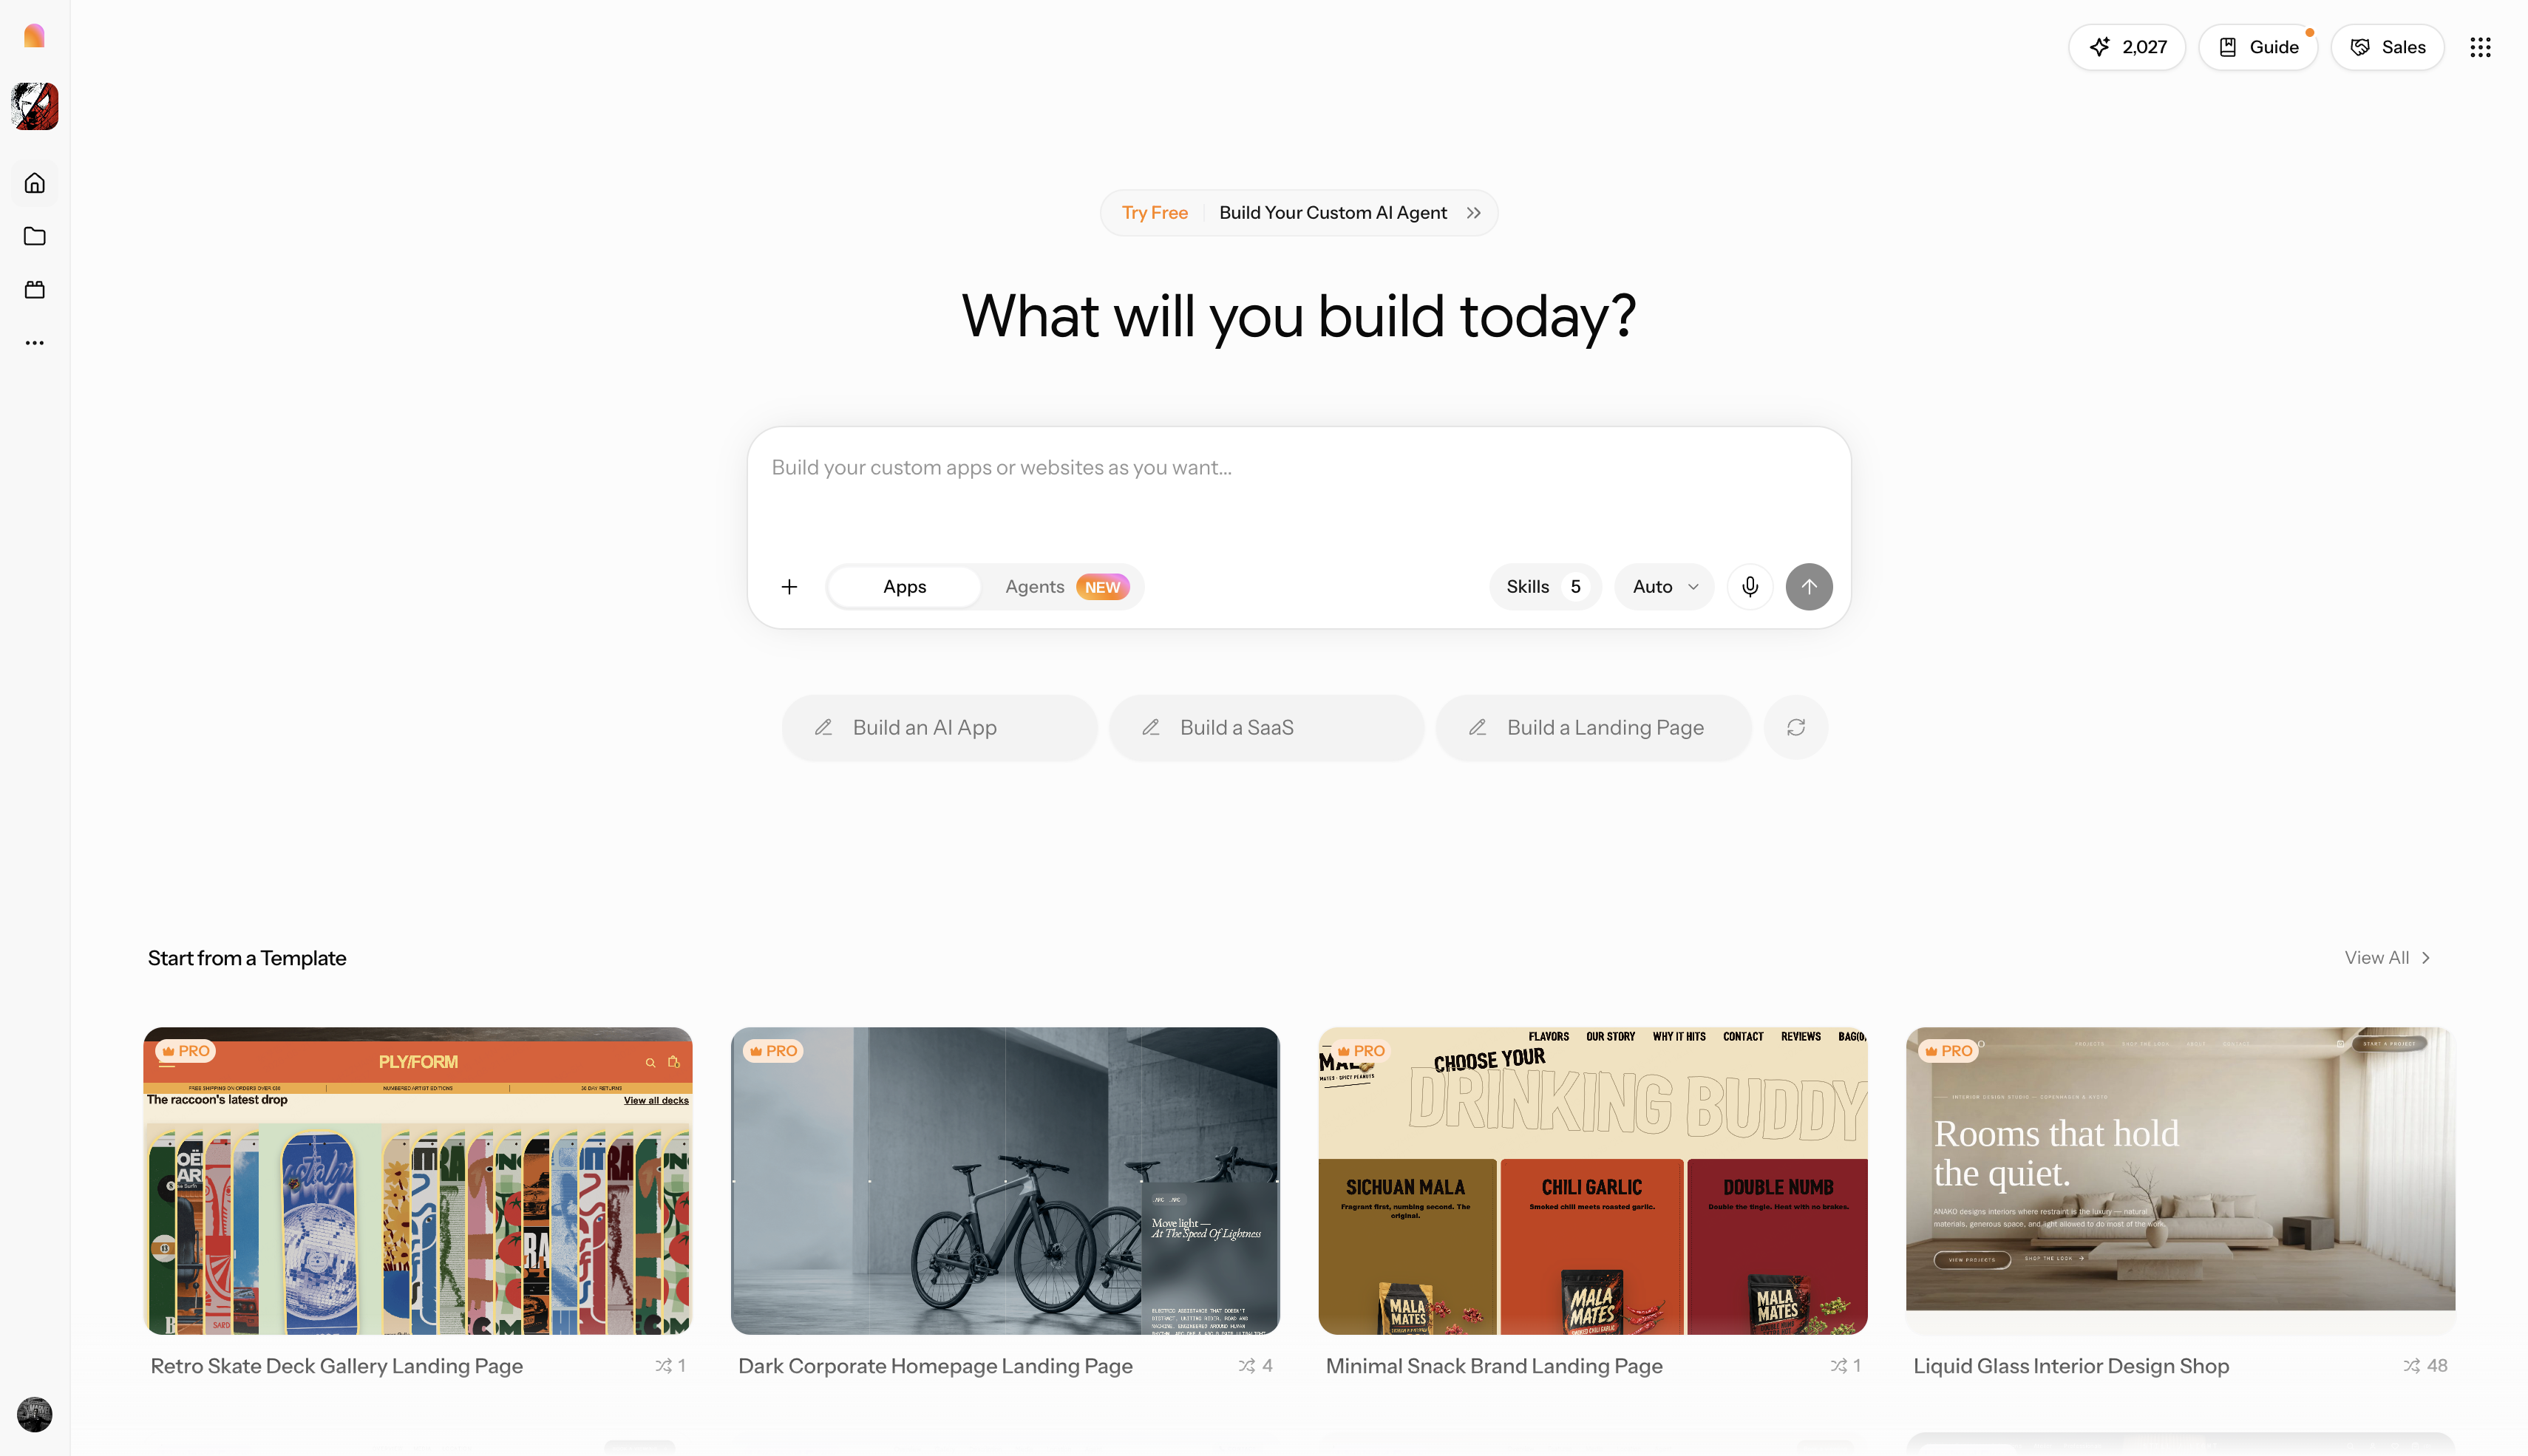
Você quer ir além de escrever funções isoladas e gerar aplicações inteiras de forma autônoma? O Enter Pro preenche a enorme lacuna entre interfaces de chat de LLM puras e a geração completa de projetos full-stack. Você não precisa mais configurar manualmente ambientes locais, atualizar dependências do sistema ou lutar com gerenciadores de pacotes complicados. Em vez disso, essa plataforma utiliza um intuitivo modo plano para vibe coding para transformar prompts de linguagem natural de alto nível diretamente em software polido e pronto para produção.
Principais recursos
- Criação baseada em prompt
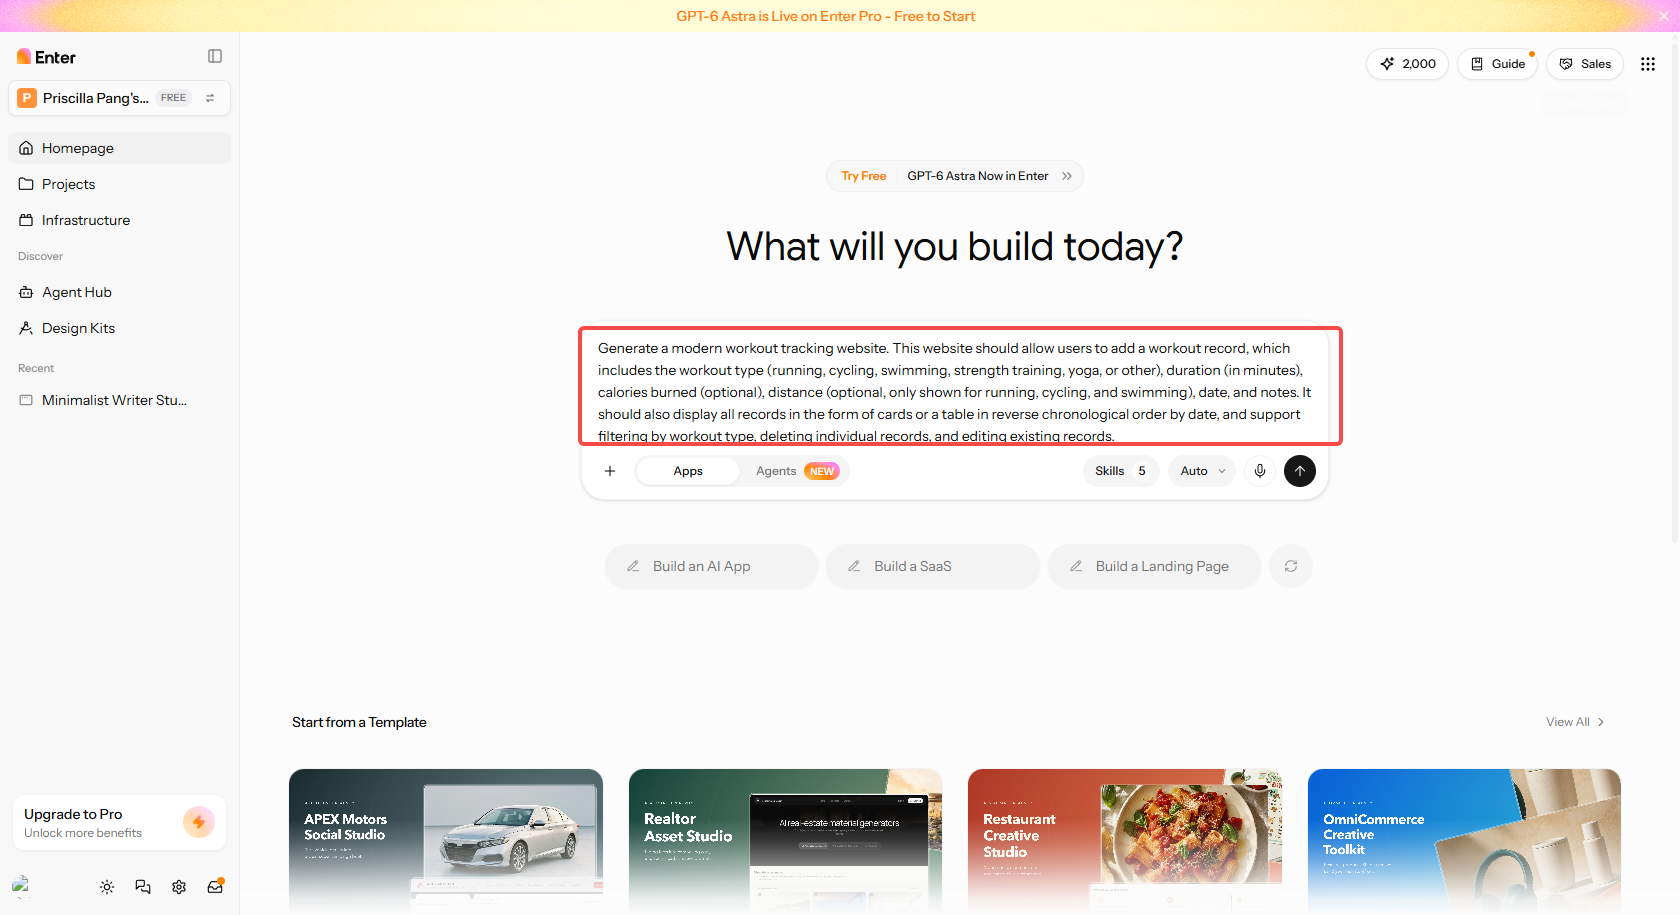
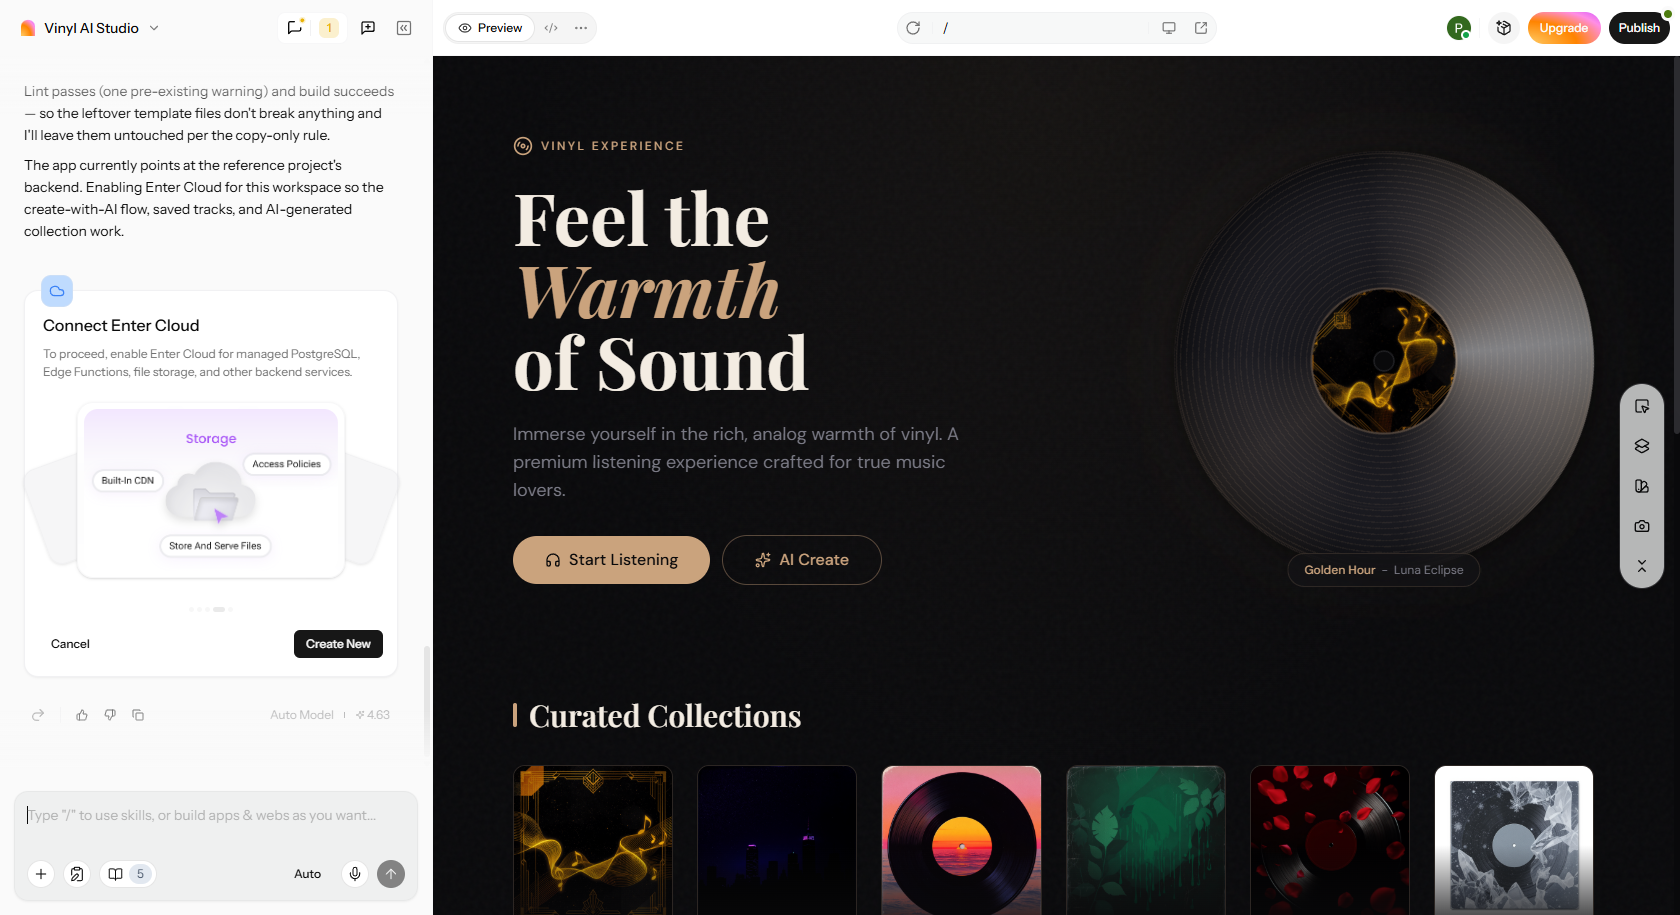
Os usuários simplesmente fornecem um prompt em linguagem natural descrevendo o tema de cores do site, o layout desejado e as páginas funcionais incluídas. O motor integrado do Enter Pro constrói instantaneamente a base de código full-stack fundamental, incluindo lógica de frontend e banco de dados, reduzindo drasticamente o tempo de configuração manual.
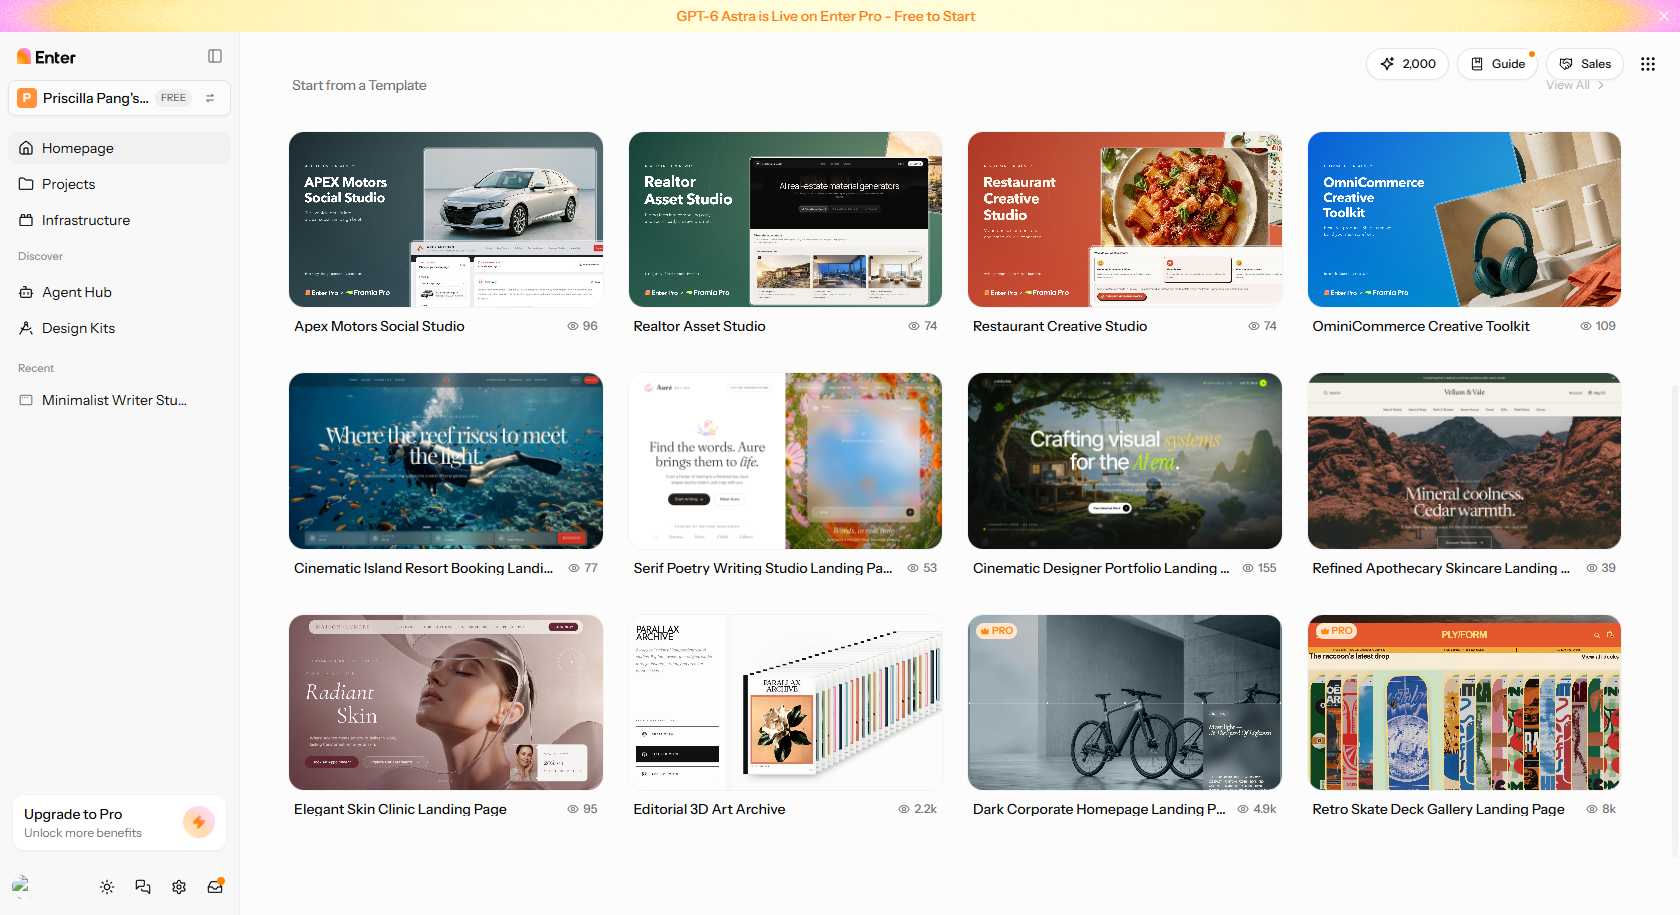
- Modelos prontos
A plataforma oferece modelos de sites profissionalmente projetados e totalmente responsivos, adaptados para velocidade extrema de deployment. O Enter Pro otimiza especificamente esses layouts para aderir rigorosamente aos padrões modernos de experiência do usuário, garantindo entrega de aplicações de alta qualidade sem ajustes visuais manuais.
- Integração unificada de modelos
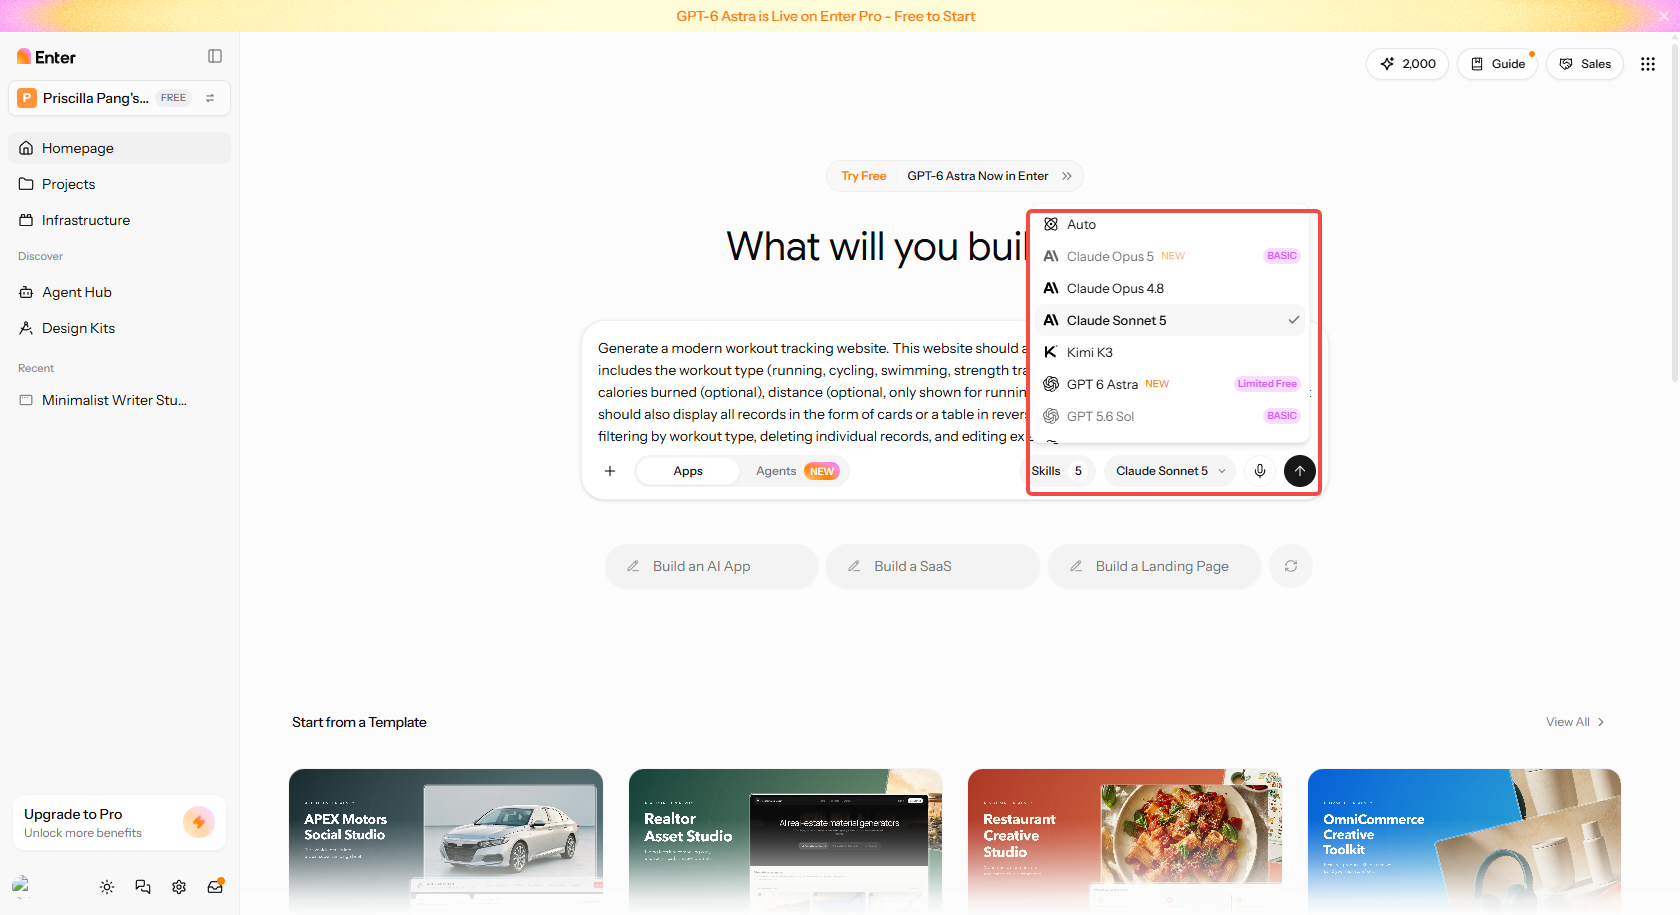
Os desenvolvedores podem incorporar nativamente assistentes de codificação de ponta e modelos avançados diretamente em seus builds ativos do Enter Pro sob uma única assinatura, incluindo Kimi K3, GPT 6 Astra e Claude Sonnet 5. Essa abordagem simplificada elimina completamente o pesadelo administrativo de gerenciar e proteger chaves de API separadas em diferentes modelos frontier.
- 100% de propriedade do código
Você mantém o controle absoluto e os direitos comerciais completos sobre o código-fonte gerado após a exportação da plataforma Enter Pro. Isso garante verdadeira independência, sem bloqueio restritivo de fornecedor nem complicações futuras de licenciamento.
Guia passo a passo para construir aplicações
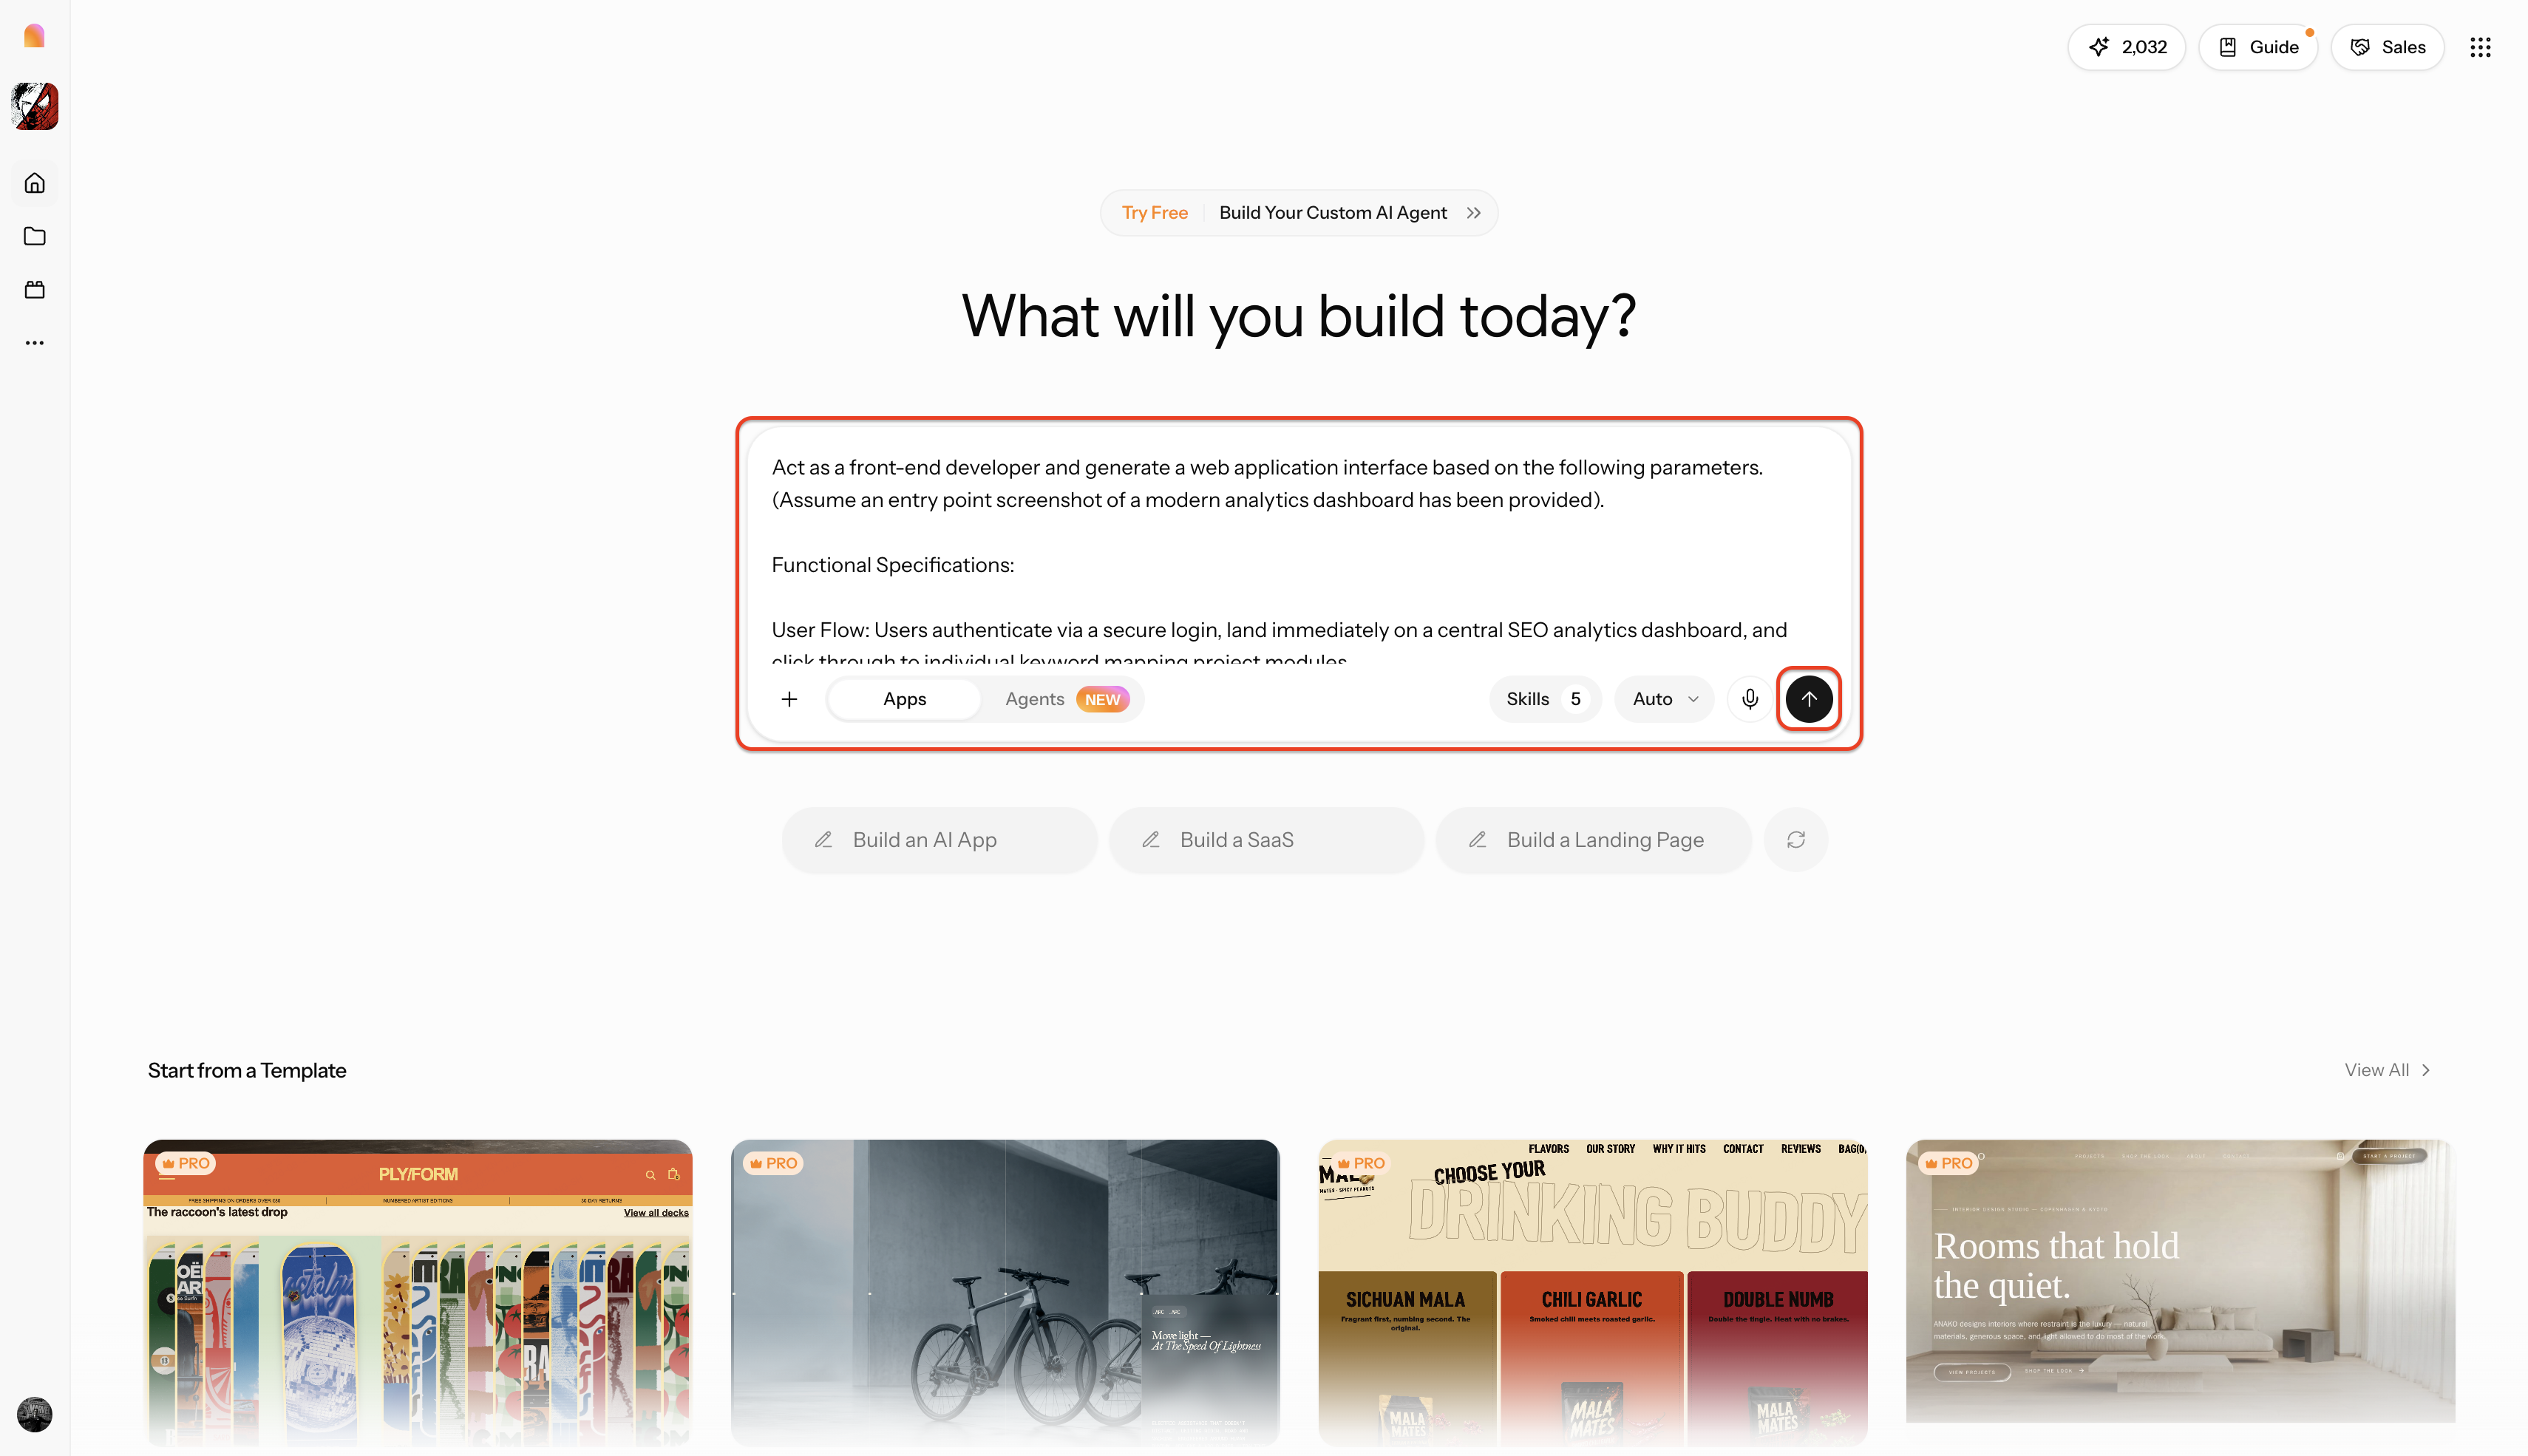
Etapa 1: Inicie o Enter Pro e digite o prompt do projeto
Comece definindo suas especificações funcionais, preferências de estilo de UI e recursos pretendidos inteiramente em linguagem natural. Você pode facilmente fazer upload de uma captura de tela do ponto de entrada da interface para guiar a compreensão estrutural e estética da IA desde o início.
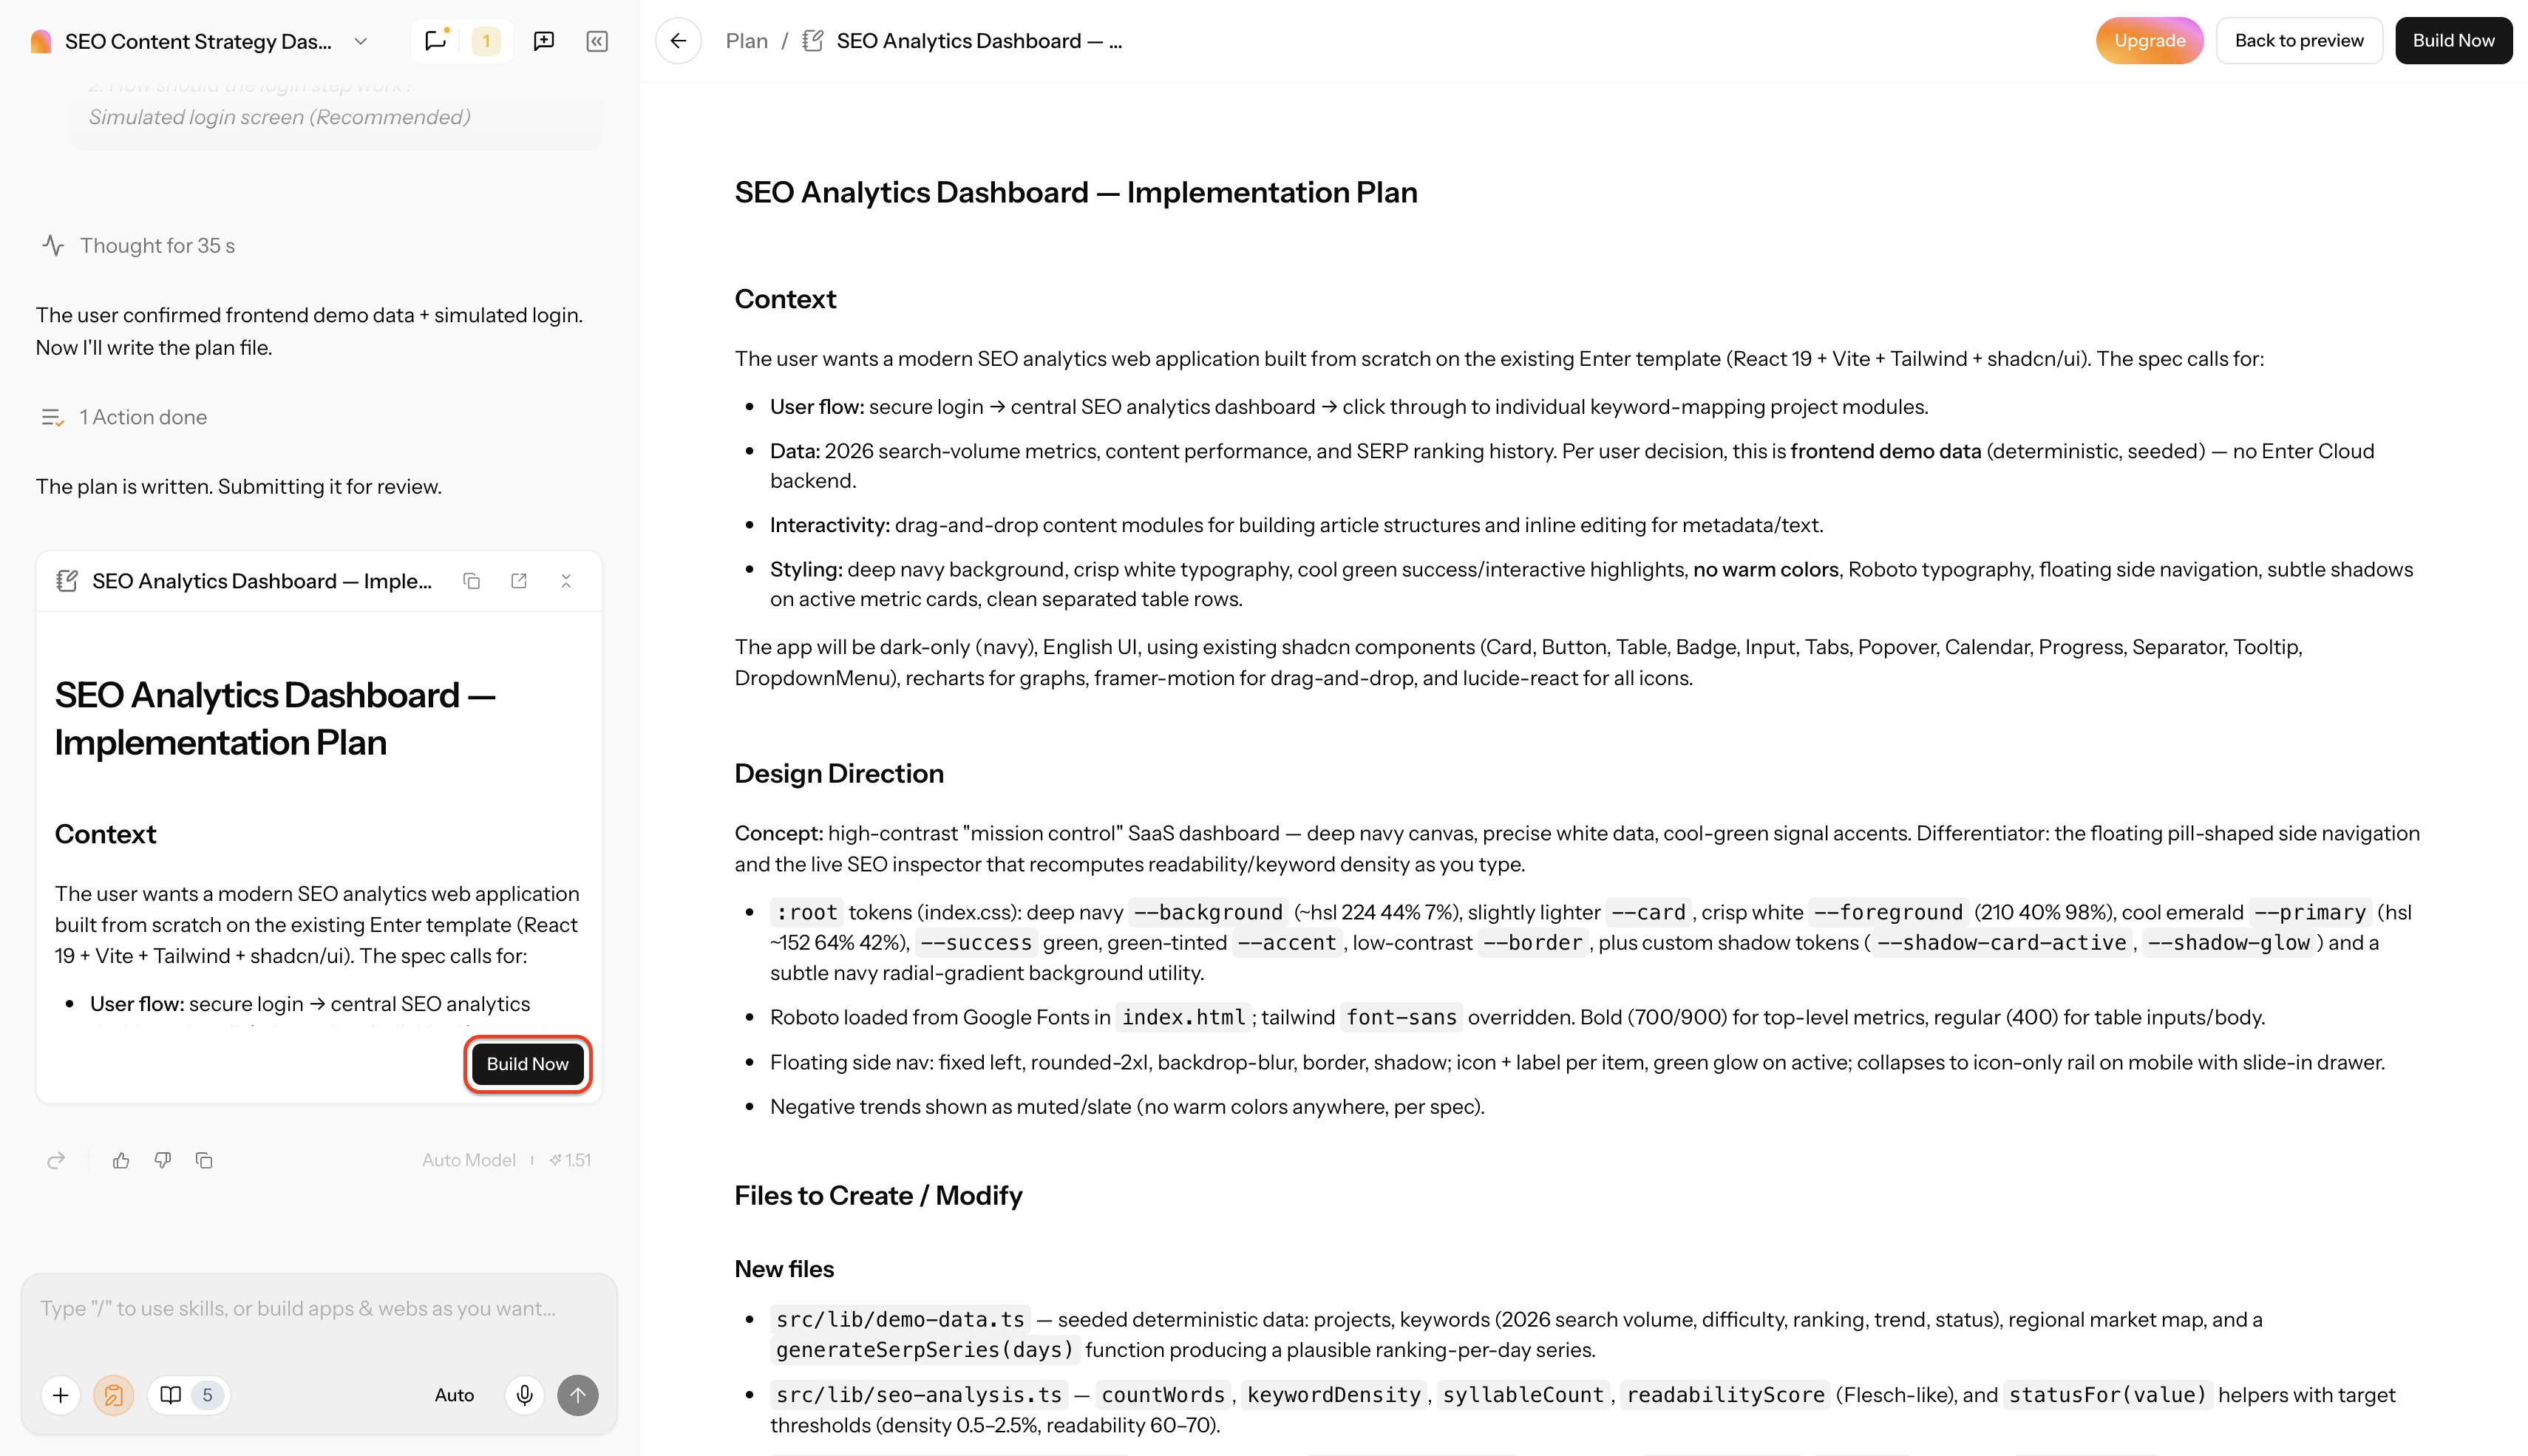
Etapa 2: Revise o plano de implementação e construa
Revise o plano gerado pela IA descrevendo o contexto do app, a direção de design e as estruturas de arquivo necessárias. Quando estiver pronto, basta clicar no botão "Build Now" para iniciar o processo de geração de código full-stack.
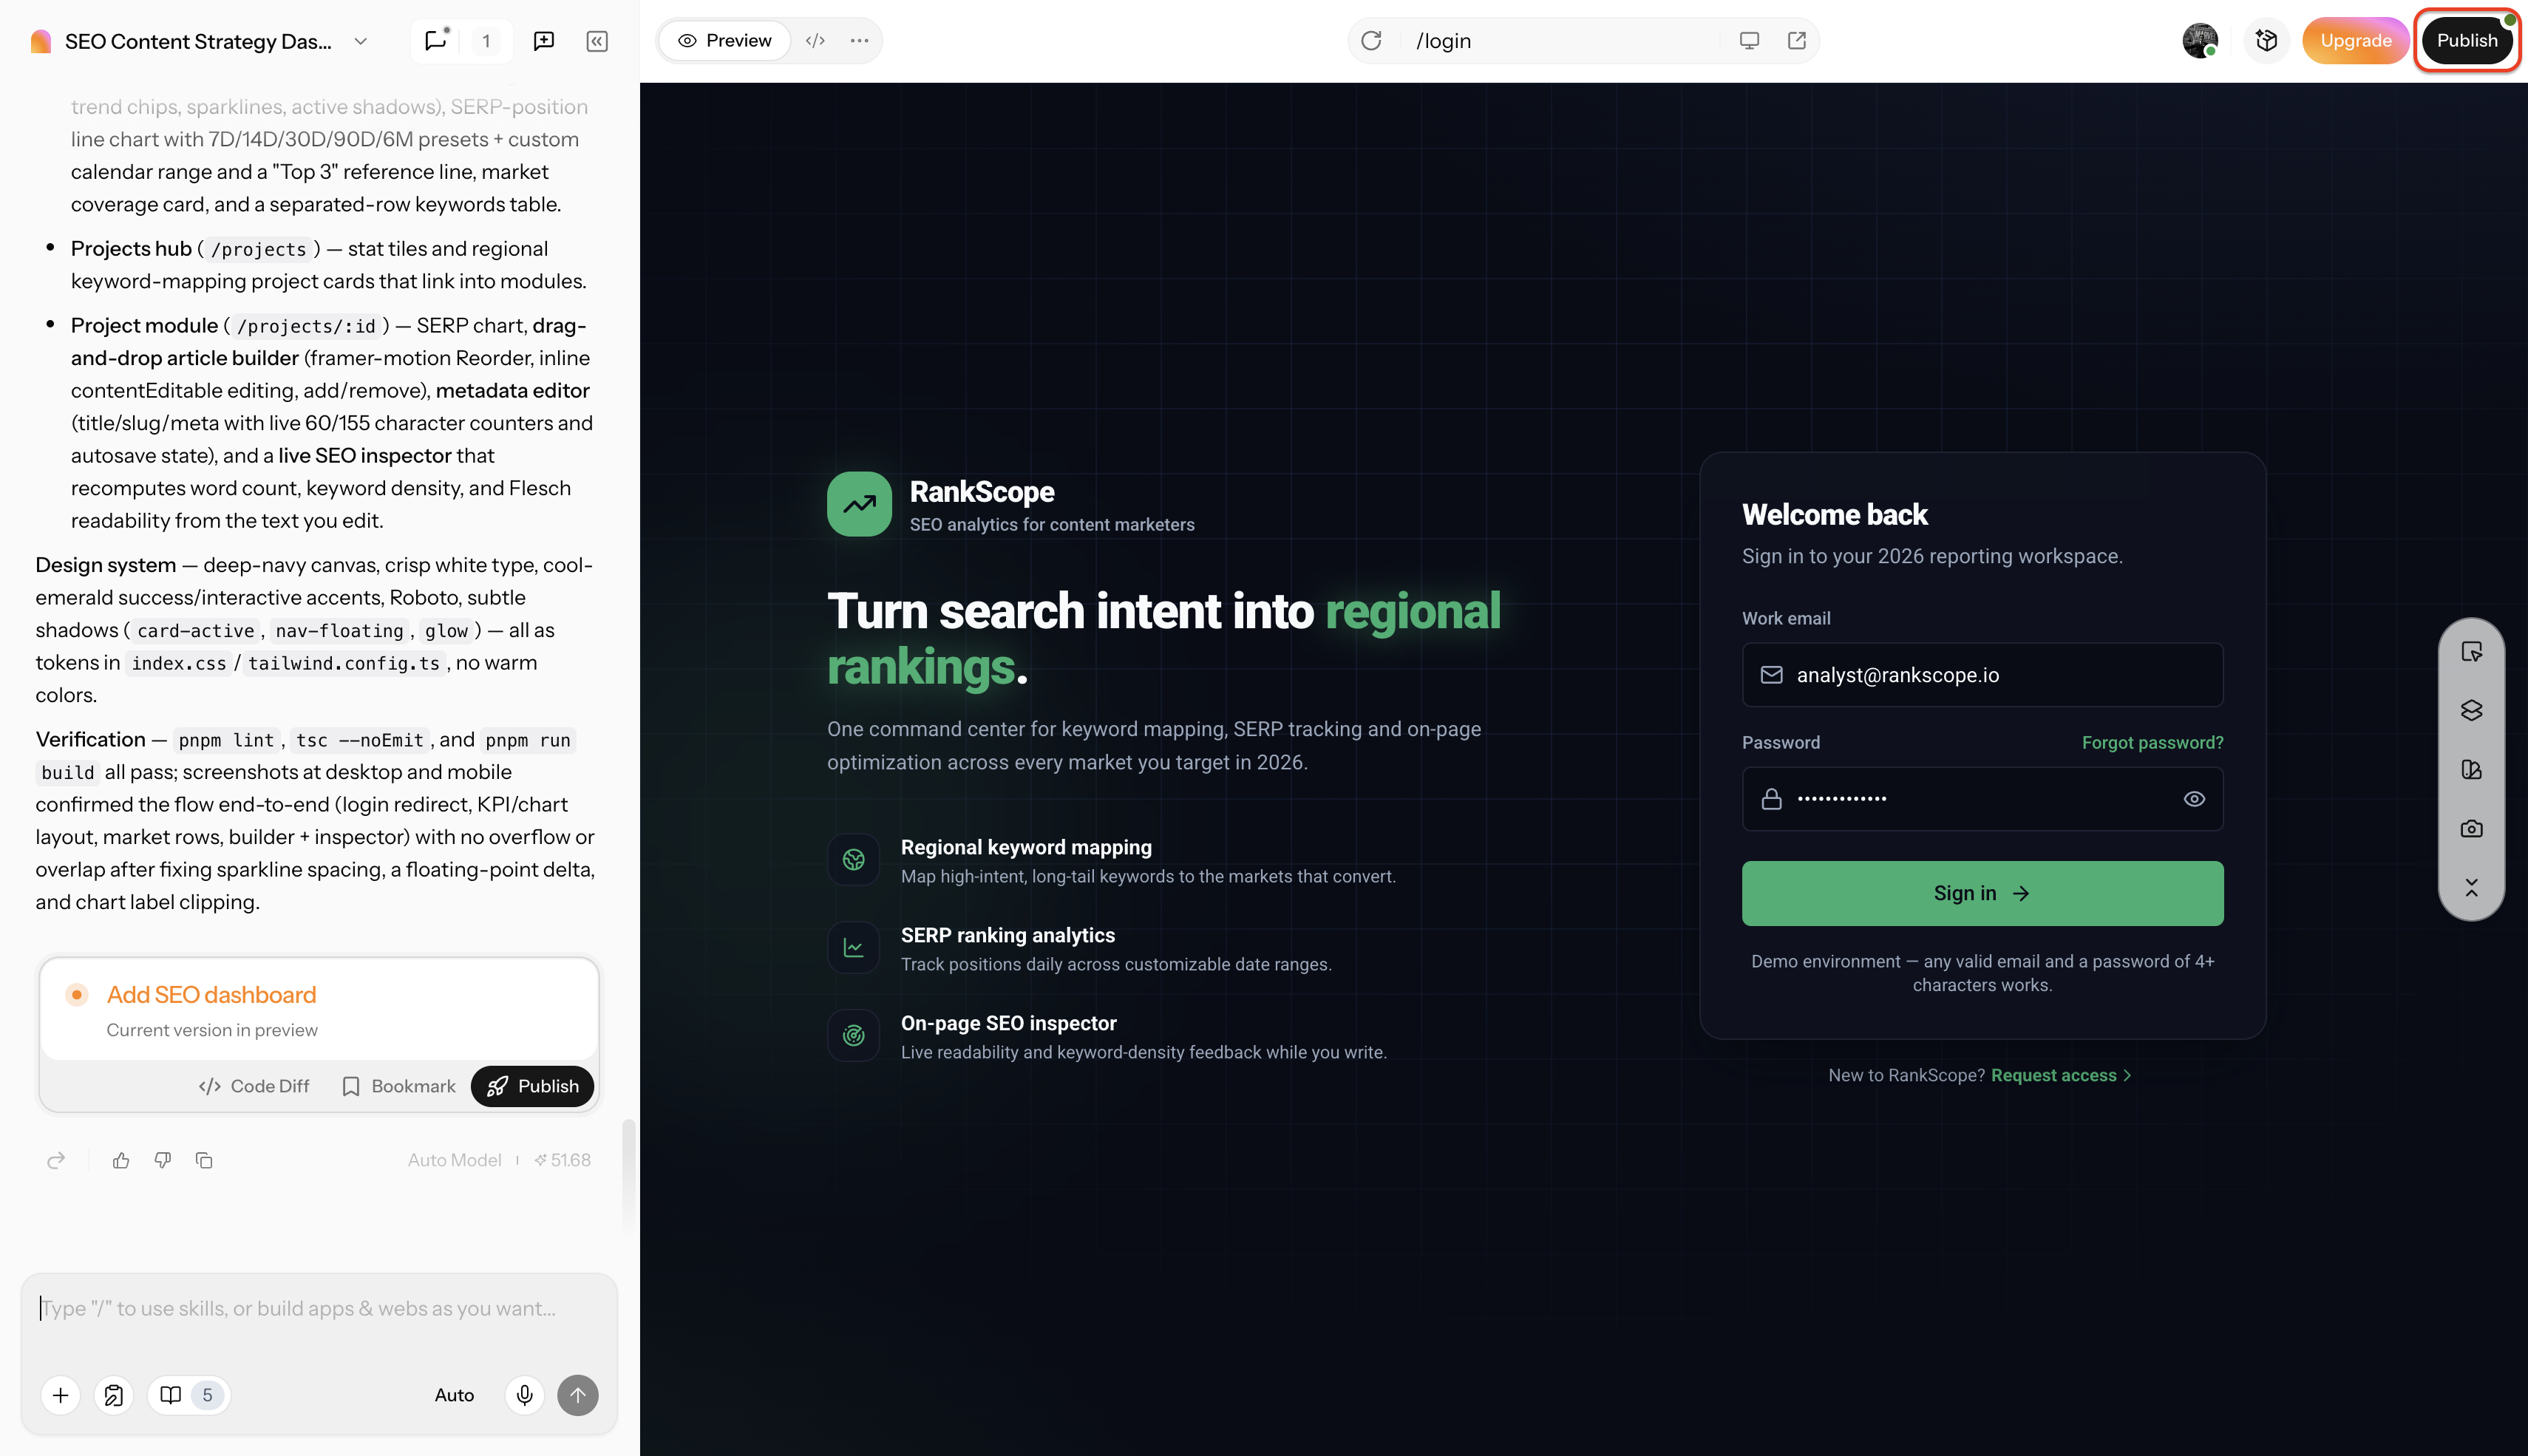
Etapa 3: Edite, publique e exporte
Refine a aplicação gerada editando com descrições de prompt simples ou com o Editor Visual. Quando estiver satisfeito com os resultados, implante a aplicação em tempo real na web com um único clique, ou exporte com segurança os arquivos de código-fonte estruturados para sua máquina local.
LLMs em nuvem vs. LLMs locais vs. agentes de IA autônomos: trade-offs de desempenho e privacidade
Selecionar a arquitetura mais apropriada exige analisar profundamente os trade-offs fundamentais presentes no seu ambiente de engenharia atual.
| Dimensão | LLMs em nuvem frontier | LLMs locais autogerenciados | Agente autônomo (Enter Pro) |
|---|---|---|---|
| Privacidade de dados | Depende da política de dados da API em nuvem | 100% privado/isolado | Espaço de trabalho isolado/propriedade do código |
| Sobrecarga de hardware | Nenhuma computação local necessária | Exige alta VRAM/GPU | Nenhuma computação local necessária |
| Complexidade de configuração | Chave de API e configuração de plugin de IDE | Configuração de runtime local e quantização | Espaço de trabalho visual pronto para prompt e execução |
| Escopo de saída | Trechos, funções e conselhos de chat | Conclusão de código e edições locais | Aplicações full-stack completas |
| Modelo de custo | Assinatura de API com pagamento por token | Custo inicial de hardware local | Assinatura fixa de plataforma |
- Privacidade e propriedade intelectual: Quando lido com bases de código rigorosas e altamente proprietárias, priorizo consistentemente modelos locais para evitar completamente o vazamento de PI confidencial. Enviar lógica corporativa não divulgada para servidores remotos frequentemente viola regulamentações estritas de conformidade.
- Requisitos de hardware: Executar modelos open source exige hardware dedicado sério. Um modelo de 7 bilhões de parâmetros geralmente exige alocar pelo menos 8 GB de VRAM, um modelo de 14 bilhões exige 16 GB, e modelos massivos de 70 bilhões de parâmetros exigem 48 GB+ de VRAM, frequentemente necessitando configurações de desktop com GPU dupla caras ou servidores locais especializados.
- Latência vs. capacidade: As redes de computação em nuvem oferecem um poder imenso e incomparável para raciocínio profundo e refatoração massiva multiarquivo. No entanto, ao mudar para modelos locais autogerenciados, experimento uma vantagem estrita de latência zero de rede que os torna muito superiores e muito mais fluidos para conclusões de texto em linha instantâneas.
Veredicto da comunidade: avaliações de desenvolvedores e tendências de vibe coding
- O vibe coding se refere a um fluxo de trabalho de desenvolvimento moderno em que os desenvolvedores direcionam a arquitetura de sistema de alto nível e a lógica de aplicação usando prompts em linguagem natural, enquanto a IA gera autonomamente a sintaxe boilerplate. Em vez de digitar rotinas manualmente, o engenheiro atua como um diretor arquitetônico, guiando a intenção do projeto e revisando os resultados gerados.
Consenso da comunidade do Reddit:
- Sintetizando percepções de discussões de desenvolvedores no r/vibecoding, engenheiros frequentemente adotam uma abordagem em camadas, multimodelo. Raramente dependem de uma única ferramenta para lidar com uma construção full-stack inteira.
- Os desenvolvedores normalmente iniciam o scaffolding de alto nível e conceitos de frontend usando modelos rápidos e abrangentes. Eles então mudam imediatamente para o Claude Opus 5 para execução lógica profunda, refatoração complexa multiarquivo e depuração direcionada.
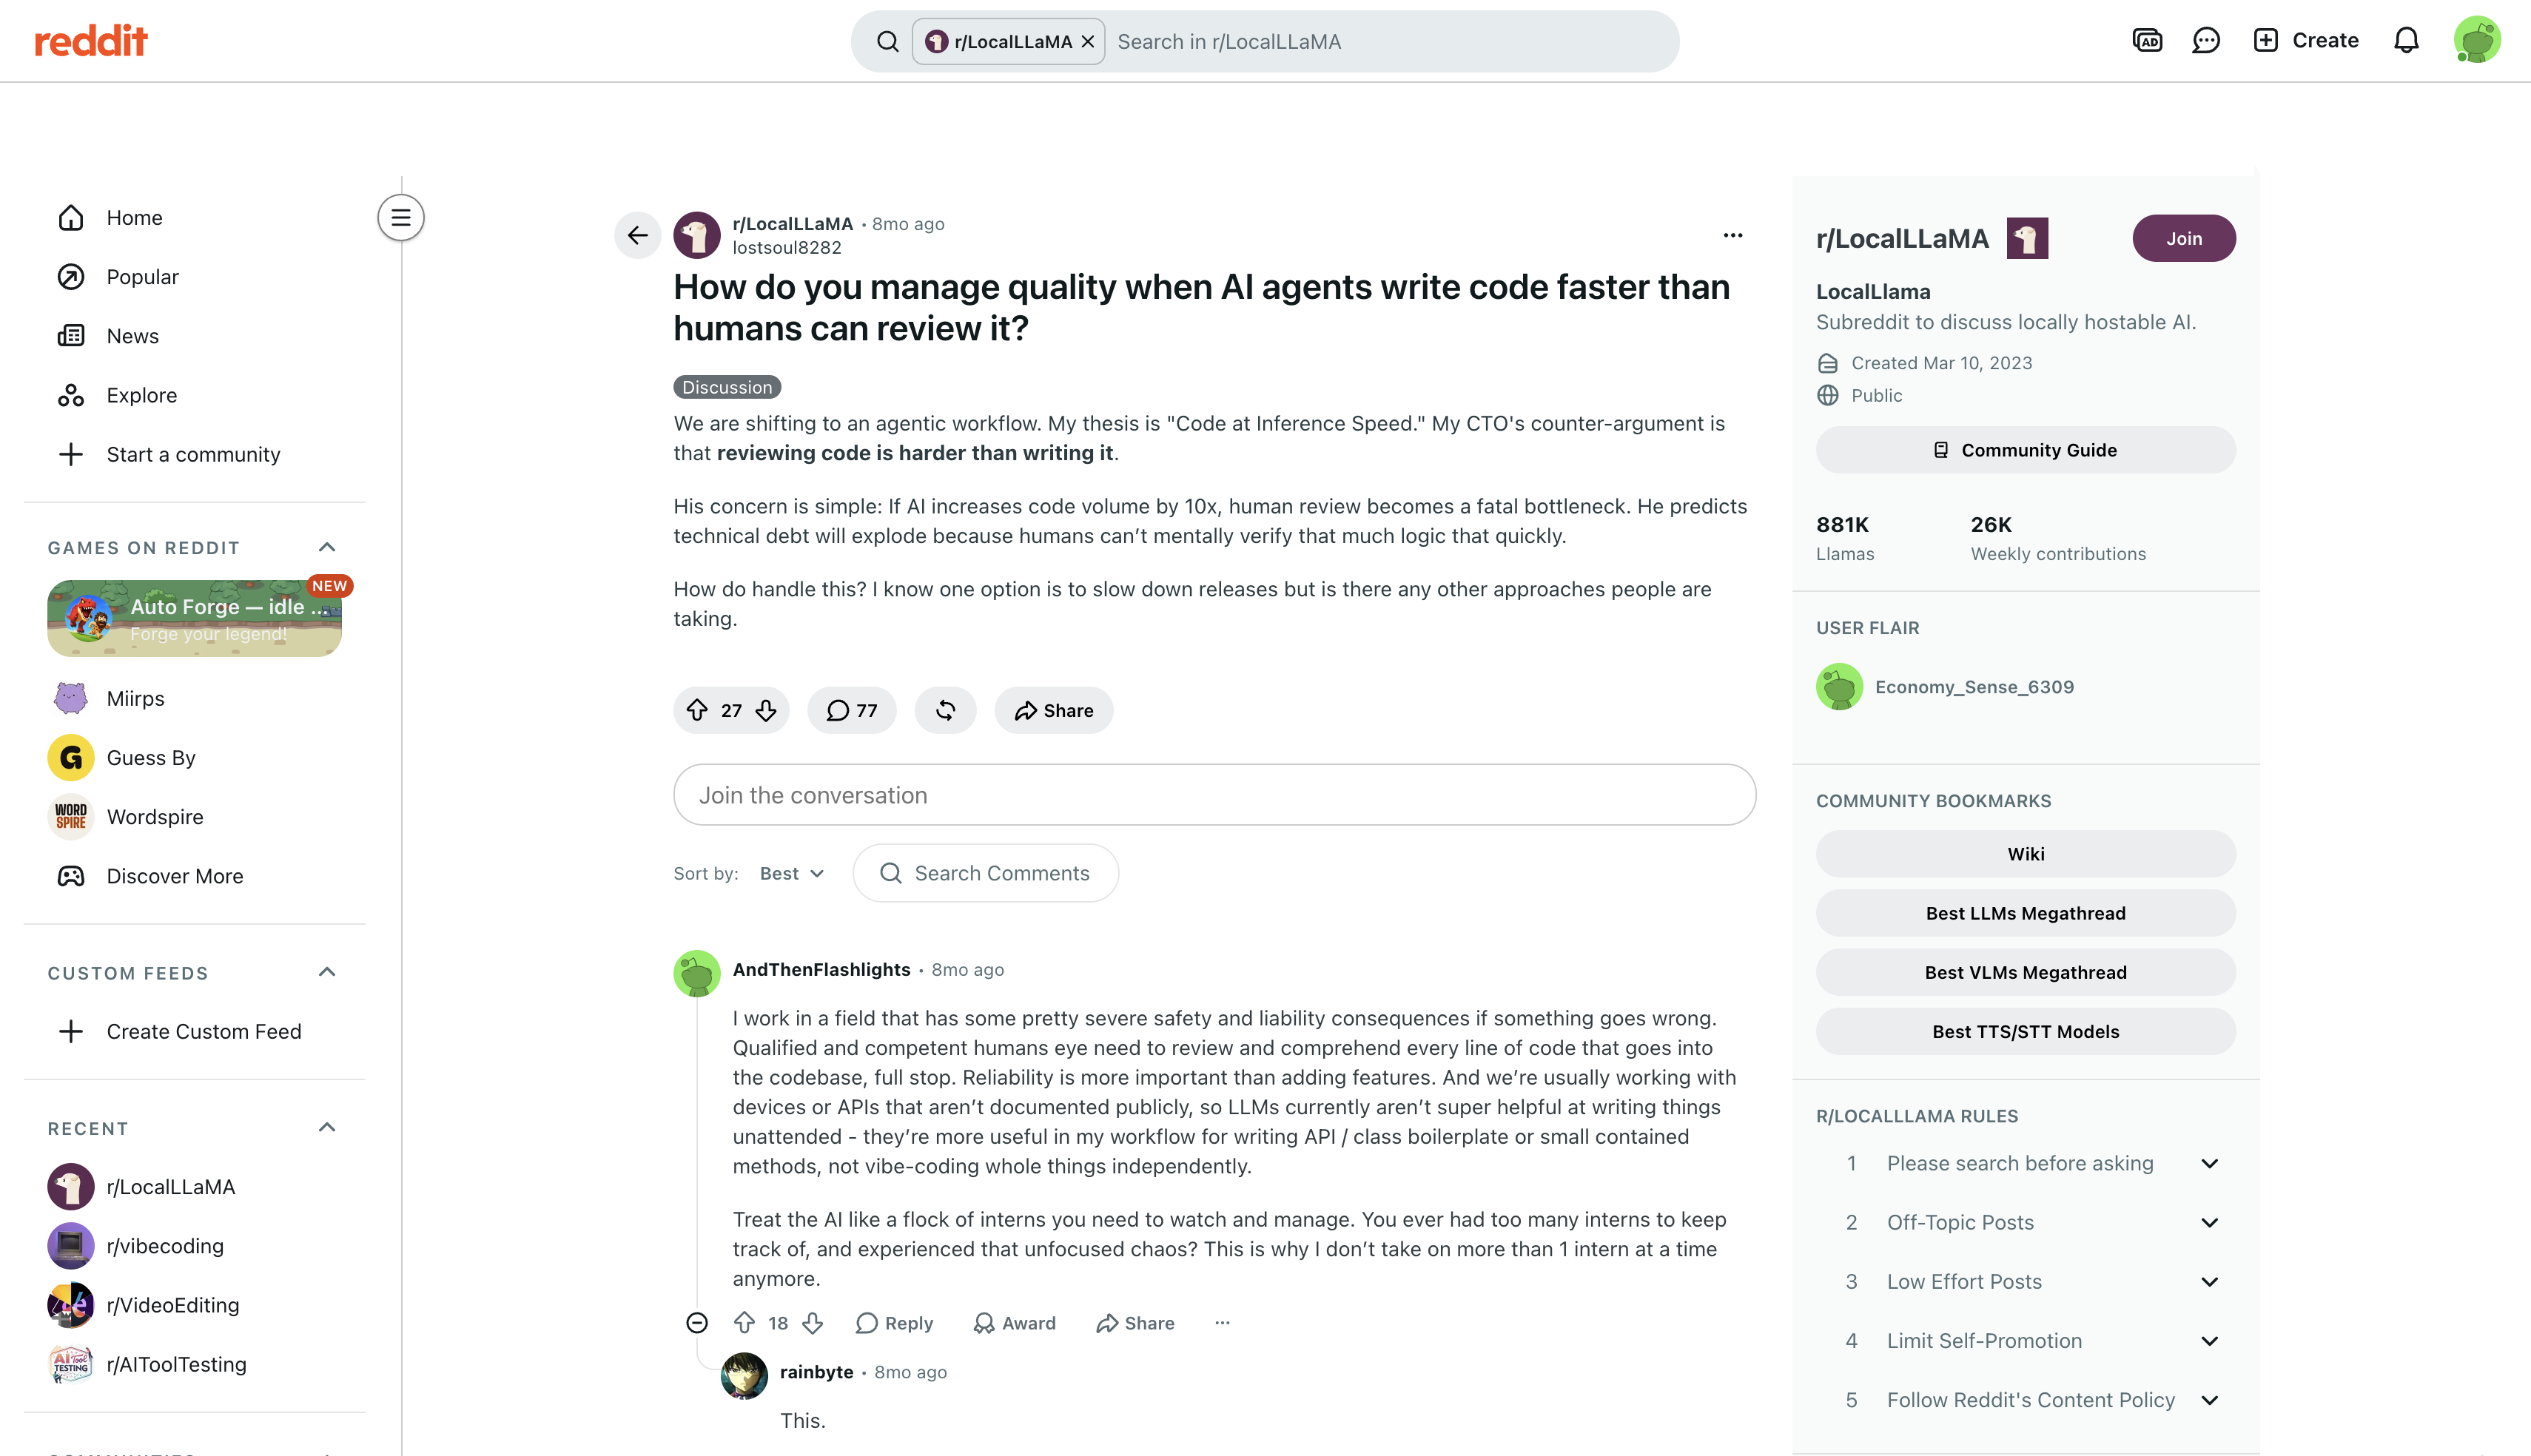
- Discussões em fóruns de engenharia como o r/LocalLLaMA enfatizam que a supervisão humana continua sendo estritamente necessária. Embora a geração autônoma acelere as construções iniciais, os desenvolvedores devem gerenciar ativamente dependências de estado complexas para evitar a deriva lógica.
Preferências de modelo da comunidade:
- Fluxos de trabalho sem configuração: Engenheiros favorecem fortemente configurações baseadas em nuvem integradas diretamente a editores de código modernos e nativos de IA, para desenvolvimento rápido. O Claude Opus 5 é amplamente citado como o padrão de fato por seu equilíbrio entre precisão zero-shot, retenção de contexto e saída altamente confiável.
- Configurações de entusiastas locais: Muitos desenvolvedores optam por implantações locais para evitar despesas recorrentes de tokens de API e proteger bases de código privadas. Modelos open source como Qwen3-Coder-Next e DeepSeek V4-Pro são amplamente recomendados para autogerenciamento via runtimes como o Ollama, oferecendo geração de código forte com zero telemetria de dados.
Conclusão
No fim das contas, nenhum único melhor LLM para programar se encaixa perfeitamente em todos os casos de uso de engenharia em 2026. Modelos frontier em nuvem entregam o poder de raciocínio bruto necessário para refatoração de sistemas complexos e design estrutural. Para segurança empresarial, o melhor LLM local para programar garante zero vazamento de dados em ambientes altamente sensíveis. Enquanto isso, adotar agentes de desenvolvimento autônomos simplifica a entrega completa de aplicações, do conceito inicial ao deployment em produção. Avalie o orçamento, as capacidades de hardware e as políticas de segurança de dados da sua equipe antes de se comprometer com um único ecossistema. Inicie um IDE e configure algumas chaves de API ou runtimes locais. Faça benchmark desses modelos com sua base de código para descobrir qual conjunto de ferramentas eleva seu fluxo de trabalho de engenharia.
Perguntas frequentes sobre o melhor LLM para programar
Qual LLM é melhor para programar em 2026?
O Claude Opus 5 é atualmente o melhor LLM de código para engenharia de software complexa, refatoração multiarquivo e loops de agentes autônomos. Para desenvolvedores que buscam execução determinística e integração ampla com IDE, o GPT-5.6 Sol serve como a melhor alternativa em nuvem. Equipes que priorizam privacidade rigorosa de dados podem implantar localmente potências de peso aberto como GLM-5.2 ou DeepSeek V4-Pro, sem dependências de nuvem.
Qual é o melhor LLM local para programar em notebooks de consumo?
Qwen3-Coder-Next e GLM-5.2 são altamente otimizados para ambientes locais. O Qwen3-Coder-Next oferece ótima eficiência por parâmetro em hardware modesto, enquanto o GLM-5.2 é o melhor codificador de peso aberto com um contexto de 1M de tokens.
Quanta RAM e VRAM são necessárias para executar modelos LLM locais?
Para executar confortavelmente um modelo de codificação padrão de 7 bilhões de parâmetros, você precisa de pelo menos 8 GB de VRAM de GPU ou memória unificada da Apple. Modelos maiores de 14 bilhões exigem cerca de 16 GB, enquanto modelos massivos de nível empresarial de 70 bilhões exigem entre 48 GB e 64 GB de VRAM para funcionar sem problemas.
Modelos de codificação em nuvem são seguros para código corporativo proprietário?
Isso depende inteira e exclusivamente da política de retenção de API do provedor específico. Embora acordos de API empresariais de alto nível geralmente prometam não treinar com dados do usuário, a conformidade corporativa estrita e regulamentações governamentais frequentemente exigem modelos locais totalmente isolados para garantir segurança absoluta.
O que é "vibe coding" e qual modelo é mais adequado para isso?
Isso se refere a um fluxo de trabalho de desenvolvimento moderno em que um engenheiro direciona a lógica da aplicação usando prompts amplos e de alto nível em linguagem natural, enquanto a IA lida autonomamente com toda a geração de boilerplate e escrita de sintaxe. Modelos frontier como Claude Opus 5 e GPT-5.6 Sol se destacam fortemente nessa metodologia para codificação agêntica e grandes refatorações.
Como os modelos de codificação open source se comparam ao Claude Fable 5?
Modelos de peso aberto como GLM-5.2 e DeepSeek V4-Pro estão reduzindo rapidamente a lacuna, superando baselines anteriores como o GPT-5.5 no SWE-bench Pro e em desafios algorítmicos. No entanto, motores frontier como GPT-5.6 Sol e Claude Fable 5 ainda mantêm uma vantagem distinta em refatorações massivas e loops de agentes complexos.
LLMs de codificação podem substituir engenheiros de software humanos?
Não. Esses modelos atualmente atuam como compiladores altamente avançados e poderosos aceleradores de fluxo de trabalho. Eles ainda exigem absolutamente engenheiros humanos experientes para projetar meticulosamente a arquitetura do sistema, gerenciar protocolos de segurança complexos e verificar rigorosamente a lógica funcional antes do deployment em produção.
Qual é o melhor LLM open source gratuito para desenvolvimento Python?
GLM-5.2 e Qwen3-Coder-Next possuem ambos capacidades extensas e altamente especializadas. O GLM-5.2 se estende até um contexto de 1M de tokens para grandes bases de código, enquanto o Qwen3-Coder-Next oferece excelente eficiência para implantações locais menores, tornando ambos escolhas gratuitas excepcionais para fluxos de trabalho de desenvolvimento web padrão.





