
Análise do GLM-5: versões, benchmarks, preços e acesso
Compare as versões do GLM-5, seus benchmarks, preços, arquitetura, deploy local, acesso via API e integração com o Enter Pro.
O GLM-5 já não é um único modelo que pode ser avaliado com base em um único benchmark. É uma família ágil: algumas variantes processam apenas texto, outras aceitam imagens como entrada, versões mais recentes ampliaram a janela de contexto para 1 milhão de tokens, e a opção mais barata custa apenas uma fração do modelo principal.
Antes de atualizar esta análise, revisei as notas de lançamento, as fichas de modelo, a documentação da API, o repositório e capturas de tela reais do produto da Z.ai. Isso é importante porque algumas das afirmações são bastante atraentes — como um ganho interno de 50% em codificação ou um custo computacional 2,9 vezes menor em contexto longo — e vêm da própria Z.ai, não de uma auditoria independente. Por isso, apresento essas afirmações como tal, não como resultados de testes que fiz pessoalmente.
Ao escolher um modelo GLM-5, há quatro perguntas a considerar: quais entradas você tem? Qual é o nível de dificuldade da tarefa? Onde a inferência precisa ser executada? Quanto custa um resultado bem-sucedido se houver repetições? Minha resposta rápida: GLM-5.3 para texto/código mais complexo, GLM-5.3-Flash para multimodalidade ou economia, e GLM-5.2 se você já tem uma integração validada.
O que é o GLM-5?
GLM-5 é a família de modelos de pesos abertos desenvolvida pela Z.ai para engenharia de software, uso de ferramentas e agentes de longo horizonte. O lançamento original (fevereiro de 2026) é um modelo Mixture-of-Experts (MoE) somente de entrada e saída em texto, com 744 bilhões de parâmetros totais, aproximadamente 40 bilhões de parâmetros ativos por token, e uma janela de contexto de 200.000 tokens. Essas especificações vêm do relatório técnico do GLM-5 e do repositório oficial no GitHub.
Um modelo MoE não ativa toda a rede para cada token. Um roteador envia cada token para um pequeno grupo de especialistas, reduzindo a computação ativa enquanto mantém um checkpoint muito grande. Isso não torna o GLM-5 um modelo para notebook: os pesos completos ainda precisam de armazenamento, roteamento e hardware de nível servidor.
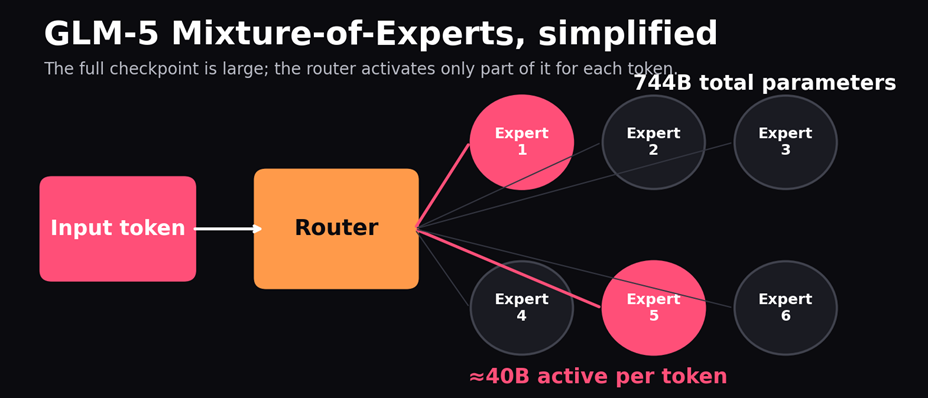
Figura 1. O GLM-5 ativa aproximadamente 40B dos 744B parâmetros por token; o checkpoint completo continua sendo um deploy em escala de servidor.
O termo correto é "pesos abertos" (open weights). Existem termos diferentes para código, pesos do modelo, serviço hospedado e dados de treinamento. Consulte a licença que acompanha a ficha de modelo que pretende usar antes de qualquer uso comercial, já que nem todas as versões do GLM têm os mesmos direitos.
A família de versões do GLM-5
O nome da família esconde diferenças importantes. Escolha pela modalidade, contexto, histórico de validação e via de deploy, em vez de tratar cada versão 5.x como intercambiável.
| Versão | Entrada/contexto | Melhor motivo para usar | Ressalva importante |
|---|---|---|---|
| GLM-5 | Texto / 200K | Pesquisa original ou integração legada | Primeiro lançamento da família; não é minha escolha padrão para um novo projeto |
| GLM-5-Turbo | Texto / 200K | Trabalho de agentes hospedado e intensivo em ferramentas | Uma via de provedor, não um checkpoint pequeno para download |
| GLM-5V-Turbo | Texto, imagens, vídeo, arquivos / 200K | Codificação visual e tarefas de GUI | Confirme os formatos aceitos no seu endpoint |
| GLM-5.1 | Texto / 200K | Execuções de engenharia sustentadas | Superado para a maioria das novas avaliações |
| GLM-5.2 | Texto / 1M | Contexto longo e integrações já comprovadas | A migração para 5.3 muda o comportamento de raciocínio |
| GLM-5.3 | Texto / 1M | Codificação difícil e agentes de longa duração | O raciocínio está sempre ativo; a saída pode ser longa |
| GLM-5.3-Flash | Multimodal / 1M | Capturas de tela, volume e baixo custo | Arquitetura separada 320B/18B, não é "5.3 com baixo esforço" |
Fontes: notas de lançamento da Z.ai, guia do GLM-5-Turbo, guia do GLM-5V-Turbo e guia do GLM-5.1. Um host pode expor uma janela de contexto menor do que o modelo suporta.
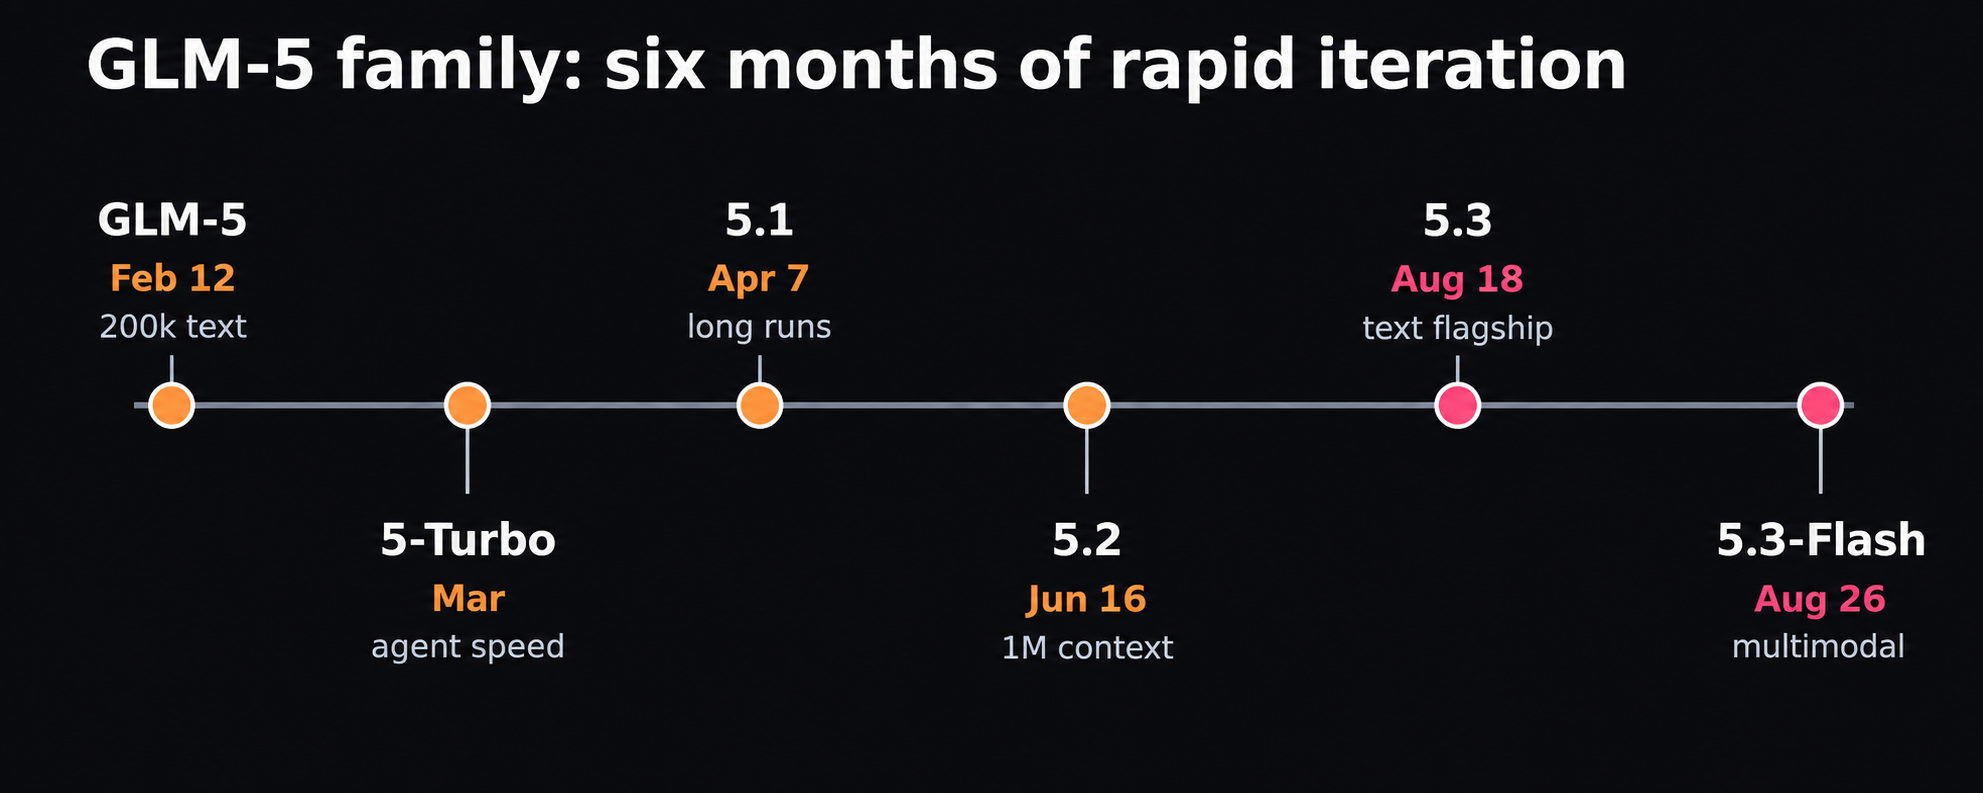
Figura 2. Seis meses de lançamentos mudaram o tamanho do contexto, a modalidade, o comportamento de raciocínio e o preço.
Do GLM-5 ao GLM-5.2
A arquitetura baseada em agentes foi estabelecida no GLM-5 base. O GLM-5.1 focou em execuções sustentadas; a Z.ai afirma que ele pode rodar por até 8 horas, mas vale levar isso com cautela, já que o seu repositório pode se comportar de forma diferente. Depois, o GLM-5.2 recebeu uma janela de contexto de um milhão de tokens, configurações flexíveis de esforço e o IndexShare, para atenção eficiente em contextos longos.
GLM-5.3 e GLM-5.3-Flash
O modelo principal da linha GLM é somente texto: o GLM-5.3. Segundo a documentação, ele tem um limite de 1 milhão de tokens na entrada, um limite de 128K na saída, e níveis de esforço de raciocínio baixo, alto ou máximo. O "thinking" não pode ser desativado; uma requisição do 5.2 que o desative explicitamente pode falhar durante a migração.
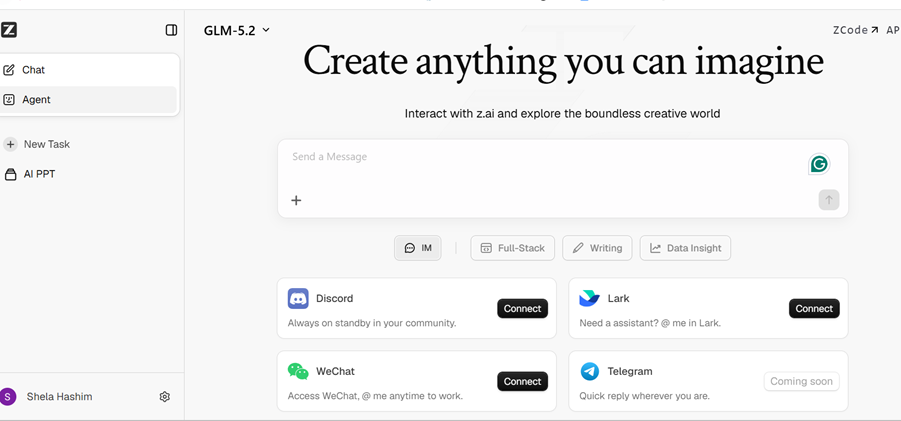
Figura 3. A interface ativa do GLM-5.3 confirma uma via principal distinta; a disponibilidade e os rótulos podem mudar.
O GLM-5.3-Flash é outro modelo, com 320B de parâmetros totais/18B ativos, com entrada multimodal nativa e atenção híbrida sparse/linear. Minha recomendação inicial é bem direta: quando profundidade é importante, use o 5.3; quando o assunto é capturas de tela ou grande volume, teste primeiro o Flash.
Antes de alterar uma integração existente, reproduza requisições salvas em vez de apenas trocar o nome do modelo. Teste saída estruturada, argumentos de chamadas de ferramentas, tamanho máximo de resposta e tratamento de timeouts. Uma resposta pode parecer mais atraente em chats, mas pode fazer o parser falhar ou simplesmente exceder o limite de latência da sua aplicação. Mantenha a via antiga ativa até que a nova versão passe pelos mesmos testes de produção.
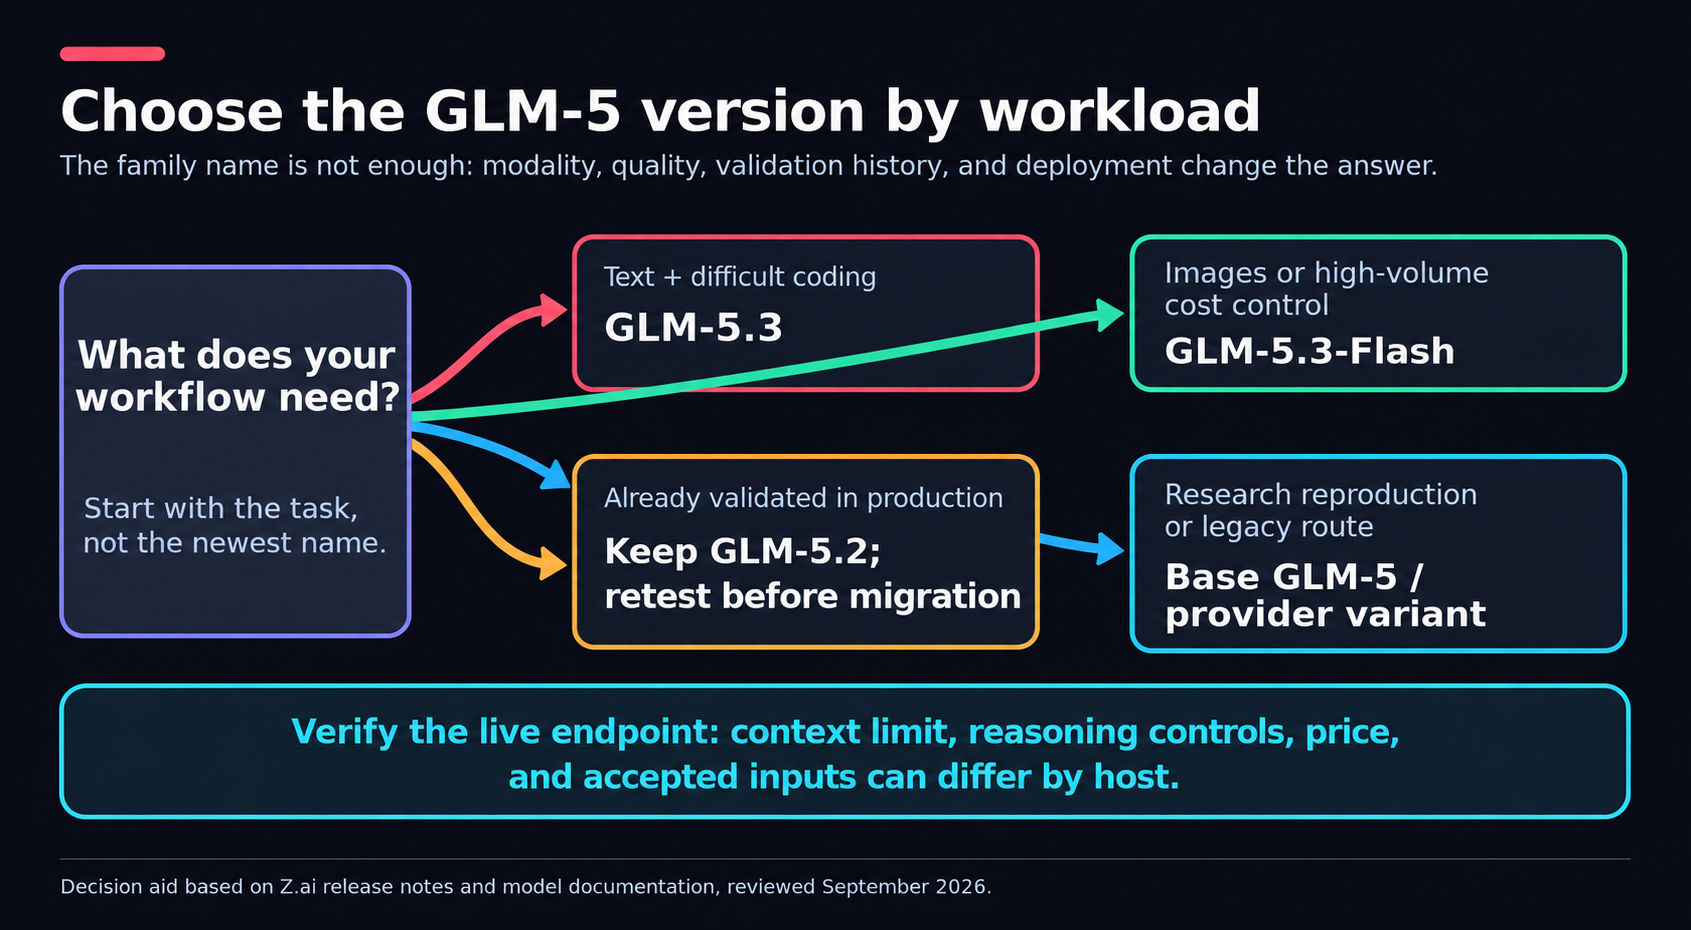
Figura 4. Escolha pela carga de trabalho e pelo comportamento do endpoint, não só pelo nome do modelo mais recente.
Como o GLM-5 se compara ao Claude, GPT e Gemini?
O GLM-5.3 merece estar em qualquer lista curta de agentes de codificação, mas uma única tabela não pode coroar um vencedor absoluto. As pontuações do Terminal-Bench dependem do harness, das permissões de ferramentas, do orçamento de tempo e do nível de esforço. A Z.ai relata 88,2 no Terminal-Bench 2.1 e 28,3 no Terminal-Bench 3.0 para o GLM-5.3 com esforço máximo; sua tabela também reproduz resultados do Claude Opus 4.8 e do GPT-5.6 Sol.
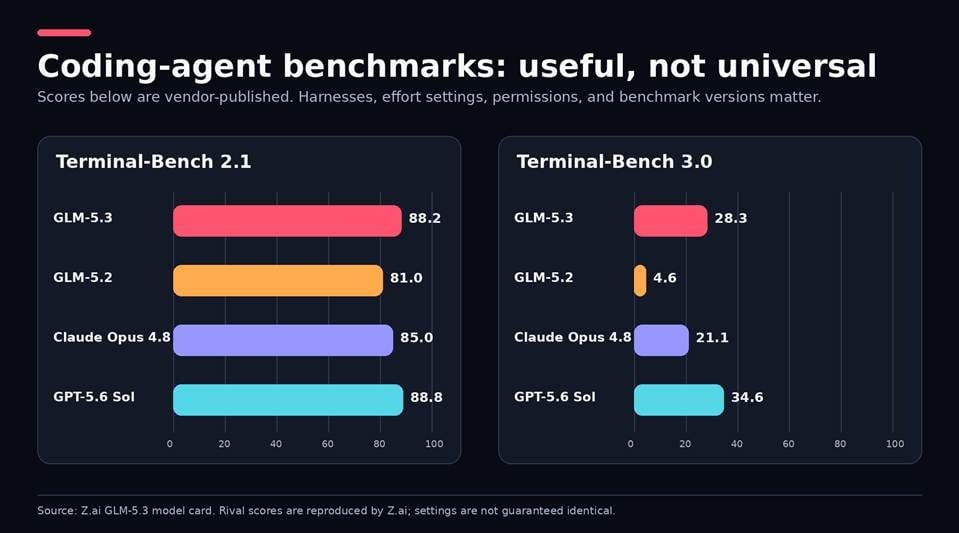
Figura 5. Pontuações publicadas pelo fornecedor são evidências direcionais, não substituem um teste idêntico e específico para sua carga de trabalho.
Diferente de outros modelos, a ficha do GLM-5.3 nomeia seus harnesses e configurações de esforço. Ela não afirma que os modelos concorrentes foram operados em condições idênticas. De forma semelhante, segundo o relatório do GLM-5.2, ele supera o Gemini 3.1 Pro em um subconjunto de tarefas do Terminal-Bench 2.1, uma pequena parte das tarefas de codificação mencionadas aqui; porém, isso não indica que o GLM supere o Gemini 3.1 Pro em todas as tarefas multimodais, de pesquisa ou de escrita.
Eu avaliaria os modelos com os mesmos prompts, ferramentas, timeout e critérios de aprovação. O importante é observar o preço de uma tarefa bem-sucedida, NÃO o preço do token. Um modelo mais barato que falha três vezes pode acabar sendo o mais caro, e quando o Flash resolve seus testes na primeira tentativa, a vantagem de um modelo principal se torna irrelevante.
A ficha do GLM-5.3 é razoavelmente peculiar ao exibir os nomes dos harnesses e os níveis de esforço. Se outros modelos concorrentes foram testados nas mesmas condições ainda precisa ser demonstrado. Da mesma forma, o guia do GLM-5.2 afirma que ele supera o Gemini 3.1 Pro no Terminal-Bench 2.1 — uma tarefa orientada a agentes de codificação — e não necessariamente em tarefas multimodais, de pesquisa ou de escrita.
Eu analisaria os modelos usando os mesmos prompts, ferramentas, timeout e critério de aprovação. Focando apenas no custo da tarefa bem-sucedida, NÃO no preço do token. Se os testes passarem de primeira, o Flash talvez seja a opção mais em conta, reduzindo também a vantagem de um modelo principal.
Por dentro do treinamento e da arquitetura do GLM-5
Sparse Attention e IndexShare
O contexto longo é custoso porque a atenção normalmente considera muitas relações entre tokens. No GLM-5.2, foi introduzido um indexador que é reutilizado em quatro camadas diferentes de atenção para encontrar os locais corretos. A Z.ai afirma obter 2,9 vezes menos FLOPs por token em 1M de tokens. É uma declaração de eficiência do desenvolvedor, não uma declaração sobre latência do endpoint ou custo real das requisições.
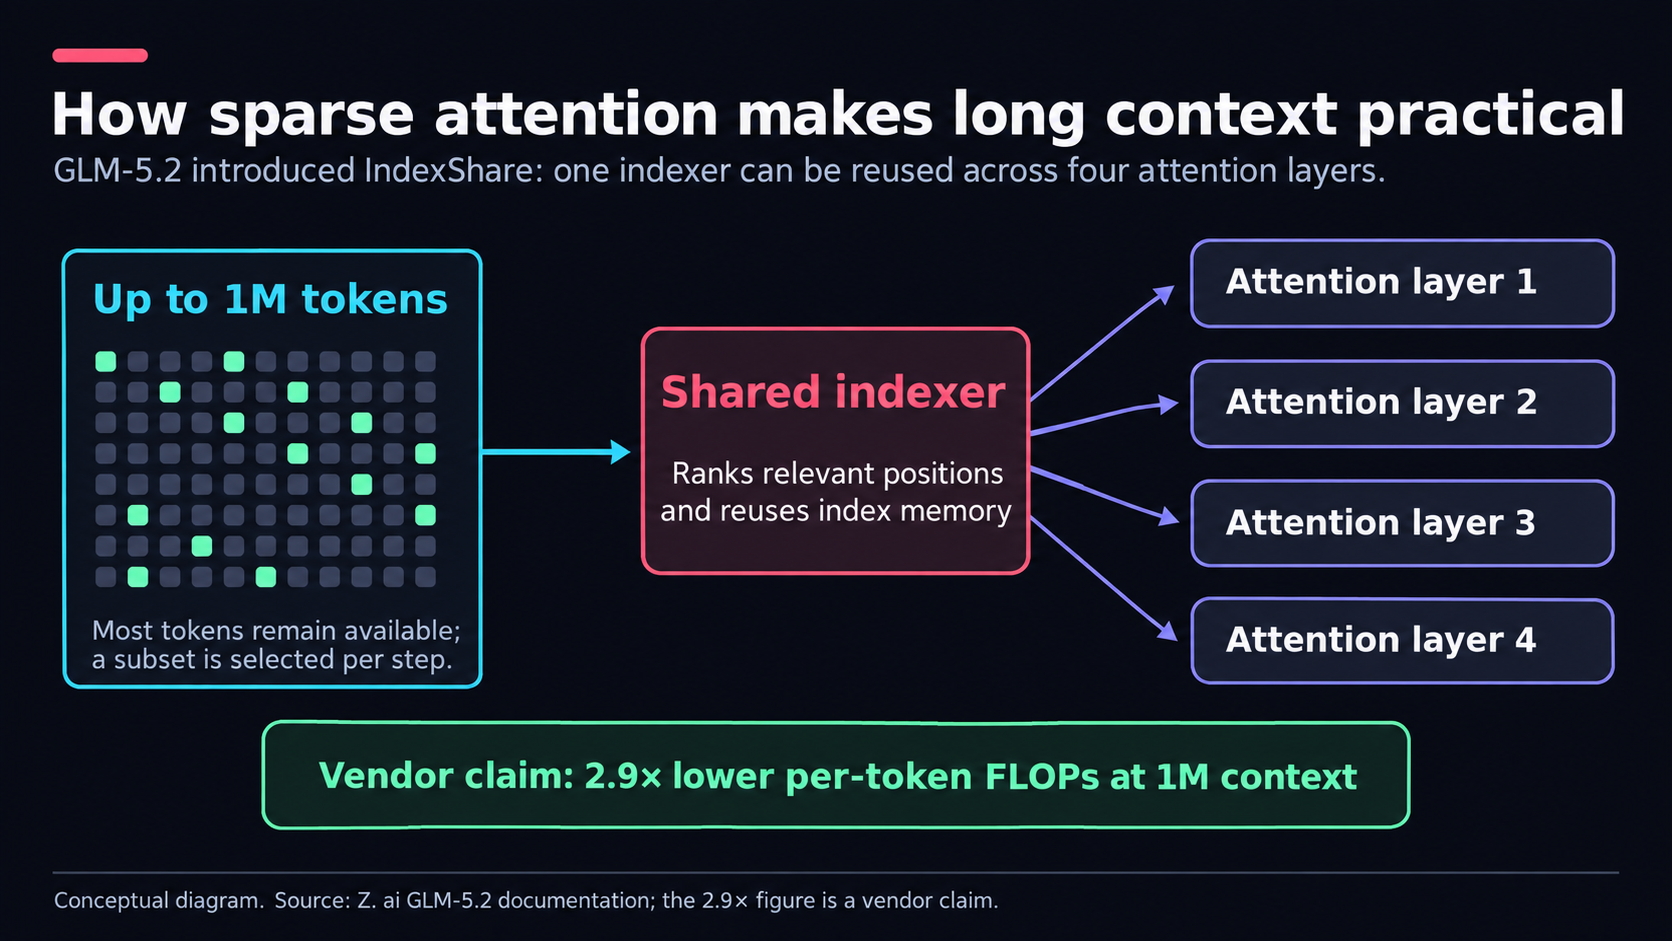
Figura 6. O IndexShare reutiliza um indexador em quatro camadas de atenção; o número 2,9x é uma afirmação da Z.ai.
Aprendizado por reforço de longo horizonte
Para o GLM-5.3, a Z.ai apresenta sua própria visão de um sistema de aprendizado por reforço assíncrono chamado "slime", junto com compactação de contexto e verificadores sintetizados. Essas técnicas focam nos erros típicos observados em agentes durante execuções longas: perder o objetivo de vista, abandonar uma tarefa ou não verificar a resposta. Mesmo assim, checkpoints e testes externos continuam necessários, o que pode implicar trajetórias mais longas e rastros de falha maiores.
A capacidade de cibersegurança precisa de validação humana
Como parte de sua colaboração em segurança, a Z.ai revela 2.436 vulnerabilidades em 269 projetos open source, das quais 1.097 são de severidade média a alta. Esses números provavelmente são relevantes para o GLM-5.3 em revisões defensivas, mas o GLM-5.3 não identifica uma vulnerabilidade confirmada, apenas um achado do modelo.
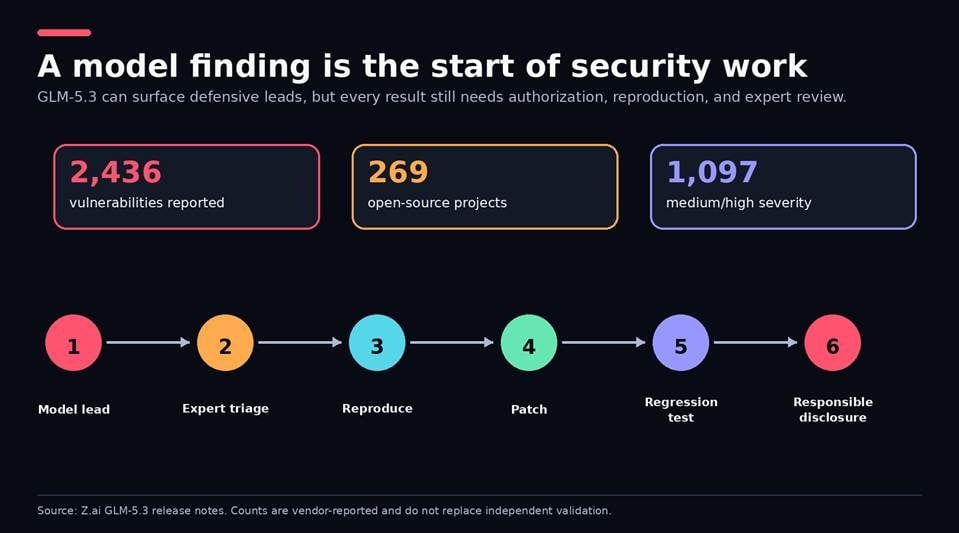
Figura 7. Reproduza, corrija, faça testes de regressão e divulgue de forma responsável; nunca direcione um agente contra sistemas que você não está autorizado a testar.
Preços do GLM-5
A Z.ai separa os custos de entrada sem cache, entrada com cache e saída desde setembro de 2026. Verifiquei novamente esses preços na página oficial de preços; não assuma que permanecerão assim ao planejar um orçamento, pois podem variar com o tempo.
| Modelo | Entrada / 1M | Entrada com cache / 1M | Saída / 1M |
|---|---|---|---|
| GLM-5 | US$ 1,00 | US$ 0,20 | US$ 3,20 |
| GLM-5.1 | US$ 1,40 | US$ 0,26 | US$ 4,40 |
| GLM-5.2 | US$ 1,40 | US$ 0,26 | US$ 4,40 |
| GLM-5.3 | US$ 1,40 | US$ 0,26 | US$ 4,40 |
| GLM-5.3-Flash | US$ 0,15 | US$ 0,03 | US$ 0,50 |
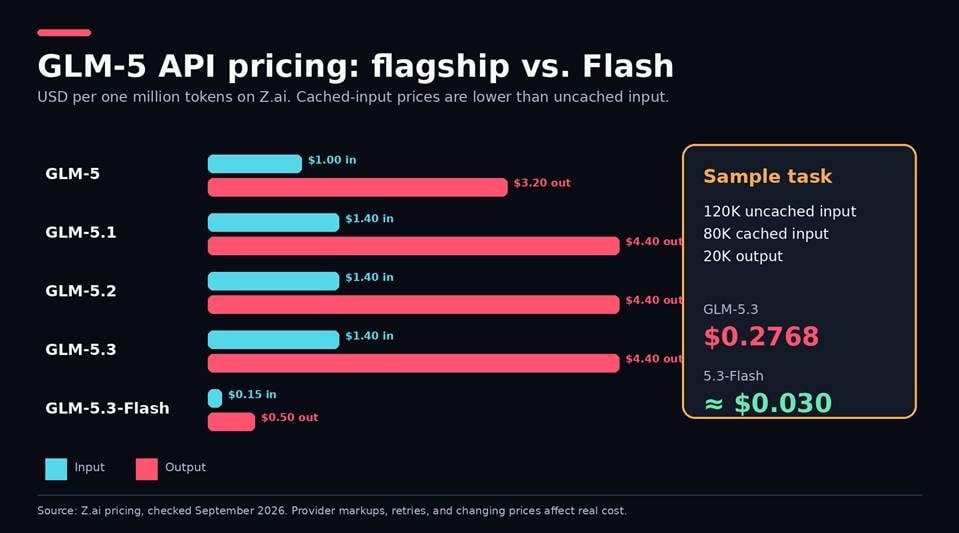
Figura 8. Os preços da API da Z.ai mostram por que o comprimento da saída e as repetições podem dominar a conta final.
O custo do GLM-5.3 é de aproximadamente US$ 0,2768 para 120K de entrada sem cache, 80K de entrada com cache e 20K de saída; o do 5.3-Flash é de aproximadamente US$ 0,030 (excluindo repetições). Outros hosts, como o OpenRouter, podem oferecer preços, limites, latência e roteamento diferentes. O GLM Coding Plan não é uma cota de API de produção, mas sim uma assinatura separada para ferramentas de codificação suportadas.
A saída é o aspecto mais caro da requisição, e um agente que raciocina por muito tempo pode facilmente superar uma estimativa rápida. Eu colocaria um teto para a saída, usaria cache onde o contexto repetido se qualificar, e registraria o custo por tarefa concluída. Ao montar um orçamento de produção, considere repetições, chamadas de ferramentas sem sucesso e o tempo humano necessário para corrigir respostas fracas. Esse é o número que você deve comparar entre provedores.
Como usar o GLM-5
| Via | Melhor para | Onde a inferência roda |
|---|---|---|
| Z.ai Chat | Avaliação qualitativa rápida | Servidores da Z.ai |
| API da Z.ai | Integração de primeira parte | Servidores da Z.ai |
| OpenRouter | Escolha de provedor e failover | Provedor hospedado selecionado |
| Enter MaaS | Acesso ao modelo dentro de um fluxo de criação de apps | Via hospedada visível no Enter |
| Hugging Face + vLLM/SGLang | Deploy autogerenciado | Sua própria infraestrutura |
| Ollama :cloud | Acesso remoto via cliente Ollama | Servidores remotos, não seu notebook |
Comece com o Z.ai Chat
A via de menor atrito para testar o GLM-5 em chat é o chat.z.ai. Use-o para testar o comportamento dos prompts e a estrutura da saída, mas observe o modelo exato exibido na interface. Não prometa a um time um uso "gratuito" ou "ilimitado" sem verificar a cota atual da conta.
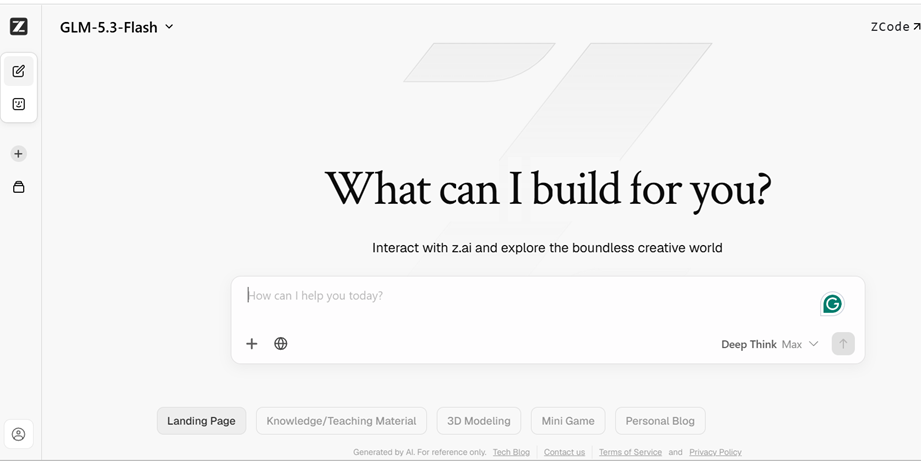
Figura 9. A interface de chat é uma verificação qualitativa rápida, mas o modelo exibido e a cota da conta ainda importam.
Chame a API da Z.ai ou o OpenRouter
A Z.ai oferece um endpoint compatível com a OpenAI, o que significa que o SDK oficial em Python pode ser usado com uma URL base diferente. Armazene a chave de API em uma variável de ambiente e registre o ID do modelo, o esforço, o número de tokens usados e se a requisição foi concluída.
Figura 10. O endpoint compatível com a OpenAI da Z.ai reduz alterações no SDK; não elimina a necessidade de testes de migração.
import os

from openai import OpenAI

client = OpenAI(

        api_key=os.environ["ZAI_API_KEY"],

        base_url="https://api.z.ai/api/paas/v4/",

)

response = client.chat.completions.create(

        model="glm-5.3",

        messages=[{"role": "user", "content": "List five tests for a password-reset flow."}],

        max_tokens=4096,

        extra_body={"thinking": {"type": "enabled"}, "reasoning_effort": "high"},

)

print(response.choices[0].message.content)
Ao migrar do 5.2, remova qualquer requisição que desative explicitamente o "thinking"; o GLM-5.3 não aceita esse comportamento. Se você usar a via GLM-5.3 do OpenRouter, registre qual provedor tratou a requisição quando governança ou reprodutibilidade forem importantes.
Baixe e hospede os pesos você mesmo
Use o repositório oficial ou a ficha verificada do GLM-5.3 no Hugging Face. A Z.ai lista SGLang, vLLM, Transformers, KTransformers e Unsloth entre os caminhos suportados.
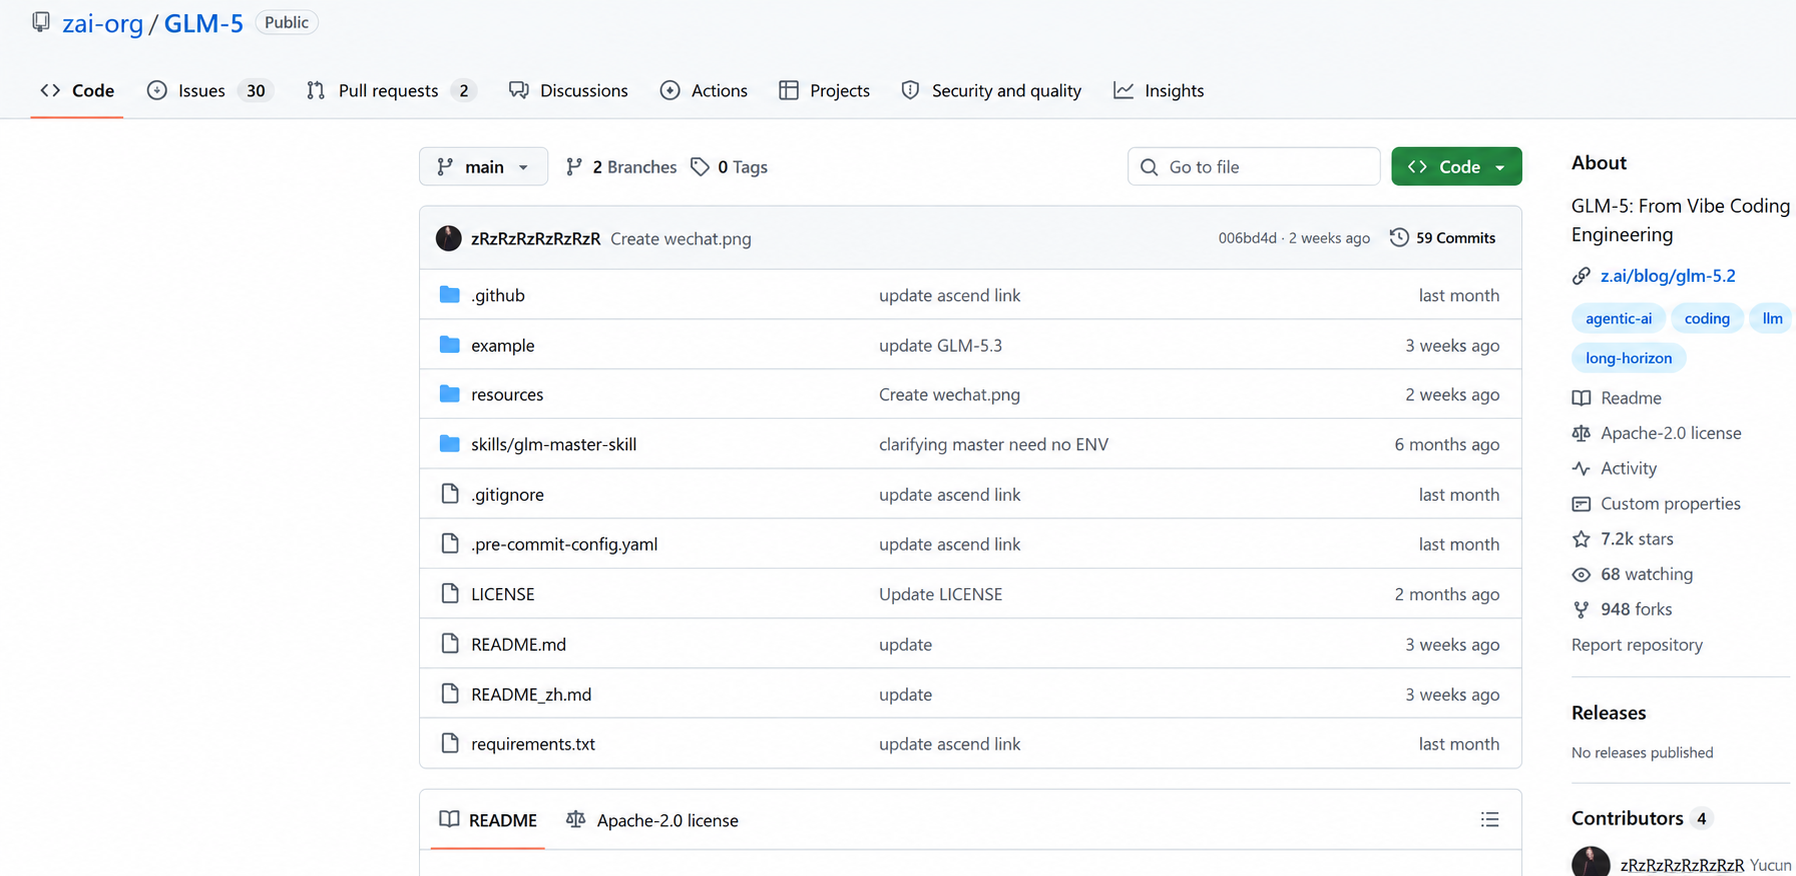
Figura 11. Use o repositório verificado e a ficha de modelo oficial, não um espelho não oficial dos pesos.
Ser possível baixar NÃO significa ser possível executar. A quantização reduz os requisitos de memória, mas pode alterar a qualidade; com um checkpoint de 744B, armazenamento e aceleradores de nível servidor são necessários. Leia com atenção a listagem do GLM-5 no Ollama: uma tag com "cloud" significa que é inferência remota. É preciso ter pesos locais, runtime local e hardware suficiente para uma execução verdadeiramente local.
Como eu avaliaria o GLM-5 antes de colocar em produção
Eu não começaria com uma pergunta genérica do tipo "qual modelo é mais inteligente?". Executaria quatro tarefas representativas contra o 5.2, o 5.3 e o Flash usando as mesmas ferramentas e limites: corrigir um bug em um repositório, recuperar fatos plantados em um documento longo, concluir um fluxo de trabalho com múltiplas ferramentas e uma falha induzida, e produzir uma saída avaliada contra uma rubrica escrita.
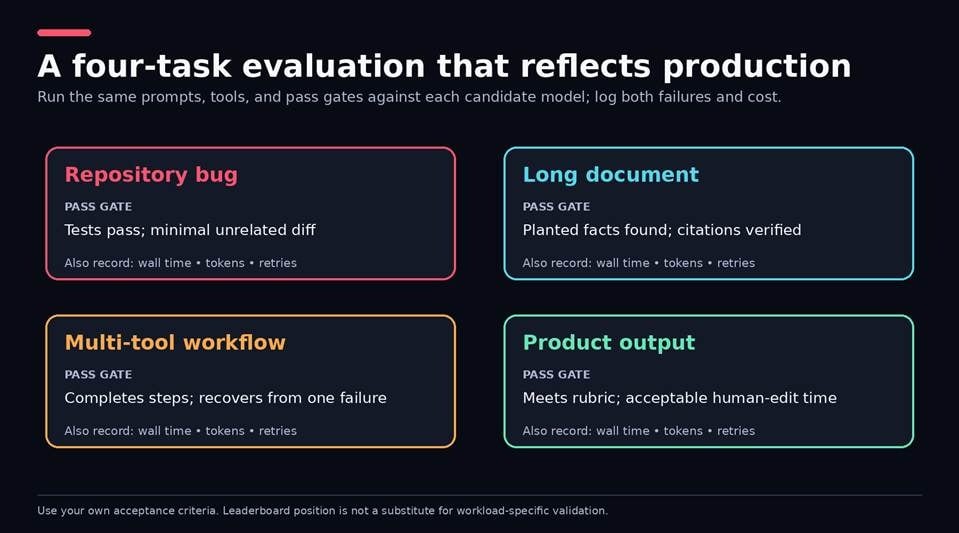
Figura 12. Um teste de carga de trabalho pequeno e repetível é mais útil do que uma pergunta genérica sobre o "modelo mais inteligente".
Aprovado/reprovado, tempo real, tokens, repetições, tempo de edição humana e provedor. Isso permite detectar riscos de migração que as médias de benchmark não revelam — como o raciocínio sempre ativo do 5.3 e a saída potencialmente longa. Também mostra se o preço mais baixo do Flash sobrevive ao contato com seus testes de aceitação.
Quem deveria usar o GLM-5?
Codificação agêntica e trabalho em repositório
O GLM-5 é uma excelente opção quando uma tarefa envolve buscar em um repositório, edições coordenadas, execução de testes e chamadas de ferramentas. As evidências públicas de benchmark apoiam essa indicação, mas seu portão de aceitação deve ser sólido: os testes precisam passar, o diff precisa ser focado, e nenhum limite de credencial ou de rede pode ser cruzado. Forneça uma área de trabalho separada e use o princípio do menor privilégio. Mais autonomia sem controles só produz rastros de falha maiores.
Documentos longos e trabalho de conhecimento
Modelos com um milhão de tokens se aplicam bem a especificações, pacotes de pesquisa e grandes bases de código. Uma janela de contexto grande não deve ser considerada recuperação confiável. Posicione informações-chave no início, no meio e no fim; cite fontes; verifique as informações citadas. Eu também consideraria uma pipeline de recuperação, já que colocar tudo em um único prompt grande pode ser mais lento e caro do que primeiro selecionar as evidências úteis.
Fluxos de trabalho multimodais e defensivos
Com o GLM-5.3-Flash ou o GLM-5V-Turbo, capturas de tela, estados de interface ou outras entradas visuais exigidas pelo trabalho passam a fazer parte da rotina. Use todos os achados como pistas para a revisão de segurança defensiva e reproduza e priorize-os. O GLM-5 é menos indicado para quem deseja um pequeno modelo local para notebook, não pode tomar decisões de deploy, ou não consegue verificar a residência do host e os termos de retenção.
O GLM-5 é seguro para dados privados ou corporativos?
Vias hospedadas
Não depende apenas do modelo, mas da via usada. Existem diferentes caminhos de dados, como o Z.ai Chat, a API da Z.ai, outro host, ou um deploy autogerenciado. Comece com a política de privacidade da Z.ai e, em seguida, verifique com todos os intermediários a retenção, o uso para treinamento, a exclusão, a residência de dados e os termos contratuais.
Fixe um provedor específico se um agregador oferecer essa opção, e não envie segredos só porque é conveniente. O que acontece com dados hospedados é determinado pelo seu contrato e configuração, não pelo termo "pesos abertos".
Autogerenciamento (self-hosting)
O self-hosting mantém os prompts no seu ambiente, mas você é responsável pelos pesos, credenciais, patches, controles de rede e monitoramento. Mesmo assim, eu continuaria presumindo que existe uma forma de injetar código gerado inseguro nas etapas iniciais. Separe credenciais de build e de produção, limite o acesso de rede de saída, audite as ações das ferramentas e mantenha aprovações humanas para mudanças relevantes. Não conceda aos agentes mais autoridade do que o necessário para a tarefa.
Como usar o GLM-5 com o Enter Pro
O GLM-5 não é um concorrente direto do Enter Pro. O GLM oferece capacidade de modelo, enquanto o Enter Pro oferece um fluxo de construção de produto em torno dos modelos. Isso é útil quando você não busca apenas "obter uma resposta", mas "obter uma resposta que possa se transformar em interface, lógica e um caminho de publicação".
Se controle de API, infraestrutura personalizada ou uma estrutura de dados específica forem necessários, a via direta é a melhor opção. Quando o contorno a nível de produto se torna um fator limitante, o Enter Pro entra em cena. Seu AI MVP Builder simplifica o planejamento, a criação do app, a edição visual e a publicação em um único processo, enquanto o Enter Code oferece uma abordagem centrada em terminal para tarefas de repositório.
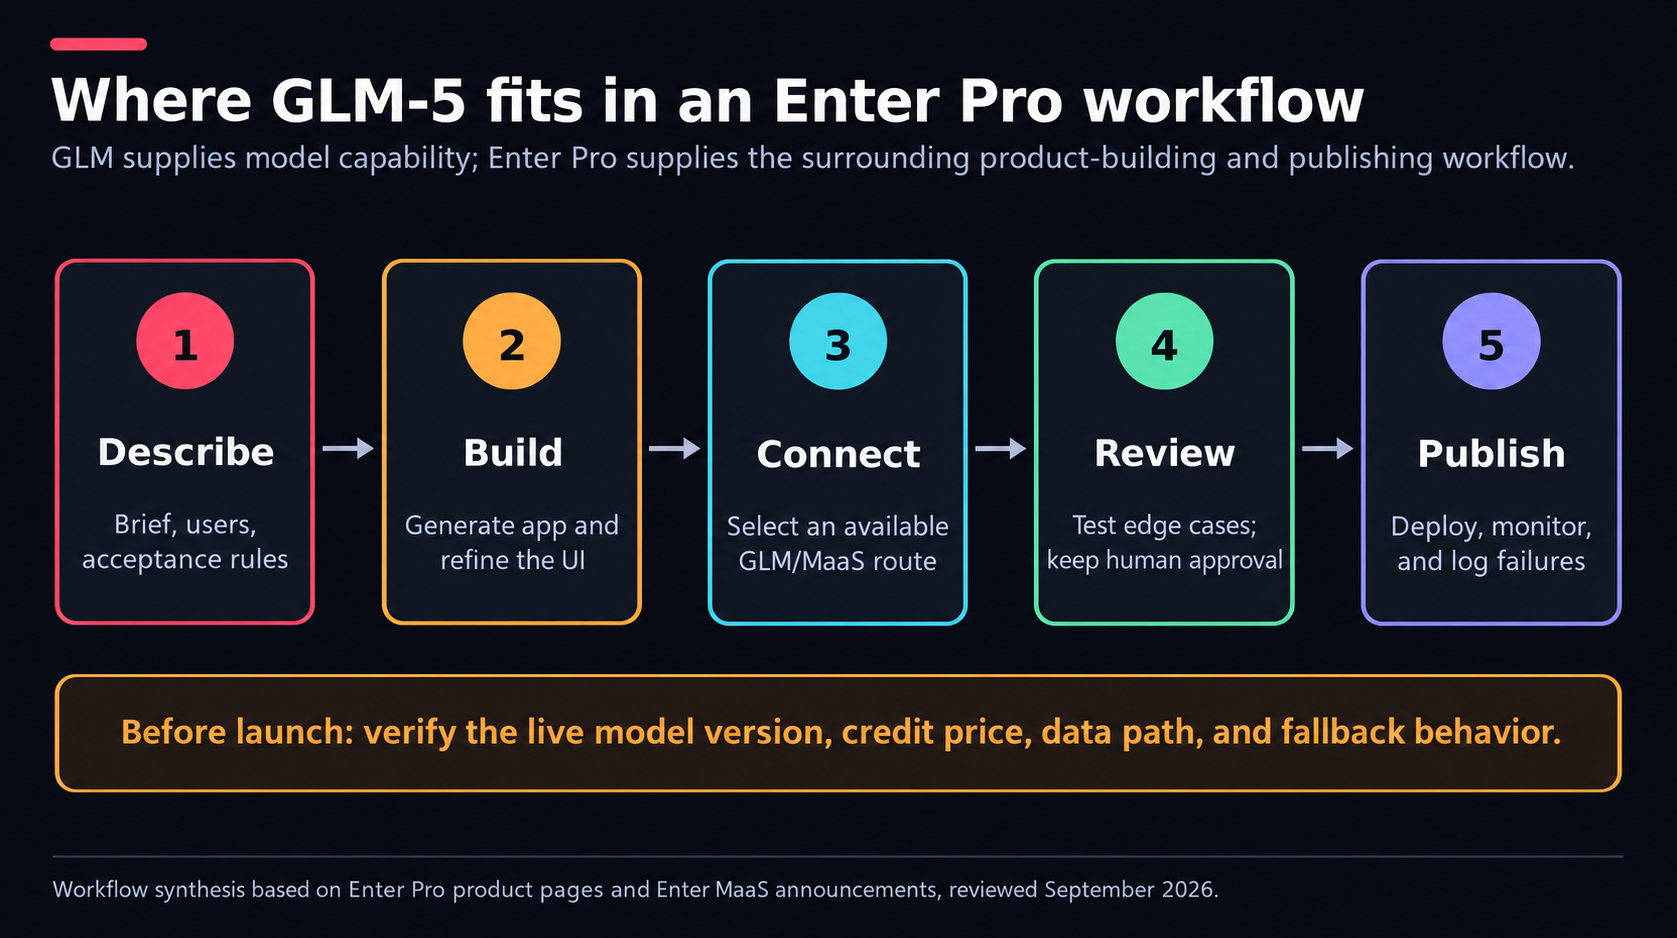
Figura 13. O modelo gera ou classifica; o fluxo de trabalho do produto adiciona UI, revisão, deploy e monitoramento.
O changelog do Enter confirma o GLM-5.2 no catálogo anterior da AI All em 17 de junho. O anúncio do Enter MaaS menciona o GLM 5 e explica como os modelos são precificados em créditos. Ele não confirma explicitamente o GLM-5.3, então vale verificar o seletor de modelos em tempo real, o preço em créditos, o limite de contexto e o caminho dos dados antes de projetar algo em torno de uma versão específica.
Um app de triagem de suporte mostra bem onde essa combinação faz sentido. Com o Enter Pro, você pode desenhar o formulário de tickets e o painel, e conectar uma via GLM existente para categorizar tickets e redigir respostas. Antes de publicar, valide respostas vazias do modelo, solicitações ambíguas, entradas multilíngues, injeção de prompt e dados privados dentro do corpo da mensagem. Mantenha sempre uma pessoa entre o rascunho e o botão de enviar.
| Se sua prioridade é… | Escolha uma via GLM direta | Escolha o Enter Pro |
|---|---|---|
| Parâmetros do modelo e controle do provedor | Sim | Somente dentro das opções expostas |
| Criação e edição visual de apps | Construir ou adicionar ferramentas separadas | Vantagem central do fluxo de trabalho |
| Hosting personalizado e política de rede | Melhor encaixe | Verificar primeiro a adequação da plataforma |
| Caminho rápido da saída do modelo para a UI do produto | Mais engenharia necessária | Melhor encaixe |
Mas o Enter não torna o GLM mais inteligente, e o fato de o GLM ter acesso a um app também não torna seu agente de codificação mais inteligente. Se o objetivo é integração ou trabalho de UI, eu optaria pelo Enter. Se você está nessa posição, abra o workspace do Enter Pro e verifique o catálogo de modelos disponível antes de se comprometer com uma arquitetura.
Conclusão
Embora se chame GLM-5, a variante e o método de disponibilização são igualmente importantes quando se trata de codificação e agentes de longo horizonte! Use o GLM-5.3 para texto e código difíceis, o GLM-5.3-Flash para multimodalidade e/ou volume, e mantenha o 5.2 até que a migração se torne economicamente viável. Depois, teste com suas próprias tarefas antes de usar os números do líder/fornecedor como prova de produção.
O modelo que realmente funciona é aquele que atende seus critérios de aceitação, permanece dentro dos seus limites de latência e privacidade, e ainda mantém o preço certo depois das repetições — independentemente da pontuação quase perfeita que ele possa alcançar naquele benchmark específico.
Comece a construir com o Enter Pro →
Perguntas frequentes
O GLM-5 é gratuito?
Os pesos públicos estão disponíveis para download, sem taxas de API por token, mas hardware e operação terão custo. O Z.ai Chat pode ter acesso baseado em cota. APIs hospedadas, roteadores e servidores GPU são serviços pagos, e pode haver diferenças de acordo com a versão e a via escolhida.
Qual versão do GLM-5 é melhor?
Para texto/código desafiador, começo com o GLM-5.3. O GLM-5.3-Flash é o melhor teste inicial para imagens, capturas de tela ou volume sensível ao custo. Não troque o GLM-5.2 se ele já está validado e o risco da migração for maior que o benefício potencial.
O GLM-5 é capaz de escrever e depurar código?
Sim. Agentes de codificação e engenharia em escala de repositório são casos de uso centrais, com boas pontuações relatadas pelos fornecedores no Terminal-Bench e no DeepSWE. Ainda são necessários sandbox, testes, permissões restritas e revisão humana.
Quanto custa a API do GLM-5?
Em setembro de 2026, a Z.ai lista o GLM-5 a US$ 1,00 na entrada e US$ 3,20 na saída por milhão de tokens; o GLM-5.3 a US$ 1,40 e US$ 4,40; e o 5.3-Flash a US$ 0,15 e US$ 0,50. A entrada com cache é mais barata. O custo real é impactado por margens de provedores e repetições.
O GLM-5 é software de código aberto?
"Pesos abertos" é mais preciso. A licença dos pesos, a licença do código do repositório e a transparência dos dados de treinamento são questões distintas. Antes de um deploy comercial, verifique a ficha específica do modelo no Hugging Face e a licença do repositório.
O GLM-5 pode ser usado localmente (com Ollama)?
Somente se você tiver pesos locais, suporte de runtime e hardware suficiente para isso. A tag cloud significa que a execução roda em infraestrutura remota, então não significa necessariamente que o modelo completo de 744B esteja rodando no seu dispositivo.
O GLM-5 é capaz de processar imagens?
O GLM-5 base e o GLM-5.3 são apenas de texto. Para entradas multimodais, use o GLM-5.3-Flash ou o GLM-5V-Turbo; verifique os tipos de arquivo aceitos no endpoint escolhido.





