
GPT-5.2 Explicado: Recursos, Benchmarks, Preços e Casos de Uso
Conheça GPT-5.2 Instant, Thinking, Pro e Codex: preços, benchmarks, acesso, limitações e a comparação com Gemini 3 para desenvolvedores em 2026.
Figura 1. GPT-5.2 avaliado em qualidade, velocidade, custo e controle
Selecionei o GPT‑5.2 Pro no Enter Pro para criar um revisor de briefings de projeto que transforma ideias de apps em requisitos e critérios de aceitação. As capturas mostram a configuração e o resultado da revisão; a verificação de uma solicitação concluída ainda é uma etapa pendente.
Esse caso prático dá a este guia um ponto de referência concreto. Separo os resultados oficiais de benchmark do que a aplicação efetivamente mostrou, e então examino as capacidades, os preços e os limites da família de modelos. Você deve identificar a variante exata antes de aplicar uma observação ao Instant, Thinking, Pro ou Codex.
A OpenAI apresentou a família em 11 de dezembro de 2025 como um lançamento voltado para trabalho profissional e agentes de longa duração. O relatório de lançamento fornece a linha de base oficial de benchmark e preços. Uso esse relatório junto com informações de roteamento atuais, críticas independentes relevantes e relatos da comunidade, porque nenhuma fonte isolada captura tanto o desempenho controlado quanto o atrito do dia a dia.
Quem busca Chat GPT 5.2 costuma se referir a toda a família de dezembro de 2025, mas a distinção entre os modos do ChatGPT e os IDs de modelo da API é importante. Um teste do Instant não determina o comportamento, o preço ou a latência do Thinking, Pro ou do modelo especializado em código.
GPT-5.2 em resumo
Em 9 de outubro de 2026, a OpenAI lista o GPT‑5.2 e o GPT‑5.2 Pro como opções da geração anterior. Projetos existentes podem valorizar seu comportamento conhecido e snapshots fixados, enquanto um novo projeto deveria comparar os modelos atualmente recomendados usando os mesmos critérios de aceitação.
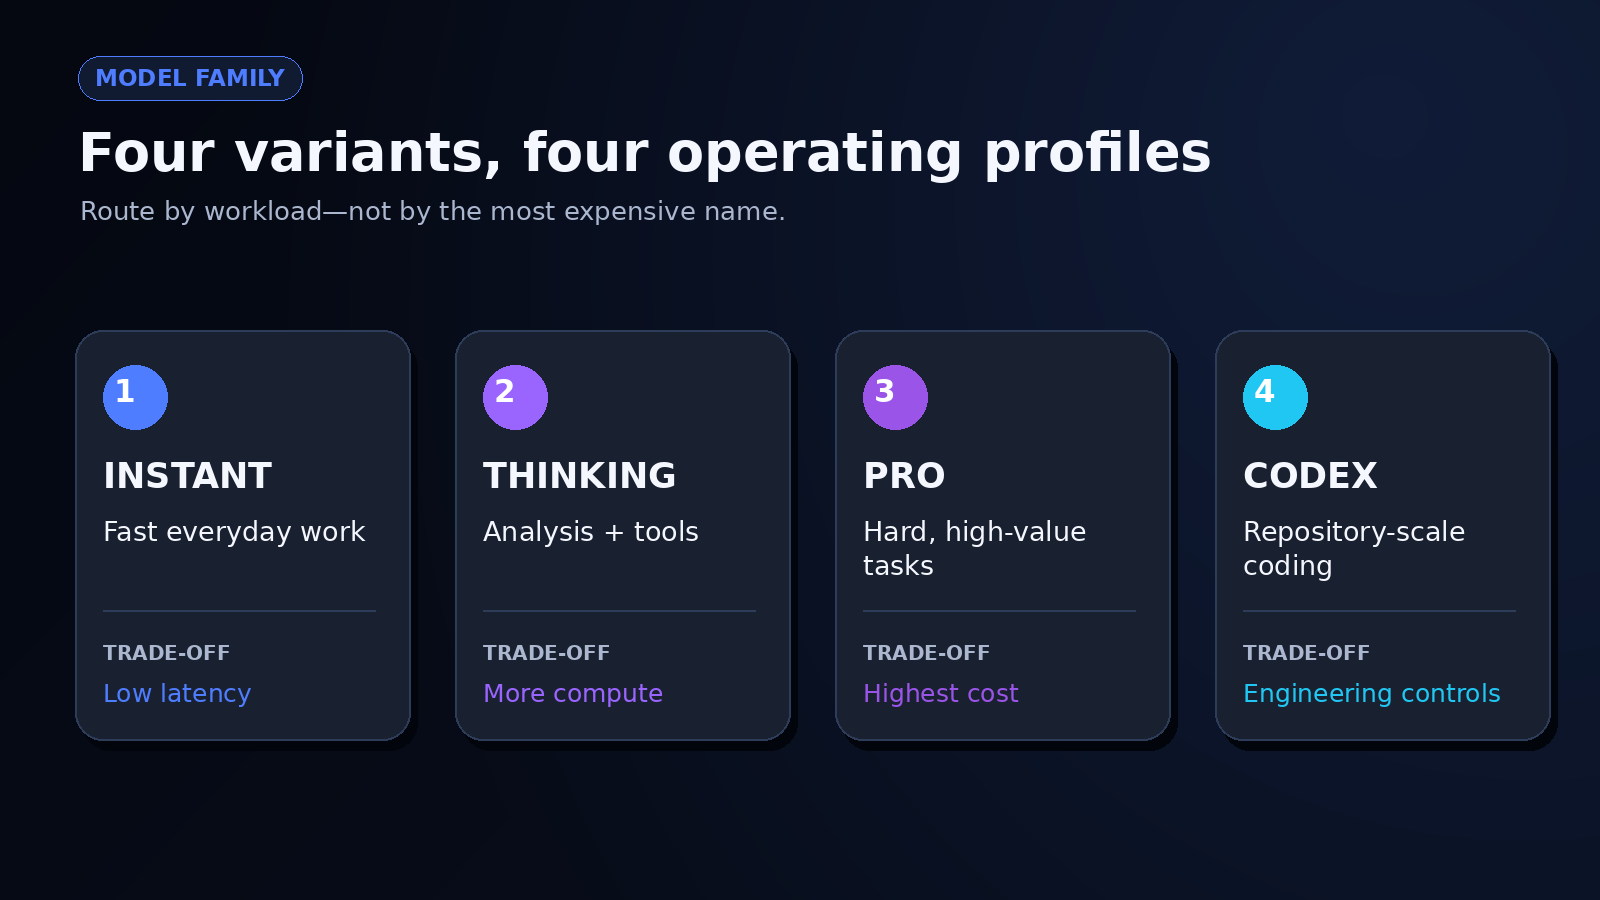
Figura 2. Instant, Thinking, Pro e Codex mapeados para tipos de carga de trabalho
| Especificação | GPT-5.2 | GPT-5.2 Pro |
|---|---|---|
| Posição atual | Antigo modelo principal | Antigo modelo Pro |
| Janela de contexto | 400.000 tokens | 400.000 tokens |
| Saída máxima | 128.000 tokens | 128.000 tokens |
| Corte de conhecimento | 31 de agosto de 2025 | 31 de agosto de 2025 |
| Modalidades | Entrada/saída de texto; entrada de imagem | Entrada/saída de texto; entrada de imagem |
| Esforço de raciocínio | nenhum, baixo, médio, alto, muito alto | médio, alto, muito alto |
| Preço da API por 1M tokens | $1,75 entrada; $0,175 cache; $14 saída | $21 entrada; $168 saída |
| Saídas estruturadas | Suportado | Não suportado |
| Fine-tuning | Não suportado | Não suportado |
| Snapshot | gpt-5.2-2025-12-11 | gpt-5.2-pro-2025-12-11 |
Status atual, contexto e modalidades
A janela de contexto de 400.000 tokens e o limite de saída de 128.000 tokens são incomumente grandes, mas capacidade não é o mesmo que recuperação de informação. Se você colocar contratos, logs, screenshots e requisitos em uma única solicitação, ainda vai precisar de um teste de recuperação: insira fatos em posições diferentes, faça perguntas que exijam combiná-los e registre o que o modelo deixa passar. Eu não inferiria um raciocínio confiável sobre documentos longos apenas pelo número do contexto.
Os modelos aceitam imagens e produzem texto; eles não aceitam áudio ou vídeo como entradas nativas. Isso os torna úteis para gráficos, screenshots de interface, diagramas e documentos digitalizados, desde que você verifique detalhes espaciais e valores extraídos. Um rótulo borrado ou uma escala de gráfico incomum pode transformar uma explicação aparentemente confiante em um erro plausível.
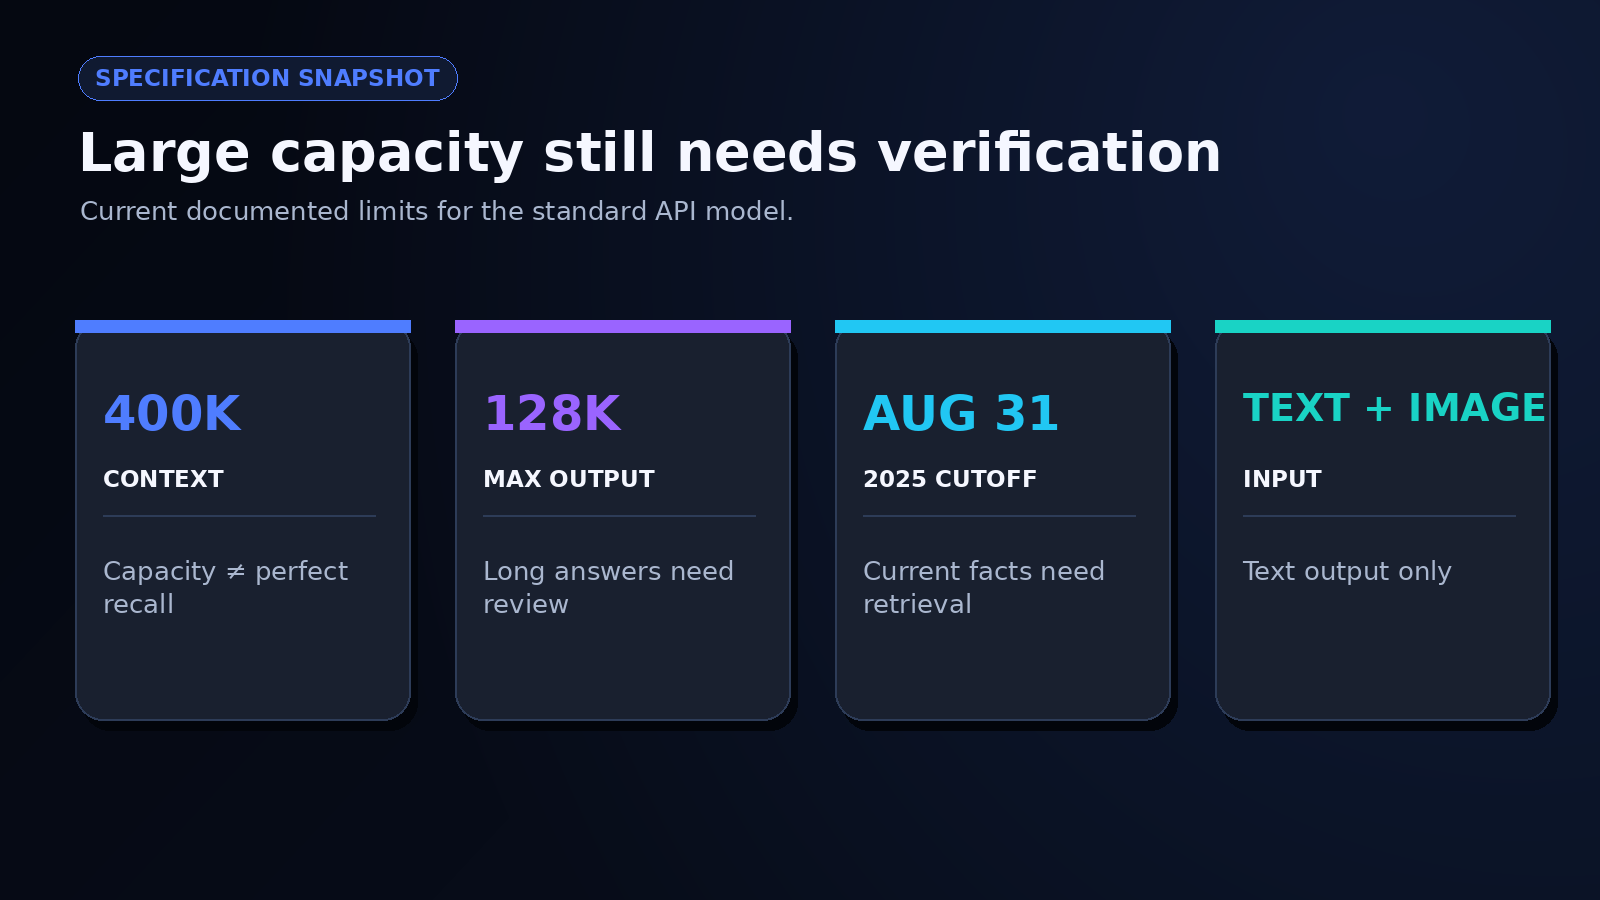
Figura 3. contexto, saída, modalidades, corte de conhecimento e snapshots
Preços e acesso à API
O modelo padrão da API custa $1,75 por milhão de tokens de entrada, $0,175 por milhão de tokens de entrada em cache, e $14 por milhão de tokens de saída. O GPT 5.2 Pro custa $21 na entrada e $168 na saída. Tokens de raciocínio, novas tentativas, chamadas de ferramentas e correções humanas afetam o custo de um resultado aceito. Ao usar uma plataforma de integração, verifique suas unidades de cobrança separadamente antes de compará-las com as tarifas em dólar da OpenAI.
Você pode ver o roteamento de provedores e a disponibilidade atual na página do GPT‑5.2 no OpenRouter. Eu calcularia o custo por tarefa concluída, não o custo por solicitação. Uma resposta mais barata que falha na validação duas vezes pode custar mais do que uma resposta mais cara que passa na primeira execução.
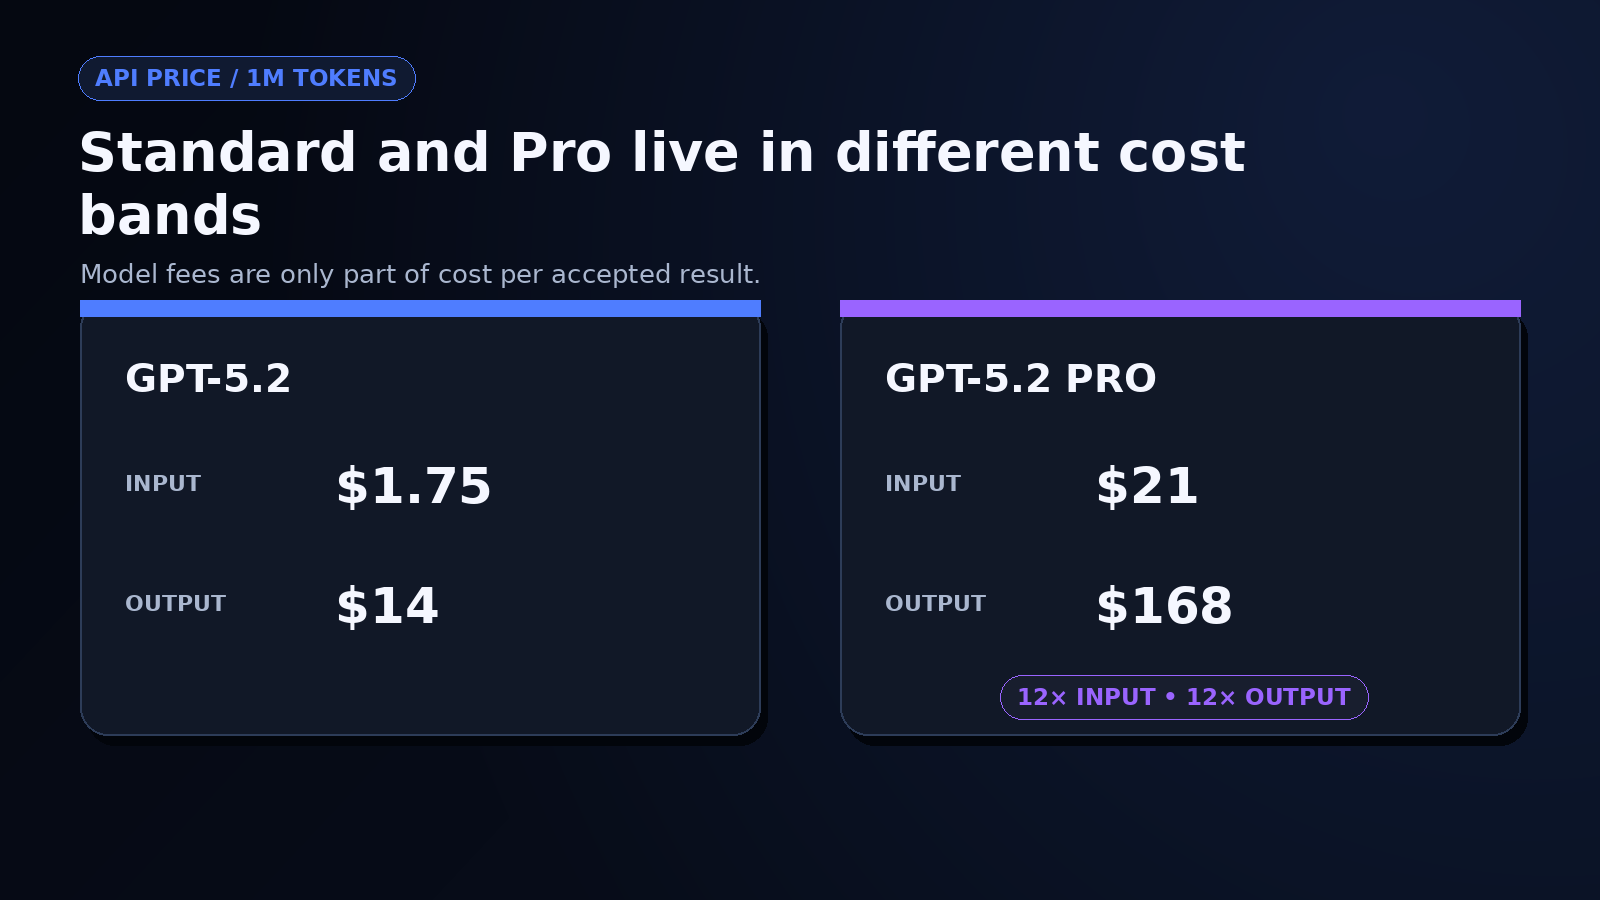
Figura 4. custo padrão versus Pro por milhão de tokens
O que mudou no lançamento do GPT-5.2 da OpenAI?
O lançamento do GPT-5.2 da OpenAI tinha como alvo trabalhos que continuam além de uma única resposta: construir artefatos, analisar documentos longos, usar ferramentas, escrever e revisar código, raciocinar sobre imagens e concluir tarefas profissionais de múltiplas etapas. Também separou chat rápido, raciocínio mais profundo e trabalho de alto processamento de forma mais clara do que sugere um único rótulo de modelo.
Instant, Thinking e Pro visam cargas de trabalho diferentes
O Instant priorizava perguntas do dia a dia, explicações, tradução e rascunhos rápidos. O Thinking visava análise, programação, arquivos, planejamento e uso de ferramentas. O Pro gastava mais processamento em problemas difíceis, onde uma espera mais longa e uma conta de API muito mais alta podiam se justificar.
| Modo ou modelo | Encaixe prático | Principal compensação |
|---|---|---|
| Instant | Perguntas rotineiras e trabalho sensível à latência | Menos deliberação em tarefas difíceis de múltiplas etapas |
| Thinking | Análise, programação, arquivos longos e fluxos orientados por ferramentas | Mais latência e uso de tokens |
| Pro | Tarefas difíceis em que qualidade incremental tem alto valor | Custo muito alto; respostas podem levar minutos |
Eu rotearia por risco, não por prestígio. Uma etapa de classificação pode precisar de um modelo rápido com um esquema rígido. Uma revisão de modelo financeiro pode justificar raciocínio mais profundo. Se você envia toda solicitação para o Pro, oculta quais tarefas realmente se beneficiam do processamento extra e torna o controle de custos muito mais difícil.
Trabalho profissional e uso de ferramentas foram centrais no lançamento
A OpenAI enfatizou planilhas, apresentações, trabalho de front-end, revisão de código, análise de documentos, ciência, matemática e chamadas de ferramentas. Em uma avaliação conduzida pelo fornecedor sobre consultas desidentificadas do ChatGPT, erros no nível de resposta foram relatados como relativamente 30% menos comuns do que com o GPT‑5.1 Thinking. O relatório de lançamento também observa que os próprios modelos realizaram a avaliação dos erros, então leio esse número como evidência direcional, não como garantia independente.
A melhoria prática não é "o modelo sabe tudo". É uma chance maior de que uma tarefa bem especificada sobreviva a várias etapas sem perder sua estrutura. Você ainda precisa de checkpoints observáveis: qual ferramenta rodou, quais dados ela recebeu, o que mudou e como o fluxo de trabalho se recuperou após uma chamada falha.
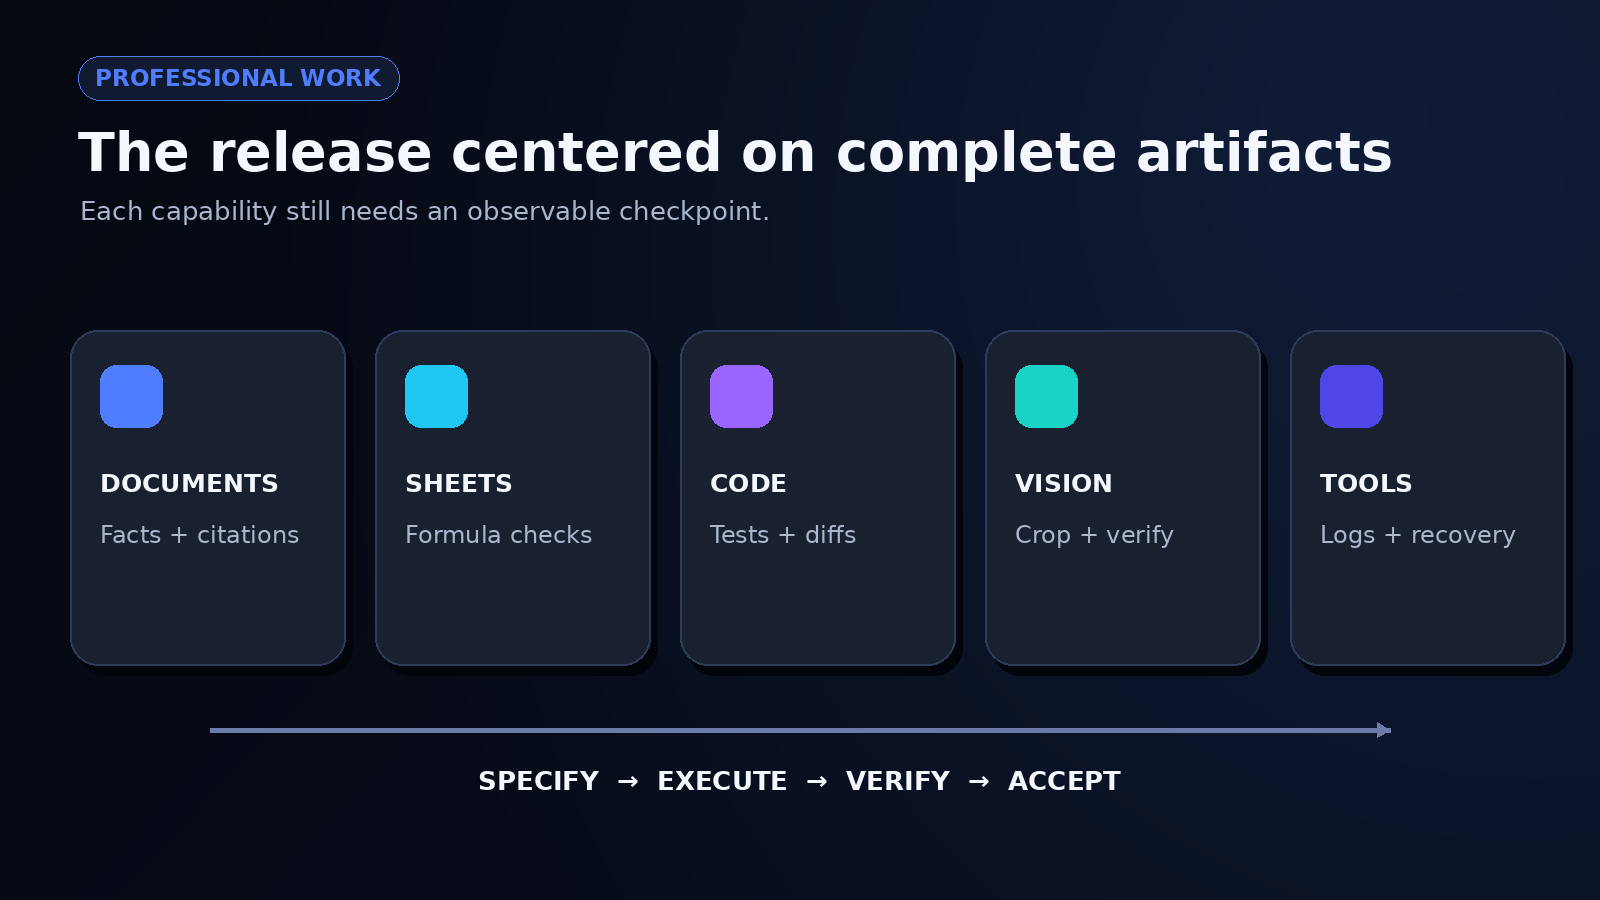
Figura 5. painéis de planilha, código, documento, imagem e chamada de ferramenta
Benchmarks de lançamento mostraram forças amplas, mas desiguais
| Benchmark | GPT-5.2 Thinking | O que mede |
|---|---|---|
| Vitórias ou empates no GDPval | 70,9% | Tarefas profissionais bem especificadas em 44 ocupações |
| SWE-Bench Pro público | 55,6% | Tarefas de engenharia de software multilíngue |
| SWE-bench Verified | 80,0% | Tarefas verificadas em repositórios Python |
| GPQA Diamond | 92,4% | Perguntas de ciência de nível de pós-graduação sem ferramentas |
| AIME 2025 | 100,0% | Matemática de competição sem ferramentas |
| ARC-AGI-2 Verified | 52,9% | Tarefas inéditas de raciocínio abstrato |
A dispersão é a parte útil. Ela mostra resultados fortes sem implicar domínio uniforme. Uma pontuação de 80% em issues verificadas de Python não prevê sua taxa de aprovação em um monorepo TypeScript com regras de deploy personalizadas. Da mesma forma, um benchmark de ciência não estabelece julgamento jurídico ou médico confiável.
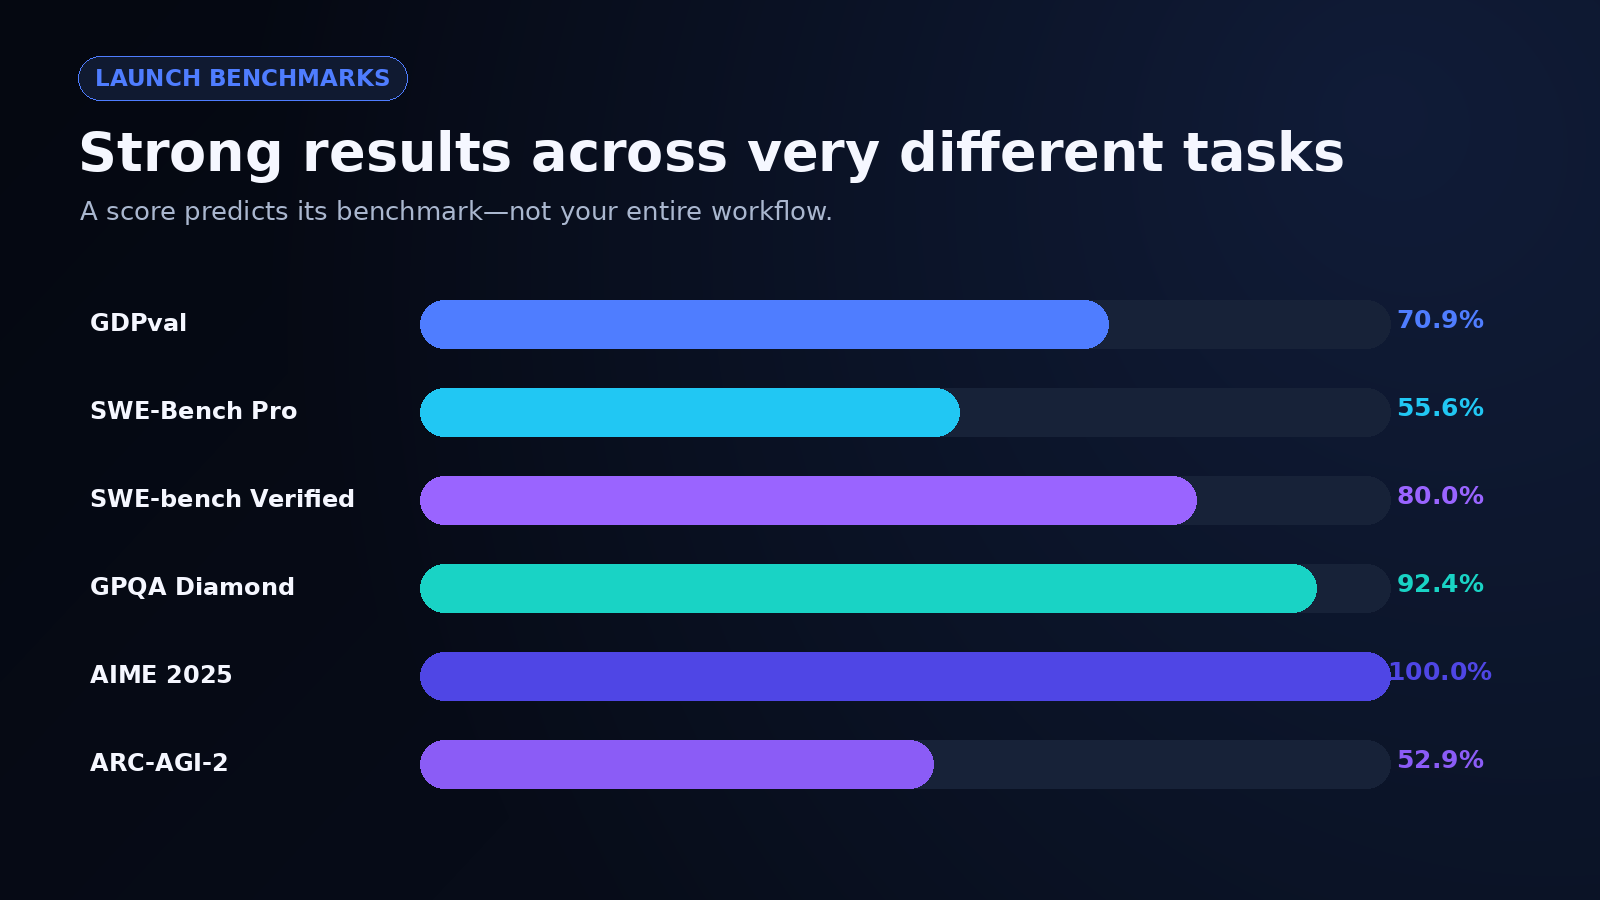
Figura 6. seis pontuações de lançamento com categorias de tarefas
Leia os benchmarks do GPT-5.2 junto com suas limitações
Pontuações públicas comprimem muitas escolhas em um único número: formato do prompt, ferramentas, esforço de raciocínio, seleção de testes, comportamento do avaliador e política de novas tentativas. Seu fluxo de trabalho em produção adiciona qualidade de dados, permissões, limites de latência e revisão humana. Acho os benchmarks mais úteis para escolher o que testar — não para pular o teste.
O que minha revisão do app realmente mostrou
O revisor de briefings de projeto exibia as instruções enviadas sob "Resumo do projeto" e "Requisitos essenciais" enquanto a resposta ainda estava em streaming. A entrada pedia verificações de implementação, mas o resultado visível organizou essa solicitação como um briefing. Ele não relatou inspeção de código concluída nem resultados de testes.
A visualização de sessão separada não tinha solicitações nem uso registrados, deixando tempo de resposta, roteamento e custo não verificados. Complete uma solicitação com um briefing restrito para finalizar a verificação.
Pontuações de benchmark não são garantias de produção
Comece com 20 a 50 tarefas representativas e defina os critérios de aceitação antes de executá-las. Para código, isso pode incluir taxa de aprovação de testes, tamanho do diff, achados de segurança e segurança de rollback. Para trabalho com documentos, pode incluir precisão factual, cobertura de citações, erros de cálculo e tempo de edição. Execute o mesmo conjunto mais de uma vez porque a variância importa.
Então meça o custo por resultado aceito. Suponha que um modelo custe $0,18 por execução e aprove 60% dos casos, enquanto outro custe $0,28 e aprove 90%. Antes da correção humana, seus custos esperados por resultado aceito são $0,30 e cerca de $0,31. Depois de precificar o tempo de revisão, o segundo pode ser claramente mais barato — ou não. A aritmética força a decisão de volta para seu fluxo de trabalho.
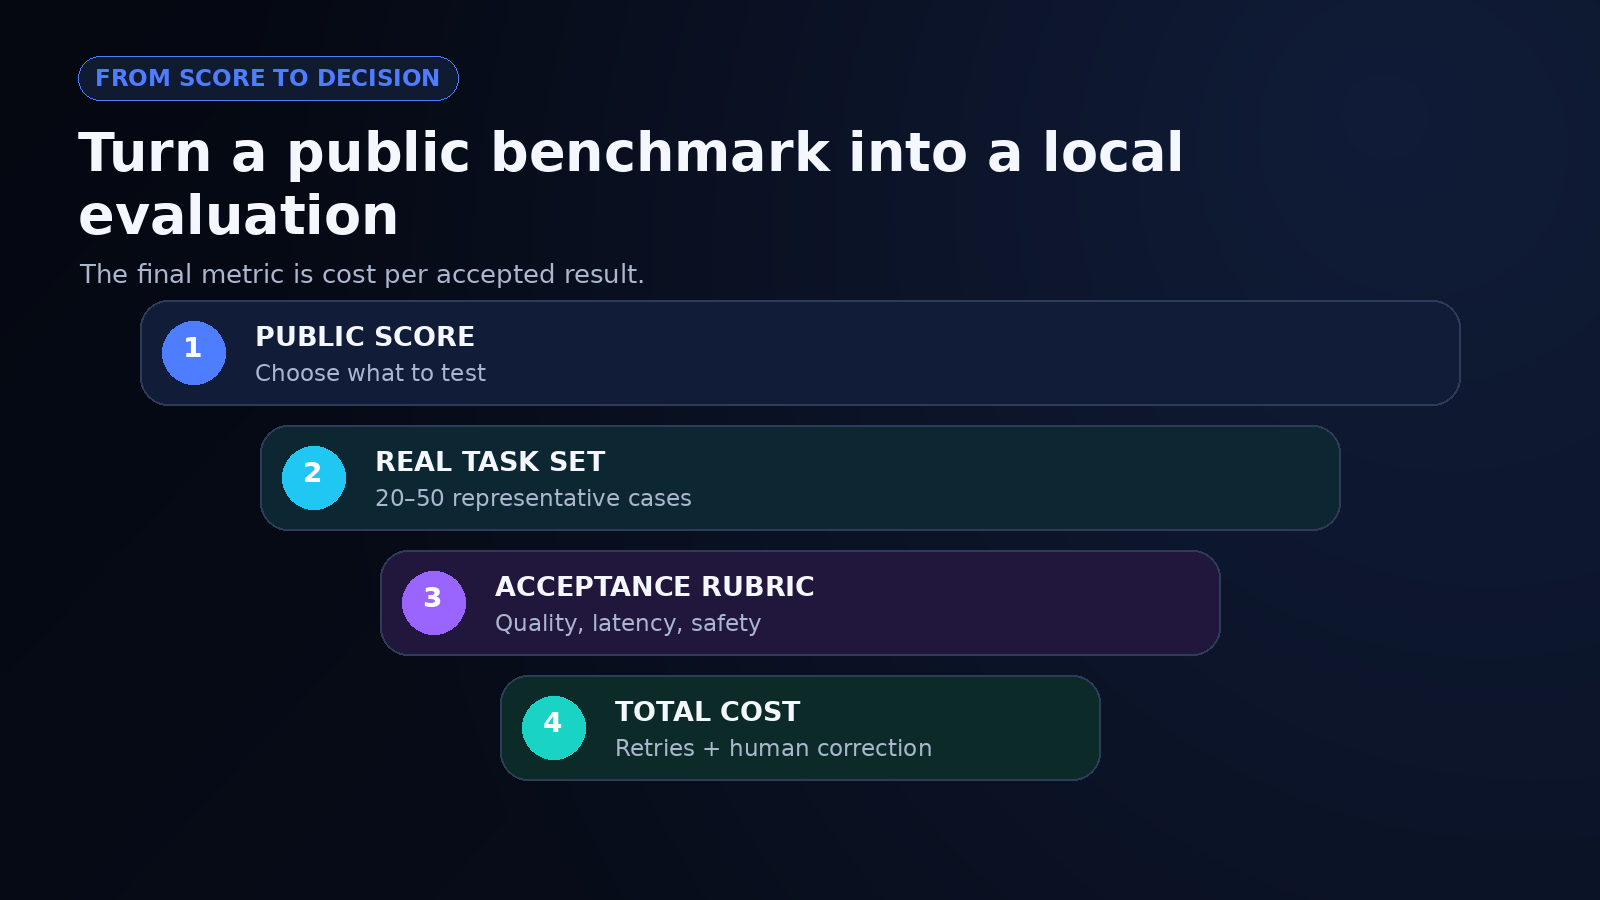
Figura 7. da pontuação de benchmark para tarefas representativas até o custo do resultado aceito
Contexto longo e entrada de imagem ainda exigem verificação
Uma janela de contexto longa pode reduzir a fragmentação, mas também torna omissões mais difíceis de notar. Eu testaria a recuperação do início, do meio e do fim de um conjunto de arquivos; exigiria citações ou identificadores de registro para fatos críticos; e refaria os cálculos fora do modelo. Para imagens, recorte a região relevante e apresente a pergunta explicitamente, em vez de esperar que o modelo infira o que importa.
Críticas independentes também podem expor modos de falha que um post de lançamento não vai destacar. Uma crítica prática descreve resultados decepcionantes nas tarefas do autor. Isso não refuta os resultados do benchmark; mostra por que seu prompt, sua carga de trabalho e seu limite de aceitação devem ser reproduzidos diretamente.
Figura 8. evidência distribuída por um fluxo de documentos de 400K tokens
Trabalho de alto risco precisa de salvaguardas específicas do domínio
O corte de conhecimento de 31 de agosto de 2025 significa que fatos atuais exigem recuperação. Os modelos ainda podem inventar fontes, ignorar requisitos, interpretar mal screenshots ou gerar código inseguro. Eles também não suportam fine-tuning, então equipes que precisam de comportamento profundamente personalizado devem recorrer a prompting, recuperação, ferramentas, validação ou outro modelo.
Você deve separar assistência de autoridade. Um modelo pode resumir um contrato, sinalizar uma transação suspeita ou propor um patch. Uma pessoa qualificada ou um controle determinístico deveria tomar a decisão jurídica, médica, financeira, de segurança e de produção. Registre as evidências e mantenha um caminho claro para rejeitar ou revogar a saída.
O que é o GPT-5.2-Codex e como os desenvolvedores devem usá-lo?
O GPT 5.2 Codex é o membro especializado em código da família, projetado para trabalho de engenharia de software mais longo em vez de autocompletar isolado. A distinção útil é a profundidade do fluxo de trabalho: entender um repositório, planejar uma mudança, editar vários arquivos, executar ferramentas, inspecionar falhas e revisar o patch.
Tarefas de programação mais adequadas
Boas candidatas incluem exploração de repositório, implementação de recursos, correção de bugs, refatoração, criação de testes, revisão de código e migrações com critérios de aceitação explícitos. Eu daria ao modelo o menor objetivo coerente que ainda inclua o limite real de dependência. Um prompt artificialmente diminuto pode produzir um diff local limpo que falha no sistema ao redor.
Você pode avaliar o GPT 5.2 Codex com um conjunto de repositórios repetível: problemas conhecidos, testes ocultos, linting, política de dependências, verificações de segurança e um diff máximo aceitável. Registre o número de chamadas de ferramentas, correções e intervenções do revisor. Um patch não é bem-sucedido só porque compila.
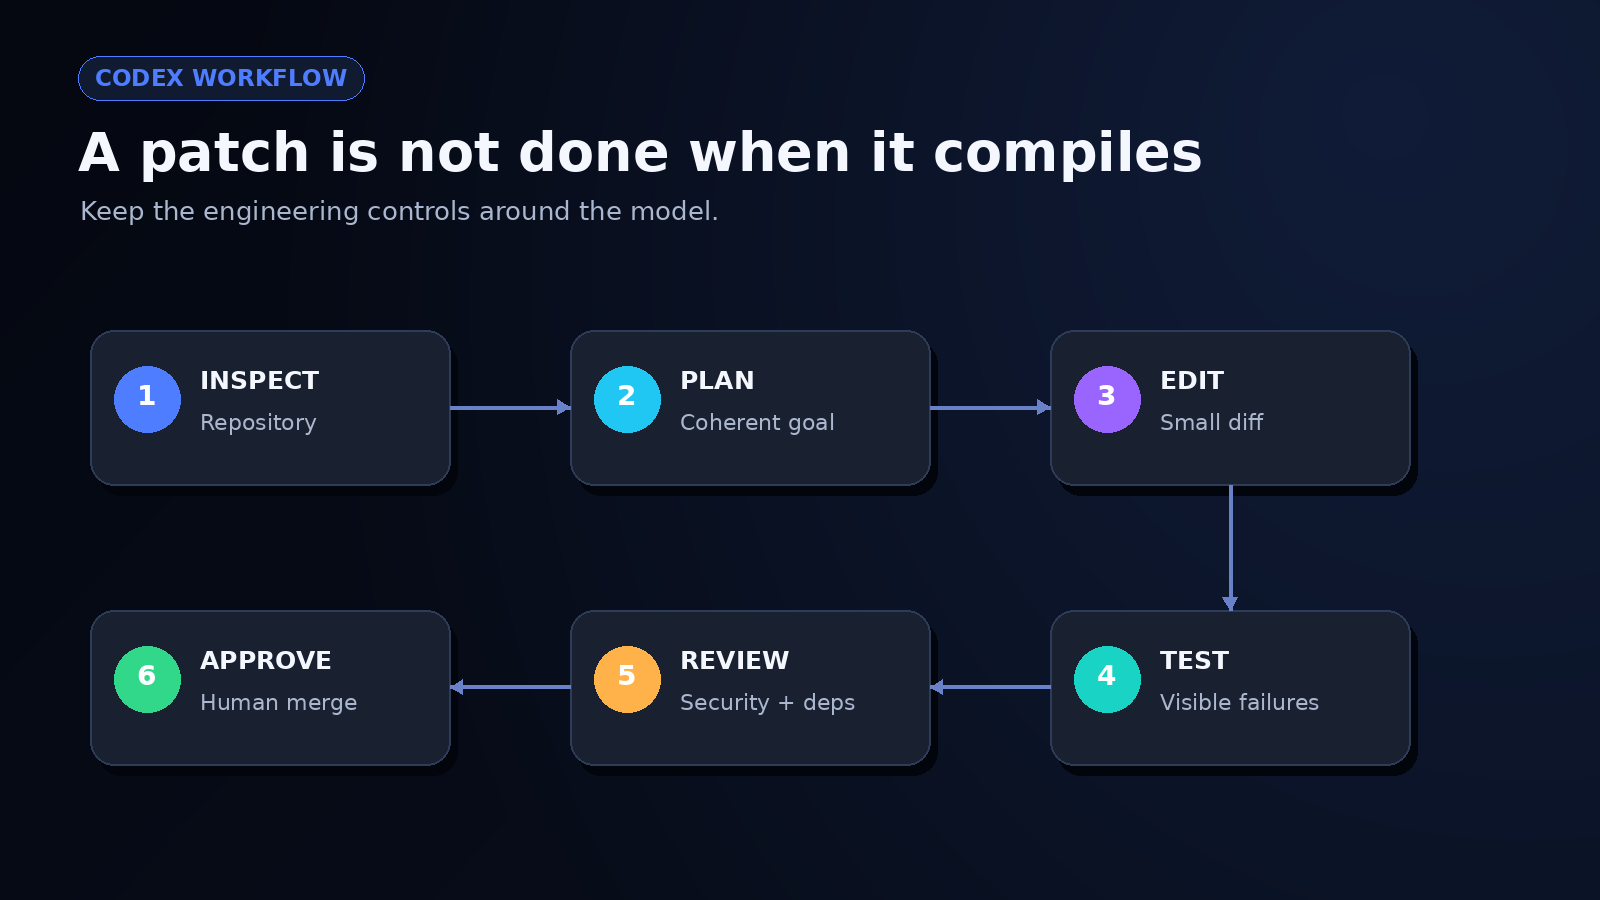
Figura 9. inspecionar, planejar, editar, testar, revisar e aprovar
Proteções de produção ainda se aplicam
Mantenha as mudanças pequenas o suficiente para revisar, fixe o snapshot do modelo quando a reprodutibilidade importar, e restrinja as ferramentas ao privilégio mínimo necessário. Execute testes de repositório, varredura de dependências, detecção de segredos, análise estática e revisão humana de diffs. Se o agente puder implantar, excluir dados ou rotacionar credenciais, coloque essas ações atrás de uma aprovação explícita.
Também prefiro um orçamento de falha: defina quantas novas tentativas, minutos ou tokens uma tarefa pode consumir antes de voltar para um humano. Sem esse limite, um agente pode parecer produtivo enquanto fica girando em correções cada vez mais especulativas.
GPT-5.2 vs Gemini 3 depende da tarefa exata
GPT-5.2 vs Gemini 3: explica que o melhor modelo de IA depende da tarefa, como programação, raciocínio, escrita ou pesquisa.
A resposta honesta para "GPT 5.2 vs Gemini 3" é um design de teste, não um vencedor universal. Variantes exatas, datas, ferramentas, tamanhos de contexto, configurações de raciocínio e preços devem ser registrados. Caso contrário, uma comparação pode dar silenciosamente a um modelo busca, execução de código ou um orçamento de tempo maior.
| Fator de decisão | Pergunta a testar |
|---|---|
| Qualidade da saída | Qual modelo passa sua rubrica de tarefas com mais frequência? |
| Programação | Qual produz a maior taxa de aprovação de testes com diffs menores e mais seguros? |
| Contexto longo | Qual recupera e combina fatos dos seus arquivos com mais precisão? |
| Uso de ferramentas | Qual conclui o fluxo de trabalho com falhas recuperáveis e logs utilizáveis? |
| Latência | Quais são os tempos de resposta mediano e do percentil 95? |
| Custo | Qual é o custo total por resultado aceito após novas tentativas e correção? |
| Governança | Quais controles de dados, retenção, região e auditoria se encaixam no seu caso de uso? |
Execute a mesma avaliação lado a lado
Dê aos dois modelos os mesmos prompts, arquivos de origem, ferramentas, orçamento de tempo e rubrica de pontuação. Randomize a ordem das tarefas e oculte o nome do modelo dos revisores onde possível. Repita casos representativos em vez de selecionar uma única resposta bonita. Reações da comunidade na discussão de lançamento do GPT‑5.2 são úteis para descobrir queixas a testar, mas não são comparações controladas.
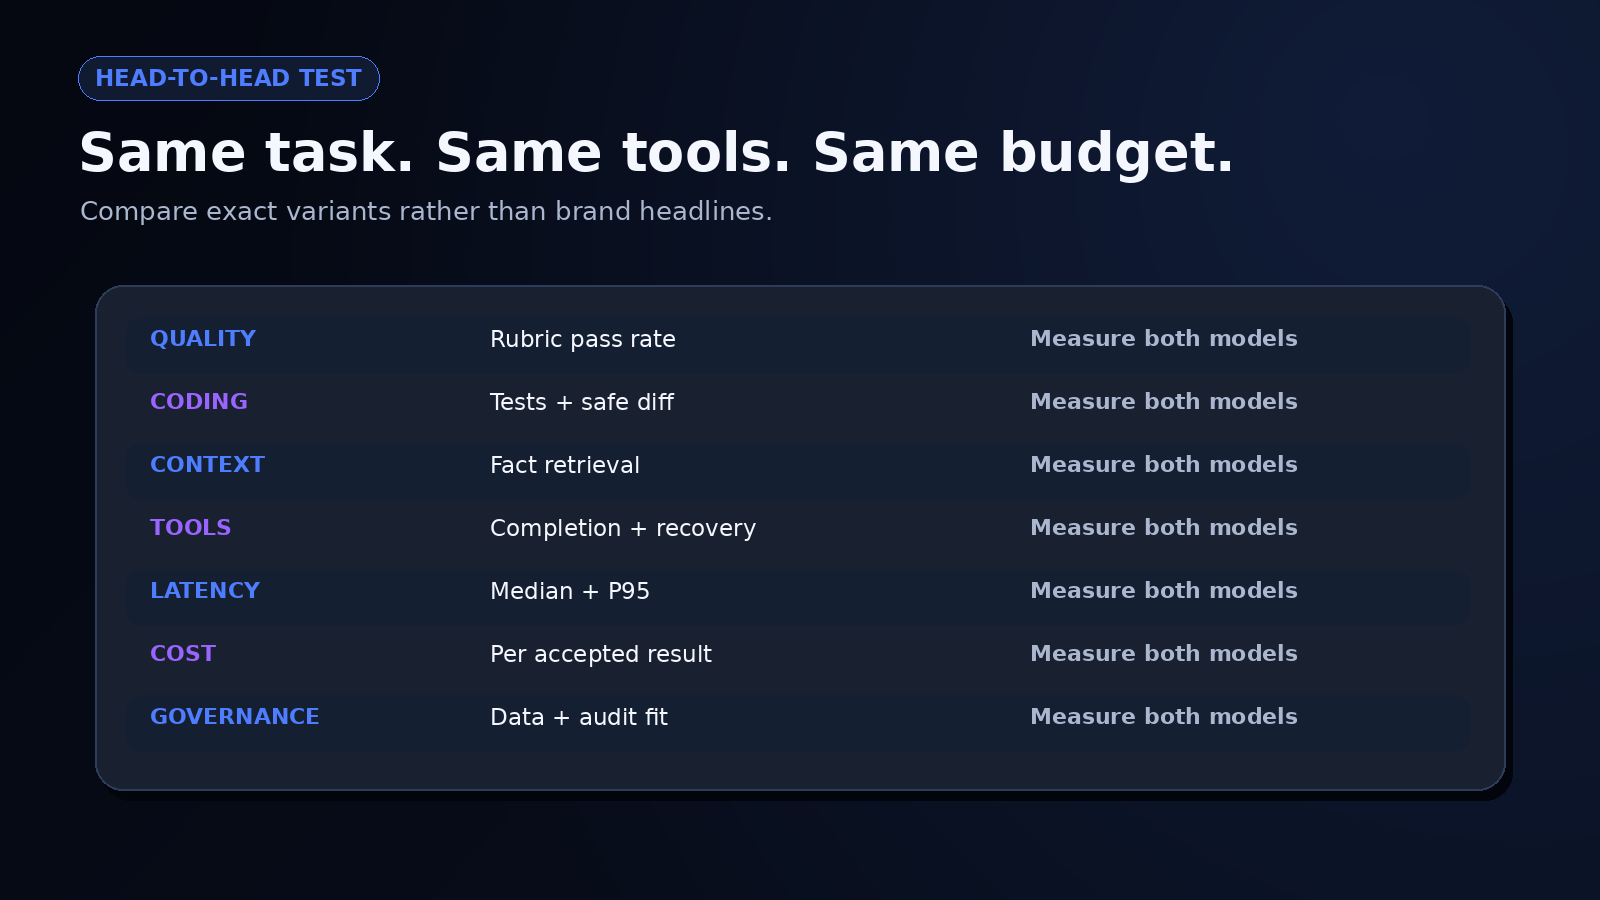
Figura 10. qualidade, programação, contexto, ferramentas, latência, custo e governança
Escolha o fluxo de trabalho de menor risco, não a melhor manchete
Seu vencedor pode variar por etapa. Um modelo pode planejar bem, outro pode gerar código mais limpo, e uma opção menor pode lidar com classificação a uma fração do custo. A arquitetura certa pode rotear o trabalho em vez de forçar um único modelo a fazer tudo.
Para uma avaliação GPT 5.2 vs Gemini 3, eu escolheria a combinação de modelos mais simples que atenda ao limite de qualidade e permaneça observável quando falhar. Cada provedor ou fallback adicional acrescenta lógica de roteamento, trabalho de avaliação, revisão de privacidade e complexidade de incidentes. Diversidade de modelos é útil quando reduz um risco medido.
Construa um app com GPT‑5.2 Pro no Enter Pro
Usei o construtor de apps com IA do Enter Pro para criar um revisor de briefings de projeto com IA, com o GPT‑5.2 Pro selecionado como sua integração. O objetivo era transformar uma ideia bruta de app em requisitos, informações faltantes, prioridades e critérios de aceitação.
Selecione o GPT‑5.2 Pro e veja as tarifas
Localizei o GPT‑5.2 Pro no catálogo de modelos e abri seus detalhes. O painel exibia um botão Integrar e tarifas de** 2,1 créditos por 1.000 tokens de entrada** e** 16,8 créditos por 1.000 tokens de saída**. Essas são as tarifas da plataforma capturadas.
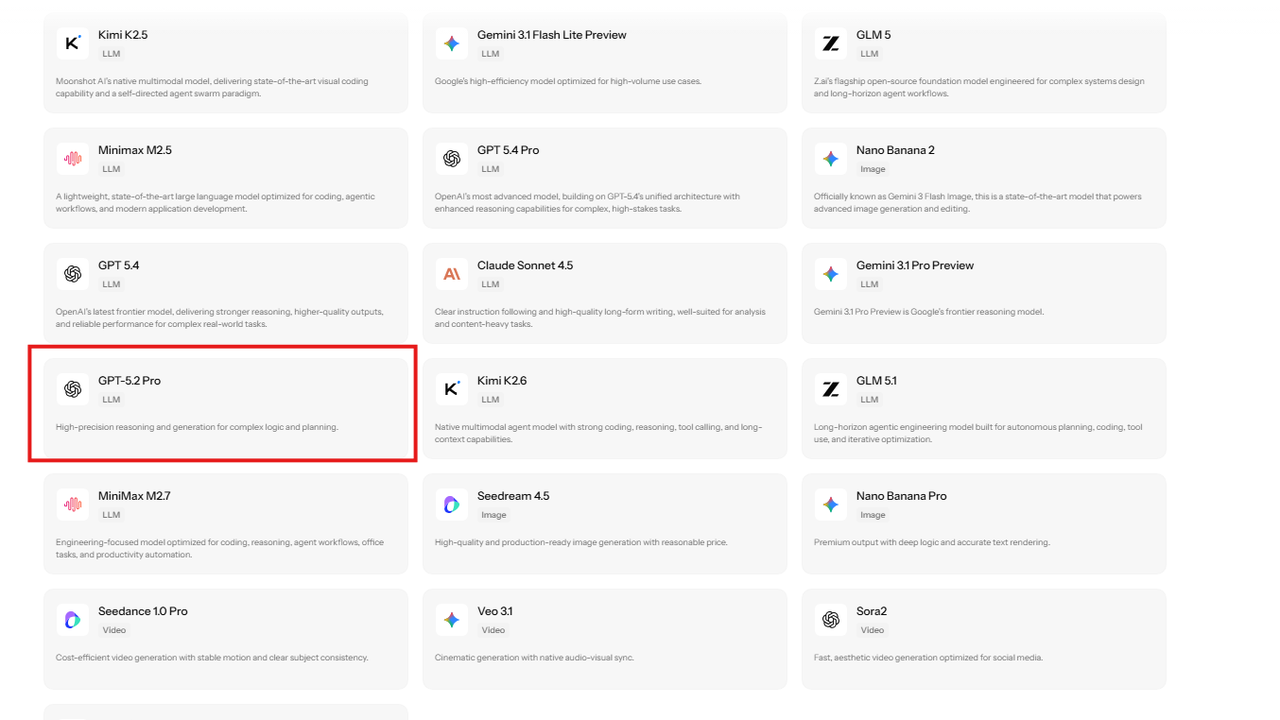
Figura 11. O GPT‑5.2 Pro aparece no catálogo de modelos entre outras integrações disponíveis.
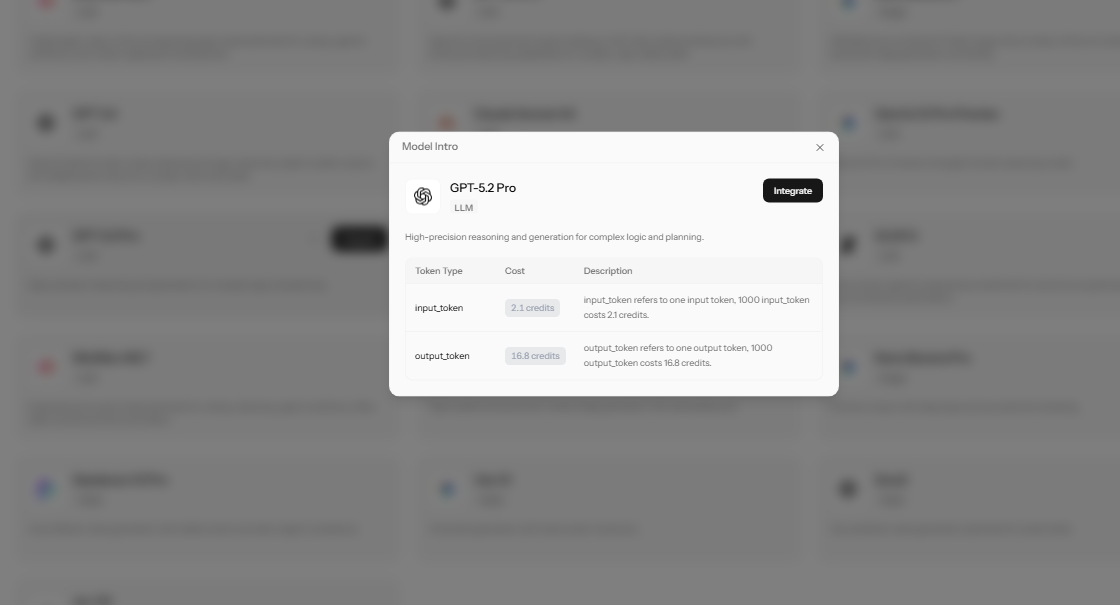
Figura 12. O painel de detalhes do GPT‑5.2 Pro exibe o controle Integrar e as tarifas em créditos.
Vincule o modelo e descreva o app
A solicitação do projeto tinha o chip do GPT‑5.2 Pro vinculado. Pedi um campo de briefing grande, um botão Revisar Briefing, e respostas organizadas em cinco seções: resumo do projeto, requisitos essenciais, contradições e informações faltantes, prioridades de implementação e critérios de aceitação. A solicitação também pedia estados reais de carregamento e erro.
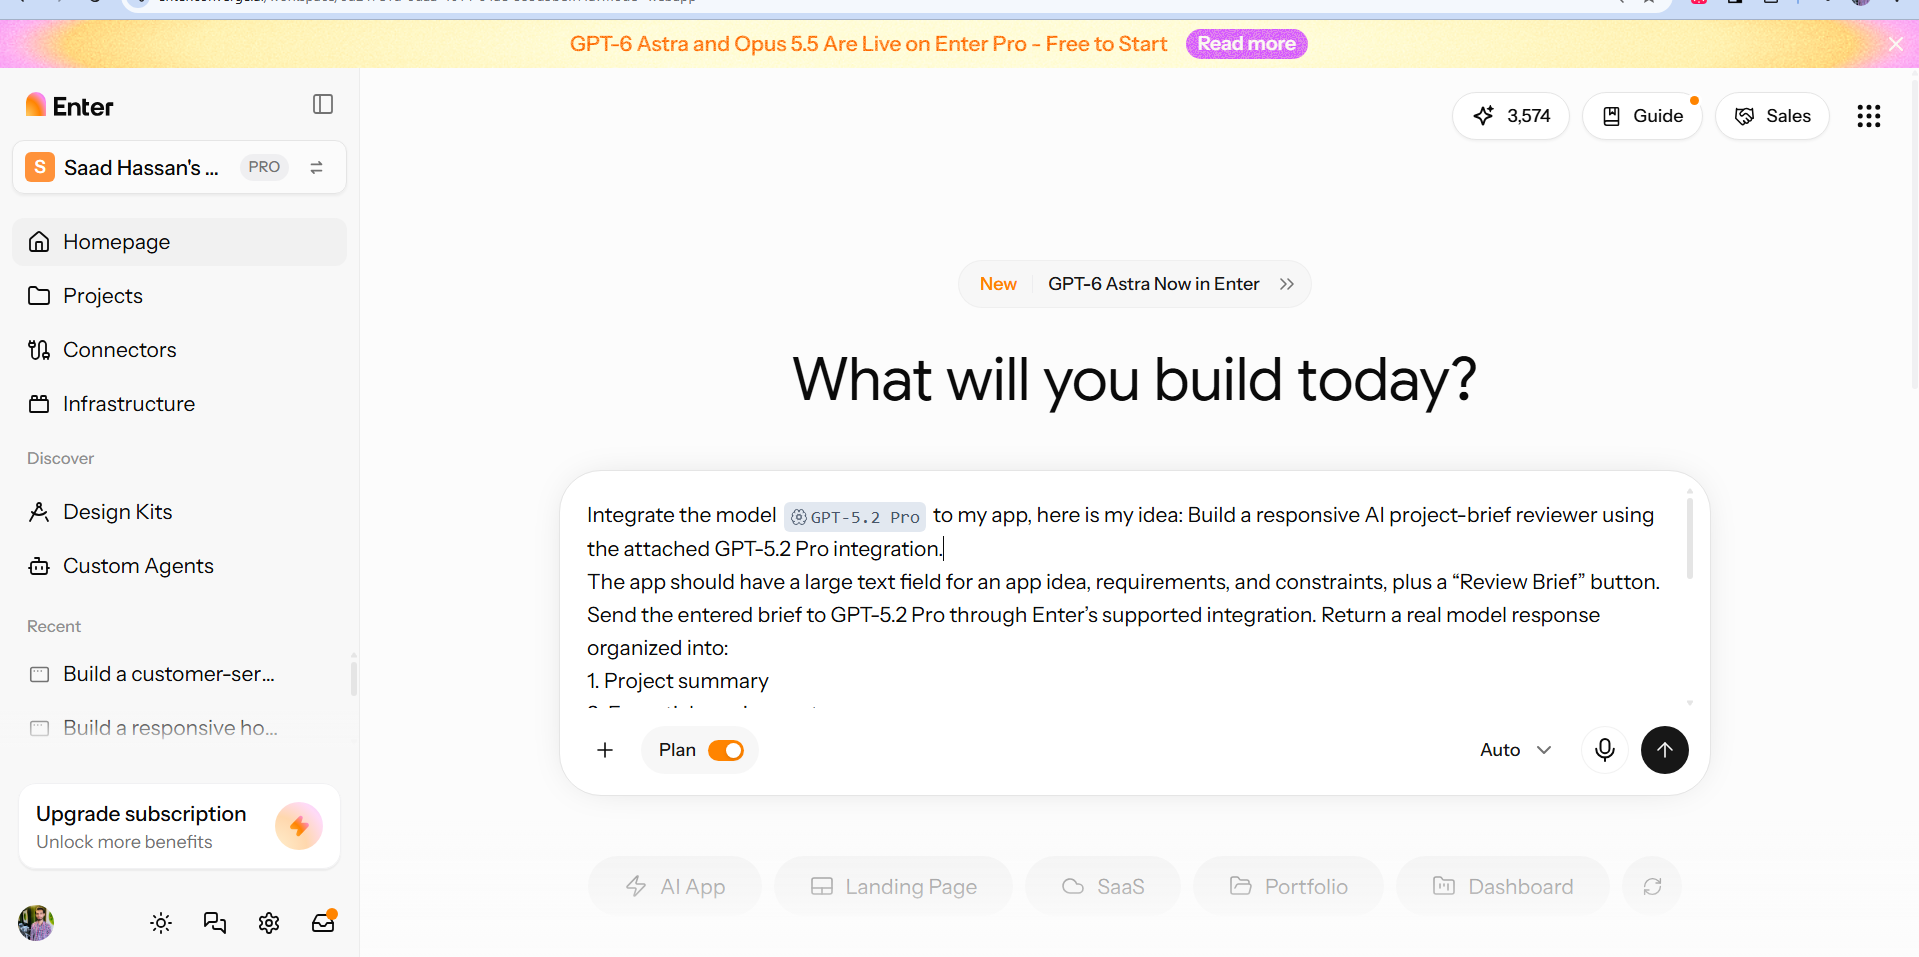
Figura 13. O prompt do projeto vincula o GPT‑5.2 Pro e especifica o propósito e a estrutura de resposta do revisor.
Examine o plano de build
O Enter gerou um plano para uma interface Vite, React e Tailwind com uma função de backend lidando com a solicitação à IA. Especificava resultados em streaming, texto em linguagem simples e nenhum histórico de revisão salvo. Manter a credencial privada no backend fazia parte do plano. Esta captura registra a implementação proposta.
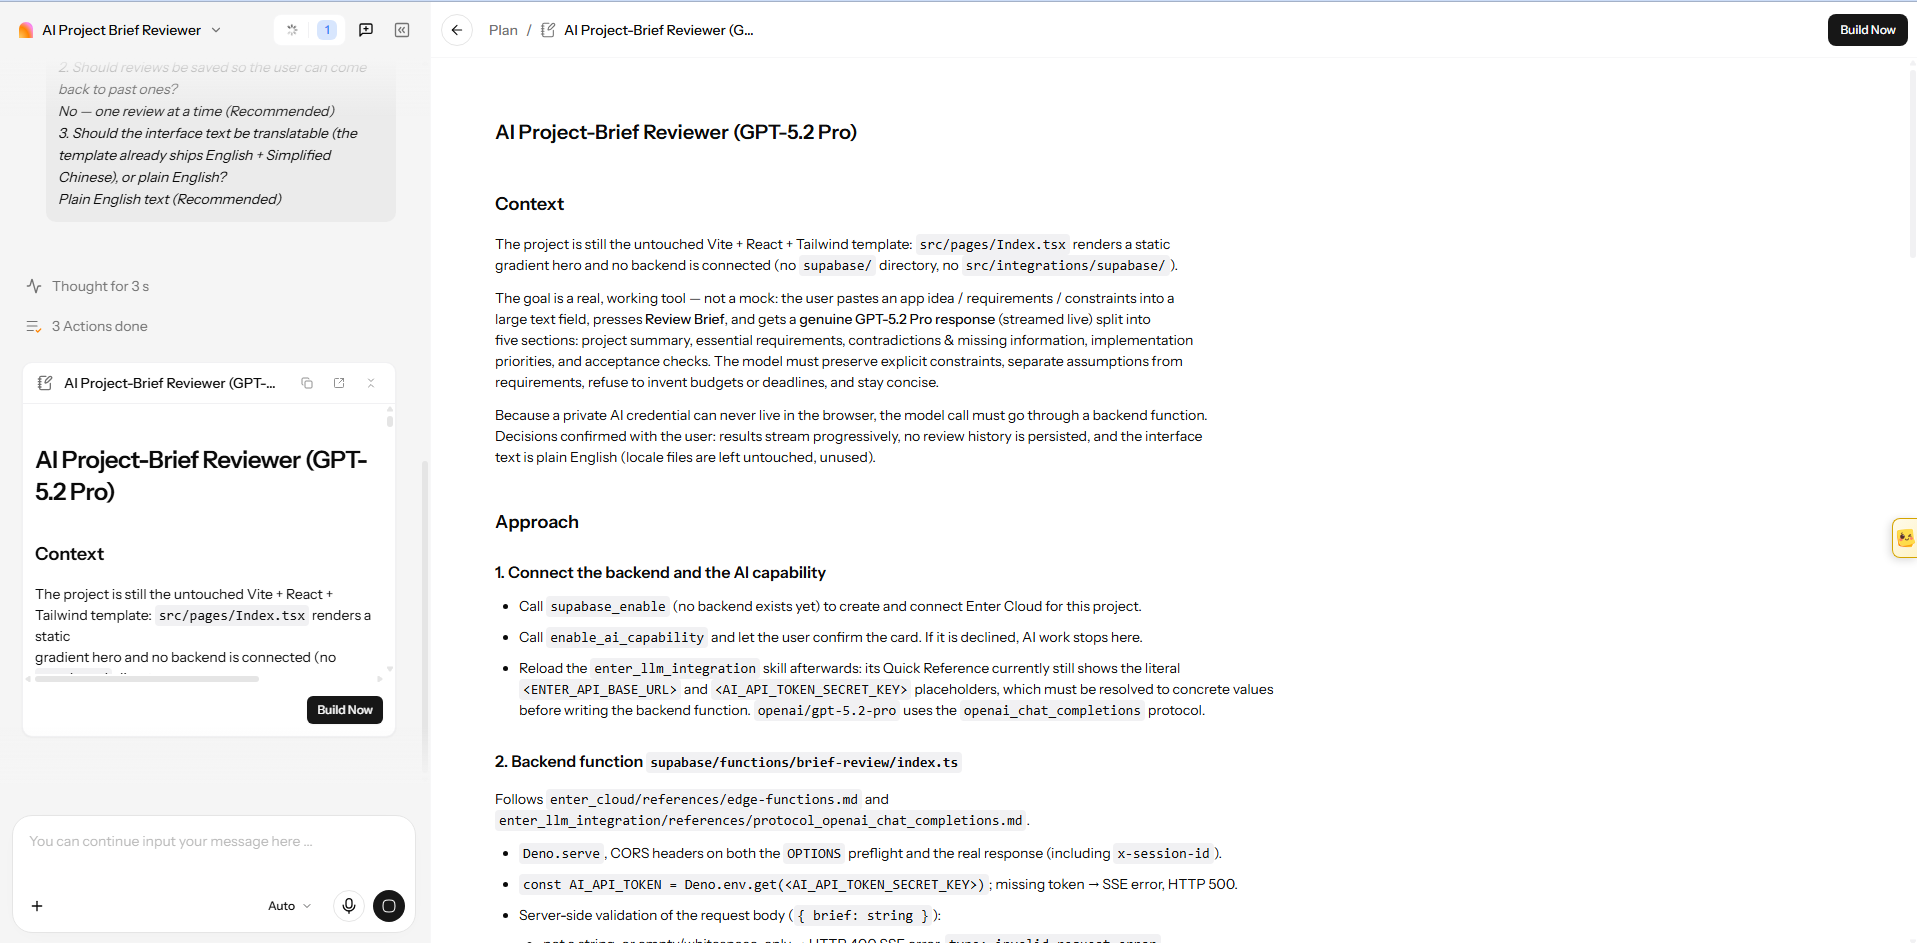
Figura 14. O plano de build descreve a interface, a solicitação de backend, a saída em streaming e o tratamento de credenciais.
Examine a revisão visível
O revisor exibia um campo de briefing ao lado de seus painéis de resposta. Na tentativa capturada, inseri a solicitação de verificação de implementação nesse campo. A resposta reorganizou seus requisitos sob os títulos solicitados, enquanto Streaming review e** Reviewing** permaneciam visíveis. Isso demonstrou a organização da resposta, com a completude e a correção ainda a verificar.
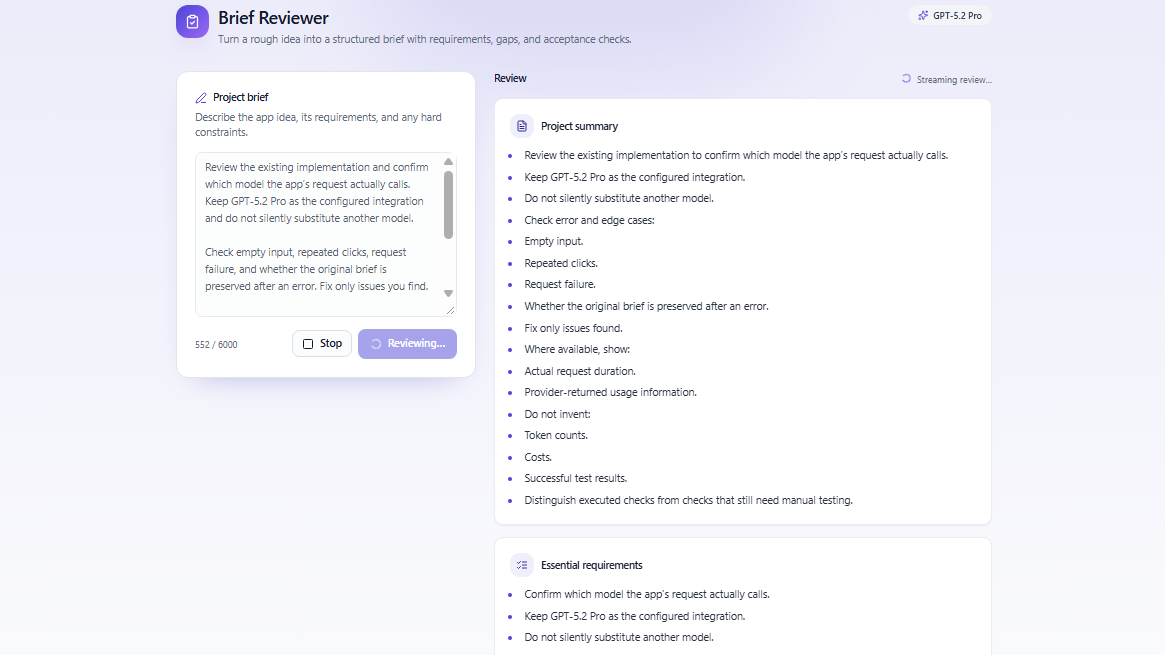
Figura 15. O texto da revisão aparece sob os títulos solicitados enquanto a interface ainda indica uma resposta ativa.
Para um teste de raciocínio, use o briefing de agendamento com três técnicos, trabalhos de 45 minutos, um buffer de deslocamento de 30 minutos, horário das 9h às 17h, sem sobreposições e uma regra de reagendamento de 12 horas. Depois adicione "permitir dois agendamentos simultâneos por técnico" e verifique se a resposta concluída sinaliza o conflito. Esse resultado não está nessas capturas.
Verifique o registro de solicitações e o uso de créditos
A visualização de status adicional rotulava a integração como GPT‑5.2 Pro, o provedor como Enter AI e o protocolo como Responses API. Sua sessão não continha nenhuma solicitação, zero tokens de entrada e saída, e zero uso consumido. Esses valores não podem estabelecer a duração, o roteamento real ou a cobrança da resposta anterior.
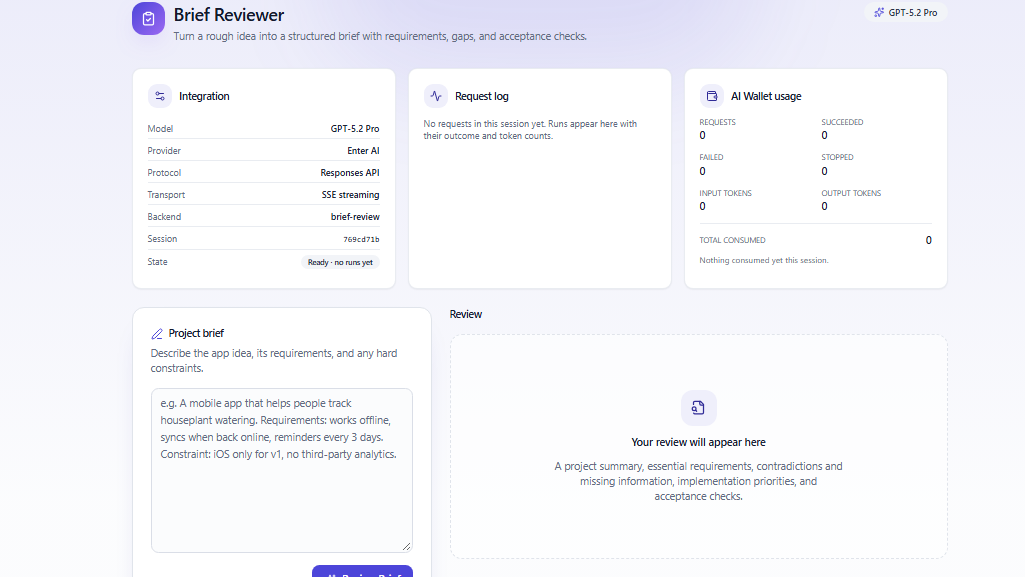
Figura 16. Os painéis de integração e uso mostram uma sessão pronta sem solicitações ou consumo registrados.
Nas tarifas exibidas, 1.000 tokens de entrada mais 500 tokens de saída cobrados, de forma ilustrativa, equivaleriam a 10,5 créditos. Isso é uma estimativa, não um gasto observado. Para comparar custos, use solicitações concluídas, uso cobrado, novas tentativas e a proporção de revisões que atendem seus critérios de aceitação.
O Enter mantém o modelo selecionado e o briefing do app em um único projeto. Construa seu app com GPT‑5.2 Pro no Enter Pro e verifique a integração antes de publicar.
Conclusão final: avalie o GPT‑5.2 por meio de uma tarefa real
O valor prático do GPT‑5.2 depende da qualidade da tarefa e do custo aceitável. O projeto de revisor conecta a seleção do Pro com uma interface de app e um texto de revisão organizado. Uma resposta finalizada, restrições verificadas e um registro de solicitação concluído ainda são necessários para julgar confiabilidade e custo-benefício.
Escolha o modelo menos caro que atenda ao seu limite de aceitação, repita casos importantes e mantenha um caminho de recuperação para erros. Você pode usar o Enter Pro para construir e refinar um app com GPT‑5.2 Pro, e depois verificar sua integração antes de expandi-lo.
Perguntas frequentes sobre Chat GPT 5.2
Quando o GPT-5.2 foi lançado?
A OpenAI o anunciou em 11 de dezembro de 2025. Os modelos de API e as variantes do ChatGPT começaram a ser disponibilizados no lançamento, embora o acesso e as alternativas recomendadas tenham mudado desde então.
O GPT-5.2 ainda é o modelo mais recente da OpenAI?
Não. Em 9 de outubro de 2026, a OpenAI o documenta como um modelo de geração anterior. Quem busca Chat GPT 5.2 deve distinguir o acesso pelo seletor do ChatGPT do acesso via API ou integração de terceiros. Verifique a variante exata e a disponibilidade atual antes de iniciar um projeto.
Qual é a janela de contexto do GPT-5.2?
A janela de contexto documentada é de 400.000 tokens, com saída máxima de 128.000 tokens. Você ainda deveria testar a recuperação e o raciocínio nos seus documentos longos reais.
Quanto custa a API do GPT-5.2?
A tarifa padrão da API é de $1,75 por milhão de tokens de entrada, $0,175 por milhão de tokens de entrada em cache, e $14 por milhão de tokens de saída. Cobranças de ferramentas, raciocínio, novas tentativas e revisão aumentam o custo da tarefa.
Como posso construir um app com GPT‑5.2 Pro usando o Enter Pro?
Selecione o GPT‑5.2 Pro no catálogo de modelos, vincule a integração e descreva o recurso que seu app precisa. Para um revisor de briefings de projeto, especifique as entradas necessárias e o formato de revisão. Examine a implementação gerada, depois verifique uma solicitação concluída para confirmar que a conexão com o modelo funciona.
Como posso verificar o uso do GPT‑5.2 Pro no Enter Pro?
Verifique os painéis de solicitações e uso da integração depois de executar uma tarefa representativa. Confirme que a solicitação aparece, depois examine tokens de entrada, tokens de saída e créditos consumidos. Inclua novas tentativas e respostas mais longas ao estimar custos, usando as tarifas atuais da plataforma.
O que é o GPT-5.2 Pro?
O GPT 5.2 Pro é um modelo de raciocínio de maior processamento para tarefas profissionais difíceis. Suas tarifas oficiais de API são $21 por milhão de tokens de entrada e $168 por milhão de tokens de saída, e algumas solicitações podem levar vários minutos.
O GPT-5.2 suporta imagens?
Sim. Ele aceita entrada de imagem e produz saída de texto. Áudio e vídeo não estão listados como entradas nativas suportadas, então esses formatos exigem uma etapa de processamento separada.
O GPT-5.2 é melhor que o Gemini 3?
Não há resposta universal. Teste as variantes exatas com os mesmos prompts, arquivos, ferramentas, orçamento e rubrica, depois compare qualidade de resultados aceitos, latência, custo, governança e recuperação de falhas.
O GPT-5.2 pode gerar código pronto para produção?
Ele pode gerar código forte, mas a prontidão para produção vem de todo o processo de engenharia: testes, revisão de diffs, verificações de dependências e segurança, ferramentas restritas, staging, monitoramento e rollback. O modelo não pode substituir esses controles.





