Лучший ИИ для программирования: сравнение по задачам, стоимости и рабочим процессам
Сравните лучший ИИ для программирования по рабочим процессам, моделям, лимитам бесплатных планов и реальной стоимости, а также изучите пример приложения на Enter Pro с проверками и доказательствами.
Лучший ИИ для программирования — это инструмент, который помогает довести до конца изменение, которое вы способны понять, проверить и поддерживать. Быстрая подсказка функции, исправление на уровне всего репозитория и работающее приложение требуют разных видов поддержки. Выбор по единственному показателю модели может скрыть редактор, инструменты выполнения, лимиты использования и объём ревью, которые на самом деле определяют результат.
Я бы сначала отбирал кандидатов по типу работы, а затем проводил небольшое сравнение на показательных задачах. Это руководство разделяет инструменты и модели, сравнивает шесть сред разработки, рассматривает бесплатный доступ и опубликованные доказательства, а также описывает повторяемый метод оценки. В конце статьи проект FixTrack, собранный в Enter Pro, объединяет проверки создания приложения через интерфейс приватного трекера задач, при этом видимые результаты чётко отделены от проверок бэкенда, которые ещё предстоит выполнить.
Какой ИИ для программирования лучше подходит для вашей реальной работы?
Выбор лучшего ИИ для программирования начинается с задачи и среды, которую вам нужно сохранить. Ассистент, хорошо вписывающийся в существующий репозиторий, может оказаться лучшим выбором для тикета по поддержке, чем генератор приложений. Браузерный конструктор, напротив, может убрать работу по настройке для нового прототипа. Ниже приведены отправные точки для оценки, а не измеренные рейтинги производительности.
Если вы хотите сохранить свой редактор и рабочий процесс GitHub: оцените GitHub Copilot для подсказок, вопросов по коду и делегированных задач по репозиторию.
Если нужно исследовать и изменить несколько файлов: сравните Cursor, Claude Code или Codex на одном и том же снимке репозитория с одинаковыми приёмочными тестами.
Если хочется попробовать среду, ориентированную на агентов: оцените Google Antigravity с учётом текущей доступности аккаунта, поддерживаемых моделей и лимитов запросов.
Если нужно собрать браузерный прототип: сравните рабочий процесс проекта в Replit с рабочим пространством для создания приложений, например Enter Pro, включая требования к данным и развёртыванию.
Лучшие ИИ-инструменты для программирования могут пересекаться по этим задачам. Не стоит платить за несколько подписок одновременно, пока вы не определите конкретную задачу, которую один инструмент решает лучше в вашем рабочем процессе.
Чтобы ответить на вопрос «какой ИИ лучше для программирования?», возьмите задачу, которую вы уже умеете оценивать. Новичок может предсказать вывод небольшой функции; поддерживающий код специалист может воспроизвести ошибку; основатель может пройти полный путь действия клиента. Такой известный ориентир не даёт складному объяснению заменить реальные доказательства. По возможности сохраняйте обычную реализацию вручную или существующий тест как базовый уровень, чтобы увидеть, действительно ли помощь ИИ сэкономила работу после проверки и исправления.
Разделяйте модель, инструмент и агента
Модель производит рассуждение и код
Модель принимает входные данные и генерирует выходные. Инструмент добавляет интерфейс и контекст проекта. Агент объединяет модель с циклом выполнения, который может просматривать файлы, запускать команды и пересматривать работу. Два продукта с похожей моделью всё равно могут вести себя по-разному, потому что предоставляют разный контекст, инструменты, права доступа и обратную связь.
Контекст и проверка важны не меньше генерации
Большое контекстное окно — это просто объём, а не доказательство того, что были использованы нужные файлы. Для ошибки входа полезный контекст включает неработающий маршрут, конфигурацию аутентификации, релевантные тесты и ожидаемое поведение. Убедительное объяснение без воспроизведённой ошибки или проверенного изменения — более слабое доказательство, чем узкое исправление, прошедшее значимую проверку.
Для изменения, затрагивающего несколько файлов, попросите агента сначала определить маршрут, схему, вызывающий код и существующий тест, прежде чем редактировать. Затем сравните эту карту с реальным репозиторием. Если агент пропустил общий хелпер или выдумал путь к файлу, исправьте контекст до реализации. Лучшие ИИ-инструменты для программирования полезны отчасти потому, что сокращают это исследование, но уверенное резюме недостаточно. Релевантный контекст должен проявляться в самом патче и в проверке.
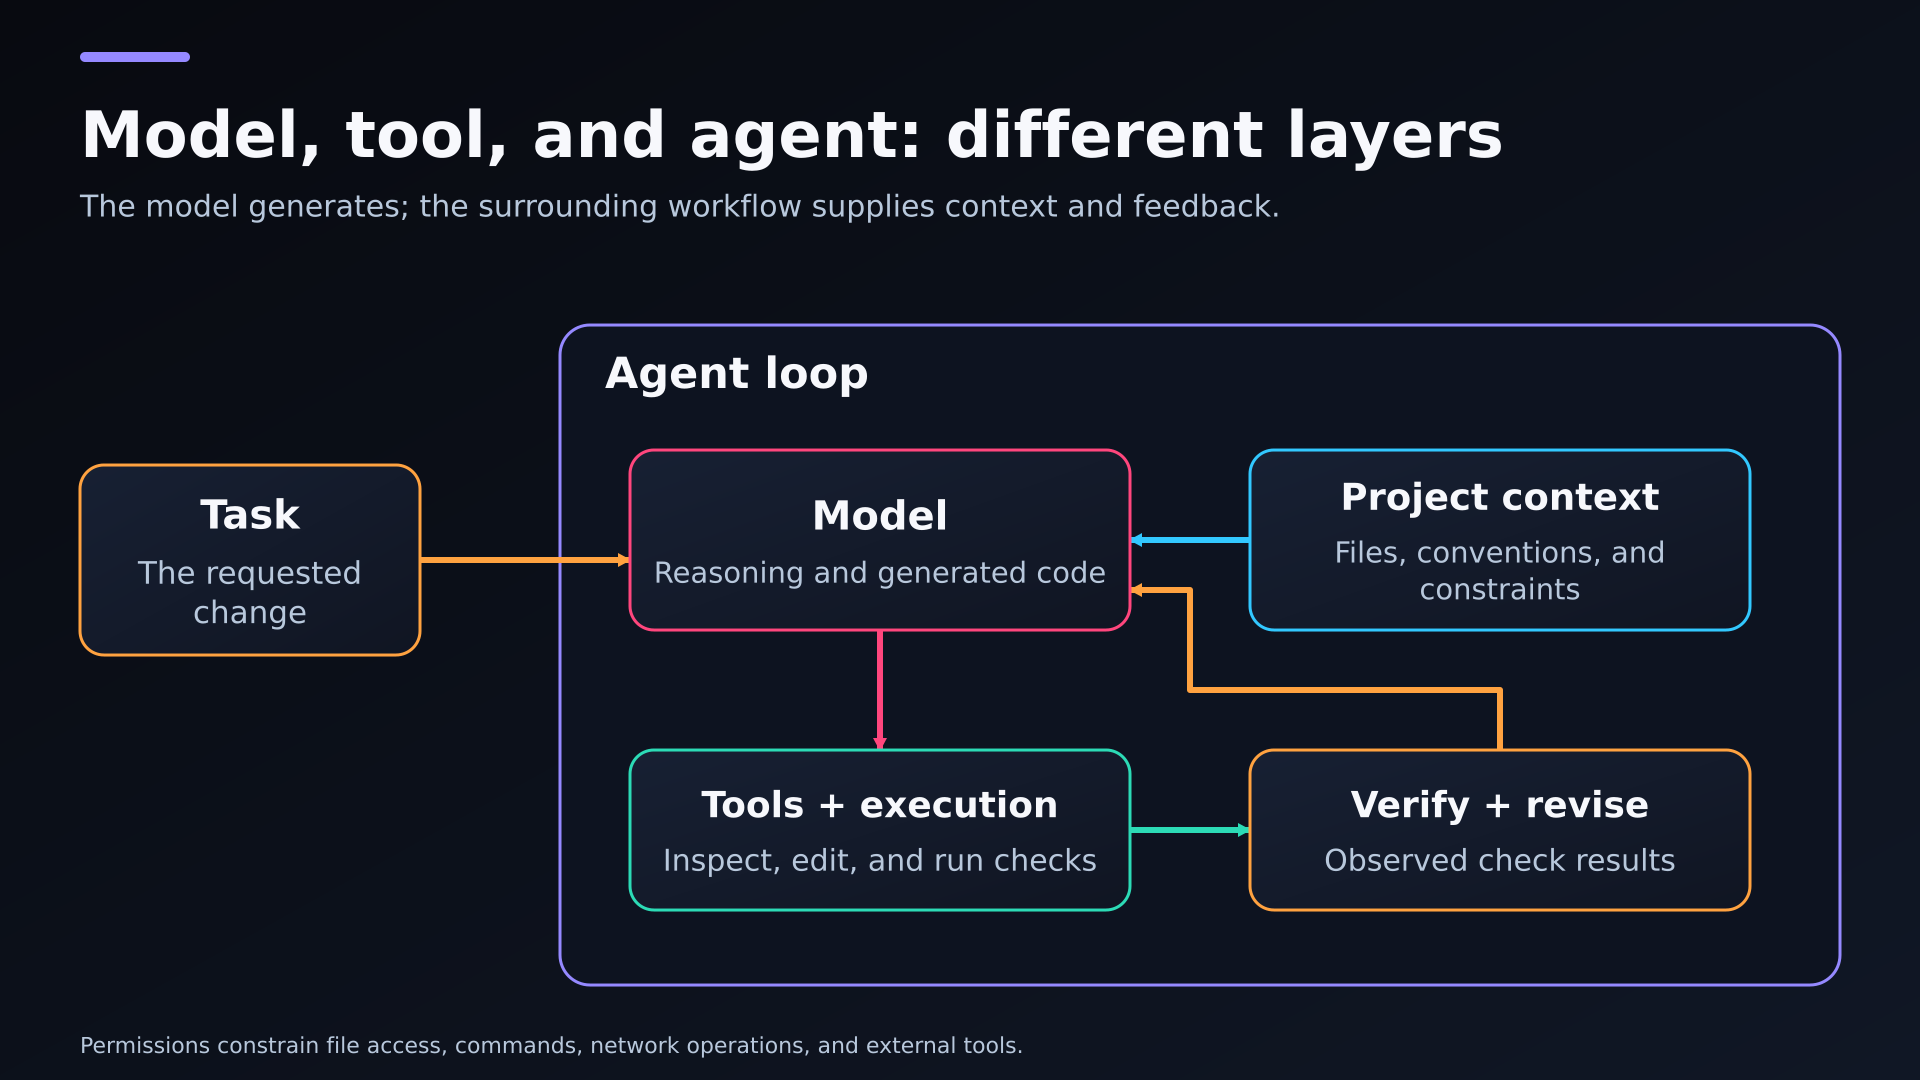
Концептуальный цикл агента, показывающий контекст проекта, модель, выполнение инструментов и проверку.
Сравнение шести ИИ-инструментов для программирования по их рабочей среде
GitHub Copilot для существующего редактора и рабочего процесса с репозиторием
Copilot предлагает встроенные подсказки, вопросы по кодовой базе, ревью и агентные задачи в рамках поддерживаемых рабочих процессов разработки. Это полезный кандидат, когда нужна поддержка вокруг существующего редактора, задачи или pull request. Оцените функции, доступные в выбранном вами плане и редакторе; локальный режим агента и pull request, созданный в облаке, — это разные возможности.
Полезным тестом будет хелпер с уже установленной сигнатурой типа и соседними вызывающими местами. Проверьте, следуют ли подсказки соглашениям проекта или подключают ещё одну библиотеку валидации. Затем попробуйте вопрос по репозиторию, требующий отслеживания импорта через модули. Рассматривайте встроенную помощь и делегированные задачи как отдельные результаты; один инструмент может быть удобен для одного случая, даже если для более масштабных изменений вы предпочитаете другого агента.
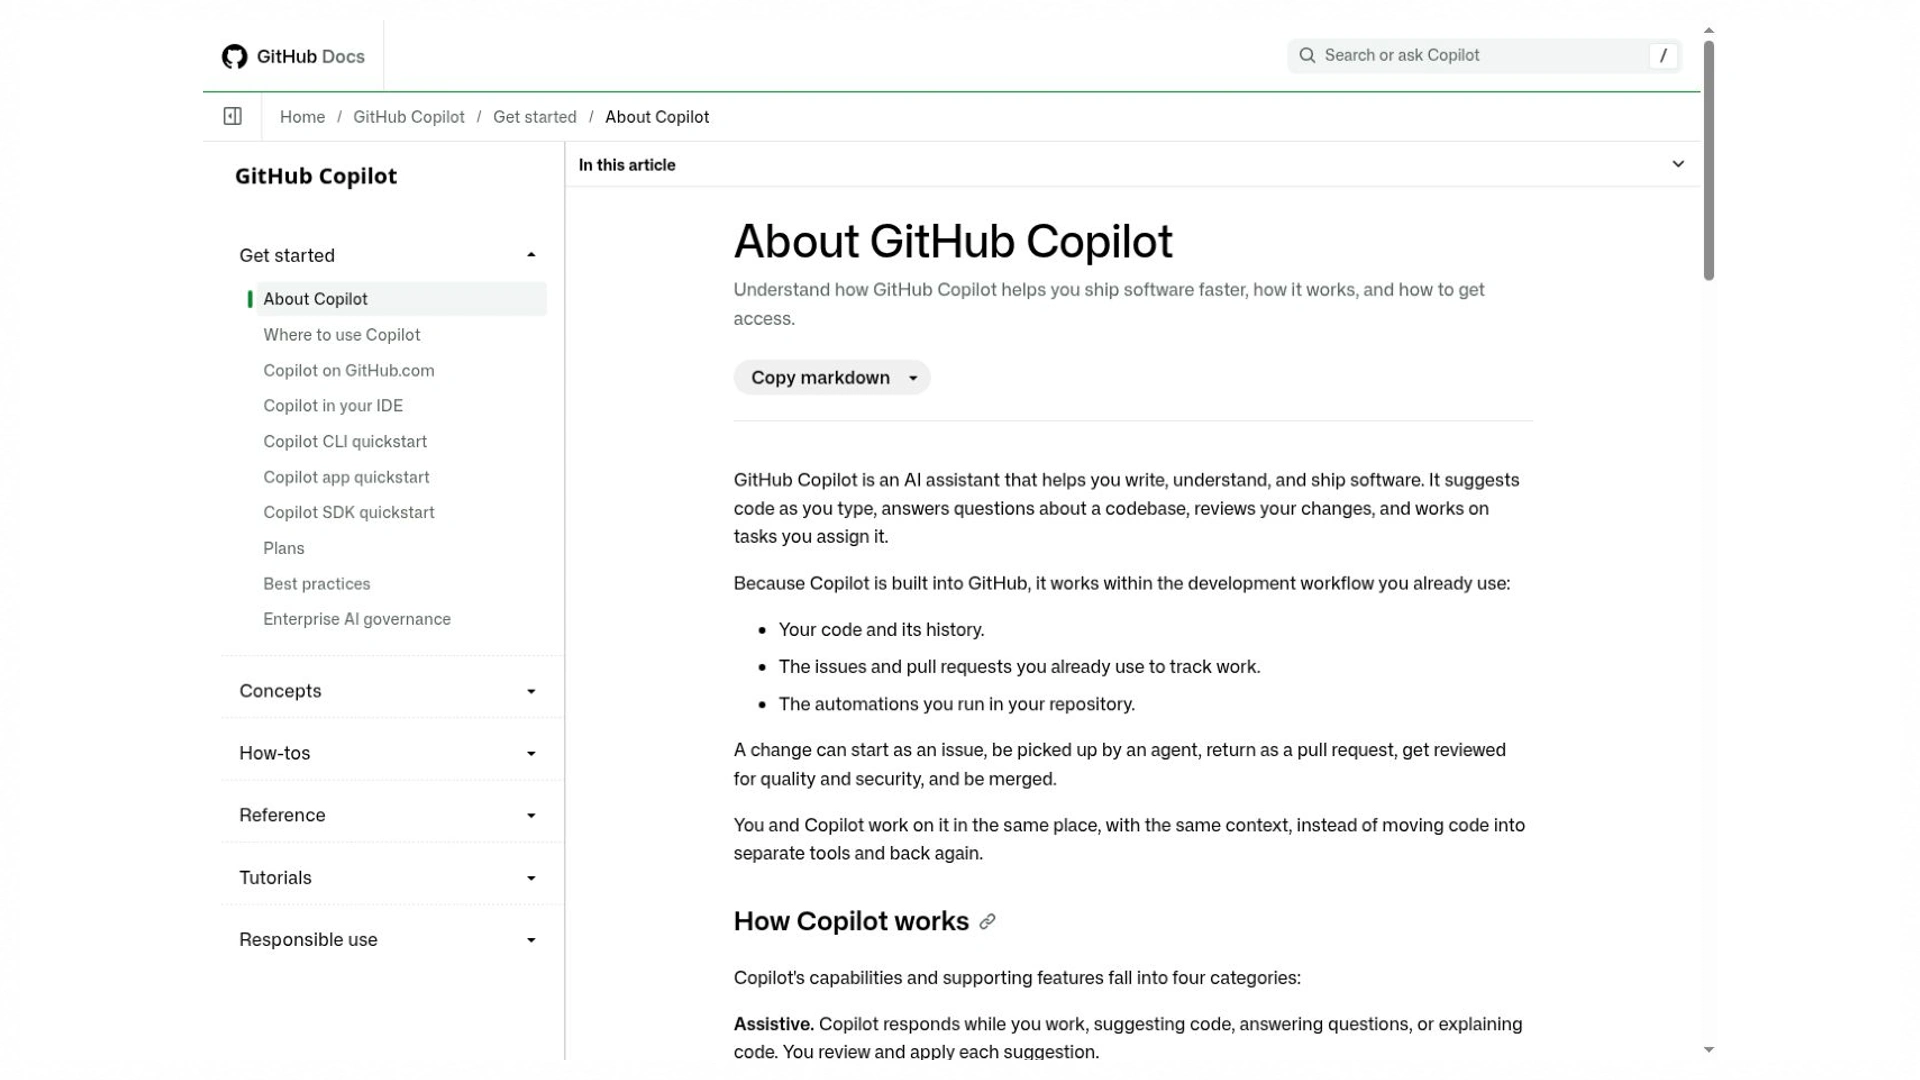
Обзор описывает поддерживаемую помощь и рабочие процессы агента. Доступность функций зависит от задокументированной среды и плана.
Cursor для планирования и проверки изменений в рамках всего проекта
Документация Cursor охватывает понимание репозитория, планирование, реализацию, отладку и проверку изменений. Стоит рассмотреть его, когда работа затрагивает несколько файлов и вы хотите, чтобы эти этапы были связаны друг с другом. Опишите неработающее поведение и соглашения репозитория, затем проверьте полученный diff. Уточните текущую модель и условия использования, а не предполагайте, что старая подписка включает неограниченный доступ к сторонним моделям.
Например, один переключатель настроек может потребовать состояния компонента, маршрута обновления на сервере и сохраняемого параметра. Попросите Cursor сохранить текущие шаблоны получения данных и валидации, а затем проверьте все три эти точки. Изменённого флажка одного недостаточно. Сохраните проверку поведения при перезагрузке страницы, чтобы задача не завершалась на привлекательном взаимодействии, которое исчезает при обновлении страницы.
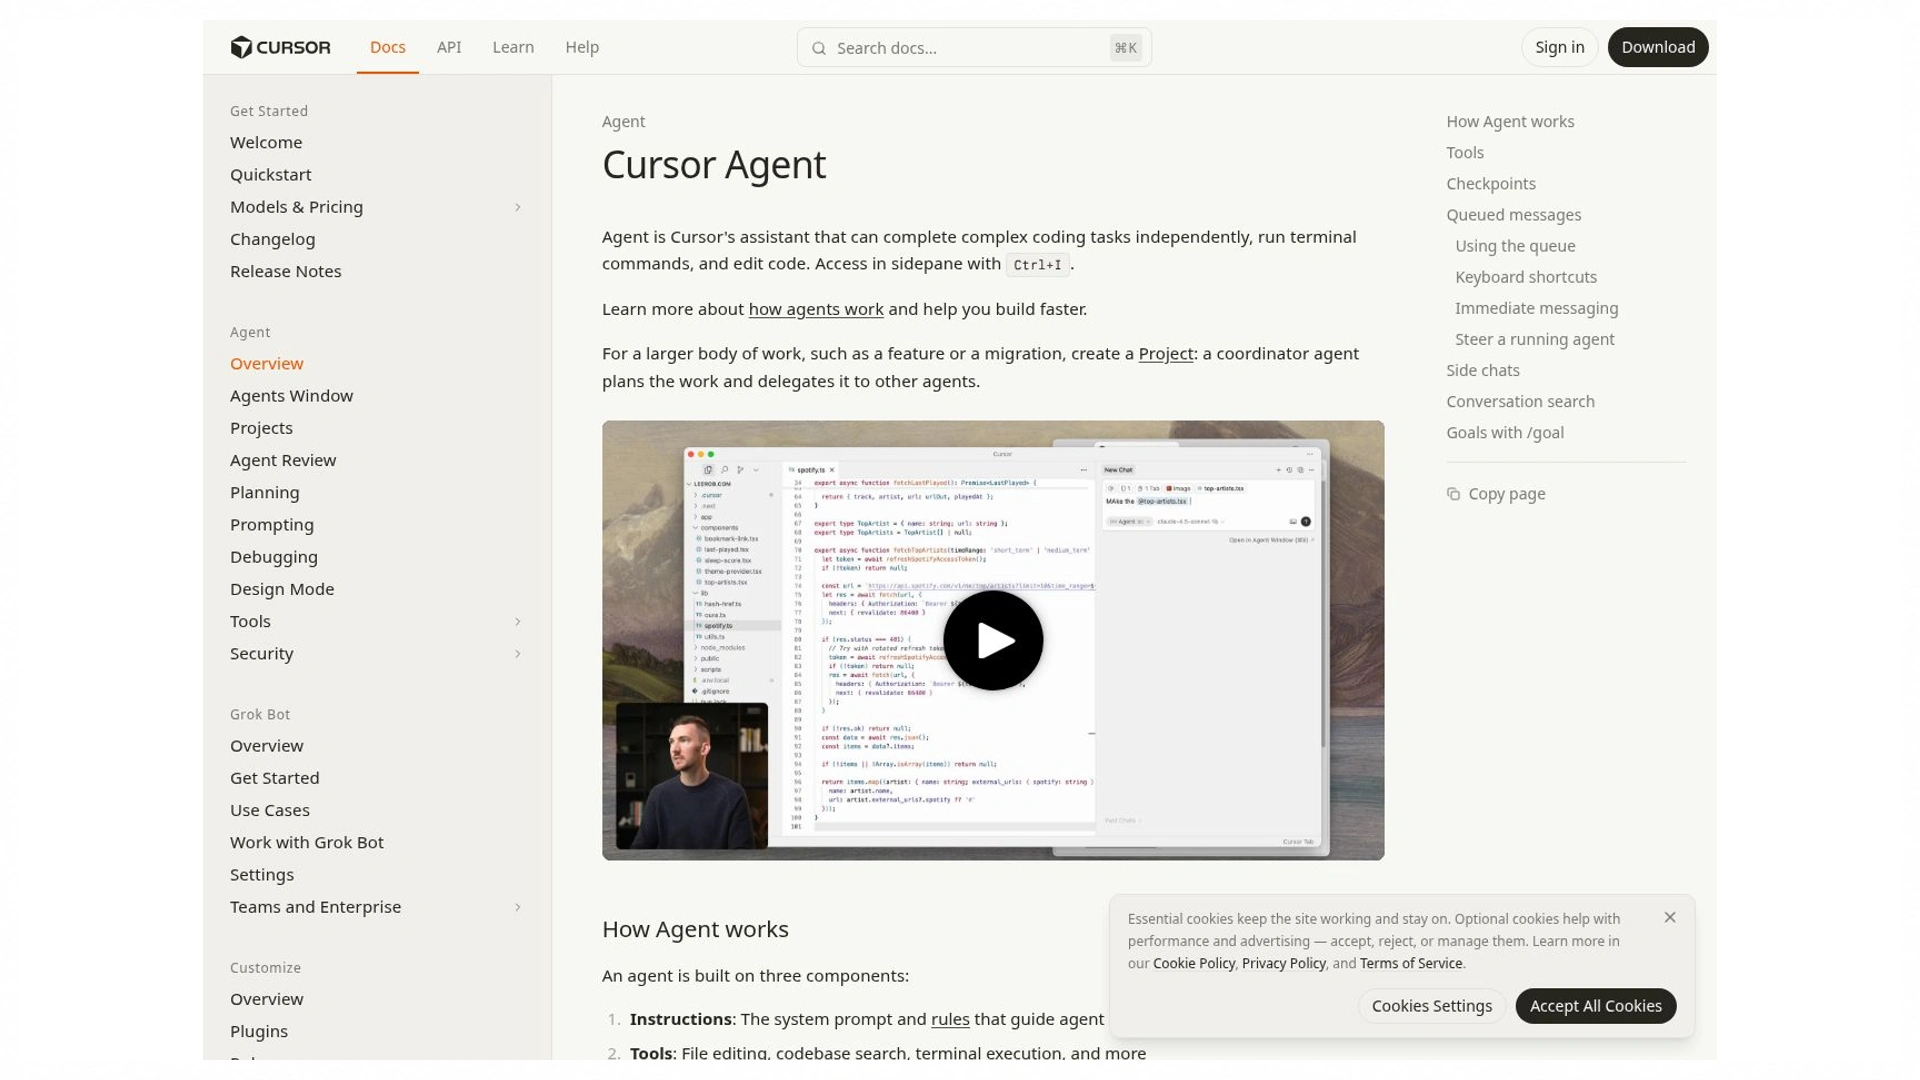
Официальная документация Cursor
Обзор агента описывает планирование, реализацию и связанные возможности рабочего процесса. Это снимок документации, а не измеренный результат программирования.
Источник: cursor.com · снято 25 октября 2026
Claude Code для разработки на основе файлов и команд
Claude Code читает код, редактирует файлы, запускает команды и работает через терминал, IDE, десктоп и браузер. Это кандидат для исследования незнакомых модулей или координации рефакторинга с заданными границами. Попросите его определить зависимости и план проверки, прежде чем изменять их. Способность запустить команду не доказывает, что сама команда или предложенная архитектура подходят.
Задача, ориентированная на терминал, может начинаться с неработающей команды и краткого воспроизведения. Дайте агенту обычное окружение проекта и попросите его определить причину, прежде чем предлагать рефакторинг. Проверяйте операции в shell и новые зависимости так же, как код. Успешный запуск тестовой команды полезен только если релевантное утверждение (assertion) всё ещё существует и среда похожа на ту, в которой вы развёртываете приложение.
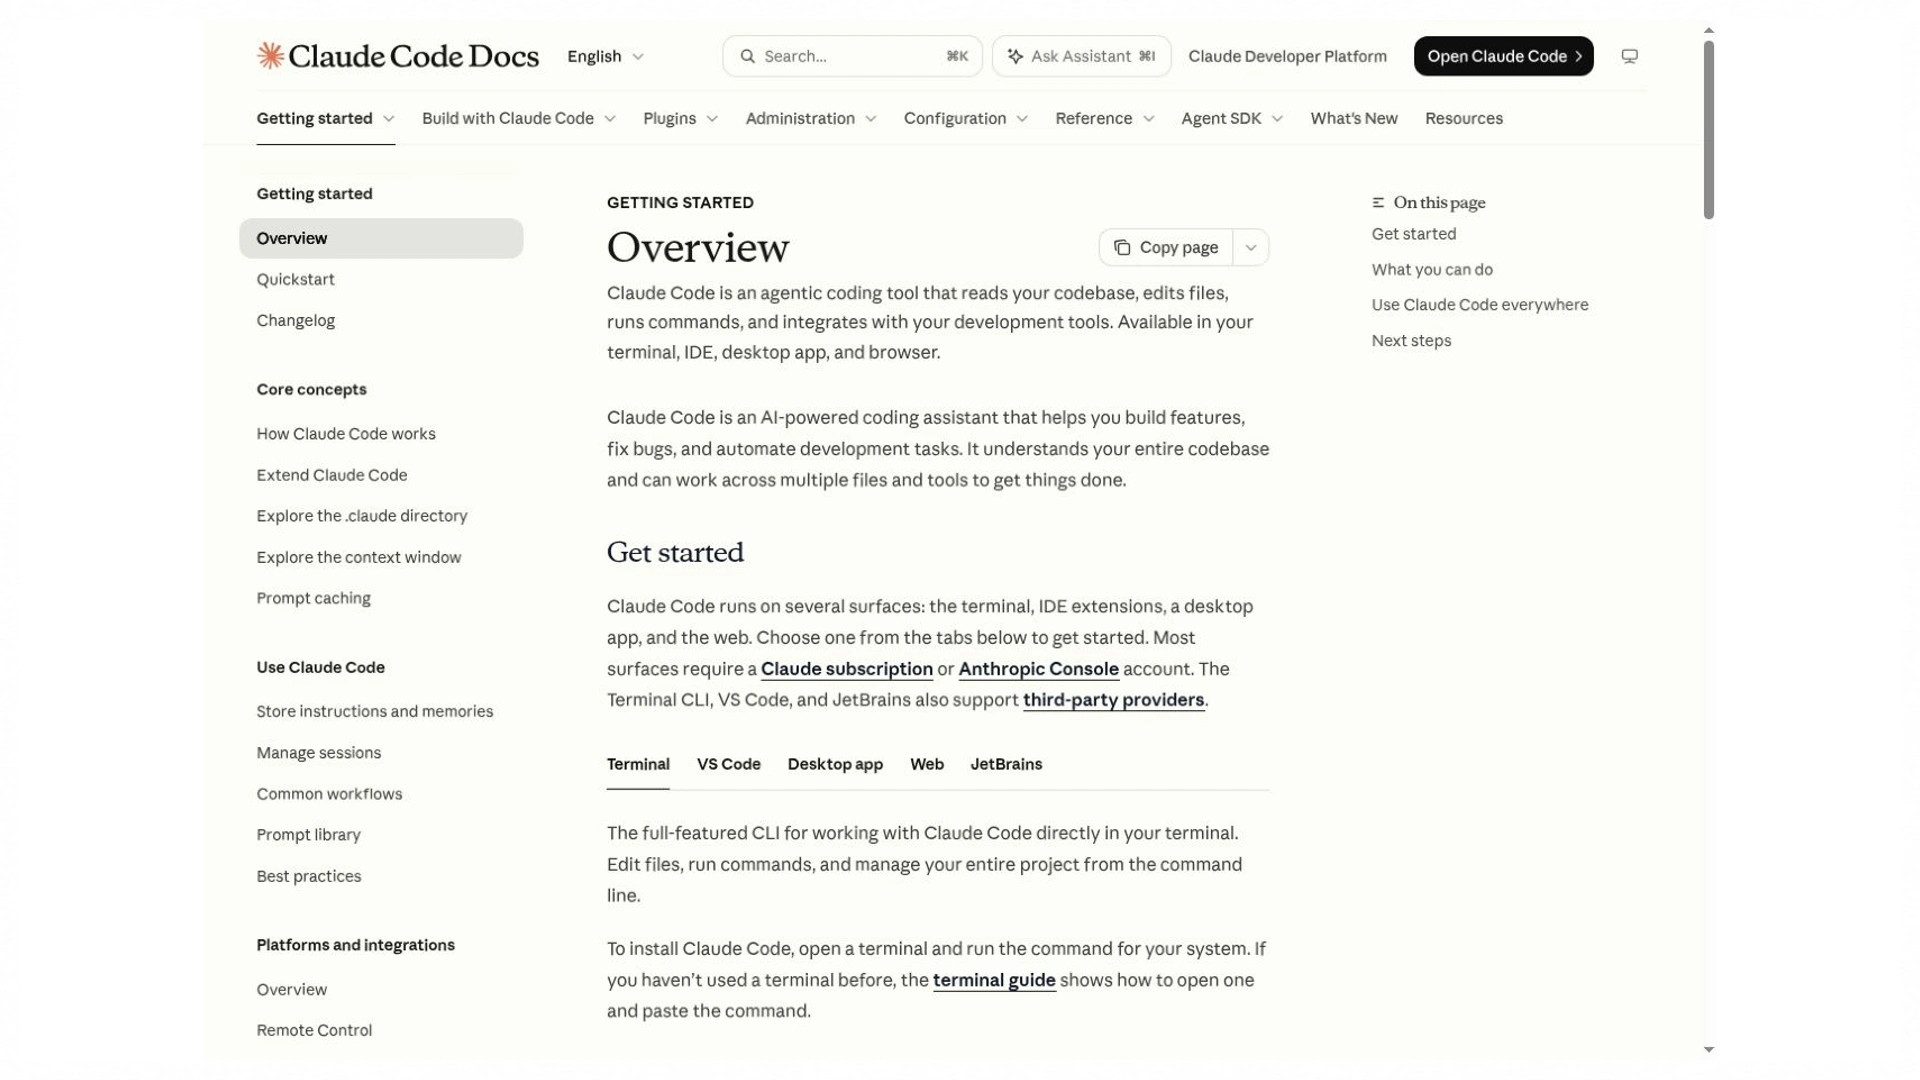
Обзор объясняет платформы разработки и рабочий процесс на основе файлов и команд. Он не устанавливает рейтинг производительности.
Codex для делегирования ограниченной программной задачи
Codex объединяет модели программирования с инфраструктурой для контекста, использования инструментов, выполнения и границ ревью. Его приложение, CLI и расширение для IDE поддерживают разные способы работы. Полезная оценочная задача имеет заявленный результат, релевантные файлы и проверки, которые могут провалиться. Сравнивайте завершённый патч и оставшийся объём ревью, а не длину объяснения агента.
Для Codex держите результат ограниченным: исправьте одну регрессию, обновите небольшой контракт API или добавьте один целевой тест. Определите, какие файлы или сервисы он может менять, и какое поведение должно оставаться совместимым. Полезная передача включает патч, вывод проверки и нерешённые ограничения. Разработчик всё равно должен решить, подходит ли реализация архитектуре репозитория и процессу релиза.
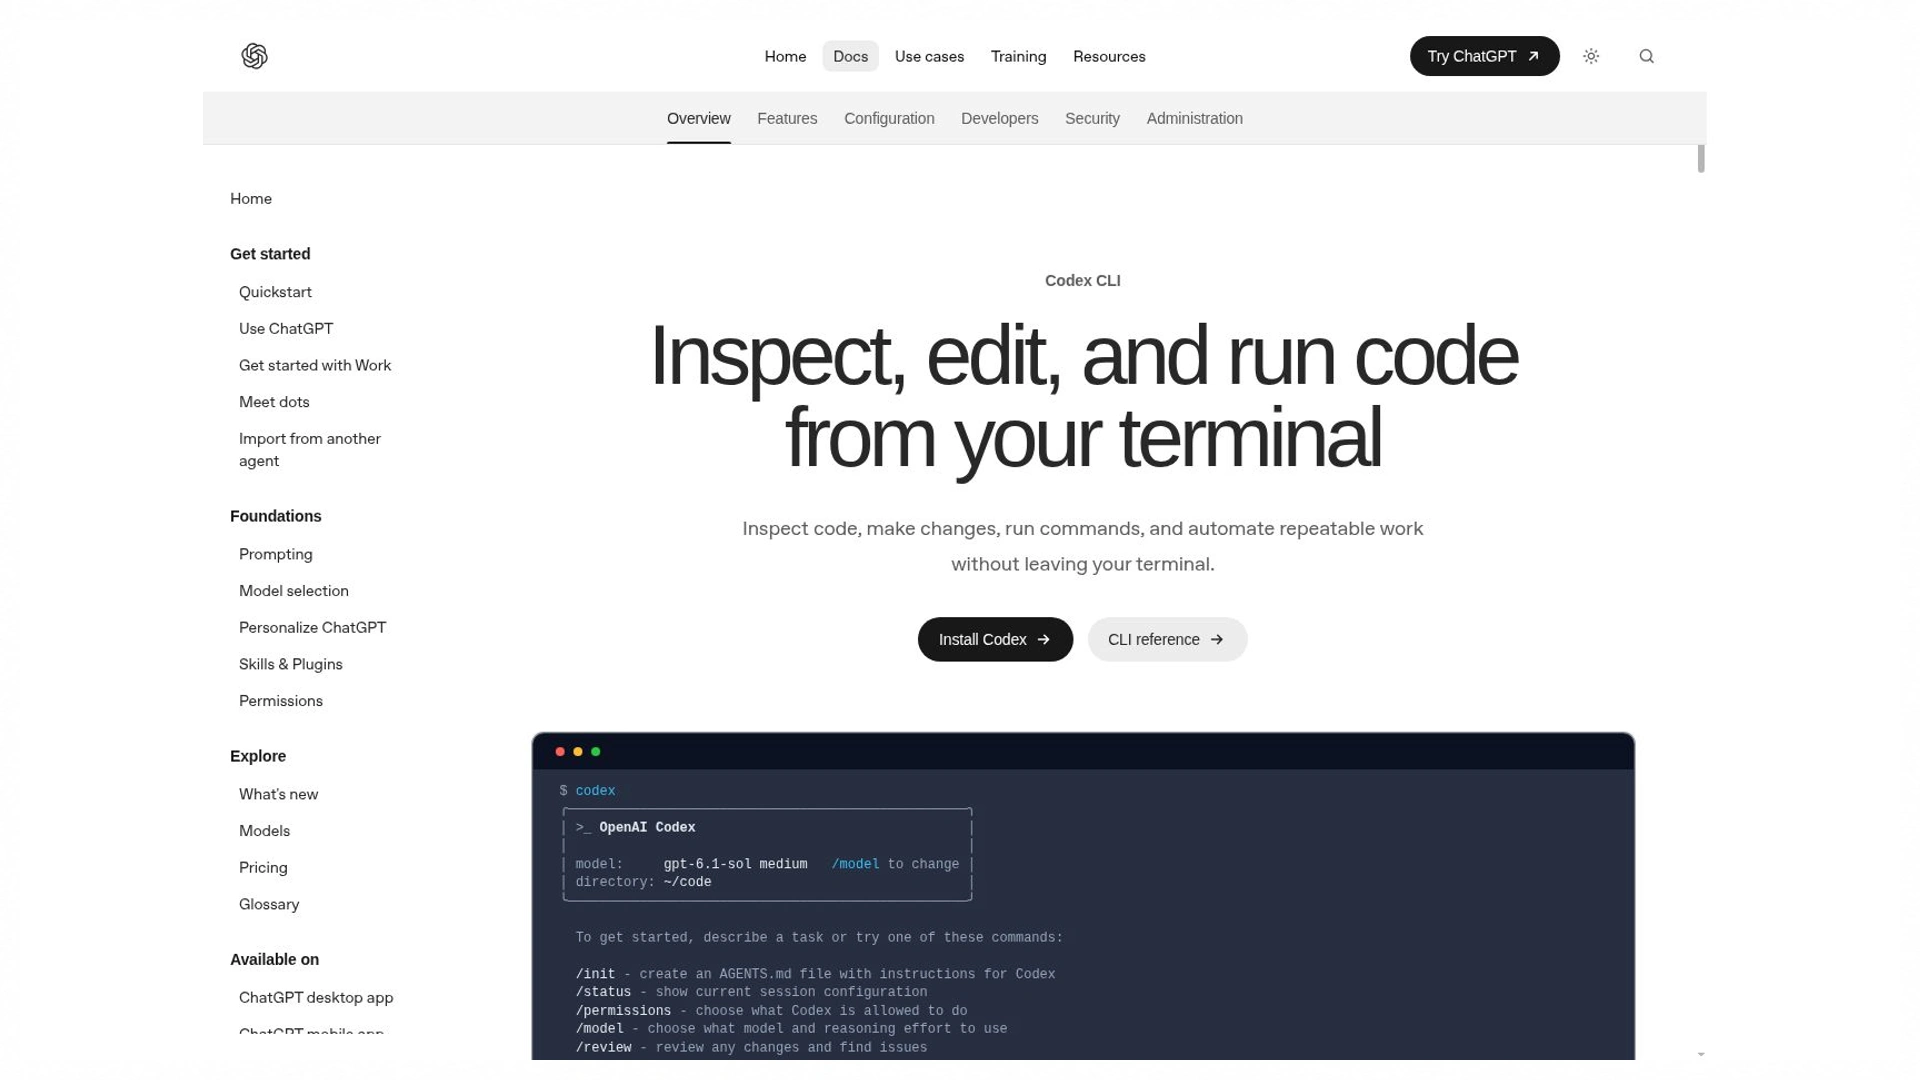
CLI — один из задокументированных путей для ограниченной задачи программирования. Проверьте настройки выполнения и просмотрите полученный патч.
Google Antigravity для рабочего процесса, ориентированного на агента
Antigravity документирует рабочий процесс разработки, ориентированный на агента, на всех поддерживаемых платформах. Стоит рассмотреть его, если вы хотите оценить планирование, выполнение и ревью вместе, а затем проверить текущую настройку, доступность аккаунта и лимиты. Попросите его исследовать одну воспроизводимую проблему и проверьте полученные артефакты и diff. Способность продукта координировать несколько видов деятельности не доказывает, что он корректно выполнит именно вашу задачу или потребует меньше контроля.
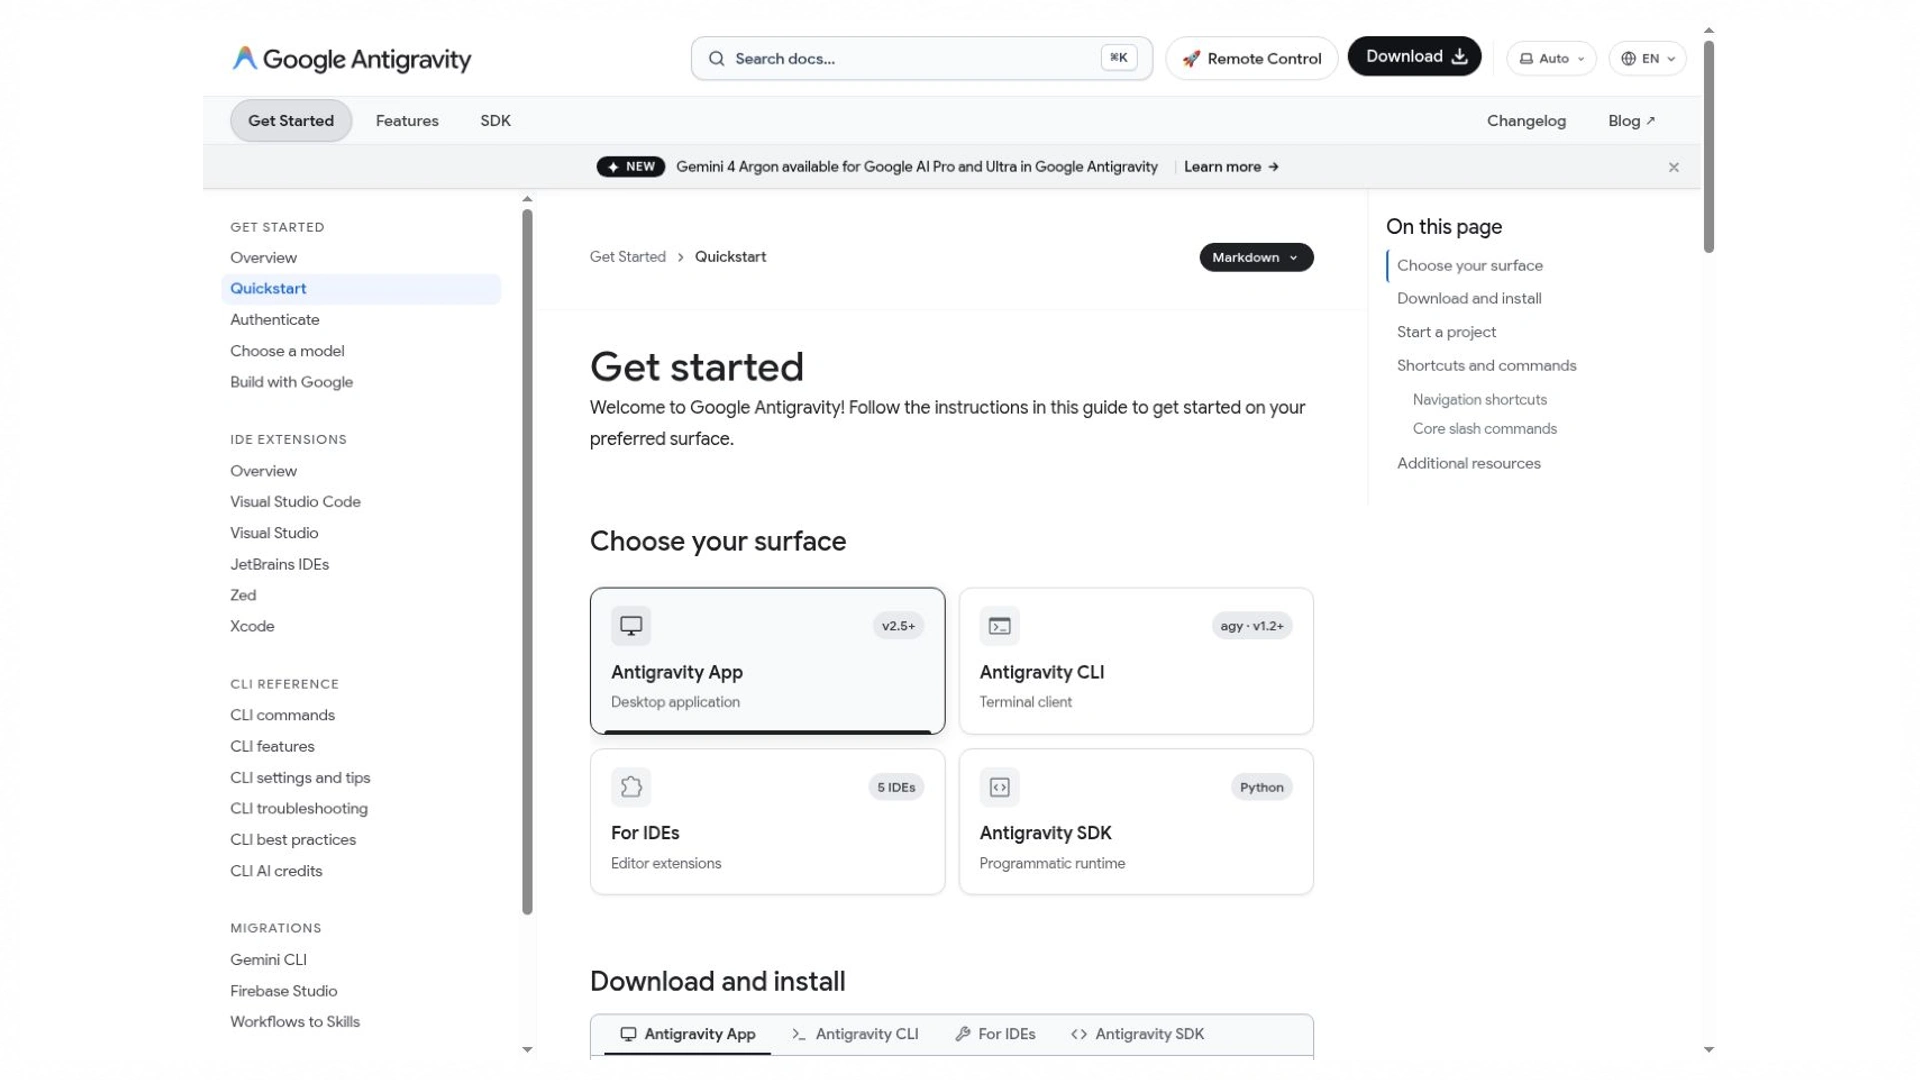
Руководство по началу работы описывает настройку и рабочий процесс агента. Подтвердите текущие условия аккаунта перед тестированием.
Replit для запуска и публикации браузерного проекта
Replit Agent может генерировать код, настраивать инфраструктуру проекта и помогать тестировать и публиковать приложение в своей рабочей среде. Оцените его, когда настройка локальной среды становится препятствием. Проверьте реально сгенерированный стек, персистентность и поведение публикации. Отдельно проверьте расходы на использование и операционные требования; привлекательный предпросмотр сам по себе не доказывает надёжность приложения.
Для хостингового прототипа откройте опубликованный маршрут повторно в отдельной сессии и проверьте назначение данных. Фикстуры разработки, хранилище предпросмотра и производственные записи могут отличаться. Сохраните редиректы аутентификации и имена переменных окружения в заметках по передаче. Эти детали часто определяют, останется ли приложение пригодным для использования после завершения первоначальной сессии генерации.
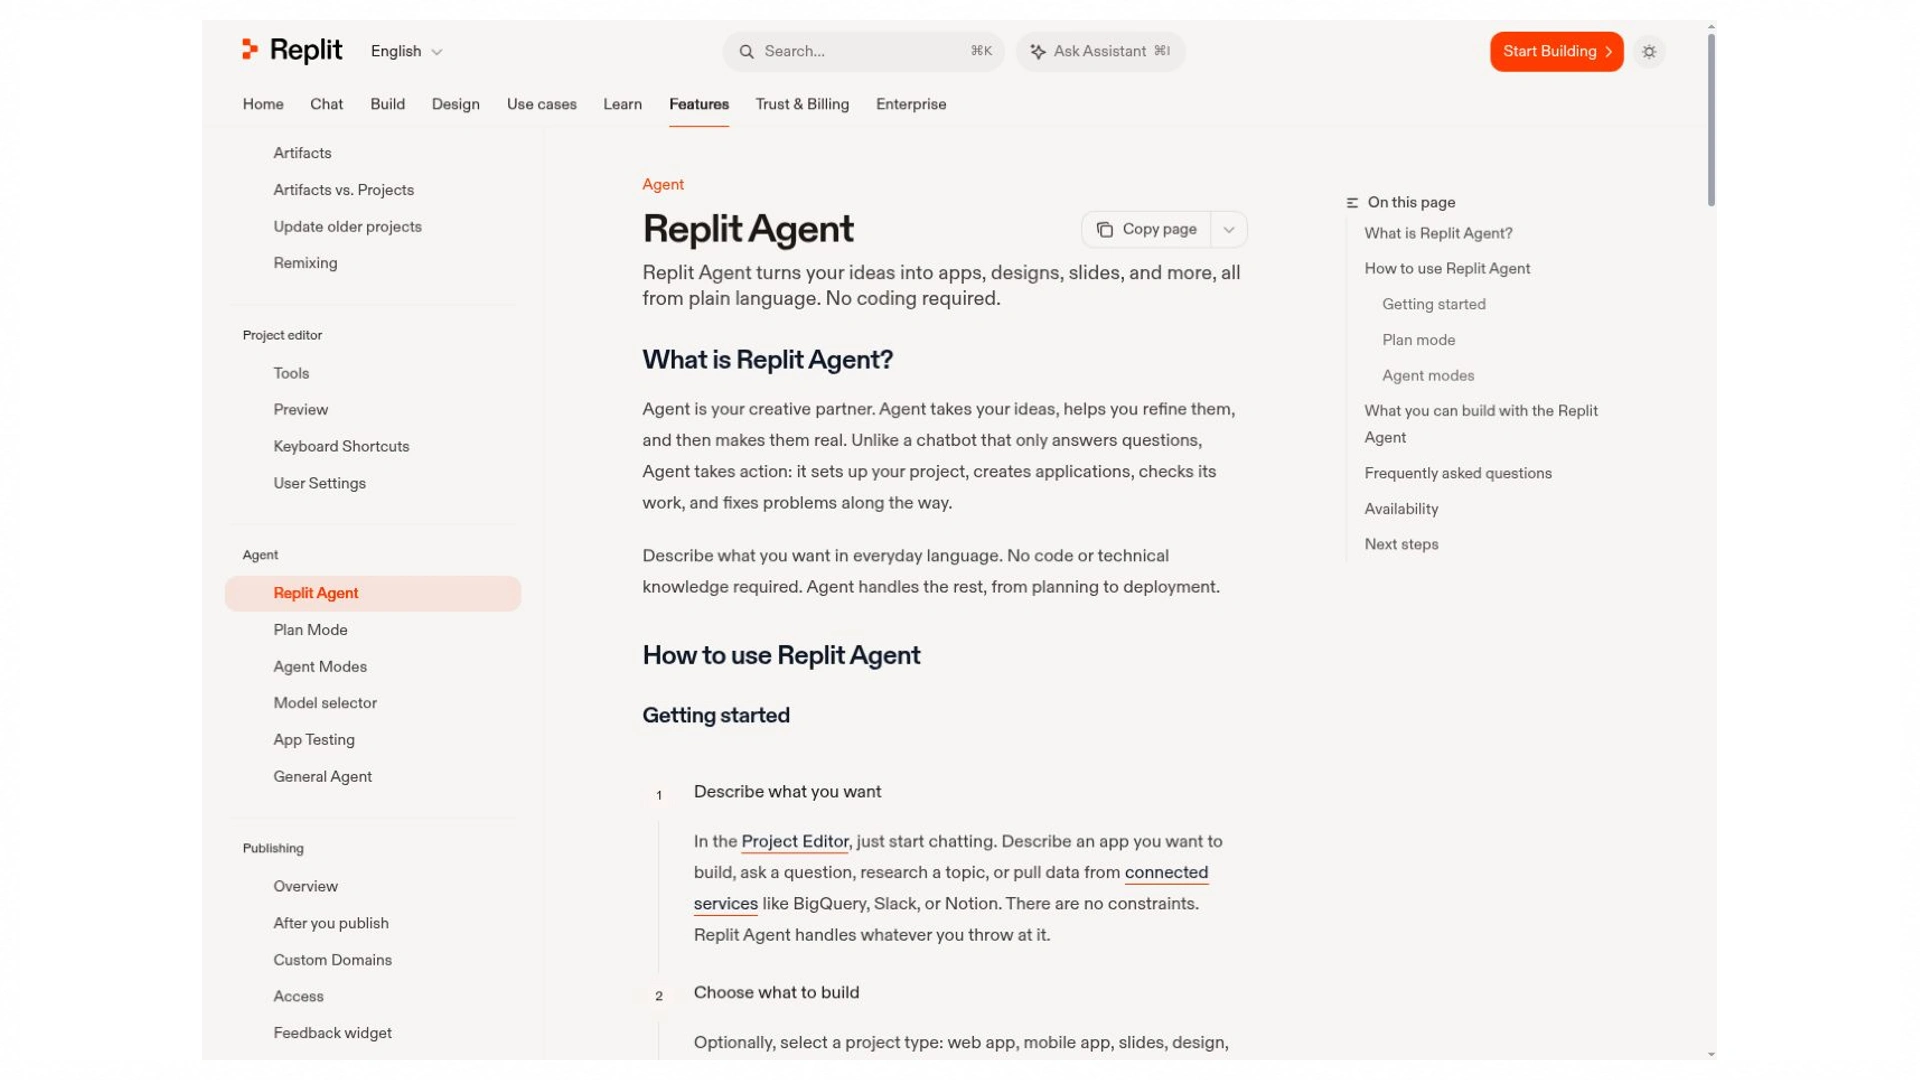
Документация описывает рабочий процесс хостингового проекта. Предпросмотр, публикация и использование ресурсов требуют собственных отдельных проверок.
Сравнивайте каждого кандидата по одним и тем же четырём вопросам: Где он выполняется? Что он может просматривать? Что он может выполнять? Как вы проверяете и сохраняете результат работы? Примеры включают исправление устаревшего кода на Python, экран настроек на React, неработающую миграцию SQL и небольшую внутреннюю панель управления. Эти примеры проверяют разные сильные стороны без необходимости в четырёх отдельных кейс-стади.
Выбирайте лучшую ИИ-модель для программирования с проверкой на уровне задачи
Используйте актуальные идентификаторы моделей, а не старые названия продуктов
Выбирайте идентификаторы моделей, которые доступны в вашем реальном инструменте и аккаунте. Актуальная документация OpenAI называет GPT-6.1 Sol кандидатом для сложного программирования; другие провайдеры также предлагают модели с разными компромиссами по рассуждению, задержке и цене. Доступность в чат-продукте не гарантирует доступность через ваш агент для программирования. Зафиксируйте точный выбранный идентификатор, любую автоматическую маршрутизацию и настройки уровня усилий. Это кандидаты для вашего пилота, а не результаты прямого сравнительного теста, проведённого для этой статьи.
Лучшая ИИ-модель для программирования может отличаться в зависимости от узкого преобразования или сложного исследования репозитория. Сначала попробуйте модель по умолчанию, затем более мощный вариант рассуждения на тех случаях, где она ошибается. Сохраняйте одни и те же входные данные и проверяйте, приводят ли дополнительная задержка и стоимость к приемлемому улучшению. Более крупная или дорогая модель не является автоматически лучшей покупкой для каждой повторяющейся задачи.
Читайте бенчмарки вместе с условиями их тестирования
SWE-bench Verified содержит 500 отфильтрованных человеком программных проблем. Его результаты относятся к конкретной настройке оценки, а не к любому языку или задаче создания приложений. Зафиксируйте вариант бенчмарка, настройку агента, версию модели и дату, прежде чем сравнивать баллы. Коллекция по программированию, предоставляемая OpenRouter, измеряет недавнее использование токенов в собственном сервисе; популярность использования — это не бенчмарк корректности.
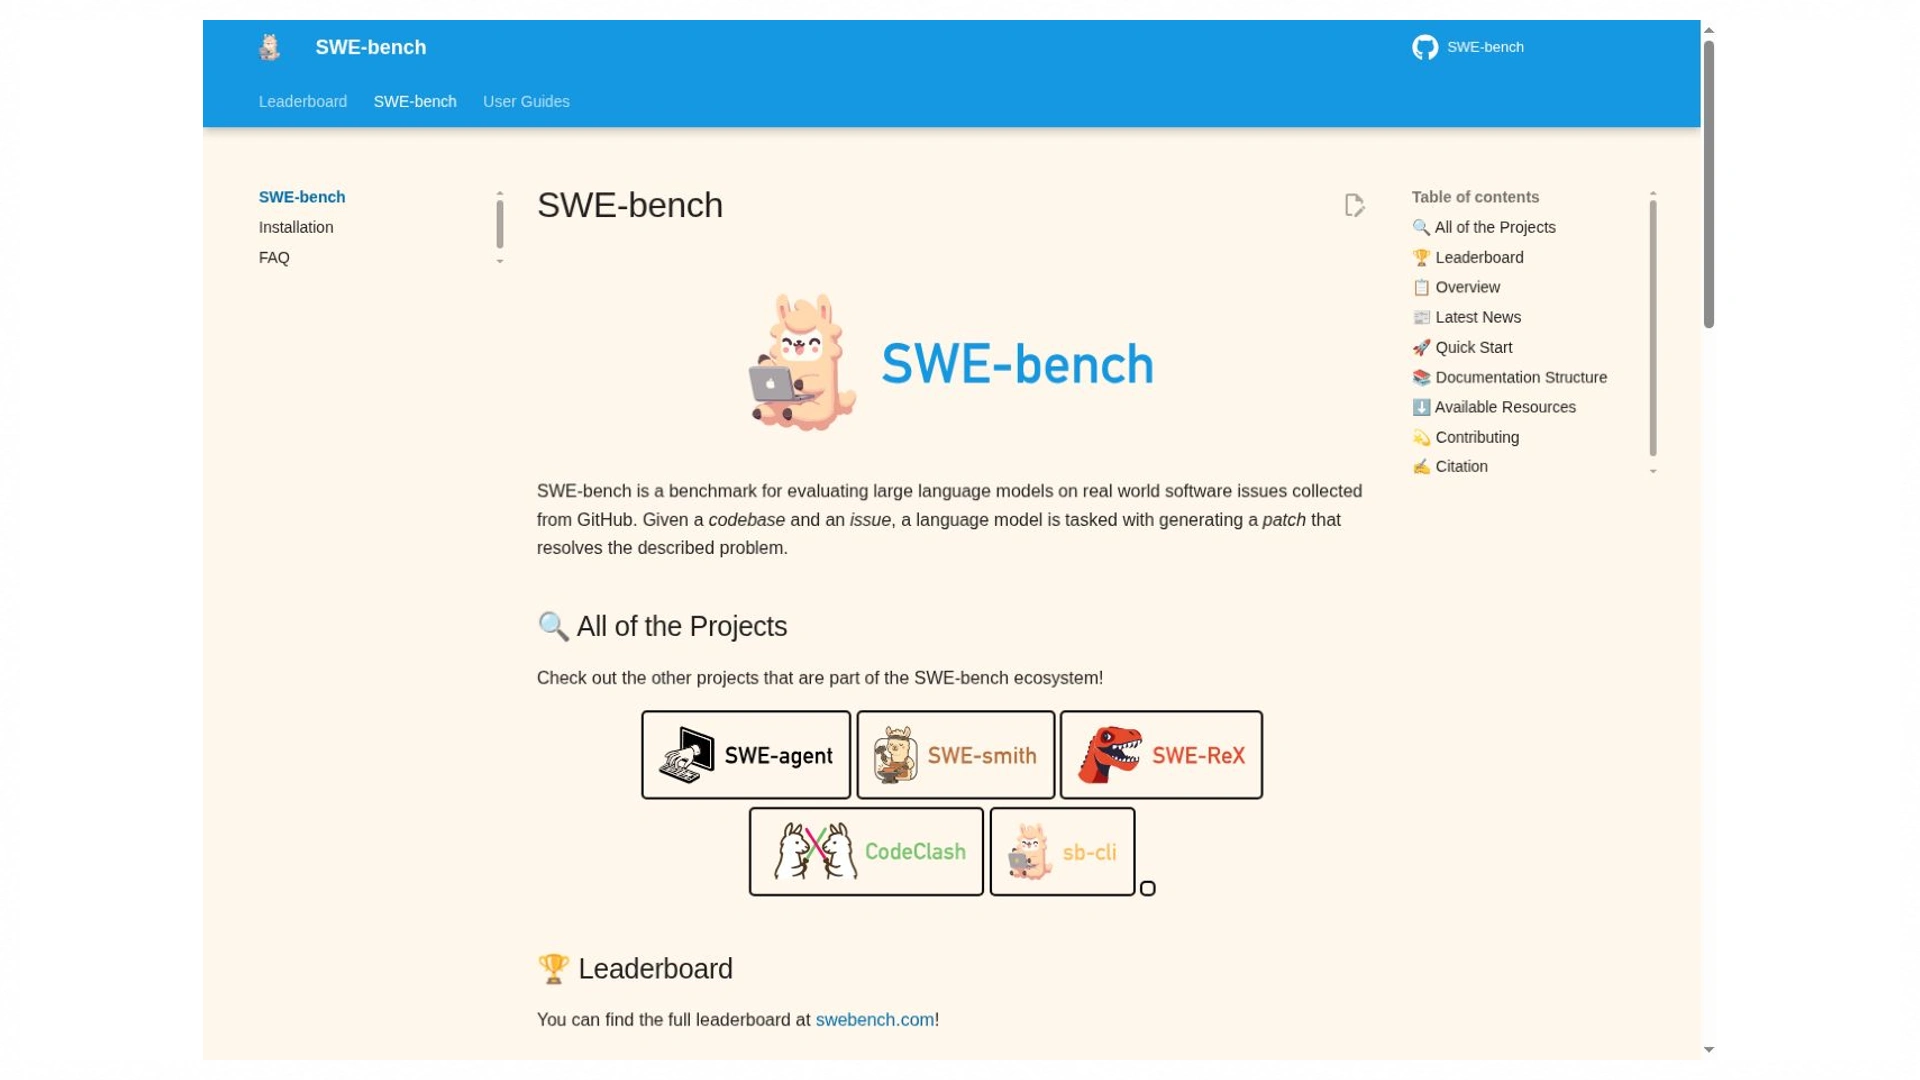
Официальная страница проекта SWE-bench
Важны варианты бенчмарка и условия оценки. Опубликованные баллы не заменяют задачу в вашем собственном репозитории.
Источник: www.swebench.com · снято 25 октября 2026
Найдите лучший бесплатный ИИ для программирования без затрат на подписку
Отделяйте бесплатный план от включённого использования агента
Текущие официальные страницы описывают ограниченный бесплатный доступ для продуктов, таких как GitHub Copilot и Cursor. Доступность и лимиты Antigravity также зависят от задокументированных условий аккаунта. Проверьте функцию, которую вы будете использовать: встроенные автодополнения, чат, действия агента и хостинговое выполнение могут иметь разные лимиты. Бесплатный интерфейс инструмента может всё же обращаться к платному провайдеру. Зафиксируйте дату проверки и проверьте оставшееся использование после одной полностью выполненной задачи, а не предполагайте, что старая месячная квота всё ещё действует.
Поиск лучшего бесплатного ИИ для программирования наиболее полезен, когда вы определяете весь бесплатный рабочий процесс целиком. Включите редактор, вызовы модели, среду выполнения и любые хостинговые ресурсы. Локальная модель может убрать счёт от провайдера, но всё равно потребовать мощного оборудования и настройки. Сделайте первый тест достаточно маленьким, чтобы завершить его в рамках текущего лимита, а затем проверьте, сколько будет стоить дальнейшее использование или публикация.
Включите время ревью, повторные попытки, хостинг и затраты на API
Полезный расчёт: стоимость за принятую задачу = относимые затраты на инструмент и использование, делённые на принятые задачи, при этом время ревью учитывается отдельно. Для примера: 12 долларов относимых затрат на четыре принятые задачи — это 3 доллара за задачу. Этот расчёт гипотетический. Включайте неудачные попытки в затраты и определите «принято» до начала тестирования, чтобы визуально завершённая, но нерабочая функция не засчитывалась.
Оценивайте продуктивность по доказательствам, а не по объёму выдаваемого результата
Используйте статистику исследований в её исходном масштабе
В опросе Stack Overflow за 2025 год 46% опрошенных, ответивших на этот вопрос, не доверяли точности ИИ-инструментов, а 33% доверяли. Это измеряет заявленное доверие, а не дефекты кода. Это поддерживает практический вопрос для вашего пилота: сколько проверки и исправлений требует результат, прежде чем вы сможете его использовать?
Эксперимент METR начала 2025 года включал 16 опытных разработчиков и 246 задач и показал, что задачи занимали на 19% больше времени с изученными инструментами. Обновление за февраль 2026 года сообщило о проблемах выбора и измерения, которые сделали более позднее исследование ненадёжным для оценки текущего эффекта. Ни одно из этих наблюдений не устанавливает универсальный штраф или выигрыш скорости для сегодняшних инструментов.
Фиксируйте корректность, объём ревью и время до принятого изменения
Чтобы определить лучший ИИ для программирования в вашем проекте, фиксируйте начальный коммит, промпт, модель, план, затраченное время, активное время ревью, затраты и оставшиеся дефекты. Запускайте каждого кандидата с чистой копии. Повторяйте показательные задачи, где возможно, и фиксируйте неудачи. Короткий пилот может направить решение о покупке, но не может оправдать универсальный процент точности или утверждение, что один продукт всегда быстрее.
Применяйте обязательные проверки прежде удобных оценок. Конечная точка, которая раскрывает запись другого пользователя, проваливает проверку, даже если её патч небольшой, а объяснение превосходно. После проверки корректности сравнивайте активные минуты ревью, прерывания и нагрузку на поддержку. Ведите учёт неудачных прогонов, а не сообщайте только о лучшей попытке. Это делает маленький пилот более информативным, не притворяясь, что он представляет каждый репозиторий или каждого разработчика.
Определите, какой ИИ лучше для программирования в вашей ситуации
Сопоставьте пример с работой, которую вам нужно завершить
Изучение функции: попросите объяснение, предскажите её вывод, затем измените её без помощи.
Исправление ошибки: предоставьте воспроизведение и ожидаемый результат; сохраните неработающую проверку как покрытие регрессии.
Изменение нескольких модулей: запросите трассировку зависимостей и небольшой патч перед масштабным переписыванием.
Создание прототипа: проверьте полный путь действия клиента, назначение данных и правила доступа.
Работа с проприетарным кодом: проверьте обработку данных применимого плана и организационные контроли перед предоставлением доступа к репозиторию.
Это делает выбор лучшего ИИ для программирования решением, которое вы можете объяснить: кандидат соответствует вашим ограничениям и требует приемлемого объёма ревью на показательных задачах. Сохраняйте доказательства и жизнеспособный путь передачи по мере роста проекта.
Решая, какой ИИ лучше для программирования, учитывайте путь восстановления вашей команды. Может ли другой разработчик запустить проект, просмотреть diff и продолжить без исходного чата? Храните архитектурные решения, проверки и настройку в репозитории. Для лучшего ИИ для vibe coding этот же вопрос важен после того, как прототип начинает хранить реальные записи: простота генерации должна приводить к приложению, которое вы можете понять и поддерживать.
Оцените Enter Pro, создав приватный трекер задач
Для читателей, оценивающих лучший ИИ для vibe coding, FixTrack даёт один конкретный пример создания приложения в Enter Pro. План определяет задачи, принадлежащие пользователю, и изменения статуса, а предоставленный предпросмотр показывает вымышленную задачу с высоким приоритетом в статусе Open. Это даёт проверяемый интерфейс и небольшой набор приёмочных проверок. Изображения не показывают тест со вторым аккаунтом, зафиксированную запись бэкенда или успешный перевод задачи в статус Resolved.
Шаг 1. Спланируйте трекер задач и его приёмочные проверки
Запланированный первый релиз имеет приватный список задач, форму создания, детальный просмотр и фильтры по статусу. Поля — это заголовок, описание, приоритет и статус: Open, In Progress или Resolved. Определите успех до генерации: валидная задача сохраняется после перезагрузки, авторизованное обновление сохраняется, а другой аккаунт не может её прочитать или изменить. Оставьте приглашения в команду и интеграции за рамками этой первой задачи, чтобы внешне завершённый интерфейс не скрывал базовую границу данных.
Копируемый промпт — Спланируй вымышленный трекер задач FixTrack. Авторизованные пользователи могут создавать, читать и обновлять только свои собственные задачи. Используй заголовок, описание, приоритет Low/Medium/High и статус Open/In Progress/Resolved. Определи маршруты, схему, авторизацию и приёмочные тесты. Оставайся в режиме Plan Mode до тех пор, пока план не будет одобрен; не придумывай ревью или результаты.
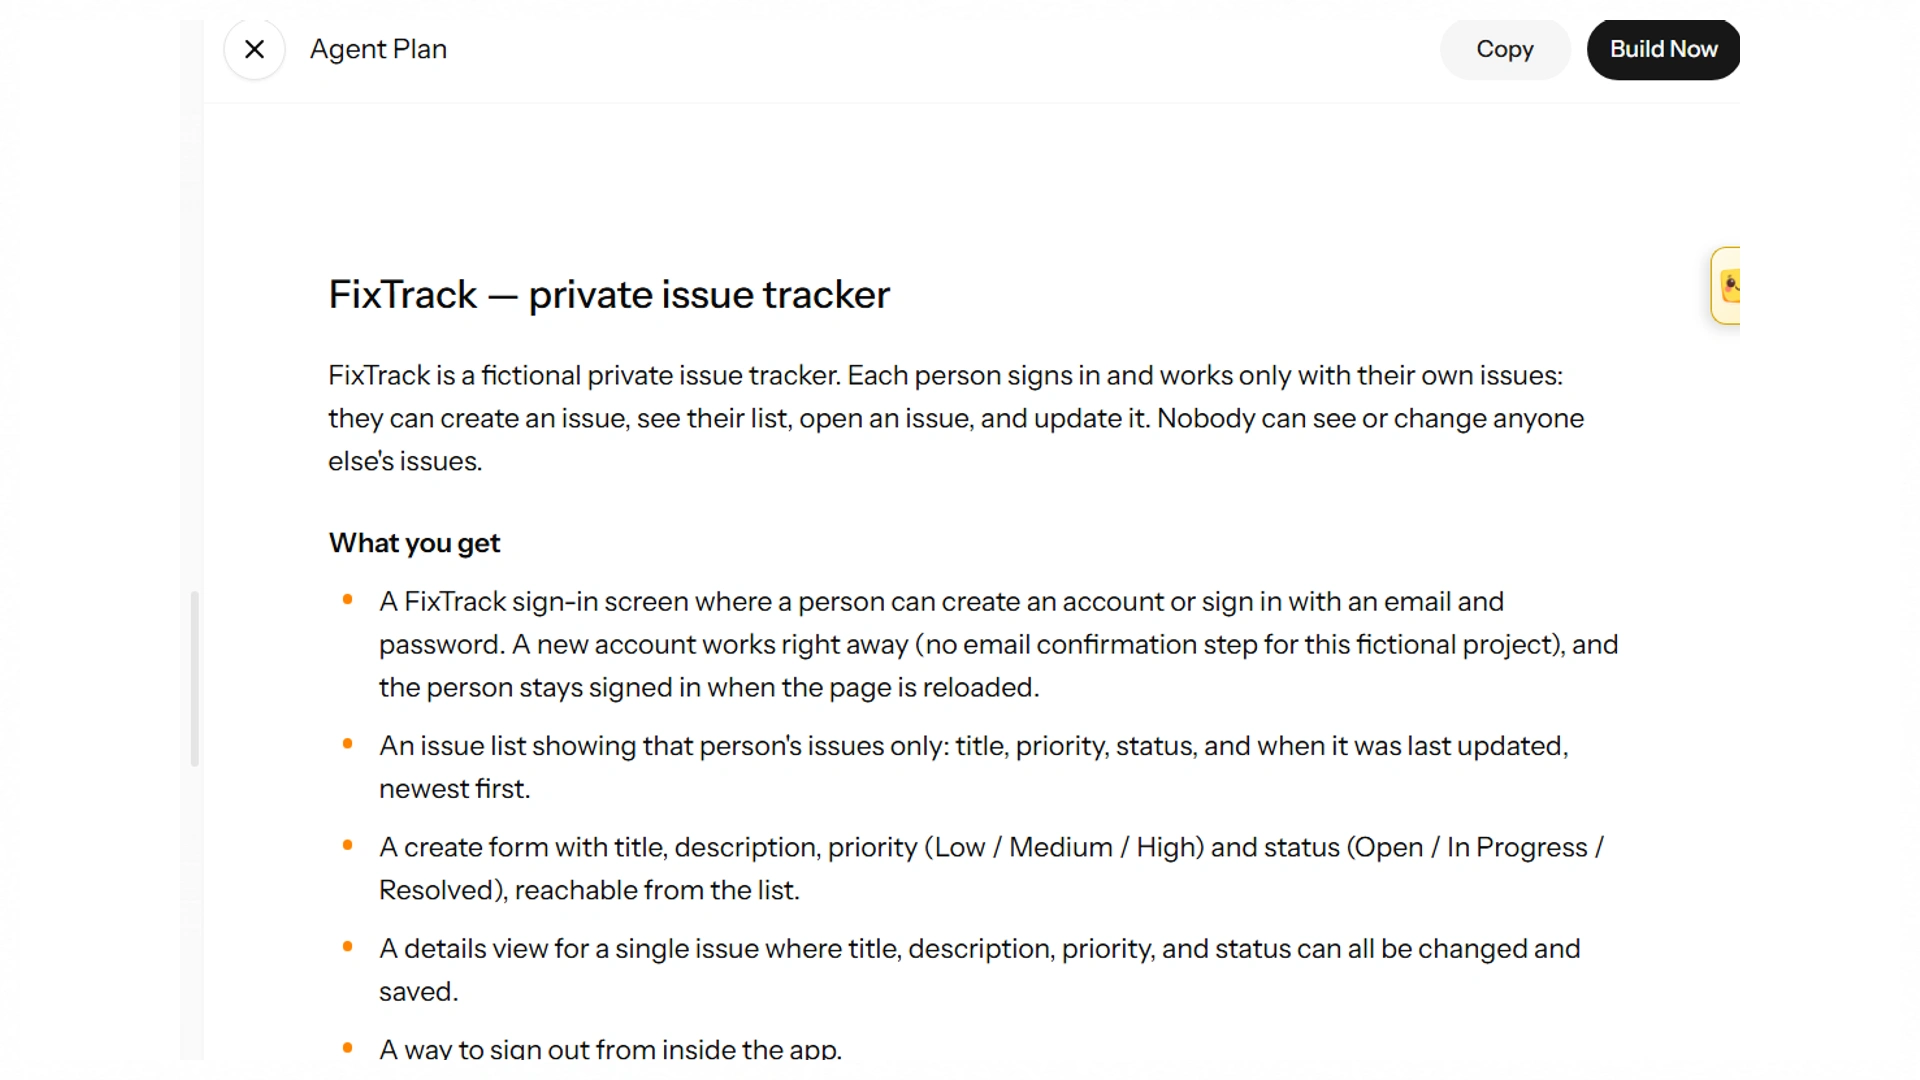
План определяет задачи, принадлежащие пользователю, и приёмочные проверки. Это спецификация для последующей проверки.
Шаг 2. Создайте интерфейс и обеспечьте владение записями
Зафиксированный предпросмотр содержит задачу «Checkout error on mobile», отмеченную как High priority, Open и «Fictional demo data». Счётчики показывают All 1, Open 1, In Progress 0 и Resolved 0. Это делает её удобной начальной фикстурой, потому что ожидаемые значения легко проверить. Описание указывает, что этот отчёт вымышленный и не касается реального клиента. Проверьте пустой список и ошибки формы создания как отдельные состояния; предоставленное изображение подтверждает видимую задачу, но не каждый маршрут из плана.
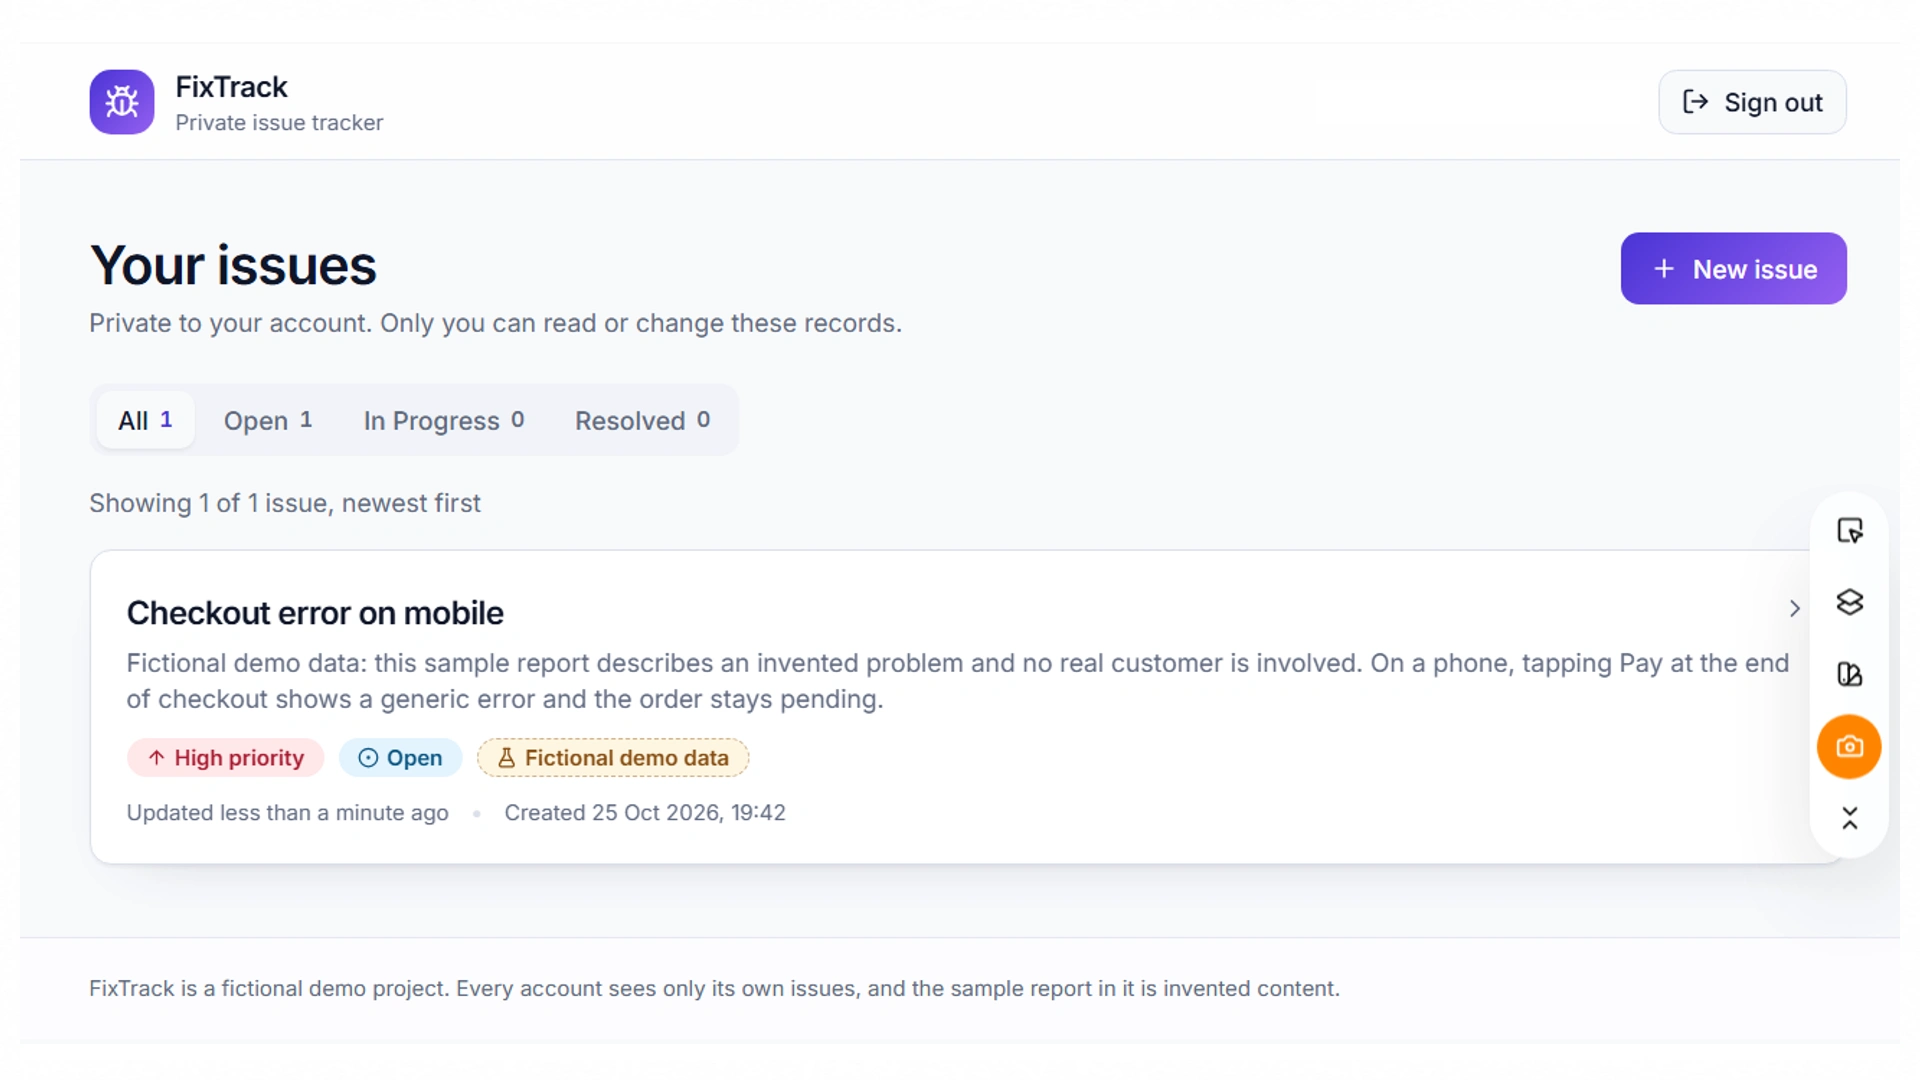
FixTrack в Enter Pro — список задач
«Checkout error on mobile» отмечена как High priority, Open и Fictional demo data. Счётчики: All 1, Open 1, In Progress 0, Resolved 0.
Таблице задач нужен идентификатор владельца, устанавливаемый сервером, и временные метки, с правилами бэкенда, ограничивающими чтение и обновления. Определяйте владельца из аутентифицированной сессии, а не доверяйте owner_id, отправленному браузером. Проверяйте приоритет и статус на соответствие допустимым значениям. Предпросмотр говорит, что записи приватны для вашего аккаунта, но это лишь обещание интерфейса. Доказательством, необходимым для его проверки, являются прямой неавторизованный запрос и сохранённые значения владения.
Шаг 3. Проверьте одно ограниченное улучшение
Видимый список уже включает фильтры All, Open, In Progress и Resolved. Используйте ограниченный запрос на улучшение, чтобы проверить их поведение, а не утверждать, что скриншоты показывают недавно добавленный фильтр. После создания второй собственной задачи с другим статусом каждый фильтр должен возвращать ожидаемое подмножество, а All должен восстанавливать обе записи. Сохраните путь создания/обновления и авторизацию владельца. Если счётчик неверен, сообщите о реальном вводе и наблюдаемом несоответствии, а не запрашивайте широкую переработку.
Копируемый промпт для улучшения — Проверь существующие фильтры All/Open/In Progress/Resolved на двух собственных демонстрационных задачах с разными статусами. Сохрани авторизацию, валидацию и поведение создания/обновления. Объясни изменённые файлы, если требуется исправление. Убедись, что фильтры не теряют записи и не раскрывают данные другого пользователя, и различай команды, которые ты выполнил, от проверок, которые ты не смог выполнить.
Шаг 4. Проверьте состояния сбоя и зафиксируйте передачу
Проверьте пустой заголовок, неподдерживаемый статус, повторную отправку и контролируемый сбой сохранения. Определите ожидаемое поведение повторных попыток, а затем проверьте его намеренно. Войдите как второй тестовый пользователь и запросите задачу первого пользователя напрямую; повторите в состоянии выхода из системы. Проверьте неавторизованное обновление так же, как и чтение. Ни один из предоставленных скриншотов не фиксирует эти результаты бэкенда, поэтому оставьте их как нерешённые приёмочные проверки, пока ответы и сохранённое состояние не будут проверены.
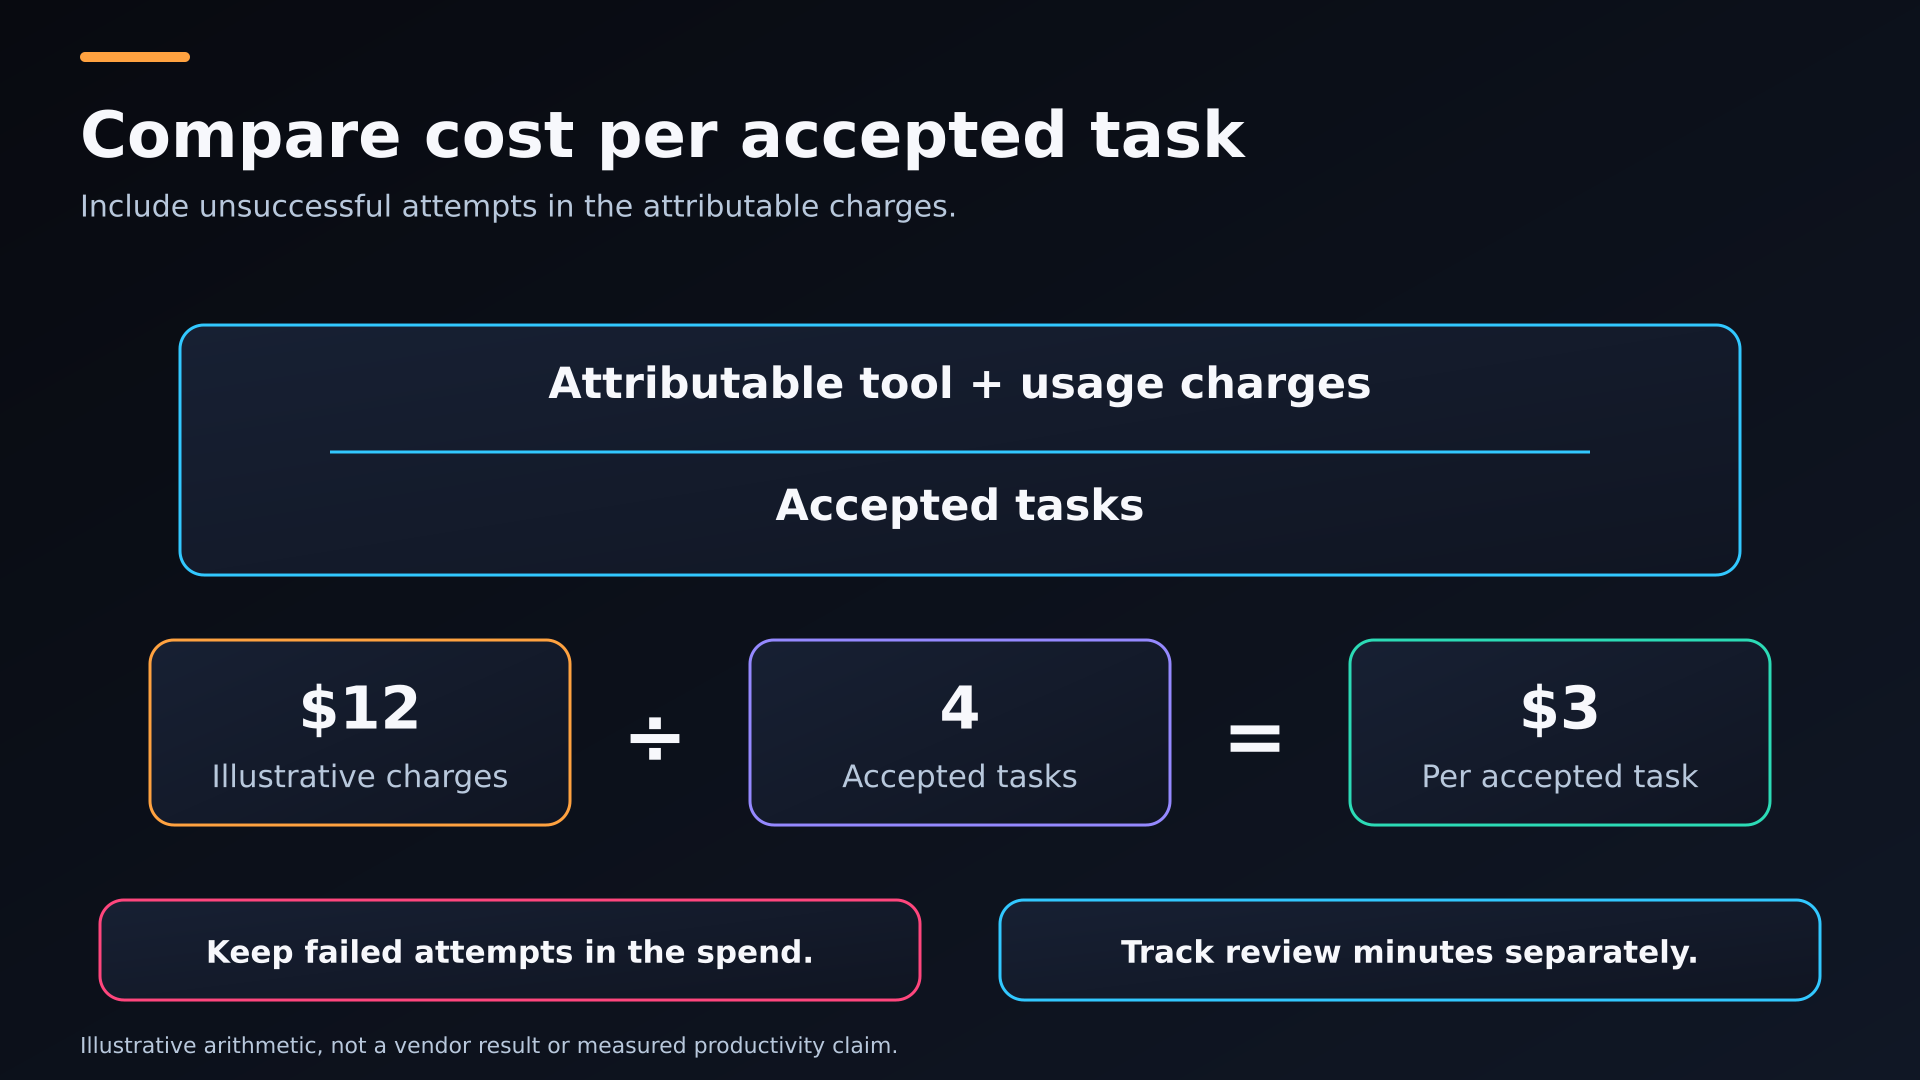
Сравните стоимость за принятую задачу: формула стоимости за принятую задачу и гипотетический пример статьи — 12 долларов, делённых на четыре.
Видимым результатом является сгенерированный план трекера задач и одна открытая демонстрационная задача с совпадающими счётчиками фильтров. Фиксируйте персистентность, изменение статуса и результаты между аккаунтами, когда вы их выполняете, вместе с затраченным временем, активным временем ревью и относимыми затратами. Сохраните исходный код, требования к настройке и оставшиеся дефекты для передачи разработчику. Этот небольшой проект может показать, подходит ли этот рабочий процесс для вашего прототипа; он не может доказать, что Enter Pro превосходит любого другого ИИ-агента для программирования или поддерживает любой существующий фреймворк.
Примите окончательное решение с помощью небольшого повторяемого пилота
Лучший ИИ для программирования — это практичное соответствие между вашей задачей, средой, бюджетом и способностью проверить результат. Отберите двух кандидатов, используйте одно и то же задание и сравнивайте принятые изменения, а не количество сгенерированных строк. Начните с небольшого пилота в Enter Pro, сохраните исходный код и проверки и расширяйте использование, когда это подтверждается доказательствами.
Часто задаваемые вопросы о лучшем ИИ для программирования
Может ли ИИ-ассистент для программирования работать без доступа ко всему моему репозиторию?
Часто да — вы можете ограничить контекст релевантным пакетом или файлами для узкой задачи, в зависимости от возможностей и настроек инструмента. Это может снизить количество нерелевантного материала и ненужное раскрытие данных. Изменение, затрагивающее общие типы или аутентификацию, может потребовать более широкого пути зависимостей. Спросите инструмент, что ему нужно, и проверьте указанные файлы, а не предоставляйте весь репозиторий по умолчанию.
Нужно ли мне платить за инструмент программирования и отдельную подписку на модель?
Только когда эта комбинация решает реальную потребность в доступе или рабочем процессе. Подписка на редактор, аккаунт API и потребительская подписка на чат могут охватывать разные продукты и пути оплаты. Проверьте, какой аккаунт на самом деле использует сессия программирования. Сравните суммарную стоимость с принятыми задачами и усилиями на ревью; не предполагайте, что двойная оплата означает двойное покрытие тех же вызовов или неограниченное использование.
Может ли локальная модель заменить хостинговый ИИ-ассистент для программирования?
Подходящая локальная модель может поддержать некоторые задачи программирования, но важны вычислительная мощность оборудования, обработка контекста, использование инструментов и производительность в языке. Локальная среда выполнения также требует интеграции с вашим редактором или агентом. Оценивайте её по тем же задачам и приёмочным проверкам, что и хостинговый вариант. Локальный вывод может изменить поток данных и затраты на провайдера, но не автоматически повышает корректность и не снижает общие усилия.
Гарантирует ли более высокий балл бенчмарка лучшие результаты на моём языке?
Нет. Бенчмарк измеряет заданный набор задач в определённой настройке. Проверьте язык, типы репозиториев, тестовую инфраструктуру, версию модели и инструменты агента. Вашему приложению может потребоваться другой фреймворк, интерактивное редактирование или недоступный внешний сервис. Высокий балл — это повод изучить кандидата, а не замена показательной задачи в вашей собственной среде.
Как часто мне следует переоценивать свою настройку ИИ для программирования?
Пересматривайте её, когда модель, цены, политика использования, репозиторий или набор задач меняются достаточно, чтобы повлиять на вашу работу. Сохраните одно короткое задание для оценки и его проверки, чтобы следующее сравнение было повторяемым. Лучшая ИИ-модель для программирования в вашей команде может меняться по мере того, как проект переходит от начального каркаса к поддержке; постоянное переключение без доказательств также расходует время.
Могу ли я использовать код, сгенерированный ИИ, в коммерческом проекте?
Коммерческое использование зависит от применимых условий использования продукта и лицензий зависимостей и исходных материалов в проекте. Проверяйте незнакомые пакеты, сохраняйте требуемые уведомления и документируйте нерешённые вопросы происхождения для передачи клиенту. Эти проверки отдельны от того, работает ли сгенерированный код. Патч, допустимый для коммерческого использования, всё равно может требовать проверки безопасности, совместимости и поддерживаемости.
Могу ли я продолжить проект Enter Pro в GitHub?
Enter Pro документирует интеграцию с GitHub для синхронизации исходного кода и совместной работы разработчиков. Подтвердите подключённый репозиторий и ветку, затем просмотрите исходный код и инструкции по настройке, прежде чем продолжать. Предоставленные изображения FixTrack не показывают, что эта передача завершена. Настройки хостинговой базы данных, секреты и миграции могут требовать дополнительного переноса или конфигурации сверх кодового репозитория.
Поддерживает ли Enter Pro любой существующий репозиторий и фреймворк?
Не предполагайте универсальную совместимость с любым репозиторием или фреймворком. Проверьте задокументированный путь проекта и изучите сгенерированный стек и требования к интеграции. FixTrack демонстрирует один рабочий процесс приложения, а не поддержку любого устаревшего сервиса. Для существующего проекта подтвердите совместимость и небольшой тестовый проход, прежде чем доверять основной репозиторий инструменту или планировать вокруг него миграцию.