
Какая LLM лучше всего подходит для кодинга в 2026 году? Тестируем и сравниваем топ-6 моделей
Выбираем лучшую LLM для программирования в 2026 году: сравниваем локальные модели и облачных ассистентов по точности, приватности и скорости работы.
Когда наша команда взялась искать лучшую LLM для кодинга, мы быстро поняли: одних результатов бенчмарков недостаточно. Каждый день мы сталкиваемся с реальными сложностями — от путаных legacy-кодовых баз до оценки традиционных backend-гигантов, которые плохо вписываются в современные workflow.
Мы выяснили, что выбор модели полностью зависит от конкретных задач. Фронтир-модели в облаке дают глубокое рассуждение, необходимое для сложных приложений, а self-hosted архитектура становится обязательной, когда речь идёт о защите корпоративного кода.
В этом гайде мы делимся личным опытом: разбираем критерии оценки, анализируем шесть лучших протестированных моделей, рассказываем про автономных dev-агентов и приводим мнение сообщества разработчиков. Вы узнаете, какой именно инструмент — от лучшей coding LLM до облачных гигантов — реально улучшит ваш рабочий процесс.
Ключевые критерии оценки LLM для разработчиков
Чтобы отделить надёжных ассистентов для кодинга от обычных разговорных ботов, мы оценивали каждую модель по 5 фундаментальным метрикам, отражающим реальную разработку ПО:
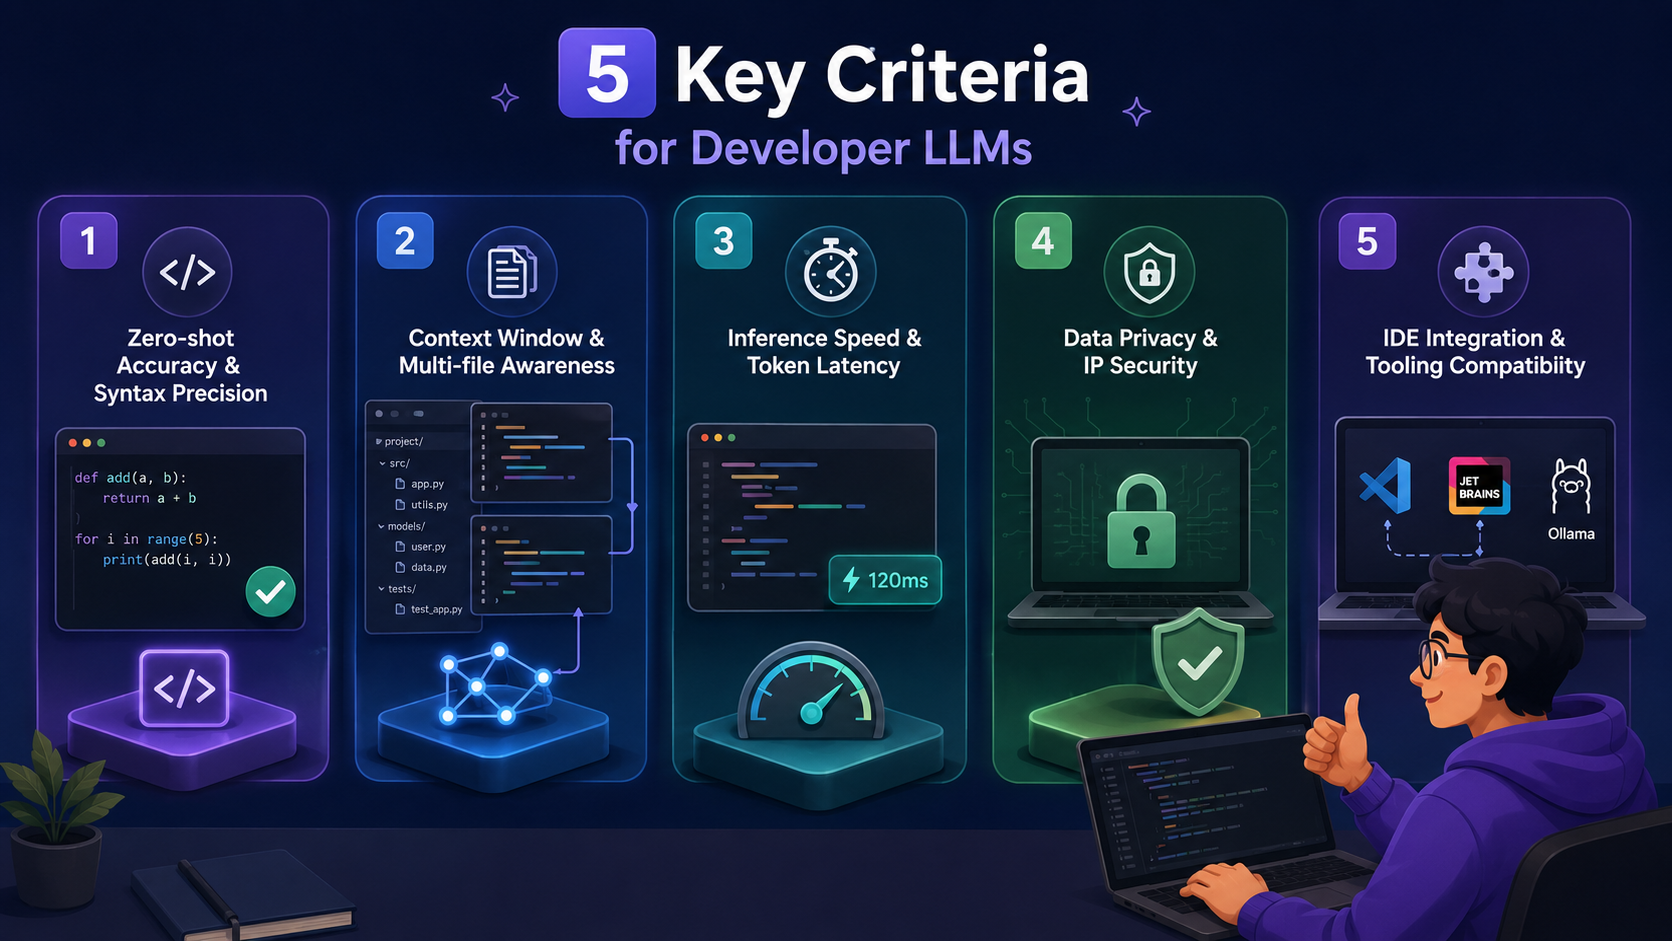
- Точность с первой попытки и синтаксическая аккуратность: показывает, насколько надёжно модель генерирует корректный, работающий код с первого раза — без выдуманных библиотек, устаревших API и скрытых логических ошибок.
- Контекстное окно и работа с несколькими файлами: современный софт редко укладывается в один файл. Мы оценивали «рабочую память» модели — насколько хорошо она отслеживает связанные переменные, зависимости и архитектурную логику во всём многофайловом проекте.
- Скорость инференса и задержка токенов: скорость напрямую влияет на поток работы разработчика. Мы проверяли, насколько быстро появляются инлайн-подсказки и автодополнение в реальном времени.
- Приватность данных и защита IP: защита проприетарного кода критична для любой команды. Мы изучили политики хранения данных облачных API и протестировали офлайн-возможности без доступа в сеть.
- Интеграция с IDE и совместимость с инструментами: мощная модель полезна только если она органично вписывается в повседневный workflow. Мы проверили, насколько легко каждая модель подключается к VS Code, JetBrains и локальным runtime вроде Ollama.
6 лучших LLM для кодинга по основным категориям
Чтобы найти лучшую LLM для кодинга в 2026 году, нужно учитывать именно ваши аппаратные ограничения, требования к приватности и сложность архитектуры:
| Модель | Категория | Главная сила | Лучше всего для |
|---|---|---|---|
| Claude Opus 5 | Фронтир, облако | Сложный агентный кодинг | Крупный рефакторинг и агентные циклы |
| GPT-5.6 Sol | Фронтир, облако | Детерминированное выполнение | Многошаговые задачи и прототипирование |
| GLM-5.2 | Локальная/открытые веса | Контекст 1M токенов | Self-hosted кодинг близкого к фронтиру уровня |
| DeepSeek V4-Pro | Локальная/открытый код | Конкурентное программирование | Высокообъёмные API-задачи и математика |
| Qwen3-Coder-Next | Лёгкая модель | Эффективность на параметр | Скромное локальное железо |
| Gemini 3.7 Flash | Лёгкая/бюджетная | Сложные агентные задачи | Высокообъёмная работа и рефакторинг |
Облачные фронтир-модели (максимум рассуждений и контекста)
Эти модели работают на мощных удалённых кластерах серверов, что позволяет обрабатывать огромные контекстные окна и сложное многошаговое рассуждение, недоступное локальному железу. Они идеальны для планирования сложной системной архитектуры.
- Claude Opus 5
При выборе инструментов для своего стека я убедился, что Claude Opus 5 — лучшая coding LLM для реальной инженерии, крупного рефакторинга и многошаговых агентных циклов. Anthropic выпускает Claude в нескольких уровнях: Haiku 4.5, Sonnet 5, Opus 5 и Fable 5. Сейчас модель лидирует в проверенных рейтингах по сложным задачам разработки.
| Версия | Объём памяти (контекст) | Лучше всего для | Простыми словами |
|---|---|---|---|
| Claude Fable 5 | Огромный (1M токенов) | Узкоспециализированные исследования и долгосрочные задачи | Ультра-премиальная модель для сложной научной работы и кибербезопасности. |
| Claude Opus 5 | Огромный (1M токенов) | Тяжёлый рефакторинг и агентные циклы | Топовый «мозг» для сложных многофайловых кодовых баз. |
| Claude Sonnet 5 | Огромный (1M токенов) | Сбалансированная повседневная разработка | Надёжная рабочая лошадка для ежедневных задач кодинга. |
| Claude Haiku 4.5 | Высокий (200K токенов) | Быстрые скрипты и оперативный дебаг | Бесплатная модель: лёгкий спринтер, созданный для скорости и нулевой стоимости. |
Плюсы:
- Лидирующая на рынке точность кода с первой попытки плюс проактивная проверка результатов.
- Огромное контекстное окно, легко вмещающее крупные многофайловые кодовые базы.
- Исключительно высокие результаты в основных бенчмарках агентного кодинга.
Минусы:
- Требует постоянного интернет-соединения и строгой зависимости от облака.
- Расходы на токены могут быстро расти для крупных команд разработки.
Лучше всего для: масштабного рефакторинга кода, full-stack системного дизайна и сложных агентных процессов.
- GPT-5.6 Sol
Это флагманская, универсальная модель с широчайшим охватом языкового синтаксиса и глубокой интеграцией в экосистему. OpenAI недавно продвинула границу цены/производительности с GPT-5.6. Модель служит надёжной рабочей лошадкой для разработчиков, эффективно решающих повседневные задачи.
| Версия | Скорость | Совместимость | Простыми словами |
|---|---|---|---|
| GPT-5.6 Sol | Быстро | Основные IDE и агентные фреймворки | Мощный ассистент, стабильно выполняющий многошаговые задачи. |
| GPT-5.6 Terra | Средне | Стандартные инструменты разработки | Сбалансированная API-версия для последовательного решения задач. |
| GPT-5.6 Luna | Молниеносно | Веб и легковесные инструменты | Бесплатная модель: быстрый бесплатный помощник для генерации кода. |
Плюсы:
- Стабильное детерминированное выполнение длинных многошаговых задач без потери фокуса.
- Глубокая совместимость с основными расширениями и платформами для разработчиков.
- Широчайшее покрытие обучения, включая редкие и устаревшие языки программирования.
Минусы:
- Иногда выдаёт избыточно многословный boilerplate вместо компактных сниппетов.
- Качество удержания контекста может снижаться в очень долгих сессиях чата.
Лучше всего для: детерминированных многошаговых задач, быстрого прототипирования и интеграции с API.
Лучшие локальные и open-source LLM (приватность и кастомизация для бизнеса)
Для организаций, где на первом месте защита интеллектуальной собственности, запуск локальных LLM офлайн гарантирует, что ни строчка проприетарного кода не уходит на сторонний сервер. Эти модели дают огромную мощь при соблюдении корпоративных требований.
- GLM-5.2
Лучшая доступная модель с открытыми весами для кодинга, с огромным потенциалом для fine-tuning. GLM-5.2 — флагманская модель для долгосрочных задач с солидным контекстом на 1 млн токенов.
| Версия | Нужное оборудование | Уровень мощности | Простыми словами |
|---|---|---|---|
| GLM-5.2 (Large) | Мощный корпоративный дата-центр | Интеллект топ-уровня | Лучший open-weight кодер с окном памяти на 1M токенов. |
| GLM-5.2 (Small) | Обычный ноутбук | Хорош для повседневных задач | 100% бесплатно и локально: работает прямо на ноутбуке офлайн без оплаты API. |
| GLM-5.2 Cloud | Браузер / API | Высокий уровень рассуждений | Бесплатный веб-доступ: инструмент в браузере без настройки. |
Плюсы:
- Очень конкурентная open-weight модель для долгосрочных инженерных задач.
- Огромное контекстное окно на 1 млн токенов для загрузки целых репозиториев локально.
- Лицензия с открытым доступом, подходящая для корпоративной и коммерческой разработки.
Минусы:
- Для полного использования окна на 1M токенов локально нужно высокопроизводительное корпоративное оборудование.
- Открытые веса бесплатны для загрузки, но их работа в масштабе требует дорогих серверных ресурсов.
Лучше всего для: self-hosted кодинга почти фронтир-уровня с абсолютной приватностью корпоративных данных.
- DeepSeek V4-Pro
Высокопроизводительная модель, созданная специально для сложных задач кодинга. DeepSeek разрабатывает и выпускает в открытый доступ фронтир-модели. Модель заметно превосходит свой «весовой класс» в математической логике и сложных алгоритмических задачах, предлагая мощную архитектуру на 1,6 трлн параметров для генерации текста.
| Версия | Главная сила | Лучше всего для | Простыми словами |
|---|---|---|---|
| DeepSeek V4-Pro | Конкурентное программирование и математика | Корпоративные репозитории | Специализированный «мозг» для кодинга, отлично справляющийся с алгоритмами и сложной логикой. |
| DeepSeek V4 | Общие рассуждения и синтаксис | Повседневные скрипты и исследования | Бесплатная веб-версия: универсальный чат-бот для повседневного письма и базового кода. |
| DeepSeek-Coder 7B | Легковесное выполнение | Офлайн-разработка локально | 100% бесплатно и локально: приватная модель без затрат для запуска на своём ПК. |
Плюсы:
- Заметно превосходит аналоги в алгоритмических и конкурентных задачах программирования.
- Абсолютная приватность данных при self-hosted развёртывании для строгого соответствия требованиям резидентности данных.
- Обширные возможности математического рассуждения и высокообъёмных API-задач.
Минусы:
- Полнопараметрические конфигурации требуют корпоративного уровня GPU-памяти (VRAM).
- Настройка и fine-tuning квантизации требуют продвинутых технических навыков.
Лучше всего для: корпоративных репозиториев с высокими требованиями к приватности, высокообъёмных API-задач и решения алгоритмических задач.
Специализированные и лёгкие модели для кодинга (быстрое автодополнение и низкая задержка)
Эти модели сильно квантизированы и специально оптимизированы для работы в фоне на обычных ноутбуках или экономичной работы в облаке. Они выступают строго как быстрые ассистенты, максимизирующие эффективность.
- Qwen3-Coder-Next
Очень эффективная специализированная модель для кодинга, оптимизированная для мультиязычного автодополнения на стандартном пользовательском оборудовании. Новейшие модели Qwen3 используют гибридный режим «мышления», позволяющий гибко управлять качеством рассуждений, скоростью и затратами.
| Версия | Скорость ответа | Охват языков | Простыми словами |
|---|---|---|---|
| Qwen3-Coder-Next | Быстро | 90+ языков программирования | Флагманский open-weight движок для серьёзных локальных разработческих машин. |
| Qwen3-Coder (7B) | Мгновенно | 90+ языков программирования | 100% бесплатно и локально: как предиктивный текст для кода, плавно работает на обычных ноутбуках. |
| Qwen-Chat | Мгновенно | Стандартный кодинг и естественный язык | Бесплатная веб-версия: быстрый бесплатный помощник для проверки синтаксиса. |
Плюсы:
- Отличная эффективность кодинга на параметр для легковесных локальных установок.
- Плавно работает на стандартном потребительском оборудовании с минимальной нагрузкой на ресурсы.
- Сильная мультиязычная поддержка синтаксиса — более 90 языков программирования.
Минусы:
- Ограниченная глубина рассуждений при планировании архитектуры целого приложения.
- Меньшее окно удержания контекста по сравнению с крупными облачными моделями.
Лучше всего для: построчного автодополнения и разработчиков, запускающих модели на стандартных ноутбуках.
- Gemini 3.7 Flash
Беглый ассистент для кодинга, специально созданный для бюджетной работы в облаке и сложных агентных сценариев. Gemini 3.7 Flash лучше всего подходит для масштабных сложных агентных задач.
| Версия | Как помогает | Где работает | Простыми словами |
|---|---|---|---|
| Gemini 3.7 Flash | Сложные агентные задачи в масштабе | Облачный API | Высокоскоростной облачный ассистент для крупных кодовых баз и сложных workflow. |
| Gemini 3.5 Flash-Lite | Высокообъёмные задачи | Облачный API | Щедрый бесплатный тариф API: легковесная модель, созданная для эффективности и интеллекта. |
| Gemini Web | Общее общение и сниппеты кода | Браузер | Бесплатная веб-версия: простой бесплатный ассистент для написания функций и ответов на вопросы. |
Плюсы:
- Невероятно эффективна для высокообъёмных агентных workflow.
- Обрабатывает огромные контекстные окна, легко читая большие кодовые базы.
- Высокая скорость выдачи токенов для быстрого дебага и мгновенных правок.
Минусы:
- Работает строго как облачный API — нельзя изолировать от сети или развернуть локально для максимальной приватности.
- Может требовать тонкой настройки промптов для соответствия строгому форматированию, как у Claude или GPT.
Лучше всего для: экономичного облачного кодинга, высокообъёмной агентной работы и задач с длинным контекстом.
Как мы тестировали эти LLM
Мы тестировали каждую модель по строго воспроизводимой технической методике, чтобы исключить субъективную предвзятость. Наш набор тестов сочетает признанные бенчмарки разработчиков с реальными инженерными задачами.
Контролируемое базовое промптирование
Чтобы проверить чистое рассуждение в 2026 году, мы отправили 5 идентичных промптов на архитектурный рефакторинг прямо в нативные веб-интерфейсы лидеров индустрии, таких как ChatGPT и Claude.
Шаг 1: Подготовить 5 идентичных промптов на архитектурный рефакторинг
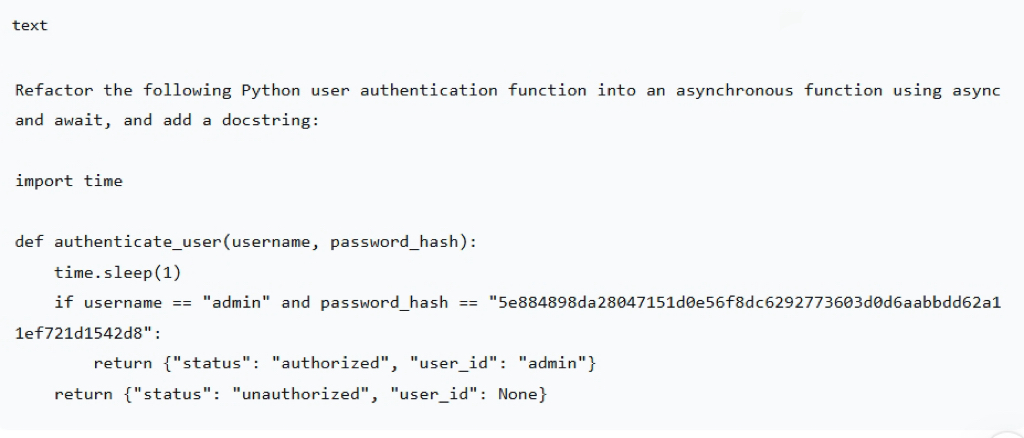
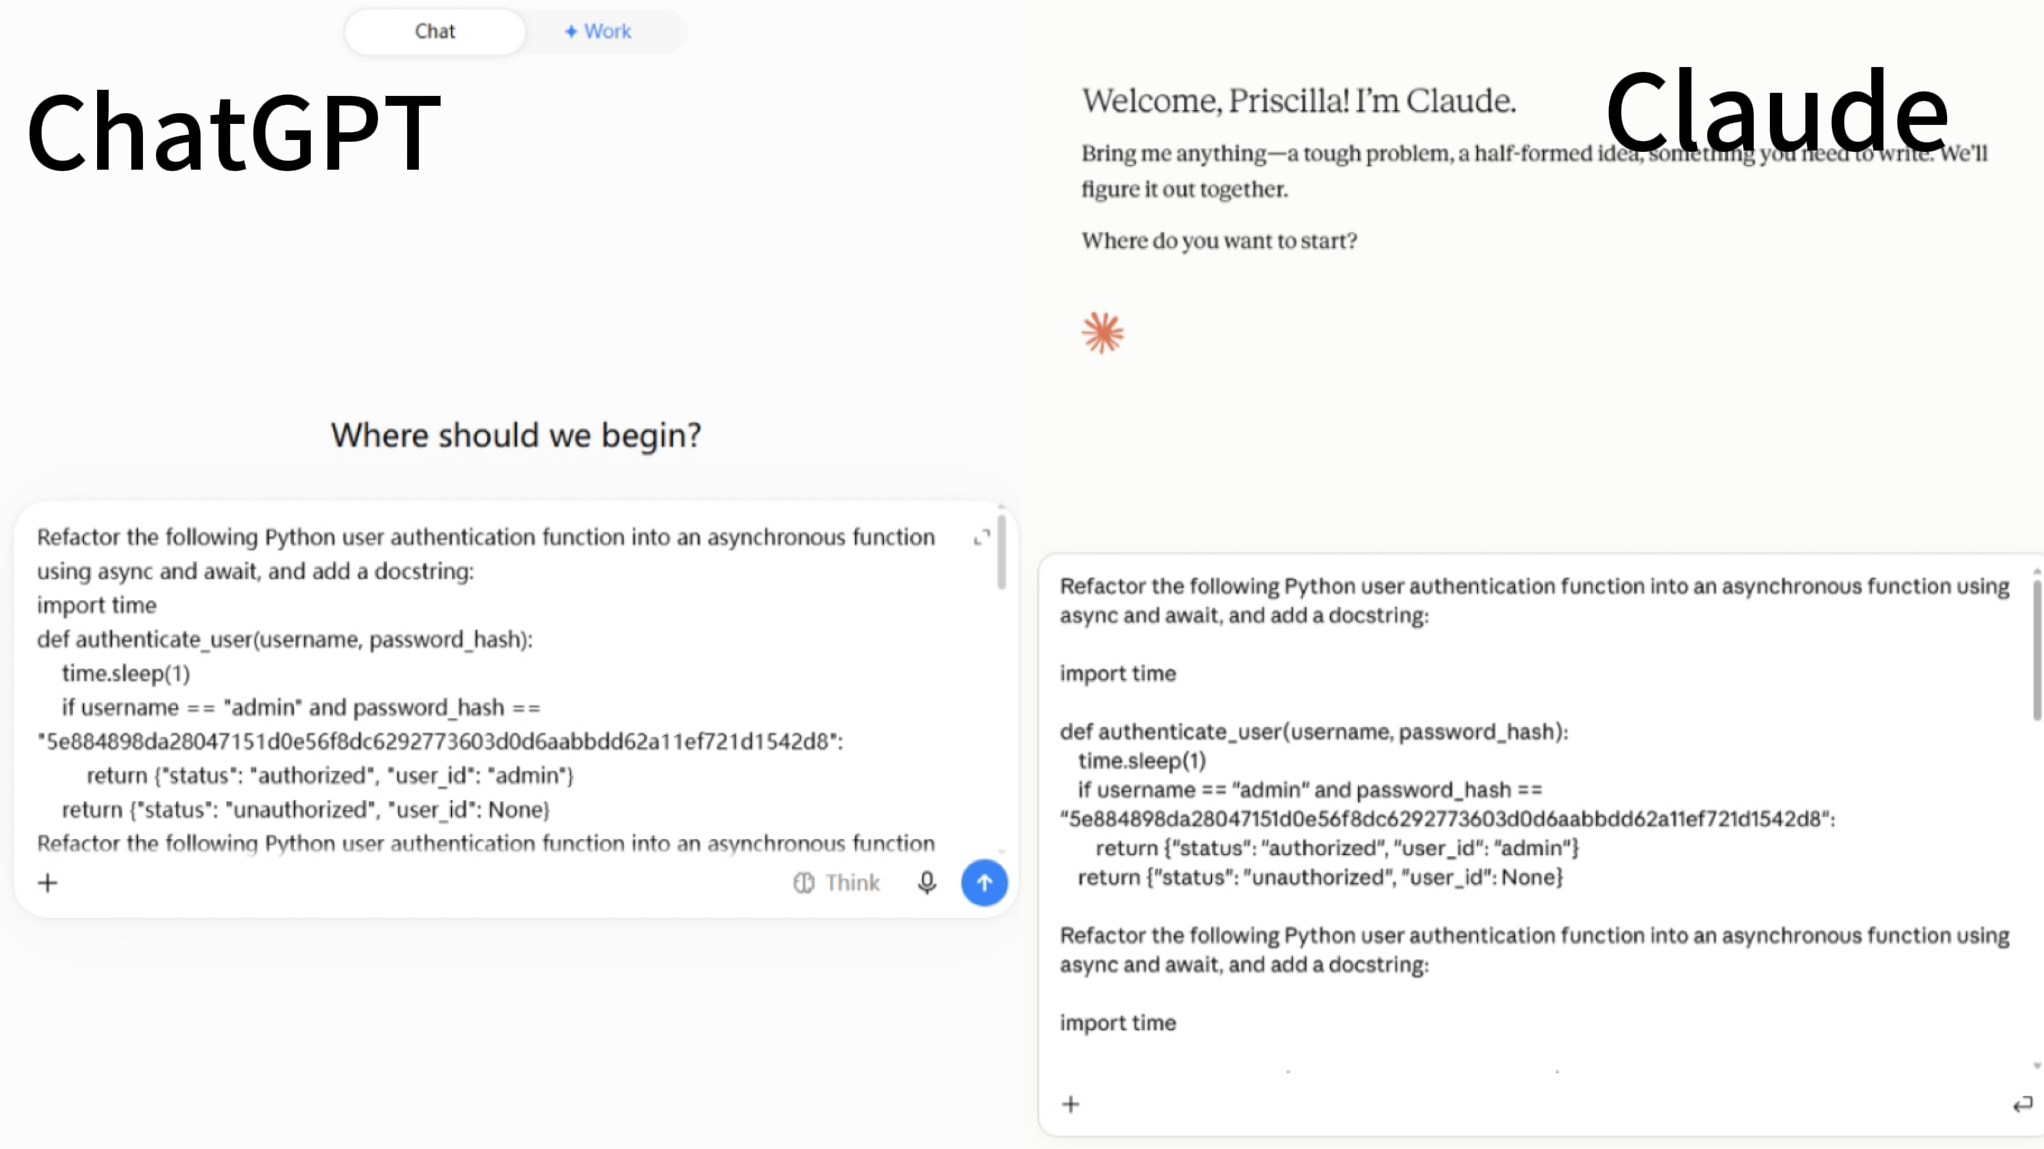
Сначала я написал один унифицированный промпт на архитектурный рефакторинг и скопировал его 5 раз, убедившись, что содержание полностью совпадает. Пример промпта показан ниже:
Шаг 2: Отправить промпты в нативных интерфейсах ChatGPT/Claude
Я открыл веб-интерфейсы ChatGPT и Claude, вставлял и отправлял промпты по одному, полностью фиксируя каждый ответ.
Шаг 3: Оценить способность обрабатывать логику нескольких файлов
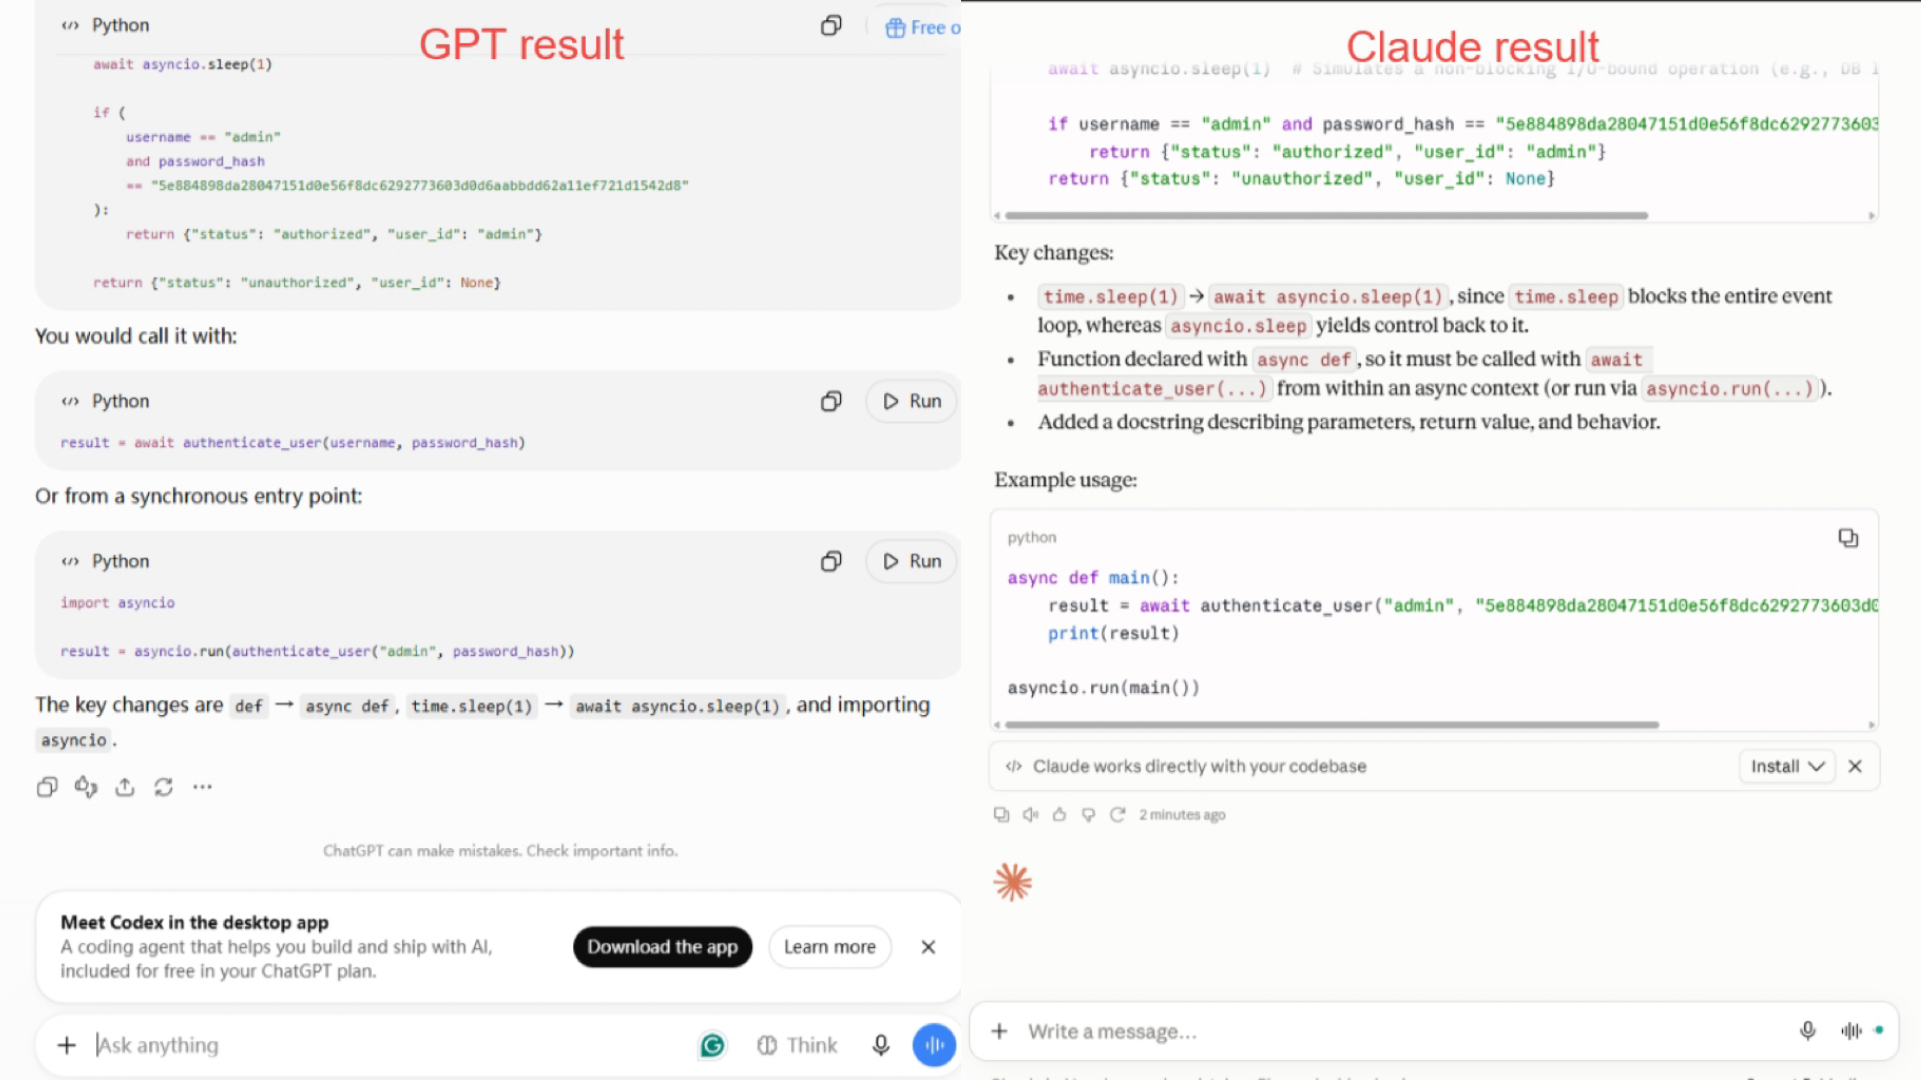
После получения результатов от каждого инструмента мы оценили их реальные способности к рассуждению. Например, ChatGPT и Claude оба корректно выполнили один и тот же рефакторинг, но стиль и акценты вывода отличались: ChatGPT склонен давать результат плюс краткое пояснение использования, а Claude — объяснять базовые принципы и подчёркивать ограничения. Это отражает разные стили рассуждения и подачи при одинаковом вводе.
Профилирование нагрузки на локальное оборудование
Локальные модели дают полную приватность данных, но только если эффективно работают на реальном оборудовании. Мы профилировали легковесные open-weight модели, такие как Qwen3-Coder (7B) и DeepSeek-Coder, прямо на локальной рабочей станции.
- Отслеживали всплески VRAM и нагрузку на CPU в пиках генерации токенов, чтобы определить реальные ограничения ресурсов.
- Проверили, могут ли разработчики развернуть безопасный офлайн-workflow без дорогого корпоративного оборудования.
Интеграция с IDE и трение в UX
Теоретические метрики задержки ничего не значат, если подсказки кода «тормозят» при живом редактировании. Мы тестировали легковесные модели, такие как Qwen3-Coder и Gemini 3.7 Flash, внутри стандартного редактора кода, оценивая live-автодополнение и задержку ввода.
- Оценили реальную задержку, чтобы убедиться, что предиктивный «ghost text» бесшовно подстраивается под естественный темп набора текста разработчиком.
- Проверили понимание контекста, чтобы убедиться, что модели корректно читают и применяют переменные из соседних открытых файлов проекта.
Изолированное выполнение и проверка синтаксиса
Код, который выглядит правильным в чате, часто ломается во время выполнения. Мы компилировали и выполняли сниппеты, сгенерированные DeepSeek V4-Pro и GPT-5.6 Sol, прямо в изолированных Docker-контейнерах.
- Объективные запуски в sandbox сразу выявляли устаревшие методы, пропущенные импорты и синтаксические «галлюцинации».
- Отслеживали реальную долю Pass@1, чтобы подтвердить, что логика проходит тестовые наборы с первой попытки.
Хотя отдельные облачные и локальные LLM отлично справляются с генерацией сниппетов и доработкой конкретных функций, создание полноценных приложений всё равно требует ручной настройки IDE, boilerplate-кода и интеграции фронтенда с бэкендом. Для разработчиков и создателей, которые хотят полностью обойти повторяющиеся циклы кодирования, автономные dev-агенты предлагают более быстрый путь от идеи до деплоя.
Enter Pro: автономный AI dev-агент для быстрой разработки софта
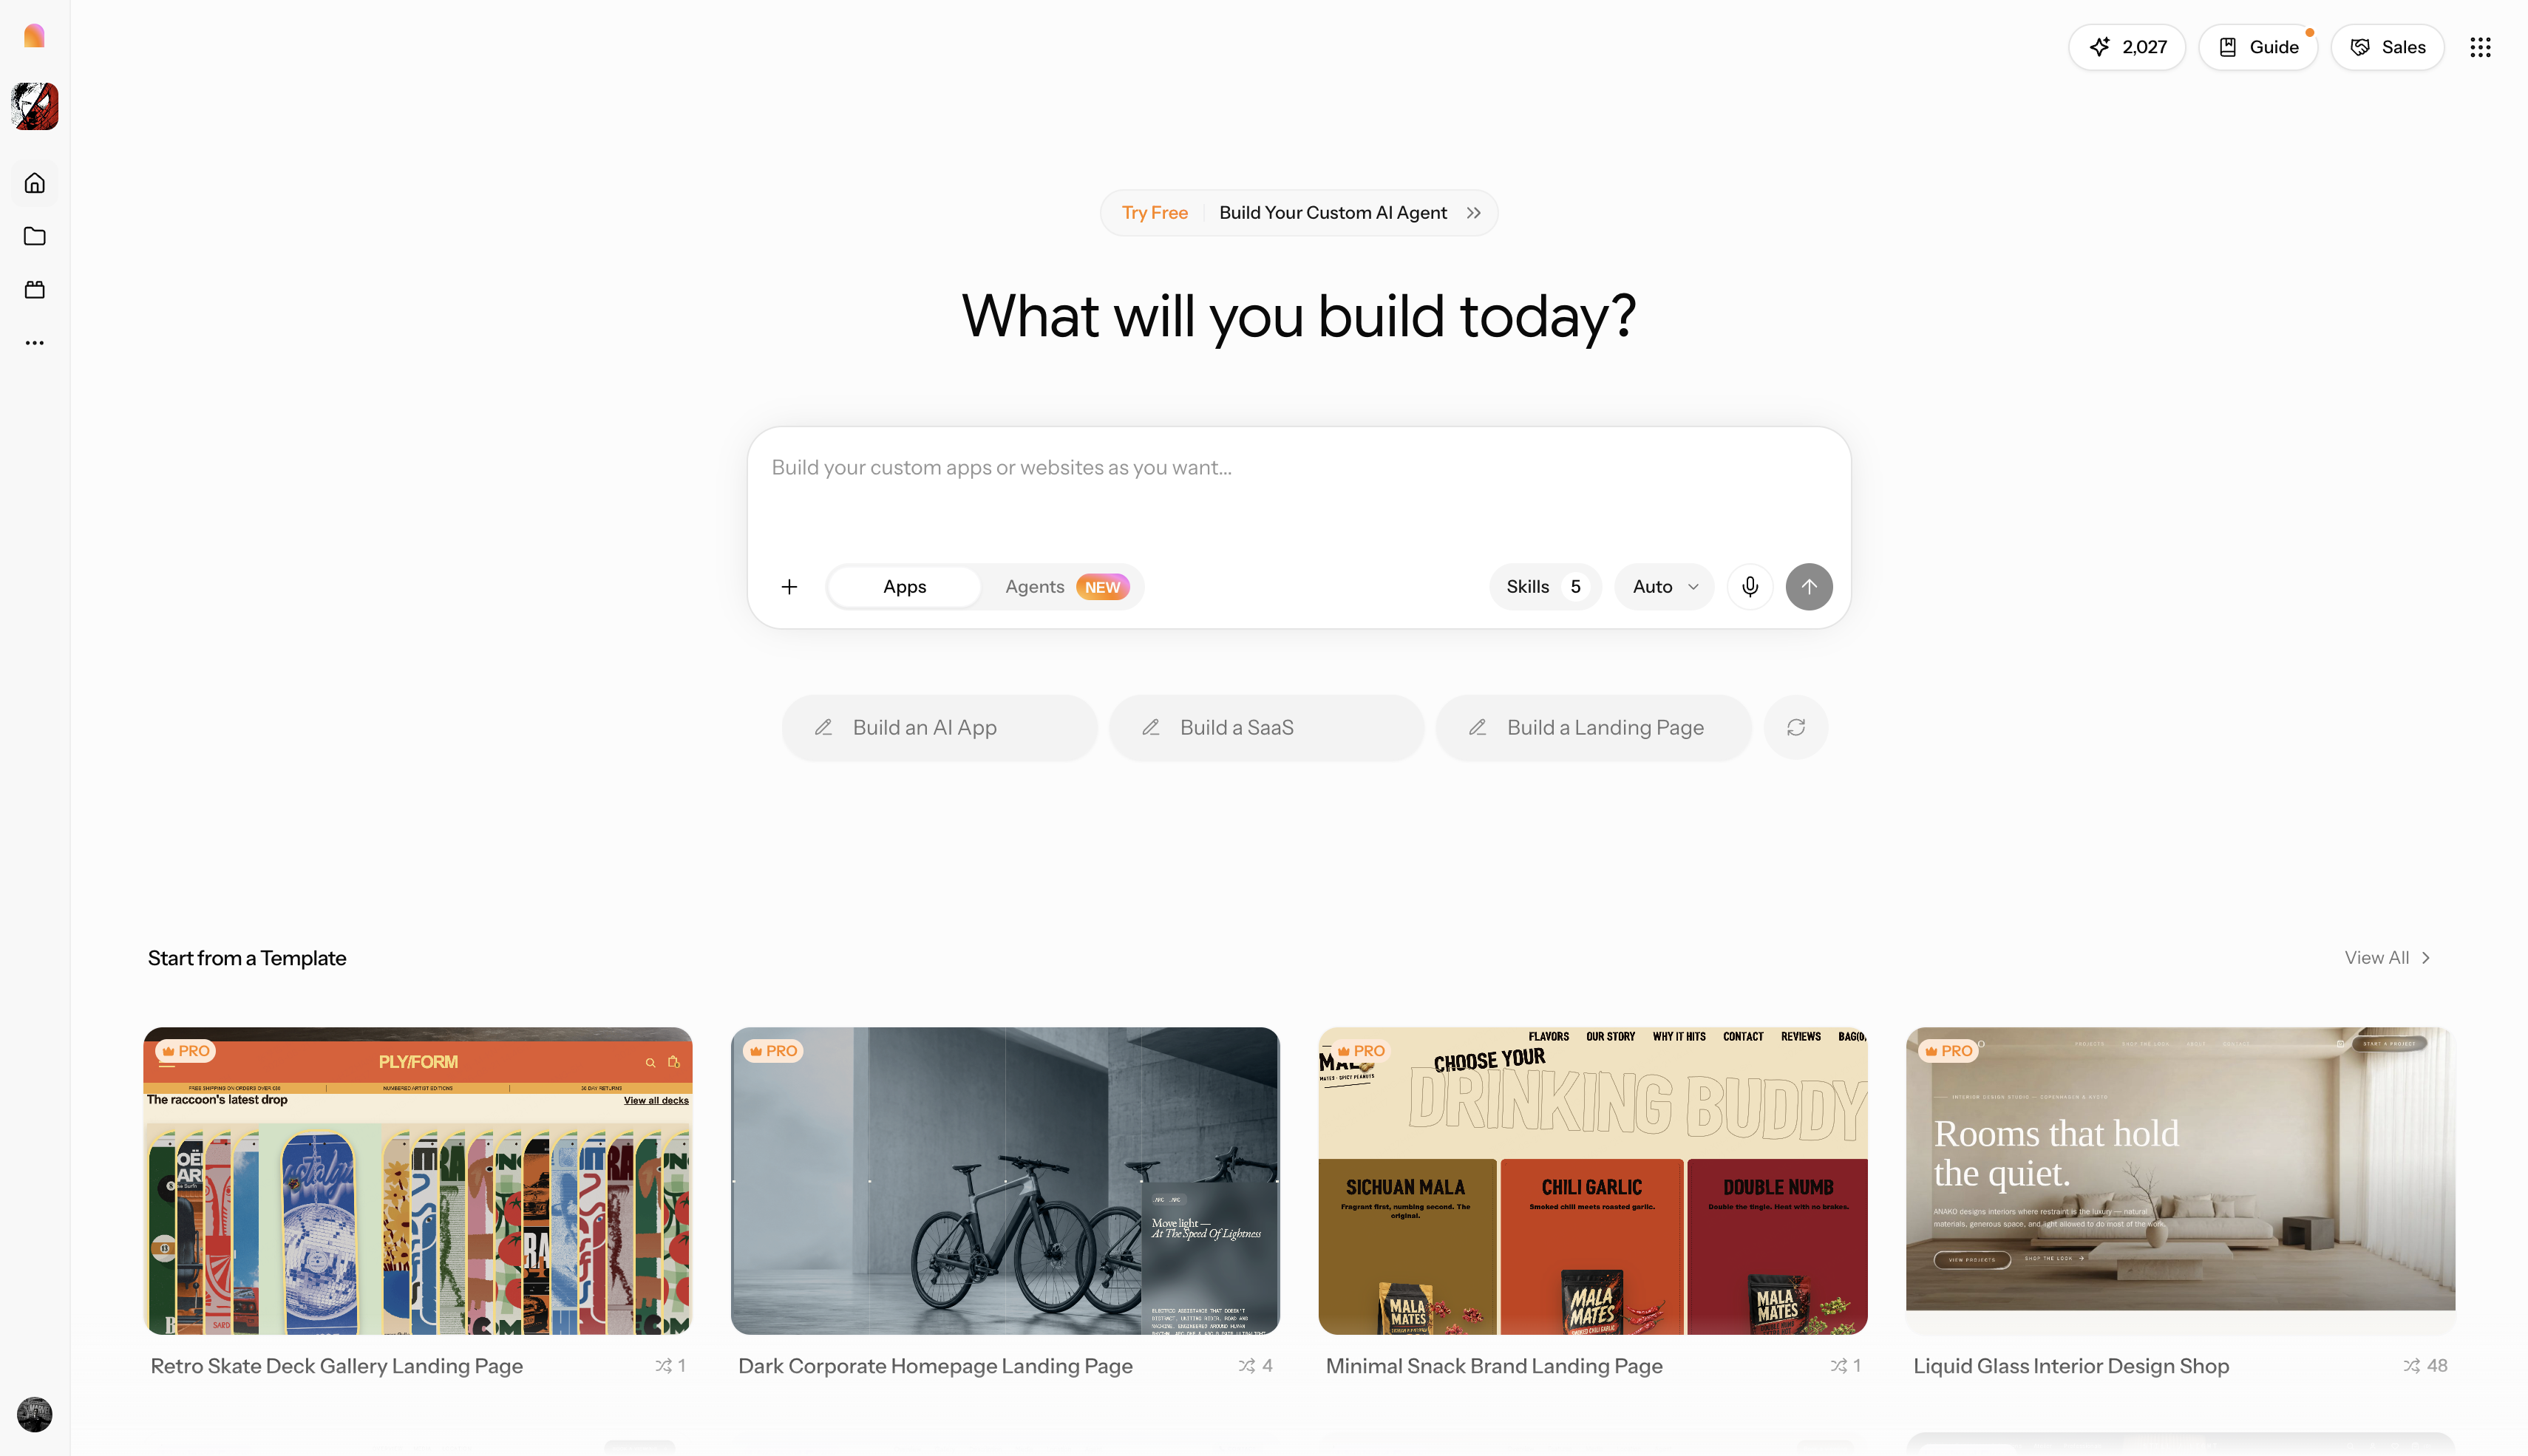
Хотите выйти за рамки написания отдельных функций и автономно генерировать целые приложения? Enter Pro закрывает огромный разрыв между чистыми чат-интерфейсами LLM и полноценной генерацией full-stack проектов. Больше не нужно вручную настраивать локальные среды, обновлять системные зависимости или бороться с запутанными пакетными менеджерами. Вместо этого платформа использует интуитивный режим планирования для vibe coding, превращая высокоуровневые промпты на естественном языке прямо в готовое к продакшену программное обеспечение.
Ключевые возможности
- Создание по промпту
Пользователь просто описывает цветовую тему сайта, желаемую раскладку и нужные функциональные страницы на естественном языке. Встроенный движок Enter Pro мгновенно строит основу full-stack кодовой базы, включая фронтенд и логику базы данных, резко сокращая время ручной настройки.
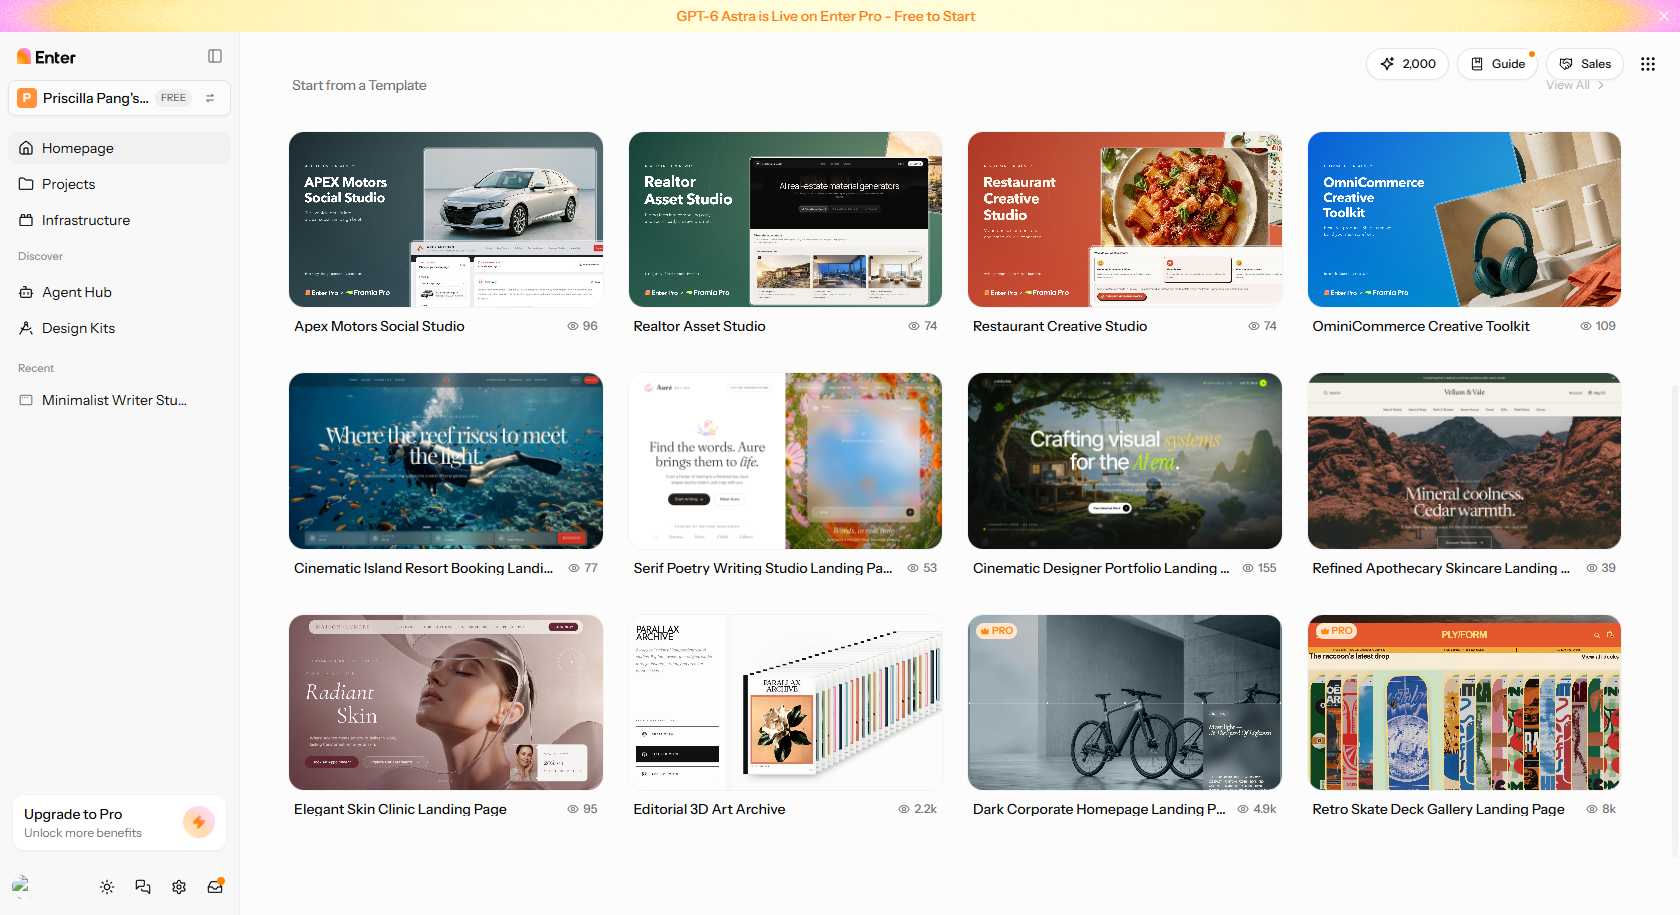
- Готовые шаблоны
Платформа предлагает профессионально оформленные, полностью адаптивные шаблоны сайтов для максимальной скорости запуска. Enter Pro специально оптимизирует эти макеты под строгие современные стандарты UX, обеспечивая качественную доставку приложения без ручной визуальной доводки.
- Единая интеграция моделей
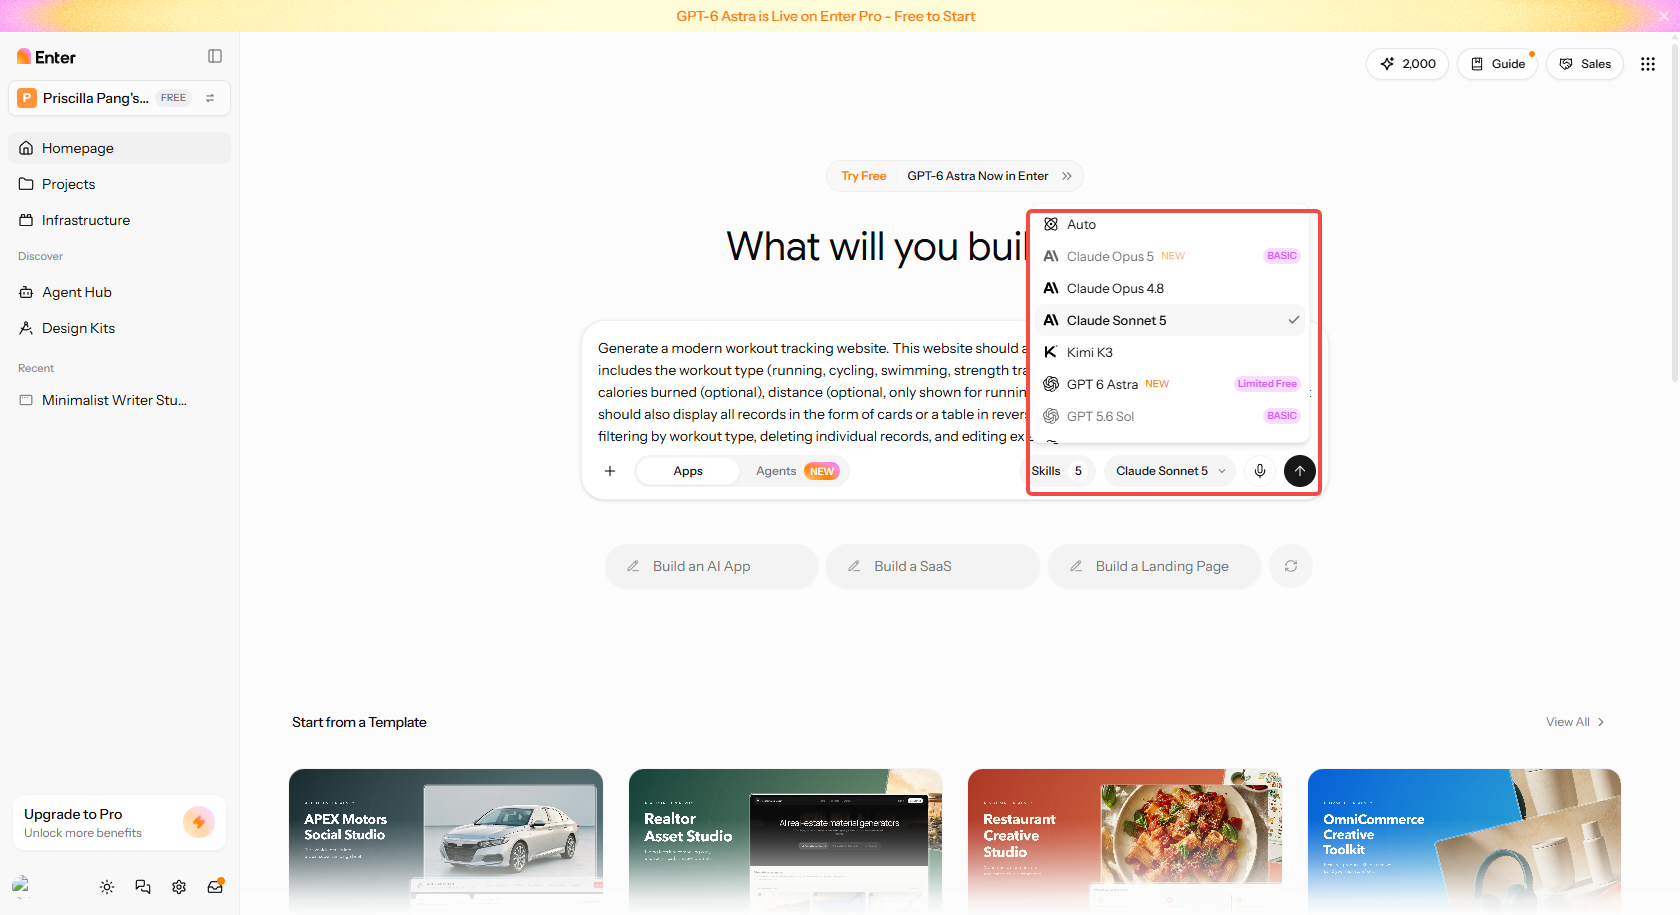
Разработчики могут нативно встраивать топовых coding-ассистентов и продвинутые модели прямо в свои активные проекты Enter Pro по единой подписке, включая Kimi K3, GPT 6 Astra и Claude Sonnet 5. Такой подход полностью устраняет административную головную боль управления и защиты отдельных API-ключей для разных фронтир-моделей.
- 100% право собственности на код
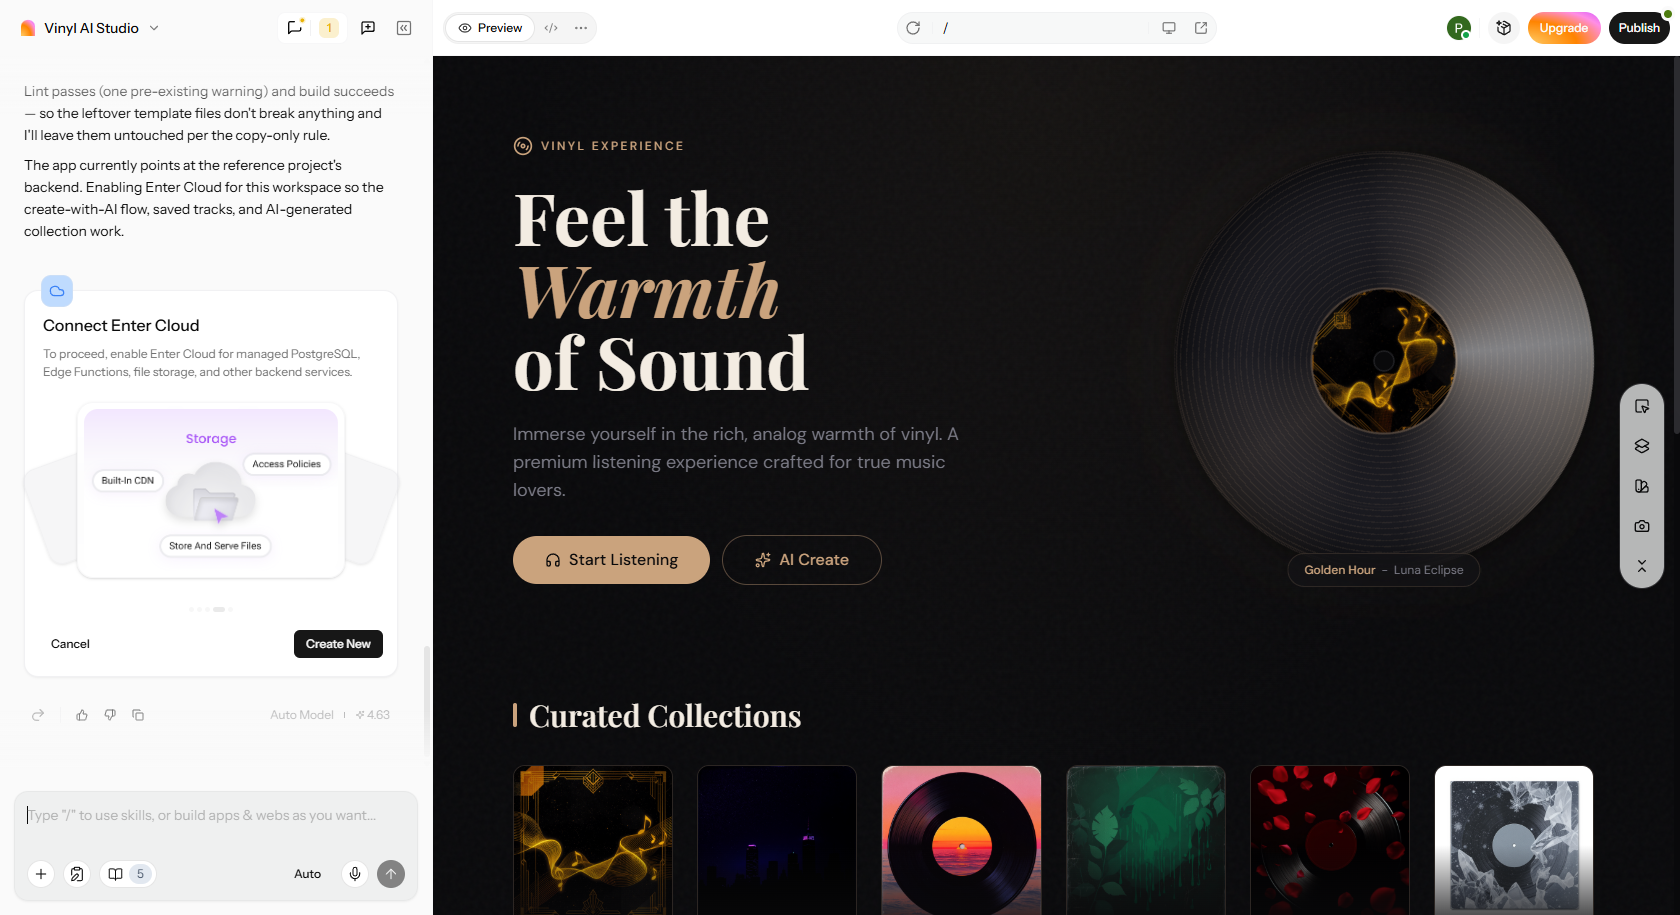
Вы сохраняете полный контроль и коммерческие права на сгенерированный исходный код при экспорте из платформы Enter Pro. Это гарантирует настоящую независимость без привязки к вендору и будущих лицензионных сложностей.
Пошаговое руководство по созданию приложений
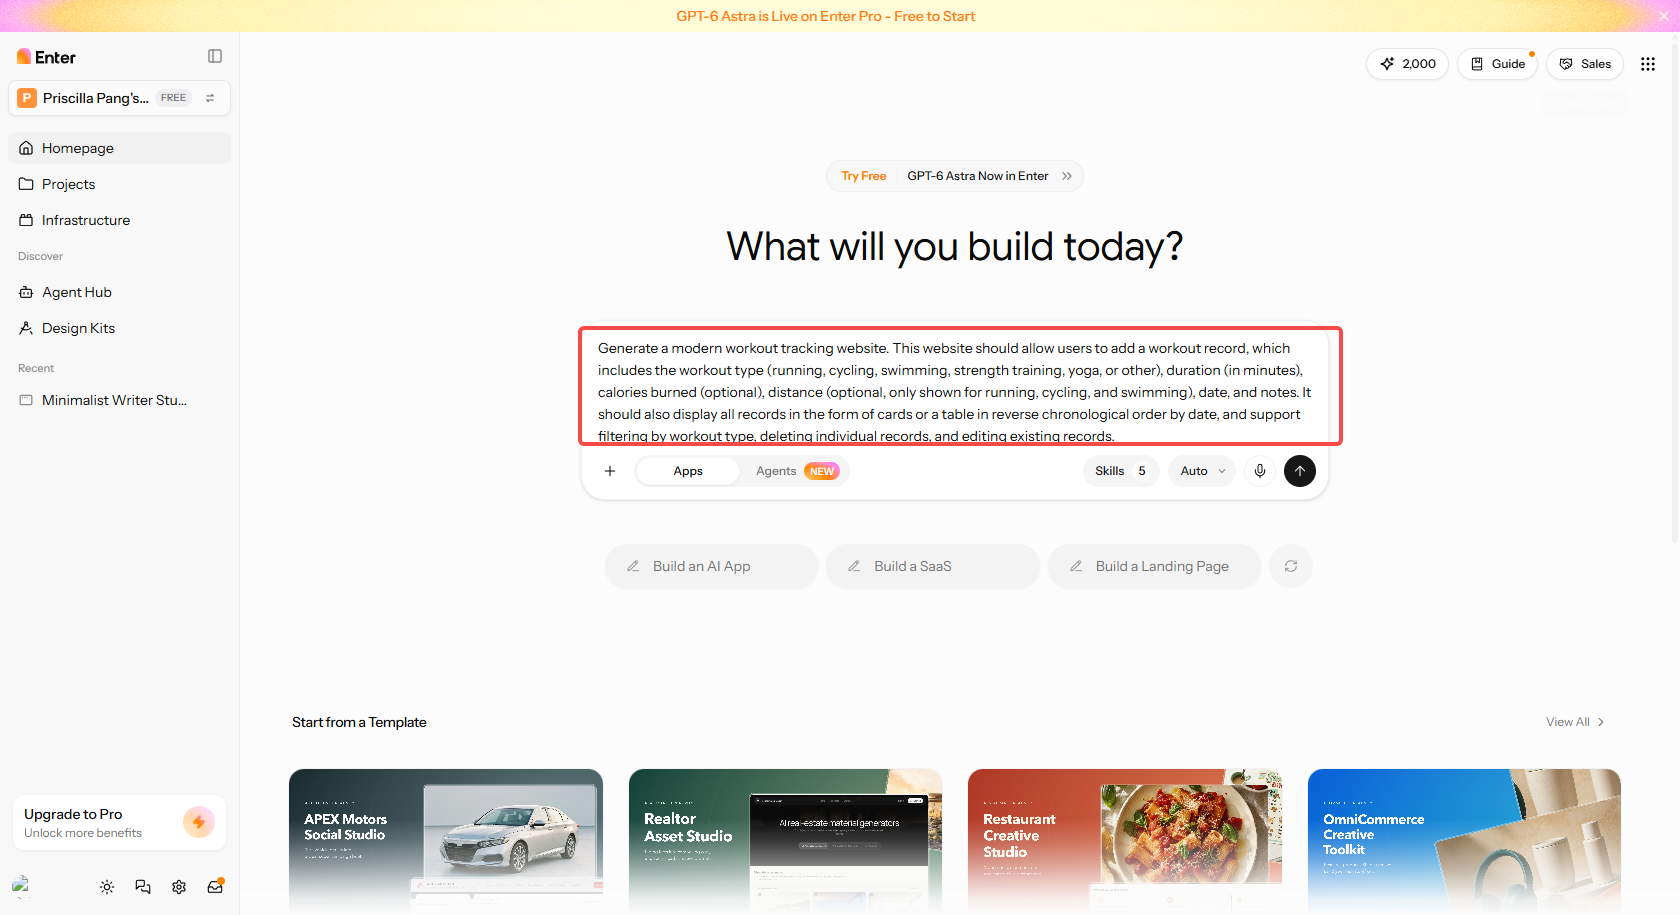
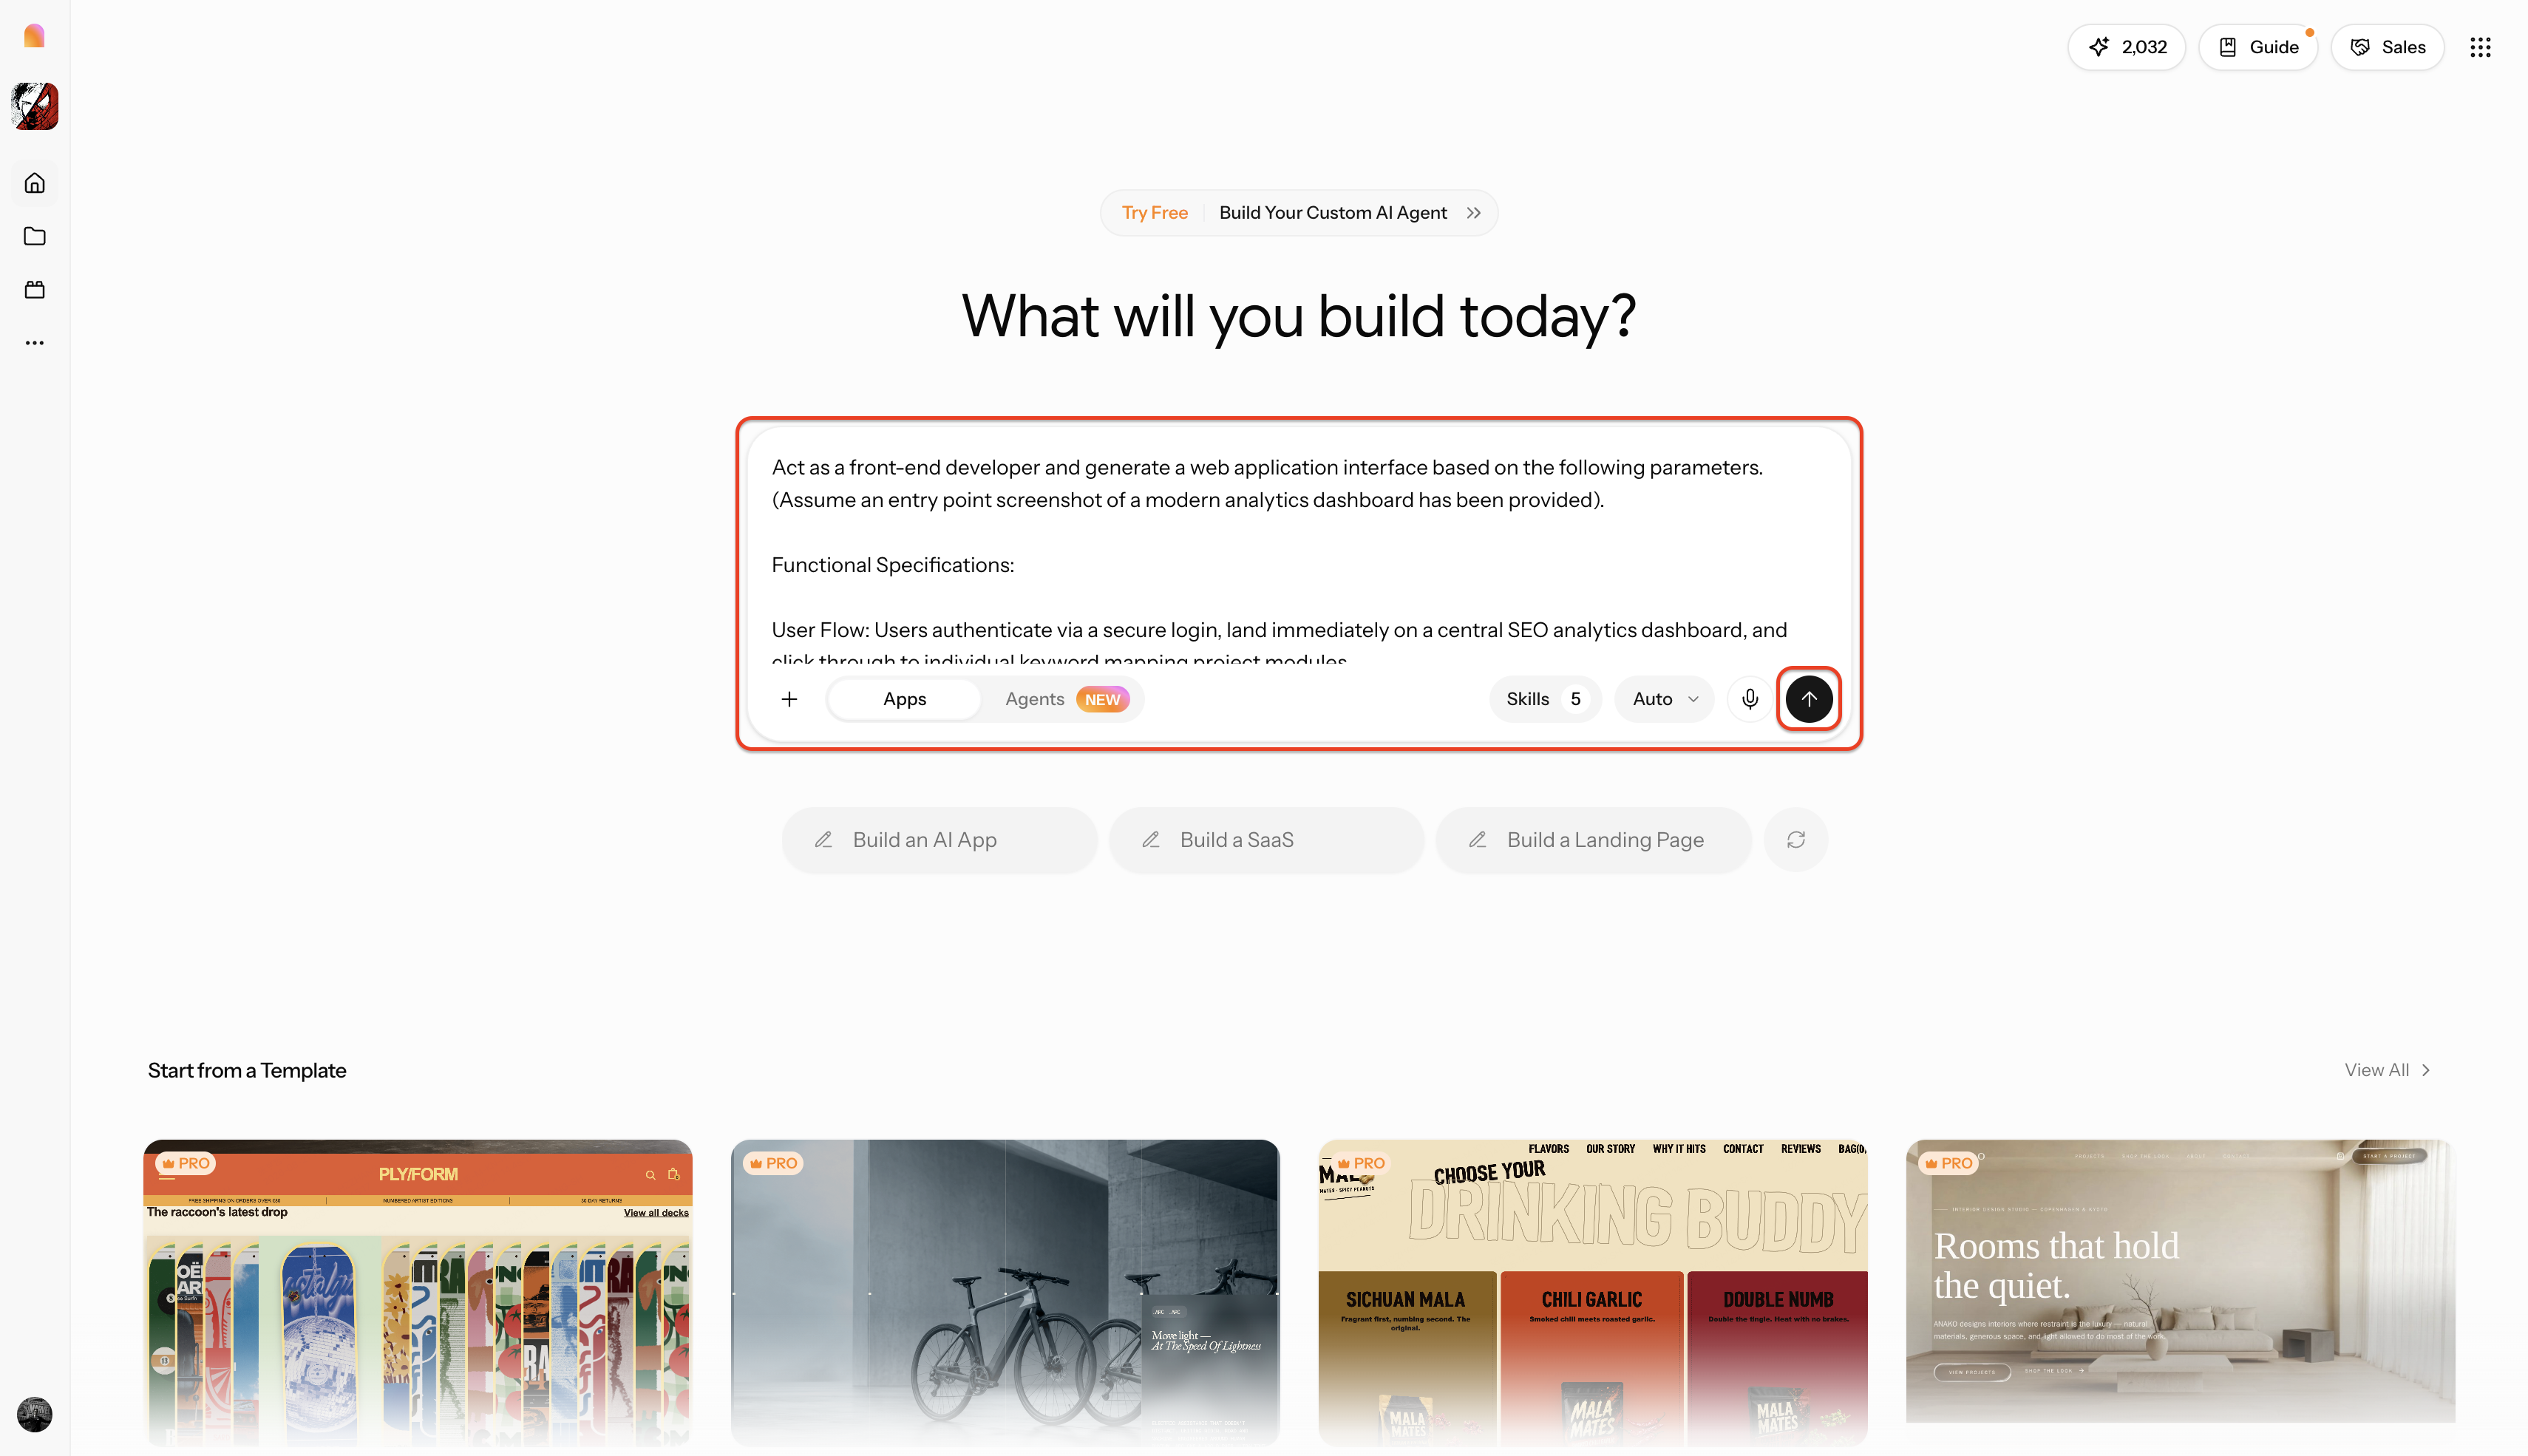
Шаг 1: Запустите Enter Pro и введите промпт проекта
Начните с описания функциональных требований, стилистических предпочтений UI и целевых функций полностью на естественном языке. Вы можете легко загрузить скриншот точки входа UI, чтобы направить структурное и эстетическое понимание AI с самого начала.
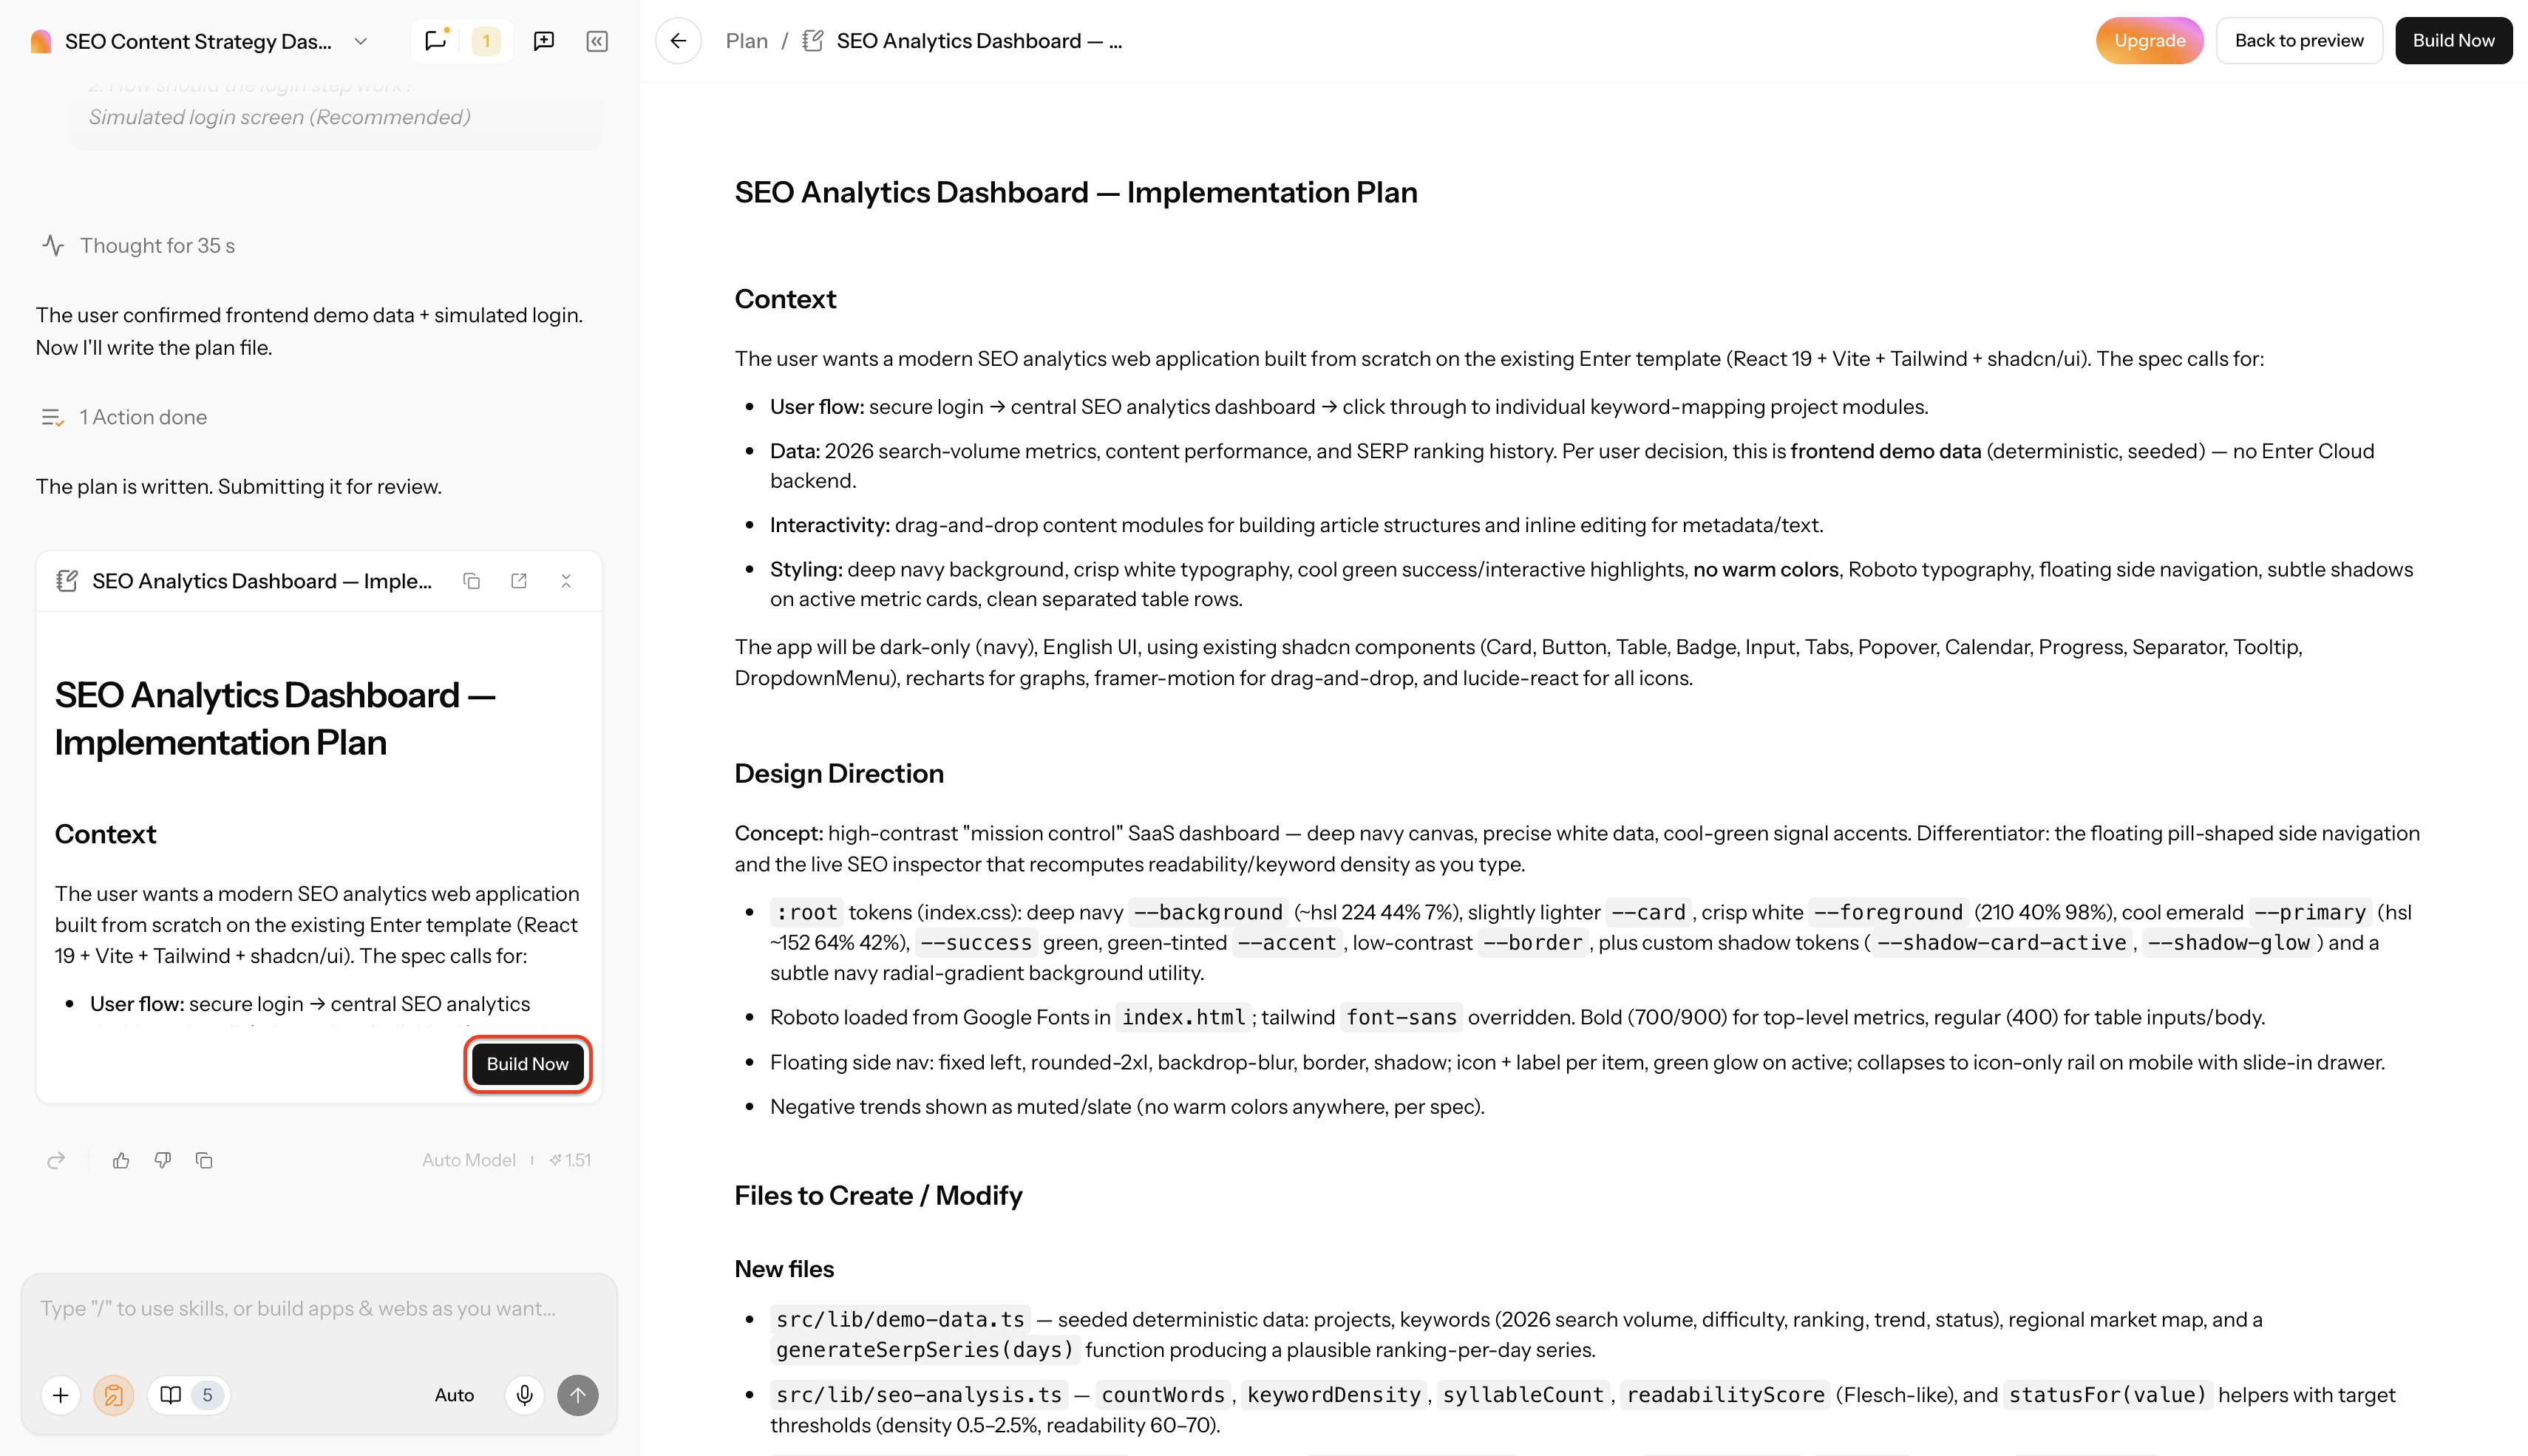
Шаг 2: Просмотрите план реализации и запустите сборку
Изучите сгенерированный AI план с описанием контекста приложения, направления дизайна и необходимой структуры файлов. Когда будете готовы, просто нажмите кнопку «Build Now», чтобы запустить процесс генерации full-stack кода.
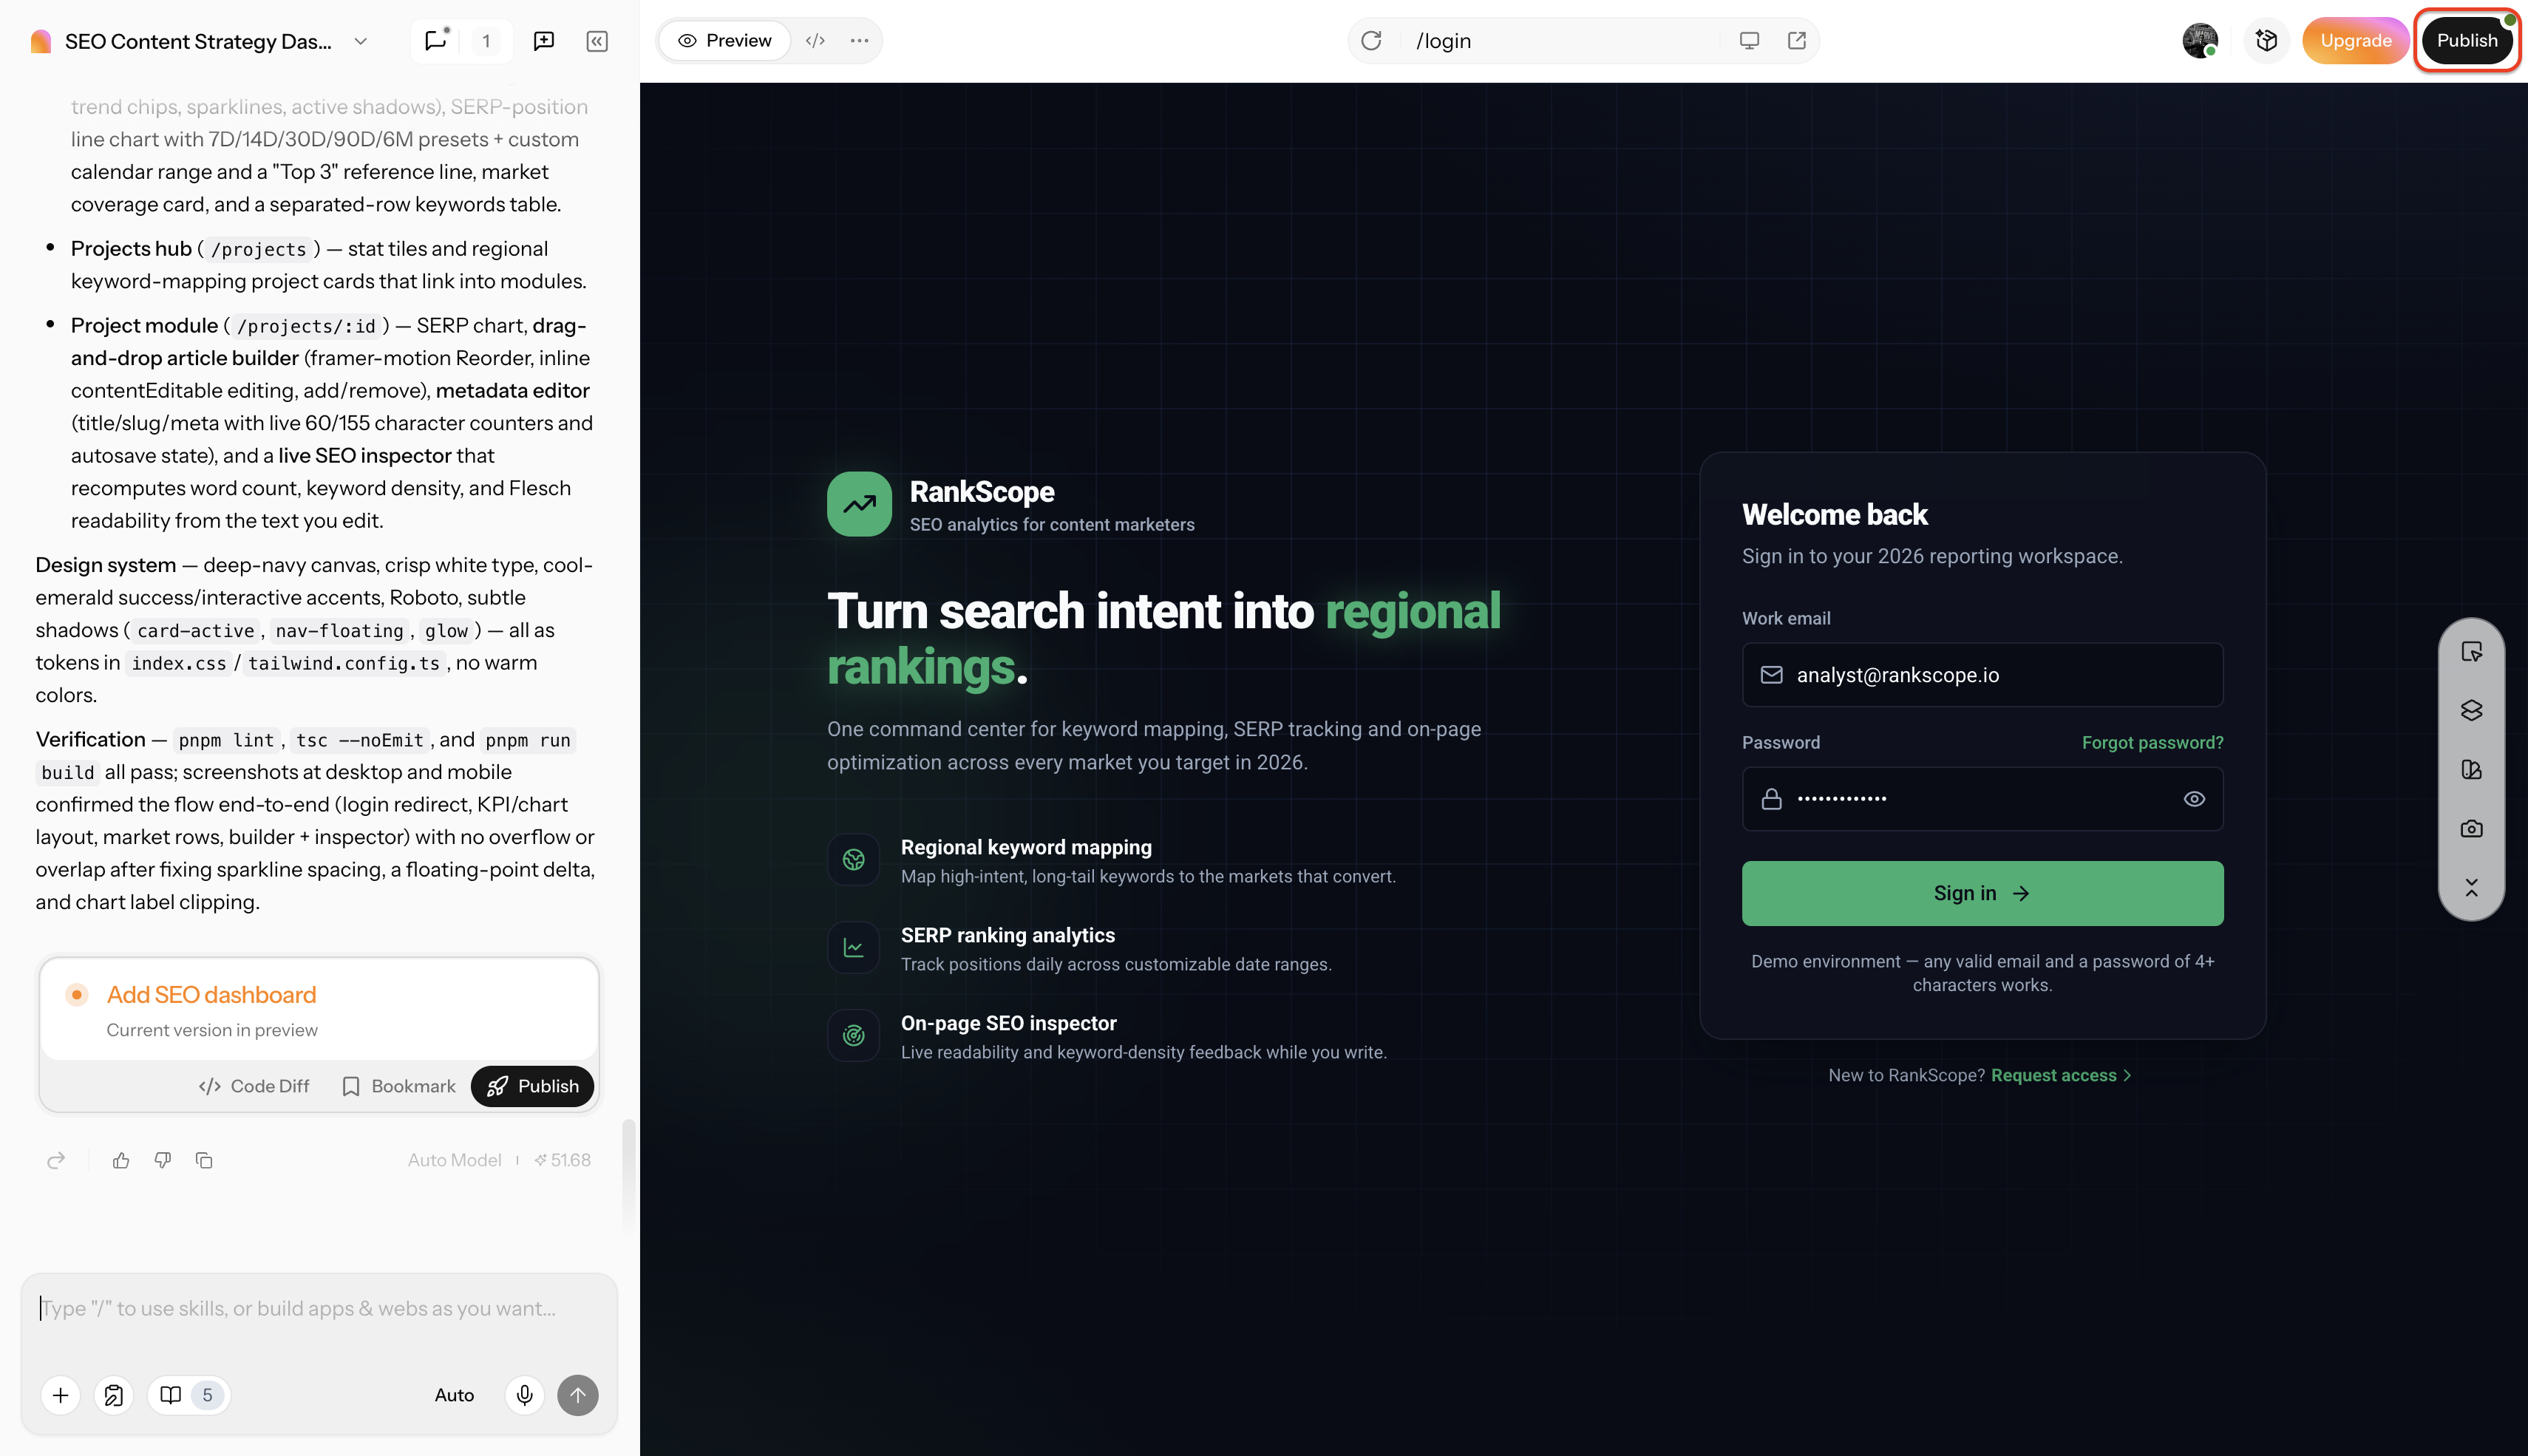
Шаг 3: Редактируйте, публикуйте и экспортируйте
Доработайте сгенерированное приложение с помощью простых промптов или Визуального редактора. Когда результат вас удовлетворит, опубликуйте приложение в сети одним нажатием или безопасно экспортируйте структурированные исходные файлы на свой компьютер.
Облачные LLM против локальных LLM против автономных AI-агентов: компромиссы производительности и приватности
Выбор оптимальной архитектуры требует глубокого анализа фундаментальных компромиссов в вашей текущей инженерной среде.
| Критерий | Фронтир облачные LLM | Self-hosted локальные LLM | Автономный агент (Enter Pro) |
|---|---|---|---|
| Приватность данных | Зависит от политики облачного API | 100% приватно / изолировано от сети | Изолированное рабочее пространство / право на код |
| Нагрузка на оборудование | Локальных вычислений не требуется | Требуется высокая VRAM/GPU | Локальных вычислений не требуется |
| Сложность настройки | API-ключ и настройка плагина IDE | Настройка локального runtime и квантизации | Визуальное рабочее пространство «промпт — запуск» |
| Объём результата | Сниппеты, функции и советы в чате | Автодополнение кода и локальные правки | Полноценные full-stack приложения |
| Модель оплаты | Подписка с оплатой за токен | Первоначальные расходы на локальное оборудование | Фиксированная подписка на платформу |
- Приватность и интеллектуальная собственность: когда я работаю со строго проприетарными кодовыми базами, я всегда выбираю локальные модели, чтобы полностью исключить утечку конфиденциальной IP. Отправка невыпущенной корпоративной логики на удалённые серверы часто нарушает строгие требования соответствия.
- Требования к оборудованию: запуск open-source моделей требует серьёзного выделенного оборудования. Модели на 7B параметров обычно требуют минимум 8 ГБ VRAM, 14B — 16 ГБ, а огромные модели на 70B параметров — 48 ГБ+ VRAM, что часто требует дорогих десктопов с двумя GPU или специализированных локальных серверов.
- Задержка против возможностей: облачные вычислительные кластеры дают огромную, несравнимую мощь для глубокого рассуждения и массового многофайлового рефакторинга. Но при переходе на self-hosted локальные модели я получаю строго нулевую сетевую задержку, которая делает их заметно более плавными для мгновенного инлайн-автодополнения текста.
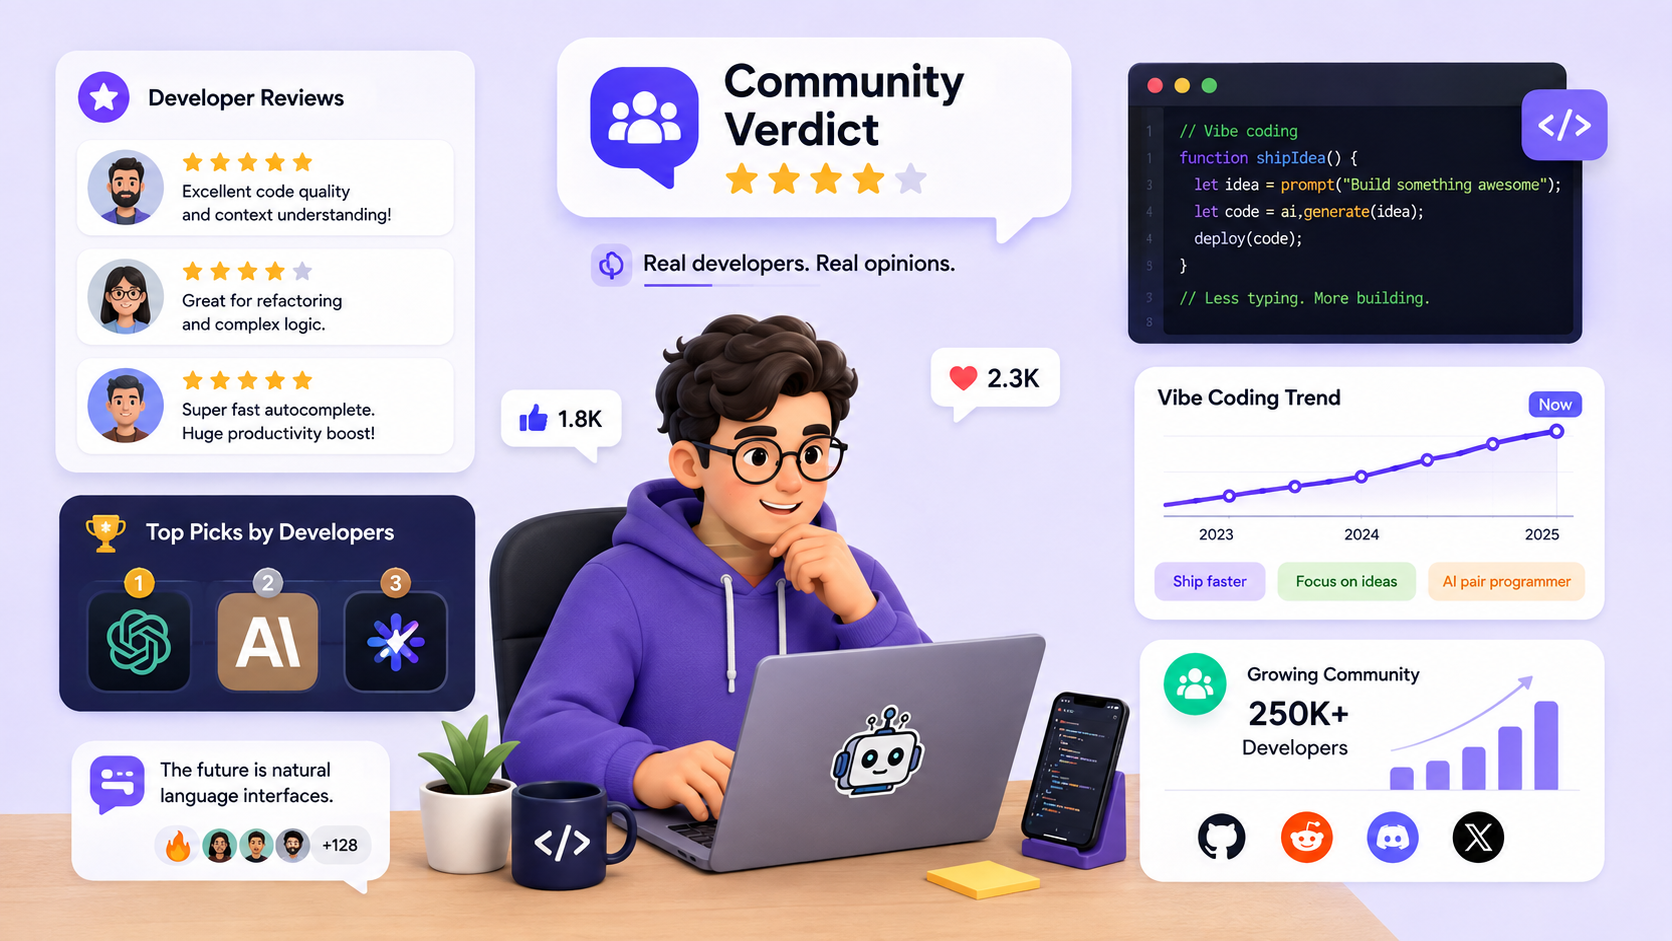
Вердикт сообщества: отзывы разработчиков и тренды vibe coding
- Vibe coding — это современный workflow разработки, где разработчик управляет высокоуровневой архитектурой системы и логикой приложения через промпты на естественном языке, а AI автономно генерирует boilerplate-синтаксис. Вместо ручного набора рутинного кода инженер выступает архитектурным «режиссёром», направляя замысел проекта и проверяя сгенерированные результаты.
Консенсус сообщества Reddit:
- Обобщая обсуждения разработчиков на r/vibecoding, можно заметить, что инженеры часто применяют многоуровневый подход с несколькими моделями. Они редко доверяют одному инструменту весь full-stack проект.
- Разработчики обычно начинают высокоуровневый скаффолдинг и фронтенд-концепции с быстрых, универсальных моделей. Затем сразу переключаются на Claude Opus 5 для глубокого выполнения логики, сложного многофайлового рефакторинга и точечного дебага.
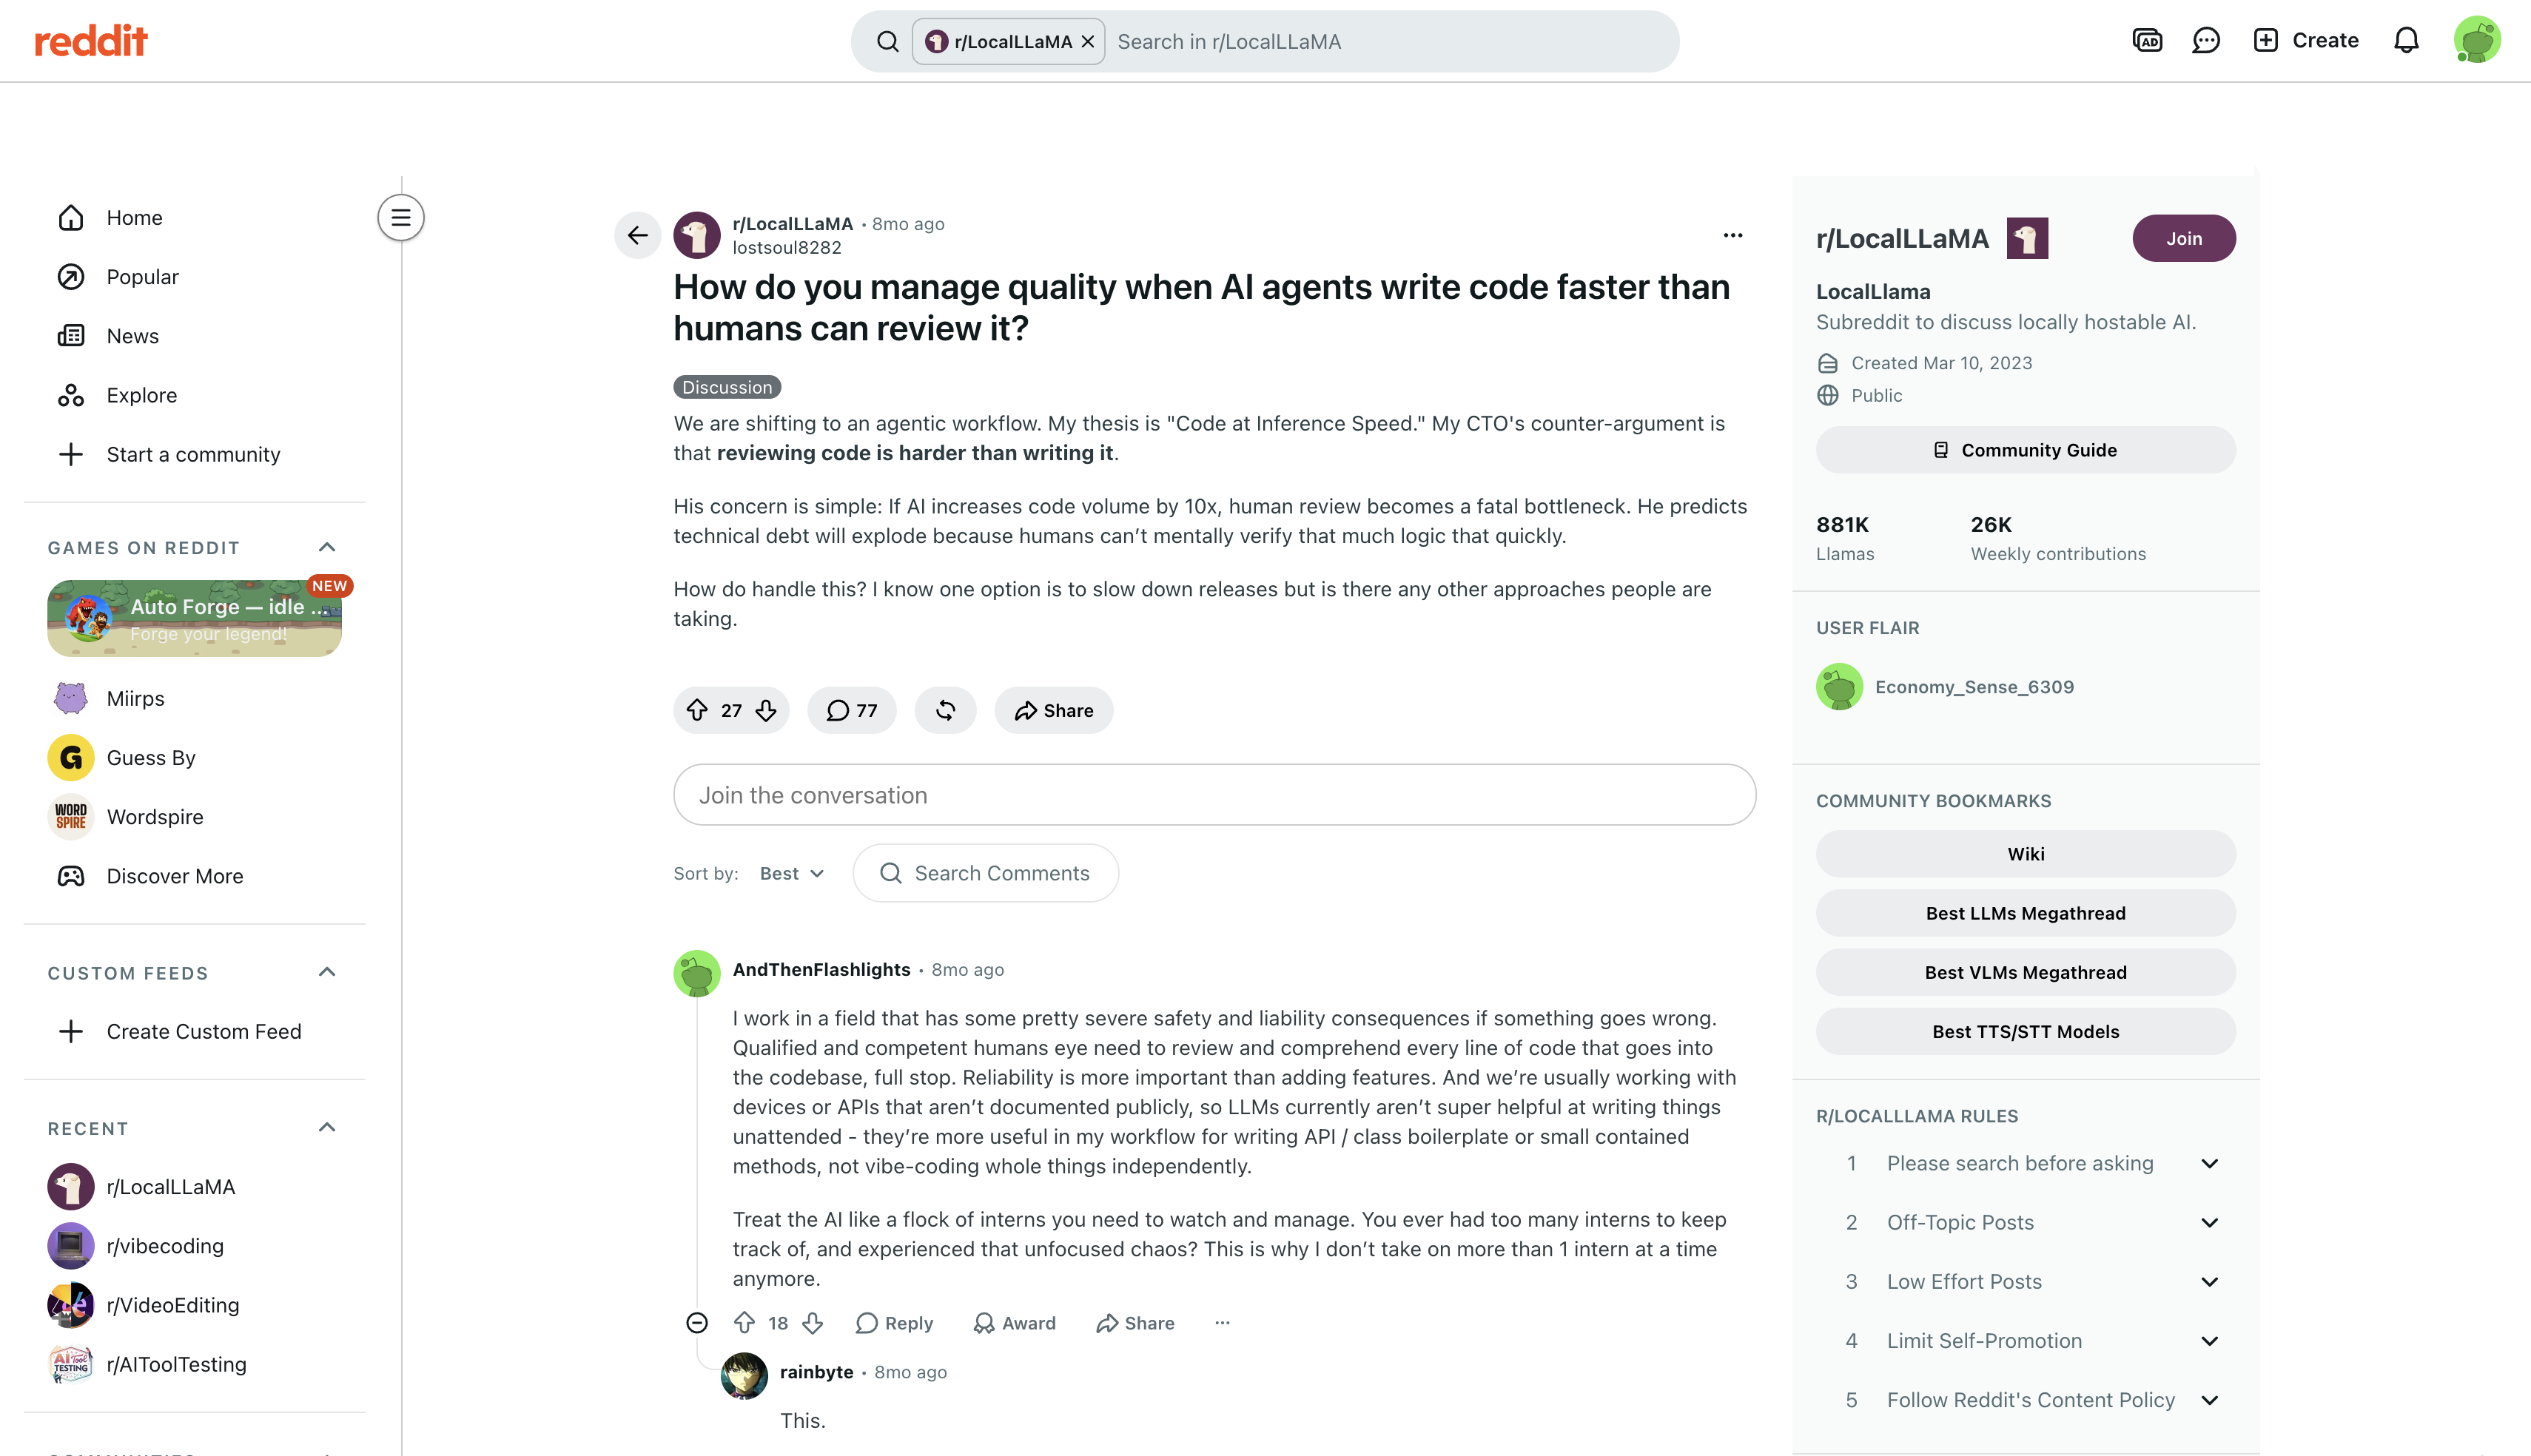
- Обсуждения на инженерных форумах, таких как r/LocalLLaMA, подчёркивают, что человеческий контроль остаётся строго необходимым. Хотя автономная генерация ускоряет первоначальную сборку, разработчики должны активно управлять сложными зависимостями состояния, чтобы предотвратить «дрейф» логики.
Предпочтения сообщества по моделям:
- Workflow без настройки: инженеры сильно предпочитают облачные конфигурации, встроенные прямо в современные AI-native редакторы кода, для быстрой разработки. Claude Opus 5 часто называют золотым стандартом за баланс точности с первой попытки, удержания контекста и высокой надёжности вывода.
- Локальные энтузиастские сборки: многие разработчики выбирают локальное развёртывание, чтобы избежать регулярных расходов на токены API и защитить приватные кодовые базы. Open-source модели, такие как Qwen3-Coder-Next и DeepSeek V4-Pro, широко рекомендуются для self-hosting через runtime вроде Ollama, обеспечивая сильную генерацию кода без передачи телеметрии данных.
Заключение
В конечном счёте, ни одна единственная лучшая LLM для кодинга не подходит идеально для всех инженерных задач в 2026 году. Фронтир облачные модели дают чистую мощь рассуждения, необходимую для сложного системного рефакторинга и структурного дизайна. Для корпоративной безопасности лучшая локальная LLM для кодинга гарантирует нулевую утечку данных в особо чувствительных средах. При этом автономные dev-агенты упрощают полную доставку приложений от идеи до продакшена. Оцените бюджет команды, возможности оборудования и политики безопасности данных, прежде чем выбрать одну экосистему. Запустите IDE, настройте пару API-ключей или локальные runtime. Протестируйте эти модели на своей кодовой базе, чтобы узнать, какой набор инструментов выведет ваш инженерный workflow на новый уровень.
Часто задаваемые вопросы о лучшей LLM для кодинга
Какая LLM лучше всего подходит для кодинга в 2026 году?
Claude Opus 5 сейчас — лучшая coding LLM для сложной инженерии ПО, многофайлового рефакторинга и автономных агентных циклов. Для разработчиков, которым нужно детерминированное выполнение и широкая интеграция с IDE, GPT-5.6 Sol — лучшая облачная альтернатива. Команды, для которых приватность данных критична, могут развернуть локально мощные open-weight модели, такие как GLM-5.2 или DeepSeek V4-Pro, без зависимости от облака.
Какая лучшая локальная LLM для кодинга на пользовательских ноутбуках?
Qwen3-Coder-Next и GLM-5.2 сильно оптимизированы для локальной среды. Qwen3-Coder-Next даёт хорошую эффективность на параметр на скромном оборудовании, а GLM-5.2 — лучший open-weight кодер с контекстом на 1 млн токенов.
Сколько RAM и VRAM нужно для запуска локальных LLM?
Для комфортного запуска стандартной модели на 7B параметров нужно минимум 8 ГБ VRAM GPU или объединённой памяти Apple. Более крупные модели на 14B требуют около 16 ГБ, а огромные корпоративные модели на 70B — от 48 до 64 ГБ VRAM для плавной работы.
Безопасны ли облачные модели для кодинга с проприетарным корпоративным кодом?
Это полностью зависит от политики хранения данных конкретного провайдера API. Хотя корпоративные тарифы высокого уровня обычно обещают не обучаться на пользовательских данных, строгие корпоративные и государственные нормы часто требуют полностью изолированных локальных моделей для гарантии абсолютной безопасности.
Что такое «vibe coding» и какая модель для этого лучше всего подходит?
Это современный workflow разработки, где инженер управляет логикой приложения через широкие, высокоуровневые промпты на естественном языке, а AI автономно пишет весь boilerplate-код и синтаксис. Фронтир-модели, такие как Claude Opus 5 и GPT-5.6 Sol, особенно хорошо справляются с этой методологией для агентного кодинга и крупного рефакторинга.
Как open-source модели для кодинга сравниваются с Claude Fable 5?
Open-weight модели, такие как GLM-5.2 и DeepSeek V4-Pro, быстро сокращают разрыв, превосходя более ранние базовые модели, такие как GPT-5.5, на SWE-bench Pro и алгоритмических задачах. Однако фронтир-движки, такие как GPT-5.6 Sol и Claude Fable 5, всё ещё заметно превосходят их в массовом рефакторинге и сложных агентных циклах.
Могут ли LLM для кодинга заменить человека-инженера?
Нет. Сейчас эти модели работают как очень продвинутые компиляторы и мощные ускорители workflow. Для проектирования системной архитектуры, управления сложными протоколами безопасности и тщательной проверки функциональной логики перед продакшеном всё равно абсолютно необходимы опытные инженеры-люди.
Какая лучшая бесплатная open-source LLM для разработки на Python?
GLM-5.2 и Qwen3-Coder-Next обе обладают обширными, высокоспециализированными возможностями. GLM-5.2 предлагает контекст на 1 млн токенов для крупных кодовых баз, а Qwen3-Coder-Next — отличную эффективность для небольших локальных развёртываний, что делает их отличным бесплатным выбором для стандартных задач веб-разработки.





