
Обзор GLM-5: версии, бенчмарки, цены и доступ
Сравнение версий GLM-5, бенчмарков, цен, архитектуры, локального развёртывания, доступа через API и интеграции с Enter Pro.
GLM-5 давно перестал быть одной моделью, которую можно оценить по единственному бенчмарку. Это целое семейство: некоторые варианты работают только с текстом, другие принимают изображения, более новые версии увеличили окно контекста до 1 миллиона токенов, а самый доступный вариант стоит лишь долю цены флагмана.
Перед обновлением этого обзора я изучил релизные заметки Z.ai, карточки моделей, документацию API, репозиторий и реальные скриншоты продукта. Это важно, потому что некоторые заявления выглядят довольно привлекательно — например, внутренний прирост в кодинге на 50% или снижение вычислений в 2,9 раза при длинном контексте — но исходят от самой Z.ai, а не от независимого аудита. Поэтому я называю это заявлениями, а не результатами собственного тестирования.
При выборе модели GLM-5 стоит задать себе четыре вопроса: какие у вас входные данные? Насколько сложна задача? Где должен выполняться инференс? Сколько стоит успешный результат, если нужны повторные попытки? Мой быстрый ответ: GLM-5.3 для сложного текста/кода, GLM-5.3-Flash для мультимодальности или экономии, и GLM-5.2, если у вас уже есть проверенная интеграция.
Что такое GLM-5?
GLM-5 — это семейство моделей с открытыми весами, разработанное Z.ai для программной инженерии, использования инструментов и агентов с длинным горизонтом работы. Исходный релиз (февраль 2026 года) — это модель Mixture-of-Experts (MoE), работающая только с текстом на входе и выходе, с 744 миллиардами параметров в сумме, примерно 40 миллиардами активных параметров на токен и окном контекста в 200 000 токенов. Эти характеристики взяты из технического отчёта GLM-5 и официального репозитория на GitHub.
Модель MoE не активирует всю сеть для каждого токена. Маршрутизатор направляет каждый токен к небольшой группе «экспертов», что снижает активные вычисления при сохранении очень большого чекпоинта. Это не делает GLM-5 моделью для ноутбука: полные веса всё равно требуют хранения, маршрутизации и серверного оборудования.
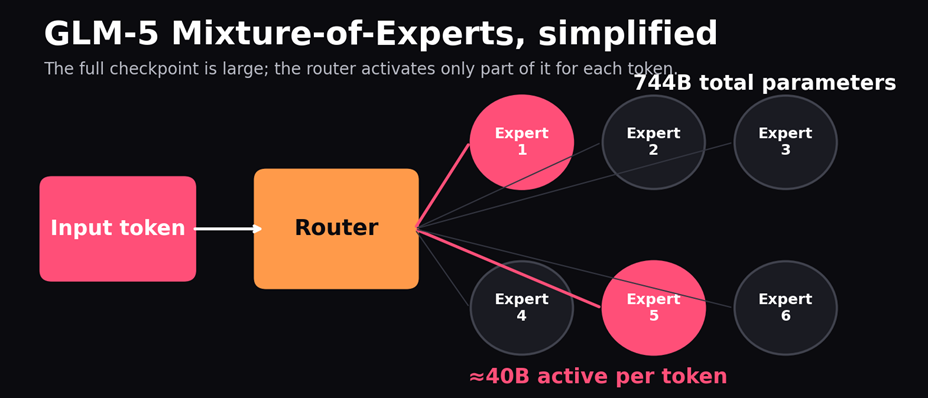
Рисунок 1. GLM-5 активирует примерно 40 млрд из 744 млрд параметров на токен; полный чекпоинт остаётся развёртыванием серверного масштаба.
Правильный термин — «открытые веса» (open weights). Для кода, весов модели, хостинг-сервиса и обучающих данных действуют разные условия. Перед любым коммерческим использованием стоит изучить лицензию, прилагаемую к конкретной карточке модели, так как не все версии GLM предоставляют одинаковые права.
Семейство версий GLM-5
Общее название семейства скрывает важные различия. Выбирайте модель по модальности, контексту, истории проверки и способу развёртывания, а не считайте все версии 5.x взаимозаменяемыми.
| Версия | Вход/контекст | Главная причина использовать | Важная оговорка |
|---|---|---|---|
| GLM-5 | Текст / 200K | Исходные исследования или устаревшая интеграция | Первый релиз семейства; не мой выбор по умолчанию для нового проекта |
| GLM-5-Turbo | Текст / 200K | Хостинговая работа агентов с активным использованием инструментов | Это маршрут провайдера, а не маленький скачиваемый чекпоинт |
| GLM-5V-Turbo | Текст, изображения, видео, файлы / 200K | Визуальное программирование и задачи GUI | Проверьте поддерживаемые форматы на вашем эндпоинте |
| GLM-5.1 | Текст / 200K | Длительные инженерные сессии | Устарела для большинства новых оценок |
| GLM-5.2 | Текст / 1M | Длинный контекст и проверенные интеграции | Миграция на 5.3 меняет поведение рассуждений |
| GLM-5.3 | Текст / 1M | Сложное программирование и долгоживущие агенты | Рассуждение всегда включено; вывод может быть длинным |
| GLM-5.3-Flash | Мультимодальная / 1M | Скриншоты, большой объём и низкая стоимость | Отдельная архитектура 320B/18B, а не «5.3 с низким усилием» |
Источники: релизные заметки Z.ai, руководство по GLM-5-Turbo, руководство по GLM-5V-Turbo и руководство по GLM-5.1. Хостинг-провайдер может предоставлять окно контекста меньше того, что поддерживает сама модель.
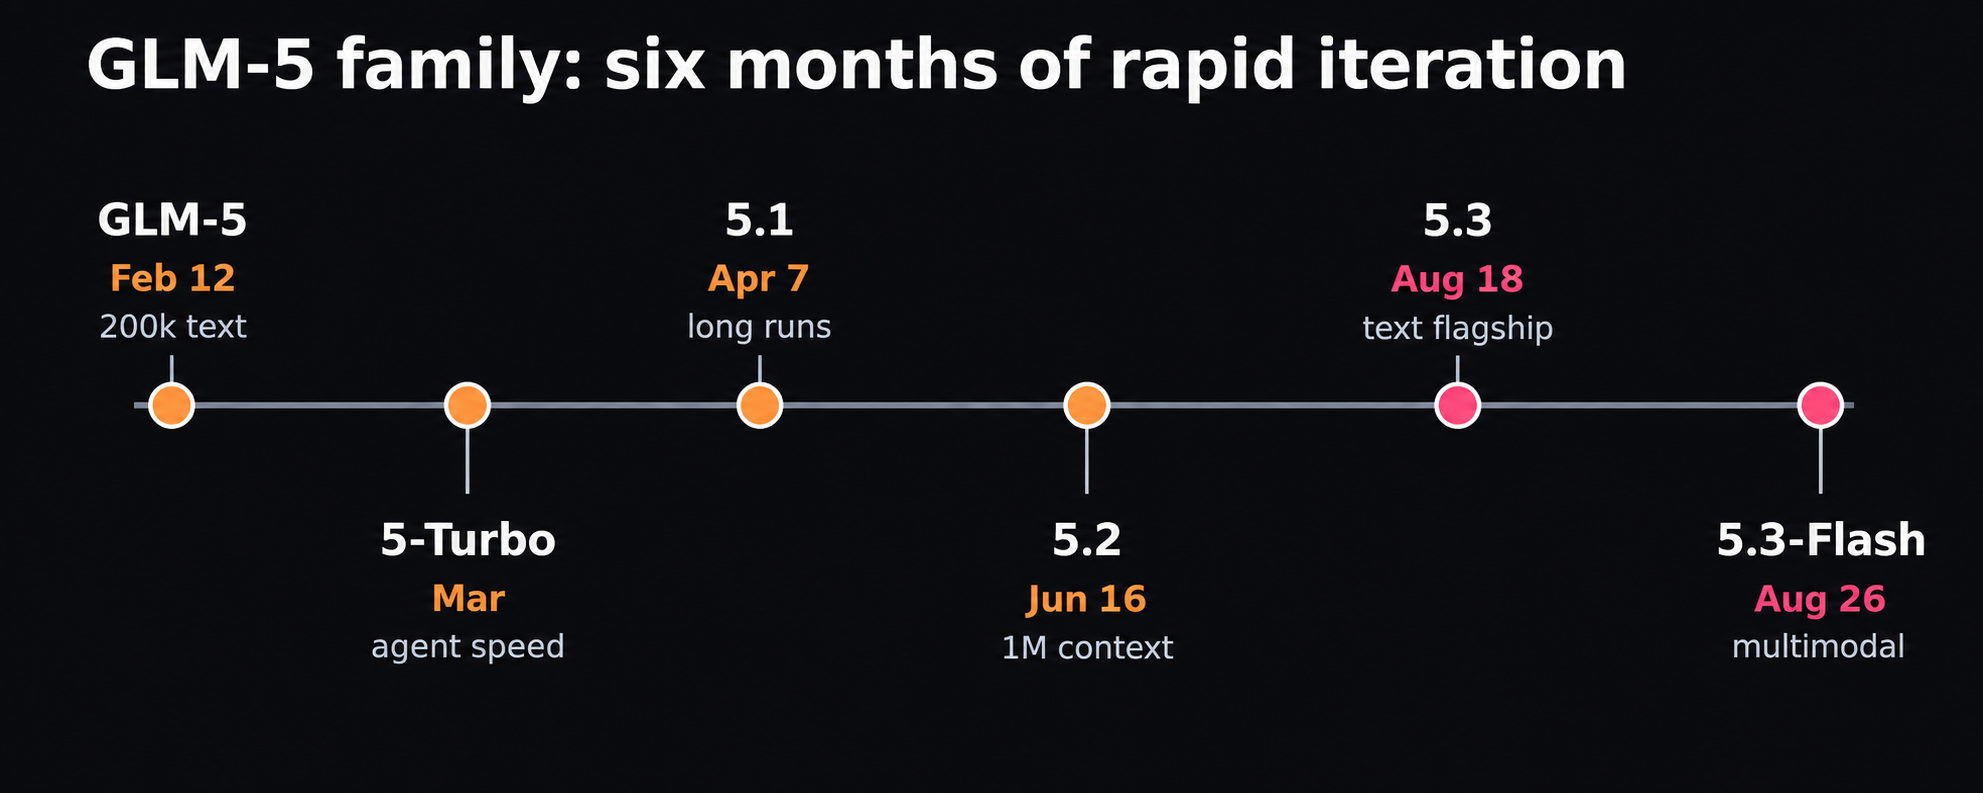
Рисунок 2. Шесть месяцев релизов изменили длину контекста, модальность, поведение рассуждений и цену.
От GLM-5 к GLM-5.2
Архитектура на основе агентов была заложена ещё в базовой GLM-5. GLM-5.1 сделал акцент на длительных сессиях работы; Z.ai заявляет, что модель может работать до 8 часов подряд, но к этому стоит относиться с осторожностью, так как ваш репозиторий может вести себя иначе. Затем в GLM-5.2 добавили окно контекста на миллион токенов, гибкие настройки усилия и IndexShare для эффективного внимания при длинном контексте.
GLM-5.3 и GLM-5.3-Flash
Флагман линейки GLM работает только с текстом — это GLM-5.3. Согласно документации, у него лимит входа в 1 миллион токенов, лимит выхода в 128K и уровни усилия рассуждения: низкий, высокий или максимальный. Отключить «thinking» нельзя; запрос из 5.2, явно отключающий его, может завершиться ошибкой при миграции.
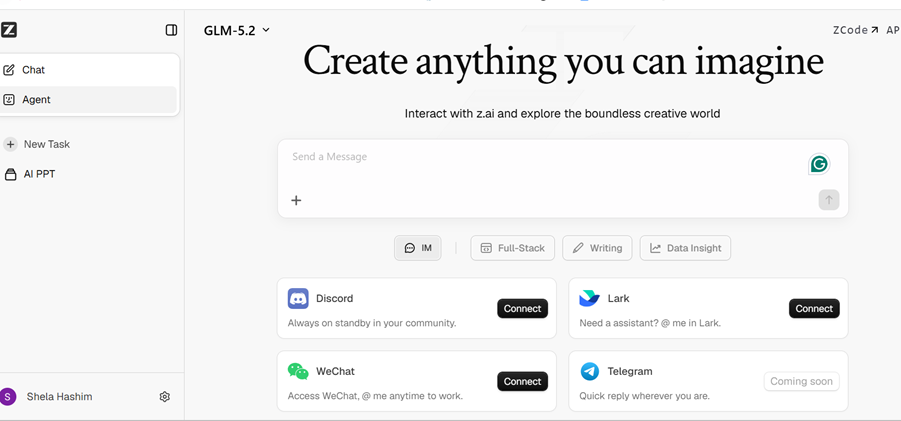
Рисунок 3. Живой интерфейс GLM-5.3 подтверждает отдельный флагманский маршрут; доступность и названия могут меняться.
GLM-5.3-Flash — это ещё одна модель с 320B параметров всего и 18B активных, с нативным мультимодальным вводом и гибридным sparse/linear вниманием. Моя первая рекомендация проста: когда важна глубина, используйте 5.3; когда речь о скриншотах или большом объёме, сначала протестируйте Flash.
Прежде чем менять существующую интеграцию, воспроизводите сохранённые запросы, а не просто меняйте имя модели. Протестируйте структурированный вывод, аргументы вызовов инструментов, максимальную длину завершения и обработку таймаутов. Ответ может выглядеть эффектнее в чате, но может ломать парсер или просто превышать лимит задержки вашего приложения. Держите старый маршрут активным, пока новая версия не пройдёт те же продакшн-проверки.
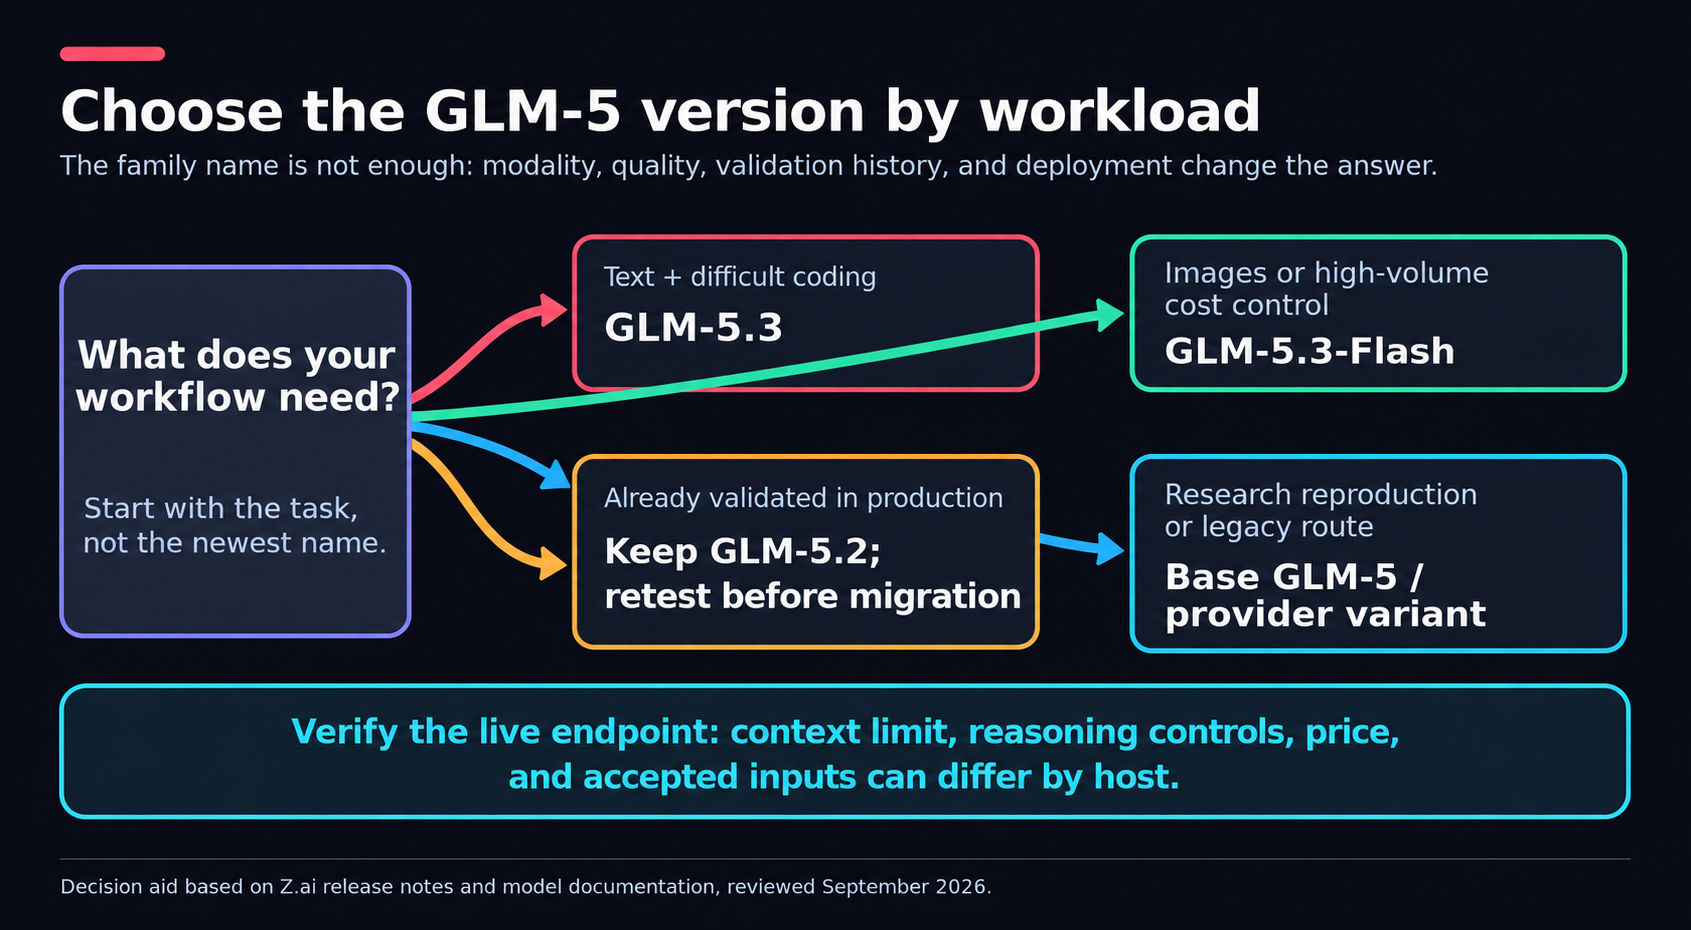
Рисунок 4. Выбирайте по нагрузке и поведению эндпоинта, а не только по названию самой новой модели.
Как GLM-5 сравнивается с Claude, GPT и Gemini?
GLM-5.3 заслуживает места в любом коротком списке агентов для кодинга, но одна таблица не может определить абсолютного победителя. Баллы Terminal-Bench зависят от harness, разрешений для инструментов, временного бюджета и уровня усилия. Z.ai сообщает о 88,2 баллах на Terminal-Bench 2.1 и 28,3 баллах на Terminal-Bench 3.0 для GLM-5.3 при максимальном усилии; в их таблице также приведены результаты Claude Opus 4.8 и GPT-5.6 Sol.
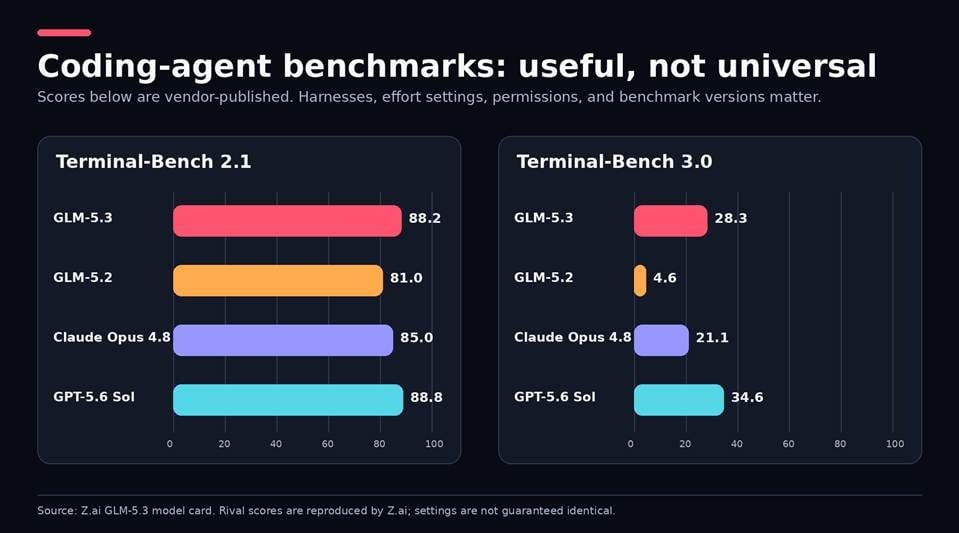
Рисунок 5. Баллы, опубликованные производителем, — это ориентировочное свидетельство, а не замена идентичного теста под конкретную нагрузку.
В отличие от других моделей, карточка GLM-5.3 называет конкретные harness и настройки усилия. Она не утверждает, что модели-конкуренты работали в идентичных условиях. Аналогично, согласно отчёту по GLM-5.2, она превосходит Gemini 3.1 Pro на подмножестве задач Terminal-Bench 2.1 — небольшой части упомянутых здесь задач по кодингу; однако это не означает, что GLM превосходит Gemini 3.1 Pro во всех мультимодальных, исследовательских или текстовых задачах.
Я бы сравнивал модели с одинаковыми промптами, инструментами, таймаутом и критериями прохождения. Важна цена успешной задачи, а НЕ цена токена. Более дешёвая модель, которая проваливается три раза, может оказаться дороже, а если Flash проходит ваши тесты с первой попытки, преимущество флагмана теряет смысл.
Карточка GLM-5.3 относительно уникальна тем, что указывает названия harness и уровни усилия. Проверялись ли другие конкурирующие модели в тех же условиях, пока остаётся неизвестным. Аналогично, руководство по GLM-5.2 утверждает, что модель превосходит Gemini 3.1 Pro на Terminal-Bench 2.1 — задаче, ориентированной на агентов для кодинга, — а не обязательно в мультимодальных, исследовательских или текстовых задачах.
Я бы рассматривал модели, используя одинаковые промпты, инструменты, таймаут и критерий прохождения. Ориентируясь только на стоимость успешной задачи, а НЕ на цену токена. Если тесты успешны с первой попытки, Flash, возможно, окажется более выгодным вариантом, а значит, преимущество флагмана тоже, вероятно, снизится.
Внутри обучения и архитектуры GLM-5
Sparse Attention и IndexShare
Длинный контекст обходится дорого, потому что внимание обычно учитывает множество связей между токенами. В GLM-5.2 внедрён индексатор, который повторно используется на четырёх разных слоях внимания для определения правильных позиций. Z.ai утверждает, что это даёт в 2,9 раза меньше FLOPs на токен при 1M токенов. Это заявление об эффективности от разработчика, а не утверждение о задержке эндпоинта или реальной стоимости запросов.
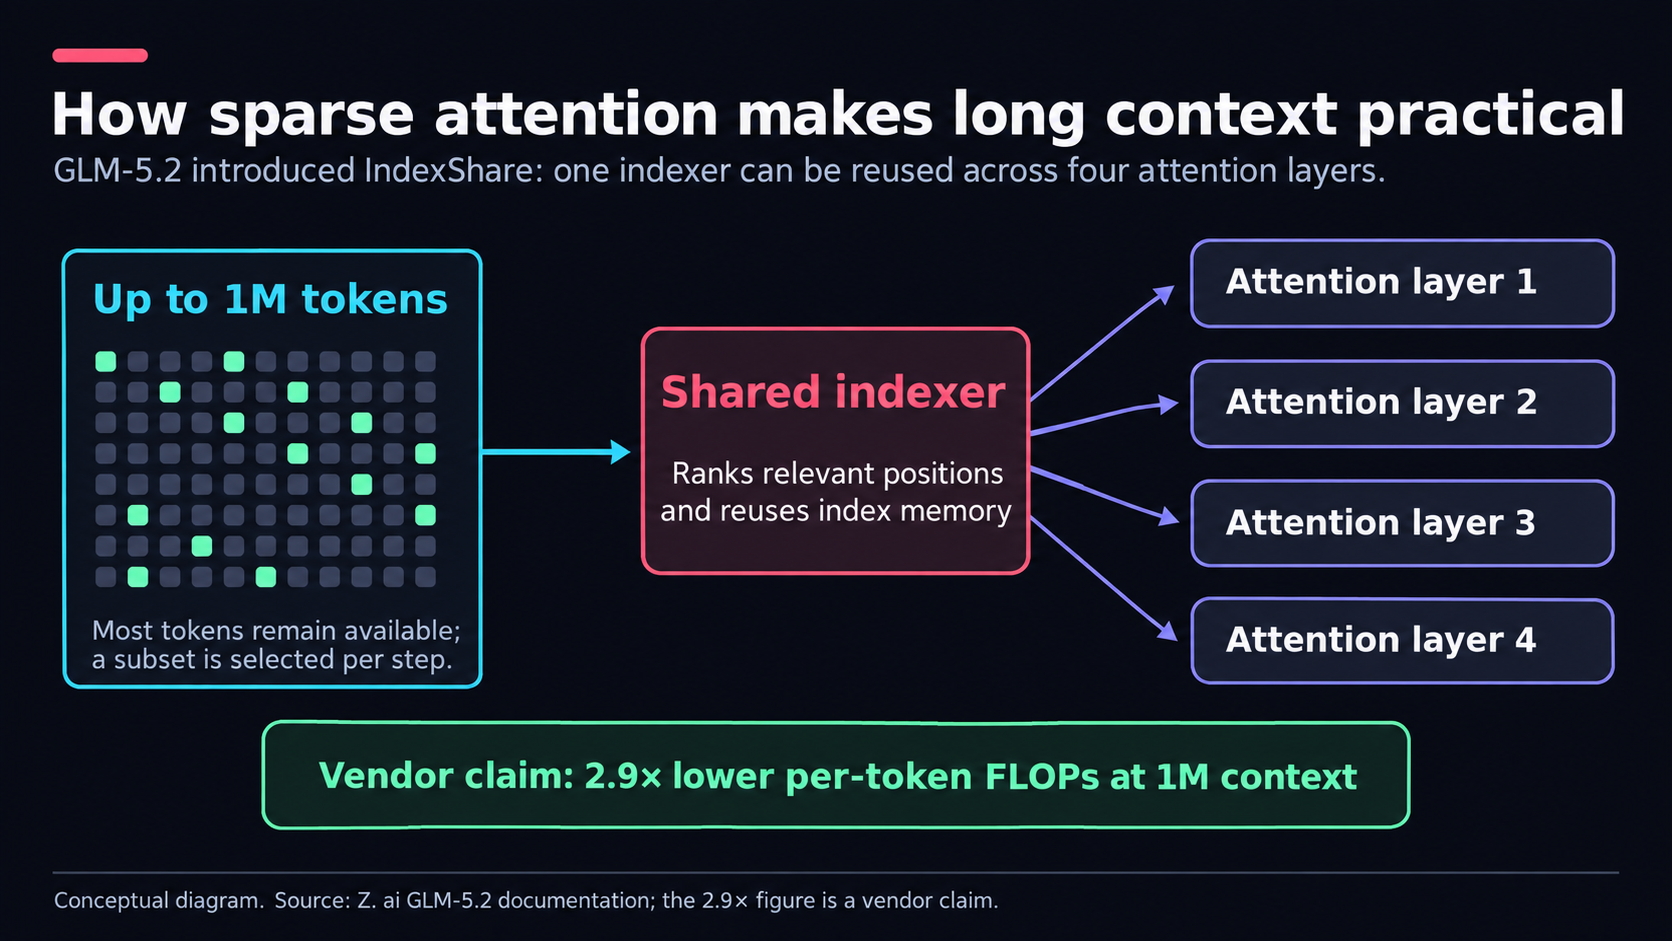
Рисунок 6. IndexShare повторно использует один индексатор на четырёх слоях внимания; цифра 2,9x — заявление Z.ai.
Долгосрочное обучение с подкреплением
Для GLM-5.3 компания Z.ai представляет собственное видение асинхронной системы обучения с подкреплением под названием «slime», а также компактирование контекста и синтезированные верификаторы. Эти техники направлены на типичные ошибки, которые агенты допускают при длинных сессиях: потеря цели, оставление задачи незавершённой или отсутствие проверки ответа. Но даже с этим всё равно нужны чекпоинты и внешние тесты, а значит, возможны более длинные траектории и более крупные трассы сбоев.
Возможности в кибербезопасности требуют проверки человеком
В рамках сотрудничества по безопасности Z.ai сообщает о 2 436 обнаруженных уязвимостях в 269 проектах с открытым исходным кодом, из которых 1 097 имеют среднюю или высокую степень серьёзности. Эти цифры, вероятно, релевантны для GLM-5.3 в контексте защитного аудита, но GLM-5.3 не подтверждает уязвимость — только обозначает находку модели.
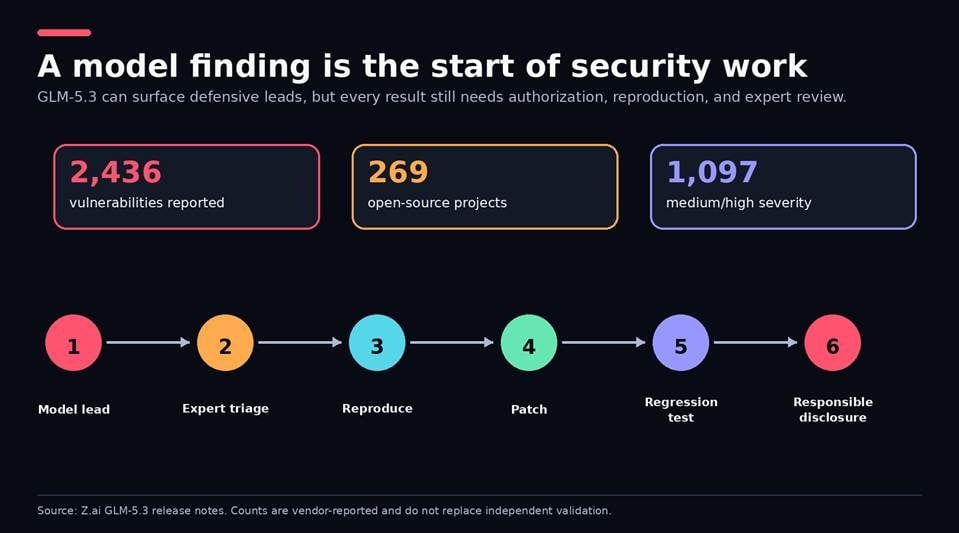
Рисунок 7. Воспроизведите, устраните, проведите регрессионное тестирование и раскрывайте информацию ответственно; никогда не направляйте агента на системы, которые у вас нет разрешения тестировать.
Цены на GLM-5
С сентября 2026 года Z.ai разделяет стоимость некэшированного входа, кэшированного входа и выхода. Я перепроверил эти цены на официальной странице тарифов; не стоит воспринимать их как неизменные при планировании бюджета, так как они могут меняться со временем.
| Модель | Вход / 1M | Кэшированный вход / 1M | Выход / 1M |
|---|---|---|---|
| GLM-5 | $1,00 | $0,20 | $3,20 |
| GLM-5.1 | $1,40 | $0,26 | $4,40 |
| GLM-5.2 | $1,40 | $0,26 | $4,40 |
| GLM-5.3 | $1,40 | $0,26 | $4,40 |
| GLM-5.3-Flash | $0,15 | $0,03 | $0,50 |
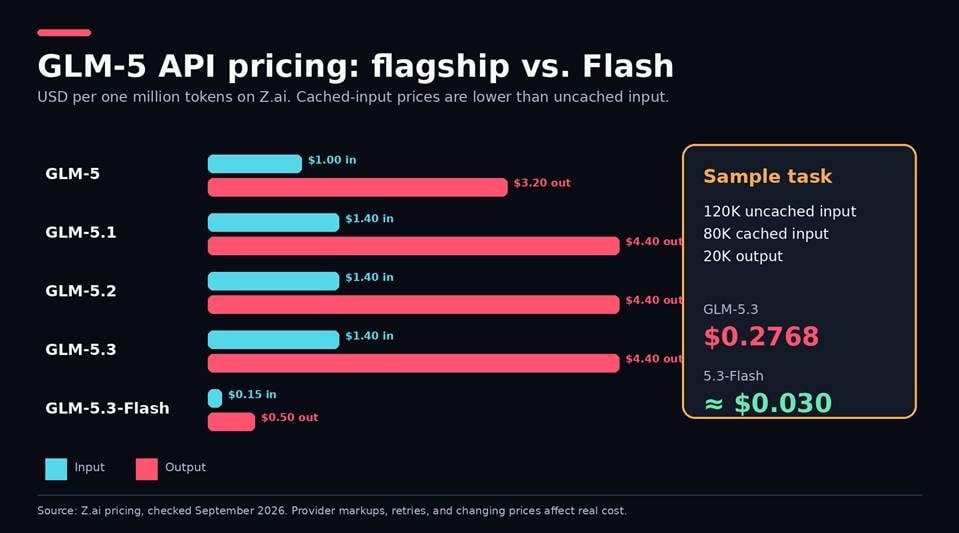
Рисунок 8. Цены API Z.ai показывают, почему длина вывода и повторные попытки могут определять итоговый счёт.
Стоимость GLM-5.3 составляет примерно $0,2768 за 120K некэшированного входа, 80K кэшированного входа и 20K выхода; у 5.3-Flash — около $0,030 (без учёта повторных попыток). Другие хостинги, например OpenRouter, могут предлагать разные цены, лимиты, задержки и маршрутизацию. GLM Coding Plan — это не продакшн-квота API, а отдельная подписка для поддерживаемых инструментов программирования.
Вывод — самая дорогая часть запроса, и агент, долго рассуждающий, легко может превысить быструю оценку стоимости. Я бы установил потолок на длину вывода, использовал кэширование там, где повторяющийся контекст это позволяет, и логировал стоимость каждой выполненной задачи. При составлении продакшн-бюджета учитывайте повторные попытки, неудачные вызовы инструментов и время, которое люди тратят на исправление слабых ответов. Именно эту цифру стоит сравнивать между провайдерами.
Как использовать GLM-5
| Маршрут | Лучше всего для | Где выполняется инференс |
|---|---|---|
| Z.ai Chat | Быстрая качественная оценка | Серверы Z.ai |
| API Z.ai | Интеграция от первого лица | Серверы Z.ai |
| OpenRouter | Выбор провайдера и резервирование | Выбранный хостинг-провайдер |
| Enter MaaS | Доступ к модели внутри процесса создания приложений | Хостинговый маршрут, видимый в Enter |
| Hugging Face + vLLM/SGLang | Самостоятельное развёртывание | Ваша собственная инфраструктура |
| Ollama :cloud | Удалённый доступ через клиент Ollama | Удалённые серверы, а не ваш ноутбук |
Начните с Z.ai Chat
Самый простой способ опробовать GLM-5 в чате — chat.z.ai. Используйте его для проверки поведения промптов и структуры вывода, но учитывайте конкретную модель, отображаемую в интерфейсе. Не обещайте команде «бесплатное» или «безлимитное» использование без проверки текущей квоты аккаунта.
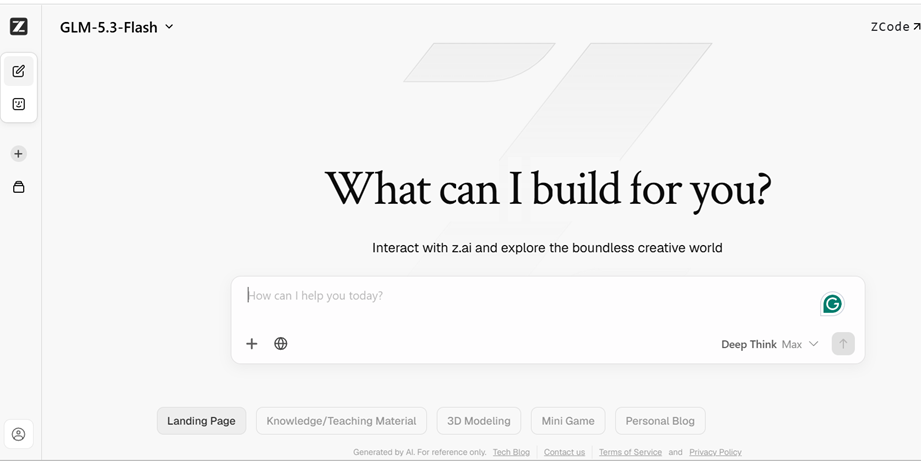
Рисунок 9. Интерфейс чата — это быстрая качественная проверка, но отображаемая модель и квота аккаунта всё ещё важны.
Вызов API Z.ai или OpenRouter
Z.ai предоставляет эндпоинт, совместимый с OpenAI, что означает, что официальный Python SDK можно использовать с другим базовым URL. Храните API-ключ в переменной окружения и записывайте ID модели, уровень усилия, количество использованных токенов и успешность завершения запроса.
Рисунок 10. Эндпоинт Z.ai, совместимый с OpenAI, сокращает изменения в SDK, но не исключает необходимость тестирования миграции.
import os

from openai import OpenAI

client = OpenAI(

        api_key=os.environ["ZAI_API_KEY"],

        base_url="https://api.z.ai/api/paas/v4/",

)

response = client.chat.completions.create(

        model="glm-5.3",

        messages=[{"role": "user", "content": "List five tests for a password-reset flow."}],

        max_tokens=4096,

        extra_body={"thinking": {"type": "enabled"}, "reasoning_effort": "high"},

)

print(response.choices[0].message.content)
При миграции с 5.2 удалите любой запрос, явно отключающий «thinking»; GLM-5.3 такое поведение не принимает. Если вы используете маршрут GLM-5.3 через OpenRouter, записывайте, какой провайдер обработал запрос, когда важны управляемость или воспроизводимость.
Скачайте и разверните веса самостоятельно
Используйте официальный репозиторий или проверенную карточку GLM-5.3 на Hugging Face. Z.ai перечисляет SGLang, vLLM, Transformers, KTransformers и Unsloth среди поддерживаемых путей.
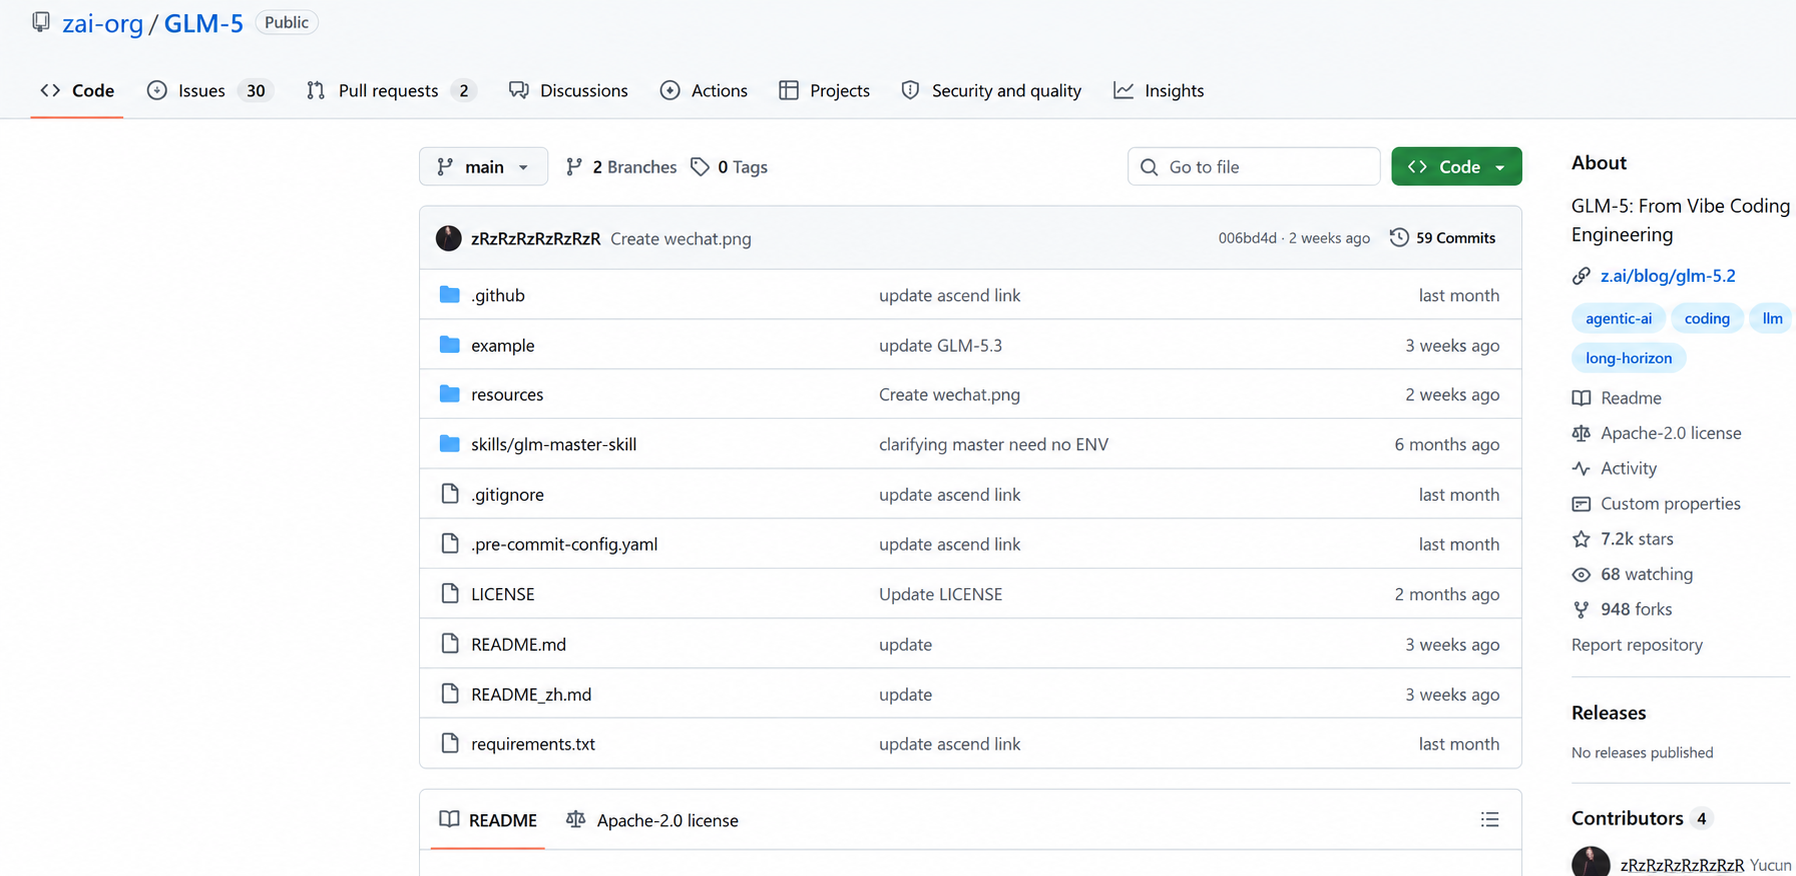
Рисунок 11. Используйте проверенный репозиторий и официальную карточку модели, а не неофициальное зеркало весов.
Возможность скачать НЕ означает возможность запустить. Квантизация снижает требования к памяти, но может повлиять на качество; при чекпоинте в 744B требуются серверное хранилище и ускорители. Внимательно читайте листинг GLM-5 на Ollama: тег «cloud» означает удалённый инференс. Для реального локального запуска нужны локальные веса, локальная среда выполнения и достаточное оборудование.
Как я бы оценивал GLM-5 перед запуском в продакшн
Я бы не начинал с общего вопроса типа «какая модель умнее?». Я бы запустил четыре репрезентативные задачи для 5.2, 5.3 и Flash, используя одинаковые инструменты и лимиты: исправление ошибки в репозитории, извлечение внедрённых фактов из длинного документа, выполнение многошагового рабочего процесса с одним искусственно внесённым сбоем, и создание результата, оцениваемого по письменной рубрике.
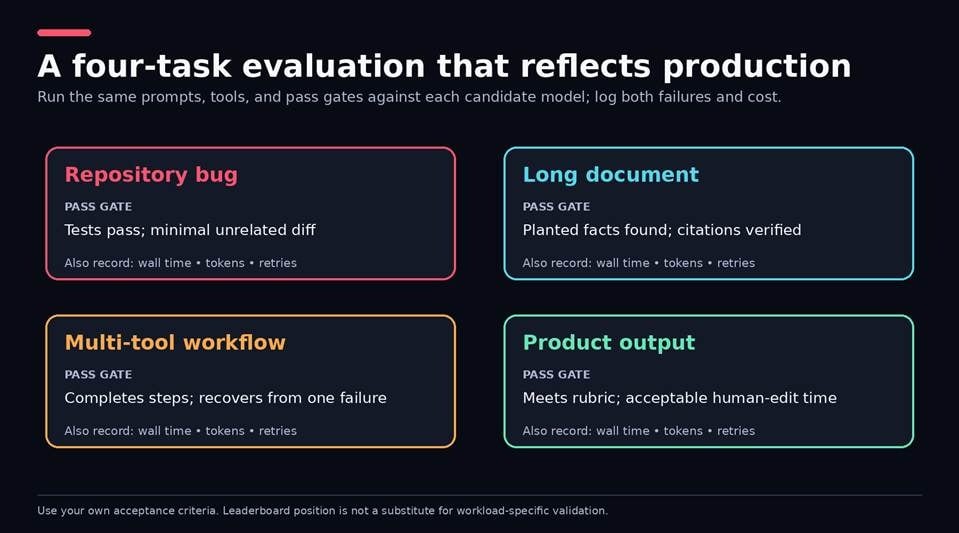
Рисунок 12. Небольшой, повторяемый тест нагрузки полезнее общего вопроса о «самой умной модели».
Прошла/не прошла, фактическое время, токены, повторные попытки, время ручного редактирования и провайдер. Это позволяет выявить риски миграции, которые не видны по средним значениям бенчмарков — например, постоянно включённое рассуждение 5.3 и потенциально длинный вывод. Это также показывает, переживёт ли более низкая цена Flash столкновение с вашими приёмочными тестами.
Кому стоит использовать GLM-5?
Агентный кодинг и работа с репозиторием
GLM-5 — отличный вариант, если задача включает поиск по репозиторию, координированные правки, выполнение тестов и вызовы инструментов. Публичные бенчмарк-данные подтверждают это, но ваш критерий приёмки должен быть строгим: тесты должны проходить, диф должен быть сфокусированным, и никакая граница учётных данных или сети не должна быть нарушена. Выделите отдельную рабочую область и используйте принцип минимальных привилегий. Больше автономии без контроля даёт только более крупные трассы сбоев.
Длинные документы и работа со знаниями
Модели с миллионом токенов подходят для спецификаций, исследовательских пакетов и больших кодовых баз. Большое окно контекста не стоит считать надёжным извлечением информации. Размещайте ключевую информацию в начале, середине и конце; указывайте источники; проверяйте процитированную информацию. Я бы также рассмотрел конвейер извлечения как альтернативу, так как помещение всего в один большой промпт может оказаться медленнее и дороже, чем предварительный отбор полезных доказательств.
Мультимодальные и защитные рабочие процессы
С GLM-5.3-Flash или GLM-5V-Turbo скриншоты, состояния интерфейса или другие визуальные входные данные, необходимые для задачи, становятся частью привычной работы. Используйте все находки как подсказки для защитного аудита безопасности, воспроизводя и приоритизируя их. GLM-5 менее подходит тем, кто хочет небольшую модель для локального ноутбука, не может принимать решения о развёртывании или не способен проверить местоположение хостинга и условия хранения данных.
Безопасен ли GLM-5 для личных или корпоративных данных?
Хостинговые маршруты
Дело не только в модели — важен и маршрут доступа. Существуют разные пути данных: Z.ai Chat, API Z.ai, другой хостинг или самостоятельное развёртывание. Начните с политики конфиденциальности Z.ai, а затем уточните у всех посредников условия хранения, использования для обучения, удаления, локализации данных и контрактные условия.
Закрепите конкретного провайдера, если агрегатор это позволяет, и не отправляйте конфиденциальные данные только из удобства. То, что происходит с хостинговыми данными, определяется вашим договором и настройками, а не словосочетанием «открытые веса».
Самостоятельное размещение
При самостоятельном размещении промпты остаются в вашей среде, но вы отвечаете за веса, учётные данные, патчи, сетевые контроли и мониторинг. Я бы всё равно исходил из того, что существует способ внедрить ранний, небезопасный сгенерированный код. Разделяйте учётные данные для сборки и продакшна, ограничивайте исходящий сетевой доступ, проверяйте действия инструментов и сохраняйте человеческое одобрение для существенных изменений. Не давайте агентам больше прав, чем необходимо для задачи.
Как использовать GLM-5 с Enter Pro
GLM-5 не является прямым конкурентом Enter Pro. GLM предоставляет возможности модели, а Enter Pro — рабочий процесс создания продукта вокруг моделей. Это полезно, когда вам нужно не просто «получить завершение», а «получить завершение, которое можно превратить в интерфейс, логику и путь публикации».
Если требуется контроль API, индивидуальная инфраструктура или специфическая структура данных, прямой маршрут — лучший вариант. Когда продуктовый обходной путь становится ограничивающим фактором, в игру вступает Enter Pro. Его AI MVP Builder объединяет планирование, создание приложения, визуальное редактирование и публикацию в единый процесс, а Enter Code предлагает подход, ориентированный на терминал, для задач с репозиторием.
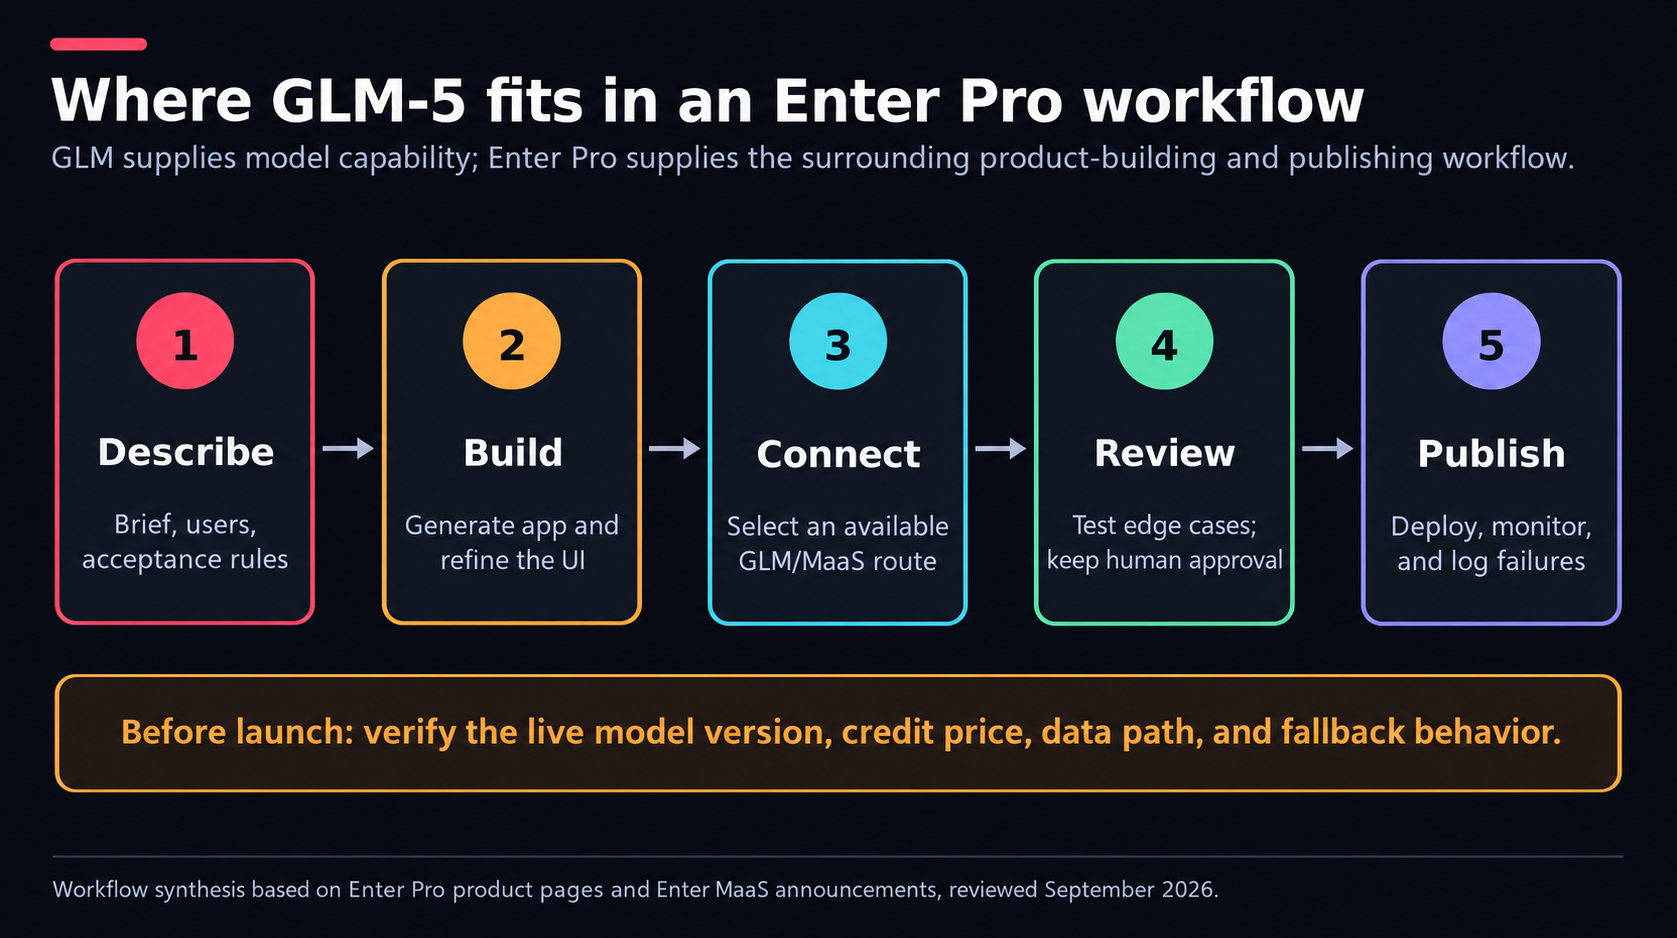
Рисунок 13. Модель генерирует или классифицирует; продуктовый рабочий процесс добавляет UI, проверку, развёртывание и мониторинг.
Чейнджлог Enter подтверждает наличие GLM-5.2 в предыдущем каталоге AI All от 17 июня. Анонс Enter MaaS упоминает GLM 5 и объясняет, как модели оцениваются в кредитах. Он не подтверждает явно GLM-5.3, поэтому стоит проверять актуальный селектор модели, цену в кредитах, лимит контекста и путь данных, прежде чем проектировать решение вокруг конкретной версии.
Приложение для триажа обращений в поддержку хорошо показывает, где эта комбинация оправдана. С Enter Pro вы можете спроектировать форму заявки и дашборд, а также подключить существующий маршрут GLM для категоризации обращений и составления ответов. Перед публикацией проверьте пустые ответы модели, неоднозначные запросы, многоязычный ввод, промпт-инъекции и личные данные внутри текста сообщения. Всегда держите человека между черновиком и кнопкой отправки.
| Если ваш приоритет… | Выберите прямой маршрут GLM | Выберите Enter Pro |
|---|---|---|
| Параметры модели и контроль провайдера | Да | Только в рамках предоставленных опций |
| Визуальное создание и редактирование приложений | Создавать или добавлять отдельные инструменты | Ключевое преимущество процесса |
| Индивидуальный хостинг и сетевая политика | Наилучшее соответствие | Сначала проверить соответствие платформы |
| Быстрый путь от вывода модели к UI продукта | Требуется больше инженерной работы | Более сильное соответствие |
Но Enter не делает GLM умнее, и доступ GLM к приложению не делает его агента для кодинга умнее. Если речь об интеграции или работе с UI, я бы выбрал Enter. Если вы в такой ситуации, откройте рабочее пространство Enter Pro и проверьте доступный каталог моделей, прежде чем определяться с архитектурой.
Заключение
Хотя модель называется GLM-5, вариант и способ подачи имеют такое же значение, как и сама модель, когда речь идёт о кодинге и агентах с длинным горизонтом работы! Используйте GLM-5.3 для сложного текста и кода, GLM-5.3-Flash для мультимодальности и/или большого объёма, и держите 5.2, пока миграция не станет экономически целесообразной. А затем протестируйте на собственных задачах, прежде чем использовать цифры лидера/вендора как доказательство для продакшна.
Модель, которая реально будет работать, — та, что действительно соответствует вашим критериям приёмки, укладывается в рамки вашей задержки и приватности и сохраняет приемлемую цену даже после повторных попыток, независимо от почти идеального балла, который она может показать в отдельном бенчмарке.
Начните создавать с Enter Pro →
Часто задаваемые вопросы
Бесплатен ли GLM-5?
Публичные веса доступны для скачивания без платы за токены API, но за оборудование и эксплуатацию придётся платить. Z.ai Chat может предоставлять доступ на основе квоты. Хостинговые API, маршрутизаторы и GPU-серверы — платные сервисы, и разница может зависеть от версии и маршрута.
Какая версия GLM-5 лучше?
Для сложного текста/кода я начинаю с GLM-5.3. GLM-5.3-Flash — лучший первый тест для изображений, скриншотов или объёма с критичной стоимостью. Не меняйте GLM-5.2, если он уже проверен и риск миграции превышает потенциальную выгоду.
Способен ли GLM-5 писать и отлаживать код?
Да. Агенты для кодинга и инженерия на уровне репозитория — ключевые сценарии использования, с хорошими результатами по данным производителей на Terminal-Bench и DeepSWE. Тем не менее всё равно нужны песочница, тесты, ограниченные права доступа и проверка человеком.
Сколько стоит API GLM-5?
В сентябре 2026 года Z.ai указывает цену GLM-5 в $1,00 за вход и $3,20 за выход на миллион токенов; GLM-5.3 — $1,40 и $4,40; а 5.3-Flash — $0,15 и $0,50. Кэшированный вход дешевле. На реальную стоимость влияют наценки провайдеров и повторные попытки.
Является ли GLM-5 программным обеспечением с открытым исходным кодом?
Термин «открытые веса» точнее. Лицензия на веса, лицензия на код репозитория и прозрачность обучающих данных — это разные вопросы. Перед коммерческим развёртыванием обязательно проверьте конкретную карточку модели на Hugging Face и лицензию репозитория.
Можно ли использовать GLM-5 локально (с Ollama)?
Только если у вас есть локальные веса, поддержка среды выполнения и достаточное оборудование для этого. Тег cloud означает, что выполнение происходит на удалённой инфраструктуре, а значит, не обязательно, что вся 744B-модель работает на вашем устройстве.
Способен ли GLM-5 обрабатывать изображения?
Базовая GLM-5 и GLM-5.3 работают только с текстом. Для мультимодального ввода используйте GLM-5.3-Flash или GLM-5V-Turbo; проверьте поддерживаемые типы файлов на выбранном эндпоинте.





