
GPT-5.2: функции, бенчмарки, цены и сценарии применения
Разбираем GPT-5.2 Instant, Thinking, Pro и Codex: цены, бенчмарки, доступ, ограничения и сравнение с Gemini 3 для разработчиков в 2026 году.
Рисунок 1. Оценка GPT-5.2 по качеству, скорости, стоимости и управляемости
Я выбрал GPT‑5.2 Pro в Enter Pro, чтобы собрать инструмент для проверки проектных брифов, превращающий идеи приложений в требования и критерии приёмки. Скриншоты показывают настройку и результат проверки; верификация завершённого запроса остаётся открытым шагом.
Этот практический кейс даёт данному руководству конкретную точку отсчёта. Я отделяю официальные результаты бенчмарков от того, что реально показало приложение, а затем рассматриваю возможности, цены и ограничения семейства моделей. Перед тем как применять наблюдение к Instant, Thinking, Pro или Codex, нужно определить точный вариант модели.
OpenAI представила семейство 11 декабря 2025 года как релиз для профессиональной работы и долгоживущих агентов. Её отчёт о запуске даёт официальную базовую линию по бенчмаркам и ценам. Я использую этот отчёт вместе с актуальной информацией о роутинге, важной независимой экспертизой и отзывами сообщества, потому что ни один отдельный источник не охватывает одновременно контролируемую производительность и повседневные трудности.
Те, кто ищет Chat GPT 5.2, часто имеют в виду всё семейство декабря 2025 года, но различие между режимами ChatGPT и идентификаторами моделей API имеет значение. Тест Instant не определяет поведение, цену или задержку Thinking, Pro или модели, специализированной на коде.
GPT-5.2 в общих чертах
На 9 октября 2026 года OpenAI указывает GPT‑5.2 и GPT‑5.2 Pro как опции предыдущего поколения. Существующие проекты могут ценить их известное поведение и закреплённые снапшоты, тогда как новый проект должен сравнивать текущие рекомендуемые модели по тем же критериям приёмки.
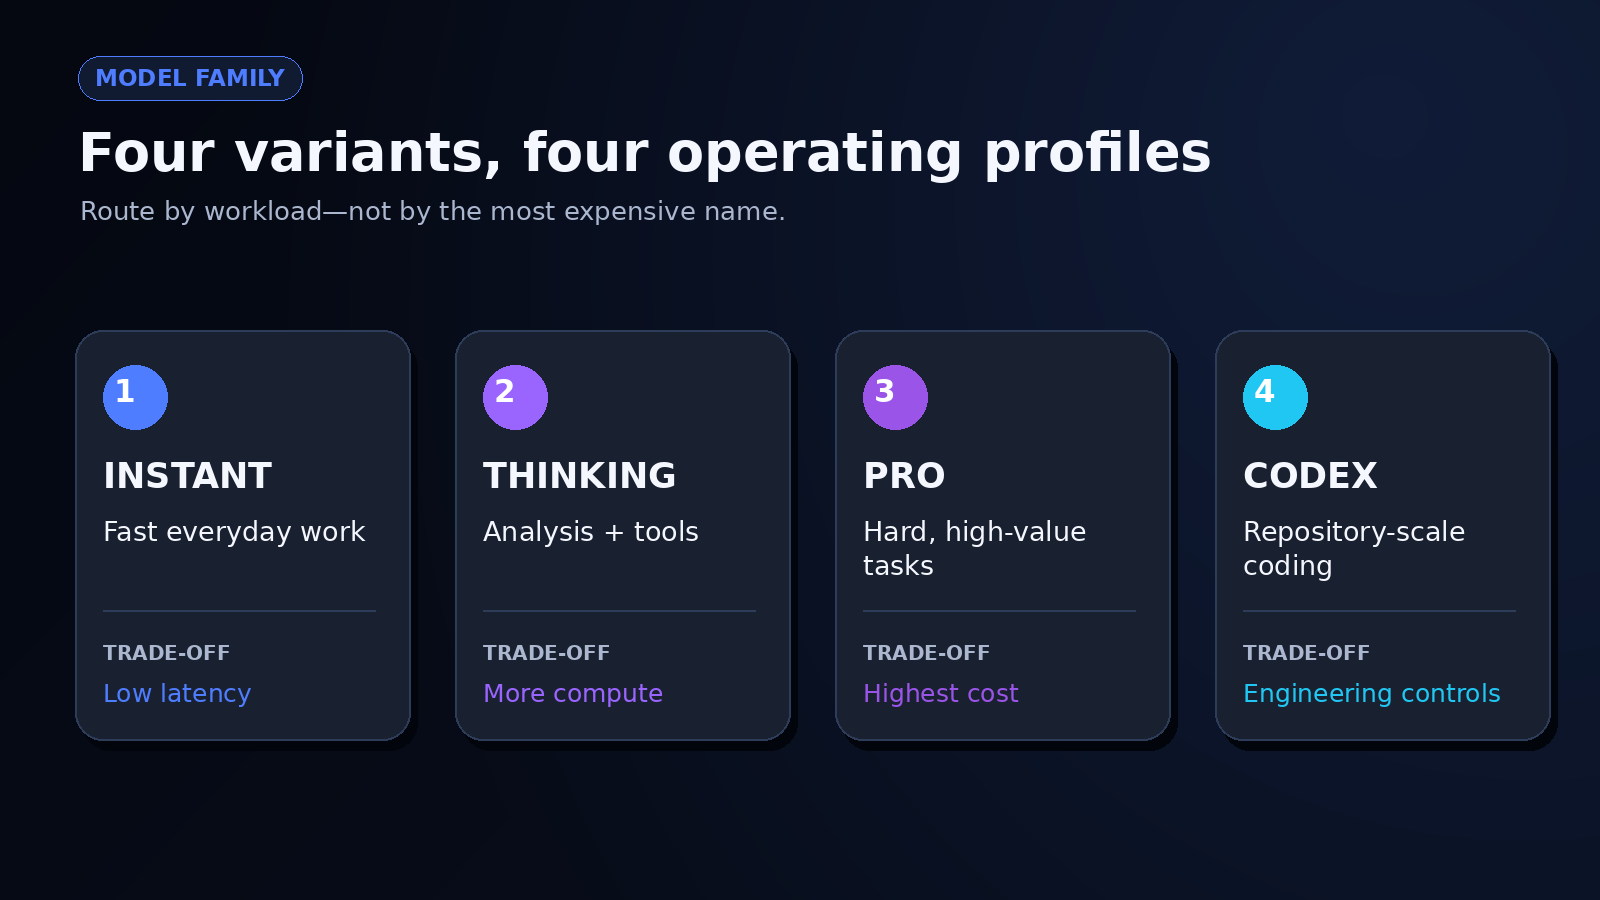
Рисунок 2. Instant, Thinking, Pro и Codex в соответствии с типами задач
| Характеристика | GPT-5.2 | GPT-5.2 Pro |
|---|---|---|
| Текущая позиция | Предыдущий флагман | Предыдущая Pro-модель |
| Контекстное окно | 400 000 токенов | 400 000 токенов |
| Максимальный вывод | 128 000 токенов | 128 000 токенов |
| Дата отсечки знаний | 31 августа 2025 | 31 августа 2025 |
| Модальности | Текст вход/выход; изображение на входе | Текст вход/выход; изображение на входе |
| Уровень рассуждений | нет, низкий, средний, высокий, очень высокий | средний, высокий, очень высокий |
| Цена API за 1 млн токенов | $1,75 вход; $0,175 кэш; $14 выход | $21 вход; $168 выход |
| Структурированный вывод | Поддерживается | Не поддерживается |
| Fine-tuning | Не поддерживается | Не поддерживается |
| Снапшот | gpt-5.2-2025-12-11 | gpt-5.2-pro-2025-12-11 |
Текущий статус, контекст и модальности
Контекстное окно в 400 000 токенов и потолок вывода в 128 000 токенов — необычно большие значения, но объём не равен точности воспроизведения. Если вы поместите контракты, логи, скриншоты и требования в один запрос, вам всё равно понадобится тест на извлечение данных: разместите факты в разных позициях, задайте вопросы, требующие их комбинирования, и зафиксируйте, что модель упускает. Я бы не стал делать вывод о надёжном рассуждении по длинным документам только на основании цифры контекста.
Модели принимают изображения и выдают текст; они не принимают аудио или видео как нативный ввод. Это делает их полезными для графиков, скриншотов интерфейсов, диаграмм и отсканированных документов — при условии, что вы проверяете пространственные детали и извлечённые значения. Размытая подпись или нестандартный масштаб графика могут превратить уверенное объяснение в правдоподобную ошибку.
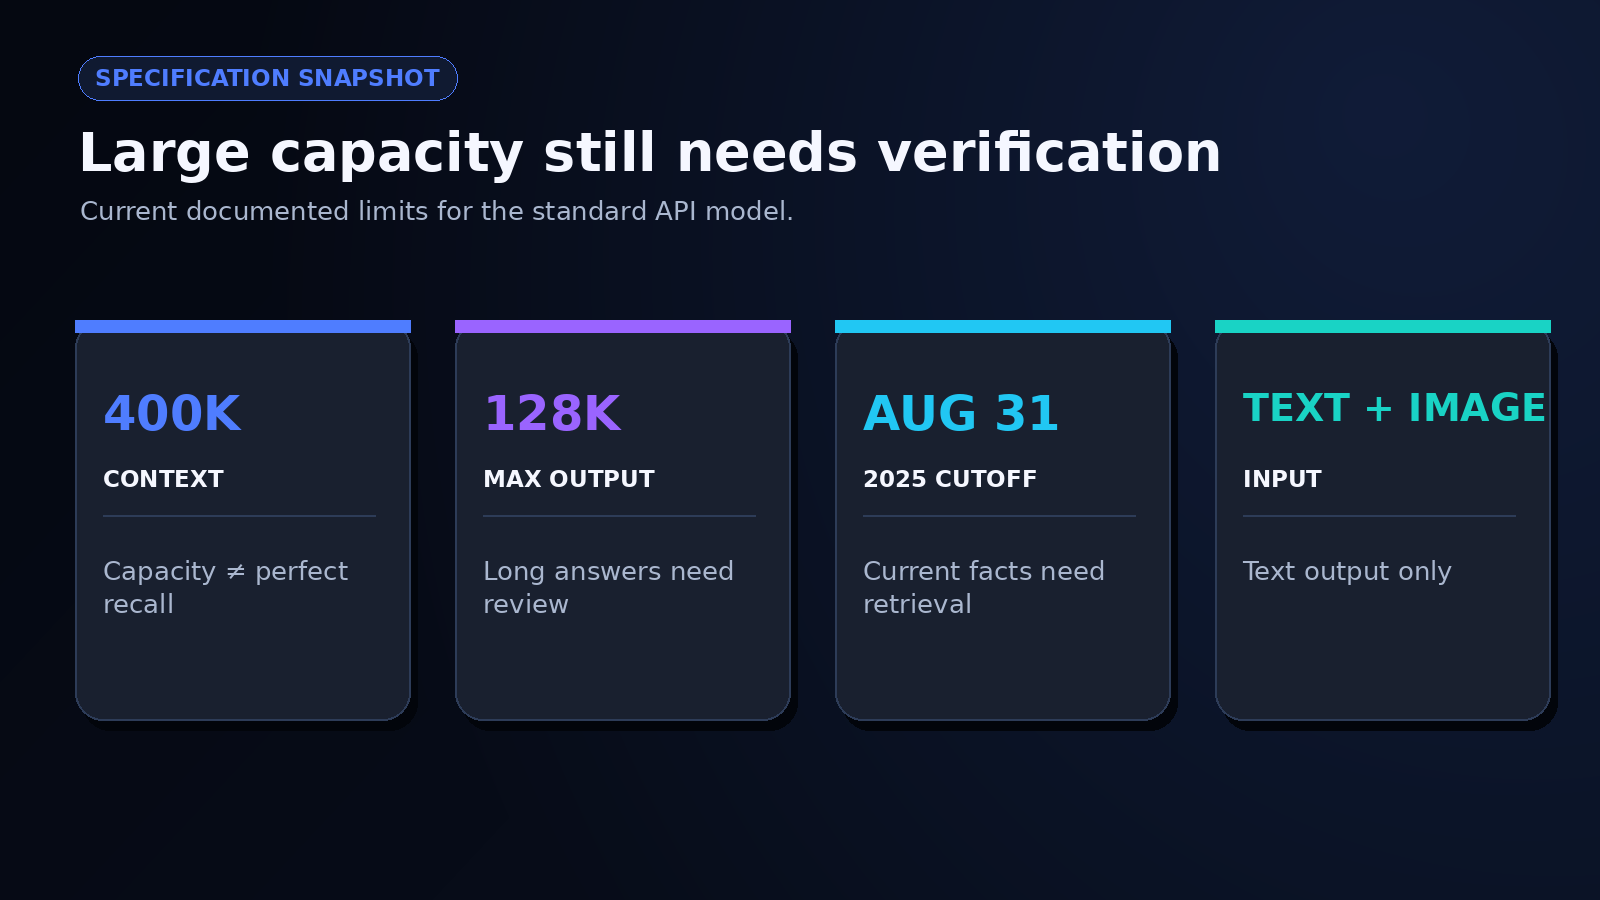
Рисунок 3. контекст, вывод, модальности, отсечка знаний и снапшоты
Цены API и доступ
Стандартная модель API стоит $1,75 за миллион входных токенов, $0,175 за миллион кэшированных входных токенов и $14 за миллион выходных токенов. GPT 5.2 Pro стоит $21 на входе и $168 на выходе. Токены рассуждений, повторные попытки, вызовы инструментов и человеческая корректировка влияют на стоимость принятого результата. При использовании платформы интеграции проверьте её единицы тарификации отдельно, прежде чем сравнивать их с долларовыми ставками OpenAI.
Текущую маршрутизацию провайдеров и доступность можно посмотреть на странице GPT‑5.2 в OpenRouter. Я бы считал стоимость за выполненную задачу, а не за запрос. Более дешёвый ответ, который дважды не проходит валидацию, может стоить дороже, чем более дорогой ответ, проходящий с первого раза.
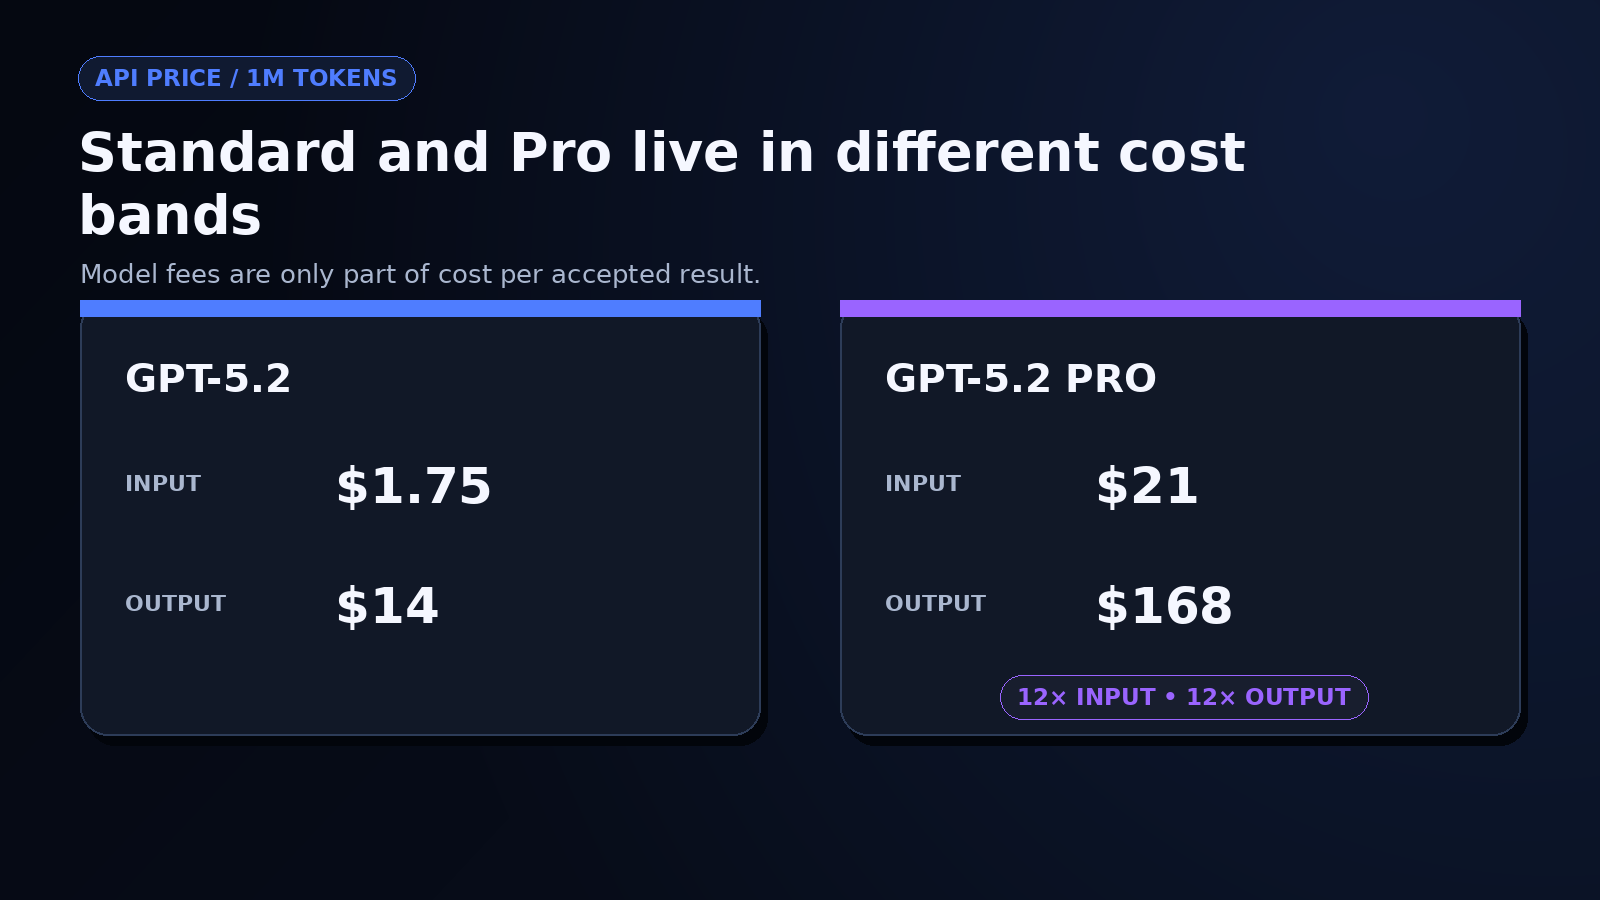
Рисунок 4. стандартная стоимость против Pro за миллион токенов
Что изменилось в релизе GPT-5.2 от OpenAI?
Релиз GPT-5.2 от OpenAI был ориентирован на работу, которая продолжается дальше одного ответа: создание артефактов, изучение длинных документов, использование инструментов, написание и проверка кода, рассуждения над изображениями и выполнение многошаговых профессиональных задач. Он также более чётко разделил быстрый чат, глубокое рассуждение и ресурсоёмкую работу, чем предполагает единая маркировка модели.
Instant, Thinking и Pro ориентированы на разные типы задач
Instant был приоритизирован для повседневных вопросов, объяснений, перевода и быстрых набросков. Thinking был ориентирован на анализ, программирование, файлы, планирование и использование инструментов. Pro тратил больше вычислений на сложные задачи, где более долгое ожидание и значительно более высокий счёт за API могли быть оправданы.
| Режим или модель | Практическое применение | Главный компромисс |
|---|---|---|
| Instant | Рутинные вопросы и чувствительная к задержке работа | Меньше размышлений при сложных многошаговых задачах |
| Thinking | Анализ, программирование, длинные файлы и workflow с инструментами | Больше задержки и расхода токенов |
| Pro | Сложные задачи, где инкрементальное качество ценно | Очень высокая стоимость; ответы могут занимать минуты |
Я бы маршрутизировал по риску, а не по престижу. Шаг классификации может требовать быстрой модели со строгой схемой. Проверка финансовой модели может оправдывать более глубокое рассуждение. Если вы отправляете каждый запрос в Pro, вы скрываете, какие задачи действительно получают выгоду от дополнительных вычислений, и значительно усложняете контроль затрат.
Профессиональная работа и использование инструментов были центральными в релизе
OpenAI сделала акцент на таблицах, презентациях, фронтенд-разработке, код-ревью, анализе документов, науке, математике и вызовах инструментов. В оценке, проведённой поставщиком на деидентифицированных запросах ChatGPT, ошибки на уровне ответов были зафиксированы как относительно на 30% менее частые, чем у GPT‑5.1 Thinking. В отчёте о релизе также отмечается, что оценку ошибок выполняли сами модели, поэтому я воспринимаю эту цифру как направленное свидетельство, а не как независимую гарантию.
Практическое улучшение не означает «модель знает всё». Это более высокая вероятность того, что хорошо специфицированная задача переживёт несколько шагов без потери структуры. Вам всё равно нужны наблюдаемые контрольные точки: какой инструмент запускался, какие данные он получил, что изменил и как рабочий процесс восстановился после неудачного вызова.
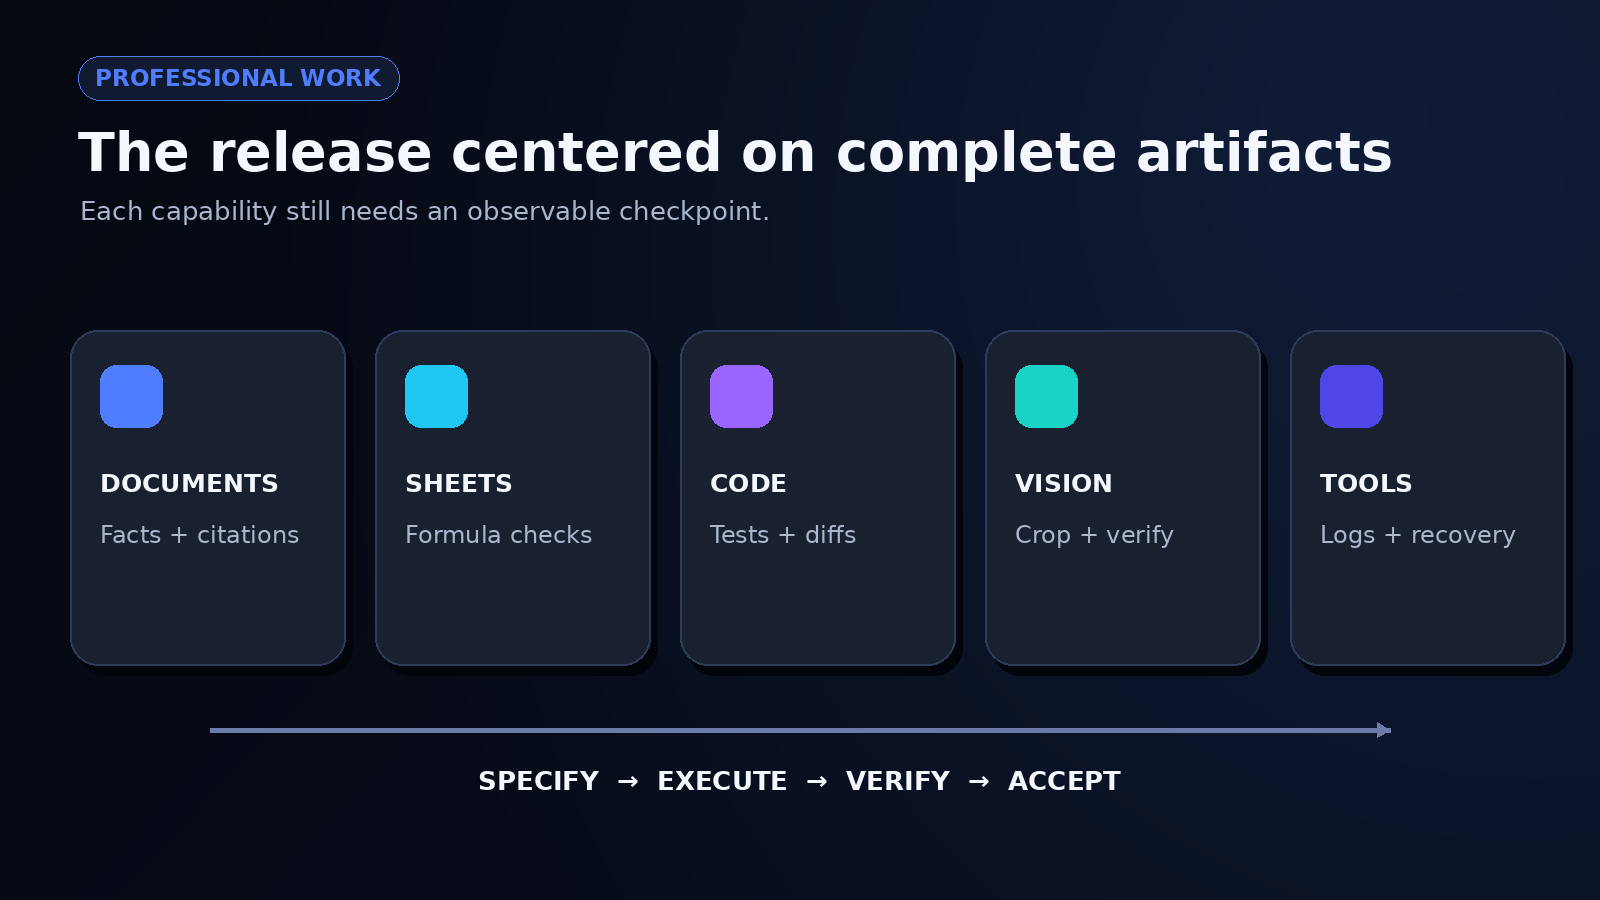
Рисунок 5. панели таблиц, кода, документа, изображения и вызова инструмента
Бенчмарки запуска показали широкие, но неравномерные сильные стороны
| Бенчмарк | GPT-5.2 Thinking | Что измеряет |
|---|---|---|
| Победы или ничьи GDPval | 70,9% | Хорошо специфицированные профессиональные задачи в 44 профессиях |
| SWE-Bench Pro публичный | 55,6% | Многоязычные задачи по программной инженерии |
| SWE-bench Verified | 80,0% | Проверенные задачи на репозиториях Python |
| GPQA Diamond | 92,4% | Научные вопросы уровня аспирантуры без инструментов |
| AIME 2025 | 100,0% | Соревновательная математика без инструментов |
| ARC-AGI-2 Verified | 52,9% | Новые задачи на абстрактное рассуждение |
Разброс — это полезная часть. Он показывает сильные результаты без подтверждения равномерного мастерства. Результат 80% на проверенных Python-задачах не предсказывает ваш процент успеха на TypeScript-монорепозитории с нестандартными правилами деплоя. Аналогично, научный бенчмарк не устанавливает надёжное юридическое или медицинское суждение.
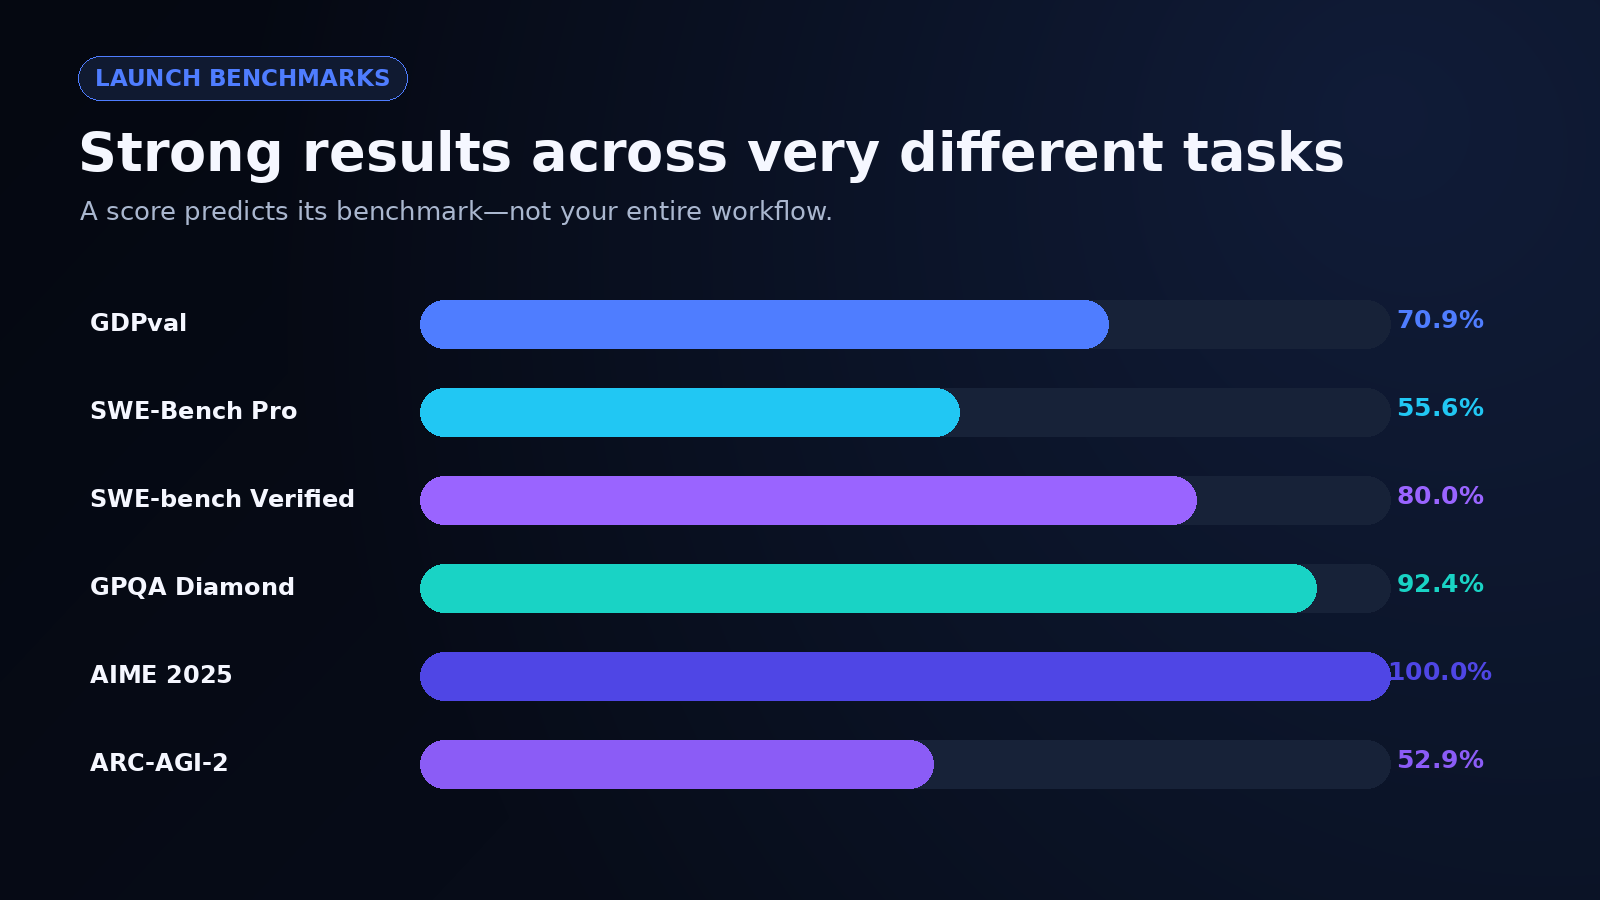
Рисунок 6. шесть результатов запуска с категориями задач
Читайте бенчмарки GPT-5.2 вместе с его ограничениями
Публичные оценки сжимают множество решений в одно число: формат промпта, инструменты, уровень рассуждений, выбор тестов, поведение оценщика и политика повторов. Ваш production-процесс добавляет качество данных, разрешения, лимиты задержки и человеческую проверку. Я считаю бенчмарки наиболее полезными для выбора того, что тестировать, а не для того, чтобы пропускать тест.
Что фактически показала моя проверка приложения
Инструмент проверки проектных брифов отображал отправленные инструкции под заголовками «Сводка проекта» и «Основные требования», пока ответ ещё передавался потоково. Входные данные запрашивали проверки реализации, но видимый результат организовал этот запрос как бриф. Он не сообщил о завершённой проверке кода или результатах тестов.
Отдельное представление сессии не содержало зарегистрированных запросов или использования, оставляя время ответа, маршрутизацию и стоимость неподтверждёнными. Завершите запрос с ограниченным брифом, чтобы закончить проверку.
Оценки бенчмарков — это не гарантии production
Начните с 20–50 репрезентативных задач и определите критерии приёмки перед их выполнением. Для кода это может включать процент прохождения тестов, размер diff, результаты проверки безопасности и безопасность откатов. Для работы с документами это может включать фактическую точность, покрытие цитатами, ошибки вычислений и время редактирования. Запустите тот же набор несколько раз, потому что вариативность имеет значение.
Затем измерьте стоимость на принятый результат. Предположим, одна модель стоит $0,18 за запуск и проходит 60% случаев, а другая стоит $0,28 и проходит 90%. До человеческой корректировки их ожидаемая стоимость на принятый результат составляет $0,30 и около $0,31 соответственно. После того как вы оцените время проверки в деньгах, вторая модель может оказаться заметно дешевле — или нет. Эта арифметика возвращает решение обратно в ваш рабочий процесс.
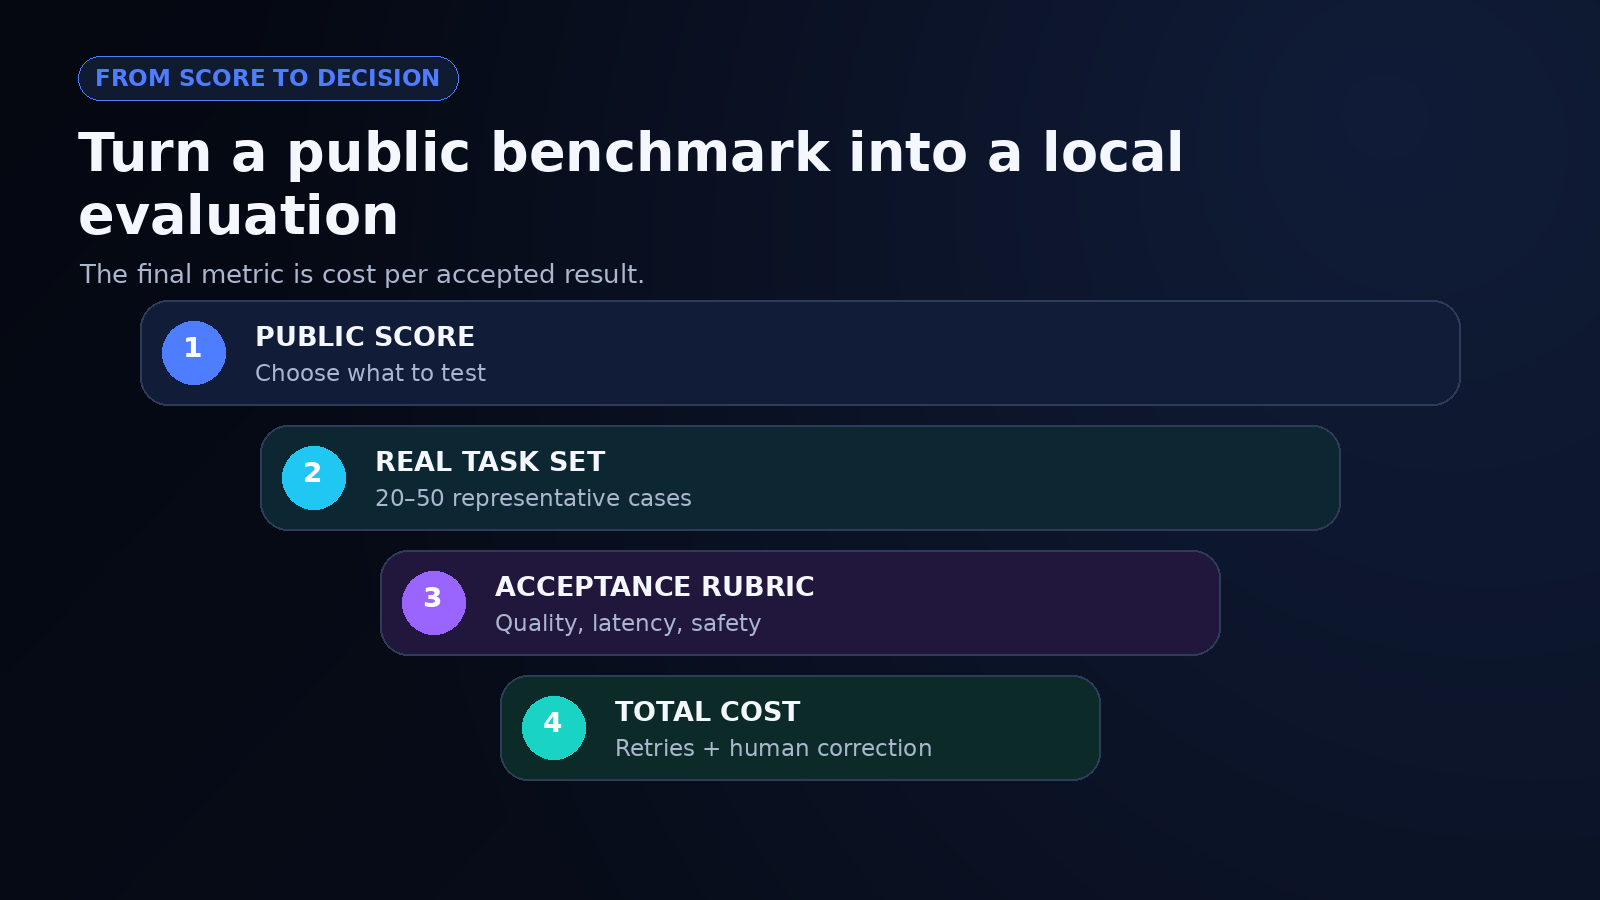
Рисунок 7. от оценки бенчмарка к репрезентативным задачам и стоимости принятого результата
Длинный контекст и ввод изображений всё ещё требуют проверки
Длинное контекстное окно может сократить необходимость разбивки на части, но также делает упущения труднее заметными. Я бы протестировал извлечение данных из начала, середины и конца набора файлов; потребовал бы цитаты или идентификаторы записей для критических фактов; и пересчитал бы вычисления вне модели. Для изображений обрежьте релевантную область и задайте вопрос явно, а не ждите, что модель угадает, что важно.
Независимая критика также может выявить сбои, которые пост о запуске не выделит на передний план. Один практический разбор описывает неудовлетворительные результаты в задачах автора. Это не опровергает результаты бенчмарков; это показывает, почему ваш промпт, нагрузку и порог приёмки нужно воспроизвести напрямую.
Рисунок 8. свидетельства, распределённые по потоку документов на 400 тыс. токенов
Работа с высокими рисками требует защитных механизмов конкретной области
Дата отсечки знаний 31 августа 2025 года означает, что актуальные факты требуют извлечения. Модели всё ещё могут придумывать источники, упускать требования, неверно читать скриншоты или генерировать небезопасный код. Они также не поддерживают fine-tuning, поэтому командам, нуждающимся в глубоко настроенном поведении, нужно полагаться на промптинг, извлечение данных, инструменты, валидацию или другую модель.
Нужно отделять помощь от полномочий. Модель может резюмировать контракт, пометить подозрительную транзакцию или предложить патч. Квалифицированный человек или детерминированный контроль должны принимать юридические, медицинские, финансовые, связанные с безопасностью и production-решения. Записывайте доказательства и сохраняйте чёткий путь для отклонения или отката результата.
Что такое GPT-5.2-Codex и как разработчикам её использовать?
GPT 5.2 Codex — специализированный на коде член семейства, созданный для более долгой работы по программной инженерии, а не для изолированного автодополнения. Полезное различие — глубина рабочего процесса: понимание репозитория, планирование изменения, редактирование нескольких файлов, запуск инструментов, изучение сбоев и доработка патча.
Наиболее подходящие задачи программирования
Хорошие кандидаты включают исследование репозитория, реализацию функций, исправление багов, рефакторинг, создание тестов, код-ревью и миграции с явными критериями приёмки. Я бы дал модели наименьшую связную цель, которая всё же включает реальную границу зависимостей. Искусственно крошечный промпт может дать чистый локальный diff, который ломает окружающую систему.
Вы можете оценивать GPT 5.2 Codex на повторяемом наборе репозиториев: известные проблемы, скрытые тесты, линтинг, политика зависимостей, проверки безопасности и максимально допустимый diff. Записывайте количество вызовов инструментов, корректировок и вмешательств рецензента. Патч не успешен только потому, что компилируется.
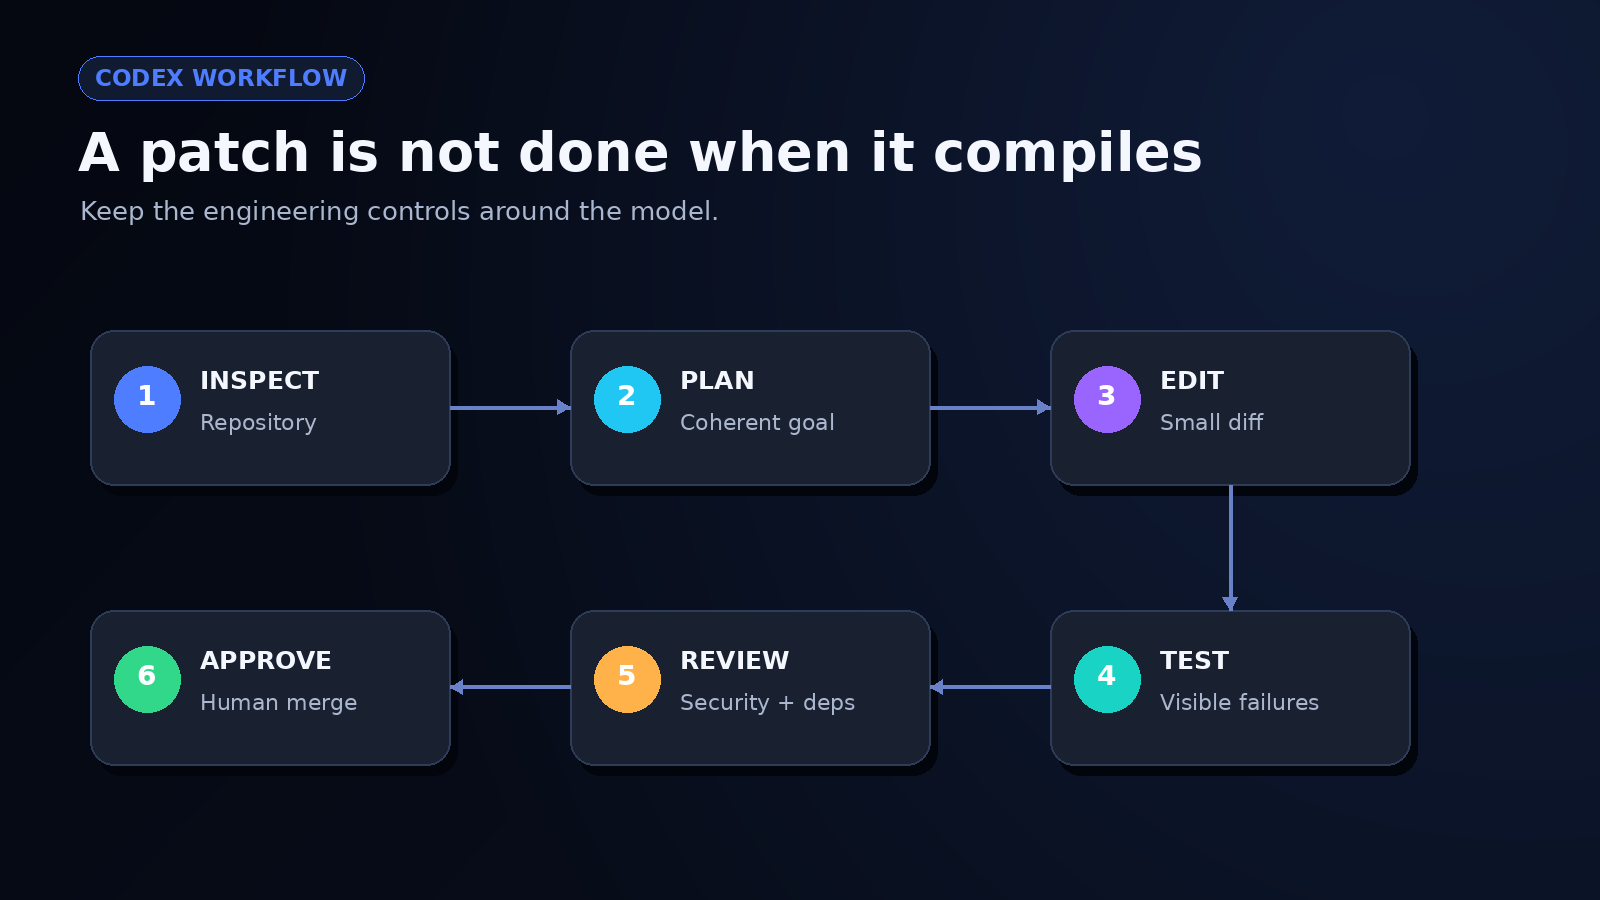
Рисунок 9. изучить, спланировать, отредактировать, протестировать, проверить и утвердить
Защитные меры production всё ещё применимы
Держите изменения достаточно маленькими для проверки, закрепляйте снапшот модели, когда важна воспроизводимость, и ограничивайте инструменты минимально необходимыми привилегиями. Запускайте тесты репозитория, сканирование зависимостей, обнаружение секретов, статический анализ и человеческую проверку diff. Если агент может деплоить, удалять данные или менять учётные данные, поставьте эти действия за явное подтверждение.
Я также предпочитаю бюджет на ошибки: определите, сколько повторов, минут или токенов может потратить задача, прежде чем вернуться к человеку. Без такой границы агент может выглядеть продуктивным, пока крутится в цикле всё более спекулятивных исправлений.
GPT-5.2 против Gemini 3 зависит от конкретной задачи
GPT-5.2 против Gemini 3: лучшая модель ИИ зависит от задачи — программирование, рассуждение, письмо или исследование.
Честный ответ на «GPT 5.2 против Gemini 3» — это дизайн теста, а не универсальный победитель. Нужно фиксировать точные варианты, даты, инструменты, размеры контекста, настройки рассуждений и цены. Иначе сравнение может незаметно дать одной модели поиск, выполнение кода или больший временной бюджет.
| Фактор решения | Вопрос для тестирования |
|---|---|
| Качество вывода | Какая модель чаще проходит вашу рубрику задач? |
| Программирование | Какая даёт более высокий процент прохождения тестов с меньшими и безопаснее diff? |
| Длинный контекст | Какая точнее извлекает и комбинирует факты из ваших файлов? |
| Использование инструментов | Какая завершает рабочий процесс с восстанавливаемыми сбоями и пригодными логами? |
| Задержка | Каковы медианное и 95-перцентильное время ответа? |
| Стоимость | Какова общая стоимость на принятый результат после повторов и коррекции? |
| Управление | Какие контроли данных, хранения, региона и аудита подходят вашему сценарию? |
Проведите одинаковую сравнительную оценку
Дайте обеим моделям одинаковые промпты, исходные файлы, инструменты, временной бюджет и рубрику оценки. Случайным образом перемешайте порядок задач и, где возможно, скройте название модели от рецензентов. Повторяйте репрезентативные случаи вместо выбора одного красивого ответа. Реакции сообщества в обсуждении запуска GPT‑5.2 полезны для обнаружения жалоб, которые стоит протестировать, но это не контролируемые сравнения.
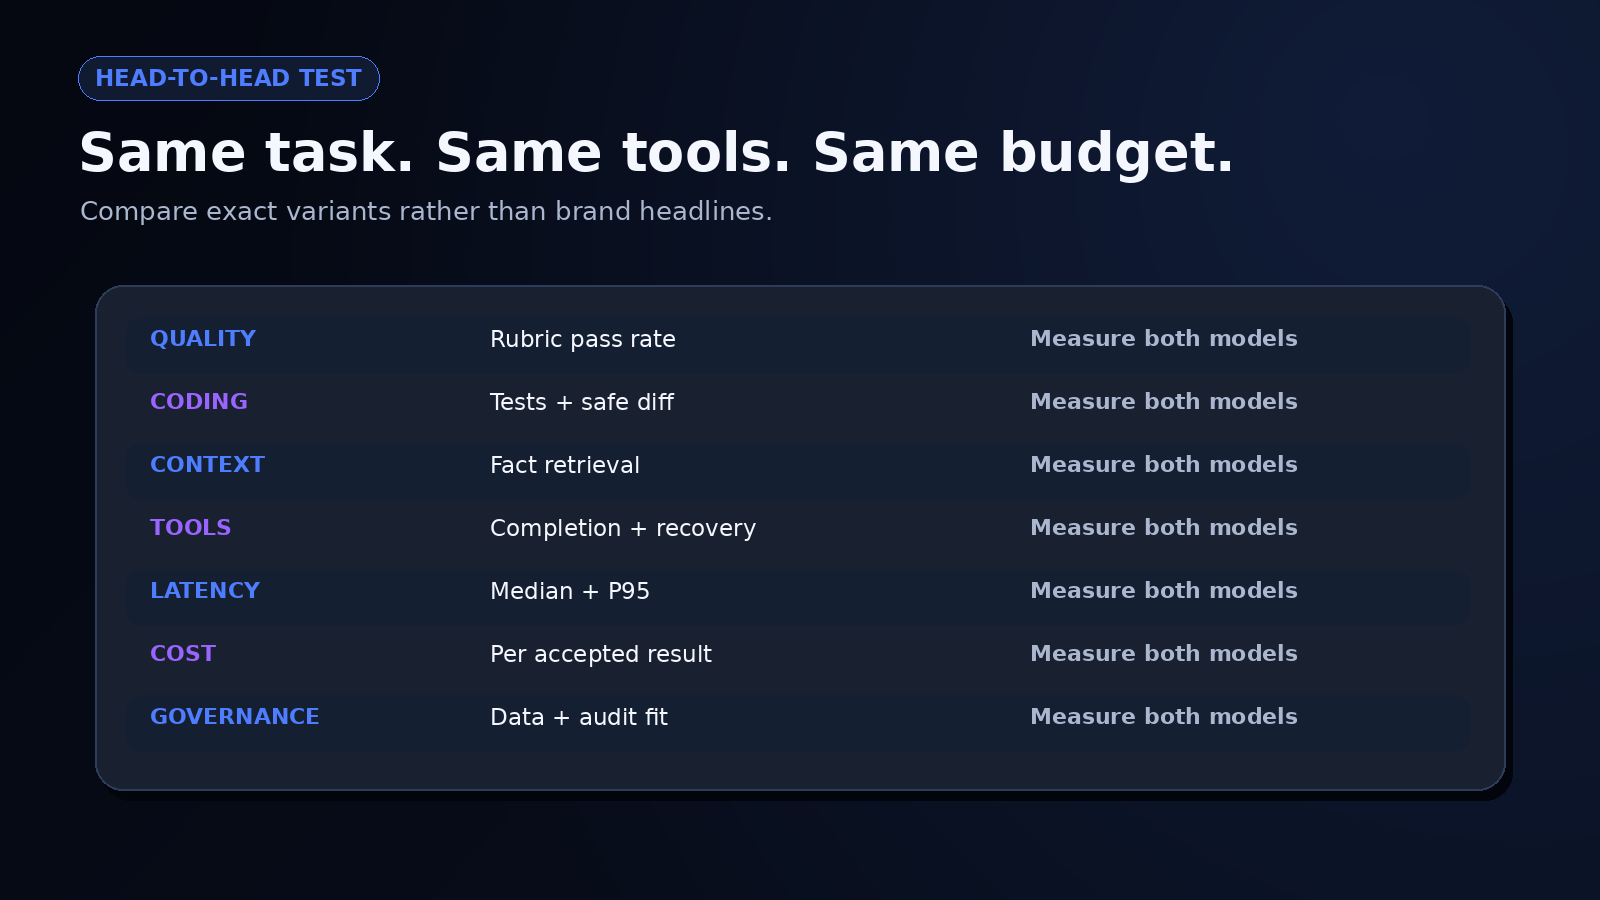
Рисунок 10. качество, программирование, контекст, инструменты, задержка, стоимость и управление
Выбирайте рабочий процесс с меньшим риском, а не лучший заголовок
Победитель может отличаться по шагам. Одна модель может хорошо планировать, другая — выдавать более чистый код, а меньшая опция может обрабатывать классификацию за долю стоимости. Правильная архитектура может маршрутизировать работу, а не заставлять одну модель делать всё.
Для оценки GPT 5.2 против Gemini 3 я бы выбрал самую простую комбинацию моделей, которая соответствует порогу качества и остаётся наблюдаемой при сбое. Каждый дополнительный провайдер или резервный вариант добавляет логику маршрутизации, работу по оценке, проверку приватности и сложность инцидентов. Разнообразие моделей полезно, когда оно снижает измеримый риск.
Создайте приложение с GPT‑5.2 Pro в Enter Pro
Я использовал конструктор AI-приложений Enter Pro, чтобы создать инструмент проверки проектных брифов на базе ИИ, выбрав GPT‑5.2 Pro в качестве интеграции. Цель заключалась в превращении грубой идеи приложения в требования, недостающую информацию, приоритеты и критерии приёмки.
Выберите GPT‑5.2 Pro и посмотрите тарифы
Я нашёл GPT‑5.2 Pro в каталоге моделей и открыл его детали. Панель показывала кнопку Интегрировать и тарифы** 2,1 кредита за 1000 входных токенов** и** 16,8 кредита за 1000 выходных токенов**. Это зафиксированные тарифы платформы.
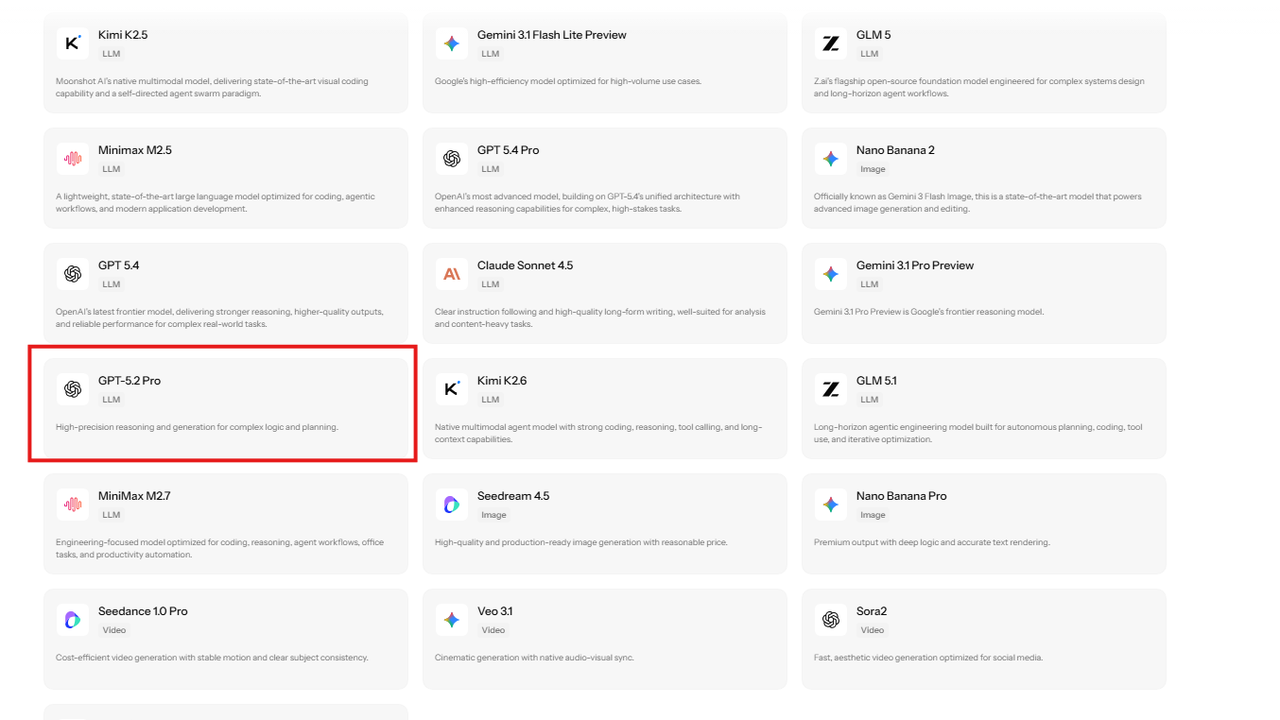
Рисунок 11. GPT‑5.2 Pro появляется в каталоге моделей среди других доступных интеграций.
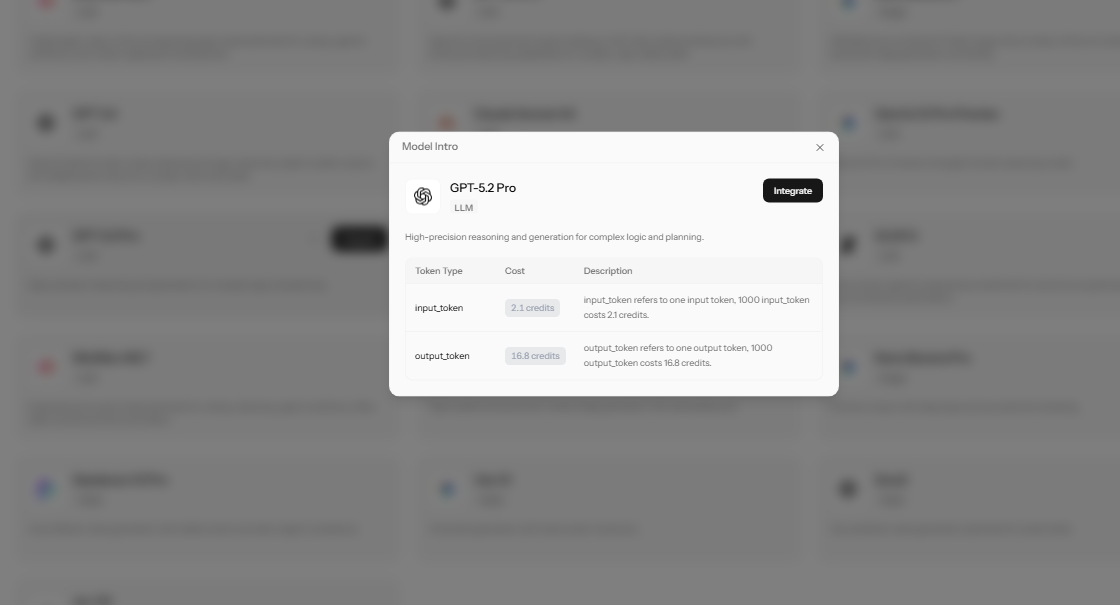
Рисунок 12. Панель деталей GPT‑5.2 Pro показывает элемент управления «Интегрировать» и тарифы в кредитах.
Подключите модель и опишите приложение
Запрос проекта имел подключённый чип GPT‑5.2 Pro. Я попросил большое поле брифа, кнопку Проверить бриф, и ответы, организованные в пять разделов: сводка проекта, основные требования, противоречия и недостающая информация, приоритеты реализации и критерии приёмки. Запрос также требовал настоящих состояний загрузки и ошибок.
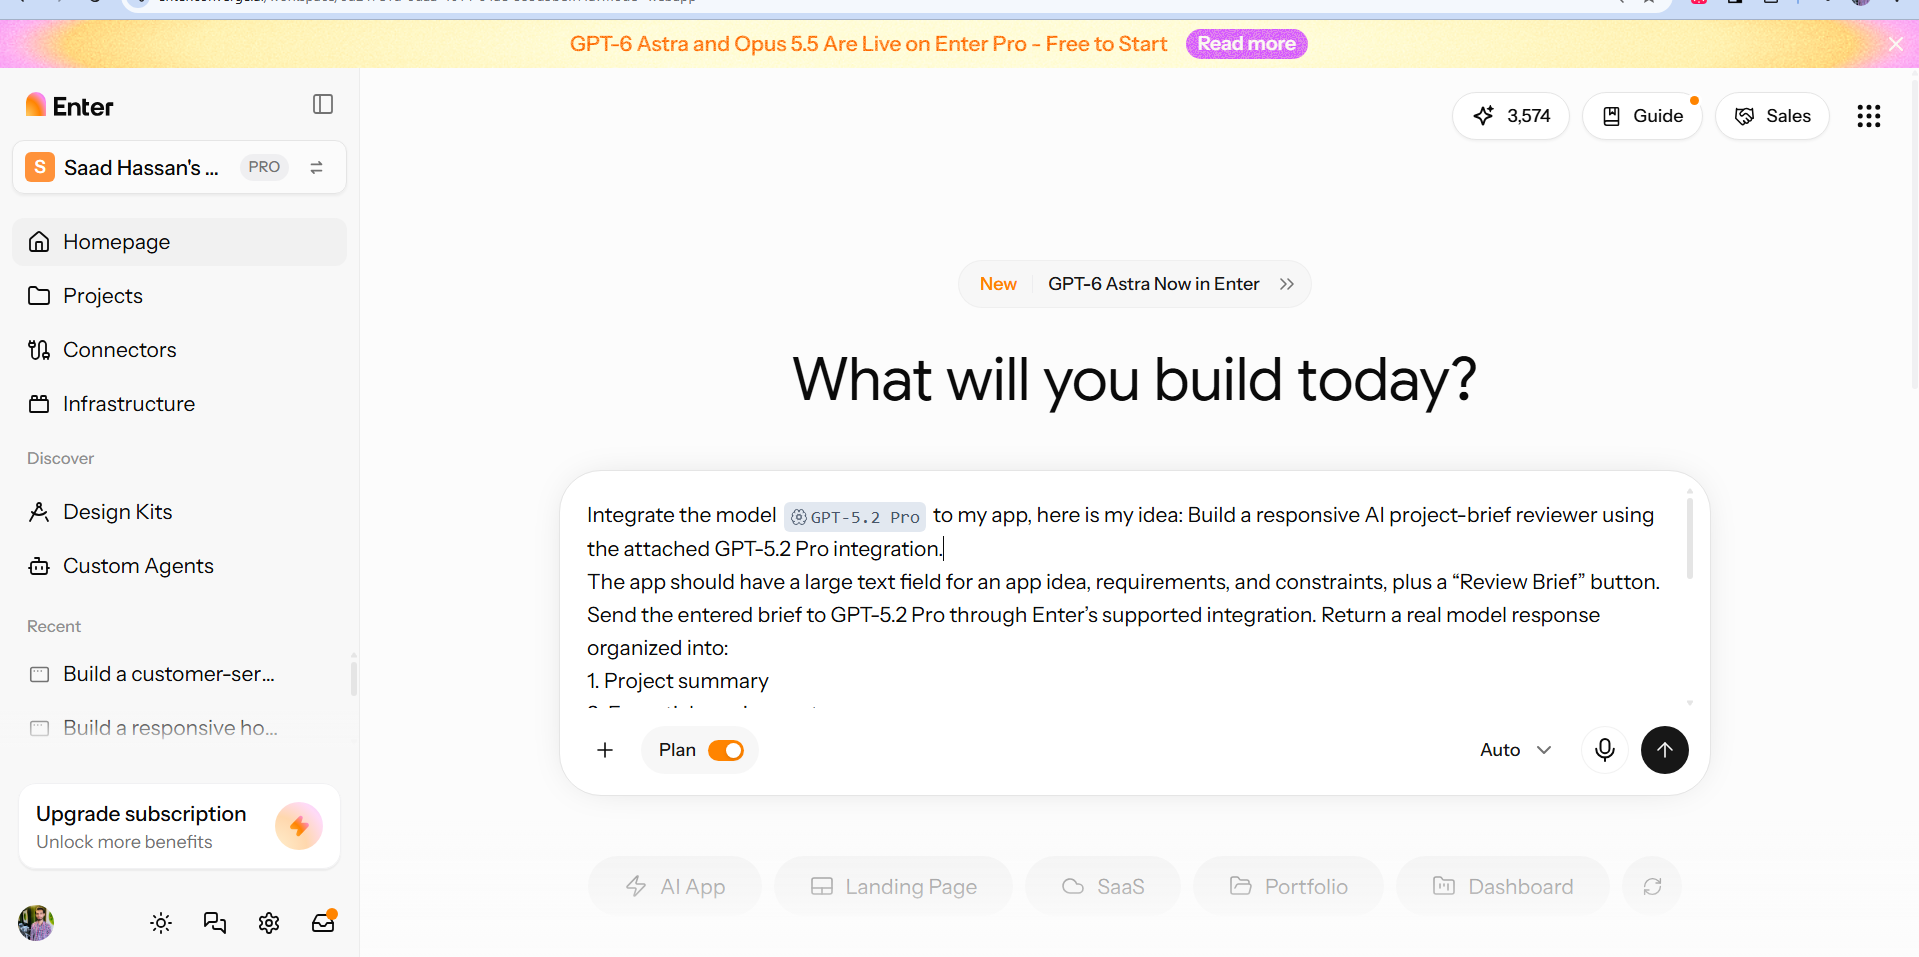
Рисунок 13. Промпт проекта подключает GPT‑5.2 Pro и определяет назначение и структуру ответа инструмента проверки.
Изучите план сборки
Enter сгенерировал план интерфейса на Vite, React и Tailwind с backend-функцией, обрабатывающей запрос к ИИ. Он указывал потоковые результаты, текст на простом языке и отсутствие сохранённой истории проверок. Хранение приватных учётных данных на backend было частью плана. Этот скриншот фиксирует предложенную реализацию.
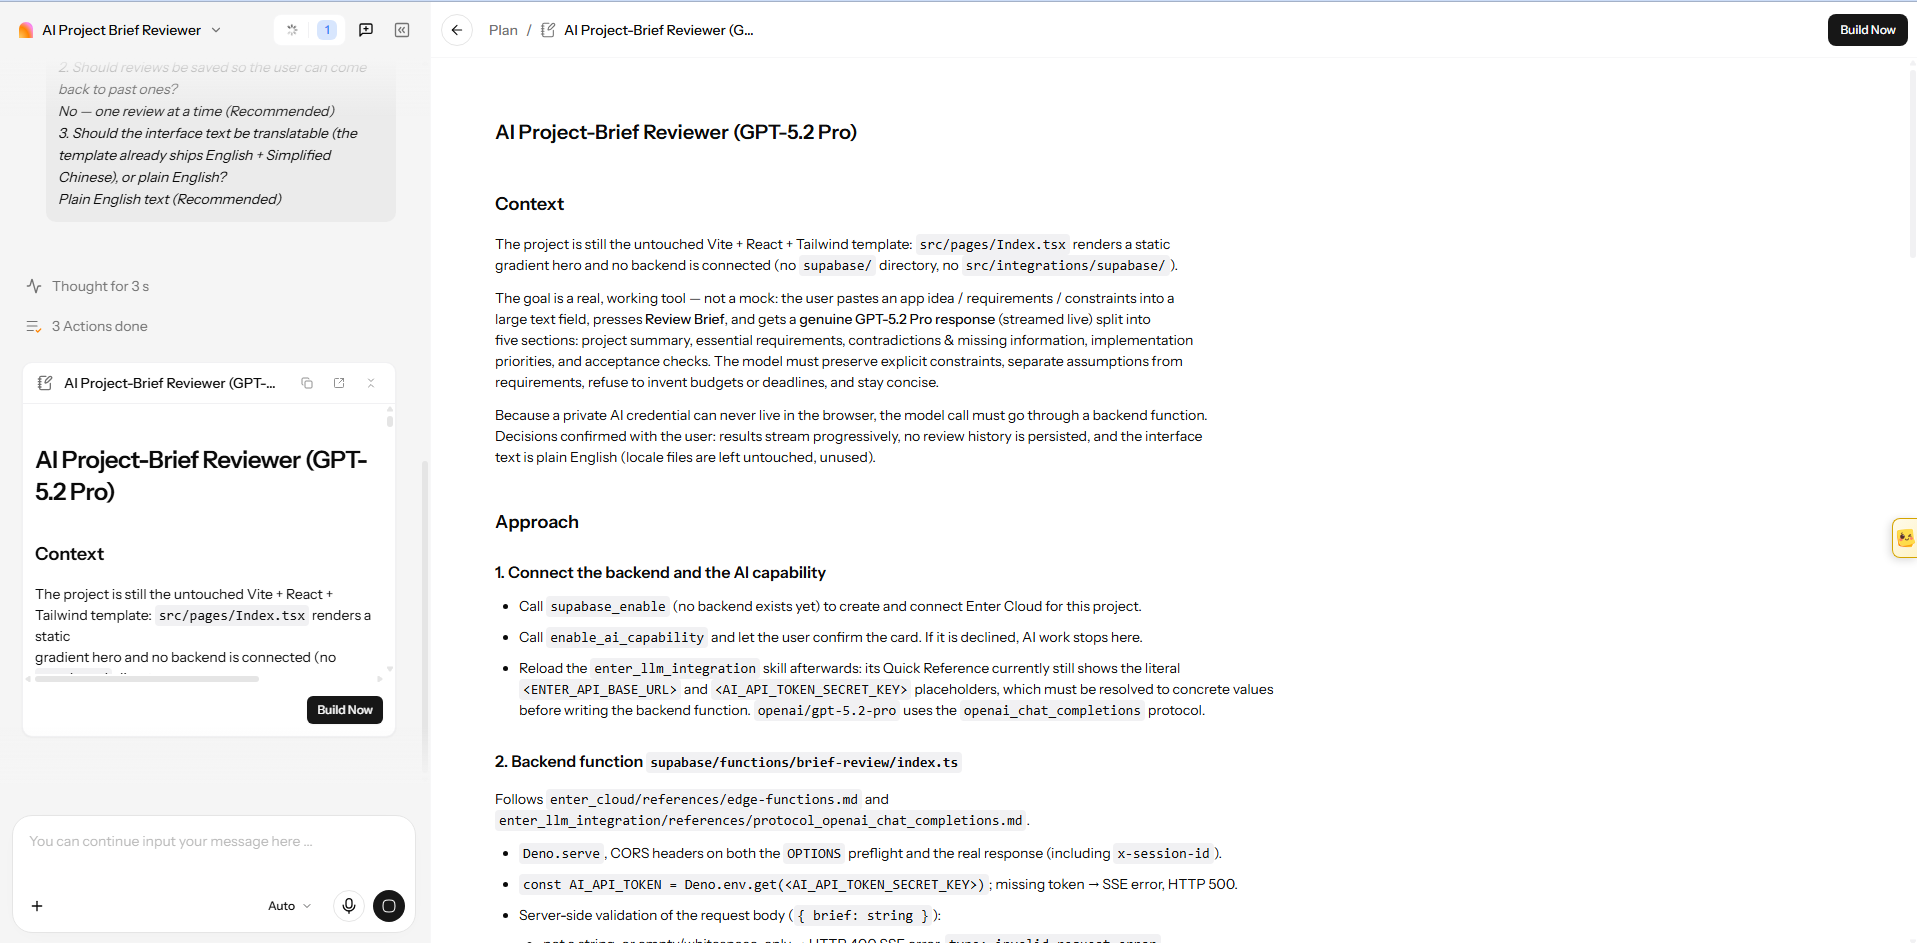
Рисунок 14. План сборки описывает интерфейс, запрос backend, потоковый вывод и обработку учётных данных.
Изучите видимую проверку
Инструмент проверки показывал поле брифа рядом со своими панелями ответа. В зафиксированной попытке я ввёл запрос проверки реализации в это поле. Ответ реорганизовал свои требования под запрошенными заголовками, при этом Streaming review и** Reviewing** оставались видимыми. Это демонстрировало организацию ответа, при том что завершённость и корректность ещё предстоит проверить.
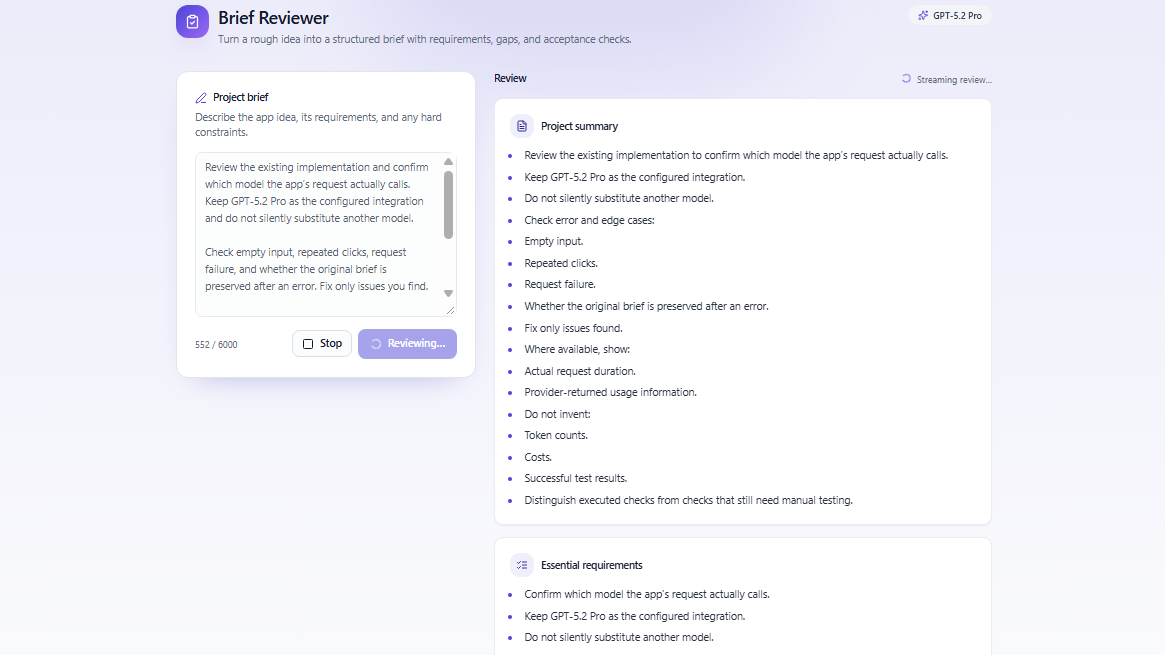
Рисунок 15. Текст проверки появляется под запрошенными заголовками, а интерфейс всё ещё показывает активный ответ.
Для проверки рассуждений используйте бриф планирования встреч с тремя техниками, 45-минутными работами, 30-минутным буфером на переезд, рабочими часами с 9:00 до 17:00, без перекрытий и правилом перепланирования на 12 часов. Затем добавьте «разрешить две одновременные встречи на техника» и проверьте, отметит ли завершённый ответ этот конфликт. Этого результата нет в данных скриншотах.
Проверьте журнал запросов и расход кредитов
Дополнительное представление статуса обозначало интеграцию как GPT‑5.2 Pro, провайдера как Enter AI и протокол как Responses API. Его сессия не содержала никаких запросов, ноль входных и выходных токенов и ноль потреблённого использования. Эти значения не могут установить длительность, реальную маршрутизацию или стоимость предыдущего ответа.
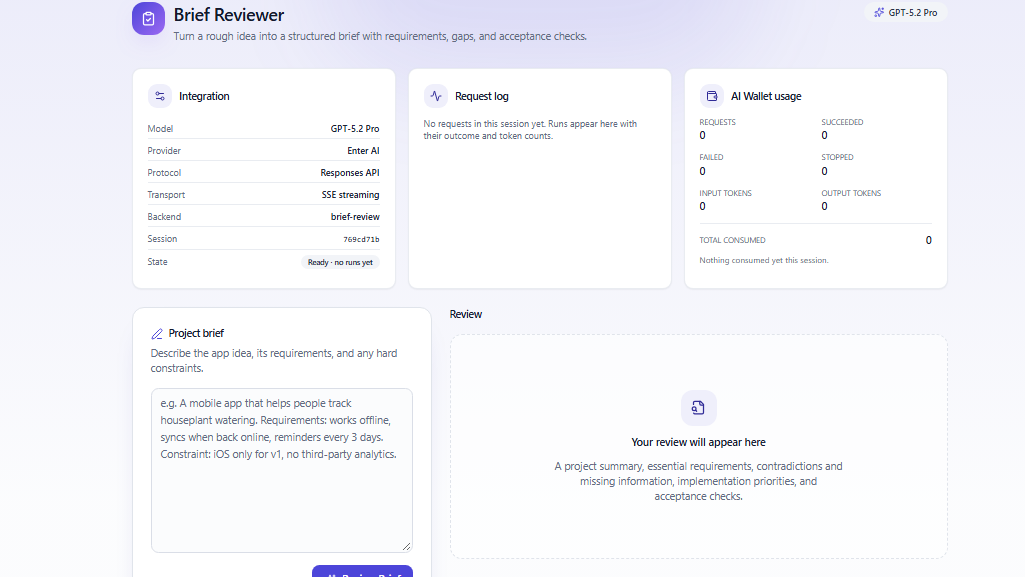
Рисунок 16. Панели интеграции и использования показывают готовую сессию без зарегистрированных запросов или потребления.
При показанных тарифах иллюстративные 1000 входных токенов плюс 500 оплачиваемых выходных токенов равнялись бы 10,5 кредитам. Это оценка, а не наблюдаемый расход. Чтобы сравнивать затраты, используйте завершённые запросы, оплаченное использование, повторы и долю проверок, соответствующих вашим критериям приёмки.
Enter хранит выбранную модель и бриф приложения в одном проекте. Создайте своё приложение с GPT‑5.2 Pro в Enter Pro и проверьте интеграцию перед публикацией.
Итоговый вывод: оцените GPT‑5.2 через реальную задачу
Практическая ценность GPT‑5.2 зависит от качества задачи и приемлемой стоимости. Проект инструмента проверки связывает выбор Pro с интерфейсом приложения и организованным текстом проверки. Для оценки надёжности и экономической эффективности всё ещё нужны завершённый ответ, проверенные ограничения и завершённый журнал запроса.
Выбирайте наименее затратную модель, которая соответствует вашему порогу приёмки, повторяйте важные случаи и сохраняйте путь восстановления для ошибок. Вы можете использовать Enter Pro, чтобы создать и доработать приложение с GPT‑5.2 Pro, а затем проверить его интеграцию перед расширением.
Частые вопросы о Chat GPT 5.2
Когда был выпущен GPT-5.2?
OpenAI объявила о нём 11 декабря 2025 года. Модели API и варианты ChatGPT начали постепенно разворачиваться при запуске, хотя доступ и рекомендуемые альтернативы с тех пор изменились.
Является ли GPT-5.2 до сих пор самой новой моделью OpenAI?
Нет. На 9 октября 2026 года OpenAI документирует её как модель предыдущего поколения. Те, кто ищет Chat GPT 5.2, должны различать доступ через селектор ChatGPT и доступ через API или интеграцию третьих сторон. Проверьте точный вариант и текущую доступность перед началом проекта.
Какое контекстное окно у GPT-5.2?
Документированное контекстное окно составляет 400 000 токенов с максимальным выводом 128 000 токенов. Вам всё же следует протестировать извлечение данных и рассуждение на ваших реальных длинных документах.
Сколько стоит API GPT-5.2?
Стандартная ставка API составляет $1,75 за миллион входных токенов, $0,175 за миллион кэшированных входных токенов и $14 за миллион выходных токенов. Плата за инструменты, рассуждения, повторы и проверку увеличивает стоимость задачи.
Как построить приложение с GPT‑5.2 Pro с помощью Enter Pro?
Выберите GPT‑5.2 Pro в каталоге моделей, подключите интеграцию и опишите функцию, которая нужна вашему приложению. Для инструмента проверки проектных брифов укажите необходимые входные данные и формат проверки. Изучите сгенерированную реализацию, затем проверьте завершённый запрос, чтобы подтвердить работоспособность подключения к модели.
Как проверить использование GPT‑5.2 Pro в Enter Pro?
Проверьте панели запросов и использования интеграции после выполнения репрезентативной задачи. Убедитесь, что запрос появился, затем изучите входные токены, выходные токены и потреблённые кредиты. При оценке затрат учитывайте повторы и более длинные ответы, используя текущие тарифы платформы.
Что такое GPT-5.2 Pro?
GPT 5.2 Pro — это модель рассуждений с более высоким вычислительным бюджетом для сложных профессиональных задач. Её официальные тарифы API составляют $21 за миллион входных токенов и $168 за миллион выходных токенов, а некоторые запросы могут занимать несколько минут.
Поддерживает ли GPT-5.2 изображения?
Да. Она принимает ввод изображения и выдаёт текстовый вывод. Аудио и видео не указаны как поддерживаемые нативные входы, поэтому эти форматы требуют отдельного этапа обработки.
Лучше ли GPT-5.2, чем Gemini 3?
Универсального ответа нет. Протестируйте точные варианты с одинаковыми промптами, файлами, инструментами, бюджетом и рубрикой, затем сравните качество принятых результатов, задержку, стоимость, управление и восстановление после сбоев.
Может ли GPT-5.2 генерировать код, готовый к production?
Он может генерировать качественный код, но готовность к production обеспечивается всем инженерным процессом: тестами, проверкой diff, проверками зависимостей и безопасности, ограниченными инструментами, staging-средой, мониторингом и откатом. Модель не может заменить эти механизмы контроля.





