
GLM-5 深度评测:版本、基准测试、价格与使用方式
全面对比GLM-5各版本、基准测试、价格、架构、本地部署、API接入方式,以及与Enter Pro的集成方案。
GLM-5 早已不是那种可以用单一基准测试来评判的单一模型了。它是一个反应迅速的模型家族:有些版本只处理文本,有些支持图像输入,较新版本把上下文窗口扩展到了100万token,而最经济的版本价格只是旗舰版的一小部分。
在更新这篇评测之前,我查阅了 Z.ai 的发布说明、模型卡、API 文档、代码仓库以及真实的产品截图。这一点很重要,因为其中一些说法相当诱人——比如内部编程能力提升50%,或长上下文计算量降低2.9倍——但这些数据都来自 Z.ai 自己,而不是独立审计机构。因此我把它们称为"官方说法",而不是我自己的测试结果。
选择 GLM-5 模型时需要考虑四个问题:你的输入类型是什么?任务难度如何?推理需要在哪里运行?如果需要重试,成功结果的成本是多少?我的快速建议是:复杂文本/编程任务用 GLM-5.3;需要多模态或追求低成本用 GLM-5.3-Flash;如果你已有经过验证的现成集成,用 GLM-5.2。
什么是 GLM-5?
GLM-5 是 Z.ai 开发的开放权重模型家族,专为软件工程、工具调用和长周期智能体任务打造。最初发布的版本(2026年2月)是一个只支持文本输入输出的混合专家(MoE)模型,拥有7440亿总参数,每个token约400亿激活参数,以及20万token的上下文窗口。这些规格数据来自GLM-5技术报告和官方 GitHub 代码仓库。
MoE 模型不会为每个 token 激活整个网络。路由器会把每个 token 发送给一小组"专家",从而减少实际计算量,同时保留一个体量极大的权重文件。但这并不意味着 GLM-5 是一个能在笔记本电脑上运行的模型:完整权重仍然需要存储空间、路由机制和服务器级硬件。
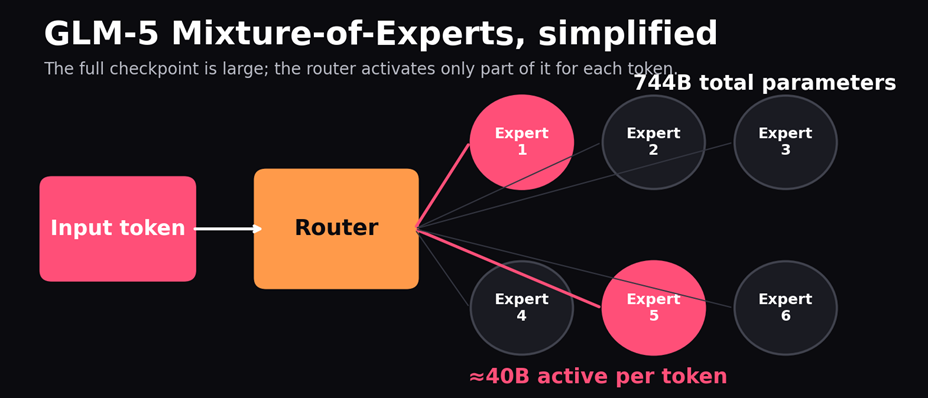
图1. GLM-5 每个token大约激活7440亿参数中的400亿;完整的权重文件仍然是服务器级规模的部署。
正确的叫法是"开放权重"(open weights)。代码、模型权重、托管服务和训练数据各自适用不同的授权条款。在进行任何商业使用之前,应仔细查阅你打算使用的那份模型卡所附带的授权协议,因为并非所有 GLM 版本都享有相同的权利。
GLM-5 版本家族详解
这个家族名称背后隐藏着重要差异。应根据模态、上下文长度、验证历史和部署方式来选择,而不是把每个5.x版本都当作可以互换使用。
| 版本 | 输入/上下文 | 最佳使用场景 | 重要注意事项 |
|---|---|---|---|
| GLM-5 | 文本 / 20万 | 原始研究或遗留系统集成 | 家族首个发布版本;不是我新项目的默认首选 |
| GLM-5-Turbo | 文本 / 20万 | 托管式、重度工具调用的智能体任务 | 这是一种供应商接入方式,不是可下载的小型权重文件 |
| GLM-5V-Turbo | 文本、图像、视频、文件 / 20万 | 视觉编程和GUI任务 | 请在你的接入端点确认所支持的格式 |
| GLM-5.1 | 文本 / 20万 | 持续运行的工程任务 | 在大多数新评测中已被更新版本取代 |
| GLM-5.2 | 文本 / 100万 | 长上下文和已验证的集成方案 | 迁移到5.3会改变推理行为 |
| GLM-5.3 | 文本 / 100万 | 高难度编程和长时间运行的智能体 | 推理功能始终开启;输出内容可能很长 |
| GLM-5.3-Flash | 多模态 / 100万 | 截图处理、大批量任务和低成本需求 | 独立的320B/18B架构,不是"低算力版5.3" |
数据来源:Z.ai 发布说明、GLM-5-Turbo 指南、GLM-5V-Turbo 指南以及 GLM-5.1 指南。需要注意的是,托管方所提供的上下文窗口可能比模型本身支持的更小。
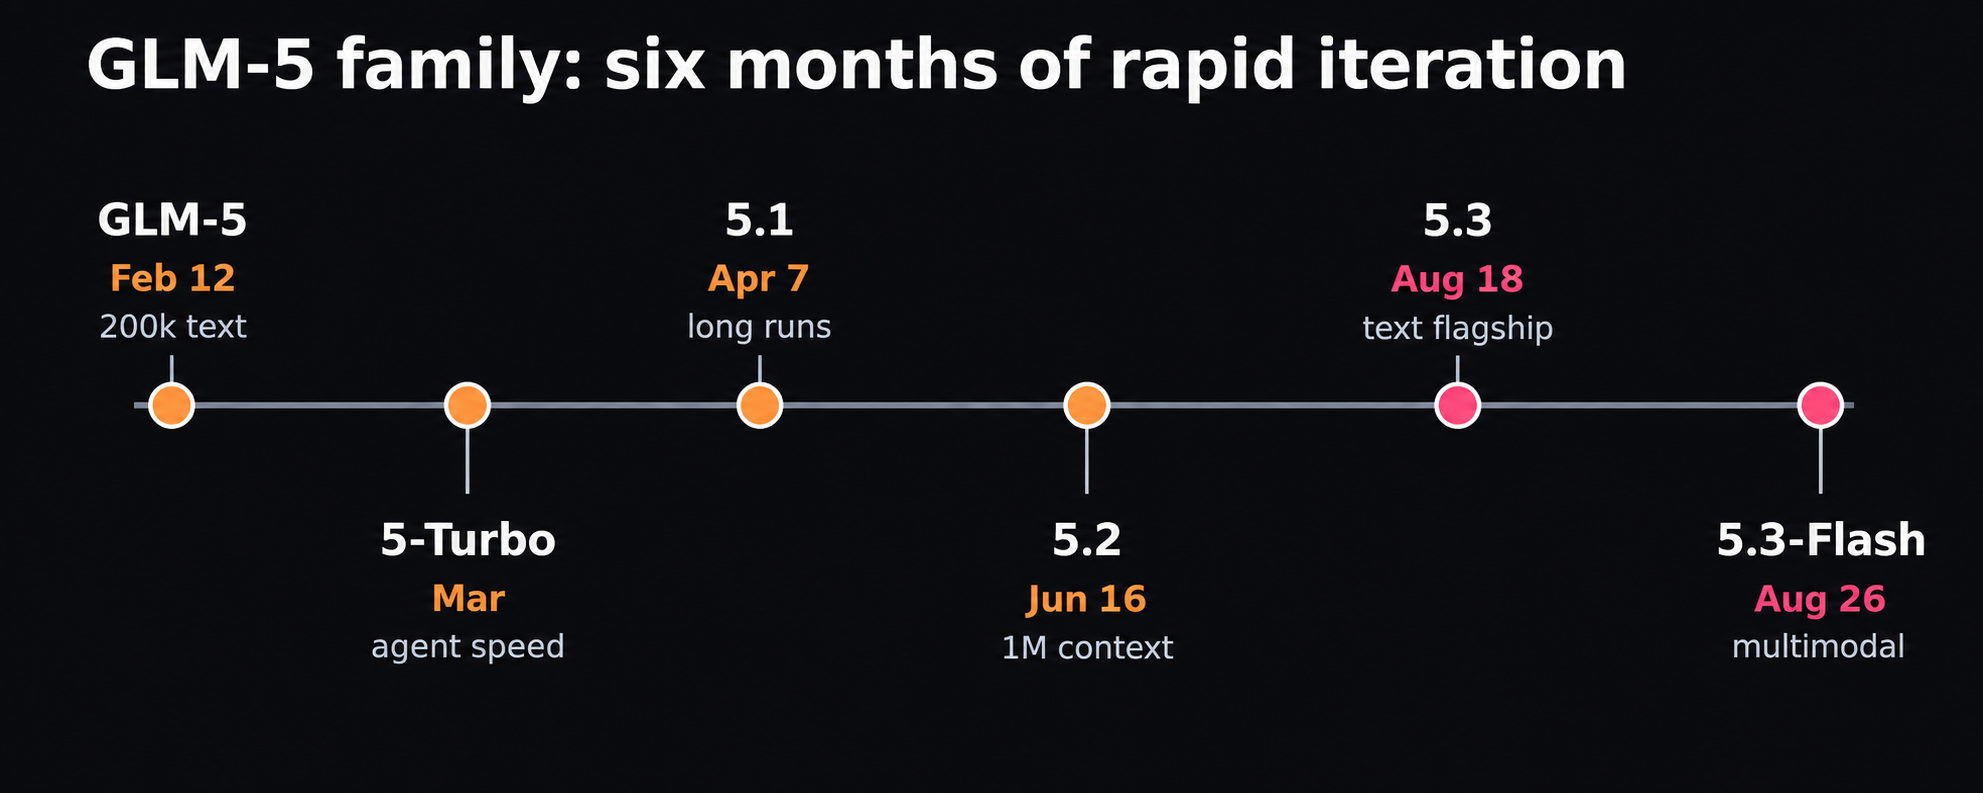
图2. 六个月的版本迭代改变了上下文长度、模态支持、推理行为和价格。
从 GLM-5 到 GLM-5.2
基于智能体的架构是在基础版 GLM-5 上建立起来的。GLM-5.1 的重点是持续运行能力;Z.ai 声称该模型最长可以连续运行8小时,但这一说法需要保留一定怀疑态度,因为你自己的代码仓库情况可能大不相同。随后,GLM-5.2 加入了百万token的上下文窗口、灵活的算力投入设置,以及用于高效处理长上下文注意力的 IndexShare 技术。
GLM-5.3 和 GLM-5.3-Flash
GLM 系列的旗舰模型只支持文本:即 GLM-5.3。根据官方文档,它的输入上限为100万token,输出上限为12.8万token,并支持低、高、最高三档推理投入等级。"思考"(thinking)功能无法关闭;如果某个5.2的请求显式关闭了该功能,在迁移过程中可能会导致失败。
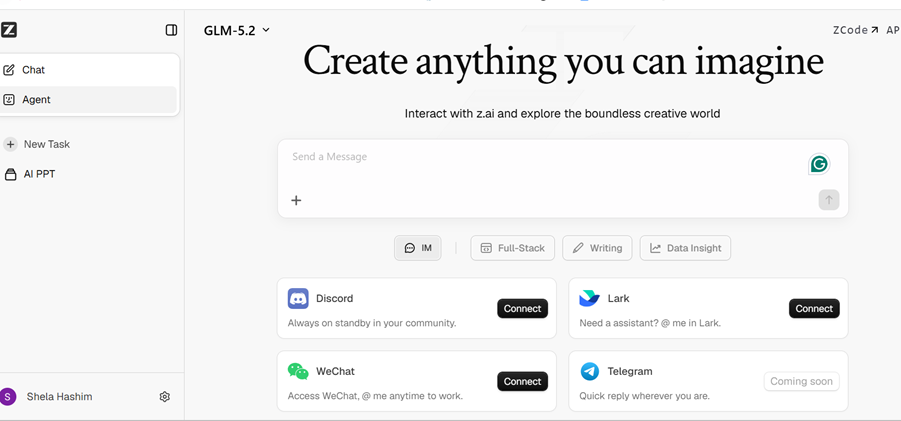
图3. GLM-5.3 的实时界面证实了其作为独立旗舰接入渠道的存在;可用性和标签可能会随时变化。
GLM-5.3-Flash 是另一个模型,总参数量为320B、激活参数为18B,支持原生多模态输入以及混合稀疏/线性注意力机制。我最初的建议很直接:当深度推理很重要时用5.3;涉及截图处理或大批量任务时,先测试一下 Flash。
在修改现有集成之前,应重放已保存的请求,而不是简单地替换模型名称。要测试结构化输出、工具调用参数、最大补全长度以及超时处理机制。某个回答在聊天界面中看起来可能更吸引人,但却可能导致解析器出错,或者直接超过你应用程序的延迟限制。在新版本通过与旧版本相同的生产环境测试之前,应保留旧接入渠道。
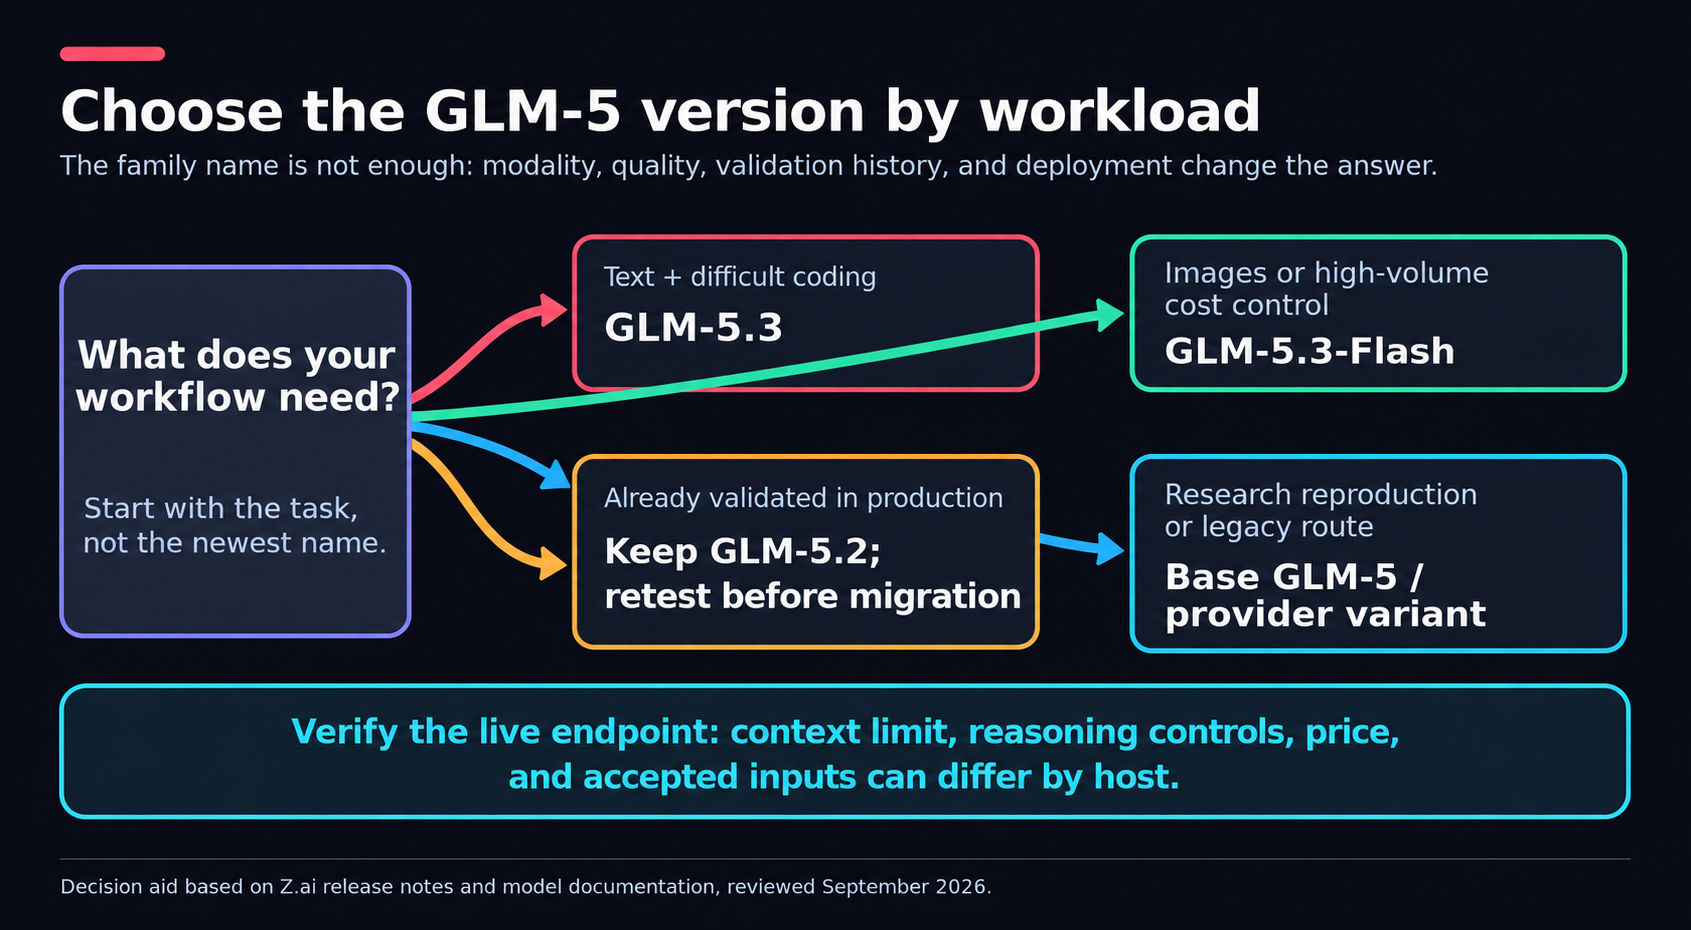
图4. 应根据工作负载和接入端点的实际表现来选择,而不是仅凭最新模型的名称。
GLM-5 与 Claude、GPT 和 Gemini 相比表现如何?
GLM-5.3 完全够资格进入编程智能体的候选名单,但单一表格无法判定全面冠军。Terminal-Bench 的得分取决于测试框架(harness)、工具权限、时间预算和算力投入等级。Z.ai 报告称,在最高算力投入下,GLM-5.3 在 Terminal-Bench 2.1 上得分88.2,在 Terminal-Bench 3.0 上得分28.3;其表格中也列出了 Claude Opus 4.8 和 GPT-5.6 Sol 的复现结果。
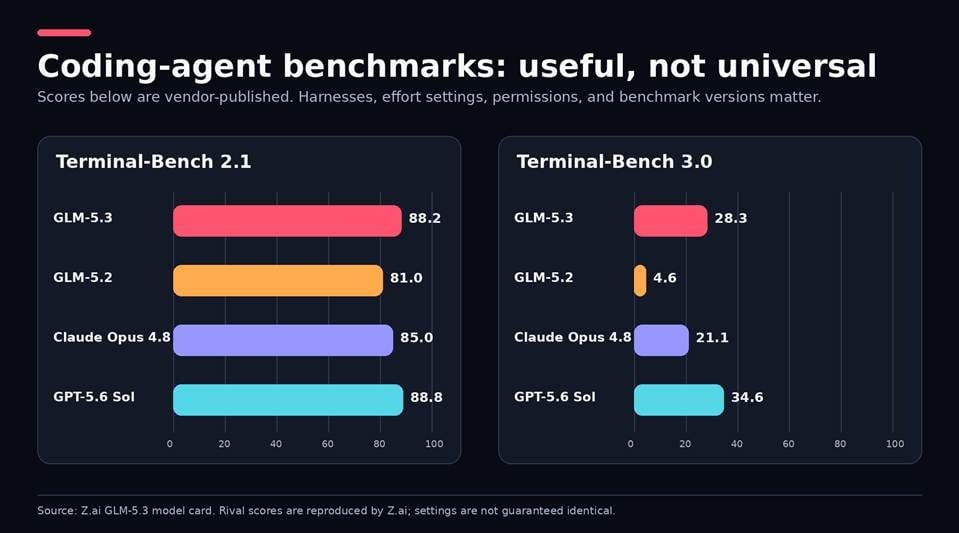
图5. 厂商公布的分数只是方向性参考证据,不能替代针对你实际工作负载的同等测试。
与其他模型不同的是,GLM-5.3 的模型卡明确列出了所使用的测试框架名称和算力投入设置。但它并未说明竞品模型是否在完全相同的条件下进行测试。类似地,根据GLM-5.2报告,它在 Terminal-Bench 2.1 的一部分任务上超过了 Gemini 3.1 Pro,而这只是本文提到的编程任务中的一小部分;但这并不意味着 GLM 在所有多模态、研究或写作任务上都胜过 Gemini 3.1 Pro。
我会用相同的提示词、工具、超时设置和通过标准来评测模型。需要关注的是每次成功任务的价格,而不是token本身的价格。一个失败三次的廉价模型,最终算下来可能反而更贵;如果 Flash 能一次性通过你的测试,旗舰模型的优势就没有意义了。
GLM-5.3 的模型卡在展示测试框架名称和算力投入等级方面相当难得。但其他竞品模型是否在相同条件下进行了测试,目前仍无法证实。同样,GLM-5.2 的指南只是说它在 Terminal-Bench 2.1(一项面向编程智能体的任务)上超过了 Gemini 3.1 Pro,并不代表它在多模态、研究或写作任务上也必然占优。
我会使用相同的提示词、工具、超时时间和通过标准来审视各个模型。只关注成功任务的成本,而不是token单价。如果测试在第一次尝试就能通过,Flash 或许才是更划算的选择,这样一来旗舰模型的优势也会随之缩小。
深入了解 GLM-5 的训练与架构
稀疏注意力与 IndexShare
长上下文的计算成本很高,因为注意力机制通常要考量token之间大量的关联关系。GLM-5.2 引入了一个索引器,可以在四个不同的注意力层中重复使用,以定位正确的位置。Z.ai 表示,在100万token的场景下,每token的FLOPs可以降低2.9倍。这是开发者给出的效率提升说法,并不是对接入端点延迟或实际请求成本的说明。
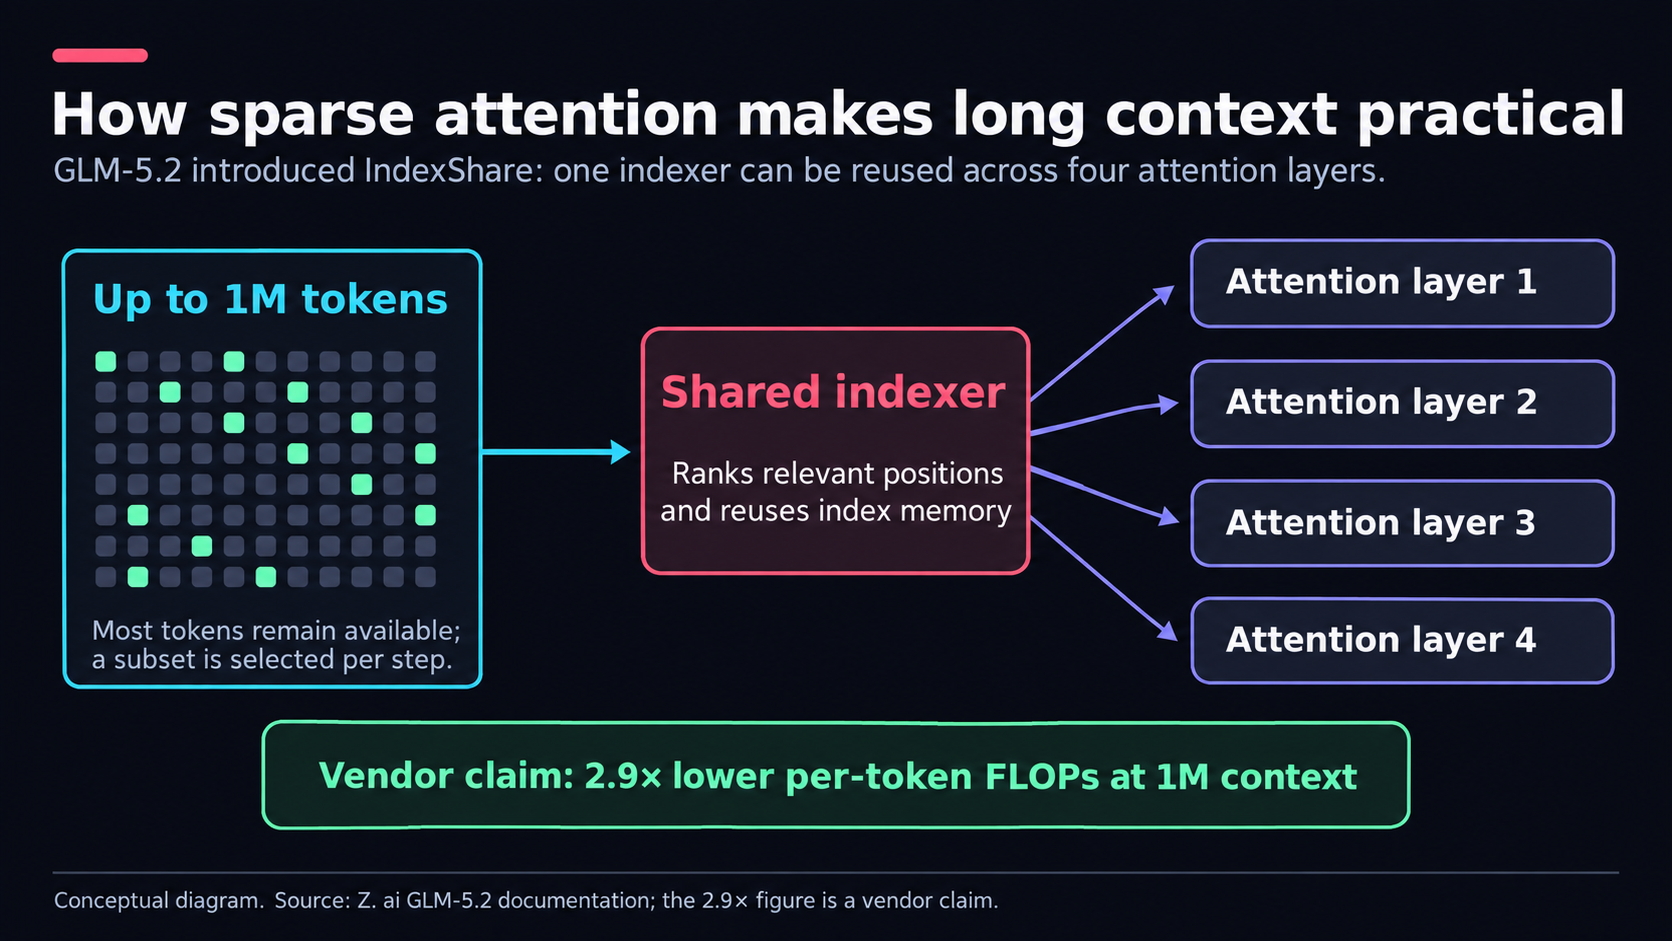
图6. IndexShare 让一个索引器在四个注意力层中重复使用;2.9倍这个数字是 Z.ai 自己给出的说法。
长周期强化学习
针对 GLM-5.3,Z.ai 提出了一套自己的异步强化学习系统构想,称之为"slime",同时还包括上下文压缩技术和合成验证器。这些技术针对的正是智能体在长时间运行中常见的错误类型:偏离目标、中途放弃任务,或是不检查答案正确性。即便如此,仍然需要人工设置的检查点和外部测试,这也可能意味着更长的运行轨迹和更大的失败追踪记录。
网络安全能力仍需人工验证
在其安全合作项目中,Z.ai 披露在269个开源项目中发现了2436个漏洞,其中1097个属于中到高危级别。这些数字很可能与 GLM-5.3 在防御性审查中的表现相关,但 GLM-5.3 本身并不能确认一个漏洞——它只能给出一个"模型发现"(model finding)。
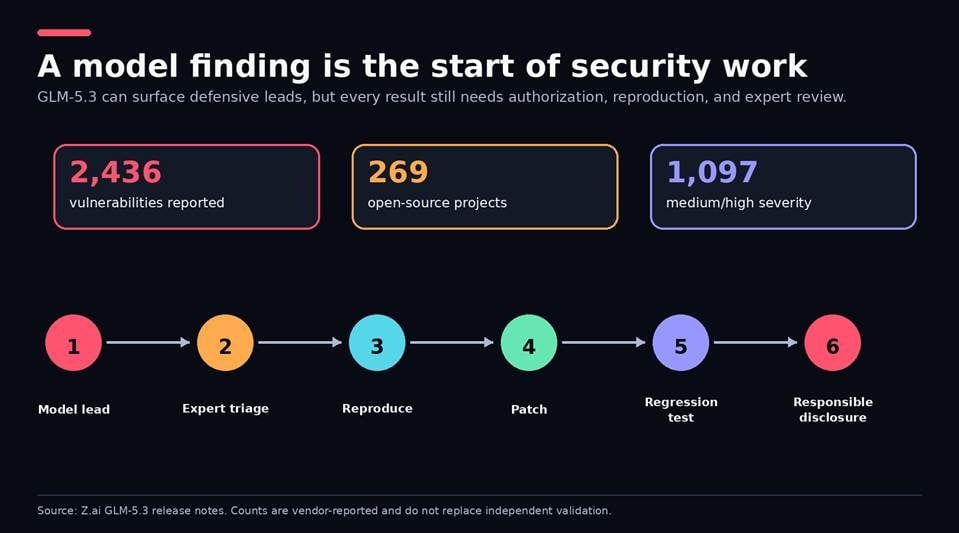
图7. 复现问题、修补漏洞、进行回归测试,并负责任地披露信息;切勿将智能体对准未经授权测试的系统。
GLM-5 价格
自2026年9月起,Z.ai 将未缓存输入、已缓存输入和输出的成本分别列出。我已通过官网价格页面重新核实了这些价格;在制定预算时不要想当然地认为价格一直不变,因为它们可能随时间调整。
| 模型 | 输入 / 100万token | 缓存输入 / 100万token | 输出 / 100万token |
|---|---|---|---|
| GLM-5 | $1.00 | $0.20 | $3.20 |
| GLM-5.1 | $1.40 | $0.26 | $4.40 |
| GLM-5.2 | $1.40 | $0.26 | $4.40 |
| GLM-5.3 | $1.40 | $0.26 | $4.40 |
| GLM-5.3-Flash | $0.15 | $0.03 | $0.50 |
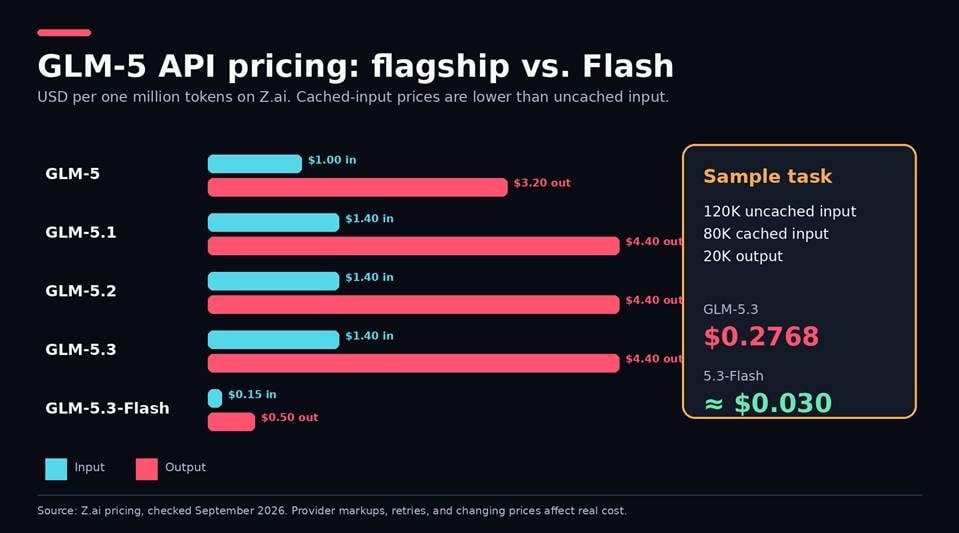
图8. Z.ai 的 API 价格说明了为什么输出长度和重试次数往往会主导最终账单。
GLM-5.3 的成本大约为 $0.2768,计算基准为12万未缓存输入、8万缓存输入和2万输出;5.3-Flash 的成本约为 $0.030(不含重试)。像 OpenRouter 这样的其他托管平台可能提供不同的价格、限制、延迟和路由方式。GLM编程计划(GLM Coding Plan)不是生产环境的API额度,而是针对受支持编程工具的独立订阅服务。
输出是请求中成本最高的部分,一个长时间进行推理的智能体很容易超出你快速估算的预算。我会设置输出上限,在重复上下文符合条件的情况下使用缓存,并记录每个完成任务的实际成本。制定生产预算时,要考虑重试次数、失败的工具调用,以及人工修正低质量回答所需的时间。这才是你应该在不同供应商之间进行比较的关键数字。
如何使用 GLM-5
| 接入方式 | 最适合场景 | 推理运行位置 |
|---|---|---|
| Z.ai Chat | 快速定性评估 | Z.ai 服务器 |
| Z.ai API | 第一方集成 | Z.ai 服务器 |
| OpenRouter | 供应商选择与故障转移 | 所选择的托管供应商 |
| Enter MaaS | 在应用构建工作流中接入模型 | Enter 内显示的托管接入方式 |
| Hugging Face + vLLM/SGLang | 自主管理部署 | 你自己的基础设施 |
| Ollama :cloud | 通过 Ollama 客户端远程访问 | 远程服务器,而非你的笔记本电脑 |
从 Z.ai Chat 开始
体验 GLM-5 聊天功能摩擦最小的方式是 chat.z.ai。可以用它来测试提示词的响应行为和输出结构,但要注意界面中显示的具体模型型号。在未核实账户当前配额之前,不要向团队承诺"免费"或"无限量"使用。
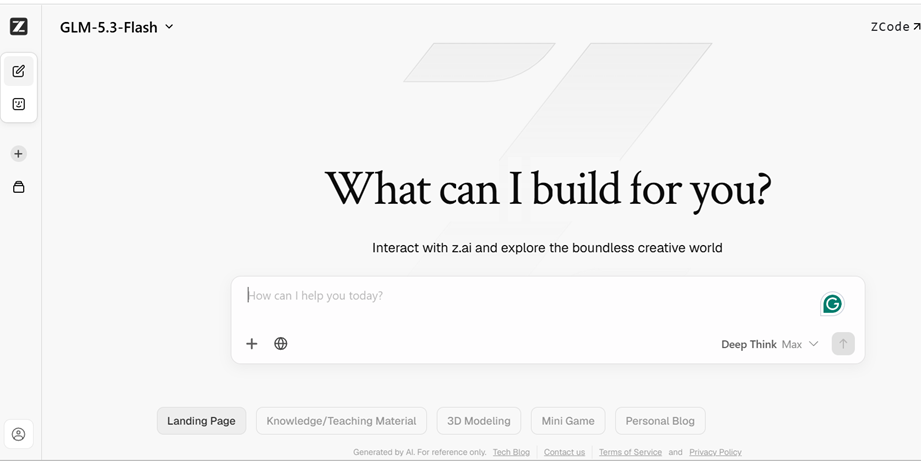
图9. 聊天界面可用于快速的定性检验,但界面中显示的模型型号和账户配额仍然很重要。
调用 Z.ai API 或 OpenRouter
Z.ai 提供了与 OpenAI 兼容的接入端点,这意味着你可以使用官方 Python SDK,只需更换基础URL即可。把API密钥存储在环境变量中,并记录模型ID、算力投入等级、使用的token数量,以及请求是否成功完成。
图10. Z.ai 兼容 OpenAI 的接入端点减少了SDK的改动量,但并不能省去迁移测试的环节。
import os

from openai import OpenAI

client = OpenAI(

        api_key=os.environ["ZAI_API_KEY"],

        base_url="https://api.z.ai/api/paas/v4/",

)

response = client.chat.completions.create(

        model="glm-5.3",

        messages=[{"role": "user", "content": "List five tests for a password-reset flow."}],

        max_tokens=4096,

        extra_body={"thinking": {"type": "enabled"}, "reasoning_effort": "high"},

)

print(response.choices[0].message.content)
从5.2迁移时,应移除任何显式关闭"thinking"的请求设置;GLM-5.3 不接受这种行为。如果你通过 OpenRouter 使用 GLM-5.3 接入渠道,在治理合规性或可复现性有要求的场景下,应记录是哪个供应商处理了该请求。
下载权重并自行托管
使用官方代码仓库,或者 Hugging Face 上经过验证的 GLM-5.3 模型卡。Z.ai 列出的受支持部署方式包括 SGLang、vLLM、Transformers、KTransformers 和 Unsloth。
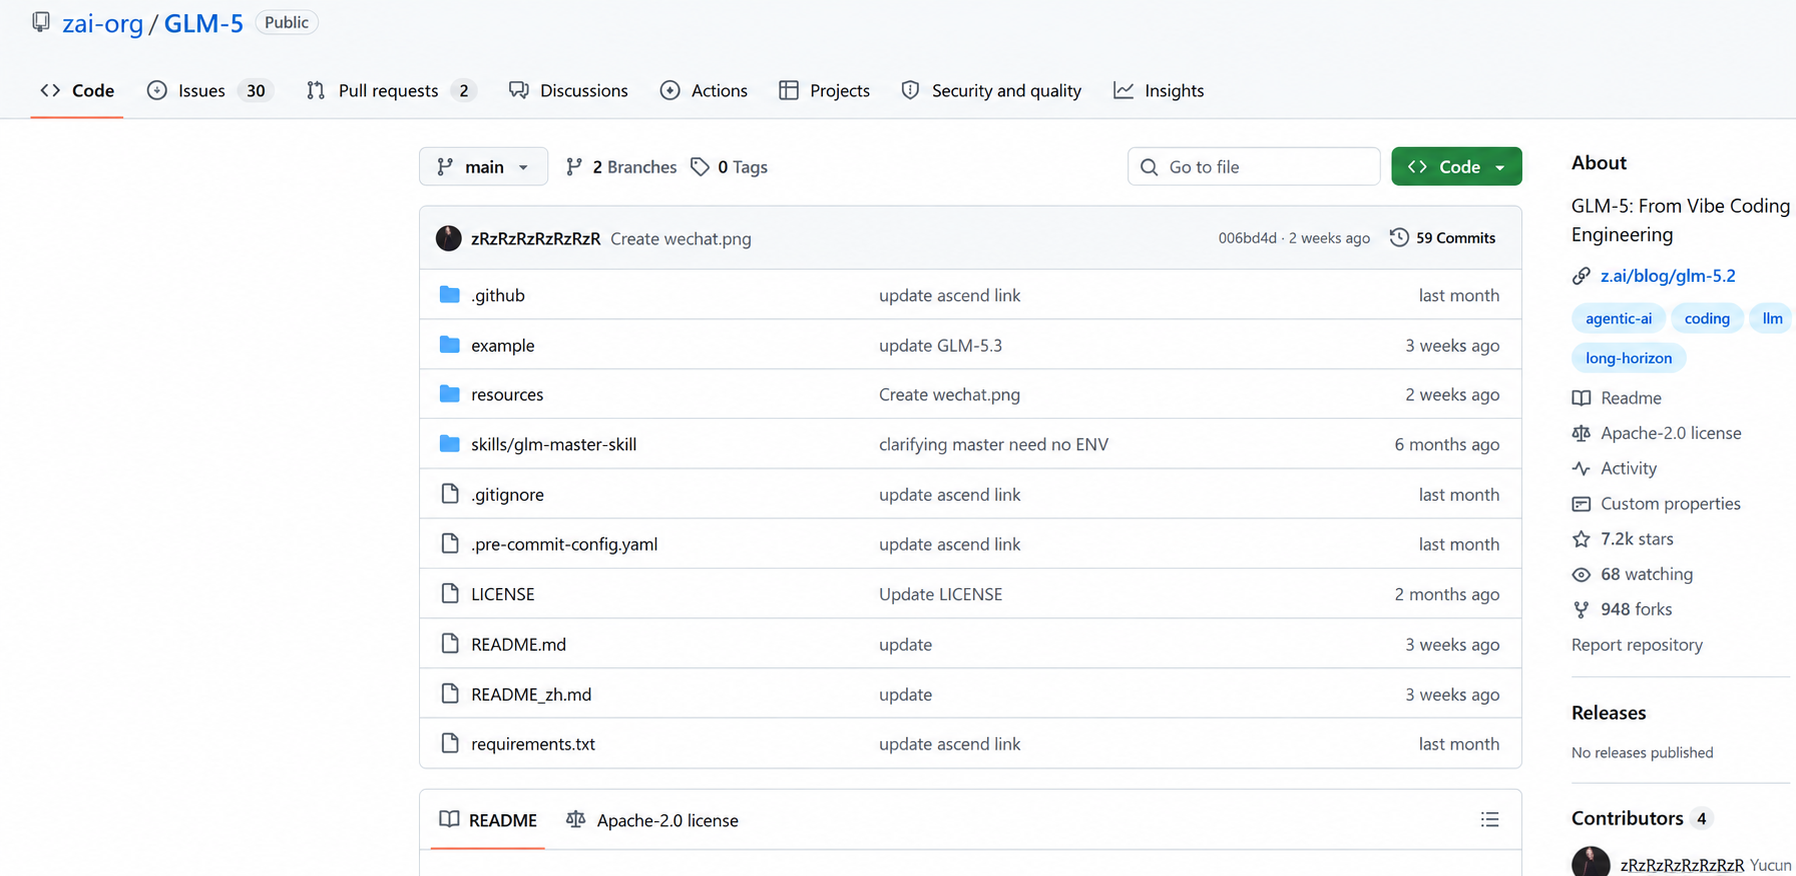
图11. 应使用经过验证的官方代码仓库和模型卡,而不是非官方的权重镜像站点。
可下载不等于可运行。量化技术可以降低内存需求,但可能会影响模型质量;对于一个7440亿参数的权重文件,仍然需要服务器级的存储空间和加速硬件。请仔细阅读 Ollama 上 GLM-5 的列表说明:标注了"cloud"的标签意味着这是远程推理。真正实现本地运行,需要本地权重文件、本地运行环境以及足够的硬件支持。
我会如何在投入生产前评测 GLM-5
我不会从"哪个模型最聪明"这种宽泛的问题开始测试。我会针对5.2、5.3和Flash,使用相同的工具和限制条件,运行四项有代表性的任务:修复代码仓库中的一个bug、从长文档中检索被预先植入的事实信息、完成一个带有人为引入故障的多工具工作流,以及按照一份书面评分标准生成输出内容。
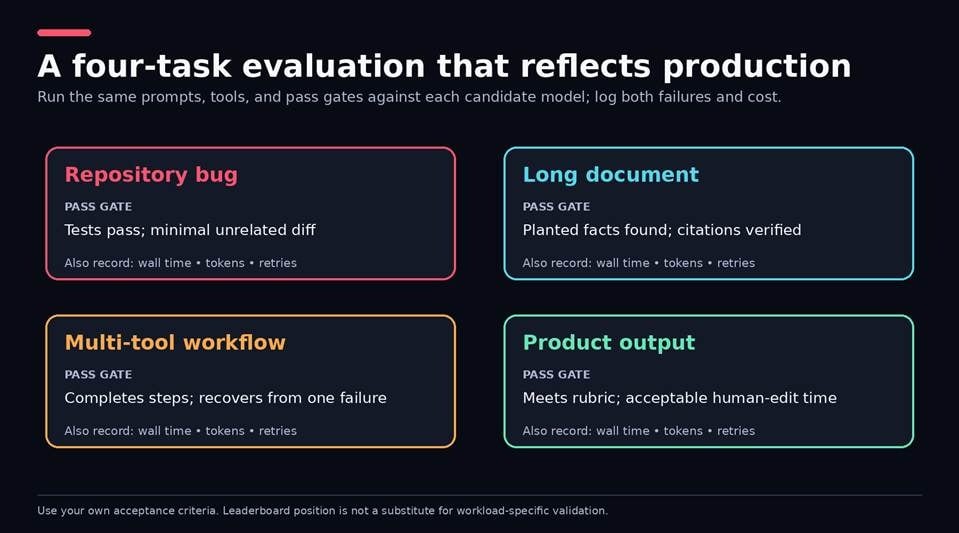
图12. 一个小规模、可重复的工作负载测试,比一个宽泛的"哪个模型最聪明"问题更有实际价值。
通过/失败、实际耗时、token用量、重试次数、人工编辑时间,以及供应商。这样可以发现基准测试平均分数所无法体现的迁移风险——比如5.3始终开启的推理功能,以及可能很长的输出内容。这同时也能告诉你,Flash更低的价格能否在真实验收测试中站得住脚。
谁应该使用 GLM-5?
智能体编程与代码仓库相关工作
如果一项任务涉及搜索代码仓库、协调式修改、运行测试和调用工具,GLM-5 是一个出色的选择。公开的基准测试证据支持这一结论,但你的验收标准应当足够严格:测试必须通过,diff改动必须聚焦明确,并且不能跨越任何凭证或网络边界。应提供一个独立的工作区域,并遵循最小权限原则。在缺乏控制的情况下赋予更多自主权,只会产生更大的失败追踪记录。
长文档与知识型工作
百万token级别的模型适用于规格文档、研究资料包和大型代码库。但不应把大上下文窗口等同于可靠的信息检索能力。应把关键信息放在文档的开头、中间和结尾;注明引用来源;核实被引用的信息。我还会考虑搭配一个检索流水线作为对照,因为把所有内容塞进一个超长提示词,可能比先筛选出有用证据再处理要更慢、成本更高。
多模态与防御性工作流
借助 GLM-5.3-Flash 或 GLM-5V-Turbo,截图、界面状态或任务所需的其他视觉输入都能成为日常工作的一部分。应把所有发现都当作防御性安全审查的线索,进行复现和优先级排序。对于那些希望使用小型本地笔记本模型、无法做出部署决策,或者无法核实托管方数据存放地与数据保留条款的用户来说,GLM-5 的适配性较差。
GLM-5 对于私人或企业数据安全吗?
托管接入方式
这不仅取决于模型本身,还取决于接入方式。存在多种不同的数据路径,比如 Z.ai Chat、Z.ai API、其他托管方,或是自主管理的部署方式。首先查阅Z.ai 的隐私政策,然后向所有中间环节确认数据保留期限、是否用于训练、删除机制、数据存放地以及合同条款。
如果聚合服务提供商允许指定具体供应商,就应当锁定明确的供应商,不要因为图方便而随意发送敏感信息。托管数据最终会如何处理,取决于你的合同和配置设置,而不是"开放权重"这个说法本身。
自行托管
自行托管可以让提示词内容保留在你自己的环境中,但你需要自行承担权重管理、凭证安全、补丁更新、网络控制和监控的责任。即便如此,我仍然会假设存在某种方式,能在早期阶段注入不安全的生成代码。应分离构建环境和生产环境的凭证,限制出站网络访问,审计工具的操作行为,并为重大变更保留人工审批环节。不要给予智能体超出任务所需的权限。
如何将 GLM-5 与 Enter Pro 搭配使用
GLM-5 并不是 Enter Pro 的直接竞品。GLM 提供的是模型能力,而 Enter Pro 提供的是围绕模型构建产品的完整工作流。当你需要的不仅是"得到一次模型输出",而是"得到一个能转化为界面、业务逻辑和发布路径的输出"时,这种差异就显得很重要。
如果你需要API控制权、定制化基础设施,或特定的数据结构,直接接入方式是更好的选择。但当产品层面的变通方案成为限制因素时,Enter Pro 就能发挥作用了。它的 AI MVP Builder 把规划、应用创建、可视化编辑和发布整合成一个单一流程,而 Enter Code 则为代码仓库相关任务提供了以终端为中心的操作方式。
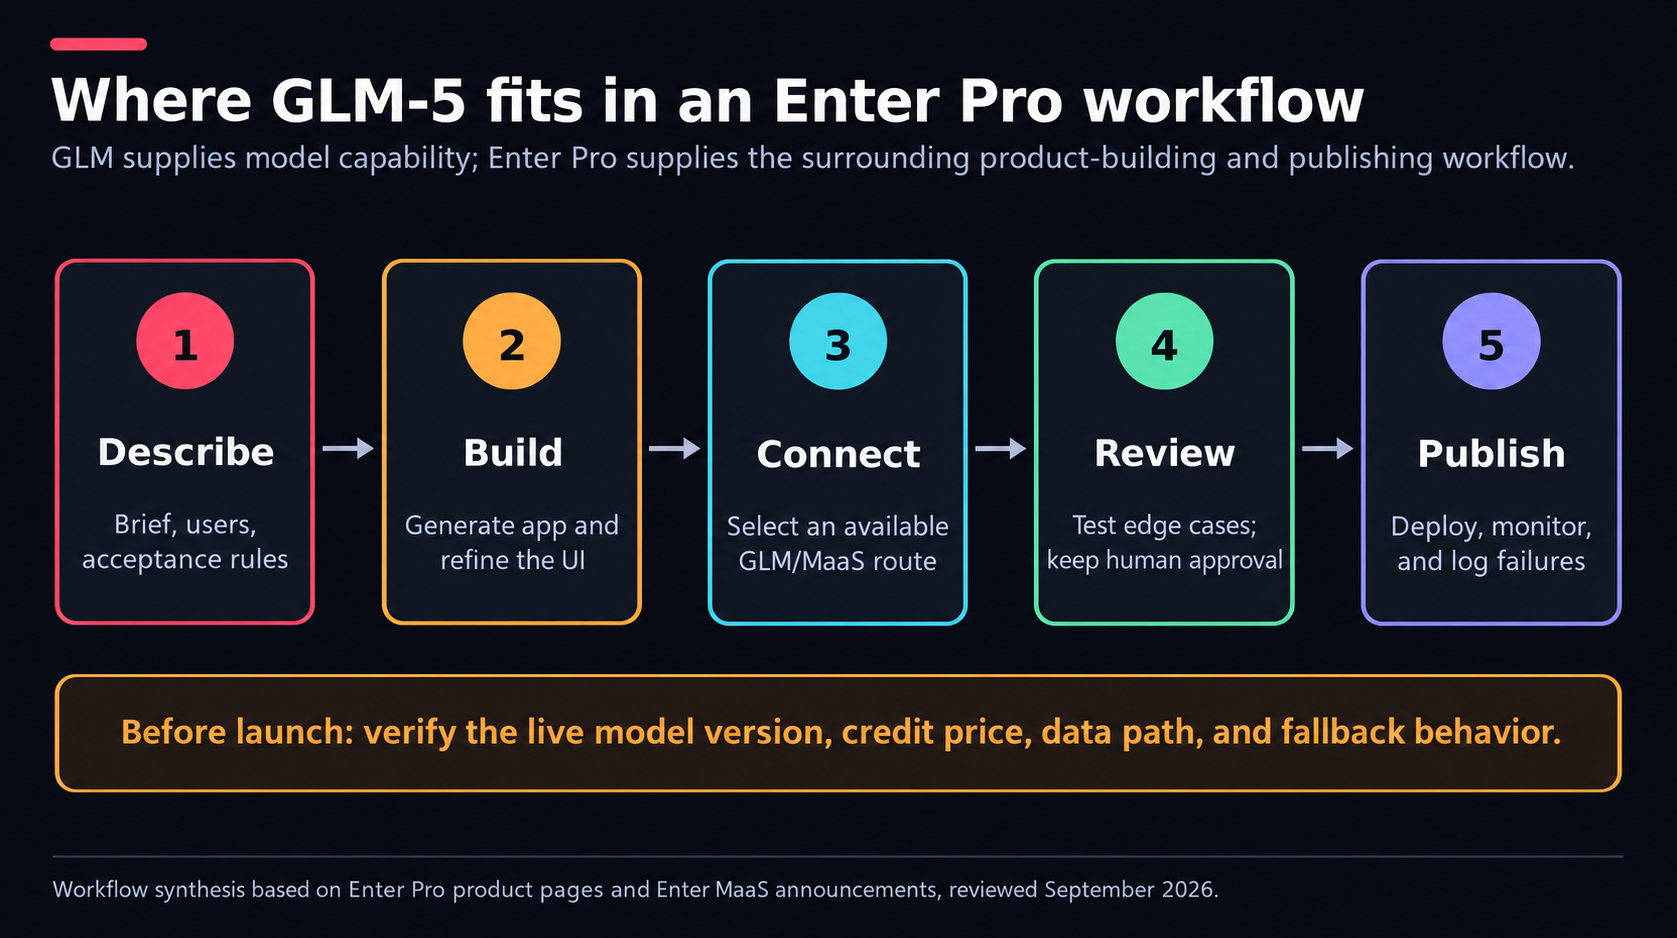
图13. 模型负责生成或分类;产品工作流则负责添加界面、审核、部署和监控环节。
Enter 的更新日志证实,GLM-5.2 出现在6月17日之前的 AI All 模型目录中。Enter MaaS 的公告中提到了 GLM 5,并说明了这些模型是如何以积分方式计费的。但该公告并未明确确认支持 GLM-5.3,因此在围绕某个特定版本进行设计之前,务必查看实时的模型选择器、积分价格、上下文限制以及数据路径。
一个客服工单分类应用很好地说明了这种组合的适用场景。借助 Enter Pro,你可以设计工单表单和查看看板,并接入现有的 GLM 接入方式来对工单进行分类并撰写回复草稿。在正式发布之前,需要验证模型空白回复、模糊不清的请求、多语言输入、提示词注入攻击,以及消息正文中可能存在的私密数据等情况。确保草稿和"发送"按钮之间始终有人工把关。
| 如果你的优先事项是…… | 选择直接接入 GLM | 选择 Enter Pro |
|---|---|---|
| 模型参数和供应商控制权 | 是 | 仅限于开放出来的选项范围内 |
| 可视化应用创建与编辑 | 需要自行搭建或添加额外工具 | 这是该工作流的核心优势 |
| 定制化托管与网络策略 | 最合适的选择 | 应先核实平台是否适配 |
| 从模型输出到产品界面的快速落地路径 | 需要更多工程投入 | 更合适的选择 |
但 Enter 并不会让 GLM 变得更聪明,同样,GLM 能接入某个应用也不会让它的编程智能体变得更聪明。如果重点是集成或界面开发工作,我会选择 Enter。如果你正处于这种情况,可以打开 Enter Pro 工作区,在确定架构方案之前先查看现有的模型目录。
结论
尽管它被称为 GLM-5,但在编程和长周期智能体任务上,版本选择和服务方式与模型本身同样重要!复杂的文本和代码任务用 GLM-5.3,多模态和/或大批量场景用 GLM-5.3-Flash,在迁移变得具有成本效益之前继续保留5.2。然后,在把行业领先者或供应商给出的数据作为生产环境依据之前,务必先用你自己的实际任务进行测试。
真正能发挥作用的模型,是那个真正满足你验收标准、处于你可接受的延迟和隐私范围之内、并且在算上重试成本后价格依然合理的模型——无论它在某一项具体基准测试中拿到了多么接近满分的成绩。
常见问题
GLM-5 是免费的吗?
公开权重可供下载,不收取按token计费的API费用,但硬件和运营成本仍需自行承担。Z.ai Chat 可能提供基于配额的访问方式。托管API、路由服务和GPU服务器都是付费服务,具体差异会根据版本和接入方式有所不同。
GLM-5 哪个版本更好?
对于高难度的文本/编程任务,我会从 GLM-5.3 开始尝试。对于图像、截图处理,或是对成本敏感的大批量任务,GLM-5.3-Flash 是更好的初始测试选择。如果 GLM-5.2 已经经过验证,且迁移风险超过了潜在收益,就不要轻易更换。
GLM-5 能够编写和调试代码吗?
可以。编程智能体和代码仓库级别的工程任务是其核心应用场景,厂商在 Terminal-Bench 和 DeepSWE 测试中报告了不错的结果。但沙箱环境、测试、受限权限和人工审查仍然是必不可少的环节。
GLM-5 的 API 价格是多少?
截至2026年9月,Z.ai 给出的价格是:GLM-5 每百万token输入1.00美元、输出3.20美元;GLM-5.3为1.40美元和4.40美元;5.3-Flash为0.15美元和0.50美元。缓存输入的价格更低。实际成本还会受到供应商加价和重试次数的影响。
GLM-5 是开源软件吗?
"开放权重"这个说法更准确。权重的授权协议、代码仓库代码的授权协议,以及训练数据的透明度,是三个不同的问题。在进行商业部署之前,一定要仔细查看 Hugging Face 上具体的模型卡和代码仓库的授权协议。
GLM-5 可以在本地使用(搭配 Ollama)吗?
只有在你拥有本地权重文件、运行环境支持以及足够硬件资源的前提下才可以。标注"cloud"的标签意味着运行是在远程基础设施上进行的,因此并不意味着整个7440亿参数模型都在你的设备上运行。
GLM-5 能够处理图像吗?
基础版 GLM-5 和 GLM-5.3 都只支持文本。对于多模态输入需求,应使用 GLM-5.3-Flash 或 GLM-5V-Turbo;并请核实所选接入端点支持的具体文件类型。





