
Bester KI-Codegenerator für Apps und den Entwickleralltag
Vergleichen Sie die besten KI-Codegeneratoren nach Aufgabe, Budget und Tech-Stack – inklusive praktischem Enter Pro Bewertungsplan für eine echte App.
Der beste KI-Codegenerator ist der, der zur Arbeit passt, die Sie erledigen müssen. GitHub Copilot eignet sich für Vorschläge direkt im gewohnten Editor; Cursor, Cline und Claude Code bieten Wege, um über ein ganzes Repository hinweg zu arbeiten. Für eine neue Webanwendung sind v0 und Replit Agent ebenfalls einen Blick wert. Der entscheidende Unterschied liegt im Output, den Sie brauchen: eine Funktion, die Sie in ein Projekt einfügen können, ein Patch, den Sie prüfen können, oder eine Anwendung mit eigenen Daten- und Deployment-Anforderungen.
Eine Suche nach bester KI-Codegenerator 2026 bringt sehr unterschiedliche Workflows in dieselbe Shortlist. Grenzen Sie die Auswahl ein, indem Sie Stack-Kompatibilität, Modellzugriff, Limits des kostenlosen Plans und den Aufwand zur Verifizierung des Ergebnisses prüfen. Später zeigt das dokumentierte ScopeQuote-Projekt einen Kostenrechner in Enter Pro und eine Bestätigung einer 450-Dollar-Anfrage. Es macht auch den Unterschied zwischen sichtbarem Interface-Verhalten und noch unverifizierten Anforderungen an Speicherung, Berechnung und Besitzerzugriff greifbar.
Was KI-Codegeneratoren tatsächlich erstellen können
Funktionen, Skripte und Datenbankabfragen
Eine fokussierte Anfrage funktioniert gut für einen Parser, eine SQL-Abfrage, ein Kommandozeilen-Tool oder eine Testfixture, weil Sie Eingaben und erwartete Ausgaben präzise definieren können. Nehmen wir einen Python-Spesenimporter: „Lies diese CSV“ lässt Währungsformate, doppelte Datensätze, fehlende Werte und fehlerhafte Zeilen ungeklärt. Eine nützliche Spezifikation legt fest, ob 03.04.2026 den 3. April oder den 4. März bedeutet und was passiert, wenn eine Zeile ungültig ist. Testen Sie diese Entscheidungen mit festen Beispielen, bevor Sie den gesamten Datensatz verarbeiten. Eine Funktion, die ohne Ausnahme läuft, kann trotzdem falsche Summen liefern.
Änderungen in einem bestehenden Repository
Repository-Agenten können Projektdateien lesen, mehrere Module bearbeiten und Entwicklungsbefehle ausführen. Das gibt ihnen eine größere Rolle als ein Chatfenster, das einen Snippet zum Kopieren liefert. Die Aktualisierung eines Login-Flows kann zum Beispiel Änderungen an einem Formular, Request-Handler, Validierungsschema, Session-Logik und Integrationstests erfordern. Die wichtige Frage ist, ob der komplette Pfad danach noch funktioniert. Ein großes Kontextfenster bietet Platz für Informationen; relevante Dateierkennung und eine lauffähige Testumgebung entscheiden, ob der Agent diese Informationen effektiv nutzen kann.
Interfaces und komplette Anwendungen
App-Builder können Interfaces generieren, Daten verbinden und Publishing-Workflows unterstützen. Sie müssen trotzdem eine überzeugende Vorschau von einer funktionierenden Anwendung unterscheiden. Ein Kunden-Dashboard kann glaubwürdige Beispieldaten anzeigen, während Authentifizierung oder persistente Speicherung noch unfertig sind. Die Seite neu laden, die App in einer anderen Sitzung öffnen und den Datensatz eines anderen Nutzers anfordern – das zeigt mehr als der erste Bildschirm. Diese Kategorien überlappen sich: Ein Editor-Agent kann eine Anwendung aufbauen, und ein Builder kann bestehenden Code unterstützen. Wählen Sie nach dem Entwicklungsworkflow und der Eigentümerschaft, die Sie danach brauchen.
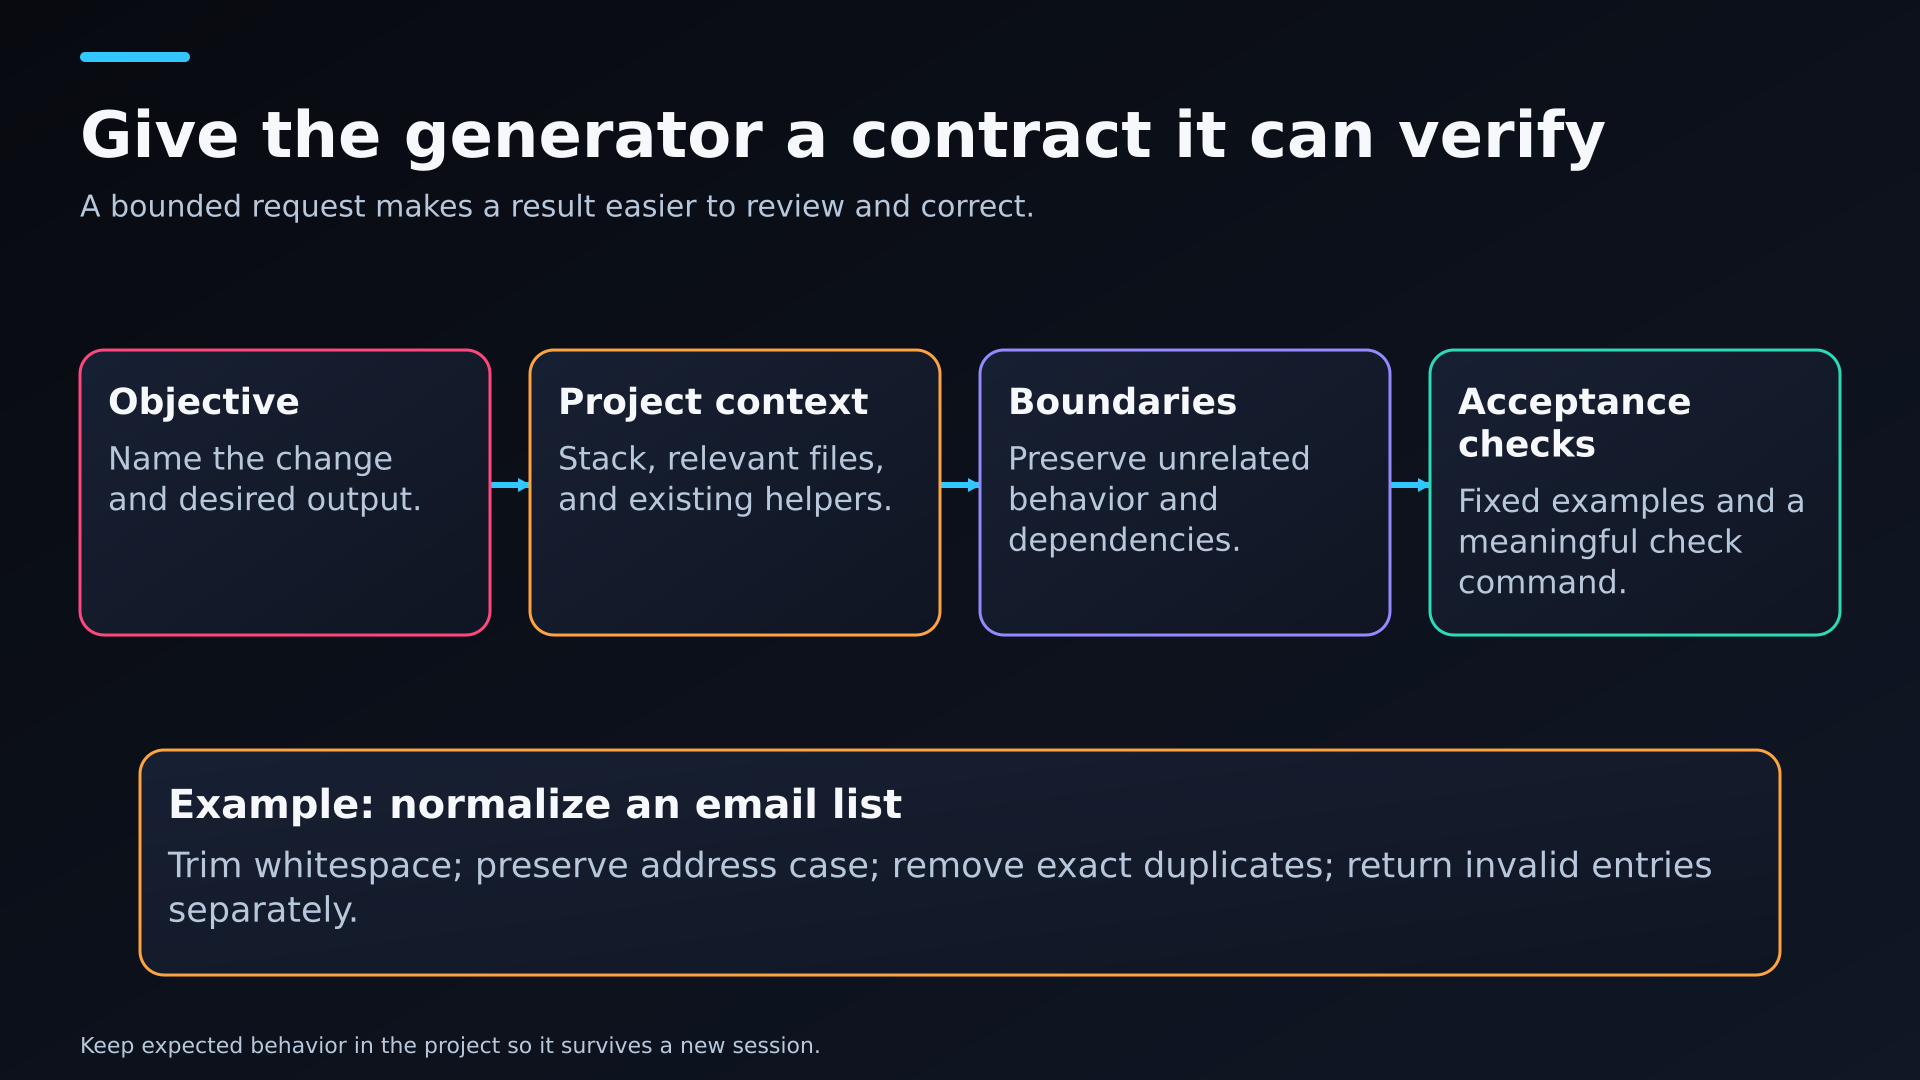
Ein vierteiliger Generierungsvertrag mit einem E-Mail-Normalisierungsbeispiel aus dem Artikel.
So vergleichen Sie den besten KI-Codegenerator für Ihr Projekt
Beginnen Sie mit einem einzelnen Deliverable und einer klaren Definition von „fertig“. Erstellen Sie eine Shortlist nach Workflow und geben Sie den stärksten Kandidaten dieselbe begrenzte Aufgabe. Ein Zwei-Datei-Validierungsfix sollte kein neues Framework oder eine komplette Neuschreibung der Anwendung erfordern. Gute Generierung erhält die Teile Ihres Projekts, die bereits funktionieren, und macht die gewünschte Änderung leicht prüfbar. Der beste KI-Codegenerator für Ihr Projekt ist der, der diese Vorgaben zu einem akzeptablen Preis erfüllt.
Sprach- und Runtime-Kompatibilität steht an erster Stelle. Ihre Python-Version, TypeScript-Einstellungen, Framework-Release, Paketmanager und Lockfile sollten mit dem Projekt übereinstimmen, das Sie weiterhin pflegen wollen.
Kontext umfasst die relevanten Dateien, API-Verträge, Projektkonventionen und Grenzen. Ein Generator sollte wissen, welchen Auth-Helper er wiederverwenden muss und welche Konfigurationsdateien er nicht anfassen darf.
Überprüfbarkeit zählt nach der Generierung. Klare Diffs, sichtbare Befehlsausgaben, passende Berechtigungen und ein verlässlicher Rückweg erleichtern die Entscheidung, eine Änderung anzunehmen oder abzulehnen.
Die Gesamtkosten umfassen Abonnements, separat abgerechnete Inferenz, App-Hosting, Datenbankressourcen und Korrekturzeit. Diese Gebühren können selbst innerhalb eines Produkts unterschiedlichen Abrechnungsregeln folgen.
Eine nützliche Übergabe umfasst zugänglichen Quellcode, ein Dependency-Manifest, Lizenzinformationen, Umgebungsvariablennamen und Setup-Anweisungen. Ein anderer Entwickler sollte verstehen können, was die Anwendung zum Laufen braucht.
Führen Sie für jeden Kandidaten ein kurzes Protokoll: Aufgabe, Startcommit, bereitgestellter Kontext, gewähltes Modell, geänderte Dateien, bestandene Prüfungen, Wiederholungen, Reviewzeit und Kosten. Das macht einen gescheiterten Versuch sichtbar, statt ihn durch einen beeindruckenden letzten Screenshot verschwinden zu lassen. So erkennen Sie auch wiederkehrende Probleme, etwa häufige Abhängigkeitsänderungen oder Tests, die erst bestehen, nachdem der Agent ihre Erwartungswerte geändert hat.
Halten Sie Umgebungsfehler von Code-Fehlern getrennt. Eine fehlende Datenbankverbindung oder ein nicht erreichbares Paket-Registry kann einen ansonsten plausiblen Patch von der Prüfung abhalten. Vermerken Sie diese Einschränkung, ohne ein Bestehen zu bescheinigen oder den Patch für falsch zu erklären. Wiederholen Sie den Lauf dann ab demselben Startcommit, sobald die Umgebung nutzbar ist. Für einen Vergleich bester KI-Codegenerator 2026 sind datierte Setup-Details genauso wertvoll wie ein Produktname, weil sich Pläne, Modellzugriff und unterstützte Ausführungsumgebungen ändern.
Beste KI-Codegenerator-Optionen nach Entwicklungsworkflow
GitHub Copilot für Generierung im bestehenden Editor
GitHub Copilot ist ein praktischer Einstiegspunkt, wenn Sie Vorschläge direkt im gewohnten Editor wollen. Inline-Unterstützung hilft bei der lokalen Umsetzung, während Chat- und Agent-Funktionen dort, wo verfügbar, breitere Änderungen unterstützen können. Für einen TypeScript-Validierungshelfer sind bestehende Types und Schemas nützlicherer Kontext als eine lange Produktbeschreibung. Prüfen Sie optionale Felder und die Fehlerstruktur, die Aufrufer erwarten. Copilot bietet begrenzten kostenlosen Zugang und kostenpflichtige Pläne mit dokumentierten Nutzungsregeln; nutzen Sie die aktuelle Plan-Seite, statt ein altes Vervollständigungskontingent in einen neuen Vergleich zu übernehmen.
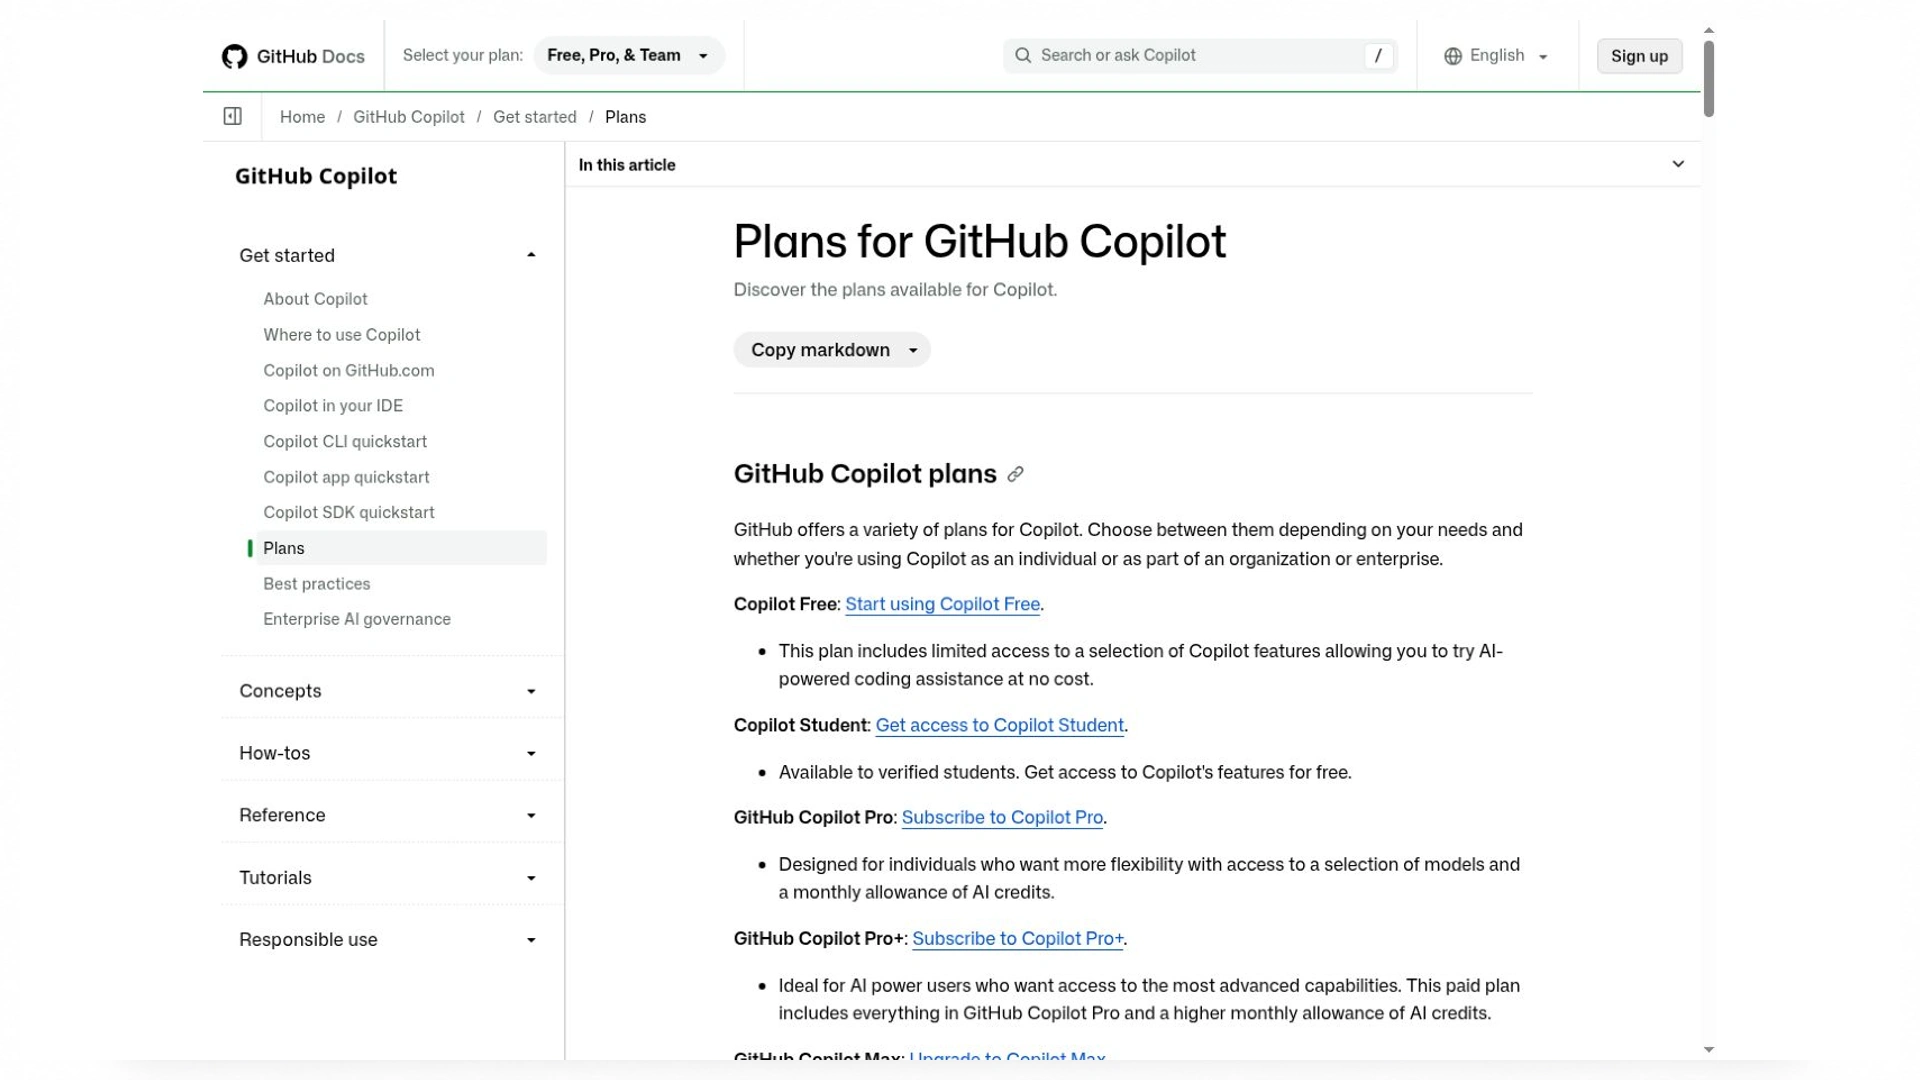
Vergleichen Sie die Funktion und das Kontingent, die für Ihre Aufgabe relevant sind. Aktuelle Pläne sind eine bessere Referenz als alte Kontingentübersichten.
Cursor für Bearbeitung und Generierung über ein ganzes Projekt
Cursor kombiniert vorausschauende Tab-Vorschläge mit Projekterkundung und agentengesteuerten Änderungen. Diese Kombination ist nützlich, wenn Sie zwischen kleinen Edits und einem Feature wechseln, das mehrere Dateien berührt. Das Hinzufügen eines Filters zu einem Admin-Bildschirm kann etwa Komponentenstatus, URL-Query-Parameter, eine Backend-Abfrage und eine Testfixture betreffen. Der Patch sollte die bestehenden Navigations- und Datenabruf-Konventionen erhalten. Die Editor-Integration von Cursor ist der Grund, es in Betracht zu ziehen; Geschwindigkeit und Korrektheit hängen weiterhin von Ihrer Aufgabe, Ihrem Modell und Ihrem Review-Prozess ab. Auch die aktuellen Plan- und Modellgebühren verdienen Aufmerksamkeit, bevor Sie sie mit älteren Preiszusammenfassungen vergleichen.
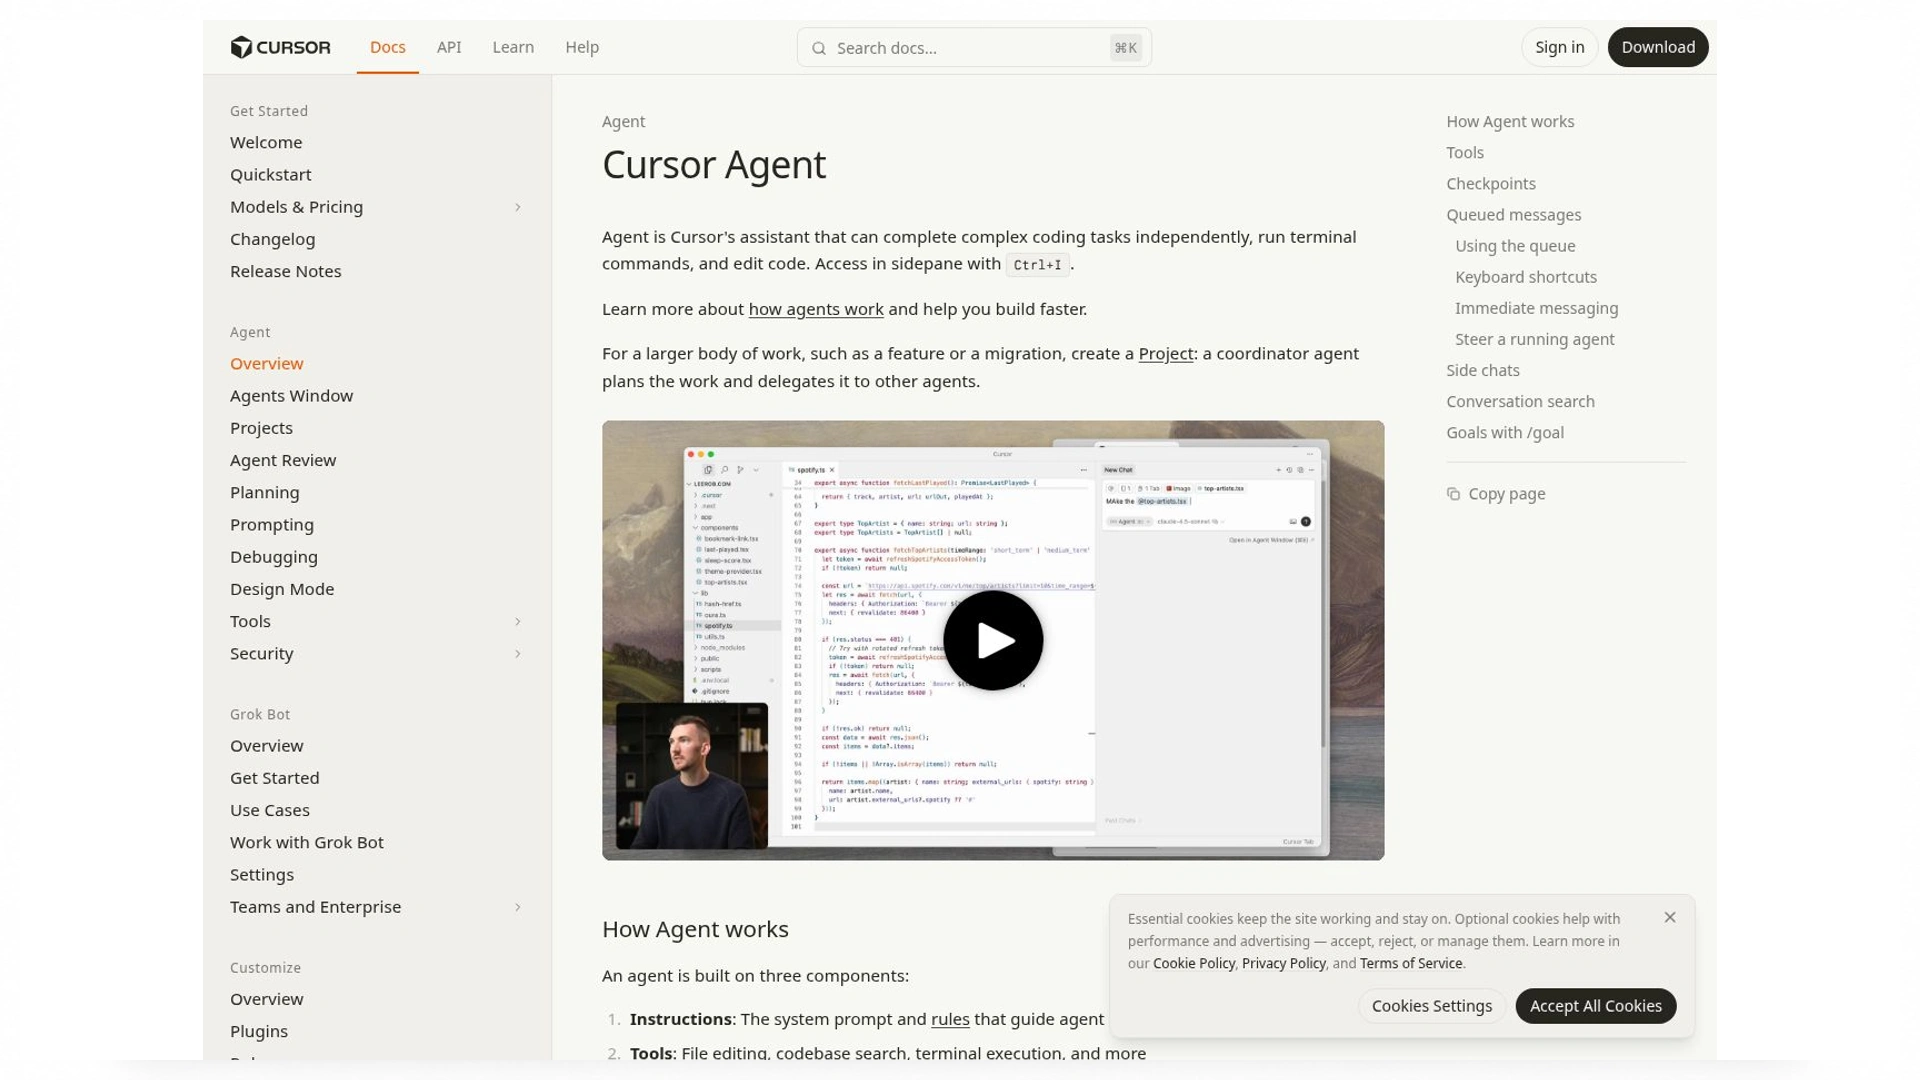
Die Agentenübersicht beschreibt Planung, Umsetzung und verwandte Workflow-Fähigkeiten. Eine Dokumentationsaufnahme, kein gemessenes Coding-Ergebnis.
Cline für konfigurierbare Agenten und Modellzugriff
Cline bietet mehrere Wege, einen Agenten zu betreiben, darunter eine IDE-Erweiterung und ein CLI, mit konfigurierbarem Modellzugriff. Sie können einen Service im Plan-Modus prüfen und in den Act-Modus wechseln, sobald die vorgeschlagene Änderung Ihren Anforderungen entspricht. Das ist nützlich, wenn Sie Anbieter vergleichen oder die Kontrolle über das Setup hinter einer Generierungsaufgabe behalten wollen. Anbieter-Credentials, integrierte Nutzungsabrechnung und das optionale ClinePass-Abonnement sind unterschiedliche Zugangswege. Die Agent-Software und die aufgerufene Inferenz verursachen getrennte Kosten. Modellfähigkeit, Freigabeeinstellungen und die Menge des bereitgestellten Kontexts beeinflussen alle, wie die Arbeit abläuft.
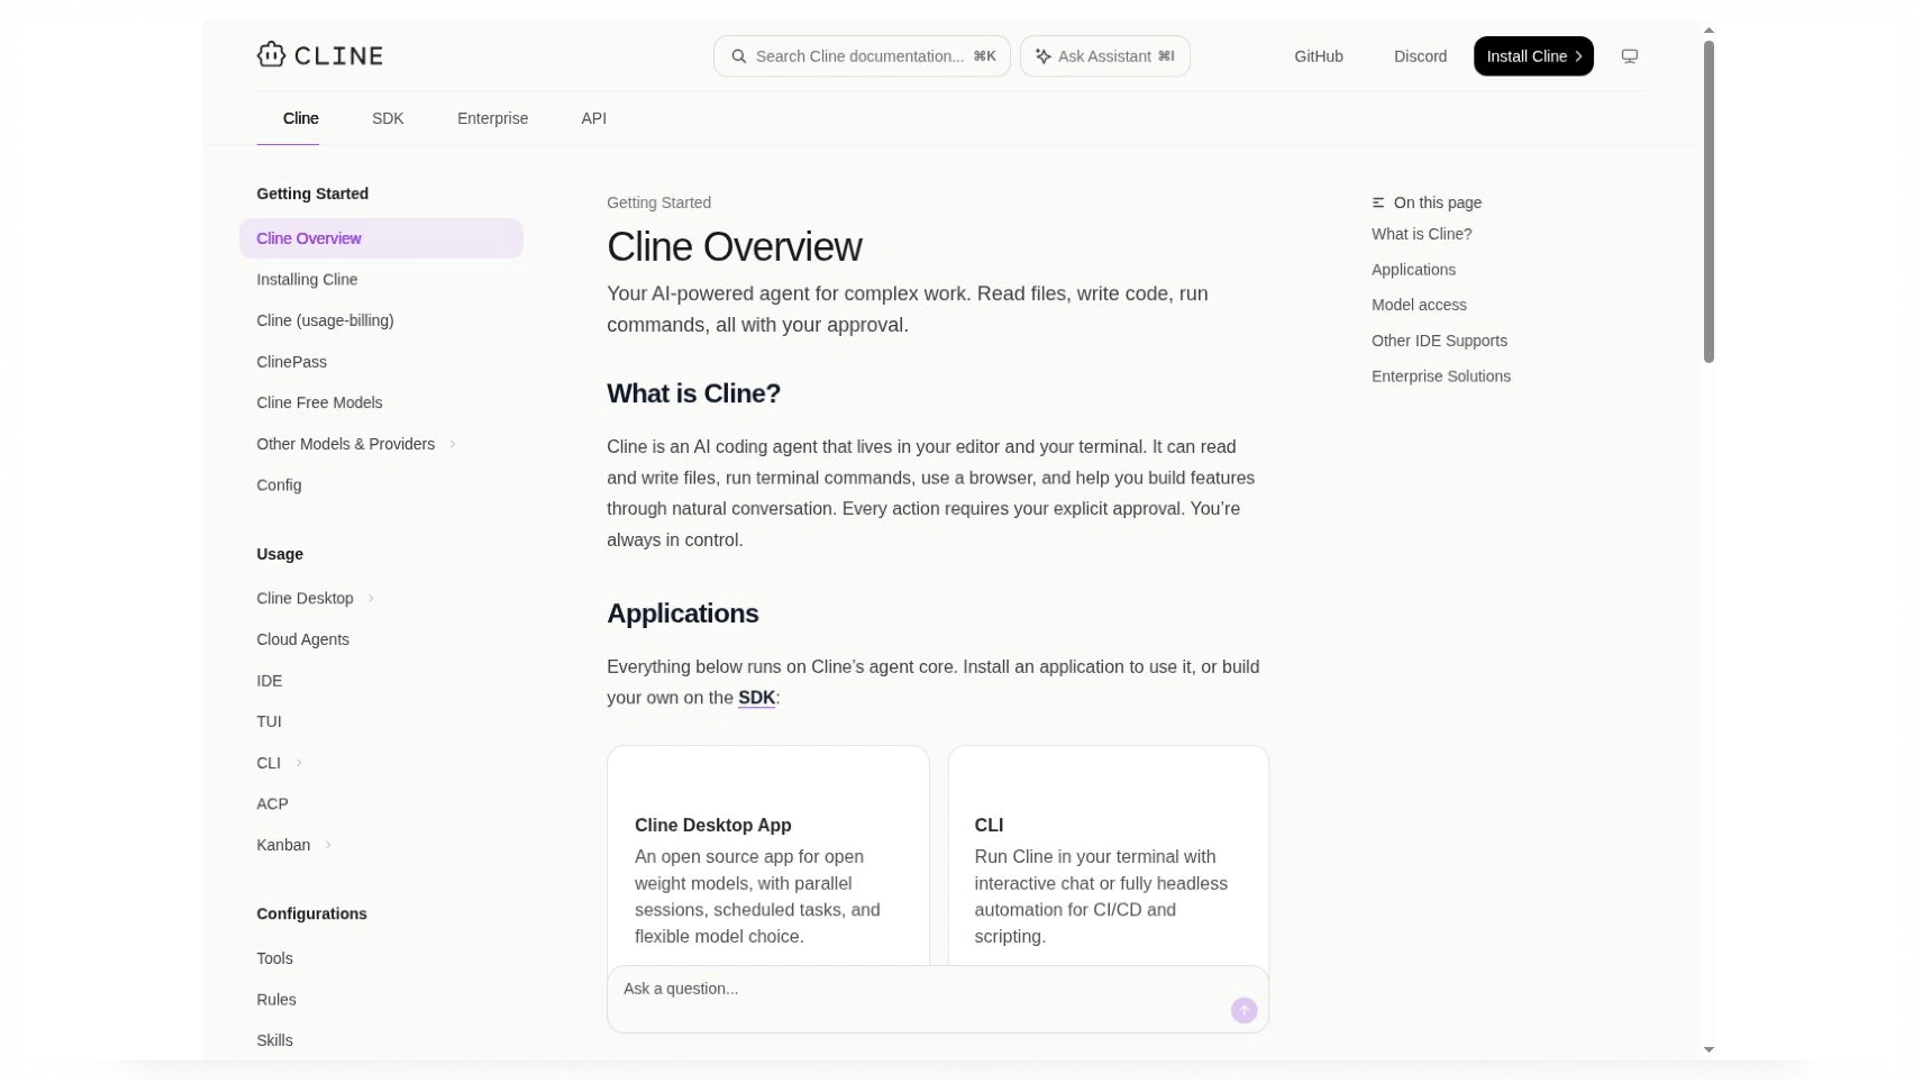
Die Übersicht beschreibt die verfügbaren Agentenoberflächen und Modellzugriffswege. Eine Dokumentationsaufnahme; kein Vergleichstest impliziert.
Claude Code für Terminal- und Repository-Arbeit
Claude Code eignet sich für Repository-Arbeit, bei der Dateien lesen, Code ändern und Befehle ausführen in dieselbe Sitzung gehören. Es ist über Terminal-, IDE-, Desktop- und Web-Workflows verfügbar. Fügen Sie einem bestehenden Service einen Endpunkt hinzu, sind Routing-Konventionen, Auth-Middleware, Response-Schema und Testbefehl die relevanten Details. Ein brauchbares Ergebnis folgt diesen Mustern und erklärt jede nötige Konfigurationsänderung. Abonnement- und API-Zugang sind getrennte Abrechnungswege, prüfen Sie also, welchen Ihre Sitzung nutzt. Der Terminal-Workflow ist besonders relevant, wenn Sie bereits auf lokale Build-Tools und Kommandozeilen-Debugging setzen.
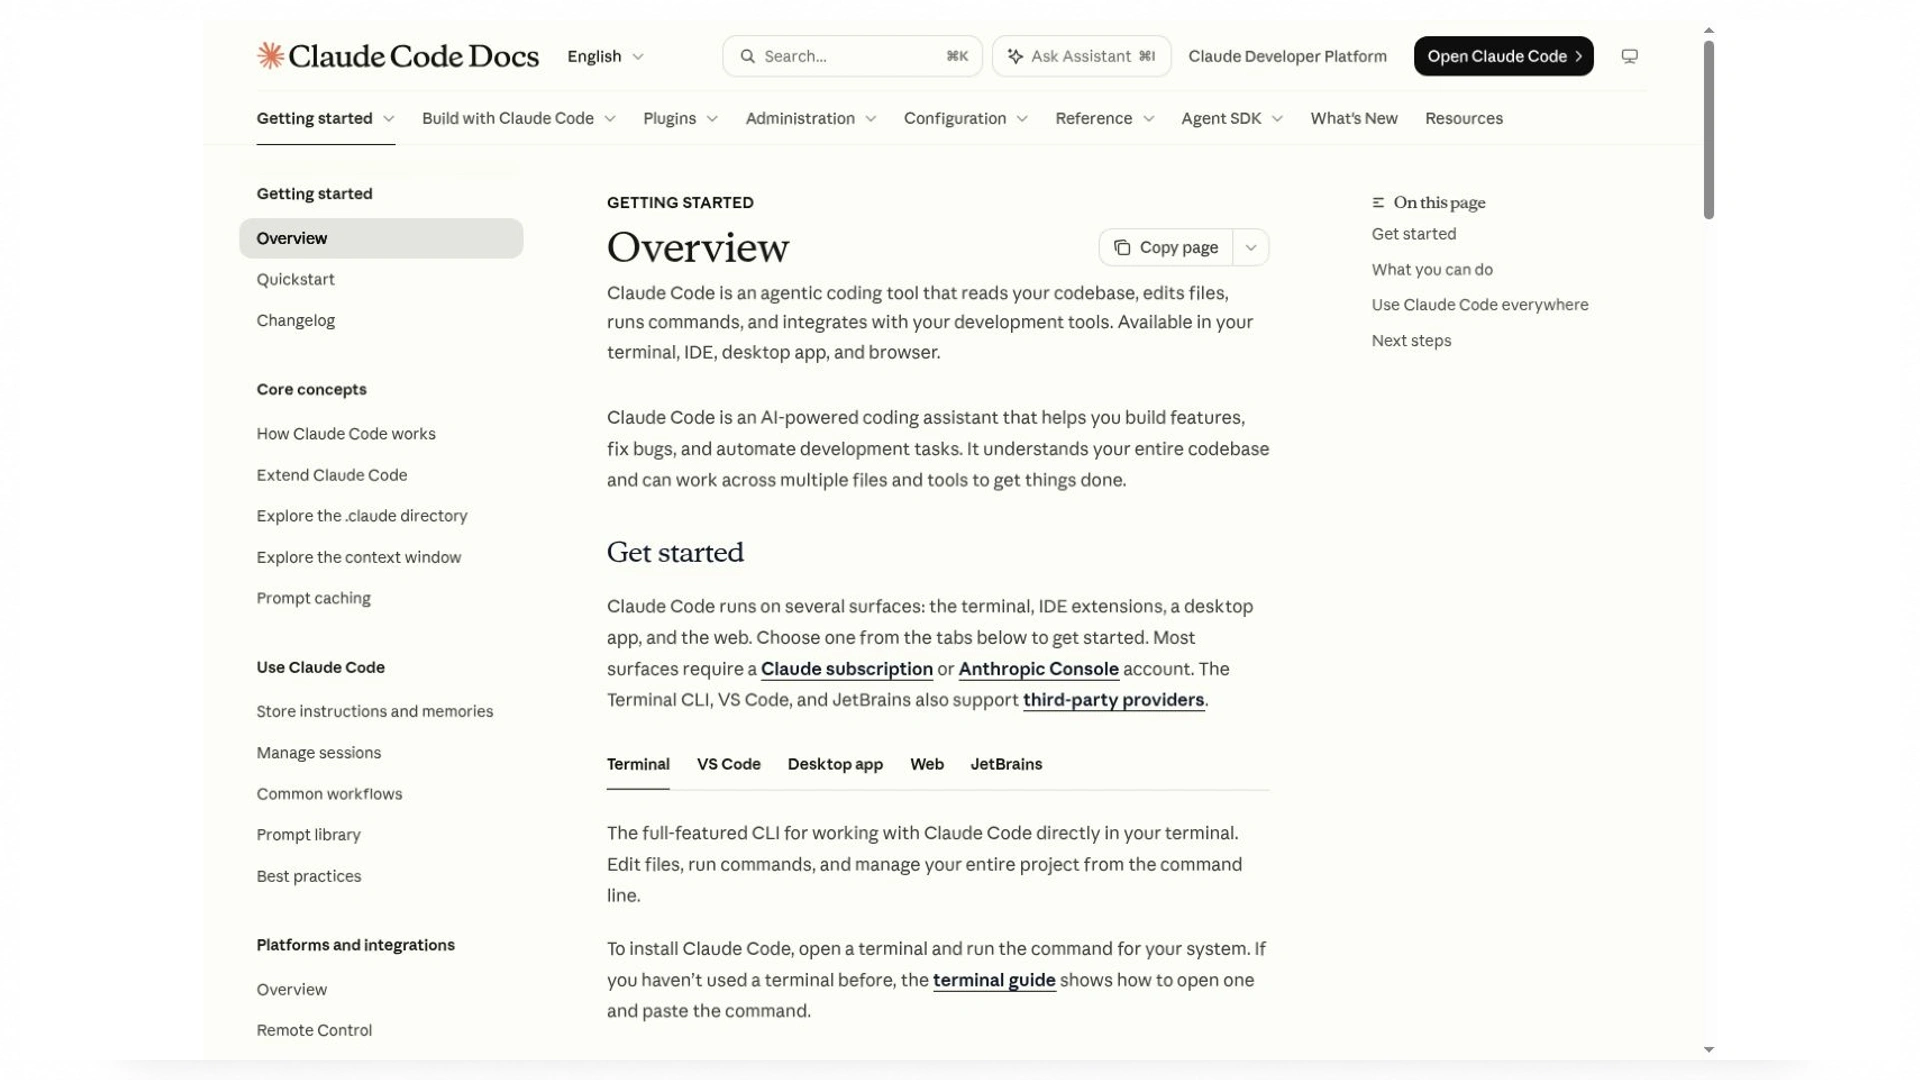
Die Übersicht erklärt die Entwicklungsoberflächen und den Datei-und-Befehls-Workflow. Sie begründet kein Performance-Ranking.
v0 für Interfaces und Next.js-Anwendungen
v0 lohnt sich für interface-getriebene Webentwicklung, etwa einen responsiven Preiskonfigurator oder ein Kundenportal. Die aktuellen Fähigkeiten reichen bis zu Full-Stack-Anwendungen, Datenbankverbindungen und Backend-Logik. Next.js ist der Standard, andere Frameworks sind aber möglich. Ihre Bewertung sollte barrierefreie Formularlabels, Tastaturfokus, mobile Layouts, Ladezustände und den Code, der eingereichte Werte verarbeitet, abdecken. Ein Preis-Steuerelement, das korrekt aussieht, kann dennoch einem vom Browser gelieferten Wert vertrauen. Berechnungs- und Autorisierungsregeln auf dem Server zu halten, ist eine separate Anforderung von der Reproduktion eines polierten Designs.
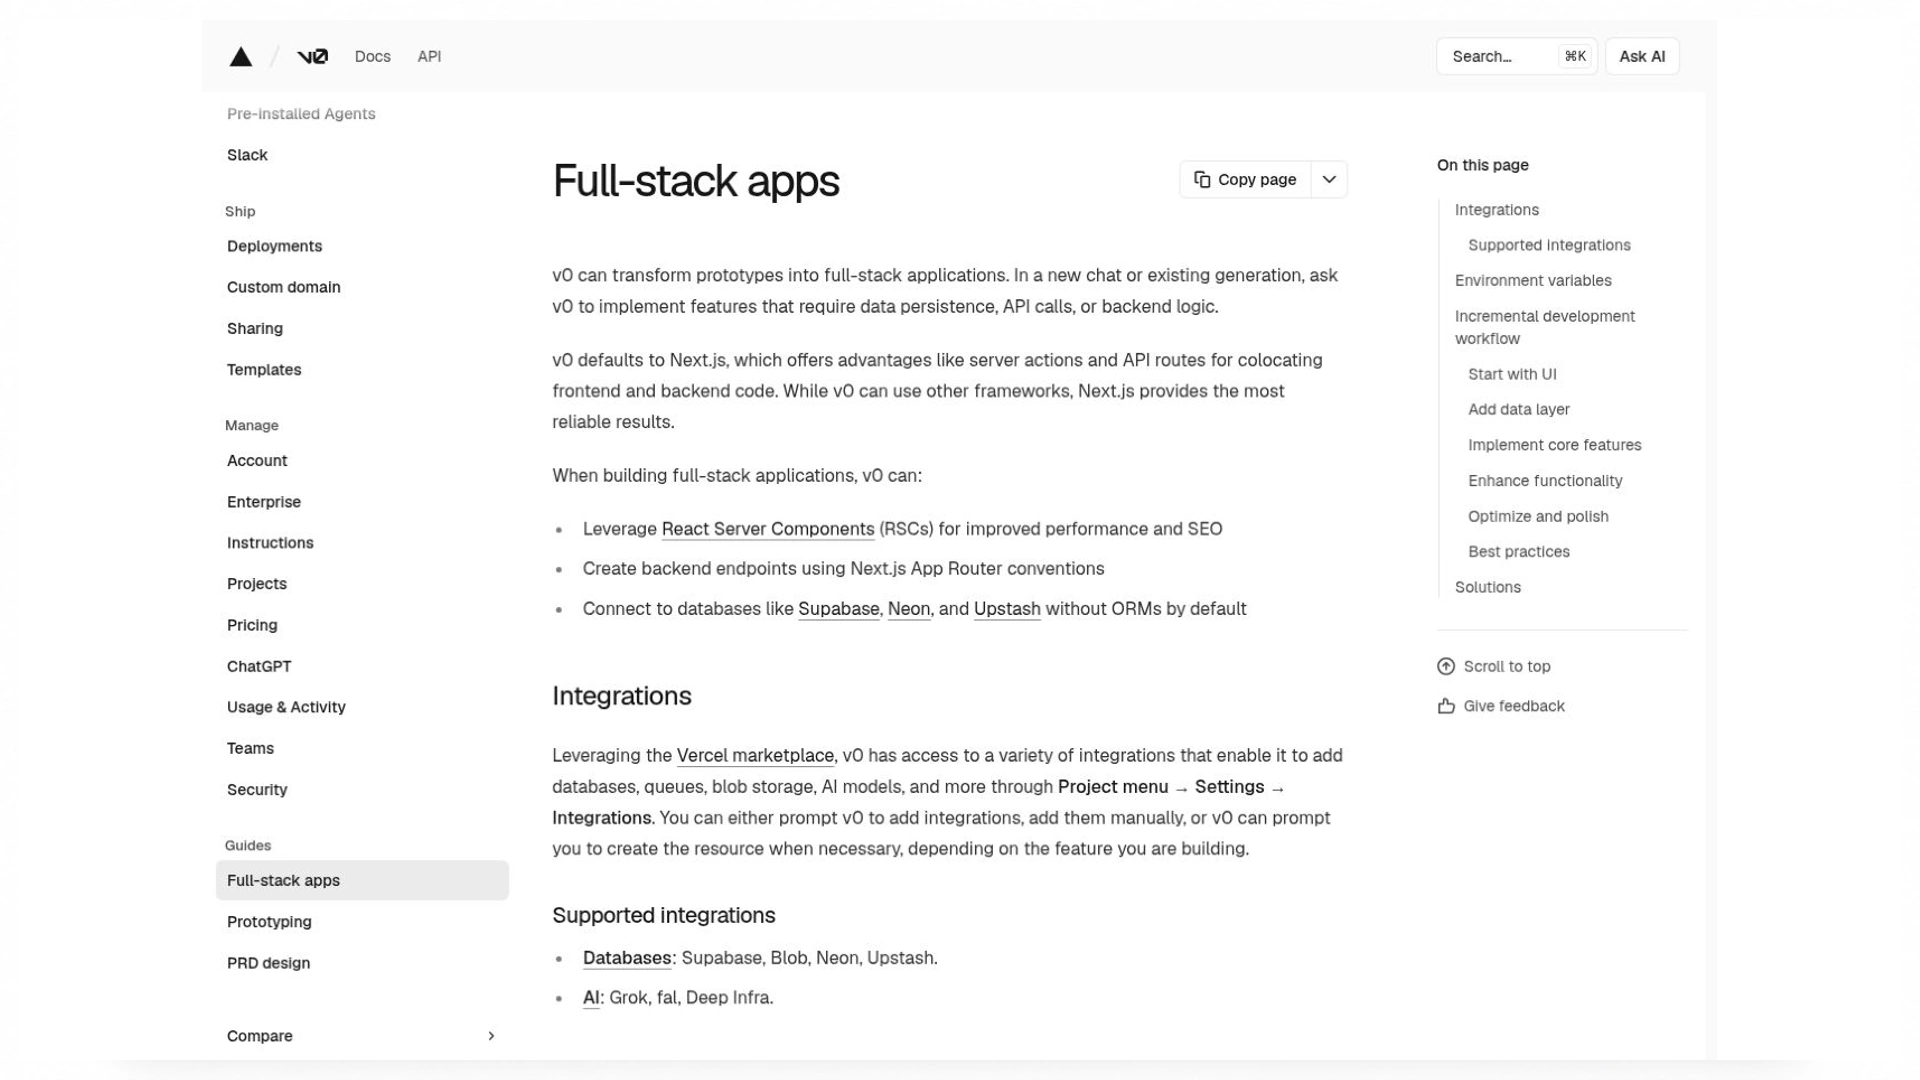
Offizielle v0-Dokumentation
Die Full-Stack-Anleitung deckt mehr als reine Interface-Generierung ab. Backend-Validierung bleibt eine separate Abnahmeanforderung.
Replit Agent für einen gehosteten Entwicklungsworkflow
Replit Agent bringt Projektaufbau, Generierung, Iteration und Veröffentlichung in einen gehosteten Workflow. Das reduziert lokales Setup, wenn Sie ein internes Dashboard bauen und schnell eine Vorschau prüfen wollen. Prüfen Sie das aktuelle Agent-Kontingent des Kontos und den Abrechnungsweg, statt anzunehmen, dass Entwicklung und Hosting ein unbegrenztes Kontingent teilen. Veröffentlichung bringt zusätzliche Konfiguration, persistente Daten, Auth-Redirects und Ressourcenverbrauch mit sich. Ein Feature, das in der Vorschau funktioniert, kann nach der Veröffentlichung fehlschlagen, wenn eine Umgebungsvariable oder Callback-URL abweicht. Die gehostete Umgebung ist eine Erleichterung; das operative Verhalten muss trotzdem verifiziert werden.
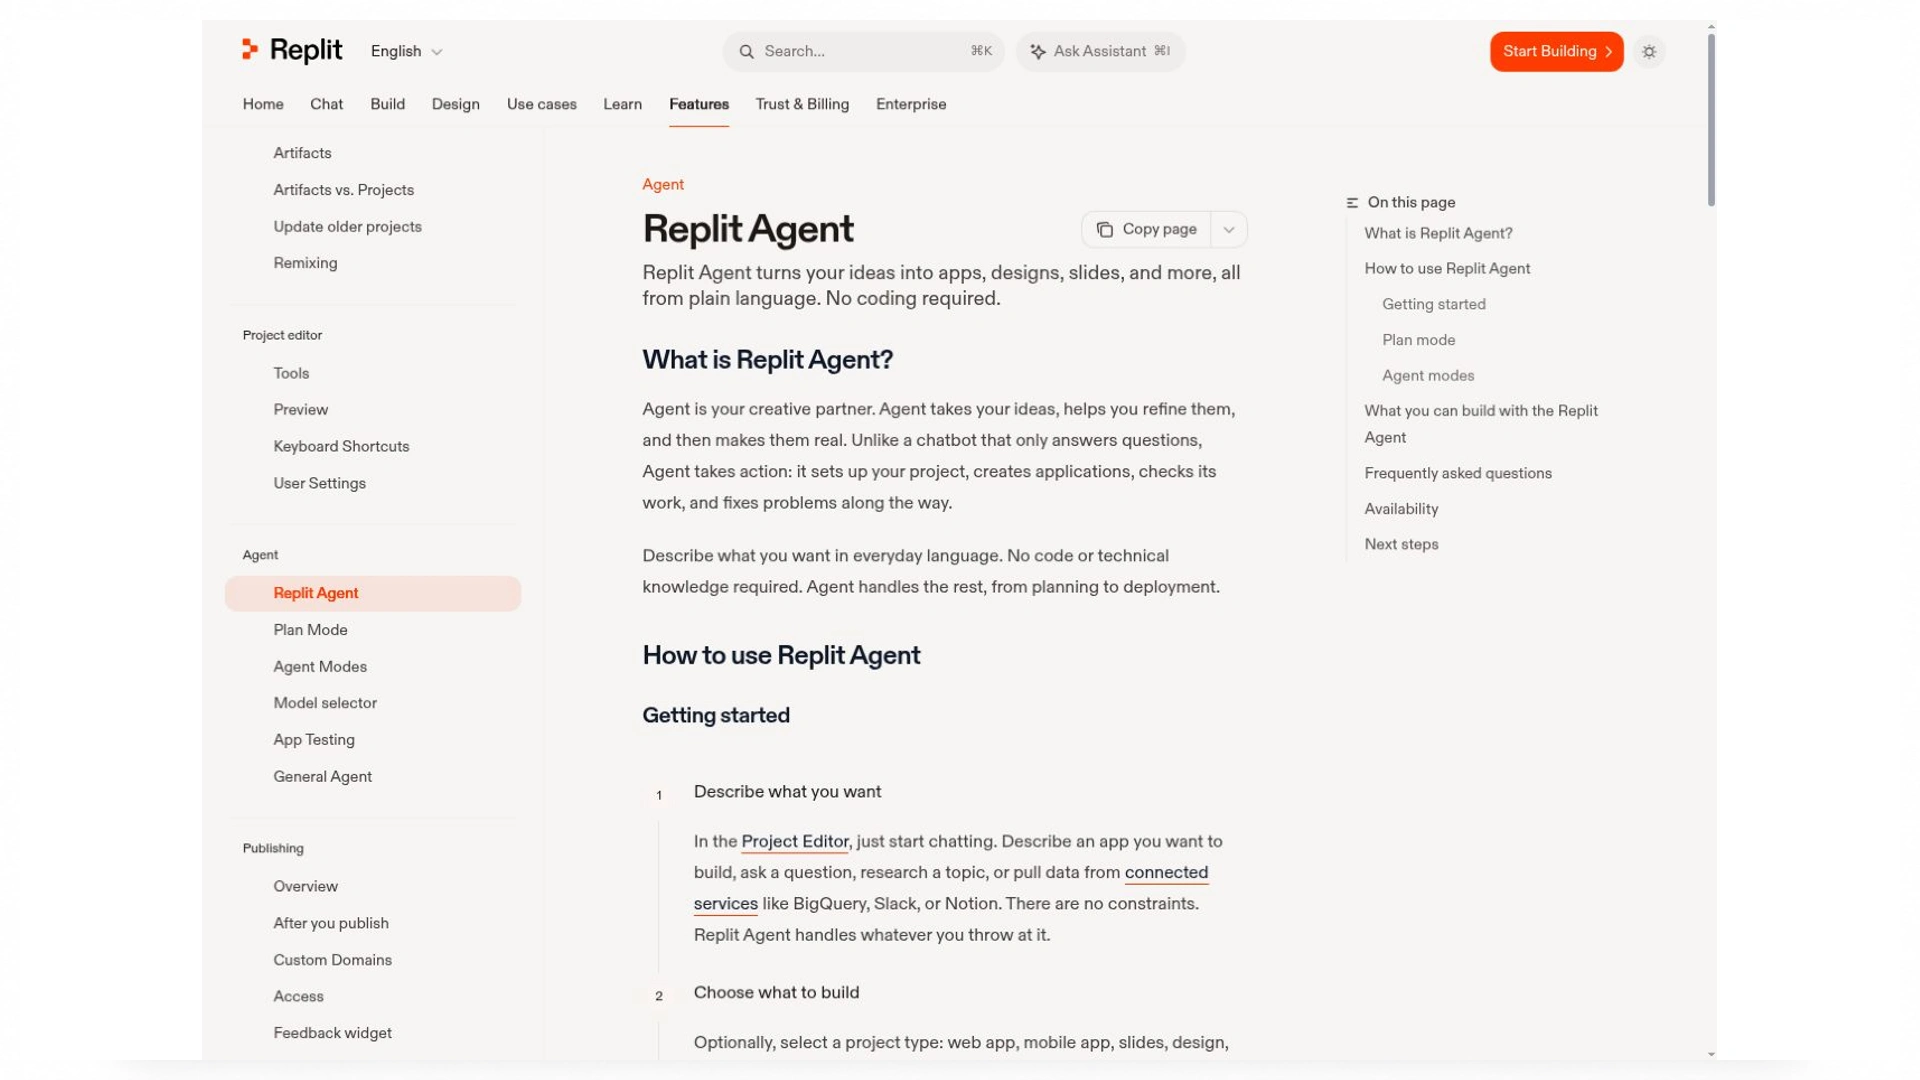
Die Dokumentation beschreibt den gehosteten Projekt-Workflow. Vorschau, Veröffentlichung und Ressourcennutzung brauchen eigene Prüfungen.
Welches ist der beste kostenlose KI-Codegenerator
Ein kostenloser Plan ist nützlich, wenn sein Kontingent die Aufgabe abdeckt, die Sie erledigen müssen. Begrenzter gehosteter Zugang, Aktionsmodelle und lokale Inferenz bieten unterschiedliche Trade-offs. Eine kostenlose Erweiterung kann trotzdem einen kostenpflichtigen Anbieter aufrufen; ein lokales Modell vermeidet diese Anbieterkosten, nutzt aber Ihre Hardware und braucht Zeit zur Konfiguration. Vervollständigungslimits unterscheiden sich auch von Chat- oder Agent-Kontingenten. Prüfen Sie vor der Festlegung auf einen Workflow, welche Aktionen das Kontingent verbrauchen und ob Veröffentlichung oder Pflege der entstandenen Anwendung separate Kosten verursacht.
Ein kleiner Test zeigt mehr als ein großzügig wirkendes Kontingent. Generieren Sie ein Utility, führen Sie es mit normalen und ungültigen Eingaben aus und nehmen Sie eine gezielte Korrektur vor. Beachten Sie, ob das Tool den Fehler selbst untersuchen kann oder ob Sie Logs zwischen Fenstern kopieren müssen. Prüfen Sie dann das verbleibende Kontingent. Eine Aufgabe kann mehrere Modell-Durchläufe verbrauchen, während der Agent Dateien liest, Code ändert, eine Prüfung ausführt und eine Reparatur versucht. Aktuelle Kontingente und Werbeangebote können sich ändern, daher ist der Nutzungsbildschirm Ihres Kontos eine bessere Planungsreferenz als eine alte Zusammenfassung.
Der beste kostenlose KI-Codegenerator ist der, in dessen Grenzen Sie für eine vollständige, prüfbare Aufgabe arbeiten können. Ein hohes kostenloses Kontingent nützt wenig, wenn das Tool die relevanten Dateien nicht lesen oder die Prüfung Ihres Projekts nicht ausführen kann. Halten Sie die erste Bewertung klein genug, um sie abzuschließen, und bewahren Sie die Quelle lokal oder in Ihrem Repository auf. Ihre nächste Änderung sollte nicht davon abhängen, eine lange Konversation wiederzufinden oder eine nicht mehr zugängliche Vorschau nachzubauen.
Nach Sprache, Framework und Projektreife wählen
Python-Automatisierung und Datenverarbeitung
Automatisieren Sie Alltagsaufgaben mit Python und vereinfachen Sie Ihren Workflow.
Python-Automatisierung profitiert von vorhersehbaren Transformationen und expliziter Fehlerbehandlung. Für ein CSV-Bereinigungsskript definieren Sie die Kodierung, Spaltentypen, Duplikat-Policy und den Umgang mit fehlenden Werten. Entscheiden Sie, ob eine ungültige Zeile den Job stoppt oder in einen separaten Fehlerbericht wandert. Falls die Datei groß sein könnte, verlangen Sie Streaming- oder Chunk-Verarbeitung statt alles ohne Grund in den Speicher zu laden. Halten Sie die Originaldatei intakt und prüfen Sie, dass ein zweiter Lauf keine doppelten Ausgaben erzeugt. Diese Anforderungen machen das generierte Utility vertrauenswürdiger als eine Fünf-Zeilen-Demonstration.
Frontend- und Full-Stack-Webentwicklung
Frontend-Arbeit braucht mehr als visuelle Ähnlichkeit. Ein React- oder Next.js-Formular sollte nutzbare Labels, vorhersehbaren Fokus, passende Ladezustände und Validierung sowohl auf dem Server als auch im Browser haben. Routing und State-Management sollten der bestehenden Anwendung folgen. Nutzen Sie Vue, Django, Laravel oder einen anderen Stack, sollte die generierte Änderung zu diesem Stack und seiner aktuellen Version passen. Das Einführen eines bevorzugten Frameworks, einer doppelten Komponentenbibliothek oder eines zweiten Auth-Systems kann aus einem kleinen Feature eine Migration machen, die Sie nie angefordert haben.
Legacy-Services und Team-Repositories
Ein etablierter Service braucht meist einen kleinen, kompatiblen Patch. Während einer Endpunkt-Migration können bestehende Aufrufer weiterhin vom vorherigen Feldnamen oder Response-Format abhängen. Eine generierte Änderung sollte diesen Übergang berücksichtigen, statt überall einen String zu ersetzen und die Arbeit für erledigt zu halten. Prüfen Sie Autorisierung, Abhängigkeitsänderungen, Datenbankmigrationen und Tests, die älteres Verhalten schützen. Ein fokussierter Patch lässt sich leichter prüfen und zurücknehmen. Vertraute Konventionen zählen auch, wenn ein anderes Teammitglied das Feature Monate nach Ende der Generierungssitzung debuggen muss.
Abhängigkeitsänderungen verdienen eine eigene Prüfung. Prüfen Sie, ob der Generator ein Paket hinzugefügt hat, um einen bereits vorhandenen Helper zu vermeiden, das Lockfile unerwartet geändert oder eine Runtime eingeführt hat, die Ihr Deployment nicht ausführen kann. Bei einer Schema-Migration identifizieren Sie die Vorwärtsänderung, das Kompatibilitätsfenster und den Rückweg. Ein Patch, der ein gleichzeitiges Update aller Aufrufer erfordert, kann für einen unabhängig deploybaren Service ungeeignet sein, selbst wenn seine lokalen Tests bestehen.
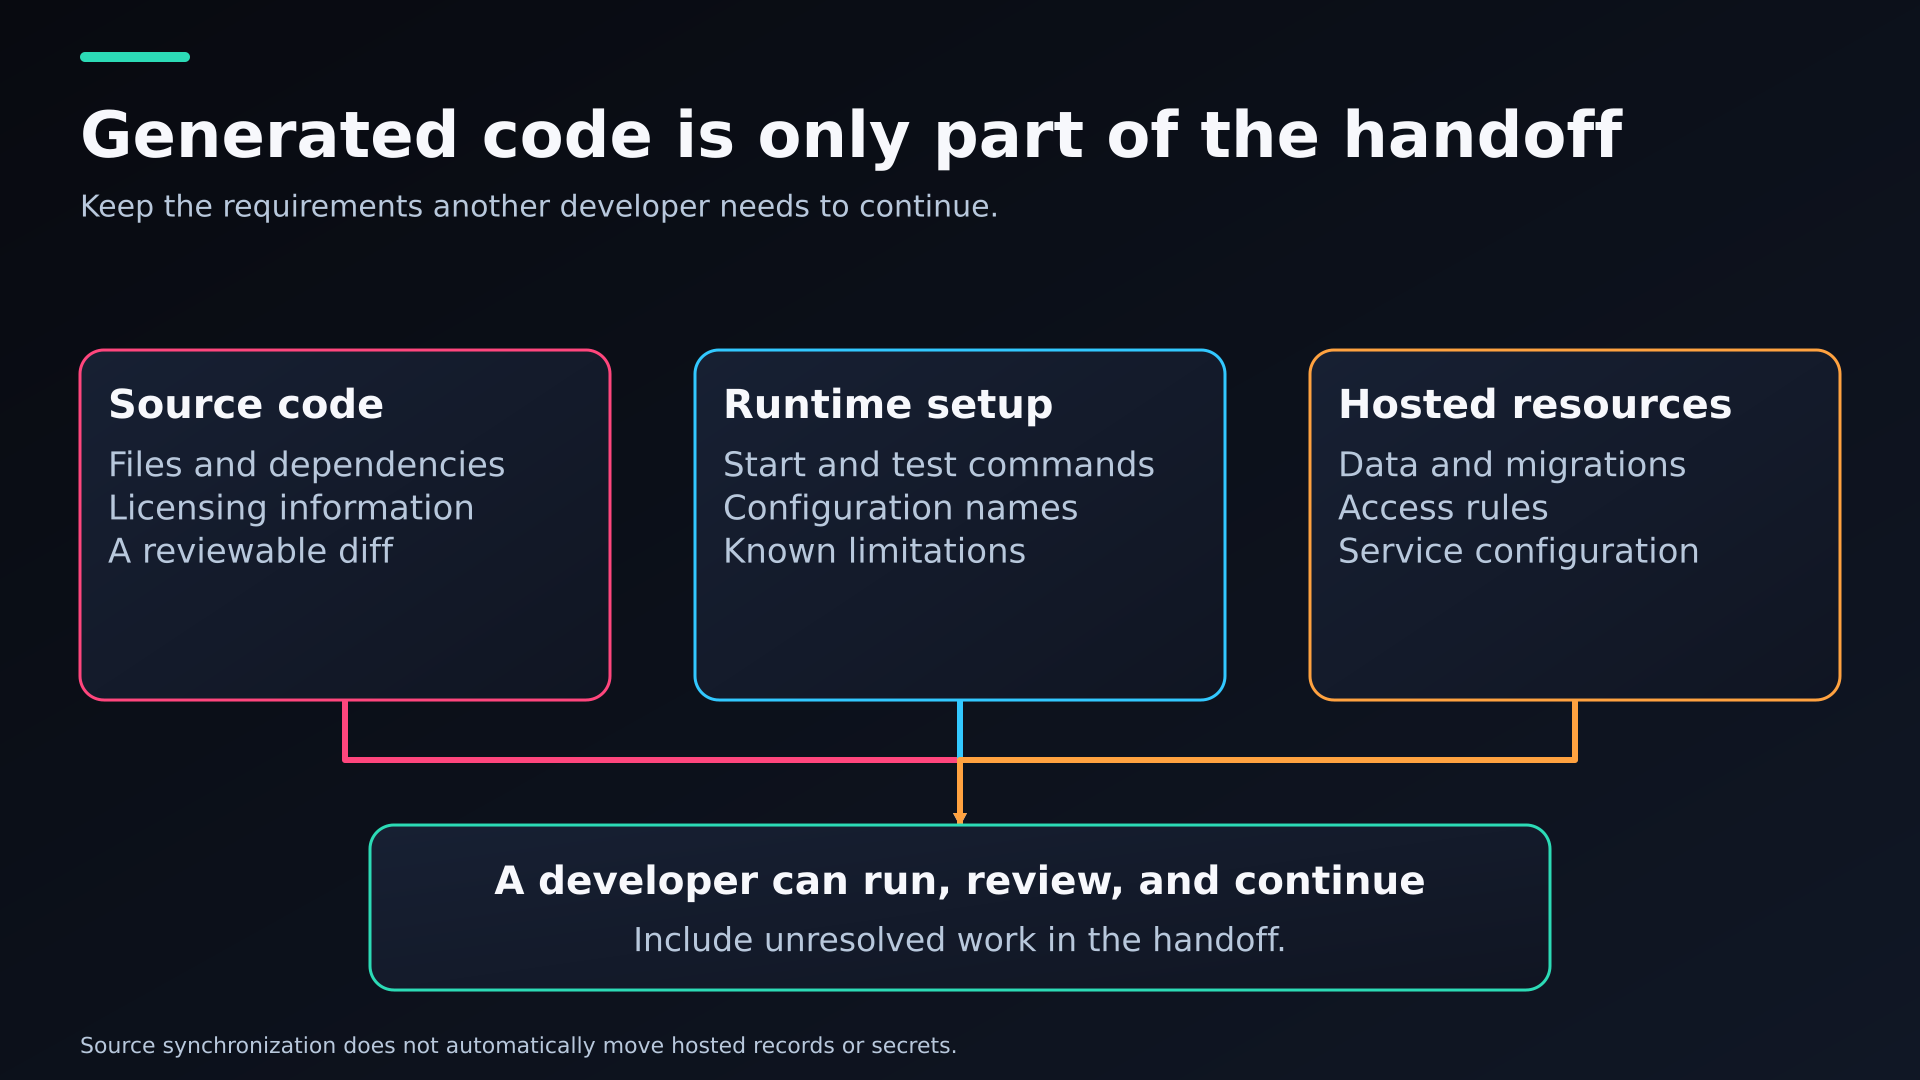
Ein Übergabediagramm, das Quelldateien, Runtime-Setup und die Konfiguration gehosteter Ressourcen trennt.
Geben Sie Ihrem Generator einen prüfbaren Vertrag
Ein starker Generierungs-Prompt definiert Ziel, aktuellen Stack, relevante Dateien, Beispiele, Einschränkungen und einen Verifizierungsbefehl. Das gibt dem Tool einen Vertrag, den es prüfen kann. Für einen Parser könnte der Vertrag exakte Outputs für gültige und fehlerhafte Eingaben festlegen. Für eine API könnte er Response-Felder, Statuscodes und Zugriffsregeln definieren. Halten Sie diese Anforderungen im Projekt fest, damit sie eine neue Sitzung überleben. Der Prompt sollte den Agenten auch verpflichten, zu berichten, welche Befehle er ausgeführt hat, und eine erfolgreiche Prüfung von einer zu unterscheiden, die er nicht ausführen konnte.
Beispiel-Prompt: „Implementiere in diesem Python-Projekt normalize_email_list mit den vorhandenen Abhängigkeiten. Entferne umgebende Leerzeichen, erhalte die Groß-/Kleinschreibung der Adresse, entferne exakte Duplikate nach dem Trimmen, weise leere Werte zurück und gib ungültige Einträge separat zurück. Füge Testfälle für leere Eingabe, wiederholte Adressen und fehlerhafte Werte hinzu. Erkläre den Patch und führe den vorhandenen Testbefehl aus. Ändere keine unbeteiligten Dateien.“
Ein nützliches Follow-up identifiziert eine Abweichung: „Der Leer-Eingabe-Fall gibt einen Datensatz zurück, der Vertrag verlangt aber eine leere Liste.“ Das gibt dem Agenten einen reproduzierbaren Fehler und begrenzt unnötige Änderungen. API-Tests sollten unautorisierte Anfragen ebenso prüfen wie erfolgreiche. SQL-Generierung braucht parametrisierte Abfragen, sinnvolle Ergebnislimits und einen Ausführungsplan, wenn Performance zählt. Ihr Generator wird leichter zu beurteilen, wenn für jeden Kandidaten dieselben Eingaben, erwarteten Verhaltensweisen und Verifizierungsprozesse gelten.
Die Frage „Was ist der beste KI-Codegenerator?“ wird nützlicher, wenn eine konkrete Einschränkung folgt: für einen bestehenden Python-Service, einen Next.js-Prototyp oder ein Offline-Utility. Halten Sie Beispiele und erwartete Outputs in einer versionierten Task-Datei fest. Bitten Sie das Tool, diese Erwartungen zu erhalten, statt sie an seinen ersten Versuch anzupassen. Das macht spätere Wiederholungen vergleichbar und hinterlässt einem anderen Entwickler eine klarere Erklärung der Änderung.
Akzeptierten Code und Gesamtkosten messen
Akzeptierter Code ist ein besseres Maß als generierte Zeilen. Verfolgen Sie erfüllte Anforderungen, Korrekturrunden, Regressionen und die Zeit, die zur Prüfung des Patches nötig ist. Prüfen Sie, ob ein Reviewer die Implementierung erklären kann und ob das ursprüngliche Verhalten noch funktioniert. Vom Generator geschriebene Tests können helfen, aber sie können dieselbe falsche Annahme wie sein Code wiederholen. Behalten Sie einige unabhängig definierte Abnahmefälle und prüfen Sie Änderungen an bestehenden Tests. Ein bestandenes Ergebnis ist weniger überzeugend, wenn der Agent die Assertion entfernt hat, die den Fehler aufgedeckt hätte.
Produktivitätsforschung braucht ebenfalls Kontext. METRs Experiment aus Anfang 2025 umfasste 16 erfahrene Entwickler, die an 246 Issues in vertrauten Open-Source-Repositories arbeiteten, und berichtete eine Verlangsamung von 19% bei KI-Zugang. Das Follow-up vom Februar 2026 beschrieb Selektionseffekte und Messschwierigkeiten, die die neueren Ergebnisse schwer interpretierbar machten. Diese Befunde legen nicht fest, welches Tool heute für Ihr Projekt am besten funktioniert. Sie zeigen aber, warum gefühlte Geschwindigkeit, Benchmark-Scores und erledigte Arbeit unterschiedliche Maße sind. Ihr eigener Vergleich sollte Review- und Reparaturzeit einbeziehen.
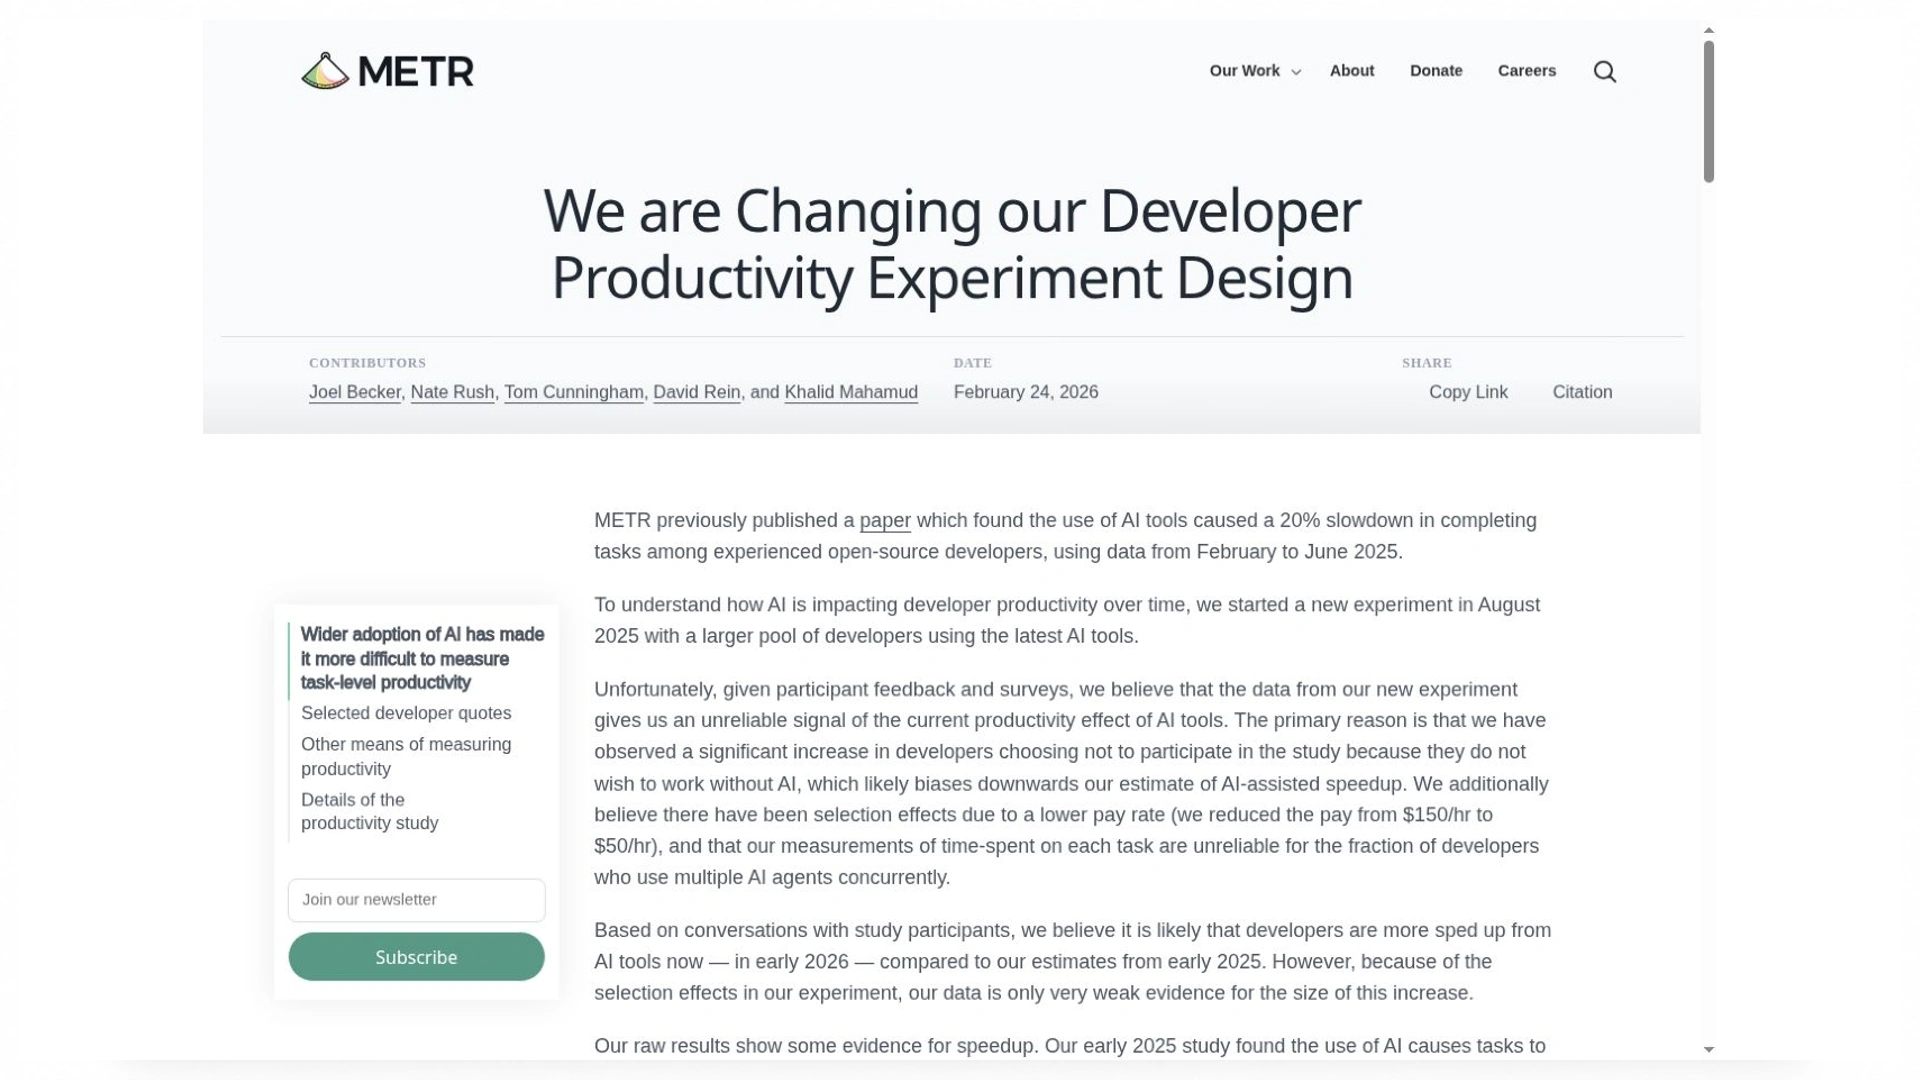
Das Update von Februar 2026 diskutiert Einschränkungen bei der Schätzung des aktuellen Produktivitätseffekts. Eine Aufnahme einer Forschungsseite.
Angenommen, ein Test verursacht 12 Dollar an Generierungskosten und produziert sechs akzeptierte Tasks. Das sind 2 Dollar pro akzeptierter Task vor Abonnements, Hosting und menschlichem Review. Sind erfolglose Versuche bereits in den 12 Dollar enthalten, lassen Sie sie drin; ein Ausschluss würde das Tool künstlich günstiger wirken lassen. Vergleichen Sie gleichwertige Aufgaben über denselben Abrechnungszeitraum. Ich würde außerdem Review-Minuten separat erfassen, denn eine niedrigere Inferenzrechnung nützt wenig, wenn jede Änderung erheblich mehr Debugging erfordert. Dies ist eine veranschaulichende Rechnung, keine Aussage über die Ergebnisse eines bestimmten Anbieters.
Enter Pro bewerten, indem Sie ScopeQuote bauen
ScopeQuote ist ein fiktiver Agentur-Kostenrechner, dokumentiert in Enter Pro. Ein Kunde wählt Leistungen aus, prüft eine Summe und sendet eine Anfrage zur späteren Prüfung durch die Agentur. Die Bilder zeigen den Plan, den Kostenrechner, die Bestätigung und das Besitzer-Login-Gate. Das reicht, um die sichtbare Journey zu untersuchen und die Backend-Prüfungen präzise zu definieren. Es ist keine dokumentierte Demonstration davon, dass ein Besitzer eine gespeicherte Anfrage liest oder ein manipulierter Browser-Preis abgelehnt wird.
Schritt 1: Den Kostenrechner und seinen Datenvertrag planen
Der Plan beginnt mit einem Landingpage-Paket für 30.000 Cent und einem SEO-Review für 15.000 Cent. Mengen sind ganze Zahlen von eins bis zehn. Halten Sie im Plan-Modus die öffentliche Schätzung, die Anfrageeinreichung und die private Besitzerprüfung an denselben Datenvertrag gebunden. Definieren Sie Service-IDs, kanonische Preise, Anfrage-Positionen und Autorisierung vor der Generierung. Zahlungen, Rabatte und automatischer E-Mail-Versand sind separate Features; diese erste Journey ist eine Anfrage mit Schätzung.
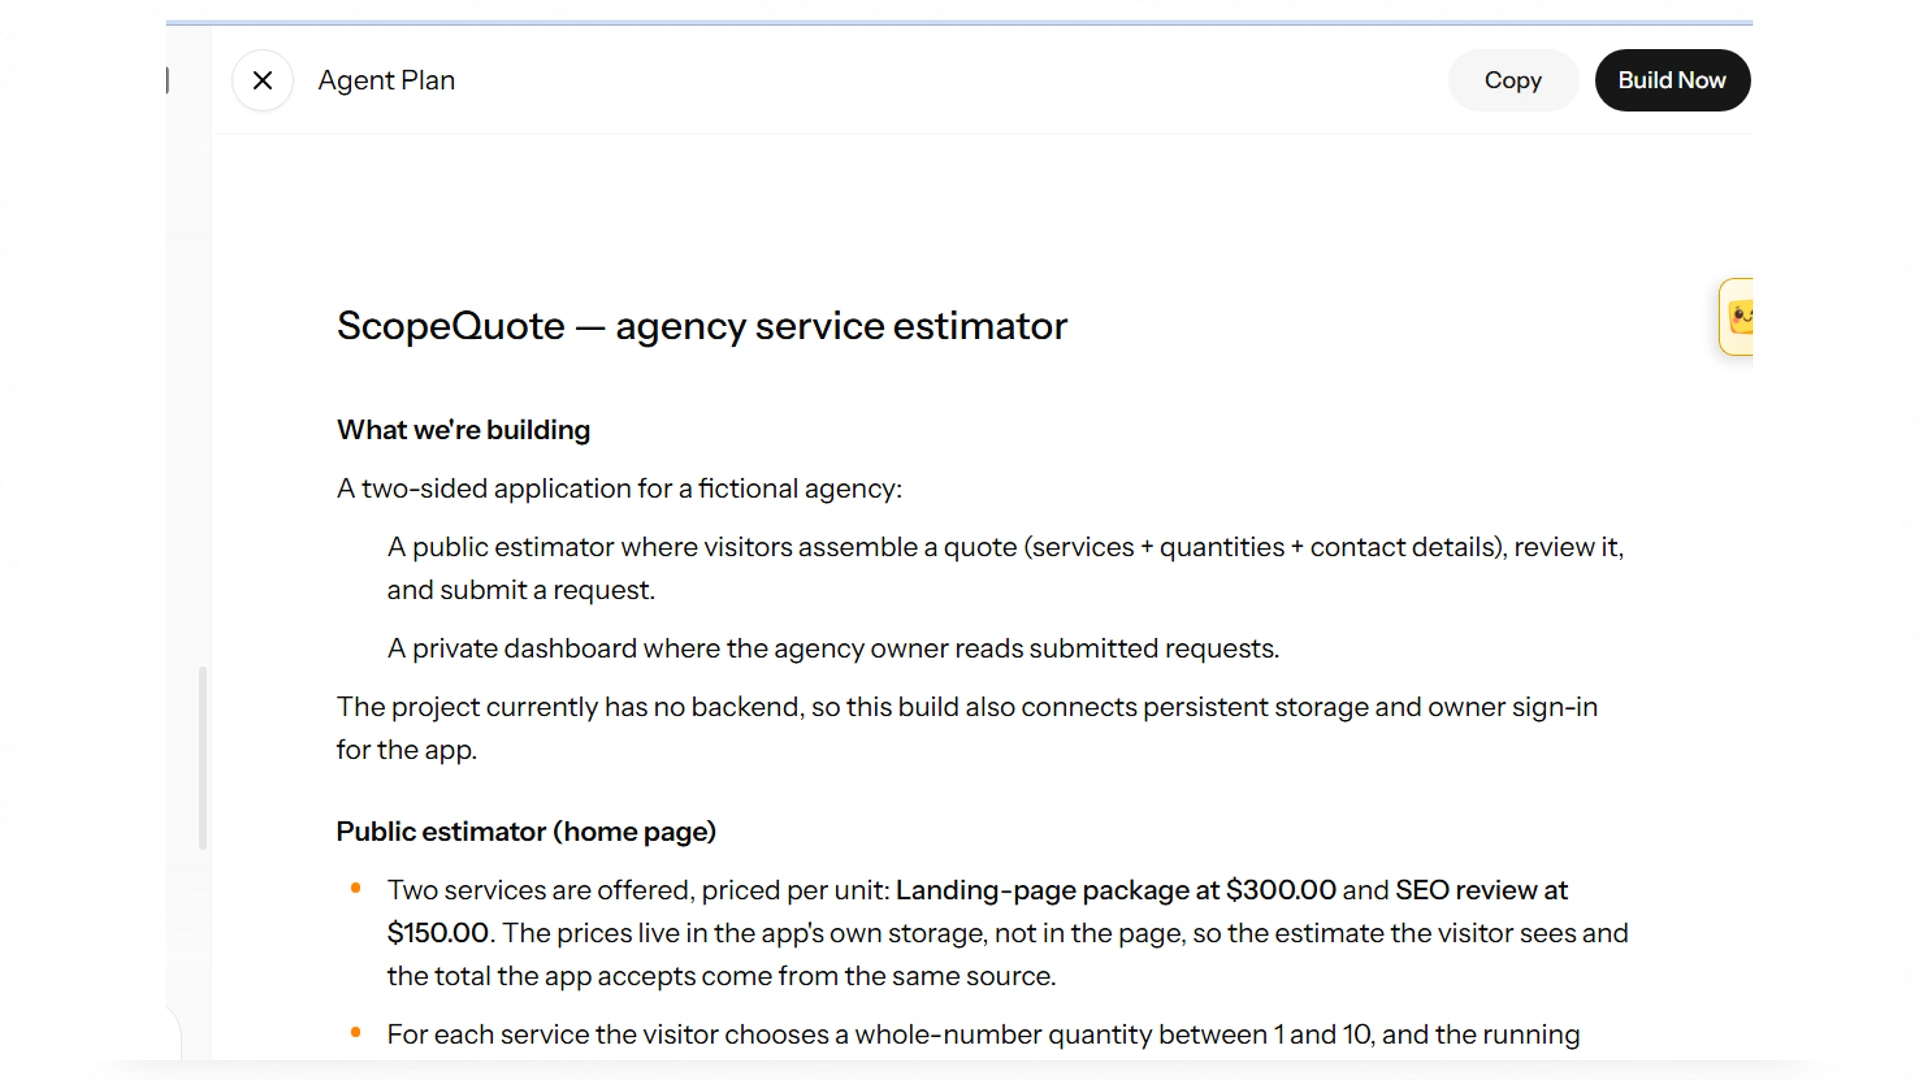
Der Plan verbindet einen öffentlichen Kostenrechner mit einer privaten Besitzerprüfung. Speicherung und Autorisierung erfordern Implementierungsprüfungen.
Schritt 2: Die Kundenjourney bauen und ihre Datensätze sichern
Der dokumentierte Kostenrechner wählt ein Landingpage-Paket für 300 $ und ein SEO-Review für 150 $ aus und erzeugt eine sichtbare Summe von 450 $. Die Aktion ist mit „Anfrage senden“ beschriftet und erklärt, dass keine Zahlung eingezogen wird. Diese Formulierung hilft, eine Schätzung nicht mit einer bezahlten Bestellung zu verwechseln. Prüfen Sie Mengensteuerungen, Tastaturnavigation und Lade- sowie Fehlerzustände neben der Vorschau. Das Bild zeigt die angezeigte Rechnung für diese Auswahl; es verrät nicht, wo die maßgebliche Summe berechnet wird.
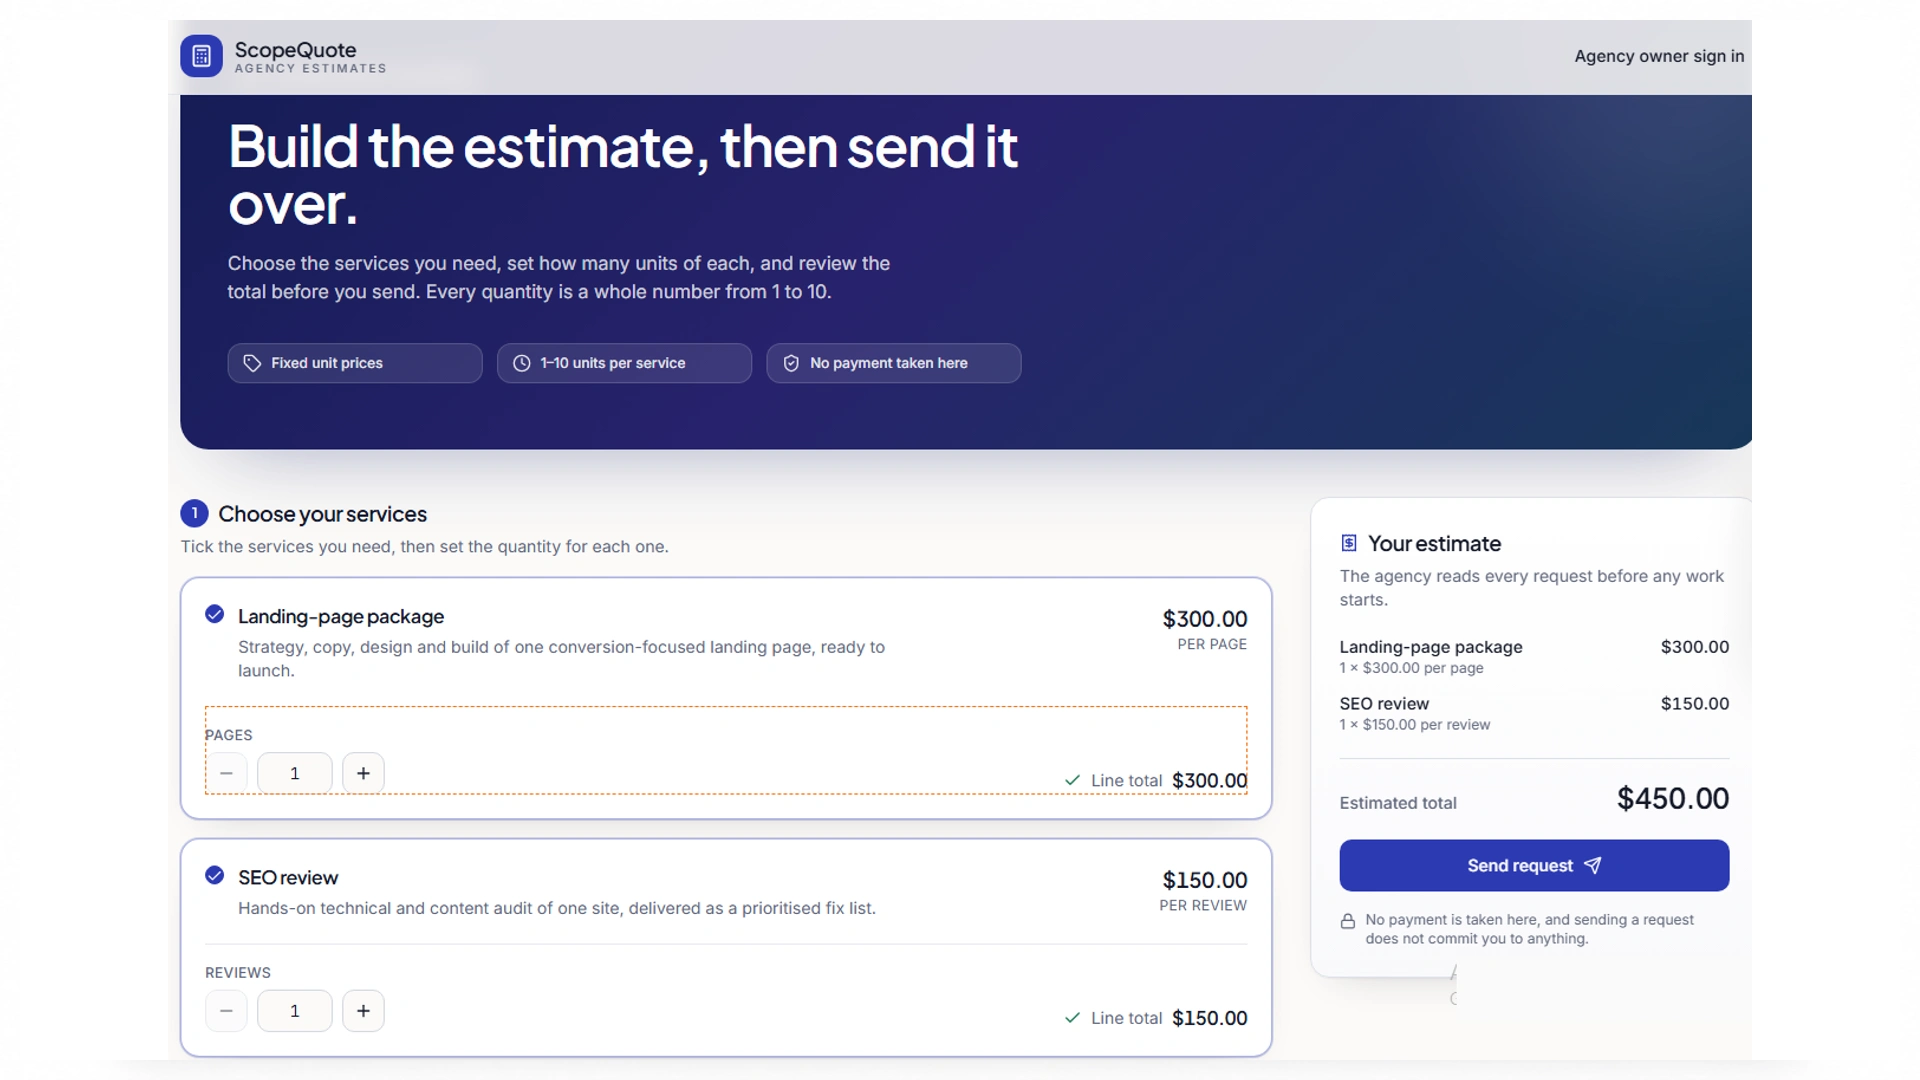
Ein Landingpage-Paket für 300 $ plus ein SEO-Review für 150 $ zeigt 450 $. Native Editor-Auswahlrahmen sind Teil der bereitgestellten Aufnahme.
Enter Cloud stellt Datenbank-, Authentifizierungs- und Funktionsfähigkeiten für eine Implementierung dieses Workflows bereit. Der Submit-Handler sollte kanonische Service-Preise laden und ganzzahlige Cent-Summen serverseitig berechnen, unbekannte Service-IDs und ungültige Mengen ablehnen – selbst wenn der Browser umgangen wird. Der bereitgestellte Besitzer-Bildschirm ist ein Login-Gate. Ein Gate ist ein nützlicher Interface-Nachweis, aber Regeln für private Leserechte müssen auch die zugrunde liegenden Anfragedaten schützen. Betrachten Sie ein verstecktes Dashboard nicht als Beweis dafür, dass direkte Anfragen abgelehnt werden.
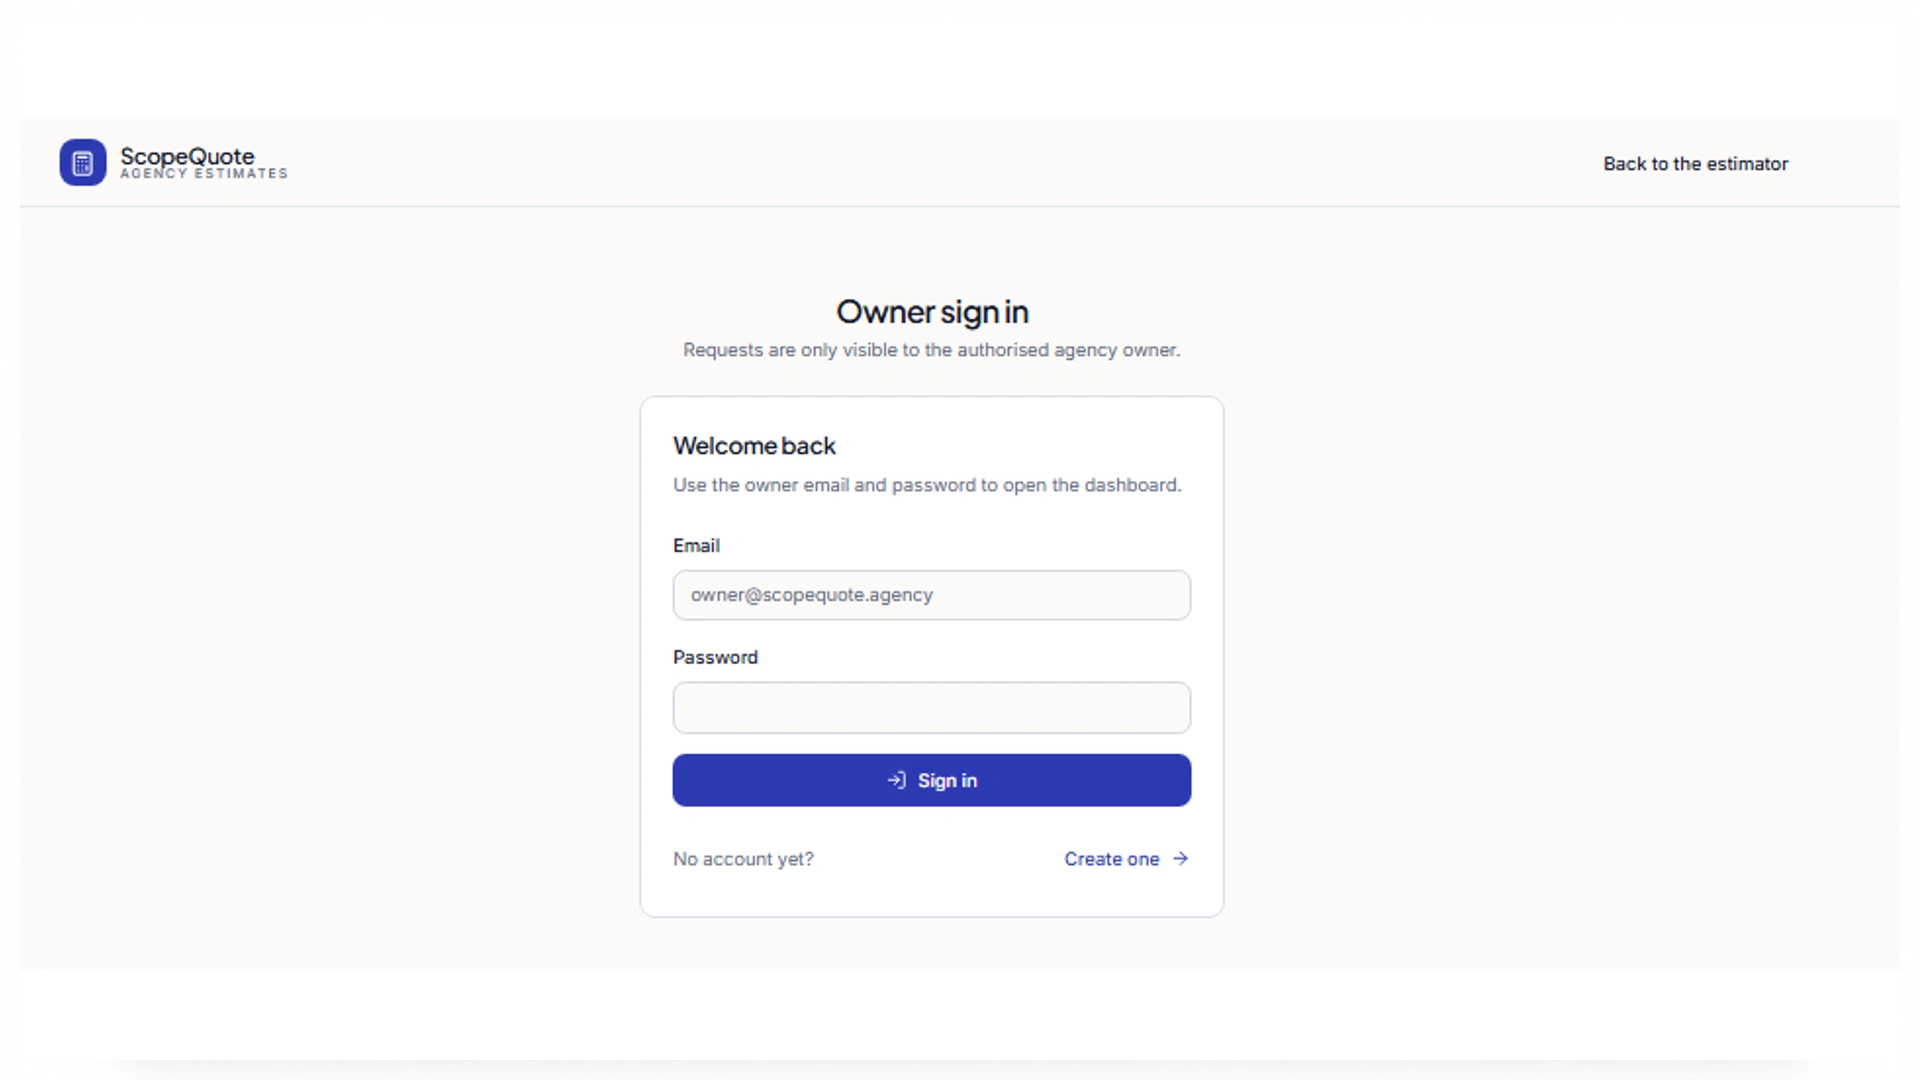
Das Besitzer-Gate ist sichtbar. Die Ablehnung unautorisierter Lesezugriffe durch das Backend braucht eine separate Prüfung.
Schritt 3: Bestätigung und Berechnungsgrenzen verifizieren
Die Bestätigung lautet „Request received“ und zeigt die Referenz SQ-2026-1002 mit einer Summe von 450 $. Das stimmt mit der sichtbaren Eins-plus-Eins-Auswahl überein. Die Referenz ist ein nützlicher Anhaltspunkt für eine spätere Besitzerprüfung, beweist aber nicht unabhängig eine dauerhafte Datenbankzeile. Prüfen Sie als Nächstes die entsprechende gespeicherte Anfrage und ihre Positionen, aktualisieren Sie die Besitzeransicht und vergleichen Sie die Server-Summe. Testen Sie einen kontrollierten Fehlschlag der Einreichung, damit eine vom Backend abgelehnte Anfrage nicht trotzdem diesen Erfolgsbildschirm erzeugt.
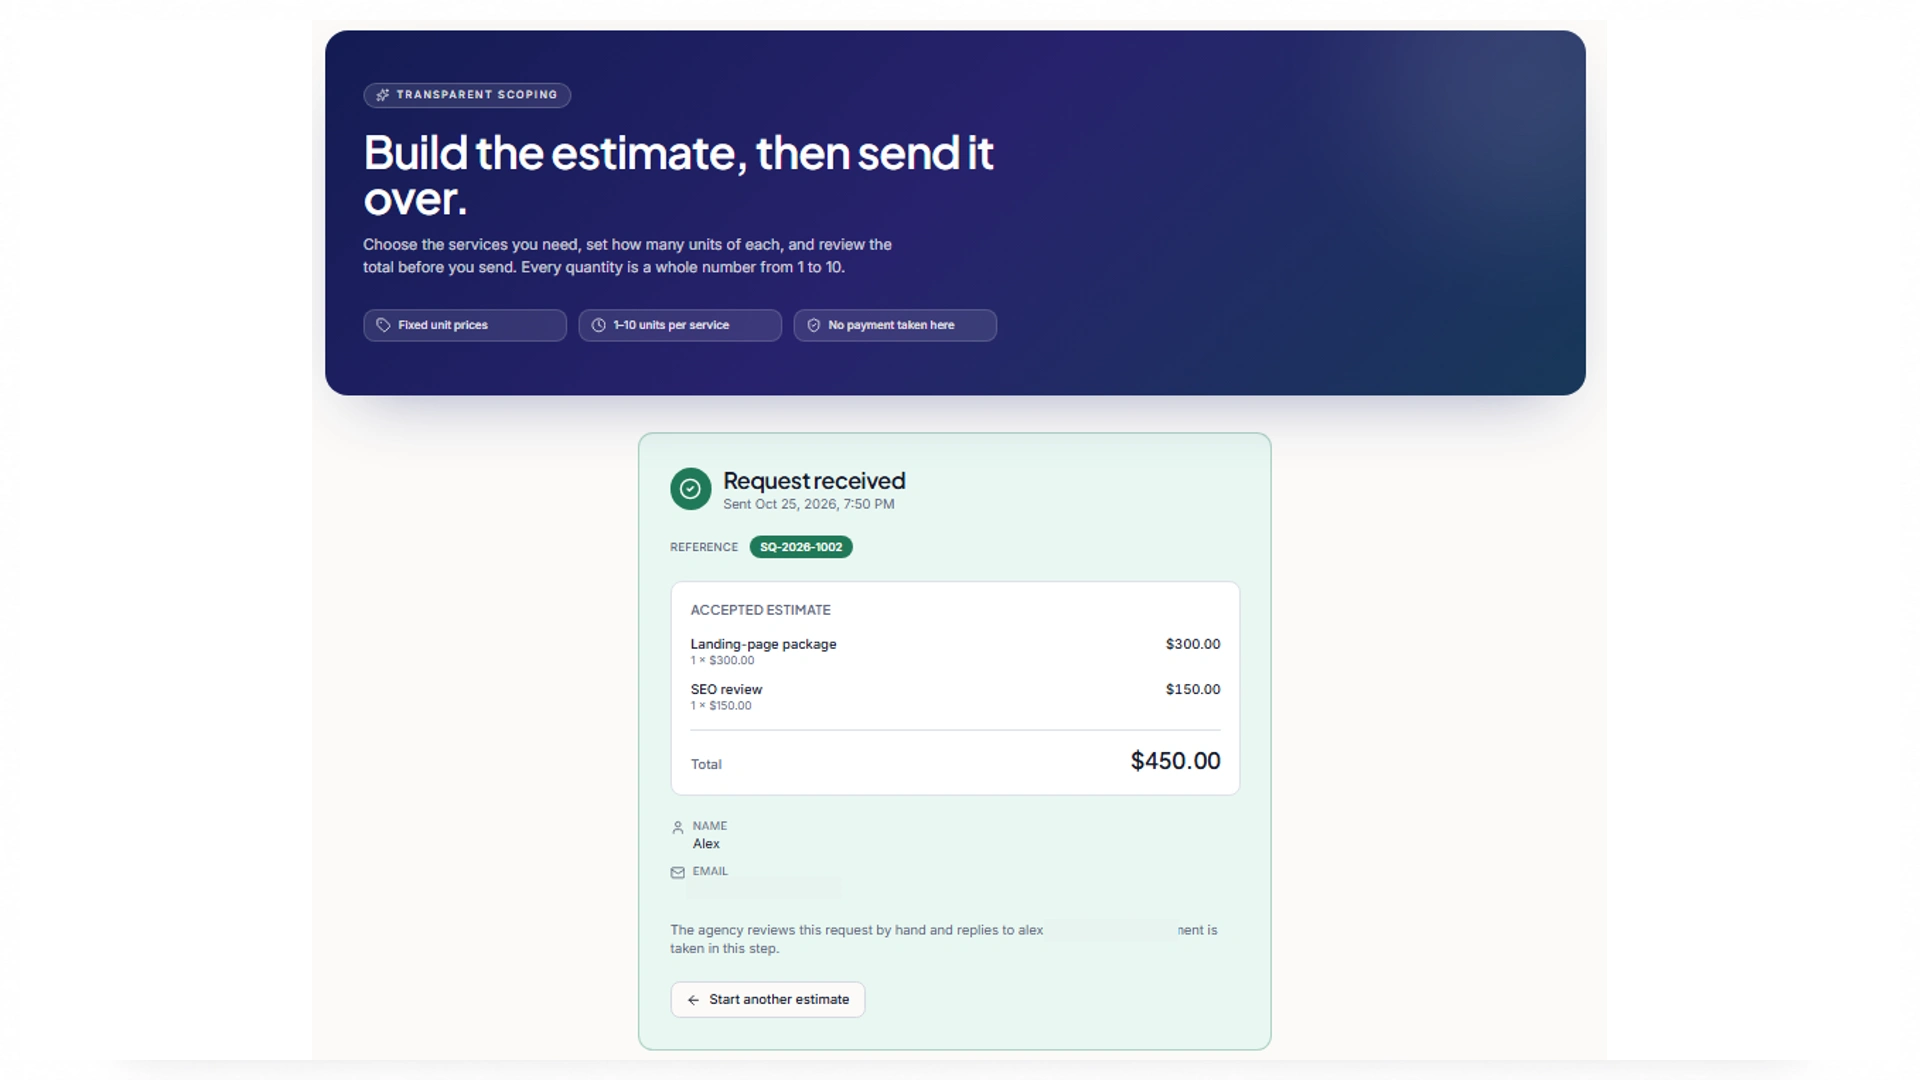
Anfrage SQ-2026-1002 zeigt dieselbe Summe von 450 $. Kontaktdaten sind geschwärzt; eine gespeicherte Datenbankzeile wird nicht gezeigt.
Halten Sie einen zusätzlichen Berechnungsfall getrennt vom dokumentierten Ergebnis: ein Landingpage-Paket plus zwei SEO-Reviews sollte 60.000 Cent beziehungsweise 600 $ ergeben. Probieren Sie dann null, negative, gebrochene und übermäßige Mengen. Manipulieren Sie den eingereichten Preis, wiederholen Sie eine Service-ID und fordern Sie einen unbekannten Service an. Verifizieren Sie anonyme und Nicht-Besitzer-Lesezugriffe über direkte Anfragen. Für Wiederholungsversuche nutzen Sie einen bewussten Einreichungs-Identifier und entscheiden Sie, ob der Server die zuvor akzeptierte Anfrage zurückgibt oder eine neue erstellt. Eine Erfolgsmeldung allein kann diese Eigenschaften nicht belegen.
Schritt 4: Belege prüfen und die Übergabe vorbereiten
Die finale Übergabe sollte Quelldateien, Abhängigkeiten, Setup-Befehle, Umgebungsvariablennamen, Schema-Änderungen und unerledigte Mängel enthalten. GitHub-Synchronisierung ist ein Weg zur Prüfung, kein durch diese ScopeQuote-Bilder demonstriertes Ergebnis. Führen Sie ein kurzes Belegprotokoll: Die 450-$-Schätzung und die passende Bestätigung sind sichtbar; serverseitige Preisdurchsetzung, dauerhafte Speicherung, Besitzerabruf und Wiederholungsverhalten brauchen noch eigene Prüfungen. Protokollieren Sie tatsächliche Kosten und Korrekturzeit beim Durchführen dieser Prüfungen, damit Ihre Bewertung akzeptiertes Verhalten abdeckt und nicht nur einen polierten Bildschirm.
Fazit: Den besten KI-Codegenerator wählen
Wählen Sie den Workflow, der zu Ihrer Aufgabe passt, und beurteilen Sie das Ergebnis dann nach Korrektheit, Review-Aufwand, Gesamtkosten und Übergabequalität. Der beste KI-Codegenerator hilft Ihnen, akzeptierte Änderungen in Ihrer eigenen Umgebung zu pflegen. ScopeQuote gibt diesem Prinzip ein konkretes Enter Pro-Beispiel: eine sichtbare Schätzung und eine passende Bestätigung, gefolgt von klaren Backend-Prüfungen, die vor breiterem Einsatz abgeschlossen werden müssen.
Häufig gestellte Fragen zum besten KI-Codegenerator
Was ist der beste KI-Codegenerator für Anfänger?
Für eine kleine Webanwendung kann ein gehosteter Builder das Setup reduzieren und das Ergebnis in einer Vorschau leichter prüfbar machen. Lernen Sie Funktionen oder arbeiten Sie in einem bestehenden Repository, passt ein Editor-Assistent vielleicht besser. Wählen Sie eine erste Aufgabe, die Sie verstehen und selbstständig prüfen können. Ein Tool, das eine kleine, korrekte Änderung erklärt, ist für Anfänger nützlicher als eines, das eine zu komplexe Anwendung generiert, um sie zu pflegen.
Kann der beste kostenlose KI-Codegenerator eine komplette App bauen?
Ein begrenzter Prototyp passt vielleicht in ein kostenloses Kontingent, aber eine komplette App braucht auch Tests, Hosting, Datenspeicherung und laufende Änderungen. Diese Ressourcen können separate Limits oder Kosten haben. Bestätigen Sie, was passiert, wenn das Generierungskontingent aufgebraucht ist, und ob die veröffentlichte App weiter funktioniert. Kostenloser Zugang ist ein sinnvoller Weg, einen Workflow zu bewerten; keine Garantie für unbegrenzte Entwicklung oder dauerhaft kostenlosen Betrieb.
Darf man KI-generierten Code kommerziell nutzen?
Die kommerzielle Nutzung hängt von den Produktbedingungen und den Lizenzen des Codes und der Abhängigkeiten in Ihrem Projekt ab. Prüfen Sie beides, statt anzunehmen, dass generierter Output keine Einschränkungen hat. Erhalten Sie Abhängigkeitshinweise, wo erforderlich, und prüfen Sie unbekannte Pakete, bevor Sie sie übernehmen. Für eine Kundenübergabe dokumentieren Sie relevante Lizenzen und ungeklärte Herkunftsfragen. Erlaubnis zur kommerziellen Nutzung und Sicherheitsqualität sind getrennte Fragen.
Braucht man Programmierkenntnisse für diese Tools?
Sie können damit beginnen, das gewünschte Verhalten zu beschreiben, besonders in einem Builder mit visueller Vorschau. Das Ergebnis zu pflegen erfordert mehr Verständnis: wie Anfragen durch die App laufen, wo Daten gespeichert werden, was Authentifizierung schützt, und wie man einen Fehler untersucht. Ein Entwickler kann bei architektonischen und sicherheitsrelevanten Änderungen helfen. Arbeiten Sie als Lernende/r an Änderungen, die Sie erklären können, bevor Sie den Umfang erweitern.
Kann ein Codegenerator ein bestehendes Repository aktualisieren?
Ja. Repository-bewusste Agenten können ein bestehendes Projekt untersuchen und Änderungen über dessen Dateien vorschlagen. Ihre Effektivität hängt von Kompatibilität, relevantem Kontext, Berechtigungen und einer funktionierenden Entwicklungsumgebung ab. Starten Sie von einem bekannten Commit, führen Sie die bestehenden Prüfungen aus und fordern Sie eine begrenzte Änderung an. Prüfen Sie, ob der Patch aktuellen Konventionen folgt und unbeteiligtes Verhalten erhält, bevor Sie ein größeres Refactoring zulassen.
Was bedeuten „Best Code AI Generator“ und „Best Code Generator AI“?
Das sind alternative Wortreihenfolgen für dieselbe Suchkategorie. Keine davon klärt, ob Sie ein Snippet, einen Repository-Patch oder eine gehostete Anwendung brauchen. Beginnen Sie mit dem Deliverable, der Runtime und dem Review-Prozess, und vergleichen Sie Tools dann innerhalb dieses Workflows. Ein Suchbegriff kann keinen Abnahmetest ersetzen.
Kann Enter Pro das Backend ebenso wie das Interface generieren?
Ja. Enter Cloud bietet Backend-Fähigkeiten einschließlich Datenbank, Authentifizierung und Funktionen. Das Design von ScopeQuote nutzt diese Fähigkeiten für gespeicherte Anfragen und maßgebliche Berechnungen. Die bereitgestellten Aufnahmen zeigen den Kostenrechner, die Bestätigung und das Besitzer-Login-Gate; sie verifizieren nicht den Handler oder private Datensätze. Prüfen Sie Backend-Validierung und Zugriffsrichtlinien, bevor Sie das generierte Projekt für echte Anfragen nutzen.
Kann ein Entwickler ein Enter Pro Projekt später weiterführen?
Ja. Die GitHub-Integration von Enter Pro bietet einen Weg für Code-Review und Entwickler-Zusammenarbeit. Die Übergabe sollte auch Setup-Anweisungen, Abhängigkeiten, Umgebungsvariablen, Migrationen und Backend-Services umfassen. Zugriff auf das Repository übertragt nicht automatisch gehostete Daten oder Secrets. Ein Entwickler sollte das Projekt ausführen und seine externen Anforderungen verstehen können, bevor er Verantwortung für Updates übernimmt.





