Beste KI für Programmierung im Vergleich: Aufgaben, Kosten und Workflow
Vergleichen Sie die beste KI für Programmierung nach Workflow, Modellen, Gratis-Limits und echten Kosten – inklusive Praxistest einer Enter Pro App.
Die beste KI für Programmierung ist das Werkzeug, mit dem Sie eine Änderung fertigstellen, die Sie verstehen, überprüfen und pflegen können. Ein schneller Funktionsvorschlag, eine repository-weite Reparatur und eine funktionierende App erfordern unterschiedliche Arten von Unterstützung. Wählt man nur nach einem einzelnen Modell-Score, verschleiert das den Editor, die Ausführungstools, die Nutzungsgrenzen und den Review-Aufwand, die das Ergebnis tatsächlich bestimmen.
Ich würde zuerst nach der Aufgabe vorsortieren und dann einen kleinen Vergleich an repräsentativen Aufgaben durchführen. Dieser Guide trennt Tools von Modellen, vergleicht sechs Entwicklungsumgebungen, untersucht kostenlosen Zugang und veröffentlichte Belege und erklärt eine wiederholbare Bewertungsmethode. Gegen Ende bringt das erfasste FixTrack-Projekt in Enter Pro die App-Build-Checks über eine private Issue-Tracker-Oberfläche zusammen, wobei sichtbare Ergebnisse klar von noch ausstehenden Backend-Prüfungen getrennt bleiben.
Was ist die beste KI für Programmierung für Ihre tatsächliche Arbeit?
Die Wahl der besten KI für Programmierung beginnt mit der Aufgabe und der Umgebung, die Sie beibehalten müssen. Ein Assistent, der zu einem etablierten Repository passt, kann für ein Wartungsticket die bessere Wahl sein als ein App-Generator. Ein Browser-Builder kann für einen neuen Prototyp den Einrichtungsaufwand entfernen. Die folgenden Punkte sind Ausgangspunkte für die Bewertung, keine gemessenen Leistungsrankings.
Editor und GitHub-Workflow beibehalten: Bewerten Sie GitHub Copilot für Vorschläge, Code-Fragen und delegierte Repository-Arbeit.
Mehrere Dateien untersuchen und ändern: Vergleichen Sie Cursor, Claude Code oder Codex anhand desselben Repository-Snapshots und derselben Abnahmetests.
Eine agentenzentrierte Umgebung ausprobieren: Bewerten Sie Google Antigravity anhand der aktuellen Kontoberechtigung, unterstützten Modelle und Nutzungsgrenzen.
Einen browserbasierten Prototyp bauen: Vergleichen Sie den Projekt-Workflow von Replit mit einem App-Build-Workspace wie Enter Pro, einschließlich Daten- und Deployment-Anforderungen.
Die besten KI-Tools für Programmierung können sich bei diesen Aufgaben überschneiden. Vermeiden Sie es, für mehrere Abonnements zu bezahlen, bevor Sie eine konkrete Aufgabe identifizieren können, die ein Tool in Ihrem Workflow nachweislich besser erledigt.
Um die Frage „Was ist die beste KI für Programmierung?" zu beantworten, nutzen Sie eine Aufgabe, die Sie bereits beurteilen können. Ein Einsteiger kann die Ausgabe einer kleinen Funktion vorhersagen; ein Maintainer kann einen Bug reproduzieren; ein Gründer kann eine vollständige Kundenaktion nachvollziehen. Diese bekannte Referenz verhindert, dass flüssige Erklärungen Beweise ersetzen. Behalten Sie, wenn möglich, eine gewöhnliche manuelle Implementierung oder einen bestehenden Test als Baseline, damit Sie sehen, ob die Unterstützung nach Review und Korrektur tatsächlich Arbeit gespart hat.
Trennen Sie das Modell vom Tool und vom Agenten
Ein Modell erzeugt die Argumentation und den Code
Ein Modell empfängt Eingaben und erzeugt Ausgaben. Ein Tool fügt die Oberfläche und den Projektkontext hinzu. Ein Agent kombiniert das Modell mit einer Ausführungsschleife, die Dateien prüfen, Befehle ausführen und Arbeit überarbeiten kann. Zwei Produkte mit einem ähnlichen Modell können sich trotzdem unterschiedlich verhalten, weil sie unterschiedlichen Kontext, Tools, Berechtigungen und Feedback bieten.
Kontext und Verifikation zählen ebenso wie die Generierung
Ein großes Kontextfenster ist Kapazität, kein Beweis dafür, dass die richtigen Dateien verwendet wurden. Bei einem Login-Bug gehört zum nützlichen Kontext die fehlschlagende Route, die Authentifizierungskonfiguration, relevante Tests und das erwartete Verhalten. Eine überzeugende Erklärung ohne reproduzierten Fehler oder geprüfte Änderung ist ein schwächerer Beweis als eine enge Korrektur, die eine aussagekräftige Prüfung besteht.
Bei einer dateiübergreifenden Änderung lassen Sie den Agenten vor der Bearbeitung Route, Schema, Aufrufer und bestehenden Test identifizieren. Vergleichen Sie dann seine Darstellung mit dem Repository. Übersieht er einen gemeinsam genutzten Helper oder erfindet er einen Dateipfad, korrigieren Sie den Kontext vor der Umsetzung. Die besten KI-Tools für Programmierung sind teilweise deshalb nützlich, weil sie diese Recherche verkürzen – aber eine selbstbewusste Zusammenfassung reicht nicht aus. Relevanter Kontext muss im tatsächlichen Patch und in der Verifikation erscheinen.
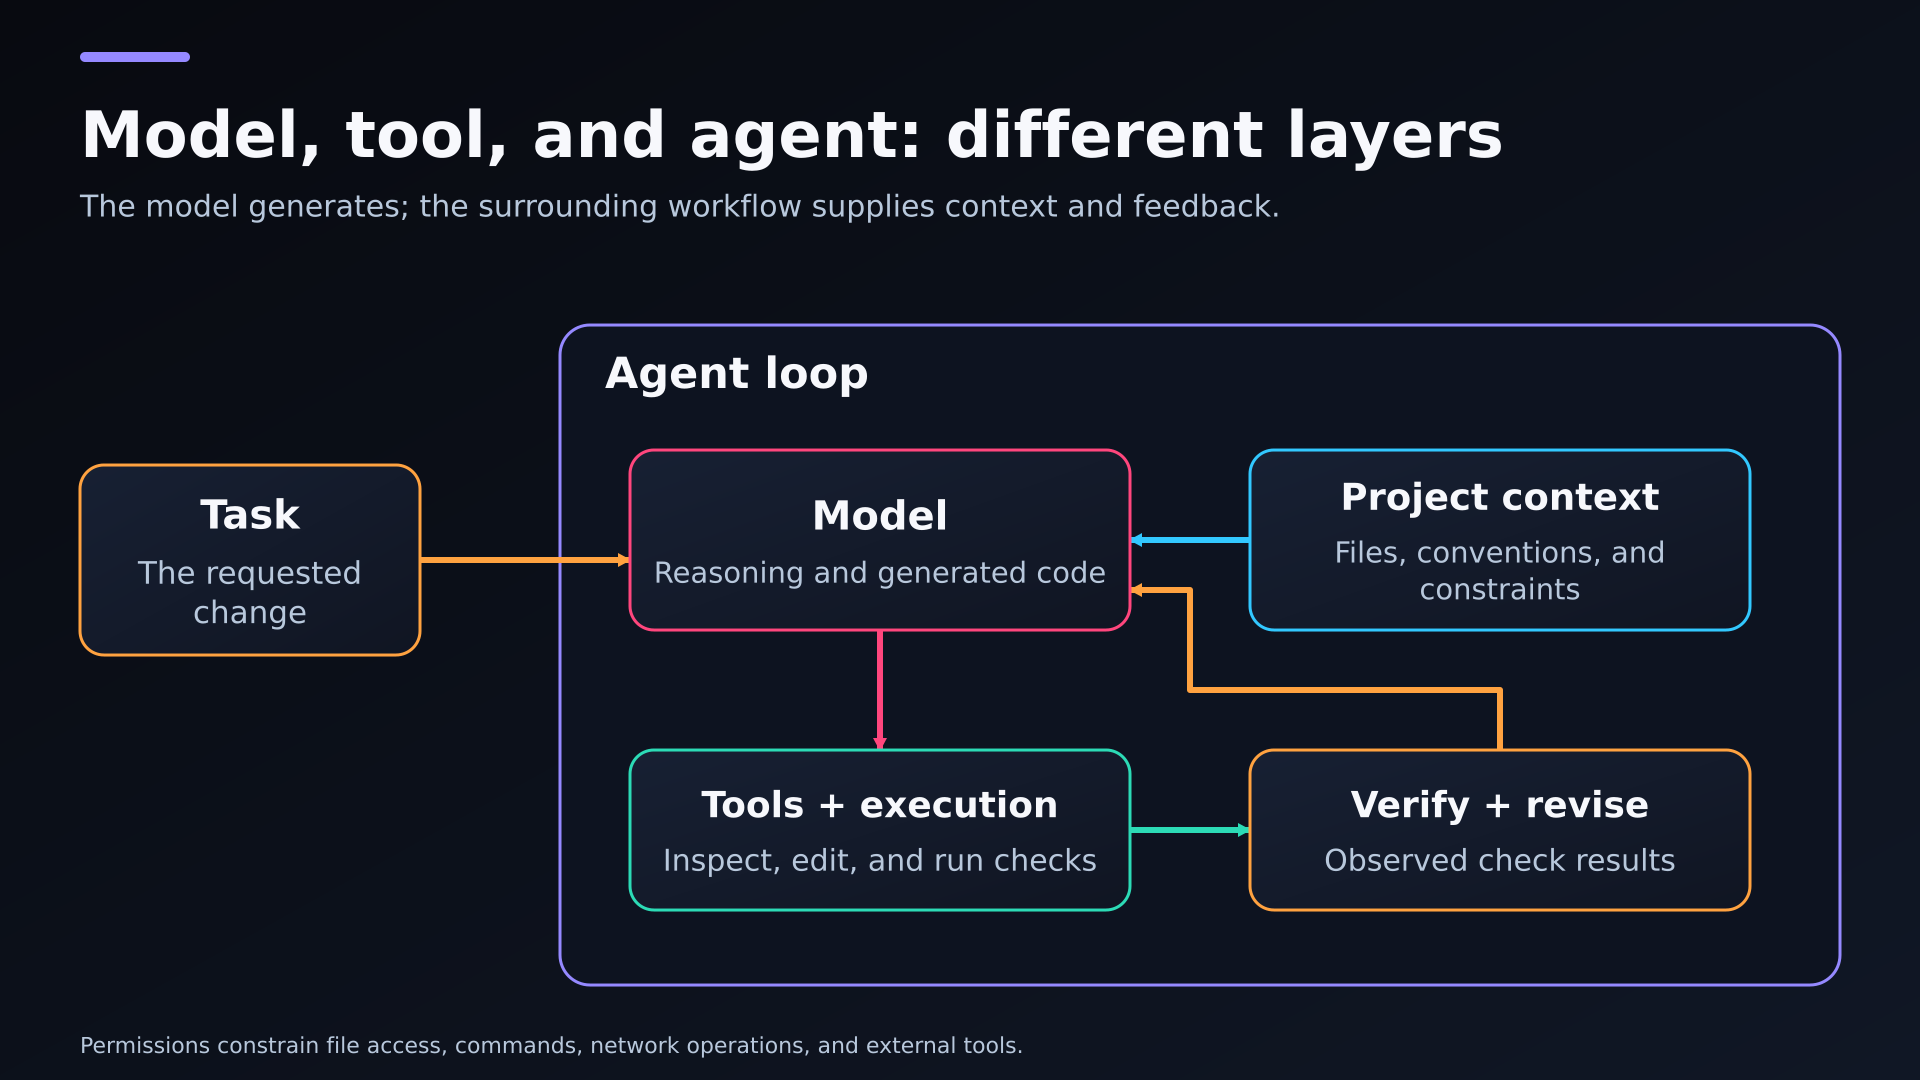
Eine konzeptionelle Agenten-Schleife mit Projektkontext, einem Modell, Tool-Ausführung und Verifikation.
Vergleichen Sie sechs KI-Coding-Tools nach ihrer Arbeitsumgebung
GitHub Copilot für einen bestehenden Editor- und Repository-Workflow
Copilot bietet Inline-Vorschläge, Codebase-Fragen, Review und agentenbasierte Aufgaben innerhalb unterstützter Entwicklungs-Workflows. Es ist ein sinnvoller Kandidat, wenn Sie Unterstützung rund um einen bestehenden Editor, ein Issue oder einen Pull Request wünschen. Prüfen Sie die in Ihrem gewählten Plan und Editor verfügbaren Funktionen; lokaler Agentenmodus und ein cloud-erstellter Pull Request sind unterschiedliche Fähigkeiten.
Ein sinnvoller Test ist ein Helper mit einer etablierten Typsignatur und nahegelegenen Aufrufern. Prüfen Sie, ob die Vorschläge dem Projekt folgen, statt eine weitere Validierungsbibliothek einzuführen. Probieren Sie dann eine Repository-Frage aus, die erfordert, einen Import über mehrere Module zu verfolgen. Behandeln Sie Inline-Unterstützung und delegierte Aufgaben als getrennte Ergebnisse; ein Tool kann für das eine praktisch sein, auch wenn Sie für umfassendere Änderungen einen anderen Agenten bevorzugen.
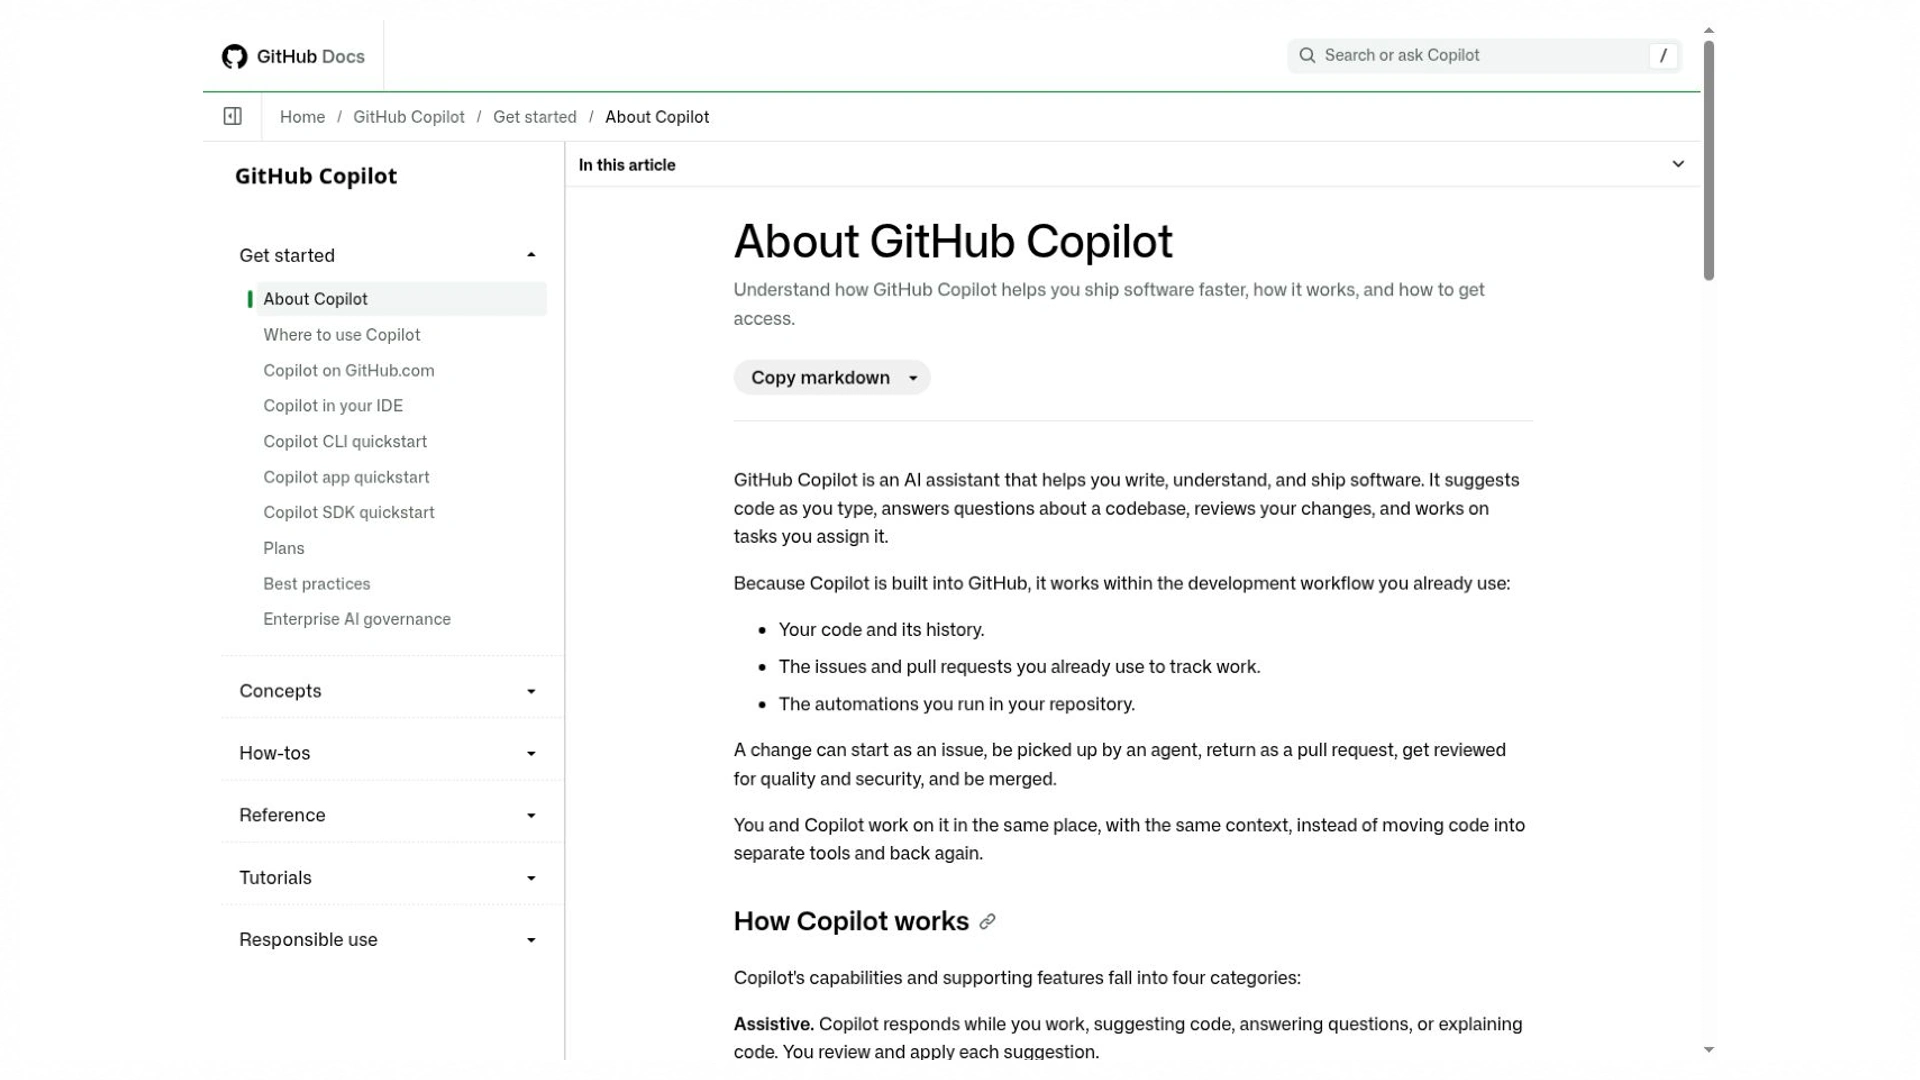
Die Übersicht beschreibt unterstützte Assistenz- und Agenten-Workflows. Die Funktionsverfügbarkeit hängt von der dokumentierten Umgebung und dem Plan ab.
Cursor zum Planen und Überprüfen von Änderungen in einem Projekt
Cursors Dokumentation umfasst Repository-Verständnis, Planung, Umsetzung, Debugging und Änderungs-Review. Erwägen Sie es, wenn die Aufgabe über mehrere Dateien geht und Sie diese Aktivitäten verbunden haben möchten. Geben Sie ihm das fehlschlagende Verhalten und die Repository-Konventionen und prüfen Sie dann den resultierenden Diff. Prüfen Sie das aktuelle Modell und die Nutzungsregelung, statt anzunehmen, dass ein älteres Abonnement uneingeschränkten Zugang zu Drittanbieter-Modellen enthält.
Zum Beispiel könnte ein Einstellungs-Schalter Komponentenstatus, eine Server-Update-Route und eine gespeicherte Präferenz benötigen. Bitten Sie Cursor, die aktuellen Fetching- und Validierungsmuster zu erhalten, und prüfen Sie dann diese drei Punkte. Eine geänderte Checkbox allein ist unvollständig. Behalten Sie einen Check für das Verhalten nach dem Neuladen, damit die Aufgabe nicht bei einer ansprechenden Interaktion endet, die beim Aktualisieren der Seite verschwindet.
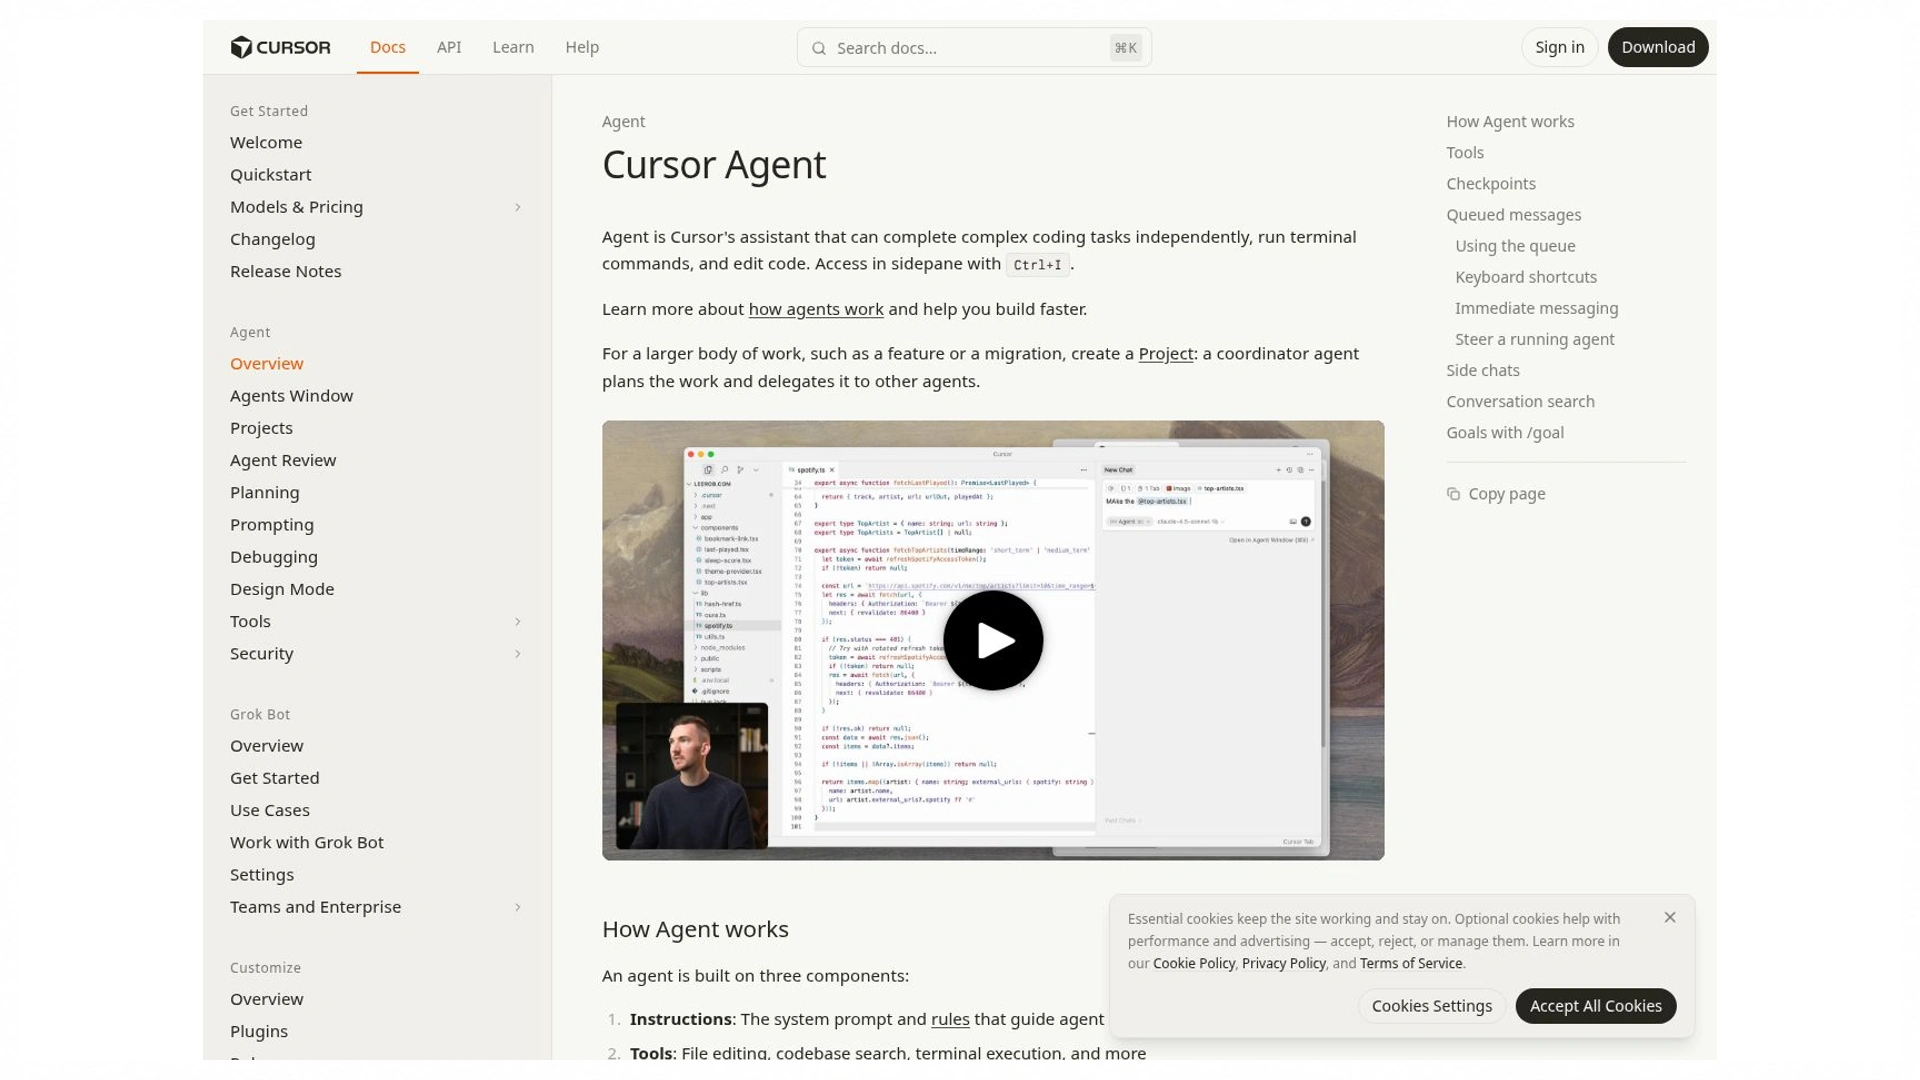
Offizielle Cursor-Dokumentation
Die Agentenübersicht beschreibt Planung, Umsetzung und zugehörige Workflow-Fähigkeiten. Dokumentations-Snapshot, kein gemessenes Coding-Ergebnis.
Quelle: cursor.com · erfasst am 25. Oktober 2026
Claude Code für datei- und befehlsbasierte Entwicklung
Claude Code liest Code, bearbeitet Dateien, führt Befehle aus und arbeitet über Terminal-, IDE-, Desktop- und Browser-Oberflächen. Es ist ein Kandidat, um unbekannte Module zu untersuchen oder ein eingegrenztes Refactoring zu koordinieren. Lassen Sie es Abhängigkeiten und den Verifikationsplan identifizieren, bevor Sie sie ändern. Dass es einen Befehl ausführen kann, belegt nicht, dass der Befehl oder die vorgeschlagene Architektur angemessen ist.
Eine terminal-orientierte Aufgabe kann mit dem fehlschlagenden Befehl und einer knappen Reproduktion beginnen. Geben Sie dem Agenten die normale Umgebung des Projekts und lassen Sie ihn die Ursache identifizieren, bevor er ein Refactoring vorschlägt. Überprüfen Sie Shell-Operationen und neue Abhängigkeiten genauso wie Code. Ein erfolgreich ausgeführter Testbefehl ist nur nützlich, wenn die relevante Assertion noch existiert und die Umgebung der Deployment-Umgebung ähnelt.
Die Übersicht erklärt seine Entwicklungsoberflächen und den datei- und befehlsbasierten Workflow. Sie begründet kein Leistungsranking.
Codex zum Delegieren einer eingegrenzten Software-Aufgabe
Codex kombiniert Coding-Modelle mit einem Harness für Kontext, Tool-Nutzung, Ausführung und Review-Grenzen. Seine App, CLI und IDE-Erweiterung unterstützen unterschiedliche Arbeitsweisen. Eine sinnvolle Bewertungsaufgabe hat ein festgelegtes Ergebnis, relevante Dateien und Checks, die fehlschlagen können. Vergleichen Sie den fertigen Patch und die verbleibende Review-Arbeit, statt die Länge der Erklärung des Agenten.
Halten Sie bei Codex das Ergebnis eingegrenzt: Beheben Sie eine Regression, aktualisieren Sie einen kleinen API-Vertrag oder fügen Sie einen fokussierten Test hinzu. Identifizieren Sie, welche Dateien oder Services er ändern darf und welches Verhalten kompatibel bleiben muss. Eine nützliche Übergabe umfasst den Patch, die Verifikationsausgabe und ungelöste Einschränkungen. Der Entwickler entscheidet weiterhin, ob die Umsetzung zur Architektur und zum Release-Prozess des Repositorys passt.
Die CLI ist ein dokumentierter Weg für eine eingegrenzte Coding-Aufgabe. Prüfen Sie die Ausführungseinstellungen und überprüfen Sie den resultierenden Patch.
Google Antigravity für einen agentenzentrierten Workflow
Antigravity dokumentiert einen agentenzentrierten Entwicklungs-Workflow über seine unterstützten Oberflächen. Erwägen Sie es, wenn Sie Planung, Ausführung und Review gemeinsam bewerten möchten, und prüfen Sie dann das aktuelle Setup, die Kontoberechtigung und die Kontingente. Lassen Sie es ein reproduzierbares Problem untersuchen und prüfen Sie die resultierenden Artefakte und den Diff. Dass ein Produkt mehrere Aktivitäten koordinieren kann, belegt nicht, dass es Ihre spezifische Aufgabe korrekt erledigt oder weniger Aufsicht benötigt.
Die Einstiegshilfe beschreibt Setup und den Agenten-Workflow. Bestätigen Sie die aktuelle Kontoregelung vor einem Test.
Replit zum Starten und Veröffentlichen eines Browser-Projekts
Replit Agent kann Code generieren, Projekt-Infrastruktur einrichten und helfen, eine App in seinem Workspace zu testen und zu veröffentlichen. Bewerten Sie es, wenn die lokale Umgebungseinrichtung eine Hürde darstellt. Überprüfen Sie den tatsächlich generierten Stack, die Persistenz und das Veröffentlichungsverhalten. Prüfen Sie Nutzungsgebühren und Betriebsanforderungen separat; eine ansprechende Vorschau allein belegt keine zuverlässige Anwendung.
Öffnen Sie bei einem gehosteten Prototyp die veröffentlichte Route in einer separaten Sitzung erneut und prüfen Sie ihr Datenziel. Entwicklungs-Fixtures, Vorschau-Speicher und Produktionsdaten können sich unterscheiden. Behalten Sie Authentifizierungs-Weiterleitungen und Namen von Umgebungsvariablen in den Übergabenotizen. Diese Details bestimmen oft, ob die Anwendung nutzbar bleibt, nachdem die ursprüngliche Generierungssitzung beendet ist.
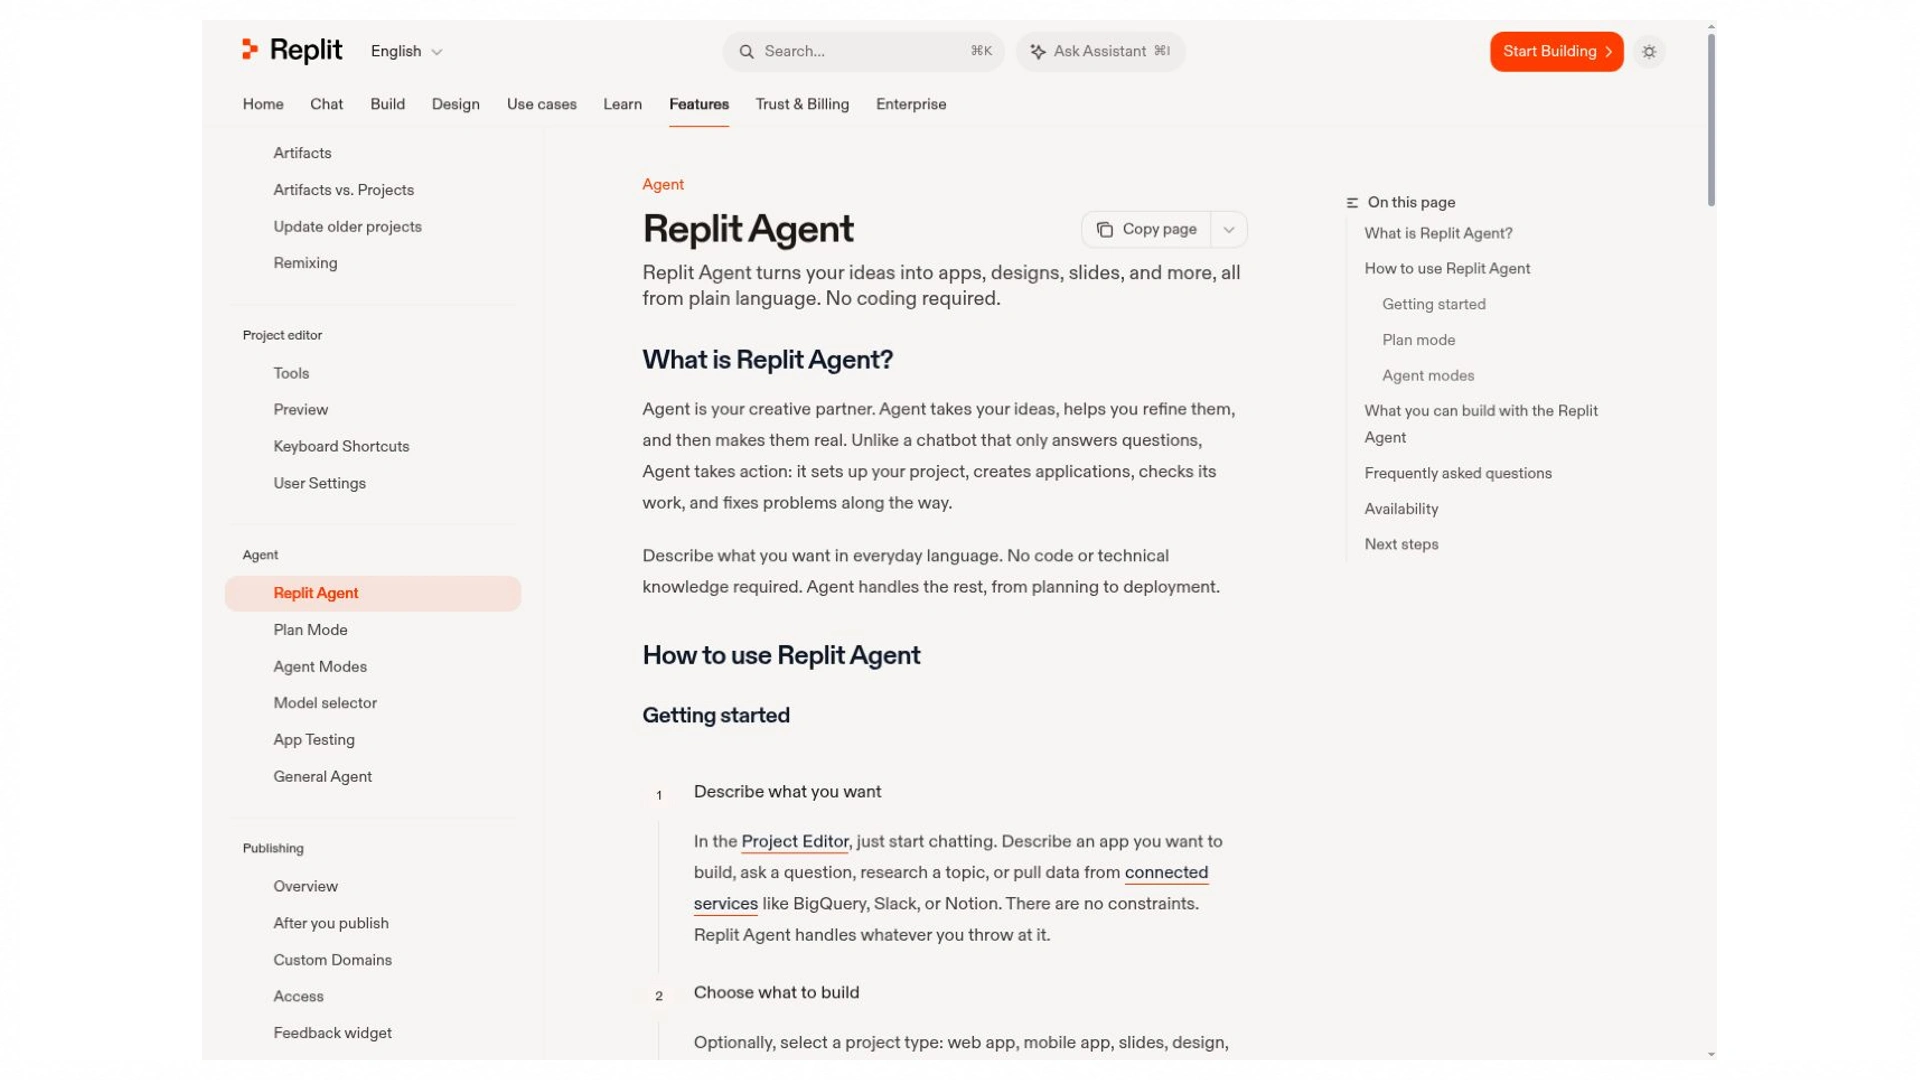
Die Dokumentation beschreibt den gehosteten Projekt-Workflow. Vorschau, Veröffentlichung und Ressourcennutzung benötigen eigene Checks.
Vergleichen Sie jeden Kandidaten anhand derselben vier Fragen: Wo läuft es? Was kann es prüfen? Was kann es ausführen? Wie verifizieren und bewahren Sie die Arbeit? Beispiele sind eine Legacy-Python-Reparatur, ein React-Einstellungsbildschirm, eine fehlschlagende SQL-Migration und ein kleines internes Dashboard. Diese Beispiele testen unterschiedliche Stärken, ohne vier separate Fallstudien zu benötigen.
Wählen Sie das beste KI-Modell für Programmierung mit einem aufgabenbezogenen Check
Verwenden Sie aktuelle Modell-IDs statt alter Produktbezeichnungen
Wählen Sie die Modell-IDs, die in Ihrem tatsächlichen Tool und Konto verfügbar sind. OpenAIs aktuelle Dokumentation nennt GPT-6.1 Sol als Kandidaten für komplexes Coding; andere Anbieter bieten ebenfalls Modelle mit unterschiedlichen Kompromissen bei Argumentation, Latenz und Preis an. Die Verfügbarkeit in einem Chat-Produkt garantiert nicht die Verfügbarkeit über Ihren Coding-Agenten. Notieren Sie die genau ausgewählte ID, jedes automatische Routing und die Effort-Einstellungen. Das sind Kandidaten für Ihren Testlauf, keine Ergebnisse eines für diesen Artikel durchgeführten direkten Vergleichstests.
Das beste KI-Modell für Programmierung kann sich zwischen einer engen Transformation und einer schwierigen Repository-Untersuchung unterscheiden. Probieren Sie zuerst das Standardmodell und dann eine leistungsfähigere Reasoning-Option bei den Fällen, die es verfehlt. Behalten Sie dieselben Eingaben und prüfen Sie, ob die zusätzliche Latenz und Kosten eine akzeptierte Verbesserung bringen. Ein größeres oder teureres Modell ist nicht automatisch der bessere Kauf für jede wiederholte Aufgabe.
Lesen Sie Benchmarks mit ihren Testbedingungen
SWE-bench Verified enthält 500 von Menschen gefilterte Software-Probleme. Seine Ergebnisse betreffen eine bestimmte Bewertungsumgebung, nicht jede Sprache oder jede App-Build-Aufgabe. Notieren Sie die Benchmark-Variante, das Agenten-Setup, die Modellversion und das Datum, bevor Sie Scores vergleichen. OpenRouters bereitgestellte Coding-Sammlung misst die jüngste Token-Nutzung auf seinem Dienst; Nutzungspopularität ist kein Korrektheits-Benchmark.
Offizielle SWE-bench-Projektseite
Benchmark-Varianten und Bewertungsbedingungen sind entscheidend. Veröffentlichte Scores ersetzen keine Aufgabe in Ihrem eigenen Repository.
Quelle: www.swebench.com · erfasst am 25. Oktober 2026
Finden Sie die beste KI für Programmierung ohne Abonnementkosten
Trennen Sie einen kostenlosen Plan von enthaltener Agenten-Nutzung
Aktuelle offizielle Seiten beschreiben begrenzten kostenlosen Zugang für Produkte wie GitHub Copilot und Cursor. Auch die Verfügbarkeit und die Grenzen von Antigravity hängen von der dokumentierten Kontoregelung ab. Prüfen Sie die Funktion, die Sie nutzen werden: Inline-Vervollständigungen, Chat, Agenten-Aktionen und gehostete Ausführung können unterschiedliche Kontingente haben. Eine kostenlose Tool-Oberfläche kann trotzdem einen kostenpflichtigen Anbieter aufrufen. Datieren Sie den Check und prüfen Sie die verbleibende Nutzung nach einer vollständig abgeschlossenen Aufgabe, statt anzunehmen, dass ein älteres monatliches Kontingent noch gilt.
Eine Suche nach kostenloser KI für Programmierung ist am nützlichsten, wenn Sie den gesamten kostenlosen Workflow definieren. Beziehen Sie Editor, Modellaufrufe, Ausführungsumgebung und alle gehosteten Ressourcen mit ein. Ein lokales Modell kann eine Anbieterrechnung entfernen, benötigt aber trotzdem leistungsfähige Hardware und Einrichtung. Halten Sie den ersten Testlauf klein genug, um ihn innerhalb des aktuellen Kontingents abzuschließen, und prüfen Sie dann, was fortgesetzte Nutzung oder Veröffentlichung kosten würde.
Berücksichtigen Sie Review-Zeit, Wiederholungen, Hosting und API-Kosten
Eine nützliche Berechnung ist Kosten pro akzeptierter Aufgabe = zurechenbare Tool- und Nutzungsgebühren geteilt durch akzeptierte Aufgaben, mit separat erfasster Review-Zeit. Zur Veranschaulichung: 12 $ zurechenbare Gebühren bei vier akzeptierten Aufgaben ergeben 3 $ pro Aufgabe. Diese Rechnung ist hypothetisch. Beziehen Sie fehlgeschlagene Versuche in die Gebühren mit ein und definieren Sie „akzeptiert" vor dem Testen, damit ein optisch fertiges, aber defektes Feature nicht mitzählt.
Beurteilen Sie Produktivität anhand von Belegen statt Output-Menge
Verwenden Sie Forschungsstatistiken innerhalb ihres ursprünglichen Rahmens
In Stack Overflows Umfrage 2025 misstrauten 46 % der Genauigkeit von KI-Tools, 33 % der Befragten vertrauten ihr. Das misst berichtetes Vertrauen, nicht Code-Fehler. Es stützt eine praktische Frage für Ihren Testlauf: Wie viel Verifikation und Korrektur benötigt die Ausgabe, bevor Sie sie nutzen können?
METRs Experiment von Anfang 2025 umfasste 16 erfahrene Entwickler und 246 Aufgaben und ergab, dass Aufgaben mit den untersuchten Tools 19 % länger dauerten. Das Update von Februar 2026 berichtete über Auswahl- und Messprobleme, die das spätere Experiment für die Schätzung des aktuellen Effekts unzuverlässig machten. Keiner der Befunde begründet einen universellen Geschwindigkeitsnachteil oder -gewinn für heutige Tools.
Erfassen Sie Korrektheit, Review-Aufwand und Zeit bis zu einer akzeptierten Änderung
Um die beste KI für Programmierung in Ihrem Projekt zu identifizieren, erfassen Sie den Ausgangscommit, den Prompt, das Modell, den Plan, die vergangene Zeit, die aktive Review-Zeit, die Gebühren und verbleibende Mängel. Führen Sie jeden Kandidaten von einer sauberen Kopie aus aus. Wiederholen Sie repräsentative Aufgaben, wenn möglich, und erfassen Sie Fehlschläge. Ein kurzer Testlauf kann eine Kaufentscheidung leiten, kann aber keinen universellen Genauigkeitsprozentsatz oder die Behauptung rechtfertigen, ein Produkt sei immer am schnellsten.
Verwenden Sie Muss-bestehen-Checks vor Komfort-Scores. Ein Endpunkt, der den Datensatz eines anderen Nutzers offenlegt, scheitert, selbst wenn sein Patch klein und seine Erklärung ausgezeichnet ist. Vergleichen Sie nach der Korrektheit aktive Review-Minuten, Unterbrechungen und Wartungsaufwand. Führen Sie ein Protokoll erfolgloser Durchläufe, statt nur den besten Versuch zu berichten. Das macht einen kleinen Testlauf aussagekräftiger, ohne vorzugeben, er repräsentiere jedes Repository oder jeden Entwickler.
Entscheiden Sie, welche KI für Ihre Situation am besten zum Programmieren ist
Passen Sie das Beispiel an die Arbeit an, die Sie fertigstellen müssen
Eine Funktion lernen: Bitten Sie um eine Erklärung, sagen Sie die Ausgabe vorher und ändern Sie sie dann ohne Unterstützung.
Einen Bug beheben: Liefern Sie eine Reproduktion und das erwartete Ergebnis; behalten Sie den fehlschlagenden Check als Regressionsabdeckung.
Mehrere Module ändern: Fordern Sie eine Abhängigkeitsverfolgung und einen kleinen Patch an, bevor Sie eine umfassende Neufassung angehen.
Einen Prototyp bauen: Verifizieren Sie die vollständige Kundenaktion, das Datenziel und die Zugriffsregeln.
An proprietärem Code arbeiten: Prüfen Sie den Datenumgang und die organisatorischen Kontrollen des zutreffenden Plans, bevor Sie Repository-Zugriff gewähren.
Das macht die beste KI für Programmierung zu einer Entscheidung, die Sie erklären können: Der Kandidat erfüllt Ihre Einschränkungen und erfordert akzeptablen Review-Aufwand bei repräsentativen Aufgaben. Behalten Sie Belege und einen tragfähigen Übergabepfad, während das Projekt wächst.
Berücksichtigen Sie bei der Entscheidung, welche KI am besten zum Programmieren ist, den Wiederherstellungspfad Ihres Teams. Kann ein anderer Entwickler das Projekt ausführen, den Diff prüfen und ohne den ursprünglichen Chat weiterarbeiten? Halten Sie Architekturentscheidungen, Checks und Einrichtung im Repository. Für die beste KI für Vibe Coding ist genau diese Frage wichtig, nachdem ein Prototyp beginnt, reale Datensätze zu speichern: Die Leichtigkeit der Generierung sollte zu einer Anwendung führen, die Sie verstehen und pflegen können.
Bewerten Sie Enter Pro, indem Sie einen privaten Issue-Tracker bauen
Für Leser, die die beste KI für Vibe Coding bewerten, liefert FixTrack ein konkretes Enter Pro App-Build-Beispiel. Der Plan definiert nutzereigene Issues und Statusänderungen, während die bereitgestellte Vorschau ein fiktives High-Priority-Issue im Status Open zeigt. Er bietet Ihnen eine prüfbare Oberfläche und einen kleinen Satz von Abnahme-Checks. Die Bilder zeigen keinen Zweitkonto-Test, keinen erfassten Backend-Datensatz und kein Issue, das erfolgreich auf Resolved wechselt.
Schritt 1: Planen Sie den Issue-Tracker und seine Abnahme-Checks
Das geplante erste Release hat eine private Issue-Liste, ein Erstellungsformular, eine Detailansicht und Status-Filter. Felder sind Titel, Beschreibung, Priorität und Status: Open, In Progress oder Resolved. Definieren Sie Erfolg vor der Generierung: Ein gültiges Issue überlebt ein Neuladen, eine autorisierte Aktualisierung bleibt erhalten, und ein anderes Konto kann es weder lesen noch ändern. Halten Sie Team-Einladungen und Integrationen außerhalb dieser ersten Aufgabe, damit eine scheinbar vollständige Oberfläche nicht ihre grundlegende Datengrenze verschleiert.
Kopierbarer Prompt — Planen Sie einen fiktiven FixTrack Issue-Tracker. Angemeldete Nutzer können nur ihre eigenen Issues erstellen, lesen und aktualisieren. Verwenden Sie Titel, Beschreibung, Priorität Low/Medium/High und Status Open/In Progress/Resolved. Definieren Sie Routen, Schema, Autorisierung und Abnahmetests. Bleiben Sie im Plan Mode, bis der Plan genehmigt ist; erfinden Sie keine Reviews oder Ergebnisse.
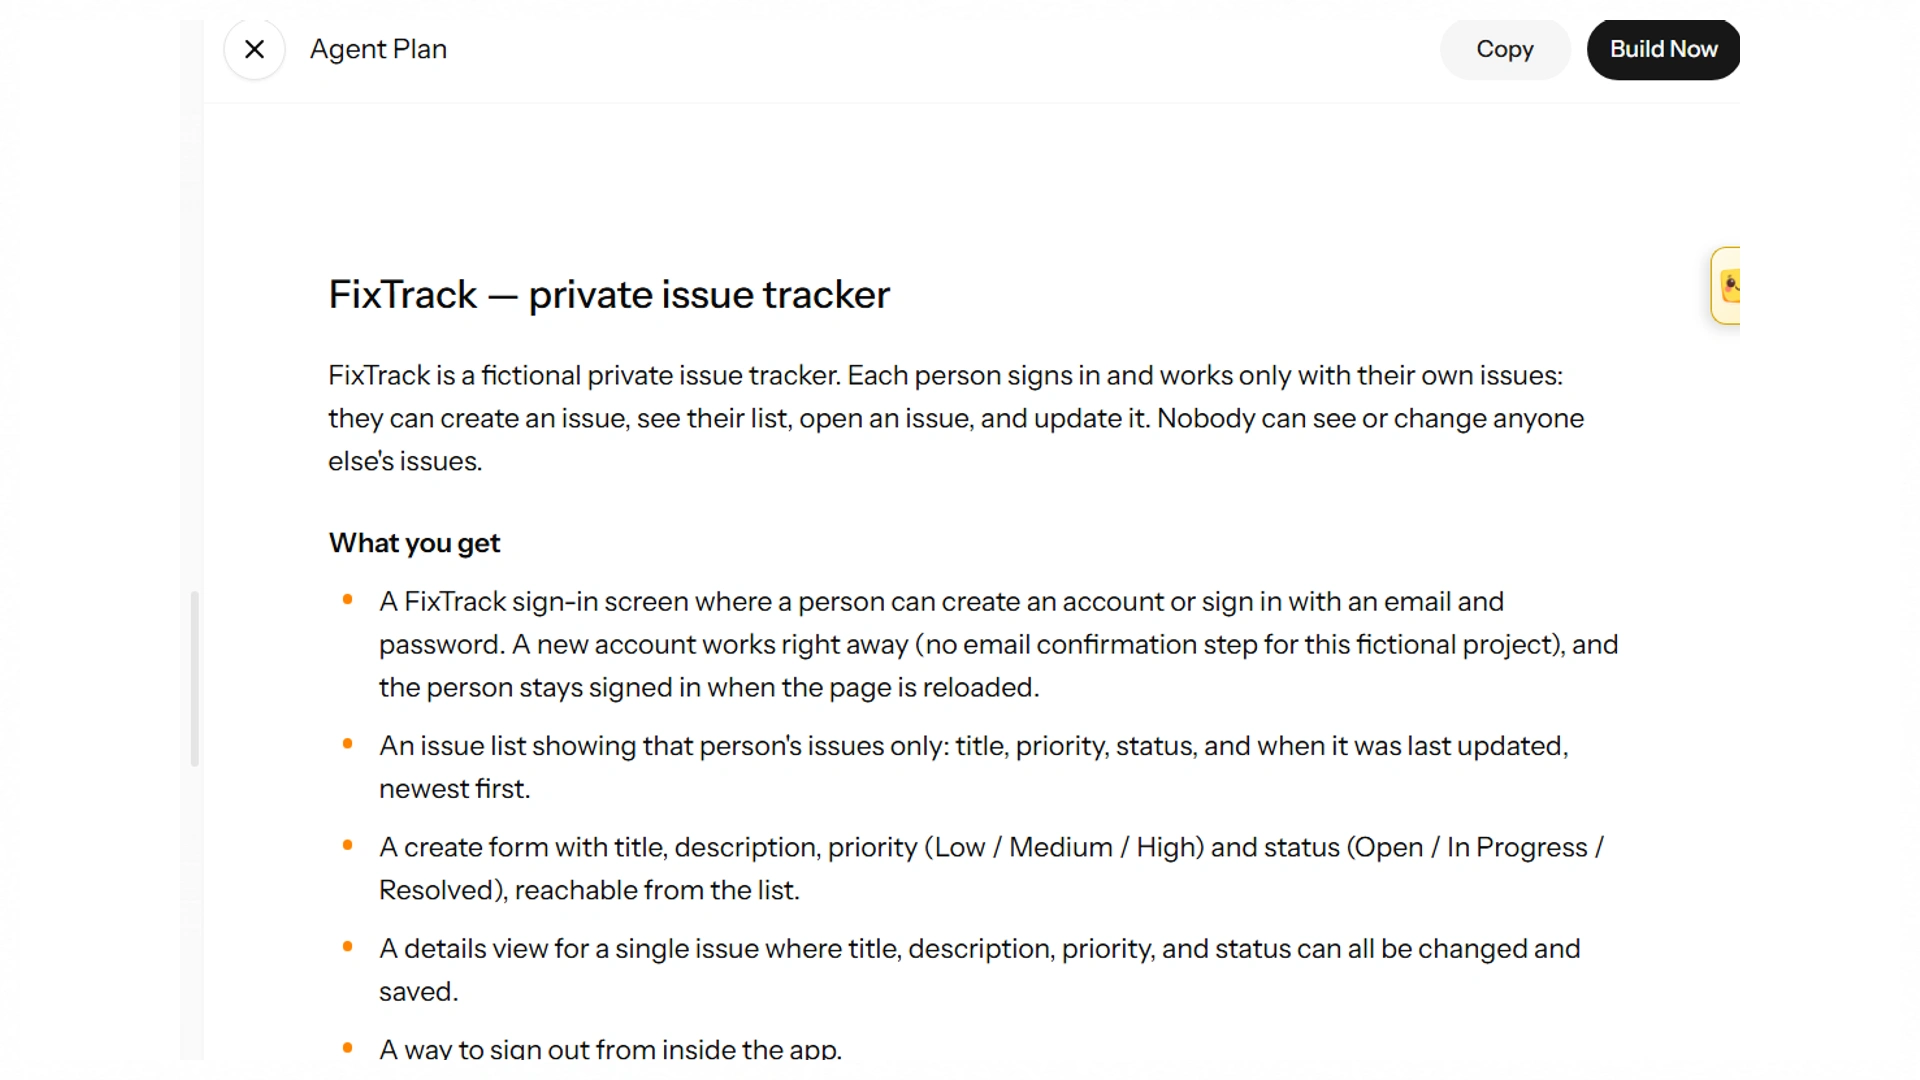
Der Plan definiert nutzereigene Issues und Abnahme-Checks. Er ist die Spezifikation für die spätere Verifikation.
Schritt 2: Bauen Sie die Oberfläche und erzwingen Sie die Datensatz-Zugehörigkeit
Die erfasste Vorschau enthält „Checkout error on mobile", markiert als High priority, Open, und Fictional demo data. Die Zähler zeigen All 1, Open 1, In Progress 0 und Resolved 0. Das macht ein nützliches Ausgangs-Fixture, weil die erwarteten Zahlen leicht zu prüfen sind. Die Beschreibung besagt, dass der Bericht erfunden ist und keinen echten Kunden betrifft. Prüfen Sie die leere Liste und Erstellungsformular-Fehler als separate Zustände; das bereitgestellte Bild belegt das sichtbare Issue, nicht jede Route im Plan.
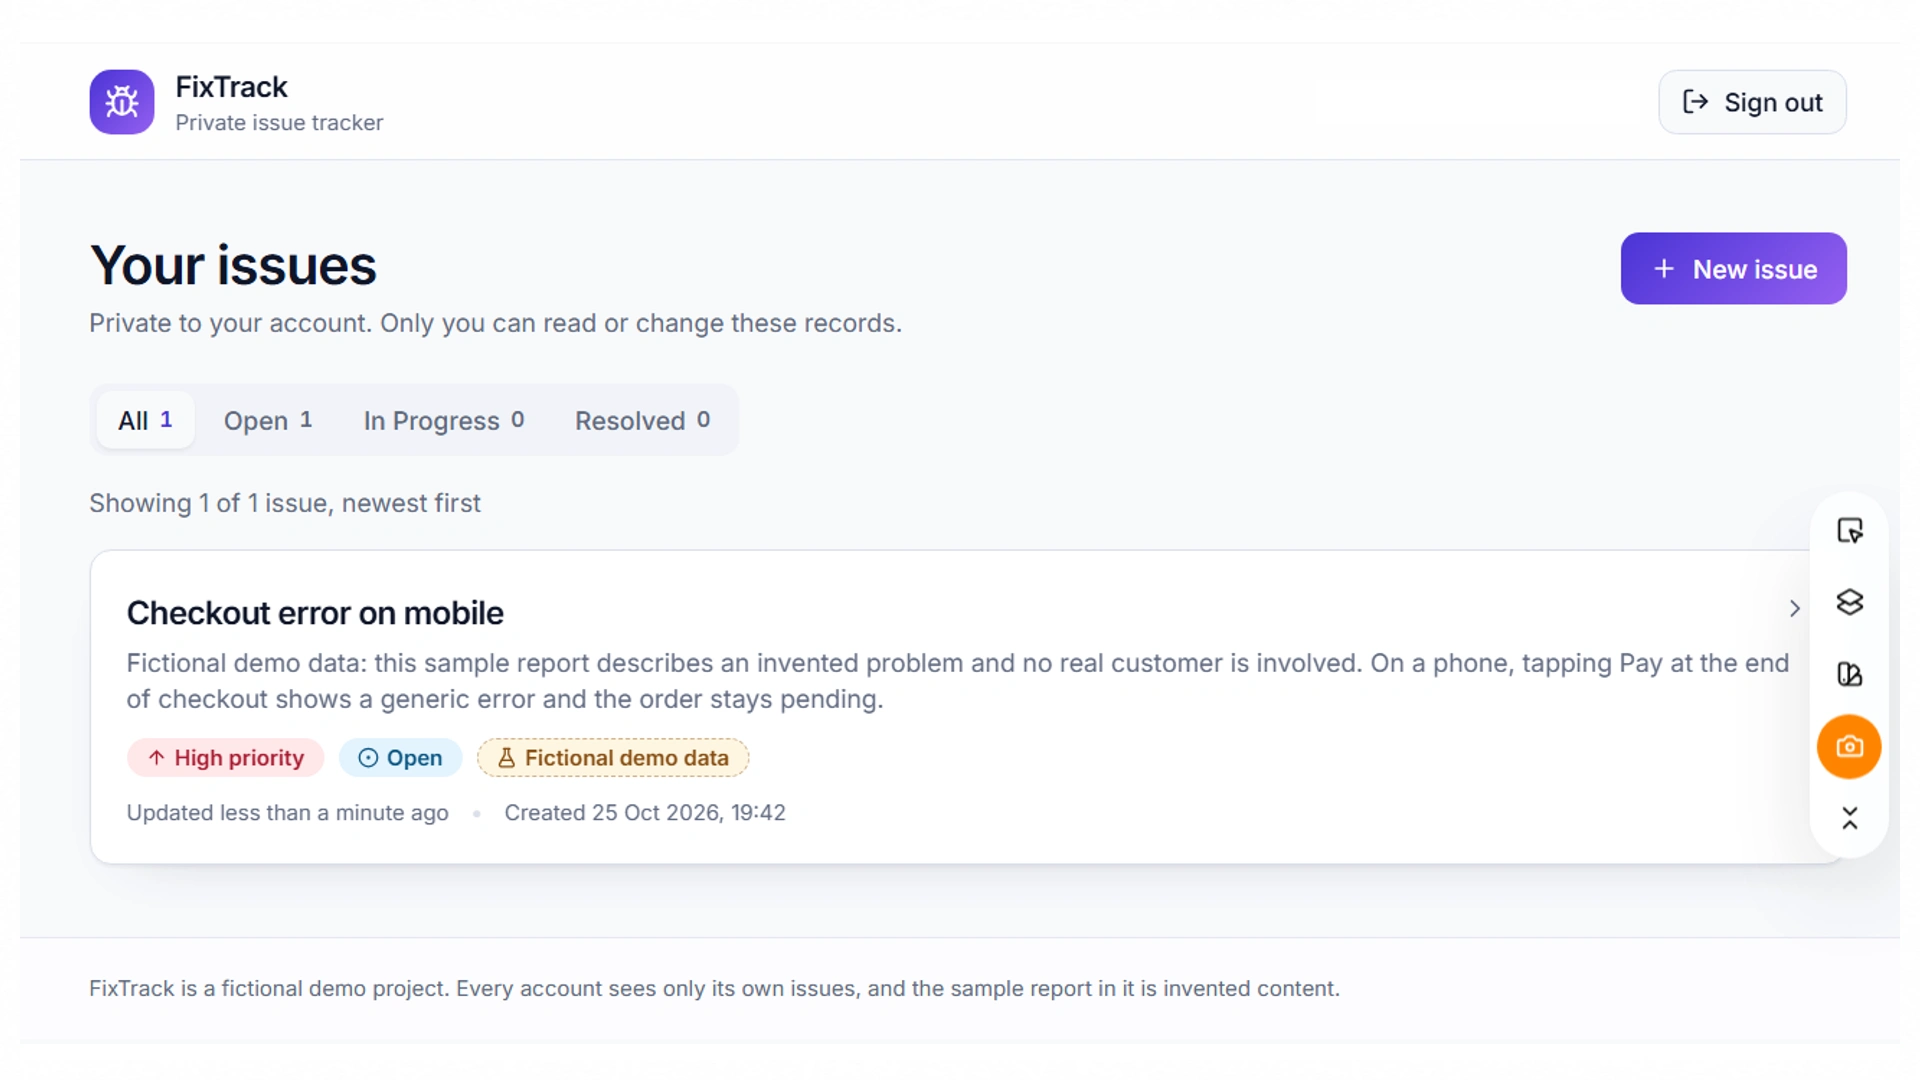
FixTrack in Enter Pro — Issue-Liste
Checkout error on mobile ist als High priority, Open und Fictional demo data gekennzeichnet. Die Zahlen sind All 1, Open 1, In Progress 0, Resolved 0.
Eine Issues-Tabelle benötigt eine serverseitig festgelegte Besitzerkennung und Zeitstempel, mit Backend-Regeln, die Lese- und Schreibzugriffe einschränken. Leiten Sie den Besitzer aus der authentifizierten Sitzung ab, statt einer vom Browser übermittelten owner_id zu vertrauen. Validieren Sie Priorität und Status gegen ihre erlaubten Werte. Die Vorschau sagt, Datensätze seien privat zu Ihrem Konto, aber das ist ein Versprechen der Oberfläche. Eine direkte unautorisierte Anfrage und die gespeicherten Besitzwerte sind die Belege, die zur Verifikation nötig sind.
Schritt 3: Prüfen Sie eine eingegrenzte Verfeinerung
Die sichtbare Liste enthält bereits die Filter All, Open, In Progress und Resolved. Verwenden Sie eine eingegrenzte Verfeinerungsanfrage, um ihr Verhalten zu verifizieren, statt zu behaupten, die Screenshots zeigten einen neu hinzugefügten Filter. Nach dem Erstellen eines zweiten eigenen Issues mit anderem Status sollte jeder Filter die erwartete Teilmenge zurückgeben und All beide Datensätze wiederherstellen. Bewahren Sie den Erstellungs-/Aktualisierungspfad und die Besitzer-Autorisierung. Ist eine Zahl falsch, melden Sie die tatsächliche Eingabe und die beobachtete Abweichung, statt eine umfassende Neugestaltung zu fordern.
Kopierbarer Verfeinerungs-Prompt — Prüfen Sie die bestehenden Filter All/Open/In Progress/Resolved anhand zweier eigener Demo-Issues mit unterschiedlichem Status. Bewahren Sie Autorisierung, Validierung und Erstellungs-/Aktualisierungsverhalten. Erklären Sie die geänderten Dateien, falls eine Korrektur nötig ist. Verifizieren Sie, dass die Filter weder Datensätze verlieren noch die Daten eines anderen Nutzers offenlegen, und unterscheiden Sie ausgeführte Befehle von Checks, die Sie nicht durchführen konnten.
Schritt 4: Verifizieren Sie Fehlerzustände und protokollieren Sie die Übergabe
Testen Sie einen leeren Titel, einen nicht unterstützten Status, eine wiederholte Einreichung und einen kontrollierten Speicherfehler. Legen Sie das erwartete Wiederholungsverhalten fest und prüfen Sie es dann gezielt. Melden Sie sich als zweiter Testnutzer an und fordern Sie das Issue des ersten Nutzers direkt an; wiederholen Sie dies abgemeldet. Prüfen Sie eine unautorisierte Aktualisierung ebenso wie ein Lesen. Kein bereitgestellter Screenshot erfasst diese Backend-Ergebnisse, behalten Sie sie daher als ausstehende Abnahme-Checks, bis Antworten und gespeicherter Zustand geprüft werden können.
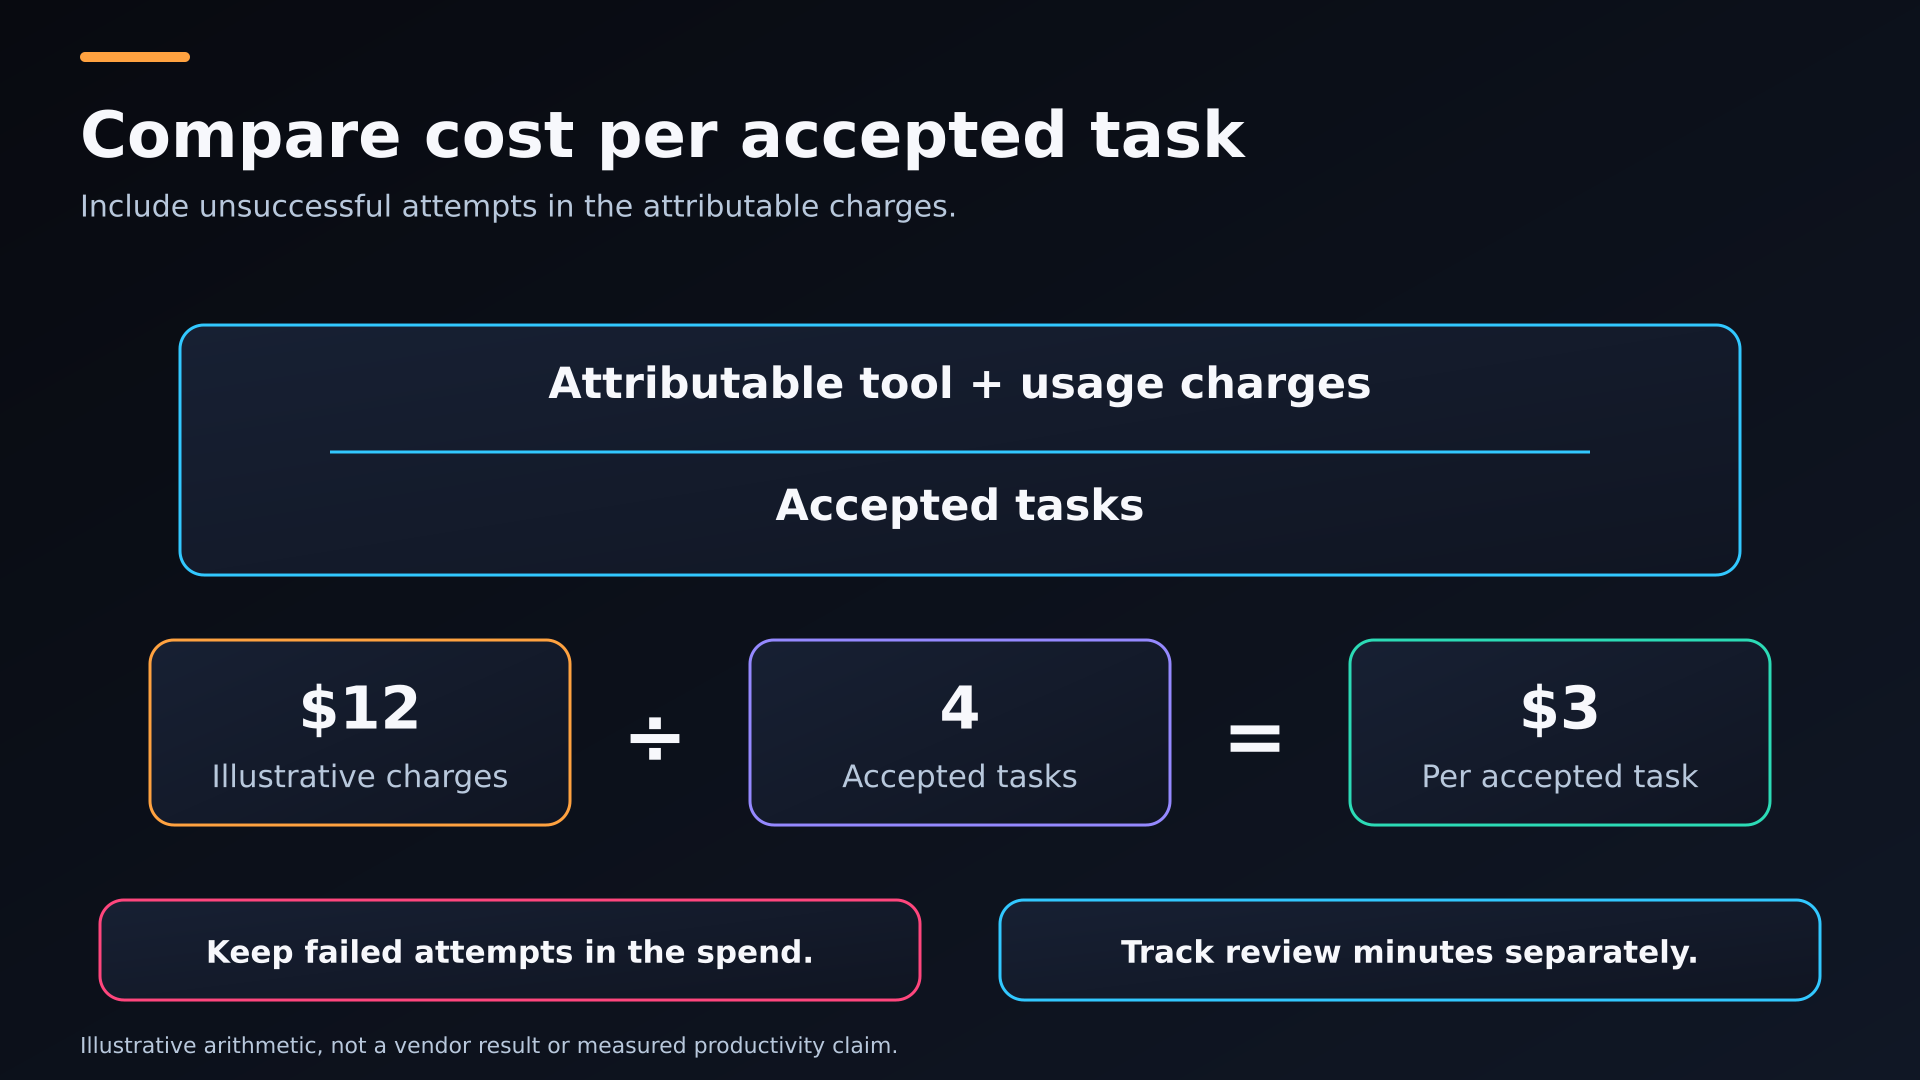
Vergleichen Sie Kosten pro akzeptierter Aufgabe: Eine Formel für Kosten pro akzeptierter Aufgabe und das hypothetische Beispiel des Artikels von 12 $ geteilt durch vier.
Das sichtbare Ergebnis ist ein generierter Issue-Tracker-Plan und ein offenes Demo-Issue mit übereinstimmenden Filterzahlen. Erfassen Sie Persistenz-, Statusänderungs- und Cross-Account-Ergebnisse, wenn Sie sie ausführen, zusammen mit vergangener Zeit, aktiver Review-Zeit und zurechenbaren Gebühren. Bewahren Sie Quelle, Einrichtungsanforderungen und ausstehende Mängel für eine Entwickler-Übergabe. Dieses kleine Projekt kann feststellen, ob der Workflow zu Ihrem Prototyp passt; es kann nicht beweisen, dass Enter Pro jeden Coding-Agenten übertrifft oder jedes bestehende Framework unterstützt.
Treffen Sie die endgültige Wahl mit einem kleinen, wiederholbaren Testlauf
Die beste KI für Programmierung ist eine praktische Passung zwischen Ihrer Aufgabe, Umgebung, Budget und Ihrer Fähigkeit, das Ergebnis zu verifizieren. Erstellen Sie eine Shortlist mit zwei Kandidaten, verwenden Sie dasselbe Briefing und vergleichen Sie akzeptierte Änderungen statt generierter Zeilen. Beginnen Sie mit einem kleinen Testlauf in Enter Pro, bewahren Sie Ihre Quelle und Checks, und erweitern Sie die Nutzung, wenn die Belege dafürsprechen.
FAQ zur besten KI für Programmierung
Kann ein Coding-Assistent ohne Zugriff auf mein gesamtes Repository arbeiten?
Oft können Sie den Kontext für eine eng gefasste Aufgabe auf das relevante Paket oder die relevanten Dateien beschränken, abhängig von den Fähigkeiten und Einstellungen des Tools. Das kann irrelevantes Material und unnötige Offenlegung reduzieren. Eine Änderung, die gemeinsam genutzte Typen oder Authentifizierung betrifft, kann einen breiteren Abhängigkeitspfad benötigen. Fragen Sie das Tool, was es benötigt, und verifizieren Sie die referenzierten Dateien, statt standardmäßig das gesamte Repository bereitzustellen.
Sollte ich für ein Coding-Tool und ein separates Modell-Abonnement bezahlen?
Nur, wenn die Kombination einen echten Zugriffs- oder Workflow-Bedarf löst. Ein Editor-Abonnement, ein API-Konto und ein Consumer-Chat-Abonnement können unterschiedliche Produkte und Abrechnungswege abdecken. Prüfen Sie, welches Konto die Coding-Sitzung tatsächlich nutzt. Vergleichen Sie die kombinierten Kosten mit akzeptierten Aufgaben und Review-Aufwand; nehmen Sie nicht an, dass doppeltes Bezahlen bedeutet, dass dieselben Aufrufe doppelt abgedeckt sind oder die Nutzung unbegrenzt ist.
Kann ein lokales Modell einen gehosteten Coding-Assistenten ersetzen?
Ein geeignetes lokales Modell kann einige Coding-Aufgaben unterstützen, aber Hardware-Kapazität, Kontextverarbeitung, Tool-Nutzung und Sprachleistung spielen eine Rolle. Die lokale Laufzeitumgebung benötigt außerdem Integration mit Ihrem Editor oder Agenten. Bewerten Sie es mit denselben Aufgaben- und Abnahme-Checks wie einen gehosteten Weg. Lokale Inferenz kann den Datenfluss und die Anbietergebühren verändern, ohne automatisch die Korrektheit zu verbessern oder den Gesamtaufwand zu reduzieren.
Garantiert ein höherer Benchmark-Score bessere Ergebnisse in meiner Sprache?
Nein. Ein Benchmark misst eine festgelegte Aufgabenmenge unter einem bestimmten Setup. Prüfen Sie die Sprache, die Repository-Typen, das Test-Harness, die Modellversion und die Agenten-Tools. Ihre Anwendung benötigt möglicherweise ein anderes Framework, interaktives Bearbeiten oder einen nicht verfügbaren externen Dienst. Ein hoher Score ist ein Grund, einen Kandidaten zu untersuchen, kein Ersatz für eine repräsentative Aufgabe in Ihrer eigenen Umgebung.
Wie oft sollte ich mein KI-Coding-Setup neu bewerten?
Überprüfen Sie es, wenn sich Modell, Preisgestaltung, Nutzungsrichtlinie, Repository oder Aufgabenmix genug ändern, um Ihre Arbeit zu beeinflussen. Bewahren Sie ein kurzes Bewertungsbriefing und dessen Checks, damit der nächste Vergleich wiederholbar ist. Das beste KI-Modell für Programmierung in Ihrem Team kann sich ändern, während Ihr Projekt vom Aufbau zur Wartung übergeht; ständiges Wechseln ohne Belege verbraucht ebenfalls Zeit.
Kann ich KI-generierten Code in einem kommerziellen Projekt verwenden?
Die kommerzielle Nutzung hängt von den geltenden Produktbedingungen und den Lizenzen von Abhängigkeiten und Quellmaterial im Projekt ab. Überprüfen Sie unbekannte Pakete, bewahren Sie erforderliche Hinweise, und dokumentieren Sie ungelöste Herkunftsfragen für eine Kunden-Übergabe. Diese Prüfungen sind unabhängig davon, ob der generierte Code funktioniert. Ein kommerziell nutzbarer Patch kann trotzdem Sicherheits-, Kompatibilitäts- und Wartbarkeits-Review benötigen.
Kann ich ein Enter-Pro-Projekt in GitHub fortsetzen?
Enter Pro dokumentiert eine GitHub-Integration für Quellcode-Synchronisation und Entwickler-Zusammenarbeit. Bestätigen Sie das verbundene Repository und den Branch und überprüfen Sie dann Quelle und Einrichtungsanweisungen, bevor Sie fortfahren. Die bereitgestellten Bilder von FixTrack zeigen nicht, dass diese Übergabe abgeschlossen wurde. Gehostete Datenbankeinstellungen, Secrets und Migrationen können zusätzliche Übertragung oder Konfiguration über das Code-Repository hinaus erfordern.
Unterstützt Enter Pro jedes bestehende Repository und Framework?
Gehen Sie nicht von universeller Repository- oder Framework-Kompatibilität aus. Prüfen Sie den dokumentierten Projektweg und untersuchen Sie den generierten Stack und die Integrationsanforderungen. FixTrack demonstriert einen Anwendungs-Workflow, nicht die Unterstützung für jeden Legacy-Dienst. Verifizieren Sie bei einem bestehenden Projekt die Kompatibilität und einen kleinen Testdurchlauf, bevor Sie das Haupt-Repository committen oder eine Migration um das Tool herum planen.