
Was ist das beste LLM für Coding 2026? 6 Top-Modelle im Test
Welches LLM eignet sich 2026 am besten zum Programmieren? Wir vergleichen Cloud-Assistenten und lokale LLM-Modelle nach Genauigkeit, Datenschutz und Geschwindigkeit.
Als unser Team sich auf die Suche nach dem besten LLM für Coding machte, merkten wir schnell: Benchmark-Werte allein reichen nicht aus. Jeden Tag kämpfen wir mit verzwickten Codebasen oder bewerten traditionelle Backend-Giganten, die mit modernen Workflows kollidieren.
Wir haben gelernt, dass die Modellwahl ganz von den konkreten Hürden abhängt, vor denen man steht. Frontier-Cloud-Modelle liefern die tiefe Schlussfolgerungsfähigkeit, die komplexe Anwendungen brauchen – doch wer proprietären Enterprise-Code verwaltet, kommt an einer selbst gehosteten Architektur nicht vorbei.
In diesem Guide teilen wir unsere Erfahrungen aus erster Hand. Wir schlüsseln unsere Bewertungskriterien auf, analysieren die sechs getesteten Top-Modelle, stellen autonome Dev-Agenten vor und werfen einen Blick auf den Konsens der Entwickler-Community. Sie erfahren genau, welches Tool – vom besten Coding-LLM bis zum cloudbasierten Giganten – Ihr Ökosystem wirklich optimiert.
Zentrale Bewertungskriterien für Entwickler-LLMs
Um verlässliche Coding-Assistenten von einfachen Chatbots zu unterscheiden, haben wir jedes Modell anhand von 5 grundlegenden Kriterien bewertet, die reale Softwareentwicklung widerspiegeln:
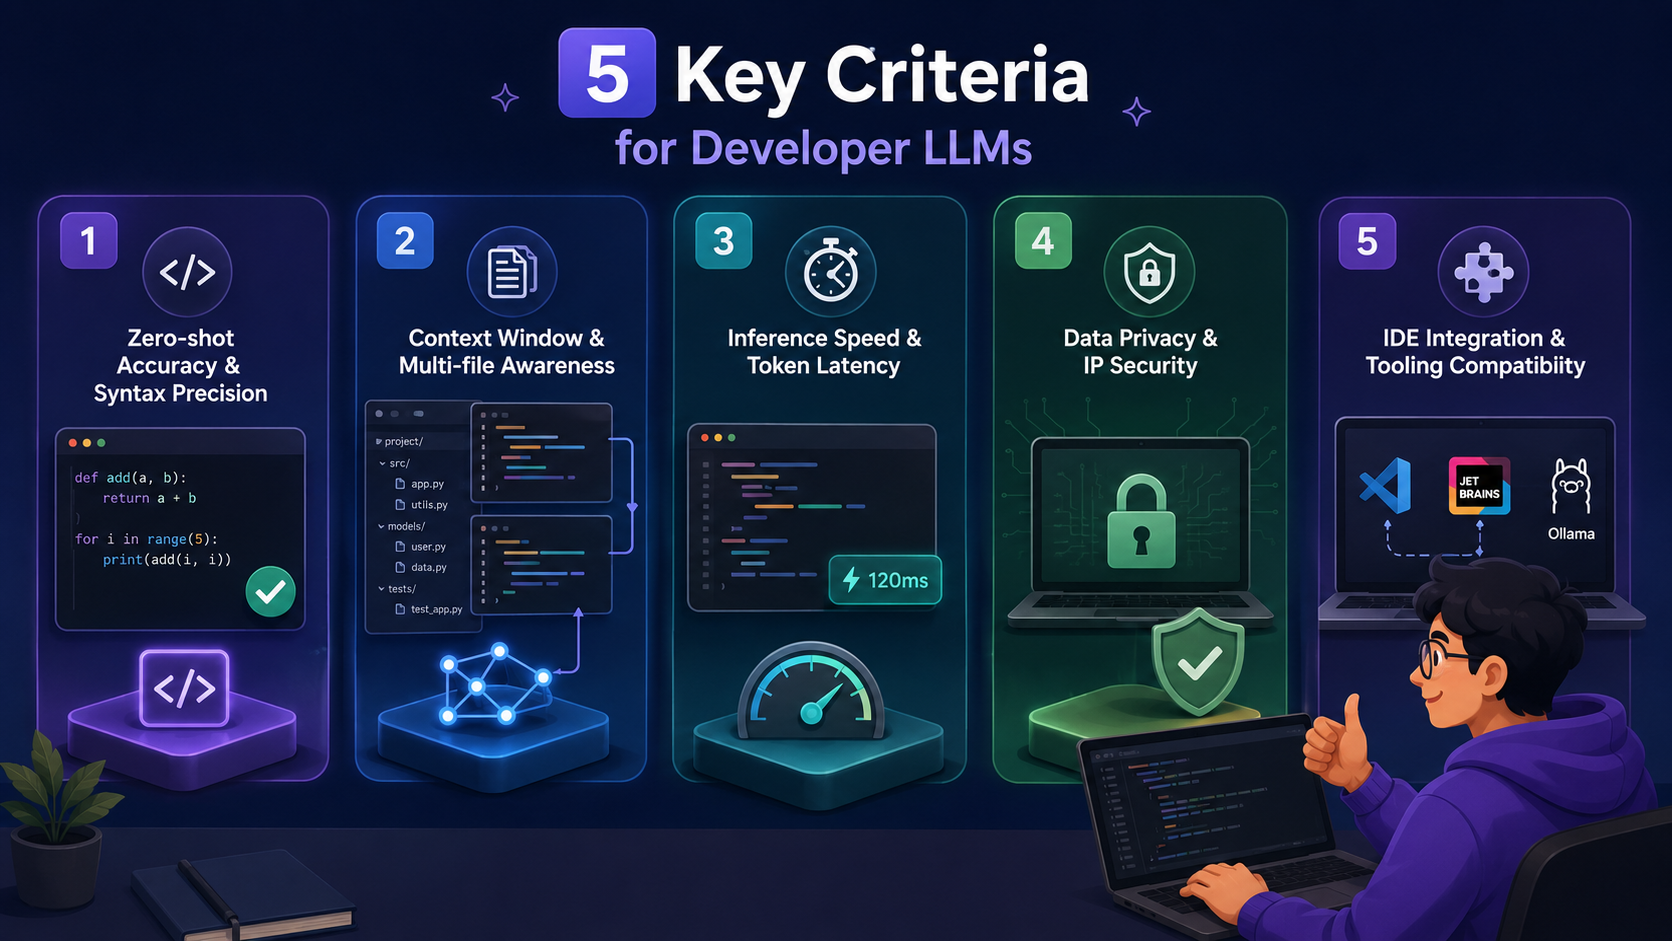
- Zero-Shot-Genauigkeit & Syntaxpräzision: Misst, wie zuverlässig ein Modell gleich beim ersten Versuch korrekten, funktionierenden Code erzeugt. Ein starkes Modell schreibt sofort saubere Syntax, ohne fiktive Bibliotheken zu erfinden, veraltete APIs zu referenzieren oder subtile Logikfehler einzubauen.
- Kontextfenster & Multi-File-Verständnis: Moderne Software passt selten in eine einzige Datei. Wir haben das „Arbeitsgedächtnis" jedes Modells getestet, um zu sehen, wie zuverlässig es verknüpfte Variablen, Abhängigkeiten und Architekturlogik über ein gesamtes Multi-File-Projekt hinweg nachverfolgt, ohne den Überblick zu verlieren.
- Inferenzgeschwindigkeit & Token-Latenz: Geschwindigkeit beeinflusst direkt den Flow-Zustand eines Entwicklers. Wir haben Antwortzeiten getestet, damit Inline-Vorschläge und Echtzeit-Autovervollständigung sofort erscheinen, ohne merkbare Tippverzögerung.
- Datenschutz & IP-Sicherheit: Der Schutz proprietären Codes ist für jedes Team entscheidend. Wir haben die Datenaufbewahrungsrichtlinien der Cloud-APIs geprüft und Offline-, abgeschottete Fähigkeiten getestet, um sicherzustellen, dass sensibler Unternehmenscode vollständig privat bleibt.
- IDE-Integration & Tool-Kompatibilität: Ein starkes Modell nützt nur dann etwas, wenn es sich nahtlos in den täglichen Workflow eines Entwicklers einfügt. Wir haben bewertet, wie einfach sich jedes Modell in beliebte Code-Editoren wie VS Code und JetBrains sowie in lokale Laufzeitumgebungen wie Ollama einbinden lässt.
Die 6 besten LLMs für Coding in den Top-Kategorien
Um sich in der sich rasant verändernden KI-Landschaft zurechtzufinden, muss man das beste LLM für Coding 2026 identifizieren, das zu den eigenen Hardware-Grenzen, Datenschutzanforderungen und der architektonischen Komplexität des Workflows passt:
| Modellname | Kategorie | Hauptstärke | Am besten für |
|---|---|---|---|
| Claude Opus 5 | Frontier-Cloud | Komplexes agentisches Coding | Große Refactorings & Agent-Loops |
| GPT-5.6 Sol | Frontier-Cloud | Deterministische Durchführung | Mehrstufige Aufgaben & Prototyping |
| GLM-5.2 | Lokal/Open-Weight | 1-Mio.-Token-Kontextfenster | Selbst gehostetes, nahezu Frontier-Coding |
| DeepSeek V4-Pro | Lokal/Open-Source | Competitive Programming | Hochvolumige API-Aufgaben & Mathematik |
| Qwen3-Coder-Next | Leichtgewichtig | Effizienz pro Parameter | Bescheidene lokale Hardware |
| Gemini 3.7 Flash | Leichtgewichtig/günstig | Komplexe agentische Aufgaben | Hochvolumige Arbeit & Refactorings |
Frontier-Cloud-KI-Modelle (maximale Schlussfolgerung & Kontext)
Diese Modelle stützen sich auf massive Remote-Server-Cluster zur Prompt-Verarbeitung und können dadurch riesige Kontextfenster und komplexes mehrstufiges Reasoning bewältigen, das lokale Hardware schlicht nicht leisten kann. Sie sind ideal für die Planung komplexer Systemarchitekturen.
- Claude Opus 5
Bei der Bewertung der Optionen für unseren Entwicklungs-Stack zeigt sich: Claude Opus 5 sticht als das beste Coding-LLM für reale Engineering-Arbeit, große Refactorings und mehrstufige Agent-Loops hervor. Anthropic entwickelt die Claude-LLMs in Stufen wie Haiku 4.5, Sonnet 5, Opus 5 und Fable 5. Aktuell führt es verifizierte Ranglisten für komplexe Software-Aufgaben an.
| Version | Speichergröße (Kontext) | Am besten für | Einfach erklärt |
|---|---|---|---|
| Claude Fable 5 | Riesig (1 Mio. Token) | Spezialisierte Forschung & langwierige Aufgaben | Das Premium-Modell für komplexe wissenschaftliche und Cybersecurity-Arbeit. |
| Claude Opus 5 | Riesig (1 Mio. Token) | Umfassende Refactorings & Agent-Loops | Das Top-Gehirn für komplexe Multi-File-Codebasen. |
| Claude Sonnet 5 | Riesig (1 Mio. Token) | Ausgewogene tägliche Entwicklung | Der verlässliche Alltags-Workhorse für tägliche Coding-Aufgaben. |
| Claude Haiku 4.5 | Hoch (200.000 Token) | Schnelle Skripte & rasche Fehlersuche | Kostenloses Modell: Der leichte Sprinter für Geschwindigkeit und null Kosten. |
Vorteile:
- Liefert branchenführende Zero-Shot-Coding-Genauigkeit mit proaktivem Verifikationsverhalten.
- Bietet ein riesiges Kontextfenster, das große Multi-File-Codebasen mühelos aufnimmt.
- Punktet außergewöhnlich gut bei wichtigen agentischen Coding-Benchmarks.
Nachteile:
- Erfordert durchgehende Internetverbindung mit strikter Cloud-Abhängigkeit.
- Die Token-Kosten können bei groß angelegten Entwicklerteams schnell steigen.
Am besten für: Großes Code-Refactoring, Full-Stack-Systemdesign und komplexe agentische Workflows.
- GPT-5.6 Sol
Ein vielseitiges Flaggschiff-Modell mit breiter Sprachsyntax-Abdeckung und umfassender Ökosystem-Integration. OpenAI hat mit GPT-5.6 die Preis-Leistungs-Grenze jüngst weiter vorangetrieben. Es dient Entwicklern, die Softwarearbeit effizient erledigen wollen, als sehr zuverlässiger Alltags-Workhorse.
| Version | Geschwindigkeit | Kompatibel mit | Einfach erklärt |
|---|---|---|---|
| GPT-5.6 Sol | Schnell | Wichtige IDEs & Agent-Frameworks | Der robuste Assistent, der mehrstufige Aufgaben stetig abarbeitet. |
| GPT-5.6 Terra | Mittel | Standard-Entwicklungstools | Die ausgewogene API-Version für stabile, schrittweise Problemlösung. |
| GPT-5.6 Luna | Blitzschnell | Web & leichte Tools | Kostenloses Modell: Der schnelle, kostenlose Alltagshelfer für rasche Codegenerierung. |
Vorteile:
- Stetige, deterministische Durchführung über lange, mehrstufige Aufgaben hinweg, ohne vom Kurs abzukommen.
- Tiefe Ökosystem-Kompatibilität mit wichtigen Erweiterungen und Entwicklerplattformen.
- Umfassende Trainingsabdeckung für obskure und veraltete Programmiersprachen.
Nachteile:
- Produziert gelegentlich übermäßig ausführlichen Boilerplate-Code statt knapper Snippets.
- Das Kontextgedächtnis kann in sehr langen Chat-Sitzungen nachlassen.
Am besten für: Deterministische, mehrstufige Aufgaben, schnelles Prototyping und API-Integration.
Top-Open-Source- & lokale LLMs (Enterprise-Datenschutz & Anpassbarkeit)
Für Organisationen, die den Schutz geistigen Eigentums priorisieren, stellt der offline Betrieb lokaler LLM-Modelle sicher, dass kein proprietärer Code jemals an einen Drittanbieter-Server übertragen wird. Diese Modelle bieten enorme Power für Enterprise-Compliance.
- GLM-5.2
Das beste verfügbare Open-Weight-Coding-Modell mit enormem Fine-Tuning-Potenzial. GLM-5.2 ist ein Flaggschiff-Modell für langwierige Aufgaben und liefert diese Fähigkeit mit einem solide ausgebauten 1-Mio.-Token-Kontext.
| Version | Benötigte Hardware | Leistungsniveau | Einfach erklärt |
|---|---|---|---|
| GLM-5.2 (groß) | Schweres Enterprise-Rechenzentrum | Top-Intelligenz | Der beste Open-Weight-Coder mit einem riesigen 1-Mio.-Gedächtnisfenster. |
| GLM-5.2 (klein) | Standard-Laptop | Gut für alltägliche Hilfe | 100 % kostenlos & lokal: Läuft offline direkt auf Ihrem Laptop ohne API-Gebühren. |
| GLM-5.2 Cloud | Webbrowser/API | Hohe Schlussfolgerungskraft | Kostenloser Web-Zugang: Das browserbasierte Tool für Experimente ohne Einrichtung. |
Vorteile:
- Sehr wettbewerbsfähiges Open-Weight-Modell für langwierige Engineering-Aufgaben.
- Riesiges 1-Mio.-Token-Kontextfenster, um ganze Repositorys lokal einzulesen.
- Großzügige Open-Lizenz, die Unternehmens- und kommerzielle Entwicklung erlaubt.
Nachteile:
- Erfordert High-End-Enterprise-Hardware, um das 1-Mio.-Token-Kontextfenster lokal voll auszunutzen.
- Open-Weight-Modelle sind zwar kostenlos herunterladbar, doch der Betrieb im großen Maßstab erfordert teure Server-Ressourcen.
Am besten für: Das Selbst-Hosten eines nahezu Frontier-fähigen Coders bei absoluter Enterprise-Datenschutzgarantie.
- DeepSeek V4-Pro
Ein leistungsstarkes Modell, speziell für fortgeschrittene Coding-Aufgaben entwickelt. DeepSeek entwickelt und veröffentlicht Frontier-LLMs als Open Source. Es überzeugt bei mathematischer Logik und komplexen algorithmischen Strukturen weit über seine Gewichtsklasse hinaus und bietet mit 1,6 Billionen Parametern eine massive Basis für umfangreiche Textgenerierung.
| Version | Kernstärke | Am besten für | Einfach erklärt |
|---|---|---|---|
| DeepSeek V4-Pro | Competitive Programming & Mathematik | Enterprise-taugliche Repositorys | Ein spezialisiertes Coding-Gehirn, das bei Algorithmen und komplexer Logik glänzt. |
| DeepSeek V4 | Allgemeine Schlussfolgerung & Syntax | Alltägliches Scripting & Recherche | Kostenlose Web-Version: Ein Allround-Chatbot für alltägliches Schreiben und einfachen Code. |
| DeepSeek-Coder 7B | Leichtgewichtige Ausführung | Offline lokale Entwicklung | 100 % kostenlos & lokal: Ein privates, kostenloses Modell, das auf dem eigenen PC läuft. |
Vorteile:
- Glänzt stark bei algorithmischen und Competitive-Programming-Aufgaben.
- Bietet beim Selbst-Hosten absoluten Datenschutz für strenge Vorgaben zur Datenresidenz.
- Umfangreiche mathematische Schlussfolgerungsfähigkeit und hochvolumige API-Fähigkeiten.
Nachteile:
- Konfigurationen mit vollen Parametern erfordern Enterprise-taugliches GPU-VRAM.
- Einrichtung und Quantisierungs-Fine-Tuning erfordern fortgeschrittenes technisches Know-how.
Am besten für: Datenschutzsensible Enterprise-Repositorys, hochvolumige API-Aufgaben und algorithmisches Problemlösen.
Spezialisierte & leichtgewichtige Coding-Modelle (schnelle Autovervollständigung & niedrige Latenz)
Diese Modelle sind stark quantisiert und explizit darauf optimiert, nativ im Hintergrund auf Consumer-Laptops zu laufen oder kosteneffizient in der Cloud zu arbeiten. Sie fungieren streng als schnelle Assistenten und maximieren die Effizienz.
- Qwen3-Coder-Next
Ein hocheffizientes, code-spezialisiertes Modell, optimiert für mehrsprachige Codevervollständigung auf Standard-Consumer-Hardware. Die neuesten Qwen3-Modelle nutzen hybride Denkmodi, mit denen sich Reasoning-Leistung, Geschwindigkeit und Kosten flexibel steuern lassen.
| Version | Antwortgeschwindigkeit | Sprachabdeckung | Einfach erklärt |
|---|---|---|---|
| Qwen3-Coder-Next | Schnell | 90+ Programmiersprachen | Die Flaggschiff-Open-Weight-Engine für ernsthafte lokale Entwickler-Setups. |
| Qwen3-Coder (7B) | Sofort | 90+ Programmiersprachen | 100 % kostenlos & lokal: Wie eine Textvorhersage für Code, die reibungslos auf Standard-Laptops läuft. |
| Qwen-Chat | Sofort | Standard-Coding & natürliche Sprache | Kostenlose Web-Version: Ein schneller, kostenloser Konversationshelfer für Syntax-Checks. |
Vorteile:
- Bietet exzellente Coding-Effizienz pro Parameter für leichtgewichtige lokale Setups.
- Läuft reibungslos auf Standard-Consumer-Hardware und bescheidenen lokalen Einsätzen mit minimalem Ressourcenaufwand.
- Starke mehrsprachige Syntax-Unterstützung für über 90 Programmiersprachen.
Nachteile:
- Begrenzte Reasoning-Tiefe bei der Planung ganzer Softwarearchitekturen.
- Kleineres Kontext-Retentionsfenster im Vergleich zu großen Cloud-Modellen.
Am besten für: Zeilenweise Autovervollständigung und Entwickler, die Modelle auf Standard-Laptops betreiben.
- Gemini 3.7 Flash
Ein flüssiger Coding-Assistent, explizit für budgetfreundlichen Cloud-Betrieb und komplexe agentische Setups entwickelt. Gemini 3.7 Flash eignet sich am besten, um komplexe agentische Aufgaben im großen Maßstab zu bewältigen.
| Version | Wie es hilft | Wo es läuft | Einfach erklärt |
|---|---|---|---|
| Gemini 3.7 Flash | Komplexe agentische Aufgaben im großen Maßstab | Cloud-API | Ein schneller Cloud-Assistent für große Codebasen und komplexe Workflows. |
| Gemini 3.5 Flash-Lite | Hochvolumige Aufgaben | Cloud-API | Großzügige kostenlose API-Stufe: Ein leichtgewichtiges Modell, entwickelt für Effizienz und Intelligenz. |
| Gemini Web | Allgemeines Chatten & Code-Snippets | Webbrowser | Kostenlose Web-Version: Ein einfacher, kostenloser Assistent zum Entwurf von Funktionen und für Antworten auf Fragen. |
Vorteile:
- Unglaublich effizient für hochvolumige Agent-Workflows.
- Bewältigt riesige Kontextfenster und liest dadurch problemlos enorme Codebasen.
- Schnelle Token-Ausgabe für rasche Fehlersuche und Echtzeit-Bearbeitungen.
Nachteile:
- Funktioniert strikt als Cloud-API, kann also für extremen Datenschutz nicht abgeschottet oder selbst gehostet werden.
- Kann Prompt-Anpassungen erfordern, um die strikte Formatierungstreue von Claude oder GPT zu erreichen.
Am besten für: Kosteneffizientes Cloud-Coding, hochvolumige Agent-Arbeit und Aufgaben mit langem Kontext.
Wie wir diese LLMs getestet haben
Wir haben jedes Modell mit einem streng reproduzierbaren technischen Framework getestet, um subjektive Verzerrungen auszuschließen. Unsere Testreihe kombiniert etablierte Entwickler-Benchmarks mit praxisnahen, realen Engineering-Herausforderungen.
Kontrolliertes Baseline-Prompting
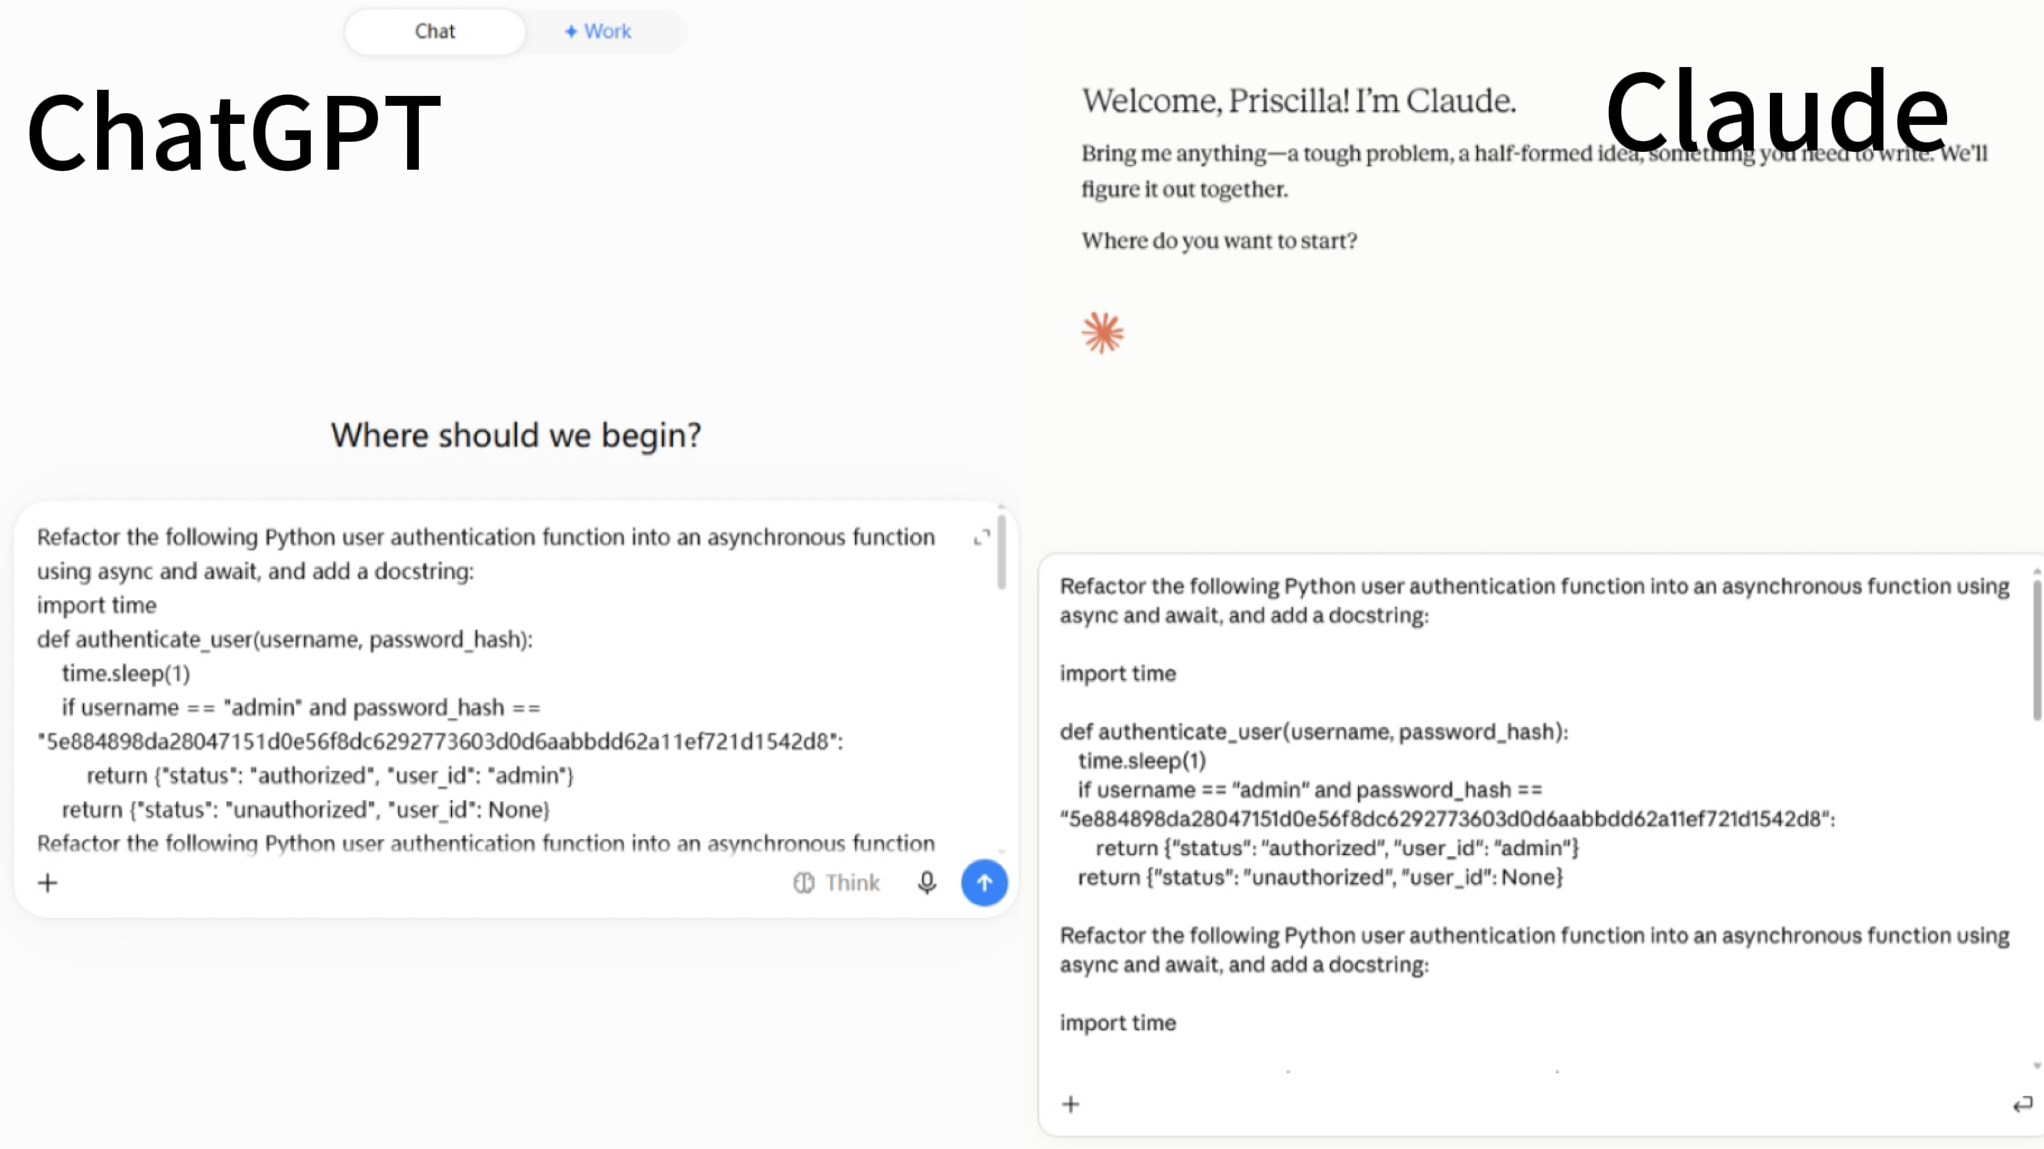
Um reines Reasoning im Jahr 2026 zu testen, haben wir 5 identische architektonische Refactoring-Prompts direkt in die nativen Web-Interfaces von Branchenführern wie ChatGPT und Claude eingegeben.
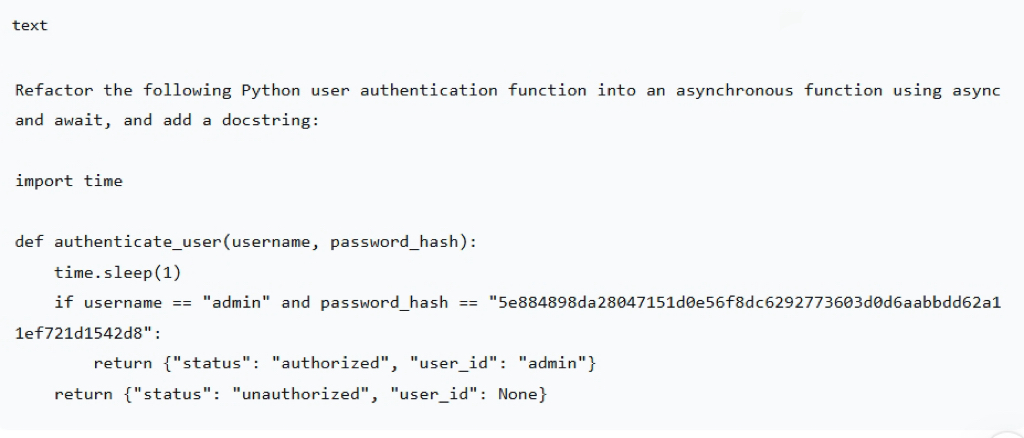
Schritt 1: 5 identische architektonische Refactoring-Prompts vorbereiten
Zuerst haben wir einen einheitlichen architektonischen Refactoring-Prompt geschrieben und ihn fünfmal kopiert, dabei darauf geachtet, dass der Inhalt exakt gleich blieb. Ein Beispiel-Prompt ist unten abgebildet:
Schritt 2: Die Prompts in den nativen ChatGPT/Claude-Interfaces einreichen
Wir haben die Web-Interfaces von ChatGPT und Claude geöffnet, die Prompts einzeln eingefügt und eingereicht und jede Antwort vollständig protokolliert.
Schritt 3: Die Fähigkeit zur Multi-File-Logikverarbeitung bewerten
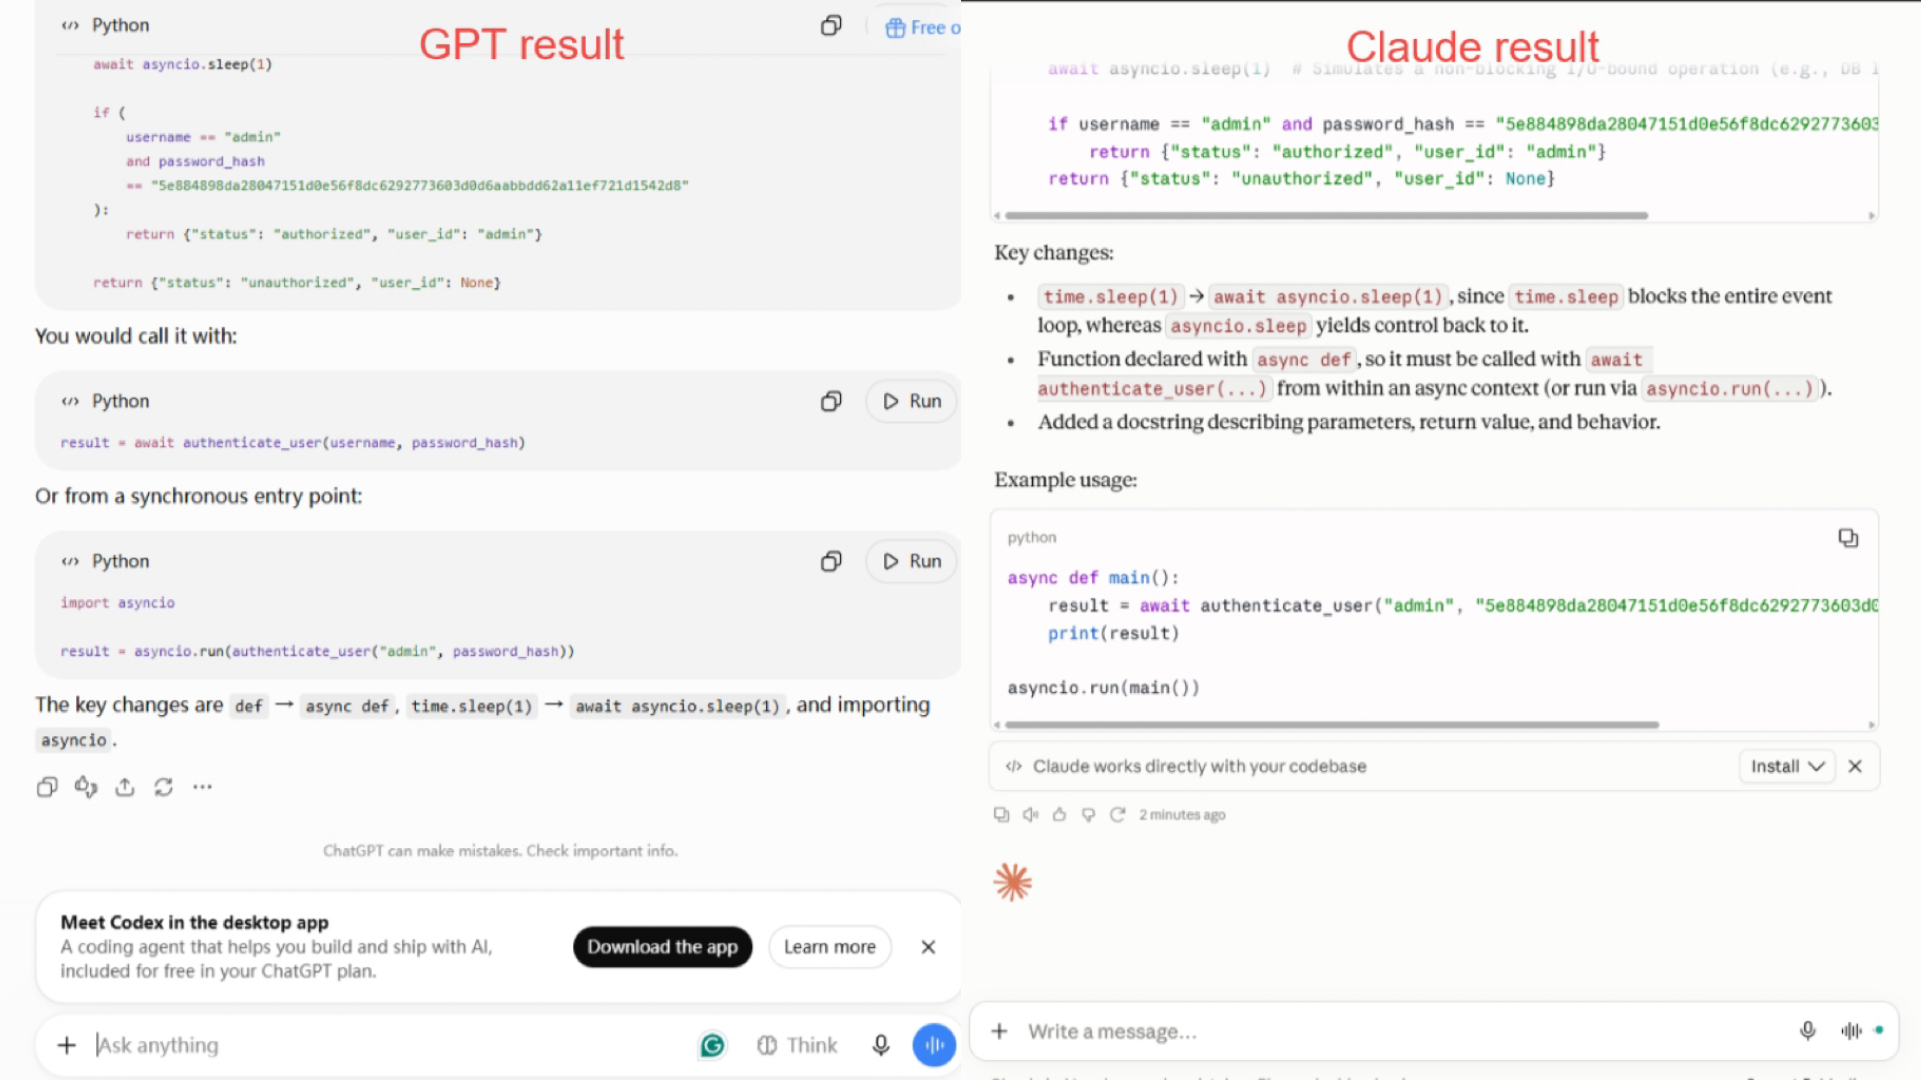
Nachdem jedes Tool seine Ergebnisse liefert, bewerten wir ihre jeweils tatsächliche Schlussfolgerungsfähigkeit. Am Beispiel von ChatGPT und Claude zeigt sich: Beide Modelle haben das gleiche Refactoring korrekt abgeschlossen, doch Ausgabestil und Schwerpunkte unterscheiden sich. ChatGPT tendiert dazu, das Ergebnis plus kurzer Nutzungshinweise zu liefern, während Claude eher die zugrunde liegenden Prinzipien erklärt und Einschränkungen betont. Das spiegelt ihre unterschiedlichen Reasoning- und Ausdrucksstile bei identischem Input wider.
Profiling des lokalen Hardware-Overheads
Lokale Modelle bieten vollständigen Datenschutz – aber nur, wenn sie effizient auf praxistauglicher Hardware laufen. Wir haben leichtgewichtige Open-Weight-Modelle wie Qwen3-Coder (7B) und DeepSeek-Coder direkt auf einer lokalen Workstation profiliert.
- Wir haben VRAM-Spitzen und CPU-Lasten während der maximalen Token-Generierung überwacht, um reale Ressourcengrenzen zu identifizieren.
- Wir haben überprüft, ob Entwickler sichere, offline Workflows selbst hosten können, ohne teure Enterprise-Hardware zu benötigen.
IDE-Integration und UX-Reibung
Theoretische Latenz-Kennzahlen bedeuten nichts, wenn sich Code-Vorschläge beim Live-Editieren träge anfühlen. Wir haben leichtgewichtige Modelle wie Qwen3-Coder und Gemini 3.7 Flash in einem Standard-Code-Editor getestet, um Live-Inline-Vervollständigung und Eingabeverzögerung zu bewerten.
- Wir haben die reale Latenz bewertet, um sicherzustellen, dass der prädiktive „Ghost-Text" sich nahtlos an das natürliche Tipp-Tempo eines Entwicklers anpasst.
- Wir haben das Kontextbewusstsein überprüft, um sicherzustellen, dass die Modelle Variablen in benachbarten geöffneten Projektdateien korrekt lesen und anwenden.
Isolierte Ausführung und Syntax-Verifikation
Code, der in einem Chat-Interface korrekt aussieht, scheitert oft zur Laufzeit. Wir haben von DeepSeek V4-Pro und GPT-5.6 Sol generierte Snippets direkt in isolierten Docker-Containern kompiliert und ausgeführt.
- Objektive Sandbox-Durchläufe markierten sofort veraltete Methoden, fehlende Imports und syntaktische Halluzinationen.
- Wir haben die tatsächlichen Pass@1-Raten verfolgt, um zu bestätigen, dass die Logik die Testsuiten bereits beim ersten Versuch erfüllte.
Während eigenständige Cloud- und lokale LLMs bei der Generierung von Snippets und der Verfeinerung spezifischer Funktionen glänzen, erfordert der Aufbau kompletter Anwendungen weiterhin manuelle IDE-Konfiguration, Boilerplate-Setup und Frontend-Backend-Integration. Für Entwickler und Creator, die repetitive Coding-Zyklen komplett vermeiden möchten, bieten autonome Entwicklungs-Agenten einen schnelleren Weg von der Idee bis zum fertigen Deployment.
Enter Pro: Der autonome KI-Dev-Agent für schnelle Softwareentwicklung
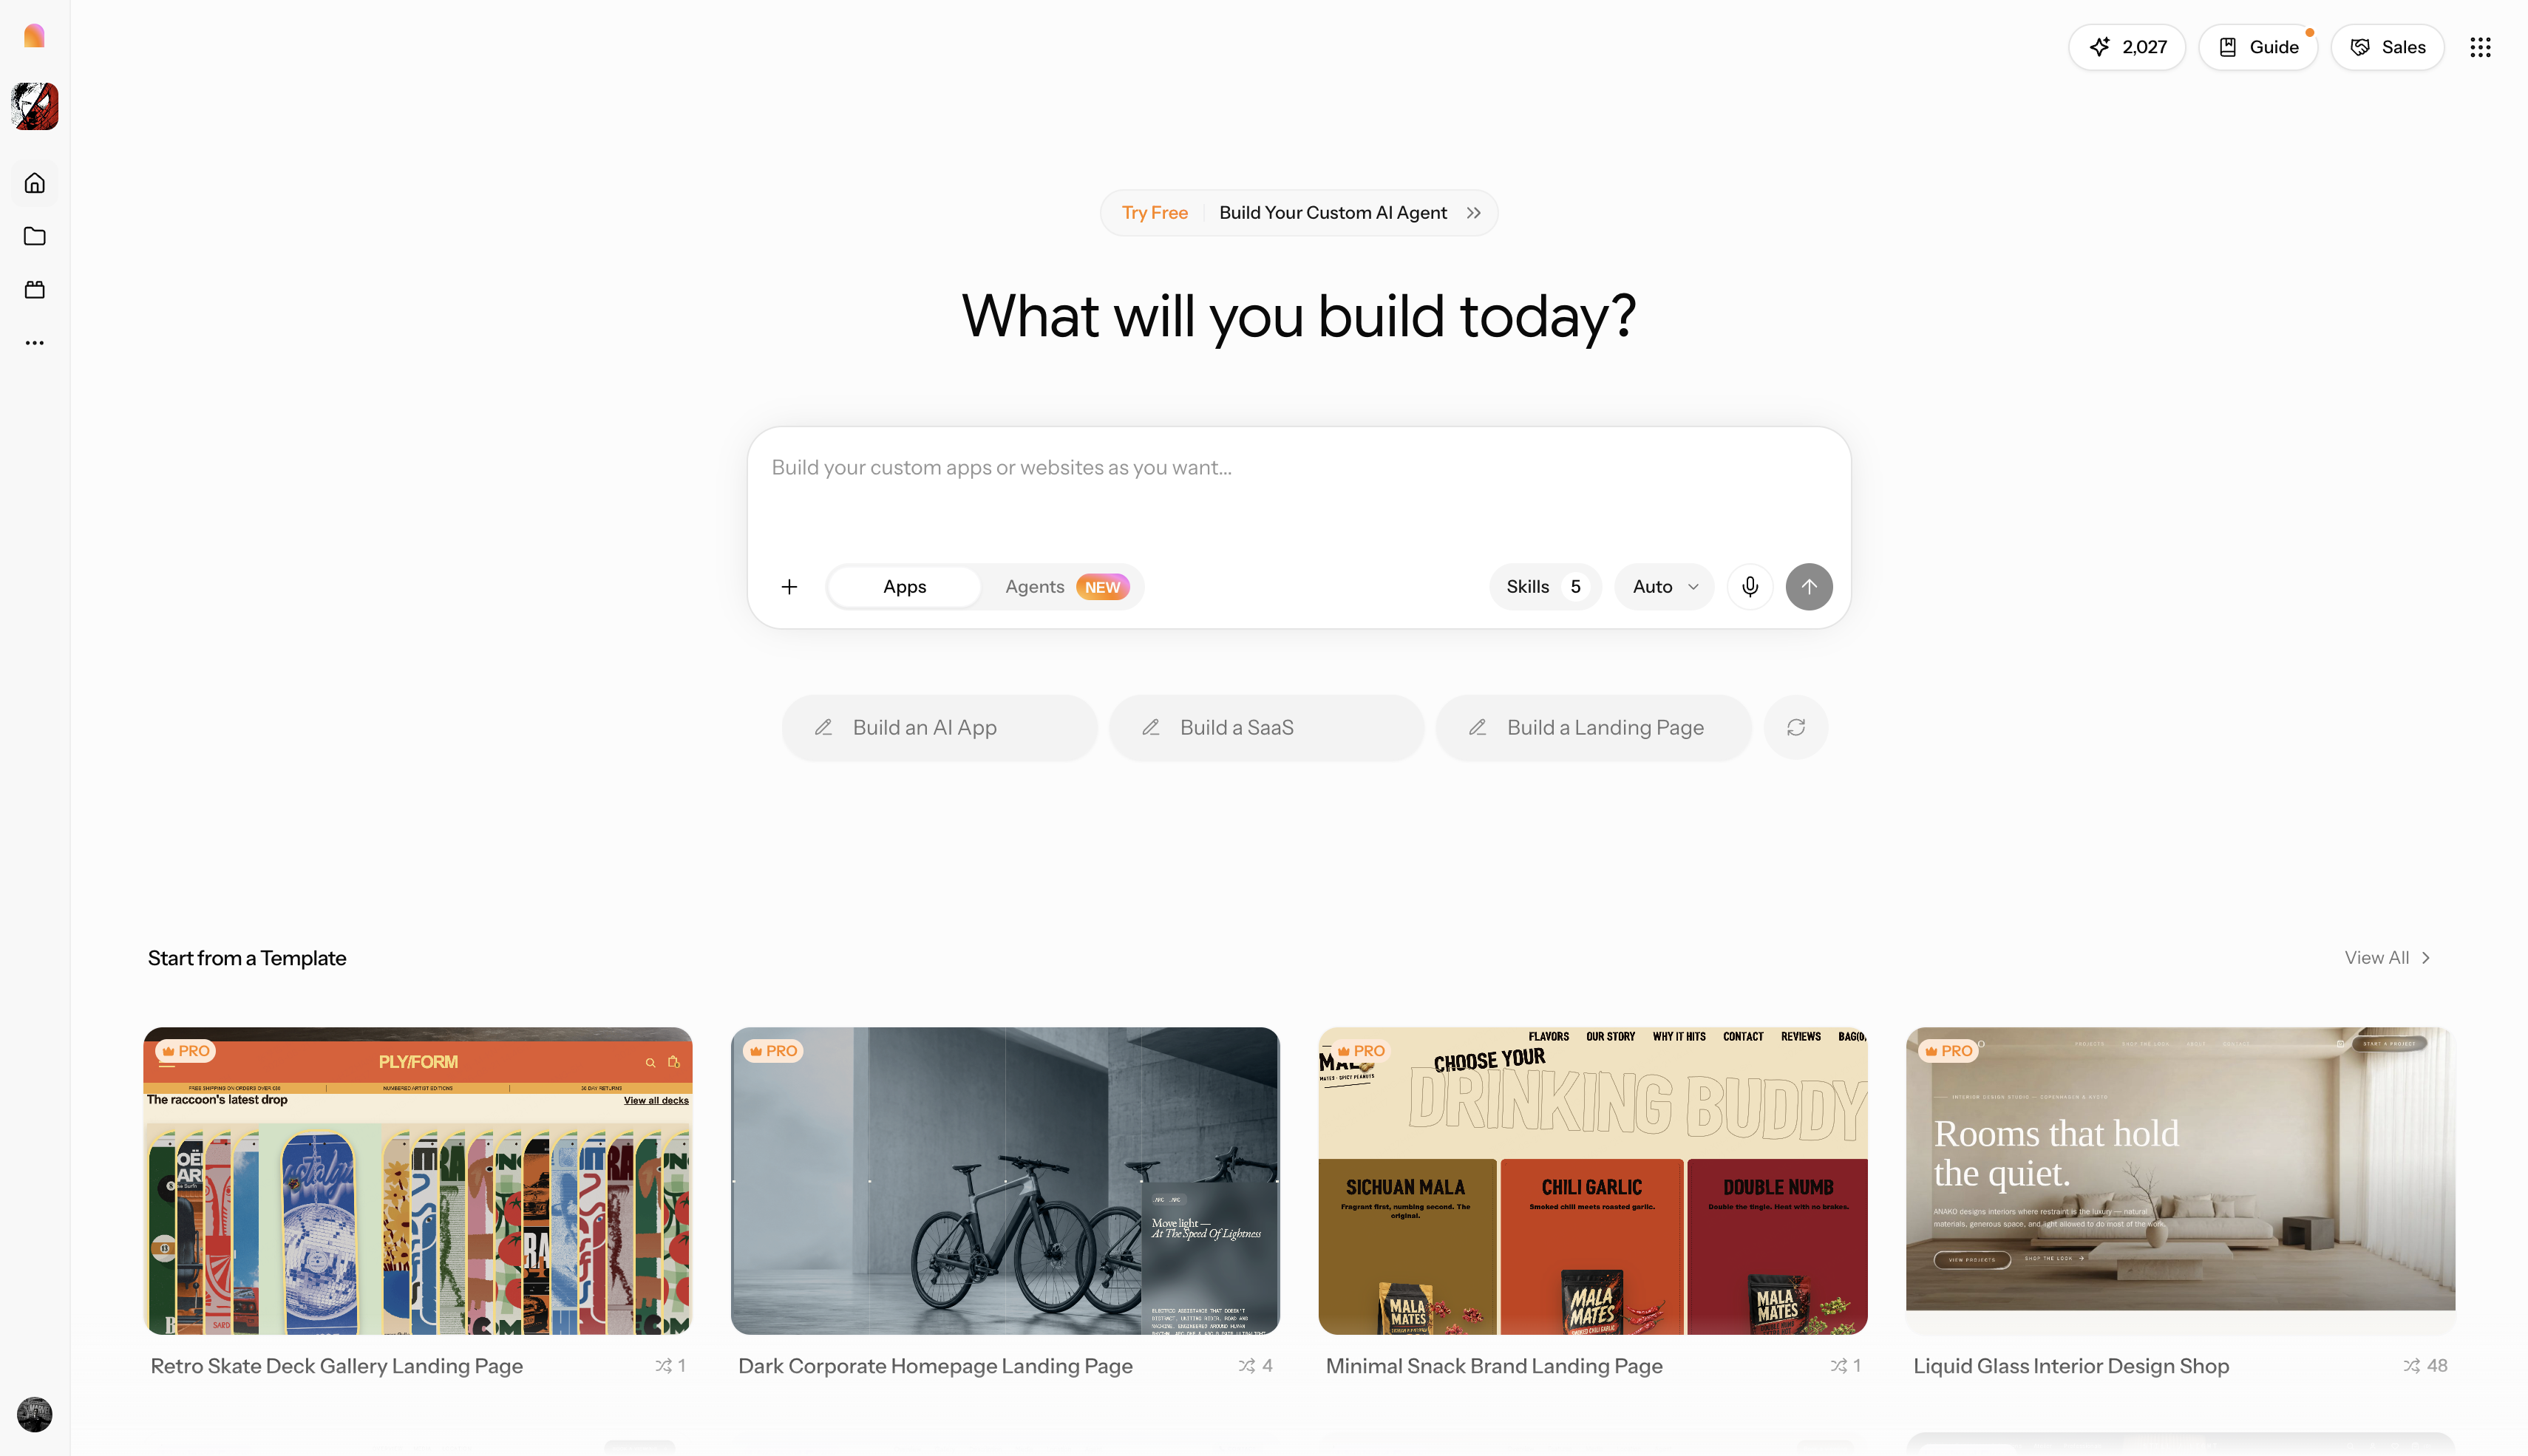
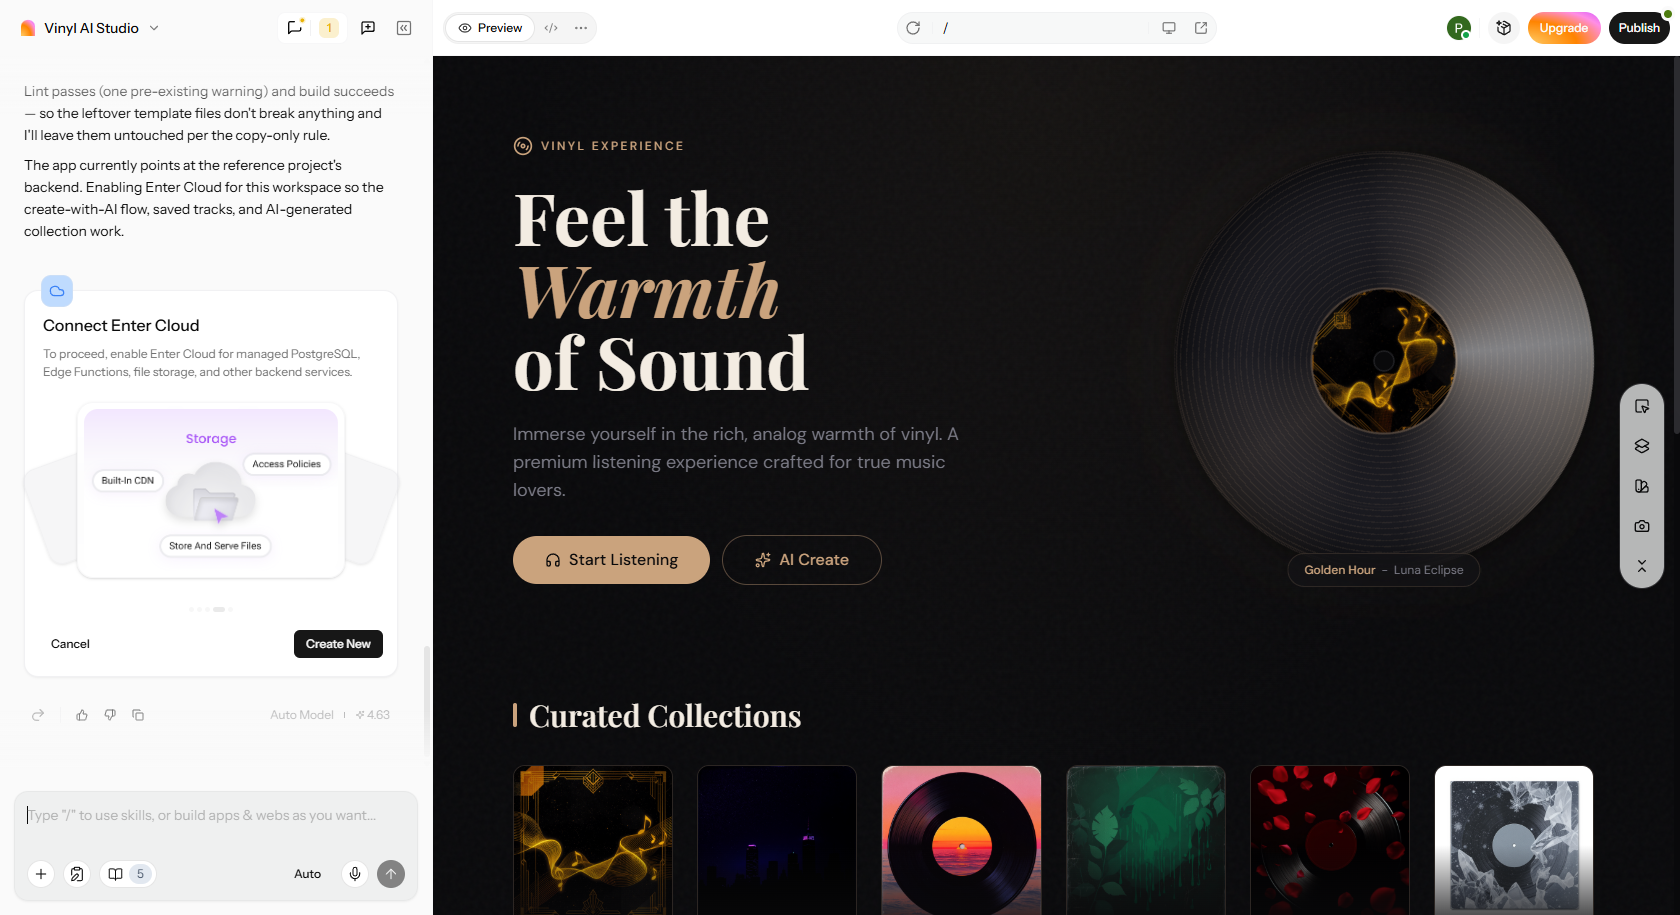
Möchten Sie über das Schreiben einzelner Funktionen hinausgehen und ganze Anwendungen autonom generieren? Enter Pro überbrückt die massive Lücke zwischen reinen LLM-Chat-Interfaces und kompletter Full-Stack-Projektgenerierung. Sie müssen nicht mehr manuell lokale Umgebungen konfigurieren, Systemabhängigkeiten aktualisieren oder sich mit verworrenen Paketmanagern herumschlagen. Stattdessen nutzt die Plattform einen intuitiven Plan-Modus für Vibe Coding, um hochgradige natürliche Sprachprompts direkt in ausgereifte, produktionsreife Software zu verwandeln.
Hauptfunktionen
- Prompt-basierte Erstellung
Nutzer geben einfach einen natürlichsprachlichen Prompt ein, der das Farbthema der Website, das gewünschte Layout und die gewünschten Funktionsseiten beschreibt. Die integrierte Engine von Enter Pro erstellt sofort die grundlegende Full-Stack-Codebasis, einschließlich Frontend- und Datenbanklogik, und reduziert so den manuellen Einrichtungsaufwand drastisch.
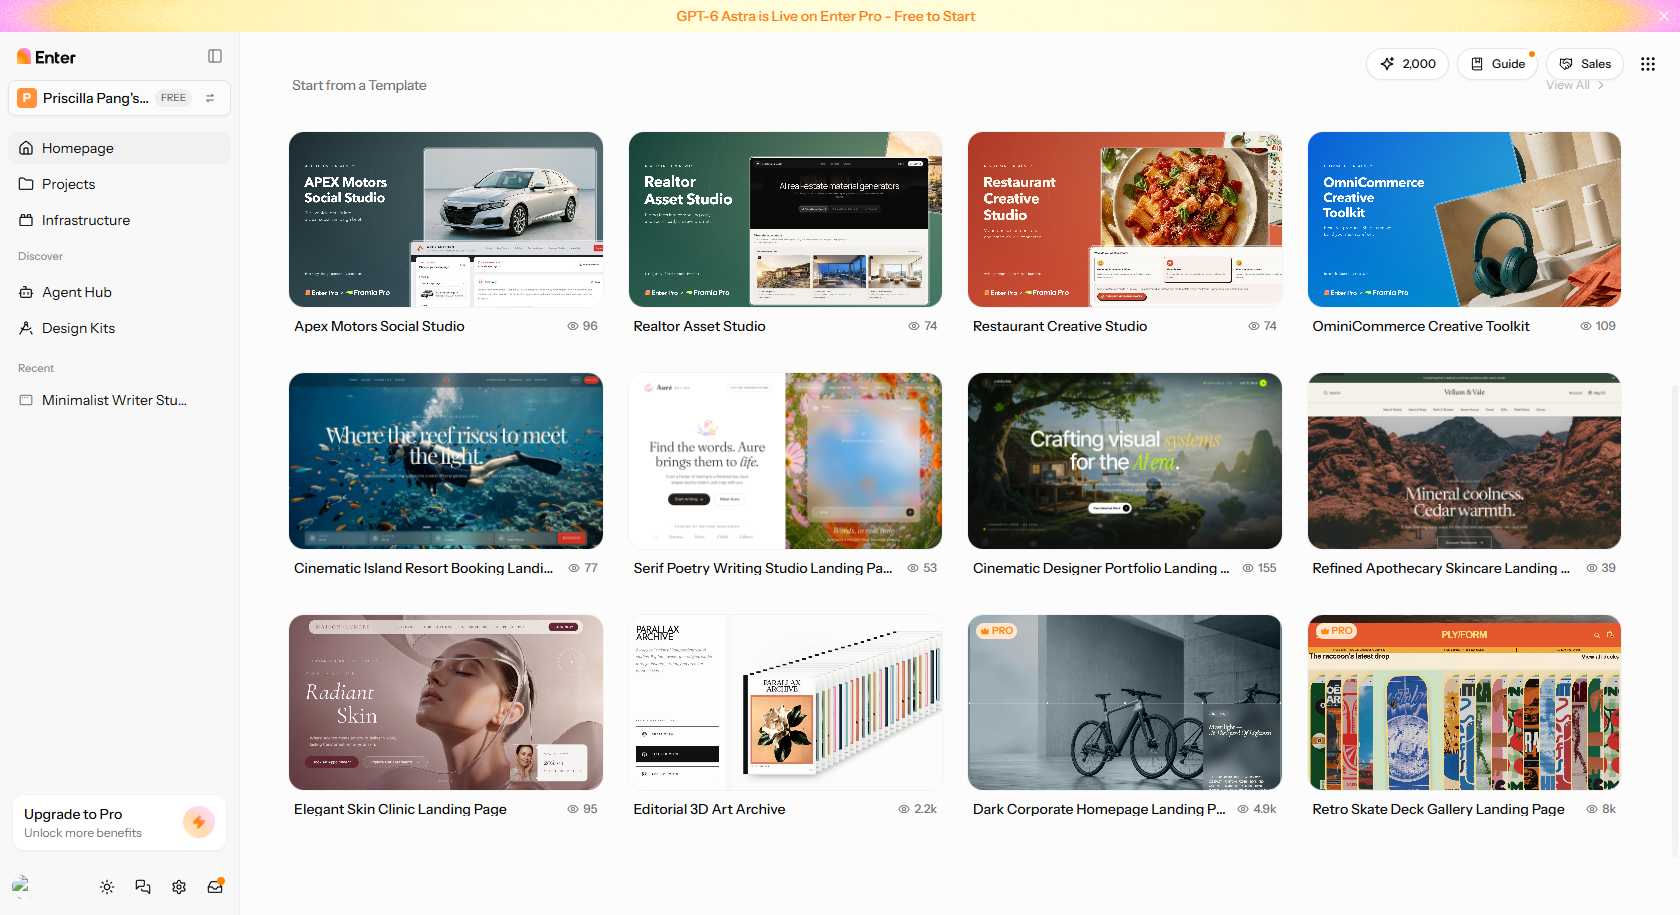
- Fertige Vorlagen
Die Plattform bietet professionell gestaltete, vollständig responsive Website-Vorlagen, die auf extreme Deployment-Geschwindigkeit ausgelegt sind. Enter Pro optimiert diese Layouts speziell, um moderne UX-Standards strikt einzuhalten, und sorgt so für hochwertige Anwendungslieferung ohne manuelle visuelle Anpassungen.
- Einheitliche Modellintegration
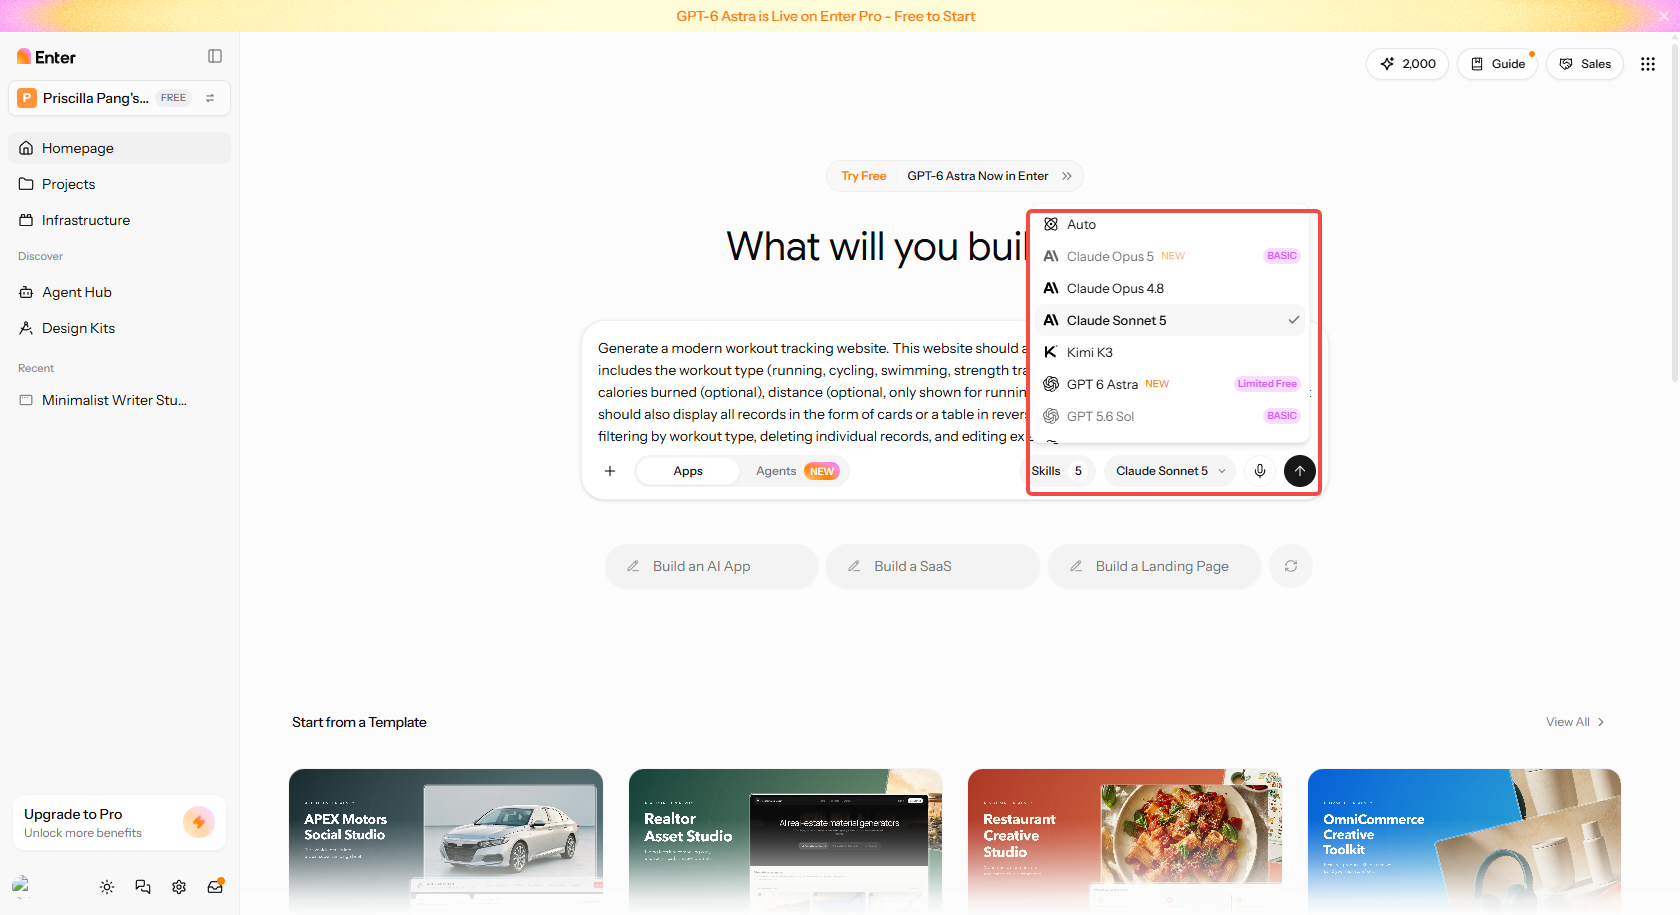
Entwickler können erstklassige Coding-Assistenten und fortgeschrittene Modelle direkt und nativ in ihre laufenden Enter Pro-Builds einbinden – unter einem einzigen Abonnement, darunter Kimi K3, GPT 6 Astra und Claude Sonnet 5. Dieser optimierte Ansatz beseitigt vollständig den administrativen Albtraum, separate API-Schlüssel für verschiedene Frontier-Modelle verwalten und sichern zu müssen.
- 100 % Code-Eigentum
Sie behalten die absolute Kontrolle und alle kommerziellen Rechte am generierten Quellcode nach dem Export von der Enter Pro-Plattform. Das garantiert echte Unabhängigkeit ohne einschränkenden Vendor-Lock-in oder zukünftige Lizenzprobleme.
Schritt-für-Schritt-Anleitung zum App-Bau
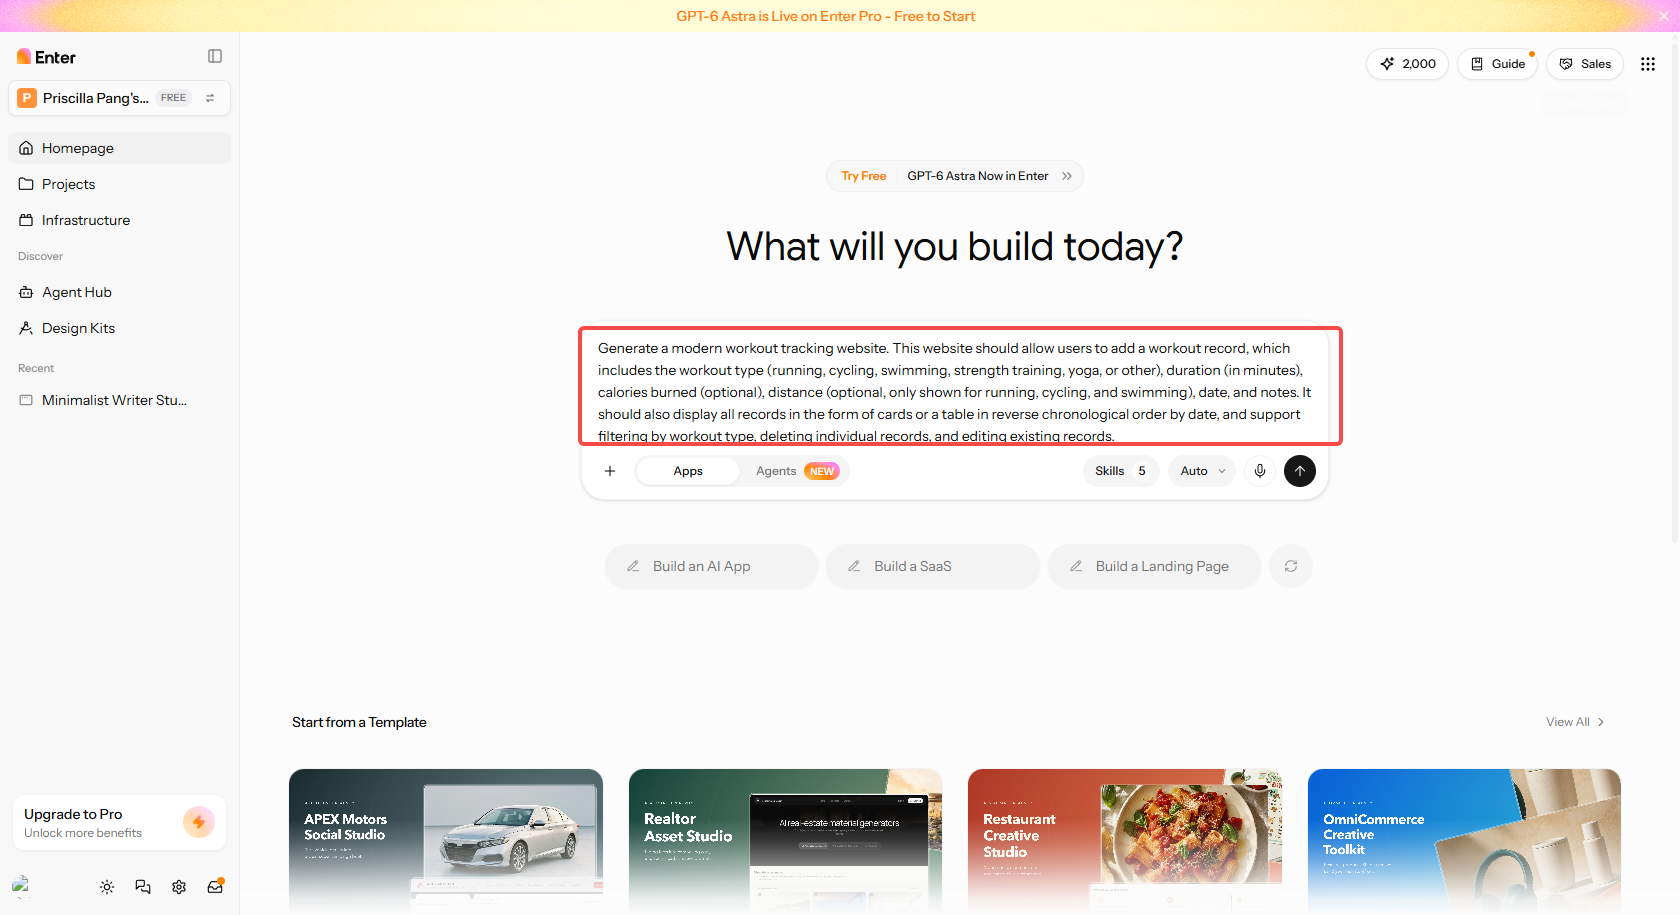
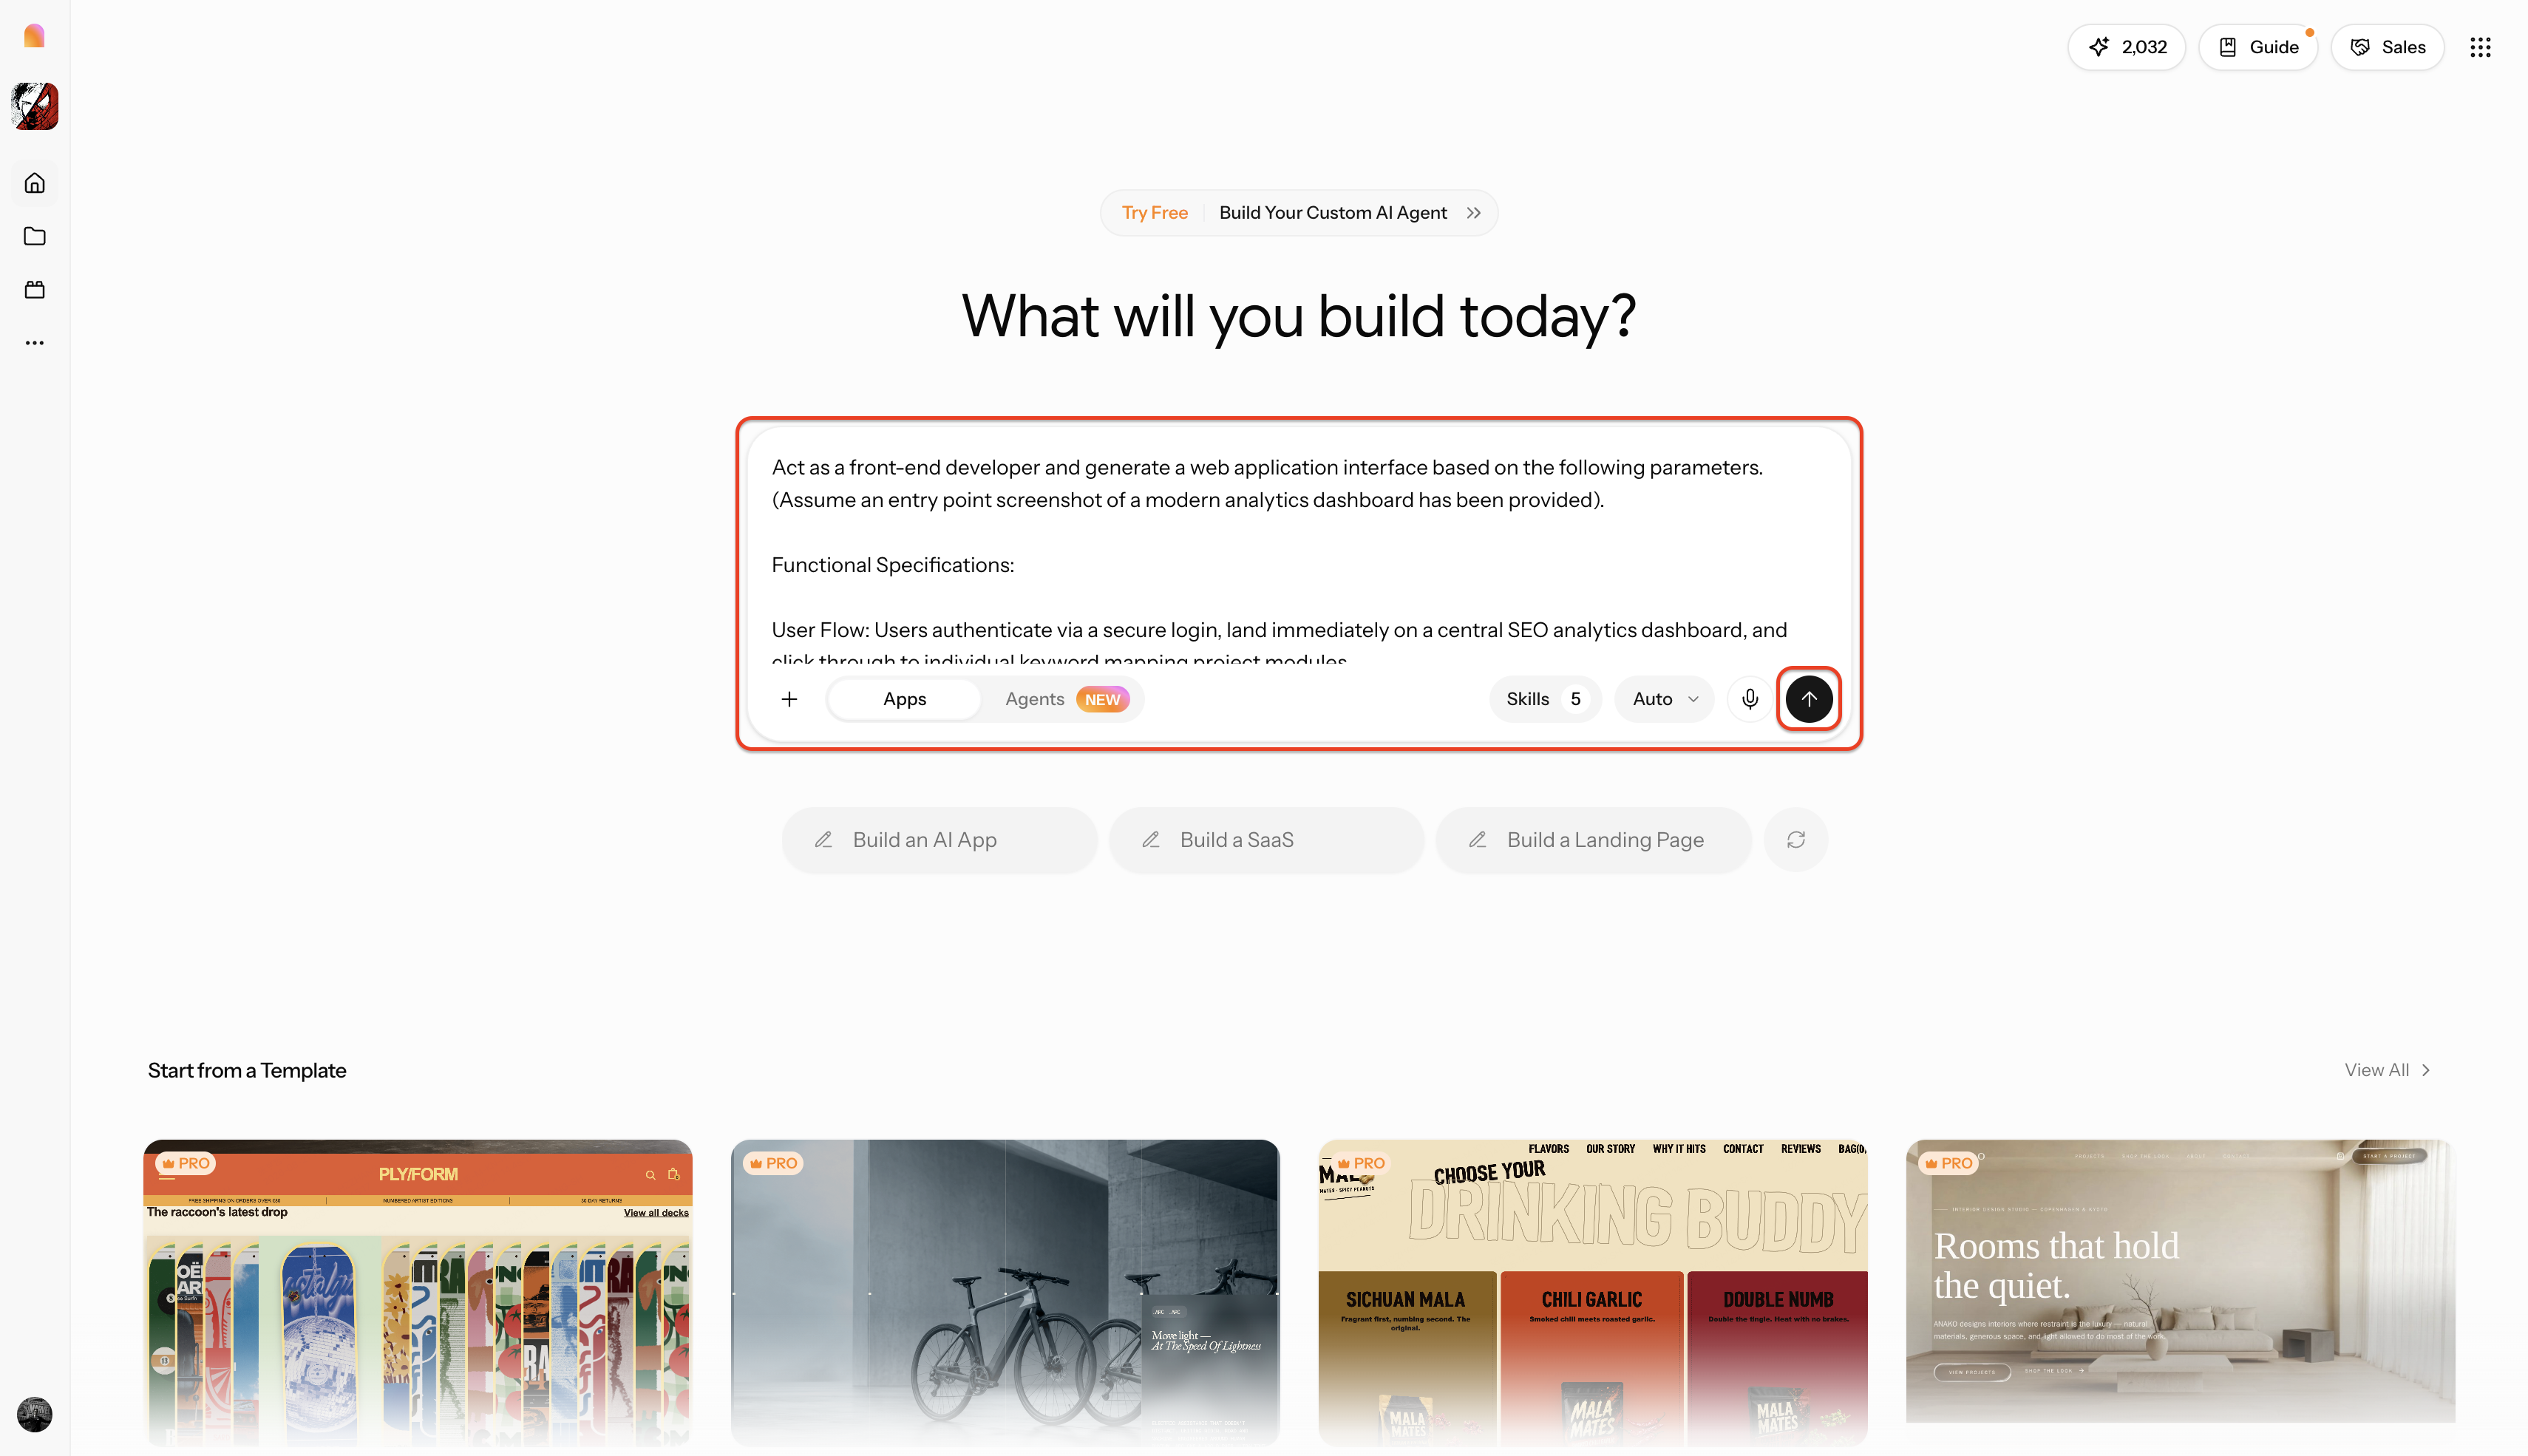
Schritt 1: Enter Pro starten und den Projekt-Prompt eingeben
Beginnen Sie damit, Ihre funktionalen Anforderungen, UI-Styling-Präferenzen und Ziel-Features vollständig in natürlicher Sprache zu definieren. Sie können problemlos einen Screenshot des UI-Einstiegspunkts hochladen, um das strukturelle und ästhetische Verständnis der KI von Anfang an zu lenken.
Schritt 2: Umsetzungsplan prüfen und bauen
Prüfen Sie den von der KI generierten Plan, der den App-Kontext, die Design-Richtung und die notwendigen Dateistrukturen umreißt. Sobald Sie bereit sind, klicken Sie einfach auf „Build Now", um den Full-Stack-Codegenerierungsprozess zu starten.
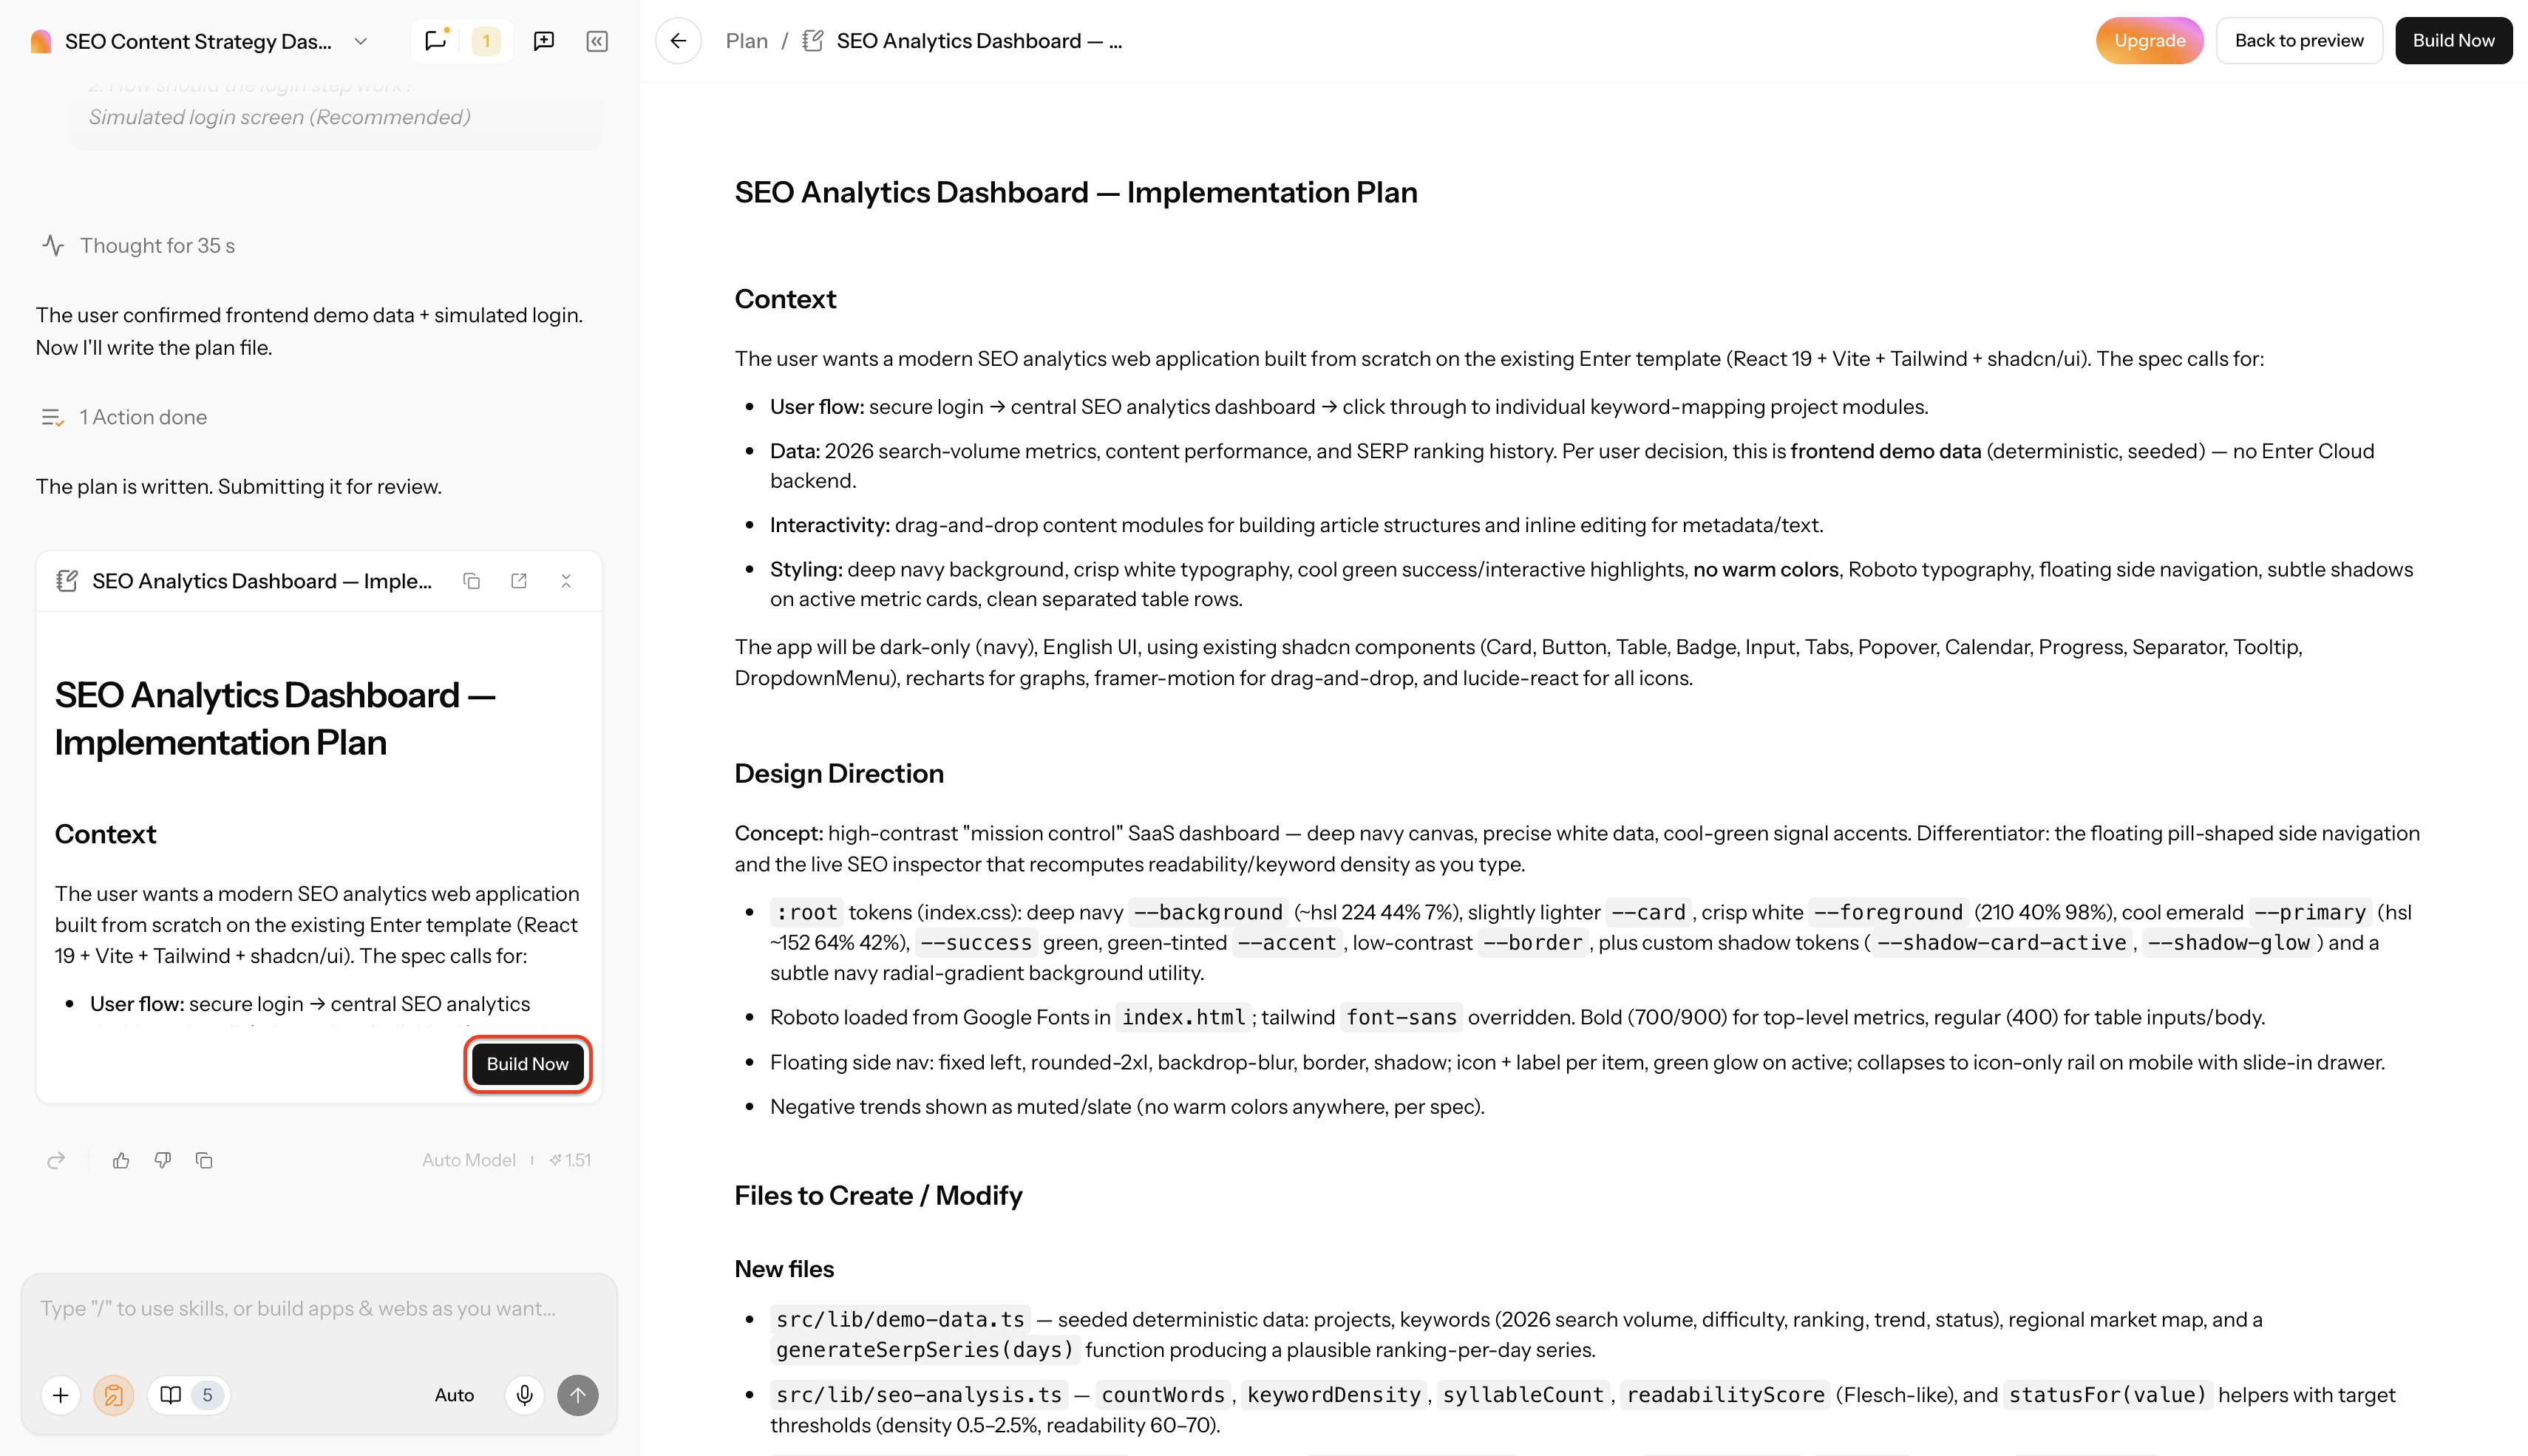
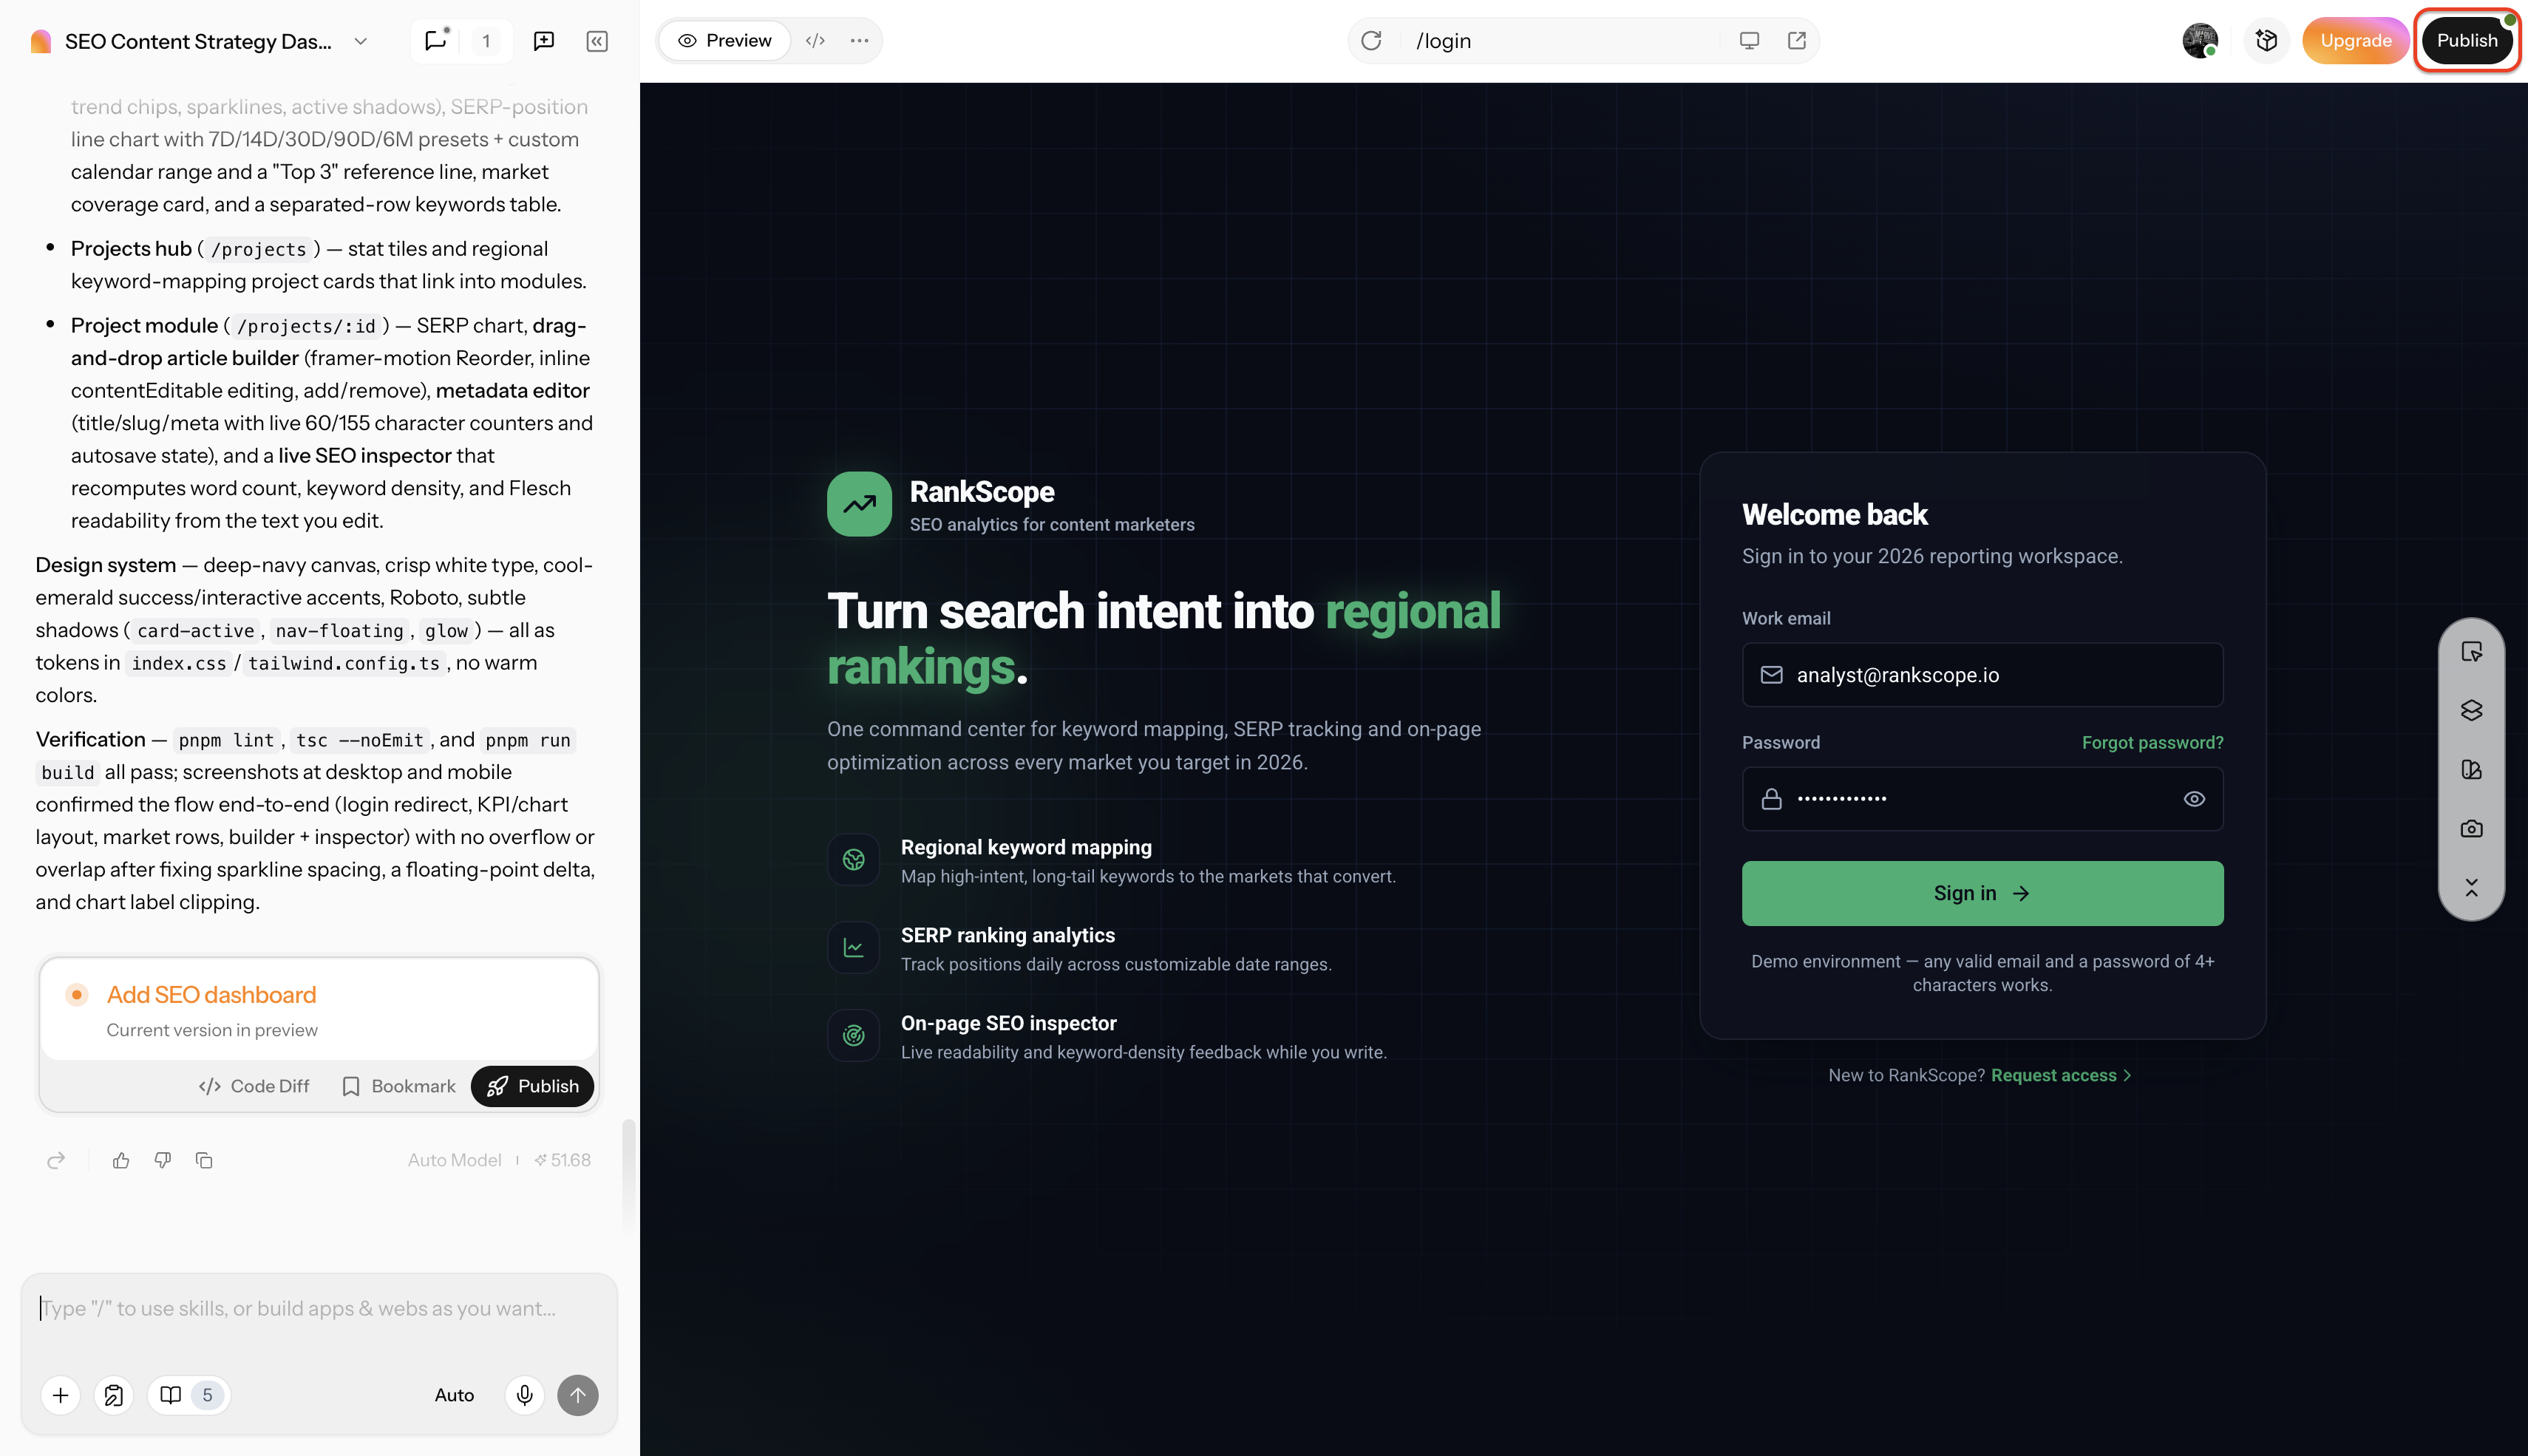
Schritt 3: Bearbeiten, veröffentlichen und exportieren
Verfeinern Sie die generierte Anwendung mit einfachen Prompt-Beschreibungen oder dem Visual Editor. Sobald Sie mit dem Ergebnis zufrieden sind, veröffentlichen Sie die Anwendung mit einem Klick live im Web oder exportieren Sie die strukturierten Quelldateien sicher auf Ihren lokalen Rechner.
Cloud- vs. lokale LLMs vs. autonome KI-Agenten: Performance- und Datenschutz-Trade-offs
Die Auswahl der passendsten Architektur erfordert eine tiefgehende Analyse der grundlegenden Trade-offs in Ihrer aktuellen Engineering-Umgebung.
| Dimension | Frontier-Cloud-LLMs | Selbst gehostete lokale LLMs | Autonomer Agent (Enter Pro) |
|---|---|---|---|
| Datenschutz | Abhängig von Cloud-API-Datenrichtlinie | 100 % privat/abgeschottet | Isolierter Arbeitsbereich/Code-Eigentum |
| Hardware-Overhead | Keine lokale Rechenleistung nötig | Benötigt hohen VRAM/GPU | Keine lokale Rechenleistung nötig |
| Setup-Komplexität | API-Schlüssel & IDE-Plugin-Konfiguration | Lokale Laufzeitumgebung & Quantisierungs-Setup | Prompt-und-Start Visual Workspace |
| Output-Umfang | Snippets, Funktionen & Chat-Ratschläge | Codevervollständigung & lokale Bearbeitungen | Vollständige Full-Stack-Anwendungen |
| Kostenmodell | Pay-per-Token-API-Abonnement | Vorab-Kosten für lokale Hardware | Festes Plattform-Abonnement |
- Datenschutz & geistiges Eigentum: Wenn ich mit strengen, hochgradig proprietären Codebasen arbeite, priorisiere ich konsequent lokale Modelle, um ein Leck vertraulichen IPs vollständig zu verhindern. Unveröffentlichte Unternehmenslogik an Remote-Server zu senden, verstößt oft gegen strenge Compliance-Vorschriften.
- Hardware-Anforderungen: Der Betrieb von Open-Source-Modellen erfordert ernsthafte, dedizierte Hardware. Ein 7-Milliarden-Parameter-Modell erfordert in der Regel mindestens 8 GB VRAM, ein 14-Milliarden-Modell benötigt 16 GB, und riesige 70-Milliarden-Parameter-Modelle brauchen 48 GB+ VRAM – häufig ist dafür ein teures Dual-GPU-Desktop-Setup oder ein spezieller lokaler Server nötig.
- Latenz vs. Fähigkeit: Cloud-Computing-Netze bieten immense, unübertroffene Power für tiefes Reasoning und massives Multi-File-Refactoring. Wechselt man jedoch zu selbst gehosteten lokalen Modellen, erlebt man einen strikten Null-Latenz-Netzwerkvorteil, der sie bei sofortigen Inline-Textvervollständigungen weit überlegen und deutlich flüssiger wirken lässt.
Community-Urteil: Entwicklerbewertungen und Vibe-Coding-Trends
- Vibe Coding bezeichnet einen modernen Entwicklungsworkflow, bei dem Entwickler die übergeordnete Systemarchitektur und Anwendungslogik mit natürlichsprachlichen Prompts steuern, während die KI autonom die Boilerplate-Syntax generiert. Statt Routinen manuell zu tippen, agiert der Engineer als architektonischer Regisseur, der die Projektabsicht leitet und die generierten Ergebnisse überprüft.
Konsens der Reddit-Community:
- Fasst man die Erkenntnisse aus Entwicklerdiskussionen auf r/vibecoding zusammen, setzen Engineers häufig einen gestuften Multi-Modell-Ansatz ein. Sie verlassen sich selten auf ein einziges Tool für den gesamten Full-Stack-Build.
- Entwickler starten typischerweise mit schnellen, breit angelegten Modellen für High-Level-Scaffolding und Frontend-Konzepte. Anschließend wechseln sie sofort zu Claude Opus 5 für tiefe Logikausführung, komplexes Multi-File-Refactoring und gezieltes Debugging.
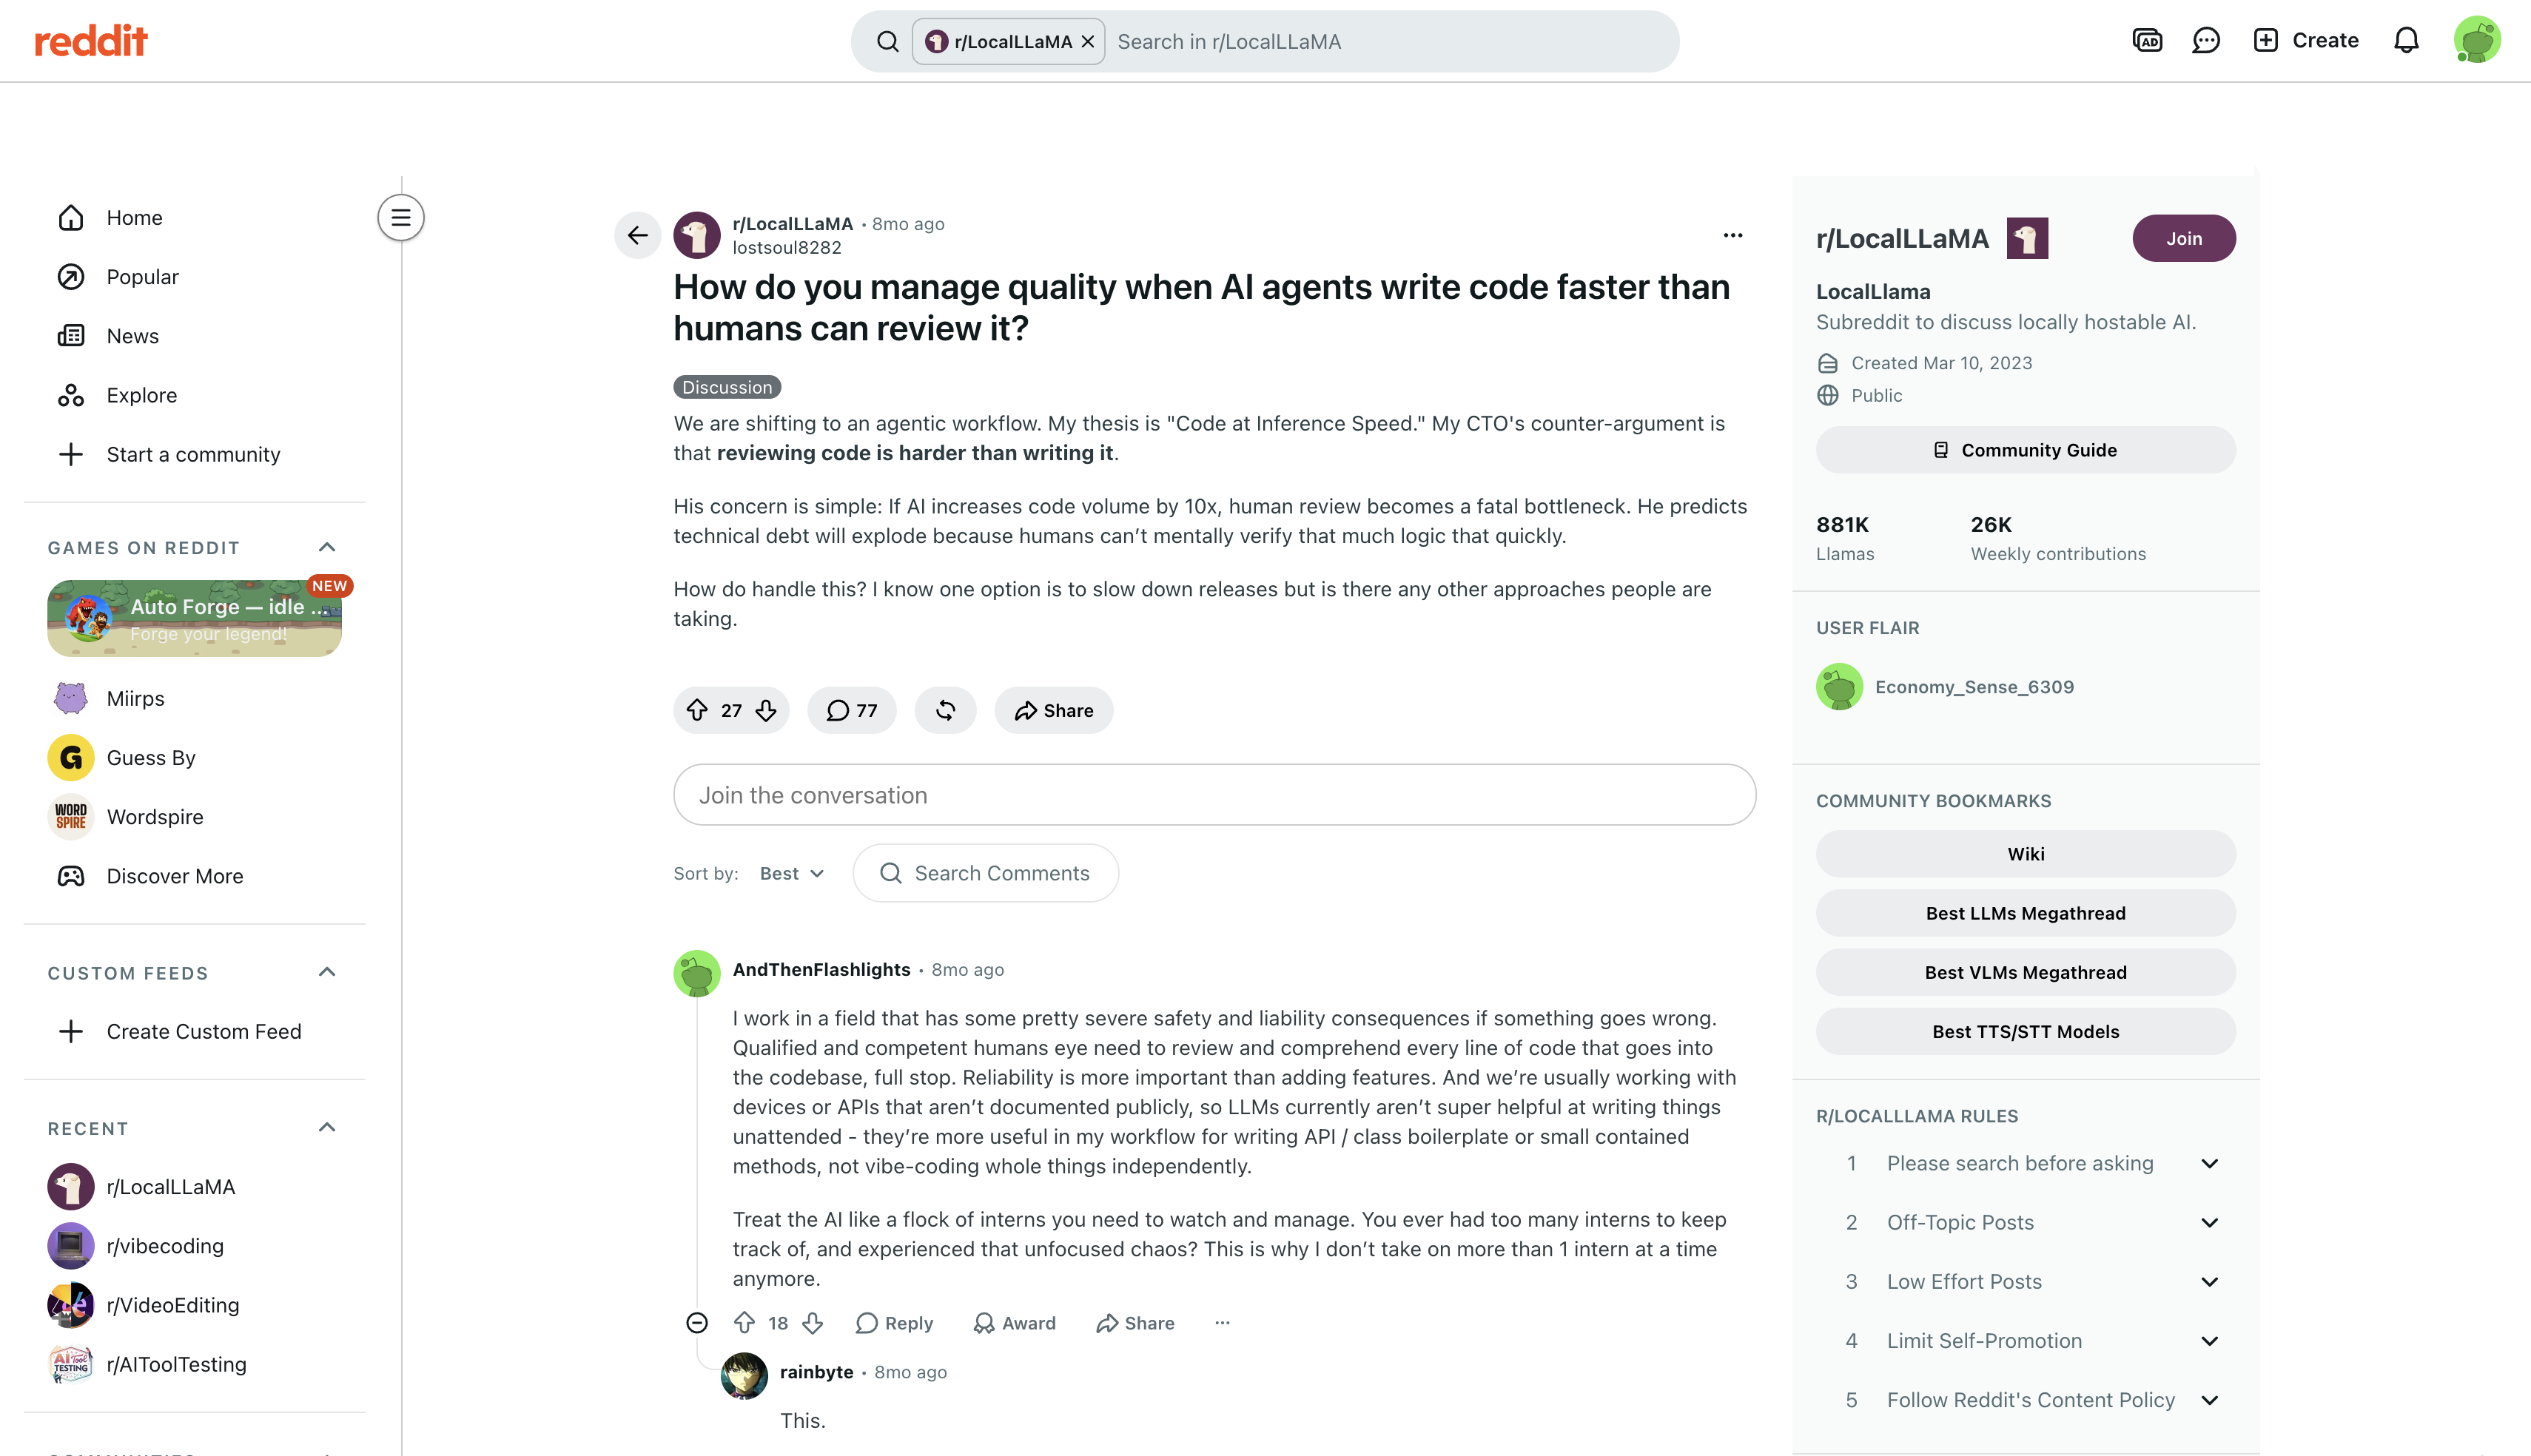
- Diskussionen in Engineering-Foren wie r/LocalLLaMA betonen, dass menschliche Aufsicht weiterhin streng notwendig bleibt. Während autonome Generierung die anfängliche Build-Geschwindigkeit erhöht, müssen Entwickler komplexe State-Abhängigkeiten aktiv verwalten, um Logik-Drift zu verhindern.
Modellvorlieben der Community:
- Zero-Setup-Workflows: Engineers bevorzugen stark cloudbasierte Setups, die direkt in moderne, KI-native Code-Editoren integriert sind, für schnelle Entwicklung. Claude Opus 5 wird häufig als der De-facto-Standard genannt, dank seiner Balance aus Zero-Shot-Genauigkeit, Kontext-Retention und sehr verlässlichem Output.
- Setups für Lokal-Enthusiasten: Viele Entwickler entscheiden sich für lokale Deployments, um wiederkehrende API-Token-Kosten zu vermeiden und private Codebasen zu schützen. Open-Source-Modelle wie Qwen3-Coder-Next und DeepSeek V4-Pro werden häufig für das Selbst-Hosten über Laufzeitumgebungen wie Ollama empfohlen und bieten starke Codegenerierung ohne jede Daten-Telemetrie.
Fazit
Letztlich gibt es 2026 kein einziges bestes LLM für Coding, das perfekt zu jedem Engineering-Anwendungsfall passt. Frontier-Cloud-Modelle liefern die rohe Schlussfolgerungskraft, die für komplexes System-Refactoring und Strukturdesign nötig ist. Für Enterprise-Sicherheit garantiert das beste lokale LLM für Coding null Datenlecks in hochsensiblen Umgebungen. Gleichzeitig vereinfacht die Einführung autonomer Entwicklungs-Agenten die komplette Anwendungslieferung vom ersten Konzept bis zum Produktions-Deployment. Bewerten Sie Budget, Hardware-Fähigkeiten und Datensicherheitsrichtlinien Ihres Teams, bevor Sie sich auf ein einzelnes Ökosystem festlegen. Starten Sie eine IDE und konfigurieren Sie ein paar API-Schlüssel oder lokale Laufzeitumgebungen. Benchmarken Sie diese Modelle gegen Ihre eigene Codebasis, um herauszufinden, welches Toolset Ihren Engineering-Workflow wirklich voranbringt.
FAQs zum besten LLM für Coding
Welches LLM ist 2026 am besten für Coding geeignet?
Claude Opus 5 ist derzeit das beste Coding-LLM für komplexe Software-Entwicklung, Multi-File-Refactoring und autonome Agent-Loops. Für Entwickler, die deterministische Ausführung und breite IDE-Integration suchen, dient GPT-5.6 Sol als Top-Cloud-Alternative. Teams, die strikten Datenschutz priorisieren, können Open-Weight-Kraftpakete wie GLM-5.2 oder DeepSeek V4-Pro lokal einsetzen, ohne Cloud-Abhängigkeiten.
Was ist das beste lokale LLM für Coding auf Consumer-Laptops?
Qwen3-Coder-Next und GLM-5.2 sind stark auf lokale Umgebungen optimiert. Qwen3-Coder-Next bietet starke Effizienz pro Parameter auf bescheidener Hardware, während GLM-5.2 der beste Open-Weight-Coder mit einem 1-Mio.-Token-Kontext ist.
Wie viel RAM und VRAM braucht man, um lokale LLM-Modelle zu betreiben?
Um ein Standard-7-Milliarden-Parameter-Coding-Modell komfortabel zu betreiben, benötigen Sie mindestens 8 GB GPU-VRAM oder Apple Unified Memory. Größere 14-Milliarden-Modelle brauchen rund 16 GB, während riesige 70-Milliarden-Enterprise-Modelle zwischen 48 GB und 64 GB VRAM benötigen, um reibungslos zu laufen.
Sind Cloud-Coding-Modelle für proprietären Unternehmenscode sicher?
Das hängt vollständig und ausschließlich von der spezifischen Aufbewahrungsrichtlinie des jeweiligen Anbieters ab. Während hochwertige Enterprise-API-Vereinbarungen in der Regel versprechen, nicht mit Nutzerdaten zu trainieren, verlangen strenge Unternehmens-Compliance und staatliche Vorschriften oft vollständig abgeschottete lokale Modelle, um absolute Sicherheit zu garantieren.
Was ist „Vibe Coding" und welches Modell eignet sich dafür am besten?
Das bezeichnet einen modernen Entwicklungsworkflow, bei dem ein Engineer die Anwendungslogik mit breiten, übergeordneten natürlichsprachlichen Prompts steuert, während die KI autonom die gesamte Boilerplate-Generierung und Syntax-Erstellung übernimmt. Frontier-Modelle wie Claude Opus 5 und GPT-5.6 Sol glänzen bei dieser Methodik für agentisches Coding und große Refactorings besonders stark.
Wie schneiden Open-Source-Coding-Modelle im Vergleich zu Claude Fable 5 ab?
Open-Weight-Modelle wie GLM-5.2 und DeepSeek V4-Pro schließen die Lücke rasant und überholen frühere Baselines wie GPT-5.5 bei SWE-bench Pro und algorithmischen Herausforderungen. Frontier-Engines wie GPT-5.6 Sol und Claude Fable 5 behalten jedoch weiterhin einen klaren Vorteil bei massiven Refactorings und komplexen Agent-Loops.
Können Coding-LLMs menschliche Software-Entwickler ersetzen?
Nein. Diese Modelle fungieren derzeit als hochentwickelte Compiler und leistungsstarke Workflow-Beschleuniger. Sie benötigen weiterhin absolut erfahrene menschliche Engineers, um die Systemarchitektur sorgfältig zu gestalten, komplexe Sicherheitsprotokolle zu verwalten und die funktionale Logik vor dem Produktions-Deployment rigoros zu überprüfen.
Was ist das beste kostenlose Open-Source-LLM für Python-Entwicklung?
GLM-5.2 und Qwen3-Coder-Next verfügen beide über umfangreiche, hoch spezialisierte Fähigkeiten. GLM-5.2 bietet bis zu 1 Mio. Token Kontext für große Codebasen, während Qwen3-Coder-Next exzellente Effizienz für kleinere lokale Deployments liefert – was beide zu hervorragenden kostenlosen Optionen für Standard-Webentwicklungs-Workflows macht.





