
GLM-5 im Test: Versionen, Benchmarks, Preise und Zugang
GLM-5-Versionen, Benchmarks, Preise, Architektur, lokales Hosting und API-Zugang im Vergleich – inklusive Enter Pro Integration.
GLM-5 ist längst kein einzelnes Modell mehr, das man anhand eines einzigen Benchmarks bewerten kann. Es ist eine ganze Modellfamilie: Manche Varianten verarbeiten nur Text, andere akzeptieren auch Bilder, neuere Versionen haben ein Kontextfenster von 1 Million Tokens, und die günstigste Option kostet nur einen Bruchteil des Flaggschiffs.
Für dieses Review habe ich die Release Notes, Modellkarten, API-Dokumentation, das Repository und aktuelle Produkt-Screenshots von Z.ai durchgesehen. Das ist wichtig zu wissen, denn einige der Aussagen sind durchaus verlockend – etwa ein interner Coding-Gewinn von 50 % oder 2,9-fach geringerer Rechenaufwand bei langem Kontext – stammen aber von Z.ai selbst und nicht aus einem unabhängigen Audit. Ich bezeichne solche Aussagen entsprechend als Behauptungen und nicht als eigene Testergebnisse.
Bei der Wahl des passenden GLM-5-Modells stellen sich vier Fragen: Welche Eingaben hast du? Wie komplex ist die Aufgabe? Wo soll die Inferenz laufen? Und wie teuer wird ein erfolgreiches Ergebnis, wenn Wiederholungen nötig sind? Meine Kurzantwort: GLM-5.3 für komplexeren Text/Code, GLM-5.3-Flash für Multimodalität oder Kosteneffizienz, und GLM-5.2, wenn du bereits eine validierte Integration hast.
Was ist GLM-5?
GLM-5 ist die Familie offener Gewichtsmodelle (open-weight), die Z.ai für Software-Engineering, Tool-Nutzung und langfristig agierende Agenten entwickelt hat. Das ursprüngliche Release (Februar 2026) ist ein reines Text-zu-Text-Modell nach dem Mixture-of-Experts-Prinzip (MoE) mit 744 Milliarden Gesamtparametern, rund 40 Milliarden aktiven Parametern pro Token und einem Kontextfenster von 200.000 Tokens. Diese Angaben stammen aus dem technischen Bericht zu GLM-5 und dem offiziellen GitHub-Repository.
Ein MoE-Modell aktiviert nicht das gesamte Netzwerk für jedes Token. Ein Router leitet jedes Token an eine kleine Gruppe von "Experten" weiter, wodurch die aktive Rechenlast sinkt, während der Checkpoint insgesamt sehr groß bleibt. Das macht GLM-5 aber nicht zu einem Laptop-Modell: Die vollständigen Gewichte brauchen weiterhin Speicherplatz, Routing und Server-Hardware.
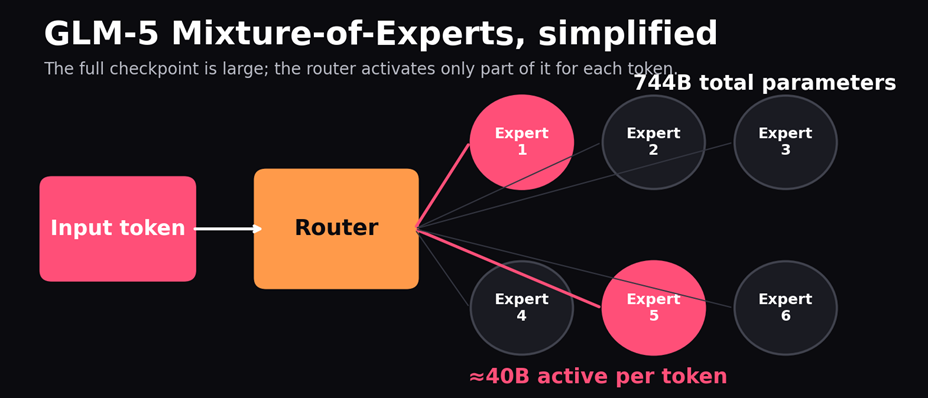
Abbildung 1: GLM-5 aktiviert pro Token rund 40 der 744 Milliarden Parameter; der vollständige Checkpoint bleibt ein Server-Deployment.
Der korrekte Begriff lautet "offene Gewichte" (open weights). Code, Modellgewichte, gehosteter Dienst und Trainingsdaten unterliegen jeweils unterschiedlichen Lizenzbedingungen. Prüfe vor jeder kommerziellen Nutzung die Lizenz der jeweiligen Modellkarte, da nicht alle GLM-Versionen dieselben Rechte einräumen.
Die GLM-5-Versionsfamilie
Der Familienname verschleiert wichtige Unterschiede. Wähle nach Modalität, Kontextlänge, Validierungshistorie und Deployment-Weg – und behandle nicht jede 5.x-Version als beliebig austauschbar.
| Version | Eingabe/Kontext | Bester Einsatzgrund | Wichtiger Hinweis |
|---|---|---|---|
| GLM-5 | Text / 200K | Ursprüngliche Forschung oder bestehende Legacy-Integration | Erstes Release der Familie; nicht meine Standardwahl für neue Projekte |
| GLM-5-Turbo | Text / 200K | Gehostete, tool-intensive Agentenaufgaben | Ein Provider-Zugang, kein kleiner herunterladbarer Checkpoint |
| GLM-5V-Turbo | Text, Bilder, Video, Dateien / 200K | Visuelles Coding und GUI-Aufgaben | Unterstützte Formate am jeweiligen Endpunkt prüfen |
| GLM-5.1 | Text / 200K | Länger laufende Engineering-Aufgaben | Für die meisten neuen Evaluierungen überholt |
| GLM-5.2 | Text / 1M | Langer Kontext und bewährte Integrationen | Migration auf 5.3 verändert das Reasoning-Verhalten |
| GLM-5.3 | Text / 1M | Anspruchsvolles Coding und lang laufende Agenten | Reasoning ist immer aktiv; Ausgaben können lang werden |
| GLM-5.3-Flash | Multimodal / 1M | Screenshots, hohes Volumen, niedrige Kosten | Eigenständige 320B/18B-Architektur, nicht "5.3 mit wenig Aufwand" |
Quellen: Release Notes von Z.ai, Leitfäden zu GLM-5-Turbo, GLM-5V-Turbo und GLM-5.1. Ein Host kann ein kleineres Kontextfenster anbieten, als das Modell eigentlich unterstützt.
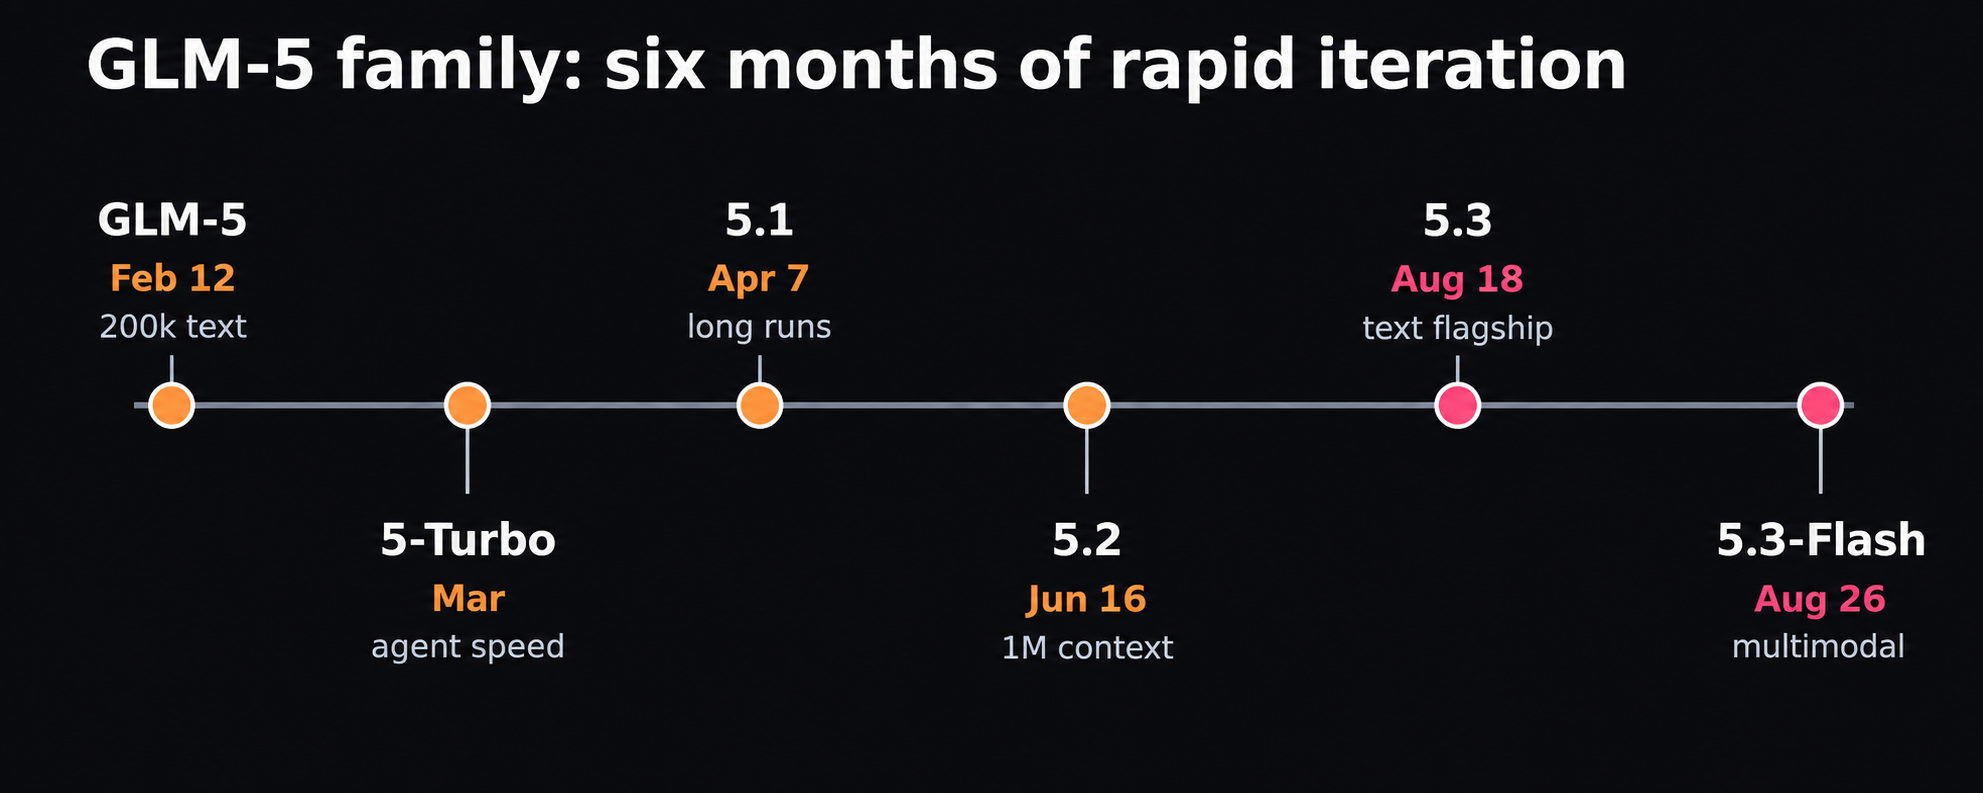
Abbildung 2: Sechs Monate an Releases haben Kontextlänge, Modalität, Reasoning-Verhalten und Preis verändert.
Von GLM-5 zu GLM-5.2
Die agentenbasierte Architektur wurde mit dem Basismodell GLM-5 etabliert. GLM-5.1 setzte den Fokus auf länger laufende Prozesse; Z.ai behauptet, es könne bis zu 8 Stunden durchgehend arbeiten – das sollte man jedoch mit Vorsicht betrachten, da dein eigenes Repository ganz anders aussehen kann. Mit GLM-5.2 kamen dann ein Kontextfenster von einer Million Tokens, flexible Effort-Einstellungen und IndexShare für effizientere Aufmerksamkeit bei langem Kontext hinzu.
GLM-5.3 und GLM-5.3-Flash
Das Flaggschiff von GLM ist reines Text-Modell: GLM-5.3. Laut Dokumentation erlaubt es bis zu 1 Million Tokens Input, bis zu 128K Tokens Output sowie niedrigen, hohen oder maximalen Reasoning-Aufwand. Thinking lässt sich nicht deaktivieren; eine 5.2-Anfrage, die es explizit abschaltet, kann bei der Migration fehlschlagen.
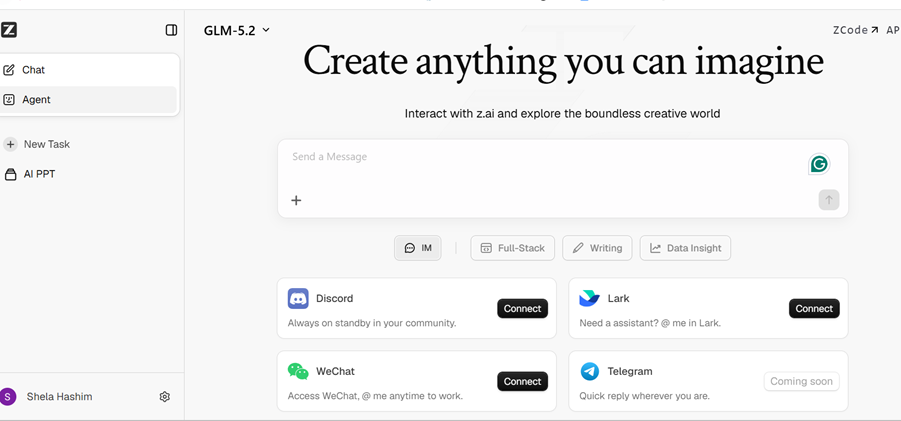
Abbildung 3: Die Live-Oberfläche von GLM-5.3 bestätigt einen eigenständigen Flaggschiff-Zugang; Verfügbarkeit und Bezeichnungen können sich ändern.
GLM-5.3-Flash ist ein weiteres Modell mit 320B Gesamtparametern/18B aktiven Parametern, das native multimodale Eingabe sowie hybride Sparse/Linear-Attention bietet. Meine erste Empfehlung ist simpel: Wenn Tiefe zählt, nutze 5.3; geht es um Screenshots oder hohes Volumen, teste zuerst Flash.
Spiele gespeicherte Anfragen erneut durch, statt bei einer bestehenden Integration einfach nur den Modellnamen auszutauschen. Teste strukturierte Ausgaben, Tool-Call-Argumente, maximale Antwortlänge und den Umgang mit Timeouts. Eine Antwort mag im Chat optisch ansprechender wirken, kann aber den Parser zum Absturz bringen oder das Latenzlimit deiner Anwendung überschreiten. Halte den alten Zugang so lange aufrecht, bis die neue Version dieselben Produktions-Checks durchlaufen hat.
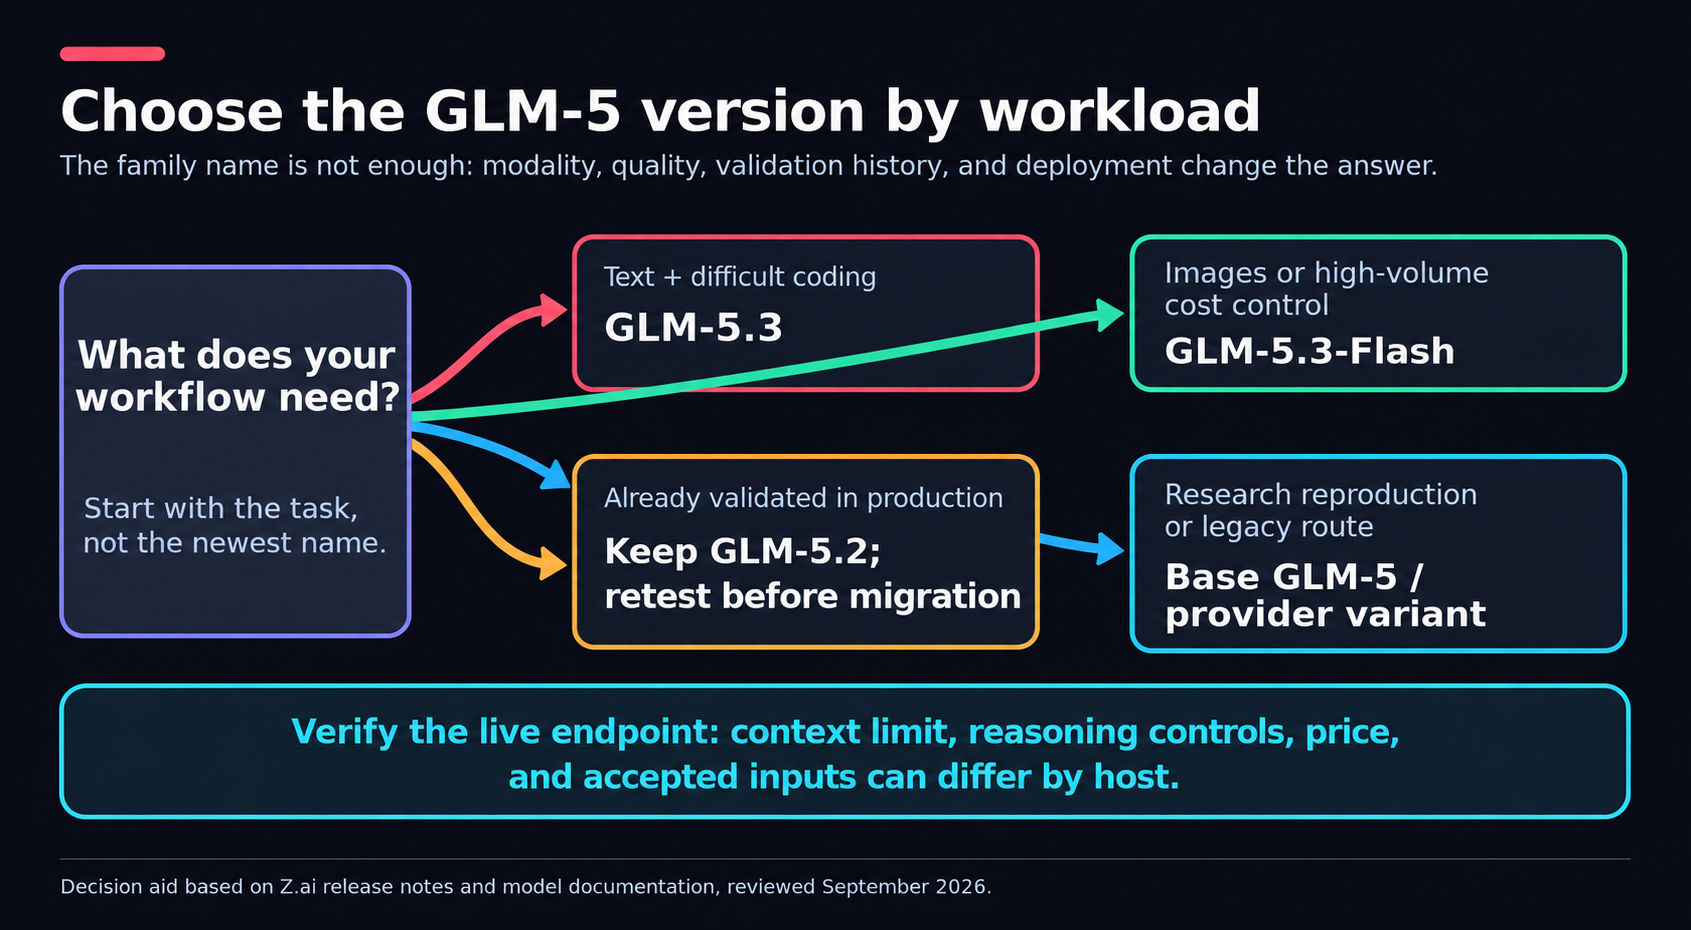
Abbildung 4: Wähle nach Workload und Endpunkt-Verhalten – nicht allein nach dem neuesten Modellnamen.
Wie schneidet GLM-5 im Vergleich zu Claude, GPT und Gemini ab?
GLM-5.3 gehört auf jede Shortlist für Coding-Agenten, aber eine einzelne Tabelle kann keinen Gesamtsieger krönen. Terminal-Bench-Werte hängen vom Harness, den Tool-Berechtigungen, dem Zeitbudget und der Effort-Stufe ab. Z.ai berichtet 88,2 Punkte auf Terminal-Bench 2.1 und 28,3 Punkte auf Terminal-Bench 3.0 für GLM-5.3 bei maximalem Effort; die zugehörige Tabelle reproduziert auch Ergebnisse von Claude Opus 4.8 und GPT-5.6 Sol.
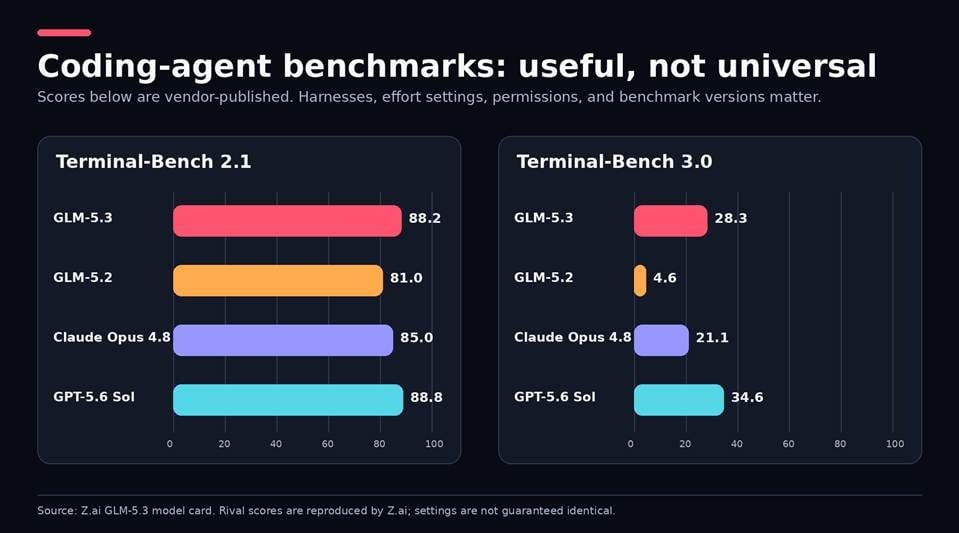
Abbildung 5: Vom Hersteller veröffentlichte Werte sind richtungsweisende Hinweise, kein Ersatz für einen identischen, workload-spezifischen Test.
Im Gegensatz zu anderen Modellen nennt die GLM-5.3-Modellkarte konkret Harness und Effort-Einstellungen. Sie sagt aber nicht, ob konkurrierende Modelle unter identischen Bedingungen getestet wurden. Ebenso schlägt GLM-5.2 laut Bericht Gemini 3.1 Pro bei einer Teilmenge der Terminal-Bench-2.1-Aufgaben – einem kleinen Ausschnitt der hier genannten Coding-Aufgaben. Das bedeutet jedoch nicht, dass GLM Gemini 3.1 Pro bei allen multimodalen, Recherche- oder Schreibaufgaben übertrifft.
Ich würde Modelle immer mit denselben Prompts, Tools, demselben Timeout und denselben Bestehenskriterien vergleichen. Entscheidend ist der Preis pro erfolgreicher Aufgabe, NICHT der Preis pro Token. Ein günstigeres Modell, das dreimal scheitert, kann am Ende teurer sein – und wenn Flash deine Tests im ersten Versuch löst, ist der Vorteil eines Flaggschiffs bedeutungslos.
Die Modellkarte von GLM-5.3 ist insofern recht transparent, als sie Harness-Namen und Effort-Stufen benennt. Ob konkurrierende Modelle unter denselben Bedingungen getestet wurden, bleibt offen. Ebenso besagt der GLM-5.2-Leitfaden nur, dass es Gemini 3.1 Pro bei Terminal-Bench 2.1 – einer Coding-Agent-Aufgabe – übertrifft, nicht notwendigerweise bei multimodalen, Recherche- oder Schreibaufgaben.
Ich würde die Modelle mit denselben Prompts, Tools, Timeout und Bestehenskriterien testen. Entscheidend ist allein der Preis der erfolgreichen Aufgabe, nicht der Preis pro Token. Gelingen Tests bereits im ersten Versuch, kann Flash sogar günstiger sein, wodurch der Vorteil eines Flaggschiff-Modells schrumpft.
Training und Architektur von GLM-5 im Detail
Sparse Attention und IndexShare
Langer Kontext ist teuer, weil Attention normalerweise sehr viele Beziehungen zwischen Tokens berücksichtigt. In GLM-5.2 wurde ein Indexer eingeführt, der in vier verschiedenen Attention-Layern wiederverwendet wird, um die richtigen Stellen zu finden. Z.ai gibt an, bei 1M Tokens 2,9-mal weniger FLOPs pro Token zu benötigen. Das ist eine Effizienzaussage des Entwicklers, keine Aussage zur Endpunkt-Latenz oder zu den tatsächlichen Anfragekosten.
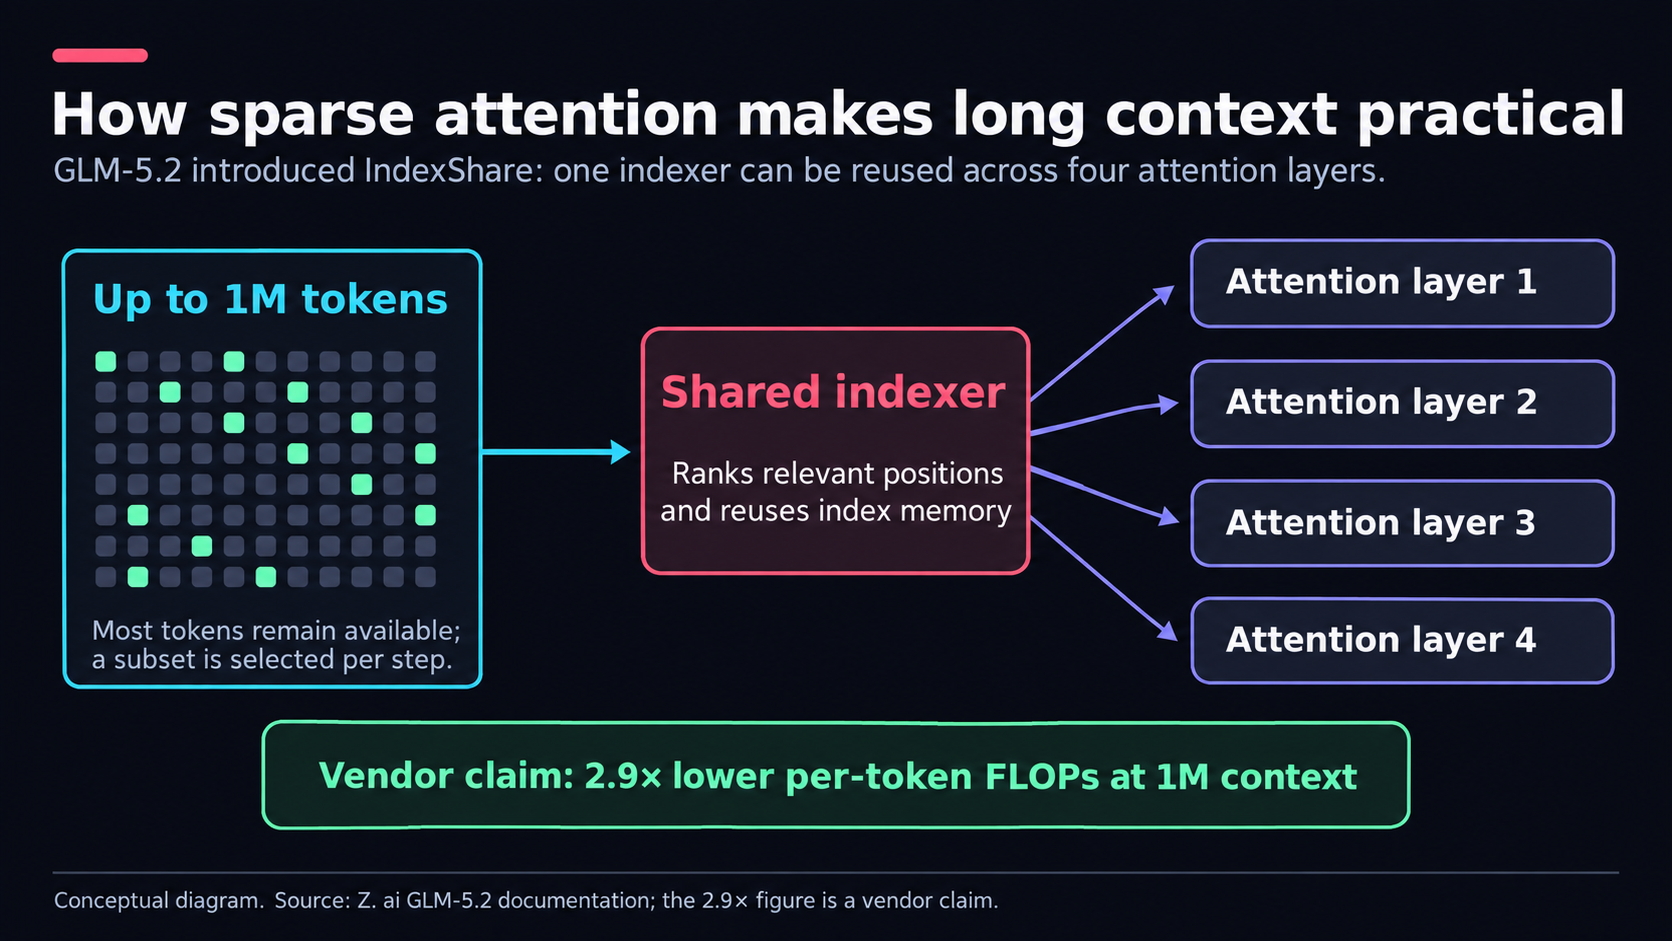
Abbildung 6: IndexShare nutzt einen Indexer über vier Attention-Layer hinweg; der Faktor 2,9 stammt von Z.ai selbst.
Langfristiges Reinforcement Learning
Für GLM-5.3 stellt Z.ai ein asynchrones Reinforcement-Learning-System namens "slime" vor, zusammen mit Context Compaction und synthetisierten Verifiern. Diese Techniken adressieren genau die Fehler, die man bei Agenten in langen Durchläufen beobachtet: das Ziel aus den Augen verlieren, eine Aufgabe abbrechen oder die Antwort nicht überprüfen. Trotzdem sind weiterhin Checkpoints und externe Tests nötig – und entsprechend auch größere Trajektorien bzw. umfangreichere Fehler-Traces.
Cybersicherheits-Fähigkeiten brauchen menschliche Validierung
Im Rahmen seiner Sicherheitskooperation gibt Z.ai an, 2.436 Schwachstellen in 269 Open-Source-Projekten entdeckt zu haben, davon 1.097 mit mittlerem bis hohem Schweregrad. Diese Zahlen sind für die defensive Überprüfung mit GLM-5.3 durchaus relevant, aber GLM-5.3 identifiziert keine bestätigte Schwachstelle – nur einen Modellfund (Model Finding).
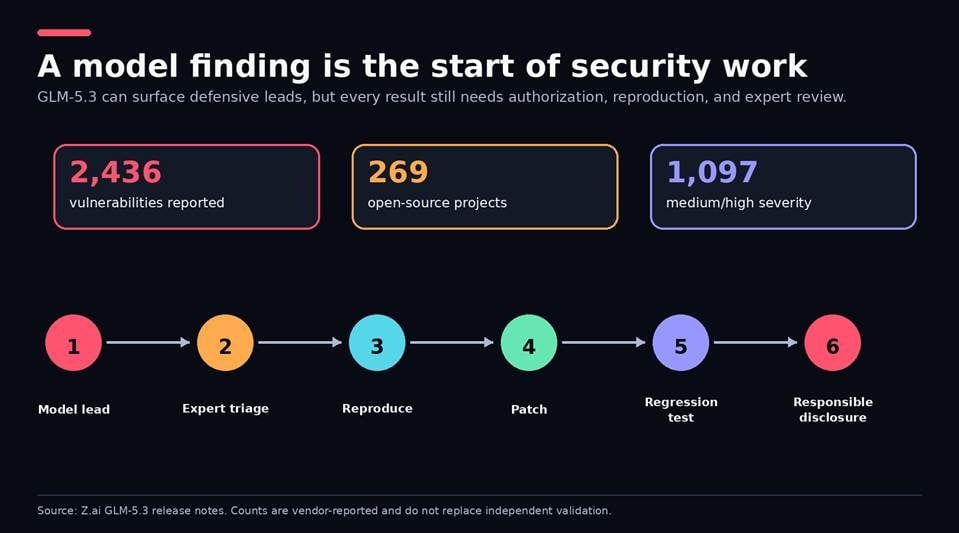
Abbildung 7: Reproduzieren, patchen, Regressionstests durchführen und verantwortungsvoll offenlegen – setze einen Agenten niemals gegen Systeme ein, für deren Test du keine Berechtigung hast.
GLM-5-Preise
Z.ai weist die Kosten für ungecachten Input, gecachten Input und Output seit September 2026 getrennt aus. Ich habe diese Preise zusätzlich auf der offiziellen Preisseite geprüft; verlasse dich bei der Budgetplanung nicht blind darauf, da sich die Preise mit der Zeit ändern können.
| Modell | Input / 1M | Gecachter Input / 1M | Output / 1M |
|---|---|---|---|
| GLM-5 | 1,00 $ | 0,20 $ | 3,20 $ |
| GLM-5.1 | 1,40 $ | 0,26 $ | 4,40 $ |
| GLM-5.2 | 1,40 $ | 0,26 $ | 4,40 $ |
| GLM-5.3 | 1,40 $ | 0,26 $ | 4,40 $ |
| GLM-5.3-Flash | 0,15 $ | 0,03 $ | 0,50 $ |
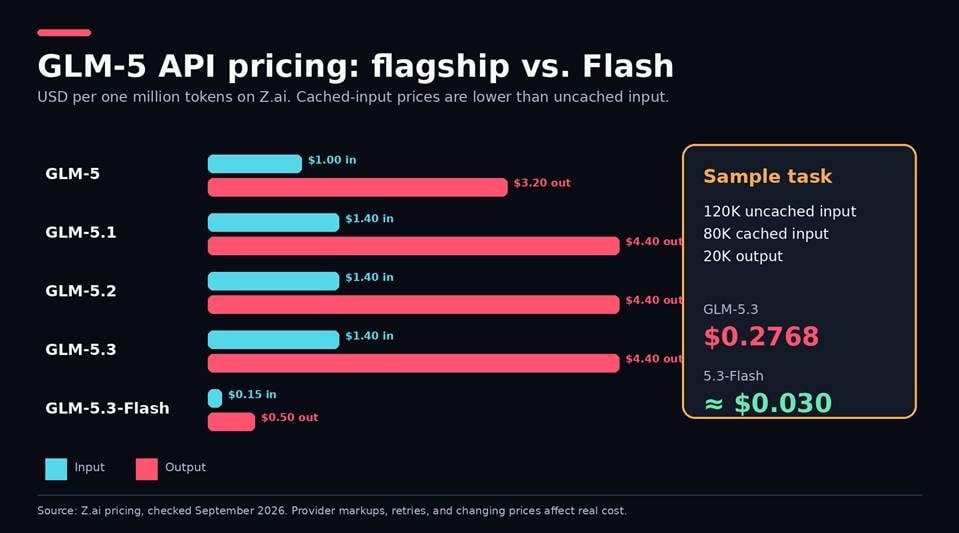
Abbildung 8: Die API-Preise von Z.ai zeigen, warum Output-Länge und Wiederholungen die Endabrechnung dominieren können.
Die Kosten für GLM-5.3 liegen bei etwa 0,2768 $ für 120K ungecachten Input, 80K gecachten Input und 20K Output; bei 5.3-Flash sind es rund 0,030 $ (ohne Wiederholungen). Andere Hosts wie OpenRouter bieten unterschiedliche Preise, Limits, Latenz und Routing. Der GLM Coding Plan ist kein Produktions-API-Kontingent, sondern ein separates Abonnement für unterstützte Coding-Tools.
Der Output ist der teure Teil der Anfrage, und ein Agent, der lange "nachdenkt", kann eine grobe Schätzung schnell übersteigen. Ich würde eine Output-Obergrenze setzen, Caching nutzen, wo wiederkehrender Kontext dies erlaubt, und die Kosten pro abgeschlossener Aufgabe protokollieren. Bei der Erstellung eines Produktionsbudgets solltest du Wiederholungen, fehlgeschlagene Tool-Calls und den Zeitaufwand von Menschen zur Korrektur schwacher Antworten einbeziehen. Diese Kennzahl ist es, die du zwischen Anbietern vergleichen solltest.
So nutzt du GLM-5
| Zugang | Am besten für | Wo die Inferenz läuft |
|---|---|---|
| Z.ai Chat | Schnelle qualitative Bewertung | Server von Z.ai |
| Z.ai API | Direkte Erstanbieter-Integration | Server von Z.ai |
| OpenRouter | Anbieterauswahl und Failover | Ausgewählter Hosting-Anbieter |
| Enter MaaS | Modellzugang innerhalb eines App-Building-Workflows | Gehosteter Zugang innerhalb von Enter |
| Hugging Face + vLLM/SGLang | Selbstverwaltetes Deployment | Eigene Infrastruktur |
| Ollama :cloud | Remote-Zugriff über den Ollama-Client | Remote-Server, nicht dein Laptop |
Mit Z.ai Chat starten
Der einfachste Einstieg in GLM-5 ist chat.z.ai. Nutze es, um Prompt-Verhalten und Output-Struktur zu testen, achte aber auf das im Interface tatsächlich angezeigte Modell. Versprich einem Team niemals "kostenlose" oder "unbegrenzte" Nutzung, ohne das aktuelle Kontingent zu prüfen.
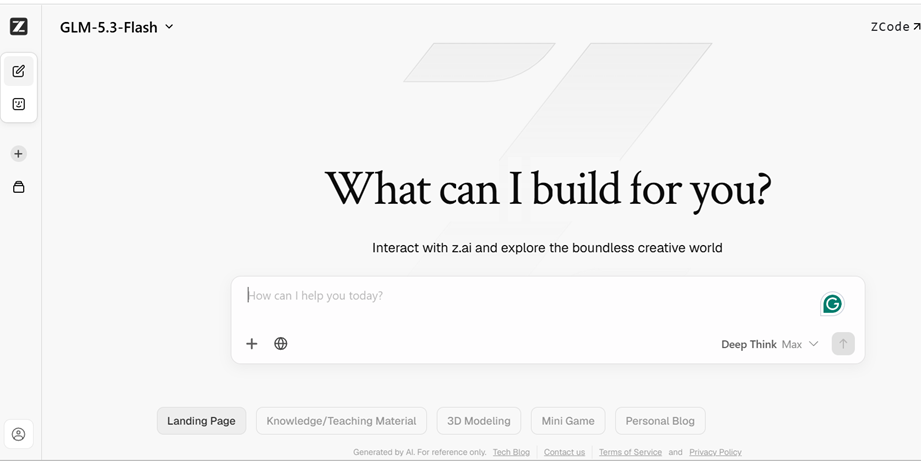
Abbildung 9: Die Chat-Oberfläche eignet sich für einen schnellen qualitativen Check, aber das angezeigte Modell und das Kontingent spielen weiterhin eine Rolle.
Die Z.ai API oder OpenRouter aufrufen
Z.ai bietet einen OpenAI-kompatiblen Endpunkt, sodass sich das offizielle Python-SDK einfach mit einer anderen Basis-URL nutzen lässt. Speichere den API-Key in einer Umgebungsvariable und protokolliere Modell-ID, Effort-Stufe, verwendete Tokens und ob die Anfrage erfolgreich abgeschlossen wurde.
Abbildung 10: Der OpenAI-kompatible Endpunkt von Z.ai reduziert SDK-Änderungen, ersetzt aber nicht die Migrationstests.
import os

from openai import OpenAI

client = OpenAI(

        api_key=os.environ["ZAI_API_KEY"],

        base_url="https://api.z.ai/api/paas/v4/",

)

response = client.chat.completions.create(

        model="glm-5.3",

        messages=[{"role": "user", "content": "List five tests for a password-reset flow."}],

        max_tokens=4096,

        extra_body={"thinking": {"type": "enabled"}, "reasoning_effort": "high"},

)

print(response.choices[0].message.content)
Wenn du von 5.2 migrierst, entferne jede Anfrage, die "thinking" explizit deaktiviert; GLM-5.3 akzeptiert dieses Verhalten nicht. Nutzt du den GLM-5.3-Zugang über OpenRouter, dokumentiere, welcher Anbieter die Anfrage tatsächlich bearbeitet hat, wenn Governance oder Reproduzierbarkeit eine Rolle spielen.
Die Gewichte herunterladen und selbst hosten
Nutze das offizielle Repository oder die verifizierte GLM-5.3-Karte auf Hugging Face. Z.ai nennt SGLang, vLLM, Transformers, KTransformers und Unsloth als unterstützte Deployment-Wege.
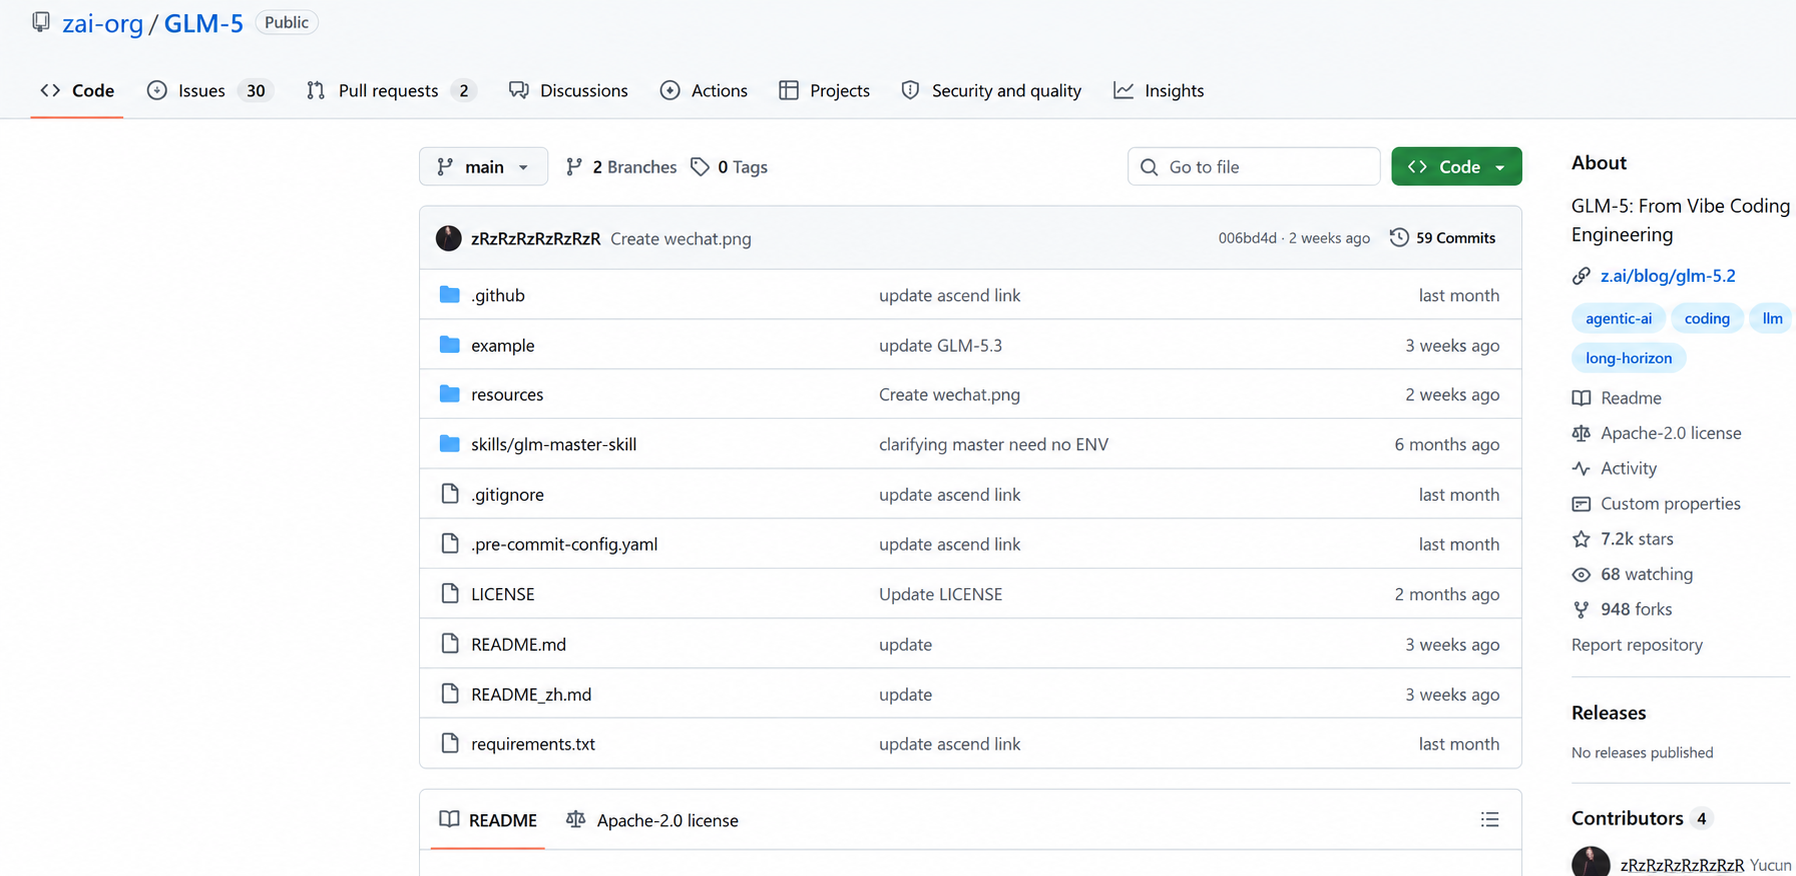
Abbildung 11: Nutze das verifizierte Repository und die offizielle Modellkarte – nicht einen inoffiziellen Gewichts-Mirror.
Herunterladbar heißt NICHT ausführbar. Quantisierung senkt den Speicherbedarf, kann aber die Qualität beeinträchtigen; bei einem 744B-Checkpoint sind Server-Hardware und entsprechender Speicherplatz zwingend erforderlich. Lies das Ollama-GLM-5-Listing genau: Ein Tag mit "cloud" bedeutet Remote-Inferenz. Für echtes lokales Ausführen brauchst du lokale Gewichte, eine lokale Runtime und ausreichend Hardware.
So würde ich GLM-5 vor dem Produktiveinsatz evaluieren
Ich würde nicht mit einer breiten Frage wie "Welches Modell ist am intelligentesten?" beginnen. Stattdessen würde ich vier repräsentative Aufgaben mit denselben Tools und Limits gegen 5.2, 5.3 und Flash laufen lassen: einen Bug im Repository beheben, platzierte Fakten aus einem langen Dokument abrufen, einen Multi-Tool-Workflow mit einem eingebauten Fehler abschließen und eine Ausgabe gegen eine schriftliche Bewertungsrubrik erstellen.
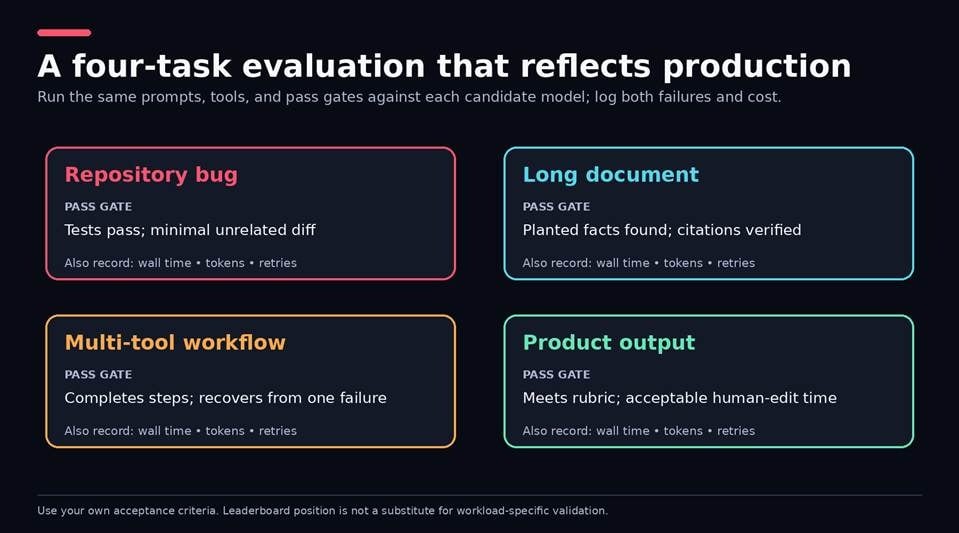
Abbildung 12: Ein kleiner, wiederholbarer Workload-Test ist nützlicher als eine allgemeine Frage nach dem "intelligentesten Modell".
Bestehen/Scheitern, Wall-Time, Tokens, Wiederholungen, Zeit für manuelle Korrekturen und der Anbieter. So lassen sich Migrationsrisiken erkennen, die Benchmark-Durchschnittswerte verschleiern – etwa das permanent aktive Reasoning von 5.3 und potenziell sehr lange Ausgaben. Es zeigt dir auch, ob der niedrigere Preis von Flash den Kontakt mit deinen Abnahmetests überlebt.
Wer sollte GLM-5 nutzen?
Agentisches Coding und Repository-Arbeit
GLM-5 ist eine ausgezeichnete Wahl, wenn eine Aufgabe das Durchsuchen eines Repositorys, koordinierte Änderungen, Testausführung und Tool-Calls umfasst. Die öffentlichen Benchmark-Daten stützen diese Einschätzung, aber dein Abnahme-Gate sollte solide sein: Tests müssen bestehen, der Diff muss fokussiert sein, und keine Credential- oder Netzwerkgrenze darf überschritten werden. Richte einen separaten Arbeitsbereich ein und arbeite nach dem Prinzip der minimalen Rechte. Mehr Autonomie ohne Kontrollen führt nur zu größeren Fehler-Traces.
Lange Dokumente und Wissensarbeit
Modelle mit einer Million Tokens eignen sich für Spezifikationen, Rechercheunterlagen und große Codebasen. Ein großes Kontextfenster sollte man aber nicht mit zuverlässigem Retrieval verwechseln. Platziere relevante Informationen am Anfang, in der Mitte und am Ende; zitiere; überprüfe zitierte Inhalte. Ich würde auch eine Retrieval-Pipeline als Alternative in Betracht ziehen, da es oft langsamer und teurer ist, alles in einen einzigen großen Prompt zu packen, statt vorher relevante Belege gezielt auszuwählen.
Multimodale und defensive Workflows
Mit GLM-5.3-Flash oder GLM-5V-Turbo gehören Screenshots, Interface-Zustände oder andere visuelle Eingaben, die die Aufgabe erfordert, zum Standardrepertoire. Behandle alle Funde als Ausgangspunkt für die defensive Sicherheitsüberprüfung und reproduziere sowie priorisiere sie entsprechend. GLM-5 ist weniger geeignet für alle, die ein kleines, lokal lauffähiges Laptop-Modell suchen, keine Deployment-Entscheidungen treffen können oder Host-Standort und Aufbewahrungsbedingungen nicht verifizieren können.
Ist GLM-5 sicher für private oder Unternehmensdaten?
Gehostete Zugänge
Es kommt nicht nur auf das Modell an, sondern auf den Zugangsweg. Es gibt verschiedene Datenpfade: Z.ai Chat, die Z.ai API, einen anderen Host oder ein selbstverwaltetes Deployment. Beginne mit der Datenschutzrichtlinie von Z.ai und prüfe anschließend bei allen beteiligten Vermittlern die Aufbewahrungsfristen, die Nutzung für Training, Löschung, Standort und Vertragsbedingungen.
Lege einen bestimmten Anbieter fest, falls ein Aggregator diesen anbietet, und sende keine vertraulichen Informationen nur, weil es bequem ist. Was mit gehosteten Daten passiert, bestimmen dein Vertrag und deine Konfiguration – nicht der Begriff "offene Gewichte".
Selbst hosten
Beim Self-Hosting bleiben Prompts in deiner eigenen Umgebung, du bist aber selbst für Gewichte, Credentials, Patches, Netzwerkkontrollen und Monitoring verantwortlich. Auch hier würde ich stets damit rechnen, dass früh generierter, unsicherer Code eingeschleust werden könnte. Trenne Build- und Produktions-Credentials, beschränke ausgehenden Netzwerkzugriff, prüfe Tool-Aktionen und halte für wesentliche Änderungen menschliche Freigaben aufrecht. Gib Agenten nicht mehr Befugnisse, als für die jeweilige Aufgabe nötig sind.
So nutzt du GLM-5 mit Enter Pro
GLM-5 ist kein direkter Konkurrent von Enter Pro. GLM liefert Modellfähigkeiten, während Enter Pro einen Produkt-Building-Workflow rund um Modelle bereitstellt. Das ist nützlich, wenn es dir nicht nur um "eine Antwort generieren" geht, sondern um "eine Antwort, die sich in eine Oberfläche, Logik und einen Veröffentlichungspfad verwandeln lässt."
Wenn API-Kontrolle, individuelle Infrastruktur oder eine bestimmte Datenstruktur erforderlich sind, ist der direkte Zugang die bessere Wahl. Wenn der Produkt-Workaround zum limitierenden Faktor wird, kommt Enter Pro ins Spiel. Der AI MVP Builder bündelt Planung, App-Erstellung, visuelle Bearbeitung und Veröffentlichung in einem einzigen Prozess, während Enter Code einen terminal-zentrierten Ansatz für Repository-Aufgaben bietet.
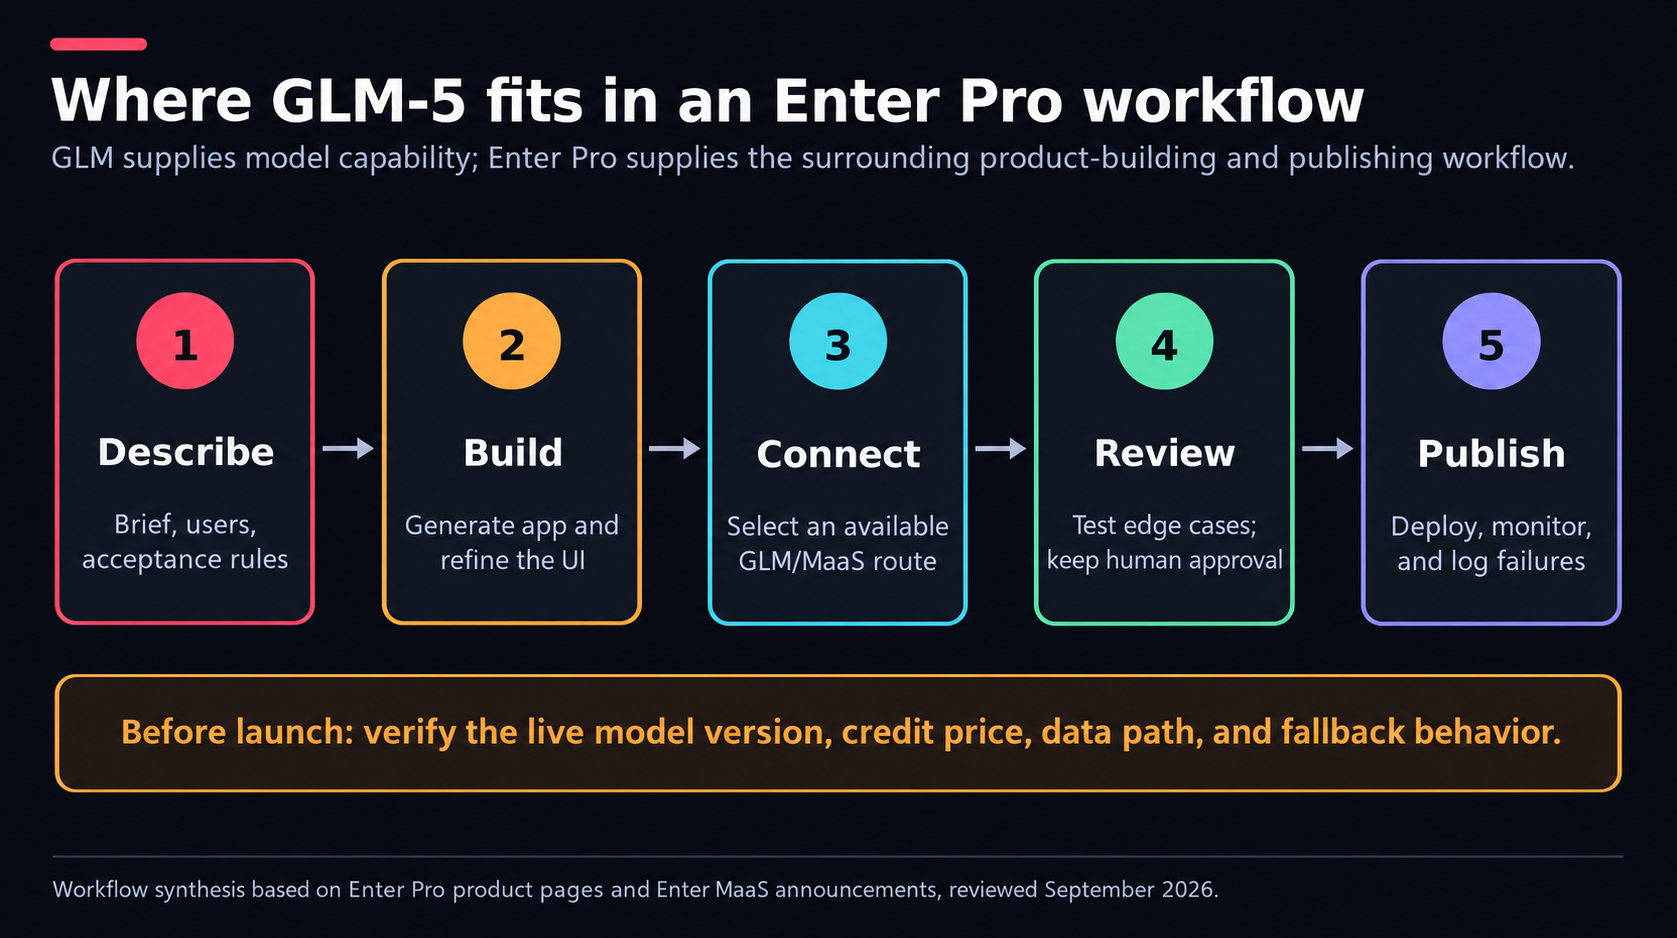
Abbildung 13: Das Modell generiert oder klassifiziert; der Produkt-Workflow ergänzt UI, Review, Deployment und Monitoring.
Das Changelog von Enter bestätigt GLM-5.2 im vorherigen AI-All-Katalog am 17. Juni. Die Ankündigung zu Enter MaaS erwähnt GLM 5 und erklärt, wie die Modelle in Credits abgerechnet werden. Eine ausdrückliche Bestätigung für GLM-5.3 liefert sie allerdings nicht – prüfe daher vor dem Design rund um eine bestimmte Version immer den aktuellen Modell-Selektor, den Credit-Preis, das Kontextlimit und den Datenpfad live im Produkt.
Eine Support-Triage-App zeigt gut, wo diese Kombination sinnvoll ist. Mit Enter Pro kannst du das Ticket-Formular und das Dashboard gestalten und einen bestehenden GLM-Zugang anbinden, um Tickets zu kategorisieren und Antworten zu entwerfen. Validiere vor der Veröffentlichung leere Modellantworten, mehrdeutige Anfragen, mehrsprachige Eingaben, Prompt-Injection und private Daten innerhalb des Nachrichtentexts. Stelle sicher, dass immer ein Mensch zwischen Entwurf und Senden-Button steht.
| Wenn deine Priorität ist … | Direkten GLM-Zugang wählen | Enter Pro wählen |
|---|---|---|
| Modellparameter und Anbieterkontrolle | Ja | Nur innerhalb der angebotenen Optionen |
| Visuelle App-Erstellung und -Bearbeitung | Separates Tooling bauen oder hinzufügen | Kernvorteil des Workflows |
| Individuelles Hosting und Netzwerk-Policy | Stärkste Eignung | Plattform-Eignung zuerst prüfen |
| Schneller Weg von Modell-Output zu Produkt-UI | Mehr Engineering nötig | Stärkere Eignung |
Aber Enter macht GLM nicht intelligenter, und dass GLM Zugriff auf eine App hat, macht dessen Coding-Agenten ebenfalls nicht schlauer. Geht es um Integration oder UI-Arbeit, würde ich mich für Enter entscheiden. Wenn du dich in dieser Situation befindest, öffne den Enter Pro Workspace und prüfe den vorhandenen Modellkatalog, bevor du dich architektonisch festlegst.
Fazit
Auch wenn es "GLM-5" heißt – bei Coding und langfristig agierenden Agenten sind Variante und Bereitstellungsweg genauso wichtig wie das Modell selbst! Nutze GLM-5.3 für schwierigen Text und Code, GLM-5.3-Flash für Multimodalität und/oder hohes Volumen, und behalte 5.2 bei, bis sich eine Migration wirtschaftlich lohnt. Teste anschließend immer mit deinen eigenen Aufgaben, bevor du Herstellerangaben als Produktionsnachweis akzeptierst.
Das Modell, das wirklich funktioniert, ist jenes, das deine Abnahmekriterien erfüllt, innerhalb deines Latenz- und Datenschutzrahmens bleibt und auch nach Wiederholungen noch den richtigen Preis hat – unabhängig davon, welche beinahe perfekte Punktzahl es bei einem einzelnen Benchmark erzielt.
FAQs
FAQ 1: Ist GLM-5 kostenlos?
Die öffentlichen Gewichte stehen zum Download bereit, ohne Pro-Token-API-Gebühren – aber Hardware und Betrieb kosten dennoch Geld. Z.ai Chat kann kontingentbasierten Zugang bieten. Gehostete APIs, Router und GPU-Server sind kostenpflichtige Dienste, die je nach Version und Zugangsweg unterschiedlich ausfallen können.
FAQ 2: Welche Version von GLM-5 ist besser?
Für anspruchsvollen Text/Code starte ich mit GLM-5.3. GLM-5.3-Flash ist der bessere erste Test für Bilder, Screenshots oder kostenkritisches Volumen. Nutze GLM-5.2 weiter, wenn es bereits validiert ist und das Migrationsrisiko den potenziellen Nutzen übersteigt.
FAQ 3: Kann GLM-5 Code schreiben und debuggen?
Ja. Coding-Agenten und Engineering-Aufgaben auf Repository-Ebene sind zentrale Anwendungsfälle, mit guten Ergebnissen, die Hersteller für Terminal-Bench und DeepSWE berichten. Sandbox, Tests, eingeschränkte Berechtigungen und menschliches Review bleiben trotzdem erforderlich.
FAQ 4: Wie viel kostet die GLM-5 API?
Im September 2026 listet Z.ai GLM-5 mit 1,00 $ Input und 3,20 $ Output pro Million Tokens; GLM-5.3 mit 1,40 $ und 4,40 $; und 5.3-Flash mit 0,15 $ und 0,50 $. Gecachter Input ist günstiger. Die tatsächlichen Kosten werden zusätzlich von Anbieter-Aufschlägen und Wiederholungen beeinflusst.
FAQ 5: Ist GLM-5 Open-Source-Software?
"Offene Gewichte" trifft es besser. Die Lizenz der Gewichte, die Lizenz des Repository-Codes und die Transparenz der Trainingsdaten sind jeweils eigene Fragen. Prüfe vor einem kommerziellen Deployment unbedingt die konkrete Modellkarte auf Hugging Face und die Repository-Lizenz.
FAQ 6: Lässt sich GLM-5 lokal (mit Ollama) nutzen?
Nur, wenn du lokale Gewichte, Runtime-Unterstützung und ausreichend Hardware dafür hast. Der Cloud-Tag bedeutet, dass die Ausführung auf Remote-Infrastruktur läuft – das vollständige 744B-Modell läuft dabei nicht auf deinem eigenen Gerät.
FAQ 7: Kann GLM-5 Bilder verarbeiten?
Das Basis-GLM-5 und GLM-5.3 sind reine Text-Modelle. Für multimodale Eingaben nutze GLM-5.3-Flash oder GLM-5V-Turbo; prüfe die am jeweiligen Endpunkt akzeptierten Dateitypen.





