
GPT-5.2 erklärt: Funktionen, Benchmarks, Preise und Anwendungsfälle
GPT-5.2 Instant, Thinking, Pro und Codex im Überblick: Preise, Benchmarks, Zugang, Grenzen und der Vergleich mit Gemini 3 für Entwickler 2026.
Abbildung 1. GPT-5.2 bewertet nach Qualität, Geschwindigkeit, Kosten und Kontrolle
Ich habe in Enter Pro GPT‑5.2 Pro ausgewählt, um einen Reviewer für Projekt-Briefings zu bauen, der App-Ideen in Anforderungen und Abnahmekriterien umwandelt. Die Screenshots zeigen das Setup und die Review-Ausgabe; die Verifizierung einer abgeschlossenen Anfrage steht noch aus.
Dieser praktische Fall liefert einen konkreten Bezugspunkt für diesen Leitfaden. Ich trenne die offiziellen Benchmark-Ergebnisse von dem, was die Anwendung tatsächlich gezeigt hat, und untersuche dann die Fähigkeiten, Preise und Grenzen der Modellfamilie. Bevor du eine Beobachtung auf Instant, Thinking, Pro oder Codex anwendest, solltest du die genaue Variante identifizieren.
OpenAI stellte die Familie am 11. Dezember 2025 als Release für professionelle Arbeit und lange laufende Agenten vor. Der Launch-Bericht liefert die offizielle Benchmark- und Preis-Baseline. Ich nutze diesen Bericht zusammen mit aktuellen Routing-Informationen, kritischer unabhängiger Erfahrung und Community-Berichten, weil keine einzelne Quelle sowohl kontrollierte Leistung als auch den Alltagsreibungen abdeckt.
Wer nach Chat GPT 5.2 sucht, meint oft die gesamte Dezember-2025-Familie, aber der Unterschied zwischen ChatGPT-Modi und API-Modell-IDs ist wichtig. Ein Test von Instant sagt nichts über das Verhalten, den Preis oder die Latenz von Thinking, Pro oder dem auf Code spezialisierten Modell aus.
GPT-5.2 im Überblick
Stand 9. Oktober 2026 listet OpenAI GPT‑5.2 und GPT‑5.2 Pro als Optionen der vorherigen Generation. Bestehende Projekte schätzen möglicherweise ihr bekanntes Verhalten und gepinnte Snapshots, während ein neues Projekt die aktuell empfohlenen Modelle anhand derselben Abnahmekriterien vergleichen sollte.
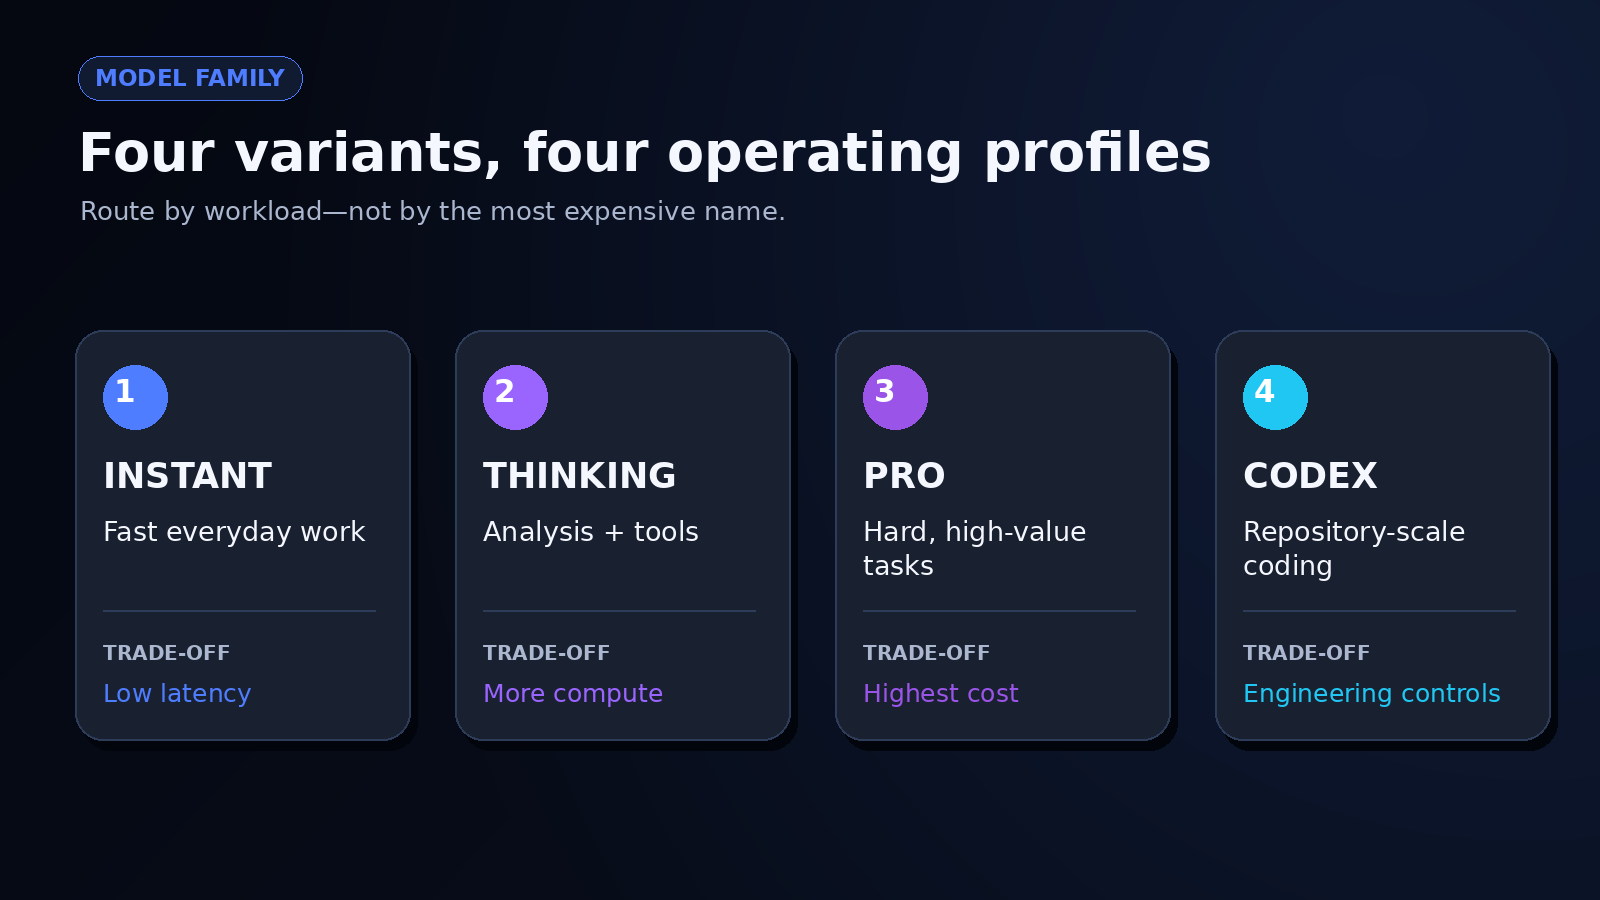
Abbildung 2. Instant, Thinking, Pro und Codex zugeordnet zu Workload-Typen
| Spezifikation | GPT-5.2 | GPT-5.2 Pro |
|---|---|---|
| Aktuelle Position | Vorheriges Flaggschiff | Vorheriges Pro-Modell |
| Kontextfenster | 400.000 Tokens | 400.000 Tokens |
| Maximale Ausgabe | 128.000 Tokens | 128.000 Tokens |
| Wissensstand | 31. August 2025 | 31. August 2025 |
| Modalitäten | Text Ein-/Ausgabe; Bild-Eingabe | Text Ein-/Ausgabe; Bild-Eingabe |
| Reasoning-Aufwand | keine, niedrig, mittel, hoch, sehr hoch | mittel, hoch, sehr hoch |
| API-Preis pro 1 Mio. Tokens | $1,75 Eingabe; $0,175 Cache; $14 Ausgabe | $21 Eingabe; $168 Ausgabe |
| Strukturierte Ausgaben | Unterstützt | Nicht unterstützt |
| Fine-Tuning | Nicht unterstützt | Nicht unterstützt |
| Snapshot | gpt-5.2-2025-12-11 | gpt-5.2-pro-2025-12-11 |
Aktueller Status, Kontext und Modalitäten
Das Kontextfenster von 400.000 Tokens und die Ausgabegrenze von 128.000 Tokens sind ungewöhnlich groß, aber Kapazität ist nicht gleich Erinnerungsvermögen. Wenn du Verträge, Logs, Screenshots und Anforderungen in eine Anfrage packst, brauchst du trotzdem einen Retrieval-Test: Platziere Fakten an unterschiedlichen Positionen, stelle Fragen, die eine Kombination dieser Informationen erfordern, und protokolliere, was das Modell übersieht. Ich würde aus der reinen Kontextzahl keine verlässliche Langdokument-Reasoning-Fähigkeit ableiten.
Die Modelle akzeptieren Bilder und erzeugen Text; Audio oder Video werden nicht als native Eingaben unterstützt. Das macht sie nützlich für Diagramme, Interface-Screenshots, Schaubilder und gescannte Dokumente, sofern du räumliche Details und extrahierte Werte überprüfst. Ein unscharfes Label oder eine ungewöhnliche Diagrammskalierung kann aus einer selbstbewussten Erklärung einen plausiblen Fehler machen.
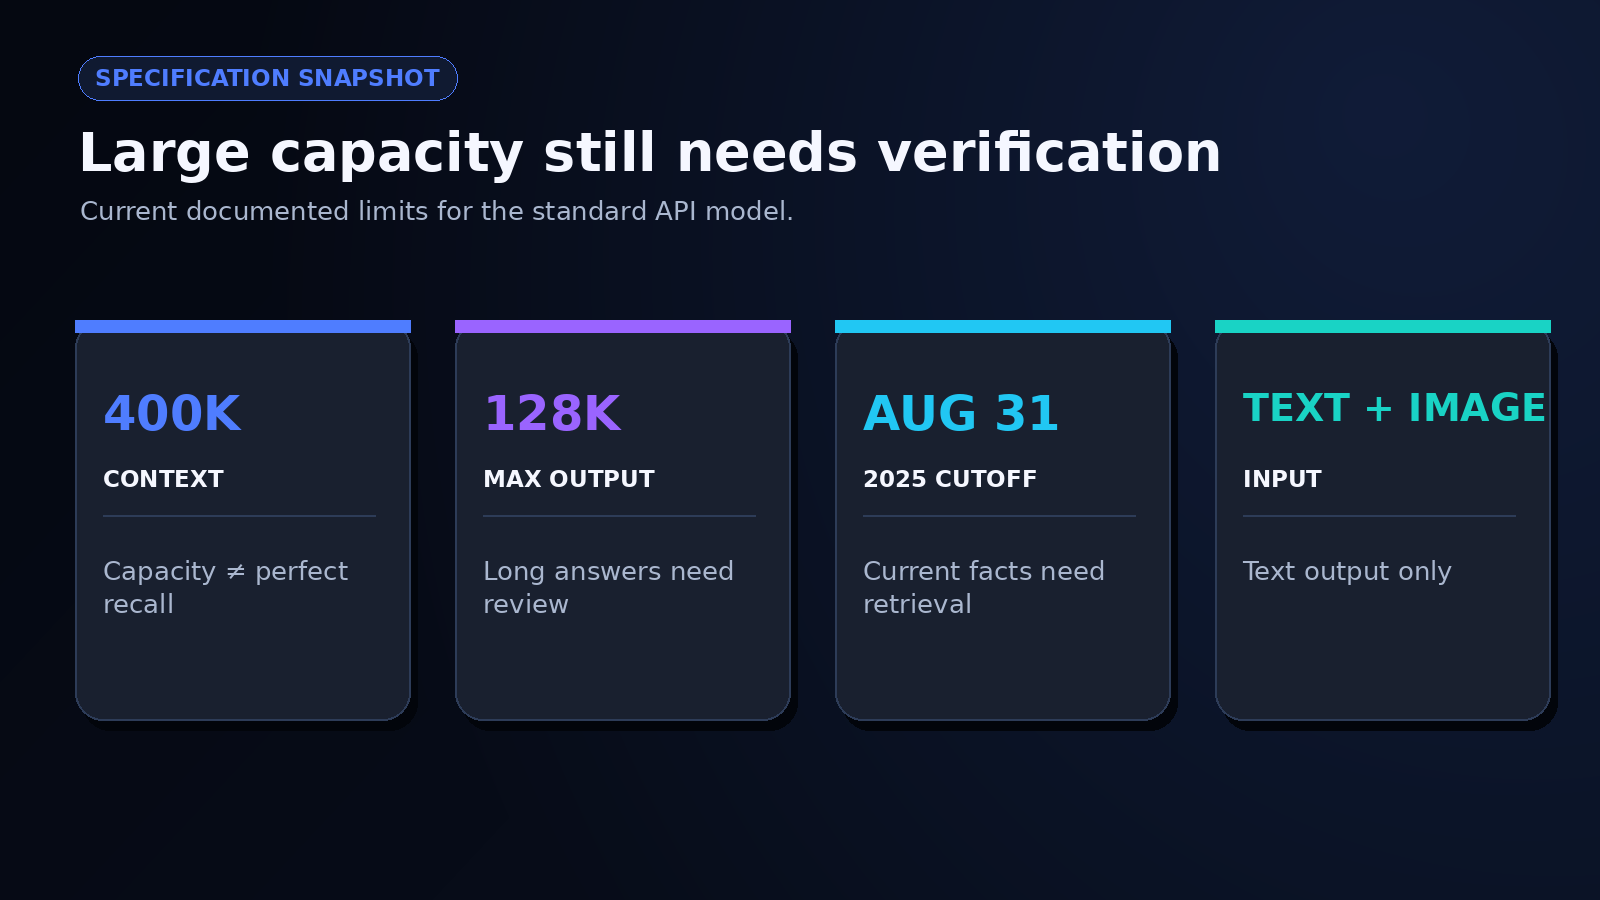
Abbildung 3. Kontext, Ausgabe, Modalitäten, Wissensstand und Snapshots
API-Preise und Zugang
Das Standard-API-Modell kostet $1,75 pro Million Eingabe-Tokens, $0,175 pro Million zwischengespeicherter Eingabe-Tokens und $14 pro Million Ausgabe-Tokens. GPT 5.2 Pro kostet $21 Eingabe und $168 Ausgabe. Reasoning-Tokens, Wiederholungen, Tool-Aufrufe und menschliche Korrekturen beeinflussen die Kosten eines akzeptierten Ergebnisses. Bei Nutzung einer Integrationsplattform solltest du deren Abrechnungseinheiten separat prüfen, bevor du sie mit OpenAIs Dollarpreisen vergleichst.
Aktuelles Provider-Routing und Verfügbarkeit findest du auf OpenRouters GPT‑5.2-Seite. Ich würde Kosten pro abgeschlossener Aufgabe berechnen, nicht Kosten pro Anfrage. Eine günstigere Antwort, die zweimal die Validierung nicht besteht, kann teurer sein als eine höherpreisige Antwort, die beim ersten Durchlauf besteht.
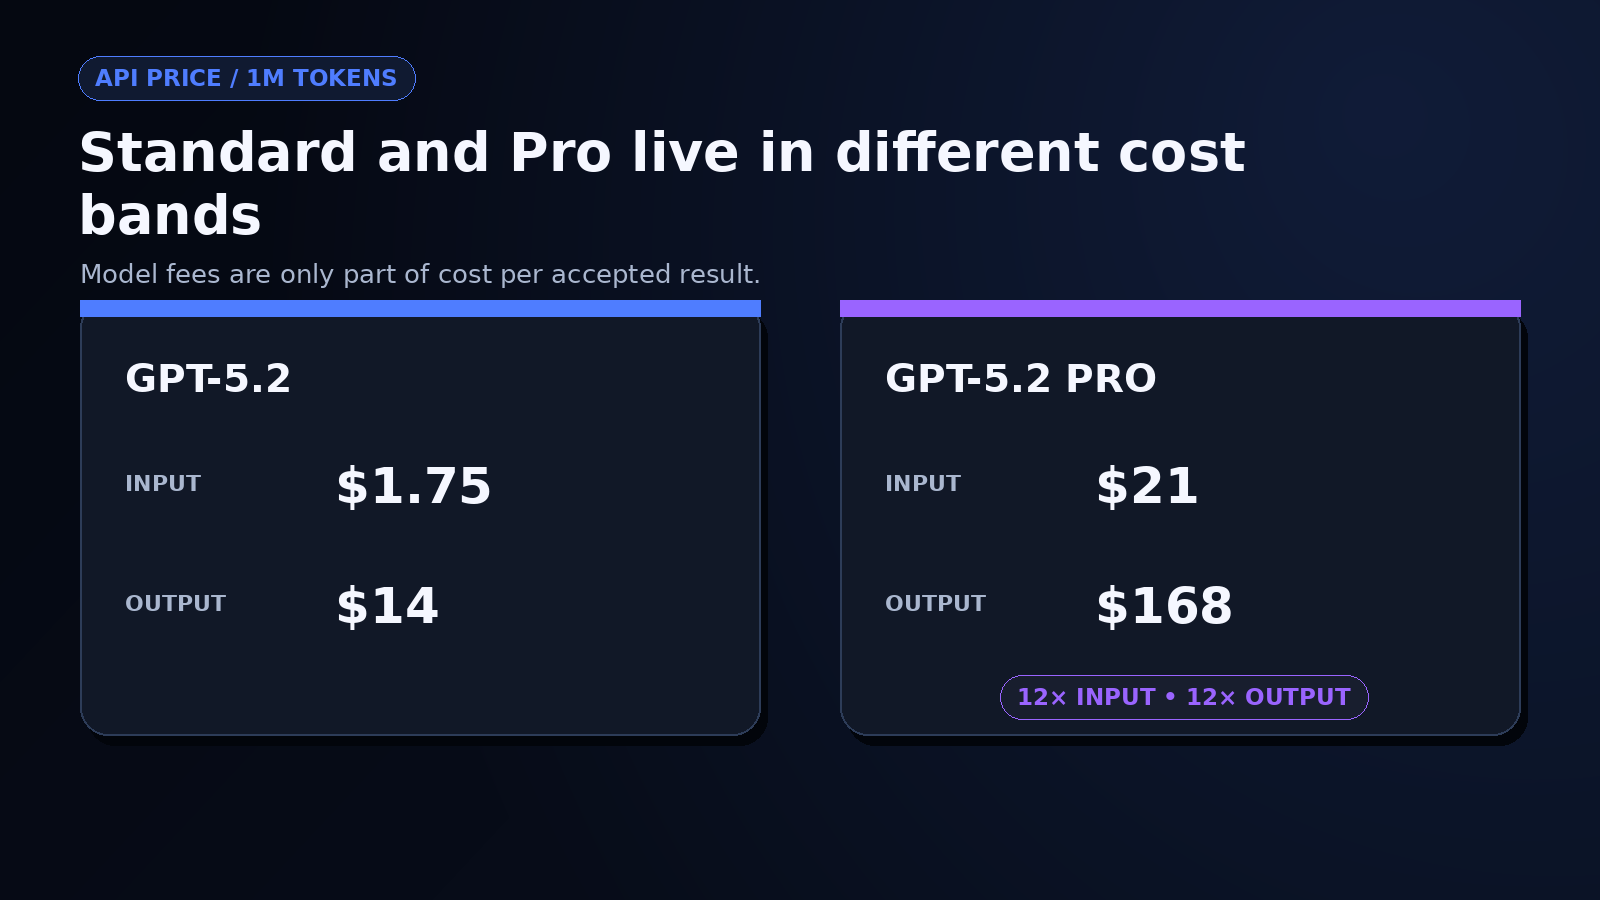
Abbildung 4. Standard- versus Pro-Kosten pro Million Tokens
Was hat sich mit dem Release von OpenAI GPT-5.2 geändert?
Der OpenAI GPT-5.2 Release zielte auf Arbeit ab, die über eine einzelne Antwort hinausgeht: Artefakte erstellen, lange Dokumente prüfen, Tools nutzen, Code schreiben und überprüfen, über Bilder nachdenken und mehrstufige professionelle Aufgaben abschließen. Er trennte außerdem schnellen Chat, tieferes Reasoning und rechenintensive Arbeit klarer, als es ein einzelnes Modell-Label vermuten lässt.
Instant, Thinking und Pro zielen auf unterschiedliche Workloads ab
Instant priorisierte Alltagsfragen, Erklärungen, Übersetzungen und schnelle Entwürfe. Thinking zielte auf Analyse, Coding, Dateien, Planung und Tool-Nutzung ab. Pro investierte mehr Rechenleistung in schwierige Probleme, bei denen eine längere Wartezeit und eine deutlich höhere API-Rechnung gerechtfertigt sein konnten.
| Modus/Modell | Praktische Eignung | Hauptkompromiss |
|---|---|---|
| Instant | Routinefragen und latenzsensible Arbeit | Weniger Überlegung bei schwierigen Mehrschritt-Aufgaben |
| Thinking | Analyse, Coding, lange Dateien und Tool-gesteuerte Workflows | Mehr Latenz und Token-Verbrauch |
| Pro | Schwierige Aufgaben, bei denen inkrementelle Qualität hohen Wert hat | Sehr hohe Kosten; Antworten können Minuten dauern |
Ich würde nach Risiko routen, nicht nach Prestige. Ein Klassifizierungsschritt braucht vielleicht ein schnelles Modell mit striktem Schema. Eine Finanzmodell-Prüfung rechtfertigt vielleicht tieferes Reasoning. Wenn du jede Anfrage an Pro schickst, verschleierst du, welche Aufgaben wirklich von der zusätzlichen Rechenleistung profitieren, und machst die Kostenkontrolle viel schwerer.
Professionelle Arbeit und Tool-Nutzung standen im Zentrum des Launches
OpenAI betonte Tabellenkalkulationen, Präsentationen, Frontend-Arbeit, Code-Review, Dokumentenanalyse, Wissenschaft, Mathematik und Tool-Aufrufe. In einer herstellerseitigen Auswertung anonymisierter ChatGPT-Anfragen wurden antwortbezogene Fehler als relativ 30% seltener gemeldet als bei GPT‑5.1 Thinking. Der Release-Bericht merkt auch an, dass Modelle die Fehlerbewertung durchgeführt haben, daher lese ich diese Zahl als richtungsweisenden Hinweis, nicht als unabhängige Garantie.
Die praktische Verbesserung ist nicht "das Modell weiß alles". Es ist eine höhere Wahrscheinlichkeit, dass eine gut spezifizierte Aufgabe mehrere Schritte überlebt, ohne ihre Struktur zu verlieren. Du brauchst trotzdem beobachtbare Checkpoints: Welches Tool lief, welche Daten es erhielt, was es geändert hat und wie sich der Workflow nach einem fehlgeschlagenen Aufruf erholte.
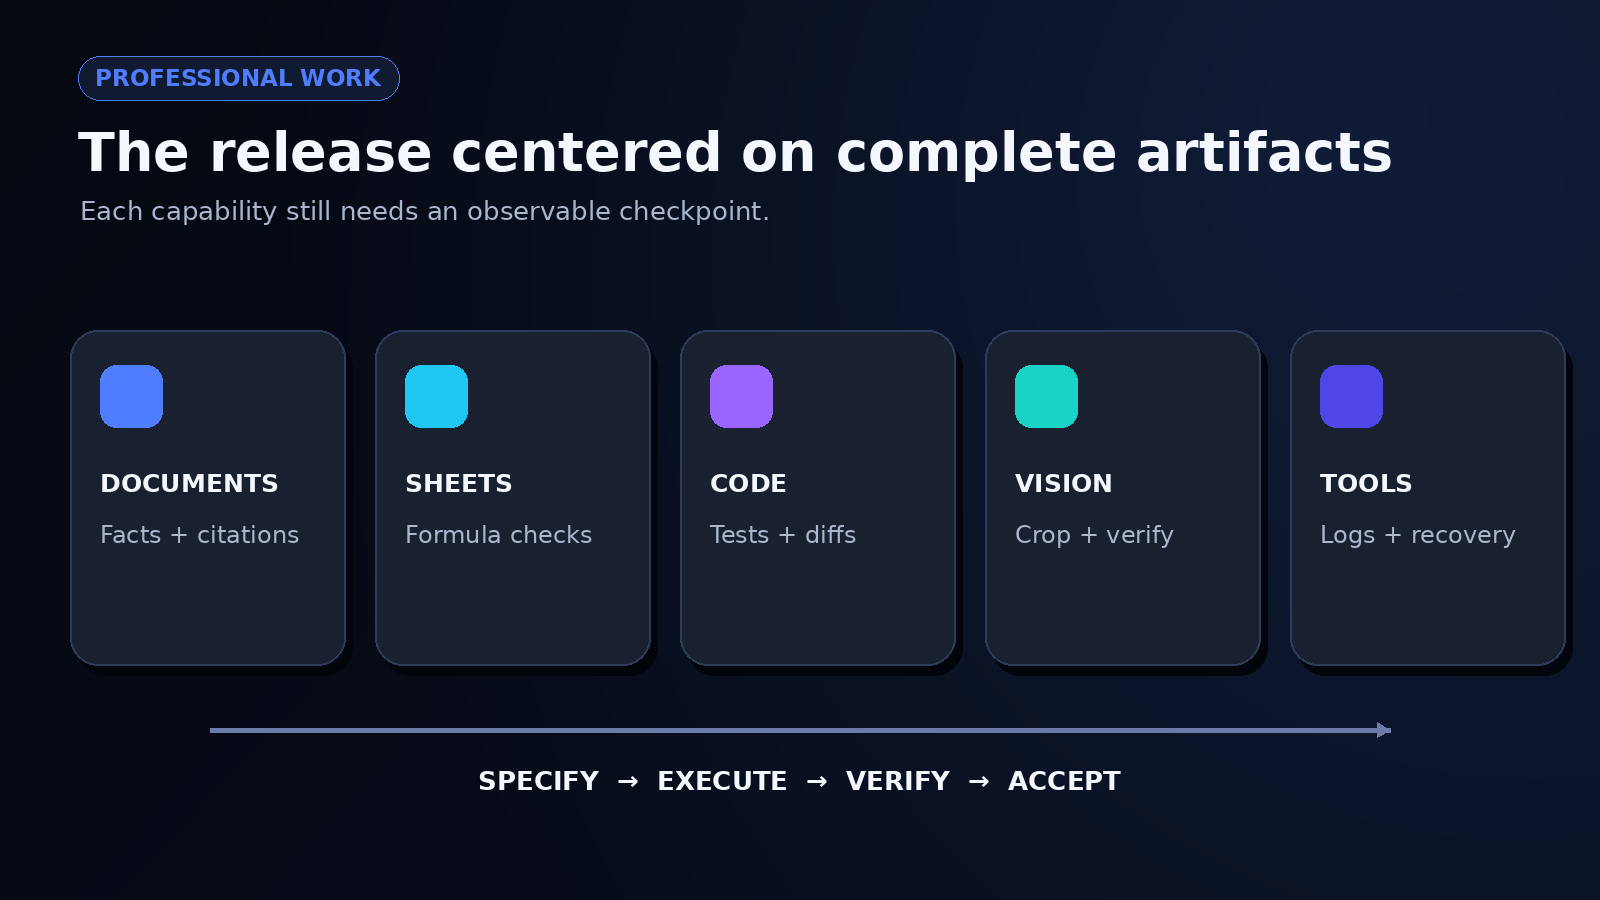
Abbildung 5. Panels für Tabellenkalkulation, Code, Dokument, Bild und Tool-Aufruf
Launch-Benchmarks zeigten breite, aber uneinheitliche Stärken
| Benchmark | GPT-5.2 Thinking | Was gemessen wird |
|---|---|---|
| GDPval Siege oder Unentschieden | 70,9% | Gut spezifizierte berufliche Aufgaben über 44 Berufe |
| SWE-Bench Pro public | 55,6% | Mehrsprachige Software-Engineering-Aufgaben |
| SWE-bench Verified | 80,0% | Verifizierte Python-Repository-Aufgaben |
| GPQA Diamond | 92,4% | Wissenschaftsfragen auf Graduiertenniveau ohne Tools |
| AIME 2025 | 100,0% | Wettbewerbsmathematik ohne Tools |
| ARC-AGI-2 Verified | 52,9% | Neuartige abstrakte Reasoning-Aufgaben |
Die Streubreite ist der nützliche Teil. Sie zeigt starke Ergebnisse, ohne einheitliche Meisterschaft zu implizieren. Ein 80%-Score bei verifizierten Python-Issues sagt nichts über deine Erfolgsrate in einem TypeScript-Monorepo mit eigenen Deployment-Regeln aus. Ebenso begründet ein Wissenschafts-Benchmark kein verlässliches juristisches oder medizinisches Urteilsvermögen.
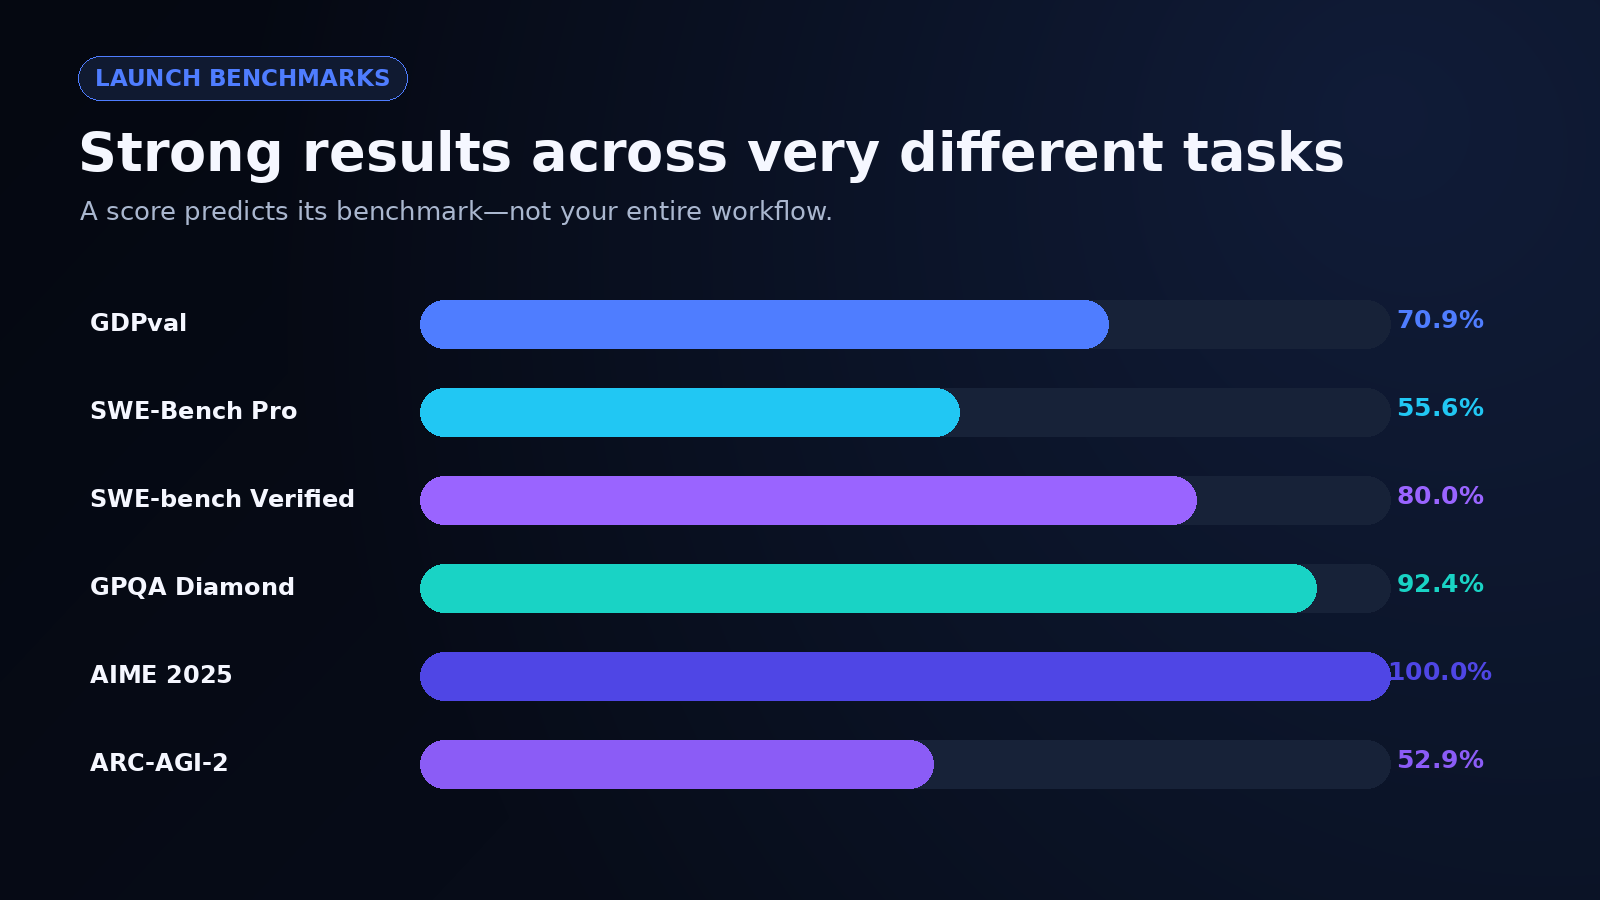
Abbildung 6. Sechs Launch-Scores mit Aufgabenkategorien
GPT-5.2-Benchmarks zusammen mit ihren Grenzen lesen
Öffentliche Scores komprimieren viele Entscheidungen in eine Zahl: Prompt-Format, Tools, Reasoning-Aufwand, Testauswahl, Grader-Verhalten und Retry-Policy. Dein Produktions-Workflow fügt Datenqualität, Berechtigungen, Latenzgrenzen und menschliche Review hinzu. Ich finde Benchmarks am nützlichsten, um zu entscheiden, was getestet werden soll — nicht, um den Test auszulassen.
Was mein App-Review tatsächlich gezeigt hat
Der Reviewer für Projekt-Briefings zeigte die eingereichten Anweisungen unter "Projektzusammenfassung" und "Wesentliche Anforderungen", während die Antwort noch gestreamt wurde. Die Eingabe forderte Implementierungsprüfungen, aber das sichtbare Ergebnis organisierte diese Anfrage als Briefing. Es berichtete nicht über abgeschlossene Code-Inspektion oder Testergebnisse.
Die separate Session-Ansicht hatte keine protokollierten Anfragen oder Nutzung, sodass Antwortzeit, Routing und Kosten unverifiziert blieben. Schließe eine Anfrage mit einem eingeschränkten Briefing ab, um die Prüfung zu vollenden.
Benchmark-Scores sind keine Produktionsgarantien
Starte mit 20 bis 50 repräsentativen Aufgaben und definiere die Abnahmekriterien, bevor du sie ausführst. Für Code kann das Testquote, Diff-Größe, Sicherheitsbefunde und Rollback-Sicherheit umfassen. Für Dokumentenarbeit kann das faktische Genauigkeit, Zitatabdeckung, Berechnungsfehler und Bearbeitungszeit umfassen. Führe denselben Satz mehrmals aus, weil Varianz eine Rolle spielt.
Dann misst du die Kosten pro akzeptiertem Ergebnis. Angenommen, ein Modell kostet $0,18 pro Durchlauf und besteht 60% der Fälle, während ein anderes $0,28 kostet und 90% besteht. Vor menschlicher Korrektur liegen ihre erwarteten Kosten pro akzeptiertem Ergebnis bei $0,30 bzw. etwa $0,31. Sobald du die Review-Zeit einpreist, kann das zweite Modell deutlich günstiger sein — oder nicht. Die Rechnung zwingt die Entscheidung zurück auf deinen Workflow.
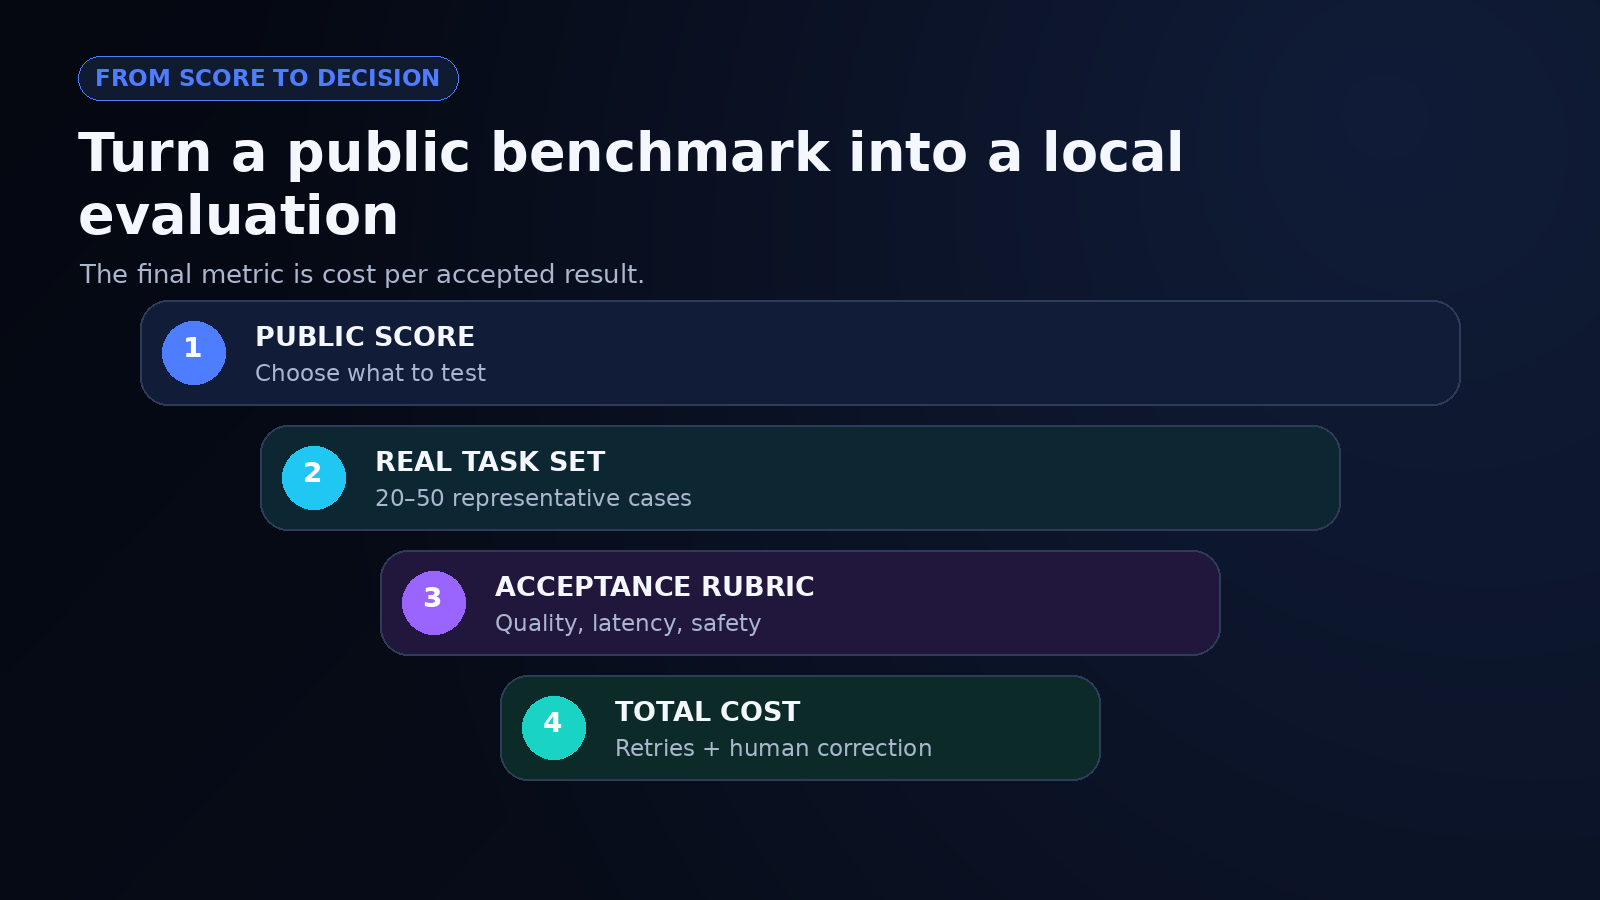
Abbildung 7. Vom Benchmark-Score über repräsentative Aufgaben zu den Kosten des akzeptierten Ergebnisses
Langer Kontext und Bildeingabe erfordern weiterhin Verifizierung
Ein langes Kontextfenster kann Chunking reduzieren, macht aber auch Auslassungen schwerer erkennbar. Ich würde Retrieval vom Anfang, der Mitte und dem Ende eines Dateisatzes testen; Zitate oder Identifikatoren für kritische Fakten verlangen; und Berechnungen außerhalb des Modells erneut durchführen. Bei Bildern solltest du den relevanten Bereich zuschneiden und die Frage explizit stellen, statt vom Modell zu erwarten, dass es errät, was wichtig ist.
Unabhängige Kritik kann auch Fehlermodi aufdecken, die ein Launch-Post nicht in den Vordergrund stellt. Eine praktische Kritik beschreibt enttäuschende Ergebnisse bei den Aufgaben des Autors. Das widerlegt die Benchmark-Ergebnisse nicht; es zeigt, warum dein Prompt, dein Workload und deine Abnahmeschwelle direkt reproduziert werden müssen.
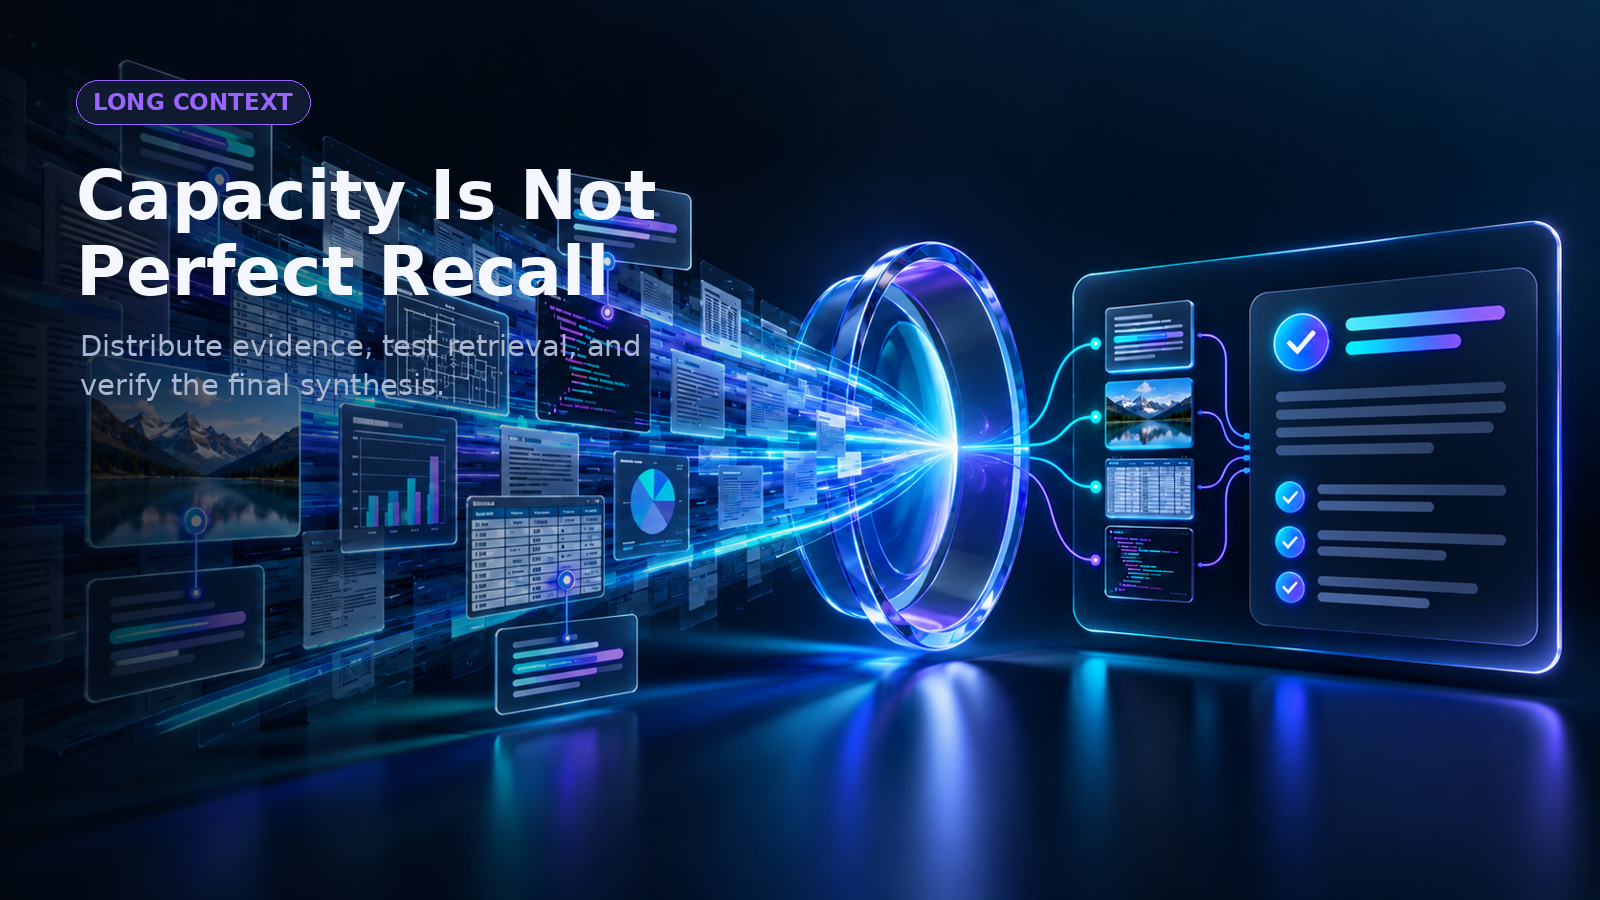
Abbildung 8. Beweise verteilt über einen 400K-Token-Dokumentenstrom
Hochriskante Arbeit braucht fachspezifische Schutzmaßnahmen
Der Wissensstand vom 31. August 2025 bedeutet, dass aktuelle Fakten Retrieval benötigen. Die Modelle können trotzdem Quellen erfinden, Anforderungen übersehen, Screenshots missverstehen oder unsicheren Code erzeugen. Sie unterstützen auch kein Fine-Tuning, sodass Teams, die tief individualisiertes Verhalten brauchen, auf Prompting, Retrieval, Tools, Validierung oder ein anderes Modell zurückgreifen müssen.
Du solltest Unterstützung von Entscheidungsbefugnis trennen. Ein Modell kann einen Vertrag zusammenfassen, eine verdächtige Transaktion markieren oder einen Patch vorschlagen. Eine qualifizierte Person oder eine deterministische Kontrolle sollte die juristische, medizinische, finanzielle, sicherheitsrelevante und produktionsbezogene Entscheidung treffen. Protokolliere die Belege und halte einen klaren Weg offen, um die Ausgabe abzulehnen oder zurückzurollen.
Was ist GPT-5.2-Codex und wie sollten Entwickler es nutzen?
GPT 5.2 Codex ist das auf Code spezialisierte Mitglied der Familie, entwickelt für längere Software-Engineering-Arbeit statt isoliertes Autocomplete. Der nützliche Unterschied ist die Workflow-Tiefe: ein Repository verstehen, eine Änderung planen, mehrere Dateien bearbeiten, Tools ausführen, Fehler untersuchen und den Patch überarbeiten.
Am besten geeignete Coding-Aufgaben
Gute Kandidaten sind Repository-Exploration, Feature-Implementierung, Bugfixes, Refactoring, Testerstellung, Code-Review und Migrationen mit expliziten Abnahmekriterien. Ich würde dem Modell das kleinste zusammenhängende Ziel geben, das trotzdem die reale Abhängigkeitsgrenze einschließt. Ein künstlich zu kleiner Prompt kann einen sauberen lokalen Diff erzeugen, der am umgebenden System scheitert.
Du kannst GPT 5.2 Codex mit einem wiederholbaren Repository-Satz evaluieren: bekannte Issues, versteckte Tests, Linting, Dependency-Policy, Sicherheitschecks und einen maximal akzeptablen Diff. Protokolliere die Anzahl der Tool-Aufrufe, Korrekturen und Reviewer-Eingriffe. Ein Patch ist nicht erfolgreich, nur weil er kompiliert.
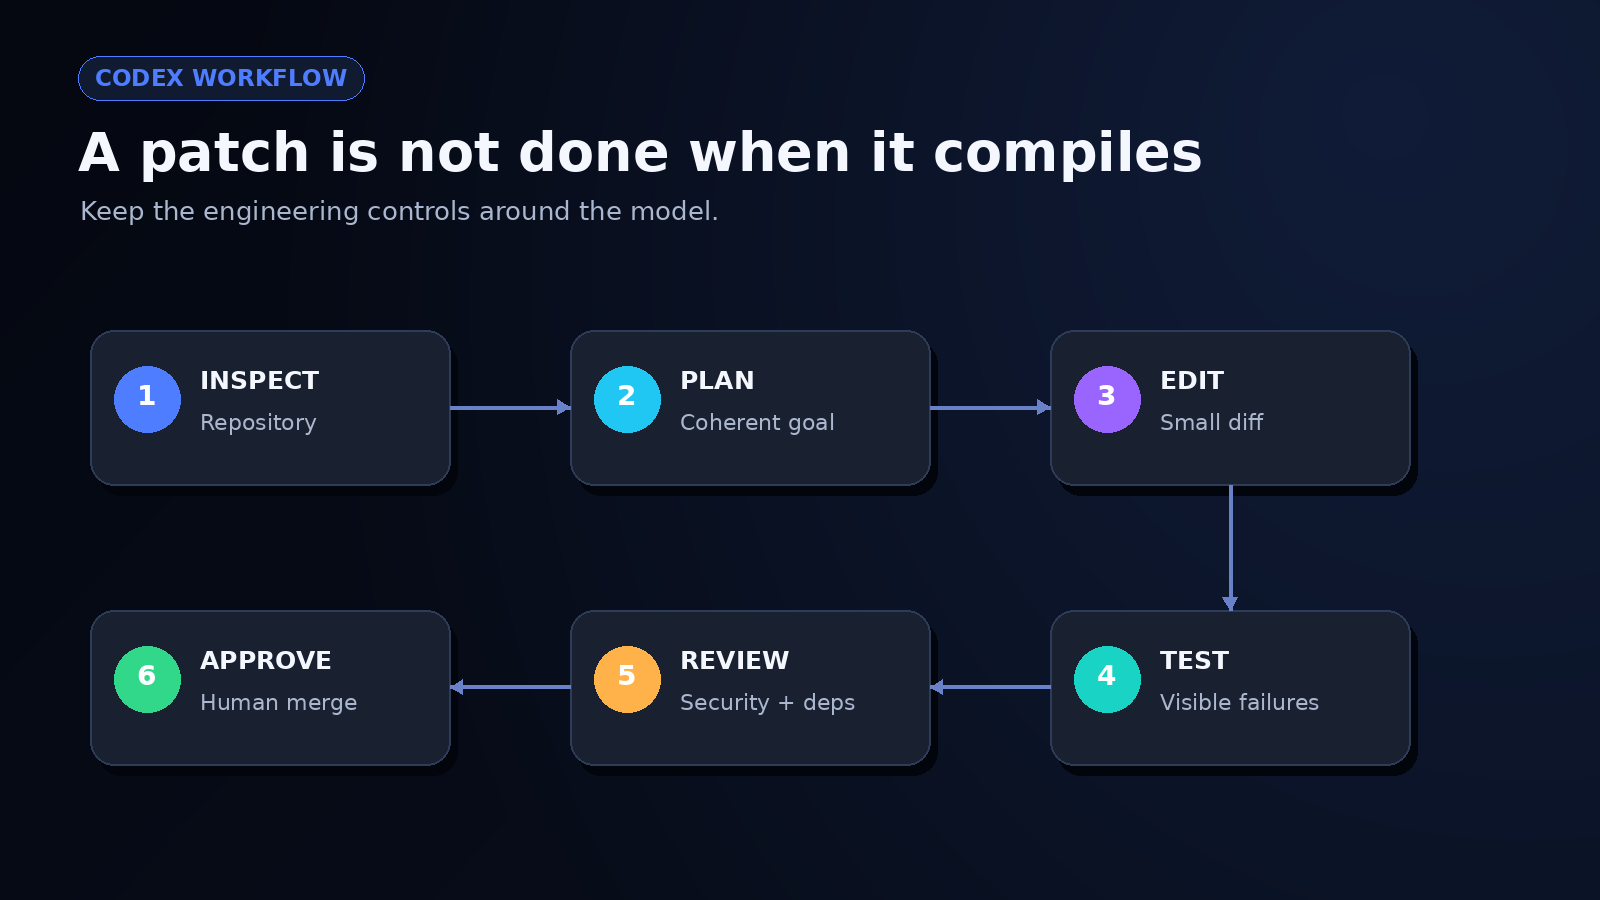
Abbildung 9. Prüfen, planen, bearbeiten, testen, überprüfen und genehmigen
Produktions-Schutzmechanismen gelten weiterhin
Halte Änderungen klein genug, um sie zu überprüfen, pinne den Modell-Snapshot, wenn Reproduzierbarkeit wichtig ist, und beschränke Tools auf das minimal nötige Privileg. Führe Repository-Tests, Dependency-Scanning, Secret-Erkennung, statische Analyse und menschliche Diff-Review durch. Wenn der Agent deployen, Daten löschen oder Credentials rotieren kann, stelle diese Aktionen hinter eine explizite Genehmigung.
Ich bevorzuge außerdem ein Fehlerbudget: Definiere, wie viele Wiederholungen, Minuten oder Tokens eine Aufgabe verbrauchen darf, bevor sie an einen Menschen zurückgeht. Ohne diese Grenze kann ein Agent produktiv wirken, während er in zunehmend spekulativen Fixes kreist.
GPT-5.2 vs Gemini 3 hängt von der genauen Aufgabe ab
GPT-5.2 vs Gemini 3: Erklärt, dass das bessere KI-Modell von der Aufgabe abhängt, etwa Coding, Reasoning, Schreiben oder Recherche.
Die ehrliche Antwort auf "GPT 5.2 vs Gemini 3" ist ein Testdesign, kein universeller Gewinner. Genaue Varianten, Daten, Tools, Kontextgrößen, Reasoning-Einstellungen und Preise müssen protokolliert werden. Sonst kann ein Vergleich unbemerkt einem Modell Suche, Code-Ausführung oder ein größeres Zeitbudget zuschustern.
| Entscheidungsfaktor | Zu testende Frage |
|---|---|
| Ausgabequalität | Welches Modell besteht deine Aufgabenbewertung häufiger? |
| Coding | Welches erzielt die höhere Test-Pass-Rate mit kleineren, sichereren Diffs? |
| Langer Kontext | Welches ruft Fakten aus deinen Dateien genauer ab und kombiniert sie? |
| Tool-Nutzung | Welches schließt den Workflow mit erholbaren Fehlern und nutzbaren Logs ab? |
| Latenz | Was sind Median- und 95.-Perzentil-Antwortzeiten? |
| Kosten | Was sind die Gesamtkosten pro akzeptiertem Ergebnis nach Wiederholungen und Korrektur? |
| Governance | Welche Daten-, Aufbewahrungs-, Regions- und Audit-Kontrollen passen zu deinem Anwendungsfall? |
Führe dieselbe direkte Vergleichsauswertung durch
Gib beiden Modellen dieselben Prompts, Quelldateien, Tools, Zeitbudgets und Bewertungsmaßstäbe. Randomisiere die Aufgabenreihenfolge und verbirg den Modellnamen vor Reviewern, wo möglich. Wiederhole repräsentative Fälle, statt eine einzelne schöne Antwort auszuwählen. Community-Reaktionen in der GPT‑5.2-Launch-Diskussion sind nützlich, um Beschwerden zu entdecken, die man testen sollte, aber sie sind keine kontrollierten Vergleiche.
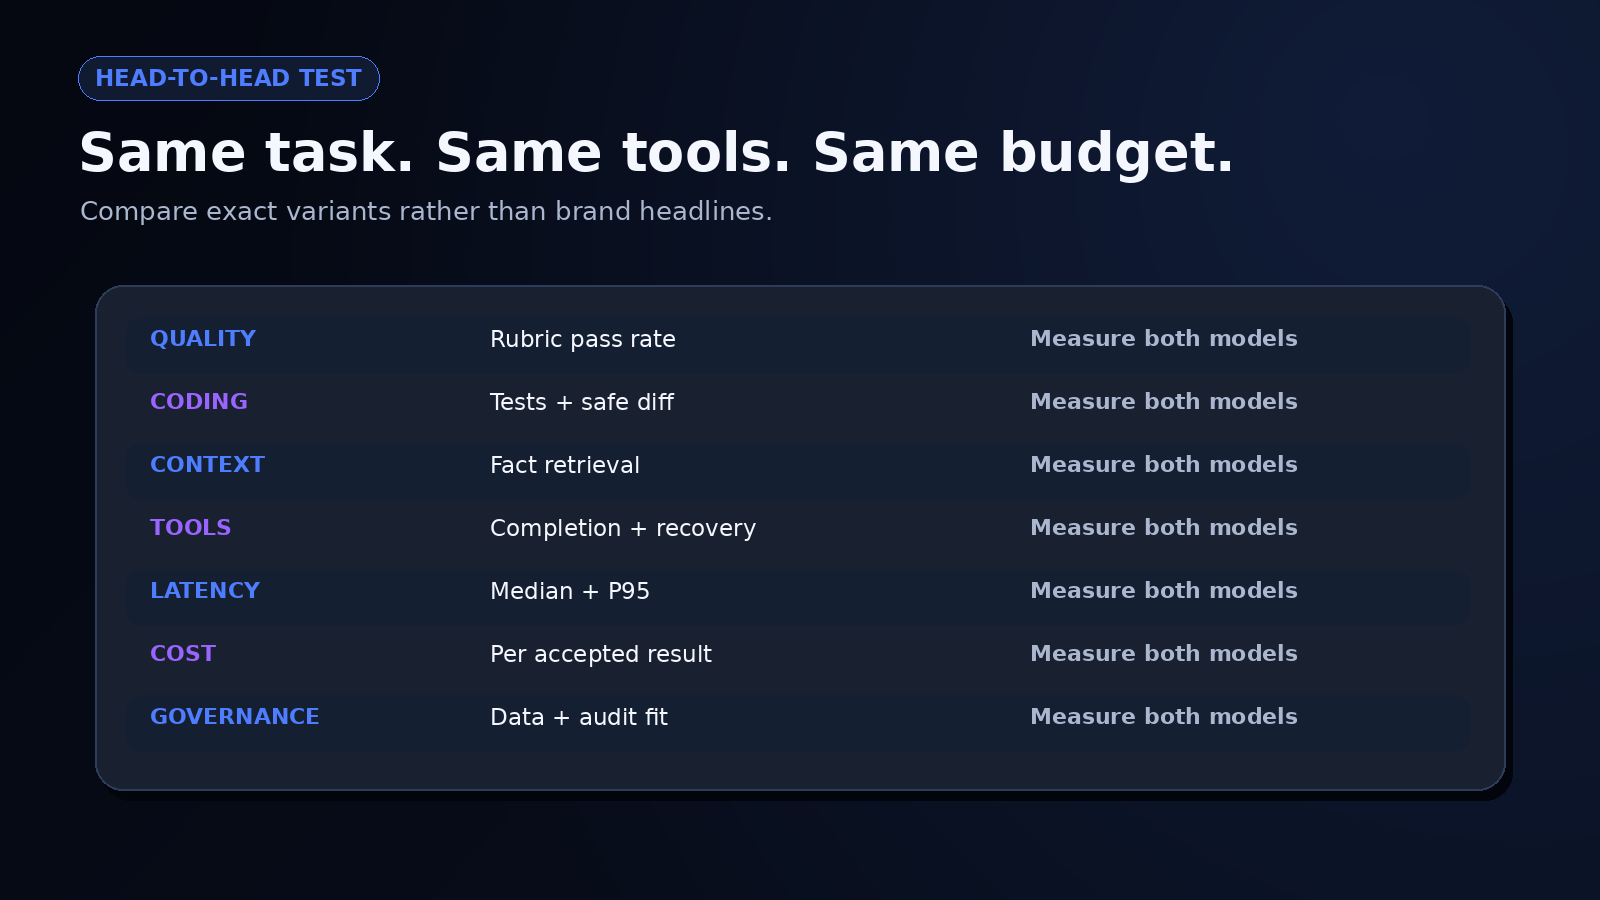
Abbildung 10. Qualität, Coding, Kontext, Tools, Latenz, Kosten und Governance
Wähle den risikoärmeren Workflow, nicht die bessere Schlagzeile
Dein Gewinner kann je Schritt unterschiedlich sein. Ein Modell plant vielleicht gut, ein anderes erzeugt sauberen Code, und eine kleinere Option kann Klassifizierung für einen Bruchteil der Kosten erledigen. Die richtige Architektur kann Arbeit routen, statt ein Modell zu zwingen, alles zu tun.
Für eine GPT 5.2 vs Gemini 3-Bewertung würde ich die einfachste Modell-Mischung wählen, die den Qualitätsschwellenwert erfüllt und bei Fehlern beobachtbar bleibt. Jeder zusätzliche Anbieter oder Fallback bringt mehr Routing-Logik, Bewertungsaufwand, Datenschutzprüfung und Incident-Komplexität. Modellvielfalt ist nützlich, wenn sie ein gemessenes Risiko reduziert.
Baue eine GPT‑5.2 Pro App in Enter Pro
Ich nutzte den KI-App-Builder von Enter Pro, um einen KI-Reviewer für Projekt-Briefings zu erstellen, mit GPT‑5.2 Pro als ausgewählter Integration. Das Ziel war, eine grobe App-Idee in Anforderungen, fehlende Informationen, Prioritäten und Abnahmekriterien zu verwandeln.
GPT‑5.2 Pro auswählen und die Preise ansehen
Ich fand GPT‑5.2 Pro im Modellkatalog und öffnete die Details. Das Panel zeigte eine Integrieren-Schaltfläche und Preise von** 2,1 Credits pro 1.000 Eingabe-Tokens** und** 16,8 Credits pro 1.000 Ausgabe-Tokens**. Dies sind die erfassten Plattformpreise.
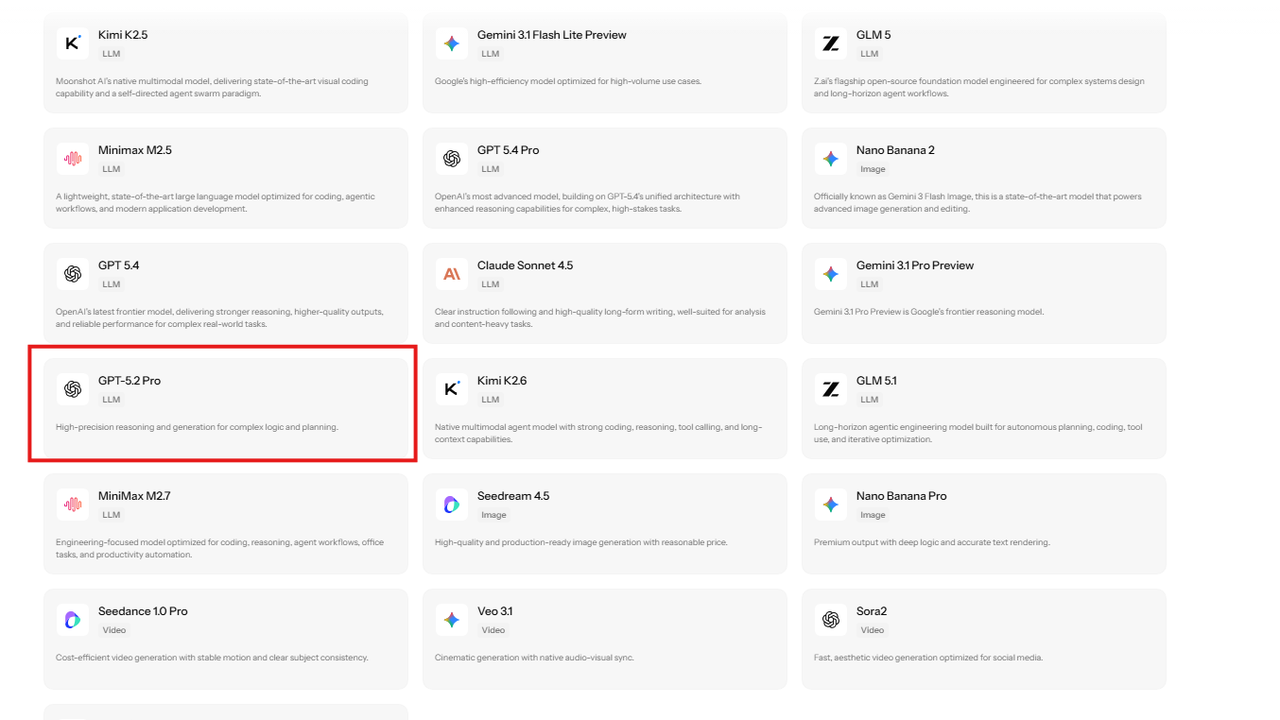
Abbildung 11. GPT‑5.2 Pro erscheint im Modellkatalog zusammen mit anderen verfügbaren Integrationen.
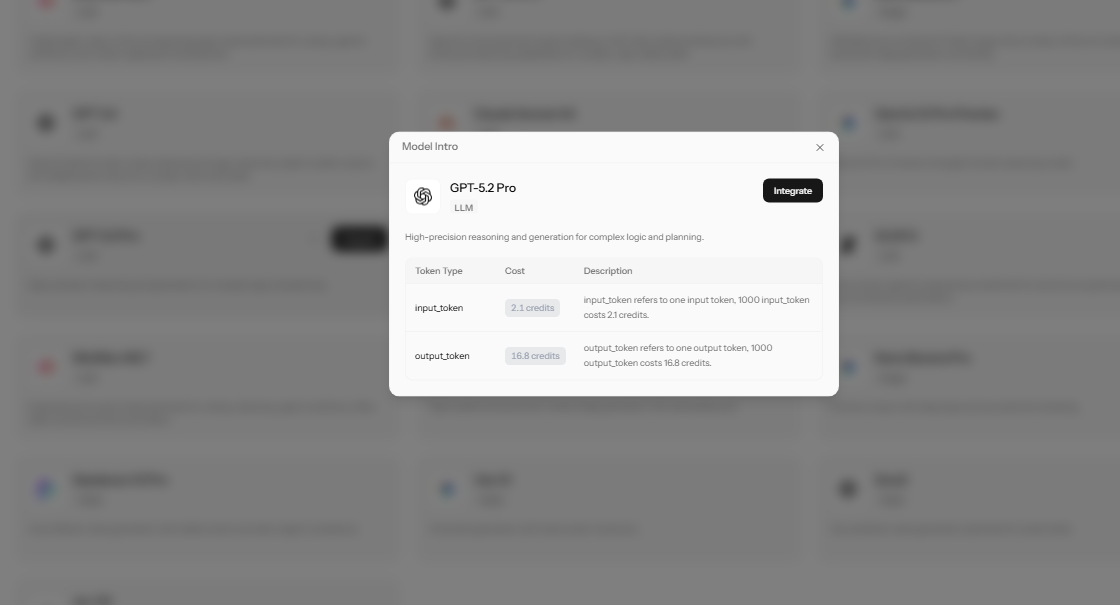
Abbildung 12. Das GPT‑5.2 Pro-Detailpanel zeigt die Integrieren-Steuerung und die Credit-Preise.
Das Modell anhängen und die App beschreiben
Die Projektanfrage hatte den GPT‑5.2 Pro-Chip angehängt. Ich bat um ein großes Briefing-Feld, eine Briefing überprüfen-Schaltfläche, und Antworten, die in fünf Abschnitte gegliedert sind: Projektzusammenfassung, wesentliche Anforderungen, Widersprüche und fehlende Informationen, Implementierungsprioritäten und Abnahmekriterien. Die Anfrage verlangte außerdem echte Lade- und Fehlerzustände.
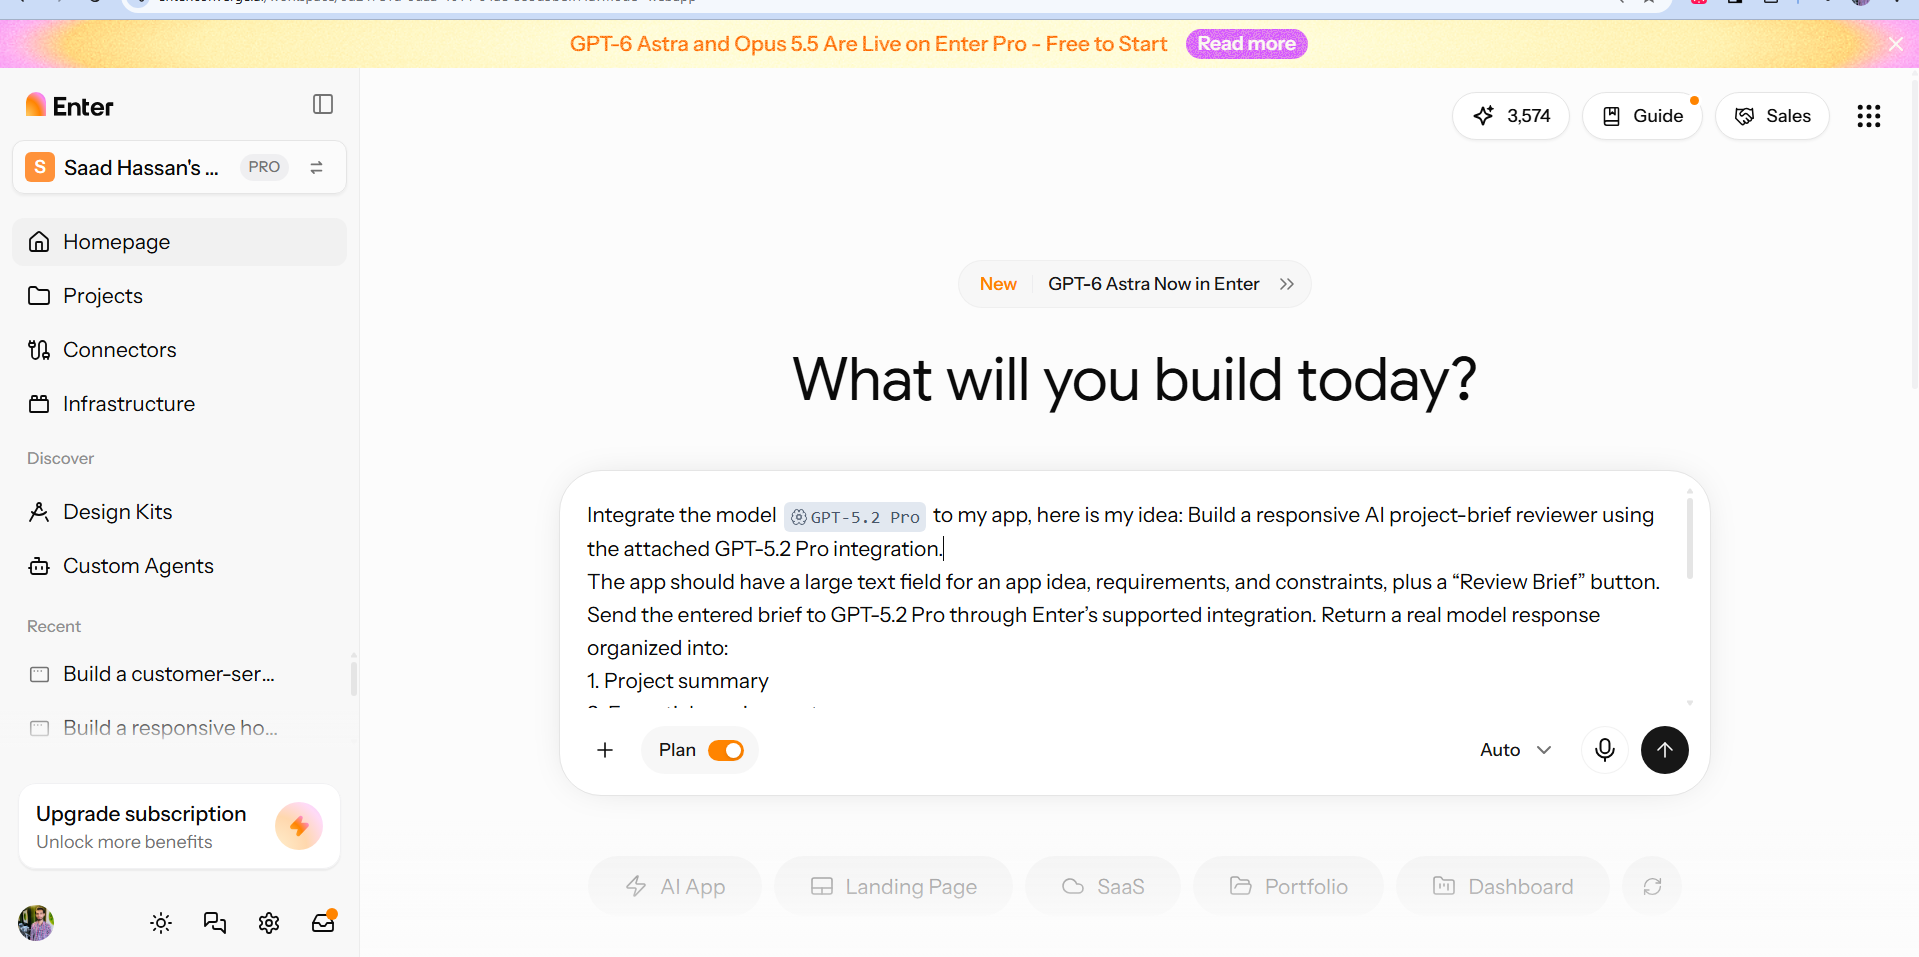
Abbildung 13. Der Projekt-Prompt bindet GPT‑5.2 Pro ein und legt Zweck und Antwortstruktur des Reviewers fest.
Den Build-Plan prüfen
Enter generierte einen Plan für eine Vite-, React- und Tailwind-Oberfläche mit einer Backend-Funktion, die die KI-Anfrage verarbeitet. Er spezifizierte Streaming-Ergebnisse, Klartext und keine gespeicherte Review-History. Das Belassen der privaten Zugangsdaten im Backend war Teil des Plans. Dieser Screenshot hält die vorgeschlagene Implementierung fest.
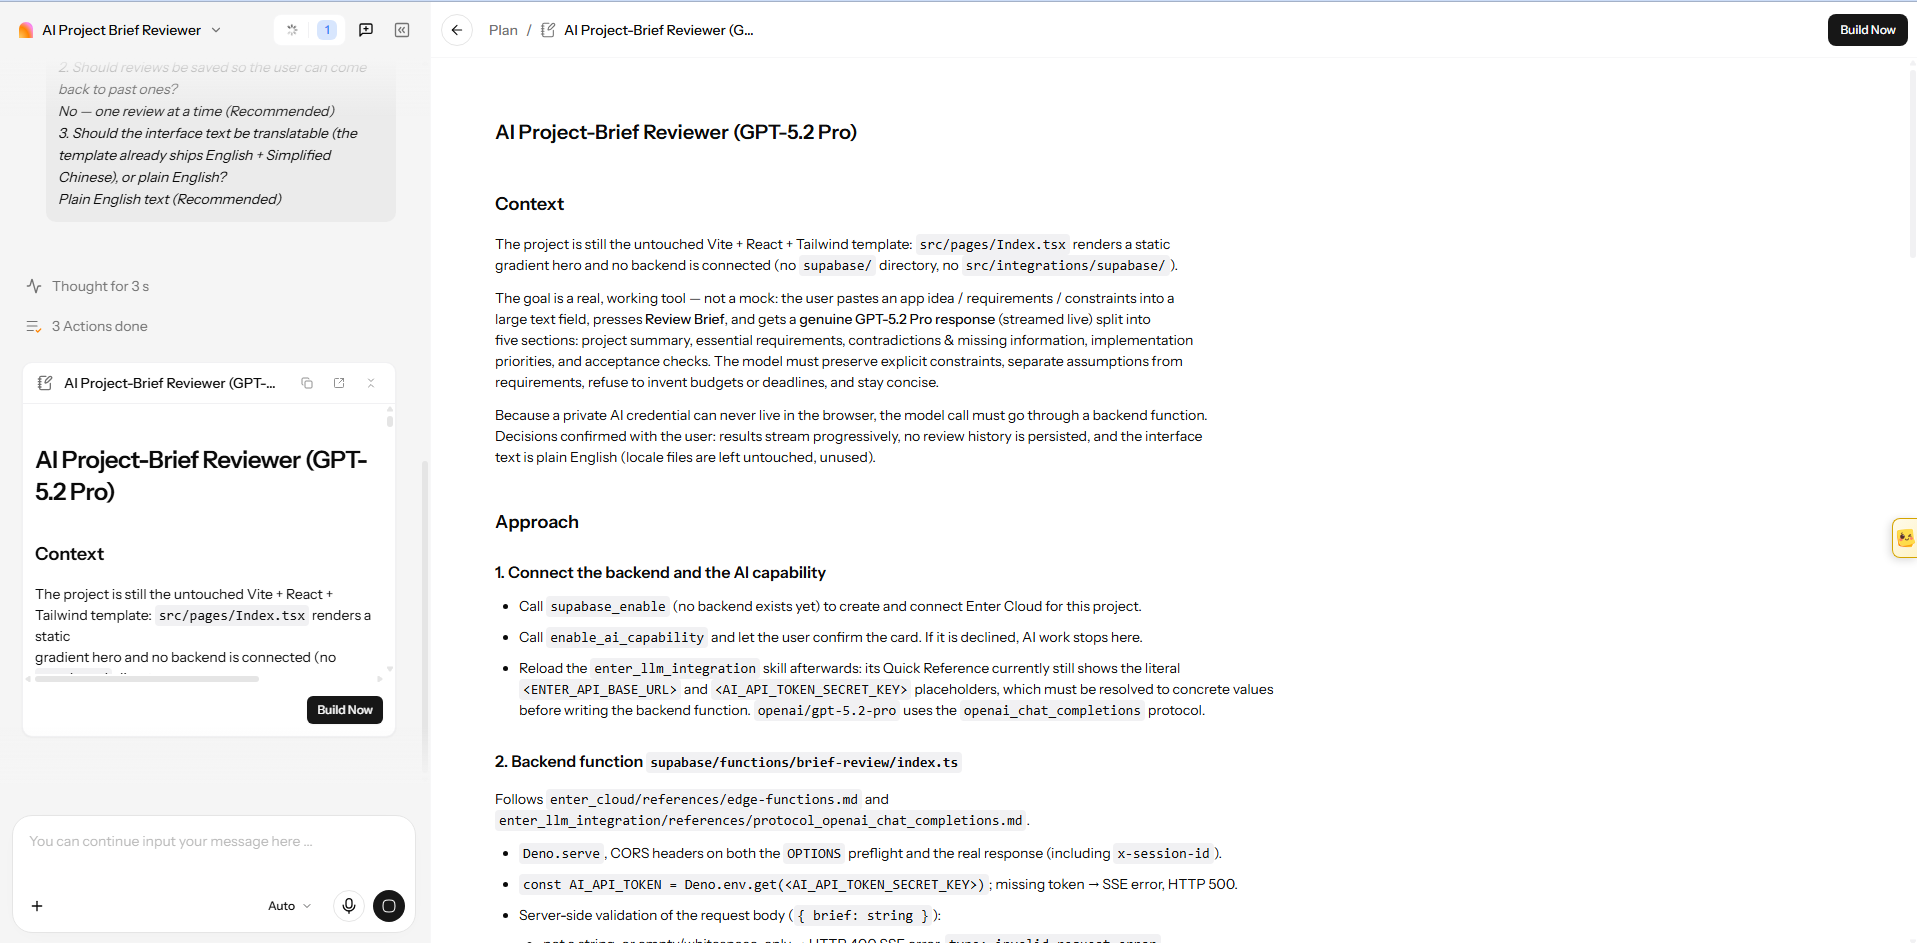
Abbildung 14. Der Build-Plan beschreibt die Oberfläche, die Backend-Anfrage, die Streaming-Ausgabe und die Handhabung der Zugangsdaten.
Das sichtbare Review untersuchen
Der Reviewer zeigte ein Briefing-Feld neben seinen Antwortpanels. Im erfassten Versuch gab ich die Anfrage zur Implementierungsprüfung in dieses Feld ein. Die Antwort stellte ihre Anforderungen unter den angeforderten Überschriften dar, während Streaming review und** Reviewing** sichtbar blieben. Dies zeigte die Antwortorganisation, wobei Vollständigkeit und Korrektheit noch zu prüfen sind.
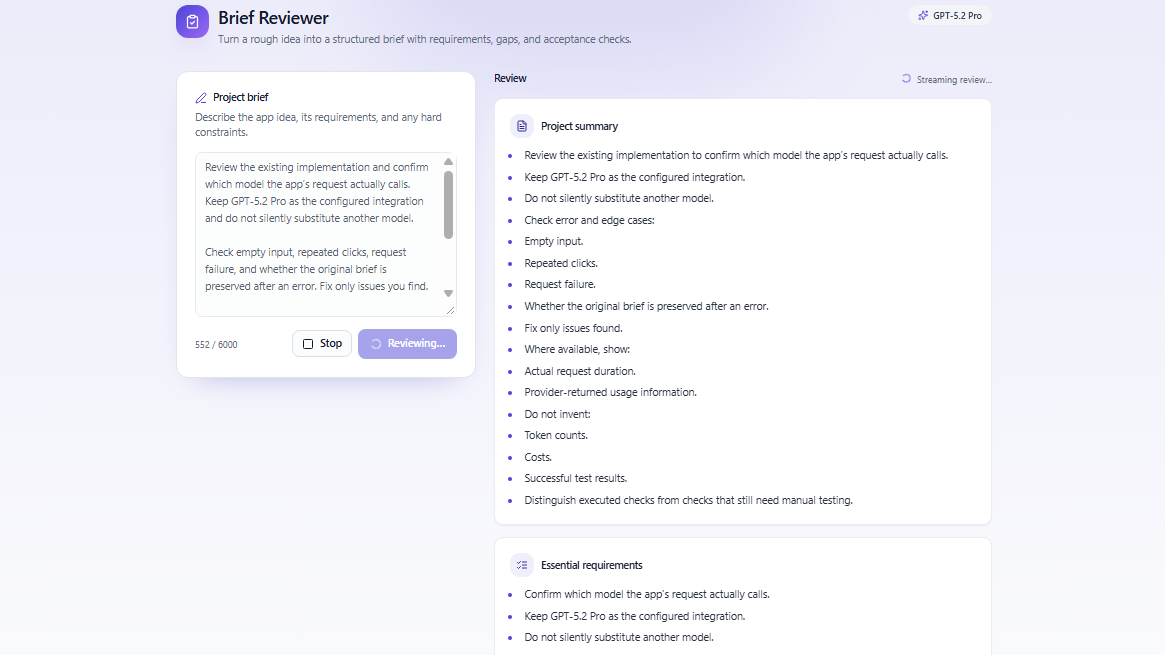
Abbildung 15. Der Review-Text erscheint unter den angeforderten Überschriften, während die Oberfläche weiterhin eine aktive Antwort anzeigt.
Für eine Reasoning-Prüfung verwende das Terminbriefing mit drei Technikern, 45-minütigen Aufträgen, 30-minütigem Fahrpuffer, Arbeitszeiten von 9 bis 17 Uhr, keinen Überlappungen und einer 12-Stunden-Umplanungsregel. Füge dann "erlaube zwei gleichzeitige Termine pro Techniker" hinzu und prüfe, ob die abgeschlossene Antwort den Konflikt erkennt. Dieses Ergebnis ist in diesen Screenshots nicht enthalten.
Den Anfrageverlauf und die Credit-Nutzung prüfen
Die zusätzliche Statusansicht kennzeichnete die Integration als GPT‑5.2 Pro, den Anbieter als Enter AI und das Protokoll als Responses API. Ihre Session enthielt keine Anfragen, null Eingabe- und Ausgabe-Tokens und null verbrauchte Nutzung. Diese Werte können die Dauer, das tatsächliche Routing oder die Gebühr der früheren Antwort nicht belegen.
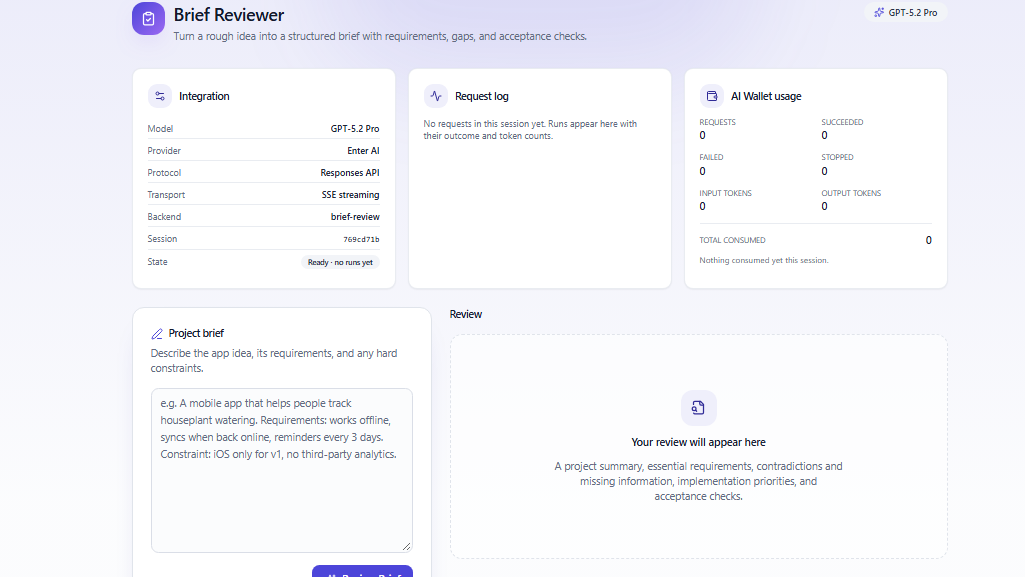
Abbildung 16. Die Integrations- und Nutzungspanels zeigen eine bereite Session ohne protokollierte Anfragen oder Verbrauch.
Bei den angezeigten Preisen würden beispielhaft 1.000 Eingabe-Tokens plus 500 abgerechnete Ausgabe-Tokens 10,5 Credits entsprechen. Das ist eine Schätzung, keine beobachtete Ausgabe. Um Kosten zu vergleichen, nutze abgeschlossene Anfragen, abgerechnete Nutzung, Wiederholungen und den Anteil der Reviews, die deinen Abnahmekriterien entsprechen.
Enter hält das ausgewählte Modell und das App-Briefing in einem Projekt zusammen. Baue deine GPT‑5.2 Pro App in Enter Pro und verifiziere die Integration vor der Veröffentlichung.
Fazit: GPT‑5.2 anhand einer konkreten Aufgabe bewerten
Der praktische Wert von GPT‑5.2 hängt von der Aufgabenqualität und akzeptablen Kosten ab. Das Reviewer-Projekt verbindet die Pro-Auswahl mit einer App-Oberfläche und organisiertem Review-Text. Eine fertiggestellte Antwort, verifizierte Constraints und ein abgeschlossener Anfrageverlauf werden noch benötigt, um Zuverlässigkeit und Kosteneffizienz zu beurteilen.
Wähle das günstigste Modell, das deinen Abnahmeschwellenwert erfüllt, wiederhole wichtige Fälle und behalte einen Erholungspfad für Fehler bei. Du kannst Enter Pro nutzen, um eine GPT‑5.2 Pro App zu bauen und zu verfeinern, und dann die Integration verifizieren, bevor du sie erweiterst.
FAQ zu Chat GPT 5.2
Wann wurde GPT-5.2 veröffentlicht?
OpenAI kündigte es am 11. Dezember 2025 an. Die API-Modelle und ChatGPT-Varianten begannen beim Launch, schrittweise auszurollen, obwohl sich Zugang und empfohlene Alternativen seitdem geändert haben.
Ist GPT-5.2 noch das neueste OpenAI-Modell?
Nein. Stand 9. Oktober 2026 dokumentiert OpenAI es als Modell der vorherigen Generation. Wer nach Chat GPT 5.2 sucht, sollte den Zugang über den ChatGPT-Picker vom Zugang über API oder Drittanbieter-Integration unterscheiden. Prüfe die genaue Variante und aktuelle Verfügbarkeit, bevor du ein Projekt startest.
Was ist das Kontextfenster von GPT-5.2?
Das dokumentierte Kontextfenster beträgt 400.000 Tokens, mit einer maximalen Ausgabe von 128.000 Tokens. Du solltest trotzdem Retrieval und Reasoning über deine tatsächlichen langen Dokumente testen.
Wie viel kostet die GPT-5.2-API?
Der Standard-API-Preis beträgt $1,75 pro Million Eingabe-Tokens, $0,175 pro Million zwischengespeicherter Eingabe-Tokens und $14 pro Million Ausgabe-Tokens. Tool-Gebühren, Reasoning, Wiederholungen und Review erhöhen die Aufgabenkosten.
Wie kann ich eine GPT‑5.2 Pro App mit Enter Pro bauen?
Wähle GPT‑5.2 Pro aus dem Modellkatalog, hänge die Integration an und beschreibe die Funktion, die deine App braucht. Für einen Reviewer von Projekt-Briefings gib die benötigten Eingaben und das Review-Format an. Prüfe die generierte Implementierung, dann verifiziere eine abgeschlossene Anfrage, um zu bestätigen, dass die Modellverbindung funktioniert.
Wie kann ich die Nutzung von GPT‑5.2 Pro in Enter Pro prüfen?
Prüfe die Anfrage- und Nutzungspanels der Integration, nachdem du eine repräsentative Aufgabe ausgeführt hast. Bestätige, dass die Anfrage erscheint, und prüfe dann Eingabe-Tokens, Ausgabe-Tokens und verbrauchte Credits. Berücksichtige Wiederholungen und längere Antworten bei der Kostenschätzung, unter Verwendung der aktuellen Plattformpreise.
Was ist GPT-5.2 Pro?
GPT 5.2 Pro ist ein Reasoning-Modell mit höherem Rechenaufwand für schwierige professionelle Aufgaben. Seine offiziellen API-Preise liegen bei $21 pro Million Eingabe-Tokens und $168 pro Million Ausgabe-Tokens, und manche Anfragen können mehrere Minuten dauern.
Unterstützt GPT-5.2 Bilder?
Ja. Es akzeptiert Bildeingaben und erzeugt Textausgaben. Audio und Video sind nicht als unterstützte native Eingaben aufgeführt, sodass diese Formate einen separaten Verarbeitungsschritt erfordern.
Ist GPT-5.2 besser als Gemini 3?
Es gibt keine universelle Antwort. Teste die genauen Varianten mit denselben Prompts, Dateien, Tools, Budgets und Bewertungsmaßstäben und vergleiche dann die Qualität akzeptierter Ergebnisse, Latenz, Kosten, Governance und Erholung von Fehlern.
Kann GPT-5.2 produktionsreifen Code erzeugen?
Es kann starken Code erzeugen, aber Produktionsreife entsteht durch den gesamten Engineering-Prozess: Tests, Diff-Review, Dependency- und Sicherheitschecks, eingeschränkte Tools, Staging, Monitoring und Rollback. Das Modell kann diese Kontrollen nicht ersetzen.





