
¿Cuál es el mejor LLM para programar en 2026? 6 modelos probados y comparados
Descubre el mejor LLM para programar en 2026. Comparamos modelos LLM locales y asistentes en la nube según precisión, privacidad y velocidad para optimizar tu flujo de trabajo.
Cuando nuestro equipo se propuso encontrar el mejor LLM para programar, enseguida nos dimos cuenta de que las puntuaciones de los benchmarks no son suficientes. Cada día nos enfrentamos a complejidades serias, como lidiar con bases de código enmarañadas o evaluar gigantes de backend tradicionales que chocan con los flujos de trabajo modernos.
Aprendimos que elegir un modelo depende por completo de los obstáculos concretos a los que te enfrentes. Mientras los modelos frontier en la nube ofrecen el razonamiento profundo que necesitamos para aplicaciones complejas, una arquitectura autoalojada es innegociable cuando se gestiona código empresarial propietario.
En esta guía compartimos nuestra experiencia de primera mano. Desglosamos nuestros criterios de evaluación, analizamos los seis mejores modelos que probamos, presentamos los agentes de desarrollo autónomos y revisamos el consenso de los desarrolladores. Descubrirás exactamente qué herramienta, desde el mejor LLM de código hasta los gigantes alojados en la nube, optimizará realmente tu ecosistema.
Criterios de evaluación clave para LLMs de desarrollo
Para separar los asistentes de código fiables de los simples bots conversacionales, nuestro equipo evaluó cada modelo según 5 métricas fundamentales que reflejan el desarrollo de software real:
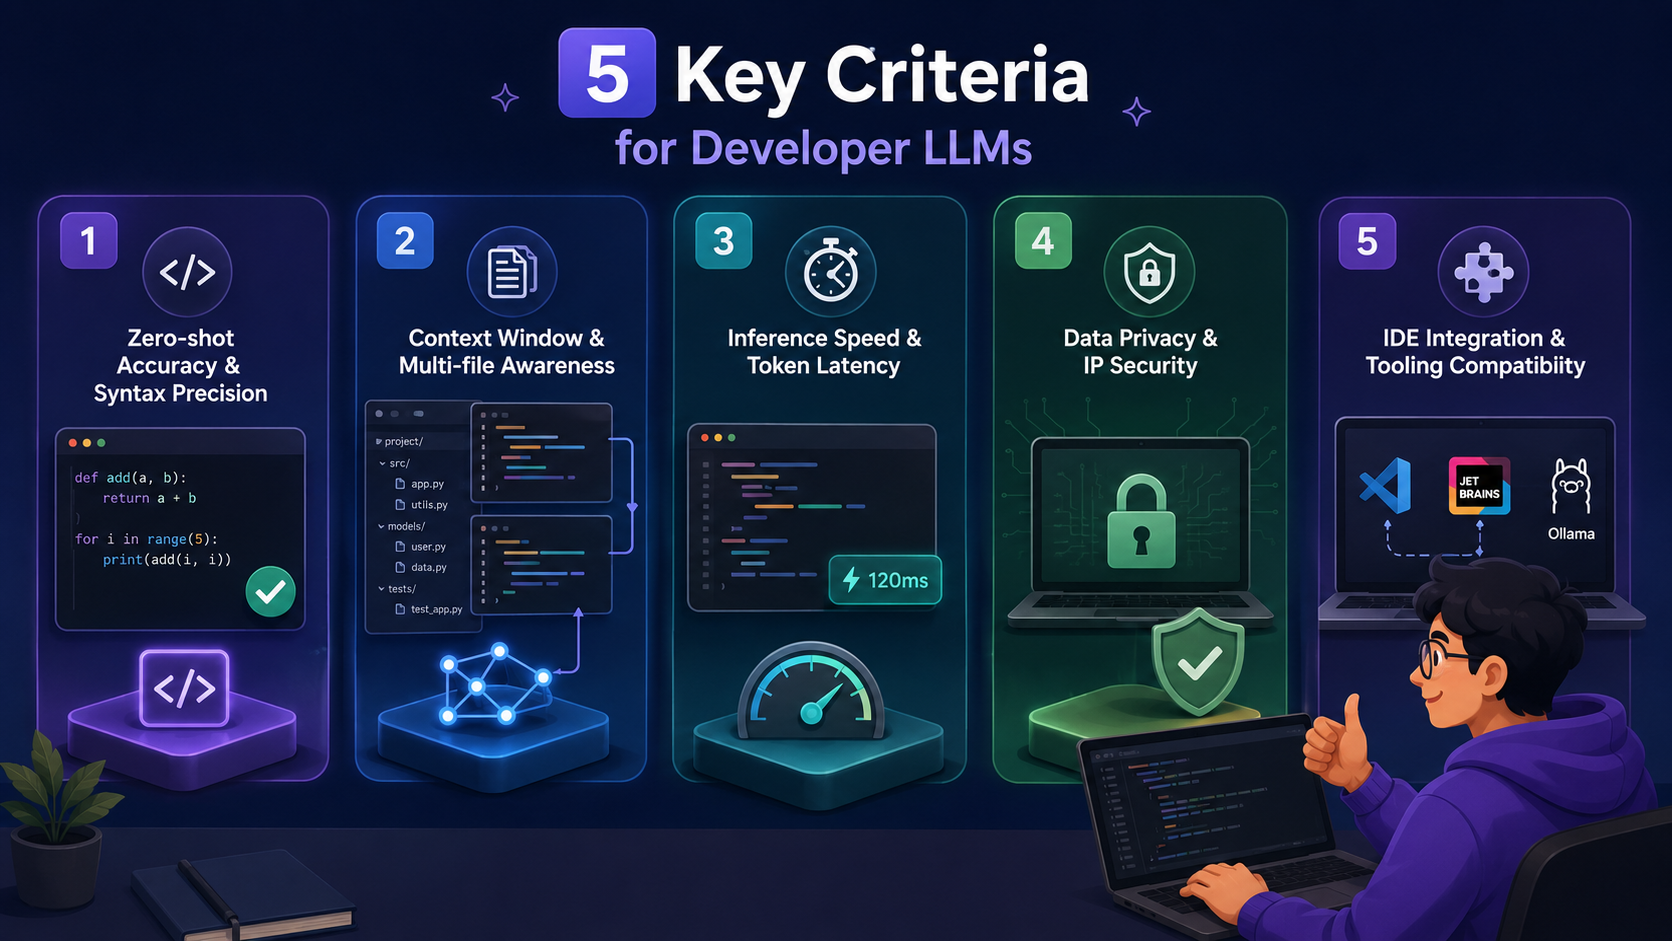
- Precisión zero-shot y exactitud sintáctica: Mide cuán fiablemente un modelo genera código correcto y funcional en su primer intento. Un modelo sólido escribe sintaxis limpia de inmediato, sin inventar librerías ficticias, referenciar APIs obsoletas ni introducir errores lógicos sutiles.
- Ventana de contexto y conciencia multiarchivo: El software moderno rara vez cabe en un solo archivo. Evaluamos la "memoria de trabajo" del modelo para ver cuán eficazmente rastrea variables interconectadas, dependencias y lógica arquitectónica en todo un proyecto multiarchivo sin confundirse.
- Velocidad de inferencia y latencia de tokens: La velocidad impacta directamente en el estado de flujo del desarrollador. Probamos los tiempos de respuesta para asegurar que las sugerencias en línea y el autocompletado en tiempo real aparezcan al instante, sin retraso de escritura perceptible.
- Privacidad de datos y seguridad de la propiedad intelectual: Proteger el código propietario es crítico para cualquier equipo. Revisamos las políticas de retención de datos de las APIs en la nube y probamos capacidades offline y aisladas para garantizar que el código empresarial sensible permanezca completamente privado.
- Integración con IDE y compatibilidad de herramientas: Un modelo potente solo es útil si se integra naturalmente en el flujo de trabajo diario de un desarrollador. Evaluamos lo fácil que resulta conectar cada modelo a editores populares como VS Code y JetBrains, así como a motores de ejecución locales como Ollama.
Los 6 mejores LLMs para programar en las principales categorías
Navegar por el panorama de la IA, que cambia rápidamente, requiere identificar el mejor LLM para programar en 2026 según tus limitaciones de hardware, requisitos de privacidad y la complejidad de tu flujo de trabajo arquitectónico:
| Nombre del modelo | Categoría | Fortaleza principal | Mejor para |
|---|---|---|---|
| Claude Opus 5 | Cloud frontier | Codificación agéntica compleja | Grandes refactorizaciones y bucles de agentes |
| GPT-5.6 Sol | Cloud frontier | Ejecución determinista | Tareas multietapa y prototipado |
| GLM-5.2 | Local/open-weight | Ventana de contexto de 1M de tokens | Codificación casi frontier autoalojada |
| DeepSeek V4-Pro | Local/open-source | Programación competitiva | Tareas API de alto volumen y matemáticas |
| Qwen3-Coder-Next | Ligero | Eficiencia por parámetro | Hardware local modesto |
| Gemini 3.7 Flash | Ligero/económico | Tareas agénticas complejas | Trabajo de alto volumen y refactorizaciones |
Modelos de IA cloud frontier (máximo razonamiento y contexto)
Estos modelos dependen de enormes clústeres de servidores remotos para procesar los prompts, lo que les permite manejar ventanas de contexto inmensas y razonamiento complejo multietapa que el hardware local simplemente no puede soportar. Son ideales para la planificación de arquitecturas de sistemas complejas.
- Claude Opus 5
Al evaluar las opciones para nuestro stack de desarrollo, encontramos que Claude Opus 5 destaca como el mejor LLM de código para ingeniería real, grandes refactorizaciones y bucles de agentes multietapa. Anthropic desarrolla el LLM Claude en niveles como Haiku 4.5, Sonnet 5, Opus 5 y Fable 5. Actualmente lidera las clasificaciones verificadas para tareas de software complejas.
| Versión | Tamaño de memoria (contexto) | Mejor para | En términos simples |
|---|---|---|---|
| Claude Fable 5 | Masivo (1M tokens) | Investigación especializada y tareas de largo alcance | El modelo ultra premium creado para trabajo científico y de ciberseguridad complejo. |
| Claude Opus 5 | Masivo (1M tokens) | Refactorización intensiva y bucles de agentes | El cerebro de primer nivel para bases de código multiarchivo complejas. |
| Claude Sonnet 5 | Masivo (1M tokens) | Desarrollo diario equilibrado | El fiable caballo de batalla diario para tareas de codificación cotidianas. |
| Claude Haiku 4.5 | Alto (200K tokens) | Scripts rápidos y depuración ágil | Modelo de nivel gratuito: El sprinter ligero creado para velocidad y coste cero. |
Pros:
- Ofrece una precisión de codificación zero-shot líder en la industria junto con un comportamiento proactivo de verificación.
- Cuenta con una ventana de contexto masiva capaz de absorber bases de código grandes y multiarchivo sin esfuerzo.
- Obtiene puntuaciones excepcionales en los principales benchmarks de codificación agéntica.
Contras:
- Requiere conectividad a internet constante con estricta dependencia de la nube para funcionar.
- Los costes de uso de tokens pueden escalar rápidamente en equipos de desarrollo a gran escala.
Mejor para: Refactorización de código a gran escala, diseño de sistemas full-stack y flujos de trabajo agénticos complejos.
- GPT-5.6 Sol
Este es un modelo insignia versátil con amplia cobertura de sintaxis de lenguajes y una integración de ecosistema generalizada. OpenAI recientemente avanzó la frontera de precio-rendimiento con GPT-5.6. Funciona como un caballo de batalla diario muy fiable para desarrolladores que manejan trabajo de software con eficiencia.
| Versión | Velocidad | Compatible con | En términos simples |
|---|---|---|---|
| GPT-5.6 Sol | Rápido | IDEs principales y frameworks de agentes | El asistente robusto que maneja con firmeza tareas multietapa. |
| GPT-5.6 Terra | Moderado | Herramientas de desarrollo estándar | La versión API equilibrada para resolver problemas paso a paso de forma estable. |
| GPT-5.6 Luna | Ultrarrápido | Web y herramientas ligeras | Modelo de nivel gratuito: El ayudante diario rápido y gratuito para generación rápida de código. |
Pros:
- Ejecución determinista estable a lo largo de tareas largas y multietapa sin desviarse del rumbo.
- Compatibilidad profunda del ecosistema con las principales extensiones y plataformas de desarrollo.
- Cobertura de entrenamiento integral en lenguajes de programación poco comunes y heredados.
Contras:
- Ocasionalmente produce boilerplate excesivamente extenso en lugar de fragmentos concisos.
- La memoria de contexto puede degradarse en sesiones de chat muy largas.
Mejor para: Tareas deterministas multietapa, prototipado rápido e integración de API.
Los mejores LLMs locales y de código abierto (privacidad y personalización empresarial)
Para las organizaciones que priorizan la seguridad de la propiedad intelectual, ejecutar modelos LLM locales offline garantiza que ningún código propietario se transmita jamás a un servidor de terceros. Estos modelos ofrecen un enorme potencial para el cumplimiento normativo empresarial.
- GLM-5.2
El mejor modelo de codificación de pesos abiertos disponible, que ofrece un enorme potencial de ajuste fino. GLM-5.2 es un modelo insignia creado para tareas de largo alcance y ofrece esta capacidad con un sólido contexto de 1M de tokens.
| Versión | Equipo necesario | Nivel de potencia | En términos simples |
|---|---|---|---|
| GLM-5.2 (grande) | Centro de datos empresarial pesado | Inteligencia de primer nivel | El mejor codificador de pesos abiertos con una ventana de memoria masiva de 1M. |
| GLM-5.2 (pequeño) | Portátil estándar | Bueno para ayuda cotidiana | 100% gratis y local: Funciona directamente en tu portátil, sin conexión y sin cuotas de API. |
| GLM-5.2 Cloud | Navegador web/API | Alto razonamiento | Acceso web gratuito: La herramienta basada en navegador para experimentar sin configuración. |
Pros:
- Modelo de pesos abiertos muy competitivo para tareas de ingeniería de largo alcance.
- Ventana de contexto masiva de un millón de tokens para absorber repositorios enteros localmente.
- Licencia abierta permisiva que acomoda el desarrollo corporativo y comercial.
Contras:
- Requiere hardware empresarial de alta gama para aprovechar plenamente la ventana de contexto de 1M de tokens localmente.
- Los modelos de pesos abiertos son gratuitos de descargar, pero operarlos a escala exige recursos de servidor costosos.
Mejor para: Autoalojar un codificador casi frontier y mantener una privacidad de datos empresarial absoluta.
- DeepSeek V4-Pro
Un modelo de alto rendimiento diseñado específicamente para tareas de codificación avanzadas. DeepSeek desarrolla y libera como código abierto LLMs frontier. Rinde muy por encima de su categoría en lógica matemática y estructuración algorítmica compleja, ofreciendo una enorme configuración de 1,6 billones de parámetros para generación de texto intensiva.
| Versión | Fortaleza principal | Mejor para | En términos simples |
|---|---|---|---|
| DeepSeek V4-Pro | Programación competitiva y matemáticas | Repositorios de nivel empresarial | Un cerebro de codificación especializado que destaca en algoritmos y lógica compleja. |
| DeepSeek V4 | Razonamiento general y sintaxis | Scripting diario e investigación | Versión web gratuita: Un chatbot de propósito general para escritura cotidiana y código básico. |
| DeepSeek-Coder 7B | Ejecución ligera | Desarrollo local offline | 100% gratis y local: Un modelo privado y sin coste que puedes ejecutar en tu propio PC. |
Pros:
- Destaca enormemente en tareas algorítmicas y de programación competitiva.
- Proporciona privacidad de datos absoluta al autoalojarse para cumplir estrictas normas de residencia de datos.
- Amplia capacidad de razonamiento matemático y capacidades API de alto volumen.
Contras:
- Las configuraciones de parámetros completos exigen VRAM de GPU de nivel empresarial.
- La configuración y el ajuste fino por cuantización requieren conocimientos técnicos avanzados.
Mejor para: Repositorios empresariales sensibles a la privacidad, tareas API de alto volumen y resolución de problemas algorítmicos.
Modelos de codificación especializados y ligeros (autocompletado rápido y baja latencia)
Estos modelos están muy cuantizados y optimizados explícitamente para ejecutarse de forma nativa en segundo plano en portátiles de consumo u operar de forma rentable en la nube. Actúan estrictamente como asistentes rápidos, maximizando la eficiencia.
- Qwen3-Coder-Next
Un modelo altamente eficiente y especializado en código, optimizado para el autocompletado multilenguaje en hardware de consumo estándar. Los últimos modelos Qwen3 adoptan modos de pensamiento híbridos que permiten controlar con flexibilidad el rendimiento de razonamiento, la velocidad y los costes.
| Versión | Velocidad de respuesta | Alcance de idiomas | En términos simples |
|---|---|---|---|
| Qwen3-Coder-Next | Rápido | 90+ lenguajes de programación | El motor insignia de pesos abiertos para configuraciones serias de desarrollo local. |
| Qwen3-Coder (7B) | Instantáneo | 90+ lenguajes de programación | 100% gratis y local: Como un texto predictivo para código que funciona con fluidez en portátiles estándar. |
| Qwen-Chat | Instantáneo | Codificación estándar y lenguaje natural | Versión web gratuita: Un ayudante conversacional rápido y sin coste para comprobaciones de sintaxis. |
Pros:
- Ofrece excelente eficiencia de codificación por parámetro para configuraciones locales ligeras.
- Funciona con fluidez en hardware de consumo estándar y despliegues locales modestos con una sobrecarga de recursos mínima.
- Fuerte soporte sintáctico multilingüe que abarca más de 90 lenguajes de programación.
Contras:
- Profundidad de razonamiento limitada al planificar arquitecturas de software completas.
- Ventana de retención de contexto más pequeña en comparación con los grandes modelos en la nube.
Mejor para: Autocompletado línea por línea y desarrolladores que ejecutan modelos en portátiles estándar.
- Gemini 3.7 Flash
Un asistente de codificación fluido diseñado explícitamente para operaciones en la nube económicas y configuraciones agénticas complejas. Gemini 3.7 Flash es el más adecuado para abordar tareas agénticas complejas a gran escala.
| Versión | Cómo ayuda | Dónde se ejecuta | En términos simples |
|---|---|---|---|
| Gemini 3.7 Flash | Tareas agénticas complejas a gran escala | API en la nube | Un asistente en la nube de alta velocidad para bases de código grandes y flujos de trabajo complejos. |
| Gemini 3.5 Flash-Lite | Tareas de alto volumen | API en la nube | Nivel API gratuito generoso: Un modelo ligero creado para eficiencia e inteligencia. |
| Gemini Web | Chat general y fragmentos de código | Navegador web | Versión web gratuita: Un asistente simple y gratuito para redactar funciones y responder preguntas. |
Pros:
- Increíblemente eficiente para flujos de trabajo de agentes de alto volumen.
- Maneja ventanas de contexto masivas, permitiéndole leer bases de código enormes con facilidad.
- Velocidades rápidas de entrega de tokens para depuración rápida y ediciones en tiempo real.
Contras:
- Funciona estrictamente como una API en la nube, lo que significa que no puede aislarse ni autoalojarse para una privacidad extrema.
- Puede requerir ajustes de prompt para igualar la estricta rigurosidad de formato de Claude o GPT.
Mejor para: Codificación en la nube rentable, trabajo de agentes de alto volumen y tareas de contexto largo.
Cómo probamos estos LLMs
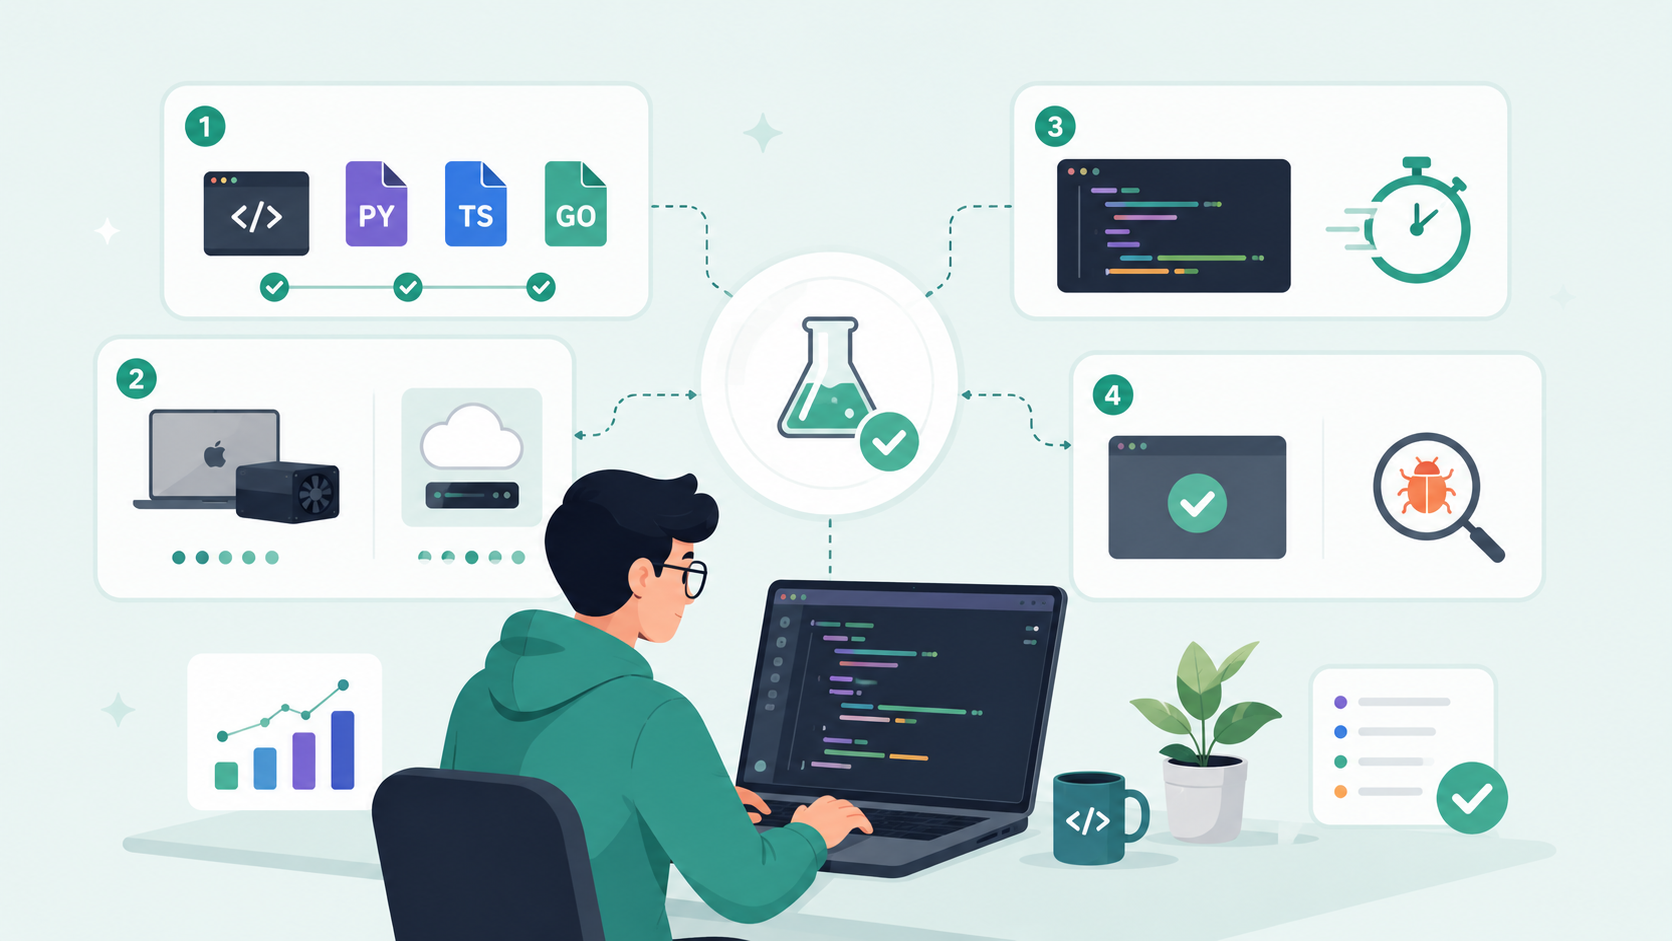
Probamos cada modelo mediante un marco técnico estrictamente reproducible para eliminar el sesgo subjetivo. Nuestra suite de pruebas combina benchmarks de desarrolladores establecidos con desafíos prácticos de ingeniería del mundo real.
Prompting de línea base controlada
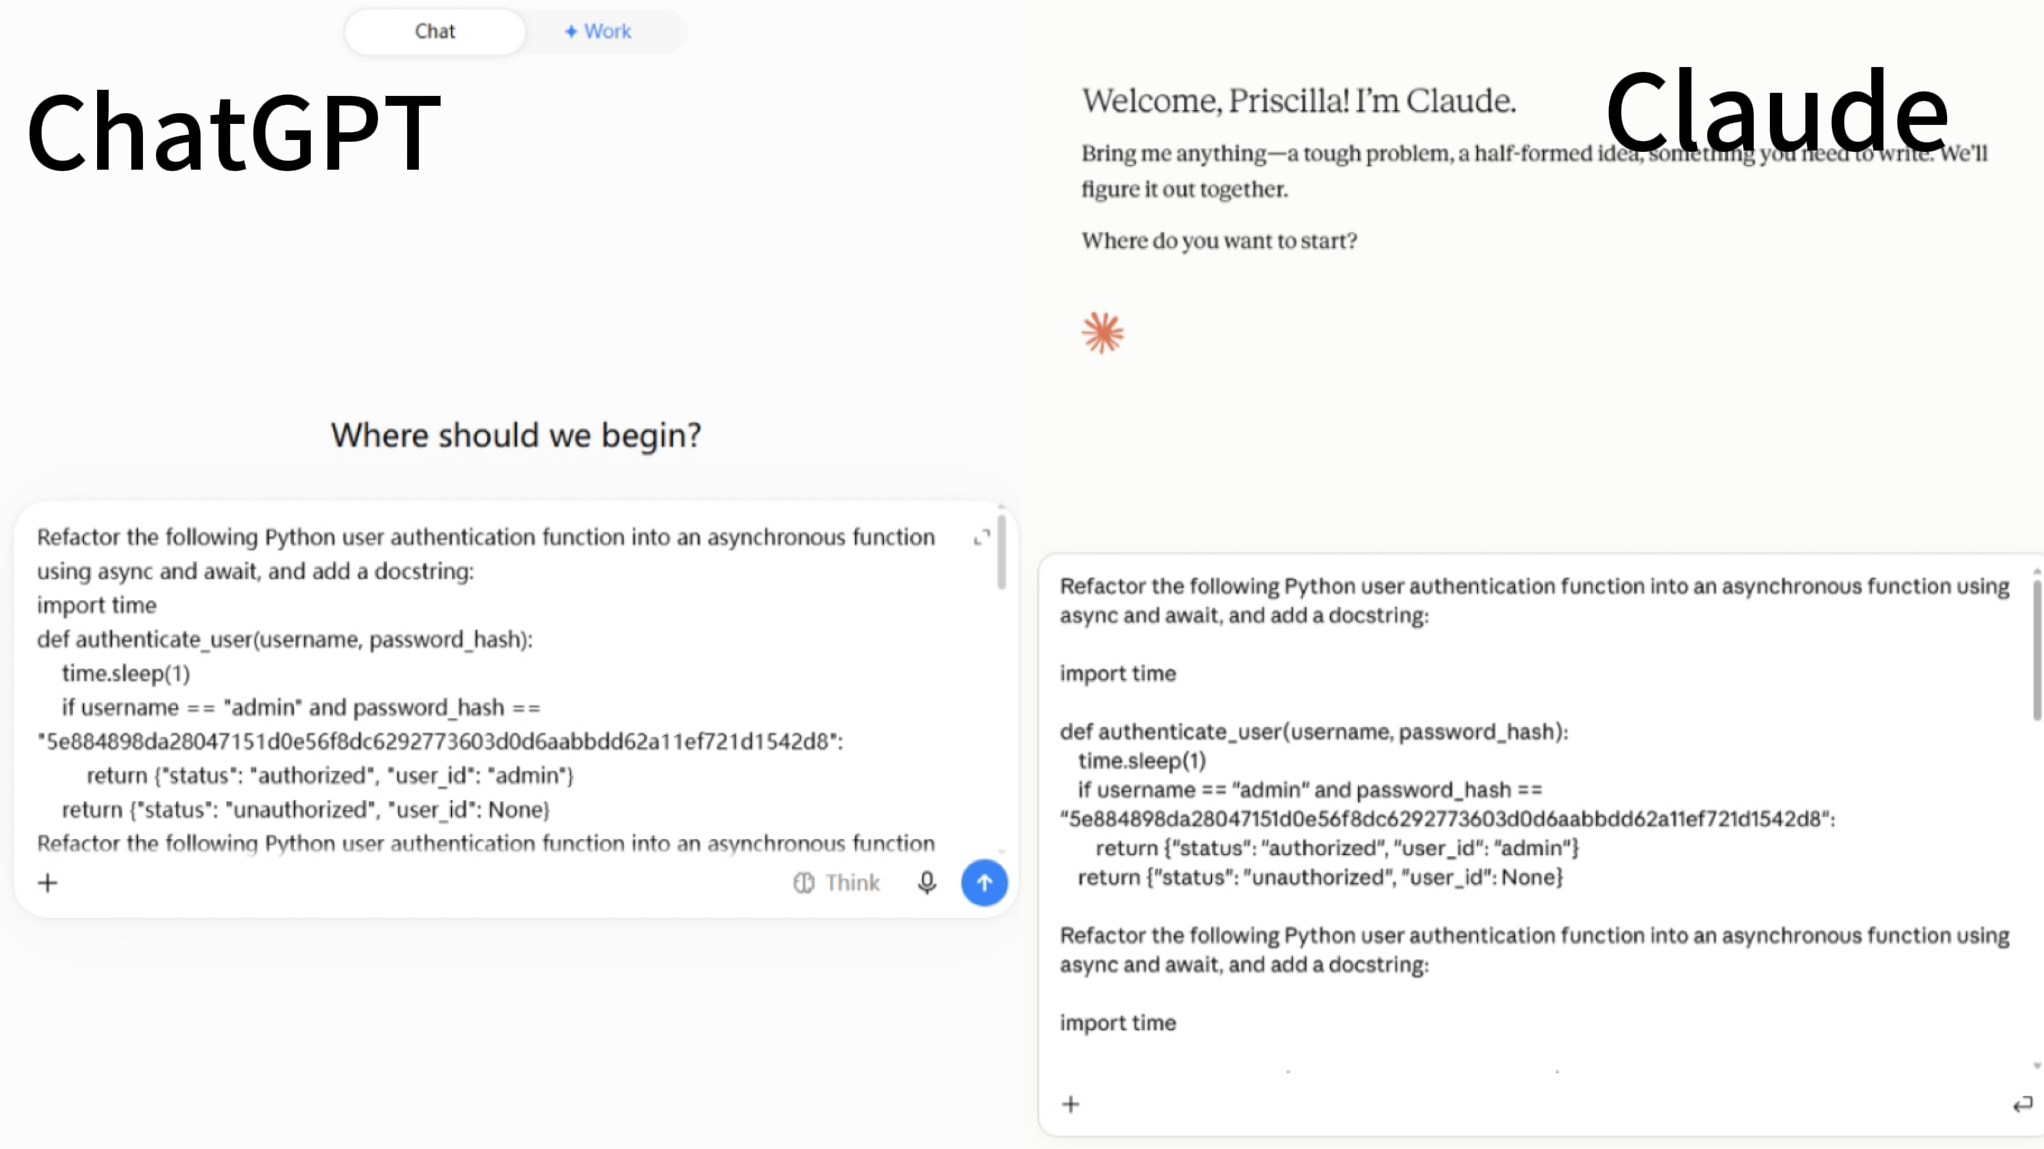
Para probar el razonamiento puro en 2026, enviamos 5 prompts idénticos de refactorización arquitectónica directamente a las interfaces web nativas de líderes de la industria como ChatGPT y Claude.
Paso 1: Preparar 5 prompts idénticos de refactorización arquitectónica
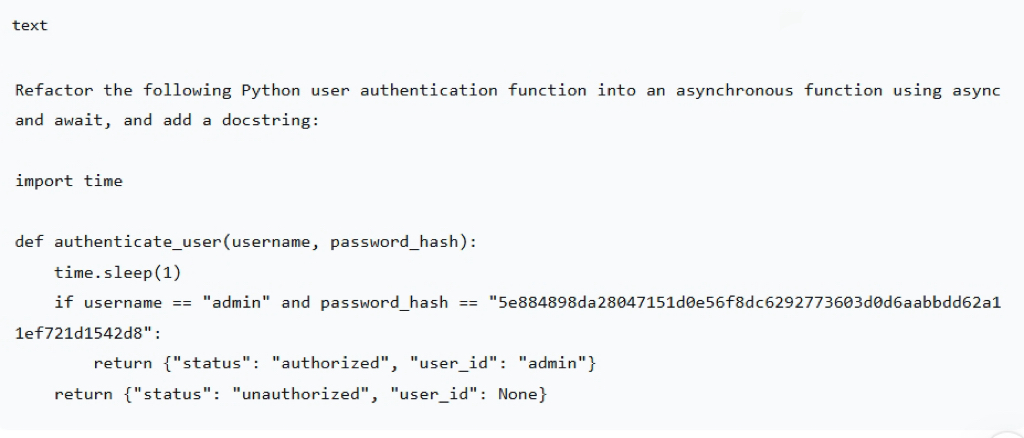
Primero, escribí un prompt de refactorización arquitectónica unificado y lo copié 5 veces, asegurándome de que el contenido fuera exactamente igual. A continuación se muestra un prompt de ejemplo:
Paso 2: Enviar los prompts en las interfaces nativas de ChatGPT/Claude
Abrí las interfaces web de ChatGPT y Claude, pegué y envié los prompts uno por uno, y registré completamente la respuesta cada vez.
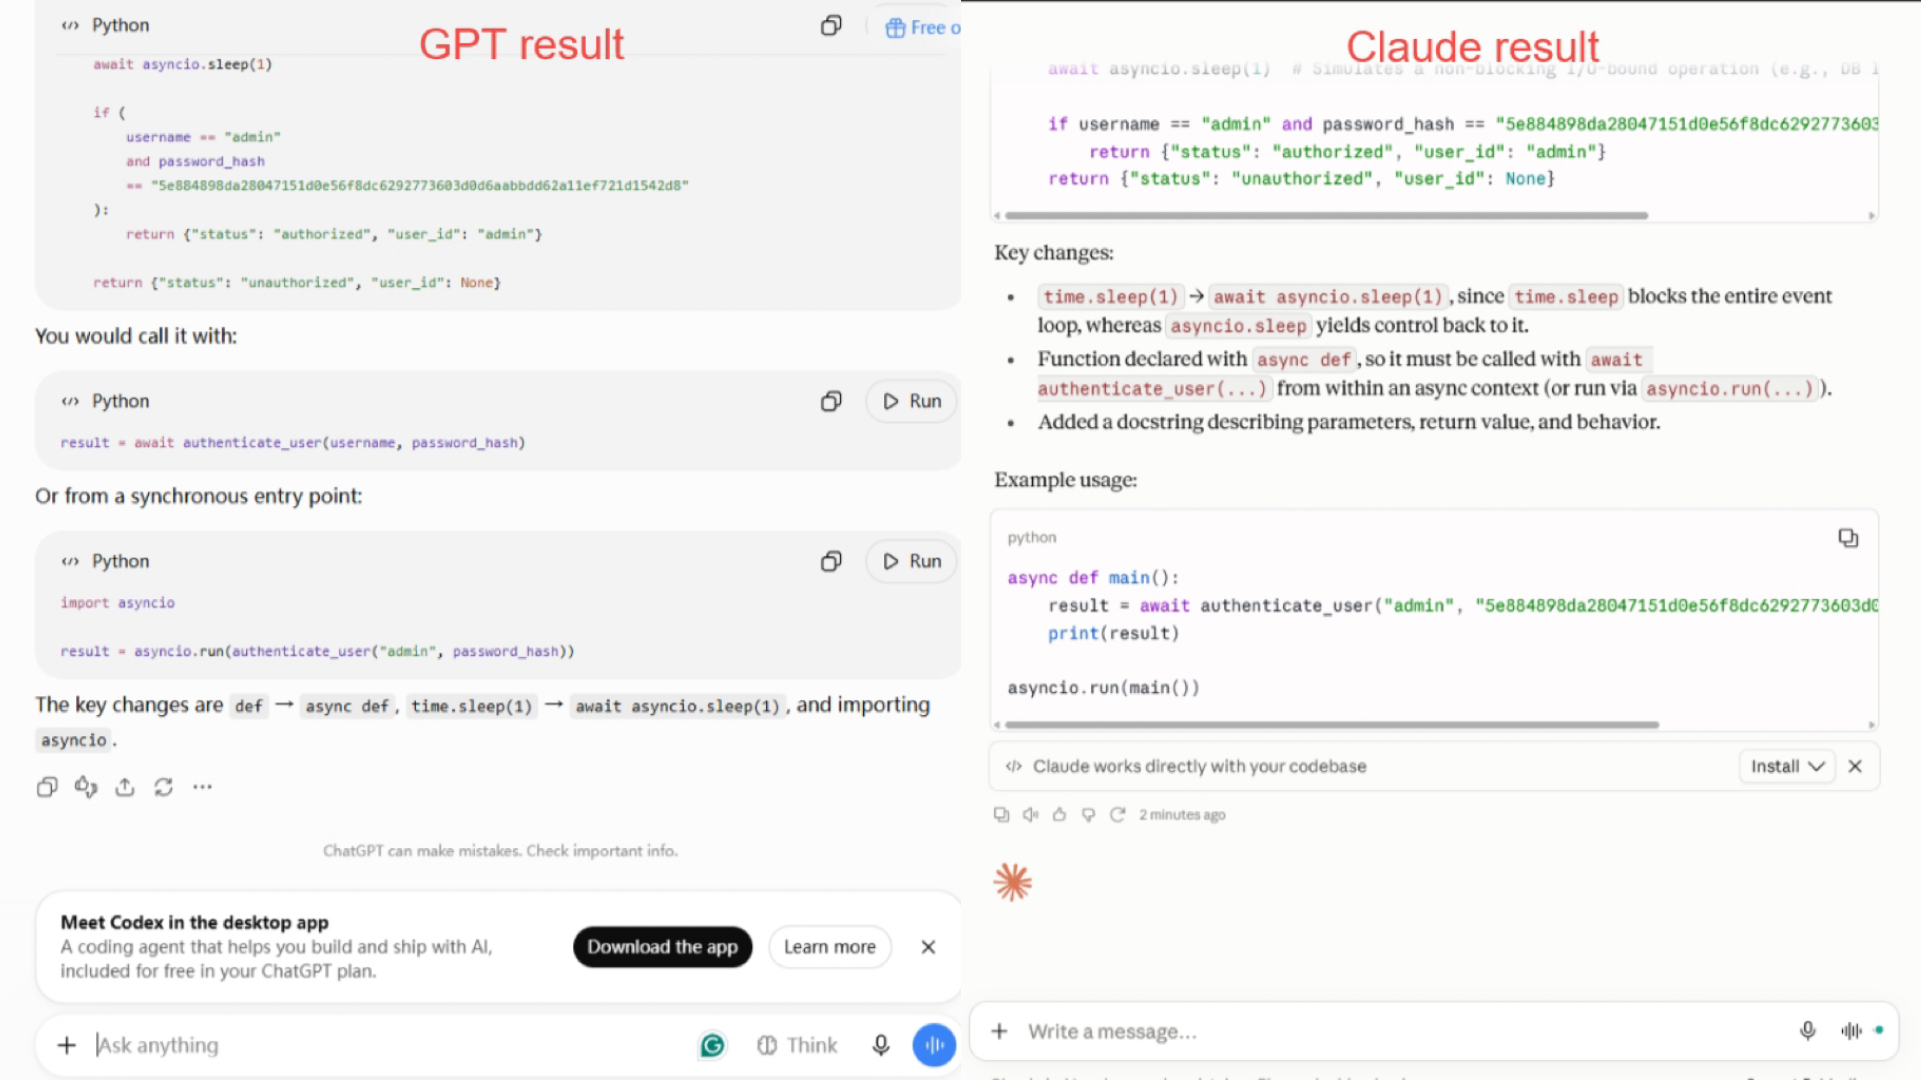
Paso 3: Evaluar la capacidad de manejo de lógica multiarchivo
Tras que cada herramienta entrega sus resultados, evaluamos su capacidad de razonamiento real respectiva. Tomando a ChatGPT y Claude como ejemplo, ambos modelos completaron correctamente la misma refactorización, pero encontré que los estilos y énfasis de salida difieren: ChatGPT tiende a dar el resultado más un uso conciso, mientras que Claude tiende a explicar los principios subyacentes y enfatizar las restricciones. Esto refleja sus diferentes estilos de razonamiento y expresión bajo la misma entrada.
Perfilado de sobrecarga de hardware local
Los modelos locales ofrecen privacidad de datos completa, pero solo si funcionan de manera eficiente en hardware práctico. Perfilamos modelos ligeros de pesos abiertos como Qwen3-Coder (7B) y DeepSeek-Coder directamente en una estación de trabajo local.
- Monitoreamos picos de VRAM y cargas de CPU durante la generación máxima de tokens para identificar los límites reales de recursos.
- Confirmamos si los desarrolladores pueden autoalojar flujos de trabajo offline seguros sin hardware empresarial costoso.
Integración con IDE y fricción de experiencia de usuario
Las métricas teóricas de latencia no significan nada si las sugerencias de código se sienten lentas durante la edición en vivo. Probamos modelos ligeros como Qwen3-Coder y Gemini 3.7 Flash dentro de un editor de código estándar para evaluar el autocompletado en línea en vivo y el retraso de entrada.
- Evaluamos la latencia del mundo real para asegurar que el texto fantasma predictivo se adaptara sin fisuras al ritmo natural de escritura de un desarrollador.
- Verificamos la conciencia de contexto para asegurar que los modelos leyeran y aplicaran correctamente variables a través de archivos de proyecto adyacentes abiertos.
Verificación de ejecución aislada y sintaxis
El código que parece correcto en una interfaz de chat a menudo falla en tiempo de ejecución. Compilamos y ejecutamos fragmentos generados por DeepSeek V4-Pro y GPT-5.6 Sol directamente dentro de contenedores Docker aislados.
- Las ejecuciones objetivas en sandbox marcaron inmediatamente métodos obsoletos, importaciones faltantes y alucinaciones de sintaxis.
- Rastreamos las tasas reales de Pass@1 para confirmar que la lógica satisfacía las suites de pruebas en el primer intento.
Aunque los LLMs independientes en la nube y locales destacan al generar fragmentos y refinar funciones específicas, construir aplicaciones completas aún exige configuración manual del IDE, montaje de boilerplate e integración frontend-backend. Para los desarrolladores y creadores que buscan evitar por completo los ciclos de codificación repetitivos, los agentes de desarrollo autónomos ofrecen un camino más rápido del concepto al despliegue.
Enter Pro: El agente de desarrollo de IA autónomo para la creación rápida de software
¿Buscas ir más allá de escribir funciones aisladas y generar aplicaciones completas de forma autónoma? Enter Pro cierra la enorme brecha entre las interfaces de chat de LLM puras y la generación completa de proyectos full-stack. Ya no necesitas configurar manualmente entornos locales, actualizar dependencias del sistema ni lidiar con gestores de paquetes complicados. En cambio, esta plataforma utiliza un intuitivo modo plan para vibe coding para transformar prompts de lenguaje natural de alto nivel directamente en software pulido y listo para producción.
Funciones clave
- Creación basada en prompts
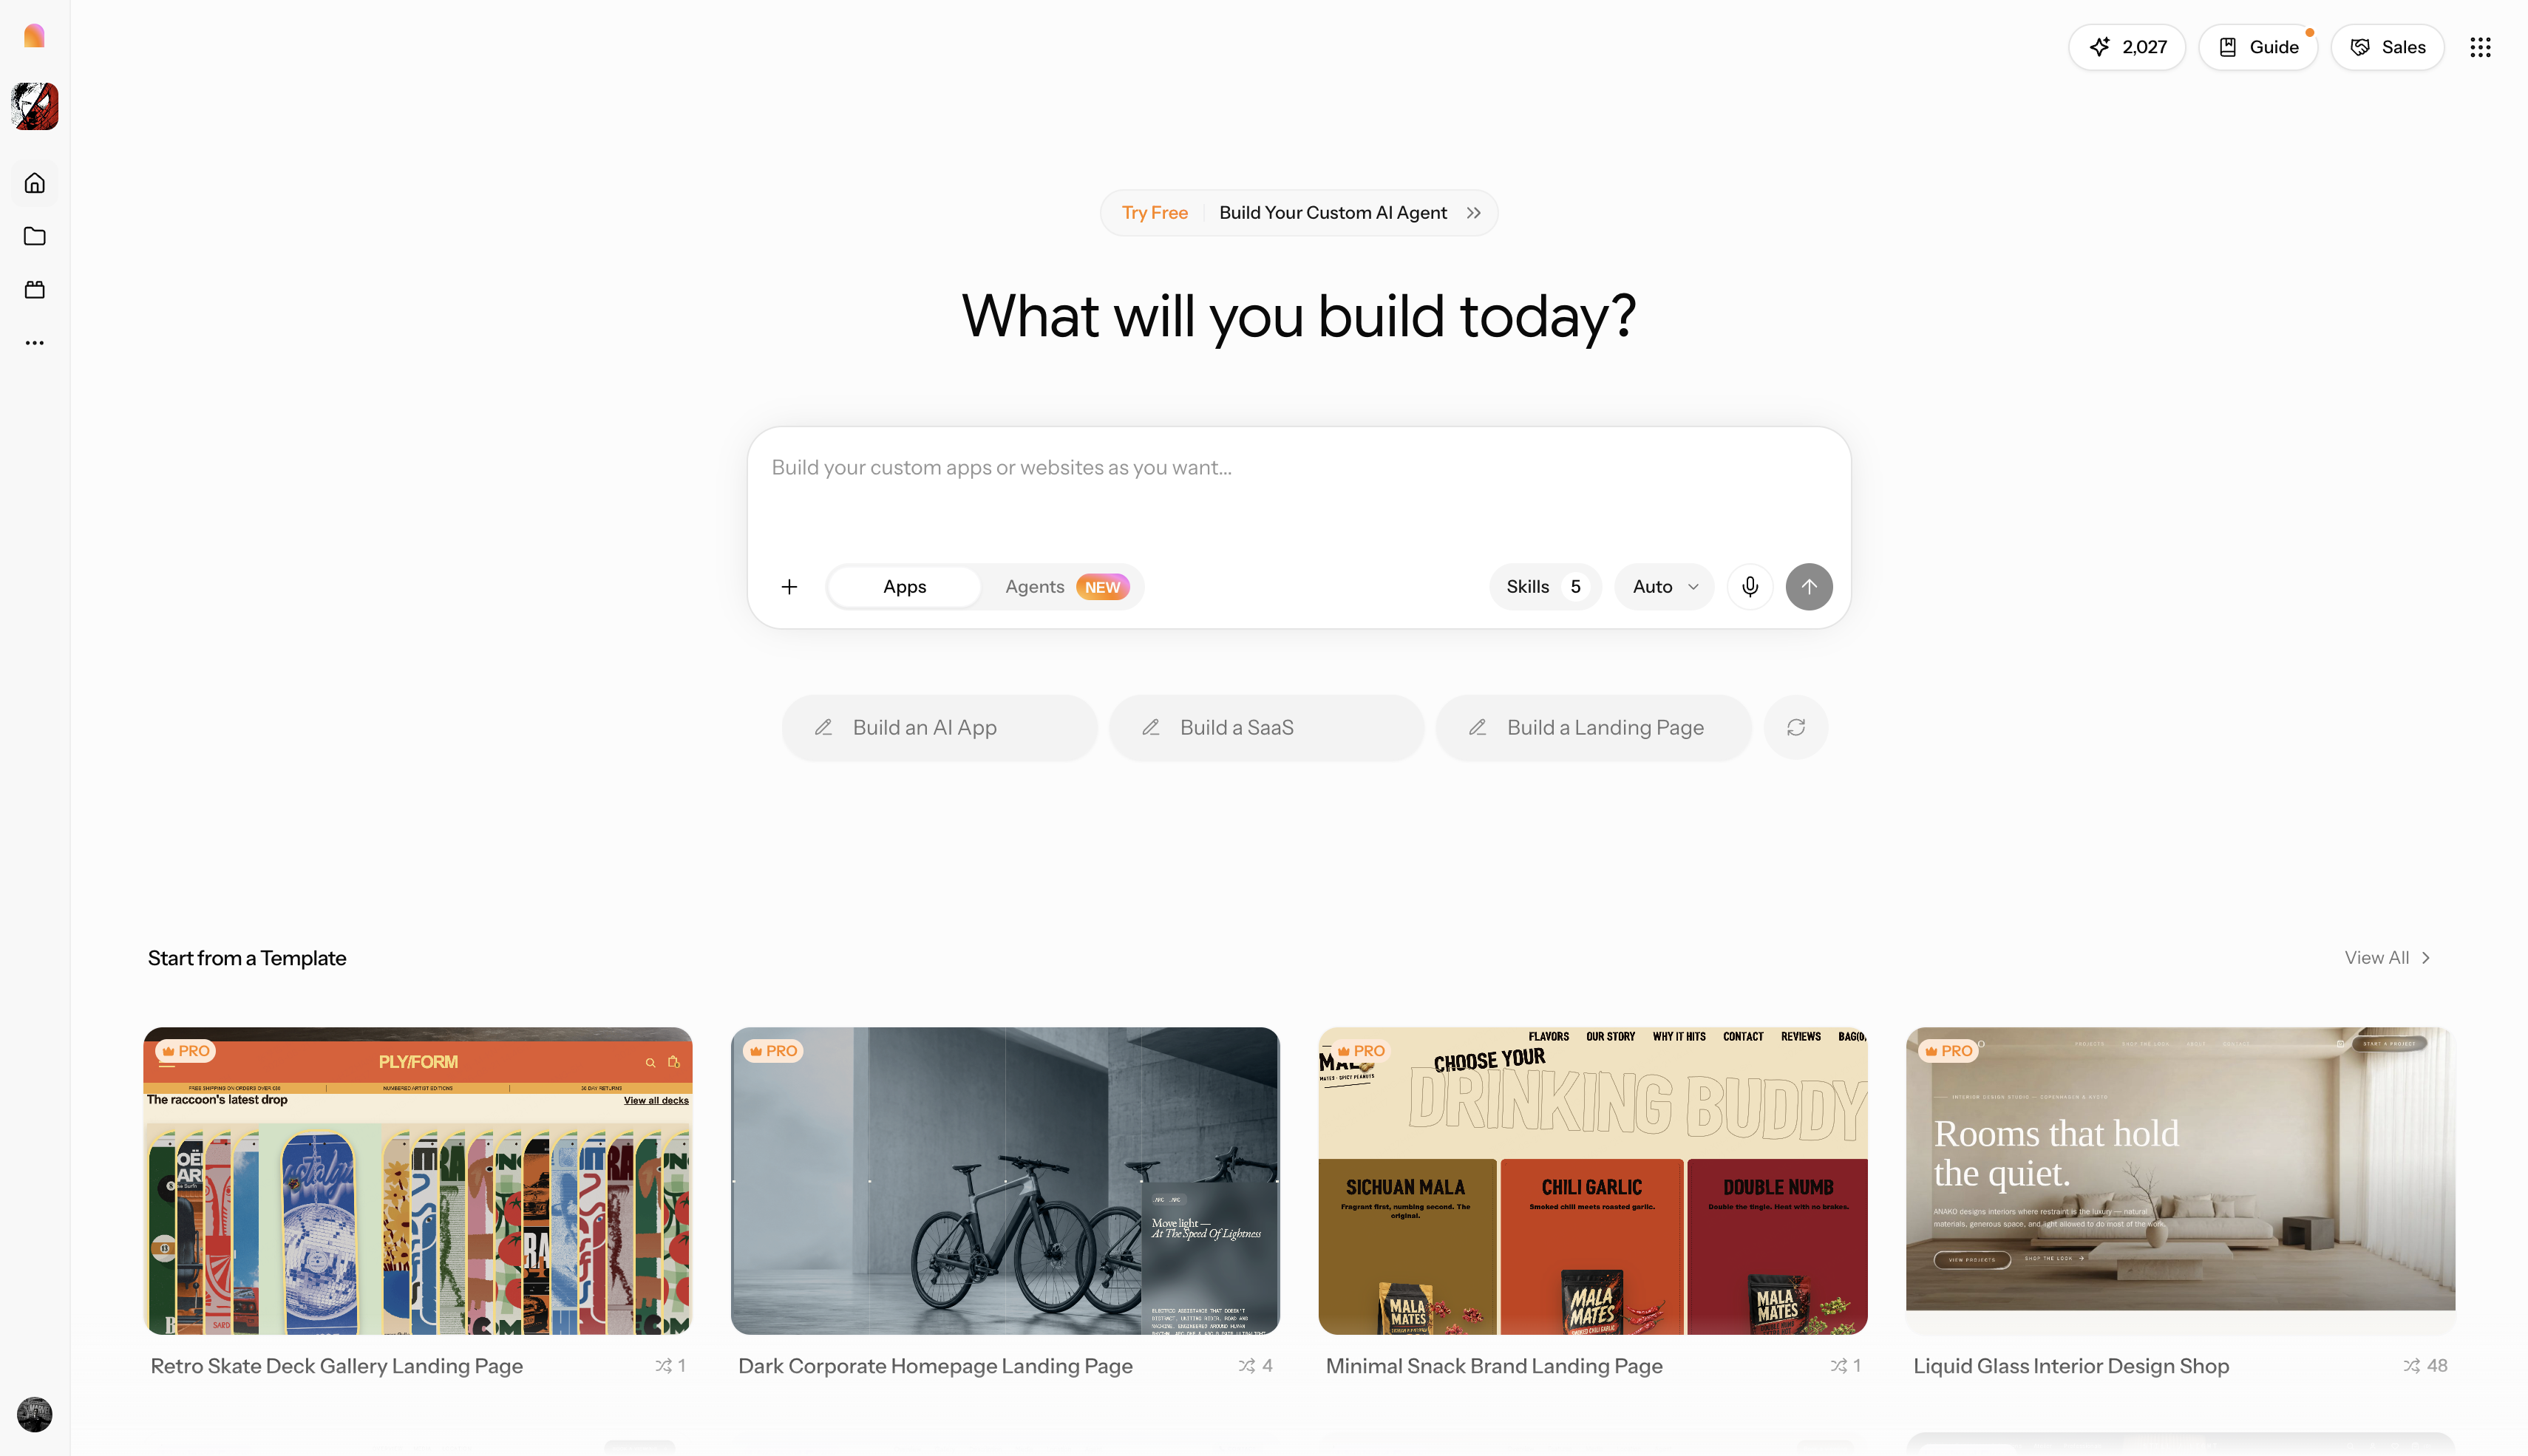
Los usuarios simplemente proporcionan un prompt en lenguaje natural que describe el tema de color del sitio web, el diseño deseado y las páginas funcionales incluidas. El motor integrado de Enter Pro construye instantáneamente la base de código full-stack, incluyendo la lógica de frontend y de base de datos, reduciendo drásticamente el tiempo de configuración manual.
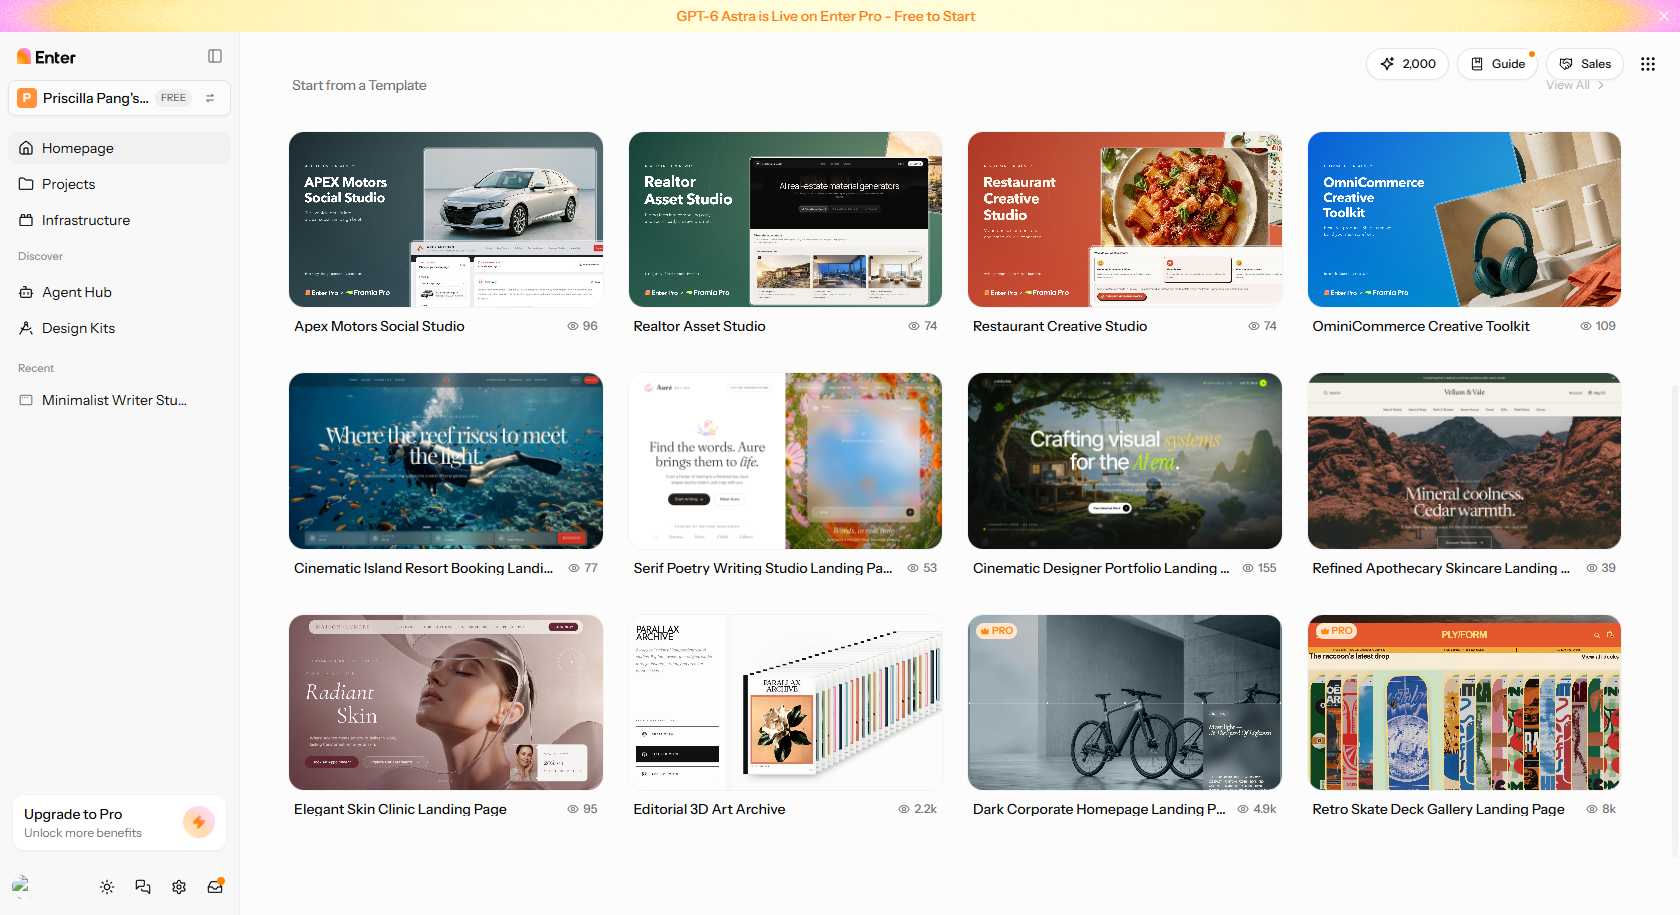
- Plantillas listas para usar
La plataforma ofrece plantillas de sitios web profesionalmente diseñadas y totalmente responsivas, adaptadas para una velocidad de despliegue extrema. Enter Pro optimiza específicamente estos diseños para cumplir estrictamente con los estándares modernos de experiencia de usuario, garantizando una entrega de aplicaciones de alta calidad sin ajustes visuales manuales.
- Integración de modelos unificada
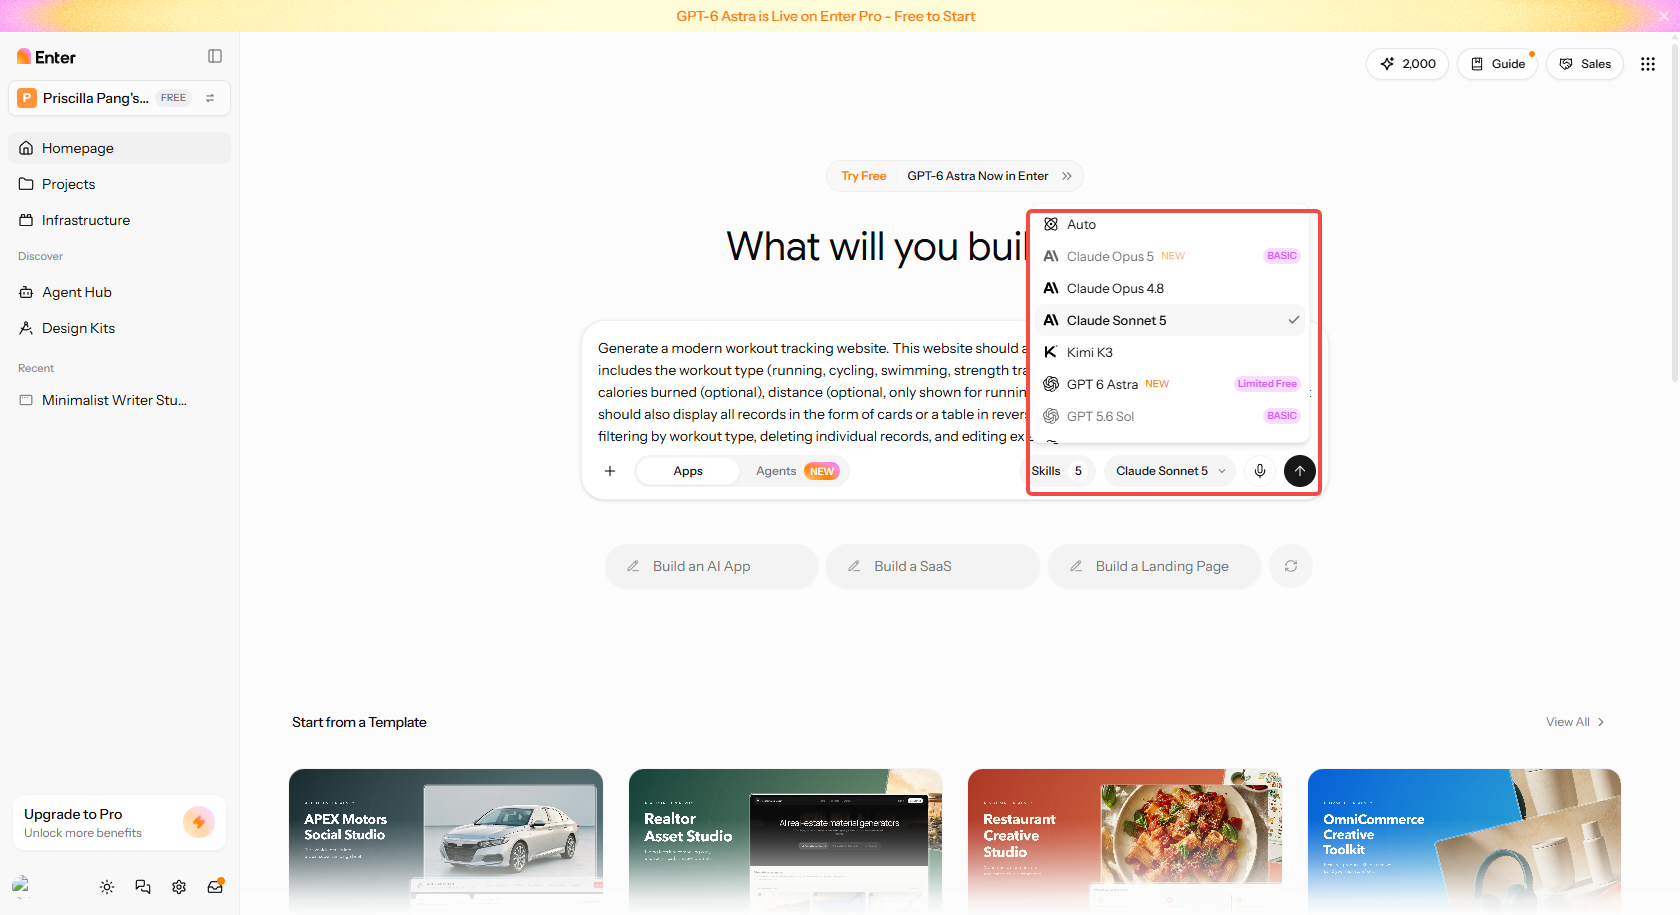
Los desarrolladores pueden incorporar de forma nativa asistentes de codificación de primer nivel y modelos avanzados directamente en sus builds activos de Enter Pro bajo una única suscripción, incluyendo Kimi K3, GPT 6 Astra y Claude Sonnet 5. Este enfoque simplificado elimina por completo la pesadilla administrativa de gestionar y asegurar claves API separadas en diferentes modelos frontier.
- 100% propiedad del código
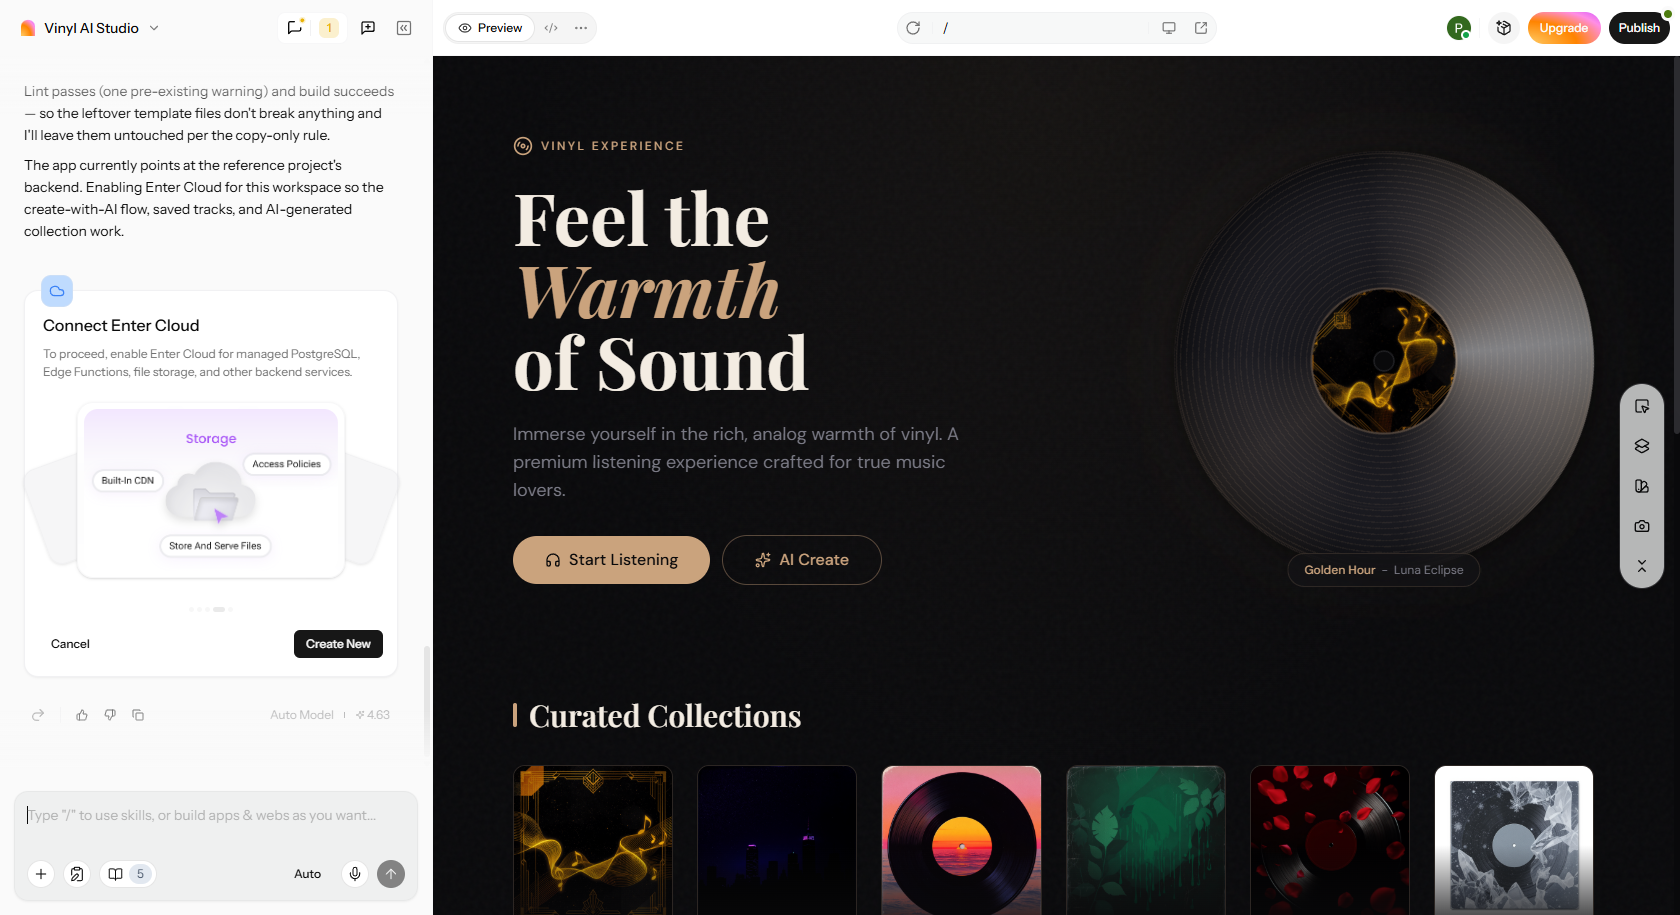
Conservas el control absoluto y los derechos comerciales completos sobre el código fuente generado al exportarlo desde la plataforma Enter Pro. Esto garantiza una verdadera independencia sin dependencia restrictiva de proveedores ni complicaciones de licencia futuras.
Guía paso a paso para construir aplicaciones
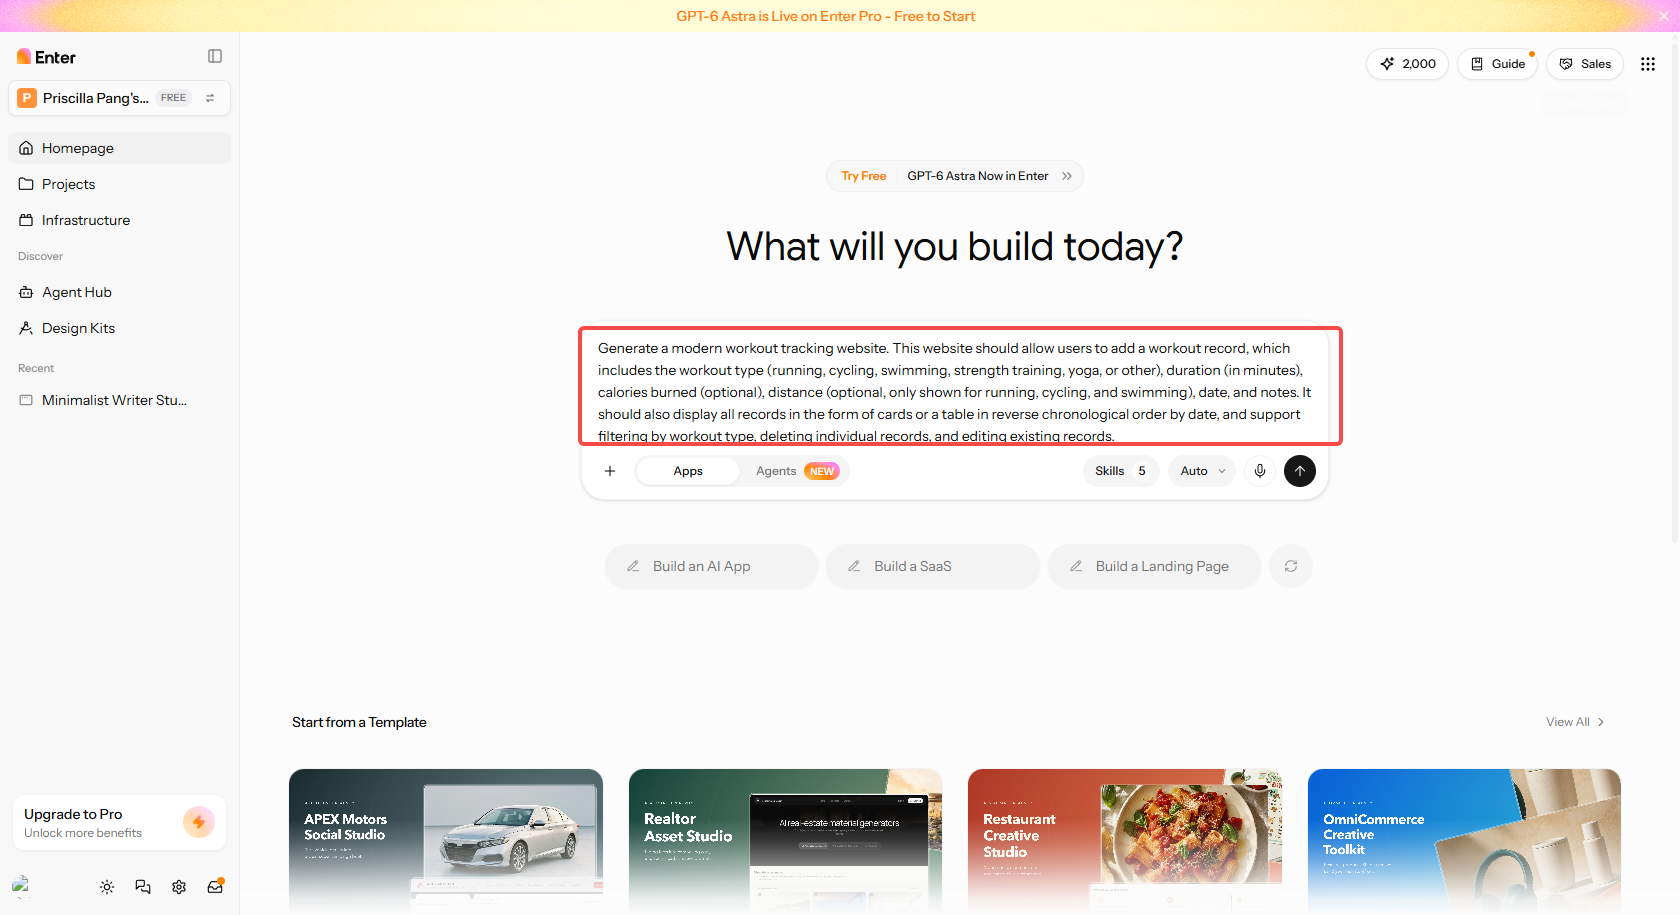
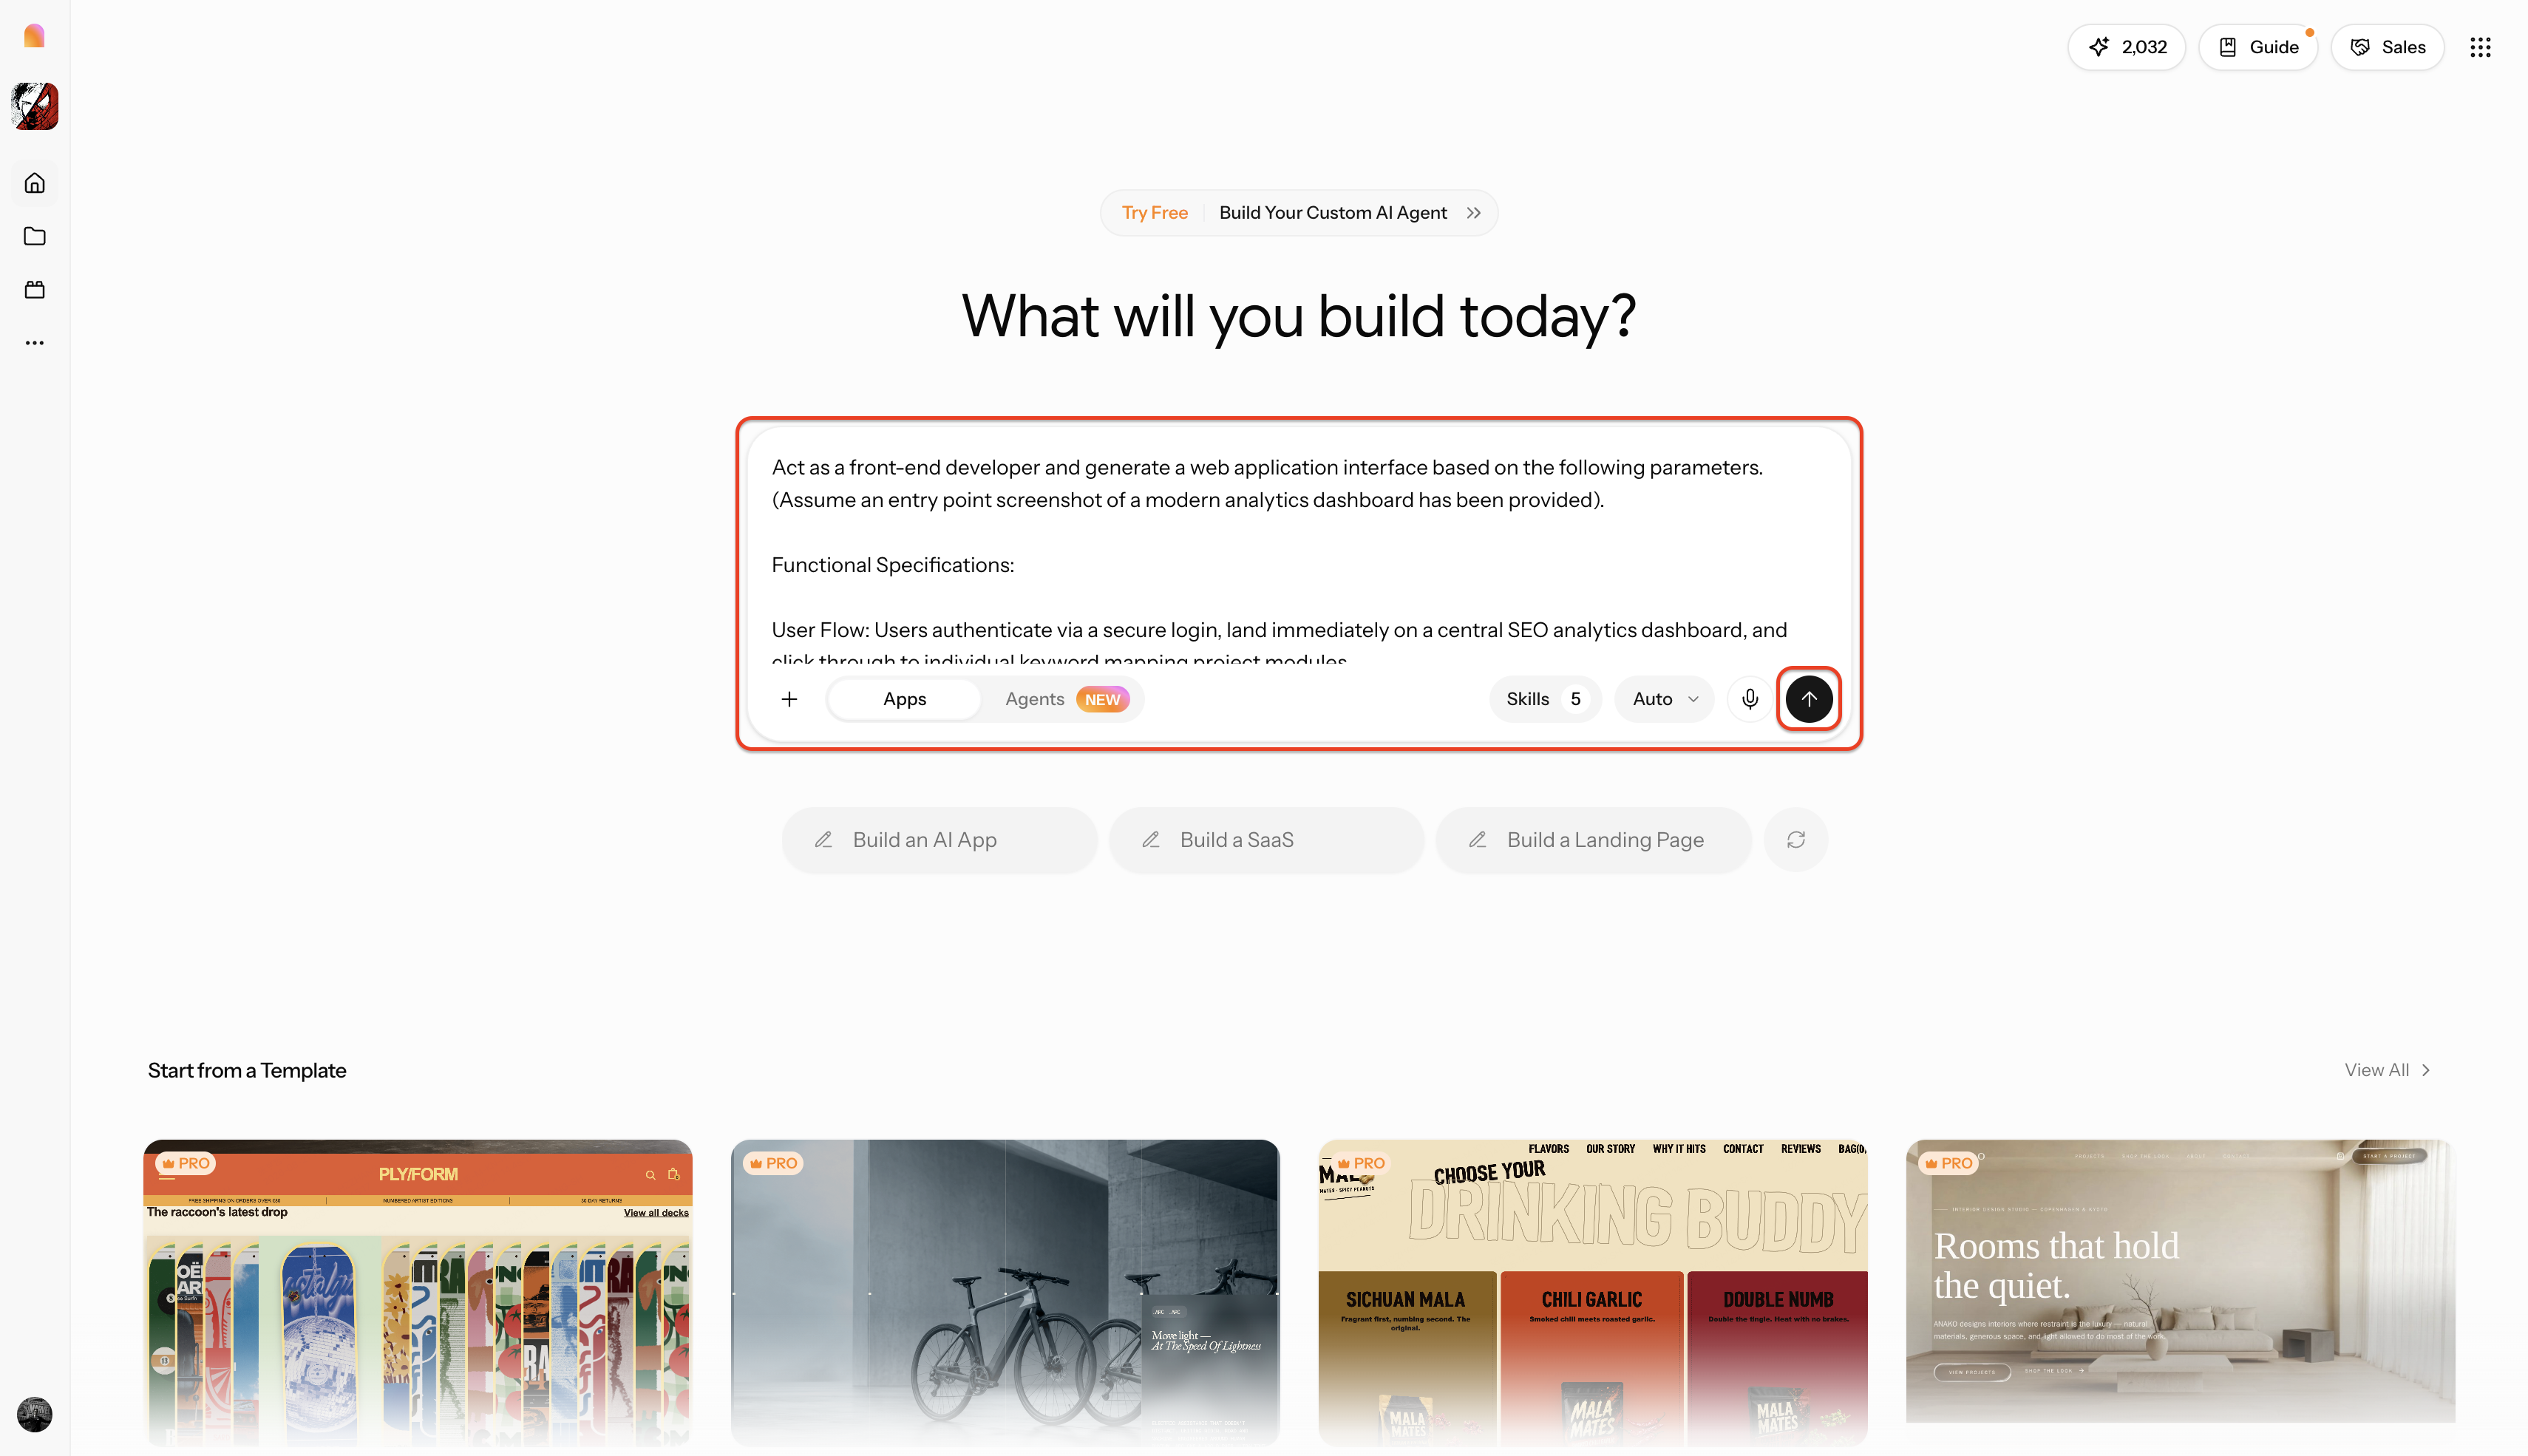
Paso 1: Lanza Enter Pro e introduce el prompt del proyecto
Comienza definiendo tus especificaciones funcionales, preferencias de estilo de interfaz y características objetivo enteramente en lenguaje natural. Puedes subir fácilmente una captura de pantalla del punto de entrada de la interfaz para guiar la comprensión estructural y estética de la IA desde el principio.
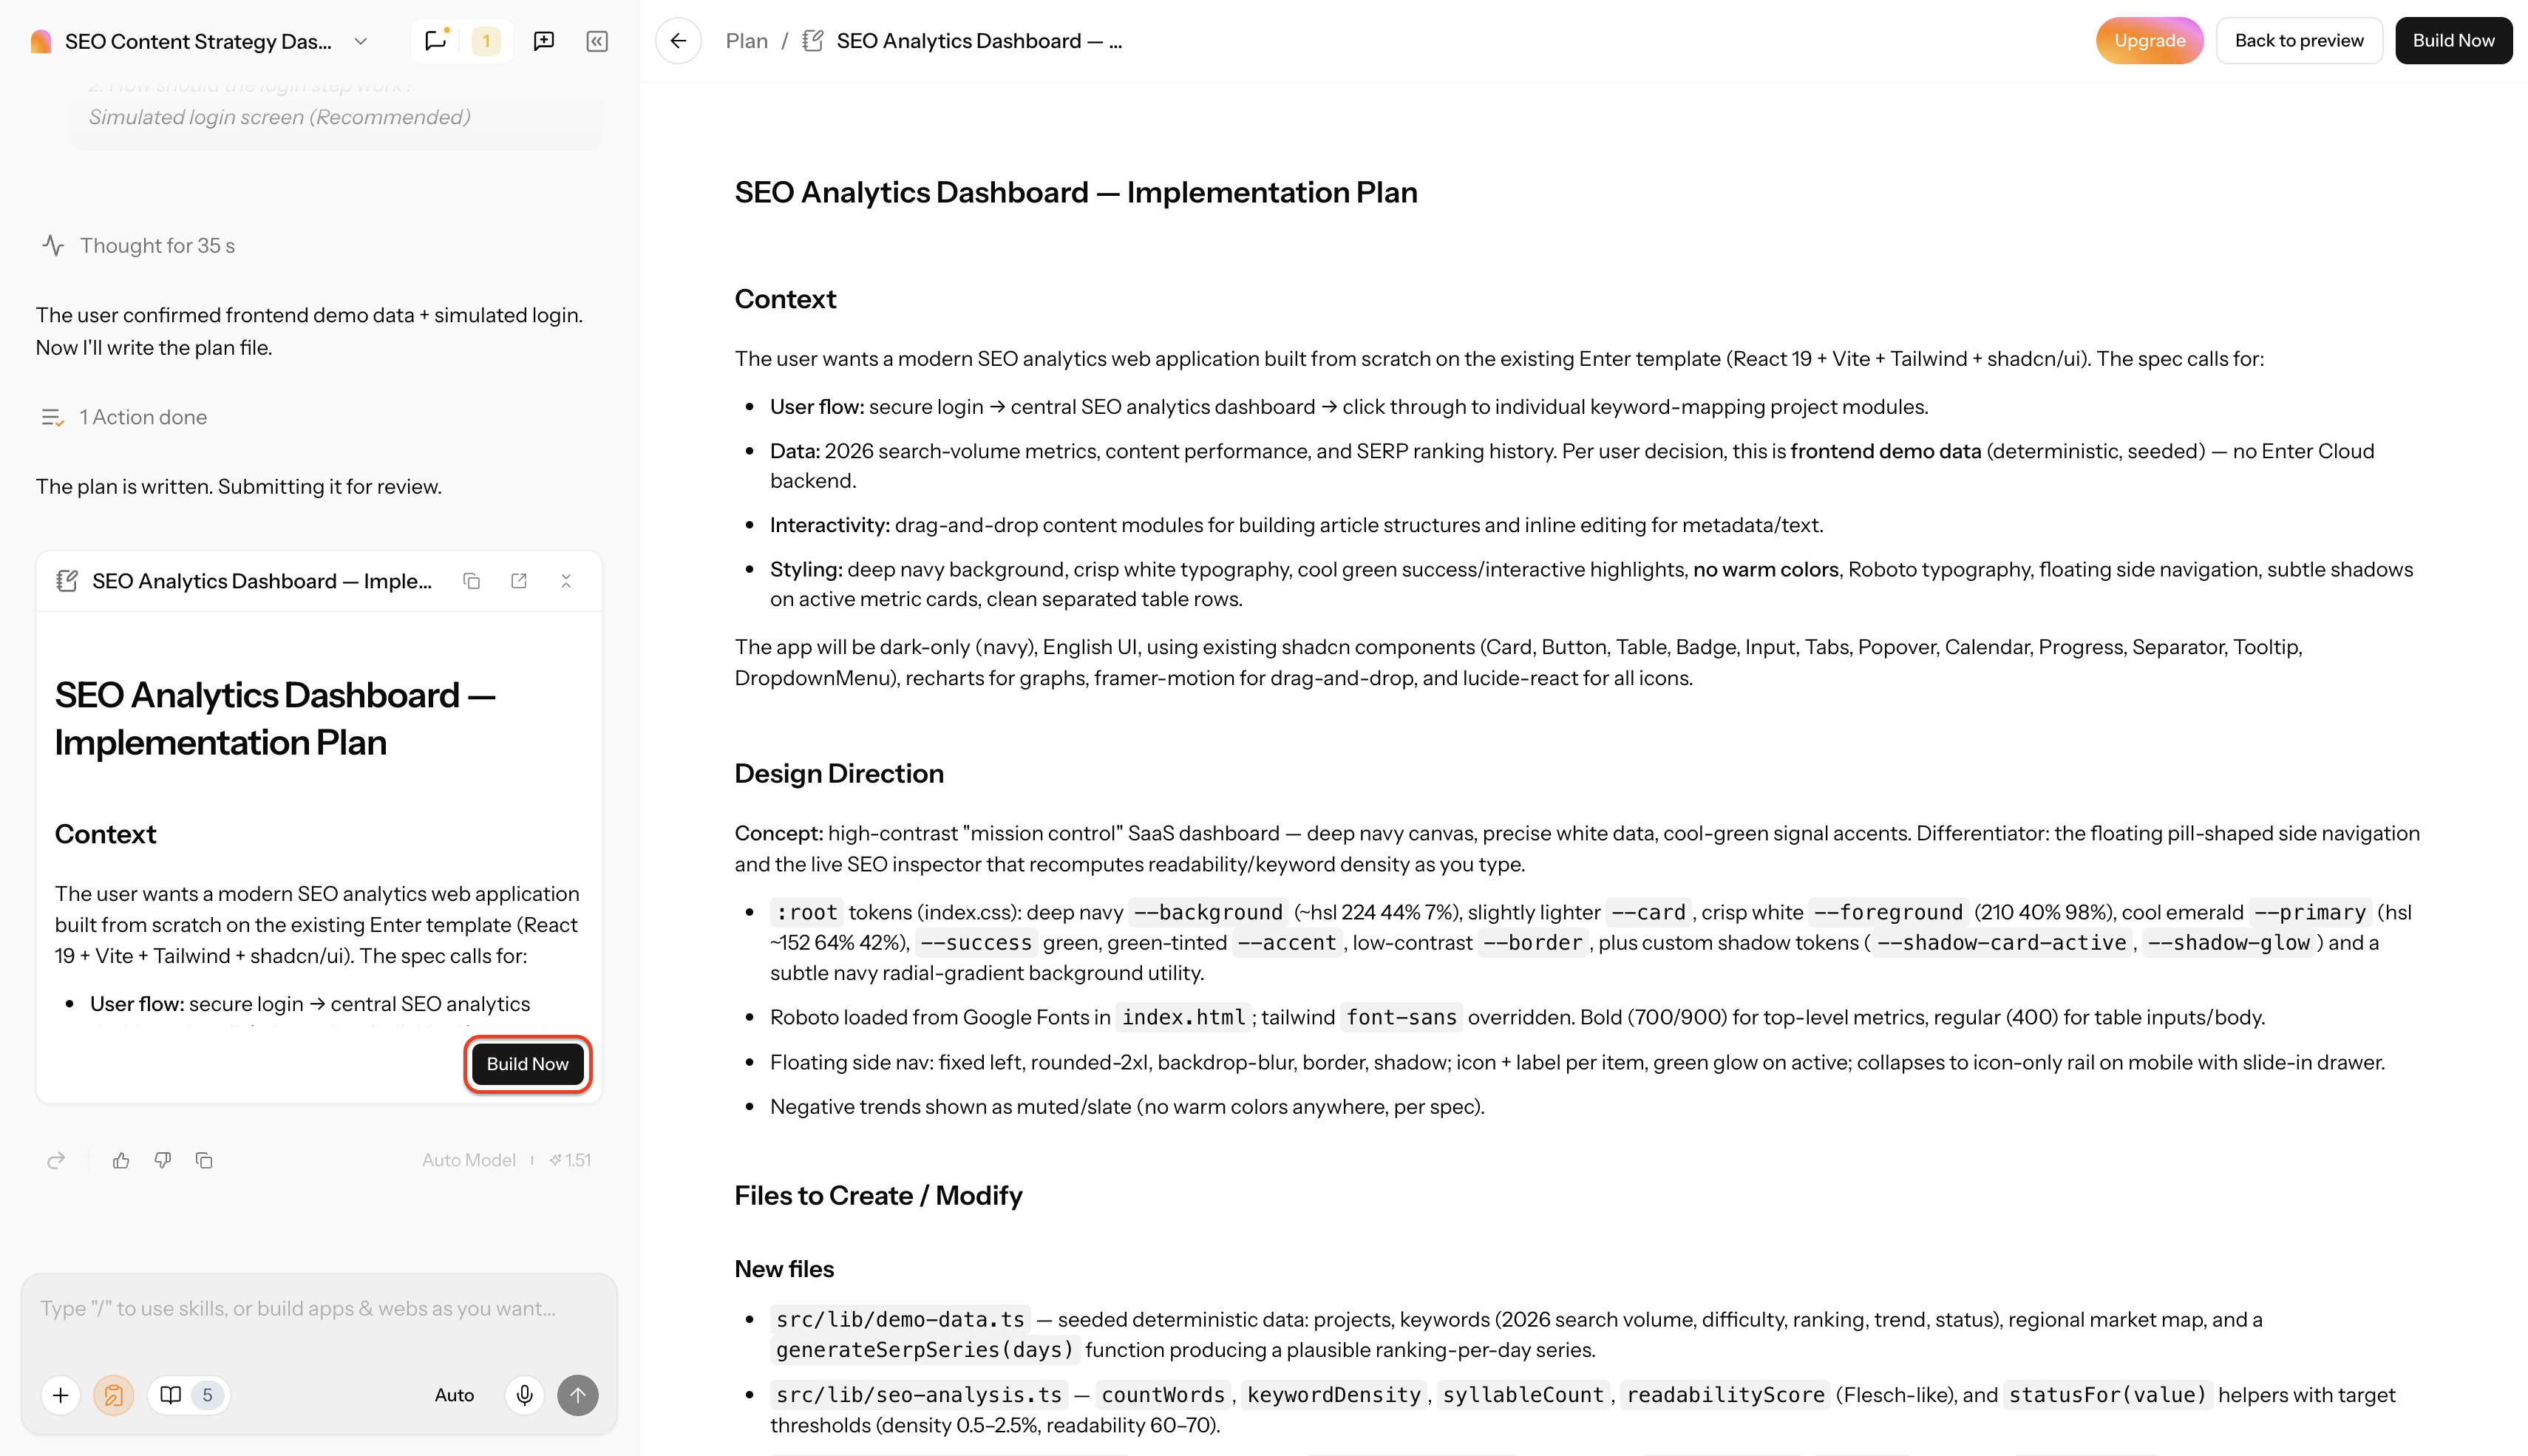
Paso 2: Revisa el plan de implementación y construye
Revisa el plan generado por la IA que describe el contexto de la aplicación, la dirección de diseño y las estructuras de archivos necesarias. Una vez listo, simplemente haz clic en el botón "Build Now" para iniciar el proceso de generación de código full-stack.
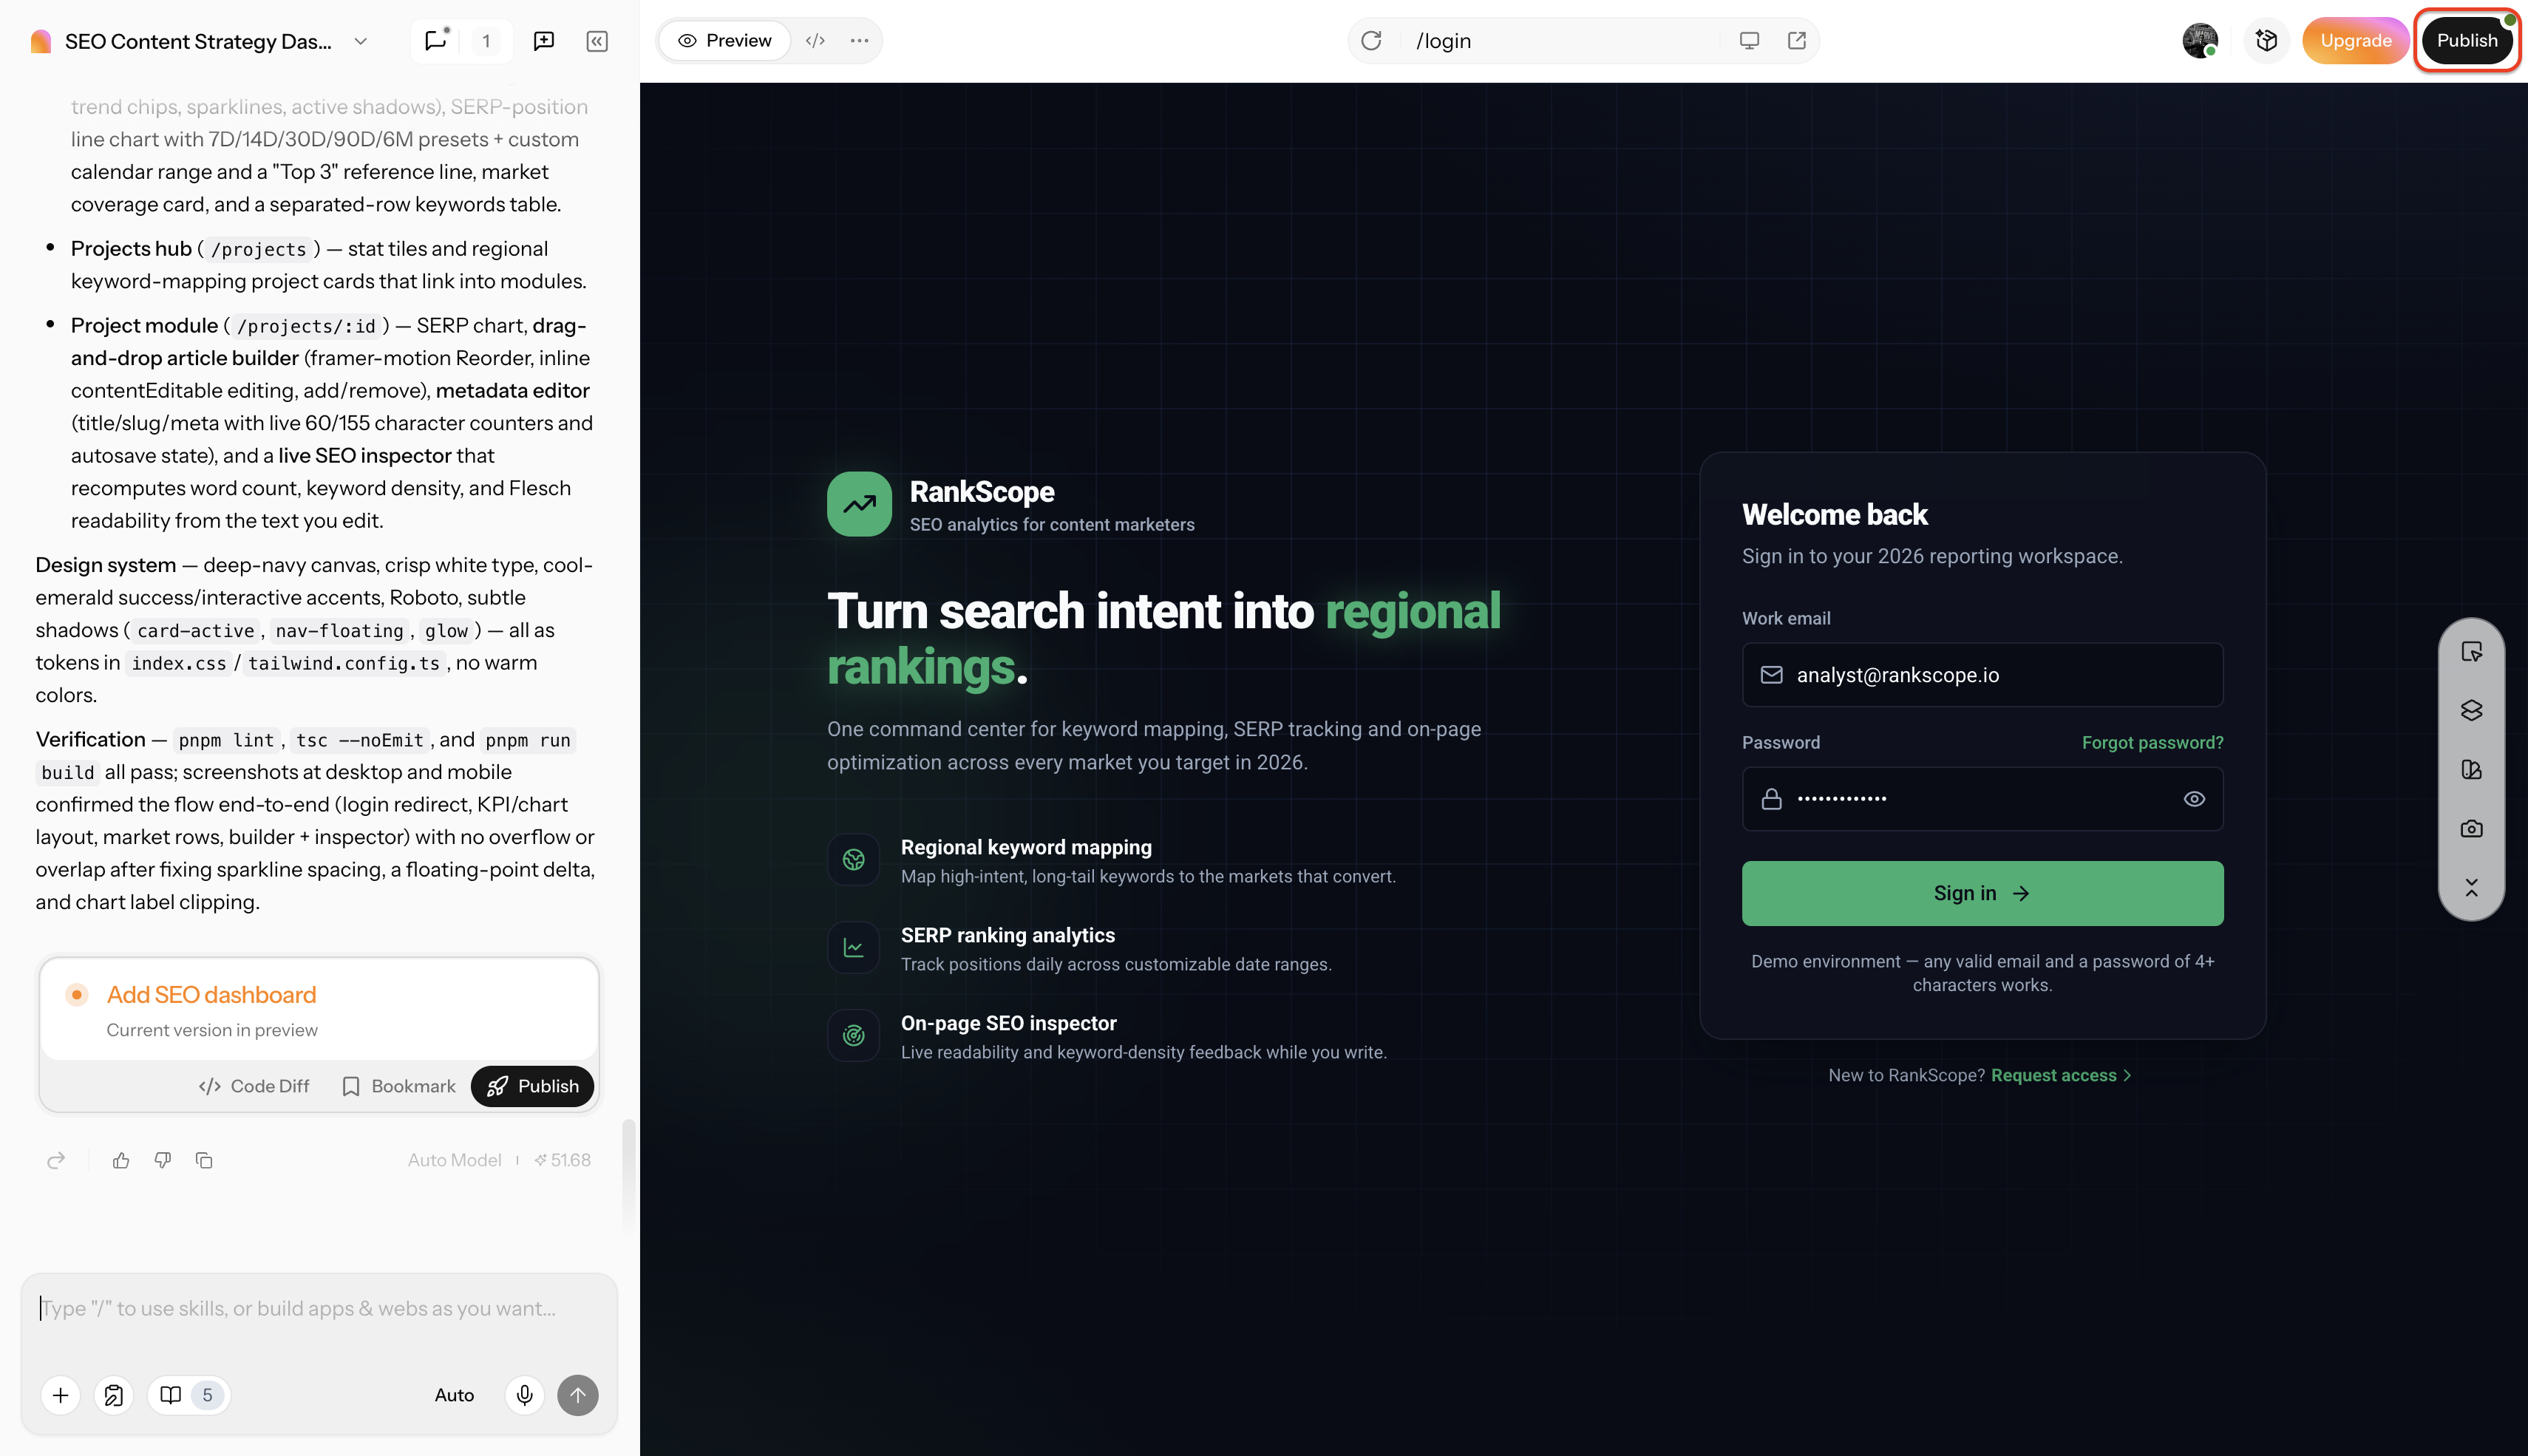
Paso 3: Edita, publica y exporta
Refina la aplicación generada editando con descripciones de prompt simples o con el Editor Visual. Cuando estés satisfecho con los resultados, despliega la aplicación en vivo en la web con un solo clic, o exporta de forma segura los archivos fuente estructurados a tu máquina local.
LLMs en la nube vs. LLMs locales vs. agentes de IA autónomos: Compensaciones de rendimiento y privacidad
Seleccionar la arquitectura más adecuada requiere analizar en profundidad las compensaciones fundamentales presentes en tu entorno de ingeniería actual.
| Dimensión | LLMs cloud frontier | LLMs locales autoalojados | Agente autónomo (Enter Pro) |
|---|---|---|---|
| Privacidad de datos | Depende de la política de datos de la API en la nube | 100% privado/aislado | Espacio de trabajo aislado/propiedad del código |
| Sobrecarga de hardware | Sin necesidad de cómputo local | Requiere VRAM/GPU alta | Sin necesidad de cómputo local |
| Complejidad de configuración | Clave API y configuración de plugin de IDE | Configuración de runtime local y cuantización | Espacio de trabajo visual de prompt y lanzamiento |
| Alcance de salida | Fragmentos, funciones y consejos de chat | Autocompletado de código y ediciones locales | Aplicaciones full-stack completas |
| Modelo de costes | Suscripción API por token | Coste inicial de hardware local | Suscripción fija a la plataforma |
- Privacidad y propiedad intelectual: Cuando manejo bases de código estrictas y altamente propietarias, priorizo constantemente los modelos locales para evitar por completo la filtración de PI confidencial. Enviar lógica corporativa no publicada a servidores remotos a menudo infringe regulaciones de cumplimiento estrictas.
- Requisitos de hardware: Ejecutar modelos de código abierto exige hardware serio y dedicado. Un modelo de 7 mil millones de parámetros generalmente requiere asignar al menos 8 GB de VRAM, un modelo de 14 mil millones requiere 16 GB, y los enormes modelos de 70 mil millones de parámetros requieren 48 GB+ de VRAM, lo que a menudo exige configuraciones de escritorio costosas con doble GPU o servidores locales especializados.
- Latencia vs. capacidad: Las redes de cómputo en la nube ofrecen una potencia inmensa e inigualable para razonamiento profundo y refactorización masiva multiarchivo. Sin embargo, al cambiar a modelos locales autoalojados, experimento una ventaja estricta de latencia de red cero que los hace sentir muy superiores y mucho más fluidos para completados de texto en línea instantáneos.
Veredicto de la comunidad: reseñas de desarrolladores y tendencias de vibe coding
- Vibe coding se refiere a un flujo de trabajo de desarrollo moderno donde los desarrolladores dirigen la arquitectura del sistema de alto nivel y la lógica de la aplicación usando prompts en lenguaje natural mientras la IA genera de forma autónoma la sintaxis boilerplate. En lugar de escribir rutinas manualmente, el ingeniero actúa como director arquitectónico, guiando la intención del proyecto y revisando los resultados generados.
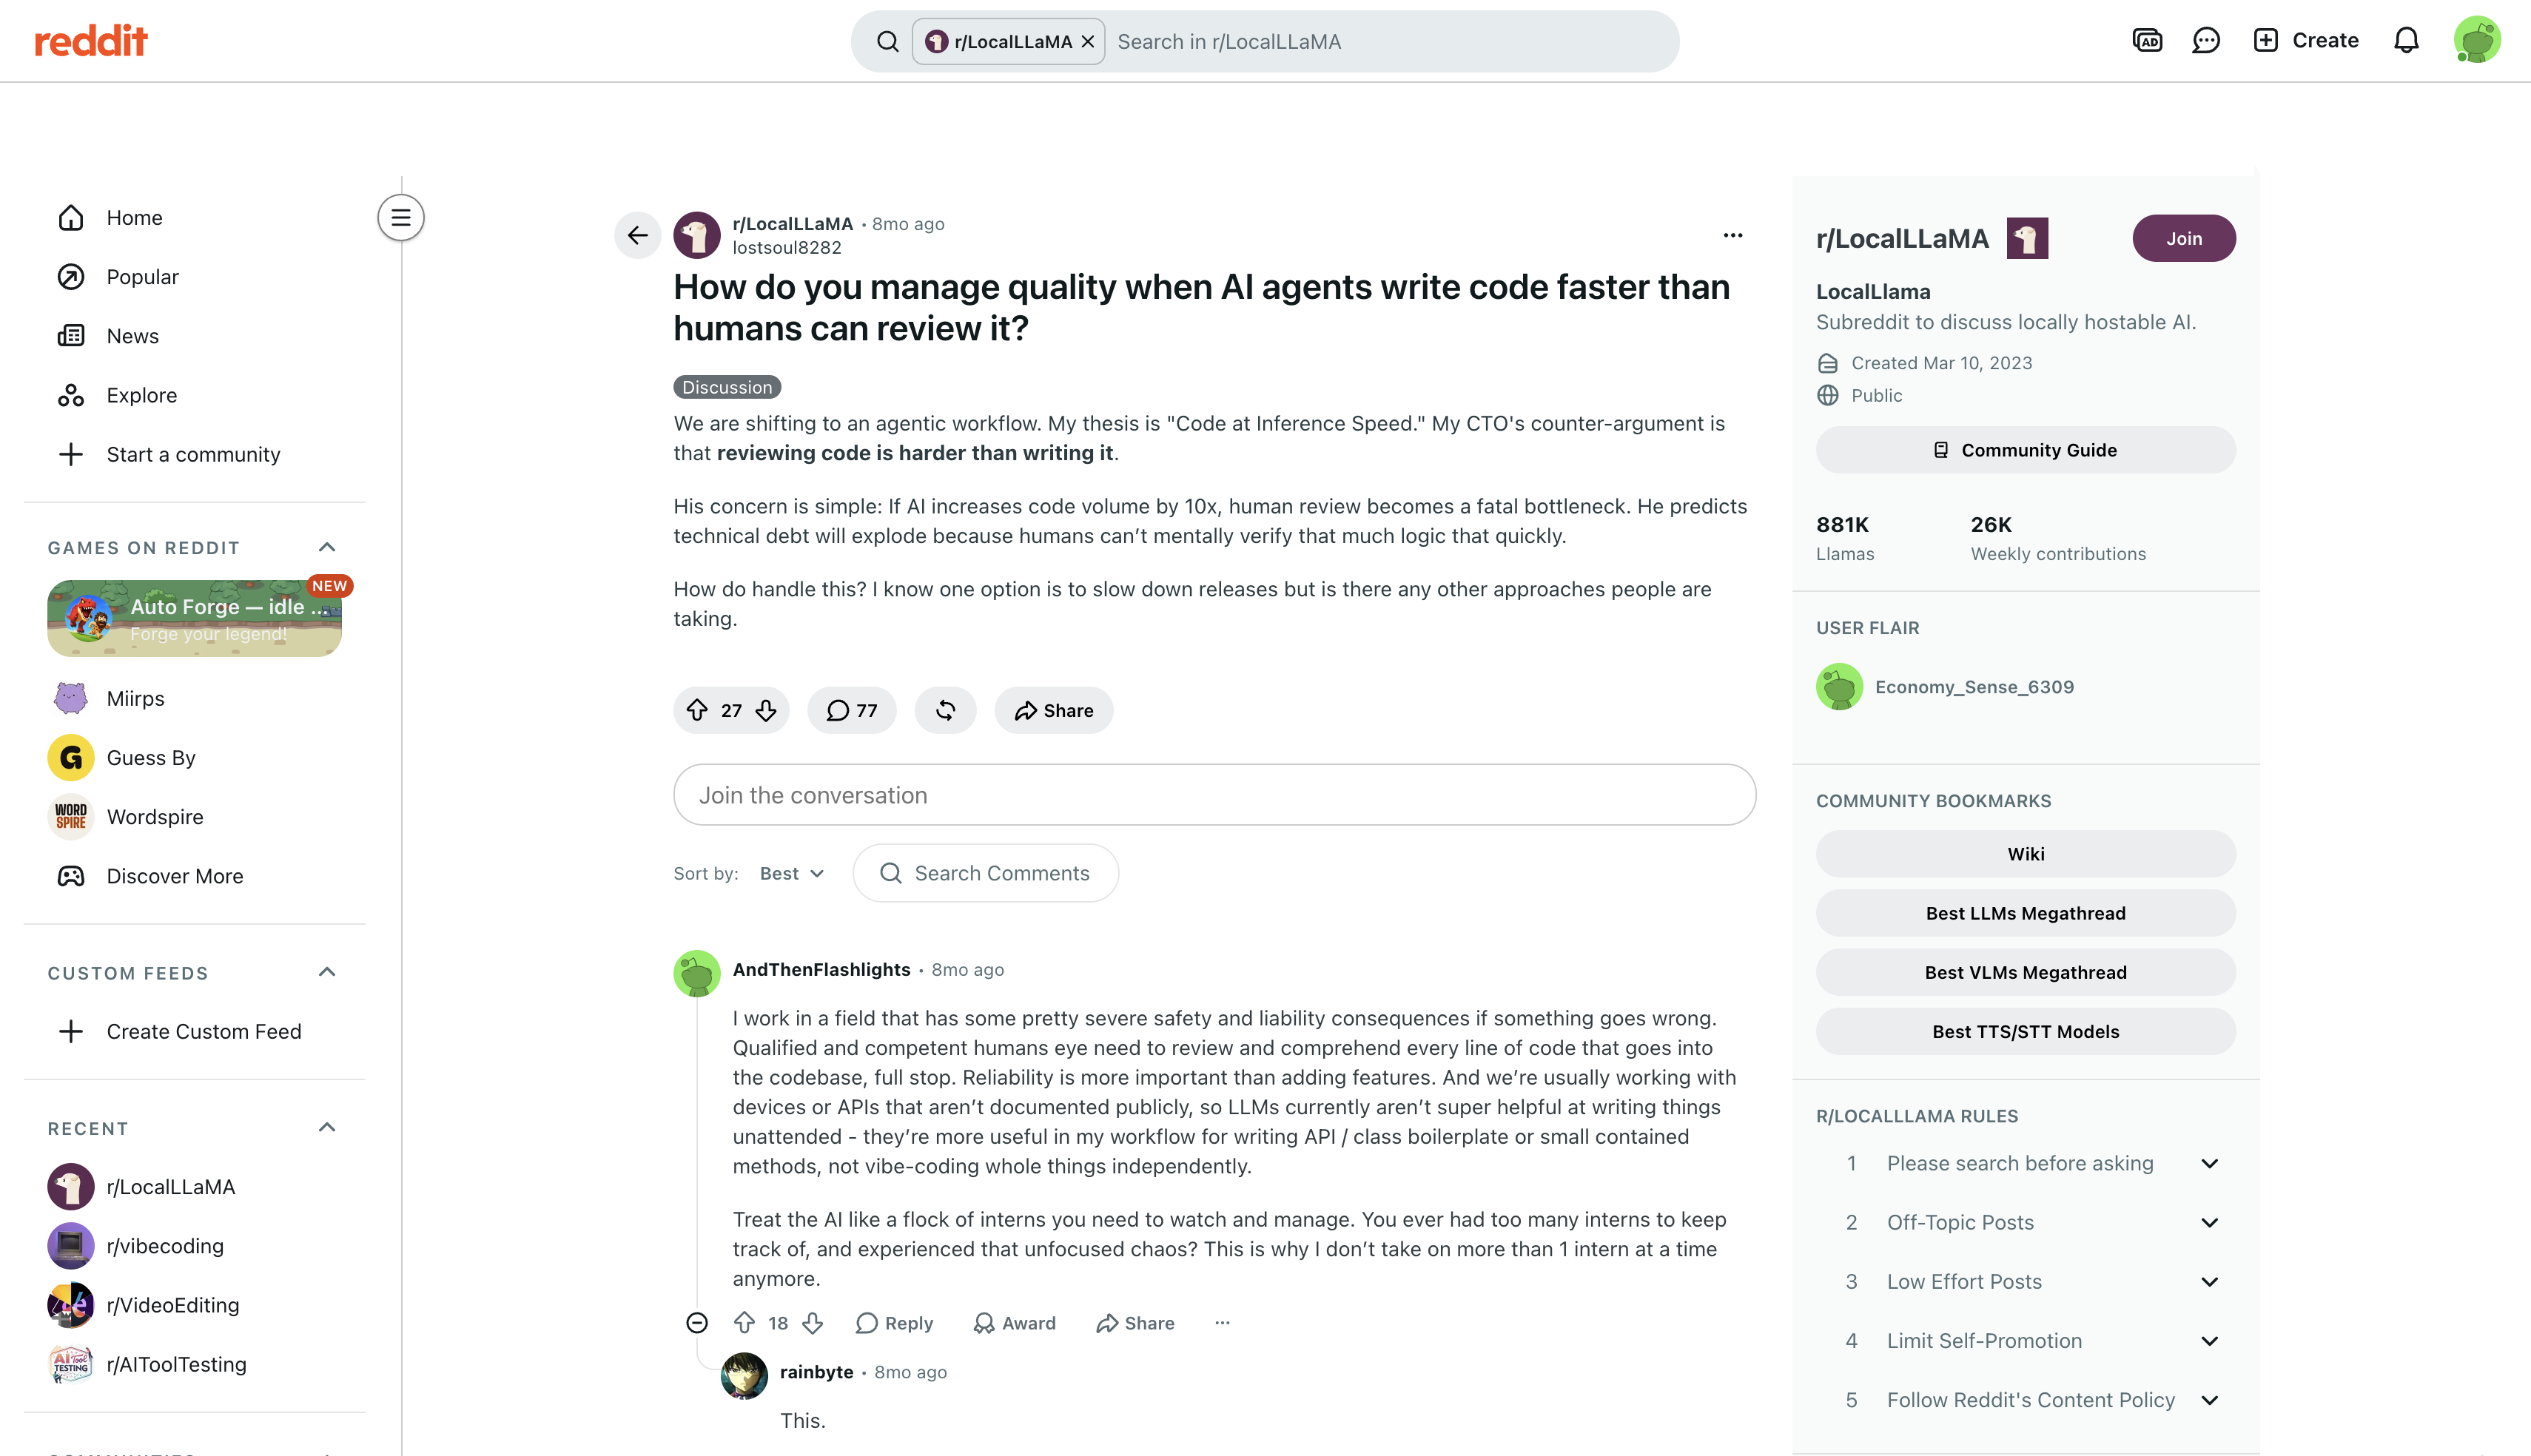
Consenso de la comunidad de Reddit:
- Al sintetizar las ideas de las discusiones de desarrolladores en r/vibecoding, los ingenieros adoptan frecuentemente un enfoque escalonado y multimodelo. Rara vez dependen de una sola herramienta para manejar una construcción full-stack completa.
- Los desarrolladores típicamente inician el scaffolding de alto nivel y los conceptos de frontend usando modelos rápidos y de amplio alcance. Luego cambian inmediatamente a Claude Opus 5 para la ejecución de lógica profunda, la refactorización compleja multiarchivo y la depuración dirigida.
- Las discusiones en foros de ingeniería como r/LocalLLaMA enfatizan que la supervisión humana sigue siendo estrictamente necesaria. Aunque la generación autónoma acelera las construcciones iniciales, los desarrolladores deben gestionar activamente dependencias de estado complejas para prevenir la deriva lógica.
Preferencias de modelo de la comunidad:
- Flujos de trabajo sin configuración: Los ingenieros favorecen fuertemente las configuraciones impulsadas por la nube integradas directamente en editores de código nativos de IA modernos para un desarrollo rápido. Claude Opus 5 se cita ampliamente como el estándar de referencia por su equilibrio de precisión zero-shot, retención de contexto y salida altamente fiable.
- Configuraciones de entusiastas locales: Muchos desarrolladores optan por despliegues locales para evitar gastos recurrentes de tokens API y proteger bases de código privadas. Modelos de código abierto como Qwen3-Coder-Next y DeepSeek V4-Pro son ampliamente recomendados para autoalojarse a través de runtimes como Ollama, ofreciendo una generación de código sólida con cero telemetría de datos.
Conclusión
En última instancia, ningún LLM único para programar se ajusta perfectamente a todos los casos de uso de ingeniería en 2026. Los modelos cloud frontier ofrecen la potencia de razonamiento bruto necesaria para refactorización de sistemas complejos y diseño estructural. Para la seguridad empresarial, el mejor LLM local para programar garantiza cero fugas de datos en entornos altamente sensibles. Mientras tanto, adoptar agentes de desarrollo autónomos agiliza la entrega completa de aplicaciones desde el concepto inicial hasta el despliegue en producción. Evalúa el presupuesto, las capacidades de hardware y las políticas de seguridad de datos de tu equipo antes de comprometerte con un solo ecosistema. Inicia un IDE y configura algunas claves API o runtimes locales. Haz un benchmark de estos modelos contra tu base de código para descubrir qué conjunto de herramientas eleva tu flujo de trabajo de ingeniería.
Preguntas frecuentes sobre el mejor LLM para programar
¿Qué LLM es mejor para programar en 2026?
Claude Opus 5 es actualmente el mejor LLM de código para ingeniería de software compleja, refactorización multiarchivo y bucles de agentes autónomos. Para desarrolladores que buscan ejecución determinista e integración amplia con IDEs, GPT-5.6 Sol sirve como la mejor alternativa en la nube. Los equipos que priorizan la privacidad estricta de datos pueden desplegar potencias de pesos abiertos como GLM-5.2 o DeepSeek V4-Pro localmente sin dependencias de la nube.
¿Cuál es el mejor LLM local para programar en portátiles de consumo?
Qwen3-Coder-Next y GLM-5.2 están muy optimizados para entornos locales. Qwen3-Coder-Next ofrece una gran eficiencia por parámetro en hardware modesto, mientras que GLM-5.2 es el mejor codificador de pesos abiertos con un contexto de 1M de tokens.
¿Cuánta RAM y VRAM se necesitan para ejecutar modelos LLM locales?
Para ejecutar cómodamente un modelo de codificación estándar de 7 mil millones de parámetros, necesitas al menos 8 GB de VRAM de GPU o memoria unificada de Apple. Los modelos más grandes de 14 mil millones requieren aproximadamente 16 GB, mientras que los enormes modelos de nivel empresarial de 70 mil millones requieren entre 48 GB y 64 GB de VRAM para funcionar con fluidez.
¿Son seguros los modelos de codificación en la nube para código corporativo propietario?
Depende completa y exclusivamente de la política de retención de la API del proveedor específico. Mientras que los acuerdos API empresariales de nivel alto generalmente prometen no entrenar con los datos del usuario, el cumplimiento corporativo estricto y las regulaciones gubernamentales a menudo exigen modelos locales completamente aislados para garantizar seguridad absoluta.
¿Qué es el "vibe coding" y qué modelo es más adecuado para ello?
Se refiere a un flujo de trabajo de desarrollo moderno donde un ingeniero dirige la lógica de la aplicación usando prompts amplios y de alto nivel en lenguaje natural, mientras la IA maneja de forma autónoma toda la generación de boilerplate y la escritura de sintaxis. Modelos frontier como Claude Opus 5 y GPT-5.6 Sol destacan enormemente en esta metodología para codificación agéntica y grandes refactorizaciones.
¿Cómo se comparan los modelos de código abierto con Claude Fable 5?
Modelos de pesos abiertos como GLM-5.2 y DeepSeek V4-Pro están cerrando la brecha rápidamente, superando líneas base anteriores como GPT-5.5 en SWE-bench Pro y desafíos algorítmicos. Sin embargo, motores frontier como GPT-5.6 Sol y Claude Fable 5 todavía mantienen una ventaja clara en refactorizaciones masivas y bucles de agentes complejos.
¿Pueden los LLMs de codificación reemplazar a los ingenieros de software humanos?
No. Estos modelos actualmente actúan como compiladores altamente avanzados y potentes aceleradores de flujo de trabajo. Todavía requieren absolutamente ingenieros humanos experimentados para diseñar meticulosamente la arquitectura del sistema, gestionar protocolos de seguridad complejos y verificar rigurosamente la lógica funcional antes del despliegue en producción.
¿Cuál es el mejor LLM gratuito y de código abierto para el desarrollo en Python?
GLM-5.2 y Qwen3-Coder-Next cuentan ambos con capacidades extensas y altamente especializadas. GLM-5.2 se extiende hasta un contexto de 1M de tokens para bases de código grandes, mientras que Qwen3-Coder-Next ofrece una excelente eficiencia para despliegues locales más pequeños, haciendo de ambos opciones gratuitas excepcionales para flujos de trabajo de desarrollo web estándar.





