
Análisis de GLM-5: versiones, benchmarks, precios y acceso
Compara las versiones de GLM-5, sus benchmarks, precios, arquitectura, despliegue local, acceso por API y su integración con Enter Pro.
GLM-5 ya no es un modelo único que se pueda evaluar con un solo benchmark. Es toda una familia muy ágil: algunas variantes solo aceptan texto, otras permiten entrada de imágenes, las versiones más recientes han ampliado la ventana de contexto a 1 millón de tokens, y la opción más económica cuesta solo una fracción del modelo insignia.
Antes de actualizar este análisis, he revisado las notas de lanzamiento, las fichas de modelo, la documentación de la API, el repositorio y capturas reales del producto de Z.ai. Esto es importante porque algunas de las afirmaciones son bastante atractivas —como una mejora interna del 50 % en programación o un cómputo 2,9 veces menor en contexto largo— y provienen de Z.ai, no de una auditoría independiente. Por eso las presento como afirmaciones, no como resultados propios de pruebas.
A la hora de elegir un modelo GLM-5 hay cuatro preguntas clave: ¿qué tipo de entradas tienes? ¿Qué nivel de dificultad tiene la tarea? ¿Dónde necesitas ejecutar la inferencia? ¿Cuánto cuesta un resultado exitoso si hay reintentos? Mi respuesta rápida: GLM-5.3 para texto o código complejo, GLM-5.3-Flash si necesitas multimodalidad o ahorro de costes, y GLM-5.2 si ya tienes una integración validada.
¿Qué es GLM-5?
GLM-5 es la familia de modelos de pesos abiertos desarrollada por Z.ai para ingeniería de software, uso de herramientas y agentes de largo horizonte. La versión original (febrero de 2026) es un modelo de Mixture-of-Experts (MoE) que solo acepta texto como entrada y salida, con 744.000 millones de parámetros totales, aproximadamente 40.000 millones de parámetros activos por token, y una ventana de contexto de 200.000 tokens. Estos datos provienen del informe técnico de GLM-5 y del repositorio oficial de GitHub.
Un modelo MoE no activa toda la red para cada token. Un enrutador envía cada token a un grupo reducido de expertos, lo que reduce el cómputo activo mientras se mantiene un checkpoint muy grande. Eso no convierte a GLM-5 en un modelo para portátiles: los pesos completos siguen necesitando almacenamiento, enrutamiento y hardware de nivel servidor.
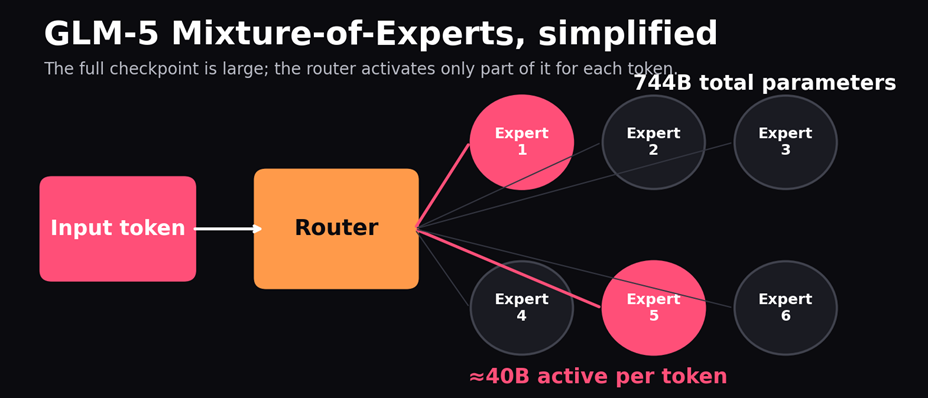
Figura 1. GLM-5 activa aproximadamente 40.000 millones de los 744.000 millones de parámetros por token; el checkpoint completo sigue siendo un despliegue de escala servidor.
El término correcto es "pesos abiertos" (open weights). Existen distintas condiciones para el código, los pesos del modelo, el servicio alojado y los datos de entrenamiento. Conviene revisar la licencia de la ficha del modelo que vayas a usar antes de cualquier uso comercial, ya que no todas las versiones de GLM comparten los mismos derechos.
La familia de versiones de GLM-5
El nombre de familia oculta diferencias importantes. Elige según la modalidad, el contexto, el historial de validación y la vía de despliegue, en lugar de tratar cada versión 5.x como intercambiable.
| Versión | Entrada/contexto | Mejor motivo para usarla | Advertencia importante |
|---|---|---|---|
| GLM-5 | Texto / 200K | Investigación original o integración heredada | Primer lanzamiento de la familia; no es mi opción por defecto para un proyecto nuevo |
| GLM-5-Turbo | Texto / 200K | Trabajo de agentes alojado y con uso intensivo de herramientas | Es una vía de proveedor, no un checkpoint pequeño y descargable |
| GLM-5V-Turbo | Texto, imágenes, video, archivos / 200K | Programación visual y tareas de GUI | Confirma los formatos aceptados en tu endpoint |
| GLM-5.1 | Texto / 200K | Ejecuciones de ingeniería sostenidas | Superado para la mayoría de evaluaciones nuevas |
| GLM-5.2 | Texto / 1M | Contexto largo e integraciones ya probadas | La migración a 5.3 cambia el comportamiento de razonamiento |
| GLM-5.3 | Texto / 1M | Programación difícil y agentes de ejecución prolongada | El razonamiento siempre está activo; la salida puede ser larga |
| GLM-5.3-Flash | Multimodal / 1M | Capturas de pantalla, volumen y bajo coste | Arquitectura independiente de 320B/18B, no es "5.3 con poco esfuerzo" |
Fuentes: notas de lanzamiento de Z.ai, guía de GLM-5-Turbo, guía de GLM-5V-Turbo y guía de GLM-5.1. Un proveedor puede ofrecer una ventana de contexto más pequeña que la que soporta el modelo.
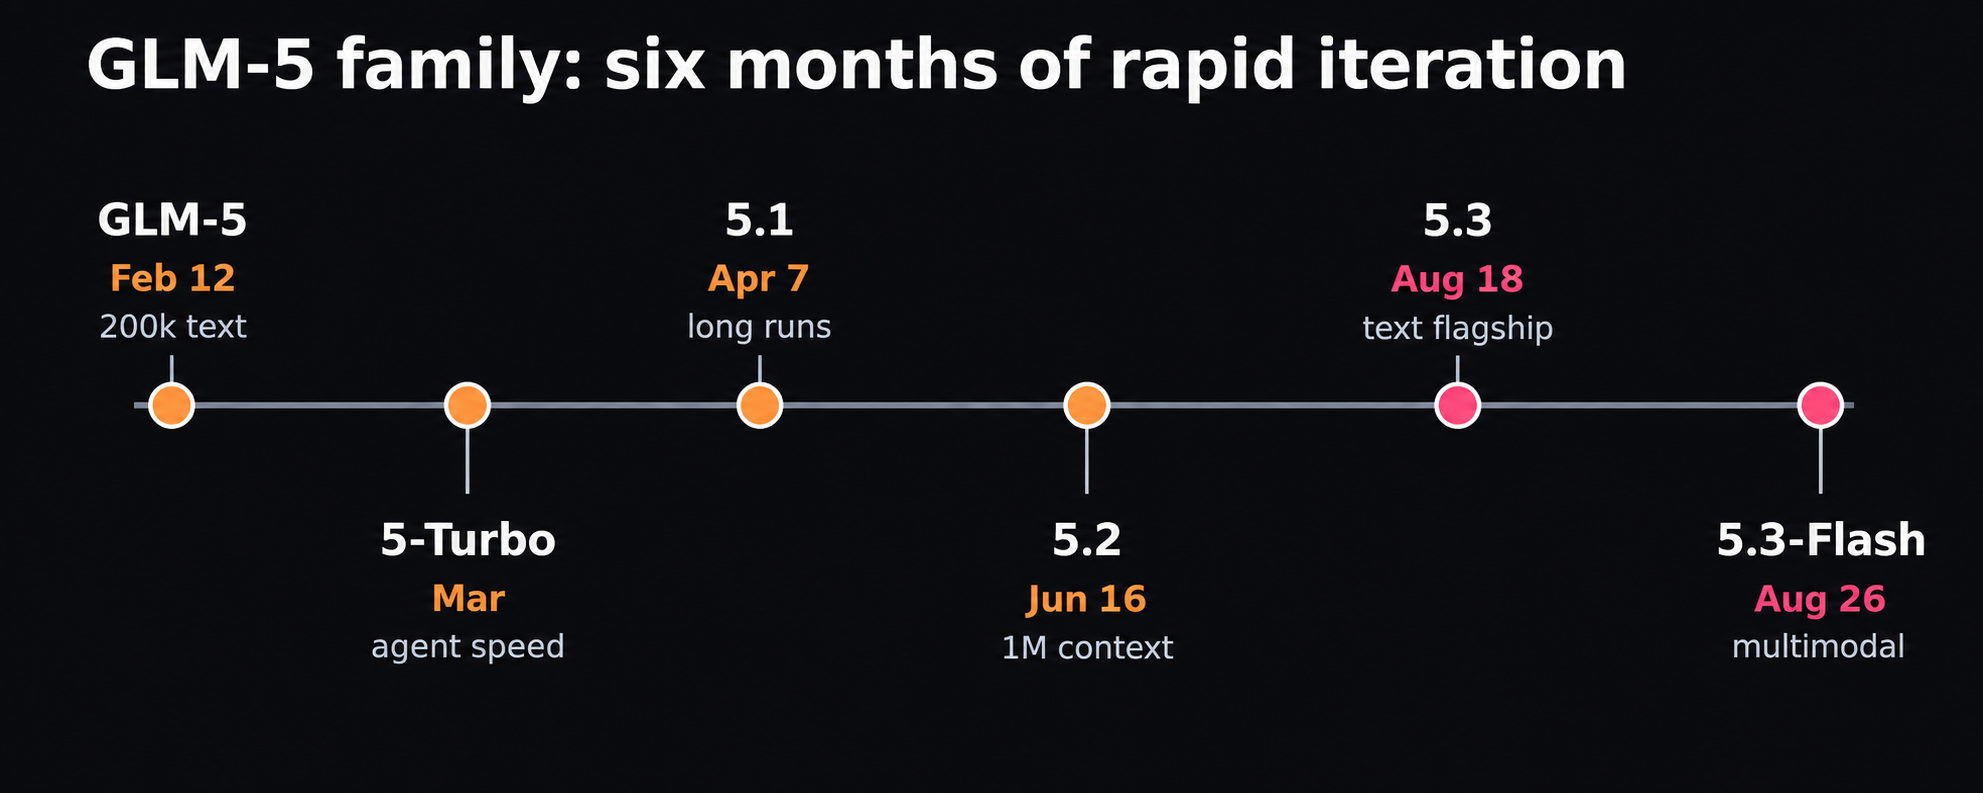
Figura 2. Seis meses de lanzamientos cambiaron la longitud de contexto, la modalidad, el comportamiento de razonamiento y el precio.
De GLM-5 a GLM-5.2
La arquitectura basada en agentes se estableció con el GLM-5 base. GLM-5.1 se centró en ejecuciones sostenidas; Z.ai afirma que puede funcionar hasta 8 horas, aunque conviene tomarlo con cautela, ya que tu repositorio puede comportarse de forma distinta. Después, GLM-5.2 añadió una ventana de contexto de un millón de tokens, ajustes de esfuerzo flexibles e IndexShare para una atención eficiente en contextos largos.
GLM-5.3 y GLM-5.3-Flash
El modelo insignia de GLM solo acepta texto: GLM-5.3. Según su documentación, tiene un límite de 1 millón de tokens de entrada, un límite de 128K en la salida, y niveles de esfuerzo de razonamiento bajo, alto o máximo. El "thinking" no se puede desactivar; una solicitud de 5.2 que lo desactive explícitamente puede fallar durante la migración.
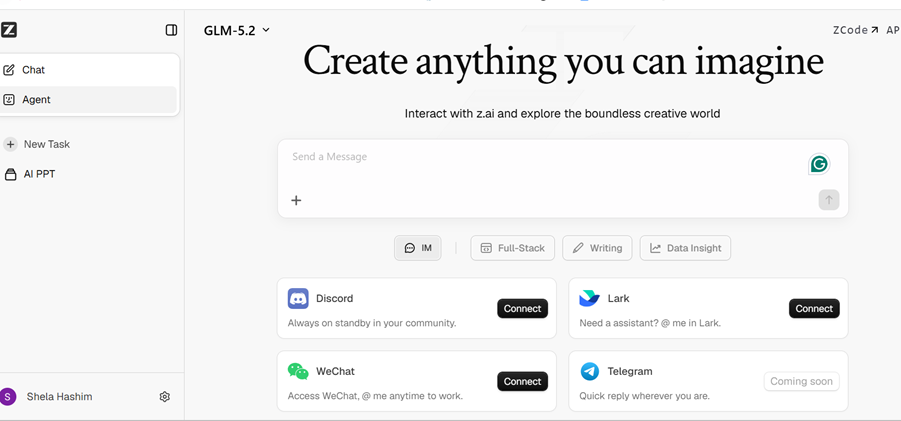
Figura 3. La interfaz en vivo de GLM-5.3 confirma una vía insignia independiente; la disponibilidad y las etiquetas pueden cambiar.
GLM-5.3-Flash es otro modelo con 320B de parámetros totales y 18B activos, que incorpora entrada multimodal nativa y atención híbrida sparse/lineal. Mi recomendación inicial es bastante directa: cuando la profundidad importa, usa 5.3; cuando se trata de capturas de pantalla o mucho volumen, prueba primero Flash.
Antes de modificar una integración existente, repite solicitudes guardadas en lugar de limitarte a cambiar el nombre del modelo. Prueba la salida estructurada, los argumentos de llamadas a herramientas, la longitud máxima de finalización y el manejo de tiempos de espera. Una respuesta puede verse más atractiva en el chat, pero puede hacer que el parser falle o simplemente supere el límite de latencia de tu aplicación. Mantén la vía antigua activa hasta que la nueva versión pase por las mismas pruebas de producción.
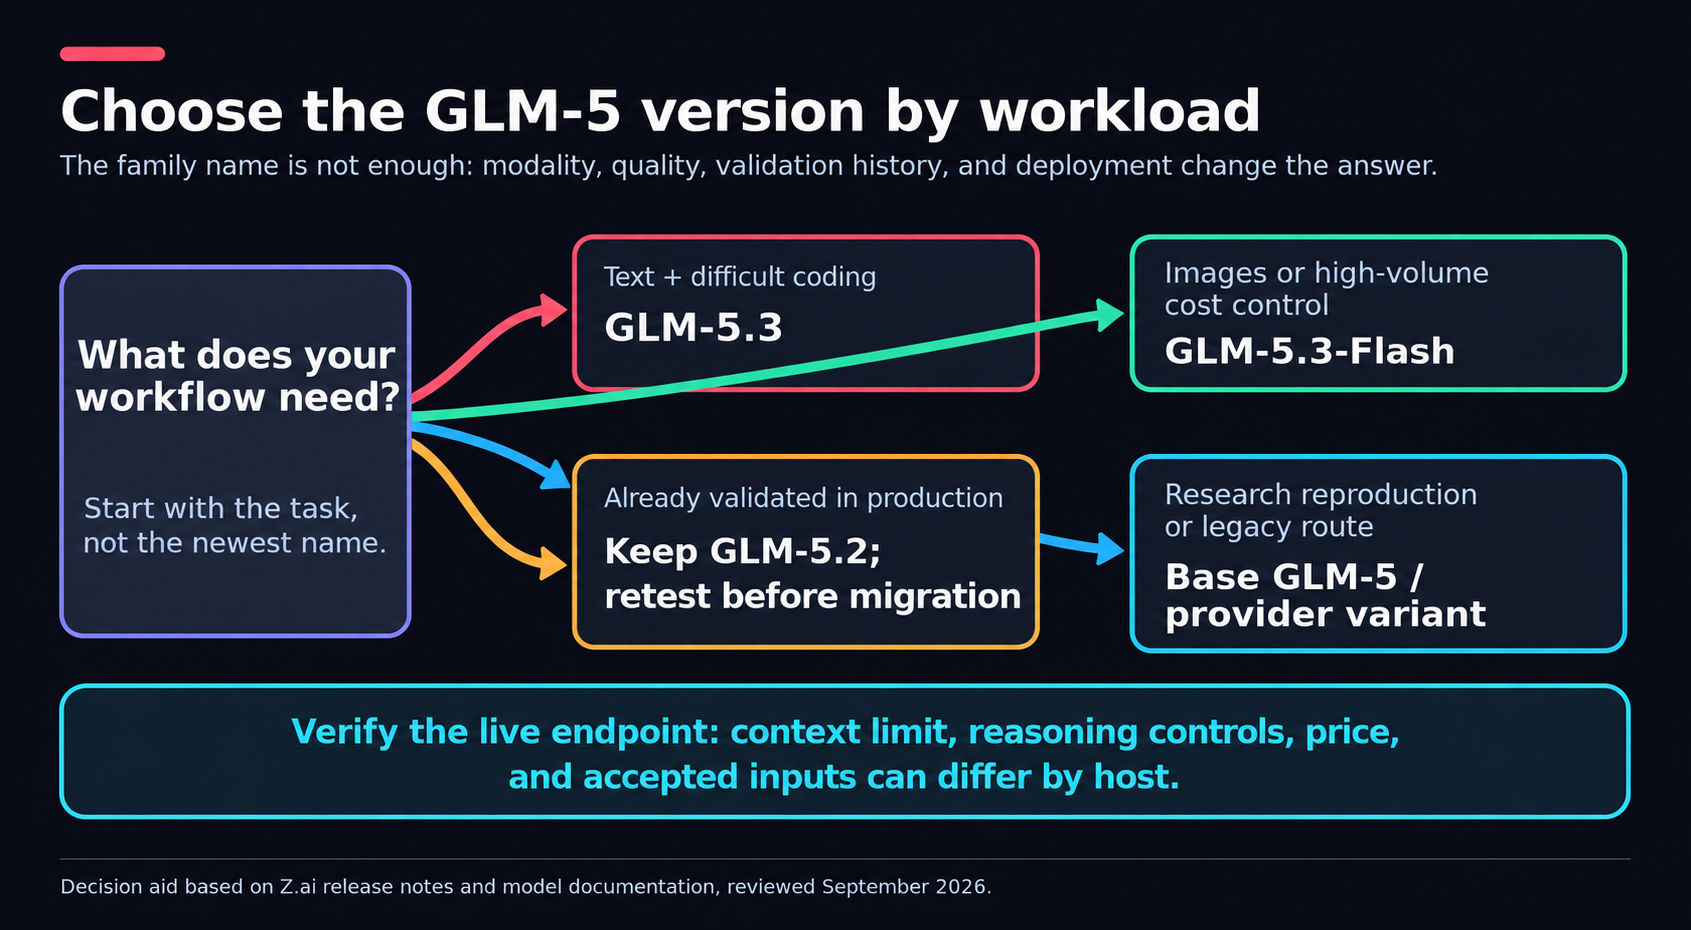
Figura 4. Elige según la carga de trabajo y el comportamiento del endpoint, no solo por el nombre del modelo más reciente.
¿Cómo se compara GLM-5 con Claude, GPT y Gemini?
GLM-5.3 merece estar en cualquier lista corta de agentes de programación, pero una sola tabla no puede coronar a un ganador absoluto. Las puntuaciones de Terminal-Bench dependen del harness, los permisos de herramientas, el presupuesto de tiempo y el nivel de esfuerzo. Z.ai reporta 88,2 en Terminal-Bench 2.1 y 28,3 en Terminal-Bench 3.0 para GLM-5.3 con esfuerzo máximo; su tabla también reproduce resultados de Claude Opus 4.8 y GPT-5.6 Sol.
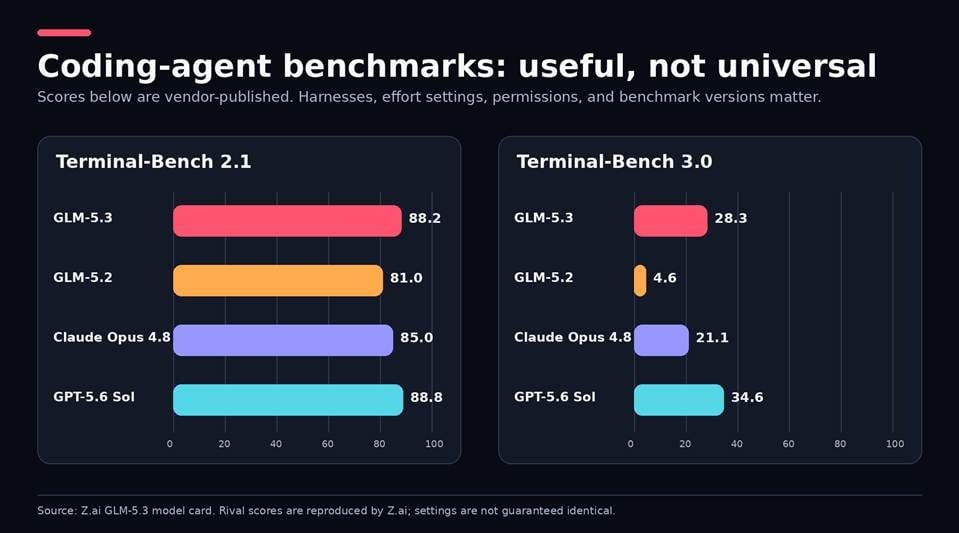
Figura 5. Las puntuaciones publicadas por el proveedor son evidencia orientativa, no sustituyen una prueba idéntica y específica para tu carga de trabajo.
A diferencia de otros modelos, la ficha de GLM-5.3 indica sus harnesses y niveles de esfuerzo. No afirma que los modelos rivales se hayan evaluado en condiciones idénticas. De forma similar, según el informe de GLM-5.2, este supera a Gemini 3.1 Pro en un subconjunto de tareas de Terminal-Bench 2.1, una pequeña parte de las tareas de programación mencionadas aquí; sin embargo, esto no indica que GLM supere a Gemini 3.1 Pro en todas las tareas multimodales, de investigación o de escritura.
Yo evaluaría los modelos con los mismos prompts, herramientas, tiempos de espera y criterios de aprobación. Hay que fijarse en el coste de una tarea exitosa, NO en el coste por token. Un modelo más barato que falla tres veces puede resultar más costoso al final, y si Flash resuelve tus pruebas al primer intento, la ventaja de un modelo insignia pierde sentido.
La ficha de GLM-5.3 es razonablemente singular al mostrar los nombres de los harnesses y los niveles de esfuerzo. Todavía queda por demostrar si otros modelos competidores se probaron en las mismas condiciones. Igualmente, la guía de GLM-5.2 afirma que supera a Gemini 3.1 Pro en Terminal-Bench 2.1 —una tarea orientada a agentes de programación—, no que necesariamente lo supere en tareas multimodales, de investigación o de escritura.
Analizaría los modelos usando los mismos prompts, herramientas, tiempo límite y criterios de aprobación. Me centraría únicamente en el coste de la tarea exitosa, NO en el precio por token. Si las pruebas se superan a la primera, Flash podría resultar la opción más rentable, reduciendo así la ventaja de un modelo insignia.
Dentro del entrenamiento y la arquitectura de GLM-5
Atención dispersa (sparse) e IndexShare
El contexto largo resulta costoso porque la atención normalmente considera muchas relaciones entre tokens. En GLM-5.2 se introdujo un indexador que se reutiliza en cuatro capas diferentes de atención para localizar las posiciones correctas. Z.ai afirma que logran 2,9 veces menos FLOPs por token con 1M de tokens. Es una afirmación de eficiencia del desarrollador, no una declaración sobre la latencia del endpoint ni sobre el coste real de las solicitudes.
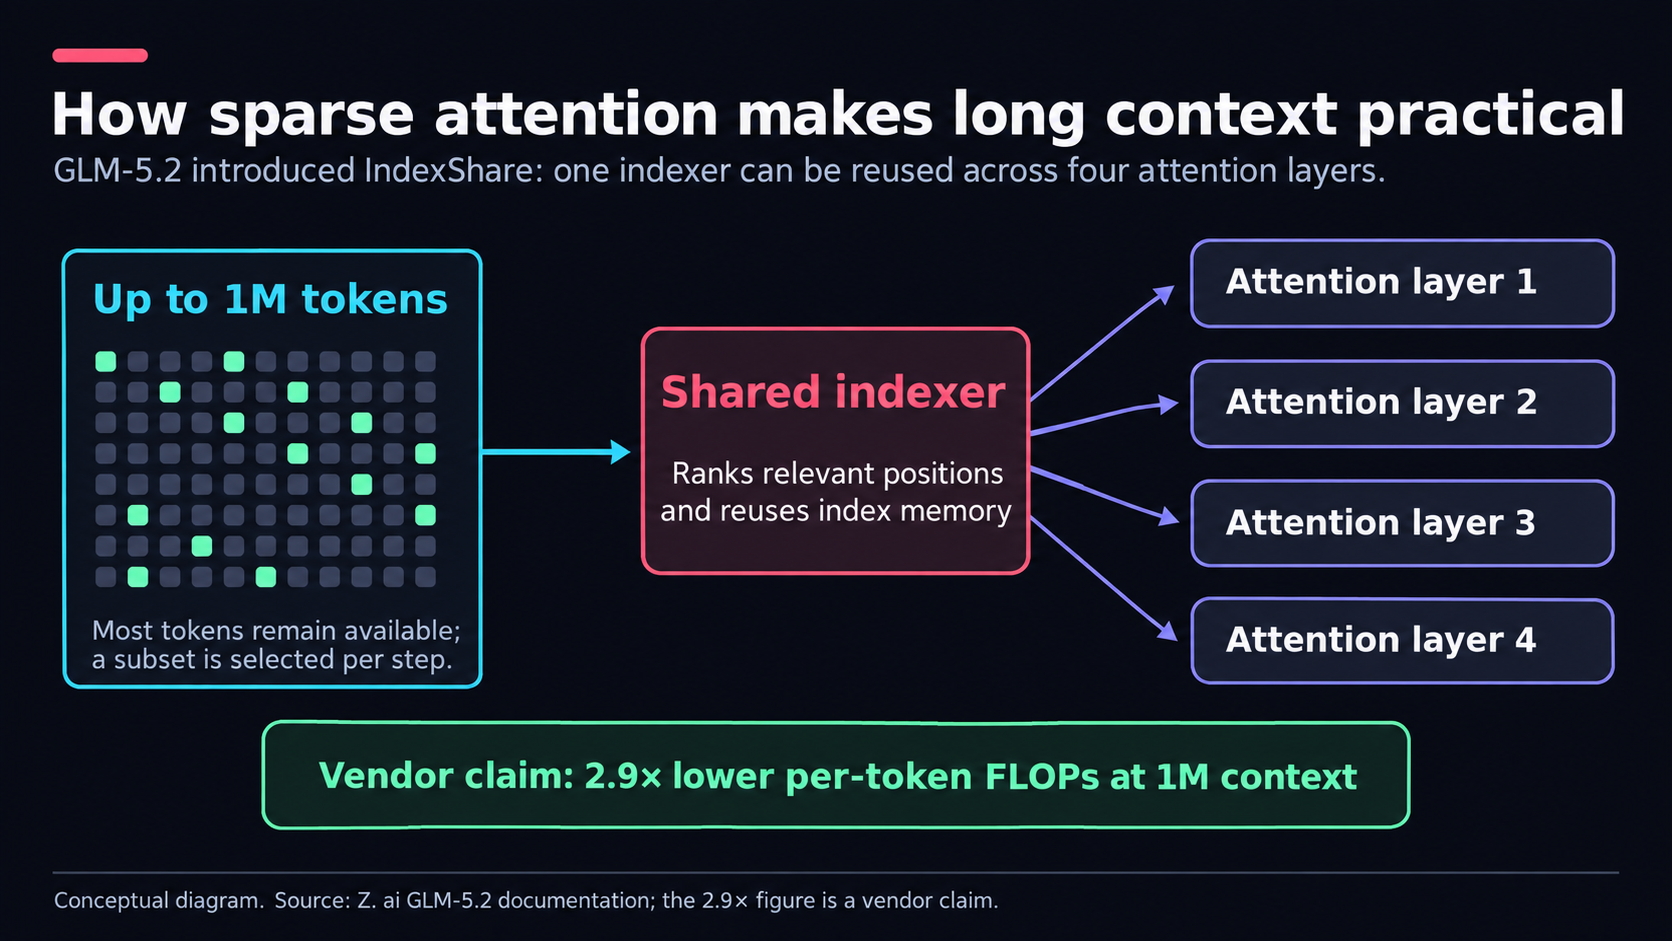
Figura 6. IndexShare reutiliza un indexador en cuatro capas de atención; la cifra de 2,9 veces es una afirmación de Z.ai.
Aprendizaje por refuerzo de largo horizonte
Para GLM-5.3, Z.ai introduce su propia visión de un sistema de aprendizaje por refuerzo asíncrono al que llaman "slime", junto con compactación de contexto y verificadores sintetizados. Estas técnicas se centran en los errores típicos que se observan en agentes durante ejecuciones largas: perder el objetivo, abandonar una tarea o no verificar la respuesta. Aun así, se siguen necesitando checkpoints y pruebas externas, lo que puede implicar trayectorias más largas y trazas de fallos más grandes.
La capacidad de ciberseguridad requiere validación humana
Como parte de su colaboración en seguridad, Z.ai revela 2.436 vulnerabilidades en 269 proyectos de código abierto, de las cuales 1.097 son de severidad media a alta. Es probable que estas cifras sean relevantes para GLM-5.3 en revisiones defensivas, pero GLM-5.3 no identifica una vulnerabilidad confirmada, solo un hallazgo del modelo.
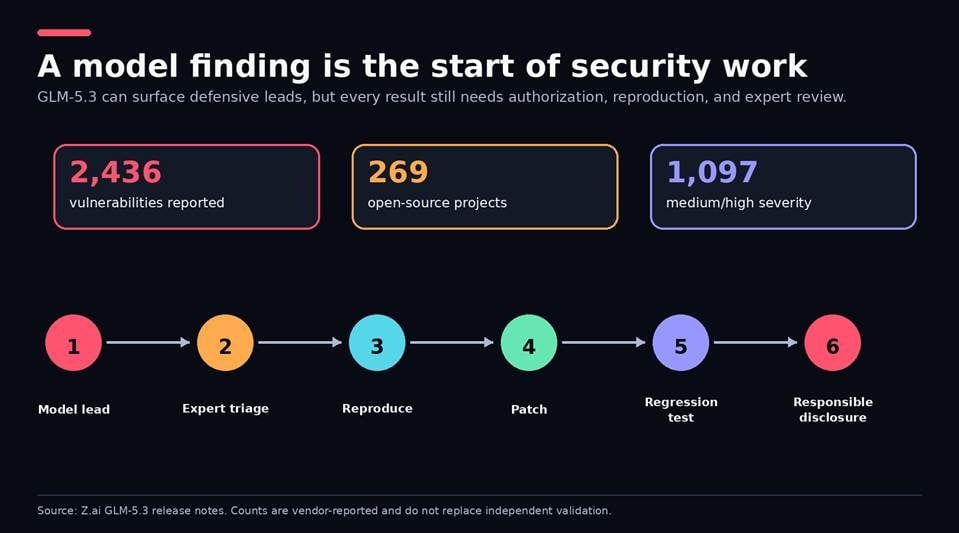
Figura 7. Reproduce, corrige, realiza pruebas de regresión y divulga de forma responsable; nunca dirijas un agente contra sistemas que no estás autorizado a probar.
Precios de GLM-5
Z.ai separa los costes de entrada sin caché, entrada con caché y salida desde septiembre de 2026. He verificado estos precios comparándolos con la página oficial de precios; no asumas que se mantendrán así al planificar tu presupuesto, ya que pueden variar con el tiempo.
| Modelo | Entrada / 1M | Entrada con caché / 1M | Salida / 1M |
|---|---|---|---|
| GLM-5 | $1,00 | $0,20 | $3,20 |
| GLM-5.1 | $1,40 | $0,26 | $4,40 |
| GLM-5.2 | $1,40 | $0,26 | $4,40 |
| GLM-5.3 | $1,40 | $0,26 | $4,40 |
| GLM-5.3-Flash | $0,15 | $0,03 | $0,50 |
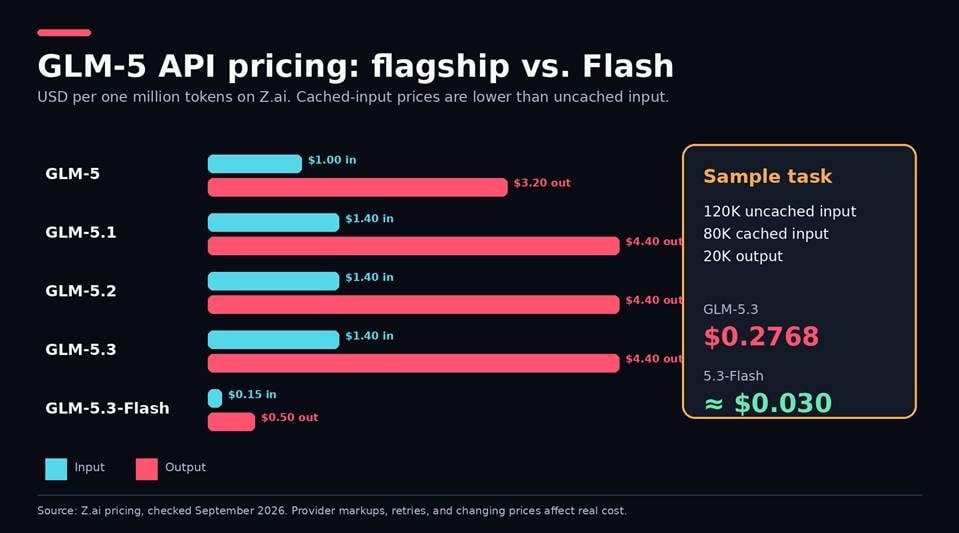
Figura 8. Los precios de la API de Z.ai muestran por qué la longitud de salida y los reintentos pueden dominar la factura final.
El coste de GLM-5.3 es de aproximadamente $0,2768 para 120K de entrada sin caché, 80K de entrada con caché y 20K de salida; en 5.3-Flash es de aproximadamente $0,030 (sin contar reintentos). Otros proveedores como OpenRouter pueden ofrecer precios, límites, latencia y enrutamiento distintos. El GLM Coding Plan no es una cuota de API para producción, sino una suscripción independiente para herramientas de programación compatibles.
La salida es el aspecto más costoso de la solicitud, y un agente que razona durante mucho tiempo puede superar fácilmente una estimación rápida. Yo pondría un límite máximo de salida, usaría caché cuando el contexto repetido lo permita, y registraría el coste por tarea completada. Al elaborar un presupuesto de producción, hay que considerar los reintentos, las llamadas a herramientas fallidas y el tiempo humano necesario para corregir respuestas deficientes. Esa es la cifra que deberías comparar entre proveedores.
Cómo usar GLM-5
| Vía | Mejor para | Dónde se ejecuta la inferencia |
|---|---|---|
| Z.ai Chat | Evaluación cualitativa rápida | Servidores de Z.ai |
| API de Z.ai | Integración de primera parte | Servidores de Z.ai |
| OpenRouter | Elección de proveedor y failover | Proveedor alojado seleccionado |
| Enter MaaS | Acceso al modelo dentro de un flujo de creación de apps | Vía alojada visible en Enter |
| Hugging Face + vLLM/SGLang | Despliegue autogestionado | Tu propia infraestructura |
| Ollama :cloud | Acceso remoto a través del cliente Ollama | Servidores remotos, no tu portátil |
Empieza con Z.ai Chat
La vía con menor fricción para probar GLM-5 en chat es chat.z.ai. Úsala para probar el comportamiento del prompt y la estructura de salida, pero fíjate en el modelo exacto que muestra la interfaz. No prometas a un equipo un uso "gratuito" o "ilimitado" sin comprobar la cuota actual de la cuenta.
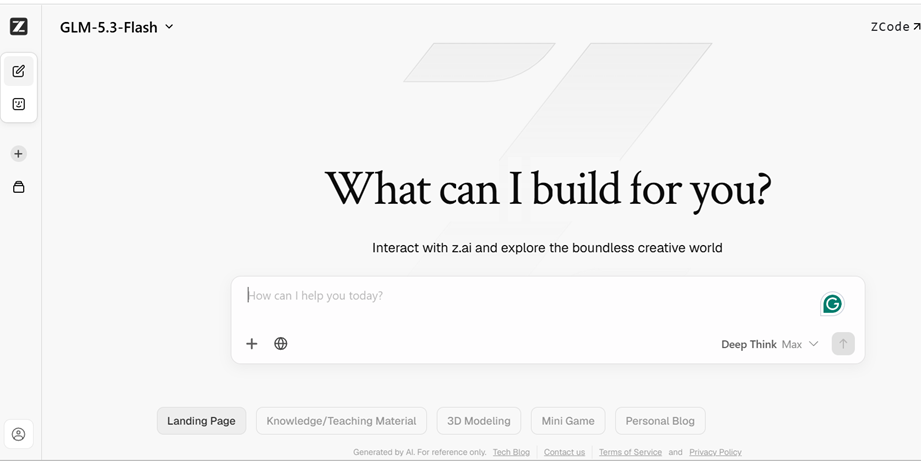
Figura 9. La interfaz de chat permite una comprobación cualitativa rápida, pero el modelo mostrado y la cuota de la cuenta siguen siendo relevantes.
Llama a la API de Z.ai o a OpenRouter
Z.ai ofrece un endpoint compatible con OpenAI, lo que significa que puedes usar el SDK oficial de Python con una URL base distinta. Guarda la clave de API en una variable de entorno y registra el ID del modelo, el esfuerzo, el número de tokens usados y si la solicitud se completó.
Figura 10. El endpoint compatible con OpenAI de Z.ai reduce los cambios en el SDK; no elimina la necesidad de pruebas de migración.
import os

from openai import OpenAI

client = OpenAI(

        api_key=os.environ["ZAI_API_KEY"],

        base_url="https://api.z.ai/api/paas/v4/",

)

response = client.chat.completions.create(

        model="glm-5.3",

        messages=[{"role": "user", "content": "List five tests for a password-reset flow."}],

        max_tokens=4096,

        extra_body={"thinking": {"type": "enabled"}, "reasoning_effort": "high"},

)

print(response.choices[0].message.content)
Al migrar desde 5.2, elimina cualquier solicitud que desactive explícitamente el "thinking"; GLM-5.3 no acepta ese comportamiento. Si usas la vía GLM-5.3 de OpenRouter, registra qué proveedor gestionó la solicitud cuando la gobernanza o la reproducibilidad sean importantes.
Descarga y autogestiona los pesos
Usa el repositorio oficial o la ficha verificada de GLM-5.3 en Hugging Face. Z.ai enumera SGLang, vLLM, Transformers, KTransformers y Unsloth entre las vías compatibles.
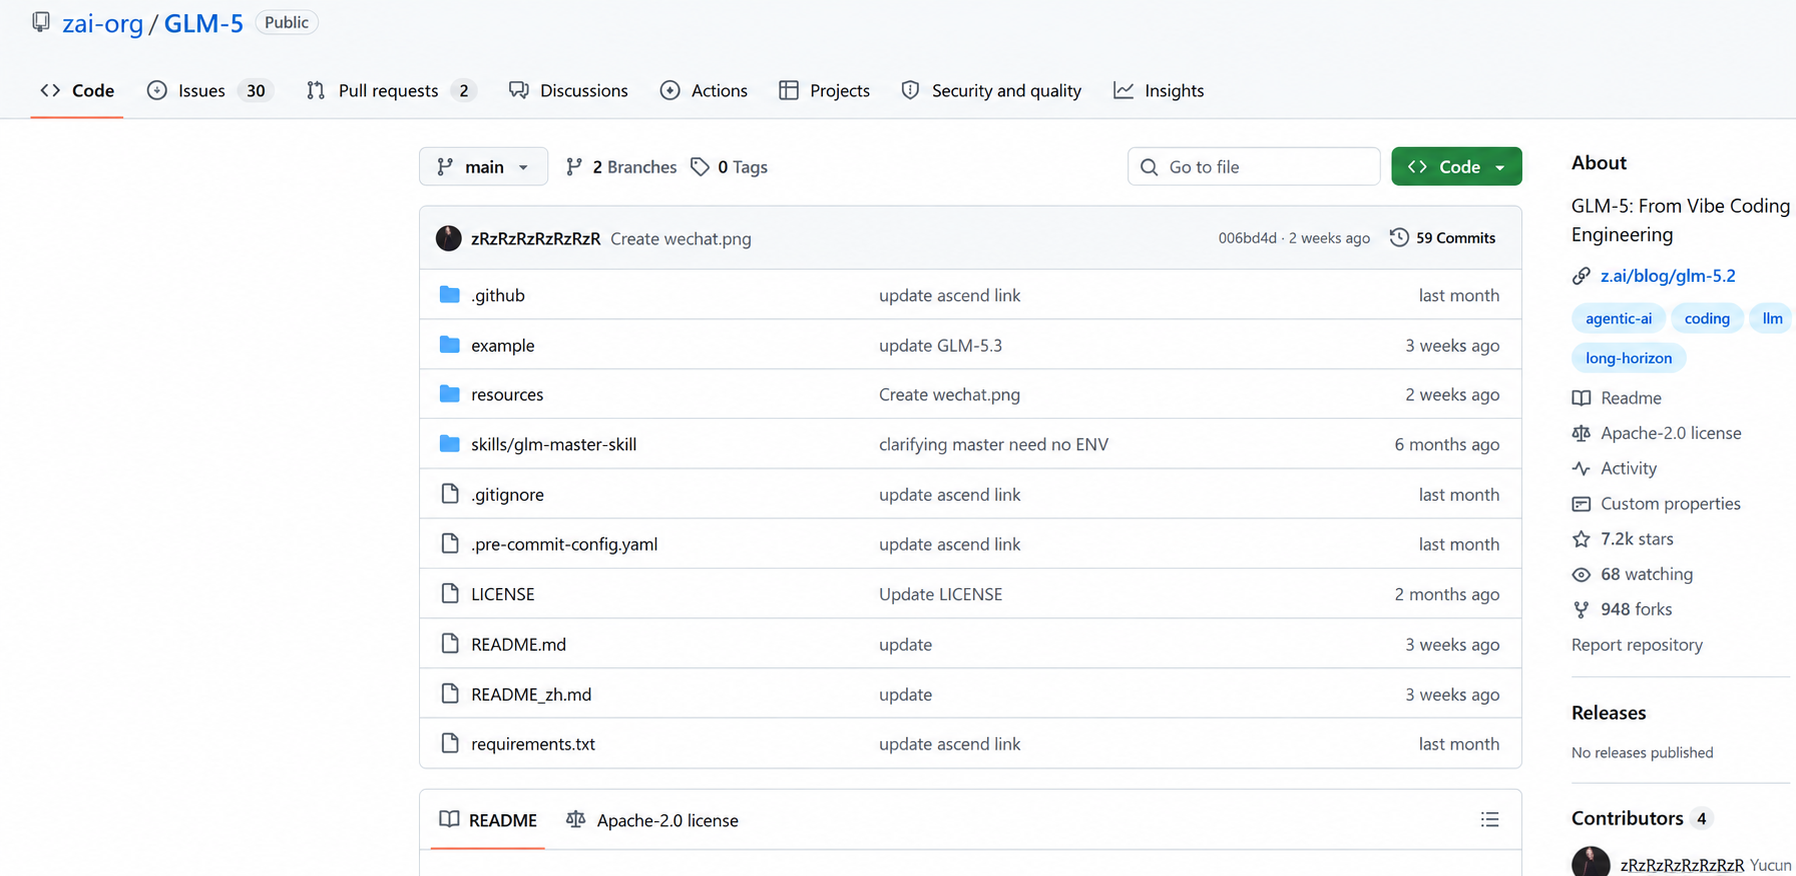
Figura 11. Usa el repositorio verificado y la ficha oficial del modelo, no un espejo de pesos no oficial.
Que algo sea descargable NO significa que sea ejecutable. La cuantización reduce los requisitos de memoria, pero puede alterar la calidad; con un checkpoint de 744B se necesita almacenamiento y aceleradores de nivel servidor. Lee con atención el listado de GLM-5 en Ollama: una etiqueta con "cloud" significa que es inferencia remota. Para ejecución local real se necesitan pesos locales, runtime local y hardware suficiente.
Cómo evaluaría GLM-5 antes de pasar a producción
No empezaría con una pregunta genérica tipo "¿qué modelo es más inteligente?". Ejecutaría cuatro tareas representativas frente a 5.2, 5.3 y Flash usando las mismas herramientas y límites: corregir un error en un repositorio, recuperar datos insertados en un documento largo, completar un flujo de trabajo multiherramienta con un fallo inducido, y producir una salida evaluada contra una rúbrica escrita.
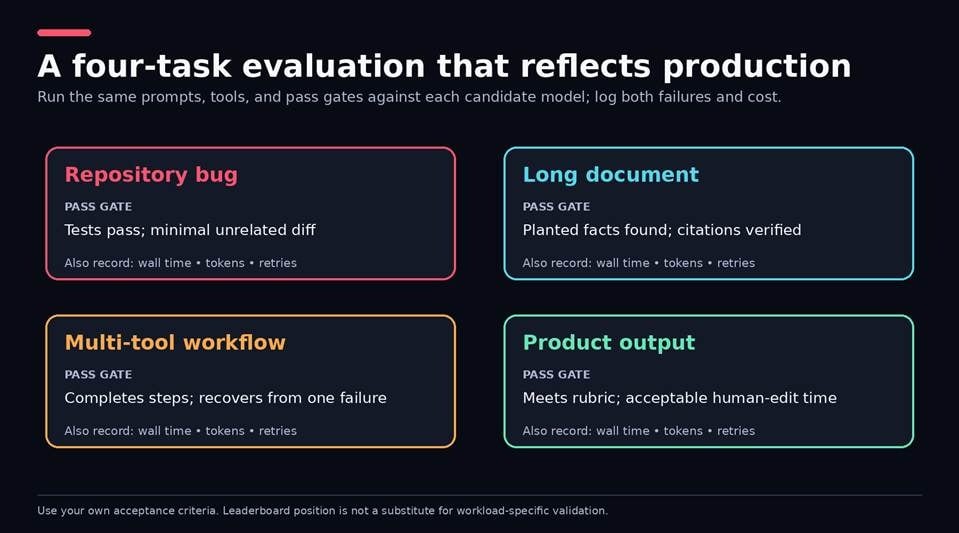
Figura 12. Una prueba pequeña y repetible de carga de trabajo es más útil que una pregunta genérica sobre el "modelo más inteligente".
Aprobado/fallido, tiempo real, tokens, reintentos, tiempo de edición humana y proveedor. Esto permite detectar riesgos de migración que los promedios de los benchmarks no muestran, como el razonamiento siempre activo de 5.3 y una salida potencialmente larga. También te indica si el precio más bajo de Flash sobrevive al contacto con tus pruebas de aceptación.
¿Quién debería usar GLM-5?
Programación agéntica y trabajo en repositorios
GLM-5 es una excelente opción si una tarea implica buscar en un repositorio, ediciones coordinadas, ejecución de pruebas y llamadas a herramientas. La evidencia pública de benchmarks respalda esta recomendación, pero tu puerta de aceptación debe ser sólida: las pruebas deben pasar, el diff debe ser enfocado y no se debe cruzar ningún límite de credenciales o de red. Proporciona un área de trabajo separada y aplica el principio de mínimo privilegio. Más autonomía sin controles solo produce trazas de fallos más grandes.
Documentos largos y trabajo de conocimiento
Los modelos de un millón de tokens son adecuados para especificaciones, paquetes de investigación y grandes bases de código. Una ventana de contexto grande no debería considerarse recuperación fiable. Coloca la información clave al principio, en el medio y al final; cita las fuentes; verifica la información citada. También recomendaría considerar una canalización de recuperación, ya que meter todo en un único prompt grande puede ser más lento y costoso que seleccionar primero la evidencia relevante.
Flujos de trabajo multimodales y defensivos
Con GLM-5.3-Flash o GLM-5V-Turbo, las capturas de pantalla, los estados de interfaz u otras entradas visuales que requiera la tarea forman parte del trabajo habitual. Usa todos los hallazgos como pistas para la revisión de seguridad defensiva, y reprodúcelos y clasifícalos por prioridad. GLM-5 es menos adecuado para quienes buscan un modelo pequeño que funcione en un portátil local, no pueden tomar decisiones de despliegue, o no pueden verificar la residencia del proveedor ni los términos de retención.
¿Es seguro GLM-5 para datos privados o de empresa?
Vías alojadas
No depende solo del modelo, sino de la vía de acceso. Existen distintas rutas de datos, como Z.ai Chat, la API de Z.ai, otro proveedor o un despliegue autogestionado. Empieza con la política de privacidad de Z.ai, y después revisa con todos los intermediarios la retención, el uso para entrenamiento, la eliminación, la residencia de datos y las condiciones contractuales.
Fija un proveedor específico si un agregador lo permite, y no envíes secretos solo porque sea conveniente. Lo que ocurre con los datos alojados lo determinan tu contrato y tu configuración, no la expresión "pesos abiertos".
Autogestión (self-hosting)
El autoalojamiento mantiene los prompts dentro de tu entorno, pero tú eres responsable de los pesos, las credenciales, los parches, los controles de red y la monitorización. Aun así, yo seguiría asumiendo que existe la posibilidad de que se inyecte código generado inseguro en etapas tempranas. Separa las credenciales de build y de producción, limita el acceso de red saliente, auditoría las acciones de las herramientas y mantén aprobaciones humanas para cambios importantes. No concedas a los agentes más autoridad de la necesaria para la tarea.
Cómo usar GLM-5 con Enter Pro
GLM-5 no es un competidor directo de Enter Pro. GLM aporta capacidad de modelo, mientras que Enter Pro ofrece un flujo de construcción de producto alrededor de los modelos. Esto resulta útil cuando no buscas simplemente "obtener una respuesta", sino "obtener una respuesta que pueda convertirse en interfaz, lógica y una vía de publicación".
Si necesitas control de la API, infraestructura personalizada o una estructura de datos específica, la vía directa es la mejor opción. Cuando la solución alternativa a nivel de producto se convierte en un factor limitante, entra en juego Enter Pro. Su AI MVP Builder agiliza la planificación, la creación de la app, la edición visual y la publicación en un solo proceso, mientras que Enter Code ofrece un enfoque centrado en la terminal para tareas de repositorio.
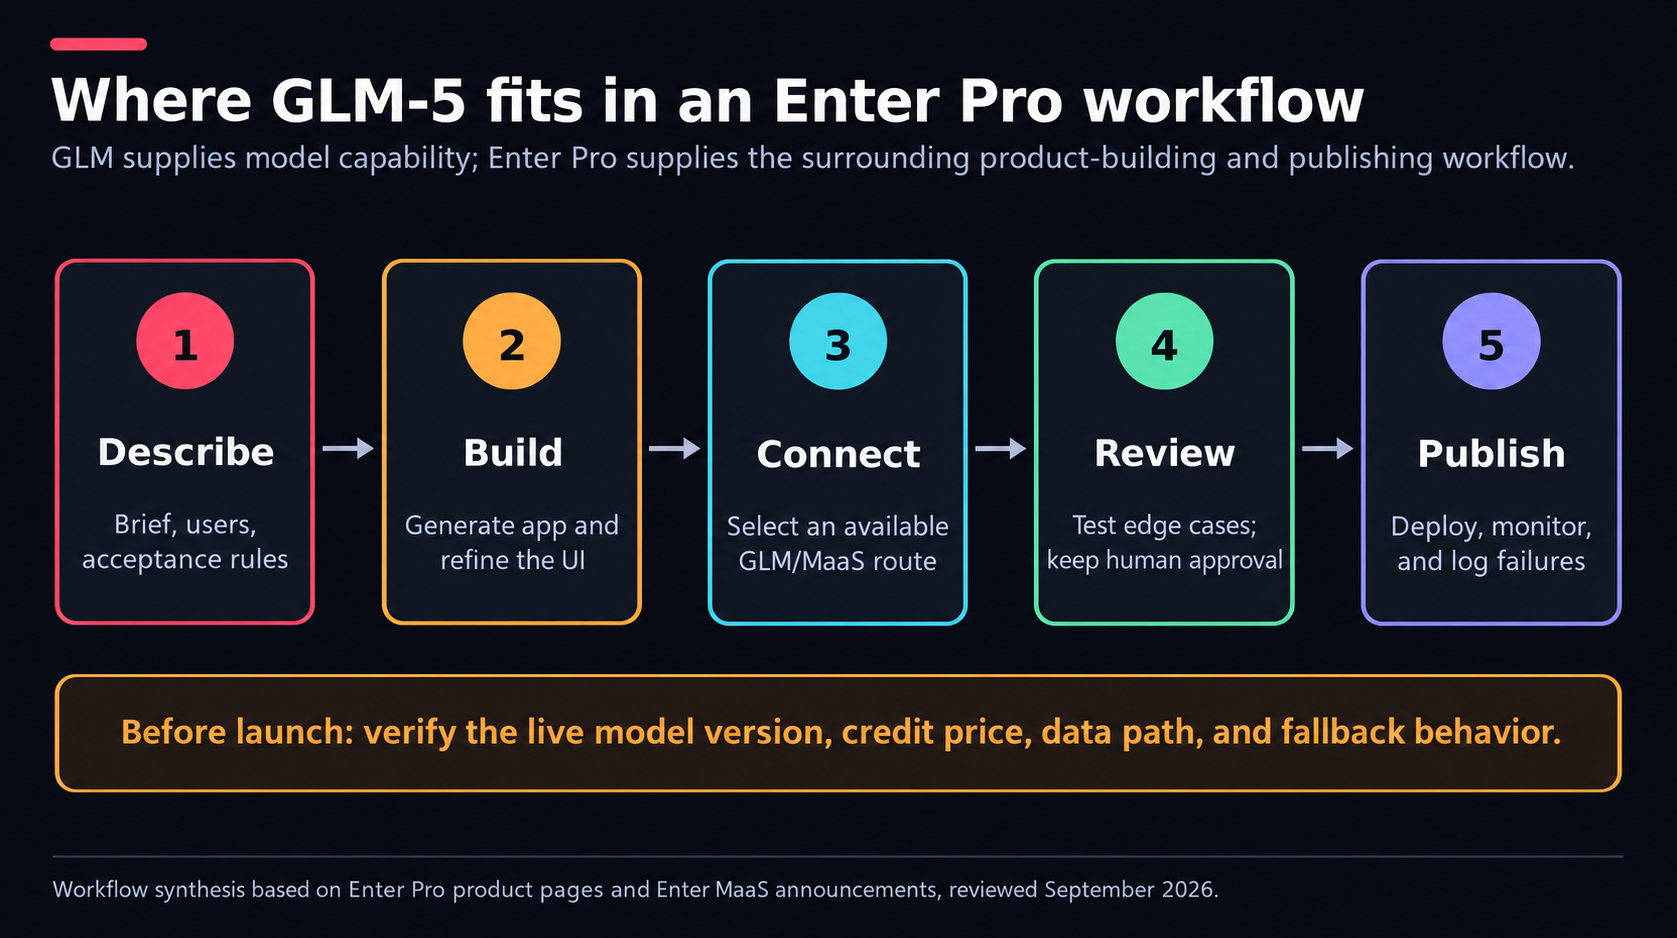
Figura 13. El modelo genera o clasifica; el flujo de trabajo del producto añade UI, revisión, despliegue y monitorización.
El changelog de Enter confirma que GLM-5.2 estaba en el catálogo anterior de AI All el 17 de junio. El anuncio de Enter MaaS menciona GLM 5 y explica cómo se tarifican los modelos en créditos. No llega a confirmar explícitamente GLM-5.3, así que conviene revisar el selector de modelos en vivo, el precio en créditos, el límite de contexto y la vía de datos antes de diseñar en torno a una versión específica.
Una app de triaje de soporte muestra bien dónde tiene sentido esta combinación. Con Enter Pro puedes diseñar el formulario de tickets y el panel de visualización, y conectar una vía GLM existente para categorizar tickets y redactar respuestas. Antes de publicar, valida respuestas vacías del modelo, solicitudes ambiguas, entradas multilingües, inyección de prompts y datos privados dentro del cuerpo del mensaje. Mantén a una persona entre el borrador y el botón de enviar.
| Si tu prioridad es… | Elige una vía GLM directa | Elige Enter Pro |
|---|---|---|
| Parámetros del modelo y control del proveedor | Sí | Solo dentro de las opciones expuestas |
| Creación y edición visual de apps | Construir o añadir herramientas aparte | Ventaja central del flujo de trabajo |
| Hosting personalizado y política de red | Mejor opción | Verificar primero la idoneidad de la plataforma |
| Camino rápido de la salida del modelo a la UI del producto | Requiere más ingeniería | Opción más adecuada |
Pero Enter no hace que GLM sea más inteligente, y que GLM tenga acceso a una app tampoco hace más inteligente a su agente de programación. Si se trata de integración o trabajo de UI, yo optaría por Enter. Si estás en esa situación, abre el espacio de trabajo de Enter Pro y revisa el catálogo de modelos disponible antes de comprometerte con una arquitectura.
Conclusión
Aunque se llame GLM-5, la variante y el método de servicio son igual de importantes que el modelo en sí a la hora de programar y usar agentes de largo horizonte. Usa GLM-5.3 para texto y código complejo, GLM-5.3-Flash para multimodalidad o volumen, y mantén 5.2 hasta que la migración resulte rentable. Luego, prueba con tus propias tareas antes de usar las cifras del proveedor líder como evidencia de producción.
El modelo que realmente funciona es el que cumple tus criterios de aceptación, se mantiene dentro de tus márgenes de latencia y privacidad, y conserva el precio adecuado incluso después de los reintentos, independientemente de la puntuación casi perfecta que pueda lograr en un benchmark concreto.
Empieza a construir con Enter Pro →
Preguntas frecuentes
¿Es GLM-5 gratuito?
Los pesos públicos están disponibles para descarga sin tarifas de API por token, pero el hardware y la operación tienen un coste. Z.ai Chat puede ofrecer acceso basado en cuotas. Las APIs alojadas, los enrutadores y los servidores con GPU son servicios de pago, y puede haber diferencias según la versión y la vía elegida.
¿Qué versión de GLM-5 es mejor?
Para texto o código complejo, empiezo con GLM-5.3. GLM-5.3-Flash es la mejor opción inicial para imágenes, capturas de pantalla o volumen con coste crítico. No cambies de GLM-5.2 si ya está validado y el riesgo de migrar supera el beneficio potencial.
¿GLM-5 puede escribir y depurar código?
Sí. Los agentes de programación y la ingeniería a escala de repositorio son casos de uso clave, con buenos resultados reportados por los proveedores en Terminal-Bench y DeepSWE. Aun así, se sigue necesitando un sandbox, pruebas, permisos restringidos y revisión humana.
¿Cuánto cuesta la API de GLM-5?
En septiembre de 2026, Z.ai lista GLM-5 a $1,00 de entrada y $3,20 de salida por millón de tokens; GLM-5.3 a $1,40 y $4,40; y 5.3-Flash a $0,15 y $0,50. La entrada con caché es más económica. El coste real se ve afectado por los márgenes de los proveedores y los reintentos.
¿GLM-5 es software de código abierto?
"Pesos abiertos" es el término más preciso. La licencia de los pesos, la licencia del código del repositorio y la transparencia de los datos de entrenamiento son cuestiones distintas. Antes de un despliegue comercial, revisa la ficha específica del modelo en Hugging Face y la licencia del repositorio.
¿Se puede usar GLM-5 localmente (con Ollama)?
Solo si cuentas con pesos locales, soporte de runtime y hardware suficiente para ello. La etiqueta "cloud" significa que se ejecuta en infraestructura remota, por lo que no implica necesariamente que todo el modelo de 744B esté corriendo en tu dispositivo.
¿GLM-5 puede procesar imágenes?
El GLM-5 base y GLM-5.3 solo aceptan texto. Para entradas multimodales, usa GLM-5.3-Flash o GLM-5V-Turbo; comprueba los tipos de archivo aceptados en el endpoint elegido.





