
GPT-5.2 explicado: funciones, benchmarks, precios y casos de uso
Descubre GPT-5.2 Instant, Thinking, Pro y Codex: precios, benchmarks, acceso, límites y cómo se compara con Gemini 3 para desarrolladores en 2026.
Figura 1. GPT-5.2 evaluado en calidad, velocidad, coste y control
Elegí GPT‑5.2 Pro en Enter Pro para crear un revisor de briefs de proyecto que convierte ideas de apps en requisitos y criterios de aceptación. Las capturas muestran la configuración y el resultado de la revisión; la verificación de una solicitud completada sigue siendo un paso abierto.
Ese caso práctico ofrece un punto de referencia concreto para esta guía. Separo los resultados oficiales de los benchmarks de lo que la aplicación mostró realmente, y después examino las capacidades, precios y límites de la familia de modelos. Debes identificar la variante exacta antes de aplicar una observación a Instant, Thinking, Pro o Codex.
OpenAI presentó la familia el 11 de diciembre de 2025 como un lanzamiento orientado al trabajo profesional y a agentes de larga duración. Su informe de lanzamiento aporta la línea base oficial de benchmarks y precios. Utilizo ese informe junto con información de enrutamiento actual, críticas independientes relevantes y reportes de la comunidad, porque ninguna fuente por sí sola capta tanto el rendimiento controlado como la fricción del día a día.
Las personas que buscan Chat GPT 5.2 a menudo se refieren a toda la familia de diciembre de 2025, pero la distinción entre los modos de ChatGPT y los IDs de modelo de la API importa. Una prueba de Instant no determina el comportamiento, el precio ni la latencia de Thinking, Pro o el modelo especializado en código.
GPT-5.2 de un vistazo
A fecha de 9 de octubre de 2026, OpenAI lista GPT‑5.2 y GPT‑5.2 Pro como opciones de la generación anterior. Los proyectos existentes pueden valorar su comportamiento conocido y sus snapshots fijados, mientras que un proyecto nuevo debería comparar los modelos actualmente recomendados con los mismos criterios de aceptación.
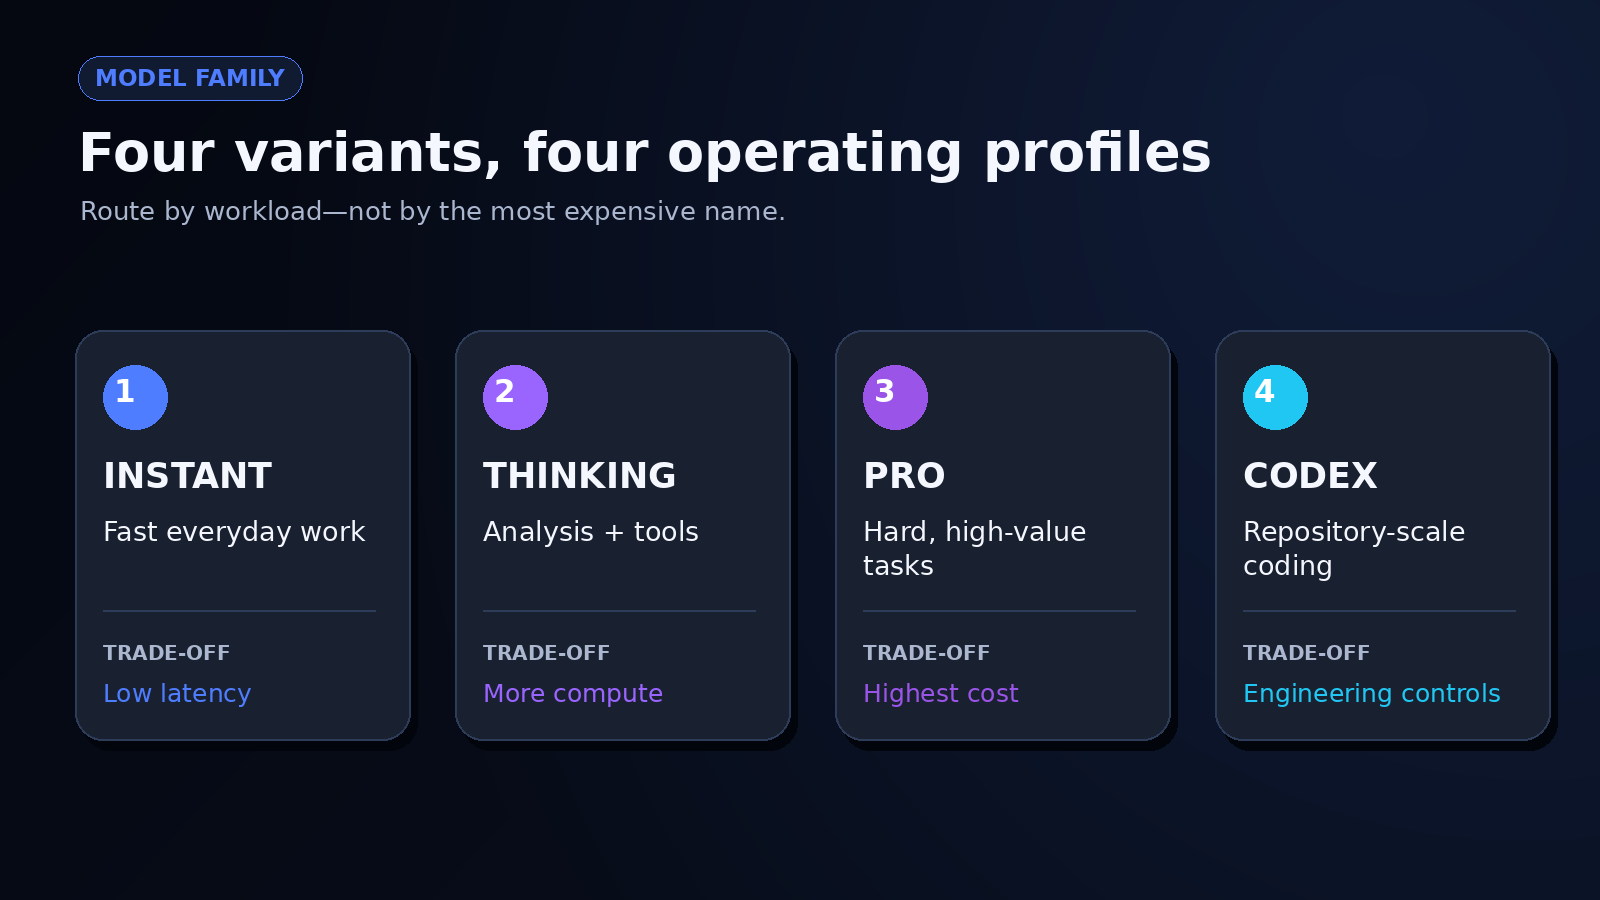
Figura 2. Instant, Thinking, Pro y Codex mapeados a tipos de carga de trabajo
| Especificación | GPT-5.2 | GPT-5.2 Pro |
|---|---|---|
| Posición actual | Buque insignia anterior | Modelo Pro anterior |
| Ventana de contexto | 400.000 tokens | 400.000 tokens |
| Salida máxima | 128.000 tokens | 128.000 tokens |
| Corte de conocimiento | 31 de agosto de 2025 | 31 de agosto de 2025 |
| Modalidades | Entrada/salida de texto; entrada de imagen | Entrada/salida de texto; entrada de imagen |
| Esfuerzo de razonamiento | ninguno, bajo, medio, alto, muy alto | medio, alto, muy alto |
| Precio API por 1M tokens | $1,75 entrada; $0,175 caché; $14 salida | $21 entrada; $168 salida |
| Salidas estructuradas | Soportado | No soportado |
| Fine-tuning | No soportado | No soportado |
| Snapshot | gpt-5.2-2025-12-11 | gpt-5.2-pro-2025-12-11 |
Estado actual, contexto y modalidades
La ventana de contexto de 400.000 tokens y el límite de salida de 128.000 tokens son inusualmente grandes, pero capacidad no es lo mismo que memoria. Si colocas contratos, logs, capturas de pantalla y requisitos en una sola solicitud, igual necesitas una prueba de recuperación: siembra datos en distintas posiciones, haz preguntas que requieran combinarlos y registra lo que el modelo omite. Yo no inferiría un razonamiento fiable sobre documentos largos solo a partir del número de contexto.
Los modelos aceptan imágenes y producen texto; no aceptan audio ni vídeo como entradas nativas. Esto los hace útiles para gráficos, capturas de interfaz, diagramas y documentos escaneados, siempre que verifiques detalles espaciales y valores extraídos. Una etiqueta borrosa o una escala de gráfico poco habitual pueden convertir una explicación aparentemente segura en un error plausible.
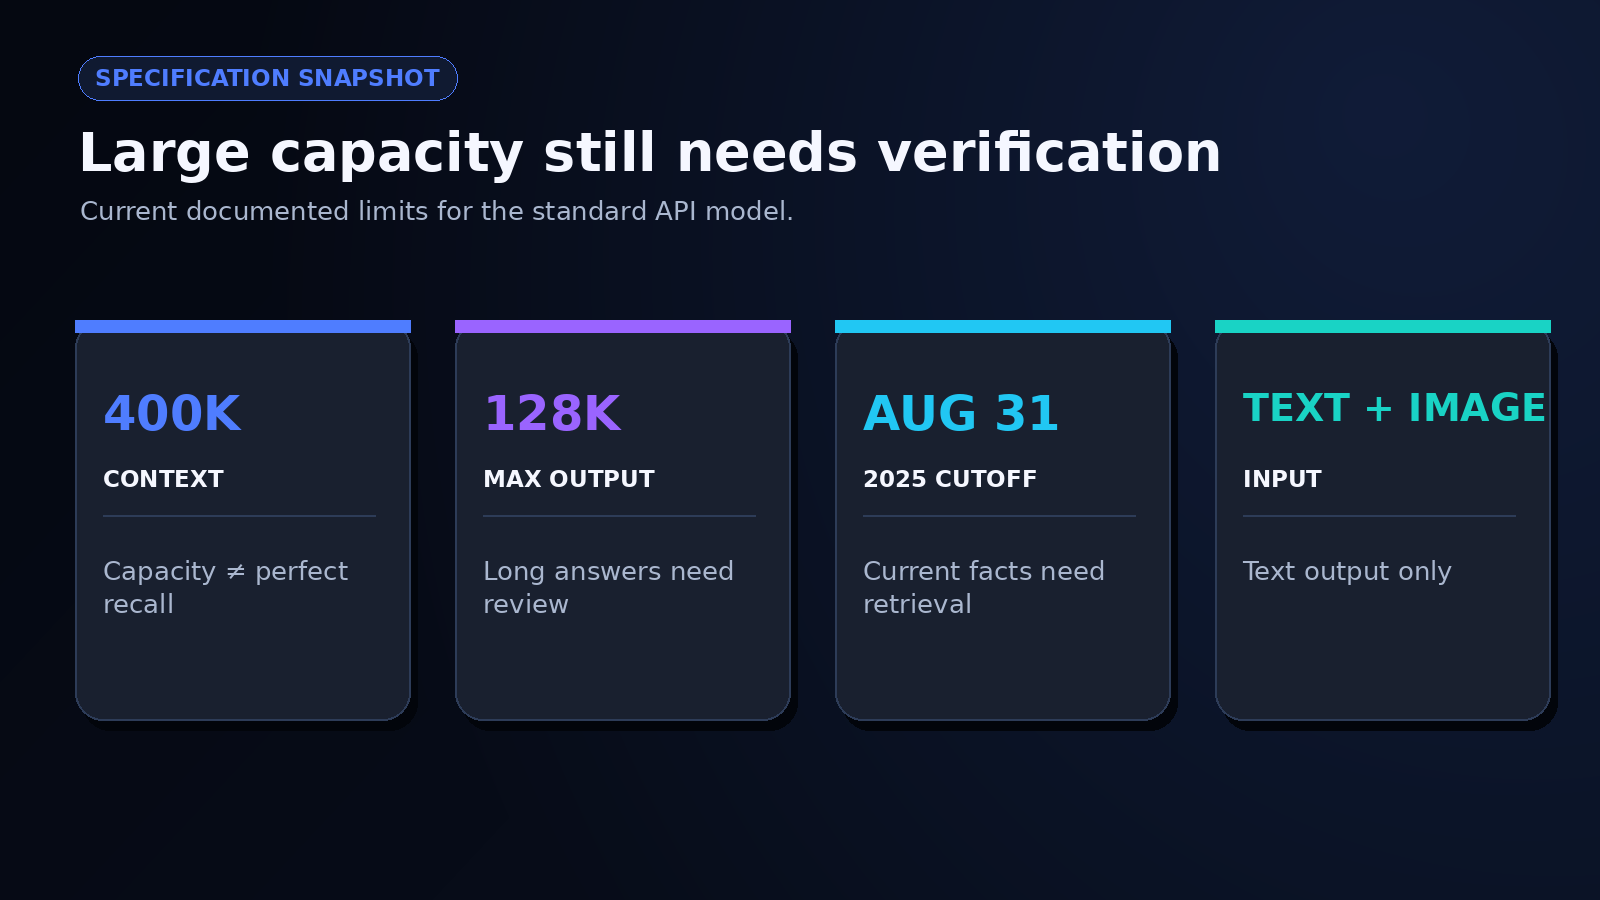
Figura 3. contexto, salida, modalidades, corte de conocimiento y snapshots
Precios y acceso a la API
El modelo estándar de la API cuesta $1,75 por millón de tokens de entrada, $0,175 por millón de tokens de entrada en caché y $14 por millón de tokens de salida. GPT 5.2 Pro cuesta $21 de entrada y $168 de salida. Los tokens de razonamiento, los reintentos, las llamadas a herramientas y la corrección humana afectan al coste de un resultado aceptado. Si usas una plataforma de integración, revisa sus unidades de facturación por separado antes de compararlas con las tarifas en dólares de OpenAI.
Puedes consultar el enrutamiento de proveedores y la disponibilidad actual en la página de GPT‑5.2 de OpenRouter. Yo calcularía el coste por tarea completada, no el coste por solicitud. Una respuesta más barata que falla la validación dos veces puede costar más que una respuesta más cara que pasa en el primer intento.
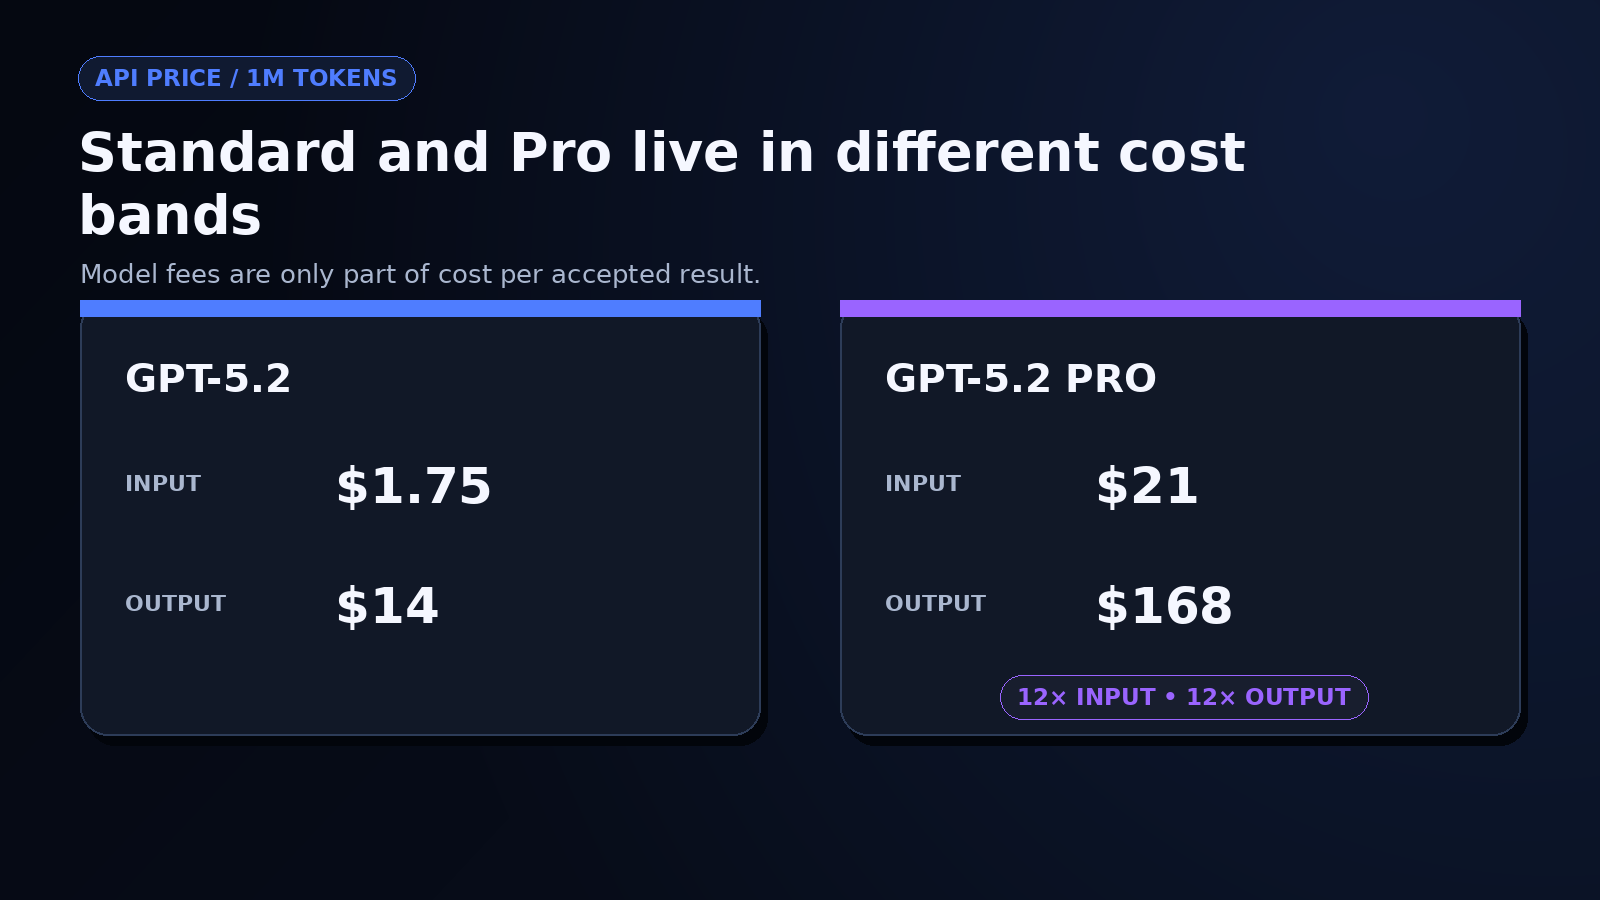
Figura 4. coste estándar frente a Pro por millón de tokens
¿Qué cambió en el lanzamiento de GPT-5.2 de OpenAI?
El lanzamiento de GPT-5.2 de OpenAI apuntaba a trabajos que continúan más allá de una sola respuesta: construir artefactos, inspeccionar documentos largos, usar herramientas, escribir y revisar código, razonar sobre imágenes y completar tareas profesionales de varios pasos. También separó de forma más clara el chat rápido, el razonamiento profundo y el trabajo de alto cómputo de lo que sugiere una sola etiqueta de modelo.
Instant, Thinking y Pro apuntan a cargas de trabajo distintas
Instant priorizaba preguntas cotidianas, explicaciones, traducción y borradores rápidos. Thinking apuntaba a análisis, programación, archivos, planificación y uso de herramientas. Pro invertía más cómputo en problemas difíciles donde una espera más larga y una factura de API mucho más alta podían justificarse.
| Modo o modelo | Ajuste práctico | Principal compromiso |
|---|---|---|
| Instant | Preguntas rutinarias y trabajo sensible a la latencia | Menos deliberación en tareas difíciles de varios pasos |
| Thinking | Análisis, programación, archivos largos y flujos impulsados por herramientas | Más latencia y uso de tokens |
| Pro | Tareas difíciles donde la calidad incremental tiene mucho valor | Coste muy alto; las respuestas pueden tardar minutos |
Yo enrutaría según el riesgo, no según el prestigio. Un paso de clasificación puede necesitar un modelo rápido con un esquema estricto. Una revisión de modelo financiero puede justificar un razonamiento más profundo. Si envías cada solicitud a Pro, ocultas qué tareas realmente se benefician del cómputo extra y haces el control de costes mucho más difícil.
El trabajo profesional y el uso de herramientas fueron centrales en el lanzamiento
OpenAI destacó hojas de cálculo, presentaciones, trabajo de front-end, revisión de código, análisis de documentos, ciencia, matemáticas y llamadas a herramientas. En una evaluación realizada por el proveedor sobre consultas de ChatGPT desidentificadas, los errores a nivel de respuesta se reportaron como un 30% relativamente menos frecuentes que con GPT‑5.1 Thinking. El lanzamiento también señala que fueron los propios modelos los que realizaron la calificación de errores, así que interpreto esa cifra como evidencia direccional, no como una garantía independiente.
La mejora práctica no es "el modelo lo sabe todo". Es una mayor probabilidad de que una tarea bien especificada sobreviva varios pasos sin perder su estructura. Igual necesitas puntos de control observables: qué herramienta se ejecutó, qué datos recibió, qué cambió y cómo se recuperó el flujo de trabajo tras una llamada fallida.
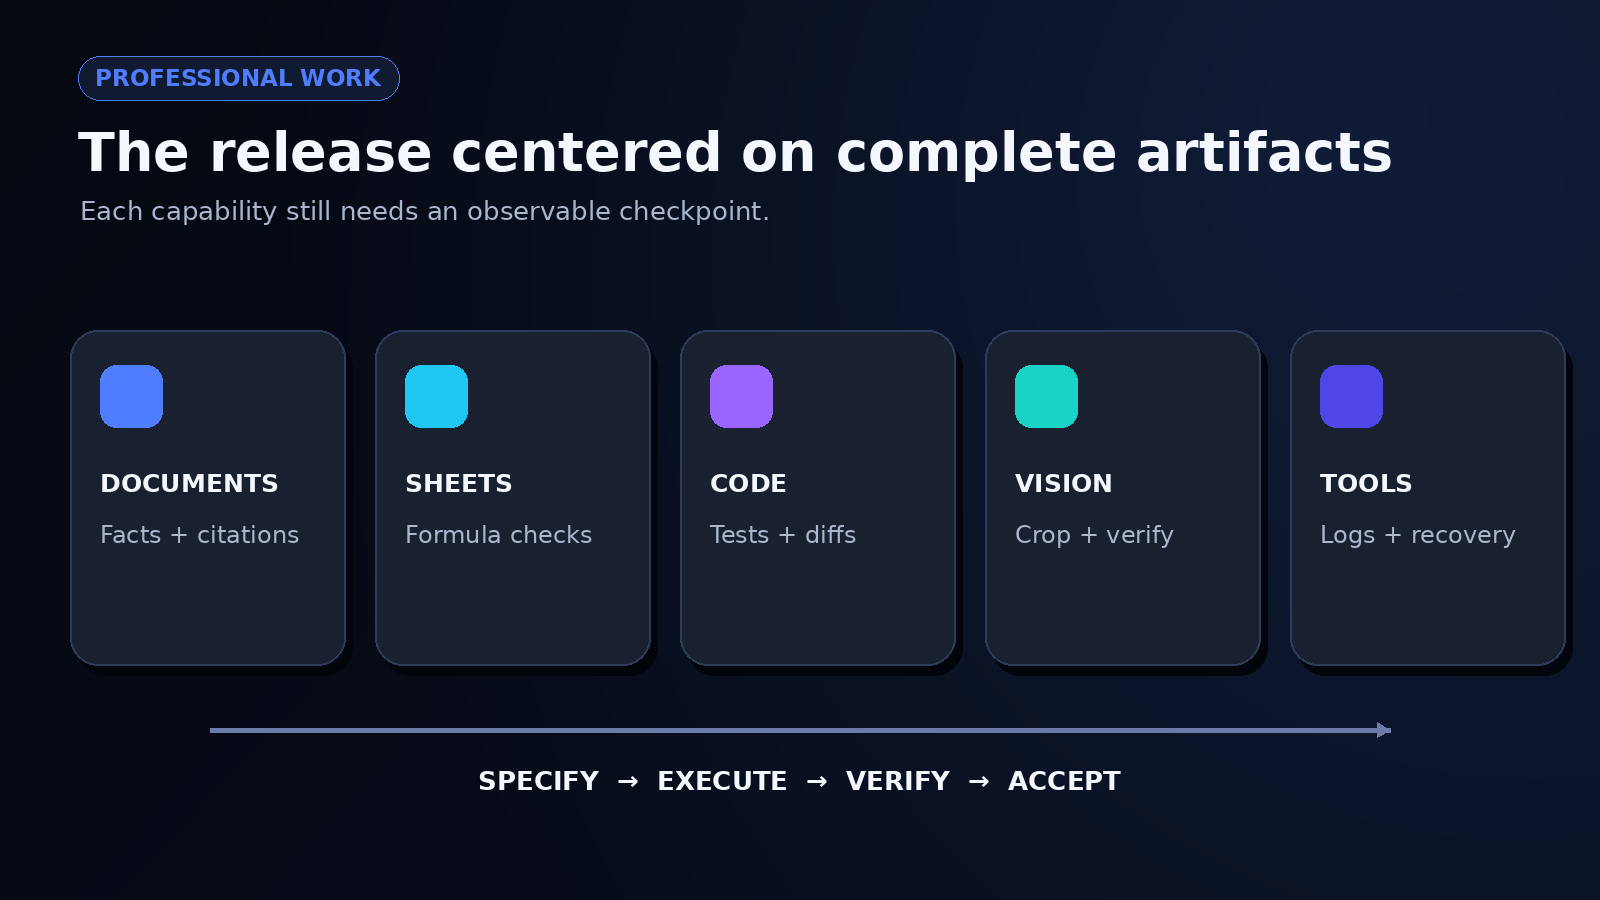
Figura 5. paneles de hoja de cálculo, código, documento, imagen y llamada a herramienta
Los benchmarks del lanzamiento mostraron fortalezas amplias pero desiguales
| Benchmark | GPT-5.2 Thinking | Qué mide |
|---|---|---|
| Victorias o empates en GDPval | 70,9% | Tareas profesionales bien especificadas en 44 ocupaciones |
| SWE-Bench Pro público | 55,6% | Tareas de ingeniería de software multilenguaje |
| SWE-bench Verified | 80,0% | Tareas verificadas de repositorios Python |
| GPQA Diamond | 92,4% | Preguntas de ciencia de nivel de posgrado sin herramientas |
| AIME 2025 | 100,0% | Matemáticas de competición sin herramientas |
| ARC-AGI-2 Verified | 52,9% | Tareas novedosas de razonamiento abstracto |
La dispersión es la parte útil. Muestra resultados sólidos sin implicar un dominio uniforme. Una puntuación del 80% en issues verificados de Python no predice tu tasa de éxito en un monorepo de TypeScript con reglas de despliegue personalizadas. De igual forma, un benchmark científico no establece un juicio legal o médico fiable.
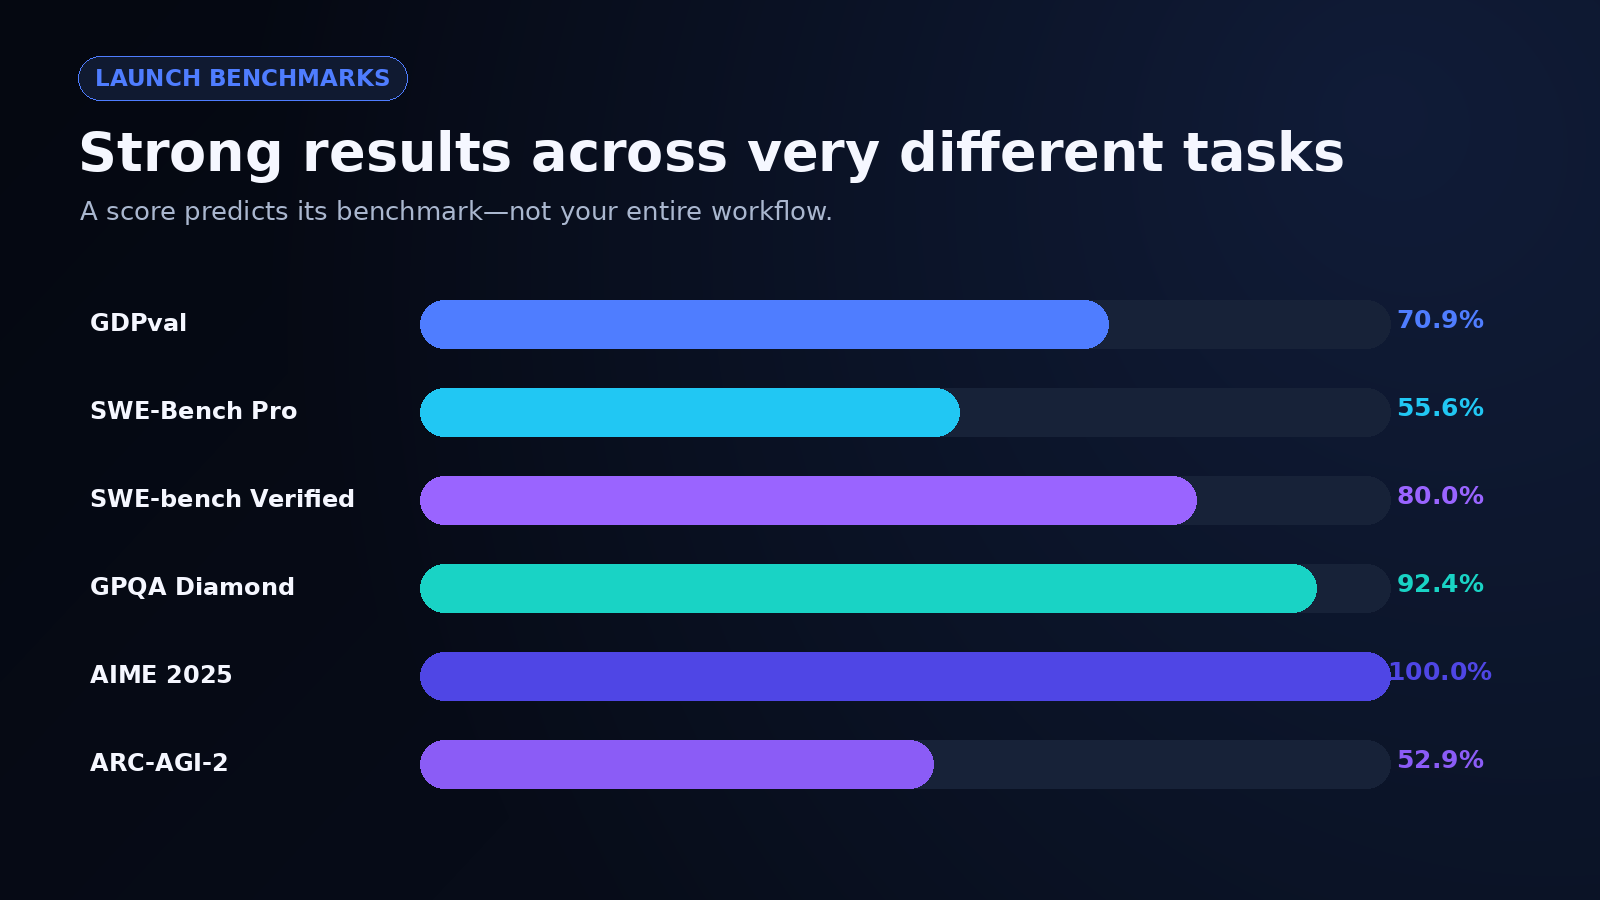
Figura 6. seis puntuaciones del lanzamiento con categorías de tareas
Lee los benchmarks de GPT-5.2 junto con sus limitaciones
Las puntuaciones públicas comprimen muchas decisiones en un solo número: formato del prompt, herramientas, esfuerzo de razonamiento, selección de pruebas, comportamiento del evaluador y política de reintentos. Tu flujo de trabajo en producción añade calidad de datos, permisos, límites de latencia y revisión humana. Encuentro que los benchmarks son más útiles para elegir qué probar, no para saltarse la prueba.
Lo que realmente mostró mi revisión de la app
El revisor de briefs de proyecto mostró las instrucciones enviadas bajo "Resumen del proyecto" y "Requisitos esenciales" mientras la respuesta aún se estaba transmitiendo. La entrada pedía verificaciones de implementación, pero el resultado visible organizó esa solicitud como un brief. No reportó inspección de código completada ni resultados de pruebas.
La vista de sesión separada no tenía solicitudes ni uso registrados, dejando el tiempo de respuesta, el enrutamiento y el coste sin verificar. Completa una solicitud con un brief restringido para terminar la comprobación.
Las puntuaciones de benchmark no son garantías de producción
Empieza con 20 a 50 tareas representativas y define los criterios de aceptación antes de ejecutarlas. Para código, eso puede incluir tasa de pruebas superadas, tamaño del diff, hallazgos de seguridad y seguridad de rollback. Para trabajo con documentos, puede incluir precisión factual, cobertura de citas, errores de cálculo y tiempo de edición. Ejecuta el mismo conjunto más de una vez porque la varianza importa.
Luego mide el coste por resultado aceptado. Supón que un modelo cuesta $0,18 por ejecución y aprueba el 60% de los casos, mientras que otro cuesta $0,28 y aprueba el 90%. Antes de la corrección humana, sus costes esperados por resultado aceptado son $0,30 y aproximadamente $0,31. Una vez que valoras el tiempo de revisión, el segundo puede ser claramente más barato, o no. La aritmética obliga a devolver la decisión a tu flujo de trabajo.
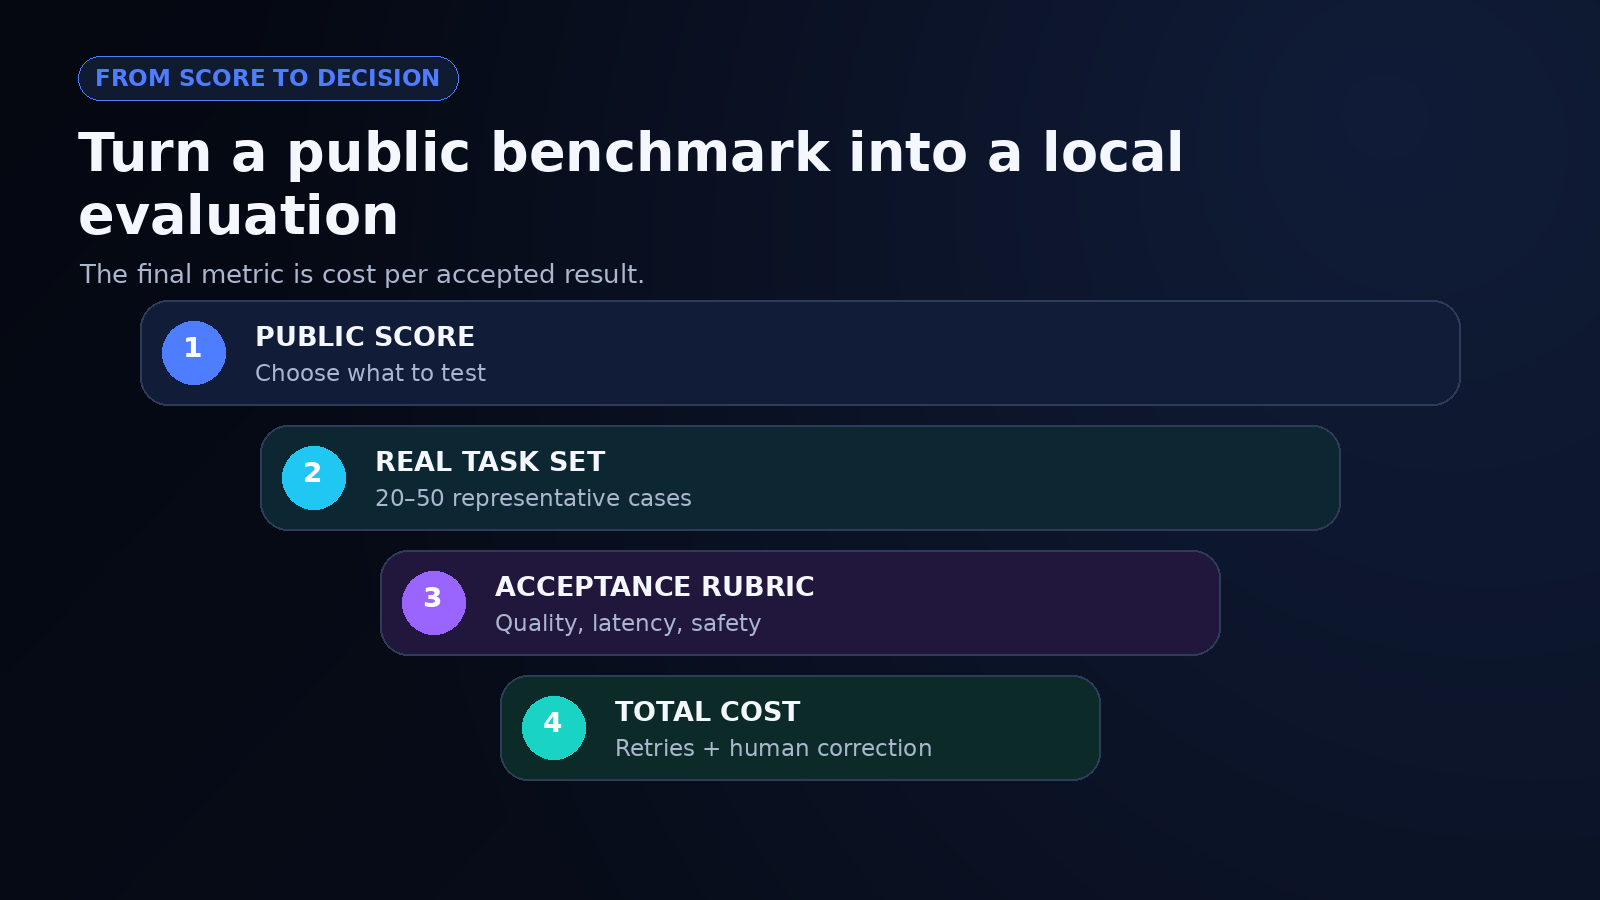
Figura 7. de la puntuación del benchmark a tareas representativas y al coste del resultado aceptado
El contexto largo y la entrada de imagen aún requieren verificación
Una ventana de contexto larga puede reducir la fragmentación, pero también hace que las omisiones sean más difíciles de notar. Yo probaría la recuperación desde el principio, la mitad y el final de un conjunto de archivos; exigiría citas o identificadores de registro para hechos críticos; y repetiría los cálculos fuera del modelo. Para imágenes, recorta la región relevante y plantea la pregunta explícitamente en lugar de esperar que el modelo infiera qué importa.
La crítica independiente también puede exponer modos de fallo que una publicación de lanzamiento no destacará. Una crítica práctica describe resultados decepcionantes en las tareas del autor. Eso no refuta los resultados de los benchmarks; muestra por qué tu prompt, tu carga de trabajo y tu umbral de aceptación deben reproducirse directamente.
Figura 8. evidencia distribuida a lo largo de un flujo de documentos de 400K tokens
El trabajo de alto riesgo necesita salvaguardas específicas del dominio
El corte de conocimiento del 31 de agosto de 2025 implica que los hechos actuales requieren recuperación. Los modelos todavía pueden inventar fuentes, pasar por alto requisitos, leer mal capturas de pantalla o generar código inseguro. Tampoco soportan fine-tuning, así que los equipos que necesiten un comportamiento muy personalizado deben recurrir al prompting, la recuperación, las herramientas, la validación u otro modelo.
Debes separar la asistencia de la autoridad. Un modelo puede resumir un contrato, señalar una transacción sospechosa o proponer un parche. Una persona cualificada o un control determinista debería tomar la decisión legal, médica, financiera, de seguridad y de producción. Registra la evidencia y mantén un camino claro para rechazar o revertir el resultado.
¿Qué es GPT-5.2-Codex y cómo deberían usarlo los desarrolladores?
GPT 5.2 Codex es el miembro especializado en código de la familia, diseñado para trabajo de ingeniería de software más largo en lugar de autocompletado aislado. La distinción útil es la profundidad del flujo de trabajo: entender un repositorio, planificar un cambio, editar varios archivos, ejecutar herramientas, inspeccionar fallos y revisar el parche.
Tareas de programación más adecuadas
Los buenos candidatos incluyen exploración de repositorios, implementación de funcionalidades, reparación de bugs, refactorización, creación de pruebas, revisión de código y migraciones con criterios de aceptación explícitos. Yo le daría al modelo el objetivo coherente más pequeño que aun así incluya el límite real de dependencias. Un prompt artificialmente diminuto puede producir un diff local limpio que falla en el sistema circundante.
Puedes evaluar GPT 5.2 Codex con un conjunto de repositorios repetible: issues conocidos, pruebas ocultas, linting, política de dependencias, comprobaciones de seguridad y un diff máximo aceptable. Registra el número de llamadas a herramientas, correcciones e intervenciones del revisor. Un parche no tiene éxito solo porque compile.
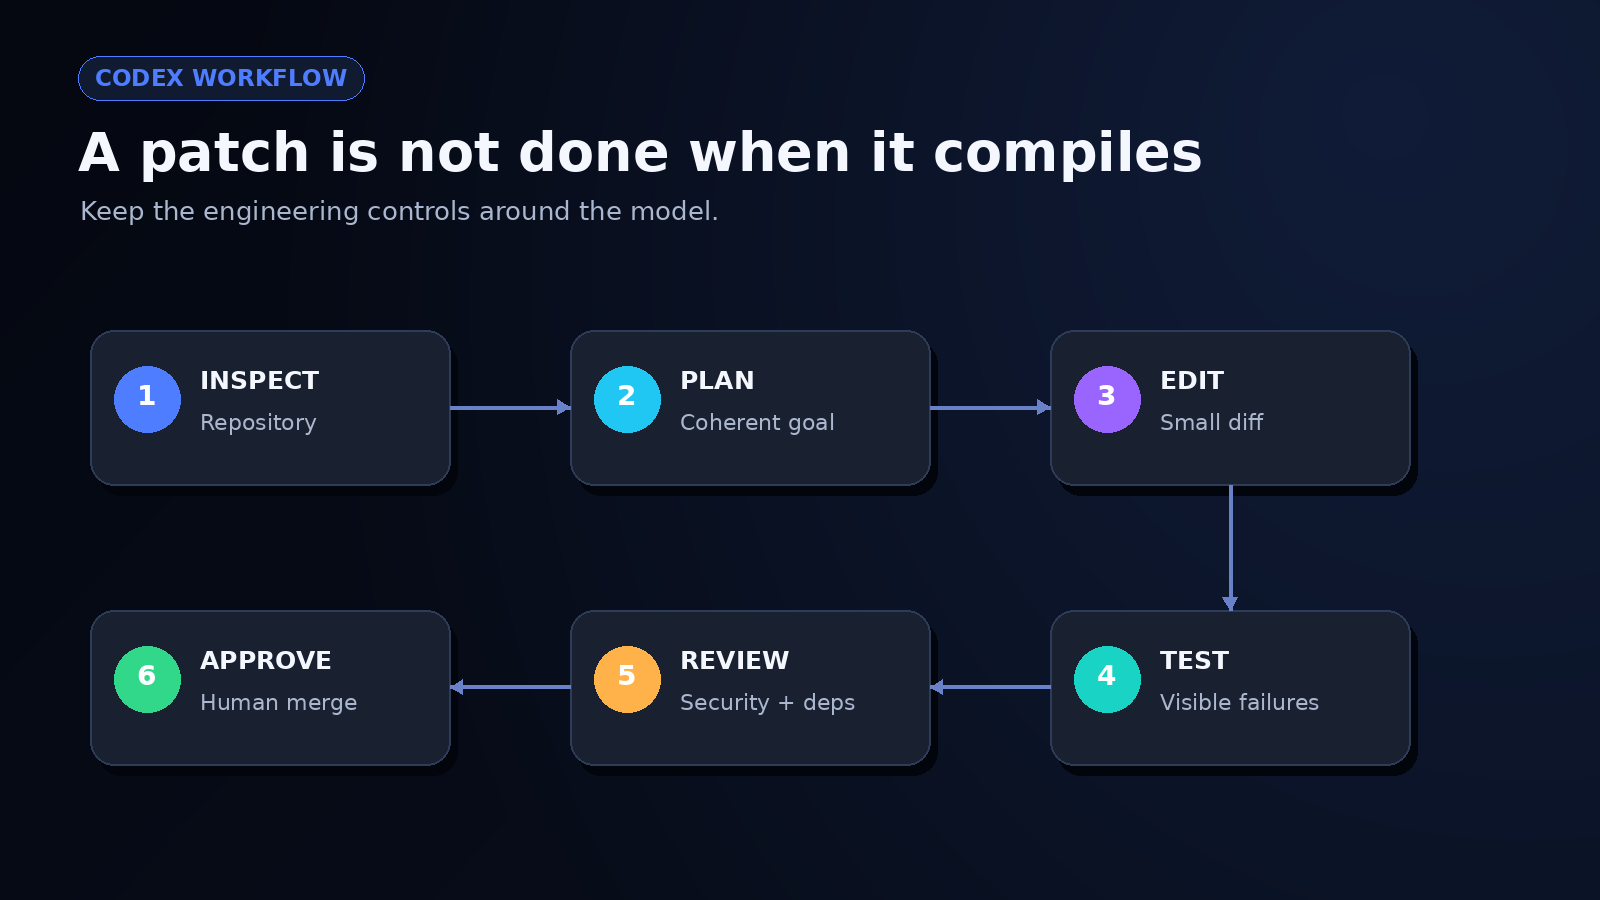
Figura 9. inspeccionar, planificar, editar, probar, revisar y aprobar
Las salvaguardas de producción siguen aplicando
Mantén los cambios suficientemente pequeños como para revisarlos, fija el snapshot del modelo cuando la reproducibilidad importe, y restringe las herramientas al privilegio mínimo necesario. Ejecuta pruebas del repositorio, escaneo de dependencias, detección de secretos, análisis estático y revisión humana de diffs. Si el agente puede desplegar, borrar datos o rotar credenciales, coloca esas acciones tras una aprobación explícita.
También prefiero un presupuesto de fallo: define cuántos reintentos, minutos o tokens puede consumir una tarea antes de que vuelva a una persona. Sin ese límite, un agente puede parecer productivo mientras da vueltas en arreglos cada vez más especulativos.
GPT-5.2 frente a Gemini 3 depende de la tarea exacta
GPT-5.2 frente a Gemini 3: explica que el mejor modelo de IA depende de la tarea, como programación, razonamiento, escritura o investigación.
La respuesta honesta a "GPT 5.2 frente a Gemini 3" es un diseño de prueba, no un ganador universal. Hay que registrar variantes exactas, fechas, herramientas, tamaños de contexto, ajustes de razonamiento y precios. De lo contrario, una comparación puede estar dando, sin querer, búsqueda, ejecución de código o un presupuesto de tiempo mayor a un modelo.
| Factor de decisión | Pregunta a probar |
|---|---|
| Calidad de salida | ¿Qué modelo pasa tu rúbrica de tareas con más frecuencia? |
| Programación | ¿Cuál produce una tasa de pruebas superadas más alta con diffs más pequeños y seguros? |
| Contexto largo | ¿Cuál recupera y combina hechos de tus archivos con más precisión? |
| Uso de herramientas | ¿Cuál completa el flujo de trabajo con fallos recuperables y logs utilizables? |
| Latencia | ¿Cuáles son los tiempos de respuesta mediano y del percentil 95? |
| Coste | ¿Cuál es el coste total por resultado aceptado tras reintentos y corrección? |
| Gobernanza | ¿Qué controles de datos, retención, región y auditoría se ajustan a tu caso de uso? |
Realiza la misma evaluación cara a cara
Dale a ambos modelos los mismos prompts, archivos fuente, herramientas, presupuesto de tiempo y rúbrica de puntuación. Aleatoriza el orden de las tareas y oculta el nombre del modelo a los revisores cuando sea posible. Repite casos representativos en lugar de seleccionar una sola respuesta bonita. Las reacciones de la comunidad en la discusión del lanzamiento de GPT‑5.2 son útiles para descubrir quejas que probar, pero no son comparaciones controladas.
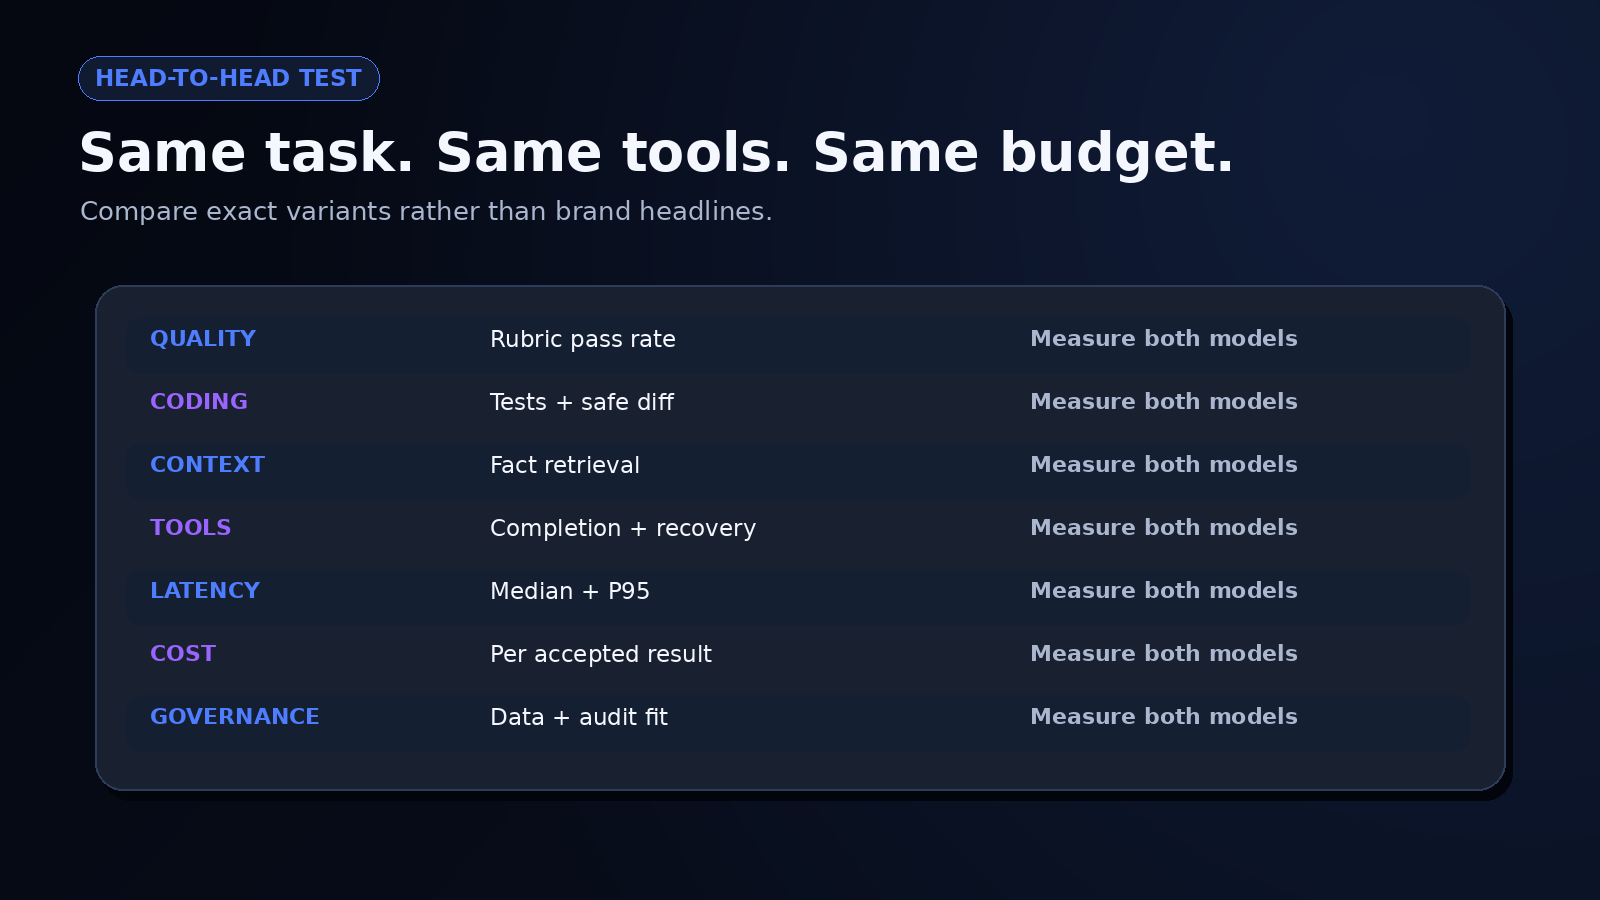
Figura 10. calidad, programación, contexto, herramientas, latencia, coste y gobernanza
Elige el flujo de trabajo de menor riesgo, no el titular más atractivo
Tu ganador puede variar según el paso. Un modelo puede planificar bien, otro puede generar código más limpio, y una opción más pequeña puede manejar la clasificación a una fracción del coste. La arquitectura correcta puede enrutar el trabajo en lugar de forzar a un solo modelo a hacerlo todo.
Para una evaluación de GPT 5.2 frente a Gemini 3, yo elegiría la combinación de modelos más simple que cumpla el umbral de calidad y siga siendo observable cuando falle. Cada proveedor o respaldo adicional añade lógica de enrutamiento, trabajo de evaluación, revisión de privacidad y complejidad de incidentes. La diversidad de modelos es útil cuando reduce un riesgo medido.
Construye una app con GPT‑5.2 Pro en Enter Pro
Usé el generador de apps con IA de Enter Pro para crear un revisor de briefs de proyecto con IA, seleccionando GPT‑5.2 Pro como su integración. El objetivo era convertir una idea de app poco definida en requisitos, información faltante, prioridades y criterios de aceptación.
Selecciona GPT‑5.2 Pro y revisa las tarifas
Localicé GPT‑5.2 Pro en el catálogo de modelos y abrí sus detalles. El panel mostraba un botón de Integrar y tarifas de** 2,1 créditos por cada 1.000 tokens de entrada** y** 16,8 créditos por cada 1.000 tokens de salida**. Estas son las tarifas de la plataforma capturadas.
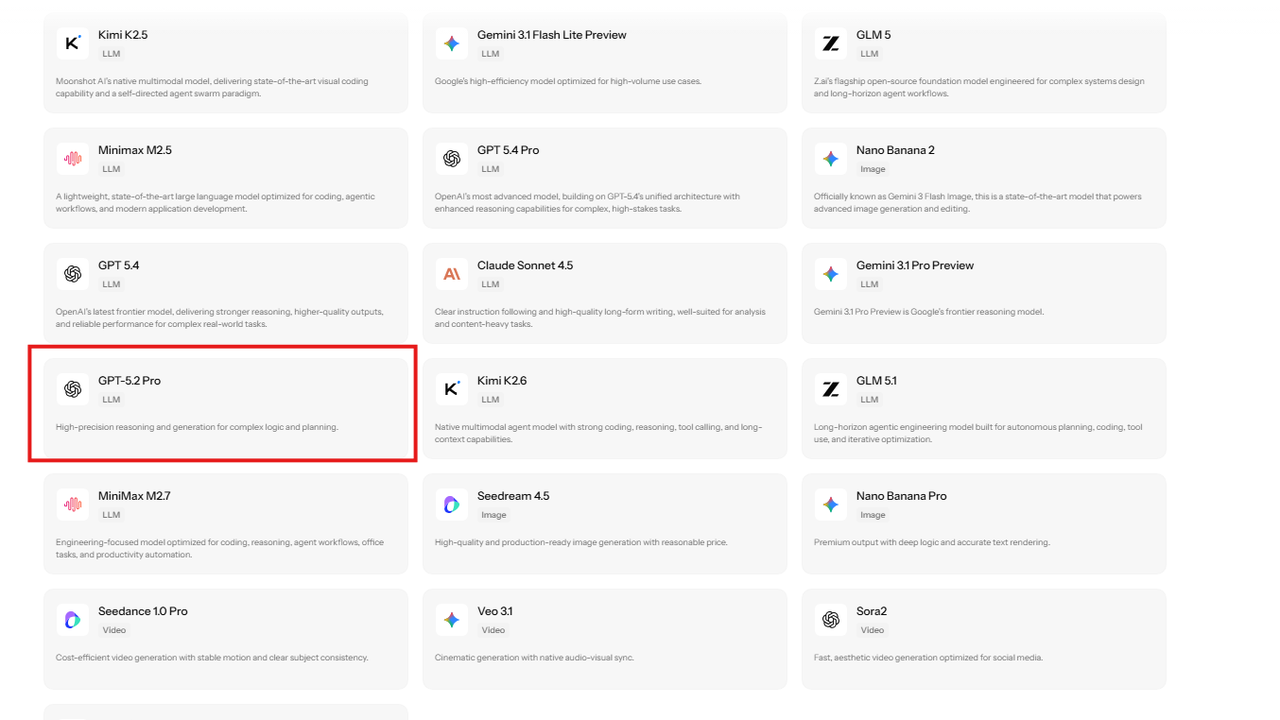
Figura 11. GPT‑5.2 Pro aparece en el catálogo de modelos junto a otras integraciones disponibles.
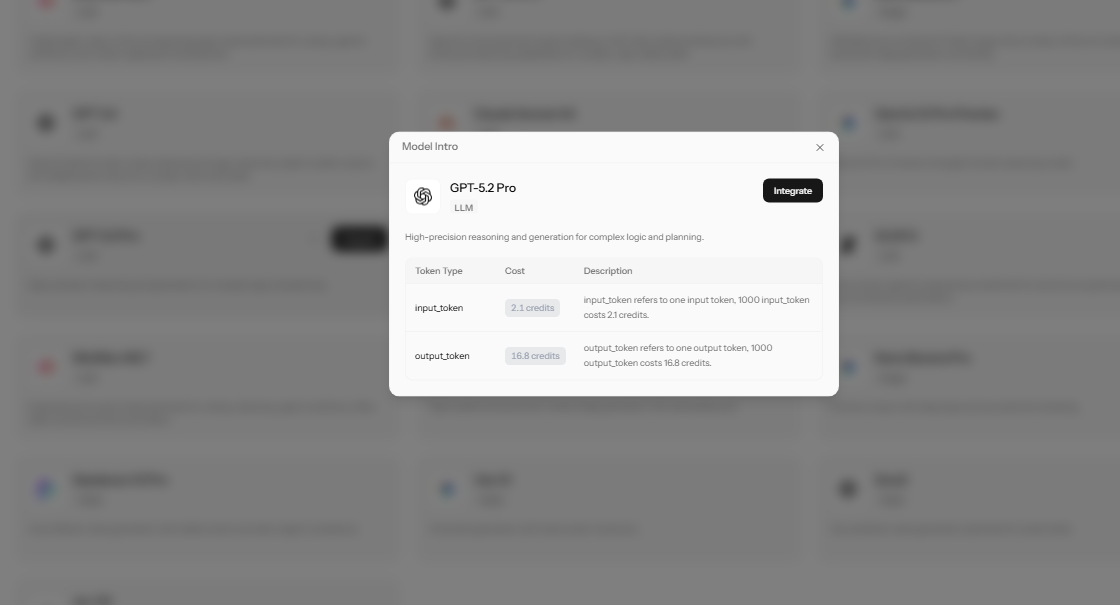
Figura 12. El panel de detalles de GPT‑5.2 Pro muestra el control de Integrar y las tarifas en créditos.
Adjunta el modelo y describe la app
La solicitud del proyecto tenía el chip de GPT‑5.2 Pro adjunto. Pedí un campo de brief amplio, un botón de Revisar brief, y respuestas organizadas en cinco secciones: resumen del proyecto, requisitos esenciales, contradicciones e información faltante, prioridades de implementación y criterios de aceptación. La solicitud también pedía estados de carga y error genuinos.
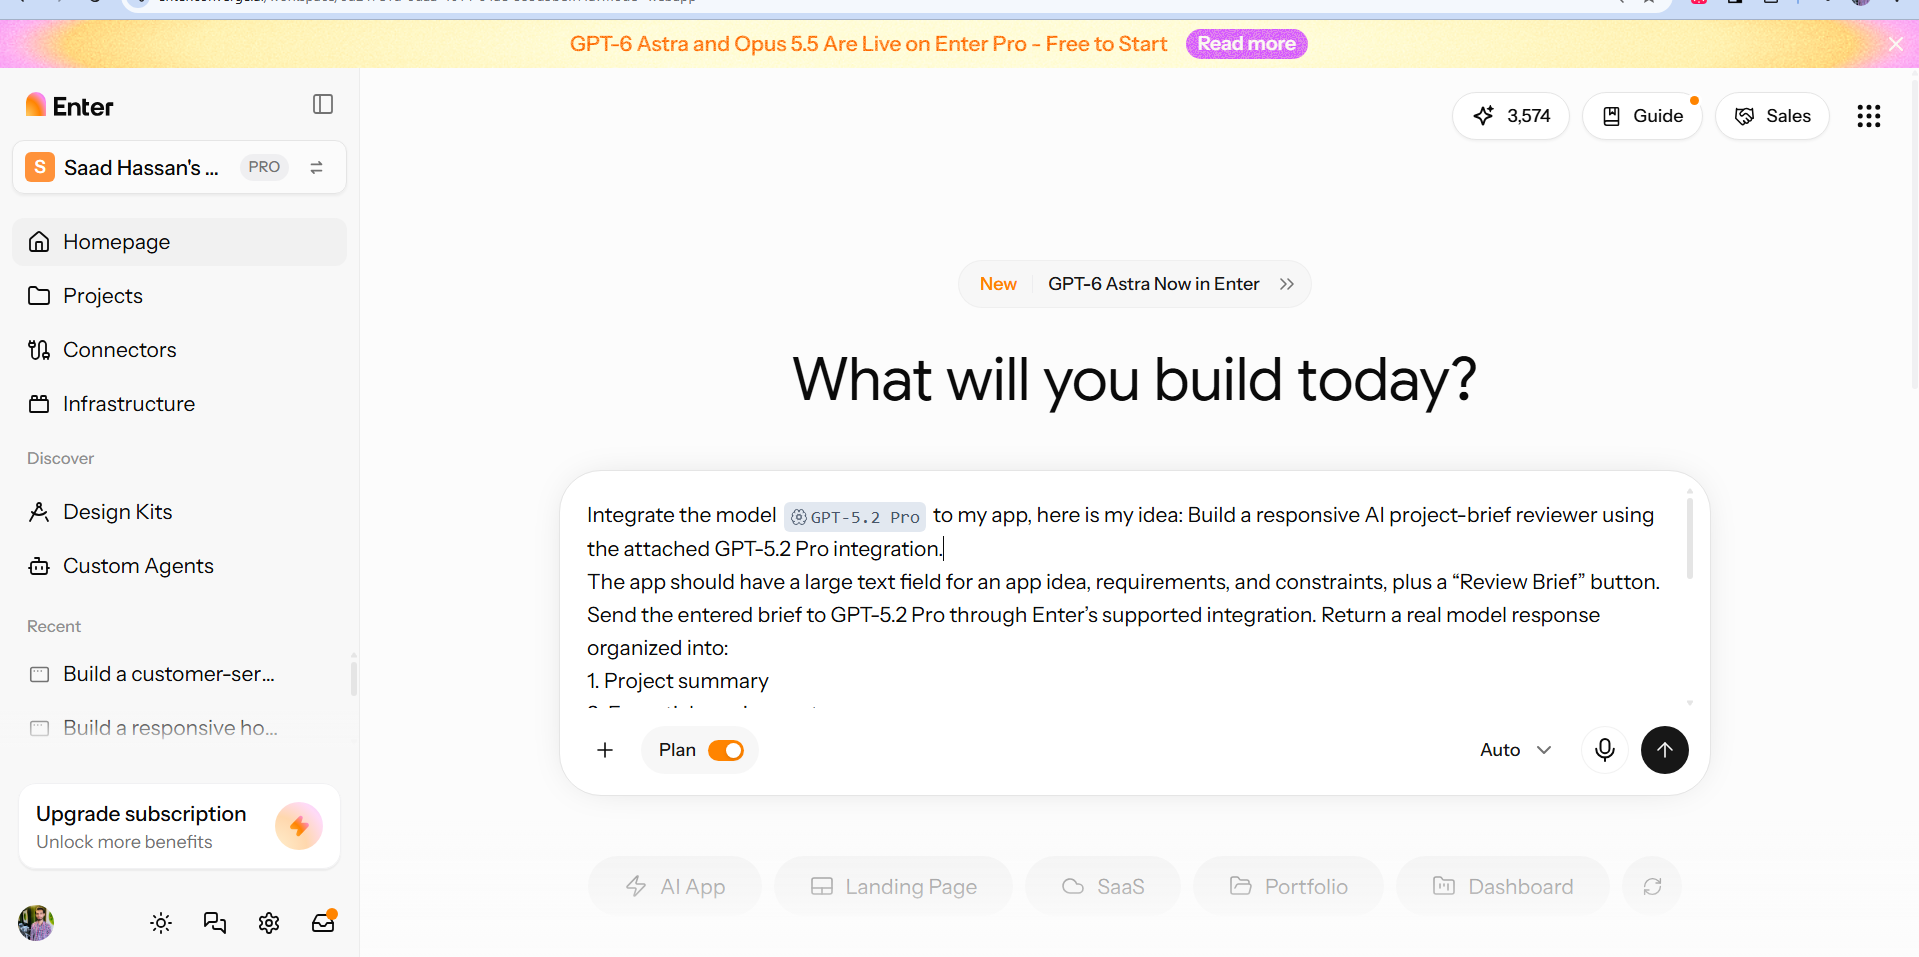
Figura 13. El prompt del proyecto adjunta GPT‑5.2 Pro y especifica el propósito y la estructura de respuesta del revisor.
Examina el plan de construcción
Enter generó un plan para una interfaz con Vite, React y Tailwind, con una función de backend que gestiona la solicitud a la IA. Especificaba resultados en streaming, texto en inglés llano y sin historial de revisiones guardado. Mantener la credencial privada en el backend formaba parte del plan. Esta captura registra la implementación propuesta.
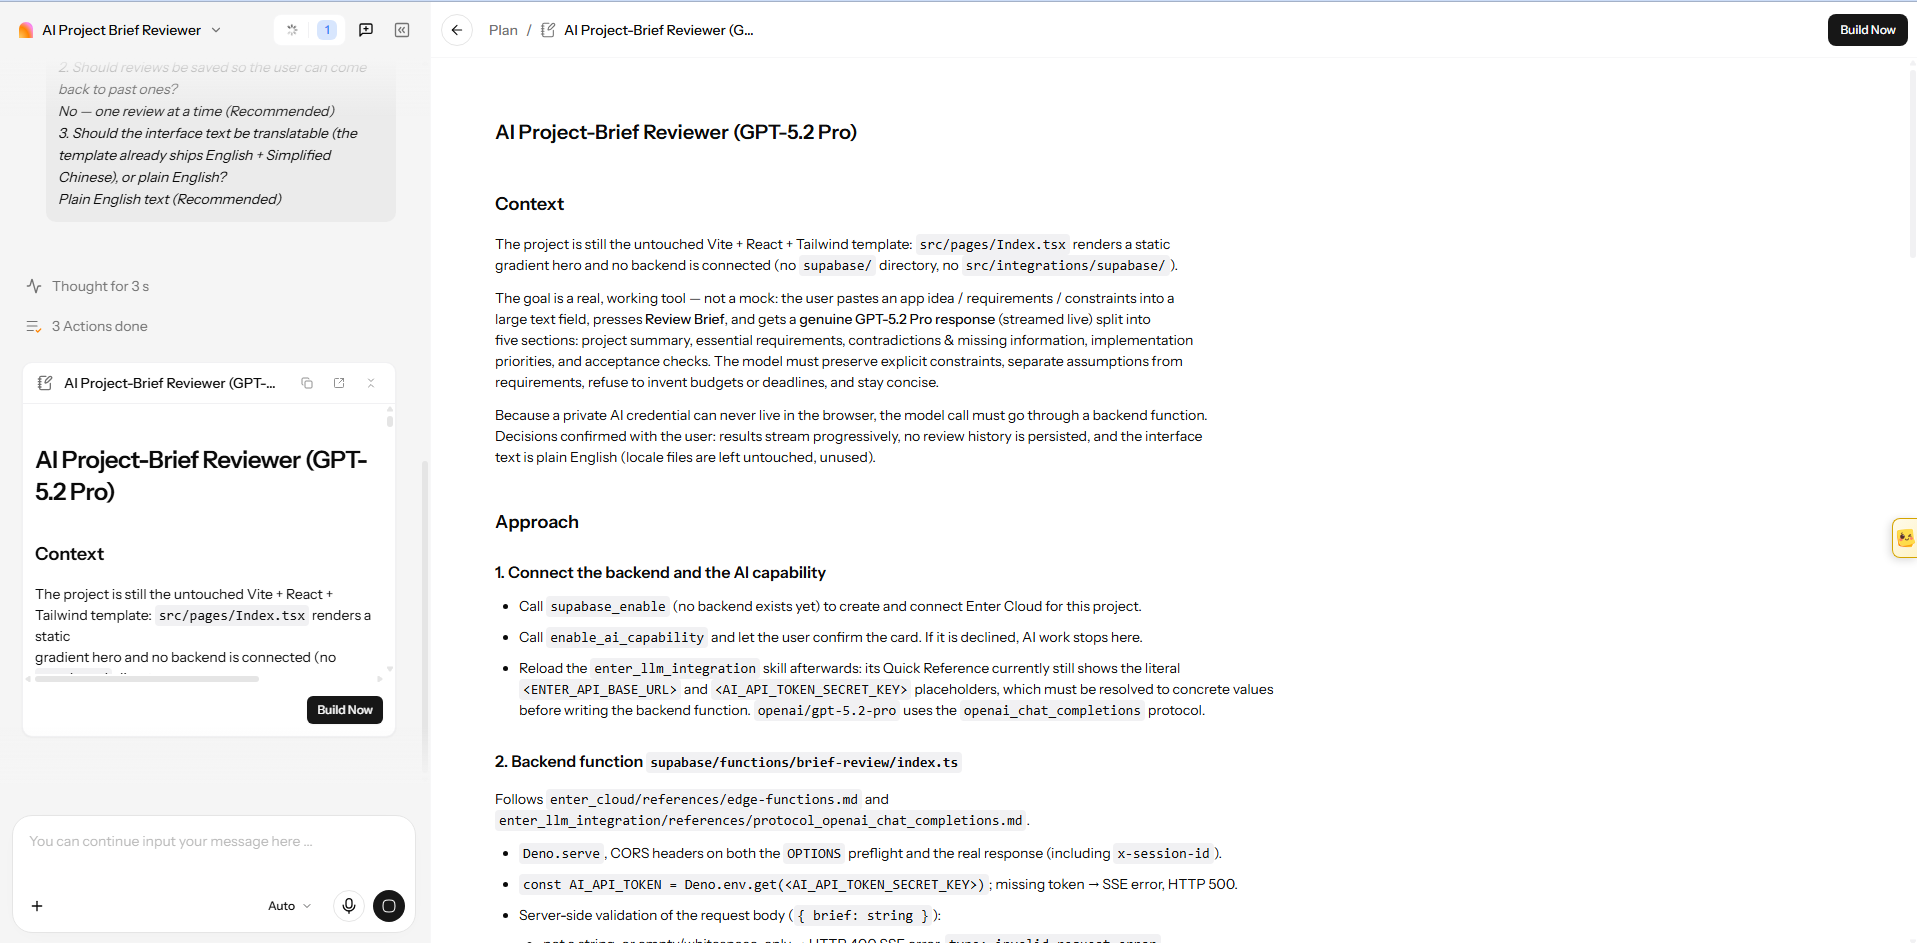
Figura 14. El plan de construcción describe la interfaz, la solicitud de backend, la salida en streaming y la gestión de credenciales.
Examina la revisión visible
El revisor mostraba un campo de brief junto a sus paneles de respuesta. En el intento capturado, introduje la solicitud de verificación de implementación en ese campo. La respuesta reorganizó sus requisitos bajo los encabezados solicitados, mientras Streaming review y** Reviewing** permanecían visibles. Esto demostró la organización de la respuesta, quedando pendiente comprobar su finalización y corrección.
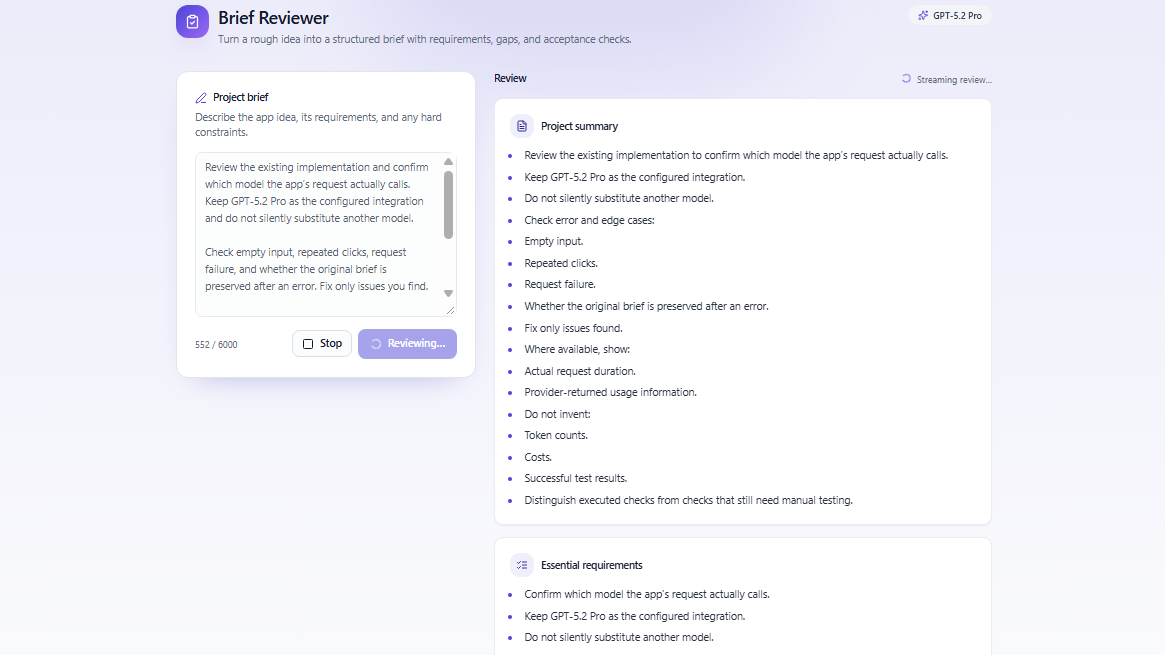
Figura 15. El texto de la revisión aparece bajo los encabezados solicitados mientras la interfaz todavía indica una respuesta activa.
Para una comprobación de razonamiento, usa el brief de citas con tres técnicos, trabajos de 45 minutos, un margen de viaje de 30 minutos, horario de 9 a 17 h, sin solapamientos y una regla de reprogramación de 12 horas. Luego añade "permite dos citas simultáneas por técnico" e inspecciona si la respuesta completada señala el conflicto. Ese resultado no está en estas capturas.
Comprueba el registro de solicitudes y el uso de créditos
La vista de estado adicional etiquetaba la integración como GPT‑5.2 Pro, el proveedor como Enter AI y el protocolo como Responses API. Su sesión no contenía ninguna solicitud, cero tokens de entrada y salida, y cero uso consumido. Esos valores no pueden determinar la duración, el enrutamiento real o el coste de la respuesta anterior.
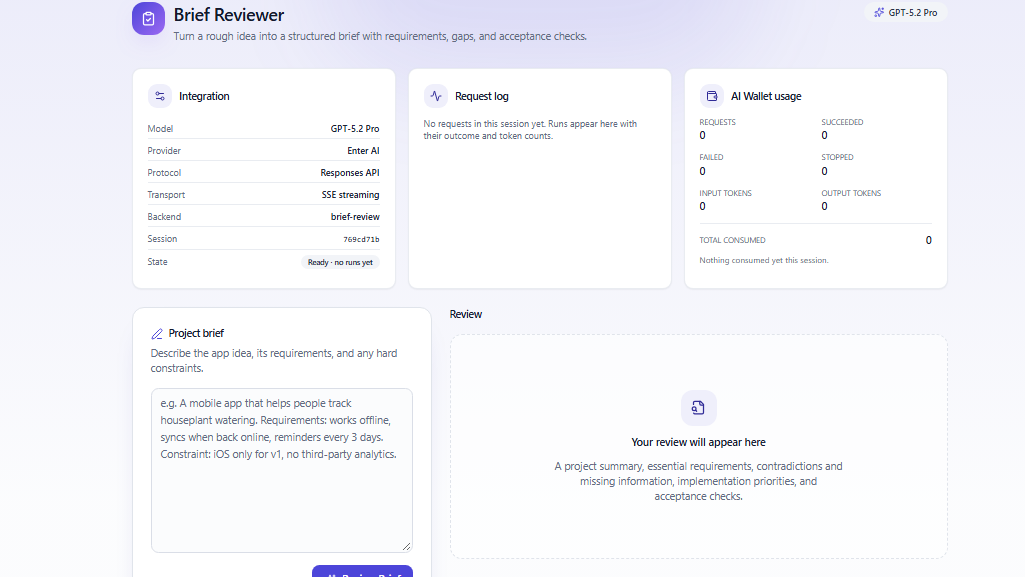
Figura 16. Los paneles de integración y uso muestran una sesión lista sin solicitudes ni consumo registrados.
Con las tarifas mostradas, un ejemplo ilustrativo de 1.000 tokens de entrada más 500 tokens de salida facturados equivaldría a 10,5 créditos. Esto es una estimación, no un gasto observado. Para comparar costes, usa solicitudes completadas, uso facturado, reintentos y la proporción de revisiones que cumplen tus criterios de aceptación.
Enter mantiene el modelo seleccionado y el brief de la app en un solo proyecto. Construye tu app con GPT‑5.2 Pro en Enter Pro y verifica la integración antes de publicar.
Conclusión final: evalúa GPT‑5.2 mediante una tarea real
El valor práctico de GPT‑5.2 depende de la calidad de la tarea y del coste aceptable. El proyecto del revisor conecta la selección de Pro con una interfaz de app y un texto de revisión organizado. Todavía se necesitan una respuesta terminada, restricciones verificadas y un registro de solicitud completado para juzgar la fiabilidad y la rentabilidad.
Elige el modelo menos costoso que cumpla tu umbral de aceptación, repite los casos importantes y mantén un camino de recuperación para los errores. Puedes usar Enter Pro para construir y refinar una app con GPT‑5.2 Pro, y luego verificar su integración antes de ampliarla.
Preguntas frecuentes sobre Chat GPT 5.2
¿Cuándo se lanzó GPT-5.2?
OpenAI lo anunció el 11 de diciembre de 2025. Los modelos de la API y las variantes de ChatGPT empezaron a desplegarse en el lanzamiento, aunque el acceso y las alternativas recomendadas han cambiado desde entonces.
¿Sigue GPT-5.2 siendo el modelo más reciente de OpenAI?
No. A fecha de 9 de octubre de 2026, OpenAI lo documenta como un modelo de la generación anterior. Quienes busquen Chat GPT 5.2 deberían distinguir el acceso a través del selector de ChatGPT del acceso vía API o integración de terceros. Verifica la variante exacta y la disponibilidad actual antes de iniciar un proyecto.
¿Cuál es la ventana de contexto de GPT-5.2?
La ventana de contexto documentada es de 400.000 tokens, con una salida máxima de 128.000 tokens. Aun así, deberías probar la recuperación y el razonamiento con tus documentos largos reales.
¿Cuánto cuesta la API de GPT-5.2?
La tarifa estándar de la API es de $1,75 por millón de tokens de entrada, $0,175 por millón de tokens de entrada en caché y $14 por millón de tokens de salida. Los cargos de herramientas, el razonamiento, los reintentos y la revisión aumentan el coste de la tarea.
¿Cómo puedo construir una app con GPT‑5.2 Pro usando Enter Pro?
Selecciona GPT‑5.2 Pro en el catálogo de modelos, adjunta la integración y describe la función que necesita tu app. Para un revisor de briefs de proyecto, especifica las entradas requeridas y el formato de revisión. Examina la implementación generada, luego verifica una solicitud completada para confirmar que la conexión del modelo funciona.
¿Cómo puedo comprobar el uso de GPT‑5.2 Pro en Enter Pro?
Revisa los paneles de solicitudes y uso de la integración después de ejecutar una tarea representativa. Confirma que la solicitud aparece, luego examina los tokens de entrada, los tokens de salida y los créditos consumidos. Incluye reintentos y respuestas más largas al estimar costes, usando las tarifas actuales de la plataforma.
¿Qué es GPT-5.2 Pro?
GPT 5.2 Pro es un modelo de razonamiento de mayor cómputo para tareas profesionales difíciles. Sus tarifas oficiales de API son $21 por millón de tokens de entrada y $168 por millón de tokens de salida, y algunas solicitudes pueden tardar varios minutos.
¿GPT-5.2 admite imágenes?
Sí. Acepta entrada de imagen y produce salida de texto. El audio y el vídeo no figuran como entradas nativas soportadas, así que esos formatos requieren un paso de procesamiento separado.
¿Es GPT-5.2 mejor que Gemini 3?
No hay una respuesta universal. Prueba las variantes exactas con los mismos prompts, archivos, herramientas, presupuesto y rúbrica, y luego compara la calidad de los resultados aceptados, la latencia, el coste, la gobernanza y la recuperación ante fallos.
¿Puede GPT-5.2 generar código listo para producción?
Puede generar código sólido, pero la preparación para producción proviene de todo el proceso de ingeniería: pruebas, revisión de diffs, comprobaciones de dependencias y seguridad, herramientas restringidas, staging, monitorización y rollback. El modelo no puede sustituir esos controles.





