
Qual è il miglior LLM per programmare nel 2026? 6 modelli testati e confrontati
Scopri il miglior LLM per programmare nel 2026. Confrontiamo modelli LLM locali e assistenti cloud per precisione, privacy e velocità, per ottimizzare il tuo workflow.
Quando il nostro team si è messo a cercare il miglior LLM per programmare, abbiamo capito subito che i punteggi dei benchmark non bastano. Ogni giorno affrontiamo complessità serie, come districarci tra codebase intricate o valutare colossi backend tradizionali che si scontrano con i flussi di lavoro moderni.
Abbiamo imparato che la scelta di un modello dipende interamente dagli ostacoli specifici che si incontrano. I modelli cloud frontier offrono il ragionamento profondo necessario per le applicazioni complesse, ma un'architettura self-hosted diventa irrinunciabile quando si gestisce codice enterprise proprietario.
In questa guida condividiamo la nostra esperienza diretta. Analizziamo i criteri di valutazione, i sei modelli migliori testati, presentiamo gli agenti di sviluppo autonomi e riportiamo il consenso degli sviluppatori. Scoprirai esattamente quale strumento, dal miglior LLM di coding ai colossi cloud-hosted, saprà davvero ottimizzare il tuo ecosistema.
Criteri fondamentali di valutazione per gli LLM per sviluppatori
Per distinguere assistenti di coding affidabili dai semplici chatbot conversazionali, il nostro team ha valutato ogni modello secondo 5 metriche fondamentali che rispecchiano lo sviluppo software reale:
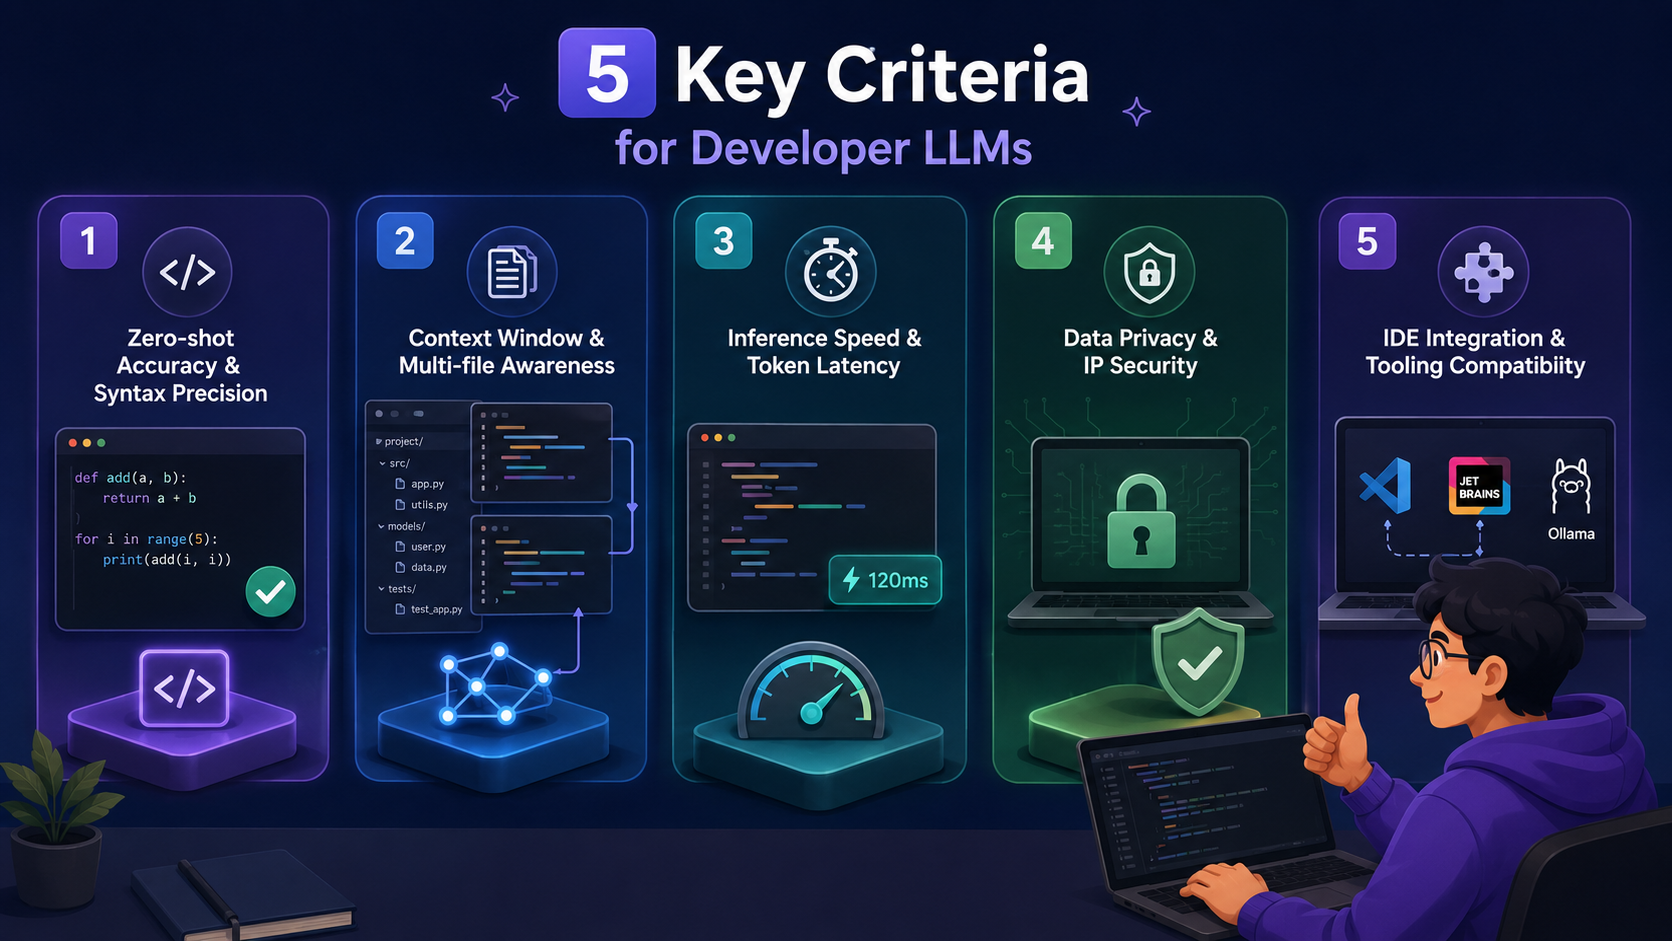
- Precisione zero-shot e correttezza sintattica: Misura quanto affidabilmente un modello genera codice corretto e funzionante al primo tentativo. Un modello solido scrive subito una sintassi pulita, senza inventare librerie fittizie, richiamare API deprecate o introdurre bug logici subdoli.
- Finestra di contesto e consapevolezza multi-file: Il software moderno raramente sta in un singolo file. Abbiamo valutato la "memoria di lavoro" del modello per vedere quanto efficacemente traccia variabili interconnesse, dipendenze e logica architetturale in un intero progetto multi-file senza confondersi.
- Velocità di inferenza e latenza dei token: La velocità influisce direttamente sullo stato di flow dello sviluppatore. Abbiamo testato i tempi di risposta per garantire che i suggerimenti inline e l'autocompletamento in tempo reale appaiano all'istante, senza alcun ritardo di digitazione percepibile.
- Privacy dei dati e sicurezza della proprietà intellettuale: Proteggere il codice proprietario è fondamentale per qualsiasi team. Abbiamo esaminato le politiche di conservazione dati delle API cloud e testato le capacità offline, air-gapped, per garantire che il codice enterprise sensibile resti completamente privato.
- Integrazione IDE e compatibilità con gli strumenti: Un modello potente è utile solo se si integra naturalmente nel flusso di lavoro quotidiano di uno sviluppatore. Abbiamo valutato la facilità con cui ogni modello si collega a editor di codice popolari come VS Code e JetBrains, così come a motori di runtime locali come Ollama.
I 6 migliori LLM per programmare nelle categorie principali
Per orientarsi nel panorama AI in rapida evoluzione, bisogna identificare il miglior LLM per programmare nel 2026 in base ai propri vincoli hardware, requisiti di privacy e complessità del flusso di lavoro architetturale:
| Nome del modello | Categoria | Punto di forza principale | Ideale per |
|---|---|---|---|
| Claude Opus 5 | Cloud frontier | Coding agentico complesso | Grandi refactoring e loop di agenti |
| GPT-5.6 Sol | Cloud frontier | Esecuzione deterministica | Compiti multi-step e prototipazione |
| GLM-5.2 | Locale/open-weight | Finestra di contesto da 1M di token | Coding quasi frontier self-hosted |
| DeepSeek V4-Pro | Locale/open-source | Programmazione competitiva | Compiti API ad alto volume e matematica |
| Qwen3-Coder-Next | Leggero | Efficienza per parametro | Hardware locale modesto |
| Gemini 3.7 Flash | Leggero/economico | Compiti agentici complessi | Lavoro ad alto volume e refactoring |
Modelli AI cloud frontier (massimo ragionamento e contesto)
Questi modelli si basano su enormi cluster di server remoti per elaborare i prompt, permettendo di gestire finestre di contesto immense e un ragionamento complesso multi-step che l'hardware locale semplicemente non può sostenere. Sono ideali per la pianificazione di architetture di sistema complesse.
- Claude Opus 5
Valutando le opzioni per il nostro stack di sviluppo, troviamo che Claude Opus 5 si distingue come il miglior LLM di coding per l'ingegneria reale, i grandi refactoring e i loop di agenti multi-step. Anthropic sviluppa l'LLM Claude in livelli come Haiku 4.5, Sonnet 5, Opus 5 e Fable 5. Attualmente guida le classifiche verificate per compiti software complessi.
| Versione | Dimensione memoria (contesto) | Ideale per | In parole semplici |
|---|---|---|---|
| Claude Fable 5 | Enorme (1M token) | Ricerca specializzata e compiti a lungo termine | Il modello ultra-premium costruito per lavoro scientifico e di cybersicurezza complesso. |
| Claude Opus 5 | Enorme (1M token) | Refactoring intensi e loop di agenti | Il cervello di punta per codebase multi-file complesse. |
| Claude Sonnet 5 | Enorme (1M token) | Sviluppo quotidiano equilibrato | Il fedele cavallo di battaglia per i compiti di coding di tutti i giorni. |
| Claude Haiku 4.5 | Alta (200K token) | Script rapidi e debug veloce | Modello gratuito: Lo sprinter leggero pensato per velocità e costo zero. |
Pro:
- Offre una precisione di coding zero-shot leader di settore insieme a un comportamento di verifica proattivo.
- Dispone di una finestra di contesto enorme capace di assorbire senza difficoltà grandi codebase multi-file.
- Ottiene punteggi eccezionali sui principali benchmark di coding agentico.
Contro:
- Richiede connettività internet costante con una stretta dipendenza dal cloud per funzionare.
- I costi di utilizzo dei token possono salire rapidamente per team di sviluppo di grandi dimensioni.
Ideale per: Refactoring di codice a grande scala, progettazione di sistemi full-stack e flussi di lavoro agentici complessi.
- GPT-5.6 Sol
Questo è un modello di punta versatile che offre un'ampia copertura sintattica dei linguaggi e un'integrazione estesa con l'ecosistema. OpenAI ha recentemente avanzato la frontiera prezzo-prestazioni con GPT-5.6. Funziona come un affidabilissimo cavallo di battaglia quotidiano per gli sviluppatori che gestiscono il lavoro software con efficienza.
| Versione | Velocità | Compatibile con | In parole semplici |
|---|---|---|---|
| GPT-5.6 Sol | Rapido | IDE principali e framework di agenti | L'assistente robusto che gestisce stabilmente i compiti multi-step. |
| GPT-5.6 Terra | Moderato | Strumenti di sviluppo standard | La versione API equilibrata per una risoluzione dei problemi stabile e passo-passo. |
| GPT-5.6 Luna | Fulmineo | Web e strumenti leggeri | Modello gratuito: L'aiutante quotidiano veloce e gratuito per la generazione rapida di codice. |
Pro:
- Esecuzione deterministica e stabile su compiti lunghi e multi-step senza deviare dalla rotta.
- Profonda compatibilità con l'ecosistema delle principali estensioni e piattaforme per sviluppatori.
- Copertura di addestramento completa su linguaggi di programmazione poco comuni e legacy.
Contro:
- Occasionalmente produce boilerplate eccessivamente prolisso invece di snippet concisi.
- La memoria contestuale può peggiorare in sessioni di chat molto lunghe.
Ideale per: Compiti deterministici multi-step, prototipazione rapida e integrazione API.
Migliori LLM open source e locali (privacy e personalizzazione enterprise)
Per le organizzazioni che danno priorità alla sicurezza della proprietà intellettuale, eseguire modelli LLM locali offline garantisce che nessun codice proprietario venga mai trasmesso a un server di terze parti. Questi modelli offrono un enorme vantaggio per la conformità enterprise.
- GLM-5.2
Il miglior modello di coding a pesi aperti disponibile, che offre un enorme potenziale di fine-tuning. GLM-5.2 è un modello di punta costruito per compiti a lungo termine e offre questa capacità con un solido contesto da 1M di token.
| Versione | Hardware necessario | Livello di potenza | In parole semplici |
|---|---|---|---|
| GLM-5.2 (grande) | Data center enterprise pesante | Intelligenza di punta | Il miglior coder a pesi aperti con una finestra di memoria enorme da 1M. |
| GLM-5.2 (piccolo) | Laptop standard | Buono per l'aiuto quotidiano | 100% gratuito e locale: Funziona direttamente sul tuo laptop offline, senza costi API. |
| GLM-5.2 Cloud | Browser web/API | Alto ragionamento | Accesso web gratuito: Lo strumento basato su browser per sperimentare senza configurazione. |
Pro:
- Modello a pesi aperti molto competitivo per compiti di ingegneria a lungo termine.
- Enorme finestra di contesto da un milione di token per assorbire interi repository localmente.
- Licenza aperta permissiva che accoglie sviluppo aziendale e commerciale.
Contro:
- Richiede hardware enterprise di alta fascia per sfruttare completamente la finestra di contesto da 1M di token localmente.
- I modelli a pesi aperti sono gratuiti da scaricare, ma utilizzarli a scala richiede risorse server costose.
Ideale per: Self-hosting di un coder quasi frontier mantenendo un'assoluta privacy dei dati enterprise.
- DeepSeek V4-Pro
Un modello ad alte prestazioni costruito specificamente per compiti di coding avanzati. DeepSeek sviluppa e rilascia come open source LLM frontier. Si comporta decisamente al di sopra della sua categoria in logica matematica e strutturazione algoritmica complessa, offrendo una configurazione enorme da 1,6 trilioni di parametri per la generazione intensiva di testo.
| Versione | Punto di forza principale | Ideale per | In parole semplici |
|---|---|---|---|
| DeepSeek V4-Pro | Programmazione competitiva e matematica | Repository di livello enterprise | Un cervello di coding specializzato che eccelle in algoritmi e logica complessa. |
| DeepSeek V4 | Ragionamento generale e sintassi | Scripting quotidiano e ricerca | Versione web gratuita: Un chatbot generico per la scrittura quotidiana e il codice base. |
| DeepSeek-Coder 7B | Esecuzione leggera | Sviluppo locale offline | 100% gratuito e locale: Un modello privato e gratuito eseguibile sul proprio PC. |
Pro:
- Eccelle enormemente nei compiti algoritmici e di programmazione competitiva.
- Fornisce privacy dei dati assoluta se self-hosted, per una conformità rigorosa sulla residenza dei dati.
- Vasta capacità di ragionamento matematico e capacità API ad alto volume.
Contro:
- Le configurazioni a parametri completi richiedono VRAM GPU di livello enterprise.
- La configurazione e il fine-tuning con quantizzazione richiedono conoscenze tecniche avanzate.
Ideale per: Repository enterprise sensibili alla privacy, compiti API ad alto volume e risoluzione di problemi algoritmici.
Modelli di coding specializzati e leggeri (autocompletamento rapido e bassa latenza)
Questi modelli sono fortemente quantizzati e ottimizzati esplicitamente per funzionare nativamente in background su laptop consumer o operare in modo economicamente efficiente sul cloud. Agiscono strettamente come assistenti rapidi, massimizzando l'efficienza.
- Qwen3-Coder-Next
Un modello altamente efficiente e specializzato nel codice, ottimizzato per il completamento multilingua su hardware consumer standard. Gli ultimi modelli Qwen3 adottano modalità di pensiero ibride che permettono di controllare in modo flessibile le prestazioni di ragionamento, la velocità e i costi.
| Versione | Velocità di risposta | Copertura linguistica | In parole semplici |
|---|---|---|---|
| Qwen3-Coder-Next | Rapido | 90+ linguaggi di programmazione | Il motore di punta a pesi aperti per configurazioni locali di sviluppatori seri. |
| Qwen3-Coder (7B) | Istantaneo | 90+ linguaggi di programmazione | 100% gratuito e locale: Come un testo predittivo per il codice che funziona fluidamente su laptop standard. |
| Qwen-Chat | Istantaneo | Coding standard e linguaggio naturale | Versione web gratuita: Un aiutante conversazionale veloce e gratuito per controlli di sintassi. |
Pro:
- Offre un'ottima efficienza di coding per parametro per configurazioni locali leggere.
- Funziona fluidamente su hardware consumer standard e deployment locali modesti con un sovraccarico minimo di risorse.
- Forte supporto sintattico multilingua che abbraccia oltre 90 linguaggi di programmazione.
Contro:
- Profondità di ragionamento limitata nella pianificazione di intere architetture software.
- Finestra di ritenzione del contesto più piccola rispetto ai grandi modelli cloud.
Ideale per: Autocompletamento riga per riga e sviluppatori che eseguono modelli su laptop standard.
- Gemini 3.7 Flash
Un assistente di coding fluido progettato esplicitamente per operazioni cloud economiche e configurazioni agentiche complesse. Gemini 3.7 Flash è ideale per affrontare compiti agentici complessi su larga scala.
| Versione | Come aiuta | Dove funziona | In parole semplici |
|---|---|---|---|
| Gemini 3.7 Flash | Compiti agentici complessi su larga scala | API cloud | Un assistente cloud ad alta velocità per grandi codebase e flussi di lavoro complessi. |
| Gemini 3.5 Flash-Lite | Compiti ad alto volume | API cloud | Livello API gratuito generoso: Un modello leggero costruito per efficienza e intelligenza. |
| Gemini Web | Chat generica e snippet di codice | Browser web | Versione web gratuita: Un assistente semplice e gratuito per bozze di funzioni e risposte alle domande. |
Pro:
- Incredibilmente efficiente per flussi di lavoro di agenti ad alto volume.
- Gestisce finestre di contesto enormi, permettendogli di leggere facilmente codebase enormi.
- Velocità rapide nella consegna dei token per debug rapido e modifiche in tempo reale.
Contro:
- Funziona strettamente come API cloud, il che significa che non può essere isolato o self-hosted per una privacy estrema.
- Può richiedere un affinamento dei prompt per adeguarsi alla rigorosità esatta di formattazione di Claude o GPT.
Ideale per: Coding cloud economicamente efficiente, lavoro di agenti ad alto volume e compiti a contesto lungo.
Come abbiamo testato questi LLM
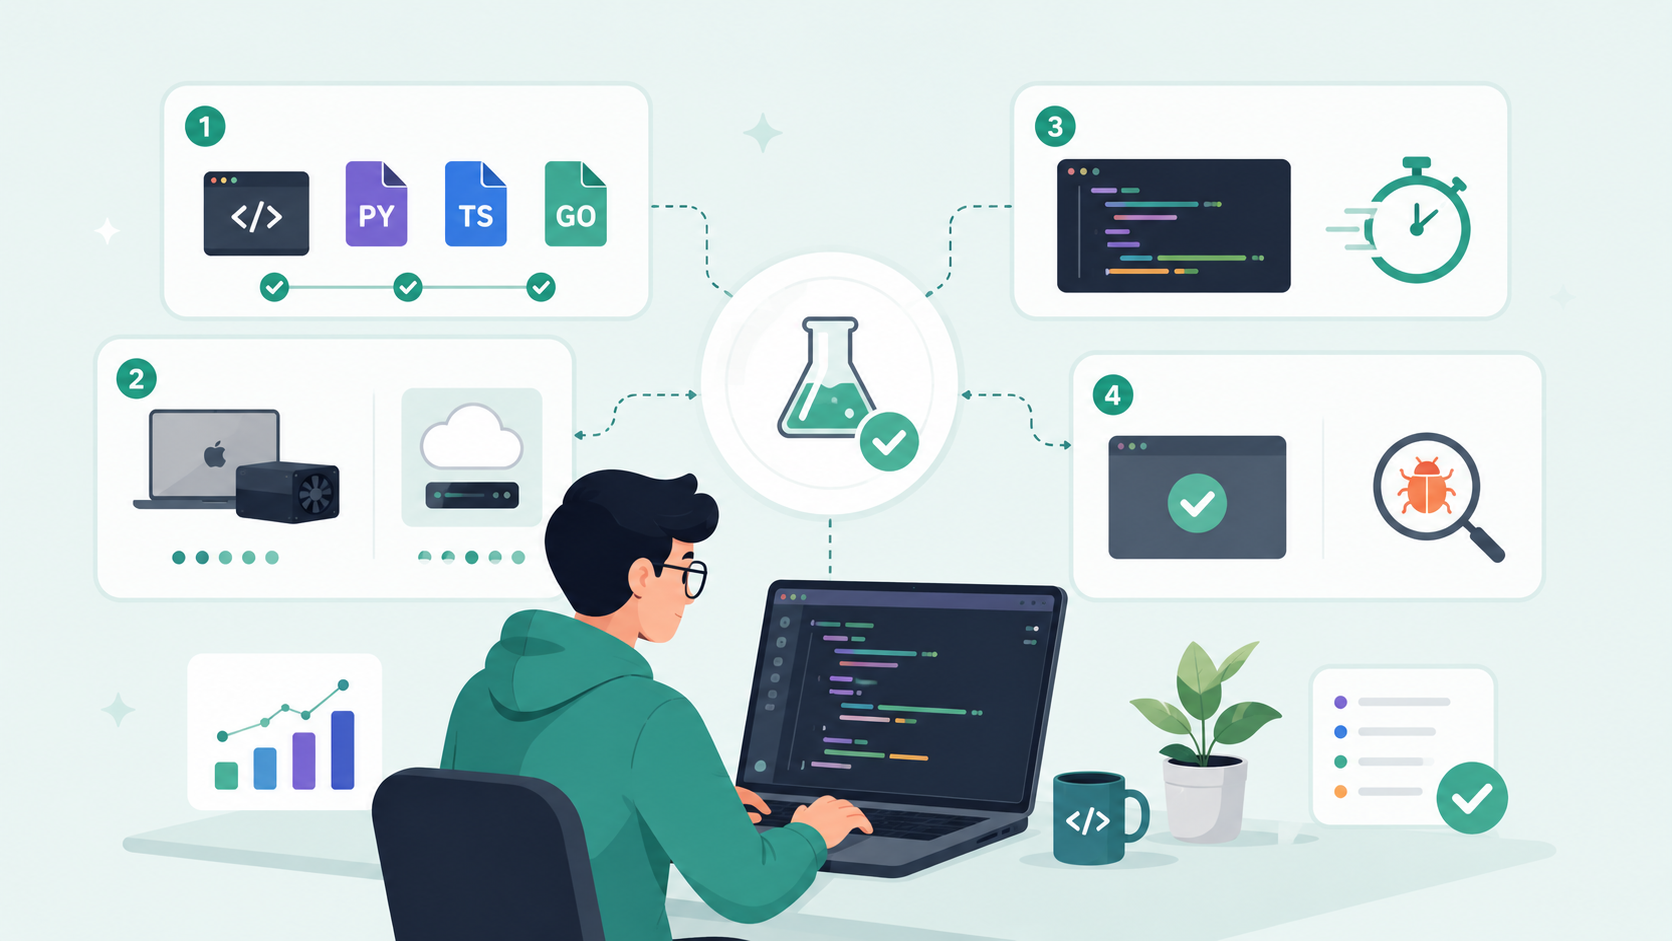
Abbiamo testato ogni modello attraverso un framework tecnico rigorosamente riproducibile per eliminare i bias soggettivi. La nostra suite di test combina benchmark consolidati per sviluppatori con sfide di ingegneria pratiche e reali.
Prompting di baseline controllata
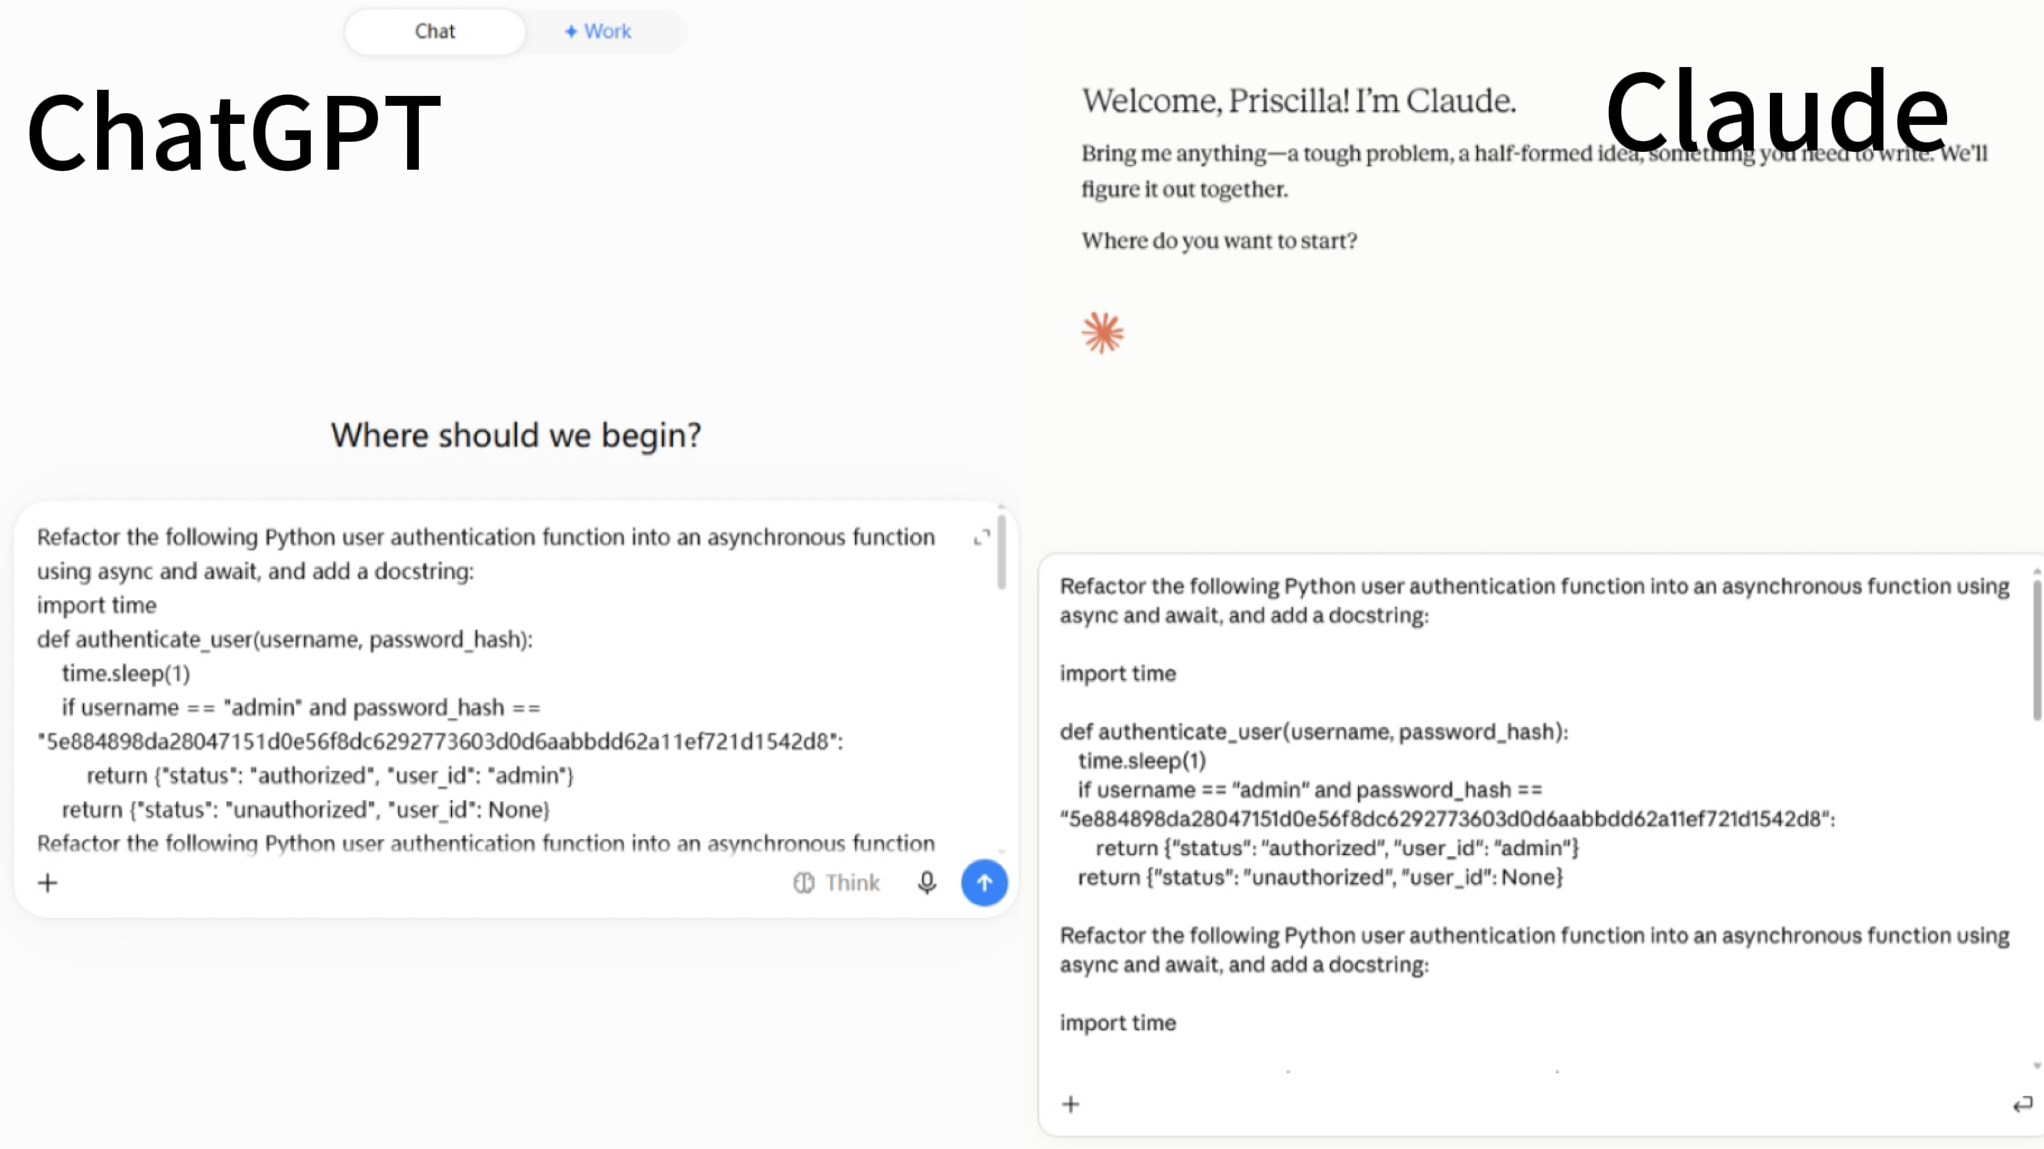
Per testare il ragionamento puro nel 2026, abbiamo inviato 5 prompt identici di refactoring architetturale direttamente nelle interfacce web native di leader di settore come ChatGPT e Claude.
Passo 1: Preparare 5 prompt identici di refactoring architetturale
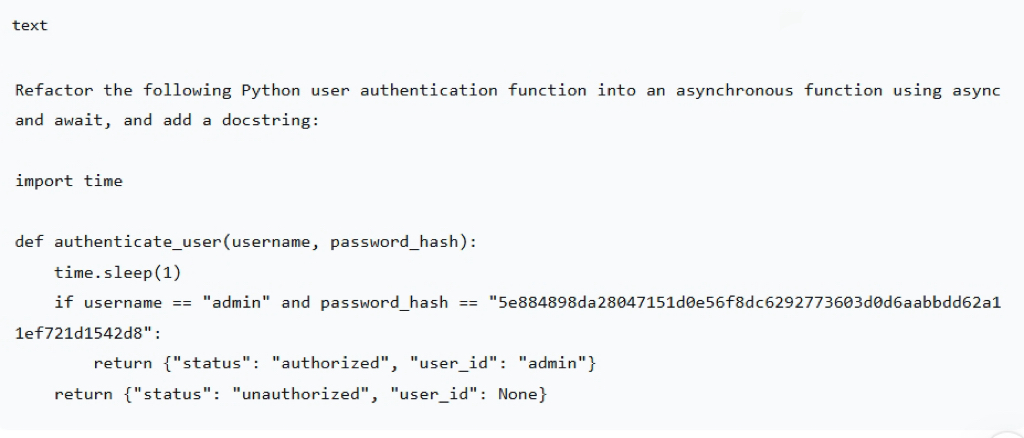
Prima ho scritto un prompt unificato di refactoring architetturale e l'ho copiato 5 volte, assicurandomi che il contenuto fosse esattamente lo stesso. Un prompt di esempio è mostrato di seguito:
Passo 2: Inviare i prompt nelle interfacce native ChatGPT/Claude
Ho aperto le interfacce web di ChatGPT e Claude, incollato e inviato i prompt uno per uno, e registrato completamente la risposta ogni volta.
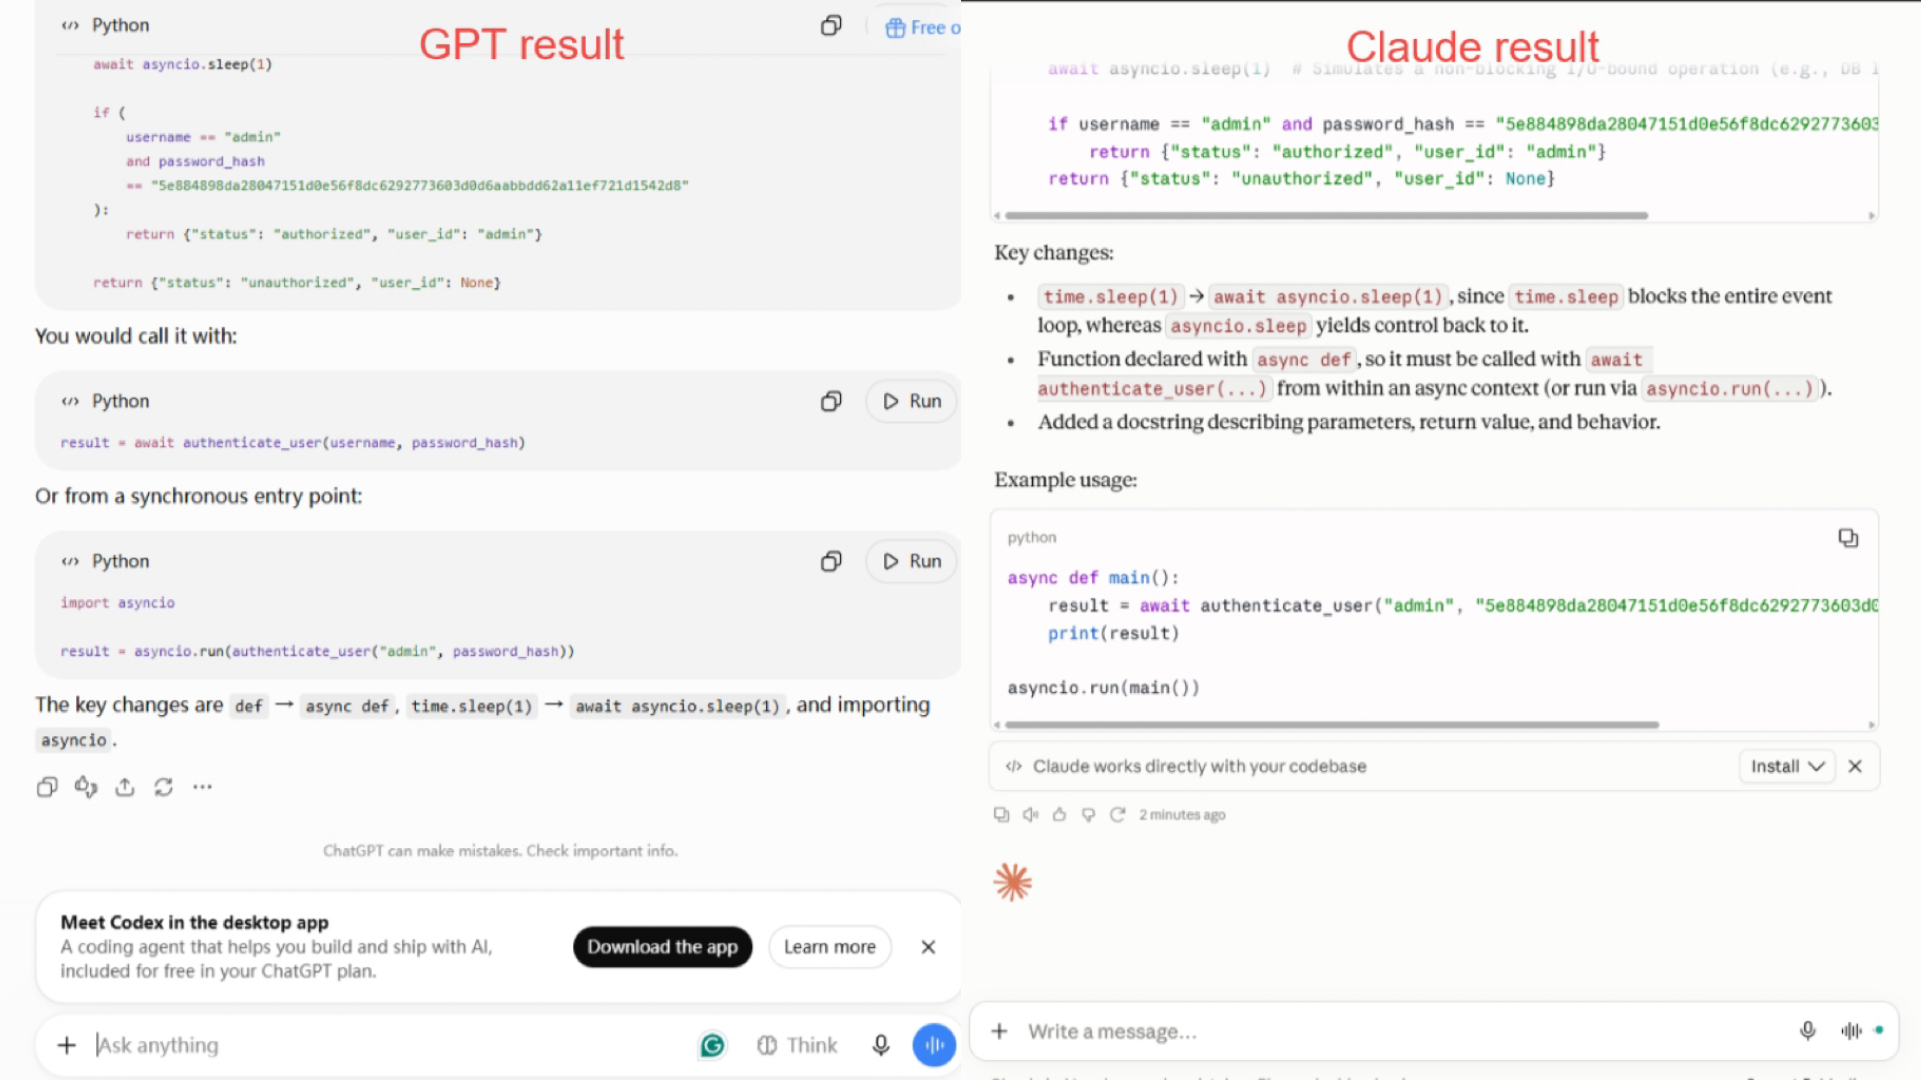
Passo 3: Valutare la capacità di gestione della logica multi-file
Dopo che ogni strumento fornisce i suoi risultati, valutiamo le rispettive vere capacità di ragionamento. Prendendo ChatGPT e Claude come esempio, entrambi i modelli hanno completato correttamente lo stesso refactoring, ma ho scoperto che gli stili e gli accenti dell'output differiscono: ChatGPT tende a fornire il risultato più un utilizzo conciso, mentre Claude tende a spiegare i principi sottostanti ed enfatizzare i vincoli. Questo riflette i loro diversi stili di ragionamento ed espressione a parità di input.
Profiling del sovraccarico hardware locale
I modelli locali offrono completa privacy dei dati, ma solo se funzionano in modo efficiente su hardware pratico. Abbiamo profilato modelli leggeri a pesi aperti come Qwen3-Coder (7B) e DeepSeek-Coder direttamente su una workstation locale.
- Abbiamo monitorato i picchi di VRAM e i carichi CPU durante la generazione massima di token per identificare i veri limiti delle risorse.
- Abbiamo confermato se gli sviluppatori possono self-hostare flussi di lavoro offline sicuri senza hardware enterprise costoso.
Integrazione IDE e frizione UX
Le metriche teoriche di latenza non significano nulla se i suggerimenti di codice risultano lenti durante l'editing live. Abbiamo testato modelli leggeri come Qwen3-Coder e Gemini 3.7 Flash all'interno di un editor di codice standard per valutare il completamento inline in tempo reale e il ritardo di input.
- Abbiamo valutato la latenza reale per garantire che il testo fantasma predittivo si adattasse senza interruzioni al ritmo naturale di digitazione di uno sviluppatore.
- Abbiamo verificato la consapevolezza del contesto per garantire che i modelli leggessero e applicassero correttamente le variabili tra file di progetto adiacenti aperti.
Verifica dell'esecuzione isolata e della sintassi
Il codice che appare corretto in un'interfaccia di chat spesso si rompe in fase di esecuzione. Abbiamo compilato ed eseguito snippet generati da DeepSeek V4-Pro e GPT-5.6 Sol direttamente all'interno di container Docker isolati.
- Esecuzioni sandbox oggettive hanno immediatamente segnalato metodi deprecati, import mancanti e allucinazioni sintattiche.
- Abbiamo tracciato i tassi reali di Pass@1 per confermare che la logica soddisfacesse le suite di test al primo tentativo.
Mentre gli LLM cloud e locali standalone eccellono nella generazione di snippet e nel perfezionamento di funzioni specifiche, costruire applicazioni complete richiede ancora configurazione manuale dell'IDE, setup di boilerplate e integrazione frontend-backend. Per sviluppatori e creator che vogliono evitare del tutto i cicli di coding ripetitivi, gli agenti di sviluppo autonomi offrono un percorso più rapido dal concetto al deployment.
Enter Pro: L'agente di sviluppo AI autonomo per la creazione rapida di software
Vuoi andare oltre la scrittura di funzioni isolate e generare applicazioni intere in modo autonomo? Enter Pro colma l'enorme divario tra le interfacce chat LLM pure e la generazione completa di progetti full-stack. Non devi più configurare manualmente ambienti locali, aggiornare dipendenze di sistema o combattere con gestori di pacchetti complicati. Invece, questa piattaforma utilizza un intuitivo modalità piano per il vibe coding per trasformare prompt in linguaggio naturale di alto livello direttamente in software raffinato e pronto per la produzione.
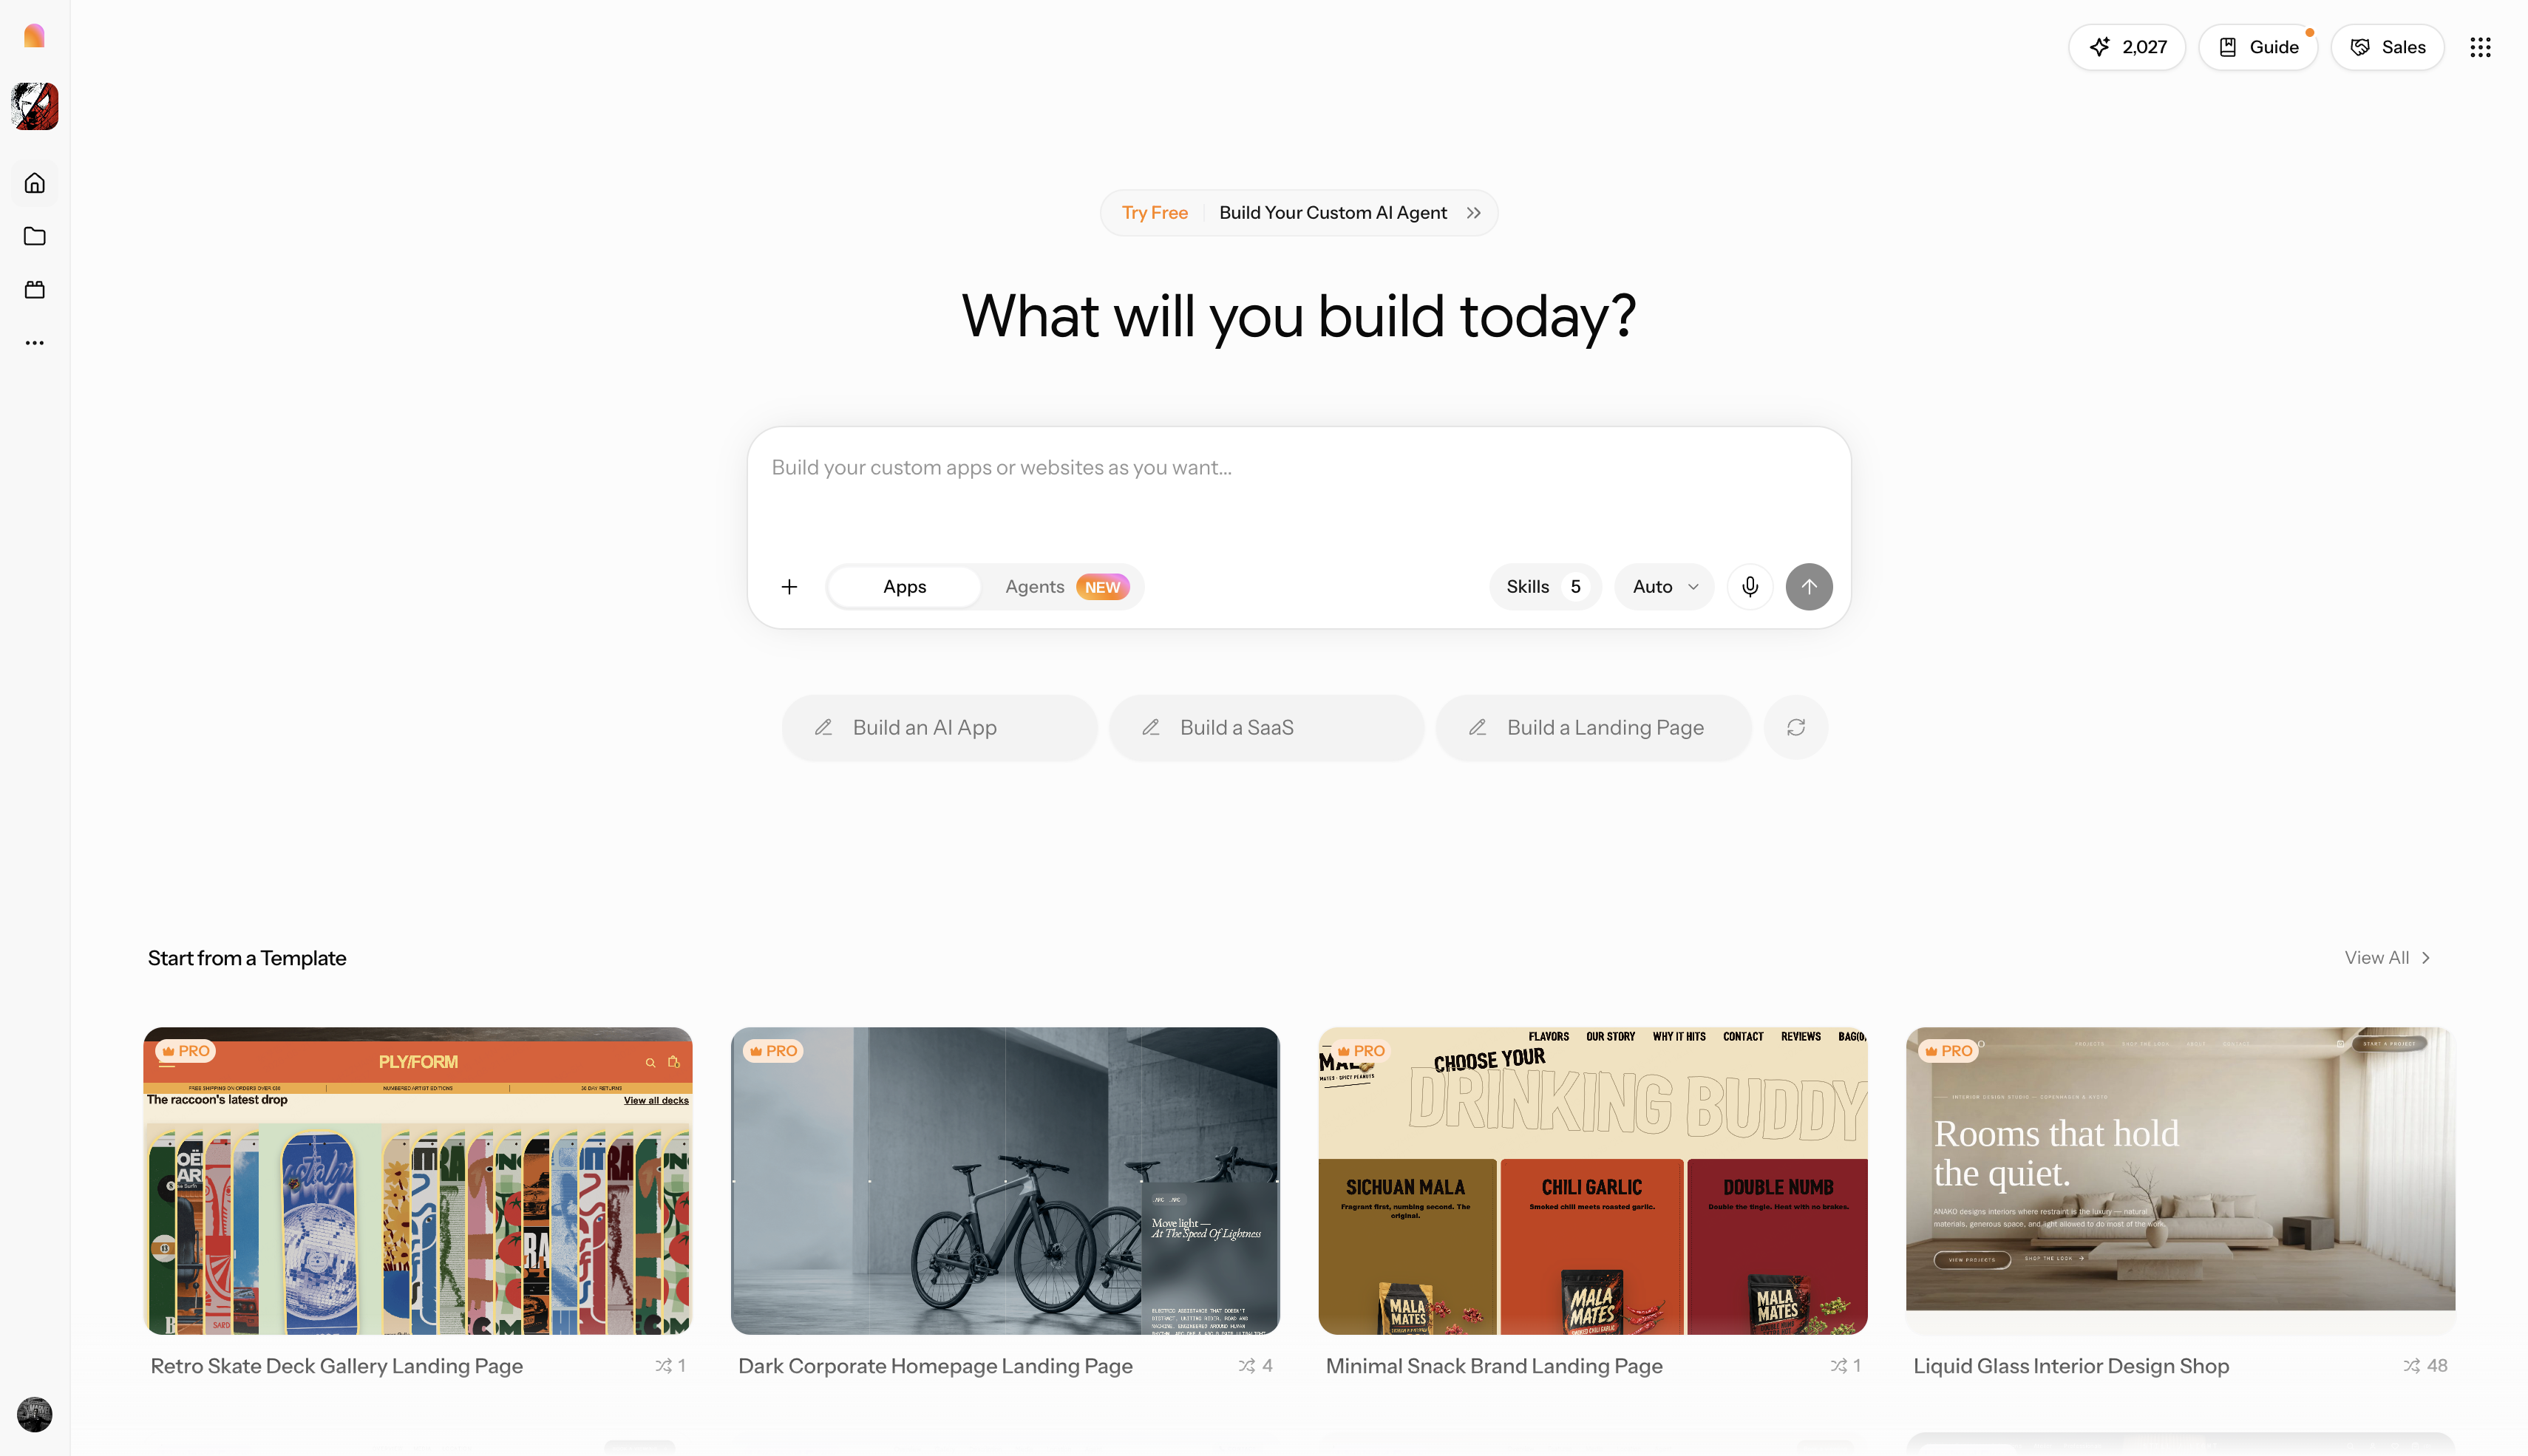
Funzionalità principali
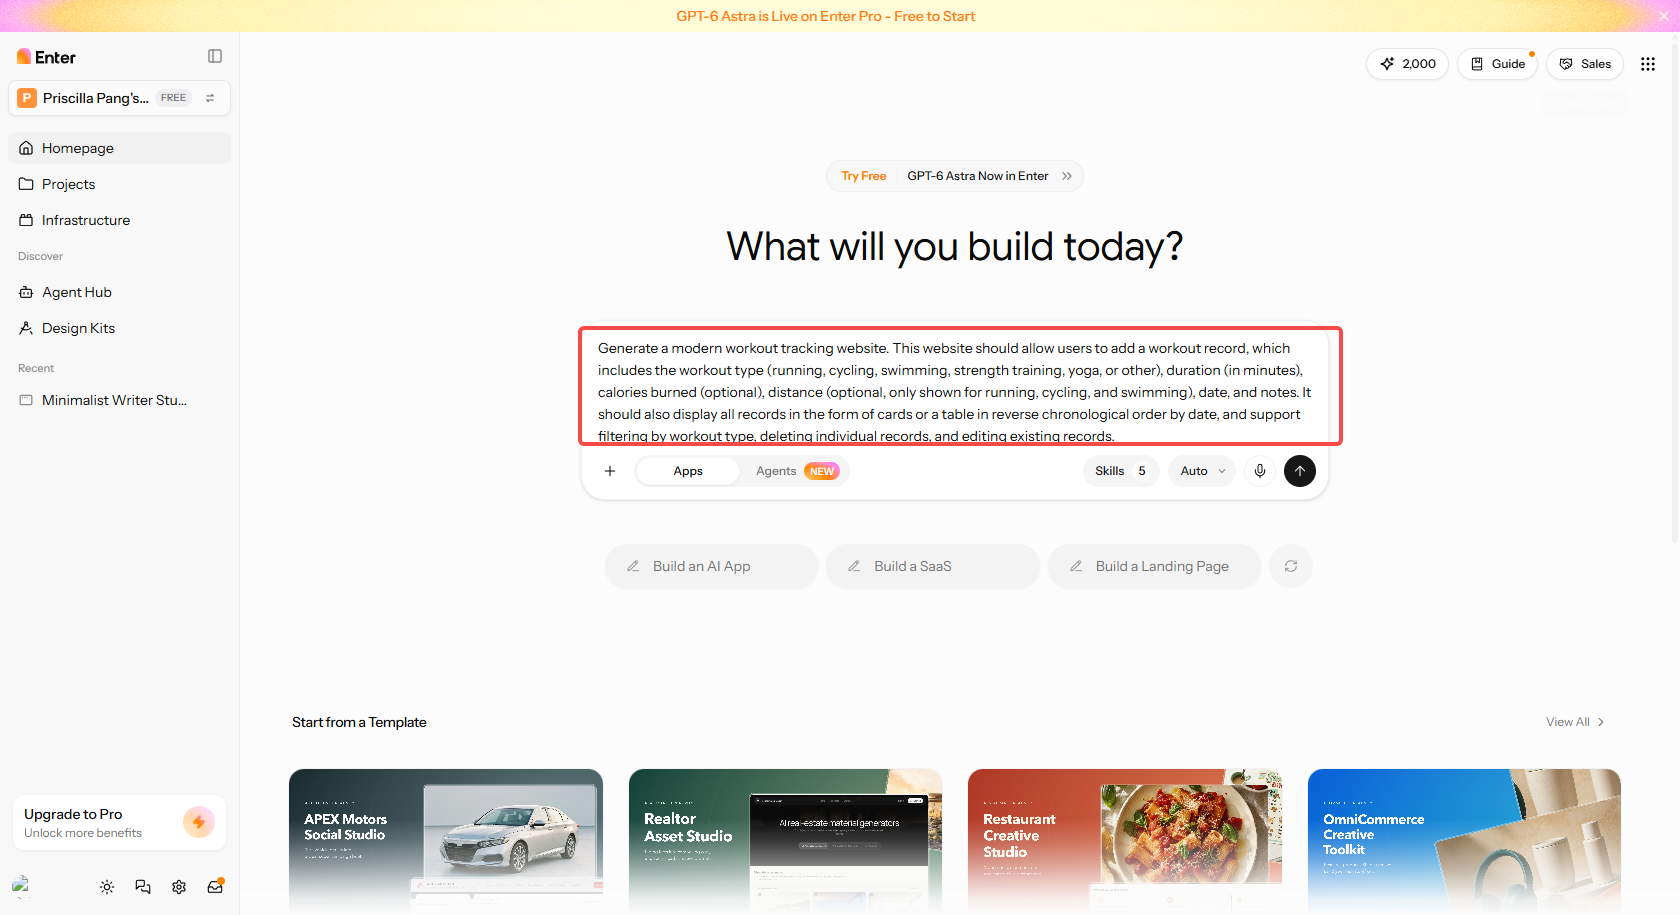
- Creazione basata su prompt
Gli utenti forniscono semplicemente un prompt in linguaggio naturale che descrive il tema cromatico del sito, il layout desiderato e le pagine funzionali incluse. Il motore integrato di Enter Pro costruisce istantaneamente la codebase full-stack fondamentale, inclusa la logica frontend e di database, riducendo drasticamente i tempi di configurazione manuale.
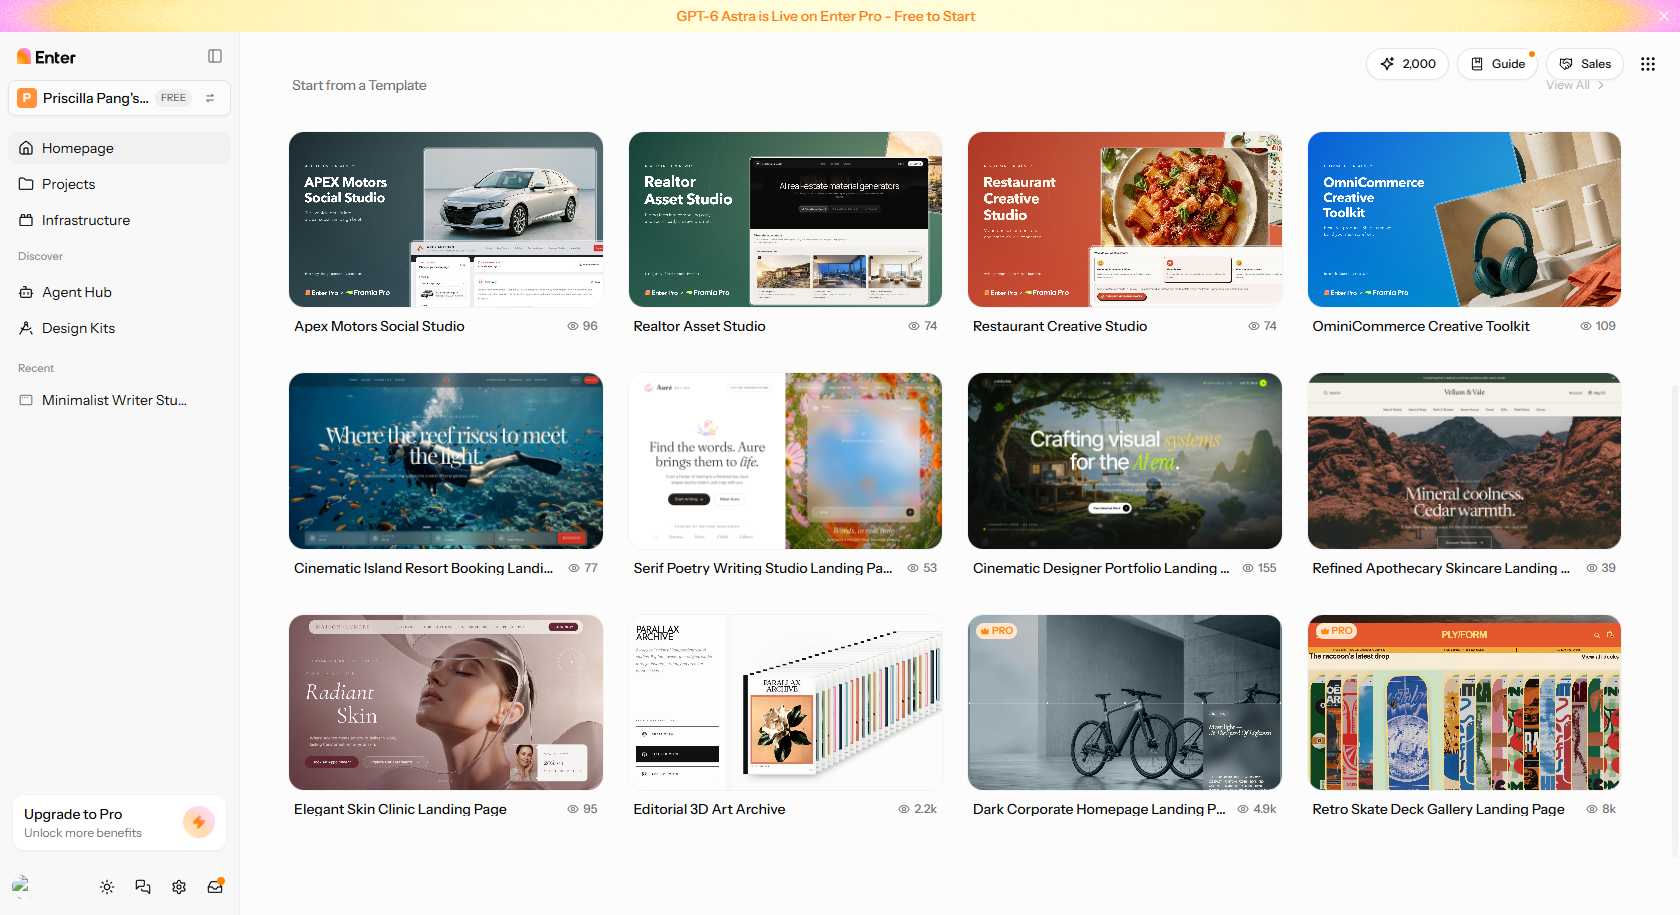
- Template pronti all'uso
La piattaforma offre template per siti web progettati professionalmente e completamente responsive, pensati per una velocità di deployment estrema. Enter Pro ottimizza specificamente questi layout per rispettare rigorosamente gli standard moderni di esperienza utente, garantendo una consegna di applicazioni di alta qualità senza aggiustamenti visivi manuali.
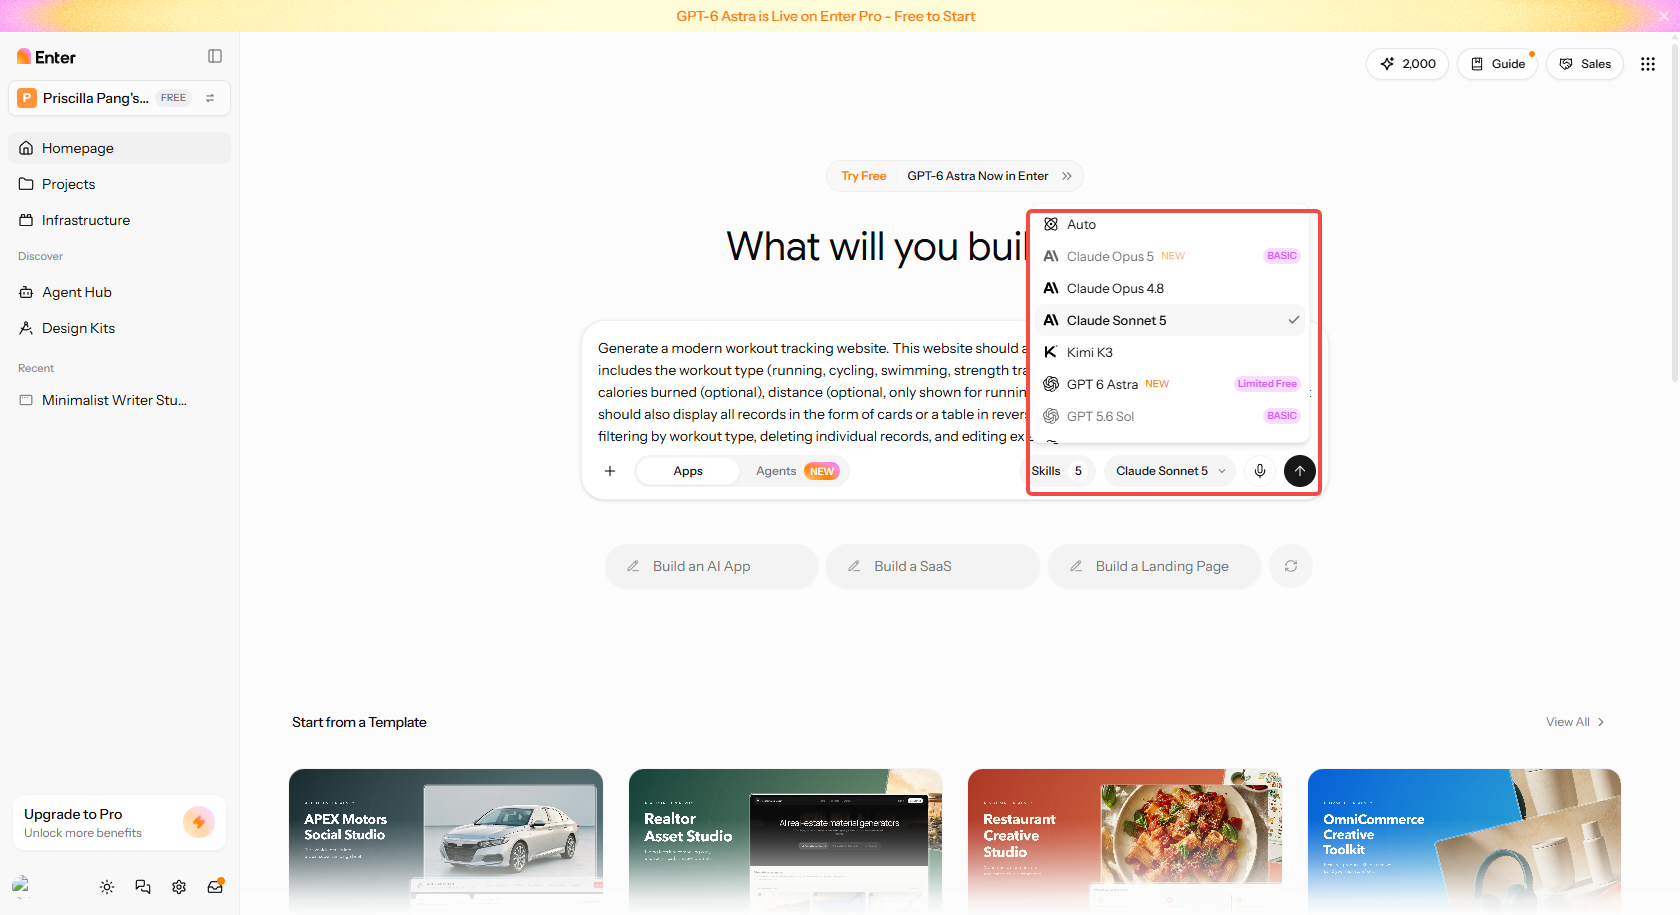
- Integrazione unificata dei modelli
Gli sviluppatori possono incorporare nativamente assistenti di coding di prima fascia e modelli avanzati direttamente nelle loro build Enter Pro attive con un unico abbonamento, inclusi Kimi K3, GPT 6 Astra e Claude Sonnet 5. Questo approccio semplificato elimina completamente l'incubo amministrativo di gestire e proteggere chiavi API separate tra diversi modelli frontier.
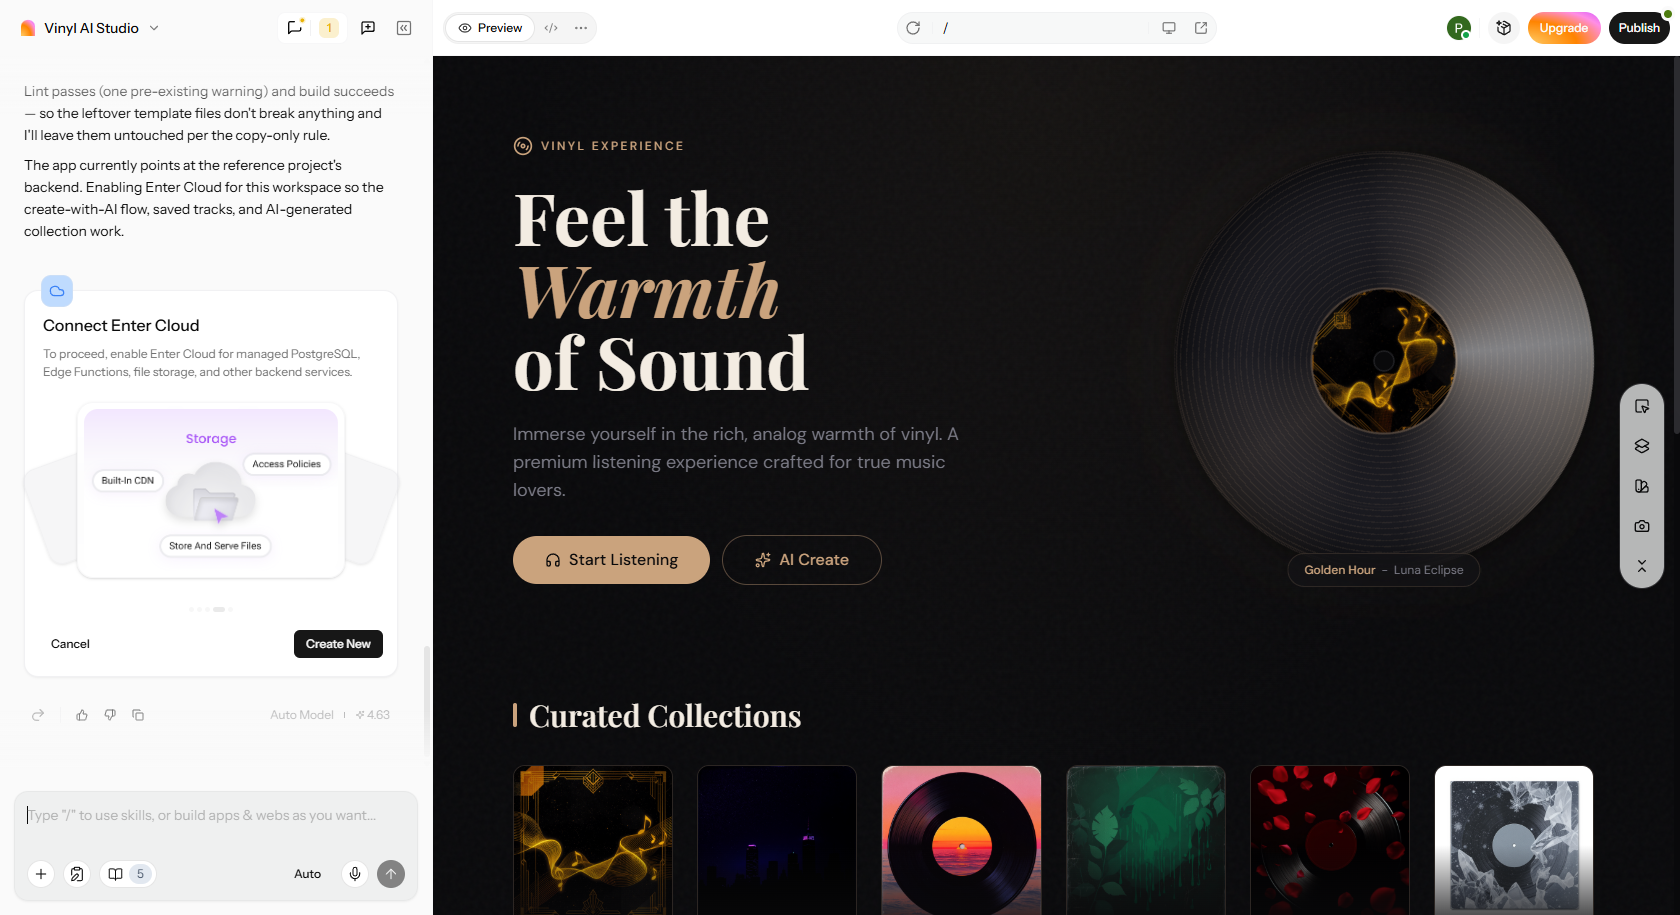
- Proprietà del codice al 100%
Conservi il controllo assoluto e i pieni diritti commerciali sul codice sorgente generato dopo l'esportazione dalla piattaforma Enter Pro. Questo garantisce una vera indipendenza, senza vincoli restrittivi al fornitore né future complicazioni di licenza.
Guida passo passo per costruire applicazioni
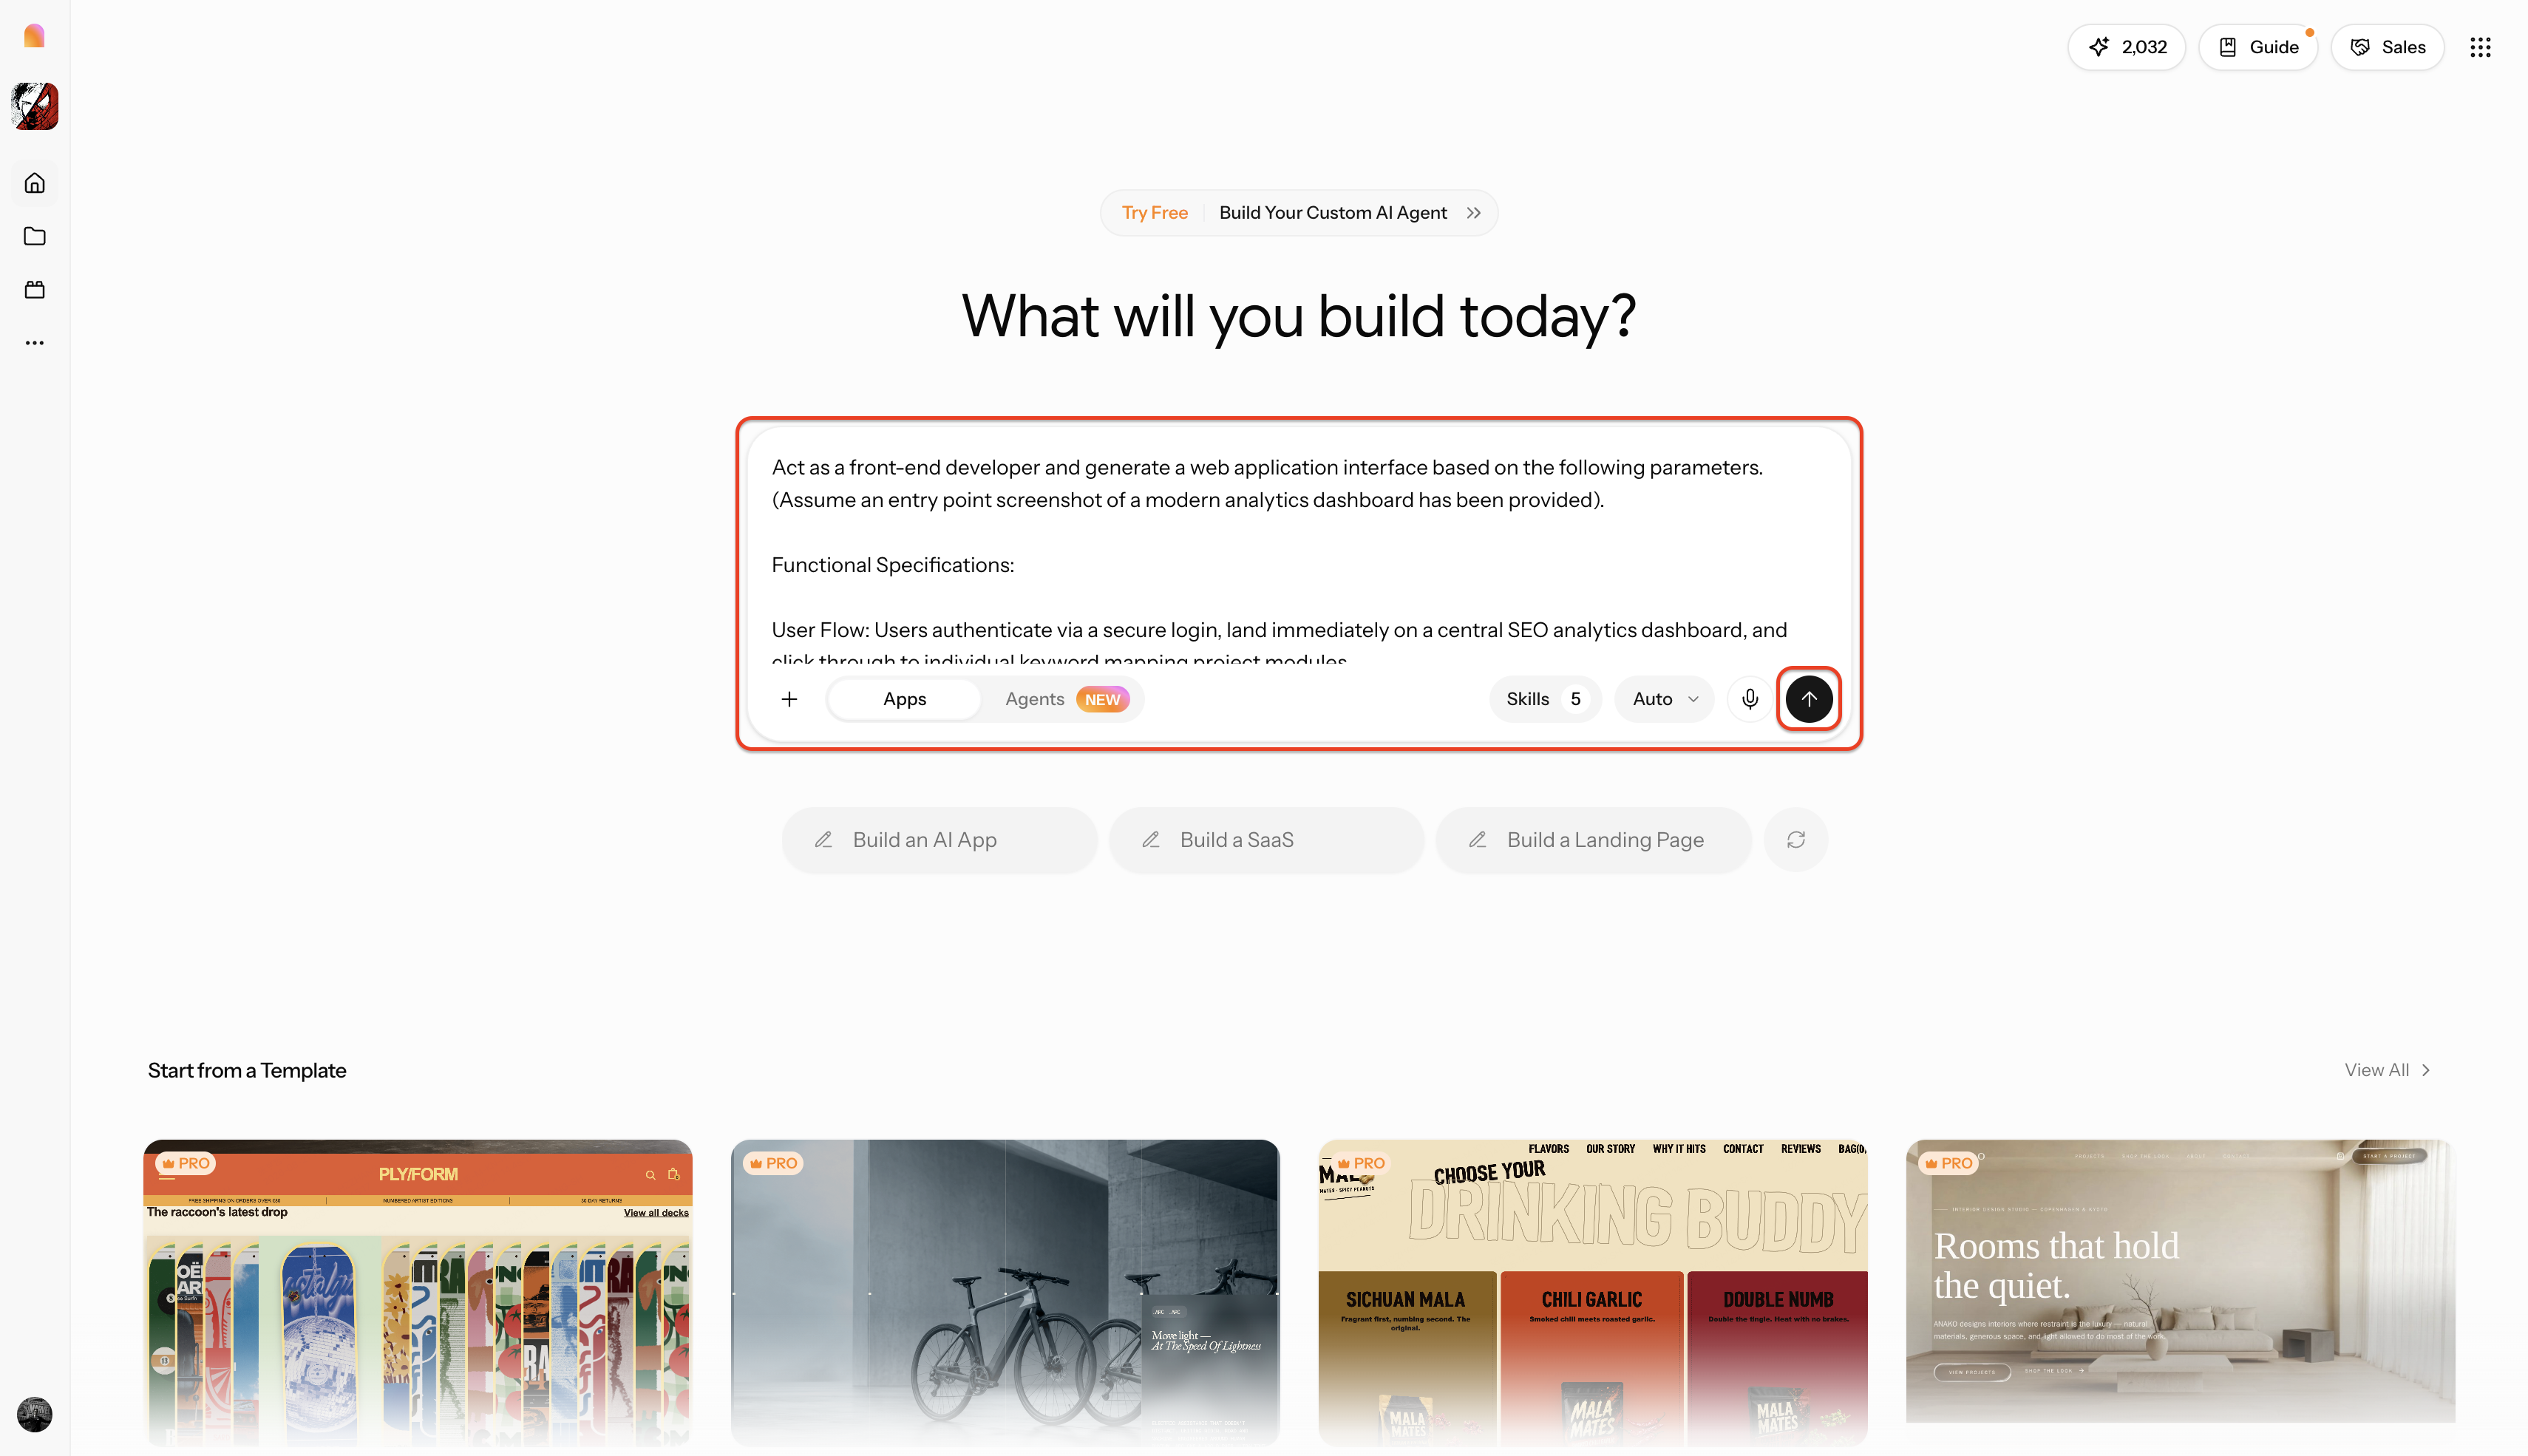
Passo 1: Avvia Enter Pro e inserisci il prompt del progetto
Inizia definendo le tue specifiche funzionali, le preferenze di stile UI e le funzionalità target interamente in linguaggio naturale. Puoi facilmente caricare uno screenshot del punto di accesso dell'interfaccia per guidare la comprensione strutturale ed estetica dell'IA fin dall'inizio.
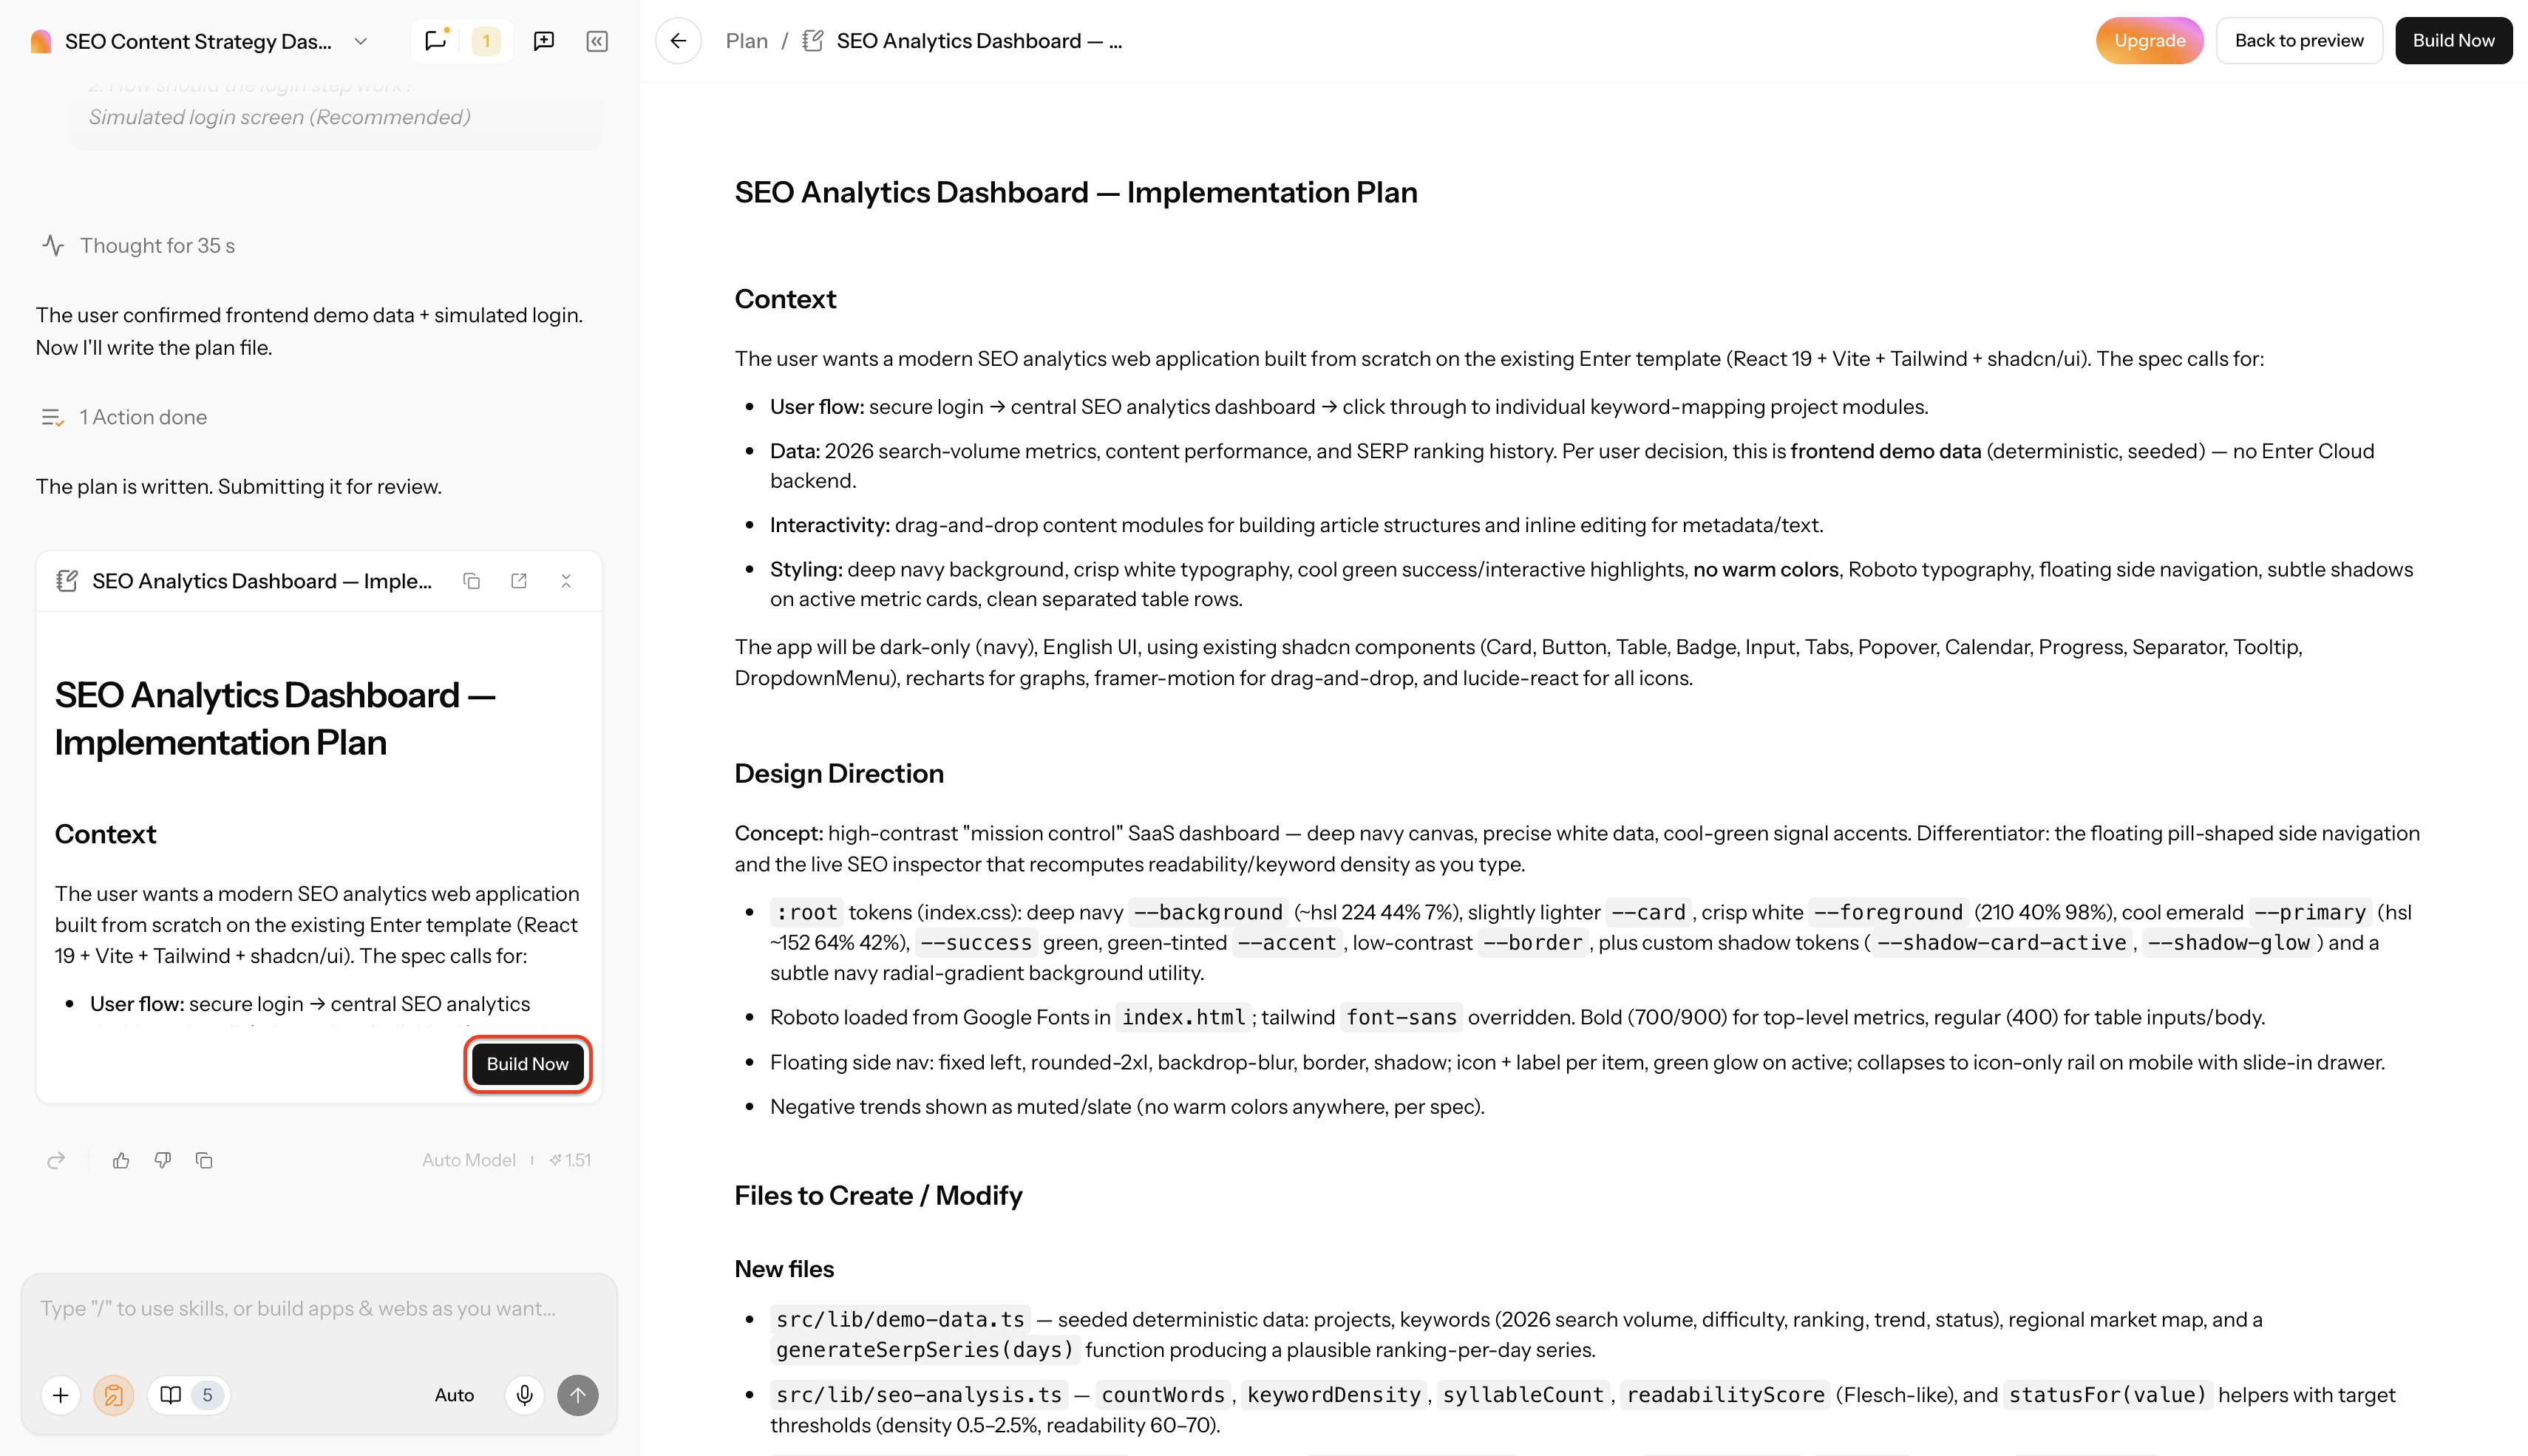
Passo 2: Rivedi il piano di implementazione e costruisci
Rivedi il piano generato dall'IA che delinea il contesto dell'app, la direzione del design e le strutture di file necessarie. Una volta pronto, clicca semplicemente sul pulsante "Build Now" per avviare il processo di generazione del codice full-stack.
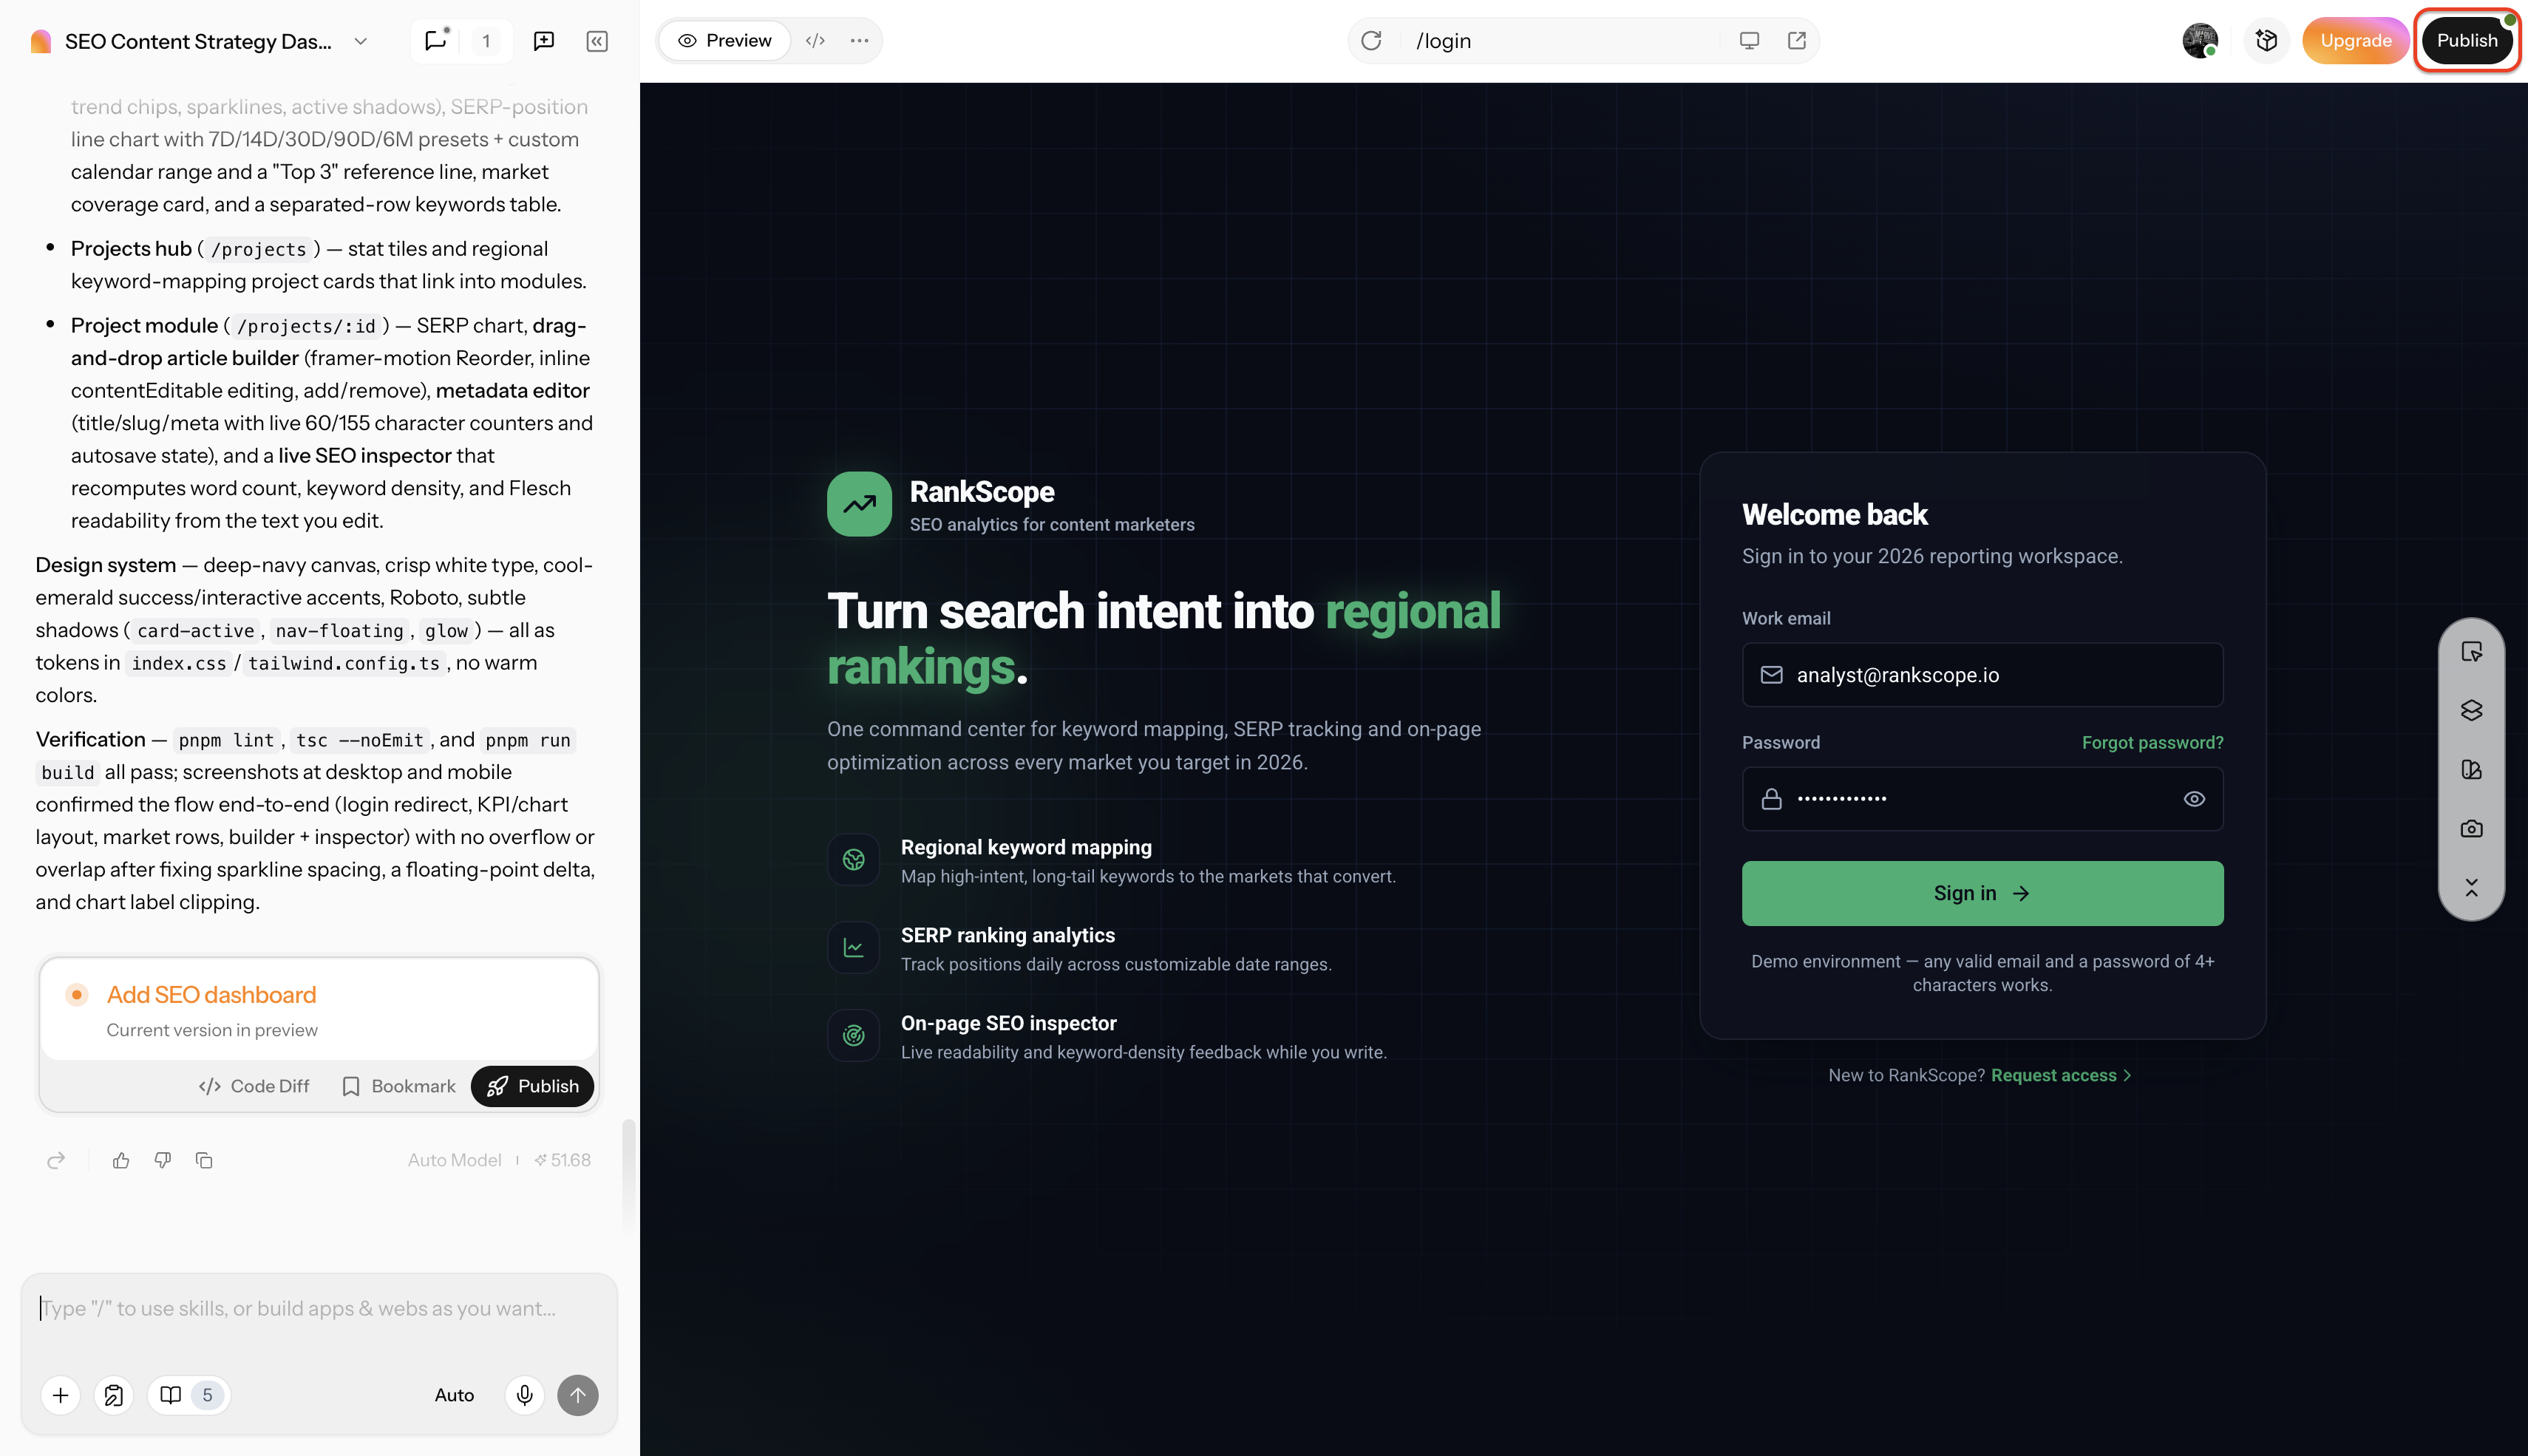
Passo 3: Modifica, pubblica ed esporta
Perfeziona l'applicazione generata modificando con semplici descrizioni di prompt o con l'Editor Visuale. Quando sei soddisfatto dei risultati, distribuisci l'applicazione live sul web con un solo clic, oppure esporta in modo sicuro i file sorgente strutturati sulla tua macchina locale.
LLM cloud vs. LLM locali vs. agenti AI autonomi: compromessi tra performance e privacy
Selezionare l'architettura più appropriata richiede un'analisi approfondita dei compromessi fondamentali presenti nel tuo attuale ambiente di ingegneria.
| Dimensione | LLM cloud frontier | LLM locali self-hosted | Agente autonomo (Enter Pro) |
|---|---|---|---|
| Privacy dei dati | Dipende dalla politica dati dell'API cloud | 100% privato/air-gapped | Spazio di lavoro isolato/proprietà del codice |
| Sovraccarico hardware | Nessun calcolo locale richiesto | Richiede VRAM/GPU elevate | Nessun calcolo locale richiesto |
| Complessità di setup | Chiave API e configurazione plugin IDE | Setup runtime locale e quantizzazione | Spazio di lavoro visuale prompt-e-avvio |
| Ambito dell'output | Snippet, funzioni e consigli in chat | Completamento del codice e modifiche locali | Applicazioni full-stack complete |
| Modello di costo | Abbonamento API a pagamento per token | Costo hardware locale anticipato | Abbonamento piattaforma fisso |
- Privacy e proprietà intellettuale: Quando gestisco codebase rigorose e altamente proprietarie, privilegio costantemente i modelli locali per prevenire completamente qualsiasi fuga di PI confidenziale. Inviare logica aziendale non pubblicata a server remoti spesso viola rigide normative di conformità.
- Requisiti hardware: Eseguire modelli open source richiede hardware dedicato serio. Un modello da 7 miliardi di parametri generalmente richiede di allocare almeno 8 GB di VRAM, un modello da 14 miliardi richiede 16 GB, e gli enormi modelli da 70 miliardi di parametri richiedono 48 GB+ di VRAM, spesso necessitando costose configurazioni desktop a doppia GPU o server locali specializzati.
- Latenza vs capacità: Le reti di calcolo cloud offrono una potenza immensa e incomparabile per il ragionamento profondo e il refactoring massiccio multi-file. Tuttavia, passando a modelli locali self-hosted, sperimento un rigoroso vantaggio di rete a latenza zero che li rende decisamente superiori e molto più fluidi per i completamenti di testo inline istantanei.
Verdetto della community: recensioni degli sviluppatori e tendenze del vibe coding
- Il vibe coding si riferisce a un moderno flusso di lavoro di sviluppo in cui gli sviluppatori guidano l'architettura di sistema di alto livello e la logica applicativa usando prompt in linguaggio naturale, mentre l'IA genera autonomamente la sintassi boilerplate. Piuttosto che digitare manualmente routine, l'ingegnere agisce come un direttore architetturale, guidando l'intento del progetto e revisionando gli output generati.
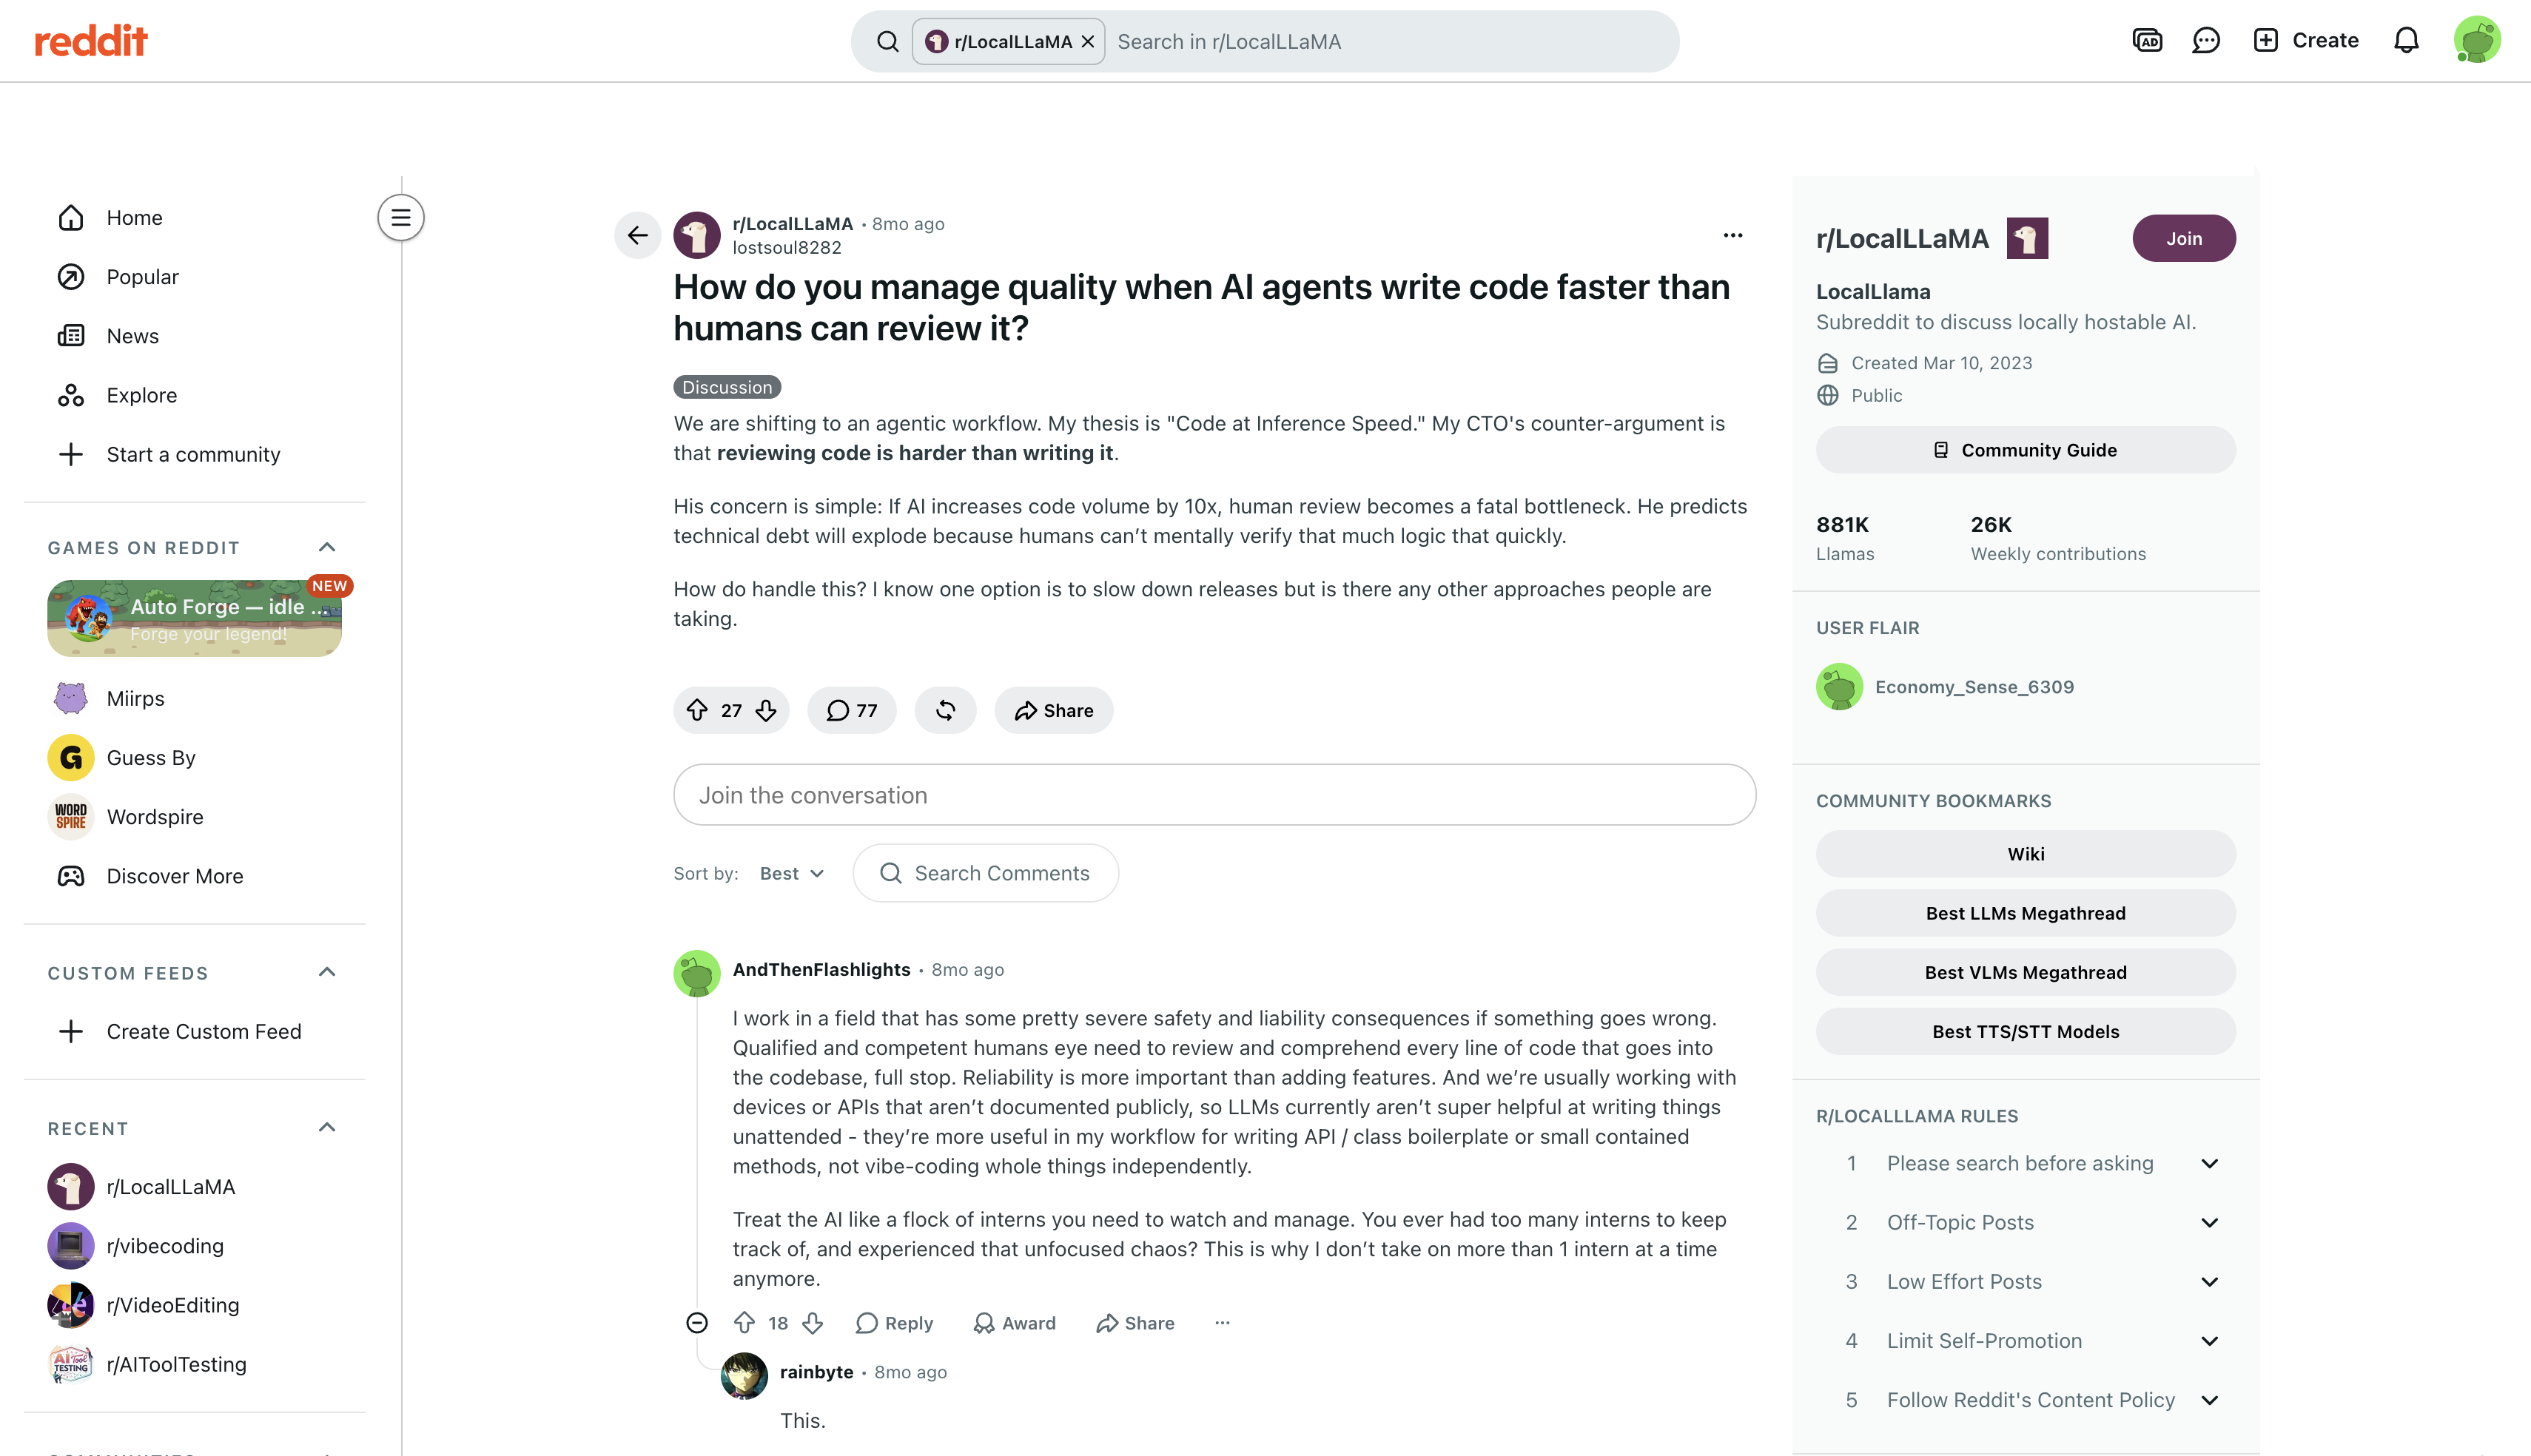
Consenso della community Reddit:
- Sintetizzando le opinioni emerse dalle discussioni degli sviluppatori su r/vibecoding, gli ingegneri adottano frequentemente un approccio a livelli, multi-modello. Raramente si affidano a un singolo strumento per gestire un'intera build full-stack.
- Gli sviluppatori in genere avviano l'impalcatura di alto livello e i concetti frontend usando modelli rapidi e generici. Poi passano immediatamente a Claude Opus 5 per l'esecuzione logica profonda, il refactoring complesso multi-file e il debug mirato.
- Le discussioni su forum di ingegneria come r/LocalLLaMA enfatizzano che la supervisione umana rimane strettamente necessaria. Sebbene la generazione autonoma accelera le build iniziali, gli sviluppatori devono gestire attivamente dipendenze di stato complesse per prevenire la deriva logica.
Preferenze di modello della community:
- Flussi di lavoro senza configurazione: Gli ingegneri favoriscono fortemente configurazioni basate sul cloud integrate direttamente in editor di codice moderni e nativi per l'IA, per uno sviluppo rapido. Claude Opus 5 è ampiamente citato come lo standard de facto per il suo equilibrio tra precisione zero-shot, ritenzione del contesto e output altamente affidabile.
- Configurazioni degli appassionati del locale: Molti sviluppatori optano per deployment locali per evitare spese ricorrenti di token API e proteggere codebase private. Modelli open source come Qwen3-Coder-Next e DeepSeek V4-Pro sono ampiamente raccomandati per il self-hosting tramite runtime come Ollama, offrendo una solida generazione di codice senza alcuna telemetria dei dati.
Conclusione
In definitiva, non esiste un unico miglior LLM per programmare che si adatti perfettamente a ogni caso d'uso ingegneristico nel 2026. I modelli cloud frontier offrono la potenza di ragionamento grezza necessaria per il refactoring di sistemi complessi e la progettazione strutturale. Per la sicurezza enterprise, il miglior LLM locale per programmare garantisce zero fughe di dati in ambienti altamente sensibili. Nel frattempo, adottare agenti di sviluppo autonomi semplifica la consegna completa delle applicazioni, dal concetto iniziale al deployment in produzione. Valuta il budget, le capacità hardware e le politiche di sicurezza dei dati del tuo team prima di impegnarti in un singolo ecosistema. Avvia un IDE e configura alcune chiavi API o runtime locali. Confronta questi modelli con la tua codebase per scoprire quale set di strumenti eleva davvero il tuo flusso di lavoro ingegneristico.
Domande frequenti sul miglior LLM per programmare
Quale LLM è il migliore per programmare nel 2026?
Claude Opus 5 è attualmente il miglior LLM di coding per l'ingegneria software complessa, il refactoring multi-file e i loop di agenti autonomi. Per gli sviluppatori che cercano esecuzione deterministica e un'ampia integrazione IDE, GPT-5.6 Sol funge da migliore alternativa cloud. I team che danno priorità a una rigorosa privacy dei dati possono distribuire localmente potenze a pesi aperti come GLM-5.2 o DeepSeek V4-Pro, senza dipendenze dal cloud.
Qual è il miglior LLM locale per programmare su laptop consumer?
Qwen3-Coder-Next e GLM-5.2 sono altamente ottimizzati per ambienti locali. Qwen3-Coder-Next offre un'ottima efficienza per parametro su hardware modesto, mentre GLM-5.2 è il miglior coder a pesi aperti con un contesto da 1M di token.
Quanta RAM e VRAM sono necessarie per eseguire modelli LLM locali?
Per eseguire comodamente un modello di coding standard da 7 miliardi di parametri, servono almeno 8 GB di VRAM GPU o memoria unificata Apple. I modelli più grandi da 14 miliardi richiedono circa 16 GB, mentre gli enormi modelli di livello enterprise da 70 miliardi richiedono tra 48 GB e 64 GB di VRAM per funzionare senza intoppi.
I modelli di coding cloud sono sicuri per il codice aziendale proprietario?
Dipende interamente ed esclusivamente dalla specifica politica di conservazione dell'API del provider. Mentre gli accordi API enterprise di alto livello generalmente promettono di non addestrarsi sui dati degli utenti, la rigida conformità aziendale e le normative governative spesso impongono modelli locali completamente air-gapped per garantire una sicurezza assoluta.
Che cos'è il "vibe coding" e quale modello gli si adatta meglio?
Si riferisce a un moderno flusso di lavoro di sviluppo in cui un ingegnere guida la logica applicativa usando prompt ampi e di alto livello in linguaggio naturale, mentre l'IA gestisce autonomamente tutta la generazione di boilerplate e la scrittura della sintassi. Modelli frontier come Claude Opus 5 e GPT-5.6 Sol eccellono fortemente in questa metodologia per il coding agentico e i grandi refactoring.
Come si confrontano i modelli di coding open source con Claude Fable 5?
Modelli a pesi aperti come GLM-5.2 e DeepSeek V4-Pro stanno riducendo rapidamente il divario, superando baseline precedenti come GPT-5.5 su SWE-bench Pro e sfide algoritmiche. Tuttavia, motori frontier come GPT-5.6 Sol e Claude Fable 5 mantengono ancora un vantaggio netto nei refactoring massicci e nei loop di agenti complessi.
Gli LLM di coding possono sostituire gli ingegneri software umani?
No. Questi modelli attualmente agiscono come compilatori altamente avanzati e potenti accelleratori di flusso di lavoro. Richiedono ancora assolutamente ingegneri umani esperti per progettare meticolosamente l'architettura di sistema, gestire protocolli di sicurezza complessi e verificare rigorosamente la logica funzionale prima del deployment in produzione.
Qual è il miglior LLM open source gratuito per lo sviluppo Python?
GLM-5.2 e Qwen3-Coder-Next vantano entrambi capacità estese e altamente specializzate. GLM-5.2 si estende fino a un contesto da 1M di token per grandi codebase, mentre Qwen3-Coder-Next offre un'eccellente efficienza per deployment locali più piccoli, rendendoli entrambi scelte gratuite eccezionali per i flussi di lavoro di sviluppo web standard.





