
Recensione GLM-5: versioni, benchmark, prezzi e accesso
Confronta le versioni di GLM-5, benchmark, prezzi, architettura, deployment locale, accesso API e integrazione con Enter Pro.
GLM-5 non è più un singolo modello valutabile con un solo benchmark. È ormai un'intera famiglia agile: alcune varianti gestiscono solo testo, altre accettano immagini in input, le versioni più recenti hanno ampliato la finestra di contesto a 1 milione di token, e l'opzione più economica costa solo una frazione del modello di punta.
Prima di aggiornare questa recensione, ho esaminato le note di rilascio, le model card, la documentazione API, il repository e screenshot reali del prodotto di Z.ai. È importante saperlo, perché alcune affermazioni sono piuttosto attraenti — come un guadagno interno del 50% nel coding o un calcolo 2,9 volte inferiore su contesti lunghi — e provengono da Z.ai, non da un audit indipendente. Le presento quindi come affermazioni, non come risultati di test personali.
Nella scelta di un modello GLM-5 ci sono quattro domande da considerare: quali input hai? Qual è il livello di difficoltà del compito? Dove deve avvenire l'inferenza? Quanto costa un risultato riuscito se sono necessari tentativi ripetuti? La mia risposta rapida: GLM-5.3 per testo/codice più complesso, GLM-5.3-Flash per multimodalità o economicità, e GLM-5.2 se hai già un'integrazione validata.
Cos'è GLM-5?
GLM-5 è la famiglia di modelli open-weight sviluppata da Z.ai per l'ingegneria del software, l'uso di strumenti e gli agenti a lungo orizzonte. La versione originale (febbraio 2026) è un modello Mixture-of-Experts (MoE) con input e output solo testuali, con 744 miliardi di parametri totali, circa 40 miliardi di parametri attivi per token, e una finestra di contesto di 200.000 token. Queste specifiche provengono dal report tecnico di GLM-5 e dal repository GitHub ufficiale.
Un modello MoE non attiva l'intera rete per ogni token. Un router indirizza ogni token verso un piccolo gruppo di esperti, riducendo il calcolo attivo mantenendo però un checkpoint molto grande. Questo non rende GLM-5 un modello da laptop: i pesi completi richiedono comunque storage, routing e hardware di livello server.
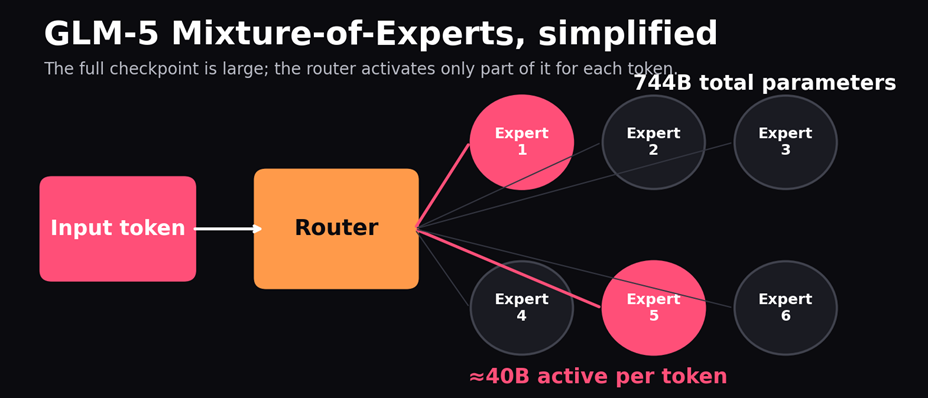
Figura 1. GLM-5 attiva circa 40 miliardi dei 744 miliardi di parametri per token; il checkpoint completo rimane un deployment su scala server.
Il termine corretto è "pesi aperti" (open weights). Esistono condizioni diverse per codice, pesi del modello, servizio ospitato e dati di addestramento. Prima di qualsiasi uso commerciale, consulta la licenza della model card che intendi usare, poiché non tutte le versioni di GLM offrono gli stessi diritti.
La famiglia di versioni GLM-5
Il nome della famiglia nasconde differenze importanti. Scegli in base a modalità, contesto, storico di validazione e modalità di deployment, piuttosto che trattare ogni versione 5.x come intercambiabile.
| Versione | Input/contesto | Motivo migliore per usarla | Avvertenza importante |
|---|---|---|---|
| GLM-5 | Testo / 200K | Ricerca originale o integrazione legacy | Primo rilascio della famiglia; non la mia scelta predefinita per un nuovo progetto |
| GLM-5-Turbo | Testo / 200K | Lavoro di agenti ospitato e intensivo nell'uso di tool | Un accesso del provider, non un piccolo checkpoint scaricabile |
| GLM-5V-Turbo | Testo, immagini, video, file / 200K | Coding visivo e task GUI | Verifica i formati accettati sul tuo endpoint |
| GLM-5.1 | Testo / 200K | Esecuzioni di engineering prolungate | Superato per la maggior parte delle nuove valutazioni |
| GLM-5.2 | Testo / 1M | Contesto lungo e integrazioni già validate | La migrazione a 5.3 modifica il comportamento di reasoning |
| GLM-5.3 | Testo / 1M | Coding difficile e agenti di lunga durata | Il reasoning è sempre attivo; l'output può essere lungo |
| GLM-5.3-Flash | Multimodale / 1M | Screenshot, volume e basso costo | Architettura distinta 320B/18B, non "5.3 a basso sforzo" |
Fonti: note di rilascio di Z.ai, guida GLM-5-Turbo, guida GLM-5V-Turbo e guida GLM-5.1. Un host può esporre una finestra di contesto più piccola di quella supportata dal modello.
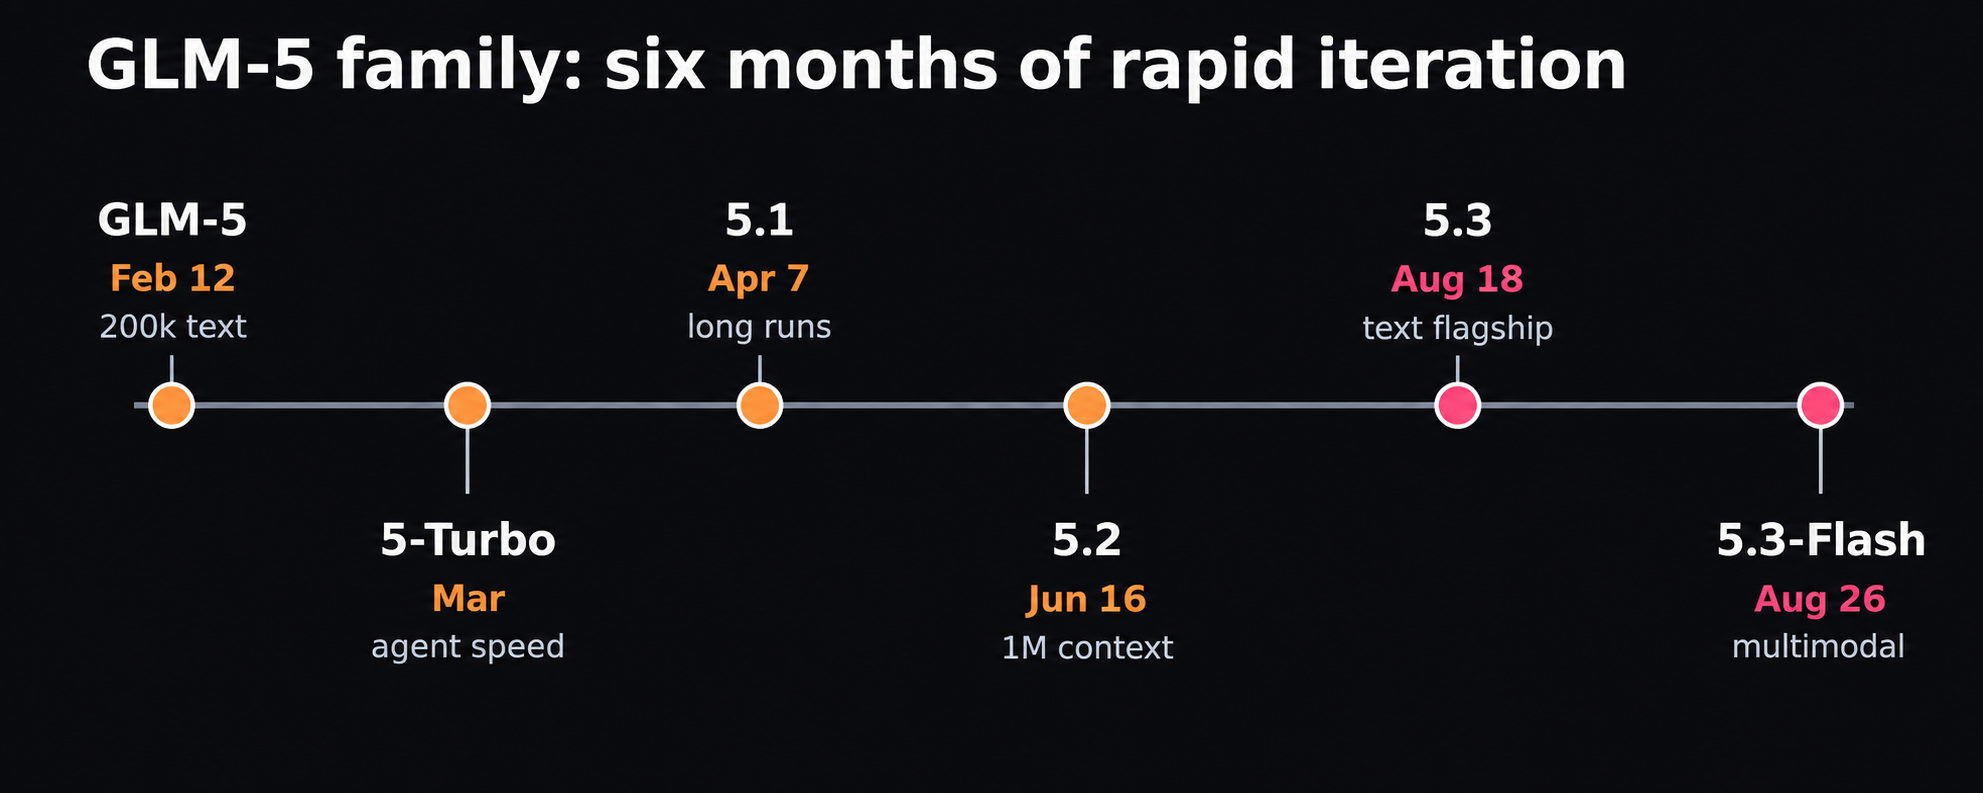
Figura 2. Sei mesi di rilasci hanno cambiato lunghezza del contesto, modalità, comportamento di reasoning e prezzo.
Da GLM-5 a GLM-5.2
L'architettura basata su agenti è stata impostata sul GLM-5 di base. GLM-5.1 si è concentrato su esecuzioni prolungate; Z.ai afferma che può funzionare fino a 8 ore, ma va preso con cautela, poiché il tuo repository potrebbe comportarsi diversamente. A GLM-5.2 sono poi state aggiunte una finestra di contesto da un milione di token, impostazioni di sforzo flessibili e IndexShare per un'attenzione efficiente su contesti lunghi.
GLM-5.3 e GLM-5.3-Flash
Il modello di punta di GLM è solo testuale: GLM-5.3. Secondo la sua documentazione, ha un limite di 1 milione di token in input, un limite di 128K in output, e livelli di sforzo di reasoning basso, alto o massimo. Il "thinking" non può essere disattivato; una richiesta 5.2 che lo disattiva esplicitamente può fallire durante la migrazione.
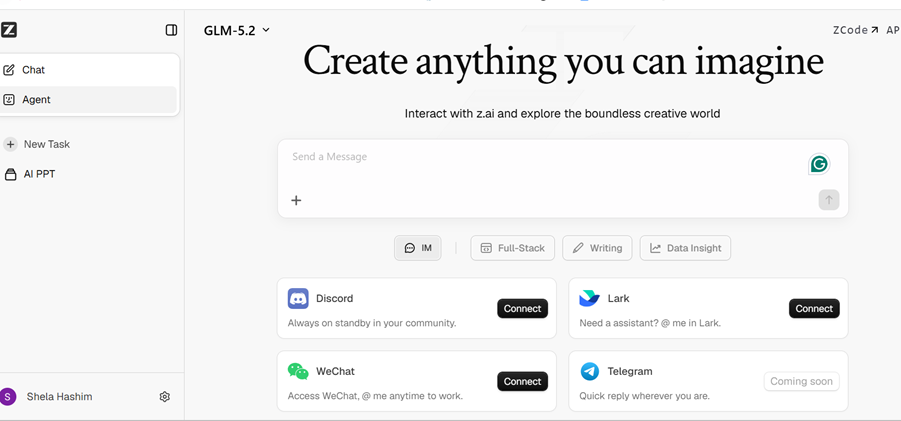
Figura 3. L'interfaccia live di GLM-5.3 confirma un accesso di punta distinto; disponibilità ed etichette possono cambiare.
GLM-5.3-Flash è un altro modello con 320B di parametri totali/18B attivi, con input multimodale nativo e attenzione ibrida sparse/lineare. La mia raccomandazione iniziale è semplice: quando la profondità conta, usa 5.3; quando si tratta di screenshot o grande volume, testa prima Flash.
Prima di modificare un'integrazione esistente, riproduci richieste salvate invece di limitarti a cambiare il nome del modello. Testa l'output strutturato, gli argomenti delle tool-call, la lunghezza massima del completamento e la gestione dei timeout. Una risposta può risultare più attraente nelle chat ma può far fallire il parser o semplicemente superare il limite di latenza della tua applicazione. Mantieni attivo il vecchio accesso finché la nuova versione non supera gli stessi controlli di produzione.
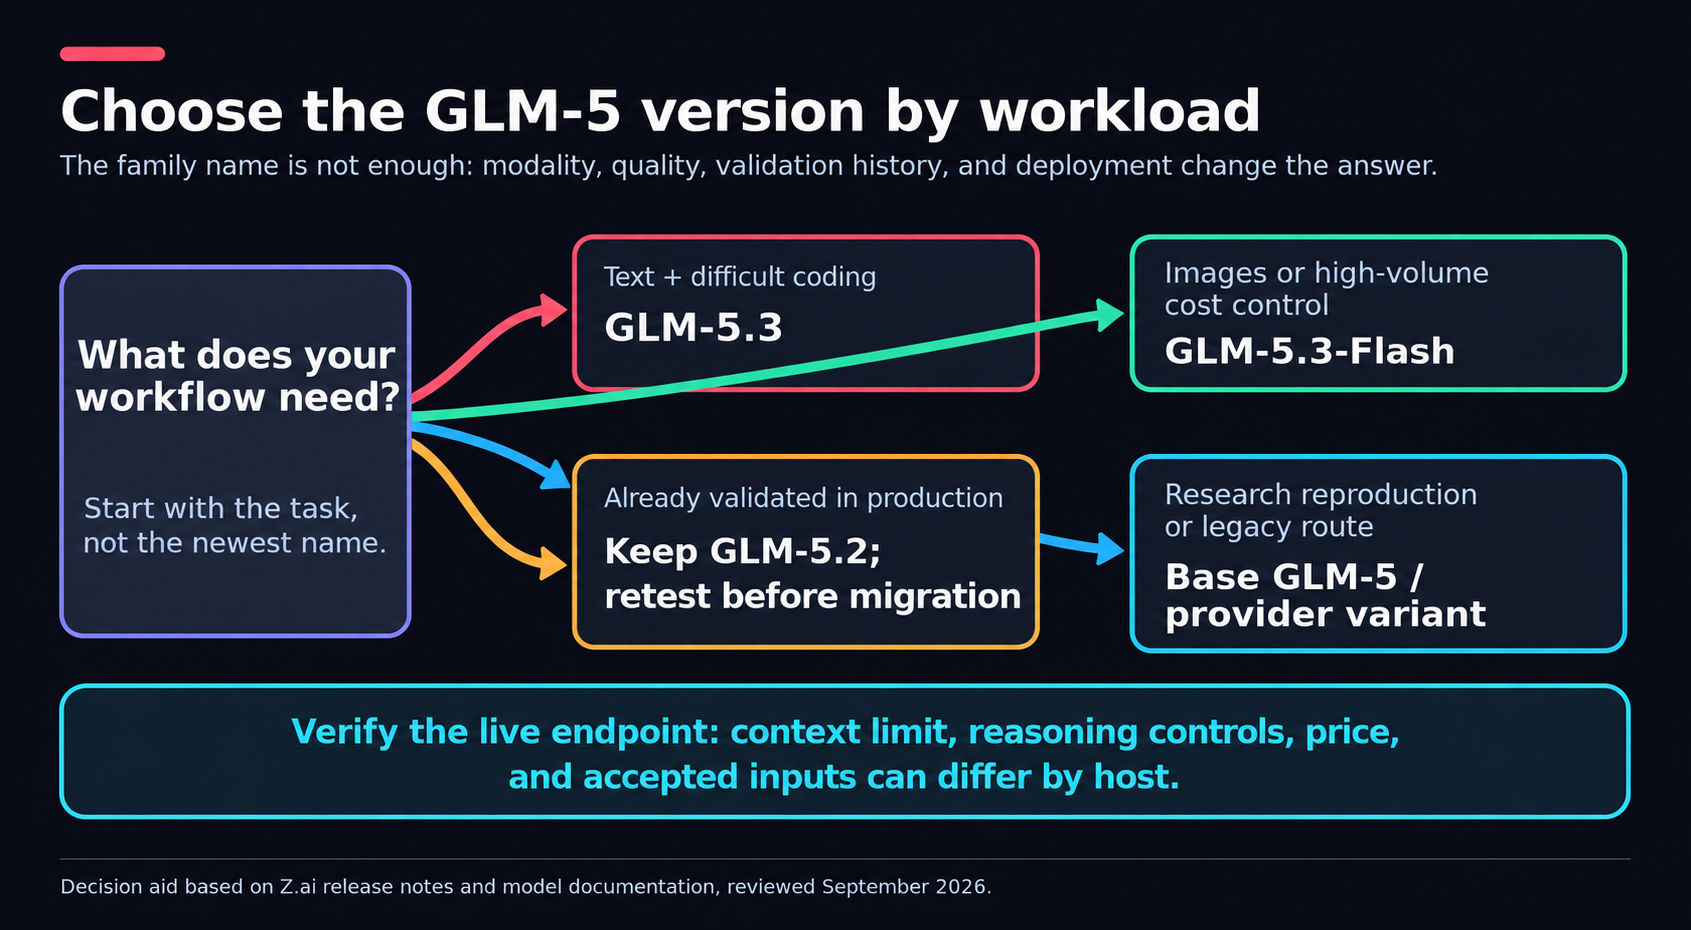
Figura 4. Scegli in base al workload e al comportamento dell'endpoint, non solo in base al nome del modello più recente.
Come si confronta GLM-5 con Claude, GPT e Gemini?
GLM-5.3 merita un posto in qualsiasi shortlist di agenti di coding, ma una singola tabella non può eleggere un vincitore assoluto. I punteggi di Terminal-Bench dipendono dal harness, dai permessi degli strumenti, dal budget di tempo e dal livello di sforzo. Z.ai riporta 88,2 su Terminal-Bench 2.1 e 28,3 su Terminal-Bench 3.0 per GLM-5.3 a sforzo massimo; la sua tabella riproduce anche i risultati di Claude Opus 4.8 e GPT-5.6 Sol.
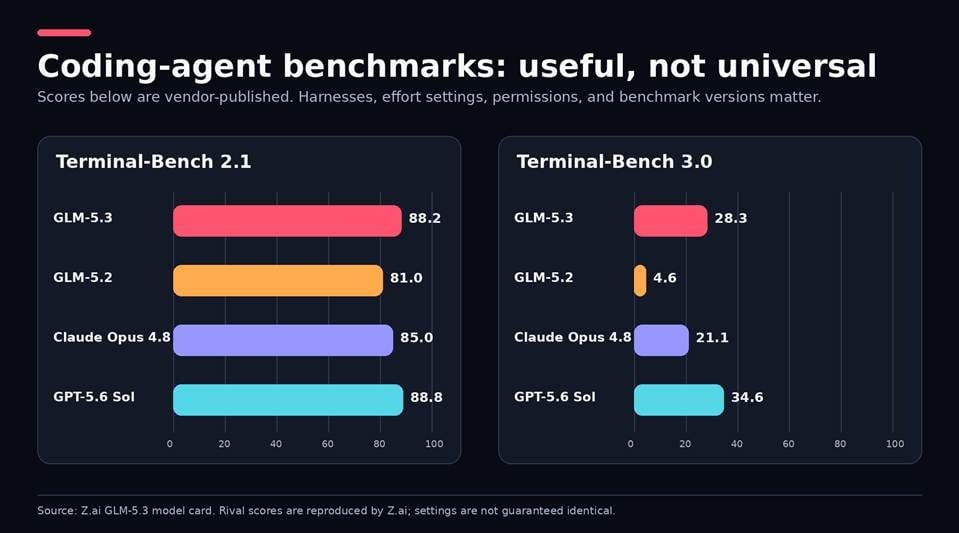
Figura 5. I punteggi pubblicati dal vendor sono prove indicative, non un sostituto di un test identico e specifico per il tuo workload.
A differenza di altri modelli, la model card di GLM-5.3 indica i nomi dei harness e le impostazioni di sforzo utilizzate. Non afferma che i modelli rivali siano stati testati in condizioni identiche. Analogamente, secondo il report GLM-5.2, questo supera Gemini 3.1 Pro su un sottoinsieme di task di Terminal-Bench 2.1, una piccola parte dei task di coding qui citati; ciò tuttavia non indica che GLM superi Gemini 3.1 Pro in tutti i task multimodali, di ricerca o di scrittura.
Valuterei i modelli con gli stessi prompt, strumenti, timeout e criteri di superamento. Da notare è il prezzo di un task riuscito, NON il prezzo del token. Un modello più economico che fallisce tre volte può risultare alla fine più costoso, e se Flash supera i tuoi test al primo tentativo, il vantaggio di un modello di punta diventa irrilevante.
La model card di GLM-5.3 è relativamente unica nel mostrare i nomi dei harness e i livelli di sforzo. Resta da dimostrare se altri modelli concorrenti siano stati testati nelle stesse condizioni. Allo stesso modo, la guida GLM-5.2 afferma di superare Gemini 3.1 Pro su Terminal-Bench 2.1 — un task orientato agli agenti di coding — non necessariamente su task multimodali, di ricerca o di scrittura.
Esaminerei i modelli usando gli stessi prompt, strumenti, timeout e criteri di superamento. Concentrandosi solo sul costo del task riuscito, NON sul prezzo del token. Se i test hanno successo al primo tentativo, Flash potrebbe essere l'opzione più conveniente, riducendo così anche il vantaggio di un modello di punta.
Dentro l'addestramento e l'architettura di GLM-5
Sparse Attention e IndexShare
Il contesto lungo è costoso perché l'attenzione tipicamente considera moltissime relazioni tra token. In GLM-5.2 è stato introdotto un indexer riutilizzato su quattro diversi livelli di attenzione per individuare le posizioni corrette. Z.ai dichiara di ottenere 2,9 volte meno FLOPs per token a 1M di token. È un'affermazione di efficienza dello sviluppatore, non una dichiarazione sulla latenza dell'endpoint o sul costo reale delle richieste.
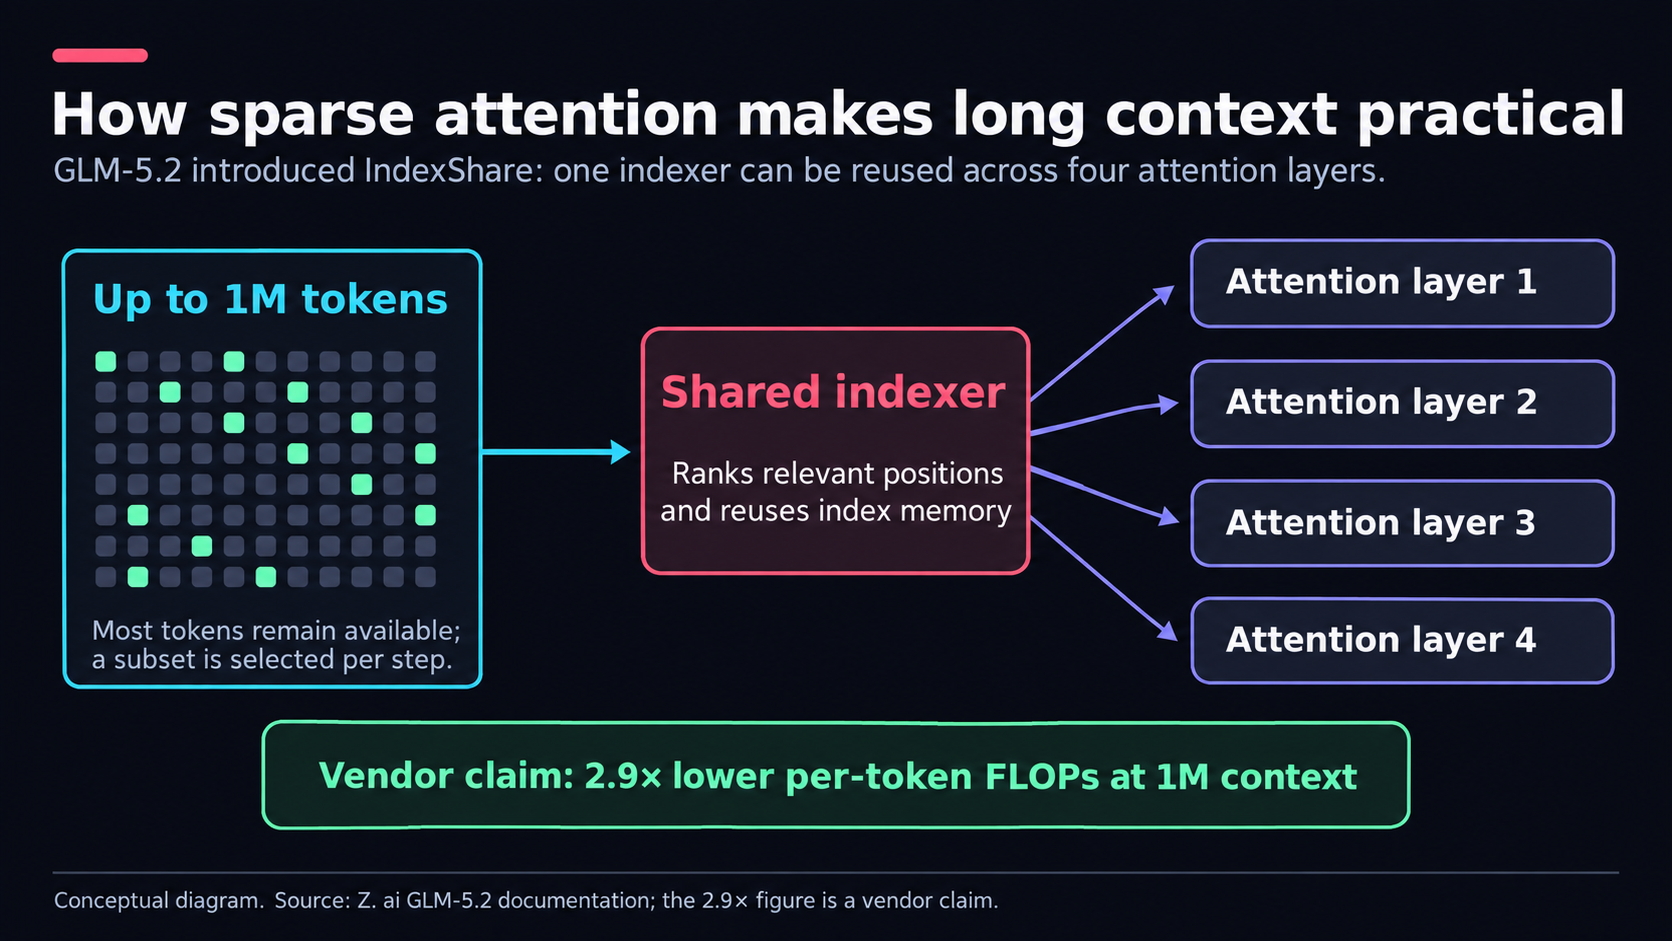
Figura 6. IndexShare riutilizza un indexer su quattro livelli di attenzione; la cifra 2,9x è un'affermazione di Z.ai.
Reinforcement Learning a lungo orizzonte
Per GLM-5.3, Z.ai introduce la propria visione di un sistema di reinforcement learning asincrono chiamato "slime", insieme a context compaction e verificatori sintetizzati. Queste tecniche si concentrano sugli errori tipici osservati negli agenti durante esecuzioni lunghe: perdere l'obiettivo, abbandonare un task, o non verificare la risposta. Anche così, restano necessari checkpoint e test esterni, il che può comportare traiettorie più lunghe e trace di errore più ampie.
Le capacità di cybersecurity richiedono validazione umana
Nell'ambito della sua collaborazione sulla sicurezza, Z.ai rivela 2.436 vulnerabilità in 269 progetti open source, di cui 1.097 di gravità medio-alta. Questi numeri sono probabilmente pertinenti per GLM-5.3 nella revisione defensiva, ma GLM-5.3 non identifica una vulnerabilità confermata, solo un model finding.
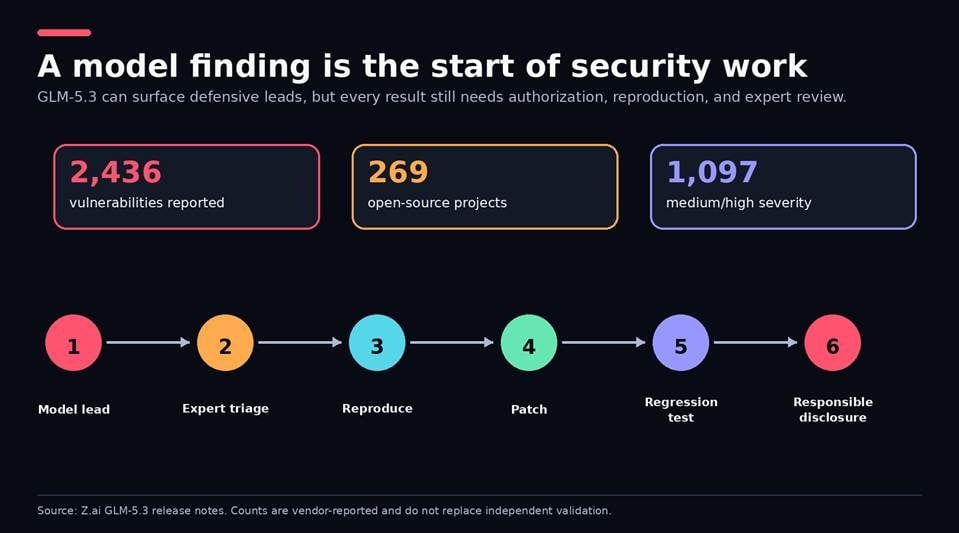
Figura 7. Riproduci, correggi, esegui test di regressione e divulga responsabilmente; non puntare mai un agente contro sistemi che non sei autorizzato a testare.
Prezzi di GLM-5
Z.ai separa i costi di input non cached, input cached e output a partire da settembre 2026. Ho verificato questi prezzi confrontandoli con la pagina prezzi ufficiale; non darli per scontati quando pianifichi un budget, poiché possono variare nel tempo.
| Modello | Input / 1M | Input cached / 1M | Output / 1M |
|---|---|---|---|
| GLM-5 | $1,00 | $0,20 | $3,20 |
| GLM-5.1 | $1,40 | $0,26 | $4,40 |
| GLM-5.2 | $1,40 | $0,26 | $4,40 |
| GLM-5.3 | $1,40 | $0,26 | $4,40 |
| GLM-5.3-Flash | $0,15 | $0,03 | $0,50 |
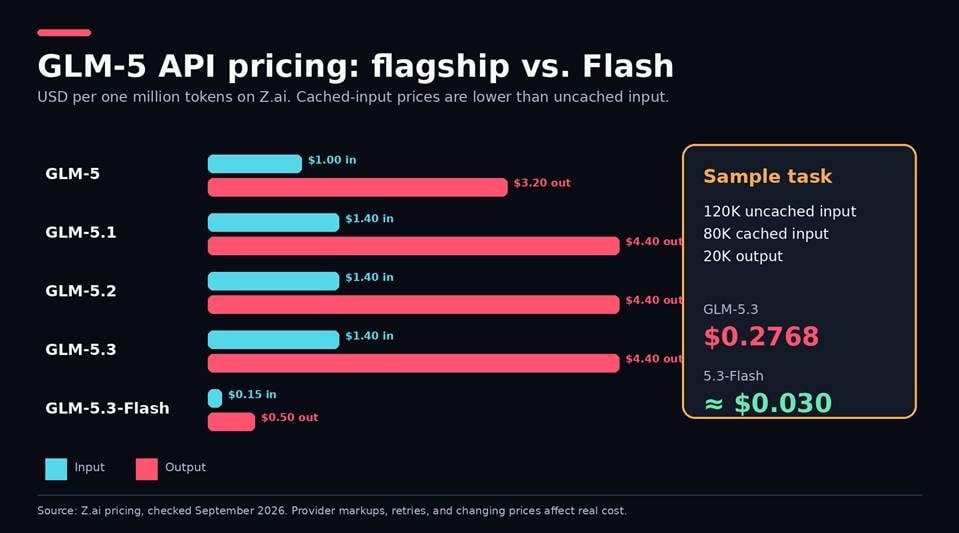
Figura 8. I prezzi API di Z.ai mostrano perché la lunghezza dell'output e i tentativi ripetuti possono dominare il conto finale.
Il costo di GLM-5.3 è di circa $0,2768 per 120K di input non cached, 80K di input cached e 20K di output; per 5.3-Flash è di circa $0,030 (escludendo i tentativi ripetuti). Altri host come OpenRouter possono offrire prezzi, limiti, latenza e routing diversi. Il GLM Coding Plan non è una quota API di produzione, ma un abbonamento separato per strumenti di coding supportati.
L'output è l'aspetto costoso della richiesta, e un agente che ragiona per molto tempo può superare facilmente una stima rapida. Imposterei un tetto massimo per l'output, userei il caching dove il contesto ripetuto lo permette, e registrerei il costo per ogni task completato. Nella definizione di un budget di produzione, considera i tentativi ripetuti, le tool-call fallite e il tempo umano necessario per correggere risposte scarse. Questo è il numero che dovresti confrontare tra provider diversi.
Come usare GLM-5
| Accesso | Ideale per | Dove avviene l'inferenza |
|---|---|---|
| Z.ai Chat | Valutazione qualitativa rapida | Server di Z.ai |
| API Z.ai | Integrazione first-party | Server di Z.ai |
| OpenRouter | Scelta del provider e failover | Provider ospitato selezionato |
| Enter MaaS | Accesso al modello all'interno di un workflow di app building | Accesso ospitato visibile in Enter |
| Hugging Face + vLLM/SGLang | Deployment autogestito | La tua infrastruttura |
| Ollama :cloud | Accesso remoto tramite client Ollama | Server remoti, non il tuo laptop |
Inizia con Z.ai Chat
L'accesso più semplice a GLM-5 in chat è chat.z.ai. Usalo per testare il comportamento dei prompt e la struttura dell'output, ma presta attenzione al modello esatto mostrato nell'interfaccia. Non promettere a un team un uso "gratuito" o "illimitato" senza verificare la quota attuale dell'account.
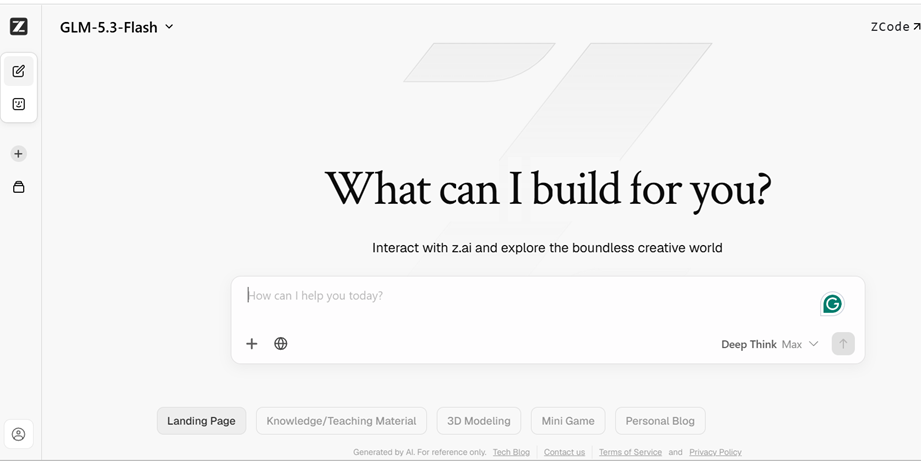
Figura 9. L'interfaccia chat offre una verifica qualitativa rapida, ma il modello mostrato e la quota dell'account restano importanti.
Chiama l'API Z.ai o OpenRouter
Z.ai offre un endpoint compatibile con OpenAI, il che significa che l'SDK Python ufficiale può essere usato con una base URL diversa. Memorizza la chiave API in una variabile d'ambiente e registra l'ID del modello, lo sforzo, il numero di token usati e se la richiesta è andata a buon fine.
Figura 10. L'endpoint compatibile con OpenAI di Z.ai riduce le modifiche all'SDK; non elimina i test di migrazione.
import os

from openai import OpenAI

client = OpenAI(

        api_key=os.environ["ZAI_API_KEY"],

        base_url="https://api.z.ai/api/paas/v4/",

)

response = client.chat.completions.create(

        model="glm-5.3",

        messages=[{"role": "user", "content": "List five tests for a password-reset flow."}],

        max_tokens=4096,

        extra_body={"thinking": {"type": "enabled"}, "reasoning_effort": "high"},

)

print(response.choices[0].message.content)
Quando migri dalla 5.2, rimuovi qualsiasi richiesta che disattivi esplicitamente il "thinking"; GLM-5.3 non accetta questo comportamento. Se usi l'accesso GLM-5.3 tramite OpenRouter, registra quale provider ha gestito la richiesta quando governance o riproducibilità sono importanti.
Scarica e auto-ospita i pesi
Usa il repository ufficiale o la model card GLM-5.3 verificata su Hugging Face. Z.ai elenca SGLang, vLLM, Transformers, KTransformers e Unsloth tra i percorsi supportati.
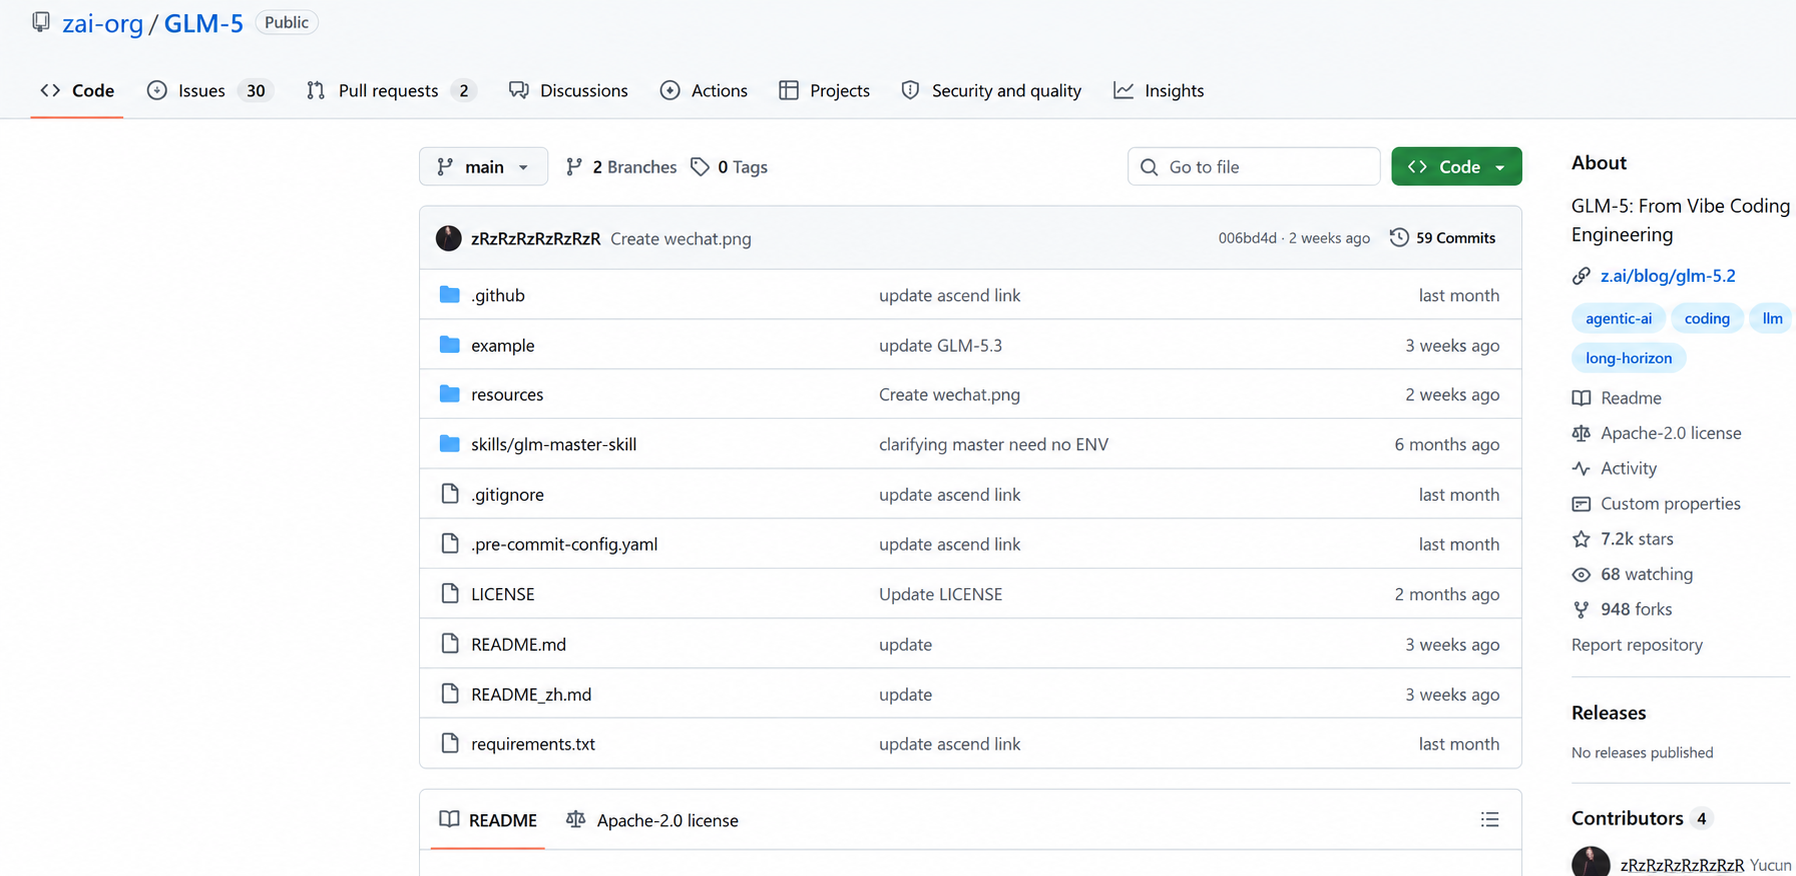
Figura 11. Usa il repository verificato e la model card ufficiale, non un mirror non ufficiale dei pesi.
Scaricabile NON equivale a eseguibile. La quantizzazione riduce i requisiti di memoria, ma può alterare la qualità; con un checkpoint da 744B sono necessari storage e accelerator di livello server. Leggi attentamente la scheda GLM-5 su Ollama: un tag con "cloud" significa che si tratta di inferenza remota. Per un'esecuzione locale vera servono pesi locali, runtime locale e hardware sufficiente.
Come valuterei GLM-5 prima della produzione
Non partirei con una domanda generica tipo "Quale modello è più intelligente?". Eseguirei quattro task rappresentativi su 5.2, 5.3 e Flash usando gli stessi strumenti e limiti: risolvere un bug in un repository, recuperare fatti inseriti in un documento lungo, completare un workflow multi-strumento con un fallimento indotto, e produrre un output valutato rispetto a una rubrica scritta.
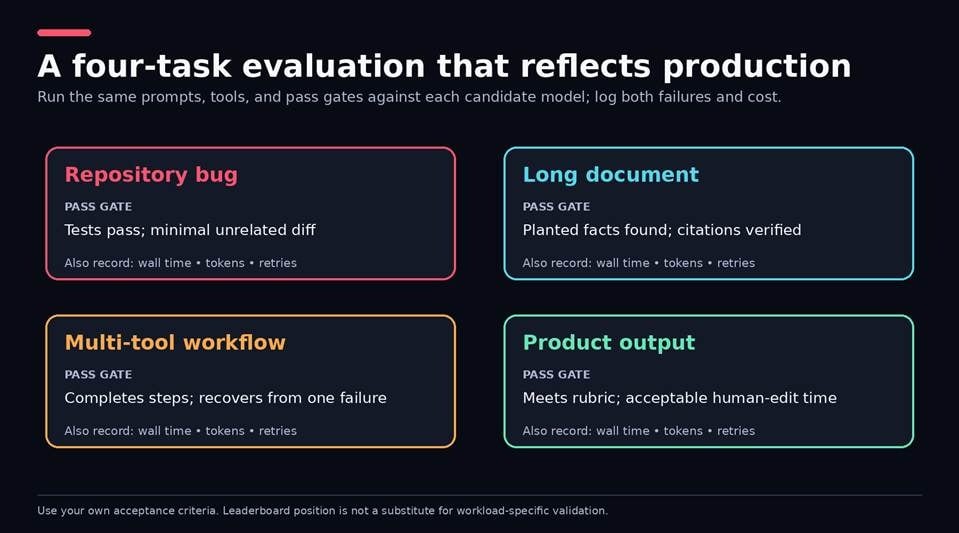
Figura 12. Un test di workload piccolo e ripetibile è più utile di una domanda generica sul "modello più intelligente".
Successo/fallimento, wall time, token, tentativi ripetuti, tempo di modifica umana e provider. Questo permette di rilevare rischi di migrazione che le medie dei benchmark non mostrano — come il reasoning sempre attivo di 5.3 e l'output potenzialmente lungo. Indica anche se il prezzo più basso di Flash sopravvive al contatto con i tuoi test di accettazione.
Chi dovrebbe usare GLM-5?
Coding agentico e lavoro sui repository
GLM-5 è un'ottima opzione se un task comporta la ricerca in un repository, modifiche coordinate, esecuzione di test e tool call. Le evidenze pubbliche dei benchmark supportano questa scelta, ma il tuo gate di accettazione dovrebbe essere solido: i test devono passare, il diff deve essere mirato, e nessun confine di credential o di rete deve essere violato. Fornisci un'area di lavoro separata e applica il principio del minimo privilegio. Più autonomia senza controlli produce solo trace di errore più ampie.
Documenti lunghi e knowledge work
I modelli da un milione di token sono adatti a specifiche, pacchetti di ricerca e grandi codebase. Una finestra di contesto ampia non dovrebbe essere considerata un recupero affidabile. Posiziona le informazioni chiave all'inizio, al centro e alla fine; cita le fonti; verifica le informazioni citate. Considererei anche una pipeline di recupero, poiché inserire tutto in un unico grande prompt può essere più lento e costoso rispetto a selezionare prima le evidenze utili.
Workflow multimodali e di difesa
Con GLM-5.3-Flash o GLM-5V-Turbo, screenshot, stati dell'interfaccia o altri input visivi richiesti dal task fanno parte del lavoro quotidiano. Usa tutti i risultati come indizi per la revisione di sicurezza defensiva, riproducendoli e assegnando loro una priorità. GLM-5 è meno adatto a chi desidera un piccolo modello locale da laptop, non può prendere decisioni di deployment, o non è in grado di verificare la residenza dell'host e i termini di conservazione.
GLM-5 è sicuro per dati privati o aziendali?
Accessi ospitati
Non dipende solo dal modello, ma dall'accesso usato. Esistono diversi percorsi dei dati: Z.ai Chat, l'API Z.ai, un altro host, o un deployment autogestito. Inizia con la privacy policy di Z.ai, poi verifica con tutti gli intermediari conservazione, uso per l'addestramento, cancellazione, residenza dei dati e termini contrattuali.
Fissa un provider specifico se un aggregatore lo offre, e non inviare segreti solo per comodità. Ciò che accade ai dati ospitati è determinato dal tuo contratto e dalla tua configurazione, non dall'espressione "pesi aperti".
Self-hosting
Il self-hosting mantiene i prompt nel tuo ambiente, ma sei responsabile di pesi, credential, patching, controlli di rete e monitoraggio. Continuerei comunque a presumere che esista un modo per iniettare codice generato in modo non sicuro nelle fasi iniziali. Separa le credential di build e produzione, limita l'accesso di rete in uscita, effettua audit delle azioni degli strumenti e mantieni approvazioni umane per i cambiamenti rilevanti. Non concedere agli agenti più autorità di quanto necessario per il task.
Come usare GLM-5 con Enter Pro
GLM-5 non è un concorrente diretto di Enter Pro. GLM fornisce capacità del modello, mentre Enter Pro fornisce un workflow di costruzione del prodotto attorno ai modelli. Questo è utile quando non cerchi semplicemente "ottenere un completamento", ma "ottenere un completamento che possa essere trasformato in un'interfaccia, una logica e un percorso di pubblicazione".
Se è richiesto il controllo API, un'infrastruttura personalizzata o una struttura dati specifica, l'accesso diretto è l'opzione migliore. Quando l'escamotage a livello di prodotto diventa un fattore limitante, entra in gioco Enter Pro. Il suo AI MVP Builder semplifica pianificazione, creazione dell'app, editing visivo e pubblicazione in un unico processo, mentre Enter Code offre un approccio incentrato sul terminale per i task sui repository.
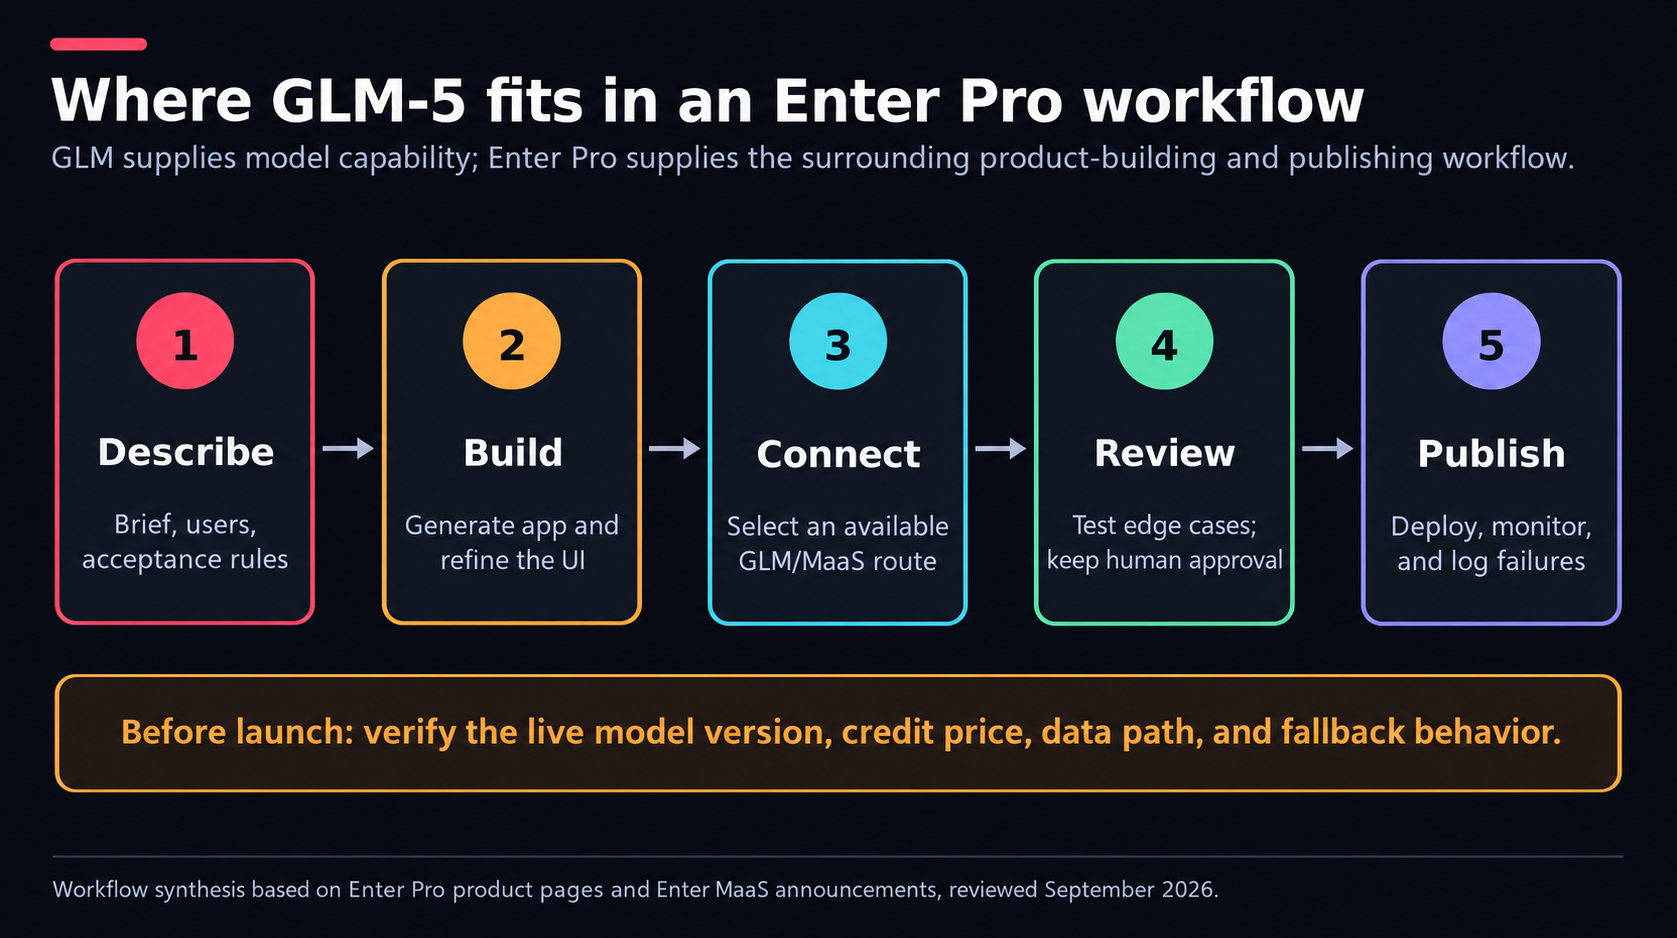
Figura 13. Il modello genera o classifica; il workflow di prodotto aggiunge UI, revisione, deployment e monitoraggio.
Il changelog di Enter confirma GLM-5.2 nel precedente catalogo AI All il 17 giugno. L'annuncio di Enter MaaS menziona GLM 5 e spiega come i modelli vengano tariffati in crediti. Non confirma esplicitamente GLM-5.3, quindi assicurati di controllare il selettore di modelli live, il prezzo in crediti, il limite di contesto e il percorso dei dati prima di progettare attorno a una versione specifica.
Un'app di triage del supporto indica bene dove questa combinazione ha senso. Con Enter Pro puoi progettare il form dei ticket e la dashboard, e collegare un accesso GLM esistente per categorizzare i ticket e comporre risposte. Prima della pubblicazione, valida risposte vuote del modello, richieste ambigue, input multilingue, prompt injection e dati privati nel corpo del messaggio. Mantieni sempre una persona tra la bozza e il tasto invio.
| Se la tua priorità è… | Scegli un accesso GLM diretto | Scegli Enter Pro |
|---|---|---|
| Parametri del modello e controllo del provider | Sì | Solo entro le opzioni esposte |
| Creazione ed editing visivo dell'app | Costruire o aggiungere tooling separato | Vantaggio centrale del workflow |
| Hosting personalizzato e policy di rete | Adattamento più forte | Verifica prima l'idoneità della piattaforma |
| Percorso rapido dall'output del modello alla UI del prodotto | Richiede più engineering | Adattamento più forte |
Ma Enter non rende GLM più intelligente, e il fatto che GLM abbia accesso a un'app non rende più intelligente nemmeno il suo agente di coding. Se si tratta di integrazione o lavoro sull'UI, opterei per Enter. Se ti trovi in questa situazione, apri lo spazio di lavoro Enter Pro e controlla il catalogo di modelli disponibile prima di impegnarti su un'architettura.
Conclusione
Anche se si chiama GLM-5, la variante e il metodo di erogazione contano tanto quanto il modello stesso quando si tratta di coding e agenti a lungo orizzonte! Usa GLM-5.3 per testo e codice difficili, GLM-5.3-Flash per multimodalità e/o volume, e mantieni 5.2 finché la migrazione non diventa conveniente dal punto di vista dei costi. Poi testa sui tuoi task prima di usare i numeri del leader/vendor come prova di produzione.
Quello che funziona davvero è il modello che soddisfa i tuoi criteri di accettazione, rimane entro i tuoi margini di latenza e privacy, e mantiene il prezzo giusto anche dopo i tentativi ripetuti — indipendentemente dal punteggio quasi perfetto che potrebbe ottenere su quel singolo benchmark.
Inizia a costruire con Enter Pro →
FAQ
GLM-5 è gratuito?
I pesi pubblici sono disponibili per il download, senza costi API per token, ma hardware e operatività restano a pagamento. Z.ai Chat può offrire accesso basato su quota. Le API ospitate, i router e i server GPU sono servizi a pagamento, e possono esserci differenze in base alla versione e all'accesso.
Quale versione di GLM-5 è migliore?
Per testo/codice impegnativo, inizio con GLM-5.3. GLM-5.3-Flash è il test iniziale migliore per immagini, screenshot o volumi sensibili ai costi. Non cambiare GLM-5.2 se è già validato e il rischio di migrazione supera il beneficio potenziale.
GLM-5 è in grado di scrivere e debuggare codice?
Sì. Gli agenti di coding e l'engineering a livello di repository sono casi d'uso chiave, con buoni risultati riportati dai vendor su Terminal-Bench e DeepSWE. Restano comunque necessari sandbox, test, permessi limitati e revisione umana.
Quanto costa l'API di GLM-5?
A settembre 2026, Z.ai elenca GLM-5 a $1,00 di input e $3,20 di output per milione di token; GLM-5.3 a $1,40 e $4,40; e 5.3-Flash a $0,15 e $0,50. L'input cached è più economico. Il costo reale è influenzato dai markup dei provider e dai tentativi ripetuti.
GLM-5 è software open source?
"Pesi aperti" è più corretto. La licenza dei pesi, la licenza del codice del repository e la trasparenza dei dati di addestramento sono questioni distinte. Prima di un deployment commerciale, controlla la specifica model card su Hugging Face e la licenza del repository.
GLM-5 può essere usato localmente (con Ollama)?
Solo se hai pesi locali, supporto runtime e hardware sufficiente per questo. Il tag cloud indica esecuzione su infrastruttura remota, quindi non implica necessariamente che l'intero modello da 744B sia in esecuzione sul tuo dispositivo.
GLM-5 è capace di elaborare immagini?
Il GLM-5 base e GLM-5.3 sono solo testuali. Per input multimodali, usa GLM-5.3-Flash o GLM-5V-Turbo; verifica i tipi di file accettati sull'endpoint scelto.





