
GPT-5.2 spiegato: funzionalità, benchmark, prezzi e casi d'uso
Scopri GPT-5.2 Instant, Thinking, Pro e Codex: prezzi, benchmark, accesso, limiti e confronto con Gemini 3 per gli sviluppatori nel 2026.
Figura 1. GPT-5.2 valutato in base a qualità, velocità, costo e controllo
Ho scelto GPT‑5.2 Pro in Enter Pro per creare un revisore di brief di progetto che trasforma le idee di app in requisiti e criteri di accettazione. Le schermate mostrano la configurazione e l'output della revisione; la verifica di una richiesta completata resta un passaggio ancora aperto.
Questo caso pratico fornisce a questa guida un riferimento concreto. Separo i risultati ufficiali dei benchmark da ciò che l'applicazione ha effettivamente mostrato, poi esamino le capacità, i prezzi e i limiti della famiglia di modelli. Dovresti identificare la variante esatta prima di applicare un'osservazione a Instant, Thinking, Pro o Codex.
OpenAI ha presentato la famiglia l'11 dicembre 2025 come release pensata per il lavoro professionale e gli agenti a lungo termine. Il suo report di lancio fornisce la baseline ufficiale di benchmark e prezzi. Utilizzo questo report insieme a informazioni di routing attuali, critiche indipendenti rilevanti e segnalazioni della community, perché nessuna fonte singola copre sia le prestazioni controllate che l'attrito quotidiano.
Chi cerca Chat GPT 5.2 intende spesso l'intera famiglia di dicembre 2025, ma la distinzione tra le modalità di ChatGPT e gli ID dei modelli API conta. Un test su Instant non stabilisce il comportamento, il prezzo o la latenza di Thinking, Pro o del modello specializzato nel codice.
GPT-5.2 in sintesi
Al 9 ottobre 2026, OpenAI elenca GPT‑5.2 e GPT‑5.2 Pro come opzioni della generazione precedente. I progetti esistenti possono apprezzare il loro comportamento noto e gli snapshot fissati, mentre un nuovo progetto dovrebbe confrontare i modelli attualmente consigliati con gli stessi criteri di accettazione.
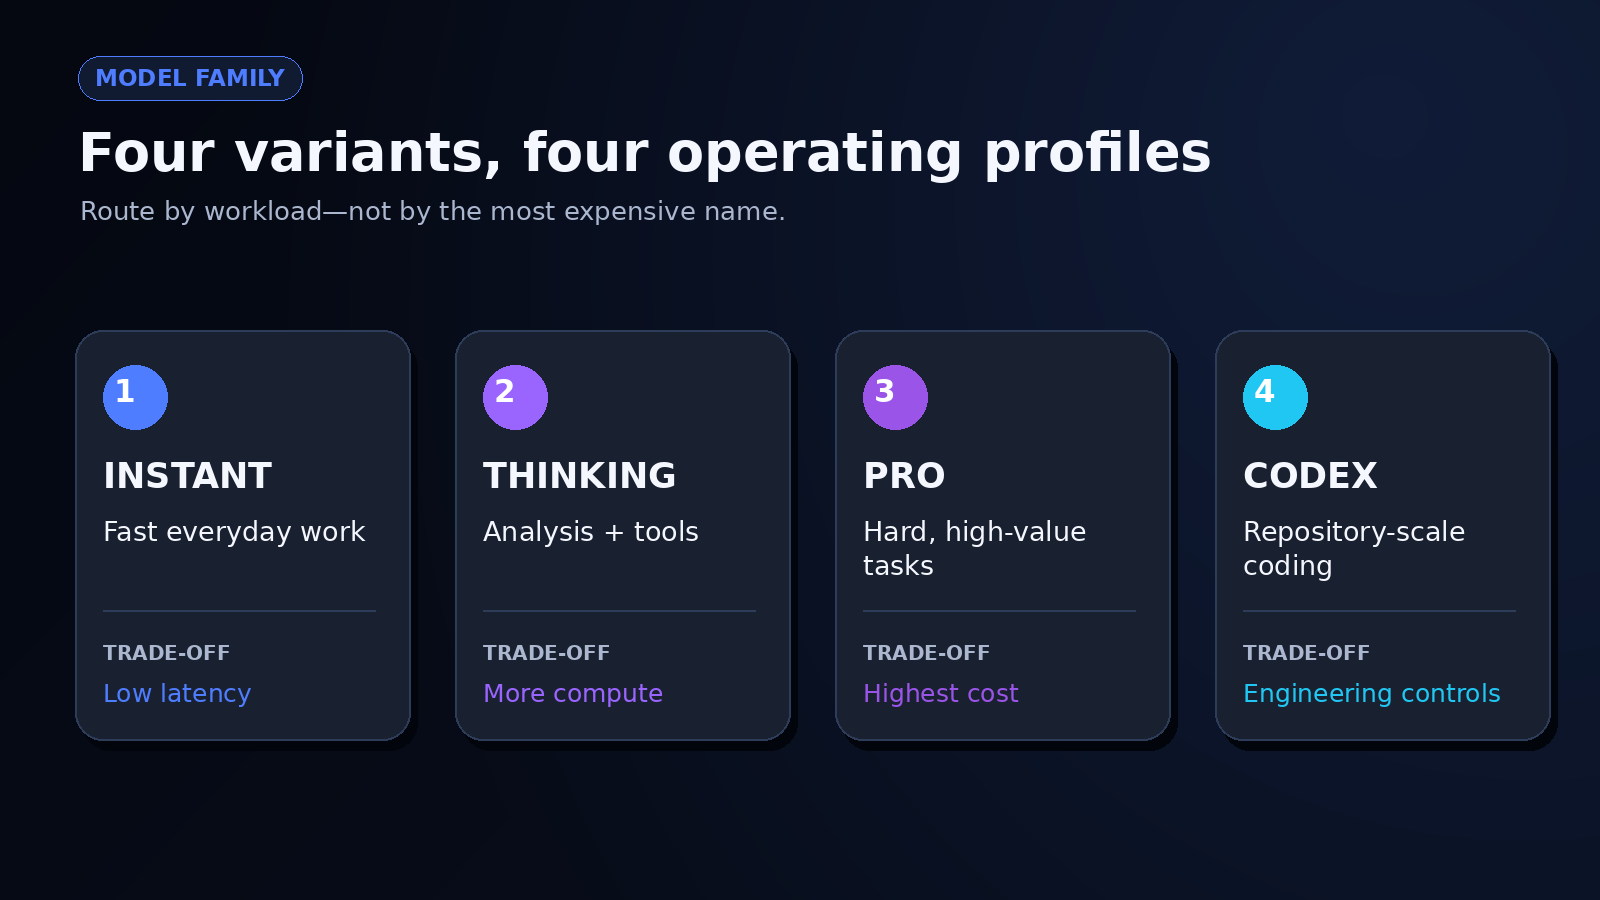
Figura 2. Instant, Thinking, Pro e Codex mappati sui tipi di carico di lavoro
| Specifica | GPT-5.2 | GPT-5.2 Pro |
|---|---|---|
| Posizione attuale | Precedente modello di punta | Precedente modello Pro |
| Finestra di contesto | 400.000 token | 400.000 token |
| Output massimo | 128.000 token | 128.000 token |
| Data di cutoff delle conoscenze | 31 agosto 2025 | 31 agosto 2025 |
| Modalità | Testo input/output; input immagine | Testo input/output; input immagine |
| Sforzo di ragionamento | nessuno, basso, medio, alto, molto alto | medio, alto, molto alto |
| Prezzo API per 1M token | $1,75 input; $0,175 cache; $14 output | $21 input; $168 output |
| Output strutturati | Supportati | Non supportati |
| Fine-tuning | Non supportato | Non supportato |
| Snapshot | gpt-5.2-2025-12-11 | gpt-5.2-pro-2025-12-11 |
Stato attuale, contesto e modalità
La finestra di contesto da 400.000 token e il limite di output da 128.000 token sono insolitamente ampi, ma la capacità non equivale al richiamo. Se inserisci contratti, log, screenshot e requisiti in un'unica richiesta, hai comunque bisogno di un test di recupero: inserisci fatti in posizioni diverse, fai domande che richiedono di combinarli e registra ciò che il modello non cattura. Non dedurrei un ragionamento affidabile su documenti lunghi dal solo numero di contesto.
I modelli accettano immagini e produco testo; non accettano audio o video come input nativi. Questo li rende utili per grafici, screenshot di interfacce, diagrammi e documenti scansionati, a condizione di verificare dettagli spaziali e valori estratti. Un'etichetta sfocata o una scala di grafico inusuale può trasformare una spiegazione apparentemente sicura in un errore plausibile.
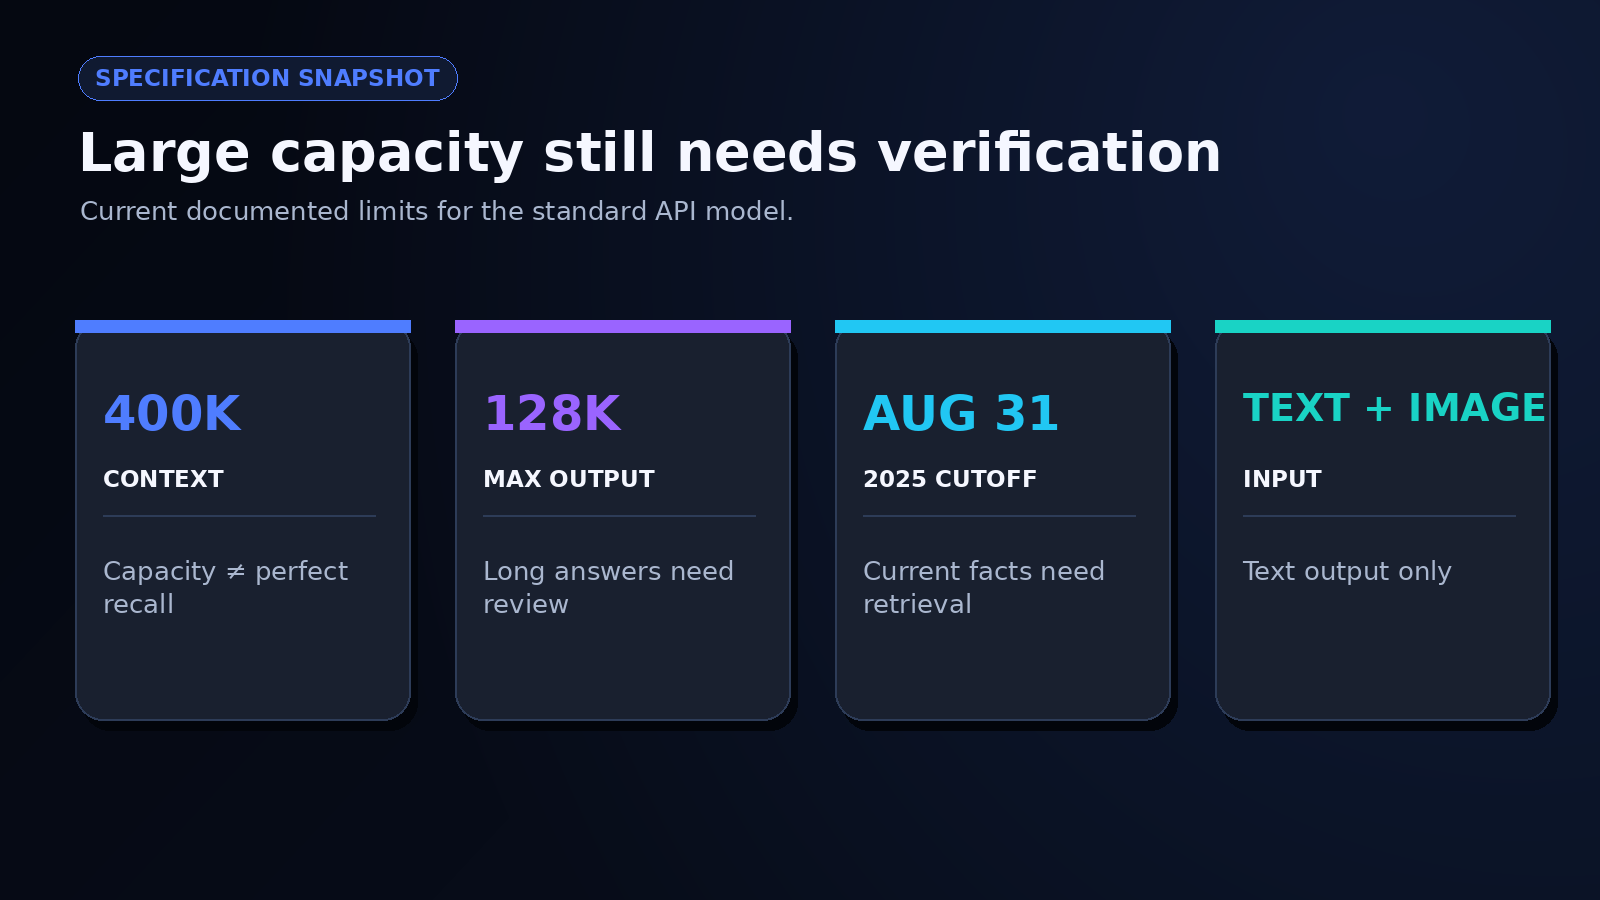
Figura 3. contesto, output, modalità, cutoff e snapshot
Prezzi e accesso all'API
Il modello API standard costa $1,75 per milione di token di input, $0,175 per milione di token di input in cache, e $14 per milione di token di output. GPT 5.2 Pro costa $21 di input e $168 di output. I token di ragionamento, i tentativi ripetuti, le chiamate agli strumenti e le correzioni umane influiscono sul costo di un risultato accettato. Quando usi una piattaforma di integrazione, verifica separatamente le sue unità di fatturazione prima di confrontarle con le tariffe in dollari di OpenAI.
Puoi vedere il routing dei provider e la disponibilità attuale sulla pagina GPT‑5.2 di OpenRouter. Calcolerei il costo per attività completata, non il costo per richiesta. Una risposta più economica che fallisce la validazione due volte può costare più di una risposta più costosa che passa al primo tentativo.
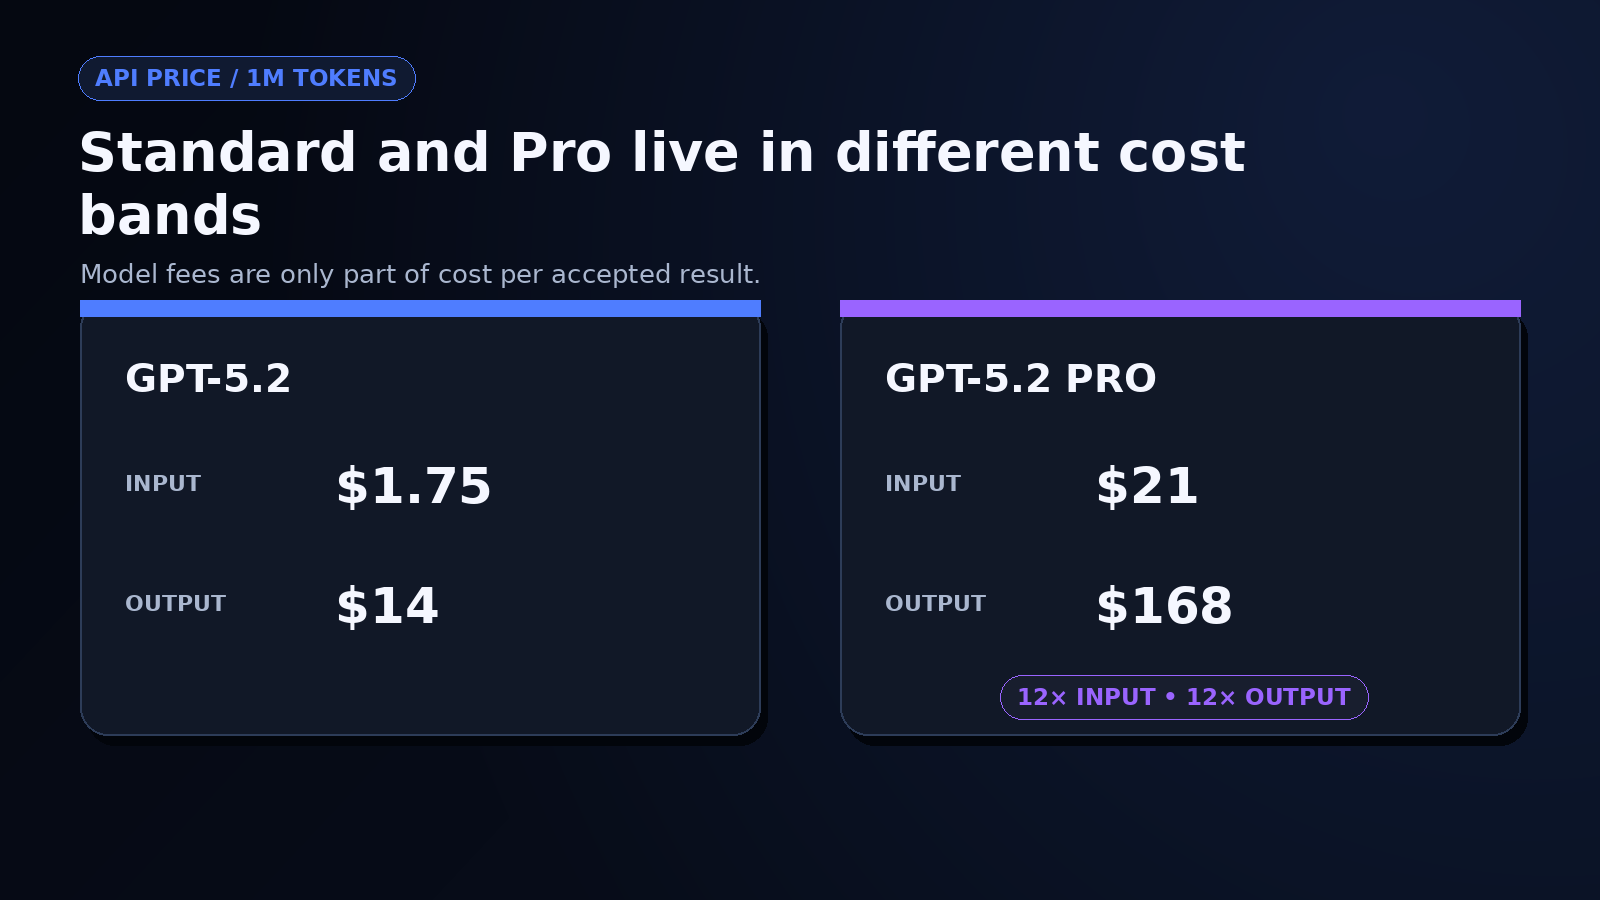
Figura 4. costo standard rispetto a Pro per milione di token
Cosa è cambiato nel lancio di GPT-5.2 di OpenAI?
Il lancio di GPT-5.2 di OpenAI era mirato a lavori che continuano oltre una singola risposta: costruire artefatti, analizzare documenti lunghi, usare strumenti, scrivere e revisionare codice, ragionare su immagini e completare attività professionali multi-step. Ha anche separato chat rapida, ragionamento più profondo e lavoro ad alto calcolo in modo più netto di quanto suggerisca un'unica etichetta di modello.
Instant, Thinking e Pro puntano a carichi di lavoro diversi
Instant privilegiava domande quotidiane, spiegazioni, traduzioni e bozze rapide. Thinking puntava ad analisi, programmazione, file, pianificazione e uso di strumenti. Pro impiegava più calcolo su problemi difficili dove un'attesa più lunga e una bolletta API molto più alta potevano essere giustificate.
| Modalità o modello | Adattamento pratico | Compromesso principale |
|---|---|---|
| Instant | Domande di routine e lavoro sensibile alla latenza | Meno elaborazione su attività difficili multi-step |
| Thinking | Analisi, programmazione, file lunghi e flussi guidati da strumenti | Maggiore latenza e uso di token |
| Pro | Attività difficili dove la qualità incrementale ha alto valore | Costo molto elevato; le risposte possono richiedere minuti |
Instraderei in base al rischio, non al prestigio. Un passaggio di classificazione può richiedere un modello rapido con uno schema rigido. Una revisione di modello finanziario può giustificare un ragionamento più profondo. Se invii ogni richiesta a Pro, nascondi quali attività beneficiano davvero del calcolo extra e rendi il controllo dei costi molto più difficile.
Il lavoro professionale e l'uso degli strumenti sono stati centrali nel lancio
OpenAI ha enfatizzato foglio di calcolo, presentazioni, lavoro front-end, revisione del codice, analisi documentale, scienza, matematica e chiamate a strumenti. In una valutazione condotta dal fornitore su query ChatGPT deidentificate, gli errori a livello di risposta sono stati riportati come relativamente 30% meno frequenti rispetto a GPT‑5.1 Thinking. Il report di lancio nota anche che la valutazione degli errori è stata eseguita dai modelli stessi, quindi leggo questo numero come prova direzionale, non come garanzia indipendente.
Il miglioramento pratico non è "il modello sa tutto". È una maggiore probabilità che un'attività ben specificata sopravviva a più passaggi senza perdere la sua struttura. Hai comunque bisogno di checkpoint osservabili: quale strumento è stato eseguito, quali dati ha ricevuto, cosa ha modificato e come il flusso di lavoro si è ripreso dopo una chiamata fallita.
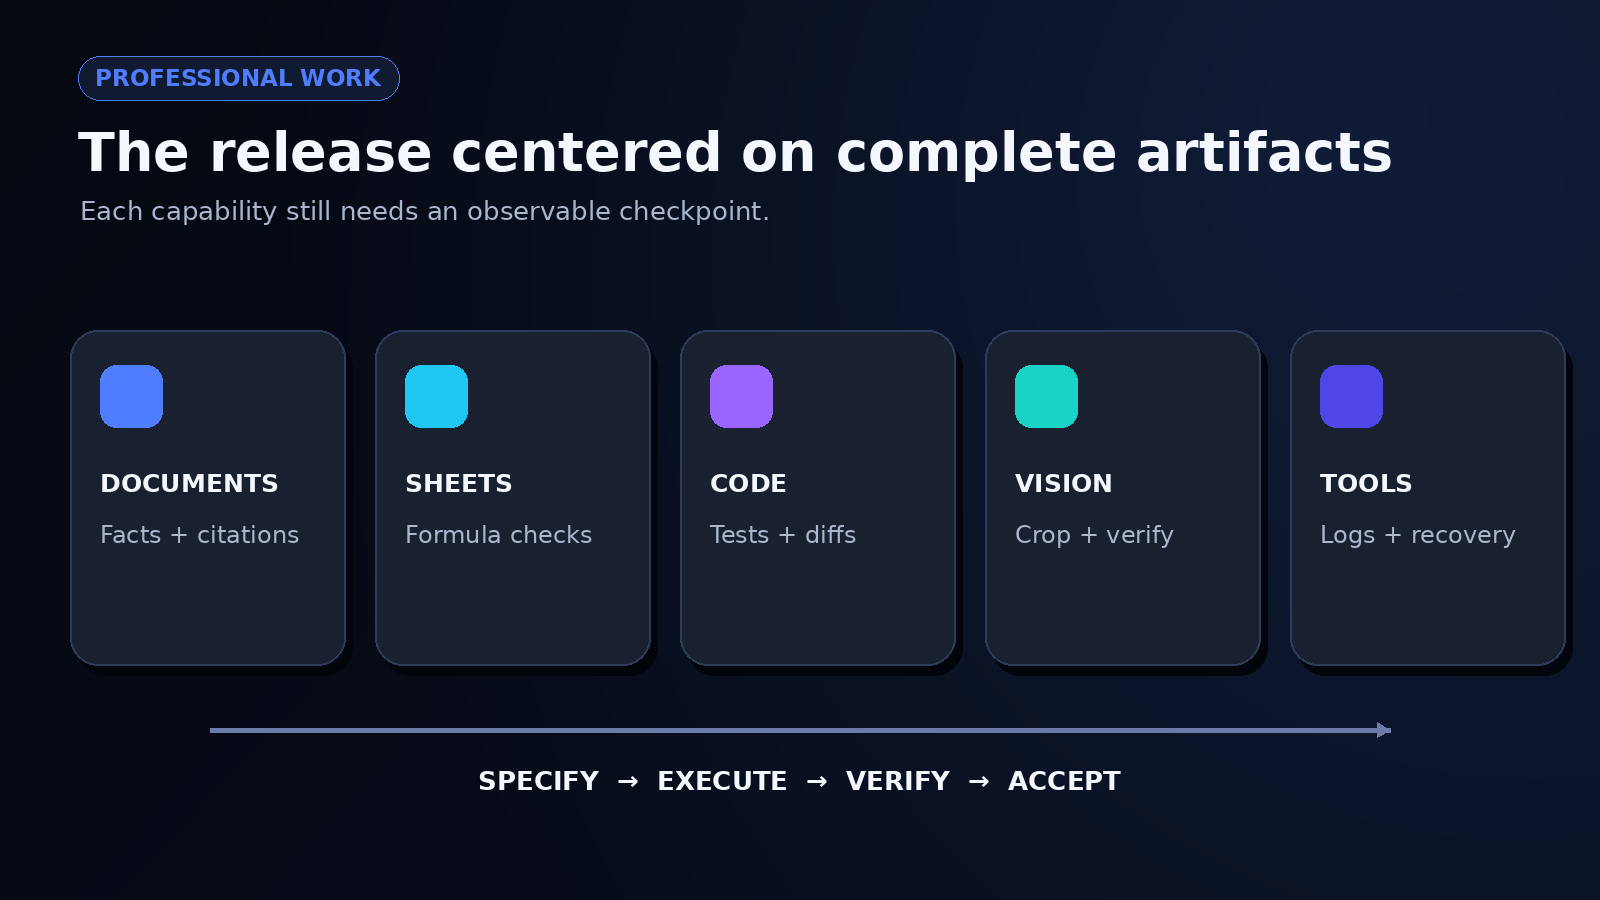
Figura 5. pannelli di foglio di calcolo, codice, documento, immagine e chiamata a strumento
I benchmark di lancio hanno mostrato punti di forza ampi ma disomogenei
| Benchmark | GPT-5.2 Thinking | Cosa misura |
|---|---|---|
| Vittorie o pareggi GDPval | 70,9% | Attività professionali ben specificate in 44 professioni |
| SWE-Bench Pro pubblico | 55,6% | Attività di ingegneria del software multilingua |
| SWE-bench Verified | 80,0% | Attività verificate su repository Python |
| GPQA Diamond | 92,4% | Domande scientifiche di livello universitario avanzato senza strumenti |
| AIME 2025 | 100,0% | Matematica da competizione senza strumenti |
| ARC-AGI-2 Verified | 52,9% | Attività inedite di ragionamento astratto |
La dispersione è la parte utile. Mostra risultati solidi senza implicare una padronanza uniforme. Un punteggio dell'80% sui problemi Python verificati non predice il tuo tasso di successo su un monorepo TypeScript con regole di deployment personalizzate. Allo stesso modo, un benchmark scientifico non stabilisce un giudizio legale o medico affidabile.
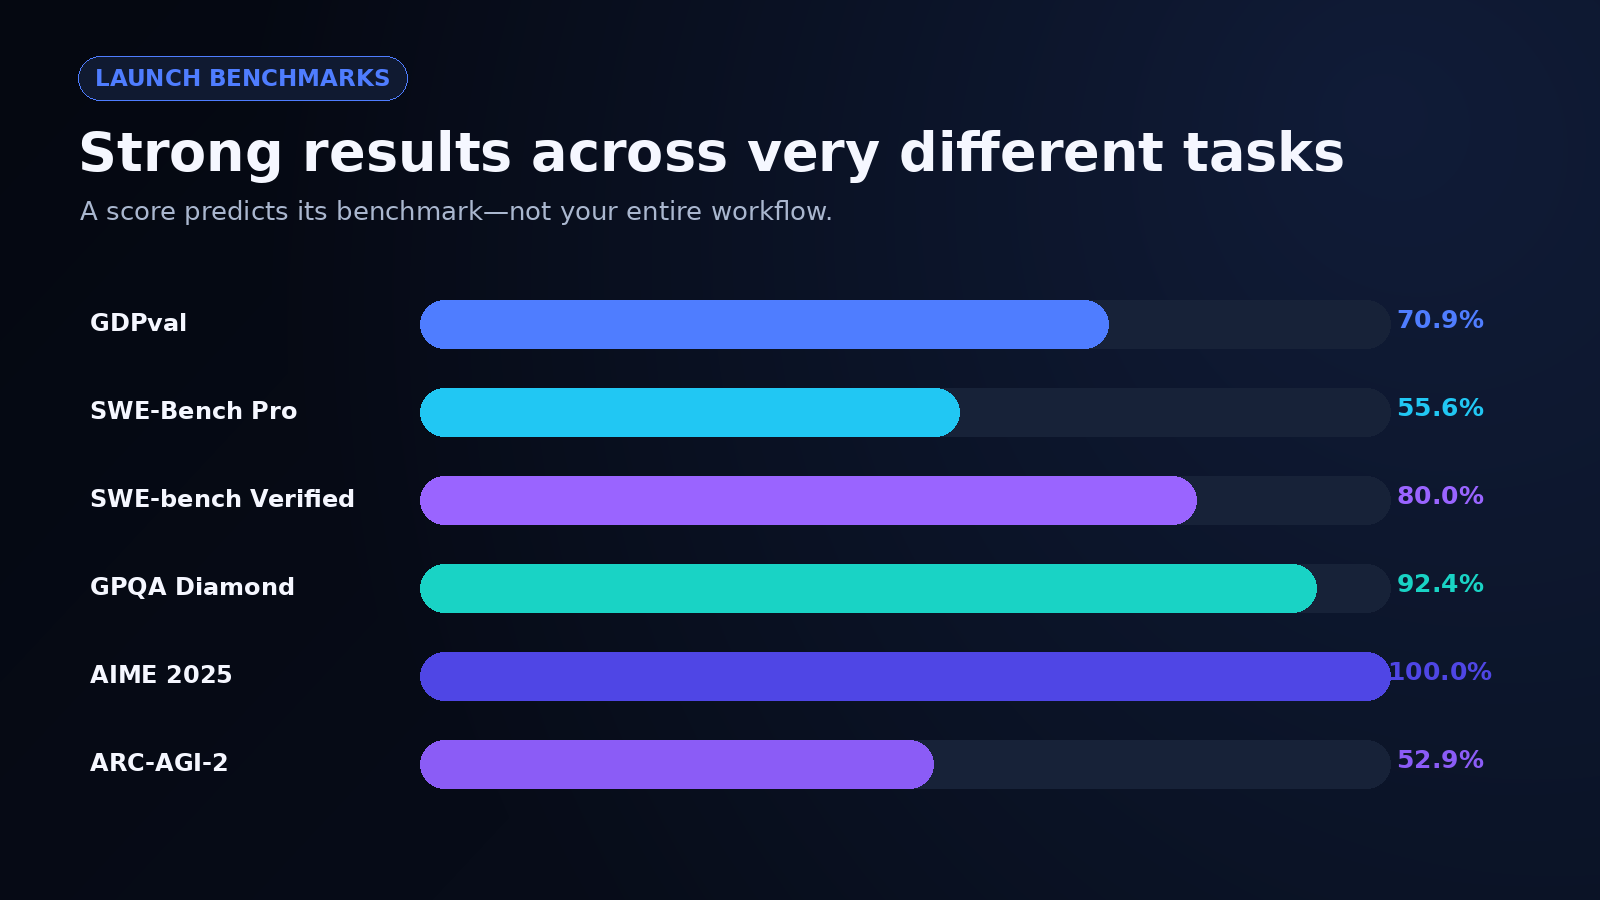
Figura 6. sei punteggi di lancio con categorie di attività
Leggi i benchmark di GPT-5.2 insieme ai suoi limiti
I punteggi pubblici comprimono molte scelte in un unico numero: formato del prompt, strumenti, sforzo di ragionamento, selezione dei test, comportamento del valutatore e politica di retry. Il tuo flusso di lavoro in produzione aggiunge qualità dei dati, permessi, limiti di latenza e revisione umana. Trovo i benchmark più utili per scegliere cosa testare, non per saltare il test.
Cosa ha effettivamente mostrato la mia revisione dell'app
Il revisore di brief di progetto mostrava le istruzioni inviate sotto "Riepilogo del progetto" e "Requisiti essenziali" mentre la risposta era ancora in streaming. L'input richiedeva verifiche di implementazione, ma il risultato visibile ha organizzato quella richiesta come un brief. Non ha riportato un'ispezione del codice completata né risultati dei test.
La vista di sessione separata non aveva richieste o utilizzo registrati, lasciando non verificati tempo di risposta, routing e costo. Completa una richiesta con un brief vincolato per finire il controllo.
I punteggi dei benchmark non sono garanzie di produzione
Inizia con 20-50 attività rappresentative e definisci i criteri di accettazione prima di eseguirle. Per il codice, questo può includere il tasso di superamento dei test, la dimensione del diff, i risultati di sicurezza e la sicurezza del rollback. Per il lavoro documentale, può includere l'accuratezza fattuale, la copertura delle citazioni, gli errori di calcolo e il tempo di editing. Esegui lo stesso set più di una volta perché la varianza conta.
Poi misura il costo per risultato accettato. Supponi che un modello costi $0,18 per esecuzione e superi il 60% dei casi, mentre un altro costi $0,28 e superi il 90%. Prima della correzione umana, i loro costi previsti per risultato accettato sono $0,30 e circa $0,31. Una volta valorizzato il tempo di revisione, il secondo può essere chiaramente più economico, oppure no. L'aritmetica riporta la decisione al tuo flusso di lavoro.
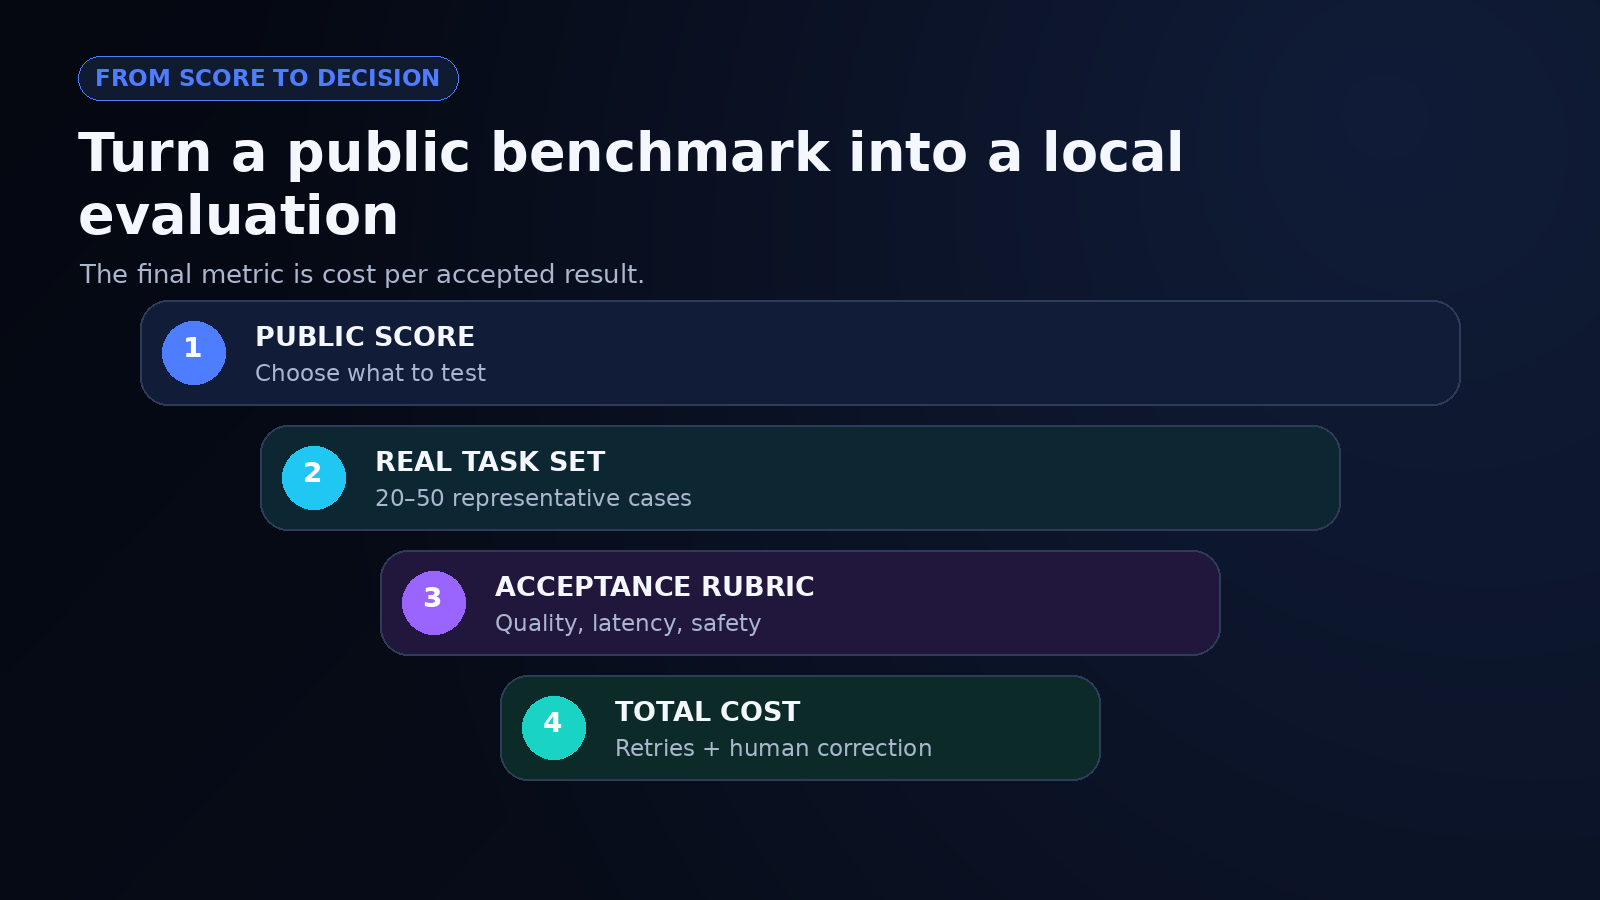
Figura 7. dal punteggio benchmark alle attività rappresentative fino al costo del risultato accettato
Il contesto lungo e l'input di immagini richiedono ancora verifica
Una finestra di contesto lunga può ridurre il chunking, ma rende anche le omissioni più difficili da notare. Testerei il recupero dall'inizio, dal centro e dalla fine di un set di file; richiederei citazioni o identificatori di record per fatti critici; e rieseguirei i calcoli fuori dal modello. Per le immagini, ritaglia la regione rilevante e fai la domanda esplicitamente invece di aspettarti che il modello deduca cosa conta.
Le critiche indipendenti possono anche svelare modalità di fallimento che un post di lancio non evidenzierà. Una critica pratica descrive risultati deludenti nelle attività dell'autore. Ciò non smentisce i risultati dei benchmark; mostra perché il tuo prompt, il tuo carico di lavoro e la tua soglia di accettazione devono essere riprodotti direttamente.
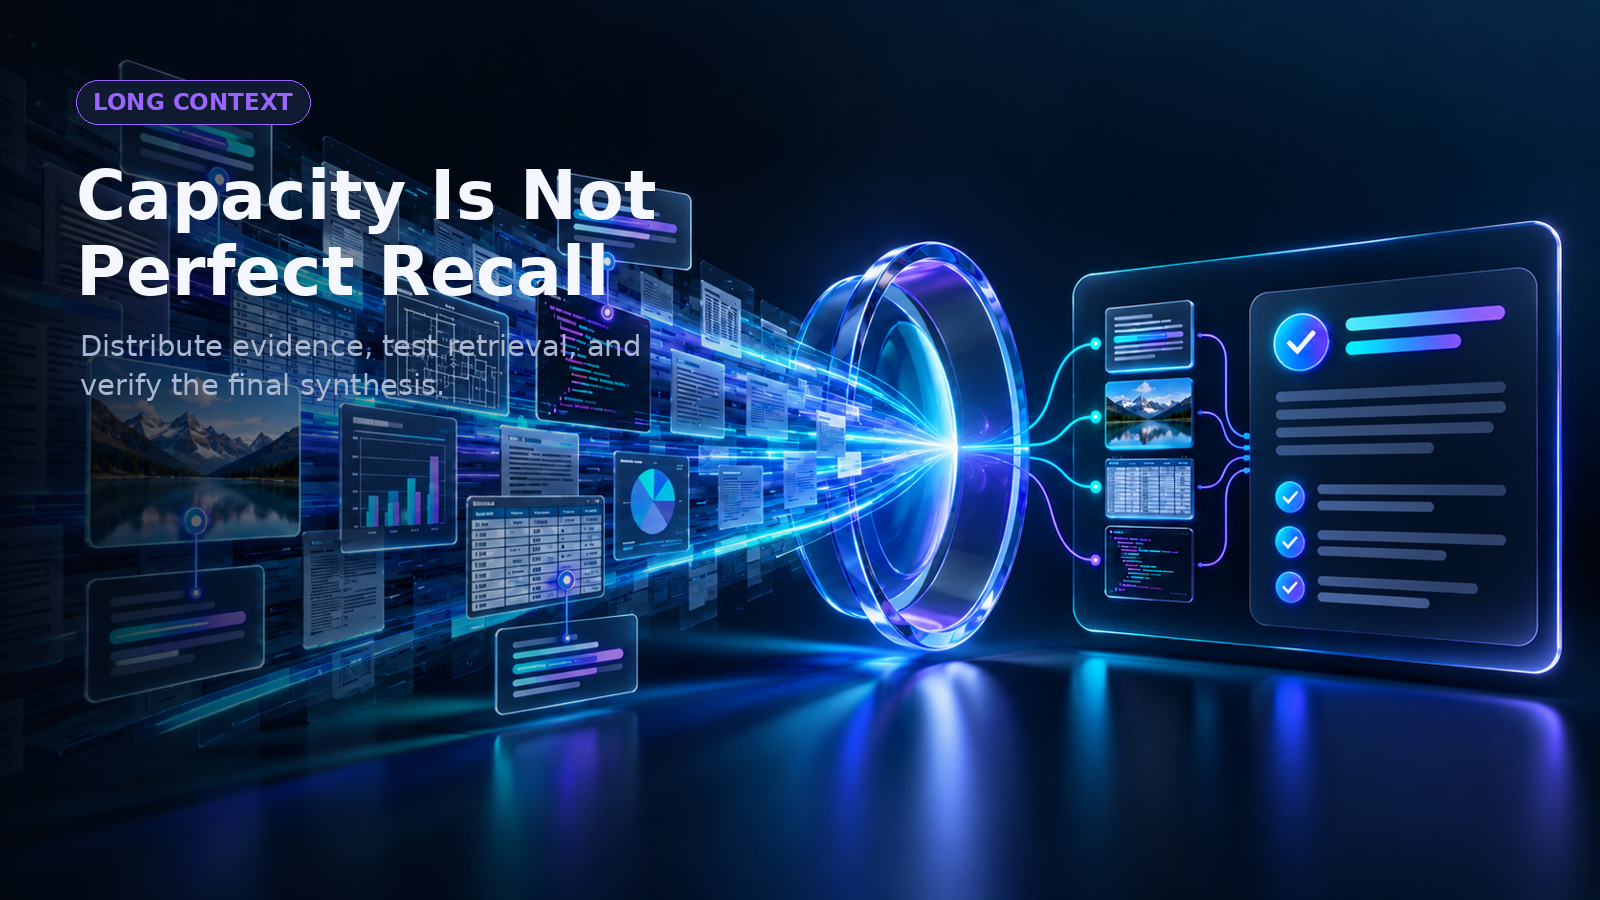
Figura 8. evidenze distribuite in un flusso di documenti da 400K token
Il lavoro ad alto rischio richiede tutele specifiche del dominio
La data di cutoff delle conoscenze del 31 agosto 2025 significa che i fatti attuali richiedono un recupero. I modelli possono comunque inventare fonti, trascurare requisiti, leggere male gli screenshot o generare codice non sicuro. Non supportano nemmeno il fine-tuning, quindi i team che hanno bisogno di un comportamento profondamente personalizzato devono affidarsi a prompting, recupero, strumenti, validazione o un altro modello.
Dovresti separare l'assistenza dall'autorità. Un modello può riassumere un contratto, segnalare una transazione sospetta o proporre una patch. Una persona qualificata o un controllo deterministico dovrebbe prendere la decisione legale, medica, finanziaria, di sicurezza e di produzione. Registra le prove e mantieni un percorso chiaro per rifiutare o annullare l'output.
Cos'è GPT-5.2-Codex e come dovrebbero usarlo gli sviluppatori?
GPT 5.2 Codex è il membro specializzato nel codice della famiglia, progettato per lavori di ingegneria del software più lunghi piuttosto che per l'autocompletamento isolato. La distinzione utile è la profondità del flusso di lavoro: comprendere un repository, pianificare una modifica, modificare diversi file, eseguire strumenti, ispezionare gli errori e rivedere la patch.
Attività di programmazione più adatte
Buoni candidati includono l'esplorazione del repository, l'implementazione di funzionalità, la riparazione di bug, il refactoring, la creazione di test, la revisione del codice e le migrazioni con criteri di accettazione espliciti. Darei al modello l'obiettivo coerente più piccolo che include comunque il reale confine di dipendenza. Un prompt artificialmente minuscolo può produrre un diff locale pulito che fallisce nel sistema circostante.
Puoi valutare GPT 5.2 Codex con un set di repository ripetibile: problemi noti, test nascosti, linting, policy sulle dipendenze, controlli di sicurezza e un diff massimo accettabile. Registra il numero di chiamate agli strumenti, correzioni e interventi del revisore. Una patch non ha successo solo perché compila.
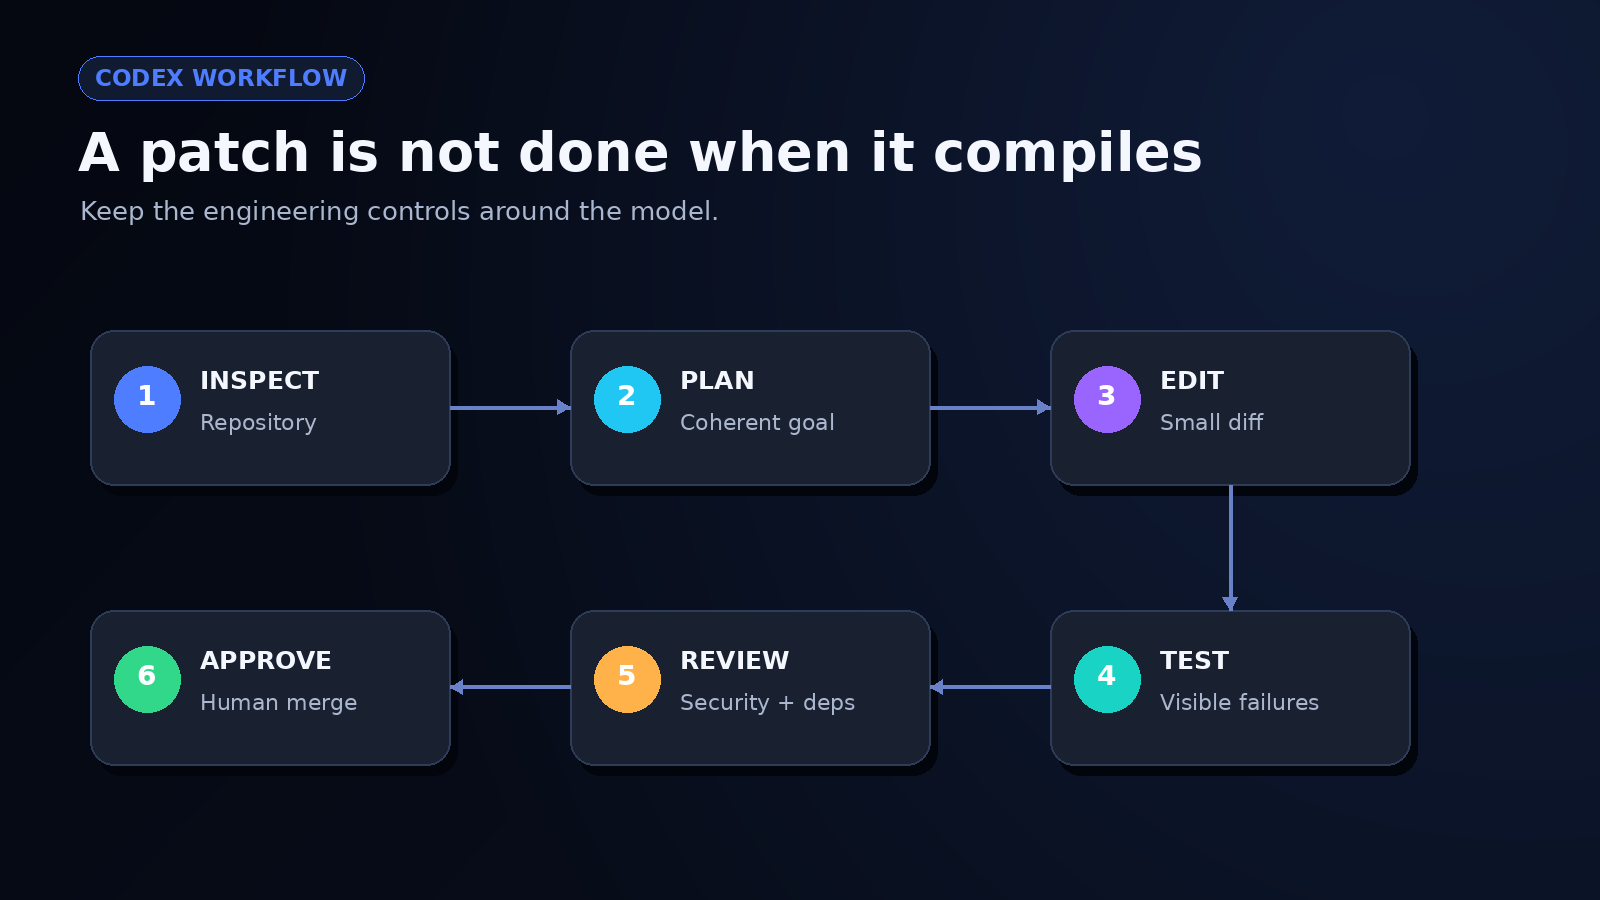
Figura 9. ispezionare, pianificare, modificare, testare, revisionare e approvare
Le protezioni di produzione restano applicabili
Mantieni le modifiche abbastanza piccole da poter essere revisionate, fissa lo snapshot del modello quando la riproducibilità conta, e limita gli strumenti al privilegio minimo richiesto. Esegui test del repository, scansione delle dipendenze, rilevamento dei segreti, analisi statica e revisione umana del diff. Se l'agente può effettuare il deployment, eliminare dati o ruotare le credenziali, metti queste azioni dietro un'approvazione esplicita.
Preferisco anche un budget di fallimento: definisci quanti retry, minuti o token un'attività può consumare prima di tornare a un umano. Senza quel limite, un agente può sembrare produttivo mentre si muove in cerchio attraverso correzioni sempre più speculative.
GPT-5.2 vs Gemini 3 dipende dall'attività esatta
GPT-5.2 vs Gemini 3: spiega che il modello IA migliore dipende dall'attività, come programmazione, ragionamento, scrittura o ricerca.
La risposta onesta a "GPT 5.2 vs Gemini 3" è un disegno di test, non un vincitore universale. Varianti esatte, date, strumenti, dimensioni di contesto, impostazioni di ragionamento e prezzi devono essere registrati. Altrimenti, un confronto può silenziosamente dare a un modello ricerca, esecuzione di codice o un budget di tempo maggiore.
| Fattore decisionale | Domanda da testare |
|---|---|
| Qualità dell'output | Quale modello supera più spesso la tua rubrica di attività? |
| Programmazione | Quale produce il tasso di superamento dei test più alto con diff più piccoli e sicuri? |
| Contesto lungo | Quale recupera e combina i fatti dai tuoi file con maggiore precisione? |
| Uso di strumenti | Quale completa il flusso di lavoro con fallimenti recuperabili e log utilizzabili? |
| Latenza | Quali sono i tempi di risposta mediani e al 95° percentile? |
| Costo | Qual è il costo totale per risultato accettato dopo retry e correzione? |
| Governance | Quali controlli su dati, conservazione, regione e audit si adattano al tuo caso d'uso? |
Esegui la stessa valutazione testa a testa
Dai a entrambi i modelli gli stessi prompt, file sorgente, strumenti, budget di tempo e rubrica di valutazione. Randomizza l'ordine delle attività e nascondi il nome del modello ai revisori dove possibile. Ripeti casi rappresentativi invece di selezionare un'unica risposta perfetta. Le reazioni della community nella discussione di lancio di GPT‑5.2 sono utili per scoprire lamentele da testare, ma non sono confronti controllati.
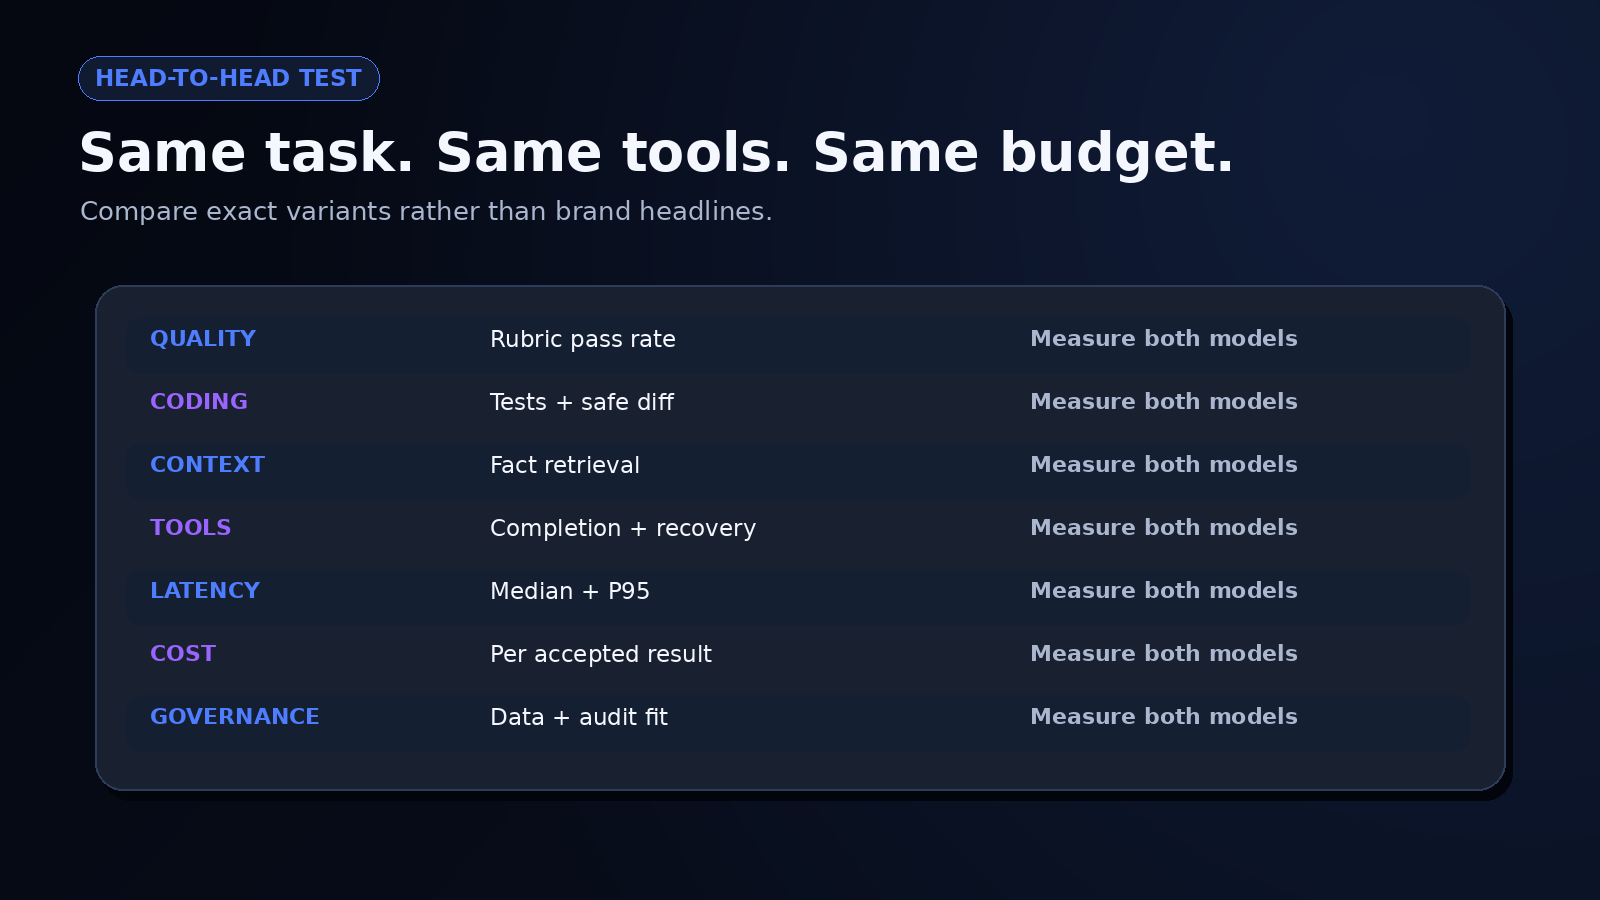
Figura 10. qualità, programmazione, contesto, strumenti, latenza, costo e governance
Scegli il flusso di lavoro a rischio più basso, non il titolo migliore
Il tuo vincitore può variare per fase. Un modello può pianificare bene, un altro può generare codice più pulito, e un'opzione più piccola può gestire la classificazione a una frazione del costo. L'architettura corretta può instradare il lavoro invece di forzare un unico modello a fare tutto.
Per una valutazione GPT 5.2 vs Gemini 3, scelgo la combinazione di modelli più semplice che soddisfa la soglia di qualità e rimane osservabile quando fallisce. Ogni provider o fallback aggiuntivo aggiunge logica di routing, lavoro di valutazione, revisione della privacy e complessità degli incidenti. La diversità dei modelli è utile quando riduce un rischio misurato.
Crea un'app GPT‑5.2 Pro in Enter Pro
Ho usato l'AI app builder di Enter Pro per creare un revisore di brief di progetto basato su IA, con GPT‑5.2 Pro selezionato come integrazione. L'obiettivo era trasformare un'idea di app approssimativa in requisiti, informazioni mancanti, priorità e criteri di accettazione.
Seleziona GPT‑5.2 Pro e controlla le tariffe
Ho individuato GPT‑5.2 Pro nel catalogo dei modelli e ho aperto i suoi dettagli. Il pannello mostrava un pulsante Integra e tariffe di** 2,1 crediti per 1.000 token di input** e** 16,8 crediti per 1.000 token di output**. Queste sono le tariffe della piattaforma catturate.
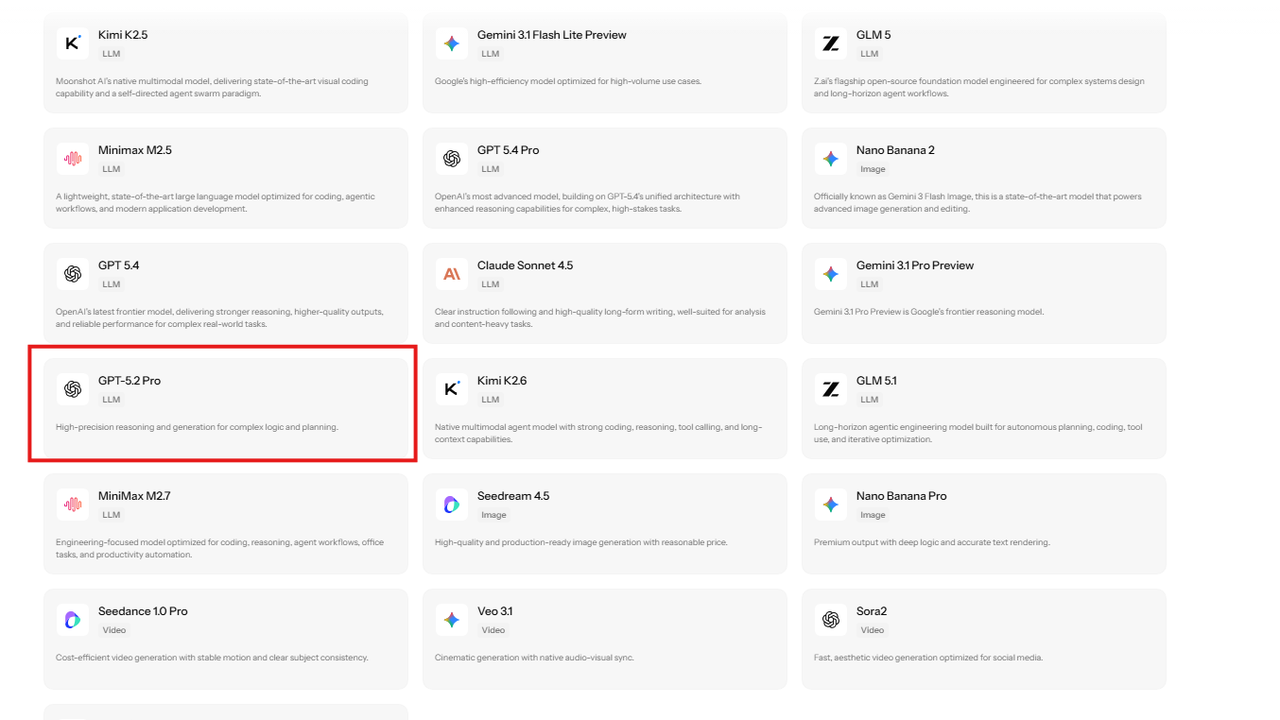
Figura 11. GPT‑5.2 Pro appare nel catalogo dei modelli tra le altre integrazioni disponibili.
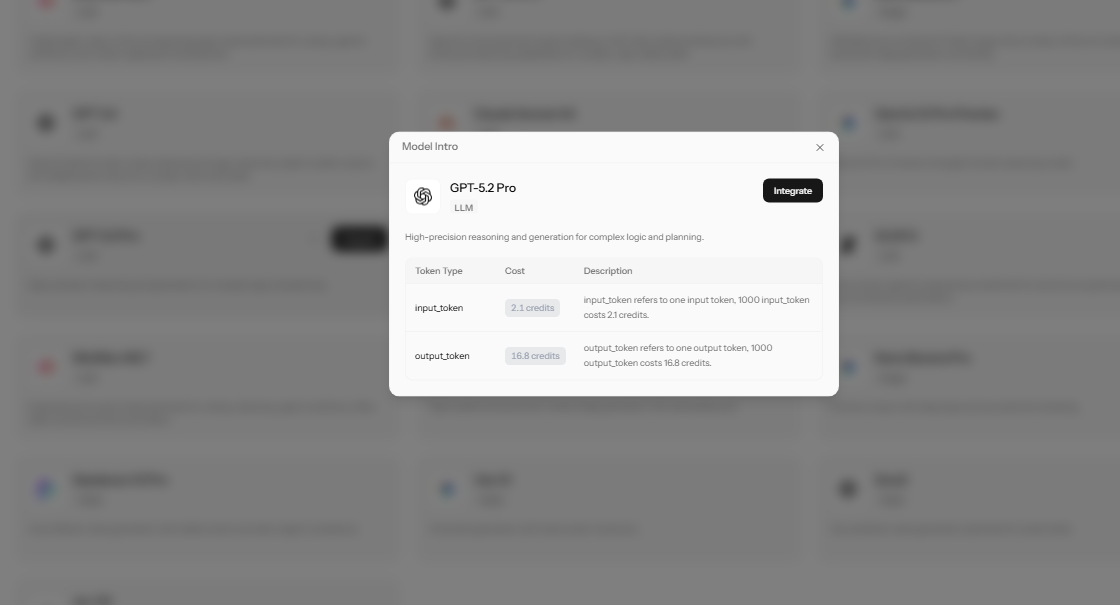
Figura 12. Il pannello dei dettagli di GPT‑5.2 Pro mostra il controllo Integra e le tariffe in crediti.
Collega il modello e descrivi l'app
La richiesta di progetto aveva il chip GPT‑5.2 Pro collegato. Ho chiesto un campo brief ampio, un pulsante Revisiona Brief, e risposte organizzate in cinque sezioni: riepilogo del progetto, requisiti essenziali, contraddizioni e informazioni mancanti, priorità di implementazione e criteri di accettazione. La richiesta richiedeva anche stati di caricamento ed errore reali.
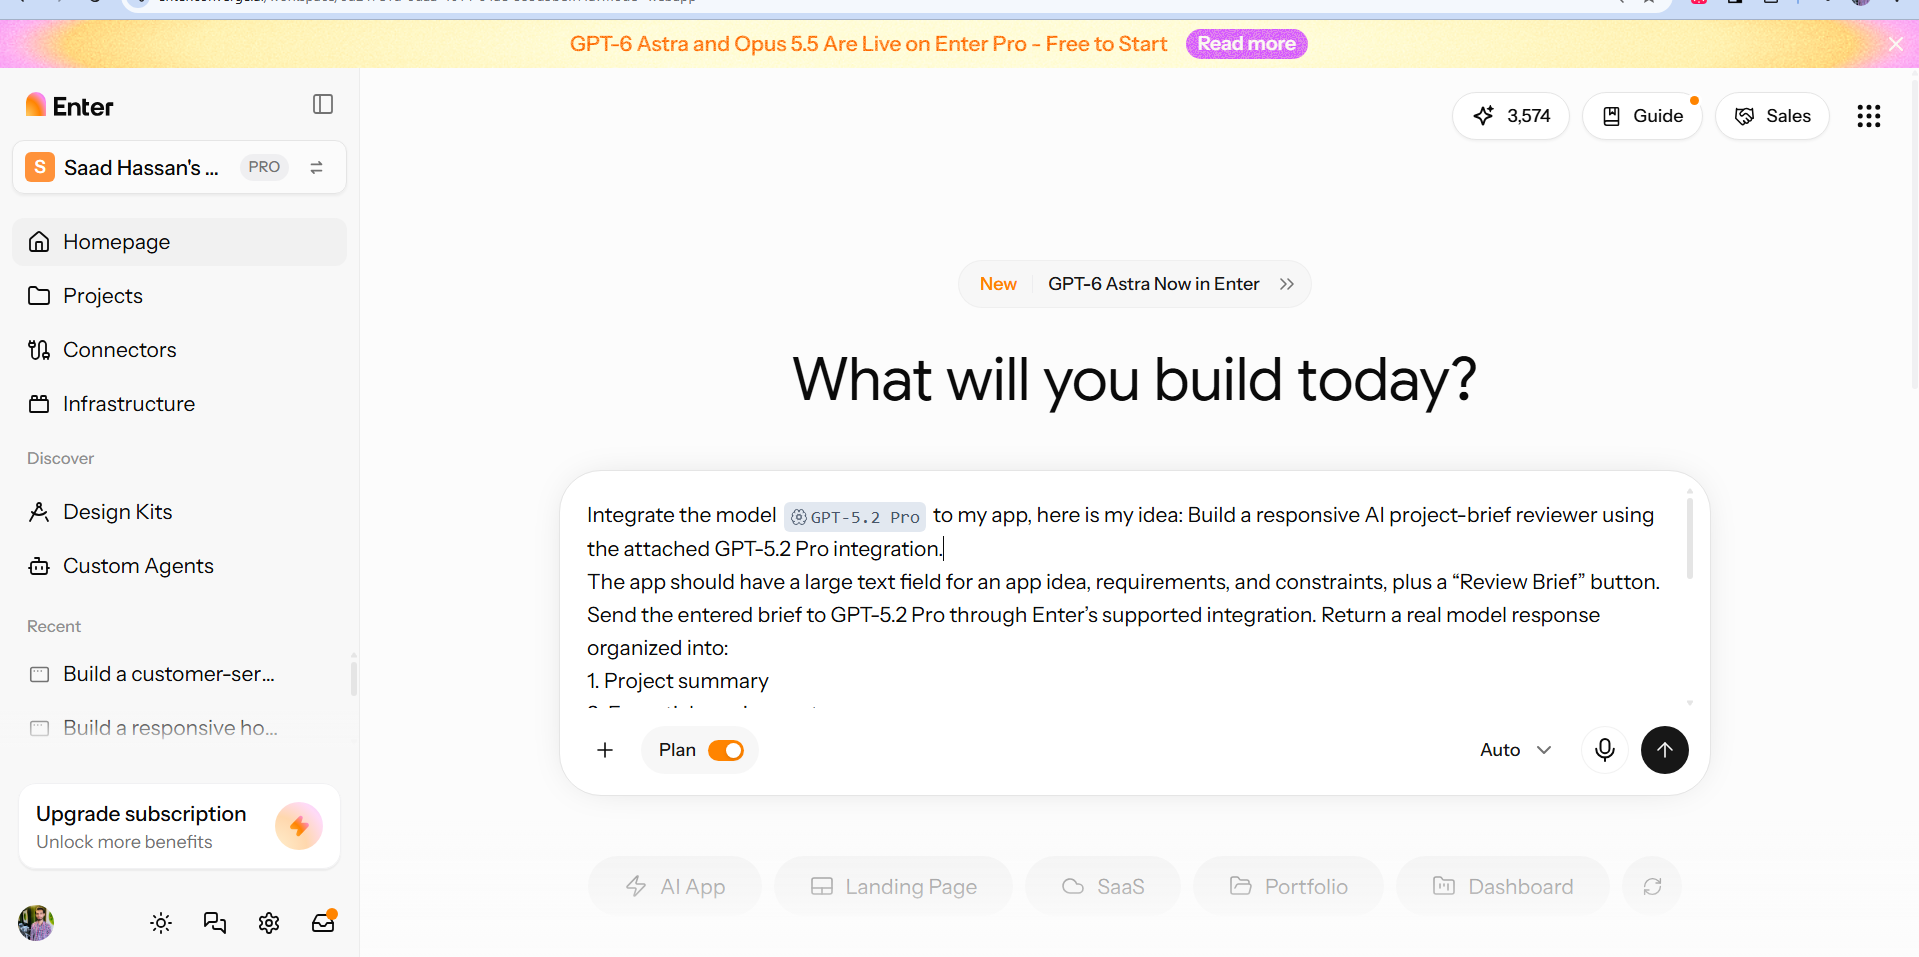
Figura 13. Il prompt di progetto collega GPT‑5.2 Pro e specifica lo scopo e la struttura di risposta del revisore.
Esamina il piano di build
Enter ha generato un piano per un'interfaccia Vite, React e Tailwind con una funzione backend che gestisce la richiesta all'IA. Specificava risultati in streaming, testo in inglese semplice e nessuna cronologia di revisione salvata. Mantenere la credenziale privata sul backend faceva parte del piano. Questa schermata registra l'implementazione proposta.
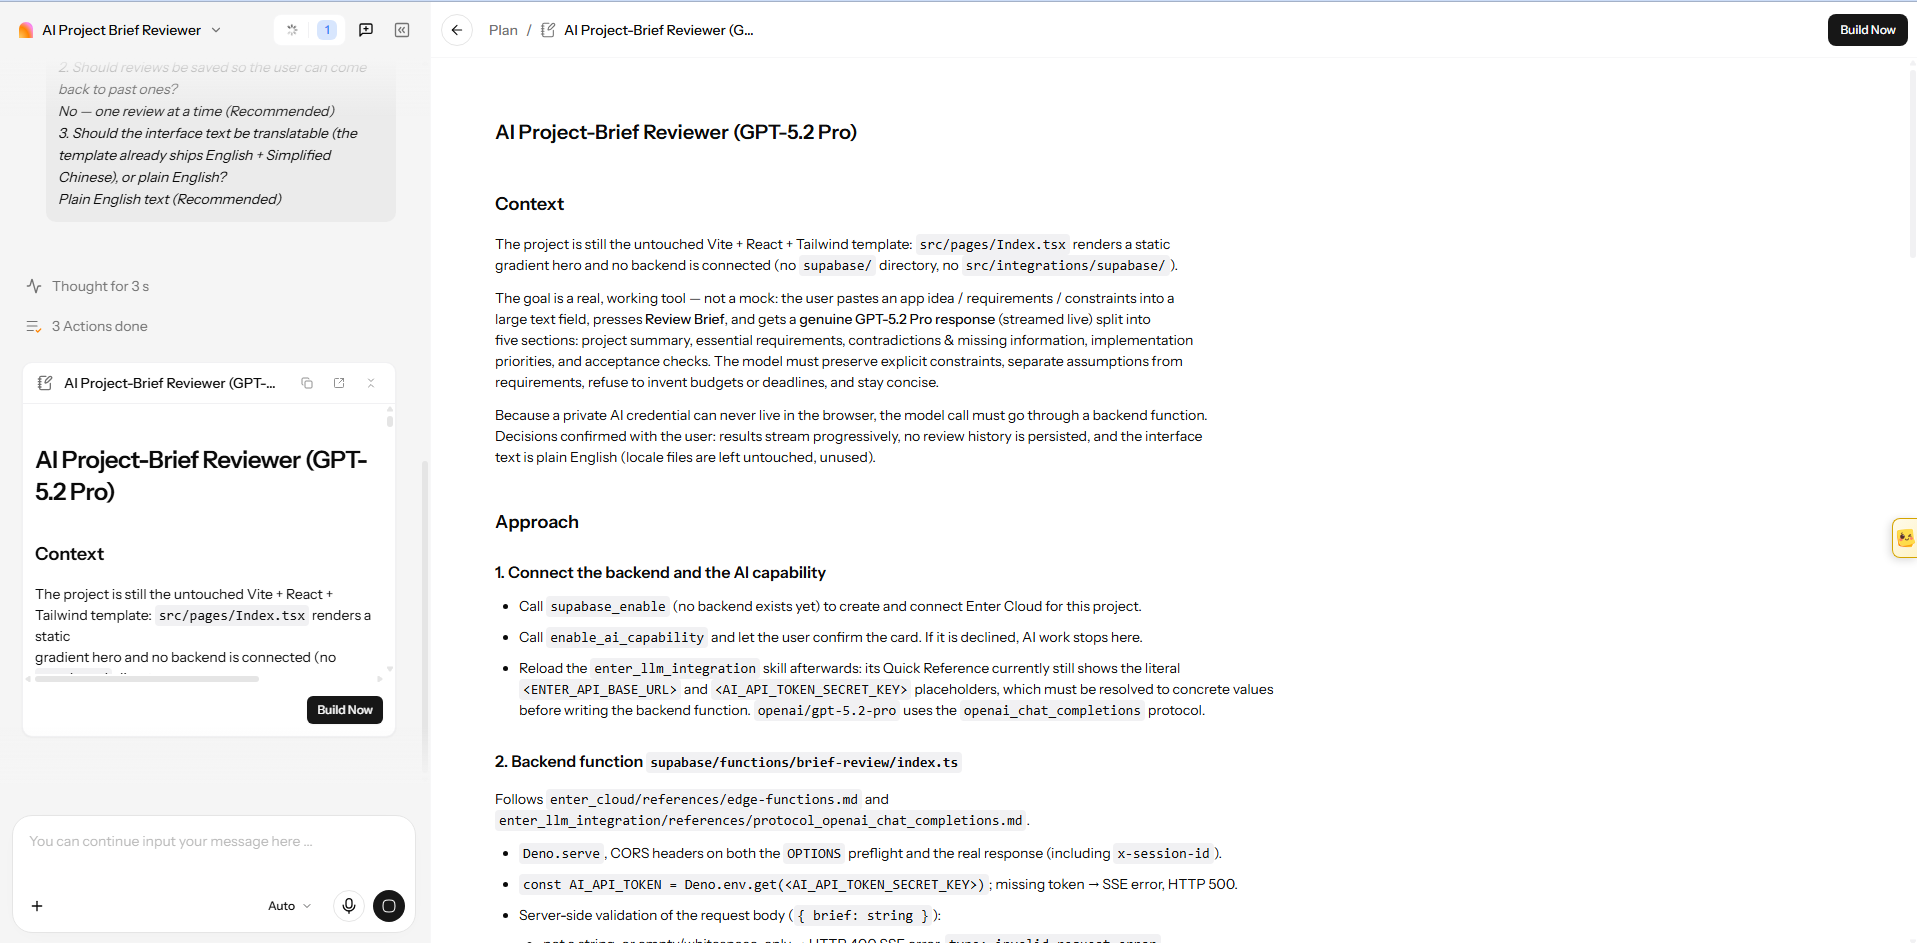
Figura 14. Il piano di build descrive l'interfaccia, la richiesta backend, l'output in streaming e la gestione delle credenziali.
Esamina la revisione visibile
Il revisore mostrava un campo brief accanto ai suoi pannelli di risposta. Nel tentativo catturato, ho inserito la richiesta di verifica dell'implementazione in quel campo. La risposta ha riorganizzato i suoi requisiti sotto le intestazioni richieste, mentre Streaming review e** Reviewing** rimanevano visibili. Questo ha dimostrato l'organizzazione della risposta, con completezza e correttezza ancora da verificare.
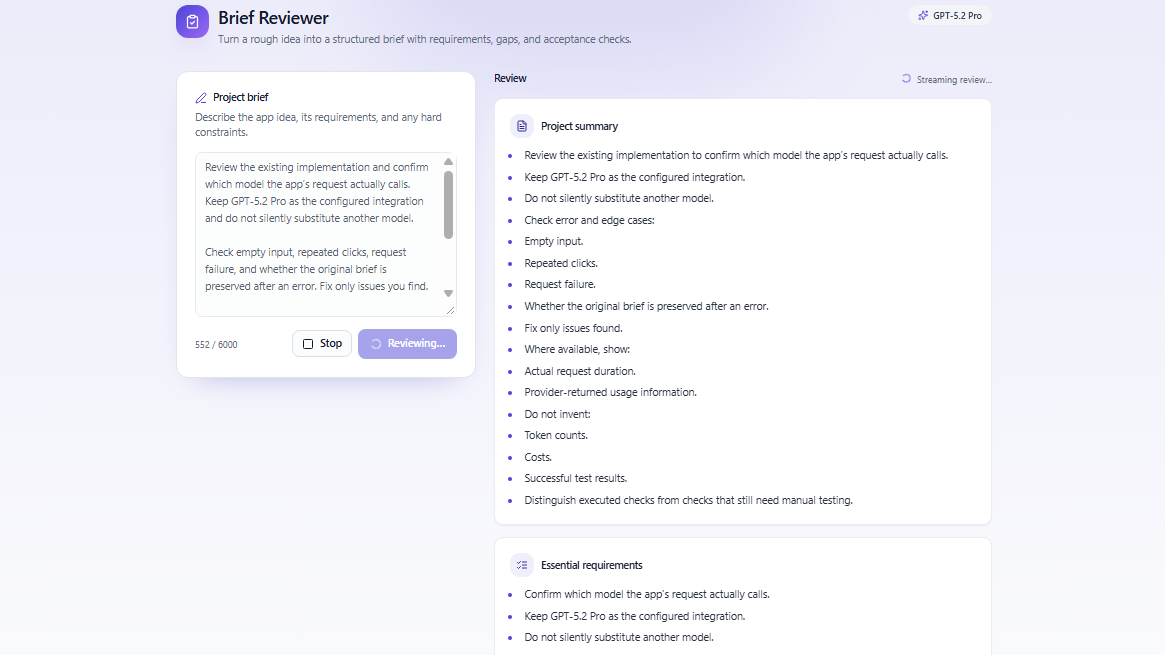
Figura 15. Il testo della revisione appare sotto le intestazioni richieste mentre l'interfaccia indica ancora una risposta attiva.
Per un controllo del ragionamento, usa il brief degli appuntamenti con tre tecnici, lavori da 45 minuti, un buffer di viaggio di 30 minuti, orari dalle 9 alle 17, nessuna sovrapposizione e una regola di riprogrammazione di 12 ore. Poi aggiungi "consenti due appuntamenti simultanei per tecnico" e verifica se la risposta completata segnala il conflitto. Questo risultato non è presente in queste schermate.
Controlla il record delle richieste e l'utilizzo dei crediti
La vista di stato aggiuntiva etichettava l'integrazione come GPT‑5.2 Pro, il provider come Enter AI e il protocollo come Responses API. La sua sessione non conteneva nessuna richiesta, zero token di input e output, e zero utilizzo consumato. Questi valori non possono stabilire la durata, il routing effettivo o il costo della risposta precedente.
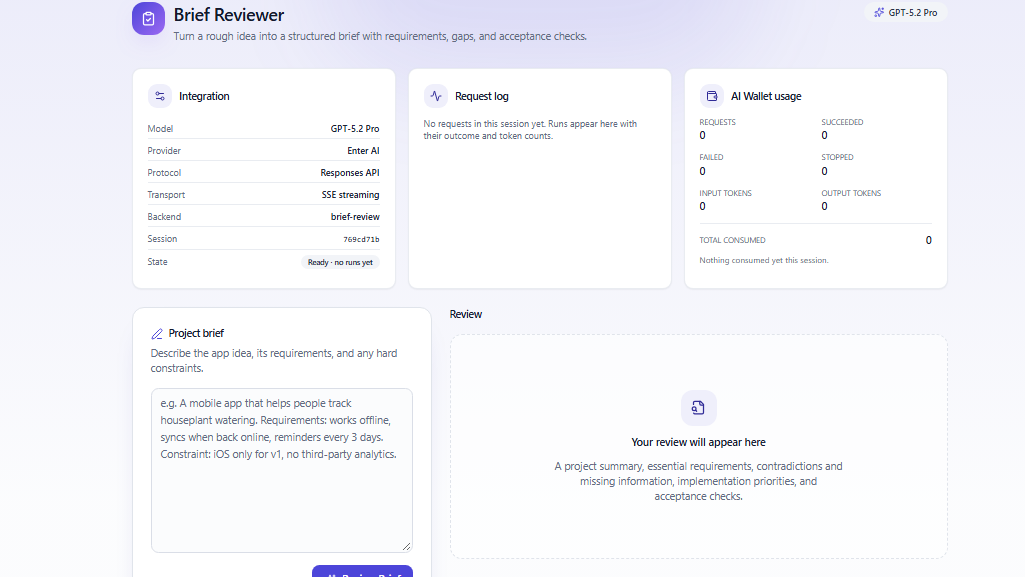
Figura 16. I pannelli di integrazione e utilizzo mostrano una sessione pronta senza richieste o consumi registrati.
Alle tariffe mostrate, 1.000 token di input più 500 token di output fatturati, a titolo illustrativo, equivarrebbero a 10,5 crediti. Questa è una stima, non una spesa osservata. Per confrontare i costi, usa richieste completate, utilizzo fatturato, retry e la proporzione di revisioni che soddisfano i tuoi criteri di accettazione.
Enter mantiene il modello selezionato e il brief dell'app in un unico progetto. Crea la tua app GPT‑5.2 Pro in Enter Pro e verifica l'integrazione prima di pubblicare.
Considerazione finale: valuta GPT‑5.2 attraverso un compito reale
Il valore pratico di GPT‑5.2 dipende dalla qualità del compito e dal costo accettabile. Il progetto del revisore collega la selezione di Pro con un'interfaccia app e un testo di revisione organizzato. Una risposta completata, vincoli verificati e un record di richiesta completato sono ancora necessari per giudicare l'affidabilità e l'efficienza in termini di costi.
Scegli il modello meno costoso che soddisfa la tua soglia di accettazione, ripeti i casi importanti e mantieni un percorso di recupero per gli errori. Puoi usare Enter Pro per costruire e perfezionare un'app GPT‑5.2 Pro, poi verificarne l'integrazione prima di espanderla.
FAQ su Chat GPT 5.2
Quando è stato lanciato GPT-5.2?
OpenAI lo ha annunciato l'11 dicembre 2025. I modelli API e le varianti di ChatGPT hanno iniziato a essere distribuiti al lancio, sebbene accesso e alternative consigliate siano cambiate da allora.
GPT-5.2 è ancora il modello più recente di OpenAI?
No. Al 9 ottobre 2026, OpenAI lo documenta come modello di generazione precedente. Chi cerca Chat GPT 5.2 dovrebbe distinguere l'accesso tramite il selettore di ChatGPT dall'accesso tramite API o integrazione di terze parti. Verifica la variante esatta e la disponibilità attuale prima di iniziare un progetto.
Qual è la finestra di contesto di GPT-5.2?
La finestra di contesto documentata è di 400.000 token, con un output massimo di 128.000 token. Dovresti comunque testare il recupero e il ragionamento sui tuoi documenti lunghi reali.
Quanto costa l'API di GPT-5.2?
La tariffa API standard è di $1,75 per milione di token di input, $0,175 per milione di token di input in cache, e $14 per milione di token di output. Costi degli strumenti, ragionamento, retry e revisione aumentano il costo del compito.
Come posso creare un'app GPT‑5.2 Pro con Enter Pro?
Seleziona GPT‑5.2 Pro dal catalogo dei modelli, collega l'integrazione e descrivi la funzionalità di cui la tua app ha bisogno. Per un revisore di brief di progetto, specifica gli input richiesti e il formato di revisione. Esamina l'implementazione generata, poi verifica una richiesta completata per confermare che la connessione al modello funzioni.
Come posso controllare l'utilizzo di GPT‑5.2 Pro in Enter Pro?
Controlla i pannelli di richieste e utilizzo dell'integrazione dopo aver eseguito un'attività rappresentativa. Conferma che la richiesta appaia, poi esamina token di input, token di output e crediti consumati. Includi retry e risposte più lunghe quando stimi i costi, usando le tariffe attuali della piattaforma.
Cos'è GPT-5.2 Pro?
GPT 5.2 Pro è un modello di ragionamento a maggiore intensità di calcolo per compiti professionali difficili. Le sue tariffe API ufficiali sono $21 per milione di token di input e $168 per milione di token di output, e alcune richieste possono richiedere diversi minuti.
GPT-5.2 supporta le immagini?
Sì. Accetta input di immagini e produce output di testo. Audio e video non sono elencati come input nativi supportati, quindi questi formati richiedono un passaggio di elaborazione separato.
GPT-5.2 è migliore di Gemini 3?
Non esiste una risposta universale. Testa le varianti esatte con gli stessi prompt, file, strumenti, budget e rubrica, poi confronta qualità dei risultati accettati, latenza, costo, governance e recupero dai fallimenti.
GPT-5.2 può generare codice pronto per la produzione?
Può generare codice solido, ma la prontezza per la produzione deriva dall'intero processo di ingegneria: test, revisione dei diff, controlli su dipendenze e sicurezza, strumenti limitati, staging, monitoraggio e rollback. Il modello non può sostituire questi controlli.





