Atlas: AI時代の学習
Atlasなら、AIが生成した3D世界を通じて歴史や科学の概念の中に入り込めます。リアルタイムAIガイドと共に没入型教育を体験しましょう。学習の未来を発見してください。
EnterはHackPrinceton Spring 2026に参加しました。プリンストン大学のキャンパスで、410人の参加者が36時間にわたって競い合いました。私たちは次世代のビルダーを支援するためにそこにいました。Atlasを開発したチームは、私たちが何度も注目せずにはいられなかったチームの一つです。
教育における問題点
歴史の授業を受けたことのある人なら誰もが知っているように、ほとんどの教育の中心には欠落しているものがあります。
「何が起きたか」を教わり、書物を読み、試験を受ける。しかし、教科書から試験までのどこかで、本当に重要であるはずの「その瞬間、場所、現実」という感覚が、どうしても腑に落ちないのです。それは抽象的なままです。目に見えない世界を説明する、紙の上の言葉に過ぎません。
科学についても同じことが言えます。光合成は、それが一つのプロセスとして理解される前に、単なる一つの言葉として扱われます。手順は暗記されます。しかし、光が当たったとき、葉の中で実際に何が起きているのかという直感や理解を得るには、図解以上の何かが必要なのです。
Atlasのチームは、単純な観察から着想を得ました。それを変えるためのツールは、すでに存在しているということです。没入型の3D環境、リアルタイムで話し、推論できるAI、そしてテキストのプロンプトから生成される世界。課題は、それらのツールを組み合わせて、製品というよりも「場所」のように感じられるものを作れるかどうかでした。
Atlasとは何か
歴史的な出来事や科学的概念を入力してください。それに基づいて生成された3Dの世界に足を踏み入れましょう。
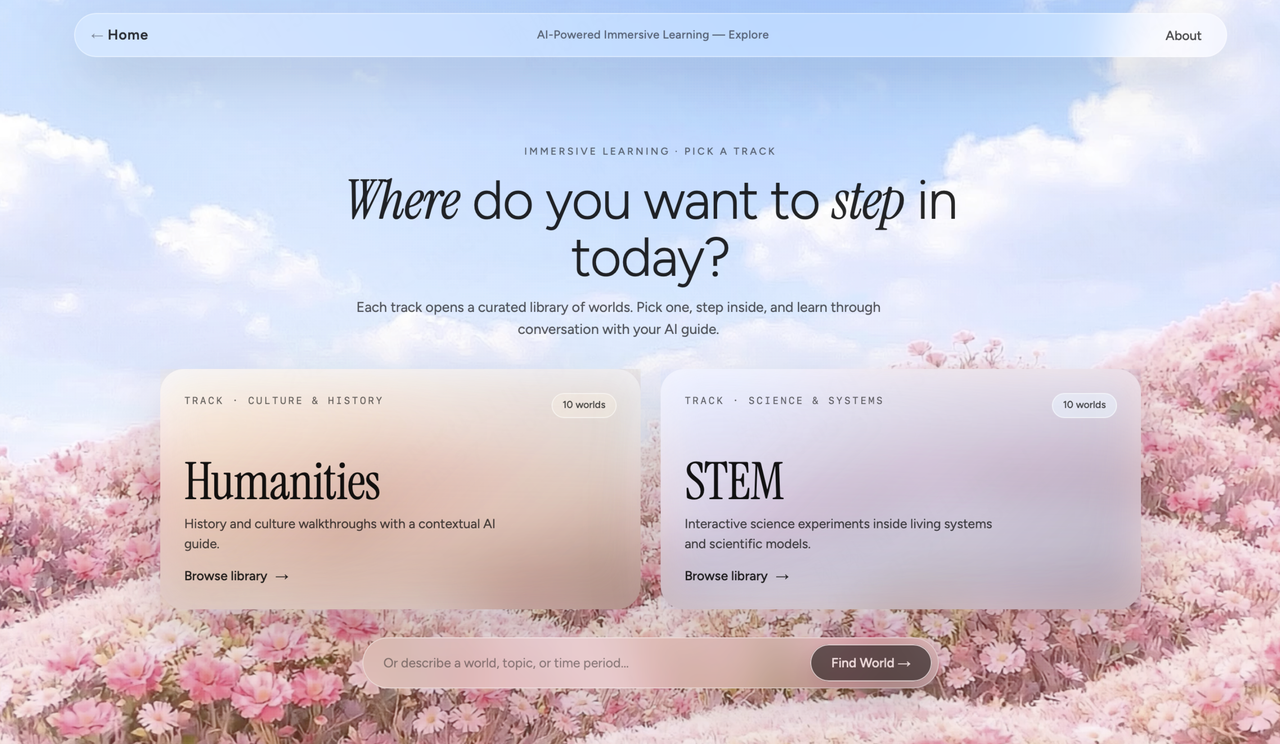
これがAtlasの核心ですが、この説明だけでは、実際に使ってみたときの感覚を伝えきれていません。この世界は、従来の意味でのイラストやシミュレーションではありません。プロンプトから生成され、リアルタイムでレンダリングされたフォトリアルな環境であり、理解したい特定の事柄を中心に構築されています。
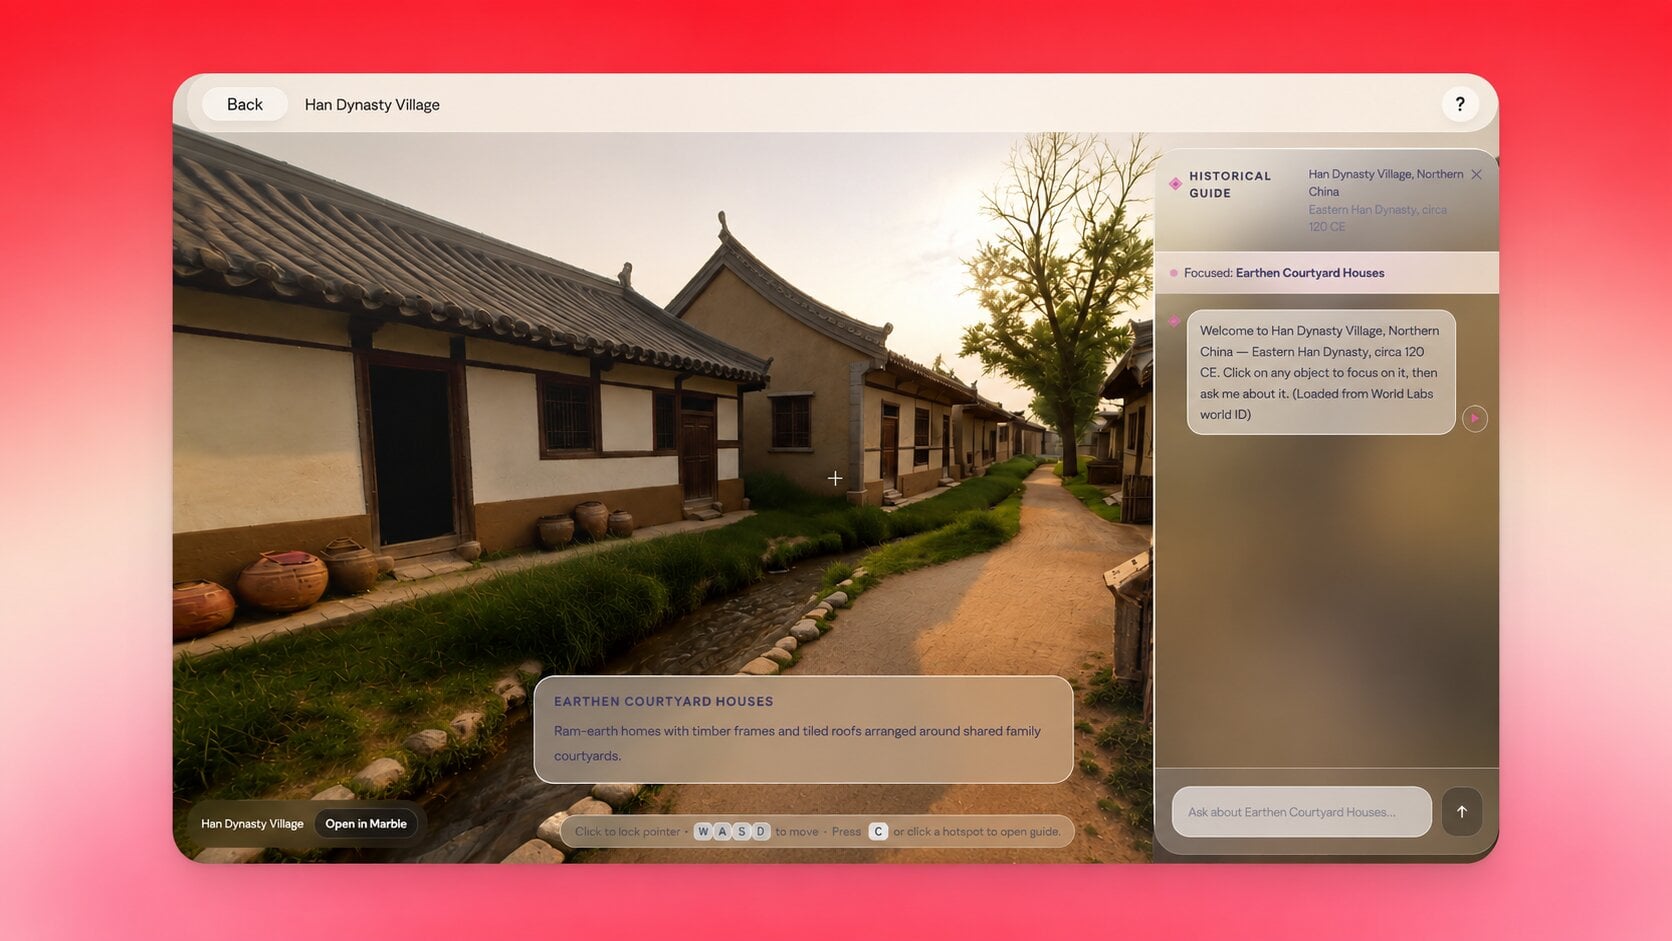
その世界の中にはAIガイドが存在します。ガイドは話し、聞き、そして隣にいる博識な人物が答えるように質問に応じます。周囲の風景、目に見えるオブジェクト、そして自分が今どこにいて何を見ているのかという特定の文脈に基づいた回答が得られます。個別の要素をクリックして直接質問することも可能です。科学のシーンでは、ガイド付きの実験があなたの行動に反応します。対話するたびに変化する光合成のサイクル。語るのではなく、体験を通して教える世界なのです。
古代中国の村を再現した3D環境を表示するAtlasのインターフェース。隅にはAIガイドが配置されており、シーン内に見えるオブジェクトや空間的な文脈に基づいた質問に答える準備ができている。
彼らが解決した難題
Atlasが直面した最も興味深い技術的課題は、最も根本的な課題でもありました。それは、AIガイドに「実際に何が存在するのか」を正確に認識させることでした。
言語モデルは、目に見えない世界の中で自由に振る舞うと、不足している情報を勝手に補完しようとします。存在しない人物について語ったり、生成されていないオブジェクトを参照したり、もっともらしく聞こえるが学習者が置かれている環境とは無関係な文脈を追加したりします。歴史の授業において、そのようなハルシネーション(幻覚)は不正確であるだけでなく、Atlasが目指している学習体験そのものを損なうことになります。
その解決策は、生成された世界内のすべてのラベル付けされたクエリ可能な要素を構造的に表現する「シーングラフ」システムでした。ガイドは、何かを答える前に必ずシーンを読み取ります。何があるかを理解しているのです。すべての回答は、モデルが持つ「古代中国の村とはこのようなものだろう」という一般的な知識ではなく、その空間的および歴史的な文脈に固定されています。
その結果、AIは検索エンジンのように振る舞うのではなく、同じ部屋に立っているガイドのような振る舞いをするようになりました。
Atlasの背後にあるシーングラフ・アーキテクチャは、生成された世界をラベル付けされたクエリ可能な要素に構造化する。これにより、AIガイドに空間的な根拠を与え、あらゆる回答が学生の目に映る現実を反映するものとなる。
彼らが最も誇りに思うこと
すべてのループが完全に機能したことです。
プロンプトを入力すれば、本格的な3D世界が生成される。音声対応のAIガイドが、歴史的に正確で、空間的に裏付けられた詳細な情報をもとに世界の中から質問に答える。ハッカソンという限られた環境において、世界生成、3Dレンダリング、シーン解釈、対話型AI、音声合成を跨ぐパイプラインを構築し、36時間でそのループを完璧に完結させたことこそが、彼らの功績です。
STEM実験モードは、チーム自身にとっても際立った成果でした。指示ではなく対話を通じて科学を教えることは、学生とコンセプトの関係性を変えます。光合成の過程を暗記するのではなく、自分の行動に反応する光合成を目の当たりにする。その違いは、想像以上に大きな意味を持っています。
今後の展開
世界生成の品質が最も明確な改善の余地です。ガウシアンスプラッティングによってフォトリアルな環境が作成されますが、現在の解像度には限界があります。チームは、単一のプロンプトから生成される世界の忠実度と規模の両方を拡大したいと考えています。
より大きな野望はVRへの対応です。画面上の3D世界も良いですが、実際にその中に立ち、体を使って動き回り、オブジェクトに手を伸ばして質問する。それこそが、学習と体験の隔たりを完全に埋めるAtlasの真の姿です。
より大きな構想
教育は常に正しい意図を持ってきました。その意図を実現するためのツールが遅れていたのです。
Atlasが提示しているのは、真に新しいモデルの始まりです。環境が教育を担い、文脈に沿って質問に答え、概念とそれを実感として理解するまでの距離が消滅する世界です。これを構築する技術は、何年も前から断片的には存在していました。変わったのは、それらの断片を組み合わせて、学生が実際に歩き回れるものを作り上げたという点です。
それこそが、36時間を費やす価値のある問題であり、完成までに36時間以上を要するような答えなのです。