
2026年コーディングに最適なLLMとは?主要6モデルを実機比較
2026年にコーディングへ最適なLLMを比較検証。精度・プライバシー・速度の観点でクラウドAIアシスタントとローカルLLMモデルを徹底比較し、開発ワークフローを最適化します。
コーディングに最適なLLMを探し始めたとき、私たちのチームはすぐに、ベンチマークのスコアだけでは不十分だと気づきました。もつれたコードベースと格闘したり、現代のワークフローと噛み合わない従来型バックエンドの巨人を評価したりと、日々深刻な複雑さに直面しているのです。
モデル選びは、あなたが今まさにぶつかっている課題によって完全に変わることを私たちは学びました。フロンティアクラウドモデルは複雑なアプリケーションに必要な深い推論力を提供しますが、独自性の高いエンタープライズコードを扱う場合は、セルフホスト型アーキテクチャが譲れない選択肢になります。
このガイドでは、私たちが実際に得た経験を共有します。評価基準を分解し、実際にテストした上位6モデルを分析、自律型開発エージェントを紹介し、開発者コミュニティのコンセンサスをレビューします。最高のコーディングLLMからクラウドホスト型の巨人まで、あなたのエコシステムを本当に最適化するツールがどれか、具体的に見えてくるはずです。
開発者向けLLMの中核評価基準
信頼できるコーディングアシスタントと単純な会話型ボットを区別するため、私たちは実際のソフトウェア開発を反映する5つの基本指標で各モデルを評価しました。
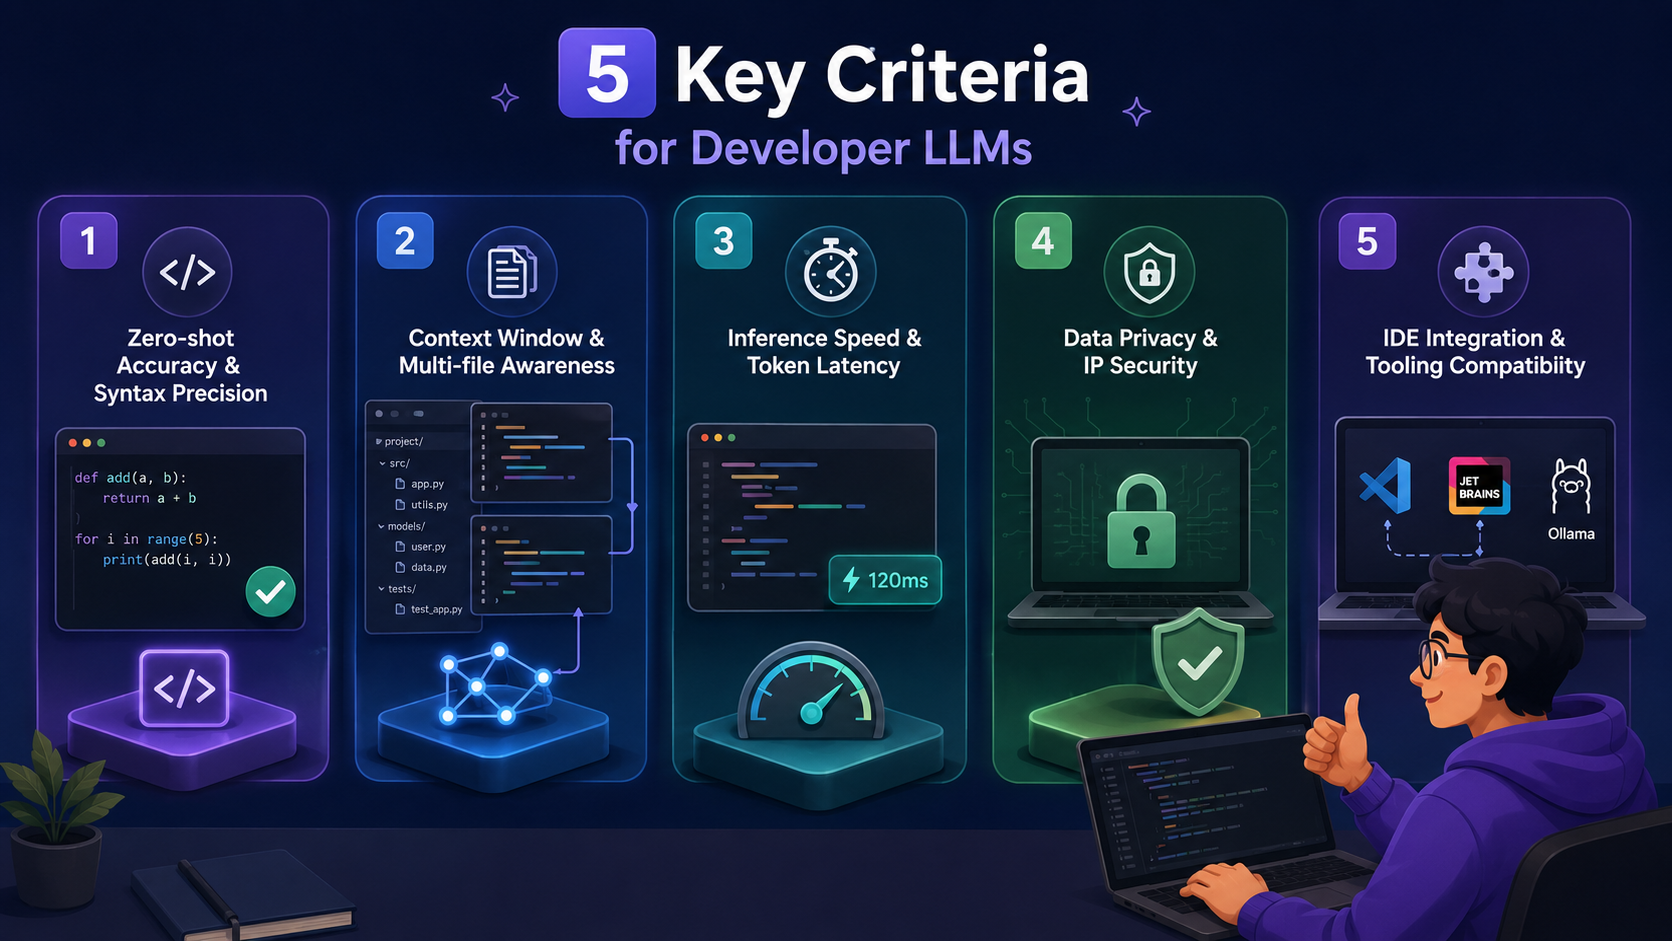
- ゼロショット精度と構文の正確性: 初回の試行でどれだけ信頼性の高い、動作するコードを生成できるかを測ります。優れたモデルは即座にクリーンな構文を書き、存在しないライブラリを創作したり、廃止されたAPIを参照したり、見えにくいロジックバグを混入させたりしません。
- コンテキストウィンドウとマルチファイル認識: 現代のソフトウェアが単一ファイルに収まることはほとんどありません。プロジェクト全体にまたがる相互関連の変数、依存関係、アーキテクチャのロジックを混乱なく追跡できるか、モデルの「作業記憶」を評価しました。
- 推論速度とトークンレイテンシ: 速度は開発者のフロー状態に直結します。インラインの提案やリアルタイムの自動補完が、目立った入力遅延なく即座に表示されるか、応答時間をテストしました。
- データプライバシーとIP保護: 独自コードの保護はどのチームにとっても重要です。クラウドAPIのデータ保持ポリシーを確認し、オフライン・エアギャップでの動作をテストして、機密性の高いエンタープライズコードが完全に非公開であることを確認しました。
- IDE統合とツール互換性: 強力なモデルも、開発者の日々のワークフローに自然に組み込めなければ意味がありません。VS CodeやJetBrainsといった主要エディタ、Ollamaのようなローカル実行環境への接続のしやすさを評価しました。
主要カテゴリ別のコーディング最適LLM6選
急速に変化するAIの世界をうまく進むには、ハードウェアの制約、プライバシー要件、アーキテクチャのワークフローの複雑さに合わせて、2026年のコーディング最適LLMを見極める必要があります。
| モデル名 | カテゴリ | 主な強み | 最適な用途 |
|---|---|---|---|
| Claude Opus 5 | フロンティアクラウド | 複雑なエージェント型コーディング | 大規模リファクタ&エージェントループ |
| GPT-5.6 Sol | フロンティアクラウド | 決定論的なタスク遂行 | マルチステップタスク&プロトタイピング |
| GLM-5.2 | ローカル/オープンウェイト | 100万トークンのコンテキストウィンドウ | セルフホスト型のフロンティア級コーディング |
| DeepSeek V4-Pro | ローカル/オープンソース | 競技プログラミング | 大量API処理&数学 |
| Qwen3-Coder-Next | 軽量 | パラメータ当たりの効率 | 控えめなローカルハードウェア |
| Gemini 3.7 Flash | 軽量/低コスト | 複雑なエージェントタスク | 大量作業&リファクタ |
フロンティアクラウドAIモデル(最大級の推論力とコンテキスト)
これらのモデルは大規模なリモートサーバークラスターでプロンプトを処理するため、ローカルハードウェアでは到底サポートできない広大なコンテキストウィンドウと複雑なマルチステップ推論を扱えます。複雑なシステムアーキテクチャの設計に最適です。
- Claude Opus 5
開発スタックの選択肢を評価していく中で、Claude Opus 5は実務的なエンジニアリング、大規模リファクタ、マルチステップのエージェントループにおいて最高のコーディングLLMだと感じています。Anthropicは、Haiku 4.5、Sonnet 5、Opus 5、Fable 5といった階層でClaude系LLMを開発しており、現在、複雑なソフトウェアタスクの検証済みリーダーボードで首位を走っています。
| バージョン | メモリサイズ(コンテキスト) | 最適な用途 | 簡単に言うと |
|---|---|---|---|
| Claude Fable 5 | 超大規模(100万トークン) | 専門研究&長期タスク | 複雑な科学研究やサイバーセキュリティ業務向けの超高級モデル |
| Claude Opus 5 | 超大規模(100万トークン) | 重量級リファクタ&エージェントループ | 複雑なマルチファイルコードベース向けのトップクラスの頭脳 |
| Claude Sonnet 5 | 超大規模(100万トークン) | バランスの取れた日常開発 | 日々のコーディング作業の信頼できる主力 |
| Claude Haiku 4.5 | 高(20万トークン) | クイックスクリプト&高速デバッグ | 無料層モデル: 速度とゼロコストのために作られた軽量な短距離型 |
メリット:
- 業界最高クラスのゼロショットコーディング精度と、積極的な検証動作を両立。
- 大規模なマルチファイルコードベースを無理なく読み込める巨大なコンテキストウィンドウ。
- 主要なエージェント型コーディングベンチマークで非常に高いスコア。
デメリット:
- 動作には常時インターネット接続と厳密なクラウド依存が必要。
- 大規模開発チームではトークン使用コストが急速に膨らむ可能性。
最適な用途: 大規模なコードリファクタリング、フルスタックのシステム設計、複雑なエージェント型ワークフロー。
- GPT-5.6 Sol
広範な言語構文カバレッジと幅広いエコシステム統合を誇る、万能型のフラッグシップモデルです。OpenAIはGPT-5.6で価格対性能のフロンティアを前進させました。ソフトウェア業務を効率的にこなす開発者にとって、非常に信頼できる日常の主力です。
| バージョン | 速度 | 対応環境 | 簡単に言うと |
|---|---|---|---|
| GPT-5.6 Sol | 高速 | 主要IDE&エージェントフレームワーク | マルチステップタスクを着実に処理する頑丈なアシスタント |
| GPT-5.6 Terra | 中程度 | 標準的な開発ツール | 着実な段階的問題解決向けのバランス型APIバージョン |
| GPT-5.6 Luna | 超高速 | Web&軽量ツール | 無料層モデル: 高速なコード生成のための無料の日常アシスタント |
メリット:
- 長いマルチステップタスクでも軌道を外れず、着実な決定論的遂行力を維持。
- 主要な拡張機能や開発者プラットフォームとの深いエコシステム互換性。
- 珍しい言語やレガシー言語も含めた包括的な学習カバレッジ。
デメリット:
- 簡潔なスニペットよりも、冗長なボイラープレートを生成することがある。
- 非常に長い会話セッションではコンテキスト記憶が低下する場合がある。
最適な用途: 決定論的なマルチステップタスク、迅速なプロトタイピング、API統合。
主要なオープンソース&ローカルLLM(エンタープライズのプライバシーとカスタマイズ)
知的財産の安全性を最優先する組織にとって、ローカルLLMモデルをオフラインで動かすことで、独自コードが一切サードパーティのサーバーに送信されないことを保証できます。これらのモデルはエンタープライズコンプライアンスに大きな力を発揮します。
- GLM-5.2
現在利用可能な最高のオープンウェイト型コーディングモデルで、絶大なファインチューニングの可能性を提供します。GLM-5.2は長期タスク向けに作られたフラッグシップモデルで、100万トークンという確かなコンテキストでこの能力を実現しています。
| バージョン | 必要な環境 | 性能レベル | 簡単に言うと |
|---|---|---|---|
| GLM-5.2(大) | 重量級のエンタープライズデータセンター | トップクラスの知能 | 100万という巨大なメモリウィンドウを持つ最高のオープンウェイトコーダー |
| GLM-5.2(小) | 標準的なノートPC | 日常的なサポートに最適 | 完全無料&ローカル: APIコストなしでノートPC上でオフライン直接動作 |
| GLM-5.2クラウド | ウェブブラウザ/API | 高い推論力 | 無料のウェブアクセス: セットアップ不要で試せるブラウザベースツール |
メリット:
- 長期エンジニアリングタスクにおいて非常に競争力のあるオープンウェイトモデル。
- リポジトリ全体をローカルで取り込める、巨大な100万トークンのコンテキストウィンドウ。
- 企業利用や商用開発に対応した寛容なオープンライセンス。
デメリット:
- ローカルで100万トークンのコンテキストウィンドウを完全に活用するには、ハイエンドなエンタープライズ級ハードウェアが必要。
- オープンウェイトモデル自体は無料でダウンロードできるが、大規模運用には高価なサーバーリソースが必要。
最適な用途: フロンティアに近いコーダーのセルフホスティングと、絶対的なエンタープライズデータプライバシーの維持。
- DeepSeek V4-Pro
高度なコーディングタスク専用に作られた高性能モデルです。DeepSeekはフロンティア級LLMを開発・オープンソース化しており、数学的ロジックと複雑なアルゴリズム構造において実力以上の力を発揮し、大規模なテキスト生成に対応する1.6兆パラメータという巨大構成を備えています。
| バージョン | 主な強み | 最適な用途 | 簡単に言うと |
|---|---|---|---|
| DeepSeek V4-Pro | 競技プログラミング&数学 | エンタープライズ級リポジトリ | アルゴリズムと複雑なロジックに優れた専門コーディング脳 |
| DeepSeek V4 | 汎用推論&構文 | 日常のスクリプト&研究 | 無料ウェブ版: 日常のライティングと基本的なコード向けの万能チャットボット |
| DeepSeek-Coder 7B | 軽量実行 | オフラインのローカル開発 | 完全無料&ローカル: 自分のPC上で動かせる、非公開でコストゼロのモデル |
メリット:
- アルゴリズムと競技プログラミングのタスクに非常に優れている。
- セルフホストすれば、厳格なデータ所在地要件に対応する絶対的なデータプライバシーを提供。
- 幅広い数学的推論力と大量API処理能力。
デメリット:
- フルパラメータ構成にはエンタープライズ級のGPU VRAMが必要。
- セットアップと量子化のファインチューニングには高度な技術知識が必要。
最適な用途: プライバシーに敏感なエンタープライズリポジトリ、大量API処理、アルゴリズム問題の解決。
専門特化&軽量コーディングモデル(高速自動補完&低レイテンシ)
これらのモデルは大幅に量子化され、コンシューマー向けノートPCでネイティブにバックグラウンド動作するか、クラウド上でコスト効率よく動作するよう明確に最適化されています。効率を最大化する、素早いアシスタントとして厳密に機能します。
- Qwen3-Coder-Next
標準的なコンシューマー向けハードウェア上でのマルチ言語補完に最適化された、非常に効率的なコード特化型モデルです。最新のQwen3モデルはハイブリッド思考モードを採用し、推論性能・速度・コストを柔軟に制御できます。
| バージョン | 応答速度 | 対応言語範囲 | 簡単に言うと |
|---|---|---|---|
| Qwen3-Coder-Next | 高速 | 90以上のプログラミング言語 | 本格的なローカル開発環境向けのフラッグシップオープンウェイトエンジン |
| Qwen3-Coder(7B) | 即時 | 90以上のプログラミング言語 | 完全無料&ローカル: 標準的なノートPCでスムーズに動く、コード用の予測変換のようなもの |
| Qwen-Chat | 即時 | 標準的なコーディング&自然言語 | 無料ウェブ版: 構文チェックのための手軽でコストゼロの会話型ヘルパー |
メリット:
- 軽量なローカル環境において、パラメータ当たりの優れたコーディング効率を提供。
- 標準的なコンシューマー向けハードウェアや控えめなローカル環境でも、リソース負荷を最小限に抑えスムーズに動作。
- 90以上のプログラミング言語に対応する強力な多言語構文サポート。
デメリット:
- ソフトウェア全体のアーキテクチャを計画する際の推論の深さが限られる。
- 大規模クラウドモデルに比べコンテキスト保持ウィンドウが小さい。
最適な用途: 行単位の自動補完、および標準的なノートPCでモデルを動かす開発者。
- Gemini 3.7 Flash
低コストなクラウド運用と複雑なエージェント構成を明確に意識して設計された、流暢なコーディングアシスタントです。Gemini 3.7 Flashは、大規模な複雑なエージェントタスクへの対応に最も適しています。
| バージョン | 得意なこと | 動作環境 | 簡単に言うと |
|---|---|---|---|
| Gemini 3.7 Flash | 大規模な複雑エージェントタスク | クラウドAPI | 大規模コードベースと複雑なワークフロー向けの高速クラウドアシスタント |
| Gemini 3.5 Flash-Lite | 大量処理タスク | クラウドAPI | 充実の無料APIプラン: 効率性と知能のために作られた軽量モデル |
| Gemini Web | 一般的なチャット&コードスニペット | ウェブブラウザ | 無料ウェブ版: 関数の下書きや質問への回答に使える、シンプルな無料アシスタント |
メリット:
- 大量のエージェントワークフローに対して驚異的な効率性。
- 巨大なコンテキストウィンドウに対応し、巨大なコードベースも簡単に読み込める。
- 高速なトークン配信速度で、迅速なデバッグやリアルタイム編集が可能。
デメリット:
- 厳密にクラウドAPIとして動作するため、極度のプライバシー要件に向けたエアギャップ化やセルフホストができない。
- ClaudeやGPTのような厳密なフォーマット要件に合わせるには、プロンプトの調整が必要になる場合がある。
最適な用途: コスト効率の良いクラウドコーディング、大量のエージェント作業、長いコンテキストを扱うタスク。
これらのLLMをどのようにテストしたか
主観的な偏りを排除するため、厳密に再現可能な技術的フレームワークで各モデルをテストしました。私たちのテストスイートは、確立された開発者向けベンチマークと、実践的な現場レベルのエンジニアリング課題を組み合わせています。
統制されたベースラインプロンプトテスト
2026年における純粋な推論力をテストするため、ChatGPTやClaudeといった業界リーダーのネイティブウェブインターフェースに、5つの同一のアーキテクチャリファクタリングプロンプトを直接投入しました。
ステップ1:同一のアーキテクチャリファクタリングプロンプトを5つ用意する
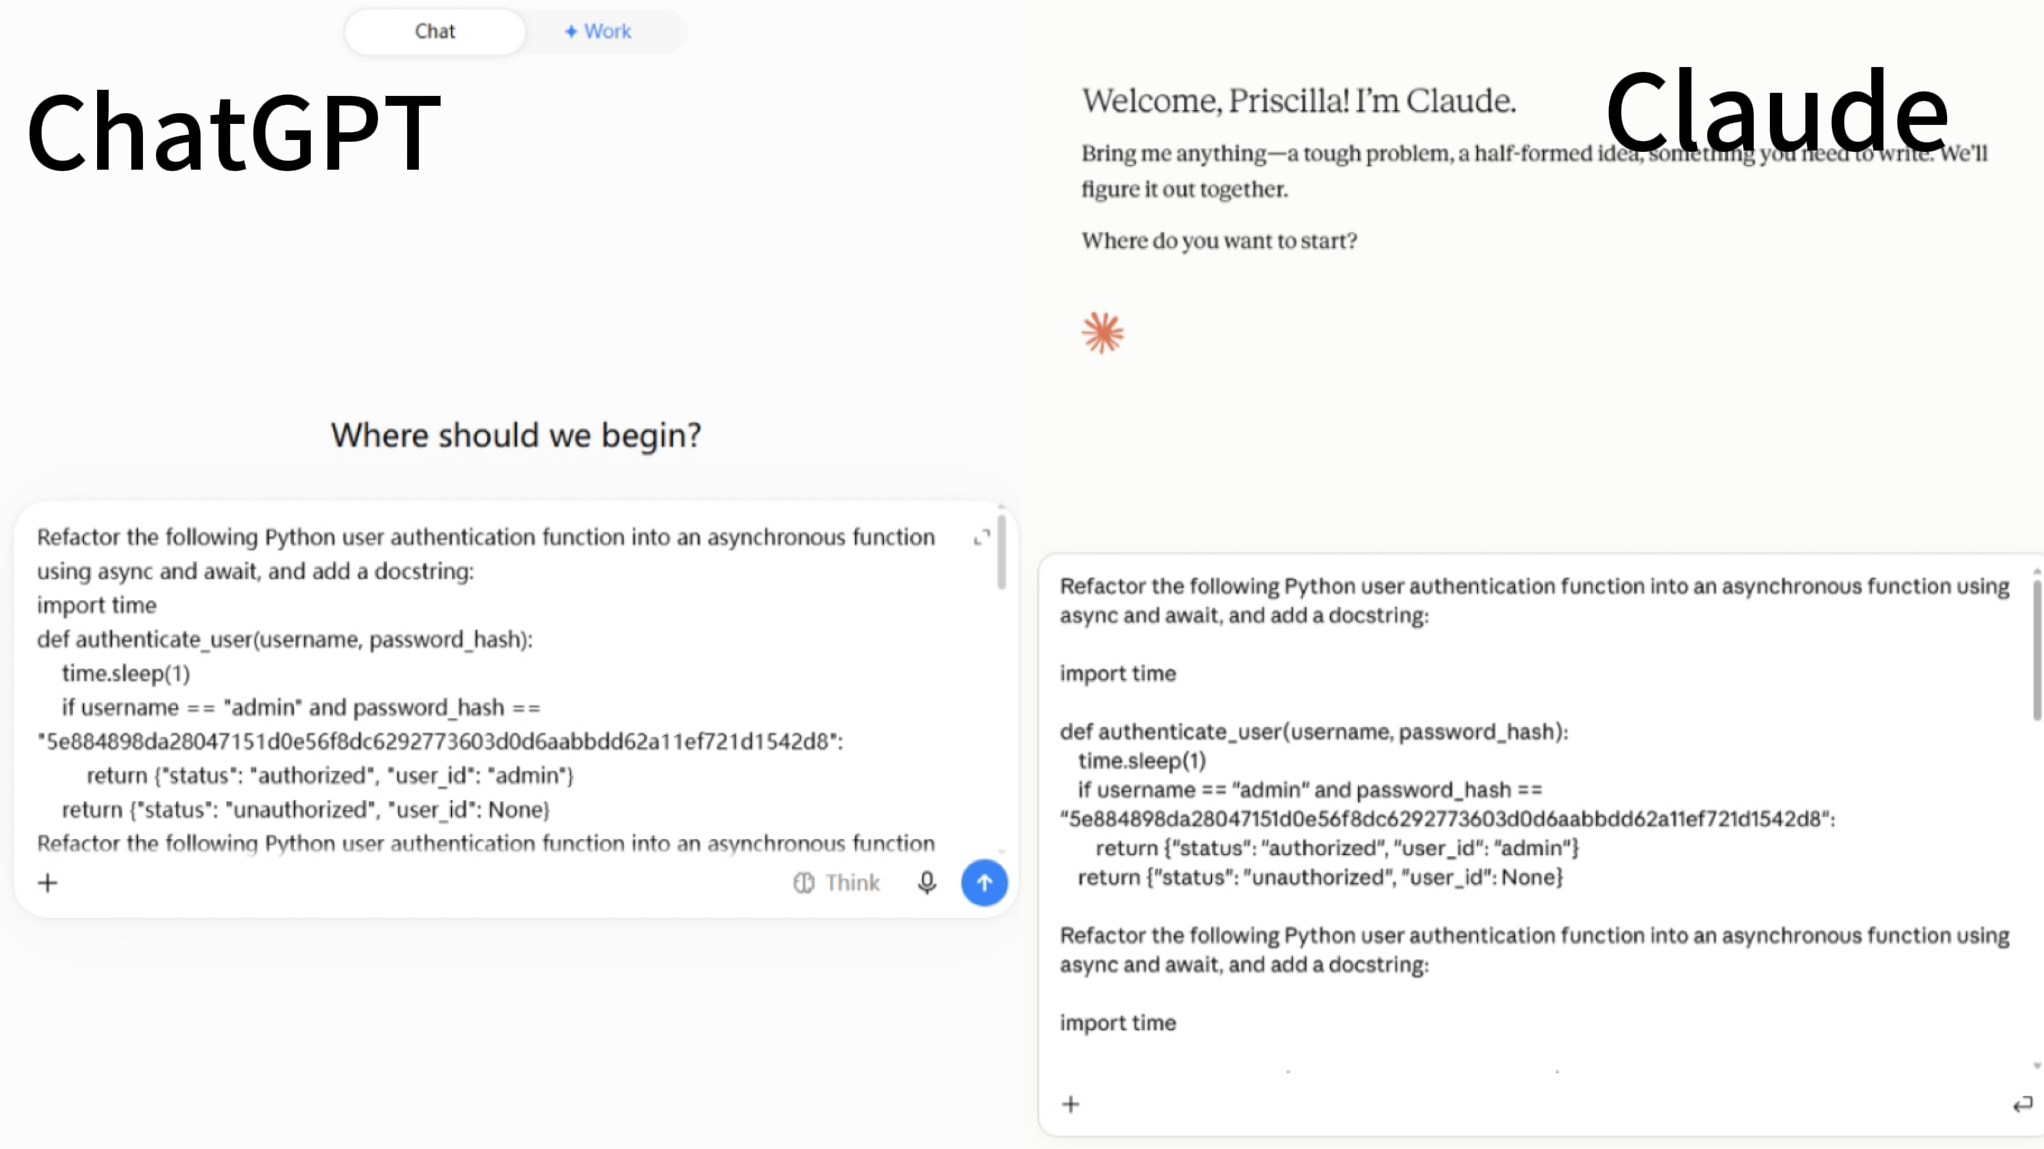
まず、統一されたアーキテクチャリファクタリングプロンプトを1つ作成し、内容が完全に一致することを確認した上で5回コピーしました。以下は例として示すプロンプトです。
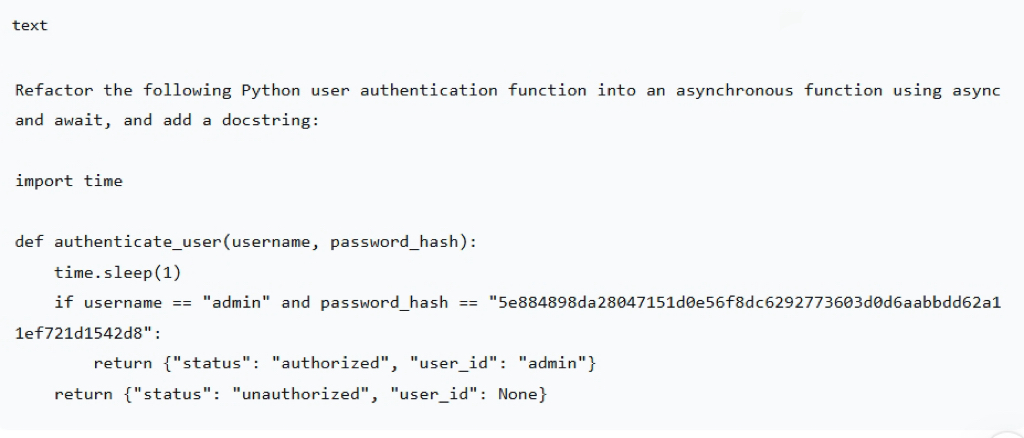
ステップ2:ChatGPT/Claudeのネイティブインターフェースでプロンプトを送信する
ChatGPTとClaudeのウェブインターフェースを開き、1つずつプロンプトを貼り付けて送信し、毎回の応答をすべて記録しました。
ステップ3:マルチファイルのロジック処理能力を評価する
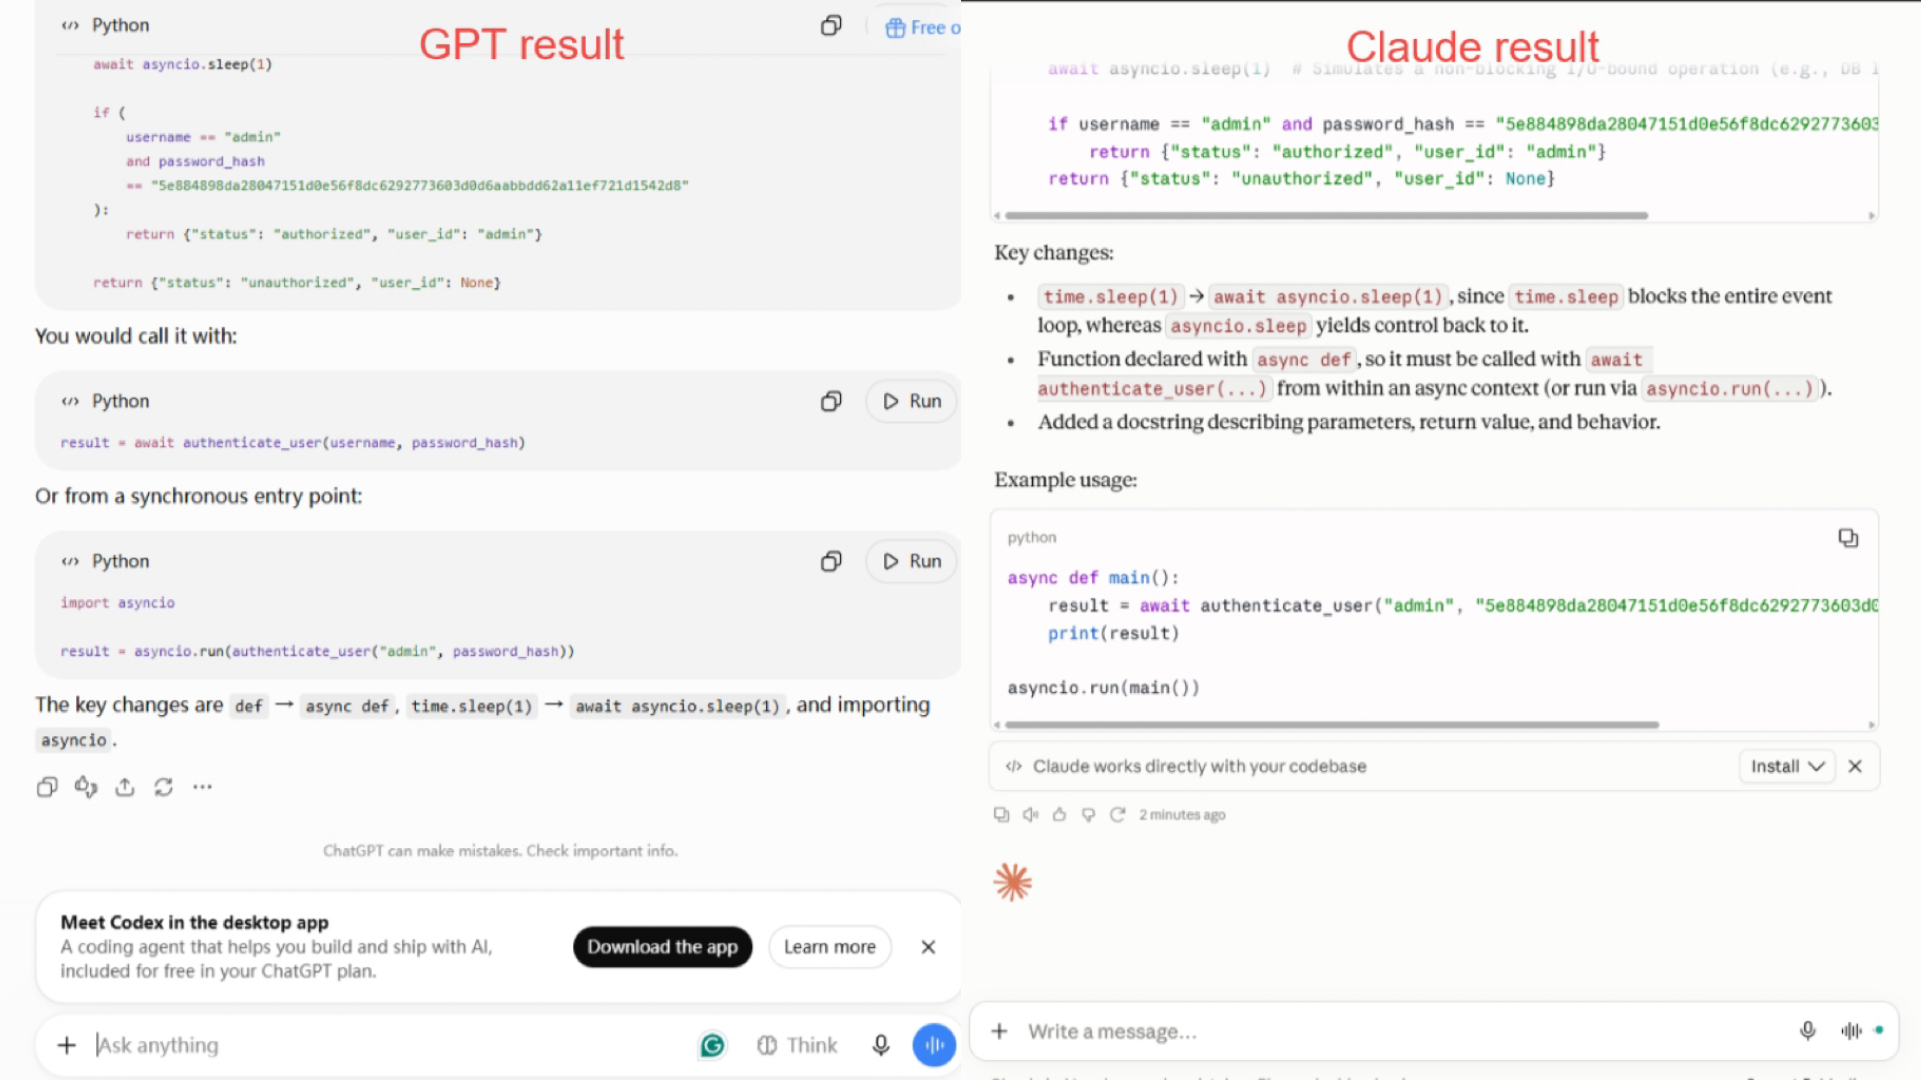
各ツールが結果を出した後、それぞれの本当の推論力を評価します。ChatGPTとClaudeを例に取ると、両モデルとも同じリファクタリングを正しく完了しましたが、出力のスタイルと重点が異なることが分かりました。ChatGPTは結果に加えて簡潔な使い方を示す傾向があり、Claudeは基礎となる原理を説明し、制約を強調する傾向があります。これは、同じ入力に対する両者の異なる推論と表現のスタイルを反映しています。
ローカルハードウェア負荷のプロファイリング
ローカルモデルは完全なデータプライバシーを提供しますが、実用的なハードウェア上で効率的に動く場合に限られます。Qwen3-Coder(7B)やDeepSeek-Coderのような軽量なオープンウェイトモデルを、実際のローカルワークステーション上で直接プロファイリングしました。
- トークン生成がピークに達した際のVRAM使用量とCPU負荷を監視し、実際のリソース限界を特定。
- 高価なエンタープライズ級ハードウェアを使わずに、開発者が安全なオフラインワークフローをセルフホストできるかを確認。
IDE統合とUXの摩擦
ライブ編集時にコード提案が鈍く感じられるなら、理論上のレイテンシ指標に意味はありません。Qwen3-CoderやGemini 3.7 Flashのような軽量モデルを標準的なコードエディタ内でテストし、ライブなインライン補完と入力遅延を評価しました。
- 予測的なゴーストテキストが開発者の自然な打鍵リズムに違和感なく追従するか、実際のレイテンシを評価。
- 隣接する開いているプロジェクトファイル間で変数を正しく読み込み、適用できているか、コンテキスト認識を検証。
独立実行環境での構文検証
チャットインターフェース上では正しく見えるコードも、実行時に動かないことがよくあります。DeepSeek V4-ProとGPT-5.6 Solが生成したスニペットを、独立したDockerコンテナ内で直接コンパイル・実行しました。
- 客観的なサンドボックス実行により、廃止されたメソッド、欠落したインポート、構文の幻覚を即座に検出。
- テストスイートを初回の試行で満たせるか、実際のPass@1率を追跡して確認。
単体のクラウドおよびローカルLLMはスニペットの生成や特定の関数の洗練には優れていますが、完全なアプリケーションを構築するには、手動でのIDE設定、ボイラープレートのセットアップ、フロントエンドとバックエンドの統合がまだ必要です。繰り返しのコーディングサイクルを完全に回避したい開発者やクリエイターにとって、自律型開発エージェントは構想からデプロイまでより速い道筋を提供します。
Enter Pro:迅速なソフトウェア開発のための自律型AI開発エージェント
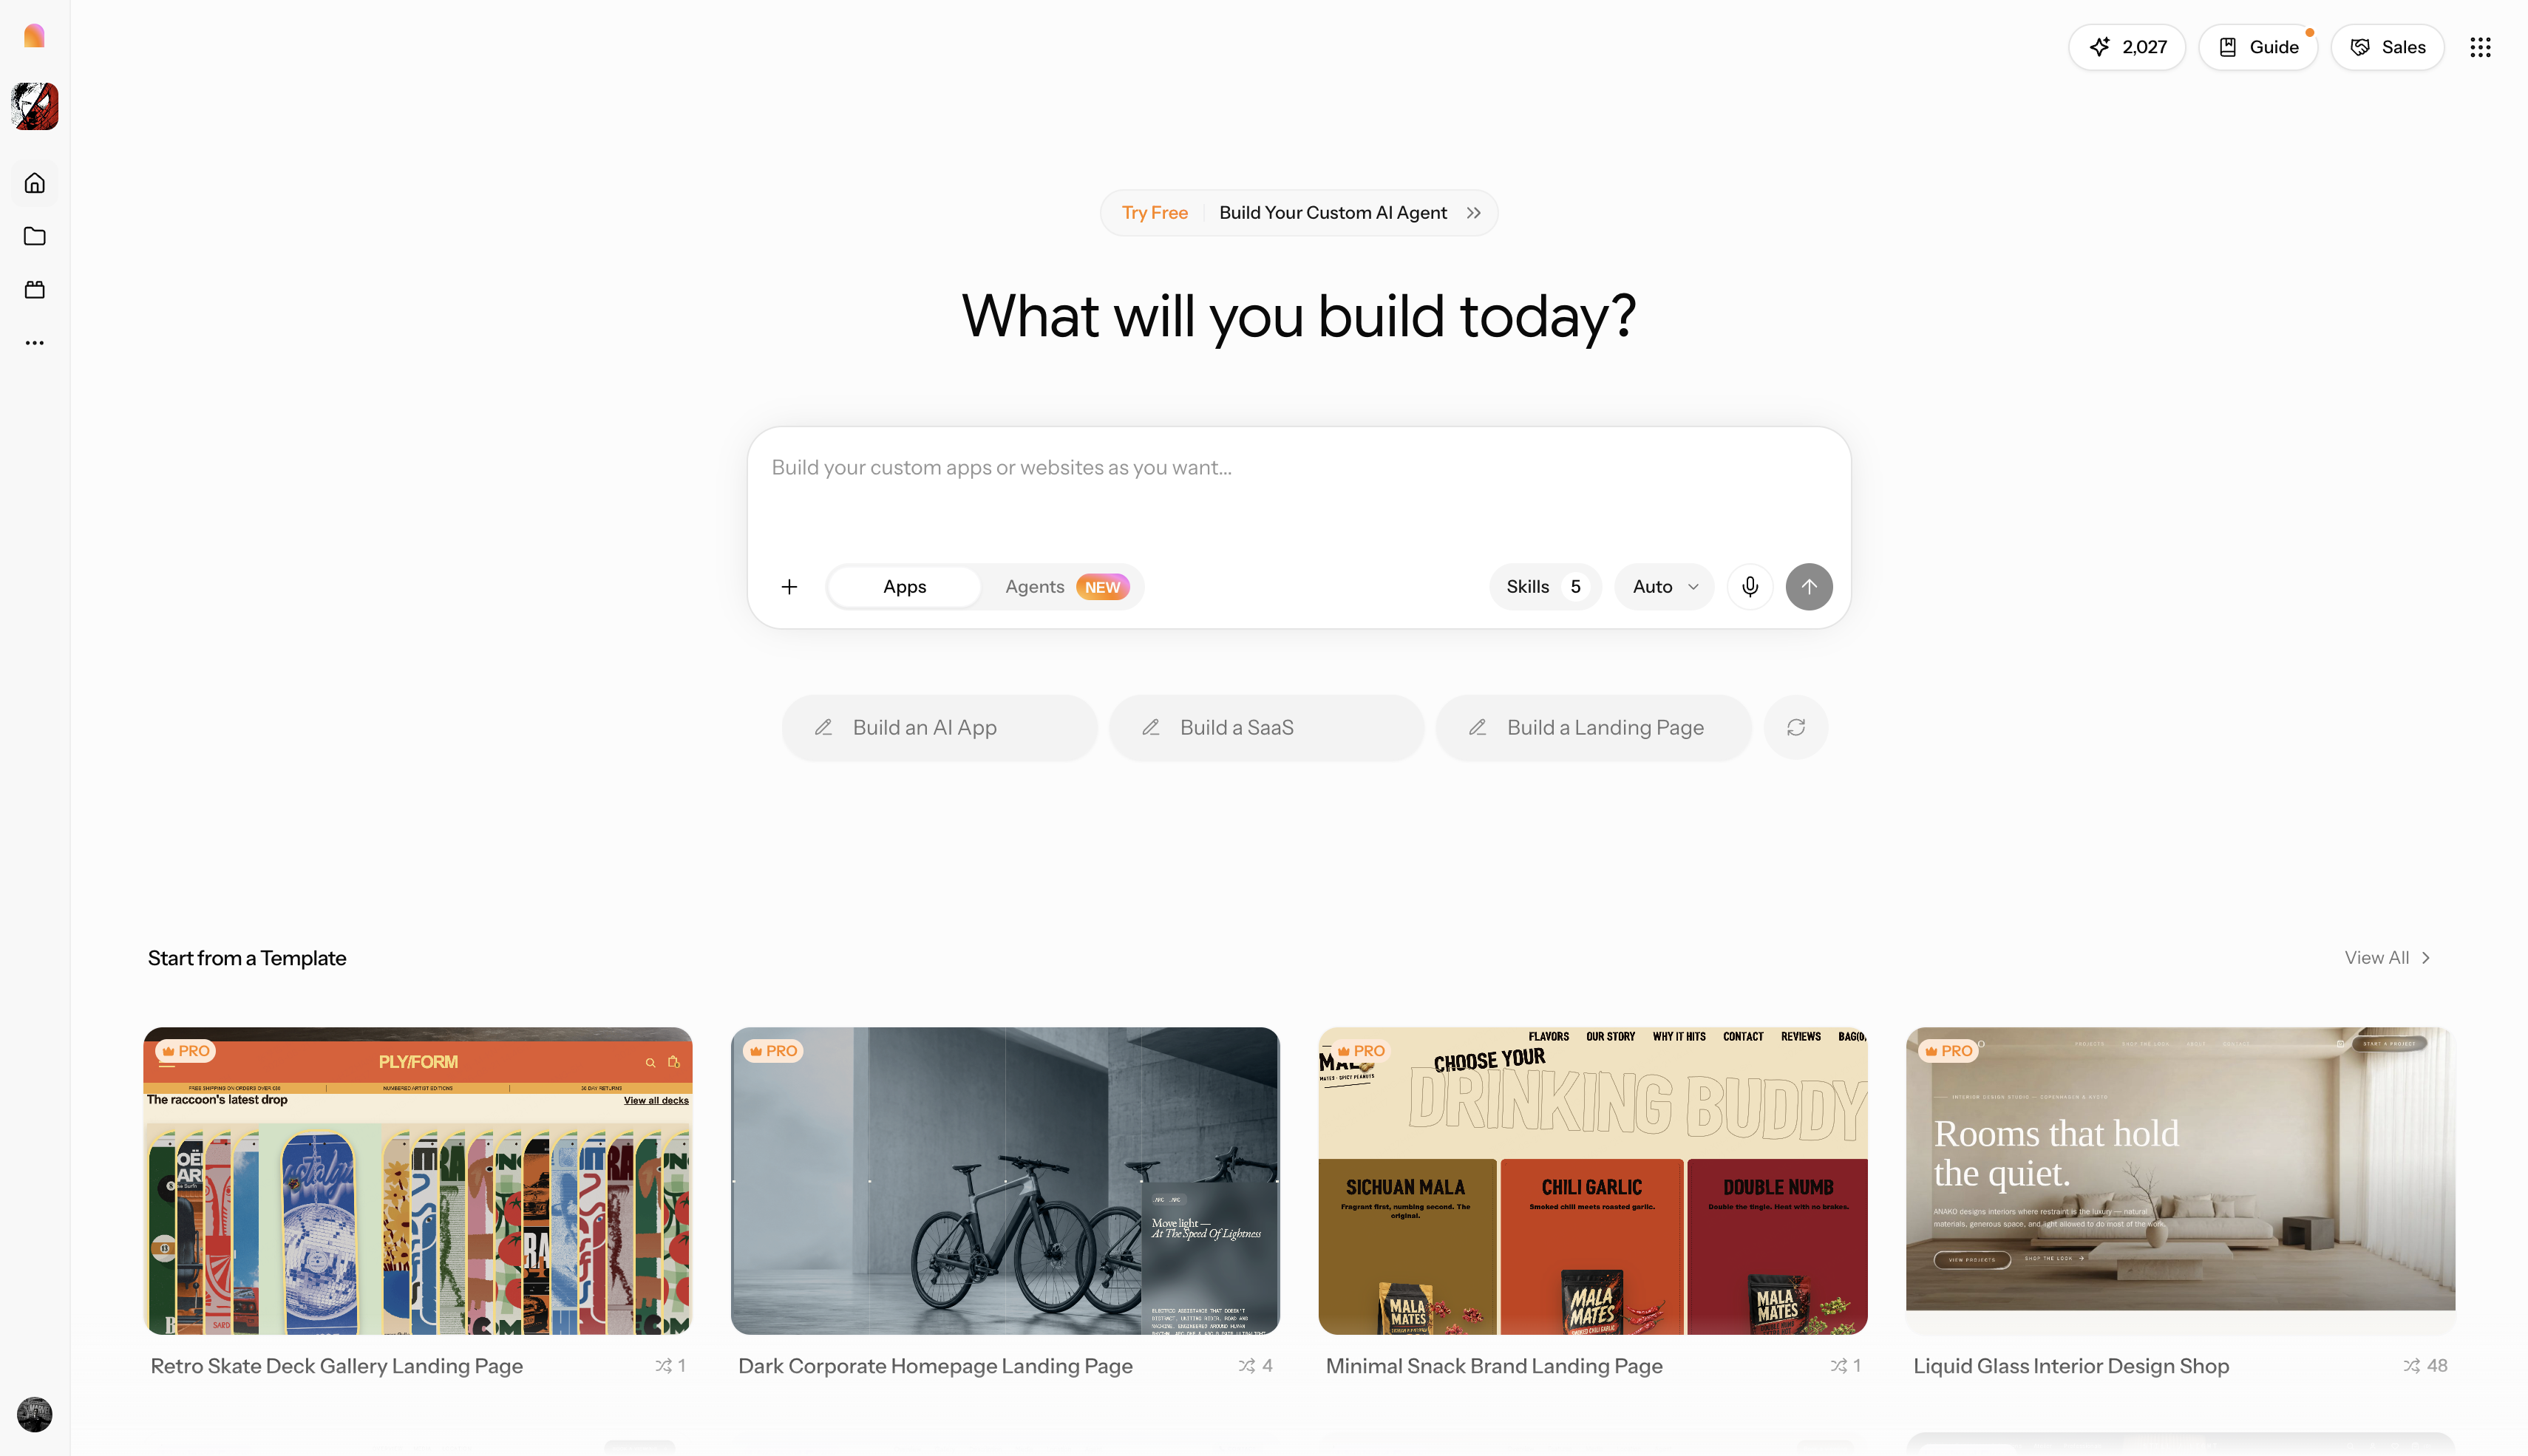
孤立した関数を書くことを超えて、アプリケーション全体を自律的に生成したいとお考えですか?Enter Proは、生のLLMチャットインターフェースと完全なフルスタックプロジェクト生成との間にある大きなギャップを埋めます。もはやローカル環境を手動で設定したり、システム依存関係を更新したり、複雑なパッケージマネージャーと格闘したりする必要はありません。このプラットフォームは代わりに、直感的なvibe coding向けプランモードを活用し、高レベルな自然言語プロンプトを、洗練された本番対応のソフトウェアへ直接変換します。
主な機能
- プロンプトベースの作成
ユーザーはウェブサイトのカラーテーマ、希望するレイアウト、含めたい機能ページを説明する自然言語のプロンプトを提供するだけです。Enter Proの統合エンジンが、フロントエンドとデータベースロジックを含む基盤的なフルスタックコードベースを即座に構築し、手動セットアップの時間を大幅に削減します。
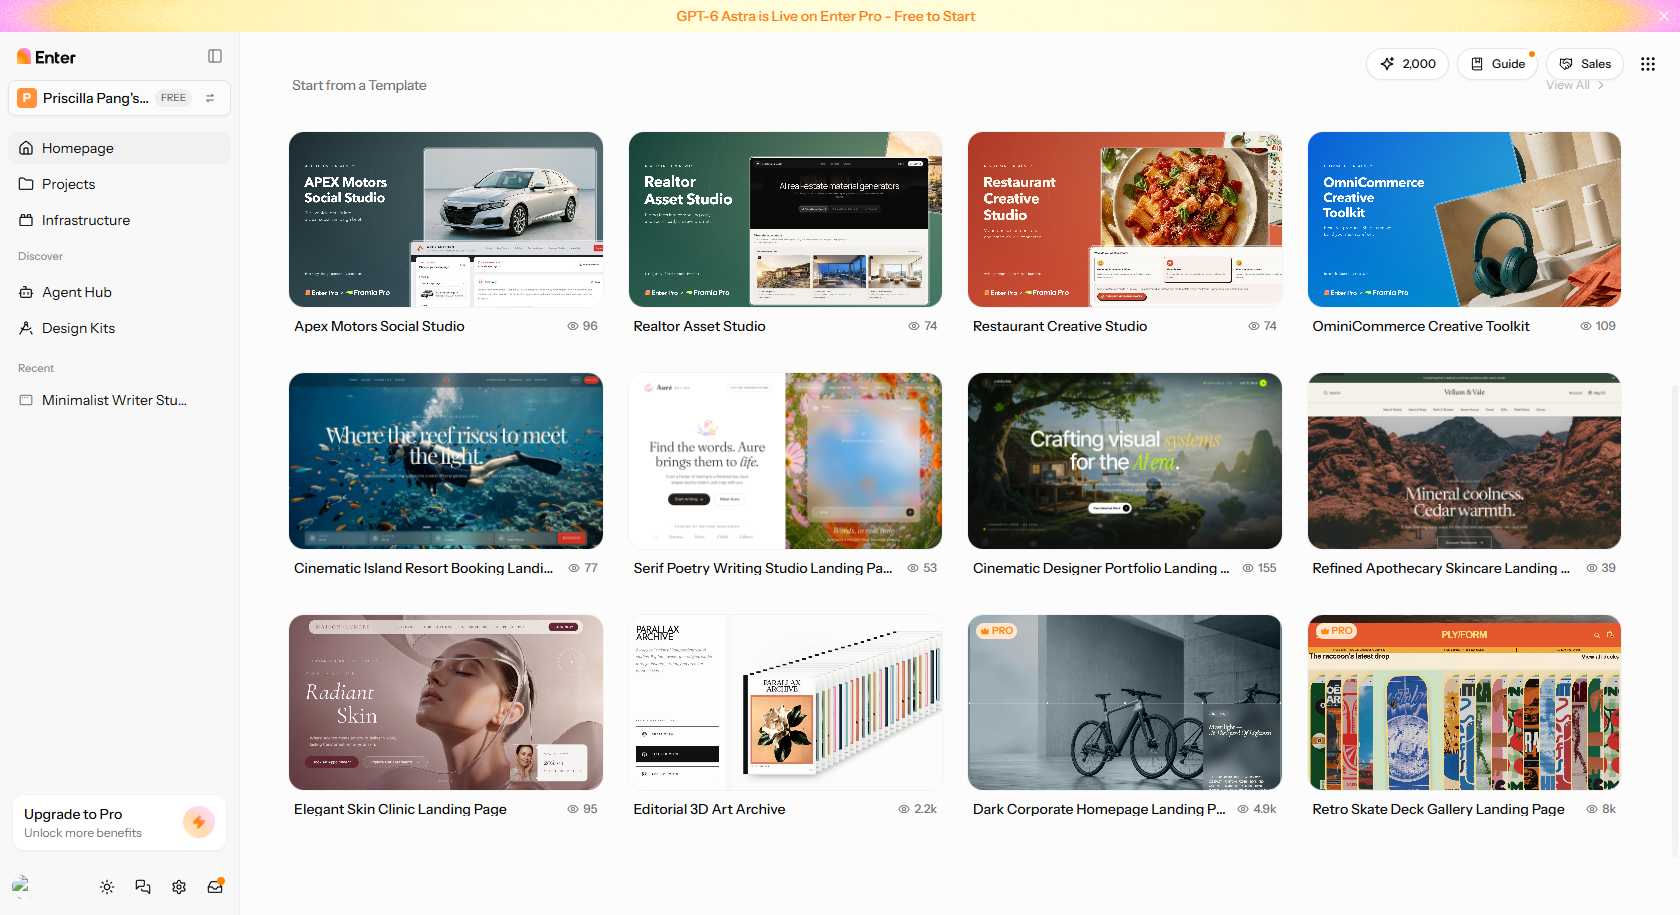
- すぐに使えるテンプレート
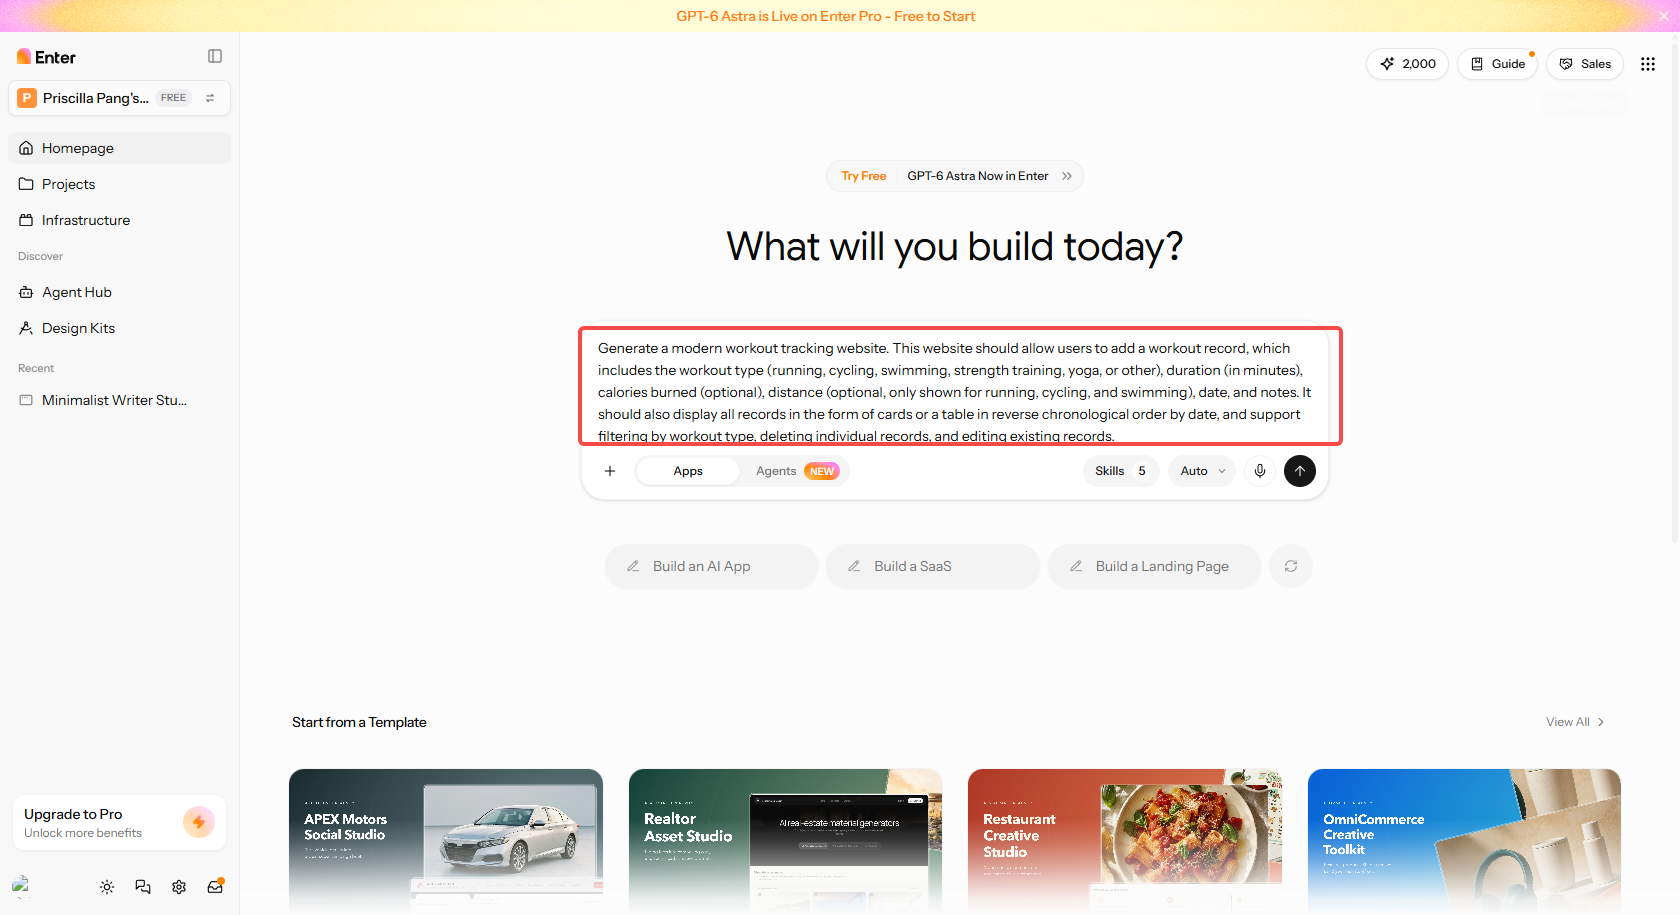
このプラットフォームは、極めて速いデプロイのために設計された、プロフェッショナルかつ完全レスポンシブなウェブサイトテンプレートを提供します。Enter Proはこれらのレイアウトを、最新のユーザーエクスペリエンス基準に厳密に準拠するよう特別に最適化しており、手動での見た目調整なしに高品質なアプリケーション提供を実現します。
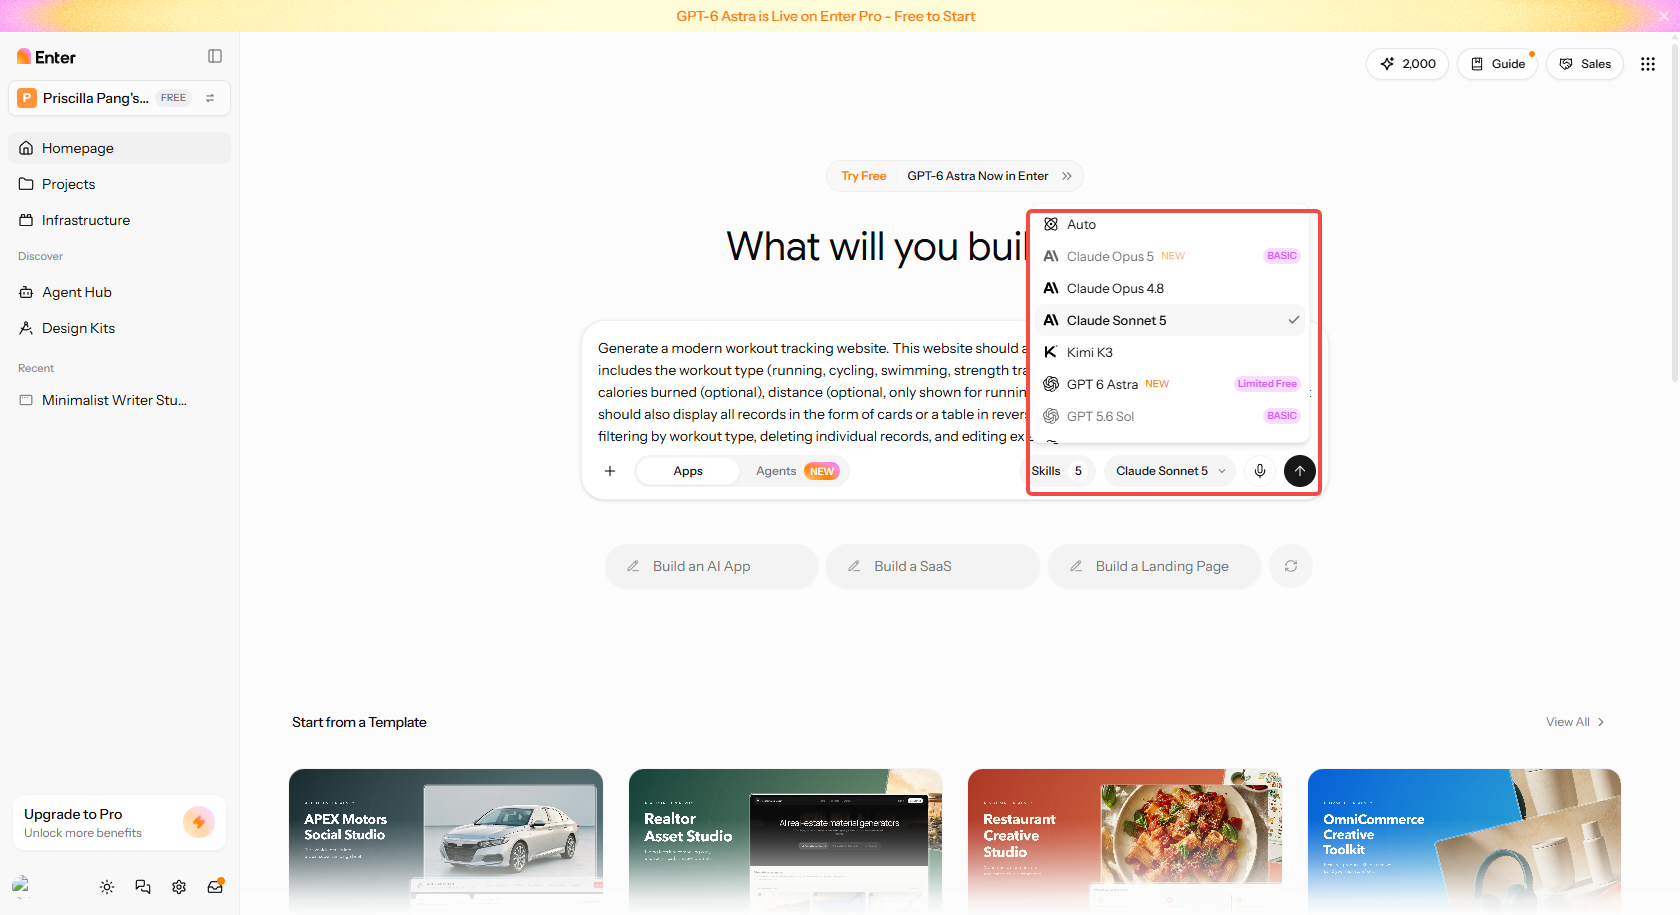
- 統合モデルアクセス
開発者は、Kimi K3、GPT 6 Astra、Claude Sonnet 5を含むトップクラスのコーディングアシスタントや高度なモデルを、単一のサブスクリプションのもとで、現在進行中のEnter Proビルドにネイティブに組み込むことができます。この効率化されたアプローチにより、異なるフロンティアモデルごとに個別のAPIキーを管理・保護するという管理上の悩みが完全に解消されます。
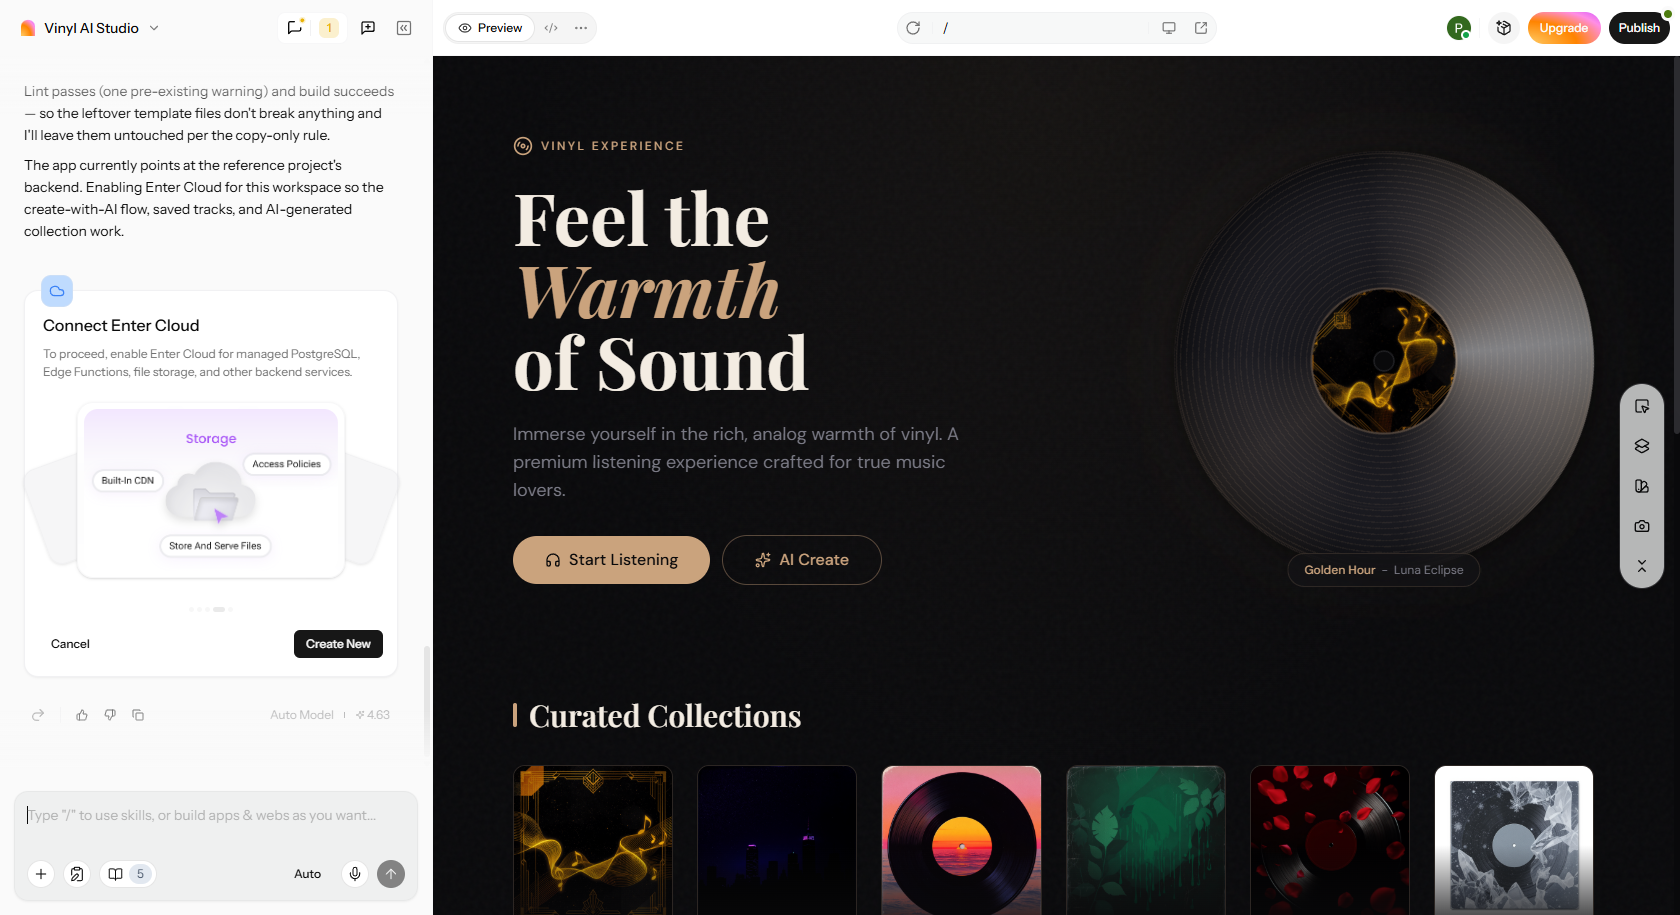
- 100%のコード所有権
Enter Proプラットフォームからエクスポートした時点で、生成されたソースコードに対する絶対的な管理権と完全な商用利用権があなたに残ります。これにより、制限的なベンダーロックインや将来のライセンス問題のない、真の独立性が保証されます。
アプリケーション構築のステップガイド
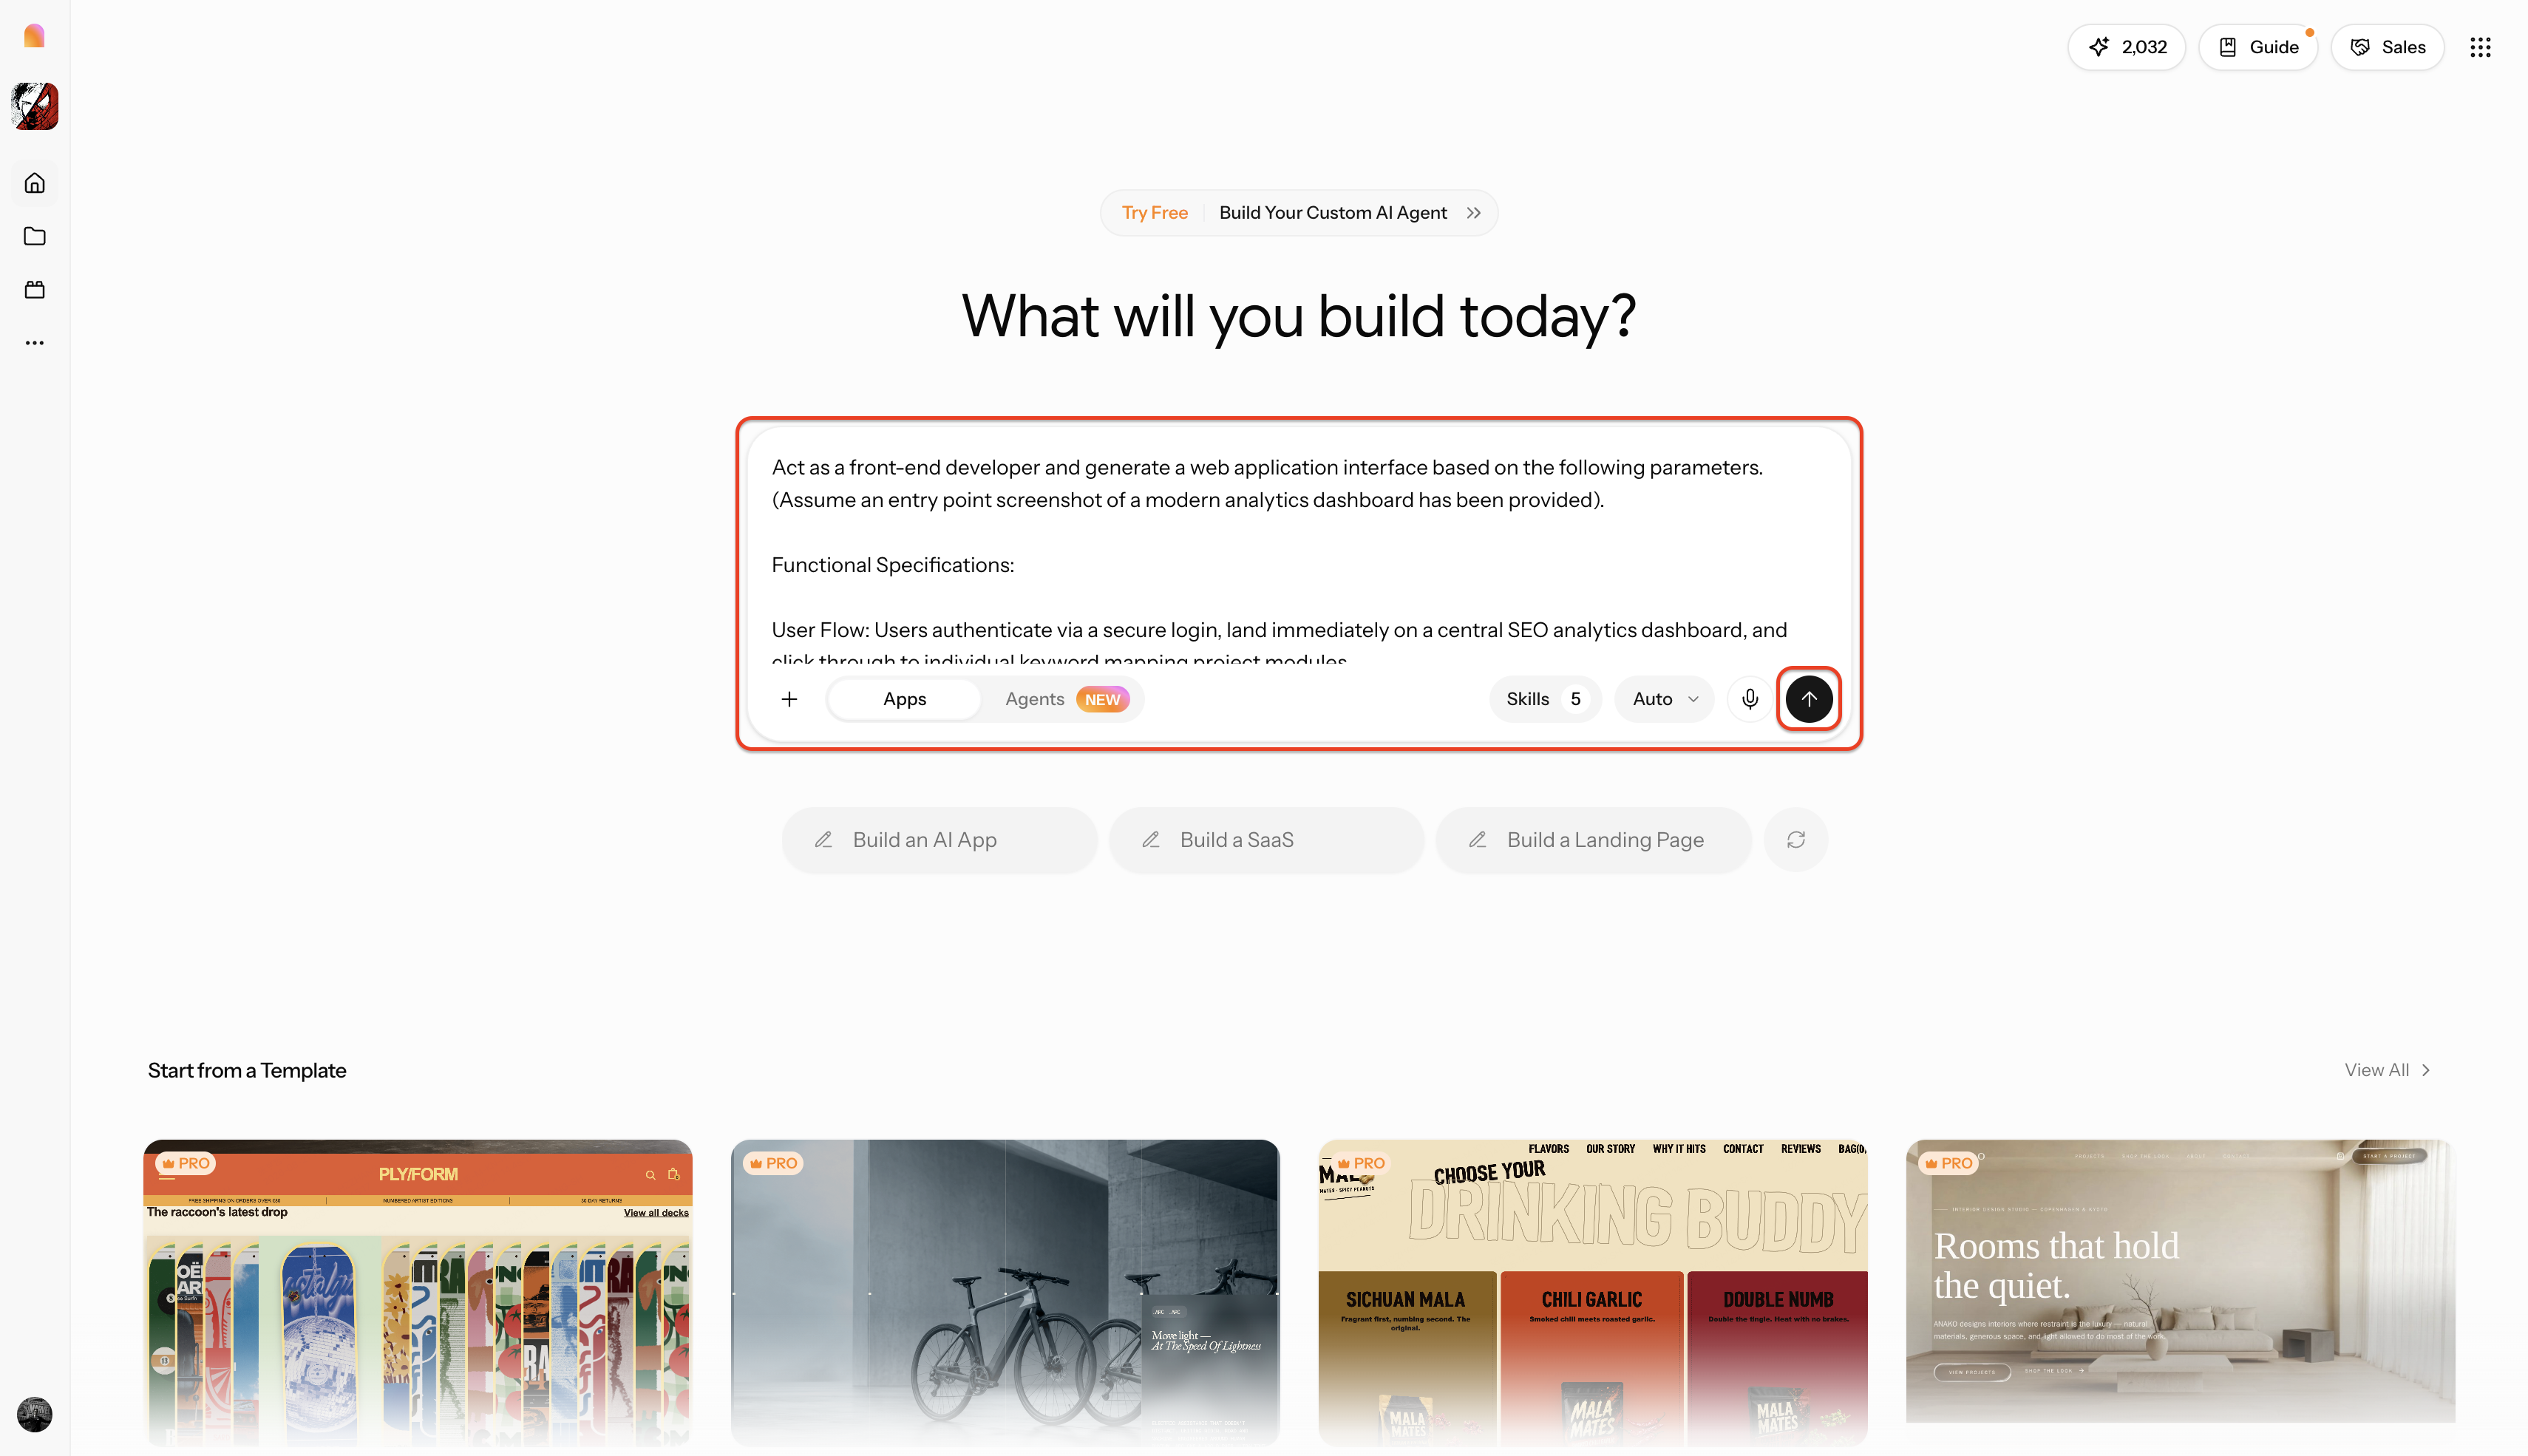
ステップ1:Enter Proを起動し、プロジェクトのプロンプトを入力する
機能要件、UIのスタイル好み、目指す機能を完全に自然言語で定義することから始めます。UIの入口画面のスクリーンショットを簡単にアップロードすることで、最初からAIの構造的・美的な理解を導くことができます。
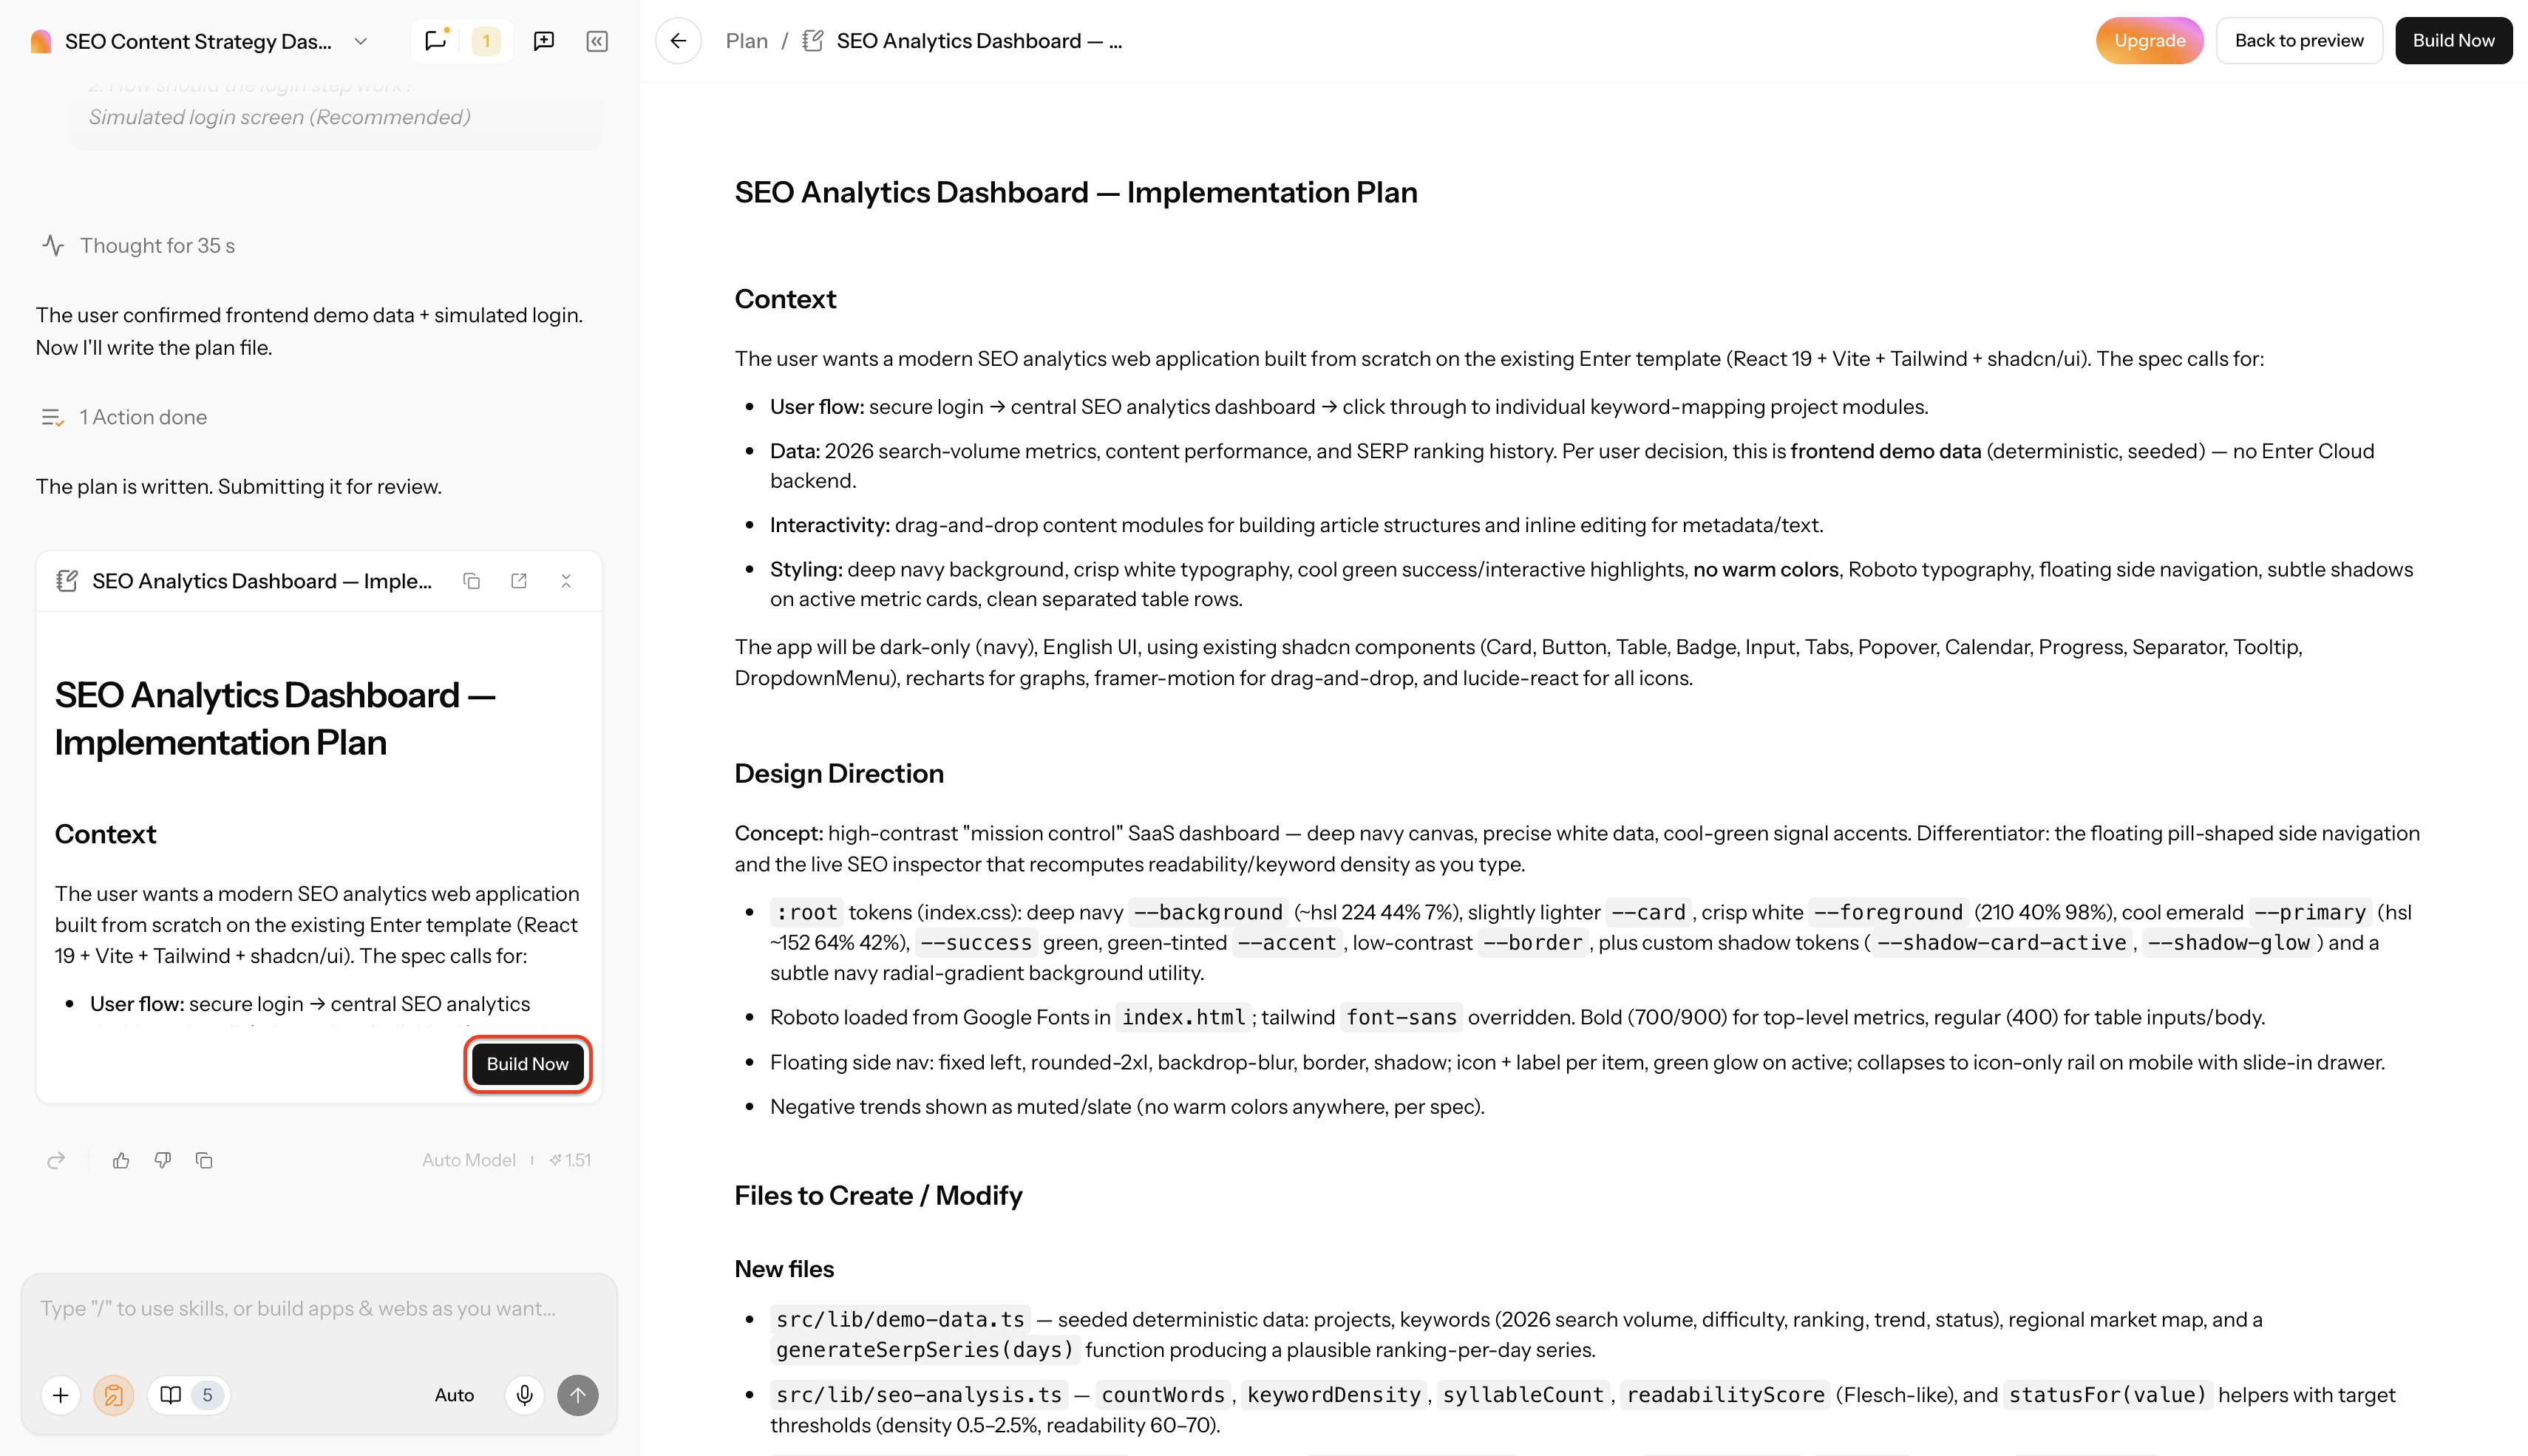
ステップ2:実装プランを確認し、ビルドする
アプリのコンテキスト、デザインの方向性、必要なファイル構造を概説するAI生成プランを確認します。準備ができたら、「Build Now」ボタンをクリックするだけでフルスタックのコード生成プロセスが始まります。
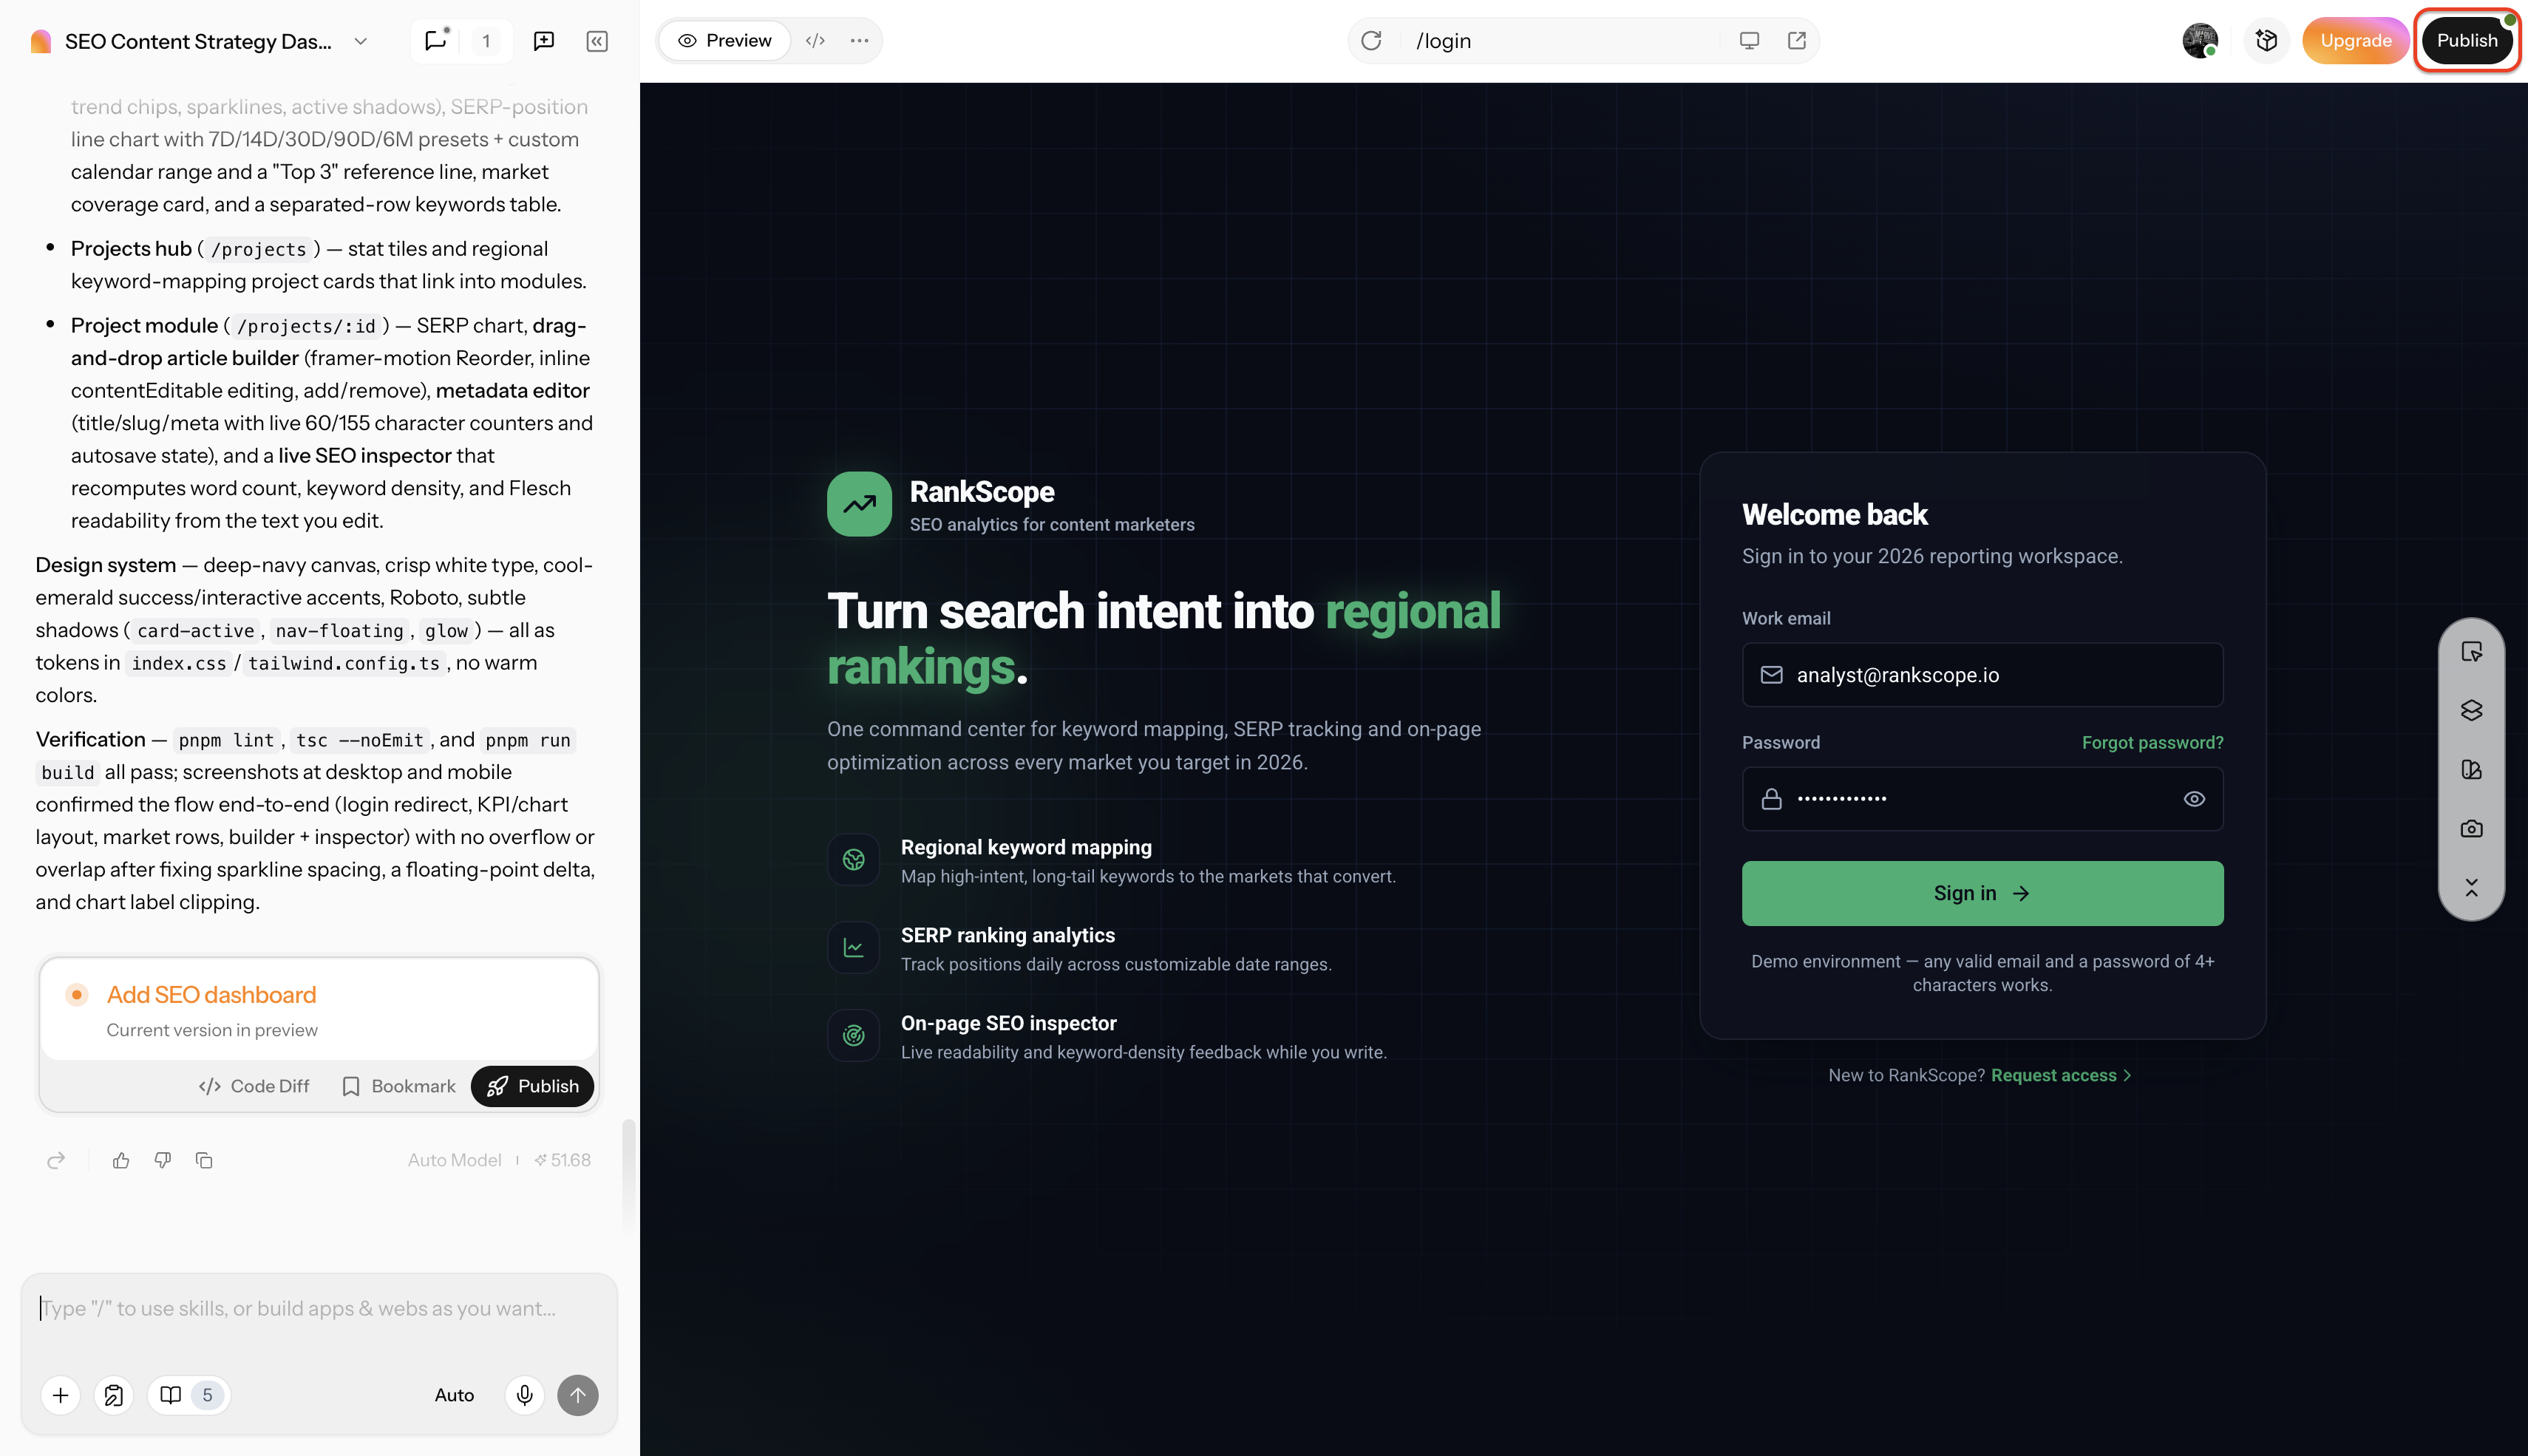
ステップ3:編集、公開、エクスポートする
シンプルなプロンプトの記述、またはビジュアルエディタを使って、生成されたアプリケーションを改良します。結果に満足したら、ワンクリックでアプリケーションをウェブ上に公開するか、構造化されたソースファイルをローカルマシンに安全にエクスポートできます。
クラウドLLM vs. ローカルLLM vs. 自律型AIエージェント:パフォーマンスとプライバシーのトレードオフ
最も適切なアーキテクチャを選ぶには、現在のエンジニアリング環境に存在する根本的なトレードオフを深く分析する必要があります。
| 観点 | フロンティアクラウドLLM | セルフホスト型ローカルLLM | 自律型エージェント(Enter Pro) |
|---|---|---|---|
| データプライバシー | クラウドAPIのデータポリシーに依存 | 100%非公開/エアギャップ | 分離されたワークスペース/コード所有権 |
| ハードウェア負荷 | ローカル計算リソース不要 | 高いVRAM/GPUが必要 | ローカル計算リソース不要 |
| セットアップの複雑さ | APIキー&IDEプラグイン設定 | ローカル実行環境&量子化のセットアップ | プロンプト即起動のビジュアルワークスペース |
| 出力範囲 | スニペット、関数、チャットでの助言 | コード補完&ローカル編集 | 完全なフルスタックアプリケーション |
| コストモデル | トークン単位課金のAPIサブスクリプション | 先行するローカルハードウェアコスト | 固定のプラットフォームサブスクリプション |
- プライバシーと知的財産: 厳格で高度に独自性のあるコードベースを扱う際、私は一貫してローカルモデルを優先し、機密IPの漏洩を完全に防ぎます。未公開の企業ロジックをリモートサーバーに送ることは、厳しいコンプライアンス規制に違反することが多いのです。
- ハードウェア要件: オープンソースモデルを動かすには、本格的な専用ハードウェアが必要です。70億パラメータのモデルには通常少なくとも8GBのVRAM、140億パラメータのモデルには16GB、巨大な700億パラメータのモデルには48GB以上のVRAMが必要で、しばしば高価なデュアルGPUのデスクトップ構成や専用のローカルサーバーが必要になります。
- レイテンシと能力のトレードオフ: クラウドの計算グリッドは、深い推論や大規模なマルチファイルリファクタリングに対して、比類のない巨大なパワーを提供します。しかし、セルフホスト型のローカルモデルに切り替えると、厳密にゼロレイテンシというネットワーク上の利点を体感でき、即時のインラインテキスト補完においてはるかに優れた、はるかに滑らかな感覚が得られます。
コミュニティの結論:開発者レビューとvibe codingの潮流
- Vibe codingとは、開発者が自然言語プロンプトを使って高レベルなシステムアーキテクチャやアプリケーションロジックを操縦し、AIが自律的にボイラープレートの構文を生成する、現代的な開発ワークフローを指します。エンジニアは手作業でルーティンを書き起こす代わりに、アーキテクチャのディレクターとして振る舞い、プロジェクトの意図を導きながら生成された出力をレビューします。
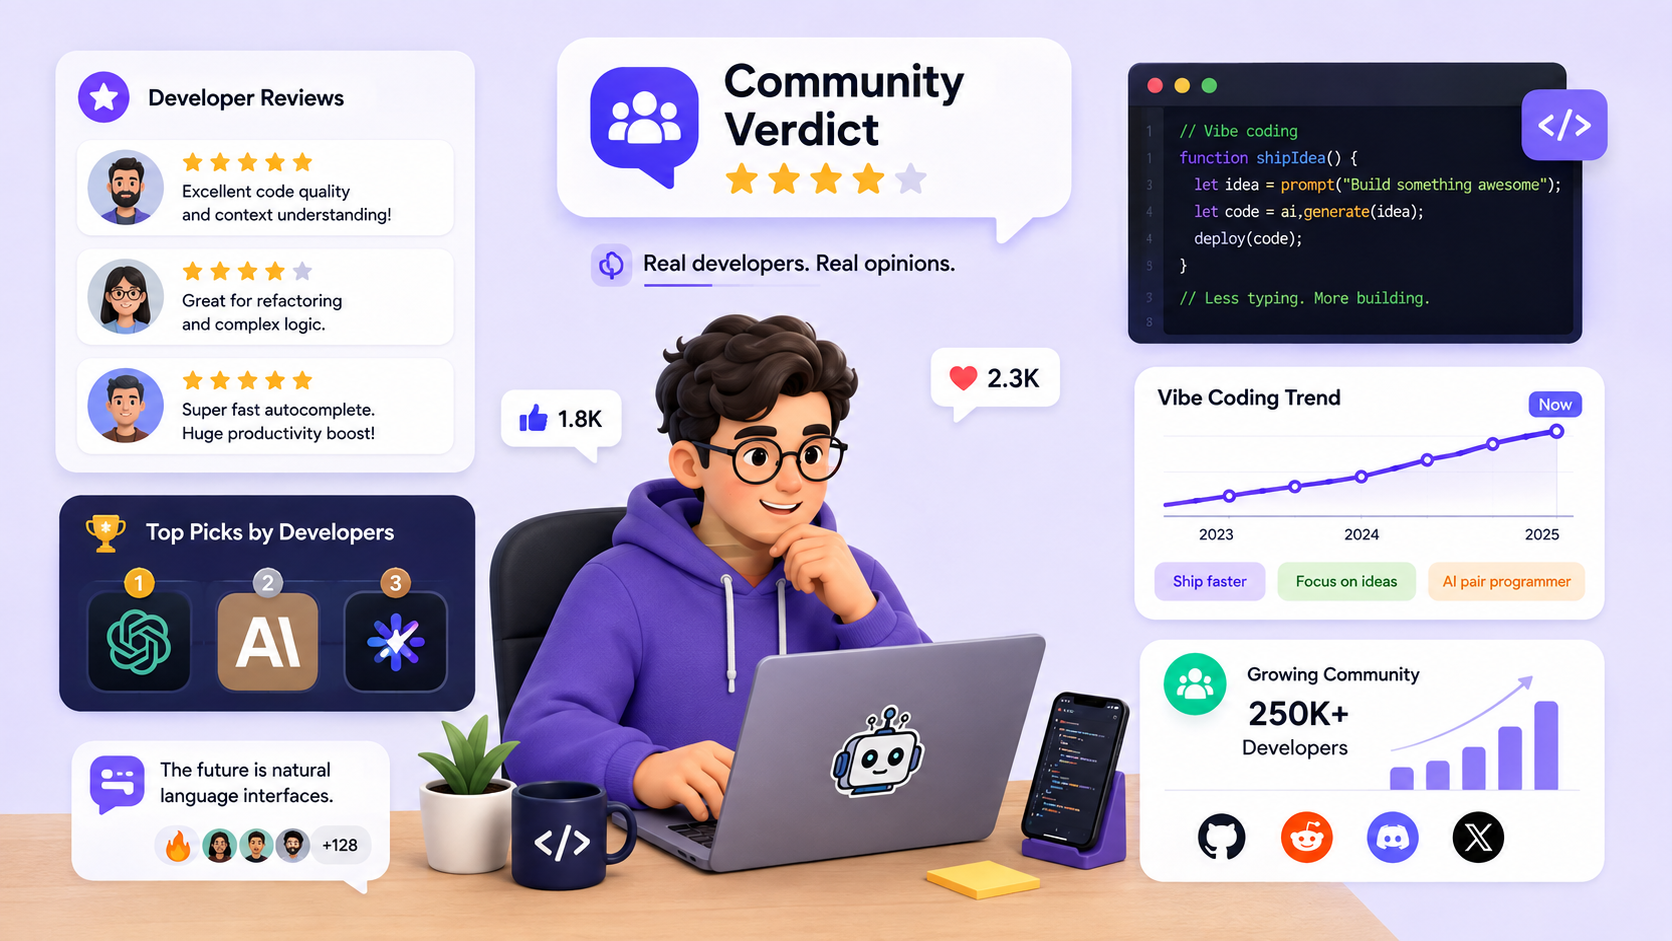
Redditコミュニティの総意:
- r/vibecodingの開発者議論から得られた知見を総合すると、エンジニアは単一のツールでフルスタック構築全体を処理するのではなく、階層的に複数のモデルを使い分けるアプローチを頻繁に採用しています。
- 開発者は通常、高速で汎用的なモデルを使って高レベルの足場やフロントエンドのコンセプトを立ち上げ、その後すぐにClaude Opus 5に切り替えて、深いロジックの実行、複雑なマルチファイルリファクタリング、的を絞ったデバッグを行います。
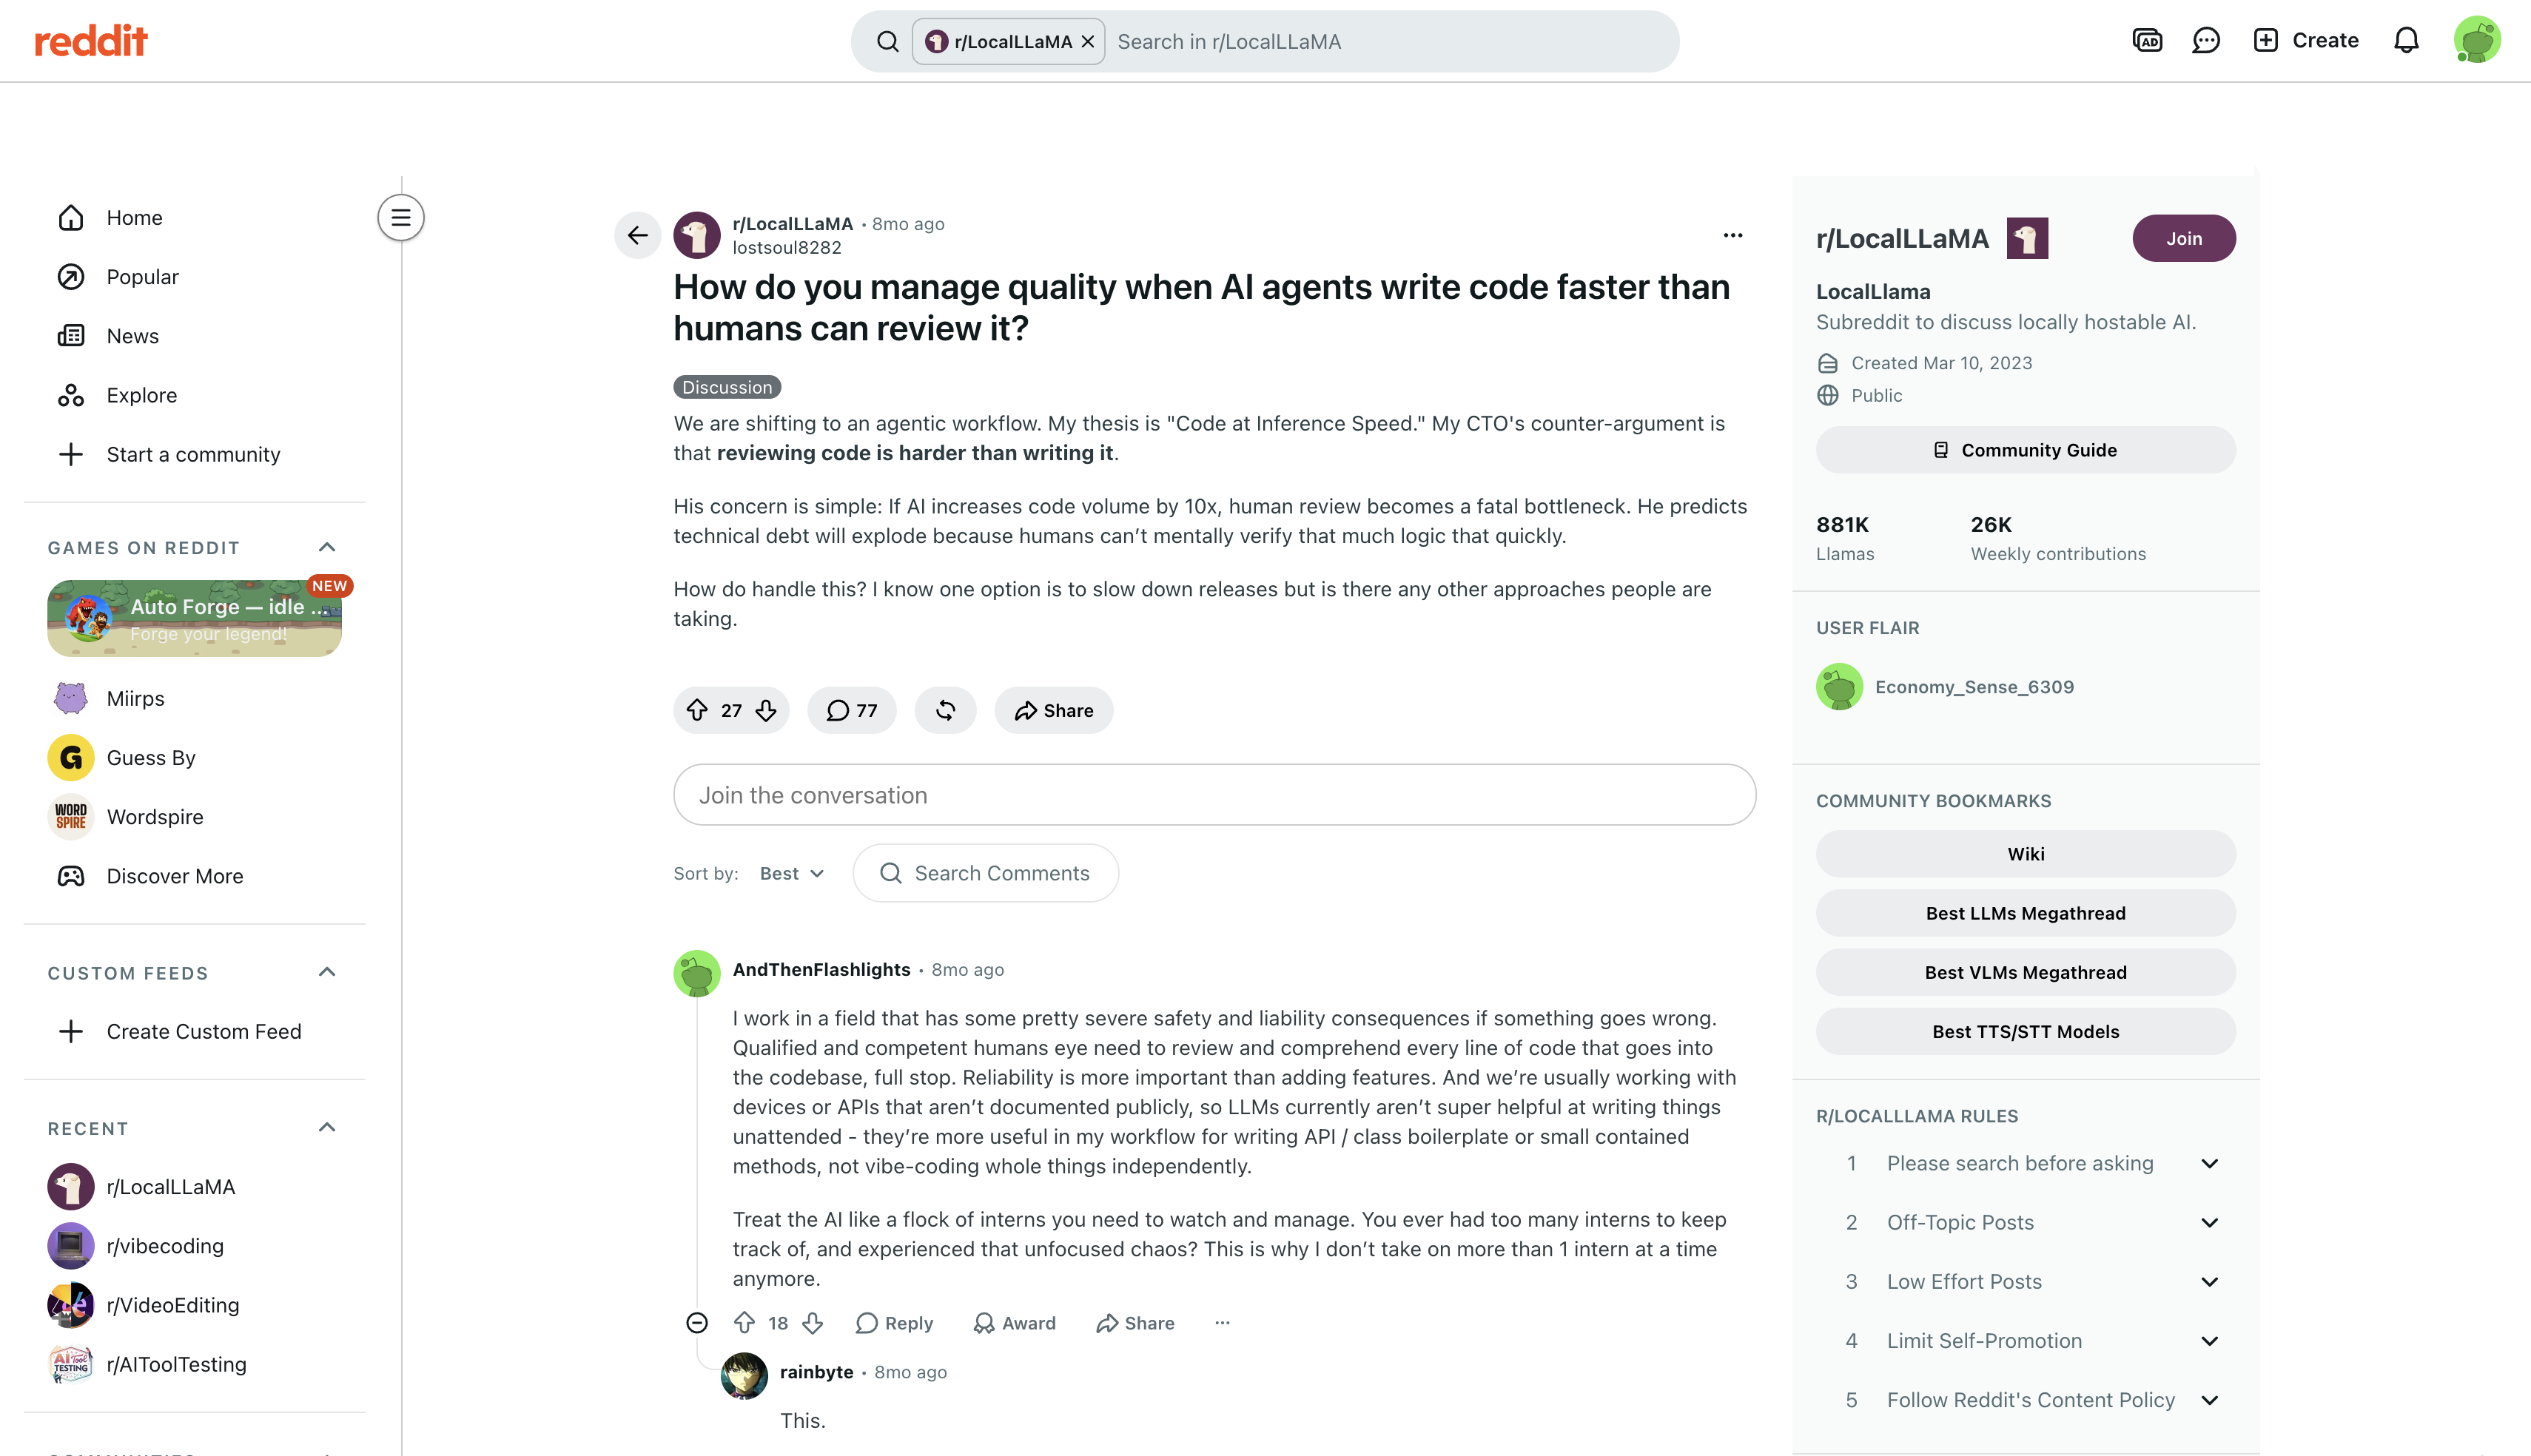
- r/LocalLLaMAといったエンジニアリング系フォーラムでの議論は、人間による監督が依然として厳密に必要であることを強調しています。自律生成は初期構築のスピードを上げますが、開発者はロジックのドリフトを防ぐために複雑な状態の依存関係を積極的に管理しなければなりません。
コミュニティのモデル選好:
- ゼロセットアップのワークフロー: エンジニアは、迅速な開発のために、最新のAIネイティブなコードエディタに直接統合されたクラウド駆動の構成を強く好みます。Claude Opus 5は、ゼロショット精度、コンテキスト保持、高い信頼性を兼ね備えた出力のバランスの良さから、デファクトスタンダードとして広く引用されています。
- ローカル愛好家の構成: 多くの開発者は、繰り返し発生するAPIトークンのコストを避け、非公開のコードベースを守るためにローカルデプロイを選択します。Qwen3-Coder-NextやDeepSeek V4-Proといったオープンソースモデルは、Ollamaなどの実行環境を介したセルフホスティングに広く推奨されており、データテレメトリーをゼロに保ちながら強力なコード生成を提供します。
結論
最終的に、2026年においてすべてのエンジニアリングのユースケースに完璧に適合する唯一のコーディング最適LLMは存在しません。フロンティアクラウドモデルは、複雑なシステムリファクタリングや構造設計に必要な生の推論力を提供します。エンタープライズのセキュリティを考えるなら、最高のローカルコーディングLLMが、極めて機密性の高い環境でのデータ漏洩ゼロを保証します。一方で、自律型開発エージェントを採用することで、初期の構想から本番デプロイまでの完全なアプリケーション提供が効率化されます。単一のエコシステムにコミットする前に、チームの予算、ハードウェア能力、データセキュリティポリシーを評価しましょう。IDEを起動し、いくつかのAPIキーやローカル実行環境を設定し、自分のコードベースに対してこれらのモデルをベンチマークして、どのツールセットがあなたのエンジニアリングワークフローを引き上げるのかを見極めてください。
コーディング最適LLMに関するFAQ
2026年、コーディングに最適なLLMはどれですか?
Claude Opus 5は現在、複雑なソフトウェアエンジニアリング、マルチファイルのリファクタリング、自律型エージェントループにおいて最高のコーディングLLMです。決定論的な実行と幅広いIDE統合を求める開発者には、GPT-5.6 Solが最有力のクラウド代替候補です。厳格なデータプライバシーを優先するチームは、クラウド依存なしでGLM-5.2やDeepSeek V4-Proのようなオープンウェイトの強力モデルをローカルに展開できます。
コンシューマー向けノートPCでの最高のローカルコーディングLLMは何ですか?
Qwen3-Coder-NextとGLM-5.2は、ローカル環境向けに高度に最適化されています。Qwen3-Coder-Nextは控えめなハードウェアでパラメータ当たりの優れた効率を提供し、GLM-5.2は100万トークンのコンテキストを特徴とする最高のオープンウェイトコーダーです。
ローカルLLMモデルを動かすには、どれくらいのRAMとVRAMが必要ですか?
標準的な70億パラメータのコーディングモデルを快適に動かすには、少なくとも8GBのGPU VRAM、またはApple統合メモリが必要です。より大きな140億パラメータのモデルには約16GBが必要で、巨大な700億パラメータのエンタープライズ級モデルがスムーズに動作するには、48GBから64GBのVRAMが必要です。
クラウドのコーディングモデルは、企業の独自コードにとって安全ですか?
これは完全に、そして唯一、特定のプロバイダーのAPI保持ポリシーに依存します。高位のエンタープライズAPI契約は一般にユーザーデータでの学習を行わないことを約束しますが、厳格な企業コンプライアンスや政府の規制により、絶対的なセキュリティを保証するために完全にエアギャップされたローカルモデルが義務付けられることがよくあります。
「vibe coding」とは何で、どのモデルがそれに最も適していますか?
これは、エンジニアが広範で高レベルな自然言語プロンプトを使ってアプリケーションロジックを操縦し、AIがすべてのボイラープレート生成と構文記述を自律的に処理する、現代的な開発ワークフローを指します。Claude Opus 5やGPT-5.6 Solといったフロンティアモデルは、このようなエージェント型コーディングや大規模リファクタリングの手法において非常に優れています。
オープンソースのコーディングモデルは、Claude Fable 5と比べてどうですか?
GLM-5.2やDeepSeek V4-Proのようなオープンウェイトモデルは急速に差を縮めており、SWE-bench Proやアルゴリズムの課題においてGPT-5.5のような初期のベースラインを上回っています。しかし、GPT-5.6 SolやClaude Fable 5のようなフロンティアエンジンは、大規模なリファクタリングや複雑なエージェントループにおいて、依然として明確な優位性を保っています。
コーディングLLMは人間のソフトウェアエンジニアに取って代わることができますか?
いいえ。これらのモデルは現在、非常に高度なコンパイラであり、強力なワークフロー加速装置として機能しています。本番デプロイの前に、システムアーキテクチャを丹念に設計し、複雑なセキュリティプロトコルを管理し、機能ロジックを厳密に検証するには、依然として経験豊富な人間のエンジニアが絶対的に必要です。
Python開発に最適な無料のオープンソースLLMは何ですか?
GLM-5.2とQwen3-Coder-Nextはいずれも、広範で高度に専門化された能力を備えています。GLM-5.2は大規模なコードベース向けに100万トークンのコンテキストまで対応し、Qwen3-Coder-Nextは小規模なローカル展開において優れた効率性を提供するため、どちらも標準的なWeb開発ワークフローにとって非常に優れた無料の選択肢となります。





