
GPT-5.2 完全解説:機能、ベンチマーク、料金、活用シーン
GPT-5.2のInstant、Thinking、Pro、Codexの料金やベンチマーク、制限、2026年のGemini 3との比較まで開発者向けに解説します。
図1. 品質、速度、コスト、制御性の4軸で評価したGPT-5.2
私はEnter Proの中でGPT‑5.2 Proを選び、アプリのアイデアを要件と受け入れ基準に変換するプロジェクト概要レビューツールを構築しました。キャプチャにはセットアップとレビュー出力が示されていますが、リクエストが完了したことの検証はまだ未完了のステップです。
この実践的なケースは、本ガイドに具体的な基準点を与えてくれます。まず公式のベンチマーク結果と、アプリが実際に表示した内容を分けて整理し、そのうえでこのモデルファミリーの能力、料金、制限を検証します。Instant、Thinking、Pro、Codexのどれに当てはまる観察結果なのかを、適用前に正確なバリアントで特定する必要があります。
OpenAIは2025年12月11日に、プロフェッショナルな業務や長時間稼働するエージェント向けのリリースとしてこのファミリーを発表しました。その発表レポートは公式のベンチマークと料金のベースラインを示しています。本記事ではこのレポートに加え、現在のルーティング情報、重要な独立した検証結果、コミュニティの報告も併用します。単一の情報源だけでは、制御された性能と日常利用の摩擦の両方を捉えきれないためです。
Chat GPT 5.2を検索する人の多くは2025年12月発表のファミリー全体を指していますが、ChatGPTのモードとAPIのモデルIDの違いは重要です。Instantでのテスト結果は、Thinking、Pro、コード特化モデルの動作、価格、レイテンシを示すものではありません。
GPT-5.2 概要
2026年10月9日時点で、OpenAIはGPT‑5.2とGPT‑5.2 Proを前世代のオプションとして位置づけています。既存のプロジェクトはその既知の動作や固定されたスナップショットに価値を見出すかもしれませんが、新規プロジェクトは同じ受け入れ基準で現在推奨されているモデルと比較すべきです。
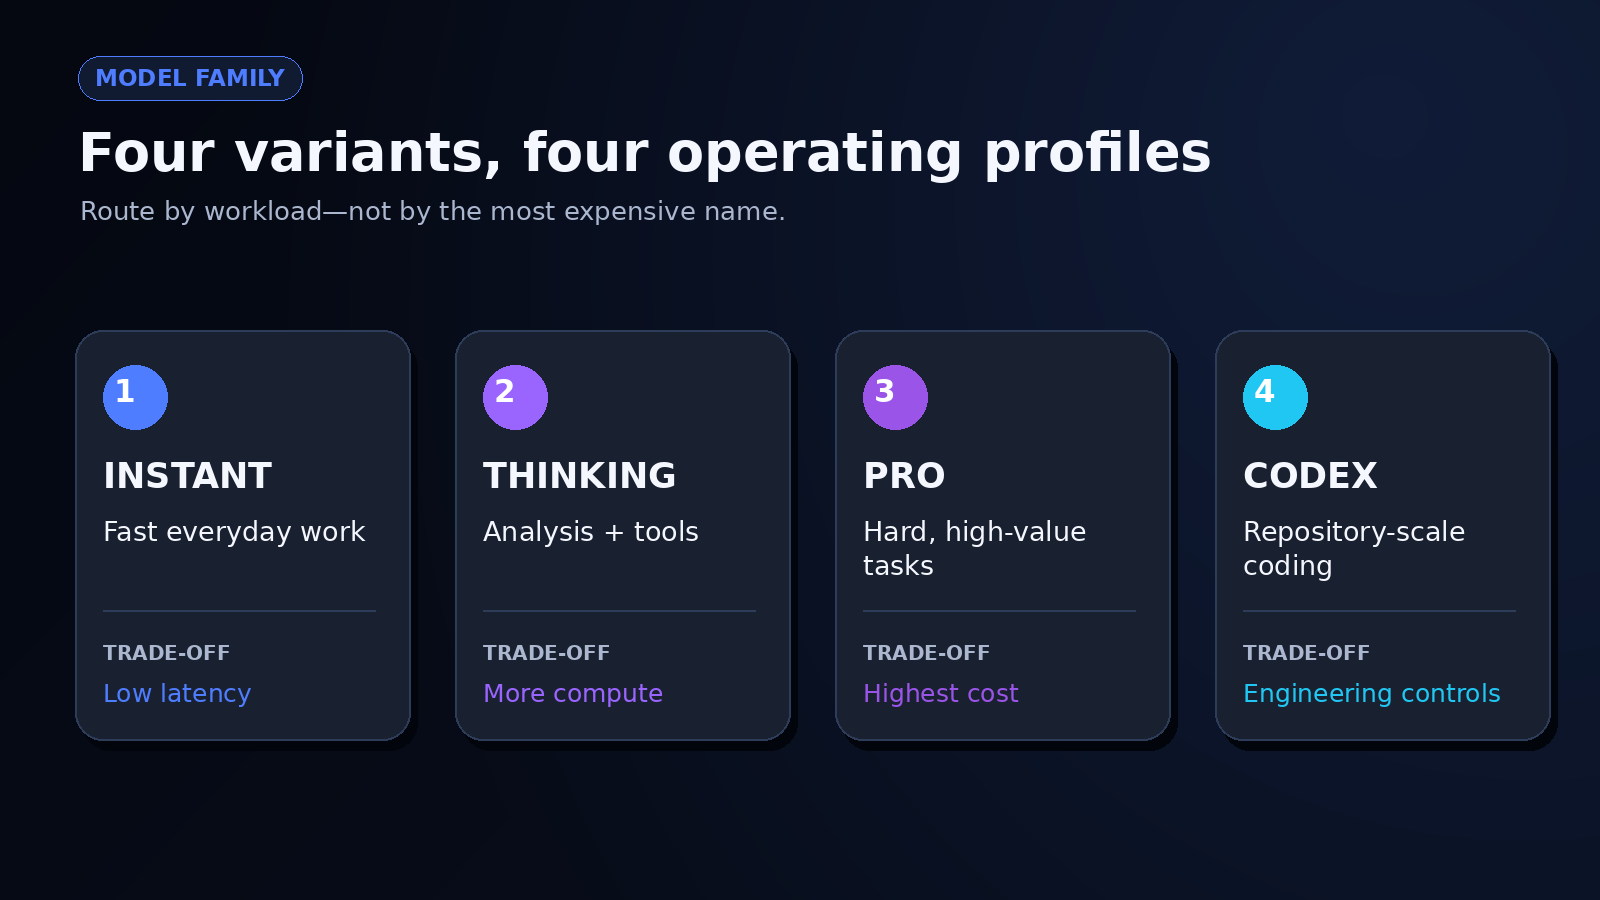
図2. Instant、Thinking、Pro、Codexとワークロードタイプの対応
| 仕様 | GPT-5.2 | GPT-5.2 Pro |
|---|---|---|
| 現在の位置づけ | 前世代フラッグシップ | 前世代Proモデル |
| コンテキストウィンドウ | 400,000トークン | 400,000トークン |
| 最大出力 | 128,000トークン | 128,000トークン |
| 知識カットオフ | 2025年8月31日 | 2025年8月31日 |
| モダリティ | テキスト入出力;画像入力 | テキスト入出力;画像入力 |
| 推論の強度 | なし、低、中、高、極高 | 中、高、極高 |
| APIの100万トークン当たりの料金 | 入力$1.75;キャッシュ$0.175;出力$14 | 入力$21;出力$168 |
| 構造化出力 | 対応 | 非対応 |
| ファインチューニング | 非対応 | 非対応 |
| スナップショット | gpt-5.2-2025-12-11 | gpt-5.2-pro-2025-12-11 |
現在のステータス、コンテキスト、モダリティ
40万トークンのコンテキストウィンドウと12万8千トークンの出力上限は非常に大きい数値ですが、容量は記憶力ではありません。契約書、ログ、スクリーンショット、要件を1つのリクエストに詰め込んだとしても、検索テストは必要です。異なる位置に事実を仕込み、それらを組み合わせないと答えられない質問をして、モデルが何を見落とすかを記録しましょう。コンテキストの数値だけから、長文書に対する信頼できる推論力を推測すべきではありません。
このモデルは画像を受け付けてテキストを生成しますが、音声や動画はネイティブ入力として受け付けません。これにより、グラフ、インターフェースのスクリーンショット、図表、スキャンされた文書に有用ですが、空間的な詳細や抽出された値を検証することが前提です。ぼやけたラベルや見慣れないグラフの目盛りは、自信あふれる説明をそれらしく聞こえる誤りに変えてしまうことがあります。
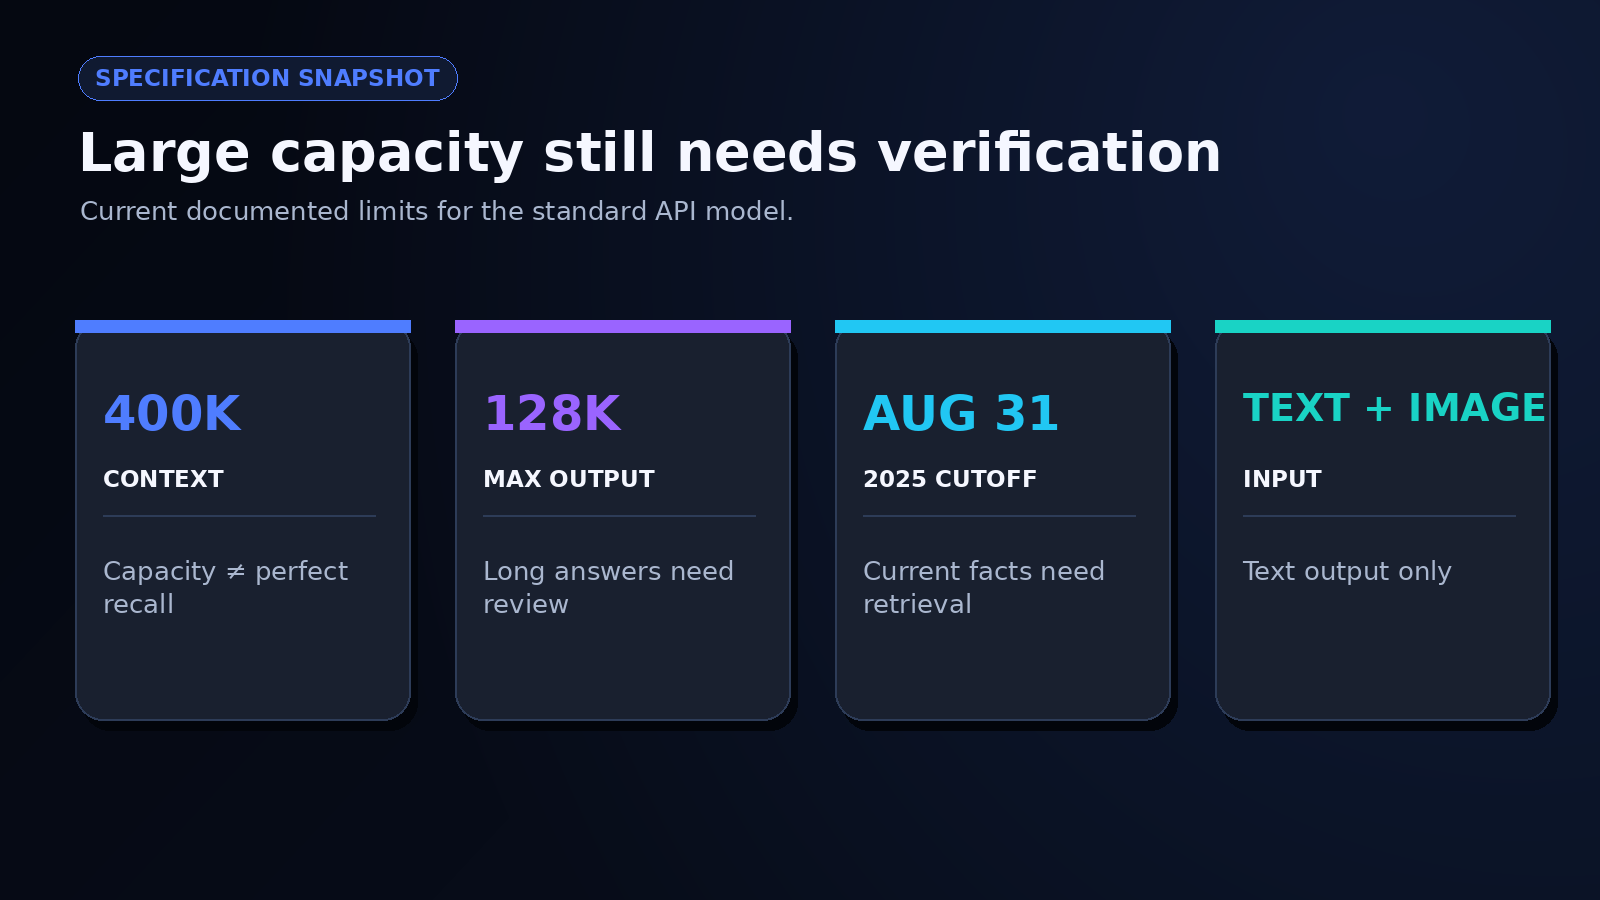
図3. コンテキスト、出力、モダリティ、カットオフ、スナップショット
API料金とアクセス
標準APIモデルは、入力トークン100万につき$1.75、キャッシュされた入力トークン100万につき$0.175、出力トークン100万につき$14です。GPT 5.2 Proは入力$21、出力$168です。推論トークン、リトライ、ツール呼び出し、人間による修正は、受け入れられた結果のコストに影響します。統合プラットフォームを使う場合は、OpenAIのドル料金と比較する前に、その課金単位を個別に確認してください。
現在のプロバイダールーティングと利用可能性はOpenRouterのGPT‑5.2ページで確認できます。コストはリクエスト当たりではなく、完了したタスク当たりで計算すべきです。検証に2回失敗する安価な応答は、1回目で通過するより高価な応答よりコストがかかる場合があります。
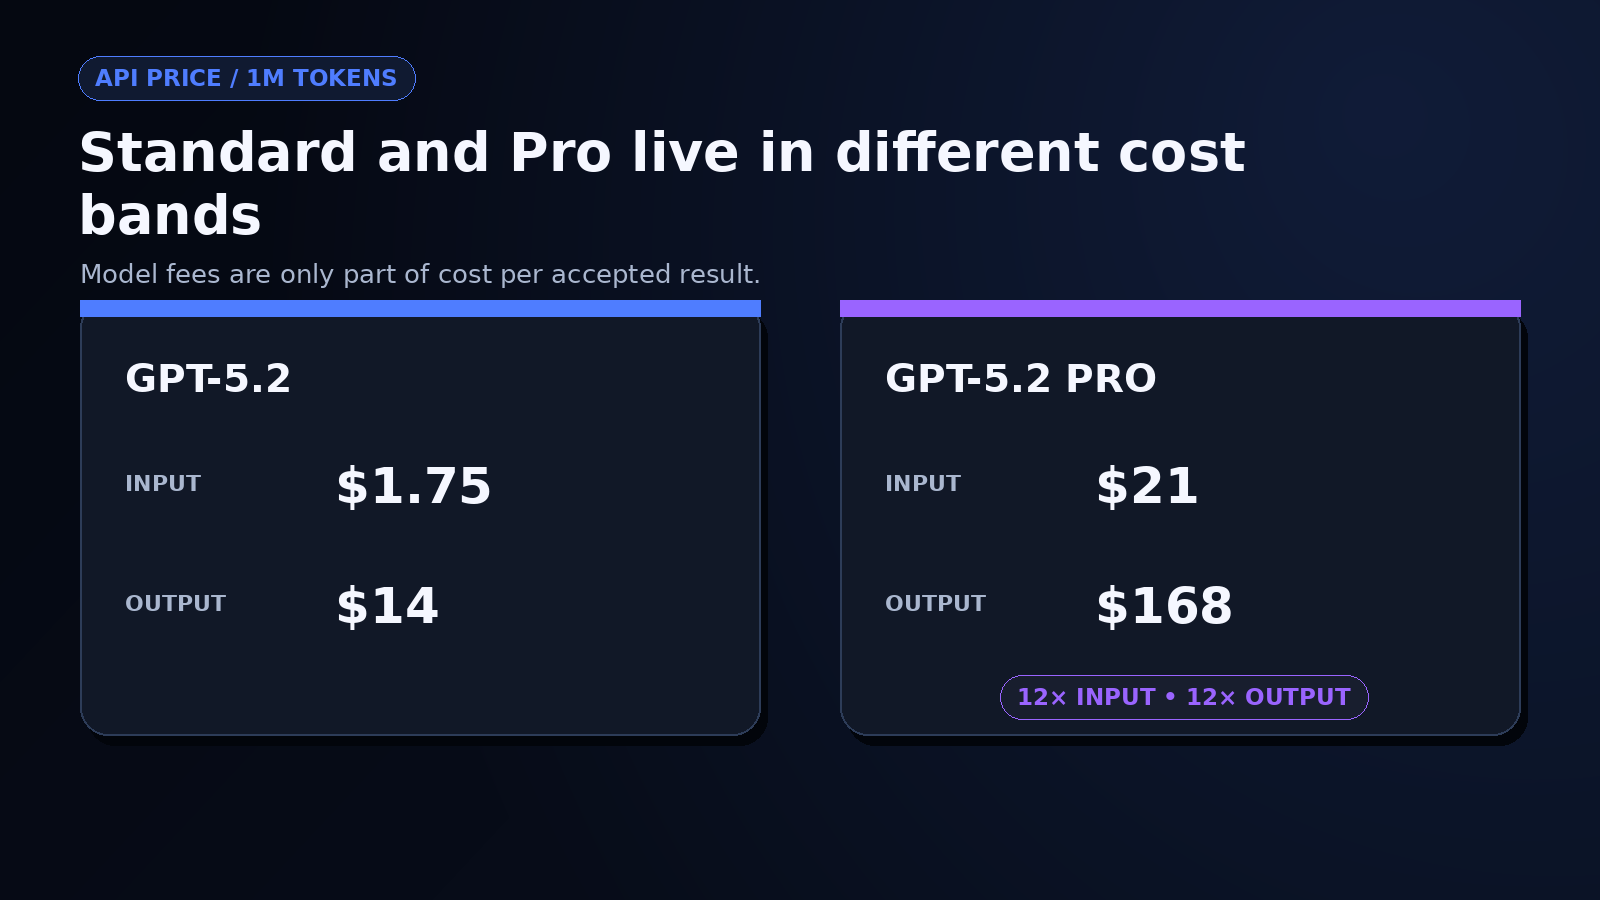
図4. 標準版とPro版の100万トークン当たりのコスト比較
OpenAIのGPT-5.2リリースで何が変わったのか?
OpenAIのGPT-5.2リリースは、1回の回答を超えて続く作業を対象としていました。アーティファクトの構築、長文書の検査、ツールの使用、コードの作成とレビュー、画像に対する推論、複数ステップのプロフェッショナルなタスクの完了などです。また、単一のモデルラベルが示すよりも明確に、高速チャット、より深い推論、高計算量の作業を分離しました。
Instant、Thinking、Proはそれぞれ異なるワークロードを対象とする
Instantは日常的な質問、説明、翻訳、素早い下書きを優先しました。Thinkingは分析、コーディング、ファイル、計画、ツール使用を対象としました。Proは、待ち時間の長さとAPI費用の大幅な上昇が正当化される難しい問題に、より多くの計算資源を投入しました。
| モードまたはモデル | 実用的な適合先 | 主なトレードオフ |
|---|---|---|
| Instant | 日常的な質問とレイテンシに敏感な作業 | 難しい複数ステップのタスクでの検討不足 |
| Thinking | 分析、コーディング、長いファイル、ツール駆動のワークフロー | レイテンシとトークン消費の増加 |
| Pro | 段階的な品質向上に高い価値がある難しいタスク | 非常に高いコスト;応答に数分かかる可能性あり |
私はプレステージではなくリスクに基づいてルーティングします。分類ステップには厳格なスキーマを持つ高速モデルが必要かもしれません。財務モデルのレビューにはより深い推論が正当化されるかもしれません。すべてのリクエストをProに送ると、実際にどのタスクが追加計算の恩恵を受けているかが見えなくなり、コスト管理が格段に難しくなります。
プロフェッショナルな業務とツール使用がローンチの中心だった
OpenAIは表計算、プレゼンテーション、フロントエンド作業、コードレビュー、文書分析、科学、数学、ツール呼び出しを強調しました。非識別化されたChatGPTのクエリに対するベンダー主導の評価では、応答レベルのエラーがGPT‑5.1 Thinkingと比べて相対的に30%少なく報告されました。発表レポートでは、そのエラー評価をモデル自身が行ったことも指摘されているため、私はこの数字を独立した保証ではなく方向性を示す証拠として受け取っています。
実用的な改善は「モデルが何でも知っている」ということではありません。十分に定義されたタスクが、構造を失わずに複数のステップを乗り越える可能性が高くなったということです。それでも、どのツールが動いたか、どのデータを受け取ったか、何を変更したか、失敗した呼び出しの後にワークフローがどう回復したかという、観察可能なチェックポイントが必要です。
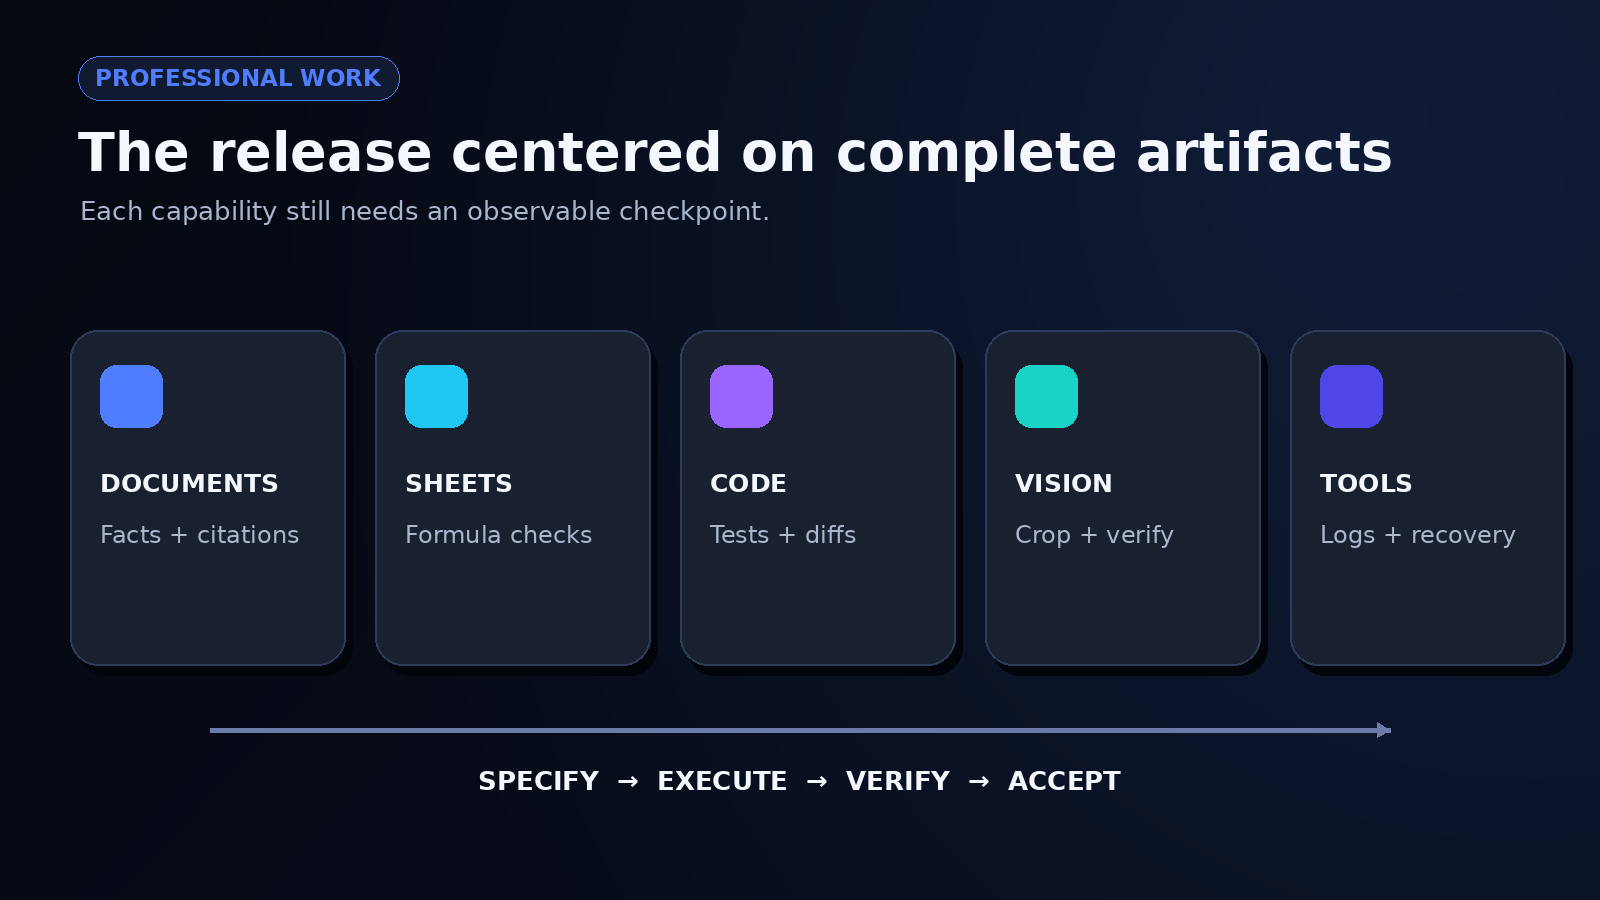
図5. 表計算、コード、文書、画像、ツール呼び出しのパネル
ローンチ時のベンチマークは広範だが不均一な強みを示した
| ベンチマーク | GPT-5.2 Thinking | 測定内容 |
|---|---|---|
| GDPvalの勝利または同等 | 70.9% | 44の職業における十分に定義されたプロフェッショナルタスク |
| SWE-Bench Pro public | 55.6% | 多言語のソフトウェアエンジニアリングタスク |
| SWE-bench Verified | 80.0% | 検証済みPythonリポジトリタスク |
| GPQA Diamond | 92.4% | ツールなしの大学院レベルの科学問題 |
| AIME 2025 | 100.0% | ツールなしの競技数学 |
| ARC-AGI-2 Verified | 52.9% | 新規の抽象推論タスク |
このばらつきこそが有用な部分です。強い結果を示していますが、均一な熟達を意味するものではありません。検証済みのPython issueで80%のスコアを得たとしても、独自のデプロイルールを持つTypeScriptモノレポでの合格率を予測することはできません。同様に、科学系ベンチマークは信頼できる法律的・医学的判断を保証するものではありません。
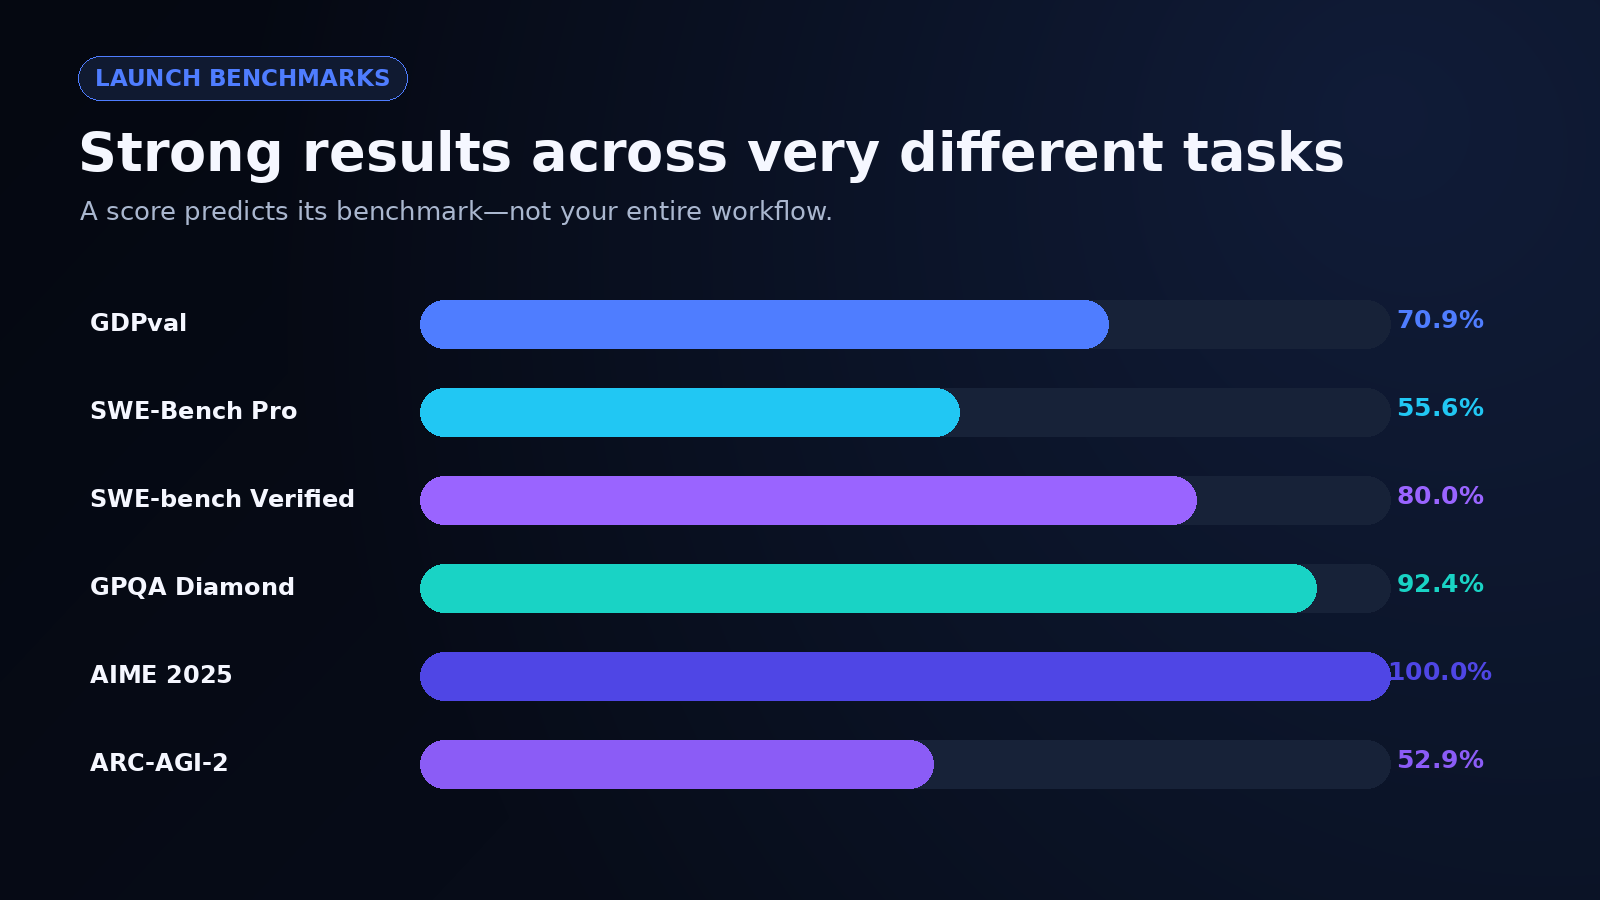
図6. タスクカテゴリ別のローンチ時6つのスコア
GPT-5.2のベンチマークはその制限と合わせて読むべき
公開スコアは、プロンプトの形式、ツール、推論の強度、テストの選定、採点者の挙動、リトライ方針など多くの選択を一つの数字に圧縮しています。本番環境のワークフローには、データ品質、権限、レイテンシ制限、人間によるレビューが加わります。ベンチマークは、何をテストすべきかを選ぶ際に最も有用であり、テストを省略する理由にはならないと私は考えています。
私のアプリレビューが実際に示したこと
プロジェクト概要レビューツールは、応答がまだストリーミング中であっても「プロジェクト概要」と「必須要件」の下に送信された指示を表示しました。入力は実装チェックを要求していましたが、表示された結果はそのリクエストをブリーフとして整理していました。完了したコード検査やテスト結果は報告されませんでした。
別のセッションビューには記録されたリクエストや使用状況がなく、応答時間、ルーティング、コストは未検証のままでした。制約されたブリーフでリクエストを完了させることで、このチェックを終える必要があります。
ベンチマークスコアは本番環境の保証ではない
20〜50件の代表的なタスクから始め、実行前に受け入れ基準を定義してください。コードの場合、テスト合格率、diffサイズ、セキュリティ上の発見事項、ロールバックの安全性などが含まれるでしょう。文書作業の場合、事実の正確性、引用のカバー率、計算ミス、編集時間などが含まれるでしょう。分散が重要なので、同じセットを複数回実行してください。
次に、受け入れられた結果当たりのコストを測定します。あるモデルが1回の実行で$0.18かかり60%のケースで合格し、別のモデルが$0.28かかり90%で合格すると仮定します。人間による修正前の、受け入れられた結果1件当たりの期待コストはそれぞれ$0.30と約$0.31です。レビュー時間をコストに換算すると、後者の方が明らかに安くなる場合もあれば、そうでない場合もあります。この計算は、決定をあなたのワークフローに戻すことを強いるものです。
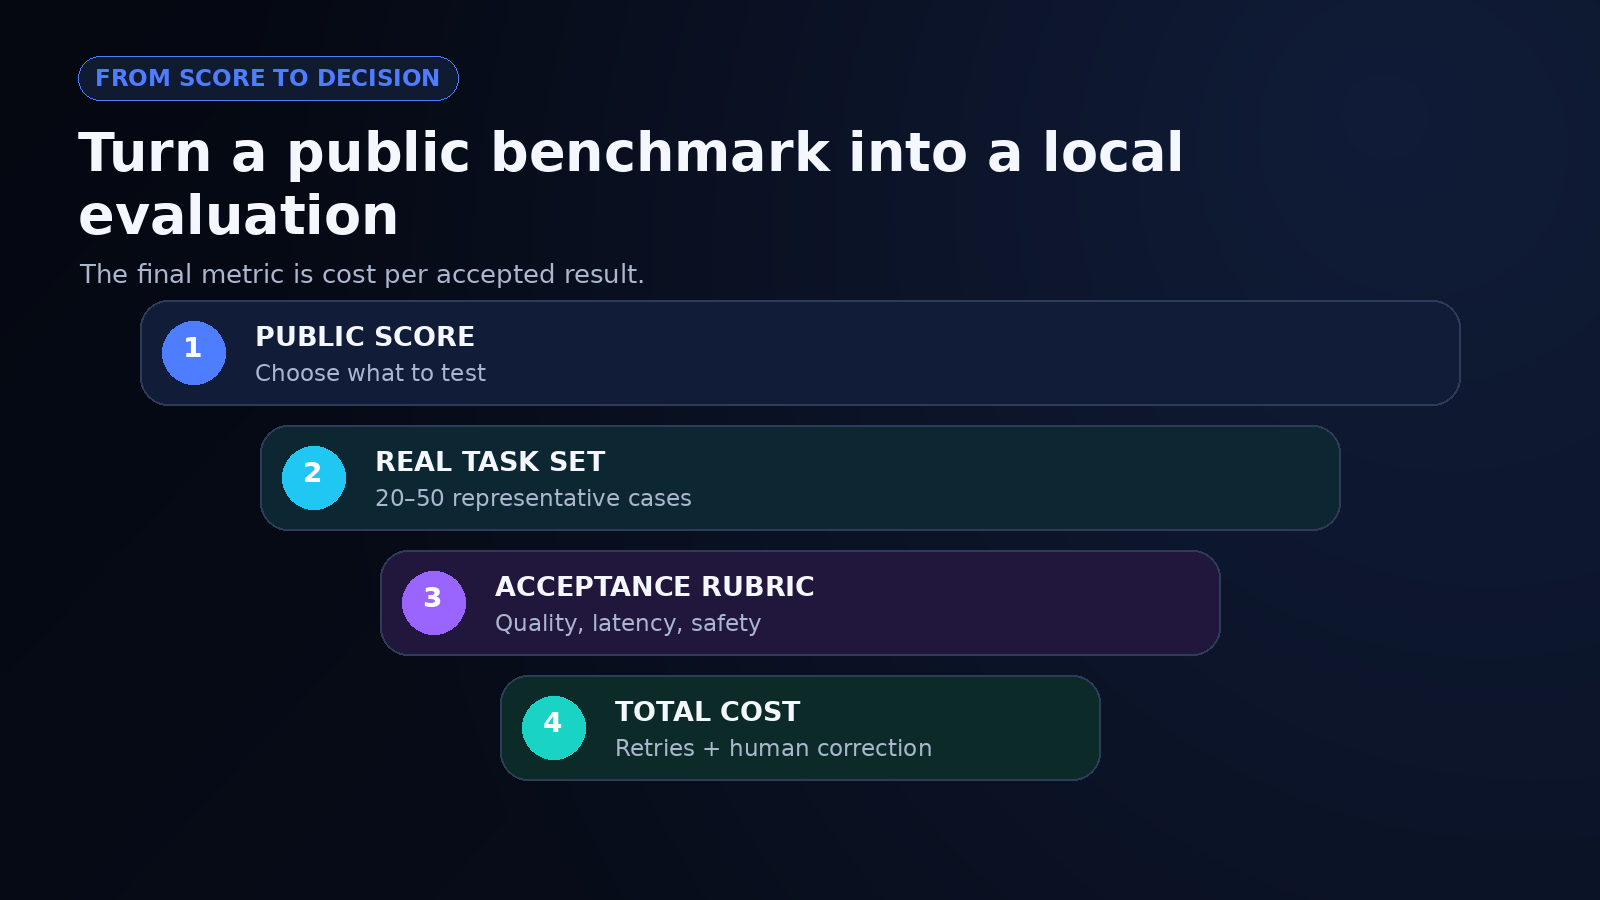
図7. ベンチマークスコアから代表的なタスク、受け入れられた結果のコストまで
長いコンテキストと画像入力は依然として検証が必要
長いコンテキストウィンドウはチャンク化を減らせますが、見落としに気づきにくくもなります。ファイルセットの最初、中間、最後からの検索をテストし、重要な事実には引用や記録識別子を要求し、計算はモデルの外で再実行することをお勧めします。画像については、関連する領域をクロップし、モデルに何が重要かを推測させるのではなく、質問を明示的に行ってください。
独立した批評は、ローンチ記事が前面に出さない失敗モードを浮き彫りにすることもあります。ある実践的な批評は、著者のタスクにおいて残念な出力を描写しています。これはベンチマーク結果を反証するものではありませんが、自分のプロンプト、ワークロード、受け入れ基準を直接再現する必要がある理由を示しています。
図8. 40万トークンの文書ストリームに分散した証拠
高リスクな業務にはドメイン固有の保護措置が必要
2025年8月31日の知識カットオフは、最新の事実には検索が必要であることを意味します。モデルは依然としてソースを捏造したり、要件を見落としたり、スクリーンショットを誤読したり、安全でないコードを生成したりする可能性があります。また、ファインチューニングに対応していないため、深くカスタマイズされた挙動が必要なチームは、プロンプティング、検索、ツール、検証、または別のモデルに頼る必要があります。
支援と権限は分けて考えるべきです。モデルは契約書を要約したり、不審な取引にフラグを立てたり、パッチを提案したりすることができます。しかし、法律、医療、財務、セキュリティ、本番環境に関わる決定は、資格を持つ人間または決定論的な制御機構が行うべきです。証拠を記録し、出力を拒否またはロールバックできる明確な経路を保持してください。
GPT-5.2-Codexとは何か、開発者はどう使うべきか?
GPT 5.2 Codexは、このファミリーのコード特化メンバーであり、孤立した自動補完ではなく、より長いソフトウェアエンジニアリング作業向けに設計されています。有用な違いはワークフローの深さです。リポジトリの理解、変更の計画、複数ファイルの編集、ツールの実行、失敗の検査、パッチの修正といった深さです。
最適なコーディングタスク
良い候補には、リポジトリの探索、機能実装、バグ修正、リファクタリング、テスト作成、コードレビュー、明示的な受け入れ基準を持つマイグレーションなどが含まれます。モデルには、実際の依存関係の境界をなお含む、最小限のまとまった目標を与えるべきです。人為的に小さすぎるプロンプトは、周辺システムで失敗するクリーンなローカルdiffを生み出すことがあります。
GPT 5.2 Codexは、再現可能なリポジトリセットで評価できます。既知の問題、隠されたテスト、リンティング、依存関係ポリシー、セキュリティチェック、許容できる最大diffなどです。ツール呼び出しの回数、修正、レビュアーの介入を記録してください。パッチは単にコンパイルできるだけでは成功とは言えません。
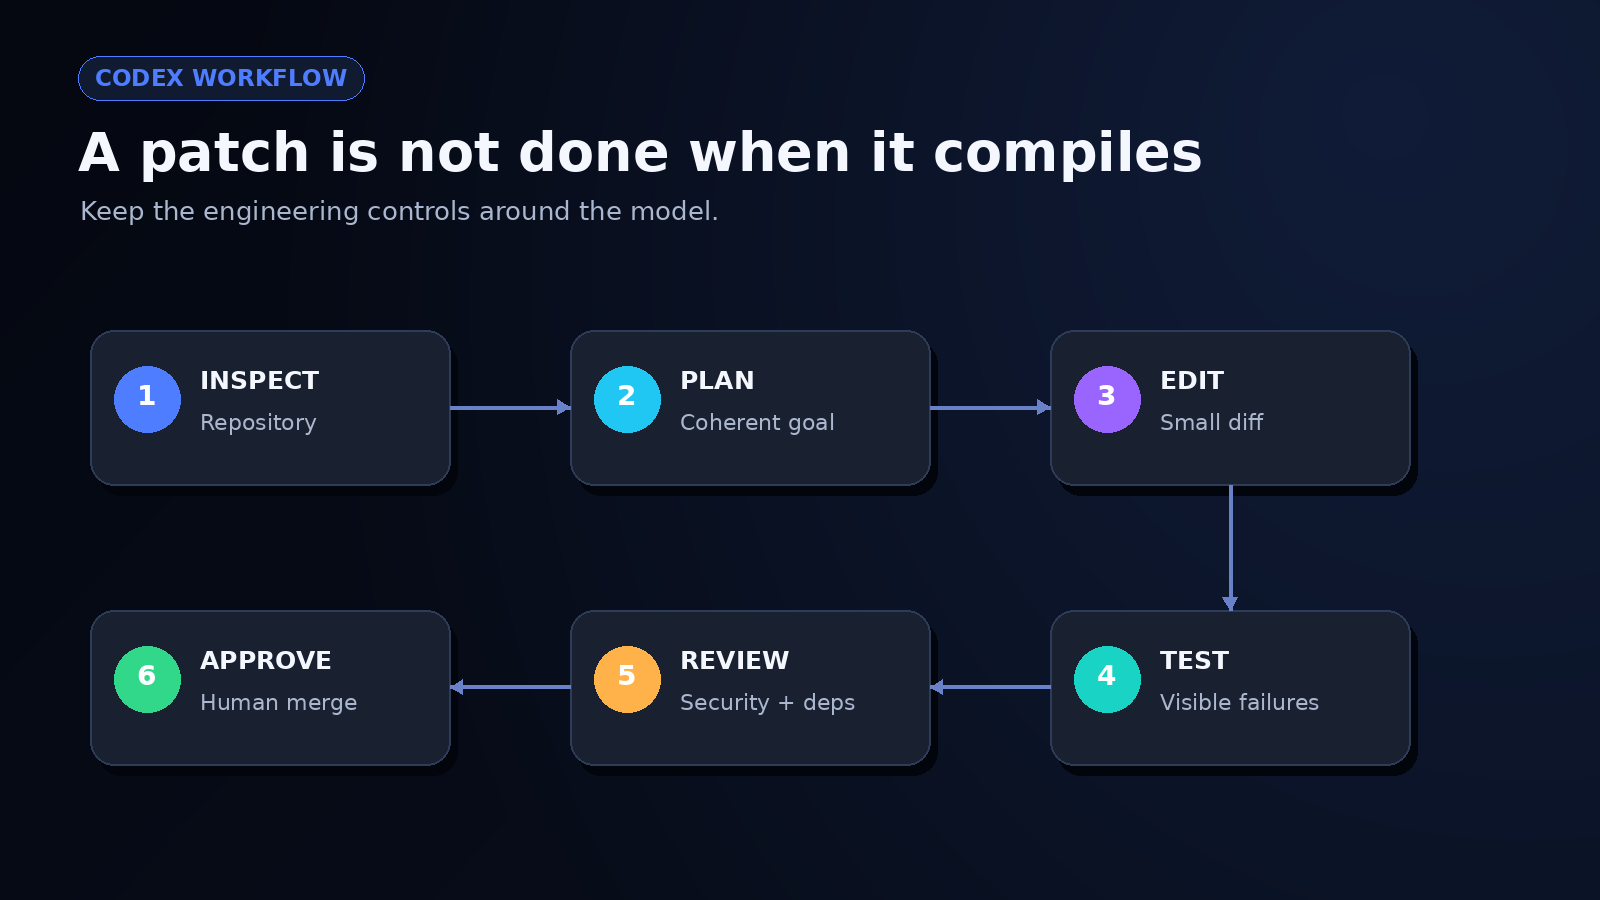
図9. 検査、計画、編集、テスト、レビュー、承認
本番環境のガードレールは依然として適用される
変更はレビューできる程度に小さく保ち、再現性が重要な場合はモデルのスナップショットを固定し、ツールは必要最小限の権限に制限してください。リポジトリのテスト、依存関係スキャン、シークレット検出、静的解析、人間によるdiffレビューを実行してください。エージェントがデプロイ、データ削除、認証情報のローテーションを行える場合は、これらの操作を明示的な承認の背後に置いてください。
また、失敗予算を設けることも好みます。タスクが人間に戻る前に、何回のリトライ、何分、何トークンを消費できるかを定義してください。この境界がなければ、エージェントはますます憶測に基づく修正を繰り返しながら、生産的に見えてしまうことがあります。
GPT-5.2対Gemini 3は正確なタスクによって異なる
GPT-5.2対Gemini 3:優れたAIモデルはコーディング、推論、ライティング、研究などタスクによって異なることを説明しています。
「GPT 5.2対Gemini 3」に対する正直な答えは、普遍的な勝者ではなくテスト設計です。正確なバリアント、日付、ツール、コンテキストサイズ、推論設定、料金を記録する必要があります。そうしないと、比較が知らないうちに一方のモデルに検索、コード実行、より大きな時間予算を与えてしまうことがあります。
| 決定要因 | テストすべき質問 |
|---|---|
| 出力品質 | どちらのモデルがタスクの評価基準をより頻繁にクリアするか? |
| コーディング | どちらが小さく安全なdiffでより高いテスト合格率を生むか? |
| 長いコンテキスト | どちらがファイルから事実をより正確に検索・結合できるか? |
| ツール使用 | どちらが回復可能な失敗と利用可能なログでワークフローを完了できるか? |
| レイテンシ | 中央値と95パーセンタイルの応答時間はどうか? |
| コスト | リトライと修正後の、受け入れられた結果1件当たりの総コストはどうか? |
| ガバナンス | どのデータ、保持期間、地域、監査管理があなたのユースケースに合うか? |
同一条件でのヘッド・トゥ・ヘッド評価を実施する
両方のモデルに同じプロンプト、ソースファイル、ツール、時間予算、採点基準を与えてください。タスクの順序をランダム化し、可能であればレビュアーからモデル名を隠してください。1つの美しい回答を選ぶのではなく、代表的なケースを繰り返してください。GPT‑5.2のローンチディスカッションでのコミュニティの反応は、テストすべき不満点を発見するのに有用ですが、それらは制御された比較ではありません。
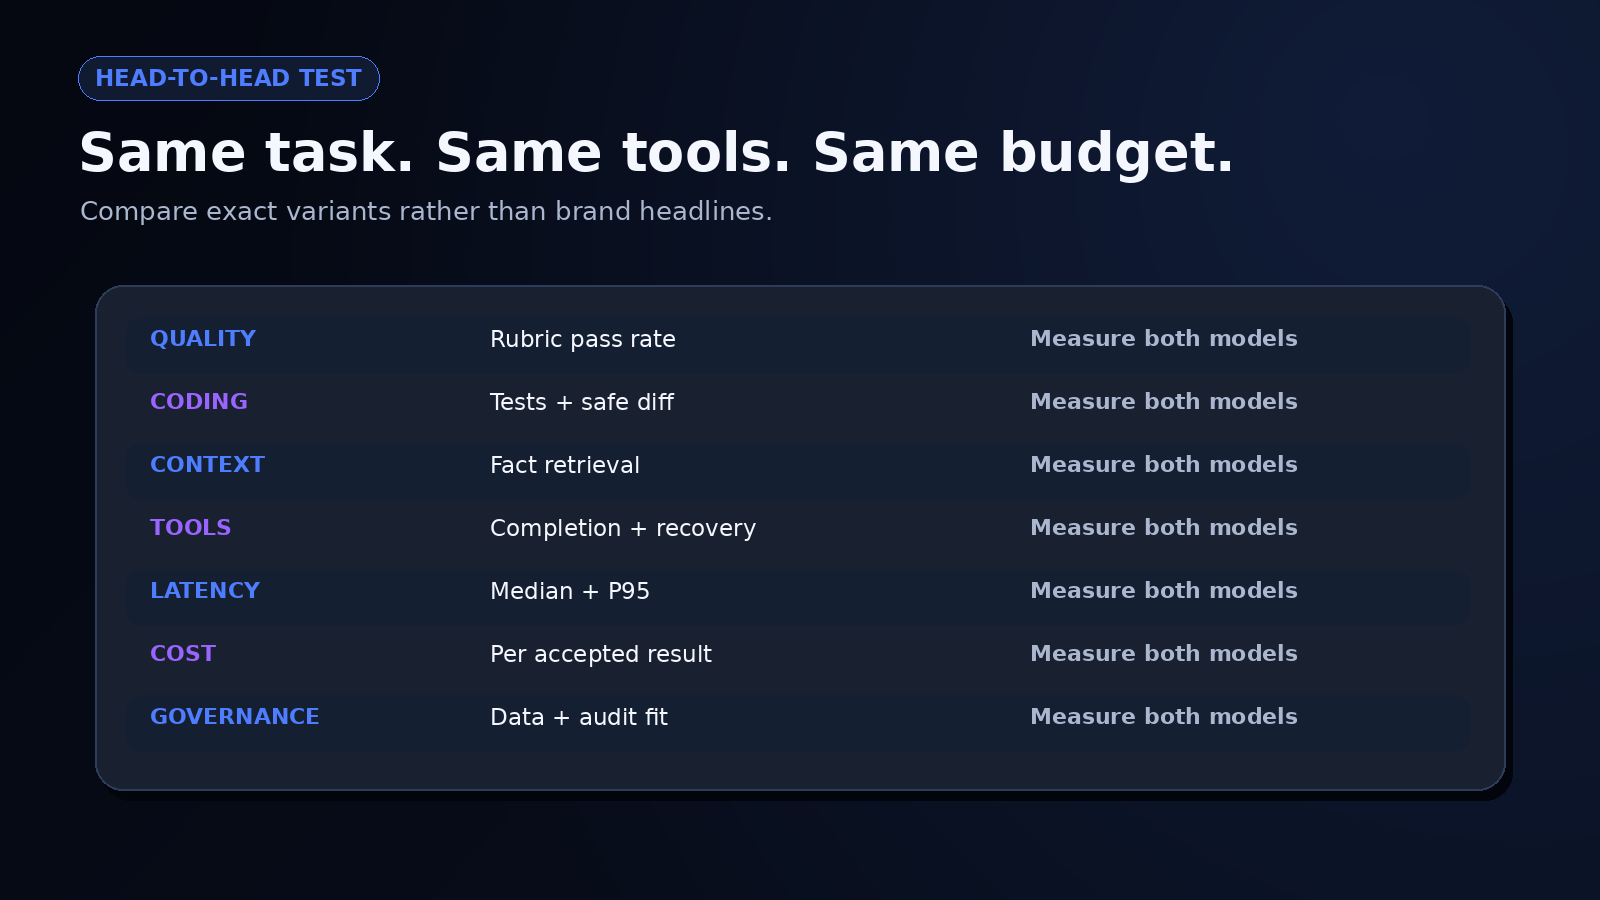
図10. 品質、コーディング、コンテキスト、ツール、レイテンシ、コスト、ガバナンス
より魅力的な見出しではなく、よりリスクの低いワークフローを選ぶ
勝者はステップによって異なる場合があります。あるモデルはうまく計画を立て、別のモデルはよりクリーンなコードを生成し、より小さなオプションがコストのわずかな一部で分類を処理できる場合もあります。正しいアーキテクチャは、1つのモデルにすべてを強いるのではなく、作業をルーティングすることができます。
GPT 5.2対Gemini 3の評価では、品質のしきい値を満たし、失敗時にも観察可能な最もシンプルなモデルの組み合わせを選びます。追加のプロバイダーやフォールバックが一つ増えるたびに、ルーティングロジック、評価作業、プライバシーレビュー、インシデントの複雑さが増します。モデルの多様性は、測定可能なリスクを減らす場合にのみ有用です。
Enter ProでGPT‑5.2 Proアプリを構築する
私はEnter ProのAIアプリビルダーを使い、GPT‑5.2 Proを統合先として選択したAIプロジェクト概要レビューツールを作成しました。目的は、ざっくりとしたアプリのアイデアを要件、不足情報、優先順位、受け入れ基準に変換することでした。
GPT‑5.2 Proを選択し、料金を確認する
モデルカタログでGPT‑5.2 Proを見つけ、その詳細を開きました。パネルには統合ボタンと、入力1,000トークン当たり2.1クレジット、出力1,000トークン当たり16.8クレジットという料金が表示されていました。これらはキャプチャされたプラットフォームの料金です。
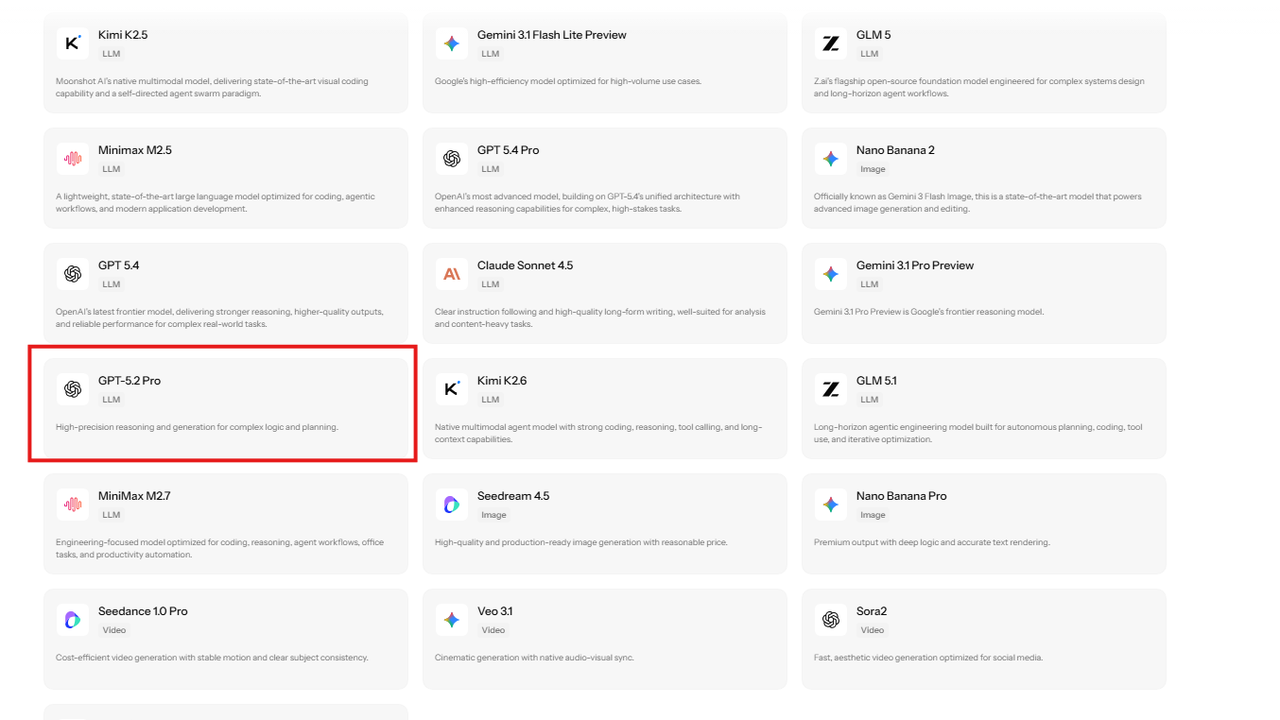
図11. GPT‑5.2 Proは、他の利用可能な統合の中でモデルカタログに表示されます。
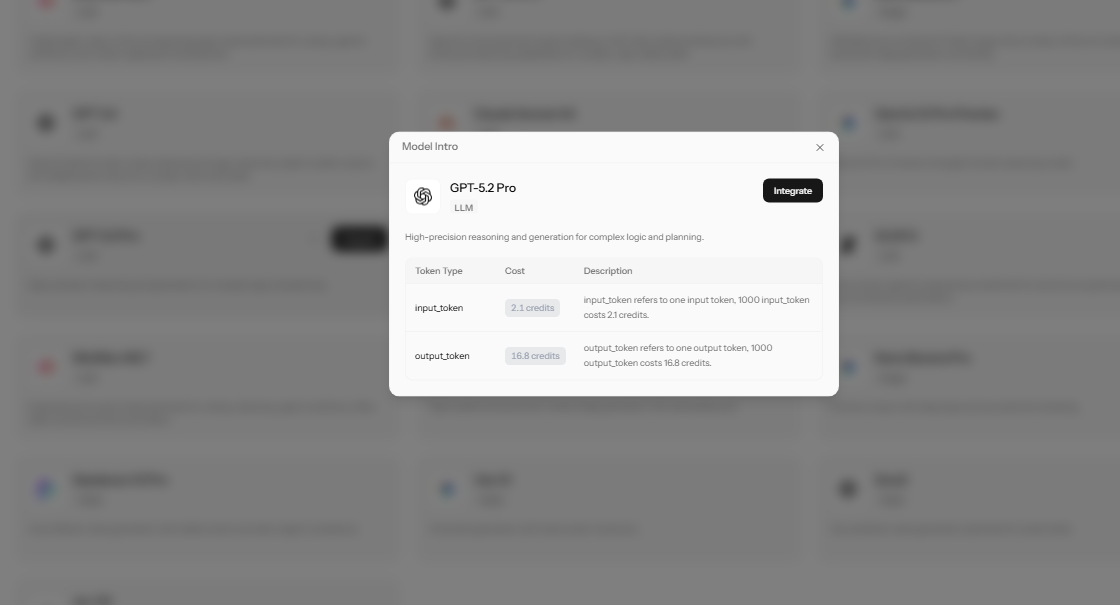
図12. GPT‑5.2 Proの詳細パネルには統合コントロールとクレジット料金が表示されます。
モデルをアタッチし、アプリを記述する
プロジェクトのリクエストにはGPT‑5.2 Proのチップがアタッチされていました。私は大きなブリーフフィールド、ブリーフをレビューボタン、そして5つのセクションに整理された応答を求めました。プロジェクト概要、必須要件、矛盾と不足情報、実装優先順位、受け入れ基準です。このリクエストは、本物のローディング状態とエラー状態も求めていました。
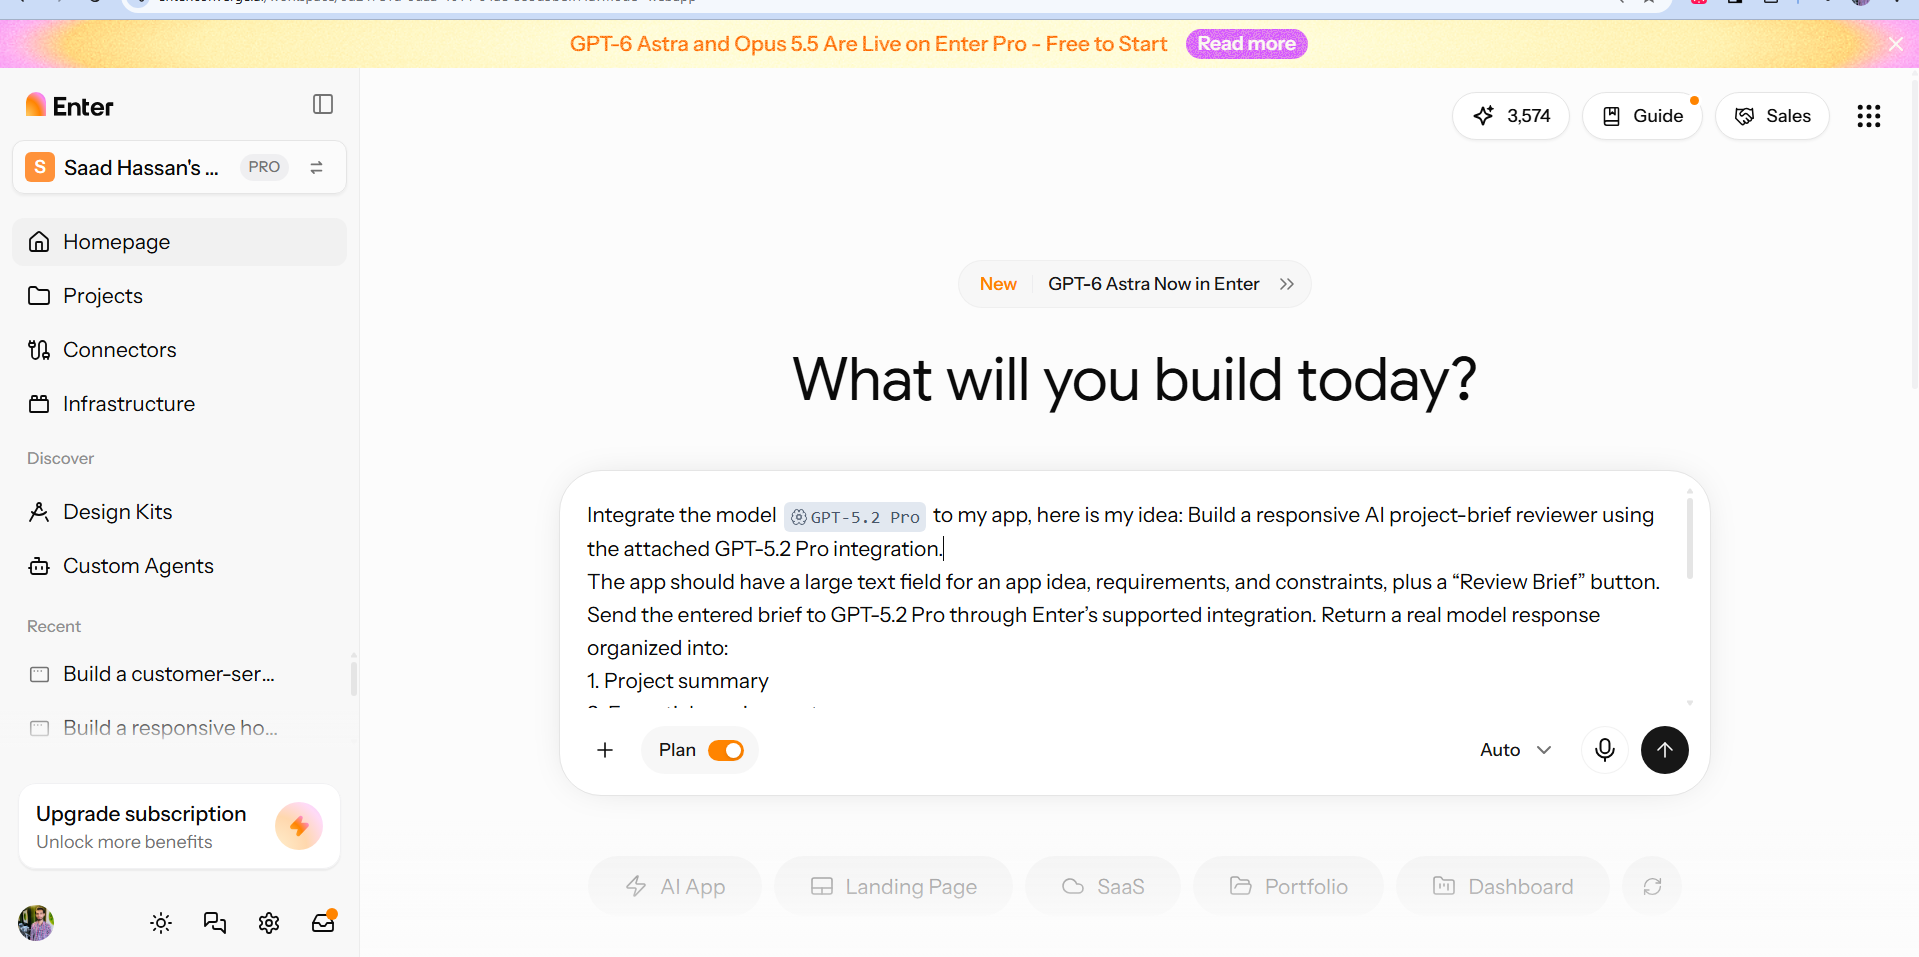
図13. プロジェクトプロンプトはGPT‑5.2 Proをアタッチし、レビューツールの目的と応答構造を指定しています。
構築プランを検査する
Enterは、Vite、React、TailwindによるインターフェースとAIリクエストを処理するバックエンド関数のプランを生成しました。ストリーミング結果、平易な英語のテキスト、保存されたレビュー履歴なしという指定がありました。プライベートな認証情報をバックエンドに保持することもプランの一部でした。このキャプチャは提案された実装を記録しています。
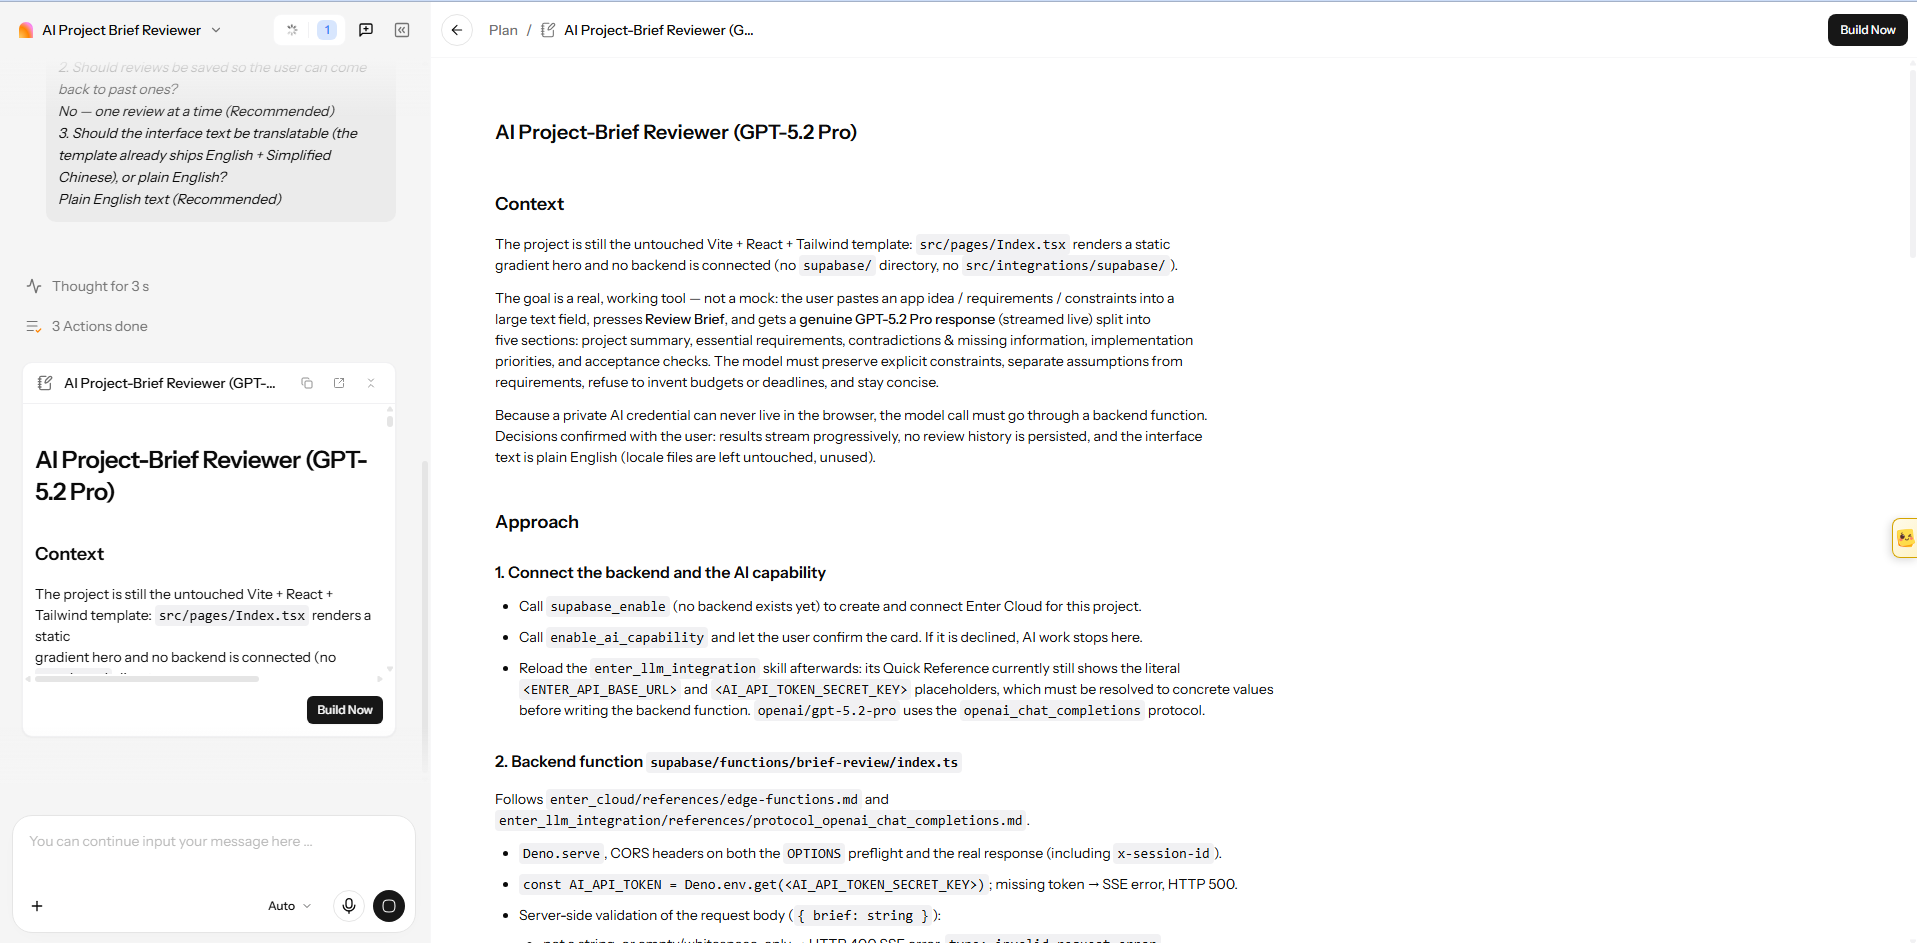
図14. 構築プランはインターフェース、バックエンドリクエスト、ストリーミング出力、認証情報の取り扱いを記述しています。
表示されているレビューを検証する
レビューツールは、応答パネルの隣にブリーフフィールドを表示していました。キャプチャされた試行では、実装チェックのリクエストをそのフィールドに入力しました。応答は要求された見出しの下で要件を再構成し、Streaming reviewとReviewingが表示され続けていました。これは応答の整理を示していますが、完全性と正確性はまだ確認が必要です。
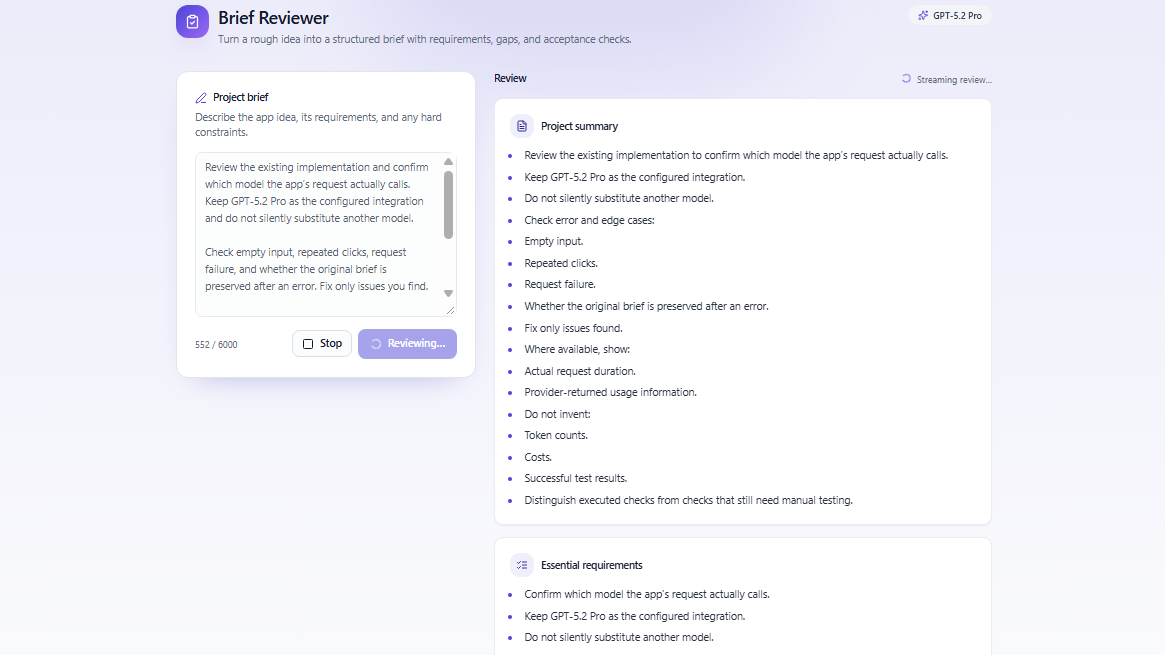
図15. レビューテキストは要求された見出しの下に表示され、インターフェースはまだアクティブな応答を示しています。
推論チェックには、3人の技術者、45分の作業、30分の移動バッファ、午前9時から午後5時までの営業時間、重複なし、12時間の再スケジュールルールという予約ブリーフを使ってみてください。その後「技術者ごとに同時に2件の予約を許可する」という条件を追加し、完成した応答がその矛盾を指摘するかどうかを検証してください。この結果はこれらのキャプチャには含まれていません。
リクエスト記録とクレジット使用量を確認する
追加のステータス表示は、統合をGPT‑5.2 Pro、プロバイダーをEnter AI、プロトコルをResponses APIとラベル付けしていました。そのセッションにはリクエストなし、入力・出力トークンゼロ、消費された使用量ゼロが記録されていました。これらの値からは、先ほどの応答の所要時間、実際のルーティング、課金を確定することはできません。
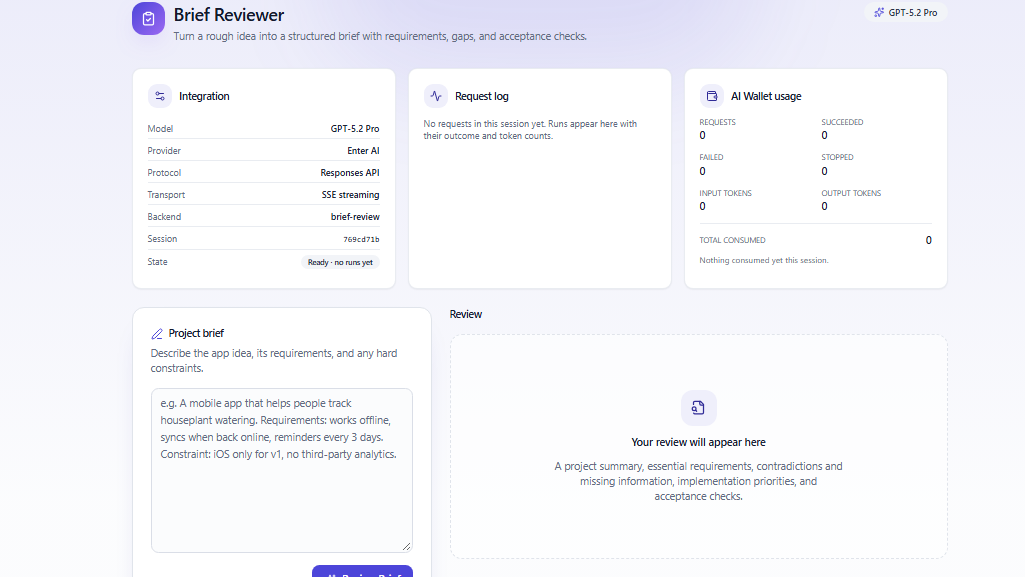
図16. 統合と使用量のパネルは、記録されたリクエストや消費がない準備済みのセッションを示しています。
表示された料金では、例示として入力1,000トークンと課金対象出力500トークンを合わせると10.5クレジットに相当します。これは推定値であり、実際に観測された支出ではありません。コストを比較するには、完了したリクエスト、課金された使用量、リトライ、そして受け入れ基準を満たしたレビューの割合を使用してください。
Enterは、選択したモデルとアプリのブリーフを1つのプロジェクトにまとめて保持します。Enter ProでGPT‑5.2 Proアプリを構築する、公開前に統合を検証してください。
最終的な見解:実際のタスクを通じてGPT‑5.2を評価する
GPT‑5.2の実用的な価値は、タスクの品質と許容できるコストに依存します。レビューツールのプロジェクトは、Proの選択とアプリのインターフェース、整理されたレビューテキストを結びつけています。信頼性とコスト効率を判断するには、完成した応答、検証された制約条件、完了したリクエスト記録が依然として必要です。
受け入れしきい値を満たす最も安価なモデルを選び、重要なケースを繰り返しテストし、エラーに対する回復経路を維持してください。Enter Proを使ってGPT‑5.2 Proアプリを構築・改良し、拡張する前にその統合を検証することができます。
Chat GPT 5.2に関するFAQ
GPT-5.2はいつリリースされましたか?
OpenAIは2025年12月11日に発表しました。APIモデルとChatGPTのバリアントはローンチ時に展開が始まりましたが、アクセス方法と推奨される代替モデルはそれ以降変化しています。
GPT-5.2は今でもOpenAIの最新モデルですか?
いいえ。2026年10月9日時点で、OpenAIはこれを前世代モデルとして文書化しています。Chat GPT 5.2を検索する人は、ChatGPTのピッカーからのアクセスと、APIやサードパーティ統合によるアクセスを区別する必要があります。プロジェクトを開始する前に、正確なバリアントと現在の利用可能性を確認してください。
GPT-5.2のコンテキストウィンドウはどのくらいですか?
文書化されているコンテキストウィンドウは40万トークンで、最大出力は12万8千トークンです。それでも、実際の長文書で検索と推論をテストすべきです。
GPT-5.2のAPIはいくらですか?
標準APIの料金は、入力トークン100万につき$1.75、キャッシュされた入力トークン100万につき$0.175、出力トークン100万につき$14です。ツールの課金、推論、リトライ、レビューはタスクコストに追加されます。
Enter ProでGPT‑5.2 Proアプリを構築するにはどうすればよいですか?
モデルカタログからGPT‑5.2 Proを選択し、統合をアタッチし、アプリが必要とする機能を記述してください。プロジェクト概要レビューツールの場合は、必要な入力とレビュー形式を指定してください。生成された実装を検査し、完了したリクエストを検証して、モデル接続が機能していることを確認してください。
Enter ProでGPT‑5.2 Proの使用状況を確認するにはどうすればよいですか?
代表的なタスクを実行した後、統合のリクエストと使用状況のパネルを確認してください。リクエストが表示されていることを確認し、入力トークン、出力トークン、消費されたクレジットを検査してください。コストを見積もる際には、現在のプラットフォーム料金を使い、リトライと長めの応答も含めてください。
GPT-5.2 Proとは何ですか?
GPT 5.2 Proは、難しいプロフェッショナルなタスク向けの、より高い計算量を持つ推論モデルです。公式のAPI料金は入力100万トークン当たり$21、出力100万トークン当たり$168で、一部のリクエストは完了に数分かかることがあります。
GPT-5.2は画像に対応していますか?
はい。画像入力を受け付け、テキスト出力を生成します。音声と動画はサポートされているネイティブ入力として記載されていないため、これらの形式には別の処理ステップが必要です。
GPT-5.2はGemini 3より優れていますか?
普遍的な答えはありません。同じプロンプト、ファイル、ツール、予算、評価基準で正確なバリアントをテストし、受け入れられた結果の品質、レイテンシ、コスト、ガバナンス、失敗からの回復を比較してください。
GPT-5.2は本番環境対応のコードを生成できますか?
強力なコードを生成できますが、本番環境対応はテスト、diffレビュー、依存関係とセキュリティのチェック、制限されたツール、ステージング、モニタリング、ロールバックといったエンジニアリングプロセス全体から生まれるものです。モデルがこれらの管理機構を置き換えることはできません。





