reAgent:在部署之前,先了解您正在构建什么
大多数 AI 部署在开始前就已失败。了解 reAgent 如何为企业提供负责任且成功部署 agentic AI 所需的可见性和框架。
如果您正在阅读这篇文章,说明您可能对 AI 有一定的兴趣。
但这种兴趣究竟从何而来呢?
对你们中的一些人来说,那是纯粹的好奇心。是对这项技术能做什么的着迷——它如何推理、如何学习、未来会变成什么样。这是一个非常好的起点。
然而,坦白说,对我们大多数人而言,这种兴趣的来源有所不同。它来自新闻头条。来自职场中的对话。来自一种感觉,即某种巨大的变革正在发生,而原地踏步可能意味着被淘汰。这并不是严格意义上的热爱,更像是一种压力。
而这种压力在各处都能感受到。
根据德勤的《企业 AI 现状》报告显示,受访企业在短短一年内将员工使用 AI 工具的比例提高了 50%。投资正在激增:84% 的组织在 2025 年增加了 AI 预算。近 3/4 的公司计划在未来两年内部署智能体 AI(agentic AI)。
每个人都在行动。而且很快。
但这里有一个没人足够大声去问的问题:
他们前进的方向对吗?
雄心与现实之间的差距
同一份德勤报告——基于与 24 个国家超过 3,200 名商业和技术领袖的对话,在发展势头之下勾勒出了一幅更为复杂的图景。
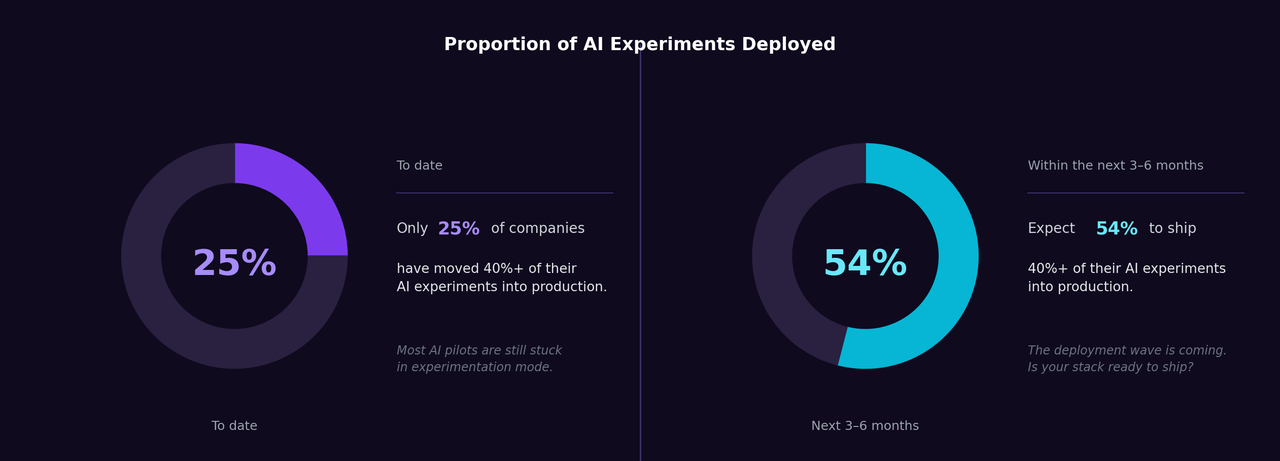
只有 25% 的组织成功地将其 40% 或更多的 AI 实验投入生产。其余的都陷入了所谓的“概念验证陷阱”:在受控条件下运行良好的试点项目,一旦遇到现实世界的复杂性,就会陷入停滞。
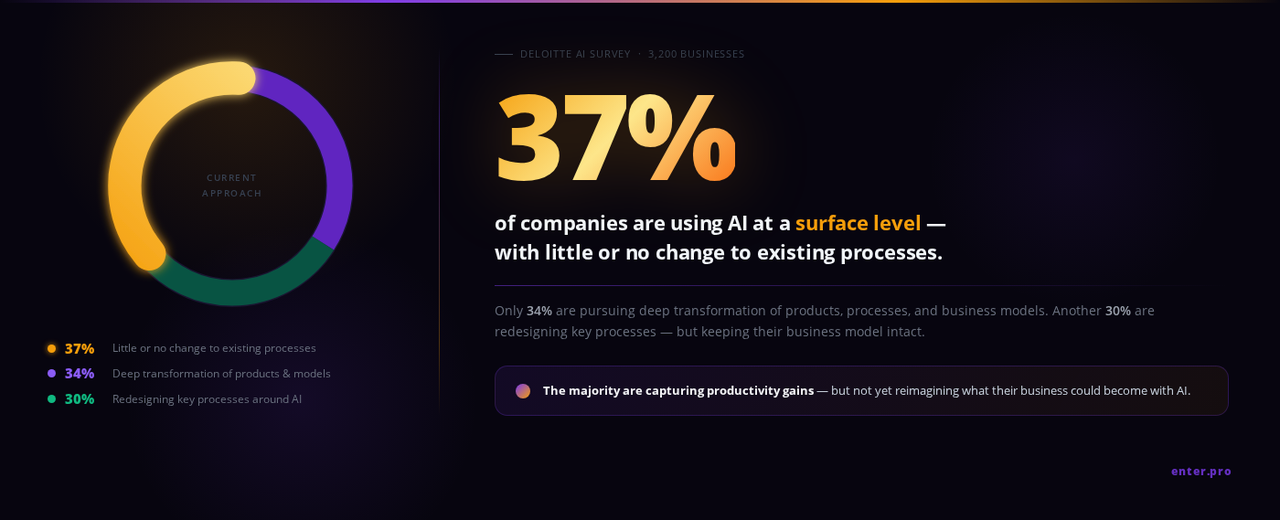
37% 的公司仅在表层使用 AI,而对现有流程几乎没有任何改变。他们拥有工具,但却没有获得价值。
这种差距——即公司前进的速度与其实际准备程度之间的差距——正是真正风险所在。
问题不在于技术尚未准备就绪,而在于大多数组织尚未建立起负责任地部署 AI 所需的框架、可见性或理解力。
这不是一场能力危机,而是一场管理危机。
而 HackPrinceton Spring 2026 的一组学生构建了解决这一问题的工具。
确实,如果您错过了,Enter 团队参加了HackPrinceton 2026——这是全国最具竞争力的学生黑客松之一,在普林斯顿校园内用一个周末的时间举行。
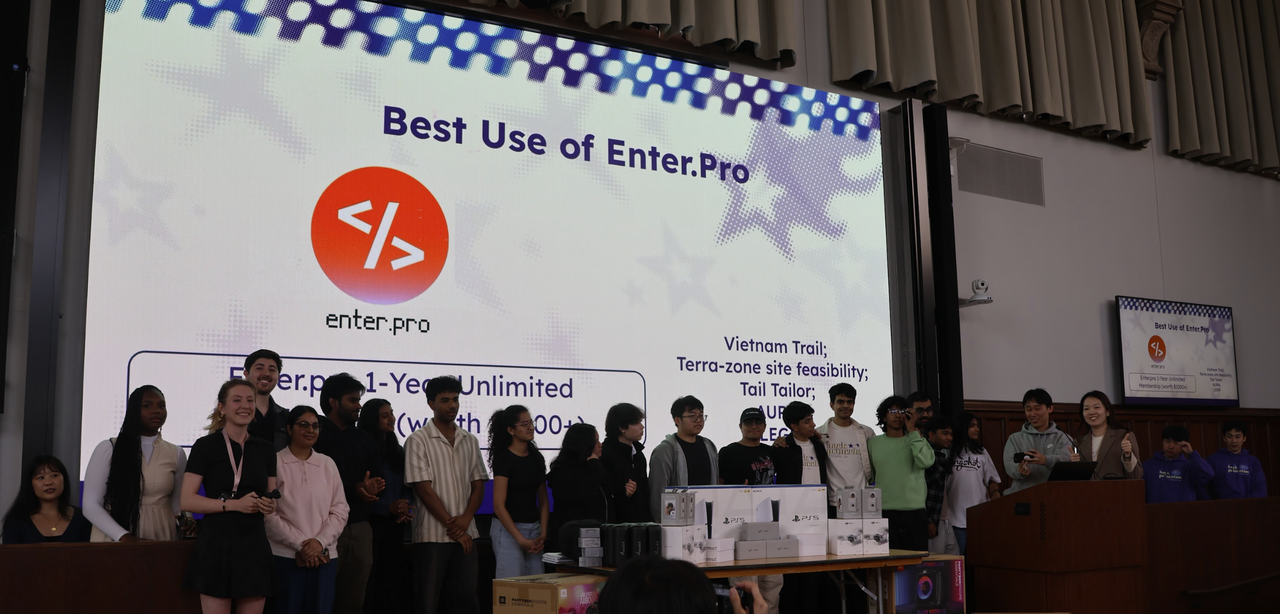
我们在那里支持下一代构建者。我们举办了研讨会,提供了咨询时间,并观察各团队在极短的时间内从空白屏幕到完成产品,这种效率至今令我们印象深刻。
这是我们 HackPrinceton 构建者系列的第三篇文章,我们将逐一介绍各个项目;而我们在那个周末看到的其中一个项目,正是直接针对上述管理危机。
一组学生——凭借原创研究和犀利的论点——构建了一个工具,旨在让企业在部署之前就能获得他们所缺失的可见性。
这个项目就是 reAgent。
什么是 reAgent
大多数 AI 部署失败都有一个共同点:在系统崩溃之前,没人能看清他们正在构建什么。
架构存在于某人的脑海中,或者白板上的草图中,或者堆满假设的 Slack 讨论串里。成本是隐形的。失败点是隐形的。逻辑漏洞也是隐形的。然后系统上线了——账单也随之而来。
reAgent 建立在一个简单的前提之上:在产生影响之前,让一切变得可见。
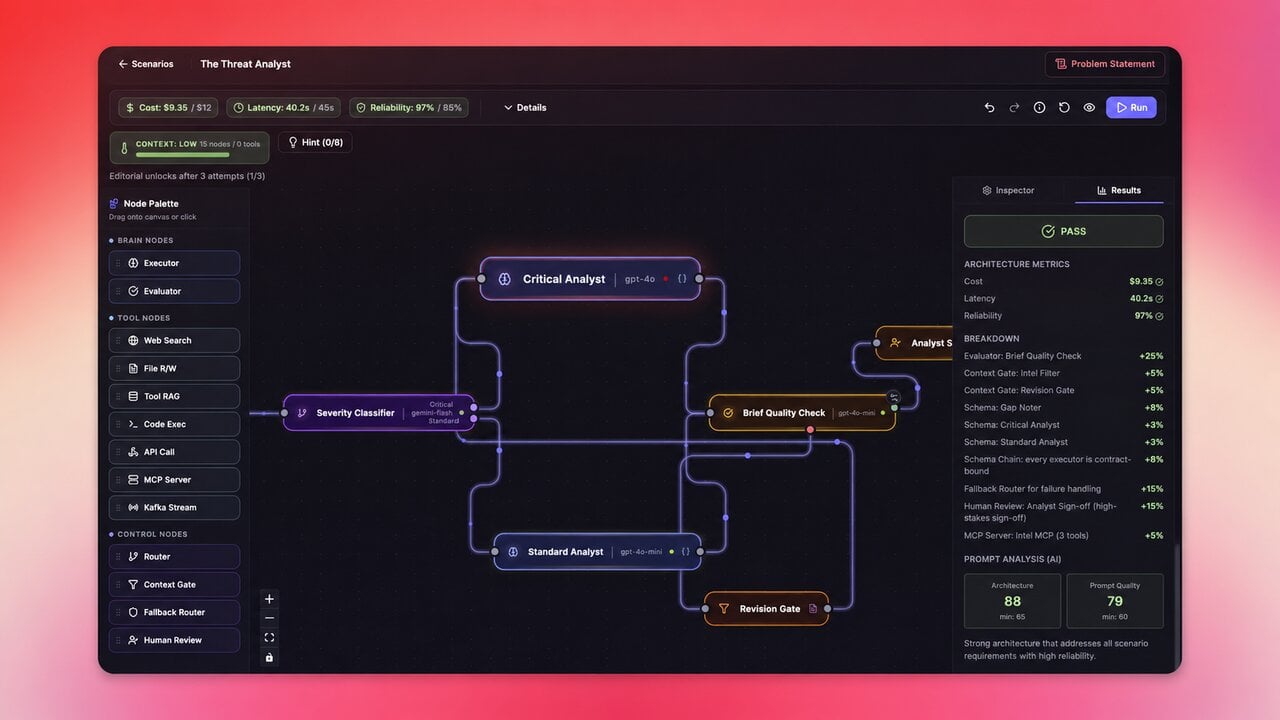
它是一个交互式的浏览器平台,能将 AI 编排中隐形的混乱转化为你可以看见、衡量并进行压力测试的内容——甚至在写下第一行代码之前。
你打开浏览器。将 AI 组件拖放到数字画布上——14 种不同的、可配置的节点类型,代表了多智能体系统的真实构建块。你将它们连接起来。你定义信息如何流动,决策在哪里做出,数据下一步去向何处。你像在白板上绘画一样构建架构——只不过这块白板会与你对话。
当你做出错误的架构选择时,节点会亮起红色。当你创建了一条低效的路径时,成本会实时更新。当你的架构导致上下文窗口超载时,界面会做出可见的反馈。
这不仅仅是一个静态的绘图工具,它是一位活跃的教练:它会实时计算你所做出的每一个架构决策的精确商业影响,在你将其投入生产之前。
reAgent 取代了*“部署后祈祷”*——并提供了一种业界一直缺失的东西:可视化风险管理。
引擎室:reAgent 的工作原理
你无法管理你无法衡量的事物。因此,reAgent 团队构建了一个“双重评估系统”(Dual-Pass Evaluation System):这是一个包含两个检查点的流程,确保每一个架构决策都既符合数学现实,又符合逻辑意图。
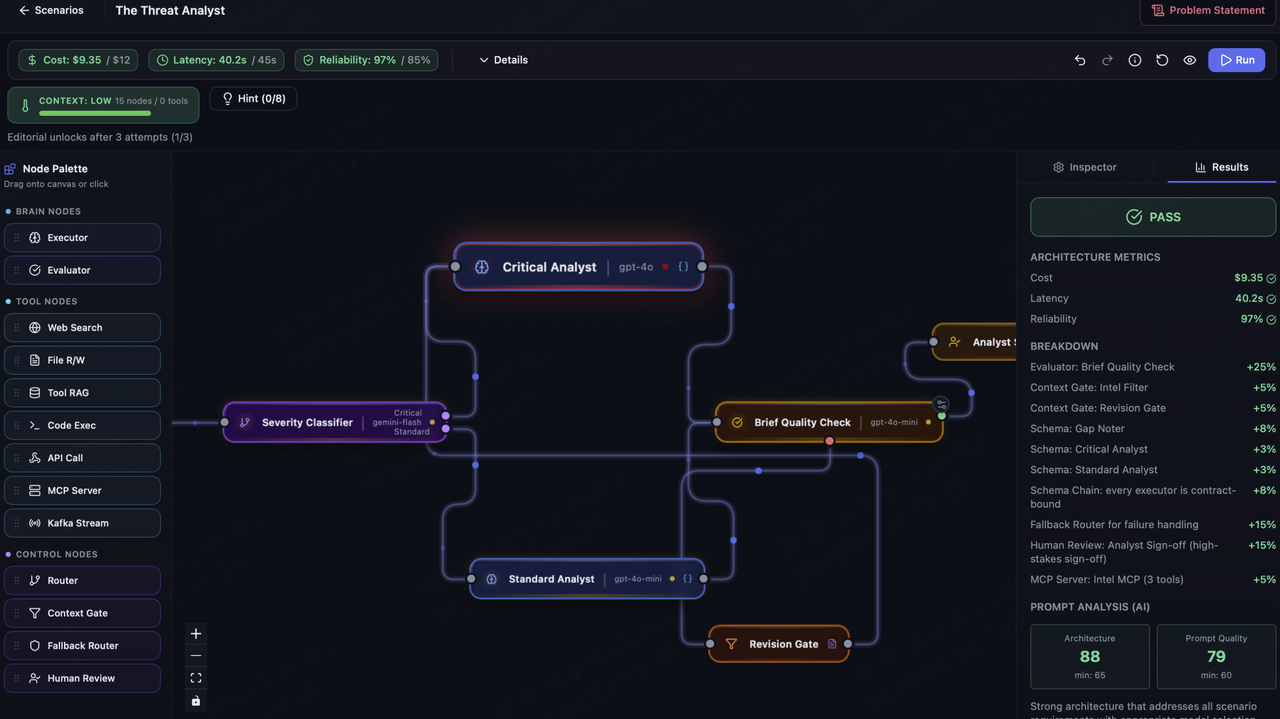
第一轮评估 —— 确定性引擎:数学与成本
当你点击“评估”(Evaluate)的那一刻,经典的图算法就会在你的架构上运行。
循环预防使用深度优先搜索(Depth-First Search)——一种追踪系统中每一条可能路径的方法——来检测死循环。如果一个 AI 模型陷入了没有退出条件的循环中,系统会立即标记出来,并计算和显示相关的成本影响。这正是导致那 47,000 美元云账单的故障类型。reAgent 在它发生前就将其捕获。
速度计算使用 Kahn 算法来映射数据在系统中传输的最长路径,从而计算出精确的 p95 延迟。并行设计(即任务同时运行而不是相互等待)会获得加分。瓶颈则会受到惩罚。数学是客观的。
第二轮评估 —— LLM-as-Judge(AI 模型担任裁判):逻辑与意图t
一旦数字校验通过,架构将由一个充当资深评审的 AI 模型进行评估。它会提出经验丰富的工程师会问的问题:
数据流动是否高效?你是否为了一个简单的规则能处理的问题而使用昂贵的 AI 模型?这个架构真的解决了你所描述的问题吗?
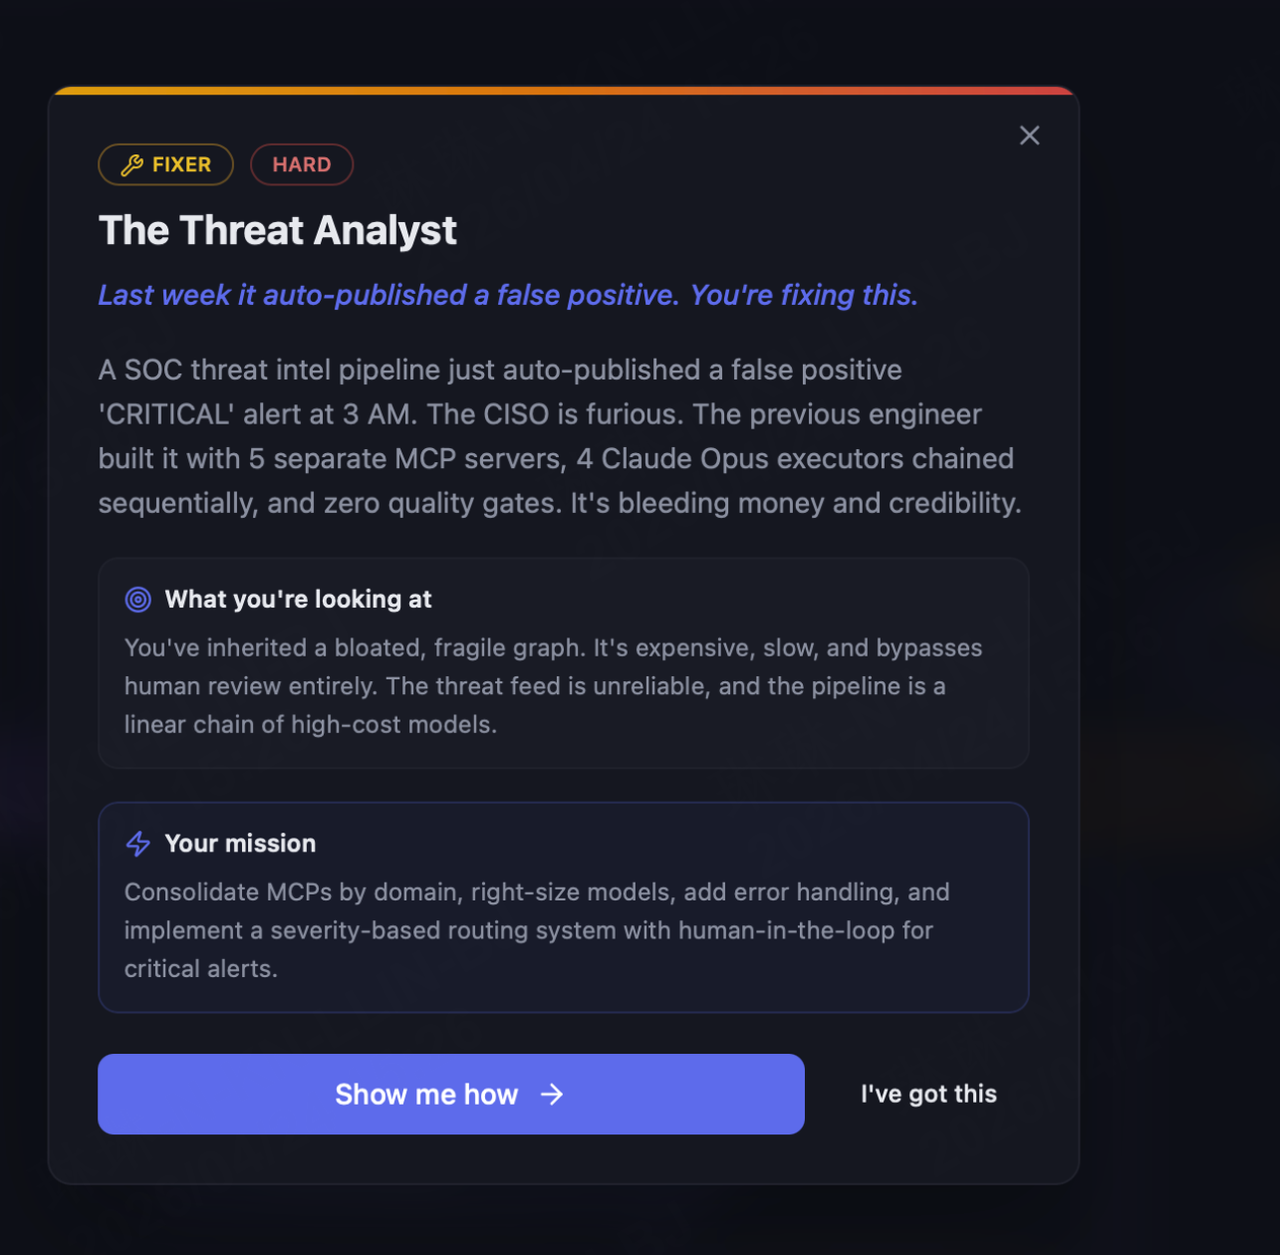
两轮评估都必须通过。你无法通过一个荒谬的图表并同时通过数学校验。你无法构建一个运行成本需要 50 美元的东西并通过逻辑校验。系统同时坚持这两个标准——而这种严谨性正是关键所在。
三个值得了解的功能
- 上下文温度计(The Context Thermometer)
每个 AI 模型都有一个上下文窗口:它一次可以容纳和处理的信息量。它是有限的,也是昂贵的。团队通常会在不知不觉中超载它,喂入所有可用的信息,让模型以高昂的成本进行筛选。
上下文温度计是一个实时视觉元素,当架构接近该限制时,它会物理晃动并发出警告。系统会遍历整个图表,追踪每一个动作链,计算每一个输入到模型中的下游工具。当负载变得危险时,界面会立即做出明显的响应。
这不仅仅是通知,而是一种物理反应。这种设计细节告诉你,构建它的人亲身体验过失控的上下文成本所带来的痛苦。
- 实时投资回报率(ROI)显示
你在画布上做的每一个决定都会立即反映在实时显示屏上,展示精确的延迟和计算出的美元成本。错误的路由选择 = 节点变红。更有效的路径 = 数字下降。
这既是一个学习工具,也是一个成本分析工具。它在你投入构建之前,就帮你建立了对“管理良好的 AI 架构”应有的直觉。
- 沙盒模式(Sandbox Mode)
输入一个简单的英文商业目标:“监控 SEC 文件并标记风险”——平台会在几秒钟内在画布上自动生成一个经过全面优化、路由和门控的多智能体架构。
这通常需要数周的工程试错,现在变成了仅需五秒的起点。
36 小时。一个实时产品。
上面提到的一切:双重评估、上下文温度计、实时 ROI 显示、沙盒模式——都是在 36 小时内构建完成的。
Enter.pro为团队提供了以黑客马拉松的速度行动,同时又不牺牲生产质量的基础设施。这不是原型,而是一个已部署的、交互式的产品,任何人现在都可以在浏览器中打开它。那种曾经需要几周时间搭建框架的东西,是在普林斯顿的一个周末里完成的。
这就是 Enter 构建的目的所在。消除绝妙想法与实时产品之间的每一个障碍,让真正进行思考的人可以将时间花在核心点上:思考。
更大的使命
reAgent 团队并没有将他们构建的东西描述为一个产品。他们将其描述为一场运动。
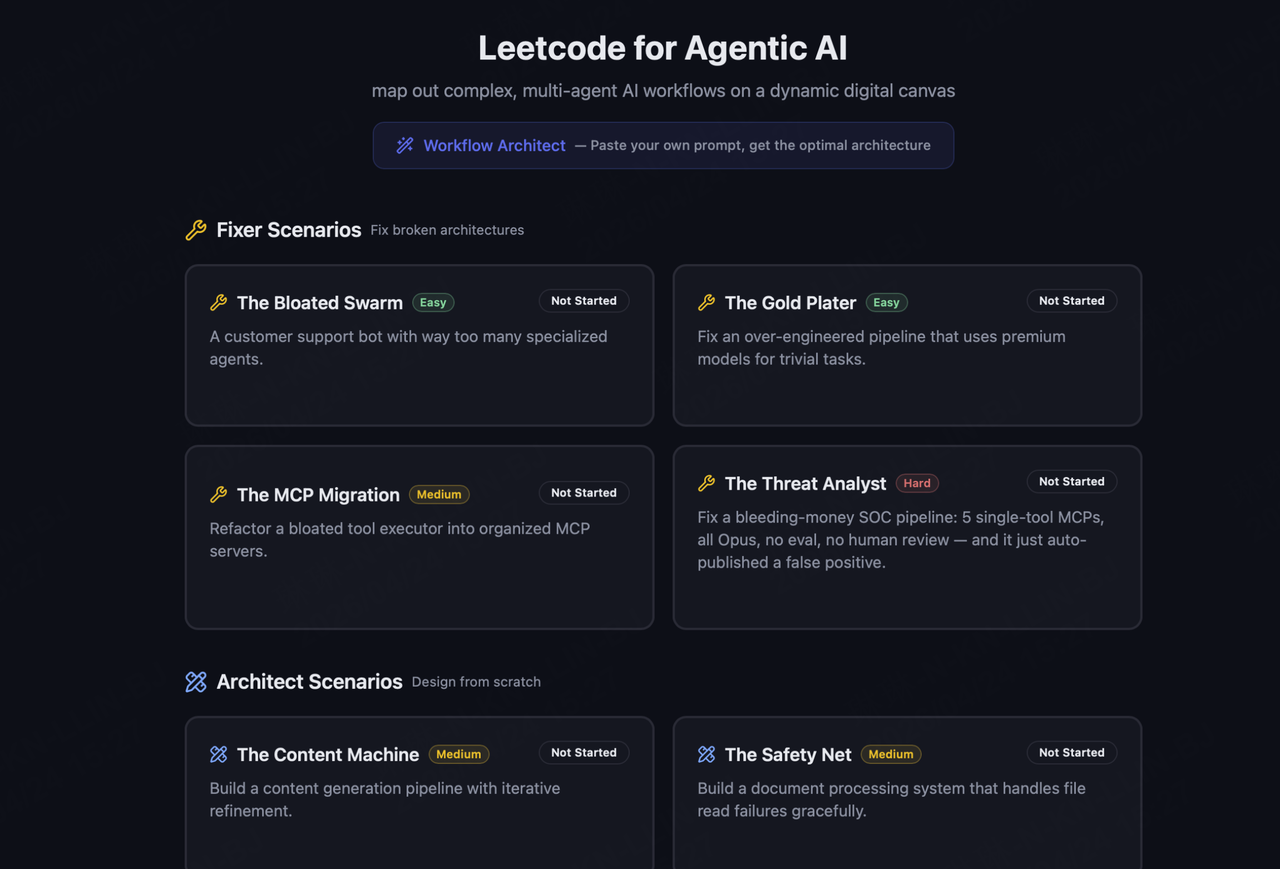
LeetCode 是一个通过成千上万个算法挑战训练了一代软件工程师的平台。它成为了工程准备的全球标准:一种共同的语言、共同的基准、以及一种判断你是否准备就绪的共同方式。
在智能体 AI 时代,没有人建立起与之相当的平台。没有课程教人如何路由模型、门控上下文、检测循环、计算实时成本,以及如何架构那些不会在隐形且昂贵的螺旋中相互消耗的系统。
“LeetCode 教了一代人如何反转链表。我们正在教下一代人如何编排 AI。”
对于学生和新工程师:一个在接触生产系统之前,就能学习未来十年最有价值工程技能的试验场。
对于企业领导者:第一个让高管和工程师能够坐在同一屏幕前,使用同一种语言,并确切了解 AI 预算去向的界面。
对于社会:精益的 AI 架构不仅仅更便宜。高效的编排意味着更少的不必要 API 调用、更少的服务器计算,以及一种更负责任的扩展方式。
下一步是什么
导出为生产就绪的样板代码(将可视化画布转换为可部署代码)的工作正在进行中。Sandbox Mode 将扩展以覆盖更多企业场景。可解释性研究也在持续进行。
那个将助力下一代负责任地部署 AI 的 IDE 才刚刚起步。
一个周末足以改变方向
AI 竞赛不会放缓。公司部署的压力不会减轻。云服务账单和失败的项目将会持续出现——只要缺乏理解所构建内容的工具,这种情况就会继续。
reAgent 就是这些工具之一。它由一群学生在 36 小时内构建完成,他们没有等待他人来解决这个问题。
这就是我们每次想到 HackPrinceton 时都会回想起来的事情。
在这里,空白屏幕永远不会获胜。
这是您体验该项目的机会:智能体工作流的 Leetcode
错过了前几期?→ 第 1 卷 — Heritage in Pixels→ 第 2 卷 — Terra Zone AI